特徴量エンジニアリングと特徴選択
拡張プレディクションでは、プレディクションを実行する前にデータに対して特徴量エンジニアリングと特徴選択を実行できるため、プレディクション精度が向上します。
拡張プレディクションを定義する場合、管理者はデータ準備ページで新しいオプションの「特徴量エンジニアリングと特徴選択の自動化の使用可能」を選択できます。このオプションはデフォルトで選択されています。
特徴量エンジニアリングとは、モデル・パフォーマンスを向上させるために既存の特徴量を変換したり新しい特徴量を作成することで、機械学習用のデータを準備するプロセスです。特徴量エンジニアリングの自動化により、このプロセスが加速され、精度が向上したモデルを実現できます。
特徴量エンジニアリングがない場合、すべてのドライバはそのまま扱われます。特徴量エンジニアリングでは、追加情報が特徴量から導出され、より正確なプレディクションが行われます。次のタイプの変換が適用されます。
- 時間ベースの特徴量。たとえば、特定の曜日にはより多くの影響がありますか。
- ラグ効果。たとえば、6月のマーケティング支出が8月の売上高に及ぼす影響など、ターゲットに対するビジネス・ドライバのラグ効果は何ですか。
- 集約変換。たとえば、1つのデータ・ポイントではなく、ローリング平均値がビジネス・ドライバに与える影響は何ですか。
「特徴量エンジニアリングと特徴選択の自動化の使用可能」を選択すると、複数のエンジニアド特徴量が作成され、モデルの生成およびプレディクション用に上位15個(以下)の特徴量が選択されます。特徴量の重要度チャートには、出力変数に対して選択した上位15個の特徴量の重要度が表示されます。
「特徴量エンジニアリングと特徴選択の自動化の使用可能」が選択されていない場合、エンジニアド特徴量は作成されません。ただし、特徴量の重要度は引き続き評価され、重要でないと判断された特徴量はモデルから除外されます。その他の特徴量はすべて、モデル生成にそのまま使用されます。
特徴量の重要度チャートには、出力変数に対して指定された特徴量の重要度が表示されます。チャートには上位9つの特徴量が表示されます。残りの特徴量は、パーセンテージ値で集約され、「その他」という見出しの下にグループ化されます。
「プレディクションの説明」画面で、特徴量エンジニアリングと特徴選択の影響を確認できます。拡張プレディクションのプレディクト値を含むフォームで、プレディクト・データを含むセルを右クリックし、「プレディクションの説明」を選択します。プレディクションの詳細は、特徴量の重要度タブおよびプレディクション分析タブで確認します。
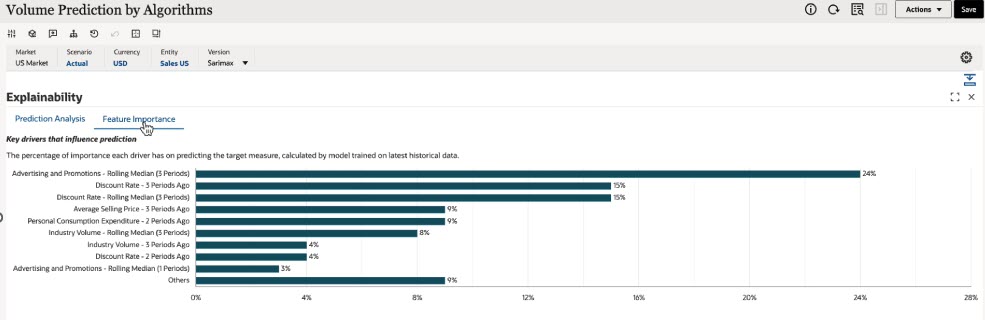
アルゴリズムとして「AutoMLx」を選択した場合は、「AutoMLx」によって、精度に基づいて単変量モデルまたは多変量モデルのいずれかが自動的に選択されることに注意してください。
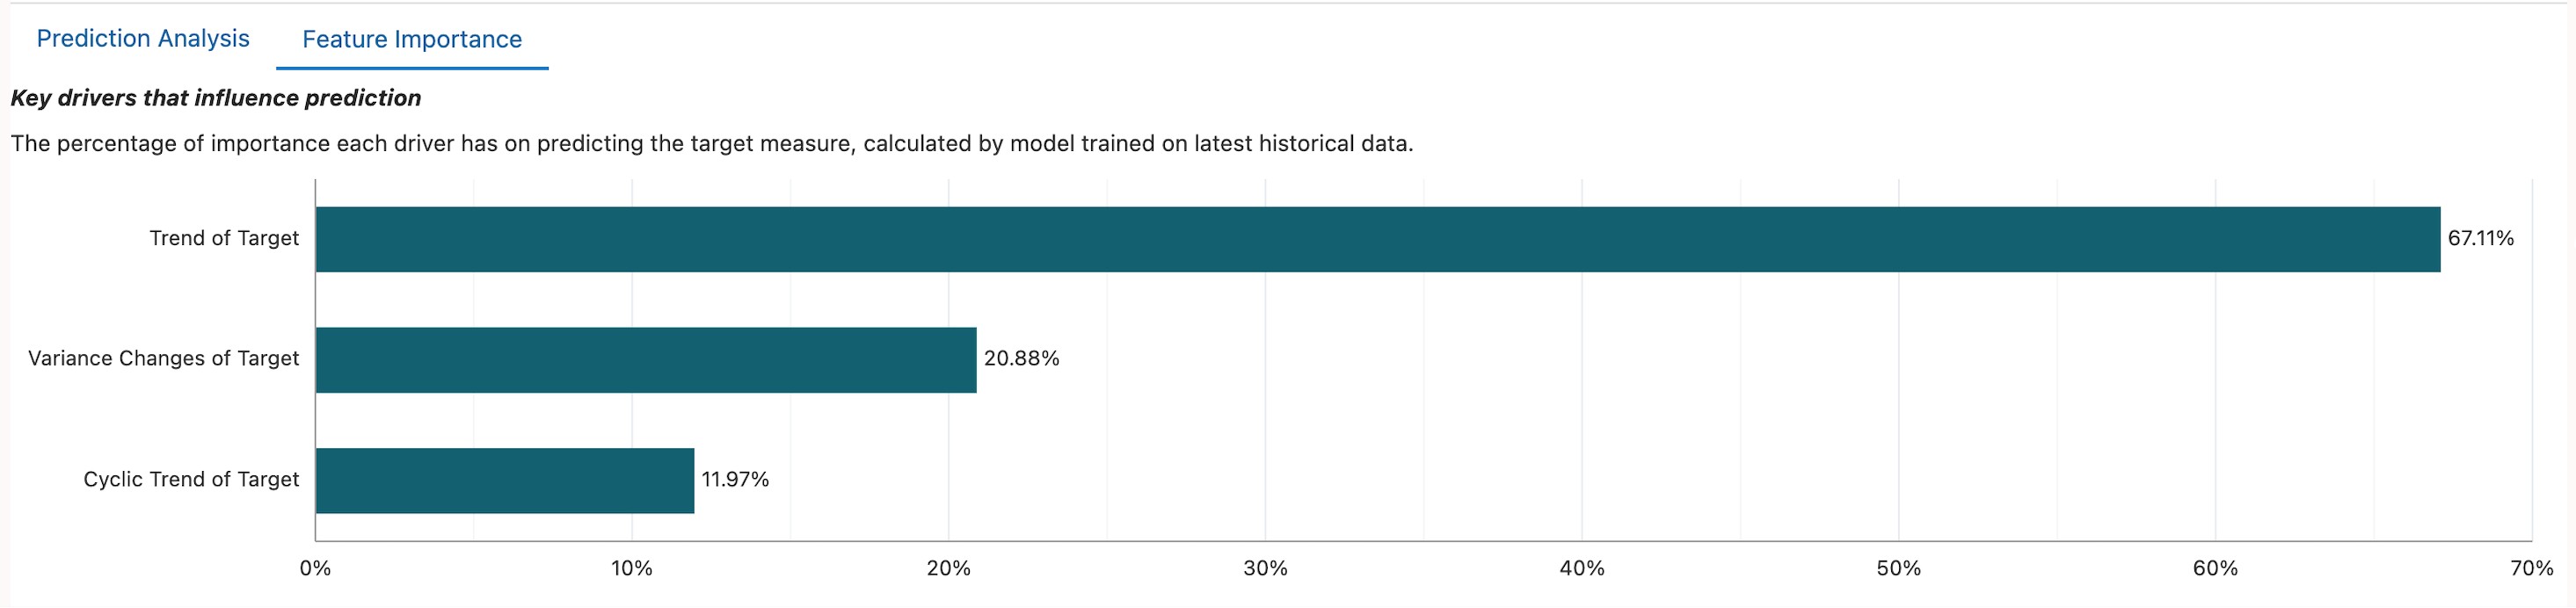
単変量モデルが選択されている場合、特徴量の重要度グラフには、ターゲットのトレンド、ターゲットN期間前、ターゲットの差異変化およびターゲットの循環トレンド(該当する場合)などの出力/ターゲット関連の特徴量のみが表示されます。
単変量モデルの特徴量の重要度グラフは次のようになります。
特徴量エンジニアリングは、入力特徴量と出力変数との間の隠れた関係を検出します。適切なエンジニアド特徴量により、モデルはより関連性の高い情報を取得できるため、モデルのパフォーマンスが向上し、プレディクションが改善されます。
特徴選択は、予測精度に影響を与える最も関連性の高いビジネス・ドライバを特定し、ノイジーまたは影響が小さい変数を除外してオーバーフィッティングを回避します。また、複雑さと処理時間を削減することでパフォーマンスを向上させます。プレディクティブ能力に基づいて特徴量をランク付けすることで、説明可能性をサポートします。
次の点に注意してください。
- デフォルトでは、「特徴量エンジニアリングと特徴選択の自動化の使用可能」が選択されています。
- 「特徴量エンジニアリングと特徴選択の自動化の使用可能」を選択すると、プレディクションの実行に必要な時間が長くなります。
ビデオ
| 目的 | 視聴 |
|---|---|
| 複数のエンジニアリング特徴量を拡張プレディクションに組み込む方法を学習します。特徴量エンジニアリングでは、追加情報が特徴量から導出され、より正確なプレディクションが行われます。適用される変換には、時間ベースの特徴量、ラグ効果および集約変換が含まれます。拡張プレディクションを定義するときに、データ準備ページで特徴量エンジニアリングと特徴選択の自動化を使用可能にするオプションを選択できます。 | 
|