Paralleles Replicat
Paralleles Replicat ist eine weitere Variante von Replicat, bei der Transaktionen parallel angewendet werden, um die Performance zu verbessern.
Dabei werden Abhängigkeiten zwischen Transaktionen berücksichtigt, ähnlich wie bei Integrated Replicat. Die Abhängigkeitsberechnung, Parallelisierung der Zuordnung und Anwendung wird außerhalb der Datenbank ausgeführt, sodass sie auf einen anderen Server ausgelagert werden kann. Die Transaktionsintegrität wird in diesem Prozess aufrechterhalten. Darüber hinaus unterstützt paralleles Replicat die parallele Anwendung großer Transaktionen, indem eine große Transaktion in Blöcke aufgeteilt und parallel angewendet wird.
Paralleles Replicat unterstützt die folgenden zwei Modi: Integriert und Nicht integriert. Nur Oracle AI Database unterstützt paralleles Replicat im integrierten Modus.
Um paralleles Replicat zu verwenden, müssen Sie sicherstellen, dass Sie über die folgenden Werte verfügen, die auch die Standardwerte sind:
-
Metadaten im Trail (d.h. Sie können kein paralleles Replicat verwenden, wenn Ihre Trails unter 12.1 formatiert sind).
-
Die Traildatei muss Planungsspalten enthalten.
-
Sie müssen
UPDATERCORDFORMAT COMPACTverwenden.
Bei integriertem parallelen Replicat sendet das Replicat die LCRs an den eingehenden Server, der die Daten auf die Zieldatenbank anwendet. Im regulären parallelen Replicat wendet Oracle GoldenGate den LCR als SQL-Anweisung direkt auf die Datenbank an, ähnlich wie die anderen nicht integrierten Replicats funktionieren. Hinweis: Um die beste Performance für eine OLTP-Workload zu erzielen, wird paralleles Replicat im nicht integrierten Modus empfohlen.
Die Komponenten von parallelem Replicat sind:
-
Mapper arbeiten parallel, um den Trail zu lesen, Traildatensätze zuzuordnen, die zugeordneten Datensätze in das integrierte Replicat-LCR-Format zu konvertieren und die LCRs zur weiteren Verarbeitung an die Fusion zu senden. Während ein Mapper eine Gruppe von Transaktionen zuordnet, ordnet der nächste Mapper die nächste Gruppe von Transaktionen zu. Die Traildaten werden aufgeteilt, und die Traildatei wird nicht berührt, weil sie Traildaten in der richtigen Reihenfolge anfordert.
-
Master-Prozesse haben zwei Threads: Collater und Scheduler. Der Collater empfängt zugeordnete Transaktionen von den Mappers und versetzt sie zurück in die Trail-Reihenfolge für die Abhängigkeitsberechnung. Der Scheduler berechnet Abhängigkeiten zwischen Transaktionen, gruppiert Transaktionen in unabhängige Batches und sendet die Batches an die Appliers, die auf die Zieldatenbank angewendet werden.
-
Ausreißer ordnen Datensätze innerhalb eines Batches zur Arrayausführung neu an. Er wendet den Batch auf die Zieldatenbank an und führt die Fehlerbehandlung aus. Außerdem werden angewendete Transaktionen in Checkpoint-Tabellen verfolgt. Hinweis: Paralleles Replicat erfordert, dass Fremdschlüsselspalten indiziert werden.
Vorteile von Parallel Replicat
Die Verwendung von parallelem Replicat bietet folgende Vorteile:
-
Mit dem integrierten parallelen Replicat können schwere Workloads automatisch zwischen parallelen Apply-Prozessen partitioniert werden, die mehrere Transaktionen gleichzeitig anwenden, wobei die Integrität und Atomizität der Quelltransaktion erhalten bleibt. Mit den Parametern
PARALLELISMundMAX_PARALLELISMkönnen sowohl eine Mindest- als auch eine Höchstanzahl von Apply-Prozessen konfiguriert werden. Replicat fügt automatisch zusätzliche Server hinzu, wenn die Workload zunimmt, und passt sich dann wieder nach unten an, wenn die Workload zunimmt. -
Integriertes paralleles Replicat erfordert minimalen Konfigurationsaufwand. Alle Arbeiten werden in einer Replicat-Parameterdatei konfiguriert, ohne Range-Partitionen zu konfigurieren.
-
High-Performance-Apply-Streaming wird für das integrierte parallele Replicat über eine einfache Anwendungsprogrammierschnittstelle (API) zwischen Replicat und dem eingehenden Server aktiviert.
-
Barrieretransaktionen werden durch integriertes paralleles Replicat zwischen mehreren Server-Apply-Prozessen koordiniert.
-
DDL-Vorgänge werden als direkte Transaktionen verarbeitet, die eine Barriere erzwingen, indem auf den Abschluss der Serververarbeitung vor der DDL-Ausführung gewartet wird.
-
Transiente doppelte Primärschlüsselaktualisierungen werden nahtlos von integriertem parallelen Replicat verarbeitet.
-
Paralleles Replicat kann eine einzelne große Transaktion in kleinere Chunks aufteilen und diese Chunks parallel anwenden. Weitere Informationen finden Sie unter SPLIT_TRANS_RECS.
Parallele Replikationsarchitektur
Parallele Replikationsprozesse nutzen die Apply-Verarbeitungsfunktionalität, die in der Oracle AI Database im integrierten Modus verfügbar ist. Innerhalb einer einzelnen Replicat-Konfiguration können mehrere untergeordnete Prozesse des eingehenden Servers, die als Apply-Server bezeichnet werden, Transaktionen parallel anwenden, während die ursprüngliche Transaktionsatomarität beibehalten wird.
Das folgende Architekturdiagramm zeigt den Ablauf von Änderungsdatensätzen durch die verschiedenen Prozesse einer parallelen Replikation von den Traildateien in die Zieldatenbank für ein nicht integriertes paralleles Replicat.
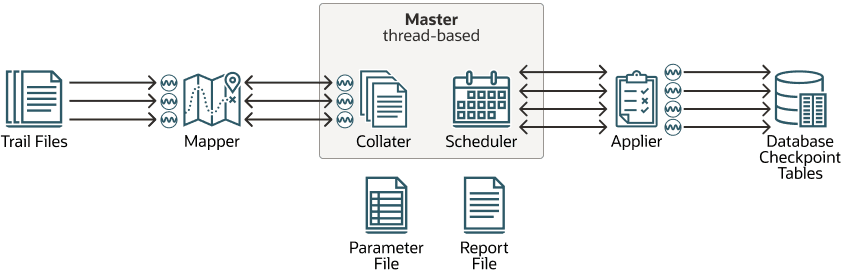
Die Beschreibung des obigen Architekturdiagramms lautet wie folgt:
-
Die Mappers lesen die Traildatei und ordnen Datensätze zu, leiten die zugeordneten Datensätze an den Master weiter. Die Batches werden an die Appliers gesendet, wo sie auf die Zieldatenbank angewendet werden.
-
Der Master-Prozess besteht aus zwei separaten Threads, Collater und Scheduler. Der Collater ist für die Verwaltung und Kommunikation mit den Mappers sowie für den Empfang der zugeordneten Transaktionen verantwortlich und ordnet sie in einem einzigen bestellten Stream neu an. Der Scheduler ist verantwortlich für die Verwaltung und Kommunikation mit den Appliers sowie für das Lesen von Transaktionen aus dem Collater, das Batching dieser Transaktionen und die Planung an Appliers.
-
Der Scheduler-Controller kommuniziert mit dem Scheduler, um alle erforderlichen Informationen zu sammeln (z. B. die aktuelle Position mit niedrigem Wasserzeichen). Der Scheduler-Controller ist für den CDB-Modus für Oracle AI Database erforderlich, da er für die Aggregation von Informationen zu den verschiedenen Ziel-PDBs und das Reporting eines einheitlichen Bildes verantwortlich ist. Der Scheduler Controller wird aus Gründen der Einfachheit und Einheitlichkeit der Implementierung erstellt, auch wenn er sich nicht im CDB-Modus befindet. Jeder Prozess liest die Parameterdatei und teilt eine einzelne Checkpoint-Datei.
Grundlegende Parameter für paralleles Replicat
In der folgenden Tabelle sind die grundlegenden parallelen Replicat-Parameter und deren Beschreibung aufgeführt.
| Parameter | Beschreibung |
|---|---|
|
|
Konfiguriert die Anzahl der Mapper. Dadurch wird die Anzahl der Threads gesteuert, die zum Lesen der Traildatei verwendet werden. Der Mindestwert ist 1, der Höchstwert ist 100 und der Standardwert ist 2. |
|
|
Konfiguriert die Anzahl der Ausreißer. Dadurch wird die Anzahl der Verbindungen in der Zieldatenbank gesteuert, mit denen die Änderungen angewendet werden. Der Standardwert ist vier. |
|
|
Die Apply-Parallelität wird automatisch optimiert. Sie können einen Mindest- und Höchstwert festlegen, um die Bereiche zu definieren, in denen Replicat seine Parallelität automatisch anpasst. Es sind keine Standardwerte vorhanden. Verwenden Sie |
|
|
Gibt an, dass große Transaktionen in Teile der angegebenen Größe aufgeteilt und parallel angewendet werden sollen. Abhängigkeiten zwischen den Stücken bleiben erhalten. Standardmäßig deaktiviert. |
|
|
Aktiviert den Commit-VOLLSTÄNDIGEN Serialisierungsmodus, der die Festschreibung von Transaktionen in Trailreihenfolge erzwingt. |
|
Erweiterte Parameter |
|
|
|
Steuert, wie weit der Scheduler beim Batching von Transaktionen voraus ist. Der Standardwert ist 10000. |
|
|
Steuert, wie groß eine Transaktion sein muss, damit paralleles Replicat sie als groß betrachtet. Wenn ein paralleles Replicat auf eine Transaktion trifft, die größer als diese Größe ist, wird es serialisiert, was zu einer verringerten Performance führt. Wenn Sie diesen Wert erhöhen, erhöht sich jedoch auch die Speichermenge, die von parallelem Replicat belegt wird. |
Beispielparameterdatei
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;