Implementieren Sie einen skalierbaren Workflow für maschinelles Lernen mit Oracle AI Data Platform und OCI Data Science
Die Lösung vereint die Stärken beider Plattformen:
- AI Data Platform: Bietet zentralisiertes und verwaltetes Datenmanagement, umfangreiche Spark-Verarbeitung, Workflow-Orchestrierung und eine Medallion-Datenarchitektur.
- Data Science: Bietet eine flexible Laufzeitumgebung und Infrastruktur für die Entwicklung von Notebook- und jobbasiertem maschinellem Lernen, Modellbereitstellung und Modellbereitstellung für Produktions-Workloads.
Diese Architektur wurde entwickelt, um zentralisierte Unternehmensdatenplattformen, groß angelegte Datenverarbeitung, mittlere bis große Workloads für maschinelles Lernen und die Zusammenarbeit zwischen Data Engineers und Data Scientists zu unterstützen.
Typische Anwendungsfälle sind:
- Einzelhandelsprognosen: Tägliche Bedarfsprognosen werden basierend auf historischen und neu aufgenommenen Daten generiert.
- Optimierung der Versicherungsverlängerung: Optimierung der Preise für die Versicherungsverlängerung, um die Margen zu maximieren und gleichzeitig Geschäftsbeschränkungen zu erfüllen. Jede Woche wird ein neuer Batch mit Erneuerungsangeboten generiert.
- Überwachung und Abweichungserkennung von Telekom-Logereignissen: Analysieren Sie umfangreiche betriebliche Ereignisstreams, um Datenabweichungen zu erkennen, Anomalien zu erkennen und tägliche Berichte und Erkenntnisse zu generieren.
Architektur
Dieses Diagramm veranschaulicht diese Referenzarchitektur.
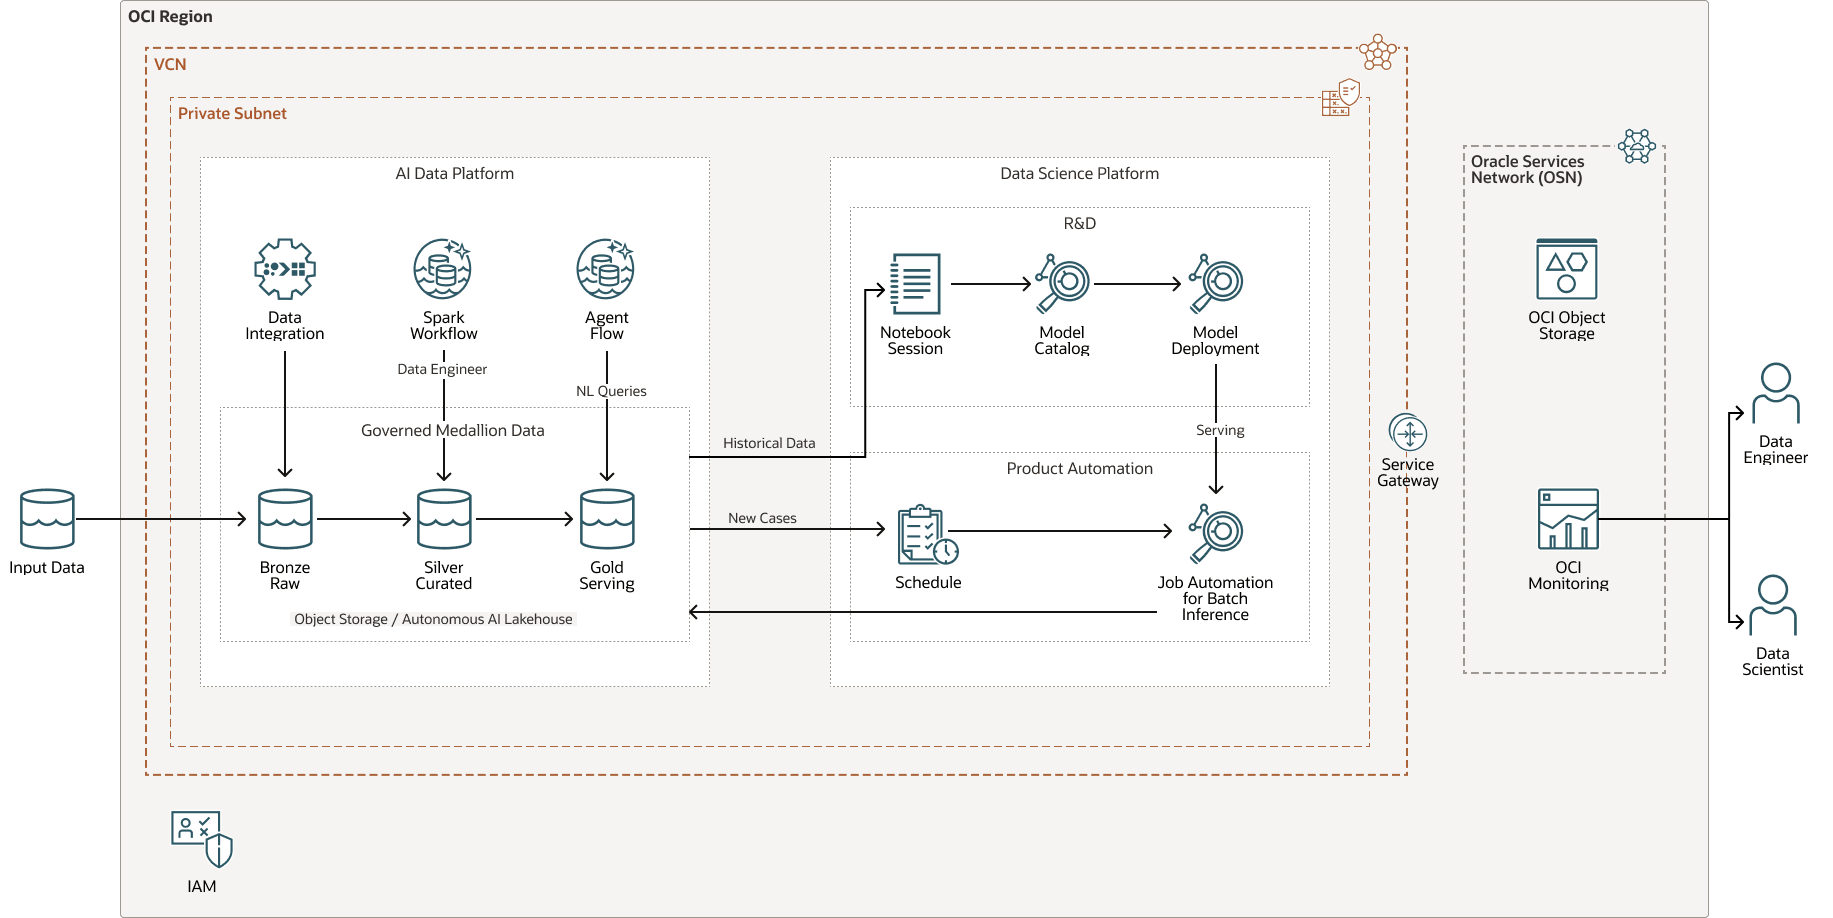
Beschreibung der Abbildung aidp-ml-workloads-architecture.png
helpp-ml-workloads-architecture-oracle.zip#GUID-73867B97-5BE4-434A-85C4-097DB840B323
Die Architektur ist in vier primäre Domänen unterteilt.
AI Data Platform (AIDP)
AI Data Platform ist für die Datenaufnahme, -transformation, -Governance und -vorbereitung verantwortlich.
- Datenintegration: Daten aus verschiedenen Unternehmensquellen mit verschiedenen Tools wie OCI Data Integration und OCI Streaming mit Apache Kafka aufnehmen
- AI Lakehouse: Skalierbarer und dynamischer Speicher
- Spark Workflows: Skalierbare Datenverarbeitung und -transformation mithilfe der Medaillon-Architektur mit Bronze-, Silber- und Goldschichten
- Agent-Ablauf: Dateninteraktionen in natürlicher Sprache
Diese Ressourcen werden hauptsächlich von Data Engineers erstellt und verwaltet.
Data Science-Plattform
Data Science verwaltet den Lebenszyklus des maschinellen Lernens mit verschiedenen Ressourcen, die während der F&E- und Produktionsphase verwendet werden.
Die F&E-Phase umfasst:
- Notizbuchsessions: ML-Experimente und Modelltraining
- Modellkatalog: Modellversionierung und Modellverwaltung
- Modell-Deployment: Deployment für sclalable model Serving
Die Produktionsphase umfasst die geplante Auftragsautomatisierung für wiederholbare Batch-Inferenzpipelines und die Produktionsautomatisierung
OCI-Monitoring
OCI Monitoring bietet eine zentrale betriebliche Transparenz über beide Plattformen hinweg für Monitoring, Visualisierung und Alarmierung im Zusammenhang mit Datenabweichungen und Modellabweichungen. OCI Monitoring trägt zur Gewährleistung der Betriebssicherheit und der Produktionsbereitschaft bei.
Plattforminteraktion
Die Interaktion zwischen der Data Science-Plattform und der AI Data Platform dient in erster Linie den folgenden Zwecken:
- Die Data Science-Plattform ruft Daten ab, die von der AI Data Platform sowohl für das Modelltraining (historische Daten) als auch für die Produktionsautomatisierung (neue Fälle, die bewertet werden müssen) verwaltet werden.
- Die Data Science-Plattform bereichert die Daten, indem Vorhersagescores für neu verarbeitete Fälle hinzugefügt werden.
Die für die Schulung und Produktionsautomatisierung verwendete Datenschicht kann je nach Schema und Architektur, die vom Dateningenieur definiert wurden, von den Anwendungen abweichen. In vielen Fällen stammen die Daten aus der kuratierten Silberschicht, können aber auch aus den Bronze- oder Goldschichten oder aus einer Kombination mehrerer Schichten stammen.
In ähnlicher Weise werden die angereicherten Daten, die Vorhersagewerte enthalten, häufig in die Gold-Schicht geschrieben, können jedoch auch in anderen Datenschichten gespeichert werden, je nach den Anforderungen und der Datenarchitektur der Anwendung.
Die für die Datenabweichungserkennung verwendeten Daten können je nach Anwendungsfall und Datenarchitektur aus den Ebenen Bronze, Silber oder Gold stammen.
Architekturkomponenten
- Oracle AI Data Platform
Oracle AI Data Platform ist eine einheitliche Plattform, die das Katalogisieren, Vorbereiten und Analysieren von Daten über Ihren gesamten Datenbestand hinweg vereinfacht. Es vereint Daten, KI, Analysen und Governance in einer zusammenhängenden Benutzererfahrung, mit der Sie sichere, skalierbare KI-gestützte Anwendungen erstellen können. Oracle AI Data Platform vereint Autonomous AI Lakehouse, Oracle Analytics Cloud, OCI Object Storage, OCI Generative AI und Fusion Data Intelligence.
Innerhalb dieser Plattform stellt Oracle AI Data Platform Workbench eine dedizierte Entwicklungsumgebung bereit, in der Sie Datenpipelines und -modelle entwerfen, orchestrieren und bereitstellen, RBAC-Policys festlegen und Open-Source-Technologien wie Spark verwenden können, um Ihre Daten vorzubereiten, zu analysieren und anzureichern.
- OCI-Datenintegration
Oracle Cloud Infrastructure Data Integration ist ein vollständig verwalteter, serverloser Service zum Entwerfen und Ausführen von Datenpipelines. Es ermöglicht eine nahtlose Extraktion, Transformation und das Laden von Daten in OCI-Ziele wie Autonomous AI Lakehouse und OCI Object Storage. Benutzer können Integrationsabläufe über eine kodierte, intuitive Benutzeroberfläche erstellen, die automatisch Ausführungsumgebungen skaliert. Es unterstützt sowohl ETL mit Spark-basierter Verarbeitung als auch ELT mit SQL Pushdown für Performance und Effizienz. Der Service bietet auch Tools zur Datenaufbereitung und schützt vor Schemaabweichungen durch regelbasiertes Handling.
- Data Science
Oracle Cloud Infrastructure Data Science ist eine vollständig verwaltete, serverlose Plattform, mit der Data-Science-Teams Modelle für maschinelles Lernen (ML) in OCI erstellen, trainieren und verwalten können. Es kann problemlos in andere OCI-Services wie Oracle Autonomous AI Lakehouse, Oracle Cloud Infrastructure Object Storage und mehr integriert werden. Sie können hochwertige Modelle für maschinelles Lernen erstellen und bewerten, die die Geschäftsflexibilität erhöhen, indem Sie unternehmensbewusste Daten schnell einsetzen. Außerdem können Sie datengesteuerte Geschäftsziele mit einfacherem Deployment von ML-Modellen unterstützen.
- OCI Identity and Access Management
Oracle Cloud Infrastructure Identity and Access Management (IAM) bietet Benutzerzugriffskontrolle für OCI und Oracle Cloud Applications. Mit der IAM-API und der Benutzeroberfläche können Sie Identitätsdomains und die darin enthaltenen Ressourcen verwalten. Jede OCI IAM-Identitätsdomain stellt eine eigenständige Identity and Access Management-Lösung oder eine andere Benutzerpopulation dar.
- OCI-Monitoring
Oracle Cloud Infrastructure Monitoring überwacht aktiv und passiv Ihre Cloud-Ressourcen und benachrichtigt Sie mit Alarmen, wenn Metriken bestimmte Trigger erfüllen.
- OCI Object Storage
OCI Object Storage bietet Zugriff auf große Mengen an strukturierten und unstrukturierten Daten eines beliebigen Inhaltstyps, darunter Datenbankbackups, Analysedaten und umfangreiche Inhalte, wie Bilder und Videos. Sie können Daten sicher und sicher direkt aus Anwendungen oder aus der Cloud-Plattform speichern. Sie können den Storage skalieren, ohne dass die Performance oder Servicezuverlässigkeit beeinträchtigt wird.
Verwenden Sie den Standardspeicher für "Hot Storage", auf die Sie schnell, sofort und häufig zugreifen müssen. Verwenden Sie Archivspeicherung für "Cold Storage", die Sie über lange Zeiträume beibehalten und nur selten darauf zugreifen.
- OCI-region
Eine OCI-Region ist ein lokalisierter geografischer Bereich, der mindestens ein Data Centre enthält, das Availability-Domains hostet. Regionen sind unabhängig von anderen Regionen, und große Entfernungen können über Länder oder Kontinente voneinander getrennt werden.
- Servicegateway
Ein Servicegateway ermöglicht den Zugriff von einem VCN auf andere Services, wie Oracle Cloud Infrastructure Object Storage. Der Datenverkehr vom VCN zum Oracle-Service wird über die Oracle-Netzwerkstruktur geleitet und durchläuft nicht das Internet.
- OCI Streaming
Oracle Cloud Infrastructure Streaming bietet eine komplett verwaltete, skalierbare und dauerhafte Speicherlösung zur Aufnahme kontinuierlicher Datenstreams mit hohem Volumen, auf die Sie in Echtzeit zugreifen und verarbeiten können. Sie können OCI Streaming zum Erfassen von Daten mit hohem Volumen verwenden, wie Anwendungslogs, Betriebstelemetrie, Clickstream-Webdaten oder für andere Anwendungsbereiche, in denen kontinuierlich und sequenziell Daten in einem Publish-Subscribe-Messagingmodell produziert und verarbeitet werden.
- Virtuelles OCI-Cloud-Netzwerk und Subnetz
Ein virtuelles Cloud-Netzwerk (VCN) ist ein anpassbares, softwaredefiniertes Netzwerk, das Sie in einer OCI-Region einrichten. Wie herkömmliche Data Center-Netzwerke erhalten Sie von VCNs die Kontrolle über Ihre Netzwerkumgebung. Ein VCN kann mehrere nicht überschneidende CIDR-Blöcke aufweisen, die Sie nach dem Erstellen des VCN ändern können. Sie können ein VCN in Subnetze segmentieren, die sich auf eine Region oder eine Availability-Domain beschränken. Jedes Subnetz besteht aus einem Bereich zusammenhängender Adressen, die sich nicht mit anderen Subnetzen im VCN überschneiden. Sie können die Größe eines Subnetzes nach der Erstellung ändern. Ein Subnetz kann öffentlich oder privat sein.
Empfehlungen
Ihre Anforderungen können abweichen.
- Automatisieren Sie wiederholbare Inferenzpipelines mit Data Science-Jobs und -Zeitplänen.
- Verwenden Sie Data Science Deployment- und Serving-Tools, um Skalierung, Betriebsüberwachung und Reproduzierbarkeit zu unterstützen.
- Überwachen Sie Workloads für maschinelles Lernen in der Produktion auf Betriebszustand, Datendrift und Modellabweichung.
- Stellen Sie eine klare betriebliche Verantwortung zwischen Data Engineering- und Data Science-Teams her.
Überlegungen
- Implementieren Sie OCI Identity and Access Management- und Role-Based Access Control-(RBAC-)Policys für beide Plattformen.
- Überwachen Sie Produktions-Workloads auf Betriebszustand, Datendrift und Modellabweichung.
- Verwenden Sie einen skalierbaren gesteuerten Speicher für langfristige Datenaufbewahrung und -analysen.