Remitir solicitudes de modelo en regiones de OCI

Cree un perfil de enrutamiento para un modelo a demanda y, a continuación, utilice el OCID del perfil de enrutamiento en las solicitudes de finalización y respuesta de chat de las aplicaciones Python.

Descripción general

Un perfil de enrutamiento especifica un modelo a demanda soportado y una o más regiones de OCI de destino en el mismo dominio donde ese modelo está disponible. Las aplicaciones envían solicitudes a un punto final de API de OCI Generative AI regional y transfieren el OCID del perfil de enrutamiento como el valor model. La IA generativa atiende cada solicitud de una región elegible en el perfil.

Utilice un perfil cuando las aplicaciones necesiten el mismo modelo y un juego aprobado de regiones de servicio. Puede actualizar la configuración del perfil en OCI en lugar de mantener una lista de regiones en cada aplicación. Un perfil con varias regiones de destino no implica un enrutamiento de asignación en rueda ni una prioridad de región fija.

En este tutorial, dos aplicaciones Python llaman al punto final de la API de Chicago. Uno utiliza las finalizaciones de chat y el otro utiliza las respuestas. Ambos utilizan un perfil de enrutamiento para openai.gpt-oss-120b que permite servir desde Chicago, Frankfurt u Osaka.
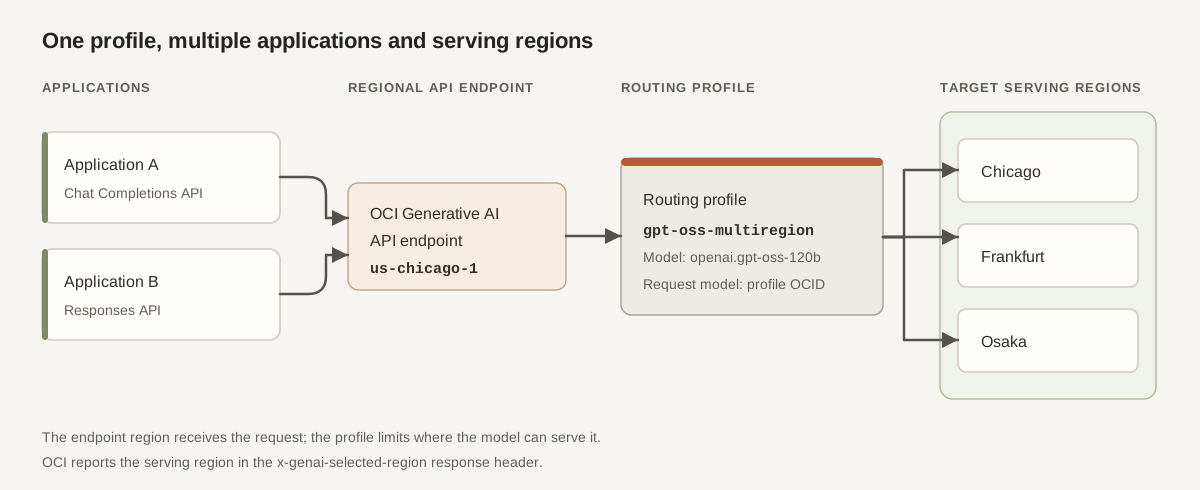
Dos aplicaciones envían solicitudes de finalización y respuesta de chat al punto final de la API de Chicago OCI Generative AI. Ambos transfieren el mismo OCID de perfil de direccionamiento que el modelo. El perfil selecciona el modelo bajo demanda openai.gpt-oss-120b y permite servir desde Chicago, Frankfurt u Osaka.

Cree un perfil, instale el SDK de Python OpenAI, ejecute ambos ejemplos y compruebe la cabecera de respuesta x-genai-selected-region para ver qué región ha servido cada solicitud.

Nota

Esta versión solo soporta perfiles de enrutamiento para modelos bajo demanda. Puede utilizar un perfil con ambas API solo si su modelo seleccionado soporta la API de finalizaciones de chat y respuestas de OCI.

Antes de empezar

Para completar este tutorial, necesita:

  • Acceso a OCI Generative AI, permiso para crear un perfil de enrutamiento en el compartimento seleccionado y permiso para utilizarlo para la inferencia. Consulte API-Level Permissions for Routing Profiles.
  • Un modelo a demanda soportado disponible para su arrendamiento en las regiones de destino. Para ejecutar ambos ejemplos con un perfil, seleccione un modelo que admita ambas API. Consulte Modelos de IA generativa por región.
  • Una clave de API de OCI Generative AI autorizada para solicitudes a través del punto final de Chicago. No coloque la clave en el código fuente ni la confirme en un repositorio.
  • Python 3.11 o posterior y uv instalados en el subsistema macOS, Linux o Windows para Linux. Los comandos de este tutorial utilizan un shell compatible con Bash.

En los ejemplos se utiliza el SDK de Python OpenAI con el punto final compatible con OpenAI de OCI. No requieren el SDK de Python de OCI ni la CLI de OCI.

1. Crear un perfil de enrutamiento

Este ejemplo crea un perfil en el medio oeste de EE. UU. (Chicago). Sus regiones de destino pueden diferir de la región de punto final de API, pero deben estar disponibles para el modelo seleccionado y en el mismo dominio. Si un modelo o región de este ejemplo no está disponible para su arrendamiento, seleccione una opción disponible.

  1. Conéctese a la consola de OCI y seleccione Midwest de EE. UU. (Chicago) (us-chicago-1) en el selector de región.
  2. Abra Análisis e IA, seleccione IA generativa y, a continuación, seleccione Perfiles de enrutamiento.
    Para obtener más información sobre la página de lista, consulte Listado de perfiles de enrutamiento.
  3. Seleccione Crear perfil de enrutamiento.
  4. Introduzca un nombre, como gpt-oss-multiregion, seleccione un compartimento y, opcionalmente, agregue una descripción o etiquetas.
  5. En Configuración, seleccione openai.gpt-oss-120b en Selección de modelo.

    OpenAI gpt-oss-120b está disponible bajo demanda en Chicago, Fráncfort y Osaka y soporta las API de finalizaciones de chat y respuestas de OCI.

    Para seleccionar un modelo, consulte Modelos por región para conocer la disponibilidad bajo demanda en las regiones de destino y Modelos y regiones para puntos finales compatibles con OpenAI de OCI para conocer los modelos soportados por las API que planea llamar.

  6. En Regiones de OCI de destino, seleccione las regiones desde las que se puede servir el modelo.

    Para este ejemplo, seleccione las siguientes regiones:

    • Medio Oeste de Estados Unidos (Chicago): us-chicago-1
    • Centro de Alemania (Fráncfort): eu-frankfurt-1
    • Centro de Japón (Osaka): ap-osaka-1
  7. Seleccione Crear.
  8. Abra la página de detalles del perfil. Confirme que su estado es Activo y revise el modelo seleccionado y las regiones de OCI de destino. Copie el OCID completo del perfil.
    Para obtener más información sobre esta página, consulte Obtención de detalles de un perfil de enrutamiento. Utilice el OCID como valor model en ambos scripts.
El perfil está listo para las solicitudes de inferencia bajo demanda admitidas.

2. Preparación del entorno de Python

  1. En un directorio de trabajo, cree y active un entorno virtual e instale el SDK de Python OpenAI:
    uv venv --python 3.11 .venv
    source .venv/bin/activate
    uv pip install --upgrade openai

    Si ya existe .venv, actívelo y ejecute el comando de instalación. El SDK de Python de OCI no es necesario para estos ejemplos.

  2. Defina la región de punto final de API y el OCID del perfil de direccionamiento para el shell actual:
    export OCI_REGION=us-chicago-1
    export OCI_ROUTING_PROFILE_OCID='<your-routing-profile-ocid>'

    Sustituya <your-routing-profile-ocid> por el OCID completo que se muestra en el perfil de direccionamiento. OCI_REGION determina qué punto final de API regional recibe la solicitud. El perfil de enrutamiento especifica las regiones en las que el modelo puede servirlo.

  3. Tenga preparada una clave de API de OCI Generative AI.
    Cada script solicita la clave sin mostrarla si OCI_GENAI_API_KEY no está definido por un gestor de secretos u otro mecanismo seguro. No pegue la clave en ninguno de los scripts.

3. Ejemplo de ejecución de finalizaciones de chat

  1. Guarde el siguiente código como routing-chat-completion.py en el directorio de trabajo:
    """Chat with an OCI Generative AI routing profile."""
    
    from __future__ import annotations
    
    import os
    from getpass import getpass
    
    from openai import OpenAI
    
    
    def main() -> None:
        region = os.environ.get("OCI_REGION", "us-chicago-1")
        profile_ocid = os.environ["OCI_ROUTING_PROFILE_OCID"]
        api_key = os.environ.get("OCI_GENAI_API_KEY") or getpass(
            "OCI Generative AI API key: "
        )
        client = OpenAI(
            base_url=f"https://inference.generativeai.{region}.oci.oraclecloud.com/openai/v1",
            api_key=api_key,
        )
    
        messages: list[dict[str, str]] = []
        print("Chat Completions with a routing profile. Type 'exit' to stop.\n")
    
        while True:
            try:
                prompt = input("You: ").strip()
            except (EOFError, KeyboardInterrupt):
                print("\nGoodbye!")
                break
    
            if prompt.lower() in {"exit", "quit"}:
                print("Goodbye!")
                break
            if not prompt:
                continue
    
            messages.append({"role": "user", "content": prompt})
            answer_parts: list[str] = []
    
            try:
                with client.chat.completions.create(
                    model=profile_ocid,
                    messages=messages,
                    stream=True,
                ) as stream:
                    selected_region = stream.response.headers.get(
                        "x-genai-selected-region"
                    )
                    print(f"Served from OCI region: {selected_region or 'not reported'}")
                    print("Assistant: ", end="", flush=True)
    
                    for chunk in stream:
                        if not chunk.choices:
                            continue
                        content = chunk.choices[0].delta.content
                        if content:
                            answer_parts.append(content)
                            print(content, end="", flush=True)
            except Exception as error:
                messages.pop()
                print(f"\nRequest failed: {error}\n")
                continue
    
            answer = "".join(answer_parts)
            if answer:
                messages.append({"role": "assistant", "content": answer})
            else:
                messages.pop()
            print("\n")
    
    
    if __name__ == "__main__":
        main()
  2. Con el entorno virtual activado, ejecute el script:
    python routing-chat-completion.py
  3. En You:, introduzca una petición de datos. Después de la respuesta, introduzca un seguimiento o exit para parar.
    El script transmite texto desde chunk.choices[0].delta.content y conserva el historial de conversaciones localmente para el proceso actual.

4. Ejemplo de ejecución de respuestas

Utilice este ejemplo solo si el modelo seleccionado en el perfil de enrutamiento soporta la API de respuestas. Utiliza el mismo OCID de perfil y punto final regional que el ejemplo de finalización de chat.

  1. Guarde el siguiente código como routing-responses-api.py en el directorio de trabajo:
    """Use the Responses API with an OCI Generative AI routing profile."""
    
    from __future__ import annotations
    
    import os
    from getpass import getpass
    
    from openai import OpenAI
    
    
    def main() -> None:
        region = os.environ.get("OCI_REGION", "us-chicago-1")
        profile_ocid = os.environ["OCI_ROUTING_PROFILE_OCID"]
        api_key = os.environ.get("OCI_GENAI_API_KEY") or getpass(
            "OCI Generative AI API key: "
        )
        client = OpenAI(
            base_url=f"https://inference.generativeai.{region}.oci.oraclecloud.com/openai/v1",
            api_key=api_key,
        )
    
        messages: list[dict[str, str]] = []
        print("Responses with a routing profile. Type 'exit' to stop.\n")
    
        while True:
            try:
                prompt = input("You: ").strip()
            except (EOFError, KeyboardInterrupt):
                print("\nGoodbye!")
                break
    
            if prompt.lower() in {"exit", "quit"}:
                print("Goodbye!")
                break
            if not prompt:
                continue
    
            messages.append({"role": "user", "content": prompt})
            answer_parts: list[str] = []
    
            try:
                with client.responses.create(
                    model=profile_ocid,
                    input=messages,
                    stream=True,
                ) as stream:
                    selected_region = stream.response.headers.get(
                        "x-genai-selected-region"
                    )
                    print(f"Served from OCI region: {selected_region or 'not reported'}")
                    print("Assistant: ", end="", flush=True)
    
                    for event in stream:
                        if event.type == "response.output_text.delta":
                            answer_parts.append(event.delta)
                            print(event.delta, end="", flush=True)
            except Exception as error:
                messages.pop()
                print(f"\nRequest failed: {error}\n")
                continue
    
            answer = "".join(answer_parts)
            if answer:
                messages.append({"role": "assistant", "content": answer})
            else:
                messages.pop()
            print("\n")
    
    
    if __name__ == "__main__":
        main()
  2. Con el entorno virtual activado, ejecute el script:
    python routing-responses-api.py
  3. Introduzca una petición de datos y un seguimiento y, a continuación, introduzca exit para parar.
    El script transmite eventos response.output_text.delta. Mantiene el historial de conversaciones localmente y lo vuelve a enviar en cada turno; no utiliza previous_response_id ni una conversación gestionada por el servidor. Se ignoran otros tipos de eventos.

Verificación del resultado y resolución de problemas

En cualquier script, introduzca una petición de datos como Explain model routing in two sentences. La respuesta del asistente debe transmitirse al terminal. Si OCI devuelve x-genai-selected-region, el script muestra la región que ha servido la solicitud. Puede ser diferente de Chicago, la región del punto final de API, pero debe ser una de las regiones de destino del perfil.

Ambos ejemplos omiten peticiones de datos vacías. Introduzca exit o quit, pulse Ctrl+C o envíe el final de la entrada en el indicador para que se detenga. El historial solo se conserva mientras se ejecuta el script.

SíntomaQué comprobar
Error de autenticación o autorización Compruebe la clave de API de OCI Generative AI, su región y acceso, el permiso de lectura de perfil de enrutamiento y el permiso para la operación de inferencia.
No se ha encontrado el perfil o el valor de modelo no es válido Utilice el OCID de perfil completo en OCI_ROUTING_PROFILE_OCID. Confirme que el perfil está activo y que OCI_REGION apunta a la región de punto final a la que desea llamar.
API o parámetro de solicitud no soportados Confirme que el modelo seleccionado del perfil admite la API que utiliza el script. Este tutorial no necesita un parámetro reasoning específico del modelo.
No se puede servir la solicitud Compruebe que el modelo seleccionado esté disponible en las regiones de destino del perfil y revise el error devuelto.
La región de servicio es not reported El script no ha encontrado x-genai-selected-region en las cabeceras de respuesta. Compruebe la respuesta y el comportamiento del servicio; no infiera la región de servicio solo desde el punto final de API.

Los ejemplos muestran solicitudes basadas en perfiles y texto de transmisión. No definen ni verifican una prioridad de enrutamiento, un algoritmo de equilibrio de carga o una política de failover.