Acerca de Parallel Replicat
Parallel Replicat es otra variante de Replicat que aplica transacciones en paralelo para mejorar el rendimiento.
Tiene en cuenta las dependencias entre transacciones, de forma similar a Integrated Replicat. El cálculo de dependencias, el paralelismo de la asignación y la aplicación se realizan fuera de la base de datos para que se puedan descargar a otro servidor. La integridad de la transacción se mantiene en este proceso. Además, el Replicat paralelo soporta la aplicación paralela de transacciones grandes dividiendo una transacción grande en fragmentos y aplicándolas en paralelo.
Parallel Replicat soporta los dos modos siguientes: integrado y no integrado. Solo Oracle AI Database soporta la replicación paralela en modo integrado.
Para utilizar el Replicat paralelo, debe asegurarse de que tiene los siguientes valores, que también son los valores por defecto:
-
Metadatos en la pista (lo que significa que no puede utilizar Replicat paralelo si las pistas tienen un formato inferior a 12.1).
-
Debe tener columnas de programación en el archivo de pista.
-
Debe utilizar
UPDATERCORDFORMAT COMPACT.
Con Replicat paralelo integrado, Replicat envía los LCR al servidor entrante, que aplica los datos a la base de datos de destino, y en Replicat paralelo normal, Oracle GoldenGate aplica el LCR como sentencia SQL directamente a la base de datos, de forma similar a cómo funcionan los otros Replicats no integrados. Nota: Para obtener el mejor rendimiento para una carga de trabajo OLTP, se recomienda el Replicat paralelo en modo no integrado.
Los componentes del Replicat paralelo son:
-
Los mapeadores operan en paralelo para leer la pista, asignar registros de pista, convertir los registros asignados al formato LCR de Replicat integrado y enviar los LCR a la fusión para su posterior procesamiento. Mientras que un asignador asigna un conjunto de transacciones, el siguiente asignador asigna el siguiente conjunto de transacciones. La información de pista se divide y el archivo de pista no se toca porque ordena la información de pista en orden.
-
Los procesos maestros tienen dos threads, Collater y Scheduler. El recopilador recibe las transacciones asignadas de los asignadores y las vuelve a poner en orden de seguimiento para el cálculo de dependencias. El programador calcula las dependencias entre transacciones, agrupa las transacciones en lotes independientes y envía los lotes a los aplicadores para que se apliquen a la base de datos de destino.
-
Los aplicadores reordenan los registros de un lote para la ejecución de la matriz. Aplica el lote a la base de datos de destino y realiza el manejo de errores. También realiza un seguimiento de las transacciones aplicadas en las tablas de puntos de control. Nota: Parallel Replicat necesita que se indexen todas las columnas de clave ajena.
Ventajas de Parallel Replicat
A continuación se muestran las ventajas del uso de Replicat paralelo:
-
La replicación paralela integrada permite particionar automáticamente cargas de trabajo pesadas entre procesos de aplicación paralela que aplican varias transacciones de forma simultánea, al tiempo que mantiene la integridad y la atomicidad de la transacción de origen. Se puede configurar un número mínimo y máximo de procesos de aplicación con los parámetros
PARALLELISMyMAX_PARALLELISM. Replicat agrega automáticamente servidores adicionales cuando la carga de trabajo aumenta y, a continuación, vuelve a ajustarse hacia abajo cuando la carga de trabajo se ilumina. -
La replicación paralela integrada requiere un trabajo mínimo para configurar. Todo el trabajo se configura en un archivo de parámetros de Replicat, sin configurar particiones de rango.
-
La transmisión de aplicación de alto rendimiento está activada para Replicat paralelo integrado mediante una interfaz de programación de aplicaciones (API) ligera entre Replicat y el servidor de entrada.
-
Las transacciones de barrera se coordinan mediante Replicat paralelo integrado entre varios procesos de aplicación de servidor.
-
Las operaciones DDL se procesan como transacciones directas que fuerzan una barrera a la espera de que se complete el procesamiento del servidor antes de la ejecución DDL.
-
Las actualizaciones de clave primaria duplicadas transitorias se gestionan mediante un Replicat paralelo integrado sin problemas.
-
Parallel Replicat puede dividir una única transacción grande en fragmentos más pequeños y aplicar esos fragmentos en paralelo. Consulte SPLIT_TRANS_RECS para obtener más información.
Arquitectura de replicación en paralelo
Los procesos de replicación en paralelo aprovechan la funcionalidad de procesamiento de aplicación que está disponible en Oracle AI Database en modo integrado. En una única configuración de Replicat, varios procesos secundarios de servidor denominados servidores de aplicación aplican transacciones en paralelo al tiempo que conservan la atomicidad de transacción original.
En el siguiente diagrama de arquitectura se muestra el flujo de registros de cambios a través de los distintos procesos de una replicación paralela de los archivos de pista a la base de datos de destino, para un Replicat paralelo no integrado.
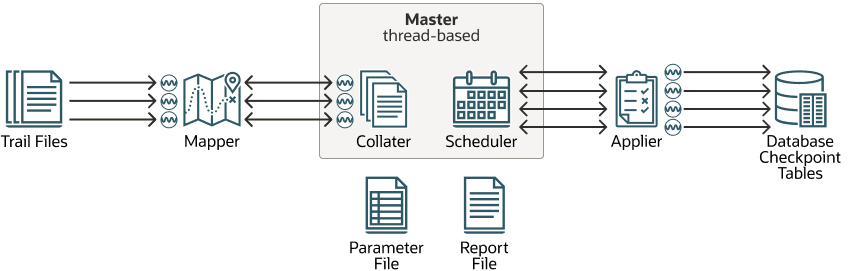
A continuación se muestra la descripción del diagrama de arquitectura indicado anteriormente:
-
Los asignadores leen el archivo de pista y asignan registros, reenvían los registros asignados al maestro. Los lotes se envían a los aplicadores, donde se aplican a la base de datos de destino.
-
El proceso maestro consta de dos threads independientes, Collater y Scheduler. El Collater es responsable de gestionar y comunicarse con los Mappers, además de recibir las transacciones asignadas y reordenarlas en un único flujo en orden. El programador es responsable de gestionar y comunicarse con los aplicadores, junto con la lectura de transacciones de la entidad de cobro, el procesamiento por lotes y la programación a los aplicadores.
-
El controlador del programador se comunica con el programador para recopilar la información necesaria (como la posición de límite inferior actual). El controlador del programador es necesario para el modo de CDB para Oracle AI Database porque es responsable de agregar información perteneciente a las distintas PDB de destino e informar de una imagen unificada. El controlador del programador se crea para simplificar y uniformizar la implementación, incluso cuando no está en modo CDB. Cada proceso lee el archivo de parámetros y comparte un único archivo de punto de control.
Parámetros básicos para Parallel Replicat
En la siguiente tabla se muestran los parámetros básicos de Replicat en paralelo y su descripción.
| Parámetro | Descripción |
|---|---|
|
|
Configura el número de asignadores. Controla el número de threads utilizados para leer el archivo de pista. El valor mínimo es 1, el valor máximo es 100 y el valor por defecto es 2. |
|
|
Permite configurar el número de aplicadores. Esto controla el número de conexiones en la base de datos de destino que se utilizan para aplicar los cambios. El valor por defecto es cuatro. |
|
|
El paralelismo de aplicación se ajusta automáticamente. Puede definir un valor mínimo y máximo para definir los rangos en los que Replicat ajusta automáticamente su paralelismo. No hay valores por defecto. No utilizar con |
|
|
Especifica que las transacciones grandes se deben dividir en partes de tamaño especificado y aplicar en paralelo. Las dependencias entre piezas siguen siendo respetadas. Está desactivado por defecto. |
|
|
Activa el modo de serialización FULL de confirmación, que fuerza la confirmación de transacciones en orden de pista. |
|
Parámetros Avanzados |
|
|
|
Controla el adelanto que tiene el programador al realizar transacciones en batch. El valor por defecto es 10000. |
|
|
Controla el tamaño de una transacción para que el Replicat paralelo la considere grande. Cuando el Replicat paralelo encuentra una transacción de mayor tamaño que este, la serializa, lo que reduce el rendimiento. Sin embargo, el aumento de este valor también aumentará la cantidad de memoria consumida por el Replicat paralelo. |
Archivo de parámetros de ejemplo
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;