Acheminer les demandes de modèle entre les régions OCI
Créez un profil d'acheminement pour un modèle sur demande, puis utilisez l'OCID du profil d'acheminement dans les demandes d'achèvement et de réponse de clavardage des applications Python.
Aperçu
Un profil d'acheminement spécifie un modèle sur demande pris en charge et une ou plusieurs régions OCI cibles dans le même domaine où ce modèle est disponible. Les applications envoient des demandes à un point d'extrémité régional de l'API du service d'intelligence artificielle générative pour OCI et transmettent l'OCID du profil d'acheminement en tant que valeur model. L'intelligence artificielle générative répond à chaque demande d'une région admissible dans le profil.
Utilisez un profil lorsque les applications ont besoin du même modèle et du même jeu approuvé de régions de desserte. Vous pouvez mettre à jour la configuration du profil dans OCI au lieu de tenir à jour une liste de régions dans chaque application. Un profil comportant plusieurs régions cibles n'implique pas un routage cyclique ou une priorité de région fixe.
Dans ce tutoriel, deux applications Python appellent le point d'extrémité de l'API de Chicago. L'un utilise les achèvements de clavardage et l'autre utilise les réponses. Les deux utilisent un profil d'acheminement pour openai.gpt-oss-120b qui permet de servir à partir de Chicago, Francfort ou Osaka.
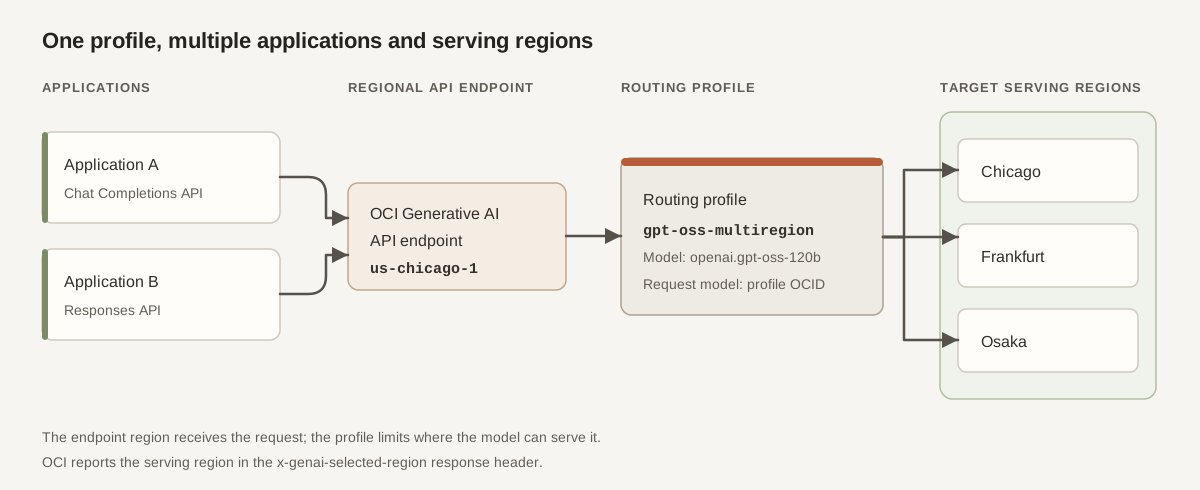
Vous créez un profil, installez la trousse SDK Python OpenAI, exécutez les deux exemples et vérifiez l'en-tête de réponse x-genai-selected-region pour voir quelle région a servi chaque demande.
Vous ne pouvez utiliser un profil avec les deux API que si son modèle sélectionné prend en charge à la fois l'API de fin d'exécution de clavardage OCI et l'API de réponses OCI. Les deux API sont disponibles au moyen de profils d'acheminement dans des régions sans traitement de modèle local. Lors de l'appel à partir d'une de ces régions, utilisez le point d'extrémité d'API de cette région et sélectionnez les régions cibles où le modèle est disponible.
Avant de commencer
Pour terminer ce tutoriel, vous devez :
- Accès au service d'intelligence artificielle générative pour OCI, autorisation de créer un profil d'acheminement dans le compartiment sélectionné et autorisation de l'utiliser pour l'inférence. Voir Autorisations au niveau de l'API pour les profils d'acheminement.
- Modèle sur demande pris en charge disponible pour votre location dans les régions cibles. Pour exécuter les deux exemples avec un profil, sélectionnez un modèle qui prend en charge les deux API. Voir Modèles d'IA générative par région.
- Une clé d'API du service d'intelligence artificielle générative pour OCI autorisée pour les demandes au moyen du point d'extrémité de Chicago. Ne placez pas la clé dans le code source ou ne la validez pas dans un référentiel.
- Python 3.11 ou version ultérieure, et
uvinstallés sur macOS, Linux ou Windows Subsystem pour Linux. Les commandes de ce tutoriel utilisent un interpréteur de commandes compatible avec Bash.
Les exemples utilisent la trousse SDK Python OpenAI avec le point d'extrémité compatible OpenAI d'OCI. Ils ne nécessitent pas la trousse SDK Python pour OCI ou l'interface de ligne de commande pour OCI.
1. Créer un profil d'acheminement
Cet exemple crée un profil dans US Midwest (Chicago). Ses régions cibles peuvent différer de la région du point d'extrémité de l'API, mais elles doivent être disponibles pour le modèle sélectionné et dans le même domaine. Si un modèle ou une région dans cet exemple n'est pas disponible pour votre location, sélectionnez une option disponible.
2. Préparer l'environnement Python
3. Exécuter l'exemple d'achèvement de clavardage
4. Exemple d'exécution des réponses
Utilisez cet exemple uniquement si le modèle sélectionné dans le profil d'acheminement prend en charge l'API Réponses. Il utilise le même OCID de profil et le même point d'extrémité régional que l'exemple d'achèvement de clavardage.
Vérifier le résultat et le dépannage
Dans l'un ou l'autre des scripts, entrez une invite telle que Explain model routing in two sentences. La réponse de l'assistant doit être transmise au terminal. Si OCI retourne x-genai-selected-region, le script affiche la région qui a servi la demande. Il peut différer de Chicago, la région du point d'extrémité de l'API, mais doit être l'une des régions cibles du profil.
Les deux exemples ignorent les invites vides. Entrez exit ou quit, appuyez sur Ctrl+C ou envoyez la fin de l'entrée à l'invite pour vous arrêter. L'historique n'est conservé que pendant l'exécution du script.
| Symptôme | Que vérifier |
|---|---|
| Erreur d'authentification ou d'autorisation | Vérifiez la clé d'API du service d'intelligence artificielle générative pour OCI, sa région et son accès, l'autorisation de lecture du profil d'acheminement et l'autorisation pour l'opération d'inférence. |
| Profil introuvable ou valeur de modèle non valide | Utilisez l'OCID de profil complet dans OCI_ROUTING_PROFILE_OCID. Vérifiez que le profil est actif et que OCI_REGION pointe vers la région de point d'extrémité que vous voulez appeler. |
| API ou paramètre de demande non pris en charge | Vérifiez que le modèle sélectionné du profil prend en charge l'API utilisée par le script. Ce tutoriel ne nécessite pas de paramètre reasoning propre au modèle. |
| La demande ne peut pas être servie | Vérifiez que le modèle sélectionné est disponible dans les régions cibles du profil et vérifiez l'erreur retournée. |
La région du service est not reported |
Le script n'a pas trouvé x-genai-selected-region dans les en-têtes de réponse. Vérifiez la réponse et le comportement du service; ne déduisez pas la région de service uniquement à partir du point d'extrémité de l'API. |
Les exemples montrent les demandes basées sur un profil et la diffusion de texte en continu. Ils ne définissent ni ne vérifient pas de priorité de routage, d'algorithme d'équilibrage de charge ou de politique de basculement.