A propos de la réplication parallèle
Le processus Replicat parallèle est une autre variante du processus Replicat qui applique des transactions en parallèle pour améliorer les performances.
Elle tient compte des dépendances entre les transactions, comme la réplication intégrée. Le calcul des dépendances, le parallélisme du mapping et de l'application des modifications sont effectués en dehors de la base de données et peuvent donc être déchargés vers un autre serveur. L'intégrité des transactions est maintenue dans ce processus. En outre, le processus Replicat parallèle prend en charge l'application parallèle de transactions volumineuses en fractionnant une transaction volumineuse en blocs et en l'appliquant en parallèle.
Parallel Replicat prend en charge les deux modes suivants : Intégré et Non intégré. Seul Oracle AI Database prend en charge la réplication parallèle en mode intégré.
Pour utiliser le processus Replicat parallèle, vous devez vous assurer que vous disposez des valeurs suivantes, qui sont également les valeurs par défaut :
-
Métadonnées dans la trace (ce qui signifie que vous ne pouvez pas utiliser le processus Replicat parallèle si les traces sont formatées en dessous de la version 12.1).
-
Vous devez avoir des colonnes de programmation dans votre fichier trace.
-
Vous devez utiliser
UPDATERCORDFORMAT COMPACT.
Avec le processus Replicat parallèle intégré, le processus Replicat envoie les LCR au serveur entrant, qui applique les données à la base de données cible, et dans le processus Replicat parallèle standard, Oracle GoldenGate applique le LCR en tant qu'instruction SQL directement à la base de données, de la même manière que les autres processus Replicat non intégrés. Remarque : pour des performances optimales pour une charge globale OLTP, la réplication parallèle en mode non intégré est recommandée.
Les composants du processus Replicat parallèle sont les suivants :
-
Les mappeurs fonctionnent en parallèle pour lire la trace, mapper les enregistrements de trace, convertir les enregistrements mappés au format LCR de réplication intégrée et envoyer les LCR à la fusion pour traitement ultérieur. Alors qu'un mappeur mappe un ensemble de transactions, le mappeur suivant mappe l'ensemble de transactions suivant. Les informations de trace sont fractionnées et le fichier trace n'est pas modifié car il ordonne les informations de trace dans l'ordre.
-
Les processus maîtres ont deux threads, Collater et Scheduler. Le programme de collage reçoit les transactions mappées des mappeurs et les remet dans l'ordre de trace pour le calcul des dépendances. Le planificateur calcule les dépendances entre les transactions, regroupe les transactions en lots indépendants et envoie les lots aux valeurs d'application à appliquer à la base de données cible.
-
Les appliers réorganisent les enregistrements d'un lot pour l'exécution de la table externe. Il applique le lot à la base de données cible et traite les erreurs. Il assure également le suivi des transactions appliquées dans les tables de points de reprise. Remarque : le processus Replicat parallèle exige que toutes les colonnes de clé étrangère soient indexées.
Avantages de la réplication parallèle
Les avantages de la réplication parallèle sont les suivants :
-
Integrated Parallel Replicat permet de partitionner automatiquement les charges globales lourdes entre les processus d'application des modifications parallèles qui appliquent plusieurs transactions simultanément, tout en préservant l'intégrité et l'atomicité de la transaction source. Vous pouvez configurer un nombre minimal et un nombre maximal de processus d'application des modifications avec les paramètres
PARALLELISMetMAX_PARALLELISM. Le processus Replicat ajoute automatiquement des serveurs supplémentaires lorsque la charge globale augmente, puis s'ajuste à nouveau à la baisse lorsque la charge globale s'allume. -
La réplication parallèle intégrée nécessite un minimum de travail à configurer. Tout le travail est configuré dans un fichier de paramètres Replicat, sans configuration de partitions de plage.
-
La transmission en continu des applications hautes performances est activée pour le processus Replicat parallèle intégré au moyen d'une interface de programmation d'application (API) légère entre le processus Replicat et le serveur entrant.
-
Les transactions de barrière sont coordonnées par une réplication parallèle intégrée entre plusieurs processus d'application des modifications de serveur.
-
Les opérations LDD sont traitées en tant que transactions directes qui forcent une barrière en attendant que le traitement du serveur se termine avant l'exécution du script LDD.
-
Les mises à jour transitoires de clés primaires en double sont gérées de manière transparente par le processus Replicat parallèle intégré.
-
Parallel Replicat peut diviser une seule transaction volumineuse en blocs plus petits et appliquer ces blocs en parallèle. Pour plus d'informations, reportez-vous à SPLIT_TRANS_RECS.
Architecture de réplication parallèle
Les processus de réplication parallèle exploitent la fonctionnalité de traitement d'application des modifications disponible dans Oracle AI Database en mode intégré. Dans une seule configuration de réplication, plusieurs processus enfant du serveur entrant, appelés serveurs d'application, appliquent des transactions en parallèle touten conservant l'atomicité de la transaction d'origine.
Le schéma d'architecture suivant illustre le flux des enregistrements de modification via les différents processus d'une réplication parallèle, des fichiers trace à la base de données cible, pour une réplication parallèle non intégrée.
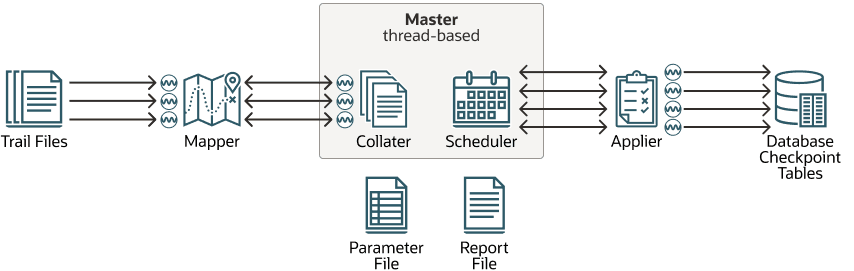
La description du schéma d'architecture donnée ci-dessus est la suivante :
-
Les mappeurs lisent le fichier trace et mappent les enregistrements, transmettent les enregistrements mappés au maître. Les lots sont envoyés aux applicateurs où ils sont appliqués à la base de données cible.
-
Le processus maître se compose de deux threads distincts, Collater et Scheduler. Le Collater est responsable de la gestion et de la communication avec les Mappeurs, ainsi que de la réception des transactions mappées et de leur réorganisation en un seul flux dans l'ordre. Le planificateur est responsable de la gestion et de la communication avec les fournisseurs, ainsi que de la lecture des transactions à partir du programme de collage, de leur mise en lot et de leur planification auprès des fournisseurs.
-
Le contrôleur du planificateur communique avec le planificateur pour collecter toutes les informations nécessaires (par exemple, la position actuelle du filigrane bas). Le contrôleur du planificateur est requis pour le mode de base de données Conteneur pour Oracle AI Database car il est responsable de l'agrégation des informations relatives aux différentes bases de données pluggables cible et de la génération d'une image unifiée. Le contrôleur Scheduler est créé pour simplifier et uniformiser l'implémentation, même lorsqu'il n'est pas en mode CDB. Chaque processus lit le fichier de paramètres et partage un seul fichier de point de reprise.
Paramètres de base pour la réplication parallèle
Le tableau suivant répertorie les paramètres de base du processus Replicat parallèle et leur description.
| Paramètre | Description |
|---|---|
|
|
Configure le nombre de mappeurs. Contrôle le nombre de threads utilisés pour lire le fichier trace. La valeur minimale est 1, la valeur maximale est 100 et la valeur par défaut est 2. |
|
|
Configure le nombre d'applicateurs. Cela contrôle le nombre de connexions dans la base de données cible utilisée pour appliquer les modifications. Par défaut, la valeur est quatre. |
|
|
Le parallélisme Apply est réglé automatiquement. Vous pouvez définir une valeur minimale et une valeur maximale pour définir les plages dans lesquelles le processus Replicat ajuste automatiquement son parallélisme. Il n'existe aucune valeur par défaut. N'utilisez pas |
|
|
Indique que les transactions volumineuses doivent être divisées en morceaux de taille spécifiée et appliquées en parallèle. Les dépendances entre les pièces sont toujours respectées. Ce paramètre est désactivé par défaut. |
|
|
Active le mode de sérialisation commit FULL, qui force les transactions à être validées dans l'ordre de trace. |
|
Paramètres avancés |
|
|
|
Contrôle l'avenir du planificateur lors du traitement par lots des transactions. Valeur par défaut : 10 000. |
|
|
Contrôle la taille d'une transaction pour que le processus Replicat parallèle la considère comme volumineuse. Lorsque le processus Replicat parallèle rencontre une transaction supérieure à cette taille, il la sérialise, ce qui entraîne une diminution des performances. Toutefois, l'augmentation de cette valeur augmentera également la quantité de mémoire consommée par le processus Replicat parallèle. |
Exemple de fichier de paramètres
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;