Instrada richieste modello in tutte le aree OCI

Creare un profilo di instradamento per un modello su richiesta, quindi utilizzare l'OCID del profilo di instradamento nelle richieste di completamento chat e risposte dalle applicazioni Python.

Panoramica

Un profilo di instradamento specifica un modello su richiesta supportato e una o più aree OCI di destinazione nello stesso realm in cui tale modello è disponibile. Le applicazioni inviano richieste a un endpoint API OCI Generative AI regionale e passano l'OCID del profilo di instradamento come valore model. L'intelligenza artificiale generativa gestisce ogni richiesta da un'area idonea nel profilo.

Utilizzare un profilo quando le applicazioni richiedono lo stesso modello e lo stesso set approvato di aree di servizio. È possibile aggiornare la configurazione del profilo in OCI invece di gestire una lista di aree in ogni applicazione. Un profilo con più aree di destinazione non implica l'instradamento round-robin o una priorità area fissa.

In questo tutorial, due applicazioni Python chiamano l'endpoint API di Chicago. Uno utilizza Completamenti chat e l'altro utilizza Risposte. Entrambi utilizzano un profilo di instradamento per openai.gpt-oss-120b che consente di servire da Chicago, Francoforte o Osaka.
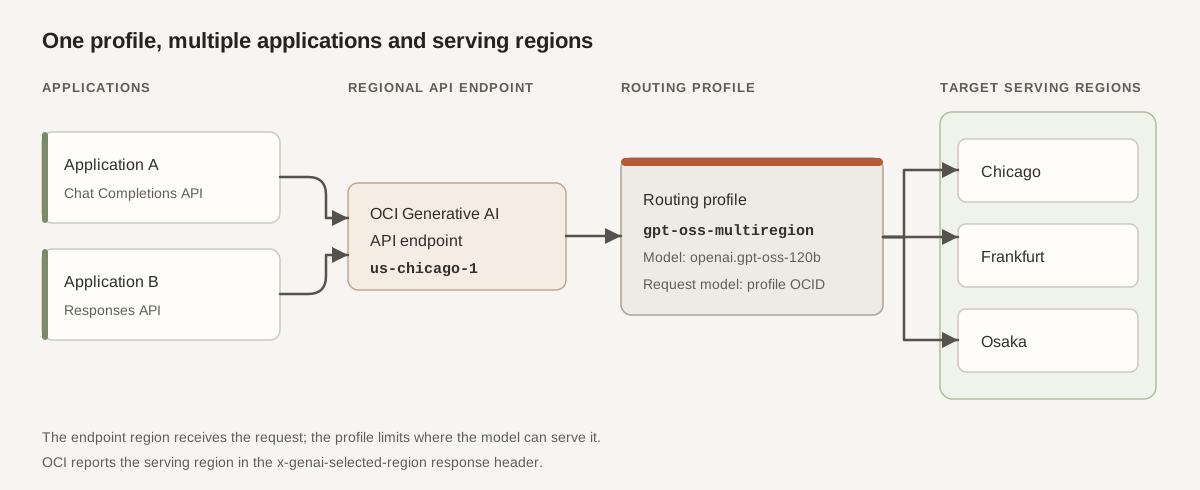
Due applicazioni inviano richieste di completamento chat e risposte all'endpoint API OCI Generative AI di Chicago. Entrambi passano lo stesso OCID del profilo di instradamento del modello. Il profilo seleziona il modello on-demand openai.gpt-oss-120b e consente di servire da Chicago, Francoforte o Osaka.

Si crea un profilo, si installa l'SDK Python OpenAI, si eseguono entrambi gli esempi e si controlla l'intestazione della risposta x-genai-selected-region per vedere quale area ha servito ogni richiesta.

Nota

È possibile utilizzare un profilo con entrambe le API solo se il modello selezionato supporta sia l'API Completamenti chat OCI che l'API Risposte OCI. Entrambe le API sono disponibili tramite profili di instradamento in aree senza elaborazione di modelli locali. Quando si esegue una chiamata da una di queste aree, utilizzare l'endpoint API di tale area e selezionare le aree di destinazione in cui è disponibile il modello.

Informazioni preliminari

Per completare questo tutorial, è necessario:

  • Accesso all'AI generativa OCI, autorizzazione a creare un profilo di instradamento nel compartimento selezionato e autorizzazione a utilizzarlo per l'inferenza. Vedere Autorizzazioni a livello di API per i profili di instradamento.
  • Modello su richiesta supportato disponibile per la tenancy nelle aree di destinazione. Per eseguire entrambi gli esempi con un unico profilo, selezionare un modello che supporti entrambe le API. Vedere Modelli di intelligenza artificiale generativa per area.
  • Una chiave API OCI Generative AI autorizzata per le richieste tramite l'endpoint di Chicago. Non inserire la chiave nel codice sorgente o eseguirne il commit in un repository.
  • Python 3.11 o versioni successive e uv installati su macOS, Linux o Windows Subsystem for Linux. I comandi in questa esercitazione utilizzano una shell compatibile con Bash.

Gli esempi utilizzano l'SDK Python OpenAI con l'endpoint compatibile con OCI OpenAI. Non richiedono l'SDK Python OCI o l'interfaccia CLI OCI.

1. Crea un profilo di instradamento

In questo esempio viene creato un profilo nel Midwest degli Stati Uniti (Chicago). Le aree di destinazione possono essere diverse dall'area dell'endpoint API, ma devono essere disponibili per il modello selezionato e nello stesso realm. Se un modello o un'area in questo esempio non è disponibile per la tenancy, selezionare un'opzione disponibile.

  1. Connettersi a OCI Console e selezionare US Midwest (Chicago) (us-chicago-1) dal selettore area.
  2. Aprire Analytics e AI, selezionare AI generativa e quindi Profili di instradamento.
    Per ulteriori informazioni sulla pagina di elenco, vedere Elenco dei profili di instradamento.
  3. Selezionare Crea profilo di instradamento.
  4. Immettere un nome, ad esempio gpt-oss-multiregion, selezionare un compartimento e, facoltativamente, aggiungere una descrizione o tag.
  5. In Configurazione selezionare openai.gpt-oss-120b da Selezione modello.

    OpenAI gpt-oss-120b è disponibile su richiesta a Chicago, Francoforte e Osaka e supporta sia l'API OCI Chat Completions che l'API OCI Responses.

    Per selezionare un modello, consulta i modelli per area per la disponibilità on-demand nelle aree di destinazione e i modelli e le aree per gli endpoint compatibili con OCI OpenAI per i modelli supportati dalle API che intendi chiamare.

  6. In Destina aree OCI, selezionare le aree da cui il modello può essere servito.

    Per questo esempio, selezionare le seguenti aree:

    • Midwest degli Stati Uniti (Chicago): us-chicago-1
    • Germania Centrale (Francoforte): eu-frankfurt-1
    • Giappone Centrale (Osaka): ap-osaka-1
  7. Selezionare Crea.
  8. Aprire la pagina dei dettagli del profilo. Verificare che il relativo stato sia Attivo ed esaminare il modello selezionato e le aree OCI di destinazione. Copia l'OCID completo del profilo.
    Per informazioni dettagliate su questa pagina, vedere Recupero dei dettagli di un profilo di instradamento. L'OCID viene utilizzato come valore model in entrambi gli script.
Il profilo è pronto per le richieste di inferenza su richiesta supportate.

2. Preparare l'ambiente Python

  1. In una directory di lavoro, creare e attivare un ambiente virtuale e installare OpenAI SDK Python:
    uv venv --python 3.11 .venv
    source .venv/bin/activate
    uv pip install --upgrade openai

    Se .venv esiste già, attivarlo ed eseguire il comando di installazione. L'SDK Python OCI non è necessario per questi esempi.

  2. Impostare l'area endpoint API e l'OCID del profilo di instradamento per la shell corrente:
    export OCI_REGION=us-chicago-1
    export OCI_ROUTING_PROFILE_OCID='<your-routing-profile-ocid>'

    Sostituire <your-routing-profile-ocid> con l'OCID completo mostrato nel profilo di instradamento. OCI_REGION determina l'endpoint API regionale che riceve la richiesta. Il profilo di instradamento specifica le aree in cui il modello può servirlo.

  3. Disporre di una chiave API OCI Generative AI.
    Ogni script richiede la chiave senza visualizzarla se OCI_GENAI_API_KEY non è impostato da un gestore di segreti o da un altro meccanismo sicuro. Non incollare la chiave in uno script.

3. Esempio di esecuzione dei completamenti chat

  1. Salvare il codice seguente come routing-chat-completion.py nella directory di lavoro:
    """Chat with an OCI Generative AI routing profile."""
    
    from __future__ import annotations
    
    import os
    from getpass import getpass
    
    from openai import OpenAI
    
    
    def main() -> None:
        region = os.environ.get("OCI_REGION", "us-chicago-1")
        profile_ocid = os.environ["OCI_ROUTING_PROFILE_OCID"]
        api_key = os.environ.get("OCI_GENAI_API_KEY") or getpass(
            "OCI Generative AI API key: "
        )
        client = OpenAI(
            base_url=f"https://inference.generativeai.{region}.oci.oraclecloud.com/openai/v1",
            api_key=api_key,
        )
    
        messages: list[dict[str, str]] = []
        print("Chat Completions with a routing profile. Type 'exit' to stop.\n")
    
        while True:
            try:
                prompt = input("You: ").strip()
            except (EOFError, KeyboardInterrupt):
                print("\nGoodbye!")
                break
    
            if prompt.lower() in {"exit", "quit"}:
                print("Goodbye!")
                break
            if not prompt:
                continue
    
            messages.append({"role": "user", "content": prompt})
            answer_parts: list[str] = []
    
            try:
                with client.chat.completions.create(
                    model=profile_ocid,
                    messages=messages,
                    stream=True,
                ) as stream:
                    selected_region = stream.response.headers.get(
                        "x-genai-selected-region"
                    )
                    print(f"Served from OCI region: {selected_region or 'not reported'}")
                    print("Assistant: ", end="", flush=True)
    
                    for chunk in stream:
                        if not chunk.choices:
                            continue
                        content = chunk.choices[0].delta.content
                        if content:
                            answer_parts.append(content)
                            print(content, end="", flush=True)
            except Exception as error:
                messages.pop()
                print(f"\nRequest failed: {error}\n")
                continue
    
            answer = "".join(answer_parts)
            if answer:
                messages.append({"role": "assistant", "content": answer})
            else:
                messages.pop()
            print("\n")
    
    
    if __name__ == "__main__":
        main()
  2. Con l'ambiente virtuale attivato, eseguire lo script:
    python routing-chat-completion.py
  3. In You:, immettere un prompt. Dopo la risposta, immettere un follow-up o exit per interrompere.
    Lo script trasmette il testo da chunk.choices[0].delta.content e conserva localmente la cronologia delle conversazioni per il processo corrente.

4. Esempio di esecuzione delle risposte

Utilizzare questo esempio solo se il modello selezionato nel profilo di instradamento supporta l'API Risposte. Utilizza lo stesso OCID profilo e lo stesso endpoint regionale dell'esempio Completamenti chat.

  1. Salvare il codice seguente come routing-responses-api.py nella directory di lavoro:
    """Use the Responses API with an OCI Generative AI routing profile."""
    
    from __future__ import annotations
    
    import os
    from getpass import getpass
    
    from openai import OpenAI
    
    
    def main() -> None:
        region = os.environ.get("OCI_REGION", "us-chicago-1")
        profile_ocid = os.environ["OCI_ROUTING_PROFILE_OCID"]
        api_key = os.environ.get("OCI_GENAI_API_KEY") or getpass(
            "OCI Generative AI API key: "
        )
        client = OpenAI(
            base_url=f"https://inference.generativeai.{region}.oci.oraclecloud.com/openai/v1",
            api_key=api_key,
        )
    
        messages: list[dict[str, str]] = []
        print("Responses with a routing profile. Type 'exit' to stop.\n")
    
        while True:
            try:
                prompt = input("You: ").strip()
            except (EOFError, KeyboardInterrupt):
                print("\nGoodbye!")
                break
    
            if prompt.lower() in {"exit", "quit"}:
                print("Goodbye!")
                break
            if not prompt:
                continue
    
            messages.append({"role": "user", "content": prompt})
            answer_parts: list[str] = []
    
            try:
                with client.responses.create(
                    model=profile_ocid,
                    input=messages,
                    stream=True,
                ) as stream:
                    selected_region = stream.response.headers.get(
                        "x-genai-selected-region"
                    )
                    print(f"Served from OCI region: {selected_region or 'not reported'}")
                    print("Assistant: ", end="", flush=True)
    
                    for event in stream:
                        if event.type == "response.output_text.delta":
                            answer_parts.append(event.delta)
                            print(event.delta, end="", flush=True)
            except Exception as error:
                messages.pop()
                print(f"\nRequest failed: {error}\n")
                continue
    
            answer = "".join(answer_parts)
            if answer:
                messages.append({"role": "assistant", "content": answer})
            else:
                messages.pop()
            print("\n")
    
    
    if __name__ == "__main__":
        main()
  2. Con l'ambiente virtuale attivato, eseguire lo script:
    python routing-responses-api.py
  3. Immettere un prompt e un follow-up, quindi immettere exit per interrompere.
    Lo script esegue lo streaming degli eventi response.output_text.delta. Gestisce la cronologia delle conversazioni a livello locale e la reinvia a ogni turno; non utilizza previous_response_id o una conversazione gestita dal server. Altri tipi di evento vengono ignorati.

Verificare il risultato e risolvere i problemi

In uno script immettere un prompt come Explain model routing in two sentences. La risposta dell'assistente deve essere trasmessa al terminale. Se OCI restituisce x-genai-selected-region, lo script visualizza l'area che ha servito la richiesta. Può differire da Chicago, l'area dell'endpoint API, ma deve essere una delle aree di destinazione nel profilo.

Entrambi gli esempi saltano i prompt vuoti. Immettere exit o quit, premere Ctrl+C o inviare la fine dell'input al prompt per l'interruzione. La cronologia viene conservata solo durante l'esecuzione dello script.

SintomoCosa controllare
Errore di autenticazione o autorizzazione Controllare la chiave API OCI Generative AI, la relativa area e accesso, l'autorizzazione di lettura del profilo di instradamento e l'autorizzazione per l'operazione di inferenza.
Profilo non trovato o valore modello non valido Utilizzare l'OCID profilo completo in OCI_ROUTING_PROFILE_OCID. Verificare che il profilo sia attivo e che OCI_REGION punti all'area endpoint che si desidera chiamare.
API non supportata o parametro di richiesta Verificare che il modello selezionato del profilo supporti l'API utilizzata dallo script. Questa esercitazione non richiede un parametro reasoning specifico del modello.
Impossibile servire la richiesta Verificare che il modello selezionato sia disponibile nelle aree di destinazione del profilo ed esaminare l'errore restituito.
L'area di servizio è not reported Lo script non ha trovato x-genai-selected-region nelle intestazioni risposta. Controllare il funzionamento della risposta e del servizio. Non dedurre l'area di servizio solo dall'endpoint API.

Gli esempi mostrano le richieste basate sul profilo e il testo in streaming. Non definiscono o verificano una priorità di instradamento, un algoritmo di bilanciamento del carico o un criterio di failover.