Informazioni su Parallel Replicat
Replicat parallelo è un'altra variante di Replicat che applica le transazioni in parallelo per migliorare le prestazioni.
Inoltre, tiene conto delle dipendenze tra le transazioni, come Integrated Replicat. Il calcolo delle dipendenze, il parallelismo del mapping e dell'applicazione vengono eseguiti al di fuori del database, pertanto possono essere scaricati in un altro server. L'integrità della transazione viene mantenuta in questo processo. Inoltre, Replicat parallelo supporta l'applicazione parallela di transazioni di grandi dimensioni suddividendo una transazione di grandi dimensioni in blocchi e applicandoli in parallelo.
Parallel Replicat supporta le seguenti due modalità: Integrated e Non-integrated. Solo Oracle AI Database supporta Replicat parallelo in modalità integrata.
Per utilizzare Replicat parallelo, è necessario assicurarsi di disporre dei seguenti valori, che sono anche i valori predefiniti:
-
Metadati nel trail (il che significa che non è possibile utilizzare Replicat parallelo se i percorsi sono formattati al di sotto della 12.1).
-
È necessario disporre di colonne di schedulazione nel file trail.
-
È necessario utilizzare
UPDATERCORDFORMAT COMPACT.
Con Replicat parallelo integrato, Replicat invia gli LCR al server in entrata, che applica i dati al database di destinazione, e in Replicat parallelo regolare, Oracle GoldenGate applica l'LCR come istruzione SQL direttamente al database, in modo simile al funzionamento degli altri Replicat non integrati. Nota: per ottenere le migliori prestazioni per un carico di lavoro OLTP, si consiglia di eseguire il Replicat parallelo in modalità non integrata.
I componenti di Replicat parallelo sono:
-
I mapper operano in parallelo per leggere il trail, mappare i record trail, convertire i record mappati nel formato LCR Replicat integrato e inviare i record LCR all'unione per un'ulteriore elaborazione. Mentre un Mapper mappa un set di transazioni, il Mapper successivo mappa il set successivo di transazioni. Le informazioni del trail vengono divise e il file del trail non viene modificato perché ordina le informazioni del trail in ordine.
-
I processi principali hanno due thread, Collater e Scheduler. Il responsabile recupero crediti riceve le transazioni mappate dai mapper e le rimette nell'ordine trail per il calcolo delle dipendenze. Lo scheduler calcola le dipendenze tra le transazioni, raggruppa le transazioni in batch indipendenti e invia i batch agli applicatori da applicare al database di destinazione.
-
I moltiplicatori riordinano i record all'interno di un batch per l'esecuzione dell'array. Applica il batch al database di destinazione ed esegue la gestione degli errori. Tiene inoltre traccia delle transazioni applicate nelle tabelle dei checkpoint. Nota: Replicat parallelo richiede l'indicizzazione di qualsiasi colonna chiave esterna.
Vantaggi di Parallel Replicat
Di seguito sono riportati i vantaggi dell'utilizzo di Replicat parallelo.
-
Integrated Parallel Replicat consente di partizionare automaticamente carichi di lavoro pesanti tra processi di applicazione parallela che applicano più transazioni contemporaneamente, preservando al contempo l'integrità e l'atomicità della transazione di origine. È possibile configurare un numero minimo e massimo di processi di applicazione con i parametri
PARALLELISMeMAX_PARALLELISM. Replicat aggiunge automaticamente server aggiuntivi quando il carico di lavoro aumenta, quindi si regola di nuovo verso il basso quando il carico di lavoro si illumina. -
La configurazione di Integrated Parallel Replicat richiede un lavoro minimo. Tutto il lavoro viene configurato all'interno di un unico file di parametri Replicat, senza configurare le partizioni di intervallo.
-
Lo streaming applicativo ad alte prestazioni è abilitato per Replicat parallelo integrato mediante un'interfaccia API (Application Programming Interface) leggera tra Replicat e il server in entrata.
-
Le transazioni barriera sono coordinate da Replicat parallelo integrato tra più processi di applicazione server.
-
Le operazioni DDL vengono elaborate come transazioni dirette che forzano una barriera in attesa del completamento dell'elaborazione del server prima dell'esecuzione DDL.
-
Gli aggiornamenti delle chiavi primarie duplicate transitori vengono gestiti da Replicat parallelo integrato in modo trasparente.
-
Parallel Replicat può rompere una singola grande transazione in pezzi più piccoli e applicare quei pezzi in parallelo. Per informazioni dettagliate, vedere SPLIT_TRANS_RECS.
Architettura di replica parallela
I processi di replica parallela sfruttano la funzionalità di applicazione dell'elaborazione disponibile in Oracle AI Database in modalità integrata. All'interno di una singola configurazione Replicat, più processi figlio di server in entrata, noti come server di applicazione , applicano le transazioni in parallelo, conservando l'atomicità della transazione originale.
Il seguente diagramma dell'architettura descrive il flusso di record di modifica attraverso i vari processi di una replica parallela dai file trail al database di destinazione, per un Replicat parallelo non integrato.
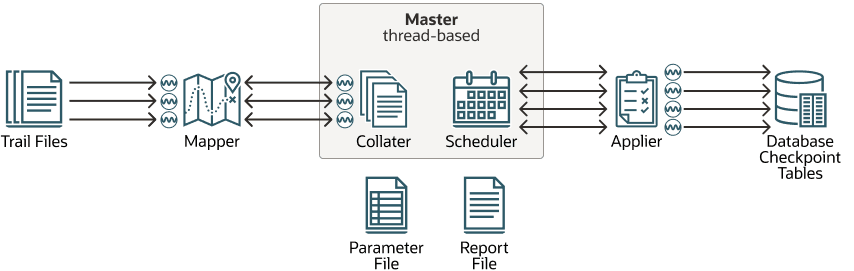
Di seguito è riportata la descrizione del diagramma dell'architettura di cui sopra:
-
I mapper leggono il file trail e mappano i record, inoltrando i record mappati al master. I batch vengono inviati agli applicatori in cui vengono applicati al database di destinazione.
-
Il processo principale è composto da due thread separati, Collater e Scheduler. Il Collater è responsabile della gestione e della comunicazione con i Mapper, oltre a ricevere le transazioni mappate e riordinarle in un unico flusso in ordine. Lo scheduler è responsabile della gestione e della comunicazione con gli applicatori, nonché della lettura delle transazioni dal collater, della loro creazione in batch e della programmazione agli applicatori.
-
Il controller Scheduler comunica con lo scheduler per raccogliere tutte le informazioni necessarie, ad esempio la posizione corrente della filigrana bassa. Il controller dello scheduler è necessario per la modalità CDB per Oracle AI Database perché è responsabile dell'aggregazione delle informazioni relative ai diversi PDB di destinazione e della generazione di report di un'immagine unificata. Il controller Scheduler viene creato per semplicità e uniformità di implementazione, anche quando non è in modalità CDB. Ogni processo legge il file dei parametri e condivide un singolo file di checkpoint.
Parametri di base per Replicat parallelo
Nella tabella seguente sono elencati i parametri Replicat paralleli di base e la relativa descrizione.
| Parametro | Descrizione |
|---|---|
|
|
Configura il numero di mappatori. Controlla il numero di thread utilizzati per leggere il file trail. Il valore minimo è 1, il valore massimo è 100 e il valore predefinito è 2. |
|
|
Consente di configurare il numero di valori anomali. Controlla il numero di connessioni nel database di destinazione utilizzato per applicare le modifiche. Il valore predefinito è quattro. |
|
|
Il parallelismo di applicazione viene eseguito automaticamente. È possibile impostare un valore minimo e massimo per definire gli intervalli in cui Replicat regola automaticamente il parallelismo. Nessuna impostazione predefinita. Non utilizzare contemporaneamente |
|
|
Specifica che le transazioni di grandi dimensioni devono essere suddivise in parti di dimensioni specificate e applicate in parallelo. Le dipendenze tra i pezzi sono ancora onorate. Disabilitato per impostazione predefinita. |
|
|
Abilita la modalità di serializzazione di commit FULL, che forza il commit delle transazioni nell'ordine trail. |
|
Parametri avanzati |
|
|
|
Controlla il livello di avanzamento dell'aspetto dello scheduler durante l'esecuzione batch delle transazioni. Il valore predefinito è 10000. |
|
|
Controlla la dimensione di una transazione affinché Replicat parallelo la consideri grande. Quando Replicat parallelo incontra una transazione più grande di questa dimensione, la serializzerà, con conseguente riduzione delle prestazioni. Tuttavia, l'aumento di questo valore aumenterà anche la quantità di memoria consumata da Replicat parallelo. |
File dei parametri di esempio
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;