Implementa un flusso di lavoro di Machine Learning scalabile utilizzando Oracle AI Data Platform e OCI Data Science
La soluzione combina i punti di forza di entrambe le piattaforme:
- AI Data Platform: fornisce una gestione dei dati centralizzata e governata, un'elaborazione Spark su larga scala, un'orchestrazione dei flussi di lavoro e un'architettura dei dati medallion.
- Data Science: fornisce un ambiente di runtime flessibile e un'infrastruttura per lo sviluppo di machine learning basato su notebook e job, l'implementazione di modelli e il servizio di modelli per i carichi di lavoro di produzione.
Questa architettura è progettata per supportare piattaforme di dati aziendali centralizzate, elaborazione di dati su larga scala, carichi di lavoro di machine learning su larga scala e collaborazione tra data engineer e data scientist.
Tipici casi d'uso sono:
- Previsione retail: generazione di previsioni della domanda giornaliera in base a dati storici e di nuova inclusione.
- Ottimizzazione del rinnovo delle assicurazioni: Ottimizza i prezzi di rinnovo delle assicurazioni per massimizzare i margini e soddisfare al contempo i vincoli aziendali. Ogni settimana viene generato un nuovo batch di offerte di rinnovo.
- Monitoraggio degli eventi di log Telecom e rilevamento delle deviazioni: analisi dei flussi di eventi operativi su larga scala per rilevare la deriva dei dati, identificare le anomalie e generare report e insight giornalieri.
Architettura
Questo diagramma illustra questa architettura di riferimento.
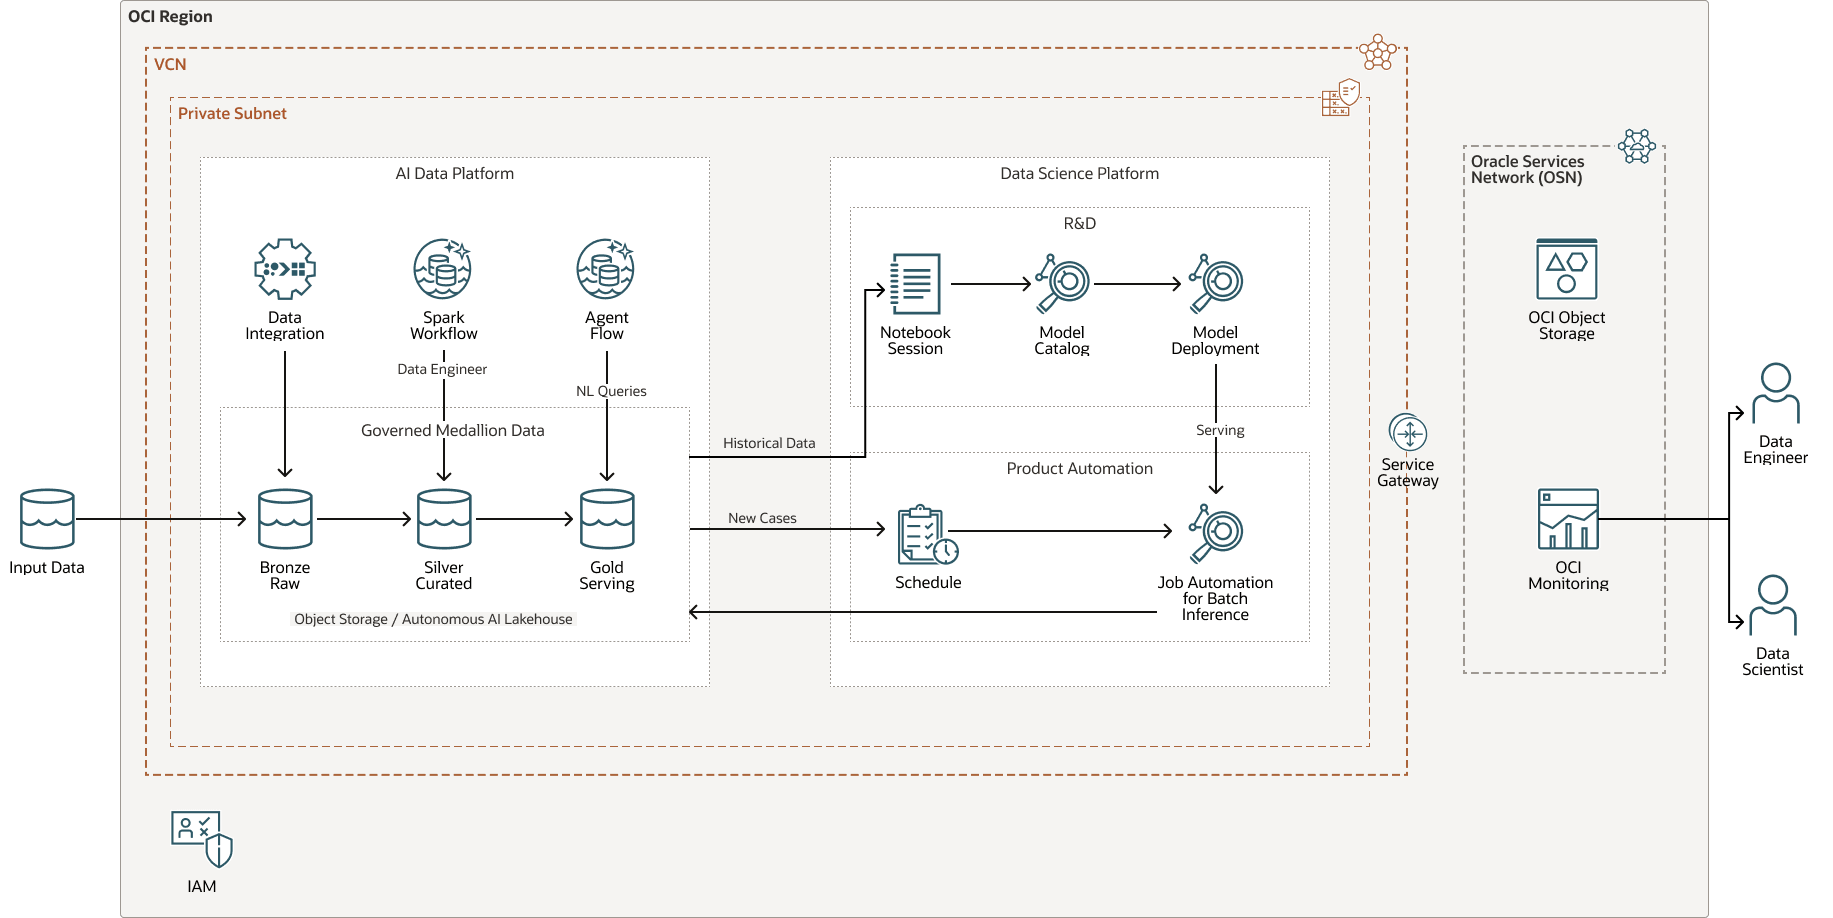
Descrizione dell'illustrazione aidp-ml-workloads-architecture.png
helpp-ml-carichi di lavoro-architettura-oracle.zip#GUID-73867B97-5BE4-434A-85C4-097DB840B323
L'architettura è divisa in quattro domini primari.
AI Data Platform (AIDP)
AI Data Platform è responsabile dell'inclusione, della trasformazione, della governance e della preparazione dei dati.
- Integrazione dei dati: inclusione di dati da origini aziendali diverse utilizzando vari strumenti come OCI Data Integration e OCI Streaming con Apache Kafka
- AI Lakehouse: storage scalabile e dinamico
- Flussi di lavoro Spark: elaborazione e trasformazione dei dati scalabili utilizzando l'architettura medaglione con livelli Bronzo, Argento e Oro
- Flusso agente: interazioni con i dati in linguaggio naturale
Queste risorse vengono create e gestite principalmente dai data engineer.
Piattaforma di data science
Data Science gestisce il ciclo di vita del machine learning, con diverse risorse utilizzate durante le fasi di R&S e produzione.
La fase di R&S comprende:
- Sessioni notebook: sperimentazione ML e addestramento dei modelli
- Catalogo modelli: controllo delle versioni del modello e gestione del modello
- Distribuzione modello: distribuzione per servizio modello scalabile
La fase di produzione include l'automazione schedulata dei job per le pipeline di inferenza batch ripetibili e l'automazione della produzione
Monitoraggio OCI
Il Monitoraggio OCI offre una visibilità operativa centralizzata su entrambe le piattaforme per il monitoraggio, la visualizzazione e gli avvisi relativi alla deriva dei dati e alla deriva dei modelli. OCI Monitoring aiuta a garantire affidabilità operativa e preparazione alla produzione.
Interazione piattaforma
L'interazione tra la piattaforma Data Science e la AI Data Platform ha principalmente i seguenti scopi:
- La piattaforma Data Science recupera i dati gestiti dalla AI Data Platform sia per l'addestramento dei modelli (dati storici) che per l'automazione della produzione (nuovi casi che richiedono il punteggio).
- La piattaforma Data Science arricchisce i dati aggiungendo punteggi di previsione per i casi appena elaborati.
Il livello di dati utilizzato per la formazione e l'automazione della produzione può variare tra le applicazioni, a seconda dello schema e dell'architettura definiti dal data engineer. In molti casi, i dati provengono dallo strato Argento curato, ma possono anche provenire dagli strati Bronzo o Oro, o da una combinazione di più strati.
Allo stesso modo, i dati arricchiti contenenti punteggi di previsione vengono spesso scritti nel livello Gold, ma possono anche essere memorizzati in altri livelli di dati, a seconda dei requisiti e dell'architettura dei dati dell'applicazione.
I dati utilizzati per il rilevamento della deriva dei dati possono provenire dai livelli Bronzo, Argento o Oro, a seconda dello specifico caso d'uso e dell'architettura dei dati.
Componenti architettura
- Oracle AI Data Platform
Oracle AI Data Platform è una piattaforma unificata che semplifica la catalogazione, la preparazione e l'analisi dei dati nella tua proprietà dei dati. Riunisce dati, intelligenza artificiale, analytics e governance all'interno di un'esperienza utente coerente che ti consente di creare applicazioni sicure e scalabili basate sull'intelligenza artificiale. Oracle AI Data Platform unifica Autonomous AI Lakehouse, Oracle Analytics Cloud, OCI Object Storage, OCI Generative AI e Fusion Data Intelligence.
All'interno di questa piattaforma, Oracle AI Data Platform Workbench fornisce un ambiente di sviluppo dedicato per progettare, orchestrare e distribuire pipeline e modelli di dati, impostare criteri RBAC e utilizzare tecnologie open source come Spark per preparare, analizzare e arricchire i dati.
- Integrazione dei dati OCI
Oracle Cloud Infrastructure Data Integration è un servizio serverless completamente gestito per la progettazione e l'esecuzione di pipeline di dati. Consente l'estrazione, la trasformazione e il caricamento senza interruzioni dei dati nelle destinazioni OCI come Autonomous AI Lakehouse e OCI Object Storage. Gli utenti possono creare flussi di integrazione attraverso un'interfaccia intuitiva e senza codice che scala automaticamente gli ambienti di esecuzione. Supporta sia ETL con elaborazione basata su Spark che ELT utilizzando SQL Pushdown per prestazioni ed efficienza. Il servizio offre anche strumenti per la preparazione dei dati e protegge dalla deriva dello schema con una gestione basata su regole.
- Data Science
Oracle Cloud Infrastructure Data Science è una piattaforma serverless completamente gestita che i team di data science possono utilizzare per creare, addestrare e gestire modelli di machine learning (ML) su OCI. Può essere facilmente integrato con altri servizi OCI come Oracle Autonomous AI Lakehouse, Oracle Cloud Infrastructure Object Storage e altro ancora. Puoi creare e valutare modelli di machine learning di alta qualità che aumentano la flessibilità aziendale mettendo i dati affidabili dell'azienda a lavorare rapidamente e puoi supportare obiettivi aziendali basati sui dati con una distribuzione più semplice dei modelli ML.
- OCI Identity and Access Management
Oracle Cloud Infrastructure Identity and Access Management (IAM) fornisce il controllo dell'accesso degli utenti per OCI e Oracle Cloud Applications. L'interfaccia API IAM e l'interfaccia utente consentono di gestire i domini di Identity e le risorse al loro interno. Ogni dominio di Identity OCI IAM rappresenta una soluzione standalone di gestione accessi e identità oppure una popolazione di utenti diversa.
- Monitoraggio OCI
Oracle Cloud Infrastructure Monitoring monitora in modo attivo e passivo le tue risorse cloud e utilizza gli allarmi per avvisarti quando le metriche soddisfano i trigger specificati.
- Memorizzazione degli oggetti OCI
Lo storage degli oggetti OCI fornisce l'accesso a grandi quantità di dati strutturati e non strutturati di qualsiasi tipo di contenuto, inclusi backup del database, dati analitici e contenuti avanzati come immagini e video. Puoi memorizzare in tutta sicurezza i dati direttamente dalle applicazioni o dall'interno della piattaforma cloud. Puoi ridimensionare lo storage senza compromettere le prestazioni o l'affidabilità del servizio.
Utilizza lo storage standard per lo storage "caldo" a cui devi accedere in modo rapido, immediato e frequente. Utilizza lo storage di archivio per lo storage "a freddo" che conservi per lunghi periodi di tempo e a cui accedi raramente o raramente.
- Area OCI
Un'area geografica OCI è un'area geografica localizzata che contiene uno o più data center, che ospitano domini di disponibilità. Le regioni sono indipendenti da altre regioni e vaste distanze possono separarle (tra paesi o addirittura continenti).
- Gateway del servizio
Un gateway di servizi fornisce l'accesso da una VCN ad altri servizi, ad esempio Oracle Cloud Infrastructure Object Storage. Il traffico dalla VCN al servizio Oracle viaggia sul fabric di rete Oracle e non attraversa Internet.
- OCI Streaming
Oracle Cloud Infrastructure Streaming offre una soluzione per lo storage completamente gestita, scalabile e duratura dedicato all'inclusione di flussi di dati continui e ad elevato volume che puoi accedere ed elaborare in tempo reale. La soluzione OCI Streaming può essere utilizzata per includere dati di elevato volume, quali log dell'applicazione, telemetria operativa, dati di click-stream Web, o per altri casi d'uso in cui le informazioni vengono prodotte ed elaborate in maniera continua e sequenziale in un modello DI messaggistica di modalità pubblicazione/sottoscrizione.
- Rete e subnet cloud virtuale OCI
Una rete cloud virtuale (VCN, virtual cloud network) è una rete personalizzabile e definita dal software impostata in un'area OCI. Come le reti di data center tradizionali, le reti VCN offrono il controllo sull'ambiente di rete. Una VCN può avere più blocchi CIDR (Classless Inter-Domain Routing) non sovrapposti che è possibile modificare dopo aver creato la VCN. È possibile segmentare una VCN in subnet, che possono essere definite in un'area o in un dominio di disponibilità. Ogni subnet è costituita da un intervallo contiguo di indirizzi che non si sovrappongono alle altre subnet nella VCN. È possibile modificare le dimensioni di una sottorete dopo la creazione. Una subnet può essere pubblica o privata.
Suggerimenti
I requisiti potrebbero essere diversi.
- Automatizza le pipeline di inferenza ripetibili utilizzando job e schedulazioni di Data Science.
- Utilizza gli strumenti di distribuzione e servizio di Data Science per supportare la scalabilità, il monitoraggio operativo e la riproducibilità.
- Monitora i carichi di lavoro di Machine Learning per lo stato operativo, la deviazione dei dati e la deriva dei modelli.
- Stabilisci una chiara proprietà operativa tra i team di Data Engineering e Data Science.
Considerazioni
- Implementare i criteri di OCI Identity and Access Management e di controllo dell'accesso basato sui ruoli (RBAC) in entrambe le piattaforme.
- Monitora i carichi di lavoro di produzione per monitorare lo stato operativo, la deviazione dei dati e la deviazione dei modelli.
- Utilizza lo storage gestito scalabile per la conservazione e l'analisi dei dati a lungo termine.