パラレルReplicatについて
並列Replicatは、パフォーマンス向上のために並列でトランザクションを適用する別のReplicatです。
これは、統合Replicatと同様に、トランザクション間の依存関係を考慮します。依存性の計算、マッピングの並列度および適用はデータベースの外部で実行されるため、別のサーバーにオフロードできます。このプロセスでトランザクションの整合性が維持されます。さらに、並列Replicatは、大きなトランザクションをチャンクに分けてパラレルに適用することで、大きなトランザクションをパラレルに適用することをサポートします。
パラレルReplicatは、統合モードと非統合モードの2つのモードをサポートします。統合モードのパラレルReplicatは、Oracle AI Databaseでのみサポートされます。
並列Replicatを使用するには、次の値(デフォルト値)も設定する必要があります。
-
証跡内のメタデータ(つまり、証跡が12.1より前でフォーマットされている場合、並列Replicatを使用できません)。
-
証跡ファイルにはスケジュール列が必要です。
-
UPDATERCORDFORMAT COMPACTを使用する必要があります。
統合並列Replicatの場合、Replicatは、ターゲット・データベースにデータを適用するインバウンド・サーバーにLCRを送信し、通常の並列Replicatの場合、Oracle GoldenGateは、他の非統合レプリカの動作と同様に、LCRをSQL文としてデータベースに直接適用します。ノート: OLTPワークロードで最適なパフォーマンスが得られるように、非統合モードのパラレルReplicatをお薦めします。
パラレルReplicatのコンポーネントは次のとおりです。
-
マッパーはパラレルに動作し、証跡の読取り、証跡レコードのマッピング、マップされたレコードの統合Replicat LCR形式への変換、および後続の処理のためのマージャへのLCRの送信を実行します。1つのマッパーが1つのセットのトランザクションをマップしている間に、次のマッパーが次のセットのトランザクションをマップします。証跡情報は分割されますが、証跡情報が正しく順序付けされるため、証跡ファイルはそのままの状態になります。
-
マスター・プロセスにはコレータとスケジューラの2つのスレッドがあります。コレータはマッパーからマップされたトランザクションを受け取り、依存関係の計算のために証跡の順序に戻します。スケジューラがトランザクション間の依存関係を計算し、トランザクションを独立したバッチにグループ化し、ターゲット・データベースに適用するためにバッチをアプライアに送信します。
-
アプライアは配列実行のためにバッチ内のレコードを並べ替えます。さらにバッチをターゲット・データベースに適用し、エラー処理を実行します。また、適用したトランザクションをチェックポイント表で追跡します。ノート:パラレルReplicatでは、外部キー列が索引付けされている必要があります。
パラレルReplicatの利点
パラレルReplicatを使用する利点は次のとおりです。
-
統合パラレルReplicatは、複数のトランザクションを同時に適用されるパラレル適用プロセス間で重いワークロードを自動的にパーティション化しながら、ソース・トランザクションの完全性とアトミック性を保持できます。適用プロセスの最小数および最大数の両方を
PARALLELISMおよびMAX_PARALLELISMパラメータで構成できます。Replicatは、ワークロードが増加すると、追加のサーバーを自動的に追加し、ワークロードが軽減されると、再度下方に調整します。 -
統合パラレルReplicatでは、最小限の構成作業が必要です。すべての作業は、レンジ・パーティションを構成することなく1つのReplicatパラメータ・ファイル内に構成されます。
-
高パフォーマンスの適用ストリーミングは、軽量アプリケーション・プログラミング・インタフェース(API)によって、Replicatとインバウンド・サーバーの間で統合並列Replicatのために有効化されます。
-
バリア・トランザクションは、複数のサーバー適用プロセス間で、統合パラレルReplicatによって調整されます。
-
DDL操作は、DDLの実行前にサーバー処理が完了まで待機することで、バリアを強制する直接トランザクションとして処理されます。
-
一時的な重複主キー更新は、統合パラレルReplicatによってシームレスに処理されます。
-
パラレルReplicatでは、単一の大規模トランザクションを小さなチャンクに分割し、そのチャンクと並行して適用できます。詳細は、「SPLIT_TRANS_RECS」を参照してください。
パラレル・レプリケーション・アーキテクチャ
パラレル・レプリケーション・プロセスでは、統合モードの場合に、Oracle AI Database内で使用可能な適用処理機能を活用します。単一のReplicat構成内で、適用サーバーと呼ばれるインバウンド・サーバーの複数の子プロセスがトランザクションをパラレルに適用し、元のトランザクションのアトミック性を保持します。
次のアーキテクチャ図に、非統合並列Replicatの証跡ファイルからターゲット・データベースへのパラレル・レプリケーションの様々なプロセスにおける変更レコードのフローを示します。
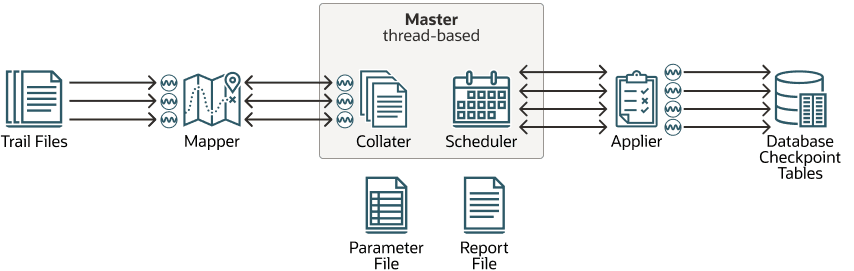
次に、前述のアーキテクチャ図の説明を示します。
-
マッパーが証跡ファイルを読み取ってレコードをマップし、マップしたレコードをマスターに転送します。バッチはアプライアに送信されて、ターゲット・データベースに適用されます。
-
マスター・プロセスにはコレータとスケジューラの2つの個別のスレッドがあります。コレータはマッパーの管理とマッパーとの通信を行い、さらにマップされたトランザクションを受信して、単一の順序ストリームに並べ替えます。スケジューラはアプライアの管理とアプライアとの通信を行い、さらにコレータからトランザクションを読み取り、バッチにしてアプライアに対してスケジュールします。
-
スケジューラ・コントローラはスケジューラと通信して必要な情報(現在の低水位標の位置など)を収集します。スケジューラ・コントローラはOracle AI DatabaseのCDBモードで必要で、これによって、様々なターゲットPDBに関連する情報を集約して、統一された状態をレポートします。スケジューラ・コントローラは、CDBモードでない場合でもシンプルで統一された実装を実現するために作成されています。各プロセスがパラメータ・ファイルを読み取り、単一のチェックポイント・ファイルを共有します。
パラレルReplicatの基本パラメータ
次の表に、基本的な並列Replicatのパラメータおよびその説明をリストします。
| パラメータ | 摘要 |
|---|---|
|
|
マッパーの数を構成します。これは、証跡ファイルを読み取るために使用されるスレッドの数を制御します。最小値は1、最大値は100、デフォルト値は2です。 |
|
|
アプライアの数を構成します。これによって、変更の適用に使用するターゲット・データベース内の接続数を制御します。デフォルト値は4です。 |
|
|
適用の並列性は自動的にチューニングされます。最小値と最大値を設定して、Replicatが自動的に並列化を調整する範囲を定義できます。デフォルトはありません。 |
|
|
大きなトランザクションを指定のサイズのピースに分割して、パラレルに適用するように指定します。ピース間の依存性関係は引き続き尊重されます。デフォルトでは無効です。 |
|
|
FULL直列化モードのコミットを有効にし、証跡の順序でトランザクションを強制的にコミットします。 |
|
拡張パラメータ |
|
|
|
スケジューラがトランザクションをバッチリングする際にどれくらい先まで認識するかを管理します。デフォルト値は10000です。 |
|
|
パラレルReplicatで、どの程度の大きさのトランザクションを大きいトランザクションとみなすかを制御します。並列Replicatは、このサイズより大きいトランザクションが検出されると、そのトランザクションをシリアライズするためにパフォーマンスが低下させます。ただし、この値を大きくすると、並列Replicatによって消費されるメモリーも増加します。 |
パラメータ・ファイルの例
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;