병렬 복제 정보
Parallel Replicat는 성능 향상을 위해 병렬로 트랜잭션을 적용하는 Replicat의 또 다른 변형입니다.
통합 Replicat와 유사하게 트랜잭션 간 종속성을 고려합니다. 종속성 계산, 매핑 및 적용의 병렬화가 데이터베이스 외부에서 수행되므로 다른 서버로 오프로드할 수 있습니다. 트랜잭션 무결성은 이 프로세스에서 유지 관리됩니다. 또한 parallel Replicat는 큰 트랜잭션을 조각으로 분할하고 병렬로 적용하여 큰 트랜잭션의 병렬 적용을 지원합니다.
Parallel Replicat는 통합 및 비통합 두 가지 모드를 지원합니다. Oracle AI Database만 통합 모드에서 병렬 Replicat를 지원합니다.
병렬 Replicat를 사용하려면 기본값인 다음 값이 있는지 확인해야 합니다.
-
추적의 메타데이터입니다. 즉, 트레일이 12.1 미만으로 포맷된 경우 병렬 Replicat를 사용할 수 없습니다.
-
추적 파일에 스케줄링 열이 있어야 합니다.
-
UPDATERCORDFORMAT COMPACT를 사용해야 합니다.
통합 병렬 Replicat를 사용하면 Replicat가 인바운드 서버로 LCR을 전송하여 데이터를 대상 데이터베이스에 적용하고 일반 병렬 Replicat에서 Oracle GoldenGate는 LCR을 데이터베이스에 직접 SQL 문으로 적용합니다(다른 비통합 Replicats의 작동 방식과 유사). 주: OLTP 작업 로드에 대한 최상의 성능을 얻으려면 비통합 모드의 병렬 Replicat가 권장됩니다.
병렬 Replicat의 구성 요소는 다음과 같습니다.
-
매퍼는 병렬로 작동하여 추적을 읽고, 추적 레코드를 매핑하고, 매핑된 레코드를 Integrated Replicat LCR 형식으로 변환하고, 추가 처리를 위해 병합기로 LCR을 전송합니다. 하나의 매퍼가 하나의 트랜잭션 세트를 매핑하는 동안 다음 매퍼는 다음 트랜잭션 세트를 매핑합니다. 추적 정보가 순서대로 추적 정보를 주문하므로 추적 정보가 분할되고 추적 파일이 변경되지 않습니다.
-
마스터 프로세스에는 Collater 및 Scheduler라는 두 개의 스레드가 있습니다. Collater는 매퍼로부터 매핑된 트랜잭션을 수신하여 종속성 계산을 위해 추적 순서로 되돌립니다. 스케줄러는 트랜잭션 간의 종속성을 계산하고, 트랜잭션을 독립 일괄 처리로 그룹화하고, 일괄 처리를 Target Database에 적용할 Applier로 보냅니다.
-
Applier는 배열 실행을 위해 뱃치 내에서 레코드의 순서를 재지정합니다. Target Database에 일괄 처리를 적용하고 오류 처리를 수행합니다. 또한 체크포인트 테이블에서 적용된 트랜잭션을 추적합니다. 주: Parallel Replicat에서는 모든 외래 키 열이 인덱스화되어야 합니다.
병렬 Replicat의 이점
다음은 병렬 Replicat 사용 시의 이점입니다.
-
Integrated Parallel Replicat를 사용하면 여러 트랜잭션을 동시에 적용하는 병렬 적용 프로세스 간에 많은 작업 로드를 자동으로 분할하는 동시에 소스 트랜잭션의 무결성과 원자성을 유지할 수 있습니다. 최소 및 최대 적용 프로세스 수는 모두
PARALLELISM및MAX_PARALLELISM매개변수로 구성할 수 있습니다. Replicat는 작업 로드가 증가할 때 자동으로 서버를 추가한 다음 작업 로드가 증가할 때 다시 아래쪽으로 조정합니다. -
Integrated Parallel Replicat는 구성 작업을 최소화해야 합니다. 모든 작업은 범위 분할 영역을 구성하지 않고 하나의 Replicat 매개변수 파일 내에 구성됩니다.
-
고성능 적용 스트리밍은 Replicat와 인바운드 서버 간의 경량 API(애플리케이션 프로그래밍 인터페이스)를 통해 통합된 병렬 Replicat에 대해 사용으로 설정됩니다.
-
배리어 트랜잭션은 여러 서버 적용 프로세스 간에 통합된 병렬 Replicat에 의해 조정됩니다.
-
DDL 작업은 DDL 실행 전에 서버 처리가 완료될 때까지 기다림으로써 장벽을 강제하는 직접 트랜잭션으로 처리됩니다.
-
일시적인 중복 기본 키 업데이트는 통합 병렬 Replicat에서 원활한 방식으로 처리됩니다.
-
Parallel Replicat는 하나의 큰 트랜잭션을 작은 조각으로 분할하고 이러한 조각을 병렬로 적용할 수 있습니다. 자세한 내용은 SPLIT_TRANS_RECS을 참조하십시오.
병렬 복제 구조
병렬 복제 프로세스는 통합 모드에서 Oracle AI Database 내에서 사용할 수 있는 적용 처리 기능을 활용합니다. 단일 Replicat 구성 내에서 적용 서버로 알려진 다중 인바운드 서버 하위 프로세스는 원래 트랜잭션 원자성을 유지하면서 트랜잭션을 병렬로 적용합니다.
다음 아키텍처 다이어그램은 비통합 병렬 Replicat에 대한 추적 파일에서 대상 데이터베이스로 병렬 복제의 다양한 프로세스를 통한 변경 레코드의 플로우를 보여 줍니다.
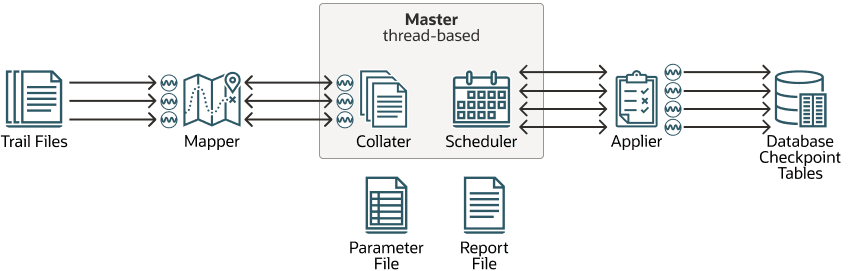
다음은 위에서 설명한 구조 다이어그램에 대한 설명입니다.
-
매퍼는 추적 파일을 읽고 레코드를 매핑하고 매핑된 레코드를 마스터로 전달합니다. 일괄 처리는 대상 데이터베이스에 적용되는 Applier로 전송됩니다.
-
마스터 프로세스는 Collater 및 Scheduler라는 두 개의 개별 스레드로 구성됩니다. Collater는 매핑된 트랜잭션을 수신하고 이를 단일 주문 스트림으로 재정렬하는 작업과 함께 Mappers와 관리 및 통신합니다. 스케줄러는 콜레이터에서 트랜잭션을 읽고 일괄 처리한 다음 Applier로 스케줄링하는 작업과 함께 Applier를 관리하고 통신합니다.
-
스케줄러 컨트롤러는 스케줄러와 통신하여 현재 로우 워터마크 위치와 같은 필요한 정보를 수집합니다. Oracle AI Database용 CDB 모드에서는 서로 다른 대상 PDB와 관련된 정보를 집계하고 통합된 그림을 보고하기 때문에 스케줄러 컨트롤러가 필요합니다. 스케줄러 컨트롤러는 CDB 모드가 아닌 경우에도 구현의 단순성과 균일성을 위해 생성됩니다. 모든 프로세스는 파라미터 파일을 읽고 단일 체크포인트 파일을 공유합니다.
병렬 Replicat에 대한 기본 매개변수
다음 표에서는 기본 병렬 Replicat 매개변수와 해당 설명을 나열합니다.
| 매개변수 | 설명 |
|---|---|
|
|
매퍼 수를 구성합니다. 추적 파일을 읽는 데 사용되는 스레드 수를 제어합니다. 최소값은 1, 최대값은 100, 기본값은 2입니다. |
|
|
이상치 수를 구성합니다. 변경 사항을 적용하는 데 사용되는 Target Database의 연결 수를 제어합니다. 기본값은 4입니다. |
|
|
Apply 병렬화는 자동 튜닝됩니다. 최소값과 최대값을 설정하여 Replicat가 자동으로 병렬화를 조정하는 범위를 정의할 수 있습니다. 기본값이 없습니다. |
|
|
대형 트랜잭션을 지정된 크기의 조각으로 나누어 병렬로 적용하도록 지정합니다. 조각 간의 종속성은 계속 유지됩니다. 기본적으로 사용 안함으로 설정됩니다. |
|
|
커밋 FULL 직렬화 모드를 활성화하여 트랜잭션이 트레일 순서대로 커밋되도록 합니다. |
|
고급 매개변수 |
|
|
|
트랜잭션을 일괄 처리할 때 스케줄러가 얼마나 앞서가는지를 제어합니다. 기본값은 10000입니다. |
|
|
병렬 Replicat에서 트랜잭션 크기를 크게 고려할 수 있는 트랜잭션 크기를 제어합니다. 병렬 Replicat가 이 크기보다 큰 트랜잭션을 발견하면 직렬화되어 성능이 저하됩니다. 그러나 이 값을 늘리면 병렬 Replicat에서 사용하는 메모리 양도 늘어납니다. |
예제 매개변수 파일
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;