Sobre Replicat Paralelo
O Replicat Paralelo é outra variante do Replicat que aplica transações em paralelo para melhorar o desempenho.
Ele leva em conta as dependências entre transações, semelhantes ao Replicat Integrado. O cálculo de dependência, o paralelismo do mapeamento e a aplicação são executados fora do banco de dados para que possam ser descarregados para outro servidor. A integridade da transação é mantida nesse processo. Além disso, o Replicat paralelo suporta a aplicação paralela de transações grandes, dividindo uma transação grande em partes e aplicando-as em paralelo.
O Replicat Paralelo suporta os dois modos a seguir: Integrado e Não Integrado. Somente o Oracle AI Database suporta Replicat paralelo no modo integrado.
Para usar o Replicat paralelo, você precisa garantir que tenha os seguintes valores, que também são os valores padrão:
-
Metadados na trilha (o que significa que você não poderá usar o Replicat paralelo se suas trilhas estiverem formatadas abaixo da versão 12.1).
-
Você deve ter colunas de programação em seu arquivo de trilha.
-
Você deve usar
UPDATERCORDFORMAT COMPACT.
Com o Replicat paralelo integrado, o Replicat envia os LCRs para o servidor de entrada, que aplica os dados ao banco de dados de destino, e no Replicat paralelo regular, o Oracle GoldenGate aplica o LCR como uma instrução SQL diretamente ao banco de dados, semelhante à forma como os outros Replicats não integrados funcionam. Observação: Para obter o melhor desempenho para uma carga de trabalho OLTP, recomenda-se o processo Replicat paralelo no modo não integrado.
Os componentes do Replicat paralelo são:
-
Os mapeadores operam em paralelo para ler a trilha, mapear registros de trilha, converter os registros mapeados para o formato LCR de Replicat Integrado e enviar os LCRs para a Fusão para processamento posterior. Enquanto um Mapeador mapeia um conjunto de transações, o próximo Mapeador mapeia o próximo conjunto de transações. As informações da trilha são divididas e o arquivo da trilha não é tocado porque ordena as informações da trilha em ordem.
-
Os processos mestre têm dois threads, Collater e Scheduler. O Colaborador recebe transações mapeadas dos Mapeadores e as coloca de volta na ordem da trilha para cálculo de dependência. O Scheduler calcula dependências entre transações, agrupa transações em lotes independentes e envia os lotes para os Aplicadores a serem aplicados ao banco de dados de destino.
-
Os fornecedores reordenam registros em um lote para execução de matriz. Ele aplica o batch ao banco de dados de destino e executa o tratamento de erros. Ele também rastreia transações aplicadas em tabelas de checkpoint. Observação: O processo Replicat Paralelo requer que quaisquer colunas de chave estrangeira sejam indexadas.
Benefícios do Replicat Paralelo
Estes são os benefícios de usar o Replicat paralelo:
-
O Replicat Paralelo Integrado permite que cargas de trabalho pesadas sejam particionadas automaticamente entre processos de aplicação paralela que aplicam várias transações simultaneamente, preservando a integridade e a atomicidade da transação de origem. É possível configurar um número mínimo e máximo de processos de aplicação com os parâmetros
PARALLELISMeMAX_PARALLELISM. O Replicat adiciona automaticamente servidores adicionais quando a carga de trabalho aumenta e depois se ajusta para baixo novamente quando a carga de trabalho diminui. -
O Replicat Paralelo Integrado requer um trabalho mínimo de configuração. Todo o trabalho é configurado em um arquivo de parâmetros Replicat, sem configurar partições de intervalo.
-
O streaming de aplicação de alto desempenho é ativado para Replicat paralelo integrado por meio de uma API (interface de programação de aplicativos) leve entre o Replicat e o servidor de entrada.
-
As transações de barreira são coordenadas pelo Replicat paralelo integrado entre vários processos de aplicação de servidor.
-
As operações DDL são processadas como transações diretas que forçam uma barreira aguardando a conclusão do processamento do servidor antes da execução da DDL.
-
As atualizações de chave primária duplicadas transitórias são tratadas pelo Replicat paralelo integrado de maneira integrada.
-
O Replicat Paralelo pode dividir uma única transação grande em blocos menores e aplicar esses blocos em paralelo. Consulte SPLIT_TRANS_RECS para obter detalhes.
Arquitetura de Replicação Paralela
Os processos de replicação paralela aproveitam a funcionalidade de processamento de aplicação disponível no Oracle AI Database no modo integrado. Em uma única configuração Replicat, vários processos-filho do servidor de entrada, conhecidos como aplicar servidores, aplicam transações em paralelo, preservando a atomicidade original da transação.
O diagrama de arquitetura a seguir descreve o fluxo de registros de alteração por meio dos vários processos de uma replicação paralela dos arquivos de trilha para o banco de dados de destino, para um Replicat paralelo não integrado.
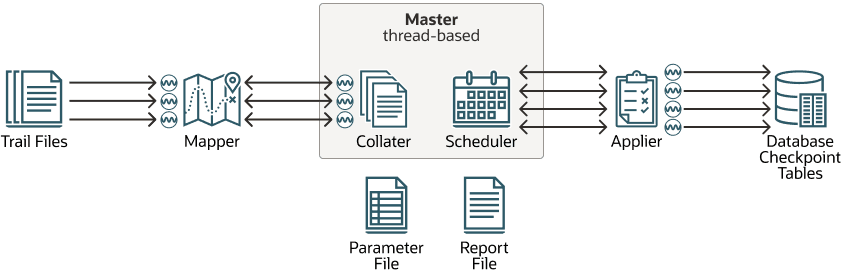
Veja a seguir a descrição do diagrama de arquitetura fornecido acima:
-
Os Mapeadores leem o arquivo de trilha e mapeiam os registros, encaminham os registros mapeados para o Mestre. Os batches são enviados para os Aplicadores em que são aplicados ao banco de dados de destino.
-
O processo Mestre consiste em dois threads separados, Collater e Scheduler. O Collater é responsável por gerenciar e se comunicar com os Mapeadores, além de receber as transações mapeadas e reordená-las em um único fluxo na ordem. O Programador é responsável por gerenciar e se comunicar com os Aplicadores, juntamente com a leitura de transações do Colaborador, agrupando-as e programando-as para os Aplicadores.
-
O controlador do Agendador se comunica com o Agendador para reunir todas as informações necessárias (como a posição da marca d'água baixa atual). O controlador do Scheduler é necessário para o modo CDB do Oracle AI Database porque é responsável por agregar informações pertencentes aos diferentes PDBs de destino e gerar relatórios de uma imagem unificada. O controlador do Scheduler é criado para simplificar e uniformizar a implementação, mesmo quando não está no modo CDB. Cada processo lê o arquivo de parâmetros e compartilha um único arquivo de checkpoint.
Parâmetros Básicos para Replicat Paralelo
A tabela a seguir lista os parâmetros básicos do Replicat paralelo e sua descrição.
| Parâmetro | Descrição |
|---|---|
|
|
Configura o número de mapeadores. Controla o número de threads usados para ler o arquivo de trilha. O valor mínimo é 1, o valor máximo é 100 e o valor padrão é 2. |
|
|
Configura o número de aplicadores. Isso controla o número de conexões no banco de dados de destino usado para aplicar as alterações. O valor padrão é quatro. |
|
|
O paralelismo Aplicar é ajustado automaticamente. Você pode definir um valor mínimo e máximo para definir os intervalos nos quais o Replicat ajusta automaticamente seu paralelismo. Não há padrões. Não use com |
|
|
Especifica que transações grandes devem ser divididas em partes de tamanho especificado e aplicadas em paralelo. As dependências entre as peças ainda são respeitadas. Desativado por default. |
|
|
Ativa o modo de serialização FULL de commit, que força as transações a serem confirmadas na ordem da trilha. |
|
Parâmetros Avançados |
|
|
|
Controla o quanto o Programador está à frente ao fazer transações em batch. O valor default é 10000. |
|
|
Controla o tamanho de uma transação para que o Replicat paralelo a considere como grande. Quando o Replicat paralelo encontrar uma transação maior que esse tamanho, ele a serializará, resultando em desempenho reduzido. No entanto, o aumento desse valor também aumentará a quantidade de memória consumida pelo Replicat paralelo. |
Arquivo de Parâmetros de Exemplo
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;