Rotear Solicitações de Modelo entre Regiões da OCI

Crie um perfil de roteamento para um modelo sob demanda e use o OCID do perfil de roteamento nas solicitações de Conclusões e Respostas de Chat de aplicativos Python.

Visão Geral

Um perfil de roteamento especifica um modelo sob demanda suportado e uma ou mais regiões do OCI de destino no mesmo realm em que esse modelo está disponível. Os aplicativos enviam solicitações a um ponto final regional da API do OCI Generative AI e especificam o OCID do perfil de roteamento como o valor model. A IA generativa atende a cada solicitação de uma região elegível no perfil.

Use um perfil quando os aplicativos precisarem do mesmo modelo e do mesmo conjunto aprovado de regiões de serviço. Você pode atualizar a configuração do perfil no OCI, em vez de manter uma lista de regiões em cada aplicativo. Um perfil com várias regiões de destino não implica roteamento de retorno ou uma prioridade de região fixa.

Neste tutorial, dois aplicativos Python chamam o ponto final da API Chicago. Um usa Conclusões de Bate-papo e o outro usa Respostas. Ambos usam um perfil de roteamento para openai.gpt-oss-120b que permite servir de Chicago, Frankfurt ou Osaka.
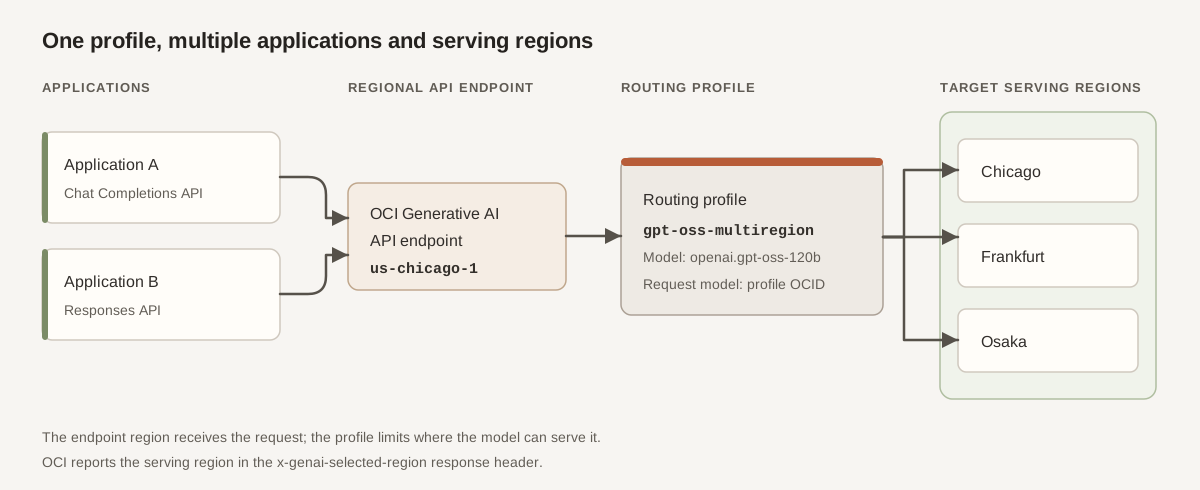
Dois aplicativos enviam solicitações de Conclusões e Respostas de Chat para o ponto final da API de IA Generativa da OCI de Chicago. Ambos passam pelo mesmo OCID de perfil de roteamento do modelo. O perfil seleciona o modelo sob demanda openai.gpt-oss-120b e permite servir de Chicago, Frankfurt ou Osaka.

Você cria um perfil, instala o SDK Python OpenAI, executa os dois exemplos e verifica o cabeçalho de resposta x-genai-selected-region para ver qual região atendeu a cada solicitação.

Observação

Você só poderá usar um perfil com ambas as APIs se o modelo selecionado suportar a API de Conclusões de Chat do OCI e a API de Respostas do OCI. Ambas as APIs estão disponíveis por meio de perfis de roteamento em regiões sem processamento de modelo local. Ao chamar de uma dessas regiões, use o ponto final da API dessa região e selecione as regiões de destino nas quais o modelo está disponível.

Antes de Começar

Para concluir este tutorial, você precisa:

  • Acesso ao OCI Generative AI, permissão para criar um perfil de roteamento no compartimento selecionado e permissão para usá-lo para inferência. Consulte Permissões no Nível de API para Perfis de Roteamento.
  • Um modelo sob demanda suportado disponível para sua tenancy nas regiões de destino. Para executar os dois exemplos com um perfil, selecione um modelo que suporte as duas APIs. Consulte Modelos de IA Generativa por Região.
  • Uma chave de API da OCI Generative AI autorizada para solicitações por meio do ponto final de Chicago. Não coloque a chave no código-fonte ou confirme-a em um repositório.
  • Python 3.11 ou posterior e uv instalado no subsistema macOS, Linux ou Windows para Linux. Os comandos deste tutorial usam um shell compatível com Bash.

Os exemplos usam o SDK Python OpenAI com o ponto final compatível com OpenAI da OCI. Eles não exigem o OCI Python SDK ou a CLI do OCI.

1. Criar um Perfil de Rota

Este exemplo cria um perfil no Centro-Oeste dos EUA (Chicago). Suas regiões de destino podem diferir da região de ponto final da API, mas devem estar disponíveis para o modelo selecionado e no mesmo realm. Se um modelo ou região neste exemplo não estiver disponível para sua tenancy, selecione uma opção disponível.

  1. Acesse a Console do OCI e selecione Centro-Oeste dos EUA (Chicago) (us-chicago-1) no seletor de região.
  2. Abra Análise e IA, selecione IA Generativa e, em seguida, selecione Perfis de roteamento.
    Para obter mais informações sobre a página da lista, consulte Listando Perfis de Roteamento.
  3. Selecione Criar perfil de rota.
  4. Digite um nome, como gpt-oss-multiregion, selecione um compartimento e, opcionalmente, adicione uma descrição ou tags.
  5. Em Configuração, selecione openai.gpt-oss-120b na seleção Modelo.

    O OpenAI gpt-oss-120b está disponível sob demanda em Chicago, Frankfurt e Osaka e suporta a API de Conclusões de Chat do OCI e a API de Respostas do OCI.

    Para selecionar um modelo, verifique Modelos por Região para obter disponibilidade sob demanda em suas regiões de destino e Modelos e Regiões para Pontos Finais Compatíveis com OpenAI do OCI para obter modelos suportados pelas APIs que você planeja chamar.

  6. Em Regiões de destino do OCI, selecione as regiões nas quais o modelo pode ser servido.

    Para este exemplo, selecione as seguintes regiões:

    • Centro-Oeste dos EUA (Chicago): us-chicago-1
    • Central da Alemanha (Frankfurt): eu-frankfurt-1
    • Central do Japão (Osaka): ap-osaka-1
  7. Selecione Criar.
  8. Abra a página de detalhes do perfil. Confirme se seu status é Ativo e revise o modelo selecionado e as regiões de destino do OCI. Copie o OCID completo do perfil.
    Para obter detalhes sobre essa página, consulte Obtendo Detalhes de um Perfil de Rota. Você usa o OCID como o valor model em ambos os scripts.
O perfil está pronto para solicitações de inferência sob demanda suportadas.

2. Preparar o Ambiente Python

  1. Em um diretório de trabalho, crie e ative um ambiente virtual e instale o OpenAI Python SDK:
    uv venv --python 3.11 .venv
    source .venv/bin/activate
    uv pip install --upgrade openai

    Se o .venv já existir, ative-o e execute o comando de instalação. O OCI Python SDK não é necessário para esses exemplos.

  2. Defina a região do ponto final da API e o OCID do perfil de roteamento para o shell atual:
    export OCI_REGION=us-chicago-1
    export OCI_ROUTING_PROFILE_OCID='<your-routing-profile-ocid>'

    Substitua <your-routing-profile-ocid> pelo OCID completo mostrado no perfil de roteamento. OCI_REGION determina qual ponto final de API regional recebe a solicitação. O perfil de rota especifica as regiões em que o modelo pode atendê-lo.

  3. Tenha uma chave de API do OCI Generative AI pronta.
    Cada script solicita a chave sem exibi-la se OCI_GENAI_API_KEY não for definido por um gerenciador de segredos ou outro mecanismo seguro. Não cole a chave em nenhum script.

3. Executar o Exemplo de Conclusões de Bate-papo

  1. Salve o seguinte código como routing-chat-completion.py em seu diretório de trabalho:
    """Chat with an OCI Generative AI routing profile."""
    
    from __future__ import annotations
    
    import os
    from getpass import getpass
    
    from openai import OpenAI
    
    
    def main() -> None:
        region = os.environ.get("OCI_REGION", "us-chicago-1")
        profile_ocid = os.environ["OCI_ROUTING_PROFILE_OCID"]
        api_key = os.environ.get("OCI_GENAI_API_KEY") or getpass(
            "OCI Generative AI API key: "
        )
        client = OpenAI(
            base_url=f"https://inference.generativeai.{region}.oci.oraclecloud.com/openai/v1",
            api_key=api_key,
        )
    
        messages: list[dict[str, str]] = []
        print("Chat Completions with a routing profile. Type 'exit' to stop.\n")
    
        while True:
            try:
                prompt = input("You: ").strip()
            except (EOFError, KeyboardInterrupt):
                print("\nGoodbye!")
                break
    
            if prompt.lower() in {"exit", "quit"}:
                print("Goodbye!")
                break
            if not prompt:
                continue
    
            messages.append({"role": "user", "content": prompt})
            answer_parts: list[str] = []
    
            try:
                with client.chat.completions.create(
                    model=profile_ocid,
                    messages=messages,
                    stream=True,
                ) as stream:
                    selected_region = stream.response.headers.get(
                        "x-genai-selected-region"
                    )
                    print(f"Served from OCI region: {selected_region or 'not reported'}")
                    print("Assistant: ", end="", flush=True)
    
                    for chunk in stream:
                        if not chunk.choices:
                            continue
                        content = chunk.choices[0].delta.content
                        if content:
                            answer_parts.append(content)
                            print(content, end="", flush=True)
            except Exception as error:
                messages.pop()
                print(f"\nRequest failed: {error}\n")
                continue
    
            answer = "".join(answer_parts)
            if answer:
                messages.append({"role": "assistant", "content": answer})
            else:
                messages.pop()
            print("\n")
    
    
    if __name__ == "__main__":
        main()
  2. Com o ambiente virtual ativado, execute o script:
    python routing-chat-completion.py
  3. Em You:, informe um prompt. Após a resposta, informe um follow-up ou exit a ser interrompido.
    O script transmite o texto de chunk.choices[0].delta.content e mantém o histórico de conversas localmente para o processo atual.

4. Executar o Exemplo de Respostas

Use este exemplo somente se o modelo selecionado no perfil de rota suportar a API de Respostas. Ele usa o mesmo OCID de perfil e o mesmo ponto final regional do exemplo de Conclusões de Chat.

  1. Salve o seguinte código como routing-responses-api.py no diretório de trabalho:
    """Use the Responses API with an OCI Generative AI routing profile."""
    
    from __future__ import annotations
    
    import os
    from getpass import getpass
    
    from openai import OpenAI
    
    
    def main() -> None:
        region = os.environ.get("OCI_REGION", "us-chicago-1")
        profile_ocid = os.environ["OCI_ROUTING_PROFILE_OCID"]
        api_key = os.environ.get("OCI_GENAI_API_KEY") or getpass(
            "OCI Generative AI API key: "
        )
        client = OpenAI(
            base_url=f"https://inference.generativeai.{region}.oci.oraclecloud.com/openai/v1",
            api_key=api_key,
        )
    
        messages: list[dict[str, str]] = []
        print("Responses with a routing profile. Type 'exit' to stop.\n")
    
        while True:
            try:
                prompt = input("You: ").strip()
            except (EOFError, KeyboardInterrupt):
                print("\nGoodbye!")
                break
    
            if prompt.lower() in {"exit", "quit"}:
                print("Goodbye!")
                break
            if not prompt:
                continue
    
            messages.append({"role": "user", "content": prompt})
            answer_parts: list[str] = []
    
            try:
                with client.responses.create(
                    model=profile_ocid,
                    input=messages,
                    stream=True,
                ) as stream:
                    selected_region = stream.response.headers.get(
                        "x-genai-selected-region"
                    )
                    print(f"Served from OCI region: {selected_region or 'not reported'}")
                    print("Assistant: ", end="", flush=True)
    
                    for event in stream:
                        if event.type == "response.output_text.delta":
                            answer_parts.append(event.delta)
                            print(event.delta, end="", flush=True)
            except Exception as error:
                messages.pop()
                print(f"\nRequest failed: {error}\n")
                continue
    
            answer = "".join(answer_parts)
            if answer:
                messages.append({"role": "assistant", "content": answer})
            else:
                messages.pop()
            print("\n")
    
    
    if __name__ == "__main__":
        main()
  2. Com o ambiente virtual ativado, execute o script:
    python routing-responses-api.py
  3. Informe um prompt e um acompanhamento e, em seguida, informe exit para interromper.
    O script transmite eventos response.output_text.delta. Ele mantém o histórico de conversas localmente e o reenvia em cada turno; ele não usa previous_response_id nem uma conversa gerenciada pelo servidor. Outros tipos de evento são ignorados.

Verificar o Resultado e a Solução de Problemas

Em ambos os scripts, insira um prompt como Explain model routing in two sentences. A resposta do assistente deve ser transmitida para o terminal. Se o OCI retornar x-genai-selected-region, o script exibirá a região que atendeu à solicitação. Pode ser diferente de Chicago, a região do ponto final da API, mas deve ser uma das regiões de destino no perfil.

Ambos os exemplos ignoram prompts vazios. Digite exit ou quit, pressione Ctrl+C ou envie o fim da entrada no prompt para interromper. O histórico só é retido enquanto o script está em execução.

SintomaO que verificar
Erro de autenticação ou autorização Verifique a chave da API do OCI Generative AI, sua região e acesso, permissão de leitura de perfil de roteamento e a permissão para a operação de inferência.
Perfil não encontrado ou valor de modelo inválido Use o OCID de perfil completo em OCI_ROUTING_PROFILE_OCID. Confirme se o perfil está Ativo e se o OCI_REGION aponta para a região do ponto final que você pretende chamar.
API ou parâmetro de solicitação não suportados Confirme se o modelo selecionado do perfil suporta a API usada pelo script. Este tutorial não requer um parâmetro reasoning específico do modelo.
A solicitação não pode ser atendida Verifique se o modelo selecionado está disponível nas regiões de destino do perfil e revise o erro retornado.
A região de serviço é not reported O script não encontrou x-genai-selected-region nos cabeçalhos de resposta. Verifique a resposta e o comportamento do serviço; não deduza apenas a região de serviço do ponto final da API.

Os exemplos mostram solicitações baseadas em perfil e texto de streaming. Eles não definem ou verificam uma prioridade de roteamento, um algoritmo de balanceamento de carga ou uma política de failover.