关于并行复制
Parallel Replicat 是 Replicat 的另一个变体,它并行应用事务以提高性能。
它考虑事务处理之间的相关项,类似于 Integrated Replicat。相关性计算、映射和应用的并行性在数据库外部执行,因此可以卸载到其他服务器。在此过程中维护事务处理完整性。此外,并行复制还支持通过将大型事务拆分为块并并行应用大型事务来并行应用大型事务。
并行复制支持以下两种模式:集成模式和非集成模式。只有 Oracle AI Database 在集成模式下支持并行复制。
要使用并行复制,您需要确保具有以下值,这些值也是默认值:
-
线索中的元数据(这意味着如果线索的格式低于 12.1,则无法使用并行复制)。
-
您的线索文件中必须有计划列。
-
必须使用
UPDATERCORDFORMAT COMPACT。
使用集成的并行复制,复制会将 LCR 发送到入站服务器,该服务器将数据应用于目标数据库,在常规并行复制中,Oracle GoldenGate 将 LCR 作为 SQL 语句直接应用于数据库,类似于其他非集成复制的工作方式。注:为了获得 OLTP 工作负载的最佳性能,建议在非集成模式下使用并行复制。
并行复制的组件包括:
-
映射器并行运行以读取线索、映射线索记录、将映射的记录转换为集成复制 LCR 格式,并将 LCR 发送到合并器以供进一步处理。一个映射器映射一组事务时,下一个映射器映射下一组事务。线索信息被拆分,线索文件不会受到影响,因为它按顺序对线索信息进行排序。
-
主进程有两个线程,即 Collater 和 Scheduler。抵押品从映射器接收映射的事务处理,并将它们重新置于线索顺序中以进行相关性计算。调度器计算事务处理之间的相关性,将事务处理分组为独立的批,并将批发送到要应用于目标数据库的供应商。
-
供应商对批中的记录重新排序以执行数组。它将批处理应用于目标数据库并执行错误处理。它还跟踪检查点表中的已应用事务处理。注:并行复制要求为任何外键列编制索引。
并行复制的优点
以下是使用并行复制的优点:
-
集成并行复制允许在并行应用进程之间自动分区重负载,这些并行应用进程同时应用多个事务,同时保留源事务的完整性和原子性。可以同时使用
PARALLELISM和MAX_PARALLELISM参数配置最小和最大应用进程数。当工作量增加时,复制会自动添加其他服务器,然后在工作量减少时再次向下调整。 -
集成的并行复制需要最少的工作来配置。所有工作都在一个 Replicat 参数文件中配置,而无需配置范围分区。
-
通过在 Replicat 和入站服务器之间使用轻量级应用编程接口 (API),为集成的并行复制启用高性能应用流。
-
屏障事务通过多个服务器应用进程之间的集成并行复制进行协调。
-
DDL 操作将作为直接事务进行处理,这些事务通过等待服务器处理在 DDL 执行之前完成来强制屏障。
-
临时重复主键更新由集成的并行复制以无缝方式进行处理。
-
并行复制可以将单个大型事务处理分成较小的块并并行应用这些块。有关详细信息,请参见 SPLIT_TRANS_RECS 。
并行复制体系结构
并行复制进程利用在集成模式下 Oracle AI Database 中可用的应用处理功能。在单个复制配置中,多个入站服务器子进程(称为应用服务器)并行执行事务处理,同时保留原始事务处理原子性。
下面的体系结构图描述了从线索文件到目标数据库的并行复制(对于非集成的并行复制)的各个进程中的更改记录流。
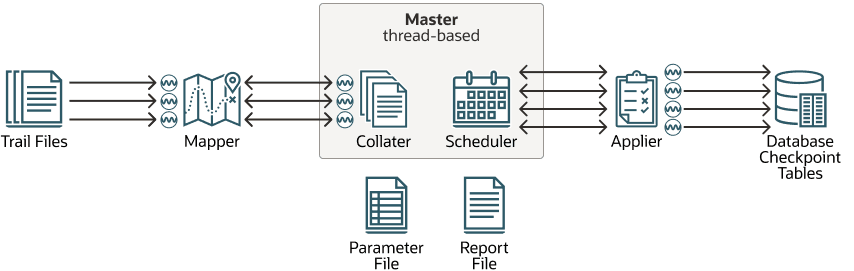
下面是上面给出的体系结构图的说明:
-
映射器读取线索文件和映射记录,将映射的记录转发到主记录。批将发送到应用到目标数据库的 Appliers。
-
主进程由两个单独的线程组成,即 Collater 和 Scheduler。抵押品负责管理和与映射器通信,同时接收映射的交易,并将它们重新排序到单个订单流中。排程引擎负责管理和与 Appliers 通信,以及从 Collater 读取交易,进行批处理,并将它们安排给 Appliers。
-
调度程序控制器与调度程序通信,以收集任何必要的信息(例如,当前的低水位)。Oracle AI Database 的 CDB 模式需要调度程序控制器,因为它负责聚合与不同目标 PDB 有关的信息并报告统一的图片。创建调度程序控制器是为了实现的简单性和一致性,即使未处于 CDB 模式也是如此。每个进程都会读取参数文件并共享单个检查点文件。
并行复制的基本参数
下表列出了基本并行复制参数及其说明。
| 参数 | 说明 |
|---|---|
|
|
配置映射器数。这将控制用于读取线索文件的线程数。最小值为 1,最大值为 100,默认值为 2。 |
|
|
配置供应商数。这将控制目标数据库中用于应用更改的连接数。默认值为四个。 |
|
|
应用并行性是自动优化的。您可以设置最小值和最大值以定义复制自动调整其并行性的范围。没有默认值。不要同时与 |
|
|
指定应将大型事务处理分成指定大小的段并并行应用。各个部分之间的依赖关系仍然得到尊重。默认情况下处于禁用状态。 |
|
|
启用提交完全序列化模式,强制按线索顺序提交事务处理。 |
|
高级参数 |
|
|
|
控制在批处理事务处理时排程引擎的显示距离。默认值为 10000。 |
|
|
控制并行复制要将其视为大事务处理,事务处理必须有多大。当并行复制遇到大于此大小的事务处理时,它将对其进行序列化,从而导致性能下降。但是,增加此值也会增加并行复制占用的内存量。 |
参数文件示例
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;