關於平行 Replicat
平行 Replicat 是 Replicat 的另一種變化形式,可平行套用交易以提升效能。
考量交易之間的相依性,類似於整合式 Replicat。對應與套用的相依性運算、平行性是在資料庫外部執行,因此可以卸載至其他伺服器。交易完整性在此處理中維護。此外,平行 Replicat 可將大型交易分割成區塊並平行套用,以支援平行套用大型交易。
平行 Replicat 支援下列兩種模式:「整合式」和「非整合式」。唯有 Oracle AI Database 支援整合模式中的平行 Replicat。
若要使用平行 Replicat,您必須確定具有下列值,這些值也是預設值:
-
歷程檔中的描述資料 (這表示如果歷程檔的格式低於 12.1,就無法使用平行 Replicat)。
-
歷程檔中必須有排程資料欄。
-
您必須使用
UPDATERCORDFORMAT COMPACT。
在整合的平行 Replicat 中,Replicat 會將 LCR 傳送至將資料套用至目標資料庫的內送伺服器,而在一般平行 Replicat 中,Oracle GoldenGate 會直接將 LCR 套用為資料庫的 SQL 敘述句,類似於其他未整合 Replicat 的運作方式。注意:為了獲得 OLTP 工作負載的最佳效能,建議使用非整合模式的平行 Replicat。
平行 Replicat 的元件包括:
-
對應程式會以平行方式運作,以讀取歷程檔、對應歷程檔記錄、將對應的記錄轉換成 Integrated Replicat LCR 格式,然後將 LCR 傳送至 Merger 以進一步處理。當一個「對應程式」對應一組交易時,下一個「對應程式」會對應下一組交易。歷程檔資訊會被分割,而且歷程檔不會受到影響,因為它會依序排列歷程檔資訊。
-
主要處理作業有兩個繫線:Collater 和 Scheduler。Collater 會從對應程式接收對應的交易,並將它們放回相依性計算的追蹤順序中。「排程器」會計算交易之間的相依性、將交易分組為獨立的批次,以及將批次傳送至要套用至目標資料庫的「極端值」。
-
異常值會重新排序批次內的記錄以執行陣列。它會將批次套用至目標資料庫,並執行錯誤處理。它也會追蹤檢查點表格中已套用的交易。注意:平行 Replicat 需要編製任何外來索引鍵資料欄的索引。
平行 Replicat 的優點
以下為使用平行 Replicat 的優點:
-
整合式平行 Replicat 可在同時套用多個交易的平行套用處理作業之間,自動分割繁重的工作負載,同時保留來源交易的完整性與單元性。可以使用
PARALLELISM和MAX_PARALLELISM參數設定套用處理作業的數目下限和上限。當工作負載增加時,Replicat 會自動新增其他伺服器,然後在工作負載減少時再次調整。 -
整合式平行 Replicat 需要最少的工作才能設定。所有工作都是在一個 Replicat 參數檔內設定,但不設定範圍分割區。
-
透過 Replicat 與內送伺服器之間的輕量型應用程式設計介面 (API),啟用整合式平行 Replicat 的高效能套用串流。
-
屏障交易由多個伺服器套用處理作業間的整合平行 Replicat 協調。
-
DDL 作業會以直接交易的形式處理,此直接交易會在 DDL 執行之前等待伺服器處理完成,以強制阻礙。
-
整合式平行 Replicat 會以無縫接軌的方式處理暫時重複的主索引鍵更新。
-
平行 Replicat 可以將單一大型交易分成較小的區塊,並平行套用這些區塊。請參閱 SPLIT_TRANS_RECS 瞭解詳細資訊。
平行複製架構
平行複製處理作業會利用整合模式中 Oracle AI Database 內可用的套用處理功能。在單一 Replicat 組態內,多個內送伺服器子項處理作業 (稱為套用伺服器) 會平行套用交易,同時保留原始的交易原子性。
下列架構圖說明透過平行複製 (從歷程檔到目標資料庫) 的各種處理作業,對非整合的平行 Replicat 進行變更記錄的流程。
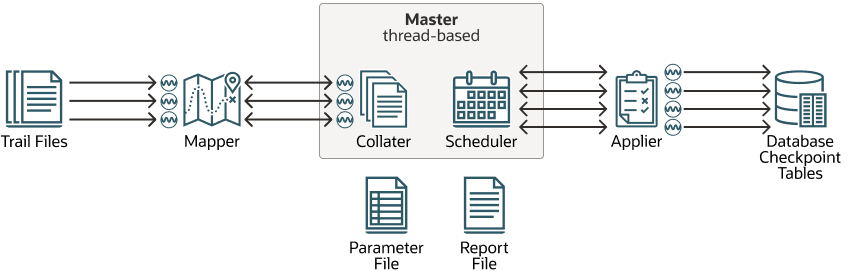
以下為上述架構圖的說明:
-
對應程式會讀取歷程檔並對應記錄,然後將對應的記錄轉送至主檔。批次會傳送至套用到目標資料庫的「極端值」。
-
「主要」處理由兩個個別的執行緒「文宣品」與「排程器」組成。Collater 負責管理與與對應程式通訊,並接收對應的交易,並將其重新排序至單一訂單資料流。「排程器」負責管理與與「極端值」通訊,以及從「文宣品」讀取交易、進行批次處理,以及將其排程至「極端值」。
-
Scheduler 控制器會與 Scheduler 通訊,以收集任何必要的資訊 (例如,目前的低浮水印位置)。Oracle AI Database 的 CDB 模式需要有 Scheduler 控制器,因為該控制器負責聚總與不同目標 PDB 有關的資訊,並報告統一的圖片。即使不是處於 CDB 模式,也會為實行建立 Scheduler 控制器以簡化和一致性。每個處理作業都會讀取參數檔,並共用單一檢查點檔案。
平行 Replicat 的基本參數
下表列出基本平行 Replicat 參數及其描述。
| 參數 | 說明 |
|---|---|
|
|
設定對應程式數目。這控制用來讀取歷程檔的繫線數目。最小值為 1,最大值為 100,預設值為 2。 |
|
|
設定極端值數目。這可控制目標資料庫中用來套用變更的連線數目。預設值為 4。 |
|
|
「套用」併行執行會自動調整。您可以設定最小值和最大值,以定義 Replicat 自動調整其併行執行的範圍。沒有預設值。請勿同時與 |
|
|
指定應將大型交易分為指定大小的片段並平行套用。片段之間的相依性仍然受到尊重。預設會停用此選項。 |
|
|
啟用確認完整序列化模式,以強制交易按照歷程檔順序確認。 |
|
進階參數 |
|
|
|
控制「排程器」在批次處理交易前的外觀。預設值為 10000。 |
|
|
控制平行 Replicat 的交易必須有多大,才能將它視為大交易。當平行 Replicat 遇到的交易大於此大小時,就會序列化它,進而降低效能。不過,增加這個值也會增加平行 Replicat 使用的記憶體量。 |
範例參數檔
REPLICAT repe USERID ggadmin, password ***
MAP_PARALLELISM 3
MIN_APPLY_PARALLELISM 2
MAX_APPLY_PARALLELISM 10
SPLIT_TRANS_RECS 60000
MAP *.*, TARGET *.*;