| Oracle® Fusion Middleware Oracle WebCenter Contentの管理 11g リリース1 (11.1.1) B72425-01 |
|


 前 |
 次 |
この付録では、Oracle WebCenter Content、および特にコンテンツ・サーバーの使用時に発生する可能性のある問題について説明します。この付録では、トラブルシューティング・プロセスで役立つ方法とツールについての情報を提供します。
|
注意: Inbound Refinery、Content Tracker、Records、WebCenter Contentリポジトリ、FoliosなどのOracle WebCenter Content機能のトラブルシューティングの詳細は、Oracle Fusion Middleware Oracle WebCenter Contentの管理を参照してください。 |
この付録では次の項について説明します。
この項では、この付録内の情報を使用するためのガイドラインとプロセスについて説明します。次のガイドラインおよびプロセスに従うことで、作業の焦点を問題解決に絞り、問題解決までの時間を短縮できます。
ガイドライン
この付録の情報を使用する際には、次のことをお薦めします。
この章の解決策を実行した後すぐに、このトラブルシューティング情報を利用するきっかけとなった失敗したタスクを再試行します。再試行してもタスクが失敗する場合、この章に記載されている他の解決策を実行し、再度失敗したタスクを実行します。このプロセスを問題が解決するまで繰り返します。
実行した解決策、確認された現象およびトラブルシューティング中に収集したデータを記録しておきます。この章の情報を使用しても問題が解決されずサービス・リクエストを記録することになった場合、これらの情報があると迅速な問題解決につながります。
プロセス
この付録の情報を利用する場合は、次に概要を示すプロセスに従ってください。特定の項の情報でも問題を解決できない場合は、このプロセスの次のステップに進んでください。
表A-1 この付録内の情報を使用するためのプロセス
| 手順 | 使用する項 | 目的 |
|---|---|---|
|
1 |
Oracle WebCenter Contentおよびコンテンツ・サーバー・インスタンスのトラブルシューティングを開始します。この項に示す手順によって、幅広い問題に迅速に対応できます。 |
|
|
2 |
|
コンテンツ・サーバーのアーカイブの問題に関する問題別トラブルシューティングの手順を実行します。この項では、次の内容について説明します。
|
|
3 |
|
My Oracle Supportを使用してその他のトラブルシューティング情報を取得します。My Oracle Supportから、ナレッジ・ベース記事、コミュニティ・フォーラム、ディスカッションを含むいくつかの有益なトラブルシューティング・リソースにアクセスできます。 |
|
4 |
|
この付録とMy Oracle Supportの情報では問題を解決できない場合に、サービス・リクエストを記録します。サービス・リクエストを記録するには、 |
この項では、トラブルシューティング・プロセスで役立つ有益で詳細な情報の様々なソースの使用についての情報を提供します。
Content Serverのロギングの詳細は、第III部「コンテンツ・サーバーの監視」を参照してください。
コンテンツ・サーバーのトレースをアクティブ化して、トラブルシューティングおよびシステム・パフォーマンスの最適化に非常に役立つ詳細なシステム情報を表示できます。
サーバー全体のトレースは、システム全体のアクティビティを表示するのに使用します。サーバー全体のトレースをアクティブ化する方法は2つあります。
コンテンツ・サーバー管理インタフェースからトレースをアクティブ化するには、次の手順を実行します。
「管理」、「システム監査情報」の順に選択します。
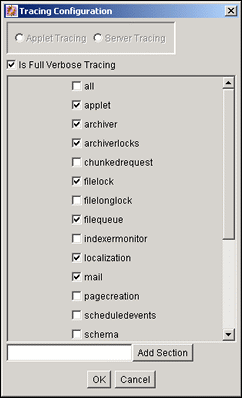
詳細出力をサポートするアクティブなセクションについて詳細なトレースを確認するには、「完全な詳細トレース」を有効にします。
トレースをアクティブ化するように指定します。
「更新」をクリックします。
「サーバー出力の表示」をクリックします。
|
ヒント: トレース・オプションは、システムを再起動する際に失われます。コンテンツ・サーバー・インスタンスの再起動後に設定を確実に保持するには、「保存」を有効にしてから「更新」をクリックします。 |
アプレットからトレースをアクティブ化するには、次の手順を実行します。
管理アプレットを起動します。
「オプション」の次に、「トレース」を選択します。
「サーバー・トレース」を選択します。
アクティブ化するトレースまたはすべてを選択し、「OK」をクリックします。
次のトレース・オプションが使用できます。コンポーネントを追加する場合、追加のトレース・セクションをリストに表示できます。
applet: このトレースには、構成マネージャやユーザー管理など、初期化されたアプレットからの結果セットが含まれます。
archiver: このトレースでは、アーカイバ・データ・ファイルの読取りと書込み、および、アクティビティの開始および終了時刻など、アーカイブ・アクティビティに関する情報が提供されます。
archiverlocks: このトレースでは、開始時刻など、アーカイブ・アクティビティ中にファイルに適用されるロックに関する情報が提供されます。
chunkedrequest: このトレースでは、大きいリクエストが小さいリクエストにチャンク化される際に作成されるメッセージおよびヘッダーが表示されます。
docprofile: このトレースでは、コンテンツ・プロファイルの計算、具体的には、どのフィールドがラベルであるか、非表示であるかなどを決定するルールの評価が表示されます。
encoding: このトレースでは、発生したエンコーディング変換およびエンコーディングが発生したアクティビティに関する情報が提供されます。
filelock: このトレースでは、発生する衝突およびタイムアウトに焦点を絞ったディレクトリに適用される短期のシステム・ロック(たとえばアーカイブなどのアクティビティ中)に関する情報が表示されます。
filelonglock: このトレースでは、システムが設定した長期のロックの作成、削除および保守に関する情報が表示されます。
filequeue: このトレースでは、ファイル・キューのアクセスに関する情報が表示されます。
indexer: このトレースでは、索引の更新のために実行されるステップ、および各ステップの経過時間など、データベースの更新時に発生する索引機能に関する情報が表示されます。
indexermonitor: このトレースでは、開始および終了時間など、自動索引アクティビティの要約が提供されます。
indexerprocess: このトレースでは、手動で起動した索引プロセスに関する情報が表示され、プロセスが正常に終了したかどうかが示されます。
localization: このトレースでは、ローカライズの使用状況およびアクティビティに関する情報が表示されます。
mail: このトレースでは、コンテンツ・サーバー・インスタンスによって送信されるメールについて説明します。
pagecreation: このトレースでは、サーバー・スレッド、およびページの生成にかかる時間など、表示されるページの作成に関する情報が表示されます。
requestaudit: このトレースでは、リクエストの経過時間、および作成されたリクエストの数など、サービス・リクエストに関するサマリー・レポートが提供されます。
scheduledevents: このトレースでは、毎時または日次のバックグラウンドのスケジュール化されたイベントのリストが提供されます。
schema: このトレースでは、スキーマのパブリッシュ(.jsファイルとしてパブリッシュされた表およびビュー)、およびキャッシュ(コンテンツ・サーバー・メモリーにキャッシュされた表)に関する情報が提供されます。
searchquery: このトレースでは、検索に使用されるフィールド、および結果のソート順など、最近の検索に関する情報が表示されます。
socketrequests: このトレースでは、ソケット・リクエストの日時とスレッド番号、およびリクエスト中のアクションが表示されます。
system: このトレースでは、システムのソケット・リクエストおよびレスポンスなど、内部システム・メッセージが表示されます。
systemdatabase: このトレースでは、実行された問合せ、索引の更新、使用されたスレッド、および開始時間など、データベース・アクティビティに関する情報が提供されます。
transfermonitor: このトレースでは、アーカイバおよびバッチ・ファイル転送アクティビティに関する情報が表示されます。
userstorage: このトレースでは、アクセス中に実行されたアクションなど、外部ユーザー・リポジトリのアクセスについて説明します。
workflow: このトレースでは、ドキュメント・タイトルおよびリビジョン番号など、ワークフローで処理されるコンテンツ・アイテム上のメタデータのリストが表示されます。
|
注意: 国際的なサポートを促進するため、ほとんどのトレース・メッセージは英語で出力され、翻訳されていません。 |
アプレット固有のトレースの場合、ブラウザのJavaコンソールに出力されます。アプレット別にトレースを実行するには、次の手順を実行します。
トレースする管理アプレットを起動します。
「オプション」の次に、「トレース」を選択します。
選択して、「OK」をクリックします。出力はブラウザのJavaコンソールに送られます。
スタック・トレースによって、コンテンツ・サーバー・インスタンス内で現在実行中のスレッドがわかります。これは、スレッドに関する情報を提供する有益なトラブルシューティング・ツールで、コンテンツ・サーバーの処理を監視できます。
コンテンツ・サーバー・インスタンスの現在のスタック・トレースを開始する手順は、Oracle WebLogic Serverのドキュメントを参照してください。
環境パッケージャは診断ツールです。それは、必要な状態ディレクトリ、ログ・ファイル、および他のコンポーネントやリソースのディレクトリのzipファイルを作成します。
環境zipファイルを作成するには、次の手順を実行します。
コンテンツ・サーバー・インスタンスに管理者としてログインします。
「管理」、「環境パッケージャ」の順に選択します。
「環境パッケージャ」ページで、パッケージ化する環境の部分を選択します。
環境zipファイルを作成する準備が完了したら、「パッケージングの起動」をクリックします。zipファイルの作成中は、zipファイルへのリンクとともにメッセージが表示されます。パッケージング・プロセスは数分かかる場合があります。プロセスが完了するまでは、zipファイルのリンクは使用できません。
|
注意: パッケージ化されたzipの名前は、server_environment_*.zipになります。コンテンツ・サーバー・インスタンスがパッケージ化されたzipファイルを作成している間、それは |
Content Serverアナライザ・アプリケーションによって、ファイル・システム、データベースおよび検索索引など、コンテンツ・サーバー・リポジトリ・コンポーネントの整合性を確認できます。また、リポジトリ・コンポーネントで検出された問題をシステム管理者が修正する場合にも役立ちます。
Content Serverアナライザを使用すると、システム管理者は次のことができます。
コンテンツ・サーバーの3つの重要なデータベース表(Revisions、DocumentsおよびDocMeta)の間の同期化の精度を確認します。
dRevClassIDフィールドおよびdDocNameフィールドが、すべてのリビジョンのコンテンツ・アイテム間で整合性がとれていることを確認します。
ファイル・システム(ネイティブ・ファイル・リポジトリおよびWeb表示可能ファイル・リポジトリ)に重複ファイルや欠落したファイルがあるかどうかを判別します。
検索索引とファイル・システム間の整合性の精度を確認します。
検索索引とRevisionsデータベース表間の整合性の精度を確認します。
ファイル・システムに必要なすべてのファイルが含まれていることを確認します。
重複ファイルを、ログ/ディレクトリに移動することによって、コンテンツ・サーバー・リポジトリから永久または一時的に削除します。
コンテンツ・サーバー・リポジトリにコンテンツ・アイテムの状態で、一般的なレポートを作成します。
Content Serverアナライザの起動方法は、オペレーティング・システムに応じて異なります。
「スタート」、「Oracle Content Server」、インスタンス、「Content Serverアナライザ」の順に選択します。
UNIX: DomainHome/ucm/cs/binディレクトリにナビゲートし、Content Serverアナライザ・プログラムを実行します。
次の項では、Content Serverアナライザのタスクについて説明します。
Content Serverアナライザを表示するには、次の方法のうちの1つを使用します。
Windows: 「スタート」、「プログラム」、「コンテンツ・サーバー」、インスタンス、「ユーティリティ」、「Content Serverアナライザ」の順に選択します。
UNIX: DomainHome/ucm/cs/binディレクトリに変更し、シェル・ウィンドウで「IdcAnalyze」と入力して、キーボードで[RETURN]キーを押します。
Content Serverアナライザ・アプリケーションが表示されます。
logs/ディレクトリは、Content Serverアナライザのデフォルトのロギング・ディレクトリです。解析の出力ファイルはこのディレクトリに書き込まれ、ファイル・システムの解析プロセス中に検出される追加のファイルもここに転送できます。オプションで、必要に応じて、デフォルトのlogs/ディレクトリの名前およびパスを変更できます。
アナライザのログ・ディレクトリの名前およびパスをカスタマイズするには、次の手順を実行します。
「Content Serverアナライザ」の「構成」タブで、「Analyzerのログ・ディレクトリ」フィールドにカーソルを置きます。
目的のディレクトリ・パスを入力します。次の解析プロセス中、Content Serverアナライザによって、DomainHome/ucm/cs/bin/ディレクトリ階層内に指定したディレクトリが自動的に作成されます。
解析プロセスを起動するには、次の手順を実行します。
「Content Serverアナライザ」の「構成」タブで、必要なオプションを選択およびアクティブ化します(対応するチェック・ボックスをチェックします)。
「解析の開始」をクリックします。
|
注意: Content Serverアナライザを初めて実行した場合、 |
「はい」をクリックして、既存のログ・ファイルを上書きします。「Content Serverアナライザ」の「進行状況」タブが自動的に表示されます。選択したすべての解析プロセスが終了すると、完了メッセージが表示されます。
|
注意: 「いいえ」をクリックした場合、解析プロセスは終了し、Content Serverアナライザを再度実行する前に、 |
「OK」をクリックします。結果は、「進行状況」タブのコンソール領域に表示されます。
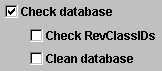
「RevClassIDのチェック」および「データベースのクリーン」オプションは、データベース列の整合性をチェックするのに使用されます。使用可能なオプションによって、コンテンツ・アイテムのリビジョン情報を格納するのに使用される3つの表(DocMeta、DocumentsおよびRevisions)を調査できます。Revisions表で見つからない追加のエントリについて、DocMetaファイルを調査します。同様に、Revisions表のエントリに対応するのに十分なエントリがあることを確認するために、Documents表を調査します。
|
注意: 「データベースのチェック」オプションが選択されている場合のみ、「RevClassIDのチェック」および「データベースのクリーン」オプションはアクティブ化され、選択可能になります。 |
コンテンツ・サーバー・データベースを分析するには、次の手順を実行します。
「Content Serverアナライザ」の「構成」タブで、適用可能なオプションを選択します。
「解析の開始」をクリックします。結果は、「Content Serverアナライザ」の「進行状況」タブのコンソール領域に表示されます。解析手順の詳細は、A.2.4.3項「解析プロセスの起動」を参照してください。
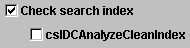
「検索索引のチェック」およびcsIDCAnalyzeCleanIndexオプションは、索引に属するすべてのドキュメントが正しくリストされていることを確認するために、Revisions表のエントリをチェックするのに使用されます。また、検索索引に重複エントリがないことを確認するために、チェックを実行できます。
|
注意: 「検索索引のチェック」オプションが選択されている場合のみ、csIDCAnalyzeCleanIndexオプションはアクティブ化され、選択可能になります。 |
コンテンツ・サーバー検索索引を分析するには、次の手順を実行します。
「Content Serverアナライザ」の「構成」タブで、適用可能なオプションを選択します。
「解析の開始」ボタンをクリックします(解析手順の詳細は、第A.2.4.3項を参照してください)。結果は、「Content Serverアナライザ」の「進行状況」タブのコンソール領域に表示されます。
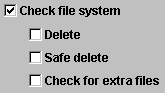
「ファイル・システムのチェック」、「削除」、「安全な削除」および「追加ファイルのチェック」オプションは、ファイル・システム(Webレイアウト・ファイル・リポジトリおよびボールト・ファイル・リポジトリ)の整合性をチェックするのに使用されます。データベース内の情報を使用すると、これらのオプションによって、Revisions表内のすべてのファイルにはファイル・システムのアイテムに対応している正確なエントリが格納されていることを確認できます。ボールト・ファイル・リポジトリおよびWebレイアウト・ファイル・リポジトリ内で追加ファイルを検索するために、チェックを実行することもできます。
|
注意: 「ファイル・システムのチェック」オプションが選択されている場合のみ、「削除」、「安全な削除」および「追加ファイルのチェック」オプションはアクティブ化され、選択可能になります。 |
コンテンツ・サーバー・ファイル・システム(ボールト・ファイル・リポジトリおよびWebレイアウト・ファイル・リポジトリ)を分析するには、次の手順を実行します。
「Content Serverアナライザ」の「構成」タブで、適用可能なオプションを選択します。
「解析の開始」をクリックします。結果は、「Content Serverアナライザ」の「進行状況」タブのコンソール領域に表示されます。解析手順の詳細は、第A.2.4.3項を参照してください。
「解析の開始」ボタンをクリックすると、「Content Serverアナライザ」の「進行状況」タブが自動的に表示されます。進行状況バーには、Content Serverアナライザが選択された分析オプションの処理を完了したタイミングが表示されます。次のイメージは、部分的に終了した分析を示しています。
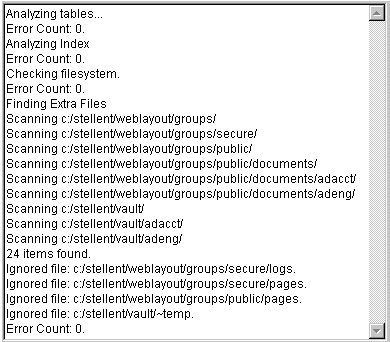
解析プロセスが完了すると、結果は「進行状況」タブのコンソール領域に表示されます。結果は、選択した分析オプションに応じて異なります。次のコンソール領域のイメージは、データベース、検索索引およびファイル・システムのオプションを選択した場合の結果を示しています。
Content Serverアナライザによって生成されるステータス・レポートでは、リポジトリ内のコンテンツ・アイテムに関する統計が提供されます。ステータス・レポートの出力は、「進行状況」タブのコンソール領域に表示されます。
ステータス・レポートを生成するには、次の手順を実行します。
「Content Serverアナライザ」の「構成」タブで、「レポートの生成」を選択します。
「解析の開始」をクリックします。解析プロセスが完了すると、「Content Serverアナライザ」の「進行状況」タブのコンソール領域に、標準的な解析結果の直後にステータス・レポート情報が表示されます。
解析プロセスの開始後に、レポート生成機能を抑制できます。解析プロセス中にコンテンツ・アイテムのステータス・レポートを取り消すには、次の手順を実行します。
解析プロセス中に、Content Serverアナライザ・アプリケーションで、「取消」をクリックします。現在のタスクの終了後に取消を行うよう求められます。
「はい」をクリックして、ステータス・レポートを抑制します。「進行状況」タブのコンソール領域に表示される解析結果には、ステータス・レポートが含まれません。
コンテンツ・サーバー・インスタンスでは、設定すると適切な診断情報をもたらすデバッグ構成変数IsDevelopmentEnvironmentも提供されます。この構成変数はインストール中およびコンテンツ・サーバー・インスタンスの更新時に、コンテンツ・サーバー・インスタンスの構成ファイル(IntradocDir/config/config.cfg)に設定されます。IsDevelopmentEnvironmentは、次のことを実行します。
コンテンツ・サーバー・インスタンスをデバッグ・モードで実行する必要があるかどうかを定義します。
スクリプト・エラーのトレースを有効にします。サービス・コールへのパラメータとして使用する場合、表示されるページの下部にスクリプト・エラー情報を追加できます。
同様にコンテンツ・サーバー・インスタンスの構成ファイル(IntradocDir/config/config.cfg)で設定されるデバッグ構成変数AlwaysReportErrorPageStackTraceは、エラーの発生時にコンテンツ・サーバーのユーザー・インタフェースを表示するブラウザにスタック・トレースが報告されるよう指定します。
|
注意: 詳細は、Oracle Fusion Middleware Oracle WebCenter Content構成リファレンスを参照してください。 |
WebCenter Content管理者は、コンテンツ・サーバーの問題をトラブルシューティングする際に.hda (HDA)ファイルを分析する必要が生じる場合があります。HyperData(HDA)ファイルは、構造化された単純なASCIIファイル形式で、プロパティおよび表データを定義するために使用されます。これは、どのコンポーネントが有効および無効になっているか、またそのコンポーネントの定義ファイルがどこにあるかを判別するために、コンテンツ・サーバーによって使用されるテキスト・ファイル(ファイル名に含まれる接尾辞.hdaによって識別される)です。HDAファイル形式が役立つのは、頻繁に変わるデータです。それは、サイズがコンパクトで形式が単純であれば、コンテンツ・サーバーでデータ通信が、より高速かつ簡単になるからです。HDAの構造と使用法の詳細は、Oracle Fusion Middleware Oracle WebCenter Contentによる開発を参照してください。
HDAを読み取るためのオプションの1つは、ページURLにIsPageDebug=1オプションを追加することです。IsPageDebug=1が使用されると、小さなグレーのタブがブラウザ・ウィンドウの右下隅に表示されます。タブをクリックすると展開されるため、表示する情報を選択できます。
idocscript trace: 以前にOracle Universal Content Management 10gR1リリースのScriptDebugTrace=1変数で表示できたネストされたインクルードを表示します。
initial binder: ページURLに&IsJava=1オプションを追加することで表示されるのと同様の、サービスから返されるローカル・データと結果セットを表示します。この表示では、結果は生HDA形式ではなく、読みやすいテーブルとしてフォーマットされます。
final binder: ページ表示のためのすべてのインクルード(サービス・コールからだけではなく)を実行した後に、すべてのローカル・データと結果セットを表示します。
javascript log: javascript関数とページ上で実行された回数についてレポートします。
詳細は、https://blogs.oracle.com/kyle/entry/what_do_you_mean_youにあるHDAが読めない場合のOracle Webページを参照してください。
この項では、コンテンツ・サーバーの一般的なアーカイブ問題に対する解決策を示します。サポートに問い合せる前に、お薦めされている解決策をお試しください。
この章の内容は、次のとおりです。
この項の内容は次のとおりです。
現象
インポート先のシステムで、ドキュメントに関連する転送およびファイル拡張子の問題があることを示すエラーが発生します。
問題
次のエラーがアーカイバ・ログに発行されました。
Error: Event generated by user <user_name> at host <host_name>. File I/O error. Saving to file collection.hda. Write error.
Error: Import error for archive <archive_name> in collection <collection_name>:
Content item <item_name> was not successfully checked in. The primary and
alternate files must have different extensions.
推奨事項
エクスポート側のI/Oエラーによってバッチ・ファイルが破損したために、インポート側でのファイル拡張子エラーが発生しています。考えられる解決策は次のとおりです。
テキスト・エディタでバッチ・ファイルを開いて、無効なデータがないか確認します。エクスポートしたcollection.hdaファイルを削除し、手動でエクスポートおよびインポート機能を再実行してみてください。
エクスポート側のサーバーで、該当するcollection.hdaファイルを開いて、ファイル拡張子エラーの原因となったコンテンツ・アイテムに関連付けられている行を探します。これらのコンテンツ・アイテムのリビジョンによっては、代替ファイルの場所に示されたボールトの場所にネイティブ・ファイルが存在する可能性があります。代替ファイルにもフォーマット・エントリがある可能性があります。これらの行を削除して、ファイルを再インポートします。
インポート側のサーバーで、コンテンツ・サーバーの構成ファイルconfig.cfg(IntradocDir/config/config.cfg)に代替拡張子構成設定を追加します。
IntradocDir/config/config.cfgファイルをテキスト・エディタで開きます。
General Option Variablesというセクションを見つけます。
次の構成設定を入力します。
AllowSamePrimaryAlternateExtensions=true
この構成設定により、チェックインされたコンテンツ・アイテムは代替ファイルとプライマリ・ファイルの両方に同じドキュメント拡張子を使用できるようになります。
config.cfgファイルを保存して閉じます。
|
注意: この構成設定をエクスポート側のサーバーのコンテンツ・サーバー |
コンテンツ・サーバー・インスタンスを再起動します。
質問
アーカイバ・ユーティリティの「一般」タブから特定のバッチ・ファイルを選択して再実行する際に、バックアップ目的で必要な他のファイルを削除せず残すにはどうすればよいですか。
推奨事項
最も効率的な方法は、新しいコレクションを作成して対象のアーカイブを新しいコレクションにコピーし、そこからインポートを実行することです。
現象
アーカイブ・コレクションへのインポート中に、値の変更を構成してメタデータ値を変更しました。しかし、転送後にインポート時の変更設定が機能しません。
問題
メタデータ値が構成済のメタデータ値変更を反映していませんでした。
推奨事項
ファイルをアーカイブにエクスポートし、後でそのアーカイブからインポートする場合に、メタデータ値の変更が保持されるようにするには、転送プロセスの両方の側で値の変更を構成する必要があります。つまり、ソース(エクスポート側)サーバーとターゲット(インポート側)サーバーの両方で、同じように値の変更を構成する必要があります。
質問
システム・クラッシュが発生したため、ドキュメントのコンテンツ情報(メタデータ)は変更せずに、古いアーカイブから新しいアーカイブにコンテンツをインポートする必要があります。この指定を使用するすべてのドキュメントが(実際は古いアーカイブから取得されたものであるが)新規のインポートであることを示すには、各コンテンツ・アイテムの先頭にどのように文字または数字を使用すればよいですか。
推奨事項
アーカイブ済のドキュメントは、再インポートして、他のインポート済コンテンツ・アイテムと区別するための適切なマークを付けることができます。これには、コンテンツIDメタデータ・フィールドを使用してインポート時の変更設定を適用します。インポート時の変更設定では、インポート中にメタデータ・フィールド間で値をどのようにコピーするかを構成できます。インポート時の変更設定を設定する手順は、次のとおりです。
アーカイバ・ユーティリティの「インポート時の変更設定」タブで、「フィールドの変更」セクションの「編集」をクリックします。
「値マップの編集」ページで、「すべて」を選択します(「入力値」フィールドは空白のままにしておきます)。
「フィールド」リストから「コンテンツID」を選択します。
「出力値」フィールドに、X<$dDocName$>と入力します。
ここで、Xは再インポートされたコンテンツ・アイテムを区別するための文字または数字であり、dDocNameはドキュメントのコンテンツIDのデータベース表フィールド値です。
「OK」をクリックします。
アーカイブを再インポートした後、Xに使用した文字または数字を各コンテンツ・アイテムのコンテンツIDに追加する必要があります。必ず、ソース(エクスポート側)サーバーとターゲット(インポート側)サーバーの両方に同じ値の変更を構成してください。これにより、ファイルがアーカイブからインポートされるときに、メタデータ値の変更が保持されます。
現象
コンテンツ・アイテムをチェックインまたはインポートしようとすると、次のエラー・メッセージが発行されます。
Content item already exists.
推奨事項
このエラーは、コンテンツIDに対して同じ自動採番スキームを使用しているコントリビューション・サーバー間でアーカイブを行うと発行されます。次に例を示します。
コンテンツID 003がコンテンツ・サーバー・インスタンスAにチェックインされ、その後でコンテンツ・サーバー・インスタンスBにアーカイブされたとします。あるファイルがコンテンツ・サーバー・インスタンスBにチェックインされた場合、次に自動生成された番号が003であると、エラーが発生します。
コンテンツID 005 がコンテンツ・サーバー・インスタンスAとコンテンツ・サーバー・インスタンスBの両方にチェックインされたとします。この同じコンテンツ・アイテムがコンテンツ・サーバー・インスタンスAからコンテンツ・サーバー・インスタンスBにアーカイブされると、エラーが発生します。
考えられる解決策は次のとおりです。
インポートされたファイルのコンテンツIDに接頭辞が追加されるように、インポート値の変更を設定します。解析手順の詳細は、第A.3.1.4項を参照してください。
各コンテンツ・サーバー・インスタンスで、システム・プロパティ・ユーティリティを使用して、チェックインされたコンテンツ・アイテムに対する自動採番接頭辞を設定します。
システム・プロパティ・ユーティリティを起動します。
「オプション」タブを開きます。
「チェックイン時にコンテンツIDを自動割当てする」を選択します。
「自動的に名前の前に付ける接頭辞」フィールドに対象の接頭辞を入力します。
「OK」をクリックします。
コンテンツ・サーバー・インスタンスを再起動します。
現象
エクスポート済アーカイブからプロキシ・コンテンツ・サーバー・インスタンスにコンテンツをインポートしようとすると、インポートが失敗します。
推奨事項
アーカイバの問題の詳細は、(コンテンツ・サーバー・インスタンスの「管理」ページからアクセス可能な)アーカイバ・ログを開いて参照してください。これらのログには、メッセージのタイプと、記録されたメッセージに関する説明情報が示されています。
たとえば、アーカイバ・ログに、使用できないメタデータ・フィールド・オプション値がインポート問題に関連していると示されている場合、(「管理」ページからアクセス可能な)構成マネージャの「情報フィールド」タブで、メタデータ・フィールドの構成済オプション・リストに関する情報を確認できます。
この情報を使用して、エクスポート側サーバーとインポート側サーバーの両方で、オプション・リストと問題のメタデータ・フィールドを比較します。違いがある場合、一方のサーバーで修正を行えば両方のオプション・リストが同じになります。これにより、使用できないオプションによる不一致が解決されます。
現象
インポート機能を実行すると、エラーは発行されないのに、一部のドキュメントがインポートされません。
問題
開発サーバーから428個のドキュメントを構成情報(メタデータ・フィールド)とともにエクスポートしました。その後、アーカイブをメインの本番サーバーに転送し、インポートを実行しました。エラーが発行されなかったので、すべて正常に完了したと思っていました。ところが、ドキュメントを検索したところ、実際には最初の428個のうち198個しかインポートされていませんでした。
推奨事項
この問題の推奨される解決策は、次のとおりです。
検索索引にすべてのMicrosoft Wordドキュメントが含まれていることを確認します。
検索コンポーネントの特定のバージョンでは、検索索引に埋込みリンクがあるMicrosoft Wordドキュメントは除外されます。このため、これらのファイルは検索問合せで見つかりません。
影響を受けるドキュメントからすべての埋込みリンクを削除するか、次の構成設定をIntradocDir/config/config.cfgに追加できます。
CheckMkvdkDocCount=true
この構成設定により、すべてのWordファイルが検索索引に含められます。ただし、フルテキストではなくメタデータのみが含められます。
最初のドキュメント・セットをエクスポートしてみて、ソース・ファイルが削除されることを確認してください。その後、エクスポートしたアーカイブを再インポートします。
現象
インポートが失敗します。
問題
システムにより、無効な選択リスト値があることを示すエラー・メッセージが発行されます。現在、値の構成および管理には、依存選択リスト・アプレットのオプション・リストを使用しています。
推奨事項
オプション・リストに対して特定のメタデータ分類法が確立されたために、互いに依存するフィールドが存在していると考えられます。この場合、以前のオプション・リストで選択された値に基づいて、オプション・リスト内の特定の値が使用可能になります。ところが、アーカイバを使用する場合、オプション・リスト内の依存性がコンテンツ・サーバー・インスタンスのカスタム・メタデータ・フィールドの処理能力と競合することは明らかです。
この競合を回避する方法は、依存選択リスト・アプレットではなくコンテンツ・サーバー・インスタンスの構成マネージャ・ユーティリティを使用することです。このためには、構成マネージャの「情報フィールド」タブでメタデータ・フィールドおよび対応するオプション・リスト値を入力する必要があります。
コンテンツ・サーバー・インスタンスに管理者としてログインします。
「管理」→「構成マネージャ」を選択します。
「構成マネージャ」ウィンドウで、「情報フィールド」タブを選択します。
「追加」ボタンをクリックし、カスタム情報フィールドの追加ダイアログにメタデータ・フィールド名の1つを入力します。
「OK」をクリックします。
必要に応じてカスタム情報フィールドの追加ダイアログで残りのフィールドに入力します。
「オプション・リスト・タイプ」フィールドで「NVタイプの選択リスト」オプションを選択します。
このオプションを使用すると、「オプション・リストの使用」に現在入力されている値と一致しない特定の値がコンテンツに含まれていても、コンテンツはその特定の値とともにチェックインされます。「オプション・リストの使用」フィールドには、ユーザーが特定のフィールドの値の選択に使用できる値リストの名前が示されます。
「OK」をクリックします。
「データベース設計の更新」をクリックします。
「検索索引の再構築」をクリックします。
インポート・プロセスの継続中は、この方法を使用してください。
現象
アーカイバを使用してドキュメントをエクスポートしました。その後、それらをインポートしようとすると、プロセスが失敗します。
問題
以前にエクスポートしたドキュメントをインポートしようとすると、コンテンツ・サーバーで、Companyメタデータ・フィールドが必要であることを示すエラーが発行されます。
推奨事項
コンテンツ・サーバー・インスタンスの構成マネージャ・ユーティリティを使用してCompanyフィールドを編集し、これを必須でないフィールドに設定する必要があります。
コンテンツ・サーバー・インスタンスに管理者としてログインします。
「管理」→「構成マネージャ」を選択します。
「構成マネージャ」ウィンドウで、「情報フィールド」タブを選択します。
「フィールド」リストからCompanyメタデータ・フィールドを選択します。
「編集」をクリックします。
カスタム情報フィールドの編集ウィンドウで、「値が必要」の選択を解除します。
「OK」をクリックします。
「データベース設計の更新」をクリックします。
「検索索引の再構築」をクリックします。
これで、アーカイブを正常に再インポートできるようになります。
現象
製品名の一部が変更されたため、影響を受けるドキュメント内のメタデータ・フィールドの1つを更新する必要があります。古い製品名メタデータ・フィールドを含むすべてのドキュメントをエクスポートした後、新しい製品名メタデータ・フィールドを使用してドキュメントをインポートしようとしました。ところが、これを試行するたびに、アーカイバでは全体のアーカイブ・タスクのうち一部のみが処理され、その後停止します。
問題
アーカイバがフリーズすると、コンテンツ・サーバー・ユーザー・インタフェースのナビゲーションができなくなり、開いているブラウザをすべて停止する必要があります。また、ブラウザを停止してから5分間は、コンテンツ・サーバー・インスタンスにまったく接続できなくなります。この5分間が経過すると、コンテンツ・サーバー・インスタンスに再びアクセスできるようになります。
このフリーズの問題に加えて、次のエラー・メッセージが発行されます。
Stream error (299) - SKIPPING
推奨事項
1つ以上のプロセスがインポートを中断している可能性があります。次の操作により、問題が解決する可能性があります。
構成マネージャで製品名メタデータ・フィールドが適切に更新されていない可能性があります。製品名のメタデータ・フィールドのタイプによっては、値の変更がロックアップ問題の原因となっていることがあります。製品名メタデータ・フィールドは(ロング)テキスト・フィールドのみか、それともオプション・リストにもなっているかを調べます。オプション・リストになっている場合は、対応するリストで新しい名前値が選択されていることを確認してください。
コンテンツ・サーバー・インスタンスに管理者としてログインします。
「管理」→「構成マネージャ」を選択します。
「構成マネージャ」ウィンドウで、「情報フィールド」タブを選択します。
「フィールド情報」リストから製品名メタデータ・フィールドを選択します。
「編集」をクリックします。
カスタム情報フィールドの編集ウィンドウで、「フィールド・タイプ」の値が「テキスト」または「ロング・テキスト」であり、かつ「オプション・リストの有効化」が選択されていない場合は、「OK」または「取消」をクリックします(これにより、ロックアップの問題を回避できます)。
あるいは、
「オプション・リストの有効化」が選択されている場合、対応するリストで新しい製品名メタデータ・フィールド値が選択されていることを確認します。
「オプション・リストの使用」フィールドを見つけて、「編集」をクリックします。
「オプションリスト」ダイアログで、新しい製品名メタデータ・フィールド値を入力します。
「OK」をクリックします。
(カスタム情報フィールドの編集ウィンドウで)再度「OK」をクリックします。
「データベース設計の更新」をクリックします。
「検索索引の再構築」をクリックします。
ロックアップの問題は、インデクサの自動更新サイクルが原因で発生する可能性があります。エラー・メッセージに、インデクサが接続を失ったために失敗したことが示されます。インデクサは5分ごとに自動更新サイクルを実行しますが、なんらかの理由で索引ファイルを取り込んでロックしてしまうことがあります。その場合、インポートの実行中に、インデクサの自動更新サイクルを無効にすると解決することがあります。
コンテンツ・サーバー・インスタンスに管理者としてログインします。
「管理」→「リポジトリ・マネージャ」を選択します。
「リポジトリ・マネージャ」ウィンドウで、「インデクサ」タブをクリックします。
タブの「自動更新サイクル」セクションで「構成」ボタンをクリックします。
「自動更新サイクル」ウィンドウで、「インデクサの自動更新」の選択を解除します。
「OK」をクリックします。
|
注意: インポートの完了後、必ず自動更新サイクルを再びアクティブにしてください。そうしない場合、サーバーで自動的に索引データベースが更新されなくなるため、以降の検索結果に影響を及ぼすことがあります。 |
この項の内容は次のとおりです。
質問
エクスポートするコンテンツ・アイテムを定義するときにエクスポート問合せを作成しない場合、コンテンツ・サーバーのコンテンツ全部がエクスポートされますか。
推奨事項
はい、「エクスポート問合せ」セクションを空白のままにする(エクスポート問合せを定義しない)と、コンテンツ・サーバー・コンテンツは全部エクスポートされます。
質問
大規模なエクスポートを開始した後で、(エクスポートの完了前に)いくつかのドキュメントをコンテンツ・サーバーにチェックインした場合、それらのドキュメントはエクスポートに含められますか。それとも、アーカイバによりタイムスタンプ情報が読み取られ、新しいファイルが最初にエクスポートに割り当てられたファイルよりも最近のものであることが判別されて、エクスポートから除外されますか。また、エクスポート中にサーバー間の接続が中断されたり失われた場合、アーカイブ・エクスポートはどのようになりますか。
推奨事項
エクスポートの開始時に、アーカイバは、エクスポートするドキュメントのリストを作成するための問合せをシステムで実行します。この情報はキャッシュされ、エクスポート・アーカイブの作成に使用されます。このため、エクスポート・プロセス中にチェックインされた新しいドキュメントは、エクスポート問合せの定義と一致していても、エクスポートに含められません。
サーバー間の接続が中断された場合、ソース・サーバーでのエクスポート・プロセスは続行されますが、ターゲット・サーバーへの転送は停止されます。ソース・サーバーでは多数のバッチ・ファイルが累積されます。これらのファイルの転送を待機しながら、ソース・サーバーは定期的にターゲット・サーバーにpingを送信して接続を要求します。接続が再確立されると、累積されたバッチ・ファイルがターゲット・サーバーに転送されます。
自動(レプリケート)転送を使用している場合、バッチ・ファイルおよび関連付けられたコンテンツ・ファイルがソース・コンテンツ・サーバーから削除されます。手動転送を使用している場合、バッチ・ファイルおよび関連付けられたコンテンツ・ファイルはソース・コンテンツ・サーバー内に残ります。
質問
ユーザーをアーカイブでエクスポートするにはどうすればよいですか。
推奨事項
次のようにして、「ユーザー」データベース表からのユーザー属性を含むusers.hdaファイルをエクスポートできます。
コンテンツ・サーバー・インスタンスに管理者としてログインします。
「管理」→「アーカイバ」を選択します。
「アーカイバ」ウィンドウで、「データのエクスポート」タブを選択します。
「追加データ」セクションで「編集」をクリックします。
「追加データの編集」ダイアログで、「ユーザー構成情報のエクスポート」タブを選択します。
「OK」をクリックします。
現象
フォルダ・アーカイブのエクスポート機能を使用して、Site Studioで作成されたWebサイト階層を移動します。最初は、「仮想フォルダの管理構成」ページを使用して、問題なくフォルダをエクスポートできました。しかし、Webサイトが大きくなるにつれて、この機能が動作しなくなってきます。エクスポート手順の間、次のエラーが発行されます。
Error <timestamp> Event generated by user '<user>' at host '<host_name>'. Referred
to by http://<host>/intradoc-cgi/nph-idc_cgi.exe?IdcService= COLLECTION_GET_ADMIN_
CONFIG. Unable to retrieve content. Unable to execute service method
'loadCollectionArchive'. (System Error: Unknown error.)
Error <timestamp> IdcAdmin: Event generated by user '<user>' at host '<host>'.
Unable to obtain the console output. Unable to execute the service
'GET_SERVER_OUTPUT' on Content Server 'contribution'. Unable to receive request.
Response from host has been interrupted. Read timed out.
また、コンテンツ・サーバー出力コンソールにメモリー不足のエラーも表示されます。
<timestamp> SystemDatabase#Thread-13: SELECT * FROM Collections, ColMeta WHERE Collections.dCollectionID=ColMeta.dCollectionID AND dParentCollectionID=564
java.lang.OutOfMemoryError
Reporting error on thread Thread-13 occurring at <timestamp>.
java.lang.OutOfMemoryError
java.lang.OutOfMemoryError
問題
アーカイブ・ファイルとしてエクスポートされるフォルダ階層のサイズによっては、Java仮想マシン(JVM)のデフォルトのヒープ・サイズでは不十分な場合があります。
推奨事項
アプリケーション・サーバーでヒープ・サイズの設定を変更し、コンテンツ・サーバーにより多くのヒープ・メモリーを提供します。詳細は、該当するアプリケーション・サーバーのマニュアルを参照してください。
コンテンツ・サーバー・インスタンスの再起動後、アーカイブ・エクスポート機能は再び正常に機能するようになります。
この項の内容は次のとおりです。
現象
ターゲット・サーバーがロックアップして、自動転送機能が停止しました。
問題
ターゲット・サーバーを再起動すると、ログ・ファイルに、セキュリティ・グループに関する問題があったためにターゲット・サーバーへのインポートが行われなかったことを示すエラー・メッセージが記録されていました。
推奨事項
この場合は、転送を続行する前に、ターゲット・サーバー上のセキュリティ・グループ問題を修正する必要があります。次の2つの追加手順を実行することをお薦めします。
送信プロバイダを確認してテストすると、送信プロバイダが適切に設定され、機能していることを確認できます。
管理者としてソース・コンテンツ・サーバー・インスタンスにログインします。
「管理」ページに移動し、「プロバイダ」リンクをクリックします。
該当する送信プロバイダの「情報」リンクをクリックします。
送信プロバイダ情報ページ上の情報を確認します。
「プロバイダ」ページに戻り、送信プロバイダに対応する「テスト」リンクをクリックします。
ソース・サーバーまたはターゲット・サーバーで問題を修正した後、ソース・サーバーでの転送が停止する場合や、自動機能が動作しなくなる場合があります。いずれの場合も、コンテンツ・サーバー・インスタンスを再起動すると問題は解決されます。
質問
誤って、非常に大きなファイルの本番コンテンツ・サーバー・インスタンスへの転送を開始してしまいました。実行中の転送プロセスを停止する最も効率的な方法は何ですか。
推奨事項
転送を中止または削除するには、次のような方法があります。
実行中の転送を中止する最も速い方法は、ソース・サーバーの送信プロバイダを無効にすることです。
管理者としてソース・コンテンツ・サーバー・インスタンスにログインします。
「管理」ページに移動し、「プロバイダ」リンクをクリックします。
「プロバイダ」ページで該当する送信プロバイダの「情報」リンクをクリックします。
送信プロバイダ情報ページで、「無効化」ボタンをクリックします。
「転送先」タブから転送を削除する手順は、次のとおりです。
管理者としてソース・コンテンツ・サーバー・インスタンスにログインします。
「管理」→「アーカイバ」を選択します。アーカイバ・ユーティリティが起動されます。
「オプション」を選択し、「アーカイブ・コレクションを開く」を選択します。
リストから該当するコレクションを選択します。
「開く」をクリックします。
「アーカイバ」ウィンドウで、現在のアーカイブ・リストからソース・アーカイブを選択します。
「転送先」タブを開きます。
「転送先」セクションで「削除」をクリックします。
アクションを確認するプロンプトが表示されます。
「はい」をクリックします。
「インスタンスの自動化の詳細」画面から自動転送を削除する手順は次のとおりです。
管理者としてソース・コンテンツ・サーバー・インスタンスにログインします。
「管理」→「アーカイバ」を選択します。アーカイバ・ユーティリティが起動されます。
「オプション」を選択し、「インスタンスの自動化の詳細を表示する」を選択します。
「インスタンスの自動化の詳細」ウィンドウで、「転送」タブを開きます。
削除する自動転送を選択します。
「削除」をクリックします。自動転送がリストから削除されます。
質問
2つのサーバー間で転送されたファイルの整合性を確認するためには、どのようなアプローチが一番よいですか。当然ながら、ターゲット・コンテンツ・サーバー・インスタンスのドキュメントとソース・インスタンスのドキュメントは同一である必要があります。すべてのドキュメントが実際に転送されたことを確認し、転送されていないファイルがあれば、どのファイルの転送に失敗したかを判別する必要があります。
推奨事項
転送されたドキュメントがソース・サーバー上のドキュメントと同一であることを確認するために、2つのアイテムを簡単に確認できます。
リビジョン表:
具体的には、両方のインスタンスでdDocName列とdRevLabel列の内容を照合し、両者が正確であり同じであることを確認します。
ファイル・システム:
各サーバーで、ネイティブ・ファイル・リポジトリ
(DomainHome/ucm/cs/vault/content_type)
およびWeb表示可能ファイル・リポジトリ
(DomainHome/ucm/cs/weblayout/groups/public/documents/content_type)
を確認し、両者が正確であり同じであることを確認します。
現象
転送プロセスが適切に設定されません。
推奨事項
転送プロセスが正常に機能していない場合は、ソース・サーバー上の送信プロバイダを確認して、情報が正しいことを確認します。特に、サーバー・ホスト名が正しく、HTTPサーバー・アドレスと一致していることを確認してください。
ソース・サーバー上のサーバー・ホスト名を確認する手順は次のとおりです。
システム・プロパティ・ユーティリティを起動します。
./SystemProperties
「インターネット」タブを開きます。
HTTPサーバー・アドレスを書き留めます。
「管理」ページに移動し、「プロバイダ」をクリックします。
「プロバイダ」ページで該当する送信プロバイダの「情報」リンクをクリックします。
送信プロバイダ情報ページで、サーバー・ホスト名が「システム・プロパティ」のHTTPサーバー・アドレス設定と完全に一致していることを確認します。
サーバー・ホスト名の設定がHTTPサーバー・アドレスと異なっている場合は、「編集」ボタンをクリックします。
必要に応じて「サーバー・ホスト名」設定を変更します。
「更新」をクリックします。
コンテンツ・サーバー・インスタンスを再起動します。
このセクションの内容は次のとおりです。
質問
自動インポート機能を停止するにはどうすればよいですか。
推奨事項
コンテンツが指定された基準を満たした場合、自動インポータはデフォルトで5分ごとにインポートを自動実行するように構成されています。ただし、自動インポート機能は次の2つの方法で無効化できます。
「レプリケーション」タブからインポータを登録解除する手順は次のとおりです。
管理者としてソース・コンテンツ・サーバー・インスタンスにログインします。
「管理」→「アーカイバ」を選択します。アーカイバ・ユーティリティが起動されます。
現在のアーカイブ・リストからアーカイブを選択します。
「レプリケーション」タブを選択します。
「登録解除」をクリックします。選択したアーカイブの自動インポート機能が無効になります。
「インスタンスの自動化の詳細」ページから登録済インポータを削除する手順は次のとおりです。
管理者としてソース・コンテンツ・サーバー・インスタンスにログインします。
「管理」→「アーカイバ」を選択します。アーカイバ・ユーティリティが起動されます。
「オプション」を選択し、「インスタンスの自動化の詳細を表示する」を選択します。
「インスタンスの自動化の詳細」ウィンドウで、「インポータ」タブを開きます。
削除する登録済インポータを選択します。
「削除」をクリックします。登録済インポータがリストから削除されます。
このセクションの内容は次のとおりです。
現象
ファイルを転送できません。ファイルを転送しようとするたびに、最大エクステントのエラー・メッセージが表示されます。
問題
次のエラー・メッセージ(または類似のメッセージ)が発行されます。
IdcApp: Unable to execute query '<query_name>'. Error: ORA-01631: max # extents (50) reached in table <table_name>.
ORA-01631 max # extents (<text_string>) reached in table <table_name>.
推奨事項
コンテンツ・サーバー・インスタンスでは、データベース表領域の作成時に50エクステントのみが割り当てられます。データベースが大きくなり、索引作成が繰り返されるにつれて、より多くの領域(エクステント)が使用されます。遂には、50エクステントの制限を超過します。転送中に、1つのファイルの拡大で最大エクステントの制限を超える瞬間があります。この場合は、解決策として次のうち1つ以上を実施してください。
非常に大きなWebレイアウト問合せを探して削除し、転送を再試行します。
コンテンツ・サーバー・ユーザーにコンテンツ・サーバー・スキーマへの適切な権限(リソースおよび接続)が付与されていない可能性があります。そのユーザーが一時表領域を所有している可能性があり、デフォルトの表領域はコンテンツ・サーバーのデフォルトに設定されています。
システムの最大エクステントの制限がシステムの最大値より低い場合は、使用可能なエクステント数を増やす必要があります。表領域エクステントを増やすための適切なOracle SQLコマンドについては、Oracle Databaseのドキュメントを参照するか、データベース管理者に問い合せてください。
オプションで、より大きい初期エクステント、次エクステントまたはパーセントを使用してデータベースを再作成し、表領域のパラメータを大きくすることもできます。この場合は、初期エクステントおよび次エクステントを1Mbに設定することをお薦めします。パラメータの拡大率を(PCTINCREASE)を0%に設定すると、表は必要に応じて自動的に拡大されます。
この項の内容は次のとおりです。
現象
2つのコンテンツ・サーバー・インスタンス間で共有ファイル・システムにアクセスする転送を試行していますが、成功しません。
推奨事項
共有ファイル・システム上のコンテンツ・サーバー・インスタンス間で転送を行う場合、マップまたはマウントされたドライブが両方のコンテンツ・サーバー・インスタンスで使用可能になっている必要があります。つまり、これらのコンピュータが稼働中であり、どちらのコンテンツ・サーバー・インスタンスにもシステム・アクセスできるユーザーとしてログインしている必要があります。次のすべての条件が満たされていることを確認してください。
両方のコンピュータが起動されています。
両方のコンピュータが、どちらのコンテンツ・サーバー・ファイル・システムにもシステム・アクセスできるユーザーとしてログインしている必要があります。
共有ドライブが、コンテンツ・サーバー・インスタンスに認識されるように適切にマップまたはマウントされています。コンピュータへのネットワーク・アクセスだけでは不十分です。
現象
2つのコンテンツ・サーバー・インスタンス間で送信プロバイダを経由する転送を試行していますが、成功しません。
推奨事項
送信プロバイダが設定されているコンテンツ・サーバー・インスタンスはローカル・サーバーとみなされ、送信プロバイダのターゲット・コンテンツ・サーバー・インスタンスはプロキシ・サーバーとみなされます。ファイルは常に、送信プロバイダの方向、つまりローカル(ソース)インスタンスからプロキシ(ターゲット)インスタンスに転送されます。
ソース・コンテンツ・サーバー・インスタンスで送信プロバイダが追加されて定義されたときに、「プロキシ」チェック・ボックスが選択された可能性があります。ところが、両方のコンテンツ・サーバー・インスタンスの相対Webルートが同じであると、送信プロバイダは混乱します。「プロキシ」チェック・ボックスは、ターゲット・コンテンツ・サーバー・インスタンスがローカル(マスター)コンテンツ・サーバー・インスタンスの実際のプロキシとしてインストールされた場合にのみ選択します。両方のコンテンツ・サーバー・インスタンスの相対Webルートが同じである場合は、このサーバー・オプションを選択しないでください。
Oracle Fusion Middlewareの問題の解決にMy Oracle Support (以前のMetaLink)を使用できます。My Oracle Supportには、次のような有用なトラブルシューティング・リソースが含まれています。
ナレッジ・ベース記事
コミュニティ・フォーラムとディスカッション
パッチとアップグレード
動作保証情報
|
注意: My Oracle Supportを使用してサービス・リクエストを記録することもできます。 |
My Oracle Supportにはhttps://support.oracle.comからアクセスできます。