Downstream-Extraktion für Oracle GoldenGate-Deployment
Mit einem Downstream-Deployment von Oracle GoldenGate können Sie die Verarbeitung der Redo-Logs in eine alternative Datenbank auslagern, die als Mining-Datenbank bezeichnet wird. Die Mining-Datenbank muss keine Daten aus der Quelldatenbank enthalten, muss jedoch dieselbe Datenbankversion oder höher sein. Das bedeutet, dass Oracle Version 12c als Quelldatenbank die Mining-Datenbankversion 19c oder höher verwenden kann, sodass Oracle GoldenGate Änderungen aus einer Oracle 12c-Datenbank erfassen kann, ohne tatsächlich in der Oracle 12-Datenbank ausgeführt zu werden.
Downstream Extract kann auch in Situationen verwendet werden, in denen GoldenGate keine Verbindung zur Quelldatenbank herstellen kann.
Hinweis: Die Quell- und Downstream-Datenbankserver müssen dieselben Endian- und Prozesstypen aufweisen. Beispiel: Downstream Extract funktioniert mit dem Quell-Linux (x86) auf einem Downstream-Windows-(x86-)Server, funktioniert aber nicht, wenn der Quellserver HP-UX ist, der Downstream-Server jedoch AIX ist oder der Quellserver HP PA-RISC ist, der Downstream-Server jedoch HP-Itanium ist.
Eine Downstream-Mining-Datenbank akzeptiert archivierte Logs und Online-Redo-Logs aus einer Quelldatenbank. Dies bedeutet, dass ein nachgelagerter Extract in zwei Modi vorhanden sein kann:
-
Echtzeit-Mining-Modus: Im Echtzeit-Mining-Modus werden die Redo-Datensätze sofort aus den Online- oder Standby-Redo-Logs verarbeitet, sodass keine Verzögerung bei der Verarbeitung der Datenbankänderungen auftritt.
-
Archive Mining-Modus: Im Archive Mining-Modus werden die Redo-Datensätze erst verarbeitet, nachdem sie in einer Redo-Logdatei archiviert wurden.
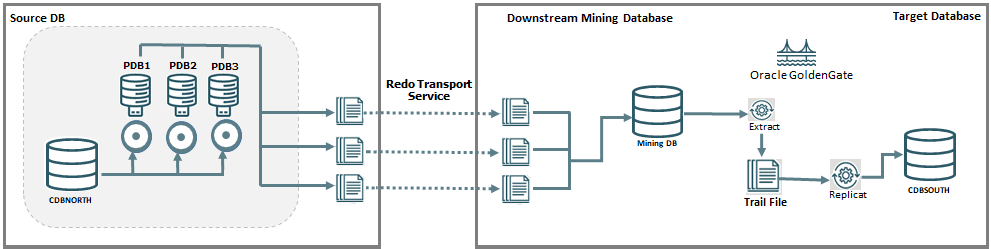
In einem typischen Downstream-Deployment sendet die Quelldatenbank, in der Änderungen an den Daten vorgenommen werden, ihre Redo-Logs oder Archive-Logs an eine Mining-Datenbank, in der der Extract-Prozess die Redo-Logs abbildet und die Traildateien ausschreibt. Downstream Extract kann auch in Situationen verwendet werden, in denen Oracle GoldenGate keine Verbindung zur Quelldatenbank herstellen kann. Im folgenden Diagramm ist CDBNORTH die Quelldatenbank und CDBSOUTH die Zieldatenbank. Zwischen der Quelle und dem Ziel befindet sich eine Mining-Datenbank mit dem Datenbank-Logmining-Server, die Redo-Logs vom Downstream Extract an das Ziel überträgt.
Eine Alternative ist die Verwendung eines kaskadierenden Ansatzes. Wenn eine Active Data Guard-Standbydatenbank vorhanden ist, können Sie die Redo-Logs von der Standbydatenbank an die Miningdatenbank senden lassen, anstatt die Logs von der Primärdatenbank zu versenden. Diese Option sollte verwendet werden, wenn die Netzwerkbandbreite begrenzt ist und sich die Standbydatenbank in derselben Region oder demselben Data Center wie die Mining-Datenbank befindet.
Bei diesem Ansatz wird ein ADG verwendet, das im kaskadierten Modus konfiguriert ist, um Redo Logs in eine Downstream-Mining-Datenbank zu übertragen, die dann von einem Downstream Extract referenziert wird. Dadurch wird der Overhead in der Quelldatenbank reduziert, wie im folgenden Diagramm dargestellt.
Hinweis: Der Extract-Prozess für Oracle kann keine Verbindung zu einer Data Guard-Standby- oder Active Data Guard-Standbydatenbank herstellen, um Daten zu erfassen.
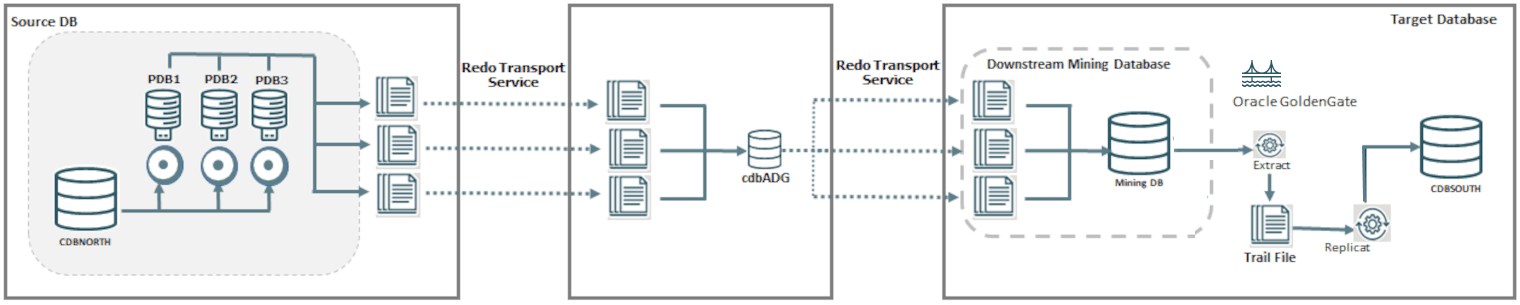
Konfigurationsdetails zum Einrichten einer kaskadierten Downstreamumgebung finden Sie unter Nachgelagerten Extract für die Arbeit mit ADG aktivieren.
Quell- und Downstream-Mining-Datenbanken konfigurieren
In diesem Abschnitt erfahren Sie, welche Parameter und Benutzerverwaltungskonfigurationen auf Datenbankseite erforderlich sind.
Oracle GoldenGate-Benutzer in Quell- und Downstream-Mining-Datenbanken
Der Oracle GoldenGate-Administratorbenutzer muss in jeder Datenbank vorhanden sein. In den Containerdatenbanken ist ein allgemeiner Benutzer erforderlich, da der Extract im Root-Container verwendet wird.
Um Benutzer für Oracle AI Database 26ai und höher einzurichten, muss die Benutzerrolle OGG_CAPTURE und OGG_APPLY dem neuen Benutzer zugewiesen werden. Weitere Informationen finden Sie unter Grant User Privileges for Oracle AI Database 26ai and Higher.
Um Benutzer für Oracle Database 21c und niedriger einzurichten, werden PL/SQL-Packages verwendet. Das folgende Beispiel zeigt die Erstellung eines Benutzers und die zugehörigen Berechtigungen, die diesem Benutzer erteilt werden, wenn Oracle GoldenGate mit Oracle Database 21c und niedriger verwendet wird:
CREATE USER c##ggadmin IDENTIFIED BY *password* CONTAINER = all;
ALTER USER c##ggadmin SET CONTAINER_DATA = all CONTAINER = current;
GRANT ALTER SESSION TO c##ggadmin CONTAINER = all;
GRANT connect, resource TO c##ggadmin CONTAINER = all;

BEGIN
  DBMS_GOLDENGATE_AUTH.GRANT_ADMIN_PRIVILEGE
    ( grantee                 => 'C##GGADMIN'
    , privilege_type          => 'CAPTURE'
    , grant_select_privileges =>  TRUE
    , container               => 'ALL'
    );
END;
/
Hinweis: Der allgemeine Benutzer (c##ggadmin) ist nur für die Downstream-Datenbank erforderlich.
Datenbankverbindungen konfiguriert
Datenbank-Net Service-Anforderungen
Auf die Quell- und Downstream-Datenbanken kann mit den Database Net Services in beide Richtungen zugegriffen werden.
In Oracle GoldenGate können Verbindungen für die Quelldatenbank (CDBNORTH_root) und die Downstreamdatenbank (cdbDSC_root) eingerichtet werden. Die Quelldatenbankverbindung wird nur zum Speichern von Dictionary-Daten während der Extract-Registrierung benötigt. Sie können den Parameter FETCHUSERIDALIAS verwenden, um eine Verbindung zur Downstream-Mining-Datenbank (cdbDSC_root) für Abrufe zur Laufzeit herzustellen. Mit der ADG-Umleitung kann die Registrierung von Extract von einem ADG zur Quelle umgeleitet werden. Stellen Sie zum Einrichten von Verbindungen sicher, dass Sie über die Datenbankzugangsdaten für diese Benutzer verfügen, um Zugangsdaten aus dem Oracle GoldenGate-Deployment zu erstellen.
Sie können den Net Service mit SQL*Plus testen, das Teil des Oracle GoldenGate-Shiphome ist.
Voraussetzungen für die Quelldatenbank
Stellen Sie zum Konfigurieren von Datenbankverbindungen sicher, dass die folgenden Einstellungen für die Quelldatenbankinstanzen vorgenommen werden:
-
(Quell- und Downstream-Mining-Datenbanken) Alle Datenbanken müssen Folgendes enthalten:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
Die Quelldatenbanken müssen sich im Archive-Logmodus befinden. Um die Archivierung in der Datenbank zu aktivieren, geben Sie den folgenden Befehl aus, mit dem die Datenbank angewiesen wird, beim Wechseln der Redo-Logs ein Archive Log zu erstellen.
ALTER DATABASE ARCHIVE LOG; -
(Empfohlen) (Nur Quelle) Alle Datenbanken müssen sich im Modus "Protokollierung erzwingen" befinden.
ALTER DATABASE FORCE LOGGING; -
Für die Quelldatenbank muss minimales zusätzliches Logging aktiviert sein, das die
TRANDATA/SCHEMATRANDATAwährend der Auslagerung des Extraktionsprozesses in die Mining-Datenbank enthält, da hier die Transaktionen stattfinden. -
(Nur Downstream-Mining-Datenbank) Die Kennwortdateien (
orapwSID) der Quell- und Downstream-Datenbank sind identisch. Daher mussremote_login_passwordfilein Oracle Database 21c und niedriger aufSHAREDoderEXCLUSIVEgesetzt werden.
Voraussetzungen für Downstream-Mining-Datenbank
Stellen Sie zum Konfigurieren von Datenbankverbindungen sicher, dass die folgenden Einstellungen für die Quell- und Downstream-Datenbankinstanzen vorgenommen werden:
-
Alle Datenbanken müssen Folgendes enthalten:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
STREAMS_POOL_SIZEmuss in Oracle 21c und niedriger festgelegt werden. Beispiel:ALTER SYSTEM SET STREAMS_POOL_SIZE = 1G; -
Die Mining-Datenbank und die Quelldatenbank müssen sich im Archive Log-Modus befinden. Um die Archivierung in der Datenbank zu aktivieren, geben Sie den folgenden Befehl aus, mit dem die Datenbank angewiesen wird, beim Wechseln der Redo-Logs ein Archive Log zu erstellen.
ALTER DATABASE ARCHIVE LOG; -
(Nur Downstream-Mining) Die Downstream-Datenbank muss unterschiedliche Einstellungen für Folgendes aufweisen:
-
DBID -
DBNAME -
DB_UNIQUE_NAME -
GLOBAL_NAME
(Downstream-Mining-Datenbank und Quelldatenbank) In einer Downstream-Umgebung entspricht der eindeutige Datenbankname dem Datenbanknamen.
-
-
Die Kennwortdateien (
orapwSID) der Quell- und der Downstream-Datenbank sind identisch. Daher muss dieremote_login_passwordfileaufSHAREDoderEXCLUSIVEgesetzt werden.
Parameter für Downstream-Datenbank konfigurieren
In diesem Abschnitt können Sie Parameter für den Echtzeit-Mining-Modus und den Archiv-Mining-Modus nach Bedarf konfigurieren.
Parametereinstellungen für Downstream-Extrakt im Echtzeit-Mining-Modus
Für Downstream Extract im Real-Time Mining-Modus ist die primäre Voraussetzung, dass für die Downstream-Datenbank Standby Redo Log-Dateien korrekt konfiguriert sind.
Downstream Real-Time Mining ist mit einer expliziten Einstellung in der Extract-Parameterdatei aktiviert. Die Konfiguration des LAD ist von diesem Modus unabhängig. Wenn der Parameter TRANLOGOPTIONS INTEGRATEDPARAMS (REAL_TIME_MINE Y) noch nicht festgelegt war, müssen Sie ihn so festlegen, dass Downstream Extract für den Echtzeit-Mining-Modus aktiviert wird:
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)Hinweis: In der Downstream-Datenbank darf nur ein Echtzeitextrakt für eine bestimmte Quelldatenbank vorhanden sein. Andere Extrakte müssen nicht in Echtzeit sein. Dies ist eine Einschränkung des Redo Transports.
Der folgende Befehl, der in der Downstream Mining-Datenbank ausgeführt wird, zeigt das lokale Backup, das mit der FRA eingerichtet wird:
ALTER SYSTEM
    SET log_archive_config='DG_CONFIG=(CDBNORTH, cdbDSC)';
ALTER SYSTEM set FAL_SERVER = 'CDBNORTH_root';
Standby Redo Log-Dateien müssen in der Downstream-Datenbank vorhanden sein. Wenn n Online-Redo-Logdateien an der Quelle vorhanden sind, müssen n+1 Standby-Redo-Logdateien auf dem Ziel derselben Größe vorhanden sein.
Standby Redo Log-Dateien in der Downstream Mining-Datenbank erstellen
In den folgenden Schritten wird das Verfahren zum Hinzufügen von Standby Redo Log-Dateien zur Downstream Mining-Datenbank beschrieben. Im Folgenden werden die Regeln zum Erstellen der Standby Redo Log-Dateien zusammengefasst:
-
Jede Standby Redo Log-Datei muss mindestens so groß sein wie die größte Redo Log-Datei der Redo-Quelldatenbank. Oracle empfiehlt, dass alle Redo Log-Dateien in der Quelldatenbank und die Standby Redo Log-Dateien in der Downstream Mining-Datenbank dieselbe Größe aufweisen.
-
Das Standby Redo Log muss mindestens eine weitere Redo Log-Gruppe aufweisen als das Redo Log in der Quelldatenbank, für jeden Redo Thread in der Quelldatenbank.
Welche Schritte und SQL-Anweisungen zum Hinzufügen von Standby Redo Log-Dateien erforderlich sind, hängt von Ihrer Umgebung ab. Ausführliche Anweisungen zum Hinzufügen von Standby Redo-Logdateien zu einer Datenbank finden Sie unter Physische Standbydatenbank erstellen.
Hinweis: Wenn mehrere Quelldatenbanken Redo an eine einzelne Downstream-Mining-Datenbank senden, kann nur eine dieser Quellen Redo an die Standby-Redo-Logs der Mining-Datenbank senden. Ein Extract-Prozess, der die Redo-Daten aus dieser Quelldatenbank ausrechnet, kann im Echtzeitmodus ausgeführt werden. Alle anderen Quelldatenbanken dürfen nur ihre archivierten Logs an die Downstream-Mining-Datenbank senden. Die Extracts, die diese Daten lesen, müssen so konfiguriert werden, dass sie im Nur-Archiv-Log-Modus ausgeführt werden.
So erstellen Sie Standby Redo Log-Dateien
-
Melden Sie sich in SQL*Plus als administrativer Benutzer bei der Quelldatenbank an.
-
Bestimmen Sie die Größe der Quelllogdatei. Notieren Sie sich die Ergebnisse.
SELECT BYTES FROM V$LOG; -
Bestimmen Sie die Anzahl der Online-Logdateigruppen, die in der Quelldatenbank konfiguriert sind. Notieren Sie sich die Ergebnisse.
SELECT COUNT(GROUP#) FROM V$LOG; -
Melden Sie sich als Administrator bei der Downstream-Mining-Datenbank an.
-
Fügen Sie der Mining-Datenbank die Standby Log-Dateigruppen hinzu. Die Größe der Standby-Logdatei muss mindestens der Größe der Quell-Logdatei entsprechen. Die Anzahl der Standby Log-Dateigruppen muss mindestens einer größer als die Anzahl der Online Log-Quelldateigruppen sein. Dies gilt für jede Instance (Thread) in einer RAC-Installation. Wenn Sie also n Threads in der Quelldatenbank haben, die jeweils m Redo-Loggruppen aufweisen, müssen Sie n*(m+1) Redo-Loggruppen in der Downstream-Mining-Datenbank konfigurieren.
Das folgende Beispiel zeigt drei Standby-Loggruppen.
ALTER DATABASE ADD STANDBY LOGFILE GROUP 3 ('/oracle/dbs/slog3a.rdo', '/oracle/dbs/slog3b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 4 ('/oracle/dbs/slog4.rdo', '/oracle/dbs/slog4b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 5 ('/oracle/dbs/slog5.rdo', '/oracle/dbs/slog5b.rdo') SIZE 500M; -
Vergewissern Sie sich, dass die Standby Log-Dateigruppen erfolgreich hinzugefügt wurden.
SELECT GROUP#, THREAD#, SEQUENCE#, ARCHIVED, STATUS
FROM V$STANDBY_LOG;
Die Ausgabe sollte dem Nachstehenden ähneln:
GROUP# THREAD# SEQUENCE# ARC STATUS ---------- ---------- ---------- --- ---------- 3 0 0 YES UNASSIGNED 4 0 0 YES UNASSIGNED 5 0 0 YES UNASSIGNED -
Stellen Sie sicher, dass Logdateien aus der Quelldatenbank in dem Verzeichnis angezeigt werden, das im Attribut
LOCATIONdes lokalenLOG_ARCHIVE_DEST_nangegeben ist, das Sie festlegen. Möglicherweise müssen Sie die Logdatei in der Quelldatenbank wechseln, um Dateien im Verzeichnis anzuzeigen.
Downstream Mining-Datenbank so konfigurieren, dass Standby Redo Log-Dateien lokal archiviert werden
Mit dieser Prozedur wird die Downstream-Mining-Datenbank so konfiguriert, dass die Standby Redo Log-Dateien archiviert werden, die Redo Log-Daten aus den Online Redo Log-Dateien der Quelldatenbank empfangen. Beachten Sie, dass externe archivierte Logs nicht im Recovery-Bereich der Downstream-Mining-Datenbank archiviert werden sollten.
So archivieren Sie Standby Redo Logs lokal:
-
Legen Sie in der Downstream-Mining-Datenbank das zweite Archive Log-Ziel im Initialisierungsparameter
LOG_ARCHIVE_DEST_nfest, wie im folgenden Beispiel dargestellt.ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='LOCATION=/home/arc_dest/srl_dbms1 VALID_FOR=(STANDBY_LOGFILE,PRIMARY_ROLE)'Oracle empfiehlt, dass externe archivierte Logs (Logs aus Remote-Quelldatenbanken) getrennt von lokalen Mining-Datenbanklogdateien und voneinander aufbewahrt werden. Sie dürfen den Recovery-Bereich der Downstream-Mining-Datenbank nicht zum Staging von archivierten Fremdlogs verwenden.
-
Aktivieren Sie den Parameter
LOG_ARCHIVE_DEST_2, den Sie im vorherigen Schritt festgelegt haben, wie im folgenden Beispiel gezeigt.ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE
Parametereinstellungen für Downstream-Extraktion im Archiv-Mining-Modus
Um einen nachgelagerten Extract entweder im Archive Mining-Modus oder im Real-Time Mining-Modus einzurichten, müssen Sie den Redo-Transport einrichten. Nehmen Sie die folgenden Parameter auf, wenn Sie den Downstream-Extract im Modus "Nur Archive-Log" einrichten:
-
LOG_ARCHIVE_CONFIG -
LOG ARCHIVE DESTINATION (LAD)-
LOG_ARCHIVE_DEST_1für lokales Backup aller Datenbanken -
LOG_ARCHIVE_DEST_2-Service für Redo-Transport in der Quelldatenbank
-
Hinweis: LOG_ARCHIVE_DEST_2 ist unabhängig von der Verwendung von Real Time Mining.
-
Backupziel der lokalen Datenbank wird mit dem Flash Recovery-Bereich festgelegt
-
FAL_SERVER -
Alle erforderlichen Systemparameter können mit
scope=bothdynamisch festgelegt werden
Die LAD-(Archive Log Destination-)Parametereinstellungen sind für das lokale Backupziel und die Redo Transport Services in den Quelldatenbanken erforderlich.
Richten Sie die LAD-Parameter für lokales Backupziel mit den folgenden Befehlen ein:
ALTER SYSTEM SET db_recovery_file_dest = '/u01/app/oracle/fast_recovery_area';
ALTER SYSTEM SET db_recovery_file_dest_size = 100G;
ALTER SYSTEM SET log_archive_dest_1 = 'LOCATION=USE_DB_RECOVERY_FILE_DEST';
Richten Sie die LAD-Parameteroptionen für Redo-Transportservices in der Quelldatenbank mit den folgenden Befehlen ein:
ALTER SYSTEM SET log_archive_config = 'DG_CONFIG = (CDBNORTH, cdbDSC)';
ALTER SYSTEM
      SET log_archive_dest_2='SERVICE=cdbDSC_root
                              ASYNC
                              NOREGISTER
                              VALID_FOR=(ONLINE_LOGFILES, PRIMARY_ROLE)
                              DB_UNIQUE_NAME=cdbDSC';
Weitere Informationen zum Parameter LOG_ARCHIVE_DEST und den zugehörigen Attributen finden Sie unter LOG_ARCHIVE_DEST_n in der Dokumentation Datenbankreferenz.
Oracle GoldenGate-Extract für Downstream-Deployment konfigurieren
In diesem Abschnitt erfahren Sie, welche Parameter von Oracle GoldenGate erforderlich sind, um Verbindungen mit Quell- und Downstreamdatenbanken einzurichten und Extract für die Downstreamdatenbank zu konfigurieren.
Oracle GoldenGate für Downstream-Datenbank konfigurieren
Die Parameterdatei für den Downstream-Extrakt muss die folgenden Parameter enthalten, um ein Downstream-Deployment einzurichten:
-
TRANLOGOPTIONS MININGUSERALIAS: Legt die Verbindung zur Downstream-Mining-Datenbank für interne Metadatenabfragen fest. -
FETCHUSERIDALIAS: Verbindet sich mit der Quelldatenbank, um Daten abzurufen, die nicht nativ aus dem Transaktionslog extrahiert werden können. -
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y): Wenn dieser Wert auf "J" gesetzt ist, erfasst Extract Änderungen aus den Standby-Redo-Logdateien in der Downstream-Datenbank. Wenn diese Option nicht aktiviert ist, erfasst Extract die Archive-Logdateien.
Im Folgenden finden Sie ein Beispiel für die Extract-Parameterdatei, die folgende Parameter enthält:
EXTRACT EXTDSC
USERIDALIAS cgg_CDBNORTH
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)
FETCHUSERIDALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate

EXTTRAIL Downstream/ea
SOURCECATALOG CDBNORTH_PDB1
DDL INCLUDE MAPPED
TABLE HR.*;
Führen Sie die folgenden Schritte aus, um das Oracle GoldenGate-Deployment für Downstream Extract einzurichten:
-
Zugangsdaten für die Quelldatenbank hinzufügen:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@CDBNORTH_root ALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate PASSWORD password -
Zugangsdaten für die Downstream-Datenbank hinzufügen:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@cdbDSC_root ALIAS cgg_cdbDSC DOMAIN OracleGoldenGate PASSWORD *password* -
Verwenden Sie
DBLOGIN, um eine Verbindung zur Quelldatenbank und zur Downstreamdatenbank von Oracle GoldenGate herzustellen:DBLOGIN USERIDALIAS cgg_CDBNORTHMININGDBLOGIN USERIDALIAS cgg_cdbDSCIn diesem Beispiel ist
cgg_CDBNORTHder Zugangsdatenalias für die Quelldatenbank CDBNORTH undcgg_cdbDSCder Zugangsdatenalias für die Mining-Datenbank. -
Fügen Sie einen Extract hinzu, registrieren Sie ihn, bearbeiten Sie die Parameterdatei, um die zuvor angegebenen Extract-Parameter einzuschließen, fügen Sie den Extract-Trailnamen und den Speicherort hinzu, und starten Sie den Extract:
ADD EXTRACT extdsc, INTEGRATED TRANLOG, BEGIN NOW
REGISTER EXTRACT extdsc, DATABASE CONTAINER (CDBNORTH_PDB01)

ADD EXTTRAIL Downstream/ea, EXTRACT extdsc
START extdsc
Kaskadierter Downstream-Extrakt mit Active Data Guard konfigurieren
Wenn keine Verbindung zur Quelldatenbank möglich ist, kann GoldenGate so konfiguriert werden, dass eine Active Data Guard-(ADG-)Standbydatenbank verwendet wird. Die Standbydatenbank ist für schreibgeschützte Verbindungen zum Ausführen von Metadatenabfragen und Abrufen verfügbar. In diesem Abschnitt erfahren Sie, wie Sie einen Downstream Extract mit ADG konfigurieren, ohne eine Verbindung zur Quelldatenbank herzustellen.
Downstream-Extraktion für die Arbeit mit ADG aktivieren
In einer kaskadierten Downstream Capture-Umgebung stellt die Downstream-Datenbank keine direkte Verbindung zur Quelldatenbank her. Es verwendet Active Data Guard (ADG) zum Abrufen und Abfragen von Metadaten.
Extract muss mit der Option "sourceless" gestartet werden, damit keine Verbindung zur Quelldatenbank hergestellt wird und stattdessen mit FETCHUSERID oder FETCHUSERIDALIAS eine Verbindung zu ADG hergestellt wird, wenn nicht native Datentypen abgerufen werden müssen. Beispiel: FETCH-Vorgänge werden in der ADG-Datenbank verarbeitet, da diese Instanz im schreibgeschützten Modus geöffnet ist. Andere Vorgänge, die auf der ADG-Instanz nicht verarbeitet werden können, wie das Erstellen des Dictionary Builds, werden vom ADG zur Quelldatenbank umgeleitet.
Wenn Sie einen Downstream Extract registrieren, stellt Oracle GoldenGate eine Verbindung zu ADG als Quelldatenbank anstelle der Datenbank her, aus der das Redo stammt. Die ADG-Umleitung wird für die folgenden Befehle und Parameter unterstützt:
-
SCHEMATRANDATA -
TRANDATA -
FLUSH SEQUENCE -
TRACETABLE -
HEARTBEATTABLE -
REGISTER EXTRACTHinweis:SCHEMATRANDATAundTRANDATA. Obwohl der Befehl im Standby-Redo-Log ausgeführt wird, werden die tatsächlichen Loggruppen in der Primärdatenbank erstellt und verwaltet, in der die tatsächlichen DML-Vorgänge stattfinden.
ADG-Umleitung ist mit Oracle Database 21c und höher verfügbar. Es unterstützt auch die Registrierung von Platzhaltern. Das folgende Beispiel zeigt die Extract-Parameterdatei für den Downstream Extract, wenn ADG verwendet wird:
EXTRACT EXTDSC
NOUSERID
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC_src DOMAIN OracleGoldenGate
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y) FETCHUSERIDALIAS cgg_cdbADG_src DOMAIN OracleGoldenGate

EXTTRAIL cascade/ea
SOURCECATALOG CDBNORTH_PDB01
DDL INCLUDE MAPPED
TABLE HR.*;
So aktivieren Sie das Arbeiten von Downstream Extract mit ADG Standby:
-
Fügen Sie eine zusätzliche
LOG_ARCHIVE_DESTINATION_N (LAD)in der ADG-Standbydatenbank hinzu, wie im folgenden Beispiel dargestellt:ALTER SYSTEM SET LOG_ARCHIVE_DEST_3='service=mining_db_service_name ASYNC NOREGISTER VALID_FOR(STANDBY_LOGFILES,STANDBY_ROLES) DB_UNIQUE_NAME=3rd_db_unique_name' scope=bothDieser Schritt transportiert und generiert die
standby_logfilesfür eine ADG-Standbydatenbank. -
Legen Sie
LOG_ARCHIVE_CONFIGin der ADG-Standbydatenbank fest, um die Logs an die Mining-Datenbank zu senden, wie im folgenden Beispiel dargestellt:ALTER SYSTEM SET LOG_ARCHIVE_CONFIG = 'DG_CONFIG' = (CDBNORTH, cdbADG_src, cdbDSC)';DB_CONFIGist der eindeutige Datenbankname der ersten, zweiten und dritten Datenbank. -
Richten Sie in der Mining-Datenbank den Speicherort für die eingehende standby_logfiles in der Mining-Datenbank ein, wie im folgenden Beispiel dargestellt:
ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='location= /home/arc_dest/dstrm VALID_FOR=(STANDBY_LOGFILE,ALL_ROLES)' scope=bothwobei
/home/arc_dest/dstrmder Speicherort für Fremdarchivlogs ist. Verwenden Sie FRA nicht zum Speichern von Fremdarchiv-Logs. -
Führen Sie
LOG_ARCHIVE_CONFIGin der Mining-Datenbank aus, damit der Extract-Prozess sie in der Mining-Datenbank lesen kann, wie im folgenden Beispiel dargestellt:ALTER SYSTEM SET LOG_ARCHIVE_CONFIG ='DG_CONFIG' scope=bothHier ist
DB_CONFIGder eindeutige Datenbankname der ersten, zweiten und dritten Datenbank. -
Bei einem Downstream Extract müssen Sie sicherstellen, dass die Datenbankverbindungen ordnungsgemäß konfiguriert sind. Stellen Sie beim Registrieren des Extract sicher, dass die
DBLOGIN-Verbindung zur ADG-Standbydatenbank hergestellt wird, die für schreibgeschützte Aktivitäten geöffnet ist. -
Um den Extract hinzuzufügen und zu registrieren, verwenden Sie den folgenden Befehl:
DBLOGIN USERID ggadmin@cdbADG_src, PASSWORD ggadmin
MININGDBLOGIN USERID ggadmin@cgg_cdbDSC, password ggadmin
cdbADG_src ist das ADG nicht primär.
cgg_cdbDSC ist die Mining-Datenbank.
-
Registrieren Sie jetzt einen Extract, der den Parameter
NOUSERIDverwendet:ADD EXTRACT exte, INTEGRATED TRANLOG, BEGIN NOW REGISTER EXTRACT exte DATABASE -
Nachdem der Extract registriert wurde, können Sie diesen Extract verwenden, um Daten zu minen und den Extract normal zu starten.