Künstliche Intelligenz in der Oracle AI Database
In diesem Kapitel werden die Funktionen der künstlichen Intelligenz beschrieben, die in Oracle AI Database bereitgestellt werden.
-
Überblick über Oracle AI Vector Search Oracle AI Vector Search wurde für Workloads mit künstlicher Intelligenz (KI) entwickelt und ermöglicht es Ihnen, Daten basierend auf Semantik und nicht auf Schlüsselwörtern abzufragen.
-
Vektorabstandsmetriken Die Messung von Entfernungen in einem Vektorraum ist das Herzstück der Identifizierung der relevantesten Ergebnisse für einen bestimmten Abfragevektor. Dieser Prozess unterscheidet sich sehr von der bekannten Schlüsselwortfilterung in der relationalen Datenbankwelt.
-
Überblick über hierarchisch navigierbare kleine Weltindizes Anhand dieser Beispiele erfahren Sie, wie Sie HNSW-Indizes für ungefähre Ähnlichkeitssuchen im Vektor erstellen.
-
Invertierte Datei-Flat-Vektorindizes verstehen Der Invertierte Datei-Flat-Vektorindex ist eine Technik zur Steigerung der Sucheffizienz, indem der Suchbereich durch die Verwendung von Neighbor Partitionen oder Clustern eingeschränkt wird.
-
Ähnlichkeitssuchen ausführen In diesem Abschnitt werden die Methoden zum Durchführen von Ähnlichkeitssuchen beschrieben.
Überblick über Oracle AI Vector Search
Oracle AI Vector Search wurde für Workloads mit künstlicher Intelligenz (KI) entwickelt und ermöglicht es Ihnen, Daten basierend auf Semantik und nicht anhand von Schlüsselwörtern abzufragen.
VECTOR-Datentyp
Der Datentyp VECTOR wird mit dem Release von Oracle AI Database 26ai eingeführt und bietet die Grundlage für die Speicherung von Vektoreinbettungen neben Geschäftsdaten in der Datenbank. Mit Einbettungsmodellen können Sie unstrukturierte Daten in Vektoreinbettungen transformieren, die dann für semantische Abfragen von Geschäftsdaten verwendet werden können. Um den Datentyp VECTOR und die zugehörigen Features verwenden zu können, muss der Initialisierungsparameter COMPATIBLE auf 23.4.0 oder höher gesetzt sein. Weitere Informationen über den Parameter und dessen Änderung finden Sie im Oracle AI Database Upgrade Guide.
Siehe das folgende grundlegende Beispiel für die Verwendung des Datentyps VECTOR in einer Tabellendefinition:
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);Weitere Informationen zum Datentyp VECTOR und zur Verwendung von Vektoren in Tabellen finden Sie unter Tabellen mit dem VECTOR-Datentyp erstellen.
Aufgrund der numerischen Natur des Datentyps VECTOR können Sie ihn als Eingabe für die Algorithmen des maschinellen Lernens verwenden, wie Klassifizierung, Anomalie, Regression, Clustering und Featureextraktion. Weitere Details zur Verwendung des Datentyps VECTOR in maschinellem Lernen finden Sie unter Unterstützung von Vektordatentypen. Hinweis: Die Unterstützung für maschinelles Lernen des Datentyps VECTOR ist in allen Versionen ab Version 23.7 verfügbar.
Vektoreinbettungen
Wenn Sie jemals Anwendungen wie Sprachassistenten, Chatbots, Sprachübersetzer, Empfehlungssysteme, Anomalieerkennung oder Videosuche und -erkennung verwendet haben, haben Sie implizit Vektoreinbettungsfunktionen verwendet.
Oracle AI Vector Search speichert Vektoreinbettungen, die mathematische Vektordarstellungen von Datenpunkten sind. Diese Vektoreinbettungen beschreiben die semantische Bedeutung hinter Inhalten wie Wörtern, Dokumenten, Audiospuren oder Bildern. Bei der textbasierten Suche wird die Vektorsuche beispielsweise oft als besser angesehen als die Stichwortsuche, da die Vektorsuche auf der Bedeutung und dem Kontext hinter den Wörtern basiert und nicht auf den eigentlichen Wörtern selbst. Diese Vektordarstellung übersetzt semantische Ähnlichkeit von Objekten, wie sie von Menschen wahrgenommen werden, in die Nähe in einem mathematischen Vektorraum. Dieser Vektorraum hat in der Regel viele Hunderte, wenn nicht Tausende von Dimensionen. Anders ausgedrückt, Vektoreinbettungen sind eine Möglichkeit, fast jede Art von Daten wie Text, Bilder, Videos, Benutzer oder Musik als Punkte in einem mehrdimensionalen Raum darzustellen, wo die Orte dieser Punkte im Raum und die Nähe zu anderen semantisch bedeutungsvoll sind.
Dieses vereinfachte Diagramm veranschaulicht einen Vektorraum, in dem Wörter als 2-dimensionale Vektoren codiert werden.
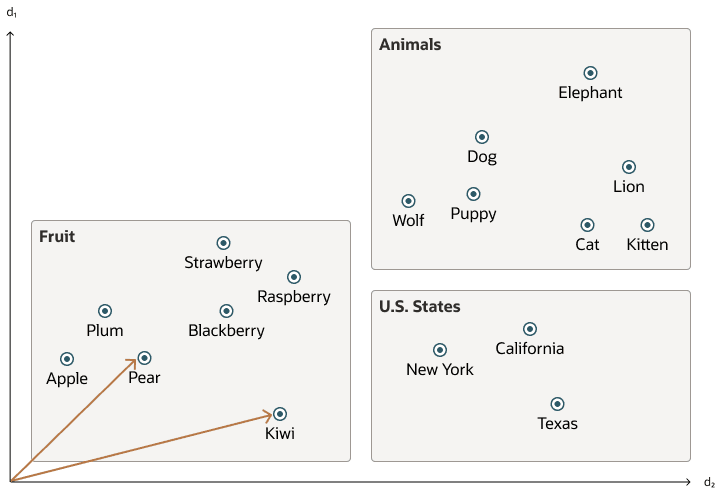
Beschreibung der Abbildung vector_embeddings.png
Ähnlichkeitssuche
Die Suche nach semantischer Ähnlichkeit in einem Dataset entspricht jetzt der Suche nach nächsten Nachbarn in einem Vektorraum, anstatt herkömmliche Stichwortsuchen mit Abfrageprädikaten zu verwenden. Wie im folgenden Diagramm dargestellt, ist der Abstand zwischen Hund und Wolf in diesem Vektorraum kürzer als der Abstand zwischen Hund und Kätzchen. In diesem Raum ist ein Hund einem Wolf ähnlicher als einem Kätzchen. Weitere Informationen finden Sie unter Suche nach genauer Ähnlichkeit ausführen.
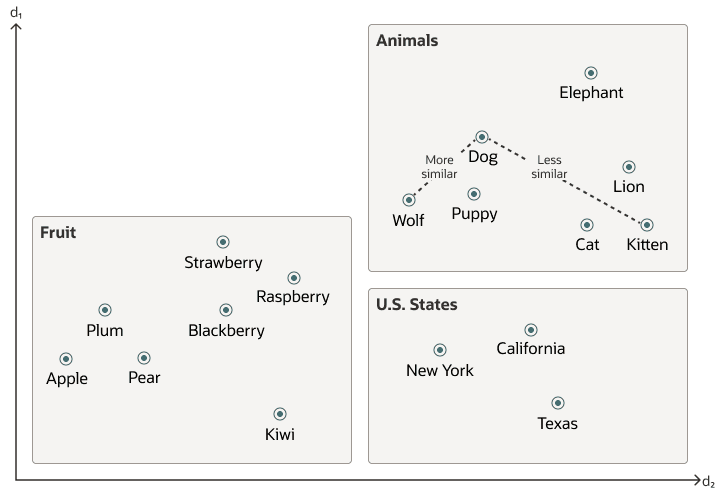
Beschreibung der Abbildung vector_embeddings_similarity.png
Vektordaten werden in der Regel ungleichmäßig verteilt und in Gruppen gruppiert, die semantisch miteinander verknüpft sind. Eine Ähnlichkeitssuche, die auf einem bestimmten Abfragevektor basiert, entspricht dem Abrufen der K-nächsten Vektoren zu Ihrem Abfragevektor in Ihrem Vektorraum. Grundsätzlich müssen Sie eine geordnete Liste von Vektoren finden, indem Sie sie einstufen, wobei die erste Zeile in der Liste der nächstgelegene oder ähnlichste Vektor zum Abfragevektor ist, die zweite Zeile in der Liste der zweitnächste Vektor zum Abfragevektor usw. Bei einer Ähnlichkeitssuche ist die relative Reihenfolge der Entfernungen wirklich wichtig und nicht die tatsächliche Entfernung.
Wenn Sie den vorhergehenden Vektorraum verwenden, sehen Sie hier eine Abbildung einer semantischen Suche, bei der der der Abfragevektor dem Wort Puppe entspricht und Sie die vier nächsten Wörter identifizieren möchten:
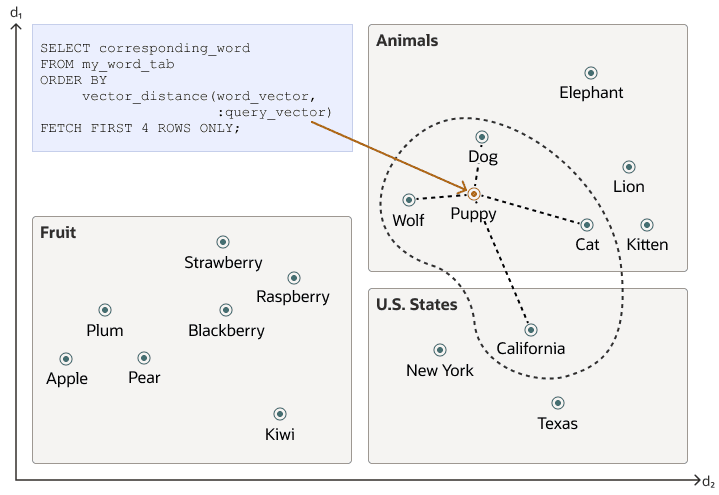
Beschreibung der Abbildung vector_embeddings_similarity_search.png
Ähnlichkeitssuchen rufen in der Regel Daten aus einem oder mehreren Clustern ab, abhängig vom Wert des Abfragevektors und der Abrufgröße.
Ungefähre Suchen mit Vektorindizes können die Suche auf bestimmte Cluster beschränken, während genaue Suchen Vektoren in allen Clustern aufrufen. Weitere Informationen finden Sie unter Vektorindizes verwenden.
Vektoreinbettungsmodelle
Eine Möglichkeit, solche Vektoreinbettungen zu erstellen, könnte darin bestehen, das Fachwissen einer Person zu nutzen, um eine vordefinierte Gruppe von Funktionen oder Dimensionen wie Form, Textur, Farbe, Stimmung und viele andere zu quantifizieren, je nach Objekttyp, mit dem Sie es zu tun haben. Die Effizienz dieser Methode hängt jedoch vom Anwendungsfall ab und ist nicht immer kostengünstig.
Stattdessen werden Vektoreinbettungen über neuronale Netzwerke erstellt. Die meisten modernen Vektoreinbettungen verwenden ein Transformatormodell, wie im folgenden Diagramm veranschaulicht, aber es können auch Faltungsneuronale Netze verwendet werden.
Abbildung 1: Vektor-Einbettungsmodell
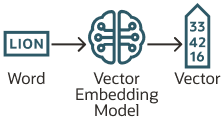
Beschreibung der Abbildung basic_transform.png
Je nach Art Ihrer Daten können Sie verschiedene vortrainierte Open-Source-Modelle verwenden, um Vektoreinbettungen zu erstellen. Beispiel:
-
Bei Textdaten transformieren Satztransformatoren Wörter, Sätze oder Absätze in Vektoreinbettungen.
-
Für visuelle Daten können Sie mit Residual Network (ResNet) Vektoreinbettungen generieren.
-
Für Audiodaten können Sie die visuelle Spektrogrammdarstellung der Audiodaten verwenden, um in den visuellen Datenfall zurückzukehren.
Jedes Modell bestimmt auch die Anzahl der Dimensionen für Ihre Vektoren. Beispiel:
-
Das Einbettungsmodell embed-english-v3.0 von Cohere hat 1024 Abmessungen.
-
Das Einbettungsmodell "Text-embedding-3-large" von OpenAI hat 3072 Dimensionen.
-
Das Einbettungsmodell von Hugging Face all-MiniLM-L6-v2 hat 384 Dimensionen
Natürlich können Sie jederzeit ein eigenes Modell erstellen, das mit Ihrem eigenen Datensatz trainiert wird.
Einbettungsmodelle in Oracle AI Database importieren
Obwohl Sie Vektoreinbettungen außerhalb von Oracle AI Database mit vortrainierten Open-Source-Einbettungsmodellen oder Ihren eigenen Einbettungsmodellen generieren können, haben Sie auch die Möglichkeit, diese Modelle direkt in die Oracle AI Database zu importieren, wenn sie mit dem Open Neural Network Exchange-(ONNX-)Standard kompatibel sind. Oracle AI Database implementiert eine ONNX-Laufzeit direkt in der Datenbank. Dadurch können Sie Vektoreinbettungen direkt in der Oracle AI Database mit SQL generieren. Weitere Informationen finden Sie unter Vektoreinbettungen generieren.
Vektorabstandsmetriken
Die Messung von Entfernungen in einem Vektorraum ist das Herzstück der Identifizierung der relevantesten Ergebnisse für einen bestimmten Abfragevektor. Dieser Prozess unterscheidet sich sehr von der bekannten Schlüsselwortfilterung in der relationalen Datenbankwelt.
Beim Arbeiten mit Vektoren gibt es mehrere Möglichkeiten, Entfernungen zu berechnen, um zu bestimmen, wie ähnlich oder unähnlich zwei Vektoren sind. Jede Entfernungsmetrik wird anhand verschiedener mathematischer Formeln berechnet. Die Zeit, die es braucht, um den Abstand zwischen zwei Vektoren zu berechnen, hängt von vielen Faktoren ab, einschließlich der verwendeten Entfernungsmetrik sowie dem Format der Vektoren selbst, wie der Anzahl der Vektordimensionen und den Vektordimensionsformaten. Im Allgemeinen ist es am besten, die von Ihnen verwendete Entfernungsmetrik mit der Metrik abzugleichen, die zum Trainieren des Vektoreinbettungsmodells verwendet wurde, das die Vektoren generiert hat.
Hierarchisch navigierbare kleine Weltindizes - Überblick
Verwenden Sie diese Beispiele, um zu verstehen, wie Sie HNSW-Indizes für ungefähre Ähnlichkeitssuchen von Vektoren erstellen.
Mit Navigable Small World (NSW) besteht die Idee darin, ein Näherungsdiagramm zu erstellen, bei dem sich jeder Vektor im Diagramm auf der Grundlage von drei Merkmalen mit mehreren anderen verbindet:
-
Der Abstand zwischen Vektoren
-
Die maximale Anzahl der nächsten Vektorkandidaten, die bei jedem Schritt der Suche beim Einfügen berücksichtigt werden
(EFCONSTRUCTION) -
Die maximal zulässige Anzahl von Verbindungen (
NEIGHBORS) pro Vektor
Wenn die Kombination der oben genannten Schwellenwerte zu hoch ist, können Sie am Ende ein dicht verbundenes Diagramm verwenden, das den Suchprozess verlangsamen kann. Andererseits, wenn die Kombination dieser Schwellenwerte zu niedrig ist, kann das Diagramm zu dünn und / oder getrennt werden, was es schwierig macht, einen Pfad zwischen bestimmten Vektoren während der Suche zu finden.
Navigable Small World (NSW)-Graph Traversal für die Vektorsuche beginnt mit einem vordefinierten Einstiegspunkt im Diagramm, der auf ein Cluster eng verwandter Vektoren zugreift. Der Suchalgorithmus verwendet zwei Schlüssellisten: Kandidaten, eine dynamisch aktualisierte Liste von Vektoren, auf die wir beim Durchlaufen des Diagramms stoßen, und Ergebnisse, die Vektoren enthalten, die dem bisher gefundenen Abfragevektor am nächsten sind. Während der Suche navigiert der Algorithmus durch das Diagramm und verfeinert die Kandidaten kontinuierlich, indem er Vektoren untersucht und bewertet, die näher als die in den Ergebnissen sein könnten. Der Prozess endet, wenn in den Kandidaten keine Vektoren mehr als die am weitesten entfernten in den Ergebnissen vorhanden sind, was darauf hinweist, dass ein lokales Minimum erreicht wurde und die nächsten Vektoren zum Abfragevektor identifiziert wurden.
Dies wird in der folgenden Grafik veranschaulicht:
Abbildung 2: Navigierbare kleine Weltgrafik
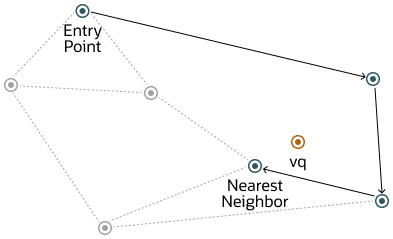
Beschreibung der Abbildung navigable-small-world-graph.png
Das beschriebene Verfahren zeigt eine robuste Leistung bis zu einer gewissen Skala der Vektoreinfügung in das Diagramm. Über diesen Schwellenwert hinaus verbessert der hierarchisch navigierbare Small World-(HNSW-)Ansatz das NSW-Modell durch die Einführung einer mehrschichtigen Hierarchie, ähnlich der Struktur, die in Probabilistic Skip Lists beobachtet wird. Diese hierarchische Architektur wird implementiert, indem die Verbindungen des Diagramms über mehrere Ebenen verteilt werden und so organisiert werden, dass jede nachfolgende Schicht eine Teilmenge der Vektoren aus der darunter liegenden Schicht enthält. Diese Schichtung stellt sicher, dass die oberen Ebenen Fernlinks erfassen, die effektiv als Schnellwege über das Diagramm dienen, während sich die unteren Ebenen auf kürzere Links konzentrieren und eine fein granulierte, lokale Navigation ermöglichen. Infolgedessen beginnen Suchen an den höheren Schichten, um schnell den Bereich des Zielvektors zu annähern, und bewegen sich schrittweise zu niedrigeren Schichten für eine genauere Suche, was die Sucheffizienz und -genauigkeit erheblich verbessert, indem kürzere Links (kleinere Abstände) zwischen Vektoren genutzt werden, wenn man sich von der obersten Ebene nach unten bewegt.
Um besser zu verstehen, wie dies für HNSW funktioniert, schauen wir uns an, wie diese Hierarchie für die Struktur "Wahrscheinlichkeitssprungliste" verwendet wird:
Abbildung 3: Skip-Listenstruktur für Wahrscheinlichkeit
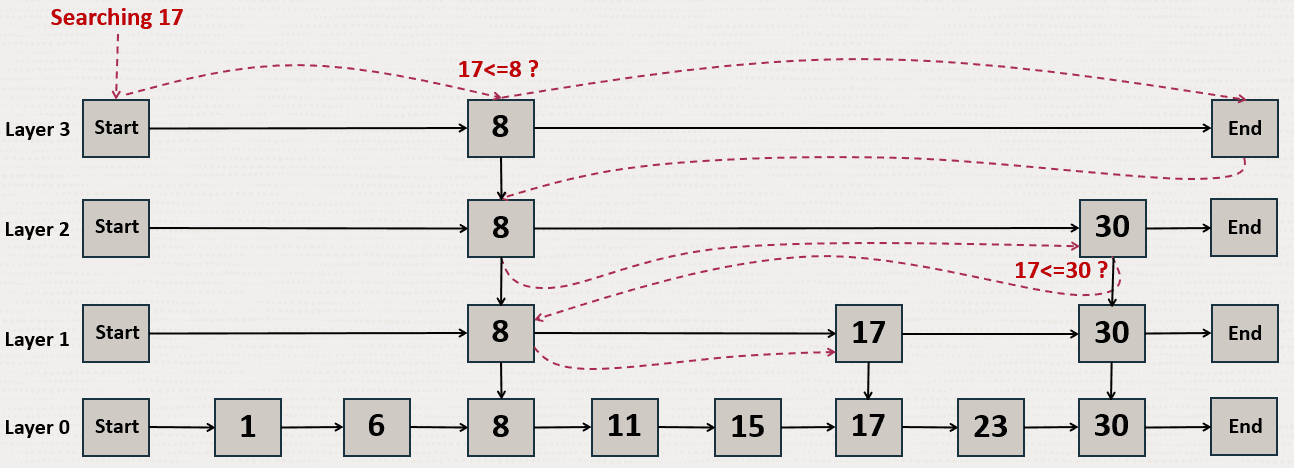
Beschreibung der Abbildung probability-skip-list_01.png
Die Struktur "Wahrscheinlichkeitssprungliste" verwendet mehrere Ebenen verknüpfter Listen, bei denen die obigen Ebenen mehr Zahlen überspringen als die unteren. In diesem Beispiel suchen Sie nach Nummer 17. Sie beginnen mit der obersten Ebene und springen zum nächsten Element, bis Sie entweder 17 finden, das Ende der Liste erreichen oder eine Zahl größer als 17 finden. Wenn Sie das Ende einer Liste erreichen oder eine Zahl größer als 17 finden, beginnen Sie in der vorherigen Ebene von der letzten Zahl kleiner als 17.
HNSW verwendet das gleiche Prinzip mit NSW-Schichten, bei denen Sie größere Abstände zwischen Vektoren in den höheren Schichten finden. Dies wird durch die folgenden Diagramme in einem 2D-Bereich veranschaulicht:
Auf der obersten Ebene sind die längsten Kanten und auf der unteren Ebene die kürzesten.
Abbildung 4: Hierarchische navigierbare kleine Weltgrafiken
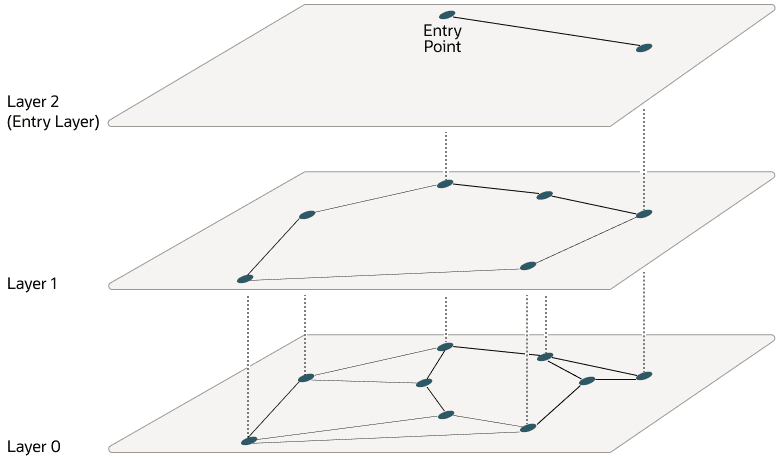
Beschreibung der Abbildung hierarchical-navigable-small-world-graph_02.png
Ausgehend von der obersten Ebene beginnt die Suche in einer Ebene am Eingabevektor. Wenn für jeden Knoten ein Neighbor vorhanden ist, der näher am Abfragevektor liegt als der aktuelle Knoten, springt er zu diesem Neighbor. Der Algorithmus tut dies so lange, bis er ein lokales Minimum für den Abfragevektor findet. Wenn ein lokales Minimum in einer Ebene gefunden wird, geht die Suche zur nächsten Ebene, indem derselbe Vektor in dieser neuen Ebene verwendet wird, und die Suche wird in dieser Ebene fortgesetzt. Dieser Vorgang wiederholt sich, bis das lokale Minimum der unteren Schicht gefunden wird, die alle Vektoren enthält. An diesem Punkt wird die Suche mit dem NSW-Algorithmus um das letzte gefundene lokale Minimum in eine ungefähre Ähnlichkeitssuche transformiert, um die Top k-Vektoren zu extrahieren, die dem Abfragevektor am ähnlichsten sind. Während die oberen Schichten für jeden durch den Parameter NEIGHBORS festgelegten Vektor maximal Verbindungen aufweisen können, kann Layer 0 doppelt so viel aufweisen. Dieser Prozess wird in der folgenden Grafik veranschaulicht:
Abbildung 5: Hierarchisch navigierbare kleine Weltgrafiken suchen
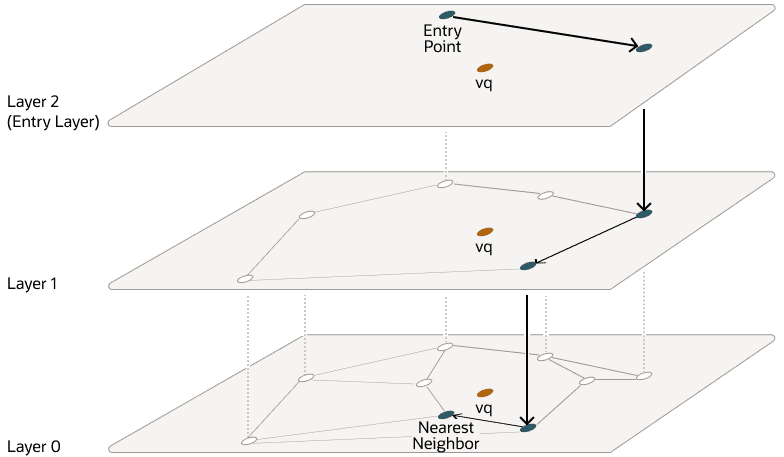
Beschreibung der Abbildung hnsw-search-graph_02-png.png
Layer werden mit In-Memory-Diagrammen (nicht mit Oracle Inmemory-Diagrammen) implementiert. Jede Ebene verwendet ein separates In-Memory-Diagramm. Wie bereits erwähnt, können Sie beim Erstellen eines HNSW-Index die maximale Anzahl der Verbindungen pro Vektor in den oberen Layern mit dem Parameter NEIGHBORS sowie die maximale Anzahl der nächsten Vektorkandidaten optimieren, die bei jedem Schritt der Suche beim Einfügen berücksichtigt werden. Verwenden Sie dazu den Parameter EFCONSTRUCTION, wobei EF für Enter Factor steht.
Wie bereits erläutert, können Sie bei der Ausführung einer ungefähren Suchabfrage mit HNSW-Indizes mit Oracle AI Vector Search eine Zielgenauigkeit angeben, bei der die ungefähre Suche ausgeführt werden soll.
Bei einer Näherungssuche mit HNSW können Sie einen Zielgenauigkeitswert in Prozent angeben, um die Anzahl der Kandidaten zu beeinflussen, die bei der Suche infrage kommen. Dies wird automatisch vom Algorithmus berechnet. Ein Wert von 100 wird in der Regel ein ähnliches Ergebnis wie eine exakte Suche auferlegen, obwohl das System möglicherweise immer noch den Index verwendet und keine exakte Suche durchführt. Der Optimizer kann einen Index weiterhin verwenden, da dies aufgrund der Prädikate in der Abfrage möglicherweise schneller erfolgen kann. Anstatt einen Prozentwert für die Zielgenauigkeit anzugeben, können Sie den Parameter EFSEARCH angeben, um eine bestimmte maximale Anzahl von Kandidaten festzulegen, die beim Durchsuchen des Index berücksichtigt werden sollen. Je höher diese Zahl ist, desto höher ist die Genauigkeit.
Hinweis:
-
Wenn Sie in Ihrer ungefähren Suchabfrage keine Zielgenauigkeit angeben, erben Sie das Set, als der Index erstellt wurde. Sie sehen, dass Sie bei der Indexerstellung eine Zielgenauigkeit entweder mit einem Prozentwert oder mit Parameterwerten angeben können, je nachdem, welchen Indextyp Sie erstellen.
-
Bei der Indexsuche kann eine andere Zielgenauigkeit als bei der Indexerstellung angegeben werden. Bei HNSW-Indizes können Sie mit dem Parameter
EFSEARCH(höher als der bei der Indexerstellung angegebene WertEFCONSTRUCTION) mehr Neighbors anzeigen, um genauere Ergebnisse zu erhalten. Die Zielgenauigkeit, die Sie bei der Indexerstellung angeben, bestimmt die Indexerstellungsparameter und fungiert auch als Standardgenauigkeitswerte für Vektorindexsuchen.
Flache Vektorindizes invertierter Datei verstehen
Der Inverted File Flat Vector Index ist eine Technik, die entwickelt wurde, um die Sucheffizienz zu verbessern, indem der Suchbereich durch die Verwendung von benachbarten Partitionen oder Clustern eingeschränkt wird.
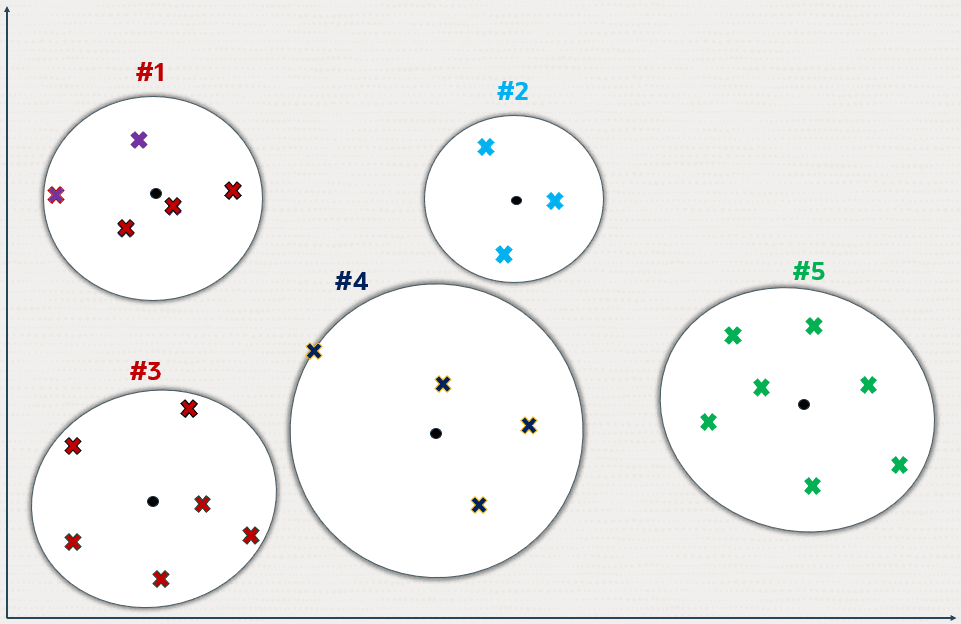
Die folgenden Diagramme zeigen, wie Partitionen oder Cluster in einer ungefähren Suche mit einer 2D-Speicherplatzdarstellung erstellt werden. Aber dies kann auf viel höher dimensionale Räume verallgemeinert werden.
Abbildung 6: Flat Index der invertierten Datei mit 2D
Beschreibung der Abbildung inverted-file-index_1.png
Kreuzungen stellen die Vektordatenpunkte in diesem Raum dar.
Neue Datenpunkte, die als kleine einfache Kreise angezeigt werden, werden hinzugefügt, um k-Partitions-Centroids zu identifizieren, wobei die Anzahl der Centroids (k) durch die Größe des Datasets (n) bestimmt wird. Normalerweise wird k auf die Quadratwurzel von n gesetzt. Sie kann jedoch angepasst werden, indem der Parameter NEIGHBOR PARTITIONS während der Indexerstellung angegeben wird.
Jeder Zentroid repräsentiert den mittleren Vektor (Schwerpunkt) der entsprechenden Partition.
Die Zentroide werden durch einen Trainingspass über die Vektoren berechnet, deren Ziel es ist, den Gesamtabstand jedes Vektors vom nächsten Zentroid zu minimieren.
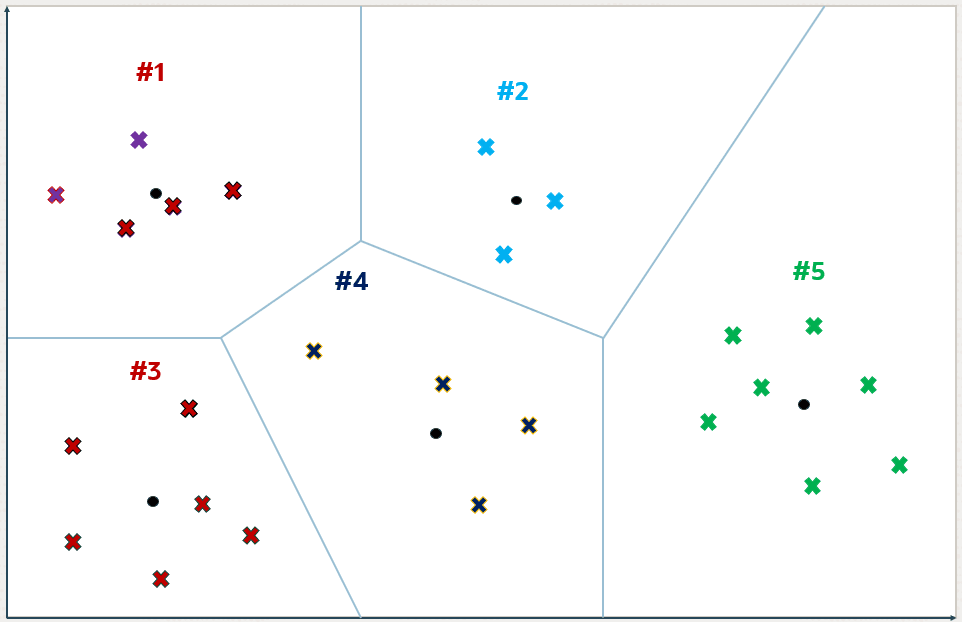
Die Centroids partitionieren den Vektorspeicher in k-Partitionen. Diese Teilung wird konzeptuell als sich ausdehnende Kreise von den Zentroiden dargestellt, die aufhören zu wachsen, wenn sie sich treffen und unterschiedliche Partitionen bilden.
Abbildung 7: Inverted File Flat Index
Beschreibung der Abbildung inverted-file-index_5.png
Mit Ausnahme derjenigen an der Peripherie fällt jeder Vektor in eine bestimmte Partition, die einem Zentroid zugeordnet ist.
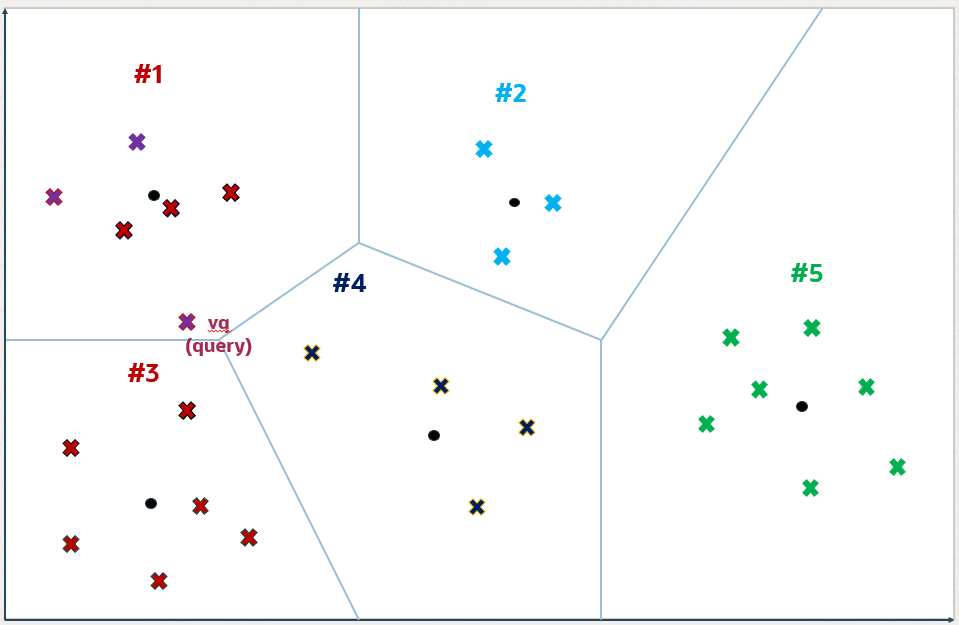
Abbildung 8: Inverted File Flat Index
Beschreibung der Abbildung invertiert-file-index_6.png
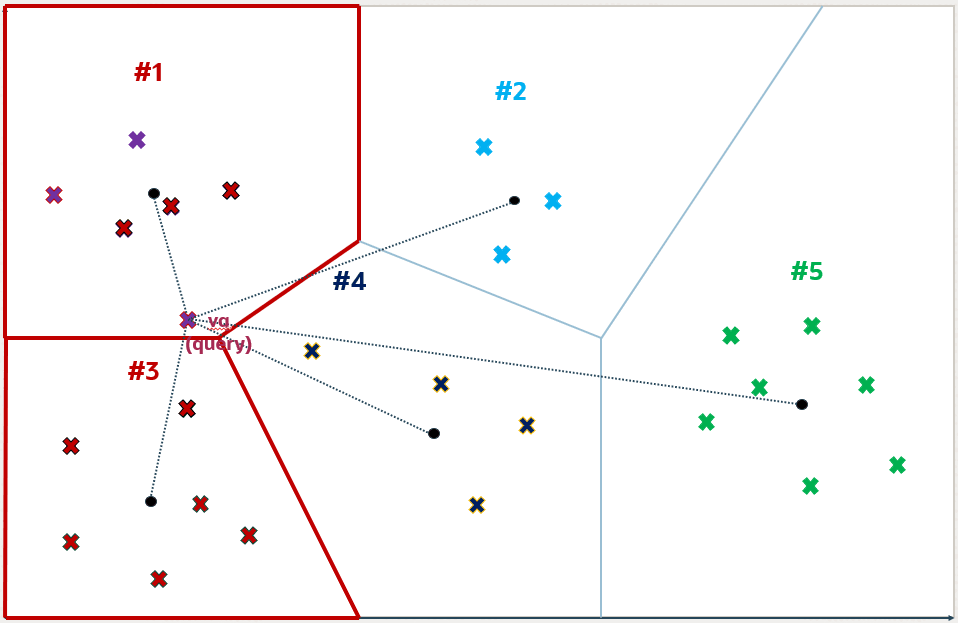
Bei einem Abfragevektor vq identifiziert der Suchalgorithmus die nächsten i-Centroids, wobei i standardmäßig die Quadratwurzel von k ist, aber für eine bestimmte Abfrage angepasst werden kann, indem der Parameter NEIGHBOR PARTITION PROBES festgelegt wird. Diese Anpassung ermöglicht einen Kompromiss zwischen Suchgeschwindigkeit und Genauigkeit.
Höhere Zahlen für diesen Parameter führen zu höherer Genauigkeit. In diesem Beispiel ist i auf 2 gesetzt, und die beiden identifizierten Partitionen sind Partitionen mit der Nummer 1 und 3.
Abbildung 9: Inverted File Flat Index
Beschreibung der Abbildung inverted-file-index_7.png
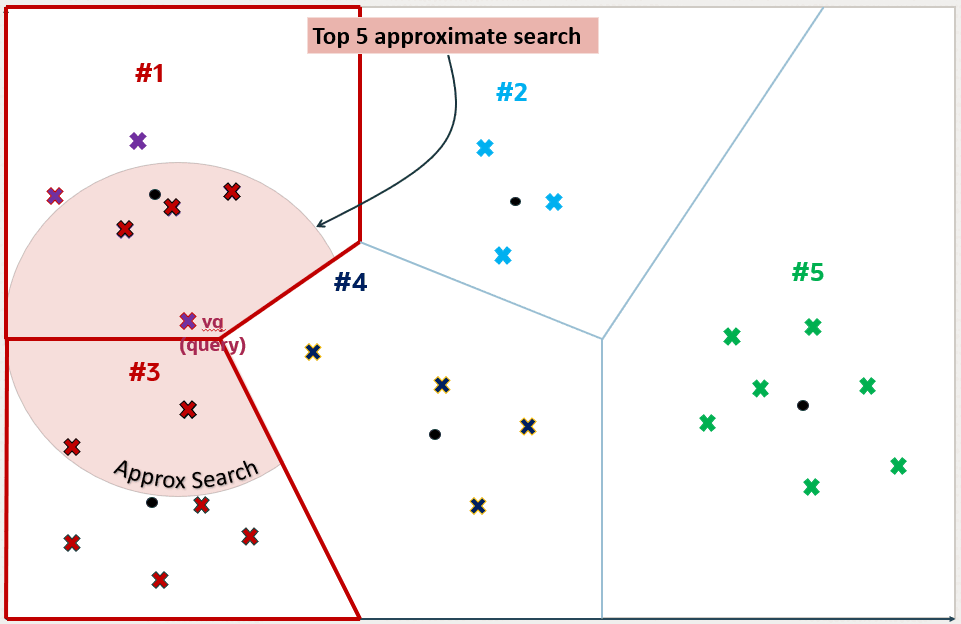
Nachdem die i-Partitionen bestimmt wurden, werden sie vollständig gescannt, um in diesem Beispiel die Top 5 der nächsten Vektoren zu identifizieren. Diese Zahl 5 kann sich von k unterscheiden, und Sie geben diese Zahl in Ihrer Abfrage an. Die fünf nächsten Vektoren zu vq, die in den Partitionen 1 und 3 gefunden wurden, werden im folgenden Diagramm hervorgehoben.
Diese Methode stellt eine ungefähre Suche dar, da sie die Suche auf eine Teilmenge von Partitionen beschränkt, wodurch der Prozess beschleunigt wird, aber möglicherweise engere Vektoren in nicht untersuchten Partitionen fehlen. Dieses Beispiel veranschaulicht, dass eine ungefähre Suche möglicherweise nicht die genauen nächstgelegenen Vektoren zu vq liefert, was den inhärenten Kompromiss zwischen Sucheffizienz und Genauigkeit zeigt.
Abbildung 10: Inverted File Flat Index
Beschreibung der Abbildung inverted-file-index_10.png
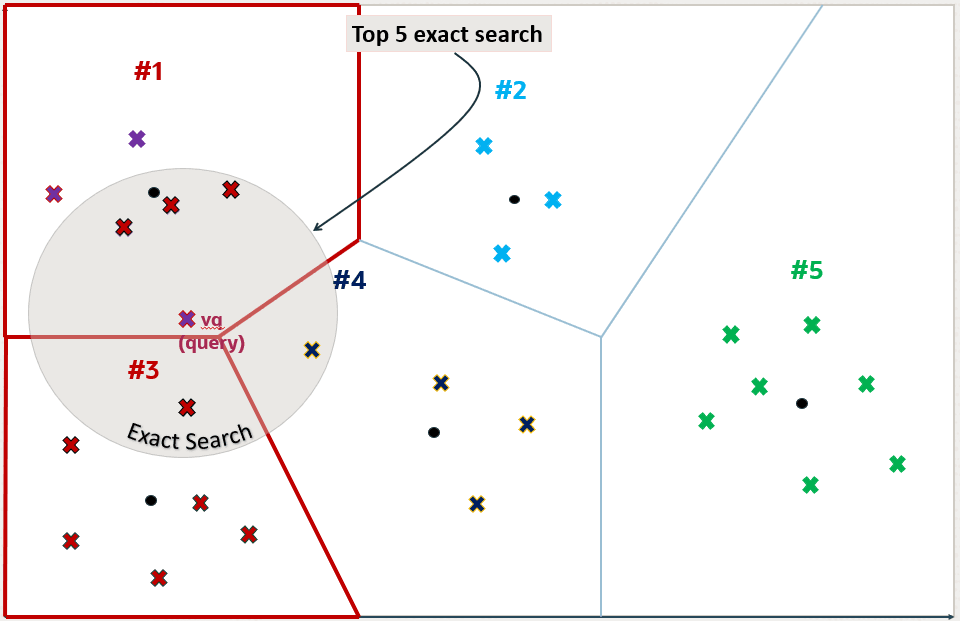
Die fünf genau nächstgelegenen Vektoren von vq sind jedoch nicht die, die bei der ungefähren Suche gefunden werden. Sie können sehen, dass einer der Vektoren in Partition 4 näher an vq liegt als einer der abgerufenen Vektoren in Partition 3.
Abbildung 11: Inverted File Flat Index
Beschreibung der Abbildung inverted-file-index_11.png
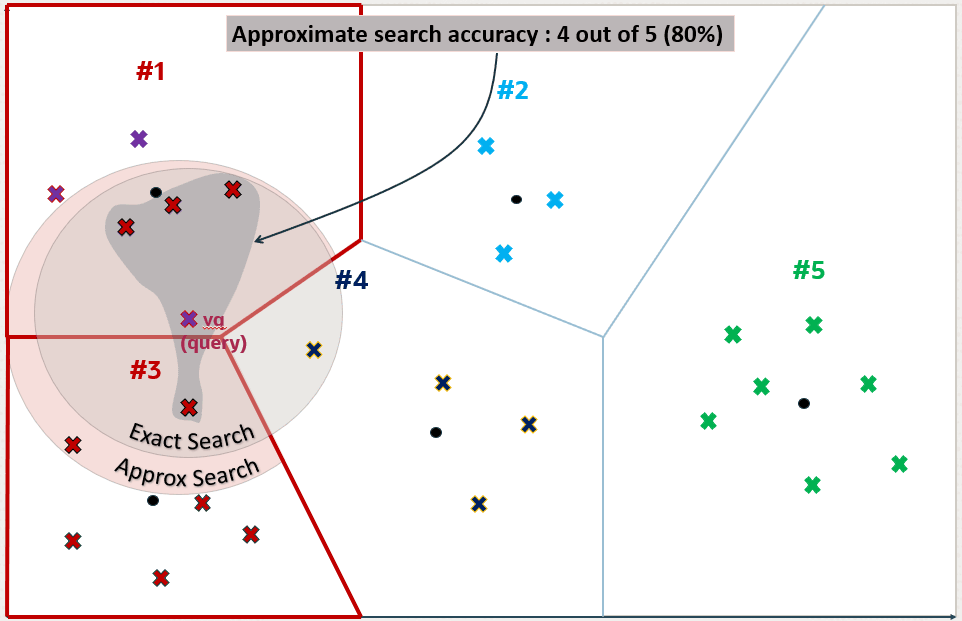
Sie können jetzt sehen, warum die Verwendung von Vektor-Index-Suchen nicht immer eine exakte Suche ist und stattdessen eine ungefähre Suche genannt wird. In diesem Beispiel beträgt die ungefähre Suchgenauigkeit nur 80%, da nur 4 von 5 Ergebnissen der exakten Suchvektoren abgerufen wurden.
Abbildung 12: Inverted File Flat Index
Beschreibung der Abbildung inverted-file-index_12.png
Wenn Sie mit Oracle AI Vector Search eine ungefähre Suchabfrage mit Vektorindizes ausführen, können Sie eine Zielgenauigkeit angeben, bei der die ungefähre Suche ausgeführt werden soll.
Bei einer ungefähren IVF-Suche können Sie einen Zielgenauigkeitsprozentsatz angeben, um die Anzahl der Partitionen zu beeinflussen, mit denen die Suche untersucht wird. Dies wird automatisch vom Algorithmus berechnet. Ein Wert von 100 wird in der Regel eine exakte Suche auferlegen, obwohl das System möglicherweise immer noch den Index verwendet und keine exakte Suche durchführt. Der Optimizer kann einen Index weiterhin verwenden, da dies aufgrund der Prädikate in der Abfrage möglicherweise schneller erfolgen kann. Anstatt einen Prozentwert für die Zielgenauigkeit anzugeben, können Sie den Parameter NEIGHBOR PARTITION PROBES angeben, um eine bestimmte maximale Anzahl von Partitionen festzulegen, die von der Suche geprüft werden sollen. Je höher diese Zahl ist, desto höher ist die Genauigkeit.
Hinweis:
-
Wenn Sie in Ihrer ungefähren Suchabfrage keine Zielgenauigkeit angeben, erben Sie das Set, als der Index erstellt wurde. Sie werden sehen, dass Sie bei der Indexerstellung eine Zielgenauigkeit entweder mit einem Prozentwert oder mit Parameterwerten angeben können, je nachdem, welchen Indextyp Sie erstellen.
-
Bei der Indexsuche kann eine andere Zielgenauigkeit als bei der Indexerstellung angegeben werden. Bei IVF-Indizes können Sie mit dem Parameter
NEIGHBOR PARTITION PROBESweitere Zentroid-Partitionen abfragen, um genauere Ergebnisse zu erhalten. Die Zielgenauigkeit, die Sie bei der Indexerstellung angeben, bestimmt die Indexerstellungsparameter und fungiert auch als Standardgenauigkeitswert für Vektorindexsuchen.
Ähnlichkeitssuchen ausführen
In diesem Abschnitt werden die Methoden für die Suche nach Ähnlichkeiten beschrieben.
-
Suche nach genauer Ähnlichkeit ausführen Eine Ähnlichkeitssuche sucht nach der relativen Reihenfolge der Vektoren im Vergleich zu einem Abfragevektor. Natürlich wird der Vergleich mit einer bestimmten Entfernungsmetrik durchgeführt, aber was wichtig ist, ist die Ergebnismenge Ihrer Top-nächsten Vektoren, nicht der Abstand zwischen ihnen.
-
Ungefähre Ähnlichkeitssuche mit Vektorindizes verstehen Für schnellere Suchgeschwindigkeiten mit großen Vektorräumen können Sie eine ungefähre Ähnlichkeitssuche mit Vektorindizes verwenden.
-
Ähnlichkeitssuche mit mehreren Vektoren ausführen Ein weiterer wichtiger Anwendungsfall der Vektorsuche ist die Vektorsuche mit mehreren Vektoren. Multi-Vector-Suche wird in der Regel mit einer Multi-Dokument-Suche verknüpft, bei der Dokumente in Blöcke aufgeteilt werden, die einzeln in Vektoren eingebettet sind.
Exakte Ähnlichkeitssuche ausführen
Bei einer Ähnlichkeitssuche wird die relative Reihenfolge der Vektoren im Vergleich zu einem Abfragevektor gesucht. Natürlich wird der Vergleich mit einer bestimmten Entfernungsmetrik durchgeführt, aber was wichtig ist, ist die Ergebnismenge Ihrer Top-nächsten Vektoren, nicht der Abstand zwischen ihnen.
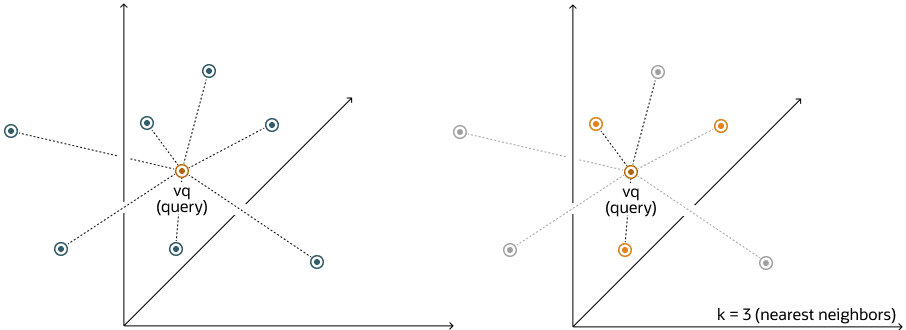
Als Beispiel können Sie bei einem bestimmten Abfragevektor den Abstand zu allen anderen Vektoren in Ihrem Datensatz berechnen. Diese Art der Suche, auch Flat Search oder exakte Suche genannt, erzeugt die genauesten Ergebnisse mit perfekter Suchqualität. Dabei geht es jedoch um erhebliche Suchzeiten. Dies wird nachfolgende Diagramme veranschaulicht:
Abbildung 13: Exakte Suche
Beschreibung der Abbildung Flat-index.png
Mit einer exakten Suche vergleichen Sie den Abfragevektor vq mit jedem anderen Vektor in Ihrem Raum, indem Sie seinen Abstand zu jedem Vektor berechnen. Nachdem alle diese Entfernungen berechnet wurden, gibt die Suche die nächste k dieser Entfernungen als die nächsten Übereinstimmungen zurück. Dies wird als k-nearest Neighbors (kNN) Suche bezeichnet.
Beispiel: Bei der euklidischen Ähnlichkeitssuche werden die Top-K-Vektoren in Ihrem Raum relativ zur euklidischen Entfernungsmetrik und einem Abfragevektor abgerufen. Im Folgenden finden Sie ein Beispiel, das die Top 10 Vektoren aus der Tabelle vector_tab abruft, die query_vector am nächsten sind. Verwenden Sie dazu die folgende Suchabfrage mit genauer Ähnlichkeit:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;
In diesem Beispiel sind docID und embedding Spalten, die in der Tabelle vector_tab definiert sind, und embedding den Datentyp VECTOR.
Bei euklidischen Entfernungen entspricht der Vergleich von quadratischen Entfernungen dem Vergleich von Entfernungen. Wenn die Reihenfolge also wichtiger ist als die Entfernungswerte selbst, ist die euklidische quadratische Entfernung sehr nützlich, da sie schneller berechnet wird als die euklidische Entfernung (vermeidet die Berechnung der Quadratwurzel). Daher ist es einfacher und schneller, die Abfrage wie folgt umzuschreiben:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;
Hinweis: Das Schlüsselwort EXACT ist optional. Wird während der Verbindung mit einer ADB-S-Instanz ausgelassen, wird eine ungefähre Suche mit einem Vektorindex versucht, sofern vorhanden. Weitere Informationen finden Sie unter Ungefähre Ähnlichkeitssuche mit Vektorindizes ausführen.
Hinweis: Stellen Sie sicher, dass Sie die Entfernungsfunktion verwenden, die zum Trainieren des Einbettungsmodells verwendet wurde.
Siehe auch: Oracle AI Database SQL Language Reference für die vollständige Syntax der ROW_LIMITING_CLAUSE
Ungefähre Ähnlichkeitssuche mit Vektorindizes verstehen
Für schnellere Suchgeschwindigkeiten mit großen Vektorräumen können Sie eine ungefähre Ähnlichkeitssuche mit Vektorindizes verwenden.
Die Verwendung von Vektorindizes für eine Ähnlichkeitssuche wird als ungefähre Suche bezeichnet. Ungefähre Suchen verwenden Vektorindizes, mit denen die Genauigkeit für die Performance beeinträchtigt wird.
Ungefähre Suche nach großen Vektorräumen
Wenn die Suchqualität Ihre hohe Priorität hat und die Suchgeschwindigkeit weniger wichtig ist, ist die Exact Similarity-Suche eine gute Option. Die Suchgeschwindigkeit kann für kleinere Vektorräume oder bei Suchvorgängen mit Hochleistungsservern irrelevant sein. ML-Algorithmen führen jedoch häufig Ähnlichkeitssuchen auf Vektorräumen mit Milliarden von Einbettungen durch. Beispiel: Das Dataset Deep1B enthält 1B-Images, die von einem Convolutional Neural Network (CNN) generiert werden. Die Berechnung von Vektorabständen mit jedem Vektor im Korpus, um Top-K-Übereinstimmungen mit einer Genauigkeit von 100 Prozent zu finden, ist sehr langsam.
Glücklicherweise gibt es viele Arten von ungefähren Suchen, die Sie mit Vektorindizes durchführen können. Vektorindizes können weniger genau sein, aber weniger Ressourcen verbrauchen und effizienter sein. Im Gegensatz zu herkömmlichen Datenbankindizes werden Vektorindizes erstellt und führen Suchen mit heuristischen Algorithmen durch.
Da die Heuristik keine 100-prozentige Genauigkeit gewährleisten kann, verwenden Vektordatensuchen die Zielgenauigkeit. Intern tun die Algorithmen, die sowohl zur Indexerstellung als auch zur Indexsuche verwendet werden, ihr Bestes, um so genau wie möglich zu sein. Sie haben jedoch die Möglichkeit, diese Algorithmen zu beeinflussen, indem Sie eine Zielgenauigkeit angeben. Wenn Sie den Index erstellen oder durchsuchen, können Sie nicht standardmäßige Zielgenauigkeitswerte angeben, indem Sie entweder einen Prozentwert angeben oder interne Parameterwerte angeben, je nach verwendetem Indextyp.
Beispiel für Zielgenauigkeit
Um besser zu verstehen, was mit Zielgenauigkeit gemeint ist, schauen Sie sich die folgenden Diagramme an. Das erste Diagramm veranschaulicht einen Vektorraum, in dem jeder Vektor durch ein kleines Kreuz dargestellt wird. Der rote Wert steht für Ihren Abfragevektor.
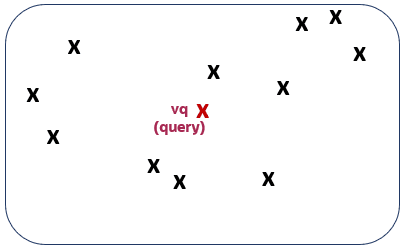
Beschreibung der Abbildung accuracy1.png
Wenn Sie eine Top-5-Suche mit genauer Ähnlichkeit in diesem Kontext ausführen, werden die fünf Vektoren zurückgegeben, die im zweiten Diagramm angezeigt werden:
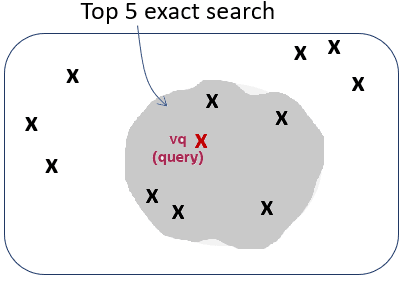
Beschreibung der Abbildung accuracy2.png
Je nachdem, wie Ihr Vektor-Index erstellt wurde, könnte eine oberste 5-nahe Ähnlichkeitssuche in diesem Kontext die fünf im dritten Diagramm gezeigten Vektoren zurückgeben. Dies liegt daran, dass der Indexerstellungsprozess Heuristiken verwendet. So kann die Suche durch den Vektor-Index zu verschiedenen Ergebnissen im Vergleich zu einer genauen Suche führen:
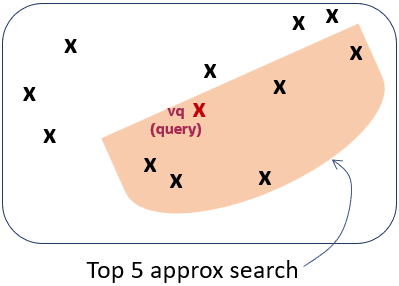
Beschreibung der Abbildung accuracy3.png
Wie Sie sehen können, sind die abgerufenen Vektoren unterschiedlich und unterscheiden sich in diesem Fall um einen Vektor. Dies bedeutet, dass die Ähnlichkeitssuche im Vergleich zur exakten Suche 4 von 5 Vektoren korrekt abgerufen hat. Die Ähnlichkeitssuche hat eine 80%ige Genauigkeit im Vergleich zur genauen Ähnlichkeitssuche. Dies wird im vierten Diagramm veranschaulicht:
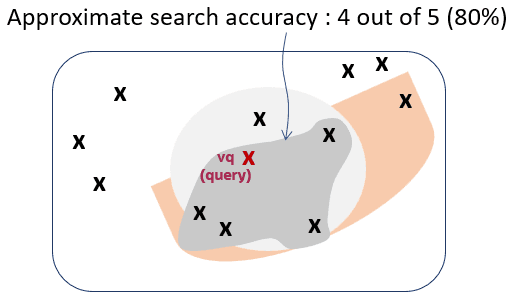
Beschreibung der Abbildung accuracy4.png
Da Vektorindizes ungefähre Suchstrukturen darstellen, ist es möglich, dass weniger als K-Zeilen in einer Top-K-Ähnlichkeitssuche zurückgegeben werden.
Informationen zum Einrichten Ihrer Vektorindizes finden Sie unter Vektorindizes erstellen.
Ähnlichkeitssuche mit mehreren Ebenen ausführen
Ein weiterer wichtiger Anwendungsfall der Vektorsuche ist die Multi-Vektor-Suche. Multi-Vector-Suche wird in der Regel mit einer Multi-Dokument-Suche verknüpft, bei der Dokumente in Blöcke aufgeteilt werden, die einzeln in Vektoren eingebettet sind.
Eine Multi-Vektor-Suche besteht darin, Top-K-Vektorübereinstimmungen anhand von Gruppierungskriterien abzurufen, die als Partitionen basierend auf den Eigenschaften der Dokumente bezeichnet werden. Diese Möglichkeit, Dokumente basierend auf der Ähnlichkeit ihrer Blöcke mit einem gesuchten Abfragevektor zu bewerten, wird in SQL mit der partitionierten Zeilenbegrenzungsklausel erleichtert.
Bei der Multi-Vector-Suche ist es einfacher, SQL-Anweisungen zu schreiben, um die folgende Art von Frage zu beantworten:
- Wenn sie existieren, was sind die vier am besten passenden Sätze in den drei am besten passenden Absätzen der beiden am besten passenden Bücher gefunden?
Beispiel: Wenn jedes Buch in Ihrer Datenbank in Absätze mit Sätzen organisiert ist, die Vektoreinbettungsdarstellungen enthalten, können Sie die vorherige Frage mit einer einzigen SQL-Anweisung beantworten, wie:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
Sie können auch eine ungefähre Ähnlichkeitssuche anstelle einer exakten Ähnlichkeitssuche verwenden, wie im folgenden Beispiel gezeigt:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;
Hinweis: Alle zurückgegebenen Zeilen werden nach VECTOR_DISTANCE() sortiert und nicht nach der Partitionsklausel gruppiert.
Semantisch wird die vorherige SQL-Anweisung wie folgt interpretiert:
-
Sortieren Sie alle Datensätze in der Bücher-Tabelle in absteigender Reihenfolge des Vektorabstands zwischen den Sätzen und dem Abfragevektor.
-
Prüfen Sie für jeden Datensatz in diesem Auftrag die Werte
bookIdundparagraphId. Dieser Datensatz wird erstellt, wenn die folgenden drei Bedingungen erfüllt sind:-
Die
bookIdist eine der ersten beiden eindeutigenbookIdin der sortierten Reihenfolge. -
Die
paragraphIdist eine der ersten drei eindeutigenparagraphIdin der sortierten Reihenfolge innerhalb derselbenbookId. -
Der Datensatz ist einer der ersten vier Datensätze innerhalb derselben Kombination aus
bookIdundparagraphId.
-
-
Andernfalls wird dieser Datensatz herausgefiltert.
Die Multi-Vektor-Ähnlichkeitssuche ist nicht nur für Dokumente gedacht und kann auch zur Beantwortung der folgenden Fragen verwendet werden:
-
Geben Sie die besten K nächstgelegenen passenden Fotos zurück, aber stellen Sie sicher, dass sie Fotos von verschiedenen Personen sind.
-
Finden Sie die besten K-Songs mit zwei oder mehr Audiosegmenten, die am besten zu diesem Sound Snippet passen.
Hinweis:
-
Diese Klauselerweiterung zur Zeilenbegrenzung der Partition ist eine allgemeine Erweiterung der SQL-Sprache. Es muss nicht nur für Vektorsuchen gelten.
-
Multi-Vector-Suche wird derzeit mit dem IVF-Index unterstützt.
Siehe auch: Oracle AI Database SQL Language Reference für die vollständige Syntax der ROW_LIMITING_CLAUSE