Inteligencia artificial en Oracle AI Database
En este capítulo se describen las funciones de inteligencia artificial que se proporcionan en Oracle AI Database.
-
Visión general de Oracle AI Vector Search Oracle AI Vector Search está diseñado para cargas de trabajo de inteligencia artificial (IA) y le permite consultar datos basados en semántica, en lugar de palabras clave.
-
Métricas de distancia de vector La medición de distancias en un espacio vectorial es el núcleo de la identificación de los resultados más relevantes para un determinado vector de consulta. Ese proceso es muy diferente del conocido filtrado de palabras clave en el mundo de las bases de datos relacionales.
-
Visión General de Índices de Mundo Pequeño Navegables Jerárquicos Utilice estos ejemplos para comprender cómo crear índices HNSW para búsquedas de similitud aproximadas vectoriales.
-
Descripción de Índices Vectoriales Planos de Archivos Invertidos El índice vectorial Planos de Archivos Invertidos es una técnica diseñada para mejorar la eficacia de la búsqueda mediante el estrechamiento del área de búsqueda mediante el uso de particiones o clusters vecinos.
-
Realización de Búsquedas de Similitud En esta sección se describen los métodos para realizar búsquedas de similitud.
Visión general de Oracle AI Vector Search
Oracle AI Vector Search está diseñado para cargas de trabajo de inteligencia artificial (IA) y te permite consultar datos basados en semántica, en lugar de palabras clave.
Tipo de datos de VECTOR
El tipo de datos VECTOR se presenta con el lanzamiento de Oracle AI Database 26ai, que proporciona la base para almacenar incrustaciones vectoriales junto con datos empresariales en la base de datos. Mediante el uso de modelos de incrustación, puede transformar datos no estructurados en incrustaciones vectoriales que luego se pueden utilizar para consultas semánticas en datos empresariales. Para utilizar el tipo de dato VECTOR y sus funciones relacionadas, el parámetro de inicialización COMPATIBLE se debe definir en 23.4.0 o una versión posterior. Para obtener más información sobre el parámetro y cómo cambiarlo, consulte Oracle AI Database Upgrade Guide.
Consulte el siguiente ejemplo básico de uso del tipo de dato VECTOR en una definición de tabla:
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);Para obtener más información sobre el tipo de dato VECTOR y cómo utilizar vectores en tablas, consulte Creación de tablas mediante el tipo de dato VECTOR.
Debido a la naturaleza numérica del tipo de dato VECTOR, puede utilizarlo como entrada para los algoritmos de Machine Learning, como la clasificación, la anomalía, la regresión, la agrupación en clusters y la extracción de funciones. Puede encontrar más información sobre el uso del tipo de datos VECTOR en el aprendizaje automático en Soporte de tipo de datos de vector. Nota: El soporte para el aprendizaje automático de tipo de dato VECTOR está disponible en todas las versiones a partir de la versión 23.7.
Incrustaciones de vector
Si alguna vez has utilizado aplicaciones como asistentes de voz, bots conversacionales, traductores de idiomas, sistemas de recomendación, detección de anomalías o búsqueda y reconocimiento de videos, has utilizado implícitamente funciones de incrustación de vectores.
Oracle AI Vector Search almacena incrustaciones vectoriales, que son representaciones vectoriales matemáticas de puntos de datos. Estas incrustaciones vectoriales describen el significado semántico detrás del contenido, como palabras, documentos, pistas de audio o imágenes. Por ejemplo, mientras se realizan búsquedas basadas en texto, la búsqueda vectorial a menudo se considera mejor que la búsqueda por palabras clave, ya que la búsqueda vectorial se basa en el significado y el contexto detrás de las palabras y no en las propias palabras. Esta representación vectorial traduce la similitud semántica de objetos, tal como perciben los humanos, en proximidad en un espacio vectorial matemático. Este espacio vectorial suele tener muchos cientos, si no miles, de dimensiones. En otras palabras, las incrustaciones vectoriales son una forma de representar casi cualquier tipo de datos, como texto, imágenes, videos, usuarios o música como puntos en un espacio multidimensional donde las ubicaciones de esos puntos en el espacio y la proximidad a otros, son semánticamente significativas.
Este diagrama simplificado ilustra un espacio vectorial donde las palabras se codifican como vectores de 2 dimensiones.
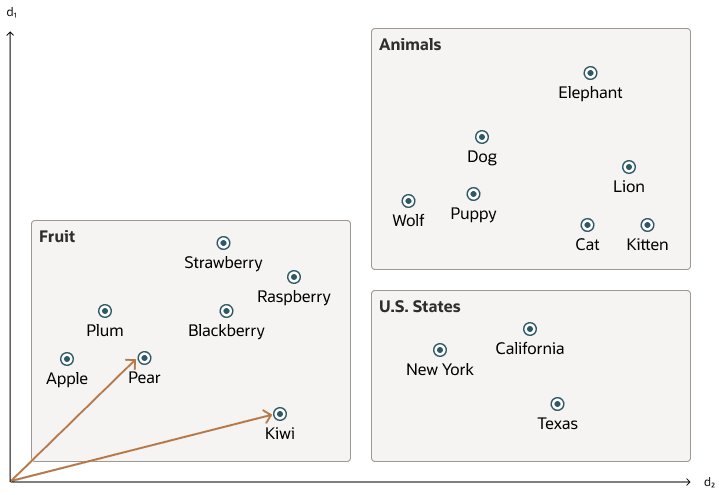
Descripción de la ilustración vector_embeddings.png
Búsqueda de similitud
Buscar similitud semántica en un conjunto de datos es ahora equivalente a buscar vecinos más cercanos en un espacio vectorial en lugar de utilizar búsquedas de palabras clave tradicionales utilizando predicados de consulta. Como se muestra en el siguiente diagrama, la distancia entre dog y wolf en este espacio vectorial es más corta que la distancia entre dog y kitten. En este espacio, un perro es más similar a un lobo que a un gatito. Consulte Realizar búsqueda de similitud exacta para obtener más información.
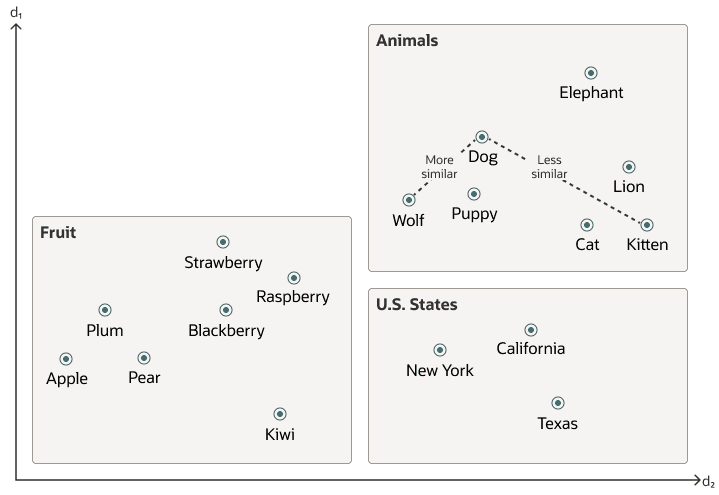
Descripción de la ilustración vector_embeddings_similarity.png
Los datos vectoriales tienden a estar distribuidos de manera desigual y agrupados en grupos que están relacionados semánticamente. Hacer una búsqueda de similitud basada en un vector de consulta dado es equivalente a recuperar los vectores K más cercanos a su vector de consulta en su espacio vectorial. Básicamente, debe encontrar una lista ordenada de vectores clasificándolos, donde la primera fila de la lista es el vector más cercano o similar al vector de consulta, la segunda fila de la lista es el segundo vector más cercano al vector de consulta, etc. Cuando se realiza una búsqueda de similitud, el orden relativo de las distancias es lo que realmente importa en lugar de la distancia real.
Con el espacio vectorial anterior, aquí se muestra una ilustración de una búsqueda semántica en la que el vector de consulta es el que corresponde a la palabra Puppy y desea identificar las cuatro palabras más cercanas:
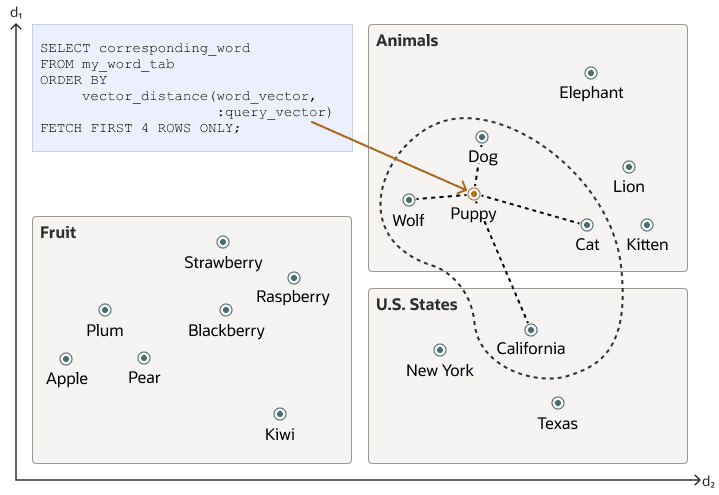
Descripción de la ilustración vector_embeddings_similarity_search.png
Las búsquedas de similitud tienden a obtener datos de uno o más clusters según el valor del vector de consulta y el tamaño de recuperación.
Las búsquedas aproximadas que utilizan índices de vector pueden limitar las búsquedas a clusters específicos, mientras que las búsquedas exactas visitan vectores de todos los clusters. Consulte Uso de índices vectoriales para obtener más información.
Modelos de incrustación de vector
Una forma de crear tales incrustaciones vectoriales podría ser utilizar la experiencia de dominio de alguien para cuantificar un conjunto predefinido de características o dimensiones como forma, textura, color, sentimiento y muchas otras, dependiendo del tipo de objeto con el que esté tratando. Sin embargo, la eficiencia de este método depende del caso de uso y no siempre es rentable.
En cambio, las incrustaciones vectoriales se crean a través de redes neuronales. La mayoría de las incrustaciones vectoriales modernas utilizan un modelo de transformador, como se ilustra en el siguiente diagrama, pero también se pueden utilizar redes neuronales convolucionales.
Figura 1: Modelo de incrustación vectorial
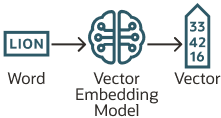
Descripción de la ilustración basic_transform.png
Dependiendo del tipo de datos, puede utilizar diferentes modelos de código abierto preentrenados para crear incrustaciones vectoriales. Por ejemplo:
-
Para los datos textuales, los transformadores de oraciones transforman palabras, oraciones o párrafos en incrustaciones vectoriales.
-
Para los datos visuales, puede utilizar Red residual (ResNet) para generar incrustaciones vectoriales.
-
Para los datos de audio, puede utilizar la representación de espectrograma visual de los datos de audio para volver a caer en el caso de datos visuales.
Cada modelo también determina el número de dimensiones de sus vectores. Por ejemplo:
-
El modelo de incrustación de Cohere embed-english-v3.0 tiene 1024 dimensiones.
-
El modelo de incrustación de OpenAI text-embedding-3-large tiene 3072 dimensiones.
-
El modelo de inserción all-MiniLM-L6-v2 de Hugging Face tiene 384 dimensiones
Por supuesto, siempre puede crear su propio modelo entrenado con su propio juego de datos.
Importación de modelos incorporados a Oracle AI Database
Aunque puedes generar incrustaciones vectoriales fuera de Oracle AI Database mediante modelos de incrustaciones de código abierto preentrenados o tus propios modelos de incrustaciones, también tienes la opción de importar esos modelos directamente en Oracle AI Database si son compatibles con el estándar Open Neural Network Exchange (ONNX). Oracle AI Database implementa un tiempo de ejecución ONNX directamente dentro de la base de datos. Esto le permite generar incrustaciones vectoriales directamente en Oracle AI Database mediante SQL. Consulte Generación de incrustaciones vectoriales para obtener más información.
Métrica de distancia del vector
La medición de distancias en un espacio vectorial es el núcleo de la identificación de los resultados más relevantes para un determinado vector de consulta. Ese proceso es muy diferente del conocido filtrado de palabras clave en el mundo de las bases de datos relacionales.
Al trabajar con vectores, hay varias maneras de calcular distancias para determinar cuán similares o diferentes son dos vectores. Cada métrica de distancia se calcula utilizando diferentes fórmulas matemáticas. El tiempo que se tarda en calcular la distancia entre dos vectores depende de muchos factores, incluyendo la métrica de distancia utilizada, así como el formato de los propios vectores, como el número de dimensiones vectoriales y los formatos de dimensión vectorial. Por lo general, es mejor coincidir con la métrica de distancia que utiliza con la que se utilizó para entrenar el modelo de incrustación de vectores que generó los vectores.
Visión General de Índices de Pequeño Mundo Navegables Jerárquicos
Utilice estos ejemplos para comprender cómo crear índices HNSW para búsquedas de similitud aproximada vectorial.
Con Navigable Small World (NSW), la idea es construir un gráfico de proximidad donde cada vector en el gráfico se conecte a varios otros en función de tres características:
-
La distancia entre vectores
-
Número máximo de candidatos vectoriales más cercanos considerados en cada paso de la búsqueda durante la inserción
(EFCONSTRUCTION) -
Número máximo de conexiones (
NEIGHBORS) permitidas por vector
Si la combinación de los umbrales anteriores es demasiado alta, puede terminar con un gráfico densamente conectado, que puede ralentizar el proceso de búsqueda. Por otro lado, si la combinación de esos umbrales es demasiado baja, entonces el gráfico puede volverse demasiado escaso y/o desconectado, lo que dificulta encontrar una ruta entre ciertos vectores durante la búsqueda.
El recorrido del gráfico Navigable Small World (NSW) para la búsqueda vectorial comienza con un punto de entrada predefinido en el gráfico, que accede a un cluster de vectores estrechamente relacionados. El algoritmo de búsqueda emplea dos listas de claves: Candidatos, una lista actualizada dinámicamente de vectores que encontramos al recorrer el gráfico, y Resultados, que contiene los vectores más cercanos al vector de consulta encontrado hasta el momento. A medida que la búsqueda avanza, el algoritmo navega a través del gráfico, refinando continuamente a los candidatos explorando y evaluando vectores que podrían estar más cerca que los de los resultados. El proceso concluye cuando no hay vectores en los Candidatos más cercanos que los más lejanos en los Resultados, indicando que se ha alcanzado un mínimo local y se han identificado los vectores más cercanos al vector de consulta.
Esto se ilustra en el siguiente gráfico:
Figura 2: Gráfico de mundo pequeño navegable
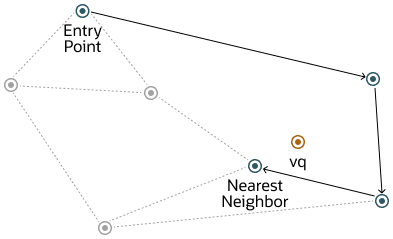
Descripción de la ilustración Navigable-small-world-graph.png
El método descrito demuestra un rendimiento sólido hasta una cierta escala de inserción de vectores en el gráfico. Más allá de este umbral, el enfoque Hierarchical Navigable Small World (HNSW) mejora el modelo NSW mediante la introducción de una jerarquía de varias capas, similar a la estructura observada en las Listas de Omisión Probabilística. Esta arquitectura jerárquica se implementa distribuyendo las conexiones del gráfico a través de varias capas, organizándolas de una manera en la que cada capa posterior contiene un subconjunto de los vectores de la capa a continuación. Esta estratificación garantiza que las capas superiores capturen enlaces de larga distancia, sirviendo efectivamente como vías rápidas a través del gráfico, mientras que las capas inferiores se centran en enlaces más cortos, lo que facilita la navegación local de grano fino. Como resultado, las búsquedas comienzan en las capas superiores para aproximarse rápidamente a la región del vector objetivo, moviéndose progresivamente a las capas inferiores para una búsqueda más precisa, mejorando significativamente la eficiencia y precisión de la búsqueda al aprovechar enlaces más cortos (distancias más pequeñas) entre vectores a medida que se mueve desde la capa superior a la inferior.
Para comprender mejor cómo funciona esto para HNSW, veamos cómo se utiliza esta jerarquía para la estructura de lista de omisiones de probabilidad:
Figura 3: Estructura de lista de omisiones de probabilidad
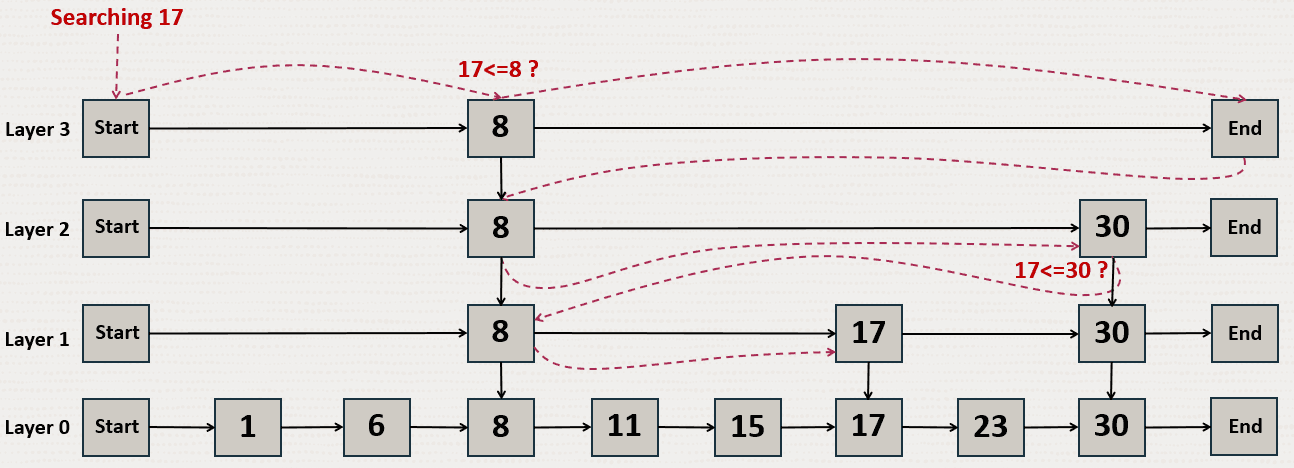
Descripción de la ilustración Prob-skip-list_01.png
La estructura de lista de omisión de probabilidad utiliza varias capas de listas enlazadas en las que las capas anteriores omiten más números que las inferiores. En este ejemplo, está intentando buscar el número 17. Empiezas con la capa superior y saltas al siguiente elemento hasta que encuentres 17, llegues al final de la lista o encuentres un número mayor que 17. Cuando llega al final de una lista o encuentra un número mayor que 17, comienza en la capa anterior desde el último número menor que 17.
HNSW utiliza el mismo principio con las capas NSW donde se encuentran mayores distancias entre los vectores en las capas superiores. Esto se ilustra con los siguientes diagramas en un espacio 2D:
En la capa superior se encuentran los bordes más largos y en la capa inferior los más cortos.
Figura 4: Gráficos de mundo pequeño navegables jerárquicos
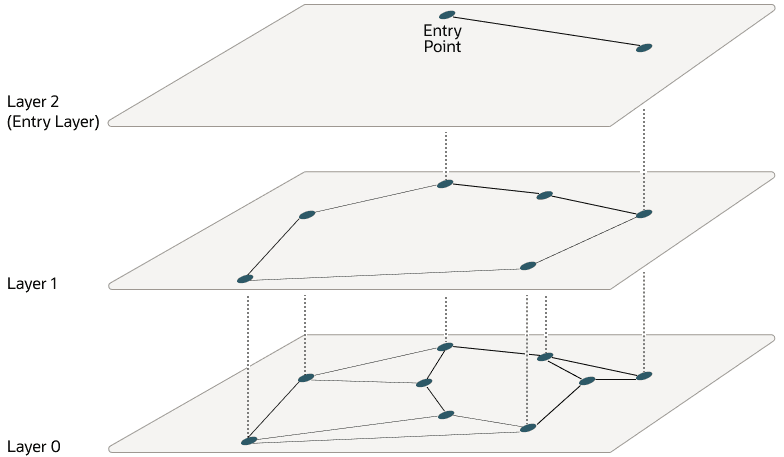
Descripción de la ilustración jerárquical-navigable-small-world-graph_02.png
A partir de la capa superior, la búsqueda en una capa comienza en el vector de entrada. A continuación, para cada nodo, si hay un vecino que está más cerca del vector de consulta que el nodo actual, salta a ese vecino. El algoritmo sigue haciendo esto hasta que encuentra un mínimo local para el vector de consulta. Cuando se encuentra un mínimo local en una capa, la búsqueda va a la siguiente capa utilizando el mismo vector en esa nueva capa y la búsqueda continúa en esa capa. Este proceso se repite hasta que se encuentra el mínimo local de la capa inferior, que contiene todos los vectores. En este punto, la búsqueda se transforma en una búsqueda de similitud aproximada utilizando el algoritmo NSW alrededor del último mínimo local encontrado para extraer los k vectores más similares a su vector de consulta. Mientras que las capas superiores pueden tener un máximo de conexiones para cada vector definido por el parámetro NEIGHBORS, la capa 0 puede tener el doble. Este proceso se ilustra en el siguiente gráfico:
Figura 5: Búsqueda de gráficos de mundo pequeño navegables jerárquicos
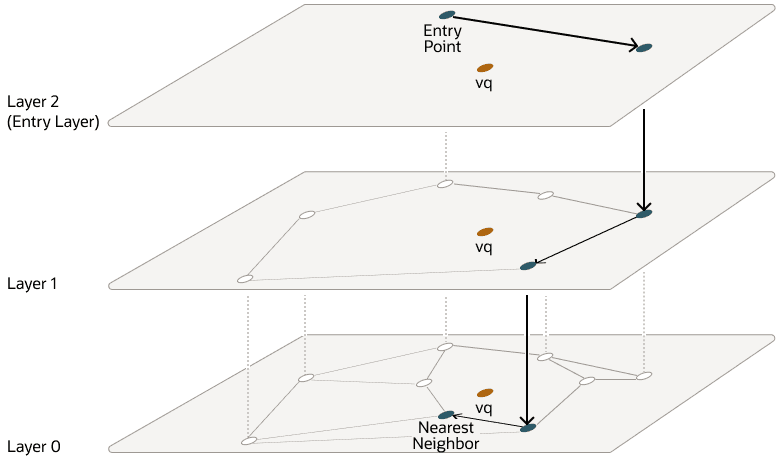
Descripción de la ilustración hnsw-search-graph_02-png.png
Las capas se implantan mediante gráficos en memoria (no mediante gráficos de Oracle Inmemory). Cada capa utiliza un gráfico en memoria independiente. Como ya se ha visto, al crear un índice HNSW, se puede ajustar el número máximo de conexiones por vector en las capas superiores mediante el parámetro NEIGHBORS, así como el número máximo de candidatos vectoriales más cercanos considerados en cada paso de la búsqueda durante la inserción mediante el parámetro EFCONSTRUCTION, donde EF significa Enter Factor.
Como se ha explicado anteriormente, al utilizar Oracle AI Vector Search para ejecutar una consulta de búsqueda aproximada mediante índices HNSW, tiene la posibilidad de especificar una precisión de destino en la que se debe realizar la búsqueda aproximada.
En el caso de una búsqueda aproximada de HNSW, puede especificar un valor de porcentaje de precisión de destino para que influya en el número de candidatos considerados para investigar la búsqueda. Esto se calcula automáticamente mediante el algoritmo. Un valor de 100 tenderá a imponer un resultado similar como una búsqueda exacta, aunque el sistema aún puede utilizar el índice y no realizará una búsqueda exacta. El optimizador puede optar por seguir utilizando un índice, ya que puede ser más rápido si se tienen en cuenta los predicados de la consulta. En lugar de especificar un valor de porcentaje de precisión de destino, puede especificar el parámetro EFSEARCH para imponer un número máximo determinado de candidatos que se deben tener en cuenta al sondear el índice. Cuando más alto es el número, mayor es la precisión.
Nota:
-
Si no especifica ninguna precisión de destino en la consulta de búsqueda aproximada, heredará el juego cuando se haya creado el índice. Verá que, al crear el índice, puede especificar una precisión de destino mediante un valor de porcentaje o valores de parámetros según el tipo de índice que esté creando.
-
Es posible especificar una precisión de destino diferente en la búsqueda de índice en comparación con la definida en la creación de índice. Para los índices HNSW, puede buscar más vecinos mediante el parámetro
EFSEARCH(más alto que el valorEFCONSTRUCTIONespecificado en la creación del índice) para obtener resultados más precisos. La precisión de destino que se proporciona durante la creación del índice decide los parámetros de creación del índice y también actúa como valores de precisión por defecto para las búsquedas de índice vectorial.
Describir los índices vectoriales planos de archivos invertidos
El índice vectorial Inverted File Flat es una técnica diseñada para mejorar la eficiencia de la búsqueda mediante el estrechamiento del área de búsqueda mediante el uso de particiones o clusters vecinos.
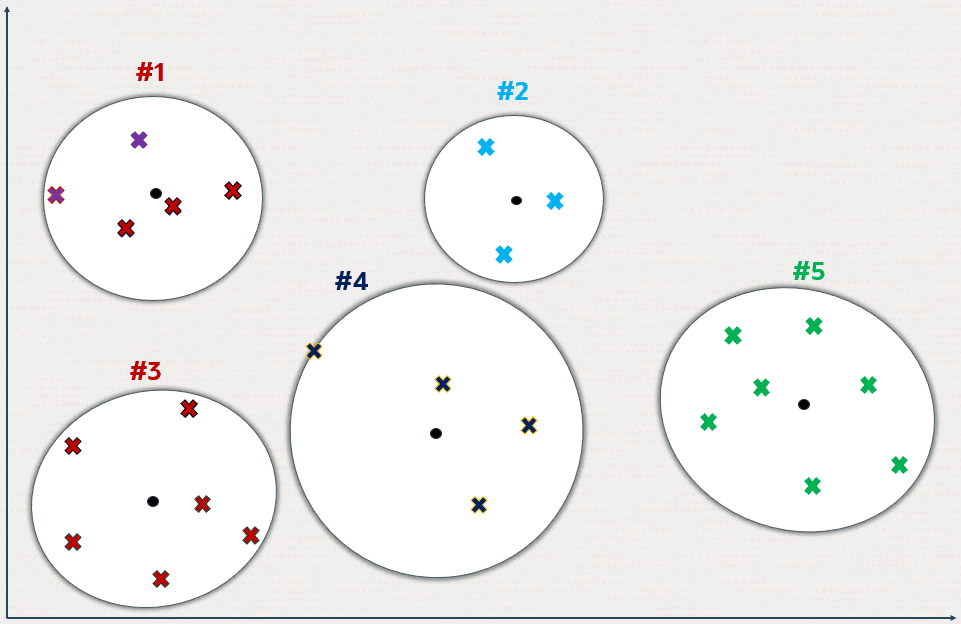
Los siguientes diagramas muestran cómo se crean particiones o clusters en una búsqueda aproximada mediante una representación de espacio 2D. Pero esto se puede generalizar a espacios dimensionales mucho más altos.
Figura 6: Índice plano de archivos invertidos mediante 2D
Descripción de la ilustración inverted-file-index_1.png
Las cruces representan los puntos de datos vectoriales en este espacio.
Se añaden nuevos puntos de datos, que se muestran como pequeños círculos simples, para identificar los centroides de partición k, donde el número de centroides (k) está determinado por el tamaño del conjunto de datos (n). Normalmente, k se define en la raíz cuadrada de n, aunque se puede ajustar especificando el parámetro NEIGHBOR PARTITIONS durante la creación del índice.
Cada centroide representa el vector promedio (centro de gravedad) de la partición correspondiente.
Los centroides se calculan mediante un pase de entrenamiento sobre los vectores cuyo objetivo es minimizar la distancia total de cada vector desde el centroide más cercano.
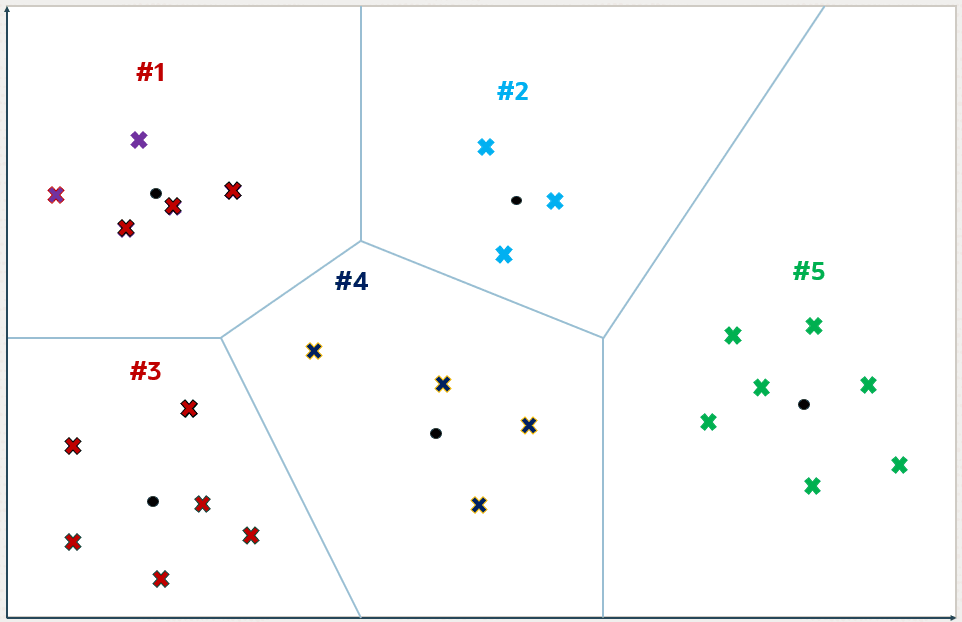
Los centroides terminan particionando el espacio vectorial en particiones k. Esta división se ilustra conceptualmente como círculos en expansión de los centroides que dejan de crecer a medida que se encuentran, formando particiones distintas.
Figura 7: Índice plano de archivo invertido
Descripción de la ilustración inverted-file-index_5.png
A excepción de los de la periferia, cada vector cae dentro de una partición específica asociada con un centroide.
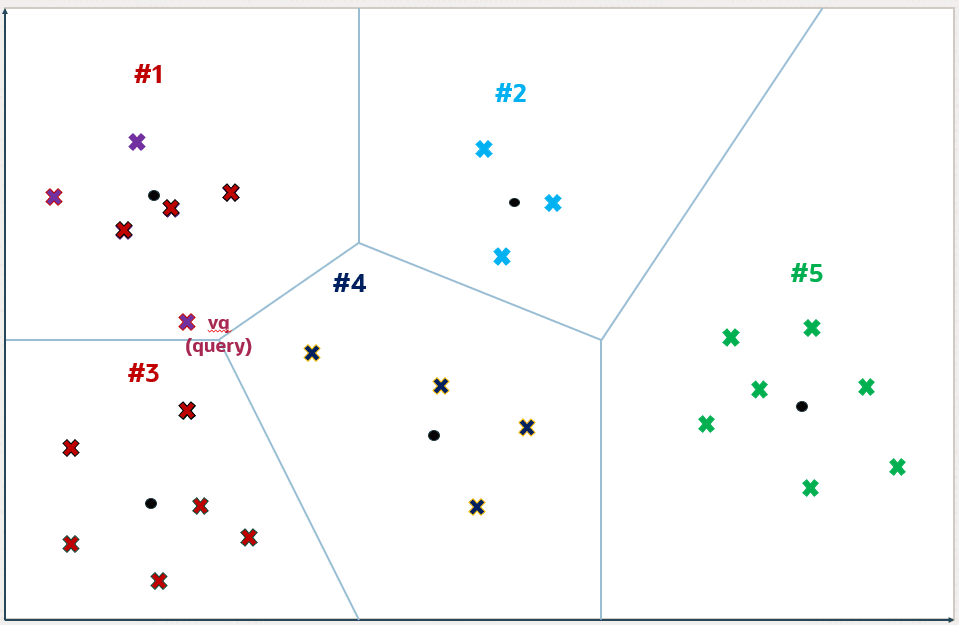
Figura 8: Índice plano de archivo invertido
Descripción de la ilustración inverted-file-index_6.png
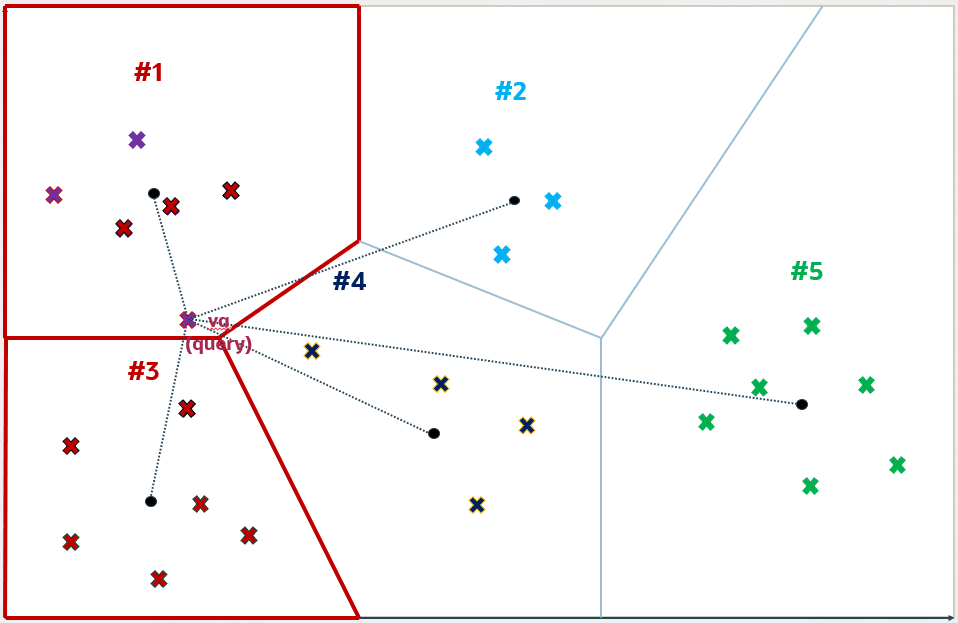
Para un vector de consulta vq, el algoritmo de búsqueda identifica los centroides i más cercanos, donde i toma por defecto la raíz cuadrada de k, pero se puede ajustar para una consulta específica definiendo el parámetro NEIGHBOR PARTITION PROBES. Este ajuste permite una compensación entre la velocidad de búsqueda y la precisión.
Los números más altos para este parámetro resultarán en una mayor precisión. En este ejemplo, i se define en 2 y las dos particiones identificadas son las particiones número 1 y 3.
Figura 9: Índice plano de archivo invertido
Descripción de la ilustración inverted-file-index_7.png
Una vez que se determinan las particiones i, se exploran por completo para identificar, en este ejemplo, los 5 vectores más cercanos. Este número 5 puede ser diferente de k y especifica este número en la consulta. Los cinco vectores más cercanos a vq que se encuentran en las particiones número 1 y 3 se resaltan en el siguiente diagrama.
Este método constituye una búsqueda aproximada, ya que limita la búsqueda a un subconjunto de particiones, acelerando así el proceso, pero potencialmente perdiendo vectores más cercanos en particiones no examinadas. Este ejemplo ilustra que una búsqueda aproximada podría no producir los vectores exactos más cercanos a vq, lo que demuestra la compensación inherente entre la eficiencia y la precisión de la búsqueda.
Figura 10: Índice plano de archivo invertido
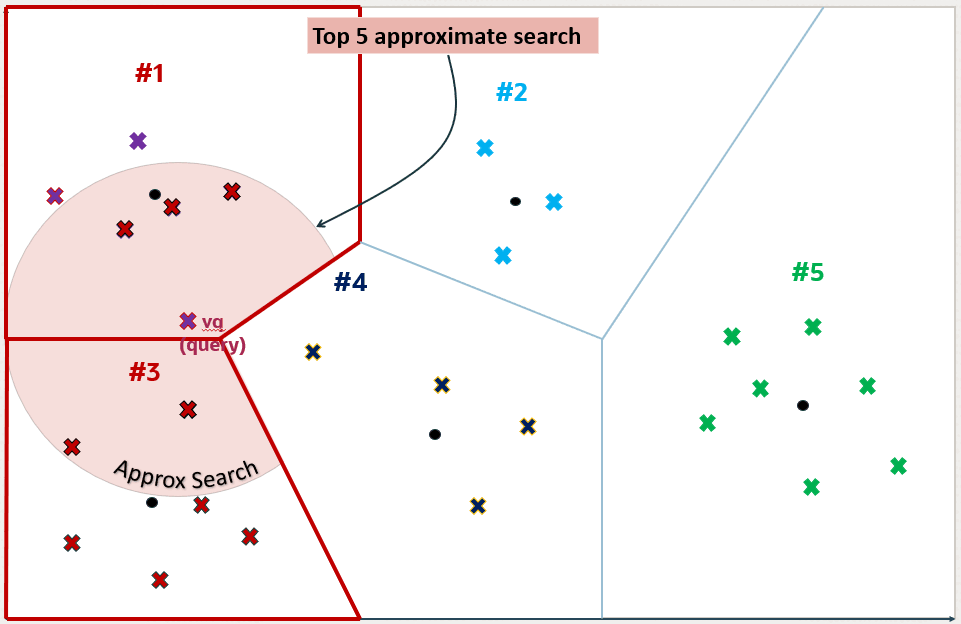
Descripción de la ilustración inverted-file-index_10.png
Sin embargo, los cinco vectores exactos más cercanos de vq no son los encontrados por la búsqueda aproximada. Puede ver que uno de los vectores de la partición número 4 está más cerca de vq que uno de los vectores recuperados en la partición número 3.
Figura 11: Índice plano de archivo invertido
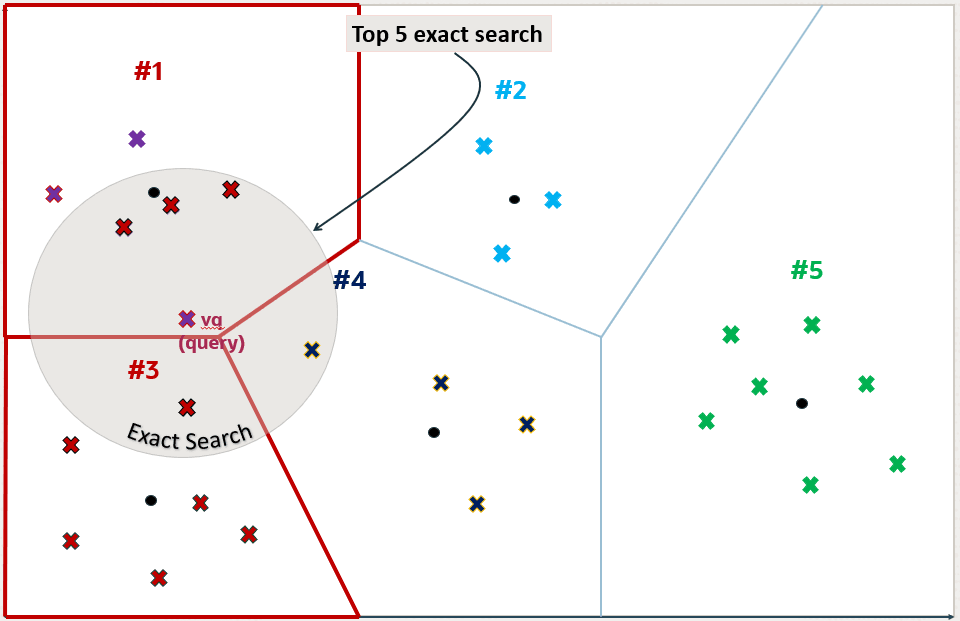
Descripción de la ilustración inverted-file-index_11.png
Ahora puede ver por qué el uso de búsquedas de índice vectorial no siempre es una búsqueda exacta y se llama una búsqueda aproximada en su lugar. En este ejemplo, la precisión aproximada de la búsqueda es solo del 80%, ya que solo ha recuperado 4 de cada 5 del resultado exacto de los vectores de búsqueda.
Figura 12: Índice plano de archivo invertido
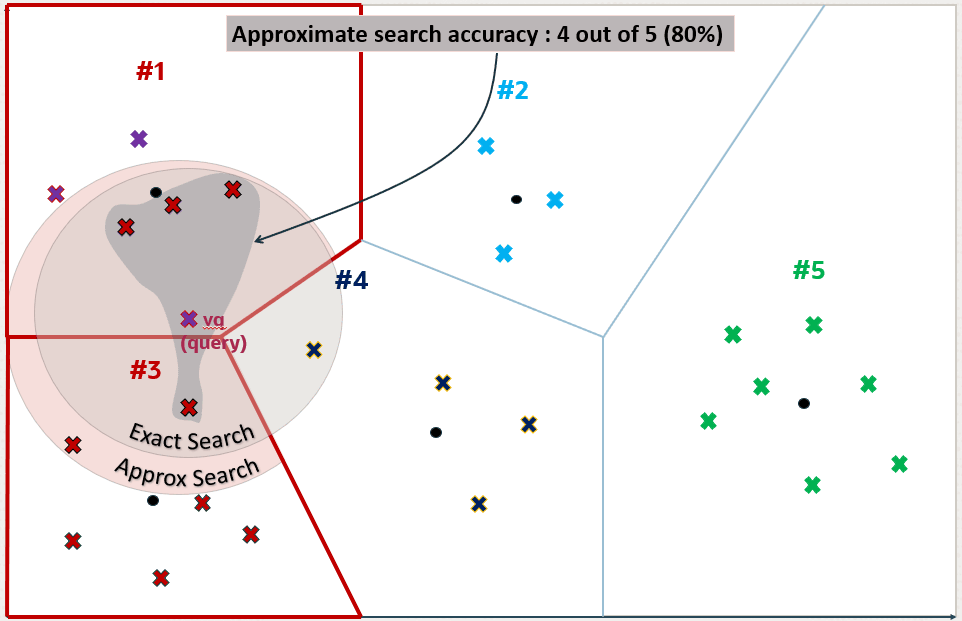
Descripción de la ilustración inverted-file-index_12.png
Al utilizar Oracle AI Vector Search para ejecutar una consulta de búsqueda aproximada mediante índices vectoriales, tiene la posibilidad de especificar una precisión de destino en la que se debe realizar la búsqueda aproximada.
En el caso de una búsqueda aproximada de FIV, puede especificar un valor de porcentaje de precisión de destino para influir en el número de particiones utilizadas para sondear la búsqueda. Esto se calcula automáticamente mediante el algoritmo. Un valor de 100 tenderá a imponer una búsqueda exacta, aunque el sistema todavía puede utilizar el índice y no realizará una búsqueda exacta. El optimizador puede optar por seguir utilizando un índice, ya que puede ser más rápido si se tienen en cuenta los predicados de la consulta. En lugar de especificar un valor de porcentaje de precisión de destino, puede especificar el parámetro NEIGHBOR PARTITION PROBES para imponer un número máximo determinado de particiones que la búsqueda va a sondear. Cuando más alto es el número, mayor es la precisión.
Nota:
-
Si no especifica ninguna precisión de destino en la consulta de búsqueda aproximada, heredará el juego cuando se haya creado el índice. Verá que, en el momento de la creación del índice, puede especificar una precisión de destino mediante un valor de porcentaje o valores de parámetros en función del tipo de índice que está creando.
-
Es posible especificar una precisión de destino diferente en la búsqueda de índices, en comparación con la definida en la creación de índices. Para los índices de FIV, puede sondear más particiones de centroides mediante el parámetro
NEIGHBOR PARTITION PROBESpara obtener resultados más precisos. La precisión de destino que se proporciona durante la creación del índice decide los parámetros de creación del índice y también actúa como valor de precisión por defecto para las búsquedas de índice vectorial.
Realización de búsquedas de similitud
En esta sección se describen los métodos para realizar búsquedas de similitud.
-
Realizar Búsqueda de Similitud Exacta Una búsqueda de similitud busca el orden relativo de los vectores en comparación con un vector de consulta. Naturalmente, la comparación se realiza utilizando una métrica de distancia particular, pero lo que es importante es el conjunto de resultados de sus vectores más cercanos, no la distancia entre ellos.
-
Descripción aproximada de la búsqueda de similitud mediante índices vectoriales Para obtener velocidades de búsqueda más rápidas con grandes espacios vectoriales, puede utilizar la búsqueda aproximada de similitud mediante índices vectoriales.
-
Realizar Búsqueda de Similitud de Varios Vectores Otro caso de uso importante de la búsqueda vectorial es la búsqueda multivectorial. La búsqueda multivectorial suele estar asociada a una búsqueda de varios documentos, donde los documentos se dividen en fragmentos que se incrustan individualmente en vectores.
Realizar búsqueda de similitud exacta
Una búsqueda de similitud busca el orden relativo de los vectores en comparación con un vector de consulta. Naturalmente, la comparación se realiza utilizando una métrica de distancia particular, pero lo que es importante es el conjunto de resultados de sus vectores más cercanos, no la distancia entre ellos.
Por ejemplo, y dado un determinado vector de consulta, puede calcular su distancia a todos los demás vectores del juego de datos. Este tipo de búsqueda, también llamada búsqueda plana, o búsqueda exacta, produce los resultados más precisos con una calidad de búsqueda perfecta. Sin embargo, esto tiene el costo de tiempos de búsqueda significativos. Esto se ilustra con los siguientes diagramas:
Figura 13: Búsqueda exacta
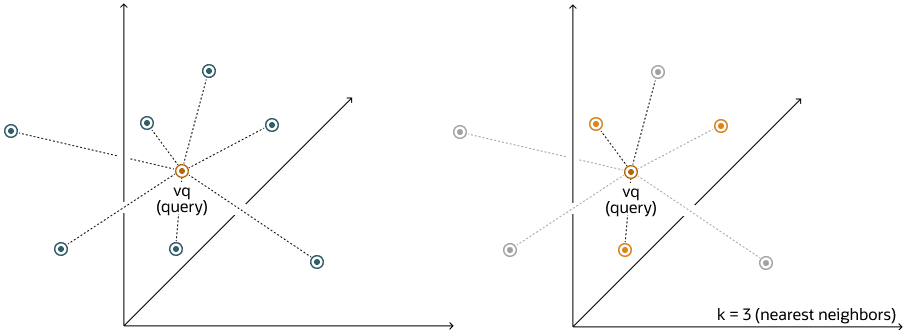
Descripción de la ilustración flat-index.png
Con una búsqueda exacta, puede comparar el vector de consulta vq con cualquier otro vector en su espacio calculando su distancia a cada vector. Después de calcular todas estas distancias, la búsqueda devuelve el k más cercano como las coincidencias más cercanas. Esto se llama una búsqueda de vecinos k más cercanos (kNN).
Por ejemplo, la búsqueda de similitud euclidiana implica recuperar los vectores más cercanos de la k superior en el espacio en relación con la métrica de distancia euclidiana y un vector de consulta. A continuación, se muestra un ejemplo que recupera los 10 vectores principales de la tabla vector_tab, que son los más cercanos a query_vector mediante la siguiente consulta de búsqueda de similitud exacta:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;
En este ejemplo, docID y embedding son columnas definidas en la tabla vector_tab y embedding tiene el tipo de dato VECTOR.
En el caso de las distancias euclidianas, comparar las distancias cuadradas equivale a comparar las distancias. Por lo tanto, cuando ordenar es más importante que los valores de distancia en sí, la distancia cuadrada euclidiana es muy útil, ya que es más rápido de calcular que la distancia euclidiana (evitando el cálculo de la raíz cuadrada). Por lo tanto, es más sencillo y rápido volver a escribir la consulta de la siguiente forma:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;
Nota: La palabra clave EXACT es opcional. Si se omite mientras está conectado a una instancia de ADB-S, se intenta realizar una búsqueda aproximada mediante un índice vectorial si existe. Para obtener más información, consulte Realización de una búsqueda de similitud aproximada mediante índices vectoriales.
Nota: Asegúrese de utilizar la función de distancia que se ha utilizado para entrenar el modelo de incrustación.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener la sintaxis completa de ROW_LIMITING_CLAUSE
Descripción de la búsqueda de similitud aproximada mediante índices vectoriales
Para velocidades de búsqueda más rápidas con grandes espacios vectoriales, puede utilizar la búsqueda de similitud aproximada mediante índices vectoriales.
El uso de índices vectoriales para una búsqueda de similitud se denomina búsqueda aproximada. Las búsquedas aproximadas utilizan índices de vector, que compensan la precisión del rendimiento.
Búsqueda aproximada de grandes espacios vectoriales
Cuando la calidad de búsqueda es su alta prioridad y la velocidad de búsqueda es menos importante, la búsqueda de similitud exacta es una buena opción. La velocidad de búsqueda puede ser irrelevante para espacios vectoriales más pequeños o cuando se realizan búsquedas con servidores de alto rendimiento. Sin embargo, los algoritmos de aprendizaje automático a menudo realizan búsquedas de similitud en espacios vectoriales con miles de millones de incrustaciones. Por ejemplo, el conjunto de datos Deep1B contiene imágenes 1B generadas por una red neuronal convolucional (CNN). Informar las distancias vectoriales con cada vector en el corpus para encontrar coincidencias Top-K con una precisión del 100 por ciento es muy lento.
Afortunadamente, hay muchos tipos de búsquedas aproximadas que puede realizar utilizando índices vectoriales. Los índices vectoriales pueden ser menos precisos, pero pueden consumir menos recursos y ser más eficientes. A diferencia de los índices de base de datos tradicionales, los índices vectoriales se construyen y realizan búsquedas utilizando algoritmos basados en heurísticas.
Debido a que la heurística no puede garantizar una precisión del 100%, las búsquedas de índice vectorial utilizan la exactitud de destino. Internamente, los algoritmos utilizados para la creación de índices y la búsqueda de índices están haciendo todo lo posible para ser lo más precisos posible. Sin embargo, tiene la posibilidad de influir en esos algoritmos especificando la precisión de un destino. Al crear el índice o buscarlo, puede especificar valores de precisión de destino no por defecto especificando un valor de porcentaje o especificando valores de parámetros internos, según el tipo de índice que esté utilizando.
Ejemplo de precisión de destino
Para comprender mejor lo que significa la precisión del objetivo, consulte los siguientes diagramas. El primer diagrama ilustra un espacio vectorial donde cada vector está representado por una pequeña cruz. El de color rojo representa el vector de consulta.
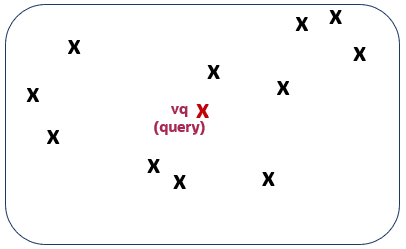
Descripción de la ilustración accuracy1.png
La ejecución de una búsqueda de similitud exacta de 5 principales en ese contexto devolvería los cinco vectores que se muestran en el segundo diagrama:
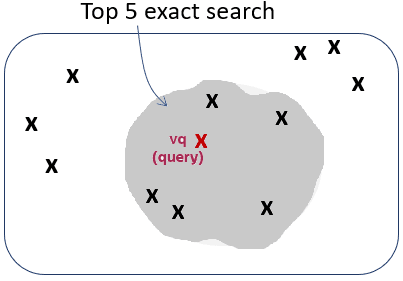
Descripción de la ilustración accuracy2.png
Dependiendo de cómo se construyó el índice vectorial, ejecutar una búsqueda de similitud aproximada de los 5 primeros en ese contexto podría devolver los cinco vectores que se muestran en el tercer diagrama. Esto se debe a que el proceso de creación de índices utiliza heurística. Por lo tanto, la búsqueda a través del índice vectorial puede conducir a diferentes resultados en comparación con una búsqueda exacta:
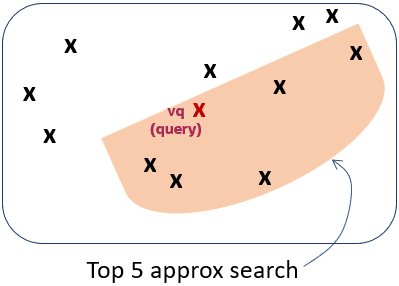
Descripción de la ilustración accuracy3.png
Como se puede ver, los vectores recuperados son diferentes y, en este caso, difieren por un vector. Esto significa que, en comparación con la búsqueda exacta, la búsqueda de similitud recuperó 4 de cada 5 vectores correctamente. La búsqueda de similitud tiene un 80% de precisión en comparación con la búsqueda de similitud exacta. Esto se ilustra en el cuarto diagrama:
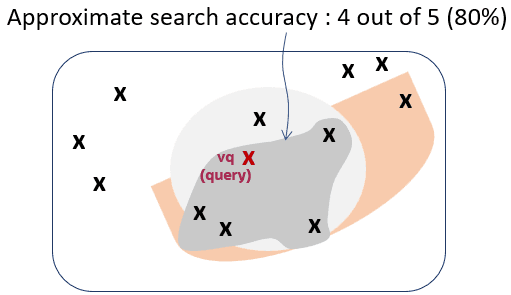
Descripción de la ilustración accuracy4.png
Debido a que la naturaleza de los índices vectoriales son estructuras de búsqueda aproximadas, es posible que se devuelvan menos filas de K en una búsqueda de similitud de K superior.
Para obtener información sobre cómo configurar los índices vectoriales, consulte Creación de índices vectoriales.
Realizar búsqueda de similitud de varios sectores
Otro caso de uso importante de la búsqueda vectorial es la búsqueda multivectorial. La búsqueda multivectorial suele estar asociada a una búsqueda de varios documentos, donde los documentos se dividen en fragmentos que se incrustan individualmente en vectores.
Una búsqueda multivectorial consiste en recuperar las coincidencias de vectores de K superior utilizando criterios de agrupación conocidos como particiones basadas en las características de los documentos. Esta capacidad para puntuar documentos en función de la similitud de sus fragmentos con un vector de consulta que se está buscando se facilita en SQL mediante la cláusula de limitación de filas particionadas.
Con la búsqueda de varios vectores, es más fácil escribir sentencias SQL para responder al siguiente tipo de pregunta:
- Si existen, ¿cuáles son las cuatro mejores frases coincidentes que se encuentran en los tres mejores párrafos coincidentes de los dos mejores libros coincidentes?
Por ejemplo, imagine que cada libro de la base de datos se organiza en párrafos que contienen oraciones que tienen representaciones de incrustación de vectores, entonces puede responder a la pregunta anterior mediante una sola sentencia SQL, como:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
También puede utilizar una búsqueda de similitud aproximada en lugar de una búsqueda de similitud exacta como se muestra en el siguiente ejemplo:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;
Nota: Todas las filas devueltas se ordenan por VECTOR_DISTANCE() y no se agrupan por la cláusula de partición.
Semánticamente, la sentencia SQL anterior se interpreta como:
-
Ordene todos los registros de la tabla de libros en orden descendente según la distancia del vector entre las oraciones y el vector de consulta.
-
Para cada registro de este Pedido, compruebe sus valores
bookIdyparagraphId. Este registro se produce si se cumplen las tres condiciones siguientes:-
Su
bookIdes uno de los dos primerosbookIddistintos en el orden ordenado. -
Su
paragraphIdes uno de los tres primerosparagraphIddistintos en el orden ordenado dentro del mismobookId. -
Su registro es uno de los cuatro primeros registros dentro de la misma combinación
bookIdyparagraphId.
-
-
De lo contrario, este registro se filtra.
La búsqueda de similitud multivectorial no es solo para documentos y también se puede utilizar para responder a las siguientes preguntas:
-
Devuelva las fotos coincidentes más cercanas a K, pero asegúrese de que sean fotos de diferentes personas.
-
Encuentra las mejores canciones K con dos o más segmentos de audio que mejor coincidan con este fragmento de sonido.
Nota:
-
Esta extensión de cláusula de limitación de filas de partición es una extensión genérica del lenguaje SQL. No tiene que aplicarse solo a las búsquedas vectoriales.
-
Actualmente se admite la búsqueda multivectorial con el índice FIV.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener la sintaxis completa de ROW_LIMITING_CLAUSE