Extraction en aval pour déploiement Oracle GoldenGate
Un déploiement Oracle GoldenGate en aval vous permet de décharger le traitement des fichiers de journalisation vers une autre base de données appelée base de données d'exploration. La base de données d'exploration n'a pas besoin de contenir de données provenant de la base de données source, mais doit avoir la même version de base de données ou une version supérieure. Cela signifie que la version 12c d'Oracle en tant que base de données source peut utiliser la version 19c ou supérieure de la base de données d'exploration, ce qui permet à Oracle GoldenGate de capturer les modifications à partir d'une base de données Oracle 12c sans réellement s'exécuter sur la base de données Oracle 12.
L'extraction en aval peut également être utilisée dans les cas où GoldenGate ne peut pas établir de connexion à la base de données source.
Remarque : les serveurs de base de données source et en aval doivent avoir les mêmes types de processeur et d'endianness. Par exemple, l'extraction en aval fonctionnera avec la source Linux (x86) vers un serveur Windows (x86) en aval, mais elle ne fonctionne pas si le serveur source est HP-UX mais le serveur en aval est AIX, ou le serveur source est HP PA-RISC mais le serveur en aval est HP-Itanium.
Une base de données d'exploration en aval accepte les fichiers de journalisation archivés et les fichiers de journalisation en ligne d'une base source. Cela implique qu'un processus Extract en aval peut exister dans deux modes :
-
Mode Exploration en temps réel : En mode Exploration en temps réel, les enregistrements de journalisation sont traités immédiatement à partir des fichiers de journalisation en ligne ou de secours. Par conséquent, le traitement des modifications de la base de données n'est pas retardé.
-
Mode d'exploration des archives : En mode d'exploration des archives, les enregistrements de journalisation ne sont pas traités tant qu'ils ne sont pas archivés dans un fichier de journalisation.
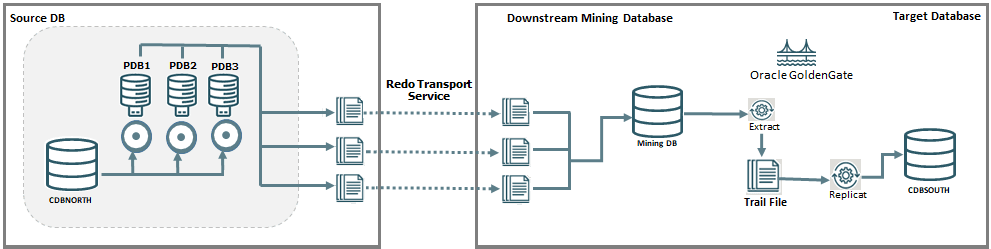
Dans un déploiement en aval standard, la base de données source, dans laquelle des modifications sont apportées aux données, envoie ses fichiers de journalisation (redo logs) ou ses fichiers de journalisation archivés à une base de données d'exploration dans laquelle le processus Extract extrait les fichiers de journalisation (redo logs) et écrit les fichiers trace (trail). L'extraction en aval peut également être utilisée dans les cas où Oracle GoldenGate ne peut pas établir de connexion avec la base de données source. Dans le diagramme suivant, CDBNORTH est la base de données source et CDBSOUTH la base de données cible. Il existe une base de données de minage entre la source et la cible avec le serveur de journalisation de base de données qui transfère les fichiers de journalisation de l'extraction en aval vers la cible.
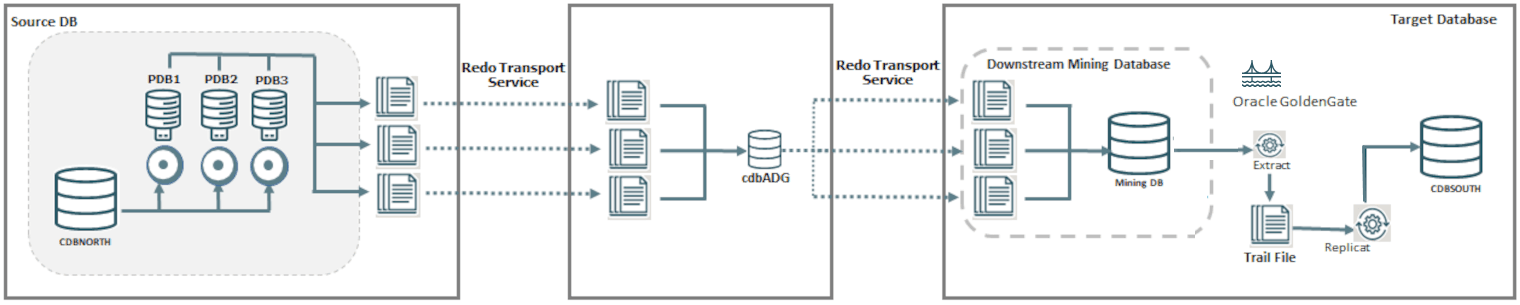
Une autre option consiste à utiliser une approche en cascade. S'il existe une base de données de secours Active Data Guard, vous pouvez demander à la base de données de secours d'expédier les fichiers de journalisation à la base de données d'exploration au lieu d'expédier les fichiers de journalisation à partir de la base principale. Cette option doit être utilisée si la bande passante réseau est limitée et que la base de données de secours se trouve dans la même région ou le même centre de données que la base de données d'exploration.
Cette approche utilise un groupe ADG configuré en mode cascade pour transporter les fichiers de journalisation vers une base de données d'exploration en aval, qui est ensuite référencée par un processus Extract en aval, ce qui réduit la surcharge sur la base de données source, comme indiqué dans le diagramme suivant.
Remarque : le processus d'extraction d'Oracle ne peut pas se connecter à une base de données de secours Data Guard ou à une base de données de secours Active Data Guard pour capturer des données.
Pour plus de détails sur la configuration d'un environnement en cascade en aval, reportez-vous à Activation de l'extraction en aval pour qu'elle fonctionne avec ADG.
Configurer les bases de données d'exploration source et en aval
Dans cette section, vous allez découvrir les paramètres et les configurations de gestion des utilisateurs requis côté base de données.
Utilisateur Oracle GoldenGate dans les bases de données source et en aval
L'administrateur Oracle GoldenGate doit exister sur chaque base de données. Dans les bases de données Conteneur, un utilisateur commun est requis car le processus Extract sera utilisé dans le conteneur racine.
Pour configurer des utilisateurs pour Oracle AI Database 26ai et versions ultérieures, le rôle utilisateur OGG_CAPTURE et OGG_APPLY doit être affecté au nouvel utilisateur. Pour plus de détails, reportez-vous à Octroi de privilèges utilisateur pour Oracle AI Database 26ai et versions supérieures.
Pour configurer des utilisateurs pour Oracle Database 21c et versions inférieures, des packages PL/SQL sont utilisés. L'exemple suivant illustre la création d'un utilisateur et les privilèges associés accordés à cet utilisateur lors de l'utilisation d'Oracle GoldenGate avec Oracle Database 21c et versions inférieures :
CREATE USER c##ggadmin IDENTIFIED BY *password* CONTAINER = all;
ALTER USER c##ggadmin SET CONTAINER_DATA = all CONTAINER = current;
GRANT ALTER SESSION TO c##ggadmin CONTAINER = all;
GRANT connect, resource TO c##ggadmin CONTAINER = all;

BEGIN
  DBMS_GOLDENGATE_AUTH.GRANT_ADMIN_PRIVILEGE
    ( grantee                 => 'C##GGADMIN'
    , privilege_type          => 'CAPTURE'
    , grant_select_privileges =>  TRUE
    , container               => 'ALL'
    );
END;
/
Remarque : l'utilisateur commun (c##ggadmin) est requis pour la base de données en aval uniquement.
Configurer les connexions à la base de données
Configuration requise pour le service Database Net
Les bases de données source et en aval sont accessibles via les services Database Net dans les deux sens.
Dans Oracle GoldenGate, il est possible de configurer des connexions pour la base de données source (CDBNORTH_root) et la base de données en aval (cdbDSC_root). La connexion à la base de données source est uniquement nécessaire pour stocker les données du dictionnaire lors de l'inscription du processus Extract. Vous pouvez utiliser le paramètre FETCHUSERIDALIAS pour vous connecter à la base de données d'exploration en aval (cdbDSC_root) afin d'effectuer des extractions lors de l'exécution. Avec la redirection ADG, l'enregistrement de l'extraction peut être redirigé vers la source à partir d'un groupe ADG. Pour configurer des connexions, assurez-vous que vous disposez des informations d'identification de base de données pour ces utilisateurs, afin de créer des informations d'identification à partir du déploiement Oracle GoldenGate.
Vous pouvez tester le service Net avec SQL*Plus, qui fait partie du shiphome Oracle GoldenGate.
Prérequis pour la base de données source
Pour configurer les connexions de base de données, assurez-vous que les paramètres suivants sont appliqués aux instances de base de données source :
-
(Bases de données d'exploration source et en aval) Toutes les bases de données doivent comprendre :
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
Les bases de données source doivent être en mode fichier de journalisation archivé. Pour activer l'archivage sur la base de données, exécutez la commande suivante qui indique à la base de données de créer un fichier de journalisation archivé lors du changement de fichier de journalisation.
ALTER DATABASE ARCHIVE LOG; -
(Recommandé) (Source uniquement) Toutes les bases de données doivent être en mode Forcer la journalisation.
ALTER DATABASE FORCE LOGGING; -
La journalisation supplémentaire minimale doit être activée pour la base de données source qui inclut
TRANDATA/SCHEMATRANDATAlors du déchargement du processus d'extraction vers la base de données Data Mining car c'est là que les transactions se produisent. -
(Base de données d'exploration en aval uniquement) Les fichiers de mots de passe (
orapwSID) de la base de données source et en aval sont identiques. Par conséquent,remote_login_passwordfiledoit être défini surSHAREDouEXCLUSIVEdans Oracle Database 21c et versions inférieures.
Prérequis de la base de données d'exploration en aval
Pour configurer les connexions de base de données, assurez-vous que les paramètres suivants sont appliqués aux instances de base de données source et en aval :
-
Toutes les bases de données doivent inclure :
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
STREAMS_POOL_SIZEdoit être défini dans Oracle 21c et versions inférieures. Par exemple :ALTER SYSTEM SET STREAMS_POOL_SIZE = 1G; -
La base de données d'exploration et la base de données source doivent être en mode fichier de journalisation archivé. Pour activer l'archivage sur la base de données, exécutez la commande suivante qui indique à la base de données de créer un fichier de journalisation archivé lors du changement de fichier de journalisation.
ALTER DATABASE ARCHIVE LOG; -
(Exploration en aval uniquement) La base de données en aval doit avoir des paramètres différents pour les éléments suivants :
-
DBID -
DBNAME -
DB_UNIQUE_NAME -
GLOBAL_NAME
(Base de données d'exploration en aval et base de données source) Dans un environnement en aval, le nom de base de données unique correspond au nom de base de données.
-
-
Les fichiers de mots de passe (
orapwSID) de la base de données source et en aval sont identiques. Par conséquent,remote_login_passwordfiledoit être défini surSHAREDouEXCLUSIVE.
Configurer les paramètres de la base de données en aval
Utilisez cette section pour configurer les paramètres du mode de minage en temps réel et du mode de minage d'archive, le cas échéant.
Paramètres pour l'extraction en aval en mode exploration en temps réel
Pour l'extraction en aval en mode Exploitation en temps réel, le principal prérequis est que les fichiers de journalisation de secours doivent être configurés correctement dans la base de données en aval.
L'exploration en temps réel en aval est activée avec un paramètre explicite dans le fichier de paramètres d'extraction. La configuration du LAD est indépendante de ce mode. Si le paramètre TRANLOGOPTIONS INTEGRATEDPARAMS (REAL_TIME_MINE Y) n'a pas encore été défini, vous devez le définir pour activer l'extraction en aval pour le mode d'exploration en temps réel :
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)Remarque : il ne peut y avoir qu'une seule extraction en temps réel sur la base de données en aval pour une base de données source donnée. Les autres extractions doivent être en temps non réel. Il s'agit d'une restriction du transport des informations de journalisation.
La commande suivante exécutée sur la base de données Downstream Mining affiche la sauvegarde locale en cours de configuration à l'aide de FRA :
ALTER SYSTEM
    SET log_archive_config='DG_CONFIG=(CDBNORTH, cdbDSC)';
ALTER SYSTEM set FAL_SERVER = 'CDBNORTH_root';
Les fichiers de journalisation de secours doivent exister dans la base de données en aval. S'il y a n fichiers de journalisation en ligne à la source, il doit y avoir n+1 fichiers de journalisation de secours à la cible de même taille.
Créer les fichiers de journalisation de secours dans la base de données Downstream Mining
Les étapes suivantes décrivent la procédure d'ajout de fichiers de journalisation de secours à la base de données d'exploration en aval. Voici un récapitulatif des règles de création des fichiers de journalisation de secours :
-
Chaque fichier de journalisation de secours doit être au moins aussi volumineux que le fichier de journalisation le plus volumineux de la base de données source. Pour faciliter l'administration, Oracle recommande que tous les fichiers de journalisation de la base source et les fichiers de journalisation de secours de la base de données d'exploration en aval aient la même taille.
-
Le fichier de journalisation de secours doit comporter au moins un groupe de fichiers de journalisation de plus que le fichier de journalisation de la base de données source pour chaque thread de journalisation de la base de données source.
Les étapes et instructions SQL spécifiques requises pour ajouter des fichiers de journalisation de secours dépendent de votre environnement. Pour obtenir des instructions détaillées sur l'ajout de fichiers de journalisation de secours à une base de données, reportez-vous à Création d'une base de données de secours physique.
Remarque : si plusieurs bases de données source envoient des informations de journalisation à une seule base de données d'exploration en aval, une seule de ces sources peut envoyer des informations de journalisation aux fichiers de journalisation de secours de la base de données d'exploration. Un processus Extract qui extrait les informations de journalisation de cette base de données source peut s'exécuter en temps réel. Toutes les autres bases de données source doivent envoyer uniquement leurs fichiers de journalisation archivés à la base de données d'exploration en aval, et les extractions qui lisent ces données doivent être configurées pour s'exécuter en mode de journalisation archivé uniquement.
Créer les fichiers de journalisation de secours
-
Dans SQL*Plus, connectez-vous à la base de données source en tant qu'administrateur.
-
Déterminez la taille du fichier journal source. Notez les résultats.
SELECT BYTES FROM V$LOG; -
Déterminez le nombre de groupes de fichiers journaux en ligne configurés sur la base de données source. Notez les résultats.
SELECT COUNT(GROUP#) FROM V$LOG; -
Connectez-vous à la base de données d'exploration en aval en tant qu'administrateur.
-
Ajoutez les groupes de fichiers journaux de secours à la base de données Data Mining. La taille du fichier journal de secours doit être au moins égale à la taille du fichier journal source. Le nombre de groupes de fichiers journaux de secours doit être supérieur au nombre de groupes de fichiers journaux en ligne source. Cela s'applique à chaque instance (thread) d'une installation RAC. Par conséquent, si vous disposez de n threads au niveau de la base de données source, chacun disposant de m groupes de fichiers de journalisation, vous devez configurer n*(m+1) groupes de fichiers de journalisation au niveau de la base de données d'exploration en aval.
L'exemple suivant présente trois groupes de journaux de secours.
ALTER DATABASE ADD STANDBY LOGFILE GROUP 3 ('/oracle/dbs/slog3a.rdo', '/oracle/dbs/slog3b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 4 ('/oracle/dbs/slog4.rdo', '/oracle/dbs/slog4b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 5 ('/oracle/dbs/slog5.rdo', '/oracle/dbs/slog5b.rdo') SIZE 500M; -
Vérifiez que les groupes de fichiers journaux de secours ont été ajoutés.
SELECT GROUP#, THREAD#, SEQUENCE#, ARCHIVED, STATUS
FROM V$STANDBY_LOG;
La sortie doit ressembler à ce qui suit :
GROUP# THREAD# SEQUENCE# ARC STATUS ---------- ---------- ---------- --- ---------- 3 0 0 YES UNASSIGNED 4 0 0 YES UNASSIGNED 5 0 0 YES UNASSIGNED -
Assurez-vous que les fichiers journaux de la base de données source apparaissent à l'emplacement indiqué dans l'attribut
LOCATIONdu fichierLOG_ARCHIVE_DEST_nlocal que vous définissez. Vous devrez peut-être changer de fichier journal au niveau de la base de données source pour voir les fichiers dans le répertoire.
Configurer la base de données d'exploration en aval pour archiver les fichiers de journalisation de secours en local
Cette procédure configure la base de données d'exploration en aval pour archiver les fichiers de journalisation de secours qui reçoivent les données de journalisation des fichiers de journalisation en ligne de la base source. N'oubliez pas que les fichiers de journalisation archivés étrangers ne doivent pas être archivés dans la zone de récupération de la base de données d'exploration en aval.
Pour archiver localement les fichiers de journalisation de secours :
-
Dans la base de données d'exploration en aval, définissez la deuxième destination de journal d'archivage dans le paramètre d'initialisation
LOG_ARCHIVE_DEST_n, comme indiqué dans l'exemple suivant.ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='LOCATION=/home/arc_dest/srl_dbms1 VALID_FOR=(STANDBY_LOGFILE,PRIMARY_ROLE)'Oracle recommande que les journaux archivés étrangers (journaux provenant de bases de données source distantes) soient séparés des fichiers journaux de base de données d'exploration locale et les uns des autres. Vous ne devez pas utiliser la zone de récupération de la base de données d'exploration en aval pour préparer les journaux archivés étrangers.
-
Activez le paramètre
LOG_ARCHIVE_DEST_2que vous avez défini à l'étape précédente, comme indiqué dans l'exemple suivant.ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE
Paramètres pour l'extraction en aval en mode Extraction d'archive
Pour configurer un processus Extract en aval en mode Archive Mining ou Real-Time Mining, vous devez configurer le transport des informations de journalisation. Incluez les paramètres suivants lors de la configuration de l'extraction en aval en mode Archive-Log-Only :
-
LOG_ARCHIVE_CONFIG -
LOG ARCHIVE DESTINATION (LAD)-
LOG_ARCHIVE_DEST_1pour la sauvegarde locale de toutes les bases de données -
Service
LOG_ARCHIVE_DEST_2pour le transport des informations de journalisation sur la base de données source
-
Remarque : LOG_ARCHIVE_DEST_2 est indépendant de l'utilisation de l'exploration en temps réel.
-
La destination de sauvegarde de la base de données locale est définie à l'aide de la zone de récupération rapide
-
FAL_SERVER -
Tous les paramètres système requis peuvent être définis dynamiquement avec
scope=both
Les paramètres LAD (Archive Log Destination) sont requis pour la destination de sauvegarde locale et les services de transport des informations de journalisation sur les bases de données source.
Configurez les paramètres LAD pour la destination de sauvegarde locale à l'aide des commandes suivantes :
ALTER SYSTEM SET db_recovery_file_dest = '/u01/app/oracle/fast_recovery_area';
ALTER SYSTEM SET db_recovery_file_dest_size = 100G;
ALTER SYSTEM SET log_archive_dest_1 = 'LOCATION=USE_DB_RECOVERY_FILE_DEST';
Configurez les options de paramètre LAD pour les services de transport des informations de journalisation sur la base de données source à l'aide des commandes suivantes :
ALTER SYSTEM SET log_archive_config = 'DG_CONFIG = (CDBNORTH, cdbDSC)';
ALTER SYSTEM
      SET log_archive_dest_2='SERVICE=cdbDSC_root
                              ASYNC
                              NOREGISTER
                              VALID_FOR=(ONLINE_LOGFILES, PRIMARY_ROLE)
                              DB_UNIQUE_NAME=cdbDSC';
Pour en savoir plus sur le paramètre LOG_ARCHIVE_DEST et ses attributs, reportez-vous à LOG_ARCHIVE_DEST_n dans le guide Référence de base de données.
Configurer l'extraction Oracle GoldenGate pour le déploiement en aval
Dans cette section, vous allez découvrir les paramètres requis par Oracle GoldenGate pour configurer les connexions avec les bases de données source et en aval, et pour configurer le processus Extract pour la base de données en aval.
Configurer Oracle GoldenGate pour la base de données en aval
Le fichier de paramètres Extract en aval doit inclure les paramètres suivants pour configurer un déploiement en aval :
-
TRANLOGOPTIONS MININGUSERALIAS: définit la connexion à la base de données d'exploration en aval pour les requêtes de métadonnées internes. -
FETCHUSERIDALIAS: se connecte à la base de données source pour extraire les données qui ne peuvent pas être extraites de manière native du journal de transactions. -
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y): si la valeur est Y (Oui), le processus Extract capture les modifications des fichiers de journalisation de secours dans la base de données en aval. S'il n'est pas défini, le processus Extract capture les données à partir des fichiers de journalisation archivés.
Voici un exemple de fichier de paramètres Extract comprenant les paramètres suivants :
EXTRACT EXTDSC
USERIDALIAS cgg_CDBNORTH
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)
FETCHUSERIDALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate

EXTTRAIL Downstream/ea
SOURCECATALOG CDBNORTH_PDB1
DDL INCLUDE MAPPED
TABLE HR.*;
Pour configurer le déploiement Oracle GoldenGate pour l'extraction en aval, procédez comme suit :
-
Ajoutez des informations d'identification pour la base source :
ALTER CREDENTIALSTORE ADD USER c##ggadmin@CDBNORTH_root ALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate PASSWORD password -
Ajoutez des informations d'identification pour la base de données en aval :
ALTER CREDENTIALSTORE ADD USER c##ggadmin@cdbDSC_root ALIAS cgg_cdbDSC DOMAIN OracleGoldenGate PASSWORD *password* -
Utilisez
DBLOGINpour vous connecter à la base de données source et à la base de données en aval d'Oracle GoldenGate :DBLOGIN USERIDALIAS cgg_CDBNORTHMININGDBLOGIN USERIDALIAS cgg_cdbDSCDans cet exemple,
cgg_CDBNORTHest l'alias d'informations d'identification de la base de données source CDBNORTH etcgg_cdbDSCest l'alias d'informations d'identification de la base de données d'exploration. -
Ajoutez et enregistrez une extraction, modifiez le fichier de paramètres pour inclure les paramètres d'extraction fournis précédemment, ajoutez le nom et l'emplacement de la trace d'extraction, puis lancez l'extraction :
ADD EXTRACT extdsc, INTEGRATED TRANLOG, BEGIN NOW
REGISTER EXTRACT extdsc, DATABASE CONTAINER (CDBNORTH_PDB01)

ADD EXTTRAIL Downstream/ea, EXTRACT extdsc
START extdsc
Configuration de l'extraction en aval en cascade à l'aide d'Active Data Guard
Si la connexion à la base de données source n'est pas possible, GoldenGate peut être configuré pour utiliser une base de données de secours Active Data Guard (ADG). La base de données de secours est disponible pour les connexions en lecture seule afin d'effectuer des interrogations de métadonnées et des extractions. Dans cette section, vous allez apprendre à configurer une extraction en aval à l'aide d'ADG et sans établir de connexion avec la base de données source.
Activer l'extraction en aval pour utiliser ADG
Dans un environnement de capture en cascade en aval, la base de données en aval ne se connecte pas directement à la base source. Il utilise Active Data Guard (ADG) pour l'extraction et les requêtes de métadonnées.
L'extraction doit être démarrée à l'aide de l'option sans source afin qu'elle ne se connecte pas à la base de données source et se connecte plutôt à ADG à l'aide de FETCHUSERID ou FETCHUSERIDALIAS lorsqu'elle doit extraire tout type de données non natif. Par exemple, les opérations FETCH sont traitées sur la base de données ADG car cette instance est ouverte en mode lecture seule. D'autres opérations qui ne peuvent pas être traitées sur l'instance ADG, telles que la création du dictionnaire, sont redirigées du groupe ADG vers la base de données source.
Lors de l'inscription d'une extraction en aval, Oracle GoldenGate se connecte à ADG en tant que base de données source au lieu de la base de données d'origine des informations de journalisation. La redirection ADG est prise en charge pour les commandes et paramètres suivants :
-
SCHEMATRANDATA -
TRANDATA -
FLUSH SEQUENCE -
TRACETABLE -
HEARTBEATTABLE -
REGISTER EXTRACTRemarque :SCHEMATRANDATAetTRANDATA, même si la commande est exécutée sur le fichier de journalisation de secours, les groupes de fichiers de journalisation réels sont créés et gérés sur la base de données principale où les opérations LMD réelles ont lieu.
ADG Redirection est disponible avec Oracle Database 21c et versions ultérieures. Il prend également en charge l'inscription avec caractères génériques. L'exemple suivant illustre le fichier de paramètres Extract pour le processus Extract en aval, lors de l'utilisation d'ADG :
EXTRACT EXTDSC
NOUSERID
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC_src DOMAIN OracleGoldenGate
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y) FETCHUSERIDALIAS cgg_cdbADG_src DOMAIN OracleGoldenGate

EXTTRAIL cascade/ea
SOURCECATALOG CDBNORTH_PDB01
DDL INCLUDE MAPPED
TABLE HR.*;
Voici les étapes permettant au processus Extract en aval d'utiliser la base de données de secours ADG :
-
Ajoutez une valeur
LOG_ARCHIVE_DESTINATION_N (LAD)supplémentaire sur la base de données de secours ADG, comme indiqué dans l'exemple suivant :ALTER SYSTEM SET LOG_ARCHIVE_DEST_3='service=mining_db_service_name ASYNC NOREGISTER VALID_FOR(STANDBY_LOGFILES,STANDBY_ROLES) DB_UNIQUE_NAME=3rd_db_unique_name' scope=bothCette étape transporte et génère le fichier
standby_logfilespour une base de données de secours ADG. -
Définissez
LOG_ARCHIVE_CONFIGsur la base de données de secours ADG pour envoyer les journaux à la base de données minière, comme indiqué dans l'exemple suivant :ALTER SYSTEM SET LOG_ARCHIVE_CONFIG = 'DG_CONFIG' = (CDBNORTH, cdbADG_src, cdbDSC)';DB_CONFIGest le nom unique de base de données des première, deuxième et troisième bases de données. -
Dans la base de données d'exploration, configurez l'emplacement de stockage de l'élément standby_logfiles entrant sur la base de données d'exploration, comme indiqué dans l'exemple suivant :
ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='location= /home/arc_dest/dstrm VALID_FOR=(STANDBY_LOGFILE,ALL_ROLES)' scope=bothoù
/home/arc_dest/dstrmest l'emplacement des journaux d'archivage étrangers. N'utilisez pas FRA pour stocker les fichiers de journalisation archivés étrangers. -
Exécutez
LOG_ARCHIVE_CONFIGsur la base de données d'extraction afin que le processus d'extraction puisse les lire dans la base de données d'extraction, comme indiqué dans l'exemple suivant :ALTER SYSTEM SET LOG_ARCHIVE_CONFIG ='DG_CONFIG' scope=bothIci,
DB_CONFIGest le nom unique de base de données des première, deuxième et troisième bases de données. -
Pour une extraction en aval, vous devez vous assurer que les connexions de base de données sont correctement configurées. Lors de l'inscription de l'extraction, assurez-vous que la connexion
DBLOGINest établie à la base de données de secours ADG, qui est ouverte pour l'activité en lecture seule. -
Pour ajouter le processus Extract et l'enregistrer, utilisez la commande suivante :
DBLOGIN USERID ggadmin@cdbADG_src, PASSWORD ggadmin
MININGDBLOGIN USERID ggadmin@cgg_cdbDSC, password ggadmin
cdbADG_src est l'ADG non principal.
cgg_cdbDSC est la base de données d'exploration.
-
Enregistrez maintenant une extraction qui utilise le paramètre
NOUSERID:ADD EXTRACT exte, INTEGRATED TRANLOG, BEGIN NOW REGISTER EXTRACT exte DATABASE -
Une fois le processus Extract enregistré, vous pouvez l'utiliser pour extraire des données et le démarrer normalement.