Intelligence artificielle dans Oracle AI Database
Ce chapitre décrit les fonctionnalités d'intelligence artificielle fournies dans Oracle AI Database.
-
Présentation d'Oracle AI Vector Search Oracle AI Vector Search est conçu pour les workloads d'intelligence artificielle (IA) et vous permet d'interroger des données en fonction de la sémantique, plutôt que de mots-clés.
-
Mesures de distance vectorielle La mesure des distances dans un espace vectoriel est au cœur de l'identification des résultats les plus pertinents pour un vecteur de requête donné. Ce processus est très différent du filtrage de mots-clés bien connu dans le monde des bases de données relationnelles.
-
Présentation des index des petits mondes hiérarchiques navigables Utilisez ces exemples pour comprendre comment créer des index HNSW pour les recherches de similarité approximative de vecteur.
-
Comprendre les index de vecteur plat de fichier inversé L'index de vecteur plat de fichier inversé est une technique conçue pour améliorer l'efficacité de la recherche en limitant la zone de recherche à l'aide de partitions ou de clusters voisins.
-
Exécution de recherches de similarité Cette section décrit les méthodes permettant d'effectuer des recherches de similarité.
Présentation d'Oracle AI Vector Search
Oracle AI Vector Search est conçu pour les charges de travail d'intelligence artificielle (IA) et vous permet d'interroger des données en fonction de la sémantique, plutôt que de mots-clés.
Type de données VECTOR
Le type de données VECTOR est introduit avec la version d'Oracle AI Database 26ai, qui fournit la base pour stocker les incorporations vectorielles avec les données d'entreprise dans la base de données. Grâce aux modèles d'intégration, vous pouvez transformer des données non structurées en incorporations vectorielles qui peuvent ensuite être utilisées pour les requêtes sémantiques sur les données d'entreprise. Pour utiliser le type de données VECTOR et ses fonctionnalités associées, le paramètre d'initialisation COMPATIBLE doit être défini sur 23.4.0 ou une version ultérieure. Pour plus d'informations sur le paramètre et sa modification, reportez-vous au Guide de mise à niveau d'Oracle AI Database.
Reportez-vous à l'exemple de base suivant pour utiliser le type de données VECTOR dans une définition de table :
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);Pour plus d'informations sur le type de données VECTOR et sur l'utilisation des vecteurs dans les tables, reportez-vous à Création de tables à l'aide du type de données VECTOR.
En raison de la nature numérique du type de données VECTOR, vous pouvez l'utiliser comme entrée pour les algorithmes d'apprentissage automatique tels que la classification, l'anomalie, la régression, le clustering et l'extraction de fonctionnalités. Pour plus de détails sur l'utilisation du type de données VECTOR dans l'apprentissage automatique, reportez-vous à la section Prise en charge des types de données vectorielles. Remarque : la prise en charge du machine learning du type de données VECTOR est disponible dans toutes les versions à partir de la version 23.7.
Plongements vectoriels
Si vous avez déjà utilisé des applications telles que des assistants vocaux, des chatbots, des traducteurs de langue, des systèmes de recommandation, la détection d'anomalies ou la recherche et la reconnaissance vidéo, vous avez implicitement utilisé des fonctionnalités d'intégration de vecteurs.
Oracle AI Vector Search stocke les incorporations vectorielles, qui sont des représentations vectorielles mathématiques de points de données. Ces incorporations de vecteurs décrivent la signification sémantique derrière le contenu tel que des mots, des documents, des pistes audio ou des images. Par exemple, tout en effectuant des recherches textuelles, la recherche vectorielle est souvent considérée comme meilleure que la recherche par mot clé car la recherche vectorielle est basée sur le sens et le contexte derrière les mots et non sur les mots eux-mêmes. Cette représentation vectorielle traduit la similitude sémantique des objets, tels que perçus par les humains, en proximité dans un espace vectoriel mathématique. Cet espace vectoriel a généralement plusieurs centaines, sinon des milliers, de dimensions. En d'autres termes, les incorporations vectorielles sont un moyen de représenter presque tous les types de données, tels que le texte, les images, les vidéos, les utilisateurs ou la musique, en tant que points dans un espace multidimensionnel où l'emplacement de ces points dans l'espace et la proximité des autres ont un sens sémantique.
Ce diagramme simplifié illustre un espace vectoriel où les mots sont codés en vecteurs 2 dimensions.
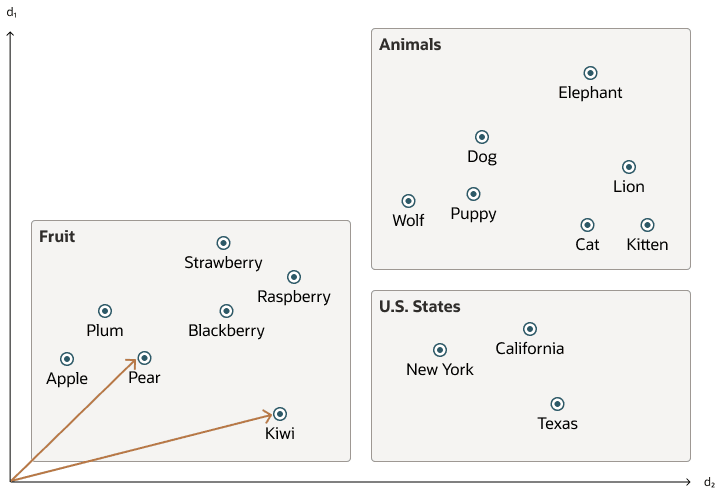
Description de l'illustration vector_embeddings.png
Recherche de similarité
La recherche de similarité sémantique dans un ensemble de données équivaut désormais à rechercher les voisins les plus proches dans un espace vectoriel au lieu d'utiliser des recherches par mot-clé traditionnelles à l'aide de prédicats de requête. Comme illustré dans le schéma suivant, la distance entre dog et wolf dans cet espace vectoriel est plus courte que la distance entre dog et kitten. Dans cet espace, un chien est plus semblable à un loup qu'à un chaton. Pour plus d'informations, voir Effectuer une recherche de similarité exacte.
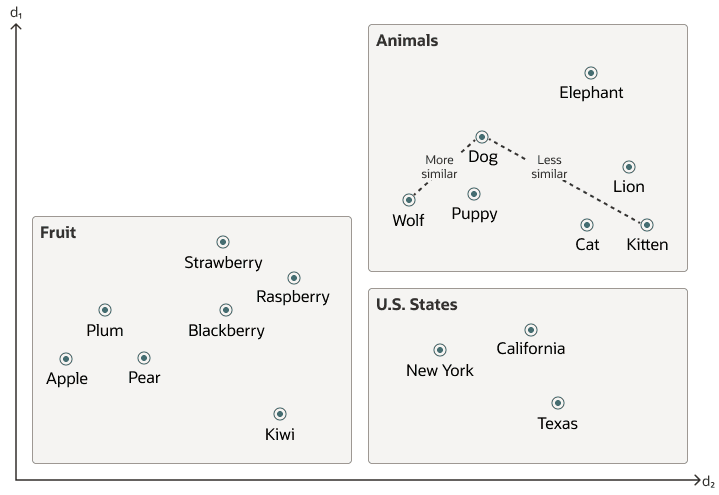
Description de l'illustration vector_embeddings_similarity.png
Les données vectorielles ont tendance à être inégalement réparties et regroupées en groupes sémantiques. Effectuer une recherche de similarité basée sur un vecteur de requête donné équivaut à récupérer les vecteurs les plus proches de votre vecteur de requête dans votre espace vectoriel. Fondamentalement, vous devez trouver une liste ordonnée de vecteurs en les classant, où la première ligne de la liste est le vecteur le plus proche ou le plus similaire au vecteur de requête, la deuxième ligne de la liste est le deuxième vecteur le plus proche du vecteur de requête, etc. Lorsque vous effectuez une recherche de similarité, l'ordre relatif des distances est ce qui compte vraiment plutôt que la distance réelle.
A l'aide de l'espace vectoriel précédent, voici une illustration d'une recherche sémantique où votre vecteur de requête est celui qui correspond au mot Puppy et où vous souhaitez identifier les quatre mots les plus proches :
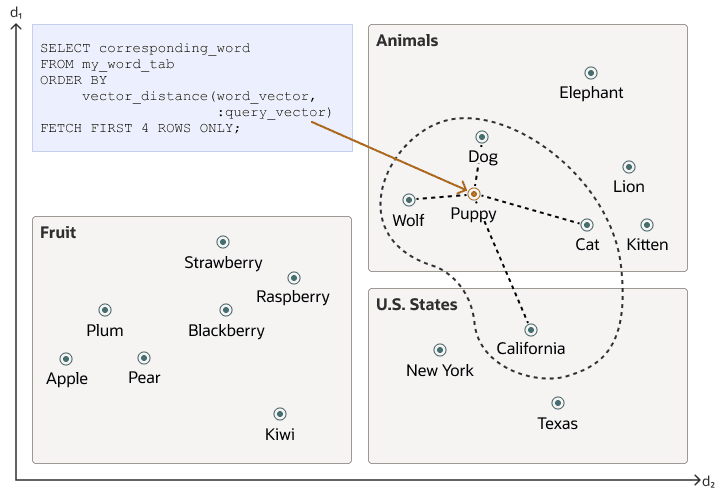
Description de l'illustration vector_embeddings_similarity_search.png
Les recherches de similarité ont tendance à obtenir des données à partir d'un ou de plusieurs clusters en fonction de la valeur du vecteur de requête et de la taille d'extraction.
Les recherches approximatives utilisant des index vectoriels peuvent limiter les recherches à des clusters spécifiques, tandis que les recherches exactes visitent des vecteurs dans tous les clusters. Pour plus d'informations, reportez-vous à Utilisation d'index vectoriels.
Modèles de plongement vectoriel
Une façon de créer de telles incorporations vectorielles pourrait être d'utiliser l'expertise de domaine de quelqu'un pour quantifier un ensemble prédéfini de caractéristiques ou de dimensions telles que la forme, la texture, la couleur, le sentiment et bien d'autres, selon le type d'objet avec lequel vous avez affaire. Cependant, l'efficacité de cette méthode dépend du cas d'utilisation et n'est pas toujours rentable.
Au lieu de cela, les incorporations vectorielles sont créées via des réseaux neuronaux. La plupart des incorporations vectorielles modernes utilisent un modèle de transformateur, comme illustré par le schéma suivant, mais des réseaux neuronaux convolutionnels peuvent également être utilisés.
Figure 1 : Modèle d'intégration de vecteur
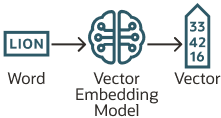
Description de l'illustration basic_transform.png
Selon le type de vos données, vous pouvez utiliser différents modèles préentraînés et open source pour créer des incorporations vectorielles. Exemple :
-
Pour les données textuelles, les transformateurs de phrases transforment les mots, les phrases ou les paragraphes en incorporations vectorielles.
-
Pour les données visuelles, vous pouvez utiliser le réseau résiduel (ResNet) pour générer des incorporations vectorielles.
-
Pour les données audio, vous pouvez utiliser la représentation visuelle par spectrogramme des données audio pour revenir dans le cas de données visuelles.
Chaque modèle détermine également le nombre de dimensions de vos vecteurs. Exemple :
-
Le modèle d'intégration embed-english-v3.0 de Cohere a 1024 dimensions.
-
Le modèle d'intégration d'OpenAI text-embedding-3-large a 3072 dimensions.
-
Le modèle d'intégration de Hugging Face all-MiniLM-L6-v2 a 384 dimensions
Bien sûr, vous pouvez toujours créer votre propre modèle entraîné avec votre propre ensemble de données.
Importer des modèles d'intégration dans Oracle AI Database
Bien que vous puissiez générer des incorporations vectorielles en dehors d'Oracle AI Database à l'aide de modèles d'intégration open source préentraînés ou de vos propres modèles d'intégration, vous avez également la possibilité d'importer ces modèles directement dans Oracle AI Database s'ils sont compatibles avec la norme ONNX (Open Neural Network Exchange). Oracle AI Database implémente une exécution ONNX directement dans la base de données. Vous pouvez ainsi générer des incorporations vectorielles directement dans Oracle AI Database à l'aide de SQL. Pour plus d'informations, reportez-vous à Générer des incorporations de vecteur.
Mesures de distance vectorielle
La mesure des distances dans un espace vectoriel est au cœur de l'identification des résultats les plus pertinents pour un vecteur de requête donné. Ce processus est très différent du filtrage de mots-clés bien connu dans le monde des bases de données relationnelles.
Lorsque vous travaillez avec des vecteurs, vous pouvez calculer les distances de plusieurs façons pour déterminer à quel point deux vecteurs sont similaires ou différents. Chaque mesure de distance est calculée à l'aide de formules mathématiques différentes. Le temps nécessaire pour calculer la distance entre deux vecteurs dépend de nombreux facteurs, dont la mesure de distance utilisée ainsi que le format des vecteurs eux-mêmes, tels que le nombre de dimensions vectorielles et les formats de dimensions vectorielles. En général, il est préférable de faire correspondre la mesure de distance que vous utilisez à celle qui a été utilisée pour entraîner le modèle d'intégration de vecteurs qui a généré les vecteurs.
Présentation des index hiérarchiques des petits mondes navigables
Utilisez ces exemples pour comprendre comment créer des index HNSW pour les recherches de similarité approximative de vecteur.
Avec Navigable Small World (NSW), l'idée est de construire un graphique de proximité où chaque vecteur du graphique se connecte à plusieurs autres en fonction de trois caractéristiques :
-
La distance entre les vecteurs
-
Nombre maximal de vecteurs candidats les plus proches pris en compte à chaque étape de la recherche lors de l'insertion
(EFCONSTRUCTION) -
Nombre maximal de connexions (
NEIGHBORS) autorisé par vecteur
Si la combinaison des seuils ci-dessus est trop élevée, vous pouvez vous retrouver avec un graphique fortement connecté, ce qui peut ralentir le processus de recherche. D'autre part, si la combinaison de ces seuils est trop faible, alors le graphique peut devenir trop clairsemé et/ou déconnecté, ce qui rend difficile de trouver un chemin entre certains vecteurs pendant la recherche.
La traversée de graphes Navigable Small World (NSW) pour la recherche de vecteurs commence par un point d'entrée prédéfini dans le graphique, accédant à un cluster de vecteurs étroitement liés. L'algorithme de recherche utilise deux listes de clés : Candidats, une liste de vecteurs dynamiquement mise à jour que nous rencontrons lors de la traversée du graphique, et Résultats, qui contient les vecteurs les plus proches du vecteur de requête trouvé jusqu'à présent. Au fur et à mesure de la progression de la recherche, l'algorithme navigue dans le graphique, affinant continuellement les candidats en explorant et en évaluant des vecteurs qui pourraient être plus proches que ceux des résultats. Le processus se termine une fois qu'il n'y a pas de vecteurs dans les candidats plus proches que le plus éloigné dans les résultats, indiquant qu'un minimum local a été atteint et que les vecteurs les plus proches du vecteur de requête ont été identifiés.
Cette opération est illustrée dans l'illustration suivante :
Figure 2 : Graphique du petit monde navigable
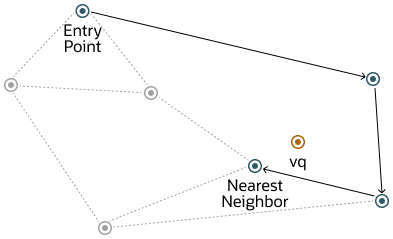
description de l'illustration navigable-small-world-graph.png,
La méthode décrite démontre des performances robustes jusqu'à une certaine échelle d'insertion de vecteurs dans le graphe. Au-delà de ce seuil, l'approche HNSW (Hierarchical Navigable Small World) améliore le modèle NSW en introduisant une hiérarchie à plusieurs couches, semblable à la structure observée dans les listes de sauts probabilistes. Cette architecture hiérarchique est implémentée en répartissant les connexions du graphique sur plusieurs couches, en les organisant de manière à ce que chaque couche suivante contienne un sous-ensemble des vecteurs de la couche ci-dessous. Cette stratification garantit que les couches supérieures capturent les liens longue distance, servant efficacement de voies express à travers le graphique, tandis que les couches inférieures se concentrent sur les liens plus courts, facilitant la navigation locale fine. En conséquence, les recherches commencent aux couches supérieures pour approcher rapidement la région du vecteur cible, se déplaçant progressivement vers les couches inférieures pour une recherche plus précise, améliorant considérablement l'efficacité et la précision de la recherche en tirant parti de liens plus courts (de petites distances) entre les vecteurs lorsque l'on se déplace de la couche supérieure vers le bas.
Pour mieux comprendre comment cela fonctionne pour HNSW, examinons comment cette hiérarchie est utilisée pour la structure de liste de saut de probabilité :
Figure 3 : Structure de la liste de saut de probabilité
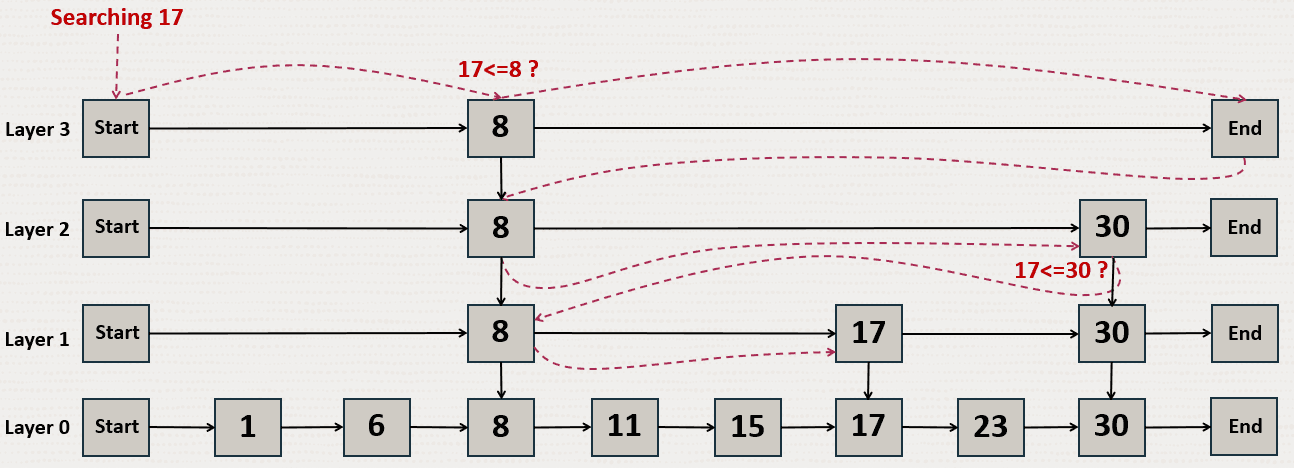
Description de l'illustration probabilité-skip-list_01.png
La structure Liste de saut de probabilité utilise plusieurs couches de listes liées où les couches ci-dessus ignorent plus de nombres que les couches inférieures. Dans cet exemple, vous essayez de rechercher le numéro 17. Vous commencez par le calque supérieur et passez à l'élément suivant jusqu'à ce que vous trouviez 17, que vous atteigniez la fin de la liste ou que vous trouviez un nombre supérieur à 17. Lorsque vous atteignez la fin d'une liste ou que vous trouvez un nombre supérieur à 17, vous commencez dans la couche précédente à partir du dernier nombre inférieur à 17.
HNSW utilise le même principe avec les couches NSW où vous trouvez de plus grandes distances entre les vecteurs dans les couches supérieures. Cela est illustré par les diagrammes suivants dans un espace 2D :
Au niveau de la couche supérieure sont les arêtes les plus longues et au niveau de la couche inférieure sont les plus courtes.
Figure 4 : Graphiques hiérarchiques des petits mondes navigables
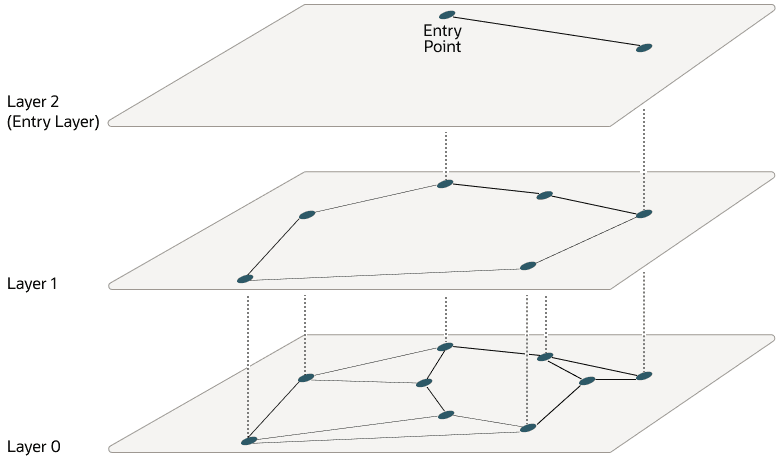
Description de l'illustration hiérarchique-navigable-small-world-graph_02.png
En partant de la couche supérieure, la recherche dans une couche commence au niveau du vecteur d'entrée. Ensuite, pour chaque noeud, s'il y a un voisin plus proche du vecteur de requête que le noeud actuel, il passe à ce voisin. L'algorithme continue de le faire jusqu'à ce qu'il trouve un minimum local pour le vecteur de requête. Lorsqu'un minimum local est trouvé dans une couche, la recherche passe à la couche suivante en utilisant le même vecteur dans cette nouvelle couche et la recherche continue dans cette couche. Ce processus se répète jusqu'à ce que le minimum local de la couche inférieure soit trouvé, qui contient tous les vecteurs. A ce stade, la recherche est transformée en une recherche de similarité approximative à l'aide de l'algorithme NSW autour de ce dernier minimum local trouvé pour extraire les k principaux vecteurs les plus similaires à votre vecteur de requête. Bien que les couches supérieures puissent avoir un maximum de connexions pour chaque vecteur défini par le paramètre NEIGHBORS, la couche 0 peut en avoir deux fois plus. Ce processus est illustré dans le graphique suivant :
Figure 5 : Recherche de graphiques hiérarchiques navigables dans les petits mondes
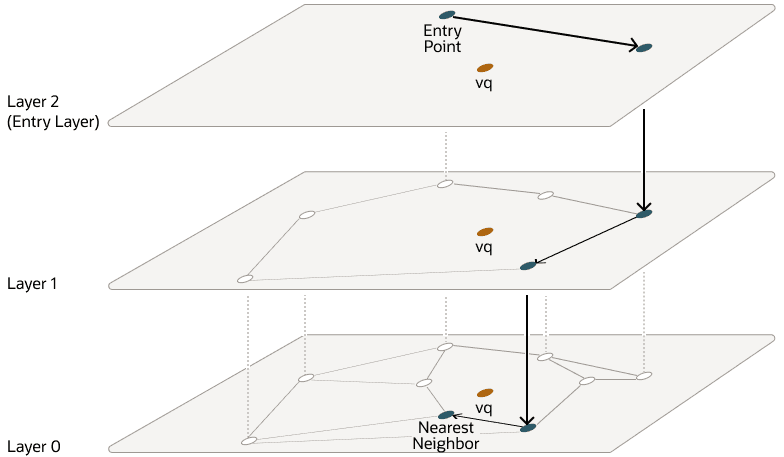
Description de l'illustration hnsw-search-graph_02-png.png
Les couches sont implémentées à l'aide de graphiques en mémoire (et non du graphique Oracle Inmemory). Chaque couche utilise un graphique en mémoire distinct. Comme nous l'avons vu précédemment, lors de la création d'un index HNSW, vous pouvez affiner le nombre maximal de connexions par vecteur dans les couches supérieures à l'aide du paramètre NEIGHBORS ainsi que le nombre maximal de candidats de vecteur les plus proches pris en compte à chaque étape de la recherche lors de l'insertion à l'aide du paramètre EFCONSTRUCTION, où EF signifie Enter Factor.
Comme expliqué précédemment, lorsque vous utilisez Oracle AI Vector Search pour exécuter une requête de recherche approximative à l'aide d'index HNSW, vous avez la possibilité de spécifier une précision cible à laquelle la recherche approximative doit être effectuée.
Dans le cas d'une recherche approximative HNSW, vous pouvez indiquer un pourcentage de précision cible afin d'influencer le nombre de candidats pris en compte pour analyser la recherche. Il est automatiquement calculé par l'algorithme. Une valeur de 100 aura tendance à imposer un résultat similaire à une recherche exacte, bien que le système puisse toujours utiliser l'index et ne pas effectuer une recherche exacte. L'optimiseur peut choisir d'utiliser un index car il peut être plus rapide compte tenu des prédicats de l'interrogation. Au lieu d'indiquer une valeur de pourcentage de précision cible, vous pouvez indiquer le paramètre EFSEARCH pour imposer un certain nombre maximal de candidats à prendre en compte lors de l'analyse de l'index. Plus ce chiffre est élevé, plus la précision est élevée.
Remarque :
-
Si vous n'indiquez aucune précision de cible dans votre requête de recherche approximative, vous hériterez de celle définie lors de la création de l'index. Lors de la création de l'index, vous pouvez spécifier une précision cible à l'aide d'une valeur de pourcentage ou de paramètres en fonction du type d'index que vous créez.
-
Il est possible de spécifier une précision cible différente lors de la recherche d'index par rapport à celle définie lors de la création de l'index. Pour les index HNSW, vous pouvez examiner davantage de voisins à l'aide du paramètre
EFSEARCH(supérieur à la valeurEFCONSTRUCTIONindiquée lors de la création de l'index) afin d'obtenir des résultats plus précis. La précision cible que vous fournissez lors de la création de l'index détermine les paramètres de création de l'index et sert également de valeurs de précision par défaut pour les recherches d'index vectoriels.
Comprendre les index de vecteur plat de fichier inversé
L'index vectoriel Inverted File Flat est une technique conçue pour améliorer l'efficacité de la recherche en réduisant la zone de recherche par l'utilisation de partitions ou de clusters voisins.
Les diagrammes suivants décrivent comment les partitions ou les clusters sont créés dans une recherche approximative effectuée à l'aide d'une représentation d'espace 2D. Mais cela peut être généralisé à des espaces de dimension beaucoup plus élevés.
Figure 6 : Index plat de fichier inversé à l'aide de 2D
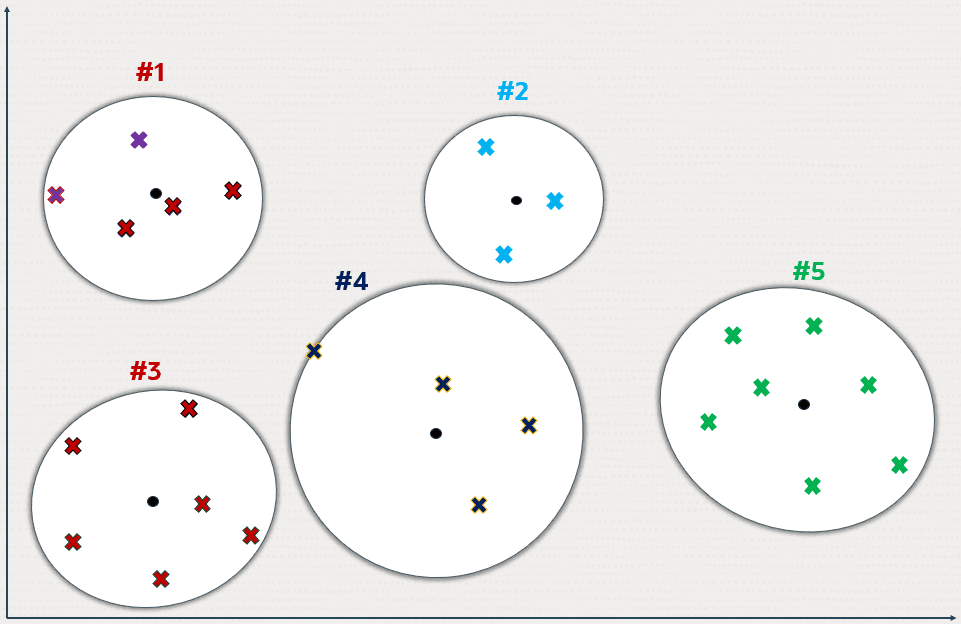
Description de l'illustration inverted-file-index_1.png
Les croix représentent les points de données vectorielles dans cet espace.
De nouveaux points de données, présentés sous forme de petits cercles simples, sont ajoutés pour identifier les centroïdes de partition k, où le nombre de centroïdes (k) est déterminé par la taille de l'ensemble de données (n). En général, k est défini sur la racine carrée de n, bien qu'il puisse être ajusté en indiquant le paramètre NEIGHBOR PARTITIONS lors de la création de l'index.
Chaque centroïde représente le vecteur moyen (centre de gravité) de la partition correspondante.
Les centroïdes sont calculés par une passe d'entraînement sur les vecteurs dont le but est de minimiser la distance totale de chaque vecteur par rapport au centroïde le plus proche.
Les centroïdes finissent par partitionner l'espace vectoriel en partitions k. Cette division est conceptuellement illustrée comme l'expansion des cercles des centroïdes qui cessent de croître à mesure qu'ils se rencontrent, formant des cloisons distinctes.
Figure 7 : Index plat de fichier inversé
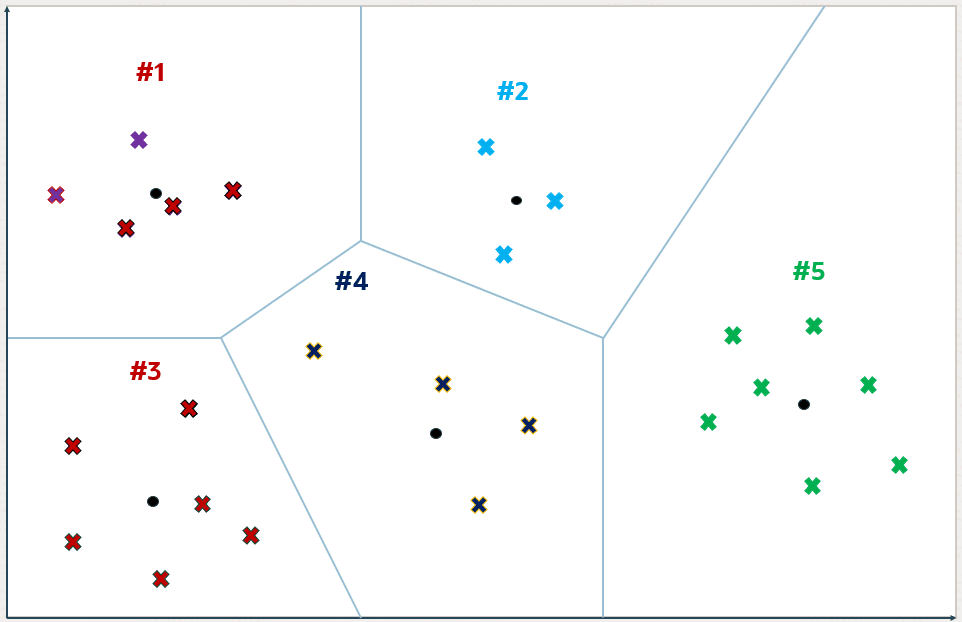
Description de l'illustration inverted-file-index_5.png
A l'exception de ceux de la périphérie, chaque vecteur tombe dans une partition spécifique associée à un centroïde.
Figure 8 : Index plat de fichier inversé
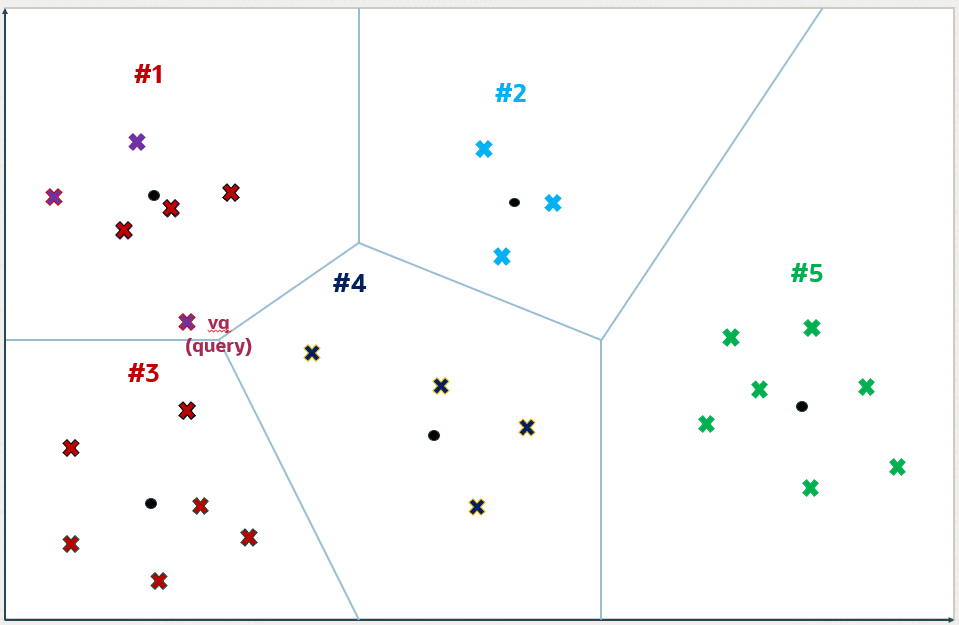
Description de l'illustration inverted-file-index_6.png
Pour un vecteur de requête vq, l'algorithme de recherche identifie les centroïdes i les plus proches, où i utilise par défaut la racine carrée de k, mais peut être ajusté pour une requête spécifique en définissant le paramètre NEIGHBOR PARTITION PROBES. Cet ajustement permet un compromis entre la vitesse de recherche et la précision.
Des nombres plus élevés pour ce paramètre se traduiront par une plus grande précision. Dans cet exemple, i est défini sur 2 et les deux partitions identifiées sont les partitions numéro 1 et 3.
Figure 9 : Index plat de fichier inversé
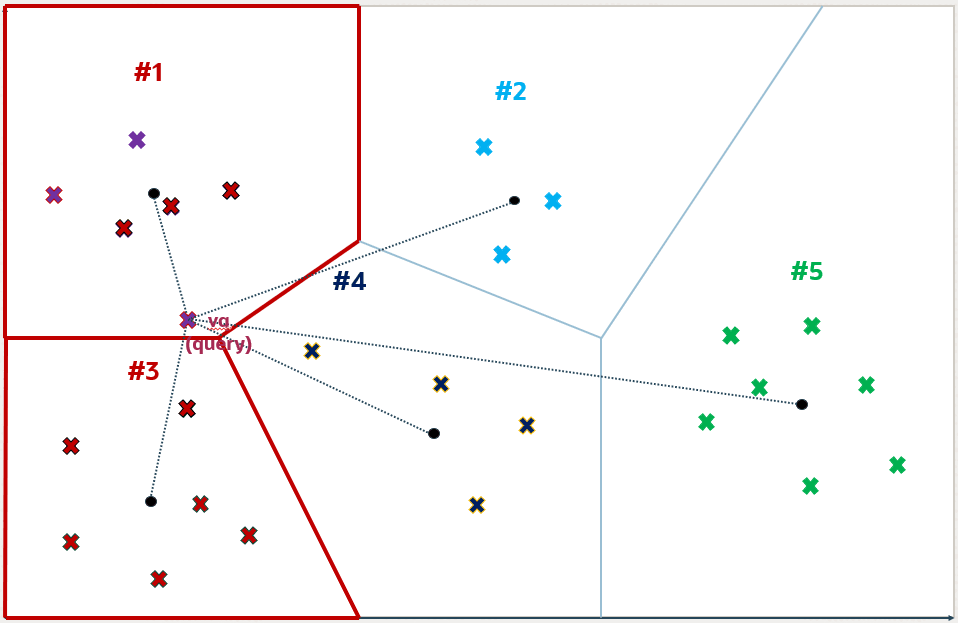
Description de l'illustration inverted-file-index_7.png
Une fois les partitions i déterminées, elles sont entièrement analysées pour identifier, dans cet exemple, les 5 principaux vecteurs les plus proches. Ce nombre 5 peut être différent de k et vous indiquez ce nombre dans votre requête. Les cinq vecteurs les plus proches de vq trouvés dans les partitions numéro 1 et 3 sont mis en évidence dans le diagramme suivant.
Cette méthode constitue une recherche approximative car elle limite la recherche à un sous-ensemble de partitions, accélérant ainsi le processus mais manquant potentiellement des vecteurs plus proches dans des partitions non examinées. Cet exemple illustre qu'une recherche approximative peut ne pas donner les vecteurs les plus proches à vq, ce qui démontre le compromis inhérent entre l'efficacité et la précision de la recherche.
Figure 10 : Index plat de fichier inversé
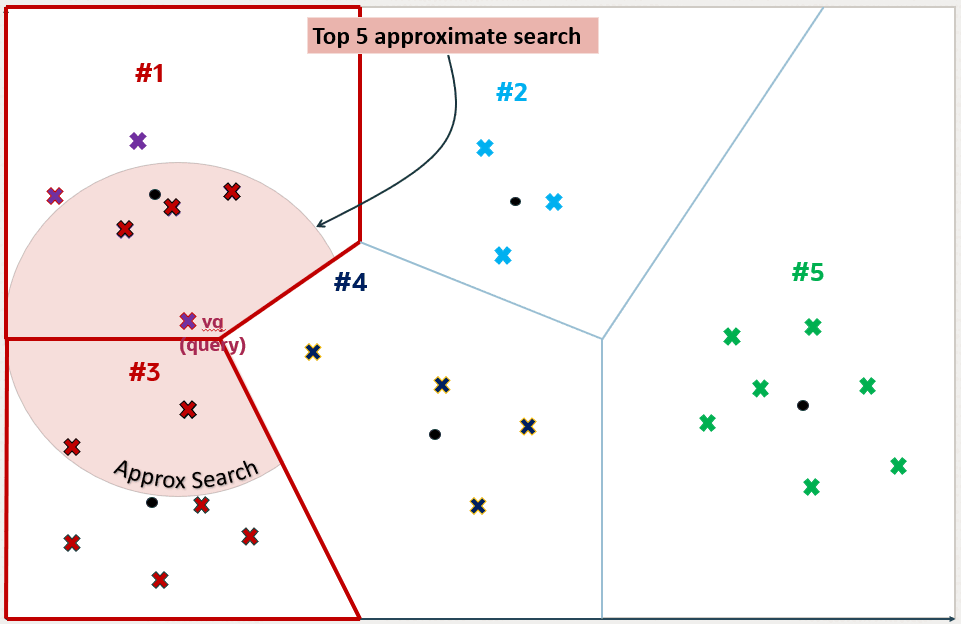
Description de l'illustration inverted-file-index_10.png
Cependant, les cinq vecteurs les plus proches de vq ne sont pas ceux trouvés par la recherche approximative. Vous pouvez voir que l'un des vecteurs de la partition numéro 4 est plus proche de vq que l'un des vecteurs extraits de la partition numéro 3.
Figure 11 : Index plat de fichier inversé
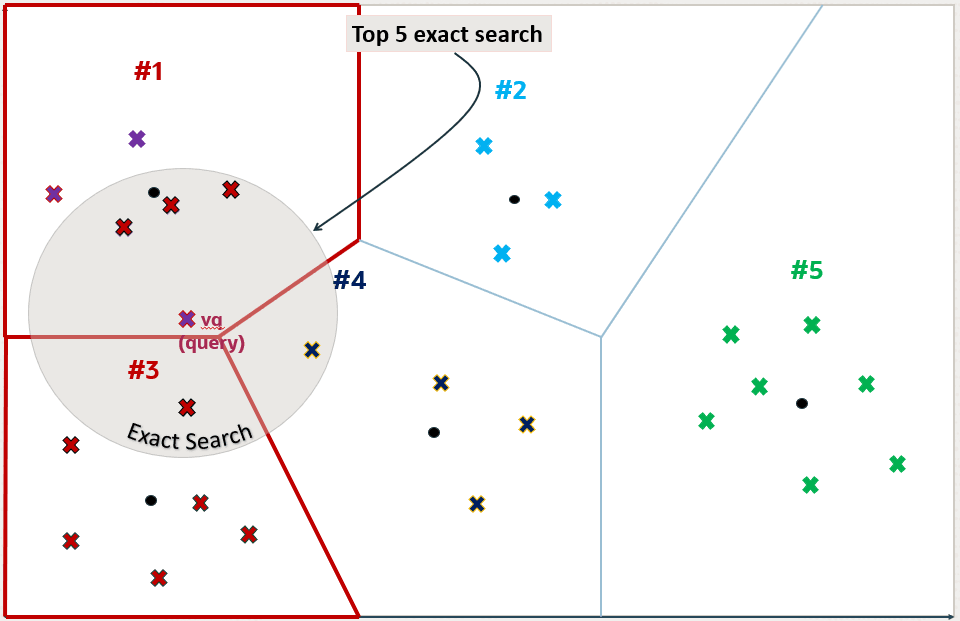
Description de l'illustration inverted-file-index_11.png
Vous pouvez maintenant voir pourquoi l'utilisation de recherches d'index vectoriels n'est pas toujours une recherche exacte et est appelée une recherche approximative à la place. Dans cet exemple, la précision de recherche approximative est de seulement 80% car elle n'a récupéré que 4 sur 5 du résultat exact des vecteurs de recherche.
Figure 12 : Index plat de fichier inversé
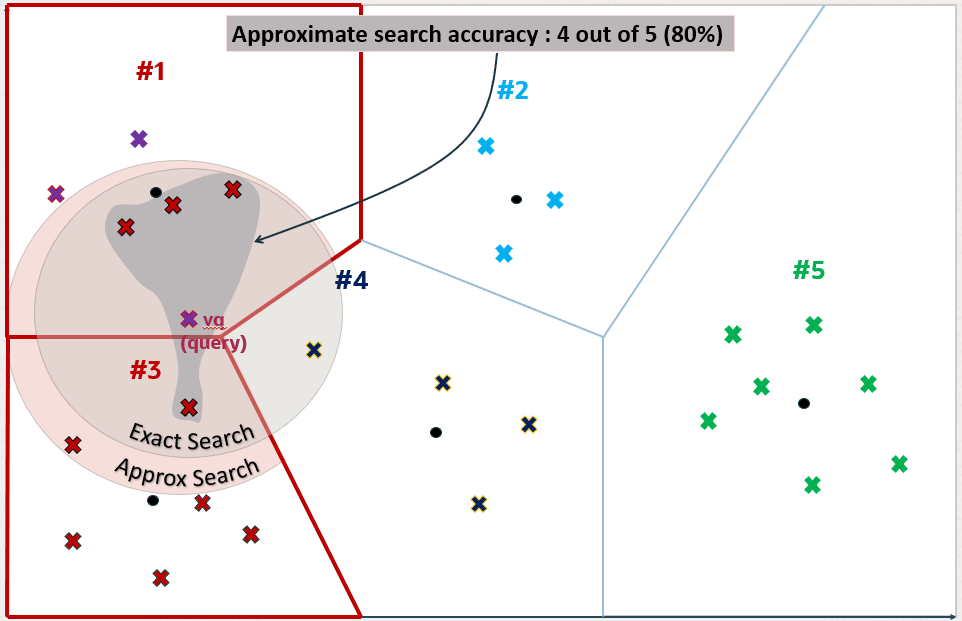
Description de l'illustration inverted-file-index_12.png
Lorsque vous utilisez Oracle AI Vector Search pour exécuter une requête de recherche approximative à l'aide d'index vectoriels, vous avez la possibilité de spécifier une précision cible à laquelle la recherche approximative doit être effectuée.
Dans le cas d'une recherche approximative de FIV, vous pouvez spécifier une valeur de pourcentage de précision cible pour influencer le nombre de partitions utilisées pour sonder la recherche. Il est automatiquement calculé par l'algorithme. Une valeur de 100 aura tendance à imposer une recherche exacte, bien que le système puisse toujours utiliser l'index et ne pas effectuer une recherche exacte. L'optimiseur peut choisir d'utiliser un index car il peut être plus rapide compte tenu des prédicats de l'interrogation. Au lieu d'indiquer une valeur de pourcentage de précision cible, vous pouvez indiquer le paramètre NEIGHBOR PARTITION PROBES pour imposer un certain nombre maximal de partitions à tester par la recherche. Plus ce chiffre est élevé, plus la précision est élevée.
Remarque :
-
Si vous n'indiquez aucune précision de cible dans votre requête de recherche approximative, vous hériterez de celle définie lors de la création de l'index. Au moment de la création de l'index, vous pouvez spécifier une précision cible à l'aide d'une valeur de pourcentage ou de paramètres en fonction du type d'index que vous créez.
-
Il est possible de spécifier une précision cible différente lors de la recherche d'index, par rapport à celle définie lors de la création de l'index. Pour les index de FIV, vous pouvez tester plus de partitions centroïdes à l'aide du paramètre
NEIGHBOR PARTITION PROBESpour obtenir des résultats plus précis. La précision cible que vous fournissez lors de la création de l'index détermine les paramètres de création de l'index et sert également de valeur de précision par défaut pour les recherches d'index vectoriels.
Effectuer des recherches de similarité
Cette section décrit les méthodes permettant d'effectuer des recherches de similarité.
-
Effectuer une recherche de similarité exacte Une recherche de similarité recherche l'ordre relatif des vecteurs par rapport à un vecteur de requête. Naturellement, la comparaison est faite en utilisant une mesure de distance particulière, mais ce qui est important est l'ensemble de résultats de vos vecteurs les plus proches, pas la distance entre eux.
-
Comprendre la recherche de similarité approximative à l'aide d'index vectoriels Pour des vitesses de recherche plus rapides avec de grands espaces vectoriels, vous pouvez utiliser la recherche de similarité approximative à l'aide d'index vectoriels.
-
Effectuer une recherche de similarité multivectorielle Un autre cas d'utilisation majeur de la recherche vectorielle est la recherche multivectorielle. La recherche multi-vecteurs est généralement associée à une recherche multi-document, dans laquelle les documents sont divisés en blocs qui sont intégrés individuellement dans des vecteurs.
Effectuer une recherche de similarité exacte
Une recherche de similarité recherche l'ordre relatif des vecteurs par rapport à un vecteur de requête. Naturellement, la comparaison est faite en utilisant une mesure de distance particulière, mais ce qui est important est l'ensemble de résultats de vos vecteurs les plus proches, pas la distance entre eux.
Par exemple, avec un certain vecteur de requête, vous pouvez calculer sa distance par rapport à tous les autres vecteurs de votre ensemble de données. Ce type de recherche, également appelé recherche à plat, ou recherche exacte, produit les résultats les plus précis avec une qualité de recherche parfaite. Toutefois, cela se traduit par des temps de recherche importants. Cette opération est illustrée par les schémas suivants :
Figure 13 : Recherche exacte
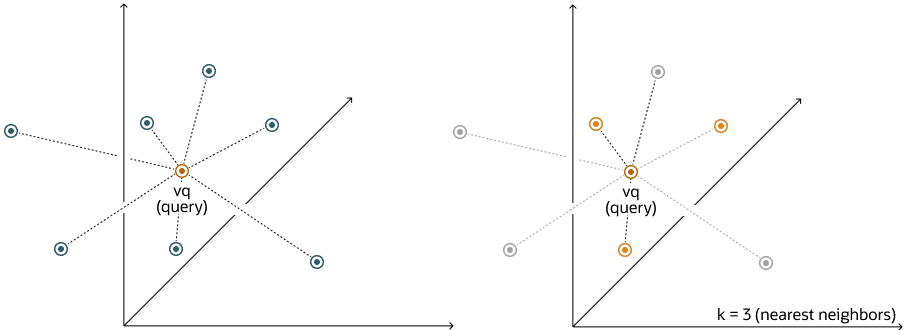
Description de l'illustration flat-index.png,
Avec une recherche exacte, vous comparez le vecteur de requête vq à tous les autres vecteurs de votre espace en calculant sa distance à chaque vecteur. Après avoir calculé toutes ces distances, la recherche renvoie la valeur k la plus proche de celles-ci en tant que correspondances les plus proches. C'est ce qu'on appelle une recherche des voisins les plus proches (kNN).
Par exemple, la recherche de similarité euclidienne consiste à extraire les k vecteurs les plus proches de votre espace par rapport à la mesure de distance euclidienne et à un vecteur de requête. Voici un exemple qui extrait les 10 principaux vecteurs de la table vector_tab qui sont les plus proches de query_vector à l'aide de la requête de recherche de similarité exacte suivante :
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;
Dans cet exemple, docID et embedding sont des colonnes définies dans la table vector_tab et embedding a le type de données VECTOR.
Dans le cas des distances euclidiennes, la comparaison des distances au carré équivaut à la comparaison des distances. Ainsi, lorsque l'ordre est plus important que les valeurs de distance elles-mêmes, la distance carrée euclidienne est très utile car il est plus rapide à calculer que la distance euclidienne (éviter le calcul de la racine carrée). Par conséquent, il est plus simple et plus rapide de réécrire l'interrogation comme suit :
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;
Remarque : le mot-clé EXACT est facultatif. S'il est omis alors qu'il est connecté à une instance ADB-S, une recherche approximative utilisant un index vectoriel est tentée s'il en existe un. Pour plus d'informations, voir Effectuer une recherche de similarité approximative à l'aide d'index vectoriels.
Remarque : veillez à utiliser la fonction distance qui a été utilisée pour entraîner votre modèle d'intégration.
Voir aussi : Référence de langage SQL Oracle AI Database pour obtenir la syntaxe complète de ROW_LIMITING_CLAUSE
Comprendre la recherche de similarité approximative à l'aide d'index vectoriels
Pour des vitesses de recherche plus rapides avec de grands espaces vectoriels, vous pouvez utiliser une recherche de similarité approximative à l'aide d'index vectoriels.
L'utilisation d'index vectoriels pour une recherche de similarité est appelée recherche approximative. Les recherches approximatives utilisent des index vectoriels, qui compensent la précision des performances.
Recherche approximative de grands espaces vectoriels
Lorsque la qualité de la recherche est votre priorité et que la vitesse de recherche est moins importante, la recherche de similarité exacte est une bonne option. La vitesse de recherche peut ne pas être pertinente pour les espaces vectoriels plus petits ou lorsque vous effectuez des recherches avec des serveurs hautes performances. Cependant, les algorithmes de ML effectuent souvent des recherches de similarité sur les espaces vectoriels avec des milliards d'intégrations. Par exemple, l'ensemble de données Deep1B contient des images 1B générées par un réseau neuronal convolutionnel (CNN). Calculer les distances vectorielles avec chaque vecteur du corpus pour trouver des correspondances Top-K avec une précision de 100% est très lent.
Heureusement, il existe de nombreux types de recherches approximatives que vous pouvez effectuer en utilisant des index vectoriels. Les index vectoriels peuvent être moins précis, mais ils peuvent consommer moins de ressources et être plus efficaces. Contrairement aux index de base de données traditionnels, les index vectoriels sont construits et effectuent des recherches à l'aide d'algorithmes basés sur l'heuristique.
Etant donné que la précision à 100 % ne peut pas être garantie par l'heuristique, les recherches d'index vectoriels utilisent la précision de cible. En interne, les algorithmes utilisés pour la création d'index et la recherche d'index font de leur mieux pour être aussi précis que possible. Cependant, vous avez la possibilité d'influencer ces algorithmes en spécifiant une précision cible. Lors de la création ou de la recherche de l'index, vous pouvez spécifier des valeurs de précision cible autres que celles par défaut en spécifiant une valeur de pourcentage ou en spécifiant des valeurs de paramètres internes, en fonction du type d'index que vous utilisez.
Exemple de précision de cible
Pour mieux comprendre ce que l'on entend par précision cible, consultez les diagrammes suivants. Le premier diagramme illustre un espace vectoriel où chaque vecteur est représenté par une petite croix. Celui en rouge représente votre vecteur de requête.
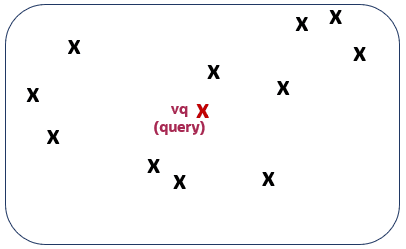
Description de l'image accuracy1.png
L'exécution d'une recherche de similarité exacte top-5 dans ce contexte renvoie les cinq vecteurs affichés sur le deuxième diagramme :
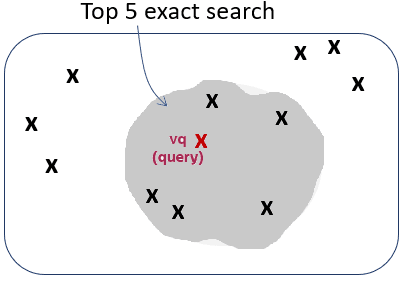
Description de l'image accuracy2.png
Selon la façon dont votre index vectoriel a été construit, l'exécution d'une recherche de similarité approximative top-5 dans ce contexte pourrait renvoyer les cinq vecteurs affichés sur le troisième diagramme. En effet, le processus de création d'index utilise l'heuristique. Ainsi, la recherche à travers l'index vectoriel peut conduire à des résultats différents par rapport à une recherche exacte :
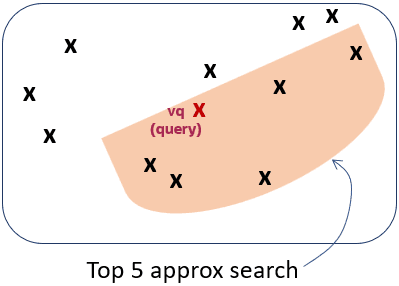
Description de l'image accuracy3.png
Comme vous pouvez le voir, les vecteurs récupérés sont différents et, dans ce cas, ils diffèrent par un vecteur. Cela signifie que, par rapport à la recherche exacte, la recherche de similarité a récupéré 4 vecteurs sur 5 correctement. La recherche de similarité a une précision de 80% par rapport à la recherche de similarité exacte. Cette opération est illustrée dans le quatrième diagramme :
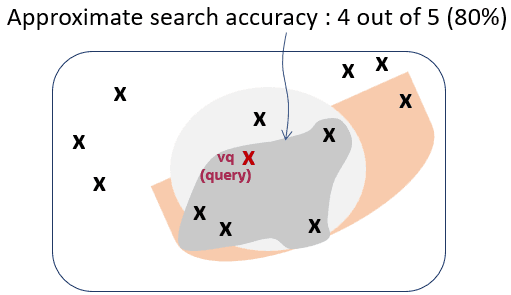
Description de l'image accuracy4.png
En raison de la nature des index vectoriels étant des structures de recherche approximatives, il est possible que moins de K lignes soient renvoyées dans une recherche de similarité top-K.
Pour plus d'informations sur la configuration des index vectoriels, reportez-vous à Création d'index vectoriels.
Effectuer une recherche de similarité multivectorielle
Un autre cas d'utilisation majeur de la recherche vectorielle est la recherche multi-vecteurs. La recherche multi-vecteurs est généralement associée à une recherche multi-document, où les documents sont divisés en morceaux qui sont individuellement intégrés dans des vecteurs.
Une recherche multi-vecteurs consiste à récupérer les correspondances vectorielles top-K à l'aide de critères de regroupement appelés partitions en fonction des caractéristiques des documents. Cette possibilité de noter des documents en fonction de la similitude de leurs blocs avec un vecteur de requête recherché est facilitée en SQL à l'aide de la clause de limitation de ligne partitionnée.
Avec la recherche multi-vecteurs, il est plus facile d'écrire des instructions SQL pour répondre au type de question suivant :
- S'ils existent, quelles sont les quatre meilleures phrases correspondantes trouvées dans les trois meilleurs paragraphes correspondants des deux meilleurs livres correspondants ?
Par exemple, si chaque livre de votre base de données est organisé en paragraphes contenant des phrases qui ont des représentations d'intégration vectorielle, vous pouvez répondre à la question précédente à l'aide d'une instruction SQL unique telle que :
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
Vous pouvez également utiliser une recherche de similarité approximative au lieu d'une recherche de similarité exacte, comme illustré dans l'exemple suivant :
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;
Remarque : toutes les lignes renvoyées sont triées par VECTOR_DISTANCE() et ne sont pas regroupées par clause de partition.
Sur le plan sémantique, l'instruction SQL précédente est interprétée comme suit :
-
Triez tous les enregistrements de la table des livres par ordre décroissant de la distance vectorielle entre les phrases et le vecteur de requête.
-
Pour chaque enregistrement de la présente commande, vérifiez ses
bookIdetparagraphId. Cet enregistrement est produit si les trois conditions suivantes sont remplies :-
Son
bookIdest l'un des deux premiersbookIddistincts dans l'ordre trié. -
Son élément
paragraphIdest l'un des trois premiers élémentsparagraphIddistincts dans l'ordre trié au sein du même élémentbookId. -
Son enregistrement est l'un des quatre premiers enregistrements de la même combinaison
bookIdetparagraphId.
-
-
Sinon, cet enregistrement est filtré.
La recherche de similarité multi-vecteurs ne concerne pas seulement les documents et peut également être utilisée pour répondre aux questions suivantes :
-
Retournez les K photos correspondantes les plus proches, mais assurez-vous qu'elles sont des photos de différentes personnes.
-
Trouvez les K meilleures chansons avec deux segments audio ou plus qui correspondent le mieux à ce fragment de son.
Remarque :
-
Cette extension de clause de limitation de ligne de partition est une extension générique du langage SQL. Il ne s'applique pas uniquement aux recherches vectorielles.
-
La recherche multi-vecteurs est actuellement prise en charge avec l'index de FIV.
Voir aussi : Référence de langage SQL Oracle AI Database pour obtenir la syntaxe complète de ROW_LIMITING_CLAUSE