Estrazione a valle per la distribuzione di Oracle GoldenGate
Una distribuzione Oracle GoldenGate a valle consente di scaricare l'elaborazione dei redo log in un database alternativo denominato database di mining. Il database di mining non deve contenere dati dal database di origine, ma deve essere la stessa versione del database o una versione successiva. Ciò significa che la versione 12c di Oracle come database di origine può utilizzare il database di mining versione 19c o successiva, consentendo a Oracle GoldenGate di acquisire le modifiche da un database Oracle 12c senza essere effettivamente in esecuzione nel database Oracle 12.
L'estrazione a valle può essere utilizzata anche in situazioni in cui GoldenGate non è in grado di stabilire una connessione al database di origine.
Nota: i database server di origine e quelli a valle devono avere gli stessi tipi di entità e di processore. Ad esempio, Extract a valle funzionerà con Linux di origine (x86) su un server Windows (x86) a valle, ma non funziona se il server di origine è HP-UX, ma il server a valle è AIX, o il server di origine è HP PA-RISC, ma il server a valle è HP-Itanium.
Un database di mining a valle accetta i log archiviati e i redo log in linea da un database di origine. Ciò implica che un Extract a valle può esistere in due modalità:
-
Modalità di mining in tempo reale: in modalità di mining in tempo reale, i redo record vengono elaborati immediatamente dai redo log in linea o in standby, quindi non vi è alcun ritardo nell'elaborazione delle modifiche al database.
-
Modalità di mining dell'archivio: in modalità di mining dell'archivio, i redo record non vengono elaborati finché non vengono archiviati in un redo log file.
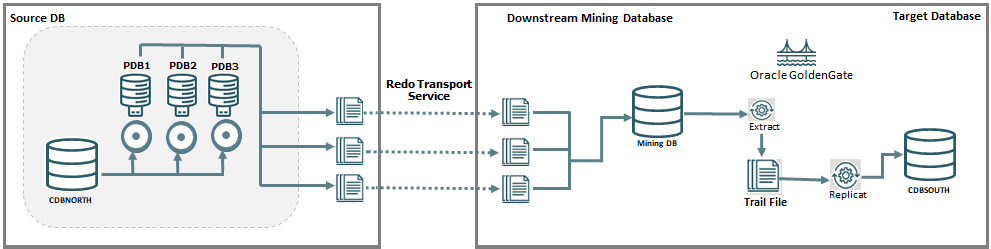
In una distribuzione a valle tipica, il database di origine, in cui vengono apportate modifiche ai dati, invierà i redo log o i log di archivio a un database di mining in cui il processo Extract estrarrà i redo log e scriverà i trail file. L'estrazione a valle può essere utilizzata anche in situazioni in cui Oracle GoldenGate non è in grado di stabilire una connessione con il database di origine. Nel diagramma seguente, CDBNORTH è il database di origine e CDBSOUTH è il database di destinazione. Esiste un database di estrazione tra l'origine e la destinazione con il logmining server del database che trasferisce i redo log dall'estrazione a valle alla destinazione.
Un'opzione alternativa è quella di utilizzare un approccio a cascata. In caso di standby Active Data Guard, puoi fare in modo che i redo log in standby vengano spediti al database di mining invece di spedire i log dal database primario. Questa opzione deve essere utilizzata se la larghezza di banda della rete è limitata e il database in standby si trova nella stessa area o nello stesso data center del database di mining.
Questo approccio utilizza un ADG configurato in modalità a cascata per trasportare i redo log in un database di mining a valle, a cui fa riferimento un Extract a valle, riducendo il carico di lavoro sul database di origine, come mostrato nel diagramma riportato di seguito.
Nota: il processo Extract per Oracle non può connettersi a uno standby Data Guard o a uno standby Active Data Guard per acquisire i dati.
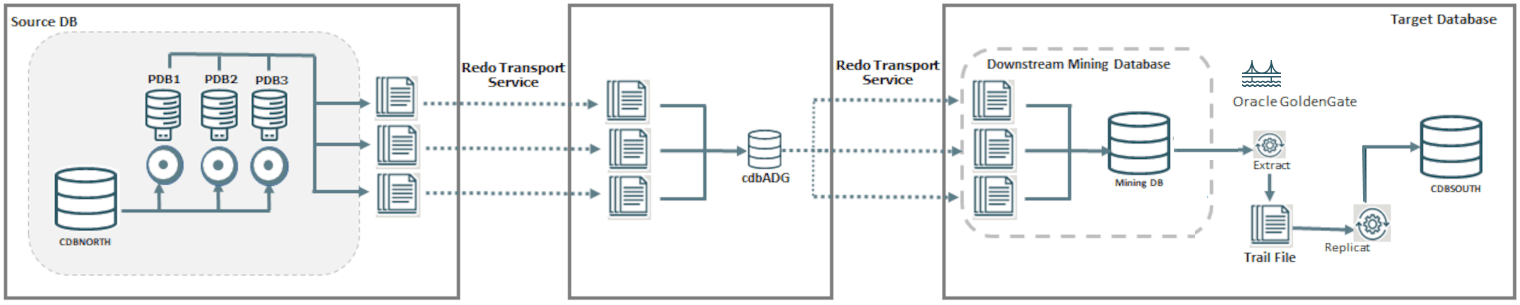
Per i dettagli di configurazione sull'impostazione di un ambiente a valle a catena, vedere Abilita estrazione a valle per utilizzare ADG.
Configurare i database di mining di origine e a valle
In questa sezione verranno fornite informazioni sui parametri e sulle configurazioni di gestione degli utenti richieste dal lato del database.
Utente Oracle GoldenGate nei database di origine e di mining a valle
L'utente amministratore di Oracle GoldenGate deve esistere in ogni database. Nei container database è necessario un utente comune poiché Extract verrà utilizzato all'interno del contenitore Root.
Per impostare gli utenti per Oracle AI Database 26ai e versioni successive, il ruolo utente OGG_CAPTURE e OGG_APPLY deve essere assegnato al nuovo utente. Per i dettagli, consulta la sezione Concedi privilegi utente per Oracle AI Database 26ai e versioni successive.
Per impostare gli utenti per Oracle Database 21c e versioni successive, vengono utilizzati i package PL/SQL. L'esempio riportato di seguito mostra la creazione di un utente e i privilegi associati concessi a questo utente quando si utilizza Oracle GoldenGate con Oracle Database 21c e versioni precedenti.
CREATE USER c##ggadmin IDENTIFIED BY *password* CONTAINER = all;
ALTER USER c##ggadmin SET CONTAINER_DATA = all CONTAINER = current;
GRANT ALTER SESSION TO c##ggadmin CONTAINER = all;
GRANT connect, resource TO c##ggadmin CONTAINER = all;

BEGIN
  DBMS_GOLDENGATE_AUTH.GRANT_ADMIN_PRIVILEGE
    ( grantee                 => 'C##GGADMIN'
    , privilege_type          => 'CAPTURE'
    , grant_select_privileges =>  TRUE
    , container               => 'ALL'
    );
END;
/
Nota: l'utente comune (c##ggadmin) è obbligatorio solo per il database a valle.
Configurare le connessioni al database
Requisiti del servizio Database Net
È possibile accedere ai database di origine e a valle utilizzando i Database Net Services in entrambe le direzioni.
In Oracle GoldenGate è possibile impostare le connessioni per il database di origine (CDBNORTH_root) e il database a valle (cdbDSC_root). La connessione al database di origine è necessaria solo per memorizzare i dati del dizionario durante la registrazione Extract. È possibile utilizzare il parametro FETCHUSERIDALIAS per connettersi al database di mining a valle (cdbDSC_root) per i recuperi in runtime. Con il reindirizzamento ADG, la registrazione di Extract può essere reindirizzata all'origine da un ADG. Per impostare le connessioni, assicurarsi di disporre delle credenziali di database per questi utenti per creare le credenziali dalla distribuzione di Oracle GoldenGate.
È possibile eseguire il test di Net Service con SQL*Plus, che fa parte della shiphome di Oracle GoldenGate.
Prerequisiti del database di origine
Per configurare le connessioni al database, assicurarsi che nelle istanze del database di origine vengano eseguite le impostazioni riportate di seguito.
-
(Source e Downstream Mining Database) Tutti i database devono includere:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
I database di origine devono essere in modalità log di archivio. Per abilitare l'archiviazione nel database, eseguire il comando seguente che indica al database di creare un log di archivio durante il passaggio dei redo log.
ALTER DATABASE ARCHIVE LOG; -
(Consigliato) (Solo origine) Tutti i database devono essere in modalità Forza registrazione.
ALTER DATABASE FORCE LOGGING; -
Per il database di origine deve essere abilitato un log supplementare minimo che includa
TRANDATA/SCHEMATRANDATAdurante l'offload del processo Extract nel database Mining perché è qui che si verificano le transazioni. -
(Solo database di mining a valle) I file delle password (
orapwSID) del database di origine e a valle sono identici. Pertanto,remote_login_passwordfiledeve essere impostato suSHAREDoEXCLUSIVEin Oracle Database 21c e versioni successive.
Prerequisiti del database di mining a valle
Per configurare le connessioni al database, assicurarsi che nelle istanze del database di origine e a valle vengano eseguite le impostazioni riportate di seguito.
-
Tutti i database devono includere:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
STREAMS_POOL_SIZEdeve essere impostato in Oracle 21c e versioni precedenti. Ad esempio:ALTER SYSTEM SET STREAMS_POOL_SIZE = 1G; -
Il database di mining e il database di origine devono essere in modalità log di archivio. Per abilitare l'archiviazione nel database, eseguire il comando seguente che indica al database di creare un log di archivio durante il passaggio dei redo log.
ALTER DATABASE ARCHIVE LOG; -
(Solo estrazione a valle) Il database a valle deve avere impostazioni diverse per quanto segue:
-
DBID -
DBNAME -
DB_UNIQUE_NAME -
GLOBAL_NAME
(Database di mining a valle e database di origine) In un ambiente a valle, il nome univoco del database corrisponde al nome del database.
-
-
I file delle password (
orapwSID) del database di origine e a valle sono identici. Pertanto,remote_login_passwordfiledeve essere impostato suSHAREDoEXCLUSIVE.
Configura parametri per database a valle
Utilizzare questa sezione per configurare i parametri per la modalità di mining in tempo reale e la modalità di mining di archivio, se necessario.
Impostazioni dei parametri per l'estrazione a valle in modalità di estrazione in tempo reale
Per Extract a valle in modalità di mining in tempo reale, il prerequisito principale è che il database a valle deve disporre di redo log file in standby configurati correttamente.
Il mining in tempo reale a valle è abilitato con un'impostazione esplicita all'interno del file dei parametri di estrazione. La configurazione del LAD è indipendente da questa modalità. Se il parametro TRANLOGOPTIONS INTEGRATEDPARAMS (REAL_TIME_MINE Y) non è già stato impostato, è necessario impostarlo per abilitare Extract a valle per la modalità di mining in tempo reale:
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)Nota: nel database a valle per un determinato database di origine può essere presente una sola estrazione in tempo reale. Altre estrazioni devono essere non in tempo reale. Questa è una restrizione dal trasporto di redo.
Il comando seguente eseguito sul database Downstream Mining mostra il backup locale in fase di impostazione utilizzando FRA:
ALTER SYSTEM
    SET log_archive_config='DG_CONFIG=(CDBNORTH, cdbDSC)';
ALTER SYSTEM set FAL_SERVER = 'CDBNORTH_root';
I file di redo log in standby devono esistere nel database a valle. Se nell'origine sono presenti n redo log file in linea, i redo log file in standby n+1 devono essere nella destinazione della stessa dimensione.
Creare i file di redo log in standby nel database di mining a valle
I passi riportati di seguito descrivono la procedura per l'aggiunta dei redo log file in standby al database di mining a valle. Di seguito sono riportate le regole per la creazione dei redo log in standby.
-
Ogni redo log file in standby deve avere dimensioni almeno pari al redo log file più grande del redo log database di origine. Per semplificare l'amministrazione, Oracle consiglia che tutti i redo log file nel database di origine e i redo log file in standby nel database di mining a valle siano della stessa dimensione.
-
Il redo log in standby deve avere almeno un gruppo di redo log in più rispetto al redo log nel database di origine, per ogni redo thread nel database di origine.
I passi specifici e le istruzioni SQL necessari per aggiungere i redo log file in standby dipendono dall'ambiente in uso. Vedere Creazione di un database di standby fisico per istruzioni dettagliate sull'aggiunta di redo log file in standby a un database.
Nota: se ci saranno più database di origine che invieranno redo a un singolo database di mining a valle, solo una di queste origini può inviare redo ai redo log in standby del database di mining. Un processo Extract che estrae il redo da questo database di origine può essere eseguito in modalità in tempo reale. Tutti gli altri database di origine devono inviare solo i log archiviati al database di mining a valle e le estrazioni che leggono questi dati devono essere configurate per essere eseguite in modalità di solo log archiviato.
Per creare i file di redo log in standby
-
In SQL*Plus, connettersi al database di origine come utente amministrativo.
-
Determinare le dimensioni del file di log di origine. Prendi nota dei risultati.
SELECT BYTES FROM V$LOG; -
Determinare il numero di gruppi di file di log in linea configurati nel database di origine. Prendi nota dei risultati.
SELECT COUNT(GROUP#) FROM V$LOG; -
Connettersi al database di mining a valle come utente amministrativo.
-
Aggiungere i gruppi di file di log in standby al database di mining. La dimensione del file di log in standby deve essere almeno la dimensione del file di log di origine. Il numero di gruppi di file di log in standby deve essere almeno uno in più del numero di gruppi di file di log in linea di origine. Ciò si applica a ciascuna istanza (thread) in un'installazione RAC. Pertanto, se si dispone di n thread nel database di origine, ciascuno con m gruppi di redo log, è necessario configurare i gruppi di redo log n*(m+1) nel database di mining a valle.
L'esempio seguente mostra tre gruppi di log in standby.
ALTER DATABASE ADD STANDBY LOGFILE GROUP 3 ('/oracle/dbs/slog3a.rdo', '/oracle/dbs/slog3b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 4 ('/oracle/dbs/slog4.rdo', '/oracle/dbs/slog4b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 5 ('/oracle/dbs/slog5.rdo', '/oracle/dbs/slog5b.rdo') SIZE 500M; -
Confermare che i gruppi di file di log in standby sono stati aggiunti correttamente.
SELECT GROUP#, THREAD#, SEQUENCE#, ARCHIVED, STATUS
FROM V$STANDBY_LOG;
L'output dovrebbe essere simile al seguente:
GROUP# THREAD# SEQUENCE# ARC STATUS ---------- ---------- ---------- --- ---------- 3 0 0 YES UNASSIGNED 4 0 0 YES UNASSIGNED 5 0 0 YES UNASSIGNED -
Assicurarsi che i file di log del database di origine vengano visualizzati nella posizione specificata nell'attributo
LOCATIONdel fileLOG_ARCHIVE_DEST_nlocale impostato. Potrebbe essere necessario cambiare il file di log nel database di origine per visualizzare i file nella directory.
Configurare il database di mining a valle per archiviare localmente i file di redo log in standby
Questa procedura configura il database di mining a valle per archiviare i redo log in standby che ricevono i dati di redo dai redo log in linea del database di origine. Tenere presente che i log archiviati esterni non devono essere archiviati nell'area di recupero del database di mining a valle.
Per archiviare i redo log in standby in locale:
-
Nel database di mining a valle, impostare la seconda destinazione del log di archivio nel parametro di inizializzazione
LOG_ARCHIVE_DEST_ncome mostrato nell'esempio seguente.ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='LOCATION=/home/arc_dest/srl_dbms1 VALID_FOR=(STANDBY_LOGFILE,PRIMARY_ROLE)'Oracle consiglia di mantenere i log archiviati esterni (log provenienti da database di origine remoti) separati dai file di log del database di mining locale e l'uno dall'altro. Non utilizzare l'area di recupero del database di mining a valle per posizionare nell'area intermedia i log archiviati esterni.
-
Abilitare il parametro
LOG_ARCHIVE_DEST_2impostato nel passo precedente come mostrato nell'esempio seguente.ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE
Impostazioni dei parametri per l'estrazione a valle in modalità di mining dell'archivio
Per impostare un Extract a valle in modalità Archiviazione mining o Estrazione in tempo reale, è necessario impostare il trasporto di redo. Includere i seguenti parametri durante l'impostazione dell'estrazione a valle in modalità solo log di archivio:
-
LOG_ARCHIVE_CONFIG -
LOG ARCHIVE DESTINATION (LAD)-
LOG_ARCHIVE_DEST_1per il backup locale di tutti i database -
Servizio
LOG_ARCHIVE_DEST_2per il trasporto di redo nel database di origine
-
Nota: LOG_ARCHIVE_DEST_2 è indipendente dall'uso del data mining in tempo reale.
-
La destinazione di backup del database locale viene impostata utilizzando l'area di recupero flash
-
FAL_SERVER -
Tutti i parametri di sistema richiesti possono essere impostati dinamicamente con
scope=both
Le impostazioni dei parametri LAD (Archive Log Destination) sono necessarie per la destinazione del backup locale e i servizi di trasporto di redo nei database di origine.
Impostare i parametri LAD per la destinazione del backup locale utilizzando i comandi seguenti:
ALTER SYSTEM SET db_recovery_file_dest = '/u01/app/oracle/fast_recovery_area';
ALTER SYSTEM SET db_recovery_file_dest_size = 100G;
ALTER SYSTEM SET log_archive_dest_1 = 'LOCATION=USE_DB_RECOVERY_FILE_DEST';
Impostare le opzioni dei parametri LAD per i servizi di trasporto di redo nel database di origine utilizzando i comandi riportati di seguito.
ALTER SYSTEM SET log_archive_config = 'DG_CONFIG = (CDBNORTH, cdbDSC)';
ALTER SYSTEM
      SET log_archive_dest_2='SERVICE=cdbDSC_root
                              ASYNC
                              NOREGISTER
                              VALID_FOR=(ONLINE_LOGFILES, PRIMARY_ROLE)
                              DB_UNIQUE_NAME=cdbDSC';
Per ulteriori informazioni sul parametro LOG_ARCHIVE_DEST e sui relativi attributi, vedere LOG_ARCHIVE_DEST_n nella guida Riferimento al database.
Configurare Oracle GoldenGate Extract per la distribuzione a valle
In questa sezione verranno fornite informazioni sui parametri richiesti da Oracle GoldenGate per impostare le connessioni con i database di origine e a valle e configurare Extract per il database a valle.
Configurare Oracle GoldenGate per il database a valle
Il file dei parametri Extract a valle deve includere i seguenti parametri per l'impostazione di una distribuzione a valle:
-
TRANLOGOPTIONS MININGUSERALIAS: imposta la connessione al database di mining a valle per le query di metadati interne. -
FETCHUSERIDALIAS: si connette al database di origine per il recupero dei dati che non possono essere estratti in modo nativo dal log delle transazioni. -
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y): se impostato su Y, Extract acquisisce le modifiche dai redo log file in standby nel database a valle. Se non è impostato, Extract acquisisce i dati dai file di log dell'archivio.
Di seguito è riportato un esempio di file dei parametri Extract che include i seguenti parametri:
EXTRACT EXTDSC
USERIDALIAS cgg_CDBNORTH
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)
FETCHUSERIDALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate

EXTTRAIL Downstream/ea
SOURCECATALOG CDBNORTH_PDB1
DDL INCLUDE MAPPED
TABLE HR.*;
Seguire i passi indicati per impostare la distribuzione di Oracle GoldenGate per Extract a valle:
-
Aggiungere le credenziali per il database d'origine:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@CDBNORTH_root ALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate PASSWORD password -
Aggiungere le credenziali per il database a valle:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@cdbDSC_root ALIAS cgg_cdbDSC DOMAIN OracleGoldenGate PASSWORD *password* -
Utilizzare
DBLOGINper connettersi al database di origine e al database a valle da Oracle GoldenGate:DBLOGIN USERIDALIAS cgg_CDBNORTHMININGDBLOGIN USERIDALIAS cgg_cdbDSCIn questo esempio,
cgg_CDBNORTHè l'alias delle credenziali per il database di origine CDBNORTH ecgg_cdbDSCè l'alias delle credenziali per il database di mining. -
Aggiungere e registrare un Extract, modificare il file dei parametri per includere i parametri di Extract forniti in precedenza, aggiungere il nome e la posizione del trail Extract e avviare Extract:
ADD EXTRACT extdsc, INTEGRATED TRANLOG, BEGIN NOW
REGISTER EXTRACT extdsc, DATABASE CONTAINER (CDBNORTH_PDB01)

ADD EXTTRAIL Downstream/ea, EXTRACT extdsc
START extdsc
Configura estrazione a catena a valle mediante Active Data Guard
Se una connessione al database di origine non è possibile, è possibile configurare GoldenGate in modo che utilizzi un database di standby ADG (Active Data Guard). Il database di standby è disponibile per le connessioni di sola lettura per eseguire query sui metadati e recuperare. In questa sezione verrà descritto come configurare un'estrazione a valle mediante ADG e senza stabilire una connessione con il database di origine.
Abilita estrazione a valle per utilizzare ADG
In un ambiente di acquisizione a valle, il database a valle non si connette direttamente al database di origine. Utilizza Active Data Guard (ADG) per il recupero e le query sui metadati.
Extract deve essere avviato utilizzando l'opzione Sourceless in modo che non si connetta al database di origine e si connetta invece ad ADG utilizzando FETCHUSERID o FETCHUSERIDALIAS quando è necessario recuperare qualsiasi tipo di dati non nativo. Ad esempio, le operazioni FETCH vengono elaborate nel database ADG poiché questa istanza è aperta in modalità di sola lettura. Altre operazioni che non possono essere elaborate nell'istanza ADG, ad esempio la creazione della build del dizionario, vengono reindirizzate dall'ADG al database di origine.
Quando si registra un Extract a valle, Oracle GoldenGate si connette ad ADG come database di origine anziché al database di origine del redo. Il reindirizzamento ADG è supportato per i seguenti comandi e parametri:
-
SCHEMATRANDATA -
TRANDATA -
FLUSH SEQUENCE -
TRACETABLE -
HEARTBEATTABLE -
REGISTER EXTRACTNota:SCHEMATRANDATAeTRANDATA, anche se il comando viene eseguito sul redo log in standby, i gruppi di log effettivi vengono creati e gestiti nel database primario in cui vengono eseguite le operazioni DML effettive.
ADG Redirection è disponibile con Oracle Database 21c e versioni successive. Supporta anche la registrazione con caratteri jolly. L'esempio riportato di seguito mostra il file dei parametri Extract per Extract a valle quando si utilizza ADG.
EXTRACT EXTDSC
NOUSERID
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC_src DOMAIN OracleGoldenGate
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y) FETCHUSERIDALIAS cgg_cdbADG_src DOMAIN OracleGoldenGate

EXTTRAIL cascade/ea
SOURCECATALOG CDBNORTH_PDB01
DDL INCLUDE MAPPED
TABLE HR.*;
Di seguito sono riportati i passi per consentire a Extract a valle di utilizzare ADG Standby.
-
Aggiungere un valore
LOG_ARCHIVE_DESTINATION_N (LAD)aggiuntivo nello standby ADG, come mostrato nell'esempio riportato di seguito.ALTER SYSTEM SET LOG_ARCHIVE_DEST_3='service=mining_db_service_name ASYNC NOREGISTER VALID_FOR(STANDBY_LOGFILES,STANDBY_ROLES) DB_UNIQUE_NAME=3rd_db_unique_name' scope=bothQuesto passo trasporta e genera il valore
standby_logfilesper uno standby ADG. -
Impostare
LOG_ARCHIVE_CONFIGnel database di standby ADG per spedire i log al database di mining, come mostrato nell'esempio riportato di seguito.ALTER SYSTEM SET LOG_ARCHIVE_CONFIG = 'DG_CONFIG' = (CDBNORTH, cdbADG_src, cdbDSC)';DB_CONFIGè il nome univoco del database del primo, secondo e terzo database. -
Nel database di mining, impostare la posizione in cui memorizzare il file standby_logfiles in entrata nel database di mining come mostrato nell'esempio seguente:
ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='location= /home/arc_dest/dstrm VALID_FOR=(STANDBY_LOGFILE,ALL_ROLES)' scope=bothdove
/home/arc_dest/dstrmè la posizione dei log di archivio esterni. Non utilizzare FRA per memorizzare i log di archivio esterni. -
Eseguire
LOG_ARCHIVE_CONFIGnel database di mining, in modo che il processo Extract sia in grado di leggerli nel database di mining, come mostrato nell'esempio seguente:ALTER SYSTEM SET LOG_ARCHIVE_CONFIG ='DG_CONFIG' scope=bothDB_CONFIGè il nome univoco del database del primo, del secondo e del terzo database. -
Per un Extract a valle, è necessario assicurarsi che le connessioni al database siano configurate in modo appropriato. Quando si registra Extract, assicurarsi che la connessione
DBLOGINvenga effettuata in standby ADG, aperto per l'attività di sola lettura. -
Per aggiungere l'estrazione e registrarla, utilizzare il comando seguente:
DBLOGIN USERID ggadmin@cdbADG_src, PASSWORD ggadmin
MININGDBLOGIN USERID ggadmin@cgg_cdbDSC, password ggadmin
cdbADG_src è l'ADG non principale.
cgg_cdbDSC è il database di mining.
-
Registrare ora un Extract che utilizza il parametro
NOUSERID:ADD EXTRACT exte, INTEGRATED TRANLOG, BEGIN NOW REGISTER EXTRACT exte DATABASE -
Dopo la registrazione dell'Estratto, è possibile utilizzare questo Estratto per estrarre i dati e avviare l'Estratto normalmente.