Intelligenza artificiale in Oracle AI Database
In questo capitolo vengono descritte le funzioni di intelligenza artificiale fornite in Oracle AI Database.
-
Panoramica di Oracle AI Vector Search Oracle AI Vector Search è progettato per carichi di lavoro di intelligenza artificiale (AI) e ti consente di eseguire query sui dati in base alla semantica, piuttosto che alle parole chiave.
-
Metriche distanza vettoriale La misurazione delle distanze in uno spazio vettoriale è al centro dell'identificazione dei risultati più rilevanti per un determinato vettore di query. Questo processo è molto diverso dal noto filtraggio delle parole chiave nel mondo dei database relazionali.
-
Panoramica sugli indici di Small World navigabili gerarchici Utilizzare questi esempi per capire come creare indici HNSW per ricerche di somiglianza approssimative vettoriali.
-
Comprendere gli indici vettoriali piatti dei file invertiti L'indice vettoriale flat dei file invertiti è una tecnica progettata per migliorare l'efficienza della ricerca restringendo l'area di ricerca mediante l'uso di partizioni o cluster vicini.
-
Esecuzione di ricerche di somiglianza Questa sezione descrive i metodi per eseguire ricerche di somiglianza.
Panoramica di Oracle AI Vector Search
Oracle AI Vector Search è progettato per carichi di lavoro di intelligenza artificiale (AI) e consente di eseguire query sui dati in base alla semantica, piuttosto che alle parole chiave.
Tipo di dati VECTOR
Il tipo di dati VECTOR viene introdotto con la release di Oracle AI Database 26ai, fornendo le basi per memorizzare integrazioni vettoriali insieme ai dati aziendali nel database. Utilizzando i modelli di incorporamento, puoi trasformare i dati non strutturati in integrazioni vettoriali che possono quindi essere utilizzate per query semantiche sui dati aziendali. Per utilizzare il tipo di dati VECTOR e le relative funzioni, il parametro di inizializzazione COMPATIBLE deve essere impostato su 23.4.0 o versione successiva. Per ulteriori informazioni sul parametro e su come modificarlo, vedere Oracle AI Database Upgrade Guide.
Vedere l'esempio di base riportato di seguito per l'utilizzo del tipo di dati VECTOR in una definizione di tabella.
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);Per ulteriori informazioni sul tipo di dati VECTOR e su come utilizzare i vettori nelle tabelle, vedere Creazione di tabelle mediante il tipo di dati VECTOR.
A causa della natura numerica del tipo di dati VECTOR, è possibile utilizzarlo come input per gli algoritmi di apprendimento automatico come classificazione, anomalia, regressione, clustering ed estrazione di funzioni. Ulteriori dettagli sull'uso del tipo di dati VECTOR nell'apprendimento automatico sono disponibili in Supporto del tipo di dati vettoriali. Nota: il supporto per l'apprendimento automatico dei tipi di dati VECTOR è disponibile in tutte le versioni a partire dalla versione 23.7.
Incorporamenti vettoriali
Se hai mai utilizzato applicazioni come assistenti vocali, chatbot, traduttori di lingua, sistemi di raccomandazione, rilevamento delle anomalie o ricerca e riconoscimento video, hai utilizzato implicitamente le funzionalità di incorporamento vettoriale.
Oracle AI Vector Search memorizza le integrazioni vettoriali, che sono rappresentazioni vettoriali matematiche dei datapoint. Queste integrazioni vettoriali descrivono il significato semantico dietro contenuti come parole, documenti, tracce audio o immagini. Ad esempio, durante le ricerche basate sul testo, la ricerca vettoriale è spesso considerata migliore della ricerca per parola chiave poiché la ricerca vettoriale si basa sul significato e sul contesto dietro le parole e non sulle parole effettive stesse. Questa rappresentazione vettoriale traduce la somiglianza semantica degli oggetti, come percepito dagli esseri umani, in prossimità in uno spazio vettoriale matematico. Questo spazio vettoriale di solito ha molte centinaia, se non migliaia, di dimensioni. In altre parole, gli incorporamenti vettoriali sono un modo per rappresentare quasi tutti i tipi di dati, come testo, immagini, video, utenti o musica come punti in uno spazio multidimensionale in cui le posizioni di quei punti nello spazio e la vicinanza ad altri sono semanticamente significative.
Questo diagramma semplificato illustra uno spazio vettoriale in cui le parole sono codificate come vettori a 2 dimensioni.
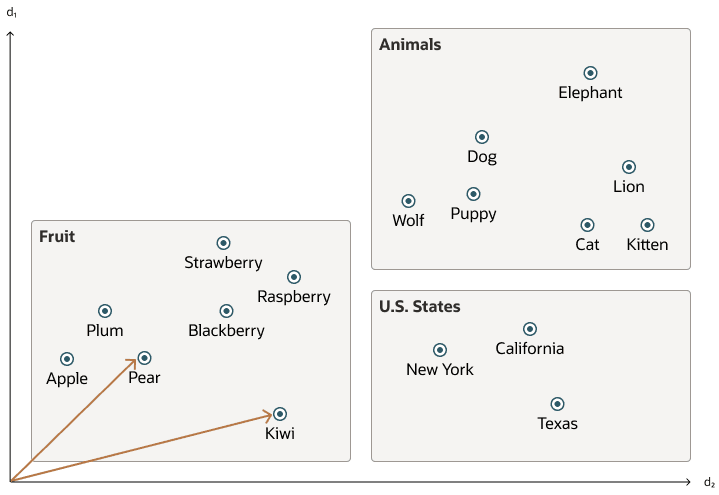
Descrizione dell'immagine vector_embeddings.png
Ricerca somiglianza
La ricerca della somiglianza semantica in un set di dati ora equivale alla ricerca dei vicini più vicini in uno spazio vettoriale invece di utilizzare le ricerche di parole chiave tradizionali utilizzando i predicati di query. Come illustrato nel diagramma seguente, la distanza tra cane e lupo in questo spazio vettoriale è inferiore alla distanza tra cane e kitten. In questo spazio, un cane è più simile a un lupo che a un gattino. Per ulteriori informazioni, vedere Esegui ricerca somiglianza esatta.
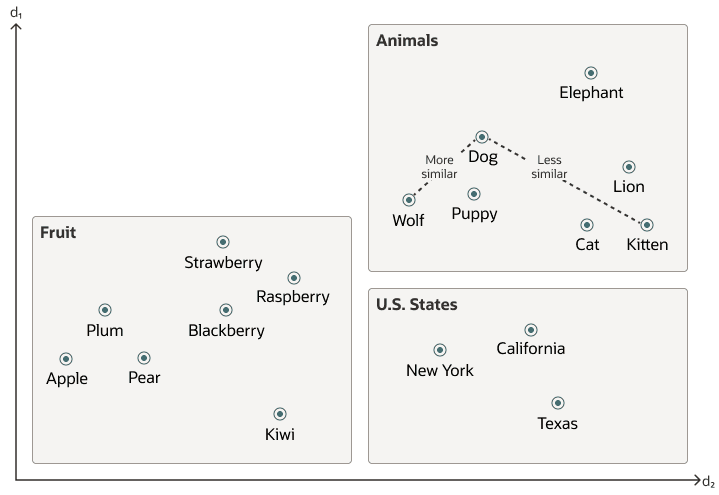
Descrizione dell'immagine vector_embeddings_similarity.png
I dati vettoriali tendono ad essere distribuiti in modo non uniforme e raggruppati in gruppi che sono semanticamente correlati. Eseguire una ricerca di somiglianza basata su un determinato vettore di query equivale a recuperare i vettori K più vicini al vettore di query nello spazio vettoriale. Fondamentalmente, è necessario trovare un elenco ordinato di vettori classificandoli, dove la prima riga dell'elenco è il vettore più vicino o più simile al vettore di query, la seconda riga dell'elenco è il secondo vettore più vicino al vettore di query e così via. Quando si fa una ricerca di somiglianza, l'ordine relativo delle distanze è ciò che conta davvero piuttosto che la distanza reale.
Utilizzando lo spazio vettoriale precedente, qui è illustrata una ricerca semantica in cui il vettore di query è quello corrispondente alla parola Puppy e si desidera identificare le quattro parole più vicine:
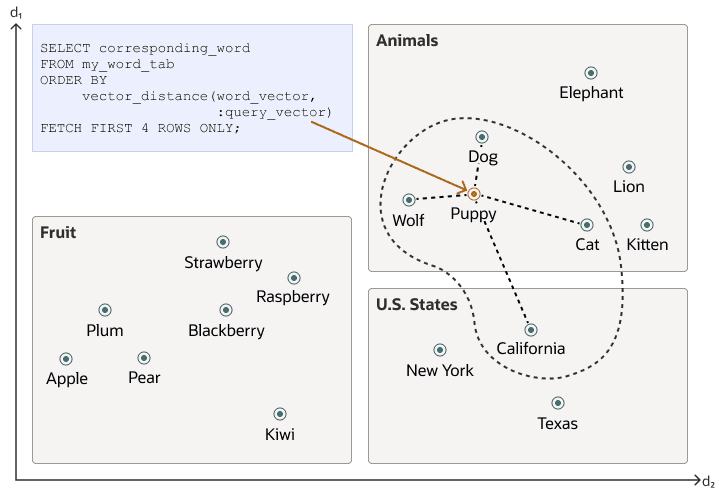
Descrizione dell'immagine vector_embeddings_similarity_search.png
Le ricerche di somiglianza tendono a ottenere dati da uno o più cluster a seconda del valore del vettore di query e della dimensione di recupero.
Le ricerche approssimative che utilizzano indici vettori possono limitare le ricerche a cluster specifici, mentre le ricerche esatte visitano vettori in tutti i cluster. Per ulteriori informazioni, vedere Usa indici vettoriali.
Modelli di incorporamento vettore
Un modo per creare tali incorporamenti vettoriali potrebbe essere quello di utilizzare l'esperienza del dominio di qualcuno per quantificare un set predefinito di caratteristiche o dimensioni come forma, struttura, colore, sentimento e molti altri, a seconda del tipo di oggetto con cui si sta trattando. Tuttavia, l'efficienza di questo metodo dipende dal caso d'uso e non è sempre conveniente.
Invece, gli incorporamenti vettoriali vengono creati tramite reti neurali. La maggior parte dei moderni incorporamenti vettoriali utilizzano un modello di trasformatore, come illustrato dal seguente diagramma, ma possono essere utilizzate anche reti neurali convoluzionali.
Figura 1: Modello di incorporamento vettoriale
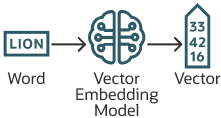
Descrizione dell'immagine basic_transform.png
A seconda del tipo di dati, è possibile utilizzare diversi modelli pre-addestrati e open source per creare integrazioni vettoriali. Ad esempio:
-
Per i dati testuali, i trasformatori di frasi trasformano parole, frasi o paragrafi in incorporamenti vettoriali.
-
Per i dati visivi, è possibile utilizzare la rete residua (ResNet) per generare integrazioni vettoriali.
-
Per i dati audio, è possibile utilizzare la rappresentazione dello spettrogramma visivo dei dati audio per rientrare nel caso di dati visivi.
Ogni modello determina anche il numero di dimensioni per i vettori. Ad esempio:
-
Il modello di incorporamento Cohere embed-english-v3.0 ha dimensioni 1024.
-
Il modello di incorporamento di OpenAI text-embedding-3-large ha 3072 dimensioni.
-
Il modello di incorporamento di Hugging Face all-MiniLM-L6-v2 ha 384 dimensioni
Naturalmente, puoi sempre creare il tuo modello addestrato con il tuo data set.
Importa modelli di incorporamento in Oracle AI Database
Sebbene sia possibile generare integrazioni vettoriali al di fuori di Oracle AI Database utilizzando modelli di incorporamento open source pre-addestrati o modelli di incorporamento personalizzati, hai anche la possibilità di importare tali modelli direttamente in Oracle AI Database se sono compatibili con lo standard Open Neural Network Exchange (ONNX). Oracle AI Database implementa un runtime ONNX direttamente all'interno del database. Ciò consente di generare integrazioni vettoriali direttamente all'interno di Oracle AI Database utilizzando SQL. Per ulteriori informazioni, vedere Genera integrazioni vettoriali.
Metriche distanza vettore
Misurare le distanze in uno spazio vettoriale è al centro dell'identificazione dei risultati più rilevanti per un dato vettore di query. Questo processo è molto diverso dal noto filtraggio delle parole chiave nel mondo dei database relazionali.
Quando si lavora con i vettori, ci sono diversi modi in cui è possibile calcolare le distanze per determinare quanto siano simili, o dissimili, due vettori. Ogni metrica di distanza viene calcolata utilizzando formule matematiche diverse. Il tempo necessario per calcolare la distanza tra due vettori dipende da molti fattori, tra cui la metrica della distanza utilizzata e il formato dei vettori stessi, come il numero di dimensioni vettoriali e i formati delle dimensioni vettoriali. In genere è meglio abbinare la metrica di distanza utilizzata a quella utilizzata per addestrare il modello di incorporamento vettoriale che ha generato i vettori.
Panoramica degli indici Small World navigabili gerarchici
Utilizzare questi esempi per capire come creare indici HNSW per ricerche di somiglianza approssimative vettoriali.
Con Navigable Small World (NSW), l'idea è quella di costruire un grafico di prossimità in cui ogni vettore del grafico si connette a diversi altri in base a tre caratteristiche:
-
La distanza tra i vettori
-
Numero massimo di vettori candidati più vicini considerati in ogni fase della ricerca durante l'inserimento
(EFCONSTRUCTION) -
Numero massimo di connessioni (
NEIGHBORS) consentite per vettore
Se la combinazione delle soglie di cui sopra è troppo alta, allora si può finire con un grafico densamente connesso, che può rallentare il processo di ricerca. D'altra parte, se la combinazione di tali soglie è troppo bassa, allora il grafico potrebbe diventare troppo sparso e/o scollegato, il che rende difficile trovare un percorso tra determinati vettori durante la ricerca.
La traversata del grafico Navigable Small World (NSW) per la ricerca vettoriale inizia con un punto di ingresso predefinito nel grafico, accedendo a un cluster di vettori strettamente correlati. L'algoritmo di ricerca utilizza due elenchi di chiavi: Candidati, un elenco aggiornato dinamicamente di vettori che incontriamo durante l'attraversamento del grafico, e Risultati, che contiene i vettori più vicini al vettore di query trovato finora. Man mano che la ricerca procede, l'algoritmo naviga attraverso il grafico, perfezionando continuamente i candidati esplorando e valutando vettori che potrebbero essere più vicini di quelli nei risultati. Il processo si conclude una volta che non ci sono vettori nei candidati più vicini del più lontano nei risultati, indicando un minimo locale è stato raggiunto e i vettori più vicini al vettore di query sono stati identificati.
Questa situazione è illustrata nell'immagine seguente:
Figura 2: Grafico navigabile del piccolo mondo
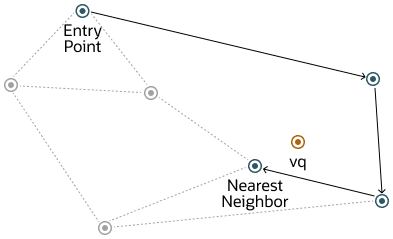
Descrizione dell'illustrazione navigable-small-world-graph.png
Il metodo descritto dimostra prestazioni robuste fino a una certa scala di inserimento vettoriale nel grafico. Oltre questa soglia, l'approccio gerarchico Navigable Small World (HNSW) migliora il modello NSW introducendo una gerarchia multilivello, simile alla struttura osservata negli elenchi di skip probabilistici. Questa architettura gerarchica viene implementata distribuendo le connessioni del grafico su più livelli, organizzandoli in un modo in cui ogni livello successivo contiene un sottoinsieme dei vettori dal livello sottostante. Questa stratificazione garantisce che i livelli superiori acquisiscano collegamenti a lunga distanza, fungendo efficacemente da percorsi espressi attraverso il grafico, mentre i livelli inferiori si concentrano su collegamenti più brevi, facilitando la navigazione locale a grana fine. Di conseguenza, le ricerche iniziano dai livelli più alti per approssimare rapidamente la regione del vettore di destinazione, spostandosi progressivamente ai livelli più bassi per una ricerca più precisa, migliorando significativamente l'efficienza e l'accuratezza della ricerca sfruttando collegamenti più brevi (distanze più piccole) tra i vettori mentre ci si sposta dal livello superiore al basso.
Per capire meglio come funziona per HNSW, esaminiamo come viene utilizzata questa gerarchia per la struttura Probability Skip List:
Figura 3: Probabilità di saltare la struttura della lista
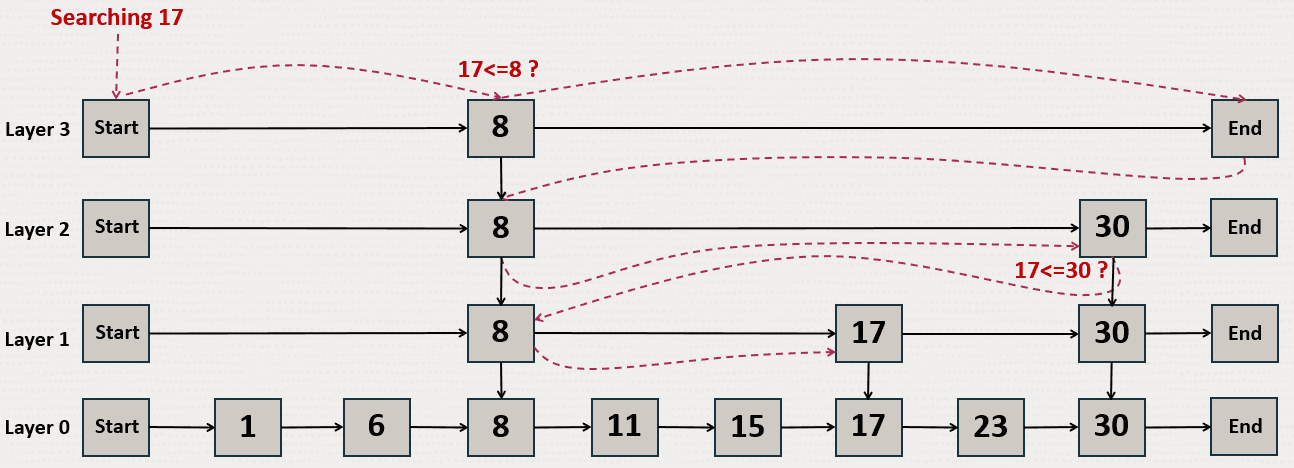
Descrizione dell'illustrazione proba-skip-list_01.png
La struttura Ignora lista di probabilità utilizza più livelli di elenchi collegati in cui i livelli sopra riportati saltano più numeri di quelli inferiori. In questo esempio si sta cercando il numero 17. Si inizia con il livello superiore e si passa all'elemento successivo finché non si trova 17, si raggiunge la fine dell'elenco o si trova un numero maggiore di 17. Quando si raggiunge la fine di un elenco o si trova un numero maggiore di 17, si inizia nel livello precedente dall'ultimo numero minore di 17.
HNSW utilizza lo stesso principio con i livelli NSW in cui si trovano distanze maggiori tra i vettori negli strati più alti. Questa è illustrata dai seguenti diagrammi in uno spazio 2D:
Al livello superiore sono i bordi più lunghi e al livello inferiore sono quelli più corti.
Figura 4: Grafici gerarchici per piccoli mondi navigabili
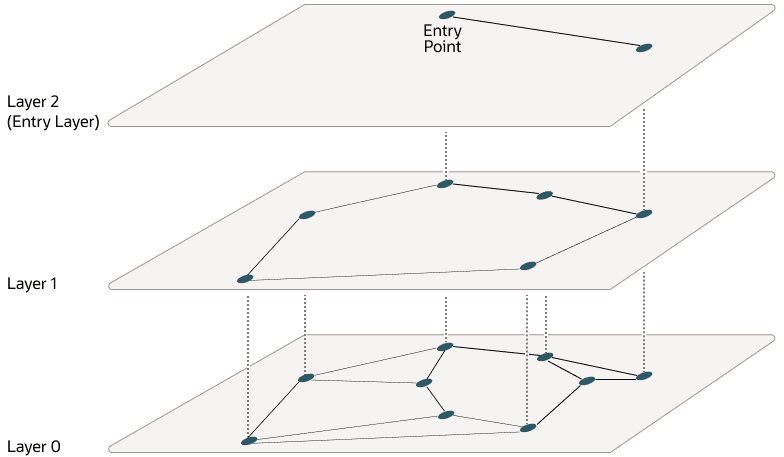
Descrizione dell'illustrazione hierarchical-navigable-small-world-graph_02.png
A partire dal livello superiore, la ricerca in un livello inizia dal vettore di ingresso. Quindi per ogni nodo, se c'è un vicino che è più vicino al vettore di query rispetto al nodo corrente, salta a quel vicino. L'algoritmo continua a eseguire questa operazione finché non trova un minimo locale per il vettore di query. Quando un minimo locale viene trovato in un livello, la ricerca passa al livello successivo utilizzando lo stesso vettore in quel nuovo livello e la ricerca continua in quel livello. Questo processo si ripete fino a quando non viene trovato il minimo locale del livello inferiore, che contiene tutti i vettori. A questo punto, la ricerca viene trasformata in una ricerca di somiglianza approssimativa utilizzando l'algoritmo NSW attorno all'ultimo minimo locale trovato per estrarre i primi k vettori più simili al vettore di query. Mentre i livelli superiori possono avere un massimo di connessioni per ogni vettore impostato dal parametro NEIGHBORS, il livello 0 può avere il doppio. Questo processo è illustrato nel grafico seguente:
Figura 5: Ricerca gerarchica di grafici di Small World navigabili
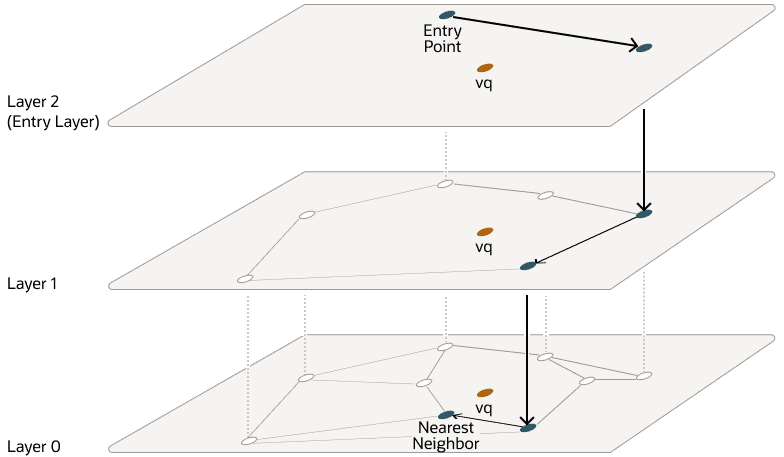
Descrizione dell'immagine hnsw-search-graph_02-png.png
I livelli vengono implementati utilizzando grafici in memoria (non Oracle Inmemory graph). Ogni livello utilizza un grafico in memoria separato. Come già visto, quando si crea un indice HNSW, è possibile regolare il numero massimo di connessioni per vettore nei livelli superiori utilizzando il parametro NEIGHBORS e il numero massimo di vettori candidati più vicini considerati in ogni fase della ricerca durante l'inserimento utilizzando il parametro EFCONSTRUCTION, dove EF sta per Enter Factor.
Come spiegato in precedenza, quando si utilizza Oracle AI Vector Search per eseguire una query di ricerca approssimativa utilizzando gli indici HNSW, è possibile specificare una precisione di destinazione in base alla quale eseguire la ricerca approssimativa.
Nel caso di una ricerca approssimativa HNSW, è possibile specificare un valore percentuale di accuratezza della destinazione per influenzare il numero di candidati presi in considerazione per esaminare la ricerca. Questo viene calcolato automaticamente dall'algoritmo. Un valore di 100 tenderà a imporre un risultato simile come una ricerca esatta, anche se il sistema potrebbe ancora utilizzare l'indice e non eseguirà una ricerca esatta. L'ottimizzatore può scegliere di utilizzare ancora un indice in quanto potrebbe essere più veloce a farlo, dati i predicati nella query. Anziché specificare un valore percentuale di precisione target, è possibile specificare il parametro EFSEARCH per imporre un determinato numero massimo di candidati da considerare durante l'analisi dell'indice. Più alto è quel numero, maggiore è l'accuratezza.
Nota:
-
Se non si specifica alcuna precisione di destinazione nella query di ricerca approssimativa, verrà ereditato il set al momento della creazione dell'indice. Vedrai che alla creazione dell'indice, è possibile specificare una precisione di destinazione utilizzando un valore percentuale o i valori dei parametri a seconda del tipo di indice che si sta creando.
-
È possibile specificare una precisione di destinazione diversa alla ricerca dell'indice rispetto a quella impostata alla creazione dell'indice. Per gli indici HNSW, è possibile esaminare più vicini utilizzando il parametro
EFSEARCH(più alto del valoreEFCONSTRUCTIONspecificato alla creazione dell'indice) per ottenere risultati più accurati. La precisione di destinazione fornita durante la creazione dell'indice determina i parametri di creazione dell'indice e funge anche da valori di precisione predefiniti per le ricerche dell'indice vettoriale.
Comprendere gli indici vettoriali flat file invertiti
L'indice vettoriale Inverted File Flat è una tecnica progettata per migliorare l'efficienza della ricerca restringendo l'area di ricerca attraverso l'uso di partizioni o cluster vicini.
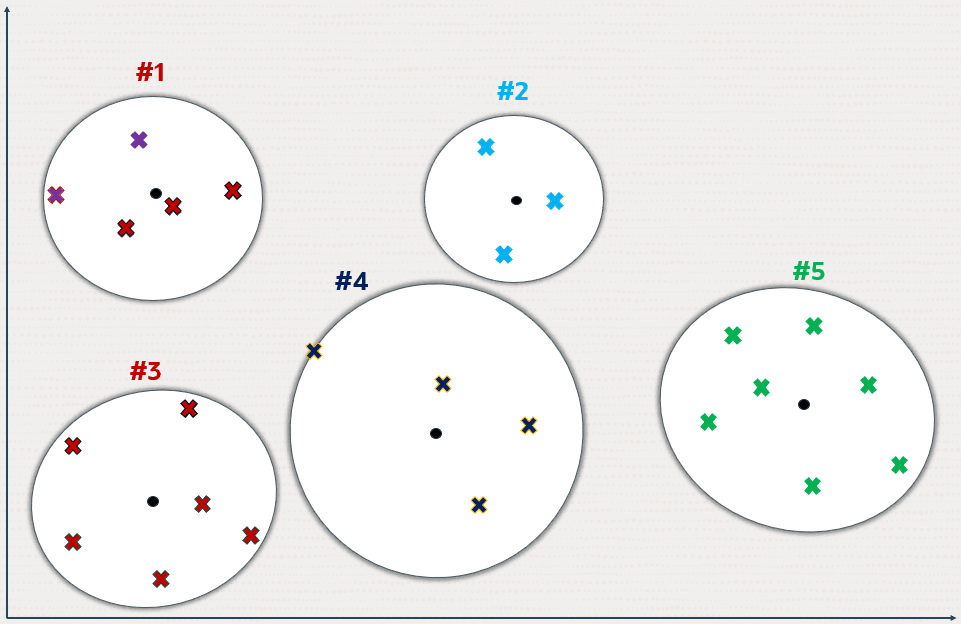
I diagrammi riportati di seguito descrivono il modo in cui le partizioni o i cluster vengono creati in una ricerca approssimativa eseguita utilizzando una rappresentazione di spazio 2D. Ma questo può essere generalizzato a spazi dimensionali molto più alti.
Figura 6: Indice di file flat invertito utilizzando 2D
Descrizione dell'immagine inverted-file-index_1.png
Le croci rappresentano i datapoint vettoriali in questo spazio.
I nuovi datapoint, mostrati come piccoli cerchi semplici, vengono aggiunti per identificare i centroidi di partizione k, dove il numero di centroidi (k) è determinato dalla dimensione del data set (n). In genere k è impostato sulla radice quadrata di n, anche se può essere modificato specificando il parametro NEIGHBOR PARTITIONS durante la creazione dell'indice.
Ogni centroide rappresenta il vettore medio (centro di gravità) della partizione corrispondente.
I centroidi sono calcolati da un passaggio di addestramento sopra i vettori il cui obiettivo è quello di ridurre al minimo la distanza totale di ogni vettore dal centroide più vicino.
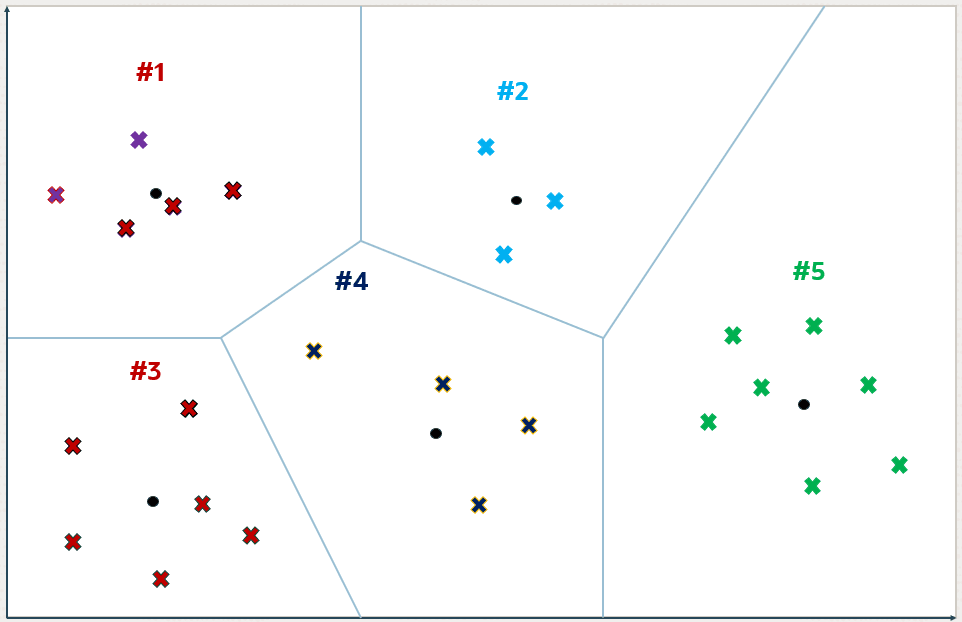
I centroidi finiscono per partizionare lo spazio vettoriale in partizioni k. Questa divisione è concettualmente illustrata come cerchi in espansione dai centroidi che smettono di crescere mentre si incontrano, formando partizioni distinte.
Figura 7: Indice flat file invertito
Descrizione dell'immagine inverted-file-index_5.png
Ad eccezione di quelli sulla periferia, ogni vettore rientra in una partizione specifica associata a un centroide.
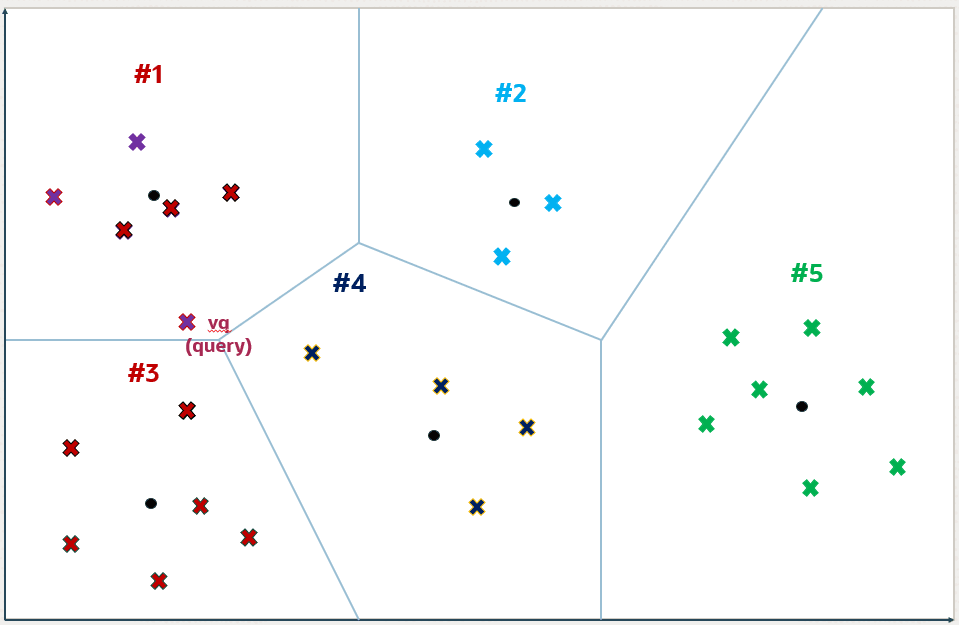
Figura 8: Indice flat file invertito
Descrizione dell'immagine inverted-file-index_6.png
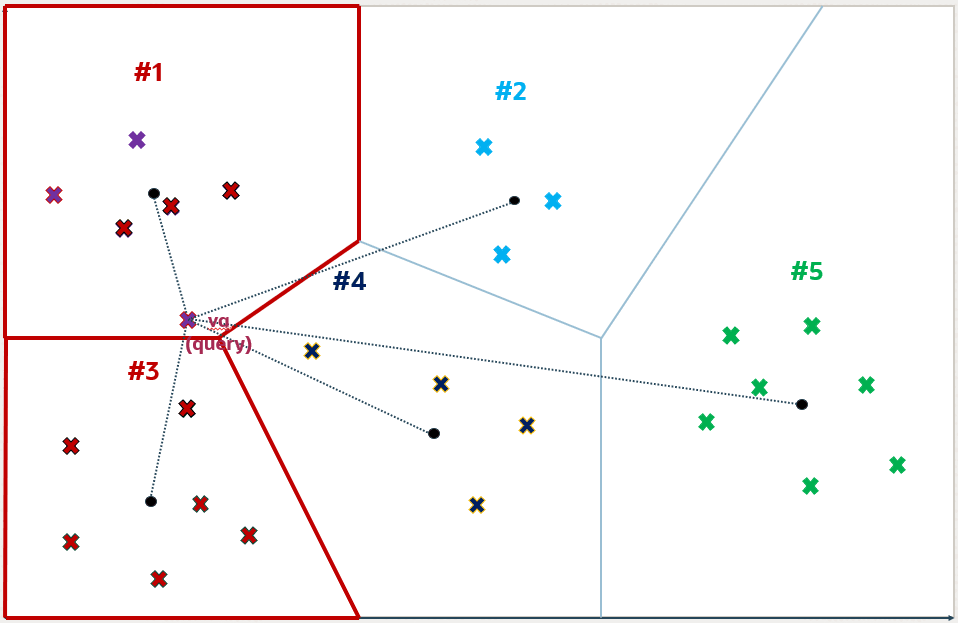
Per un vettore di query vq , l'algoritmo di ricerca identifica i centroidi i più vicini, dove i utilizza per impostazione predefinita la radice quadrata di k, ma può essere regolato per una query specifica impostando il parametro NEIGHBOR PARTITION PROBES. Questa regolazione consente un compromesso tra velocità di ricerca e precisione.
Numeri più elevati per questo parametro determineranno una maggiore precisione. In questo esempio, i è impostato su 2 e le due partizioni identificate sono le partizioni numero 1 e 3.
Figura 9: Indice flat file invertito
Descrizione dell'immagine inverted-file-index_7.png
Una volta determinate, le partizioni i vengono sottoposte a scansione completa per identificare, in questo esempio, i primi 5 vettori più vicini. Questo numero 5 può essere diverso da k e si specifica questo numero nella query. I cinque vettori più vicini a vq trovati nelle partizioni numero 1 e 3 sono evidenziati nel diagramma seguente.
Questo metodo costituisce una ricerca approssimativa in quanto limita la ricerca a un sottoinsieme di partizioni, accelerando così il processo ma potenzialmente perdendo vettori più vicini in partizioni non esaminate. In questo esempio viene illustrato che una ricerca approssimativa potrebbe non produrre i vettori più vicini a vq, dimostrando il compromesso intrinseco tra efficienza e precisione della ricerca.
Figura 10: Indice flat file invertito
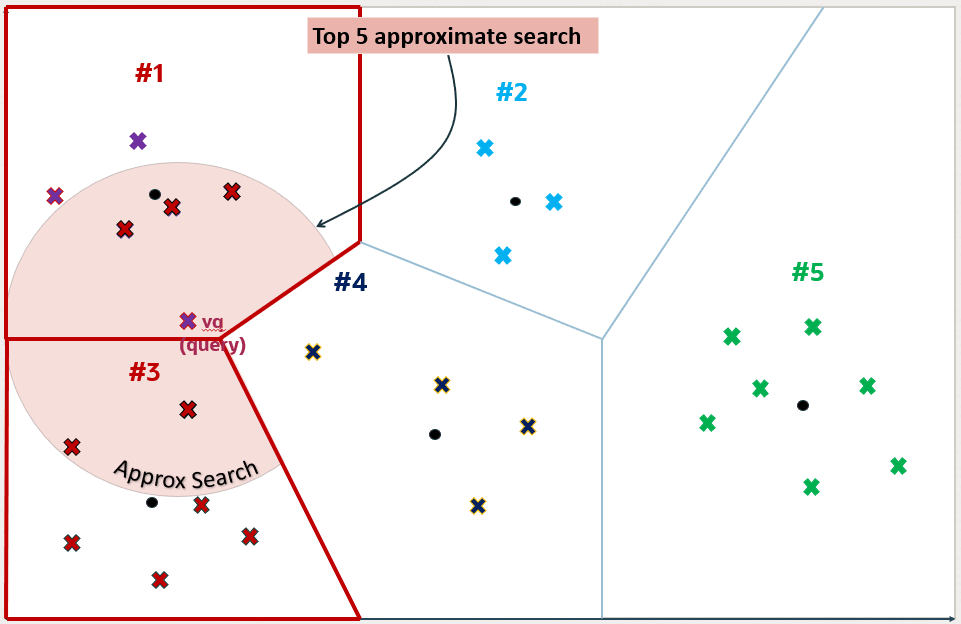
Descrizione dell'immagine inverted-file-index_10.png
Tuttavia, i cinque vettori più vicini esatti di vq non sono quelli trovati dalla ricerca approssimativa. Si può vedere che uno dei vettori nella partizione numero 4 è più vicino a vq di uno dei vettori recuperati nella partizione numero 3.
Figura 11: Indice flat file invertito
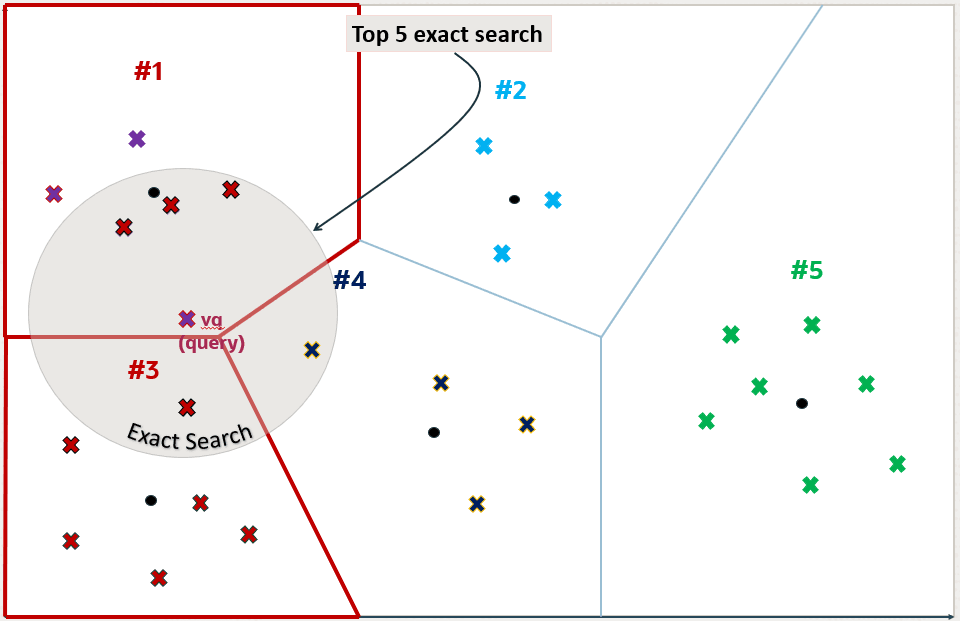
Descrizione dell'immagine inverted-file-index_11.png
Ora puoi vedere perché utilizzare le ricerche di indici vettoriali non è sempre una ricerca esatta ed è invece chiamata ricerca approssimativa. In questo esempio, la precisione approssimativa della ricerca è solo dell'80% in quanto ha recuperato solo 4 su 5 dei risultati esatti dei vettori di ricerca.
Figura 12: Indice flat file invertito
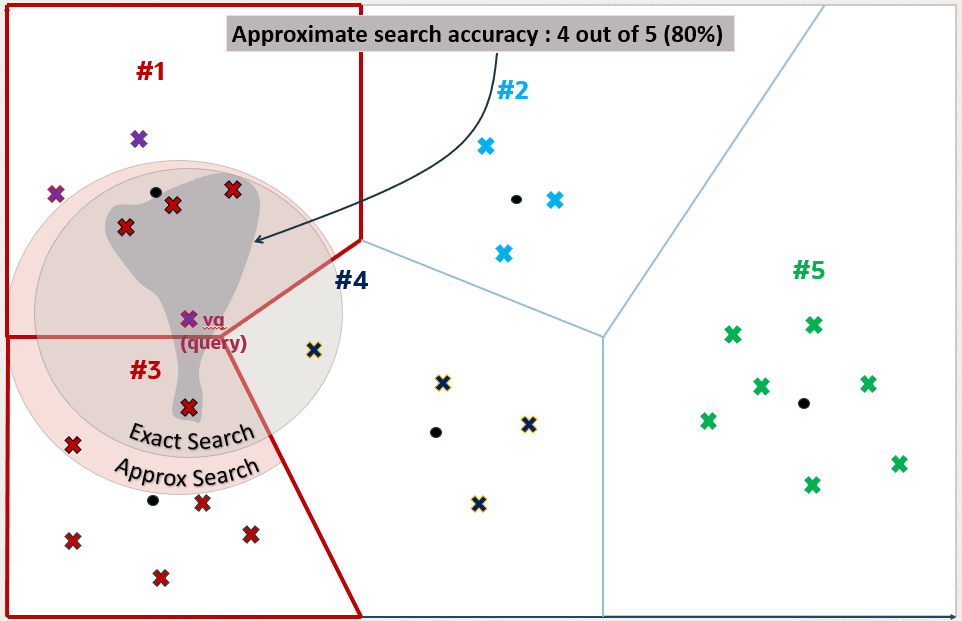
Descrizione dell'immagine inverted-file-index_12.png
Quando si utilizza Oracle AI Vector Search per eseguire una query di ricerca approssimativa utilizzando indici vettoriali, è possibile specificare una precisione di destinazione in base alla quale eseguire la ricerca approssimativa.
Nel caso di una ricerca approssimativa IVF, è possibile specificare un valore percentuale di accuratezza target per influenzare il numero di partizioni utilizzate per sondare la ricerca. Questo viene calcolato automaticamente dall'algoritmo. Un valore di 100 tenderà a imporre una ricerca esatta, anche se il sistema potrebbe ancora utilizzare l'indice e non eseguirà una ricerca esatta. L'ottimizzatore può scegliere di utilizzare ancora un indice in quanto potrebbe essere più veloce a farlo, dati i predicati nella query. Anziché specificare un valore percentuale di accuratezza della destinazione, è possibile specificare il parametro NEIGHBOR PARTITION PROBES per imporre un determinato numero massimo di partizioni di cui eseguire il test dalla ricerca. Più alto è quel numero, maggiore è l'accuratezza.
Nota:
-
Se non si specifica alcuna precisione di destinazione nella query di ricerca approssimativa, verrà ereditato il set al momento della creazione dell'indice. Vedrete che al momento della creazione dell'indice, è possibile specificare una precisione di destinazione utilizzando un valore percentuale o i valori dei parametri a seconda del tipo di indice che si sta creando.
-
È possibile specificare una precisione di destinazione diversa alla ricerca dell'indice, rispetto a quella impostata alla creazione dell'indice. Per gli indici IVF, è possibile sondare più partizioni centroide utilizzando il parametro
NEIGHBOR PARTITION PROBESper ottenere risultati più accurati. La precisione di destinazione fornita durante la creazione dell'indice determina i parametri di creazione dell'indice e funge anche da valore di precisione predefinito per le ricerche dell'indice vettoriale.
Esecuzione di ricerche di somiglianza
Questa sezione descrive i metodi per eseguire ricerche di somiglianza.
-
Esegui ricerca somiglianza esatta Una ricerca di somiglianza cerca l'ordine relativo dei vettori rispetto a un vettore di query. Naturalmente, il confronto viene fatto utilizzando una metrica di distanza particolare, ma ciò che è importante è l'insieme di risultati dei vettori più vicini, non la distanza tra loro.
-
Comprendere la ricerca approssimativa della somiglianza utilizzando gli indici vettoriali Per velocizzare la ricerca con spazi vettoriali di grandi dimensioni, è possibile utilizzare la ricerca approssimativa della somiglianza utilizzando indici vettoriali.
-
Esegui ricerca somiglianza multi-vettore Un altro caso d'uso importante della ricerca vettoriale è la ricerca multi-vettore. La ricerca multi-vettore è in genere associata a una ricerca multi-documento, in cui i documenti vengono suddivisi in blocchi incorporati singolarmente nei vettori.
Esegui ricerca somiglianza esatta
Una ricerca di somiglianza cerca l'ordine relativo dei vettori rispetto a un vettore di query. Naturalmente, il confronto viene fatto utilizzando una metrica di distanza particolare, ma ciò che è importante è l'insieme di risultati dei vettori più vicini, non la distanza tra loro.
Ad esempio, e dato un certo vettore di query, è possibile calcolare la distanza da tutti gli altri vettori nel data set. Questo tipo di ricerca, chiamata anche ricerca piatta, o ricerca esatta, produce i risultati più accurati con una qualità di ricerca perfetta. Tuttavia, ciò comporterà una riduzione dei tempi di ricerca significativi. Questa situazione è illustrata dai diagrammi riportati di seguito.
Figura 13: Ricerca esatta
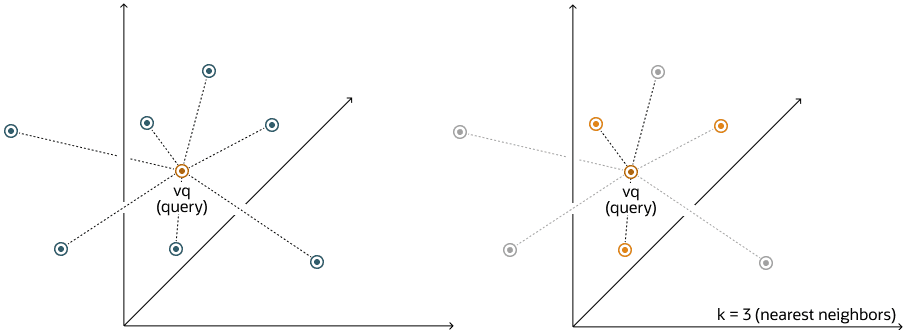
Descrizione dell'illustrazione flat-index.png
Con una ricerca esatta, si confronta il vettore di query vq con ogni altro vettore nel vostro spazio calcolando la sua distanza da ogni vettore. Dopo aver calcolato tutte queste distanze, la ricerca restituisce il k più vicino di quelli come corrispondenze più vicine. Questa è chiamata una ricerca k-nearest neighbor (kNN).
Ad esempio, la ricerca di somiglianza euclidea prevede il recupero dei vettori superiori più vicini nello spazio rispetto alla metrica della distanza euclidea e a un vettore di query. Di seguito è riportato un esempio che recupera i primi 10 vettori dalla tabella vector_tab più vicini a query_vector utilizzando la seguente query di ricerca di somiglianza esatta:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;
In questo esempio, docID e embedding sono colonne definite nella tabella vector_tab e embedding ha il tipo di dati VECTOR.
Nel caso delle distanze euclidee, il confronto delle distanze quadrate equivale al confronto delle distanze. Quindi, quando l'ordine è più importante dei valori di distanza stessi, la distanza quadrata euclidea è molto utile in quanto è più veloce da calcolare rispetto alla distanza euclidea (evitando il calcolo della radice quadrata). Di conseguenza, è più semplice e veloce riscrivere la query in questo modo:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;
Nota: la parola chiave EXACT è opzionale. Se omesso durante la connessione a un'istanza ADB-S, viene tentata una ricerca approssimativa utilizzando un indice vettoriale, se esistente. Per ulteriori informazioni, vedere Esecuzione di una ricerca approssimativa della somiglianza mediante indici vettoriali.
Nota: assicurarsi di utilizzare la funzione di distanza utilizzata per addestrare il modello di incorporamento.
Vedi anche: Oracle AI Database SQL Language Reference per la sintassi completa di ROW_LIMITING_CLAUSE
Comprendere la ricerca approssimativa della somiglianza utilizzando indici vettoriali
Per velocità di ricerca più elevate con grandi spazi vettoriali, è possibile utilizzare la ricerca approssimativa di somiglianza utilizzando indici vettoriali.
L'utilizzo di indici vettoriali per una ricerca di somiglianza è denominata ricerca approssimativa. Le ricerche approssimative utilizzano gli indici vettori, che garantiscono la precisione delle prestazioni.
Ricerca approssimativa di grandi spazi vettoriali
Quando la qualità della ricerca è la tua priorità alta e la velocità di ricerca è meno importante, la ricerca Exact Similarity è una buona opzione. La velocità di ricerca può essere irrilevante per spazi vettoriali più piccoli o quando si eseguono ricerche con server ad alte prestazioni. Tuttavia, gli algoritmi ML spesso eseguono ricerche di somiglianza su spazi vettoriali con miliardi di incorporamenti. Ad esempio, il set di dati Deep1B contiene immagini 1B generate da una rete neurale convoluzionale (CNN). Computare le distanze vettoriali con ogni vettore nel corpus per trovare corrispondenze Top-K con una precisione del 100% è molto lento.
Fortunatamente, ci sono molti tipi di ricerche approssimative che è possibile eseguire utilizzando indici vettoriali. Gli indici vettoriali possono essere meno accurati, ma possono consumare meno risorse e possono essere più efficienti. A differenza degli indici di database tradizionali, gli indici vettoriali vengono costruiti ed eseguono ricerche utilizzando algoritmi basati su euristica.
Poiché l'euristica non garantisce l'accuratezza del 100%, le ricerche degli indici vettoriali utilizzano l'accuratezza degli obiettivi. Internamente, gli algoritmi utilizzati per la creazione di indici e la ricerca di indici stanno facendo del loro meglio per essere il più accurati possibile. Tuttavia, hai la possibilità di influenzare tali algoritmi specificando una precisione di destinazione. Quando si crea l'indice o si esegue una ricerca, è possibile specificare valori di precisione di destinazione non predefiniti specificando un valore percentuale o specificando valori di parametri interni, a seconda del tipo di indice in uso.
Esempio di accuratezza della destinazione
Per capire meglio cosa si intende per accuratezza del target, guarda i seguenti diagrammi. Il primo diagramma illustra uno spazio vettoriale in cui ogni vettore è rappresentato da una piccola croce. Quello in rosso rappresenta il vettore di query.
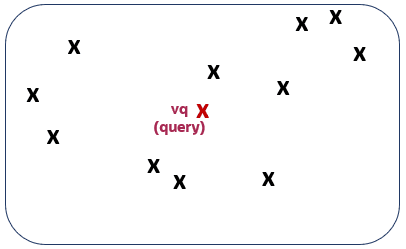
Descrizione dell'illustrazione accuracy1.png
L'esecuzione di una ricerca di somiglianza tra le prime 5 esatte in tale contesto restituirà i cinque vettori mostrati nel secondo diagramma:
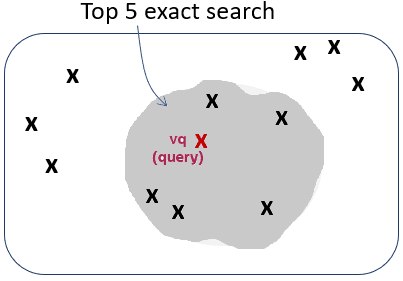
Descrizione dell'illustrazione accuracy2.png
A seconda di come è stato costruito l'indice vettoriale, l'esecuzione di una ricerca approssimativa di somiglianza tra i primi 5 in quel contesto potrebbe restituire i cinque vettori mostrati nel terzo diagramma. Questo perché il processo di creazione dell'indice utilizza l'euristica. Quindi la ricerca attraverso l'indice vettoriale può portare a risultati diversi rispetto a una ricerca esatta:
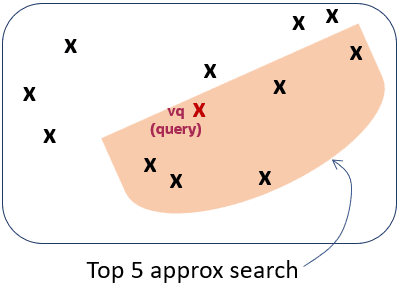
Descrizione dell'illustrazione accuracy3.png
Come potete vedere, i vettori recuperati sono diversi e, in questo caso, differiscono per un vettore. Ciò significa che, rispetto alla ricerca esatta, la ricerca di somiglianza ha recuperato correttamente 4 vettori su 5. La ricerca di somiglianza ha una precisione dell'80% rispetto alla ricerca di somiglianza esatta. Questa situazione è illustrata nel quarto diagramma:
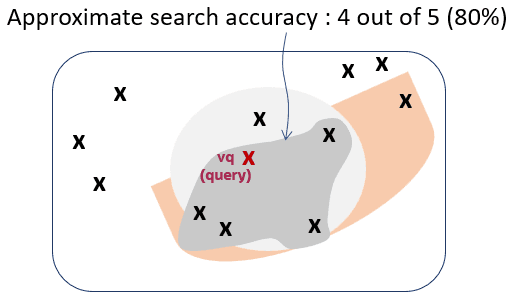
Descrizione dell'illustrazione accuracy4.png
A causa della natura degli indici vettoriali come strutture di ricerca approssimative, è possibile che vengano restituite meno righe K in una ricerca di somiglianza top-K.
Per informazioni su come impostare gli indici vettoriali, vedere Crea indici vettoriali.
Esegui ricerca somiglianza multi vettore
Un altro importante caso d'uso della ricerca vettoriale è la ricerca multi-vettore. La ricerca multi-vettore è in genere associata a una ricerca multi-documento, in cui i documenti vengono suddivisi in blocchi incorporati singolarmente nei vettori.
Una ricerca multi-vettoriale consiste nel recuperare le corrispondenze vettoriali top-K utilizzando criteri di raggruppamento noti come partizioni in base alle caratteristiche dei documenti. Questa capacità di assegnare un punteggio ai documenti in base alla somiglianza dei loro chunk con un vettore di query in fase di ricerca è facilitata in SQL utilizzando la clausola di limitazione delle righe partizionate.
Con la ricerca multi-vettore, è più facile scrivere istruzioni SQL per rispondere al seguente tipo di domanda:
- Se esistono, quali sono le quattro frasi più corrispondenti trovate nei tre paragrafi più corrispondenti dei due migliori libri corrispondenti?
Ad esempio, immagina se ogni libro del tuo database è organizzato in paragrafi contenenti frasi che hanno rappresentazioni di incorporamento vettoriale, puoi rispondere alla domanda precedente utilizzando una singola istruzione SQL come:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
È inoltre possibile utilizzare una ricerca di somiglianza approssimativa anziché una ricerca di somiglianza esatta come mostrato nell'esempio riportato di seguito.
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;
Nota: tutte le righe restituite vengono ordinate in base a VECTOR_DISTANCE() e non raggruppate in base alla clausola di partizione.
Semanticamente, l'istruzione SQL precedente viene interpretata come:
-
Ordinare tutti i record nella tabella dei registri in ordine decrescente rispetto alla distanza vettoriale tra le frasi e il vettore di interrogazione.
-
Per ogni record del presente ordine, controllare i propri
bookIdeparagraphId. Questo record viene prodotto se vengono soddisfatte le tre condizioni riportate di seguito.-
Il suo
bookIdè uno dei primi duebookIddistinti nell'ordine ordinato. -
Il suo
paragraphIdè uno dei primi treparagraphIddistinti nell'ordine ordinato all'interno dello stessobookId. -
Il record è uno dei primi quattro record della stessa combinazione
bookIdeparagraphId.
-
-
In caso contrario, il record viene filtrato.
La ricerca di somiglianza multi-vettoriale non è solo per i documenti e può essere utilizzata anche per rispondere alle seguenti domande:
-
Restituisci le foto K più vicine ma assicurati che siano foto di persone diverse.
-
Trova le migliori canzoni K con due o più segmenti audio che meglio corrispondono a questo frammento di suono.
Nota:
-
Questa estensione della clausola di limitazione delle righe della partizione è un'estensione generica del linguaggio SQL. Non si applica solo alle ricerche vettoriali.
-
La ricerca multi-vettore è attualmente supportata con l'indice IVF.
Vedi anche: Oracle AI Database SQL Language Reference per la sintassi completa di ROW_LIMITING_CLAUSE