データ検出の概要
データ検出は、Oracleデータベースの機密データの検出に役立ちます。
データ検出による機密データの検索方法
機密データの保護は、保有している機密データとその場所を把握することから始まります。ターゲット・データベースで機密データを検出するためのデータ検出の主な手段は、機密タイプを使用することです。また、データ検出では、ディクショナリベースの参照関係を検索して親子関係を検索します。データ検出では、非ディクショナリ参照関係(アプリケーションレベルの関係)を検索することもできます。
データ検出では、選択したOracleの事前定義済およびユーザー定義の機密タイプを使用して、Oracleデータベースの機密列が検索されます。データ検出に検索対象を指定すると、基準を満たす機密列が検出されます。
検出された機密列の検証に役立つように、データ検出時にターゲット・データベースからサンプル・データを収集することを選択できます。サンプル・データは機密データであるため、この機能を使用する場合は注意してください。認可されたユーザーのみがサンプル・データを収集および表示できるようにする必要があります。
機密タイプによる検出
機密タイプは、列名、データおよびコメントに基づいた機密列の検索を支援する正規表現を定義します。Oracle Data Safeには、機密データの検索に使用できる180以上の事前定義された機密タイプが用意されています。事前定義された機密タイプはカテゴリに編成されるため、関連する機密タイプを簡単に見つけて使用できます。事前定義された機密タイプは変更または削除できません。ただし、独自の機密タイプおよび機密カテゴリを作成できます。データ検出では、objectデータ型を使用する機密列は発見されません。
事前定義された機密タイプの最上位レベルのカテゴリは次のとおりです:
-
識別情報:国、個人および公開識別子の機密タイプが含まれます。例として、米国社会保障番号(SSN)、カナダ社会保険番号(SIN)などの国民ID、Visa番号および氏名があります。
-
経歴情報:住所、家族データ、拡張PIN、制限付き処理データの機密タイプが含まれます。例として、完全住所、母親の旧姓、生年月日、宗教があります。
-
IT情報:ユーザーITデータおよびデバイス・データの機密タイプが含まれます。例として、ユーザーID、パスワード、IPアドレスがあります。
-
財務情報:支払カード・データおよび銀行口座データの機密タイプが含まれます。例として、カード番号、カード・セキュリティPIN、銀行口座番号があります。
-
医療情報:健康保険データ、ヘルスケア・プロバイダ・データおよび医療データの機密タイプが含まれます。例として、健康保険番号、ヘルスケア・プロバイダ、血液型があります。
-
雇用情報:従業員基本データ、組織データおよび報酬データの機密タイプが含まれます。例として、役職、退職日、所得、株式があります。
-
学業情報:学生基本データ、機関データおよび成成績データの機密タイプが含まれます。例として、学資援助、単科大学名、成績、懲戒記録があります。
ディクショナリベースの参照関係による検出
データ検出では、Oracleデータ・ディクショナリも検索され、主キー列と外部キー列の間の関係が検出されます。次に、関連する列に機密としてフラグが設定されます。たとえば、2つの表があるとします。最初の表CUSTOMERSには、顧客の名、姓、開始日などの情報が格納されます。2番目の表LOCATIONSには、販売ロケーションに関する情報が格納されます。
CUSTOMERS表では、LOCATION_IDは、LOCATIONS表の主キーLOCATION_IDを参照する外部キーとして定義されます。データ検出では、これらのタイプの参照関係が自動的に検出されます。
この例では、場所に機密タイプが定義されている場合、両方の表のLOCATION_ID列は機密として識別されます。
非ディクショナリ参照関係による検出
Oracle Data Safeでは、非ディクショナリ参照関係を使用して機密列を識別することもできます。これらは、アプリケーションで定義されているがOracleデータ・ディクショナリには記録されていないデータベース列間の関連です。データ検出では、選択した機密タイプの列名パターンおよび列データ・パターンを使用して、列間の潜在的な関係を検出します。
たとえば、親表はCUSTOMERという名前で、関連表はPAYMENT_METHODという名前であるとします。親表の機密列はCUST_NAMEであり、関連表の機密列はCUST_NMです。データ・ディクショナリに親表へのリンクを提示せずに関連表が作成された(つまり、外部キー情報がデータ・ディクショナリに入力されなかった)場合、親表と関連表の間の関係は"非ディクショナリ参照関係"です。
機密データ・モデル
データ検出では、検出結果が機密データ・モデルとしてOracle Cloud Infrastructureの指定されたコンパートメントに保存されています。アクセスできる機密データ・モデルは、Oracle Data Safeの「機密データ・モデル」ページで確認できます。結果は、機密列、参照関係および信頼度レベルで構成されます。
機密データ・モデルの「信頼度レベル」列は、特定の機密タイプの分類における信頼度を表します。高、中または低に分類されることがわかります。-として表示されるnoneの信頼度レベルは、手動で追加された列に対して表示されます。信頼度スコアは、列のデータ、名前およびコメントが一致するかどうかなど、複数の属性を評価することによって決定されます。また、同じ表または関連表で検出された類似の機密タイプも検索されます。これは、コンテキストの類似性が信頼性を高める可能性があるためです。また、スコアリングでは、同じ表または関連表の他の列(参照関係を共有する表)と組み合せた場合に、列が個人識別可能情報(PII)を形成できるかどうか、およびそのような組合せが非関連表にまたがって発生するかどうかが評価されます。現在、同じ表または関連表の機密タイプに基づく評価、および関連表または非関連表でPIIを形成する列は、検出範囲に含まれるスキーマおよび機密タイプに制限されています。
たとえば、CUSTOMERS表のCUST_EMAILという名前の列について考えてみます。列名は機密タイプEmail Addressに明確に一致し、信頼度スコアに寄与します。列内のデータは、有効なEメール・アドレス・パターンに従うため、信頼性がさらに向上します。また、ORDERSという関連表には列CUST_PHONEが含まれており、これはPIIとしても分類されるため、コンテキストが強化されます。これらの属性に基づいて、CUST_EMAIL列に高い信頼度レベルが割り当てられます。
ターゲット・データベースで変更が発生した場合、機密データ・モデルに対する増分更新の実行、機密データ・モデルへの機密列の追加と削除、および機密列間の参照関係の管理を行うことができます。「信頼度レベル」列は、増分検出の実行時に更新されるため、機密データ・モデル作成の完了時と増分検出ジョブの実行後の両方で信頼度レベルを表示できます。機密データ・モデルをダウンロードし、オフラインで変更してから、同じかまたは他のOracle Data Safeリージョンにアップロードできます。機密データ・モデルは一度に1つのターゲット・データベースに関連付けられますが、必要に応じてそのターゲット・データベースを変更できます。
空の機密データ・モデルを直接作成できるため、機密オブジェクトの追跡およびマスキングに合せて調整できます。データ検出を実行し、不要な列を削除するかわりに、事前定義済の列がない新しい機密データ・モデルを作成し、その後対象の列のみを追加できます。
機密データを把握しやすくしたり、レコード管理のために、データ検出には機密データ・モデルおよび増分検出用のダウンロード可能なレポートが用意されています。どちらのタイプのレポートでも、機密表、列および値の合計および機密列の詳細が提供されます。機密列は、機密タイプに基づいて分類されます。
オプションで、サンプル・データや推定行数など、機密データ・モデルにメタデータを格納できます。この情報から、ターゲット・データベースの様々なタイプの機密データの数量に関する全体像がわかります。
機密データ・モデルを使用して、データ・マスキングなどの他のセキュリティ制御を実装できます。たとえば、機密データ・モデルを使用してマスキング・ポリシーを定義し、そのデータ・モデルを使用してターゲット・データベースの機密データをマスキニングできます。複数のマスキング・ポリシーに機密データ・モデルを再利用できます。
データ検出ランディング・ページ
データ検出ランディング・ページは、選択したコンパートメント内のターゲット・データベース全体の機密データの概要ビューを提供します。必要に応じて、ターゲット・データベース・グループおよび機密タイプ・グループに設定されたフィルタを変更できます。チャートと表はすぐに更新されます。
「機密タイプ」タブ
データ検出ダッシュボードの「機密タイプ」タブには、ターゲット・データベース・フリート全体で66の共通機密タイプが使用される頻度の概要が表示されます。一般的な機密タイプは、データベース内に存在する可能性が最も高い機密タイプとしてOracleによって識別されています。機密タイプ検索を使用して、ターゲット・データベース・フリート全体で他の機密タイプが使用される頻度を確認します。
「機密タイプ」チャートでは、ターゲット・データベース・フリート全体で共通の機密タイプの内訳を示すことで、ターゲット・データベース内で最も一般的な機密タイプを識別できます。
「機密タイプ」表は、機密データ・モデルが作成されておらず、データベースの数を示すことで、ターゲット・データベース・フリート全体でデータ検出が十分に利用されているかどうかを識別するのに役立ちます。
次の図は、データ検出の機密タイプのリストを示しています。 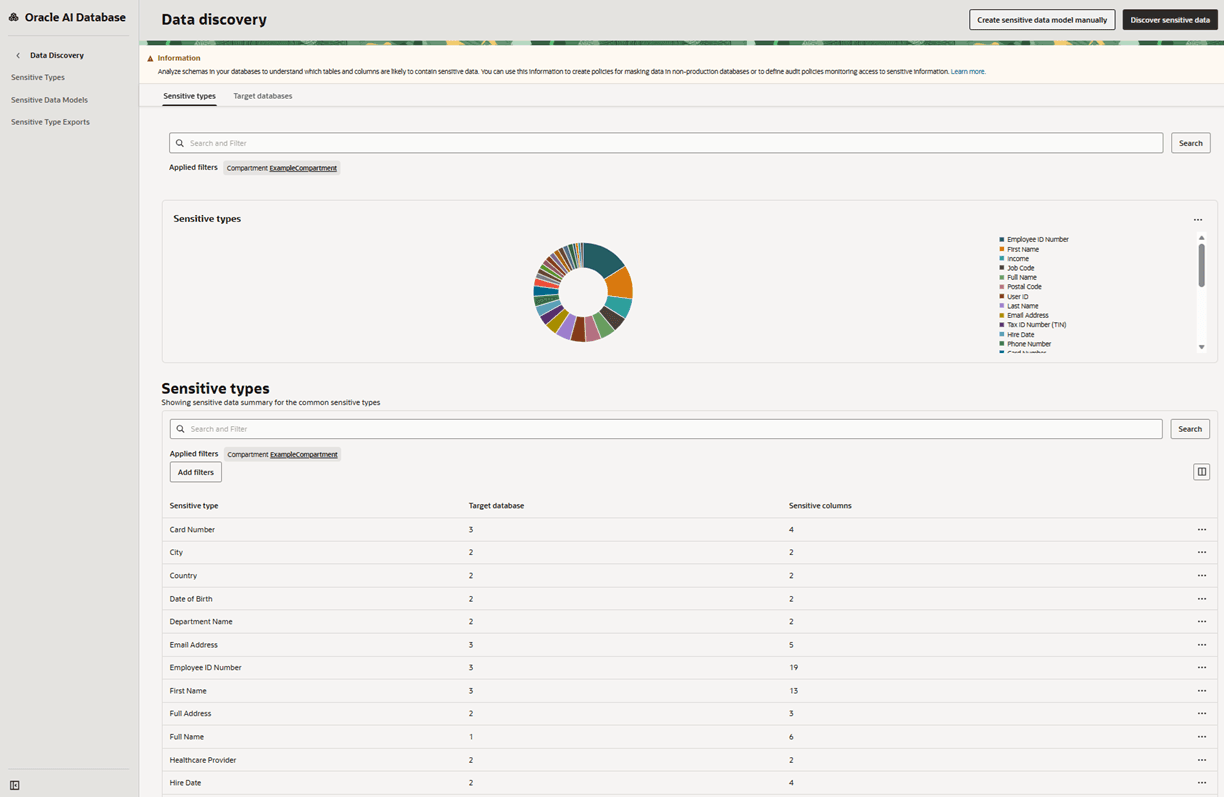
図discovery-dashboard-common-sensitive-tab.pngの説明
「ターゲット・データベース」タブ
ダッシュボードの上部にあるチャートは、上位5つのターゲット・データベースにフォーカスしています。「上位5ターゲット(機密列別)」チャートは、上位5つのターゲット全体にわたる機密列の割合の内訳を示すことで、機密列の最も多くのターゲット・データベースの識別するのに役立ちます。上位5ターゲット(機密値別)チャートは、5つのターゲット全体にわたる機密値の割合の内訳を示すことで、機密値の最も多くのターゲット・データベースの識別に役立ちます
次の図は、選択したコンパートメント内のターゲット・データベースの機密データ・サマリーを示しています。 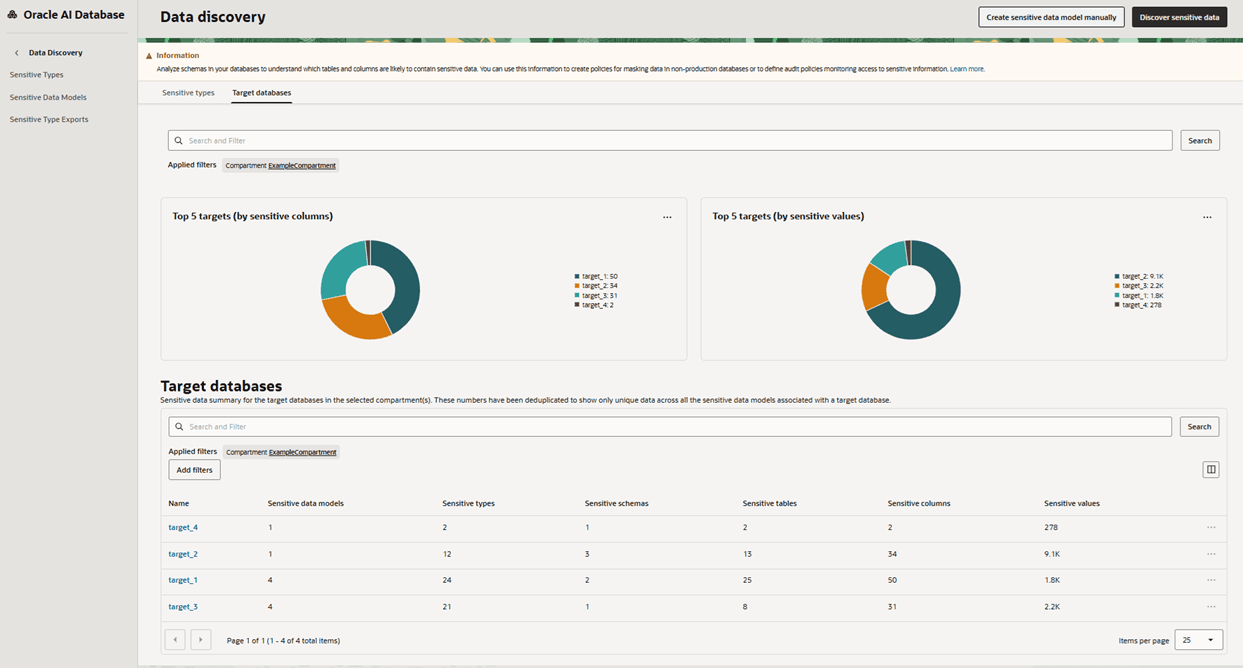
図data-discovery-dashboard.pngの説明
チャートの後に、選択したコンパートメント内のターゲット・データベースの機密データ・サマリーが続きます。サマリーでは、ターゲット・データベース全体の統計(ターゲット・データベースごとに作成された機密データ・モデルの数、および各ターゲット・データベースの機密タイプ、機密スキーマ、機密表、機密列、機密値を含む)を比較できます。
機密データのサマリーから、「ターゲット・データベース」タブを選択し、ターゲット・データベース名を選択して「詳細」タブおよび「機密データ・モデル」タブを表示します。「機密データ・モデル」タブには、選択したターゲット・データベースに関連付けられた機密データ・モデルがリストされます。この表は、機密データ・モデルごとに、ターゲット名と、モデル内の次の各数量(機密タイプ、機密スキーマ、機密表、機密列および機密値)を示しています。
データ検出のワークフロー
機密データ・モデルを作成する前に、次を行う必要があります:
-
Oracle Cloud Infrastructure Identity and Access Managementで適切な権限を取得し、ターゲット・データベースを登録します。
-
(オプション)スキーマ・レベルの統計が最新でない場合は、ターゲット・データベースでスキーマ統計を収集し、正確な結果を確認します。これを行うには、
dbms_stats.gather_schema_statsプロシージャを実行します。この手順はリソース集中型の操作であるため、必要な場合にのみ実行することをお薦めします。組み込めるパラメータの詳細は、GATHER_SCHEMA_STATSプロシージャを参照してください。次の例では、HCM1スキーマに関する統計情報を収集します:exec dbms_stats.gather_schema_stats(ownname => 'HCM1');
これで、機密データ・モデルを作成する準備ができました。データ検出で作業する場合は、機密データ・モデルの作成時に次の一般的なステップに従います:
-
機密データ・モデル情報を指定し、ターゲット・データベースを選択します。
-
(オプション)指定された日時以降にターゲット・データベースのスキーマが更新された場合は、「データベース・スキーマのリフレッシュ」を選択します。
-
機密データを検索するスキーマを選択します。すべてのスキーマを選択することもできます。Oracle以外のメンテナンス・スキーマのみが表示され、選択可能です。
-
ターゲット・データベースで検索する機密タイプを選択します。すべての機密タイプを選択することもできます。
-
サンプル・データを取得するかどうか、アプリケーションレベルの参照関係を検索するかどうかなど、任意の検出オプションを選択します。
機密データ・モデルに機密列が最初に移入された後、次のステップでは次を行います:
-
ターゲット・データベース内の機密データを正確に反映するように、必要に応じて機密データ・モデルを変更します。
-
イベント通知の設定。たとえば、機密データ・モデルが作成された場合に自動的に通知される
Sensitive Data Model Create Beginイベントを作成できます。
一定の期間にわたり、次のタスクを実行できます:
-
他のターゲット・データベースで機密データ・モデルを使用します。これを行うには、機密データ・モデルをダウンロードして別のOracle Data Safeリージョンにアップロードします。機密データ・モデルを別のターゲット・データベースに関連付けることもできます。
-
機密データ・モデルを手動で作成することで、機密オブジェクトの追跡およびマスキングに合せて調整されたアプローチが可能になります。
-
データ検出を実行し、不要な列を削除するかわりに、事前定義済の列がない新しい機密データ・モデルを作成し、その後対象の列のみを追加できます。
-
これを行うには、ダッシュボードで「機密データ・モデルの手動作成」ボタンを選択するか、「機密データの検出」パネルで「機密データ・モデルの手動作成」チェック・ボックスを選択します。
-
新しい機密データ・モデルを作成した後、「列の追加」を選択して、関心のある列を機密データ・モデルに手動で追加します。
-
データ検出でサポートされていないデータ型、オブジェクトおよびデータベース機能
コンテンツ/データ・パターン・スキャンでは、データ検出でサポートされていないデータ型は次のとおりです。
- ロング*
- RAW*
- BFILE*
- BLOB*
- JSON
* LONG/RAW、BFILEおよびBLOBは、列名やコメントなどのメタデータから引き続き検出できます。
データ検出でサポートされていないオブジェクト・タイプは次のとおりです。
- XMLTYPE
- HTTP純度
- XDBURITYPE
- DBURITYPE
- ADT
データ検出でサポートされていないデータベース機能は次のとおりです。
- 外部表
- 一時表
- 表示
- インデックス
- ネストされた表
データ検出を使用するための前提条件
次に、データ検出を使用するための前提条件を示します:
-
データ検出で使用するターゲット・データベースを登録します。
- ターゲット・データベースが他のユーザーによってOracle Data Safeにすでに登録されている場合、検出ジョブを実行するには、Oracle Cloud Infrastructure Identity and Access Management (IAM)のターゲット・データベース・リソースに対する
READ権限を取得する必要があります。
- ターゲット・データベースが他のユーザーによってOracle Data Safeにすでに登録されている場合、検出ジョブを実行するには、Oracle Cloud Infrastructure Identity and Access Management (IAM)のターゲット・データベース・リソースに対する
-
ターゲット・データベースに対するデータ検出ロールを付与します。データベース管理者は、このロールをターゲット・データベースのOracle Data Safeサービス・アカウントに付与できます。
-
Oracle Data Safeのデータ検出機能を使用するためのIAMの権限を取得します。テナンシ管理者は、これらの権限を付与できます。これらのリソースには権限が必要です:
-
data-safe-discovery-jobs検出ジョブを実行するには、
manage権限が必要です。 -
data-safe-sensitive-data-models検出ジョブを実行し、機密データ・モデルを変更するには、
manageが必要です。 -
data-safe-sensitive-types機密タイプを作成するには、
manageが必要です。 -
data-safe-work-requests作業リクエストを表示するには、
read権限が必要です。
権限を選択的に付与するかわりに、関連するコンパートメントの
data-safe-discovery-familyに対する権限を付与できます。これには、前述のすべてのリソースに対する権限が含まれます。data-safe-discovery-family Resourceを参照してください。 -
関連トピック
-
ターゲット・データベースのOracle Data Safeサービス・アカウントへのロールの付与では、データ検出および他のOracle Data Safe機能に必要なロールについて説明します。
-
Oracle Data SafeのIAMポリシーの作成では、Oracle Data Safeの各機能に必要な権限について説明します。