Oracle AI Database의 인공 지능
이 장에서는 Oracle AI Database에서 제공되는 인공 지능 기능에 대해 설명합니다.
-
Oracle AI Vector Search 개요 Oracle AI Vector Search는 AI(인공 지능) 워크로드용으로 설계되었으며, 키워드가 아닌 의미 체계를 기반으로 데이터를 쿼리할 수 있게 해 줍니다.
-
벡터 거리 측정항목 벡터 공간에서 거리를 측정하는 것은 주어진 질의 벡터에 대해 가장 관련성이 높은 결과를 식별하는 핵심입니다. 이 프로세스는 관계형 데이터베이스 환경에서 잘 알려진 키워드 필터링과는 매우 다릅니다.
-
Hierarchical Navigable Small World Indexes 개요 이 예에서는 벡터 근사 유사성 검색을 위한 HNSW 인덱스를 생성하는 방법을 이해할 수 있습니다.
-
반전된 파일 플랫 벡터 인덱스 이해 반전된 파일 플랫 벡터 인덱스는 인접 분할 영역 또는 클러스터를 사용하여 검색 영역을 좁혀 검색 효율성을 향상시키기 위해 설계된 기술입니다.
-
유사성 검색 수행 이 섹션에서는 유사성 검색을 수행하는 방법에 대해 설명합니다.
Oracle AI Vector Search 개요
Oracle AI Vector Search는 AI(인공 지능) 워크로드를 위해 설계되었으며 키워드가 아닌 의미를 기반으로 데이터를 쿼리할 수 있습니다.
VECTOR 데이터 유형
VECTOR 데이터 유형은 Oracle AI Database 26ai의 출시와 함께 도입되었으며, 벡터 임베딩을 데이터베이스에 비즈니스 데이터와 함께 저장할 수 있는 기반을 제공합니다. 임베딩 모델을 사용하여 비구조적 데이터를 벡터 임베딩으로 변환한 다음 비즈니스 데이터에 대한 의미 쿼리에 사용할 수 있습니다. VECTOR 데이터 유형 및 관련 기능을 사용하려면 COMPATIBLE 초기화 매개변수를 23.4.0 이상으로 설정해야 합니다. 매개변수 및 매개변수 변경 방법에 대한 자세한 내용은 Oracle AI Database Upgrade Guide를 참조하십시오.
테이블 정의에서 VECTOR 데이터 유형을 사용하는 기본 예는 다음과 같습니다.
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);VECTOR 데이터 유형 및 테이블에서 벡터를 사용하는 방법에 대한 자세한 내용은 VECTOR 데이터 유형을 사용하여 테이블 생성을 참조하십시오.
VECTOR 데이터 유형의 수치적 특성으로 인해 분류, 변형, 회귀, 클러스터링 및 기능 추출과 같은 머신 러닝 알고리즘에 대한 입력으로 사용할 수 있습니다. 머신 러닝에서 VECTOR 데이터 유형을 사용하는 방법에 대한 자세한 내용은 벡터 데이터 유형 지원을 참조하십시오. 참고: VECTOR 데이터 유형 머신 러닝에 대한 지원은 23.7부터 모든 버전에서 사용할 수 있습니다.
벡터 임베딩
음성 어시스턴트, 챗봇, 언어 번역기, 추천 시스템, 이상 감지 또는 비디오 검색 및 인식과 같은 애플리케이션을 사용한 적이 있다면 암시적으로 벡터 임베딩 기능을 사용하게 됩니다.
Oracle AI Vector Search는 데이터 포인트의 수학적 벡터 표현인 벡터 임베딩을 저장합니다. 이러한 벡터 임베딩은 단어, 문서, 오디오 트랙 또는 이미지와 같은 콘텐츠의 의미적 의미를 설명합니다. 예를 들어, 텍스트 기반 검색을 수행하는 동안 벡터 검색은 실제 단어 자체가 아닌 단어 뒤의 의미와 컨텍스트를 기반으로 하므로 키워드 검색보다 더 나은 것으로 간주되는 경우가 많습니다. 이 벡터 표현은 인간에 의해 인식되는 물체의 의미적 유사성을 수학적 벡터 공간의 근접성으로 변환합니다. 이 벡터 공간에는 일반적으로 수천 개의 치수가 아닌 수백 개의 치수가 있습니다. 다르게 말하자면, 벡터 임베딩은 텍스트, 이미지, 비디오, 사용자 또는 음악과 같은 거의 모든 종류의 데이터를 다차원 공간에서 포인트로 표현할 수 있는 방법입니다. 이 공간에서는 이러한 포인트의 위치와 다른 지점과의 근접성이 의미가 있습니다.
이 간단한 다이어그램은 단어가 2차원 벡터로 인코딩되는 벡터 공간을 보여줍니다.
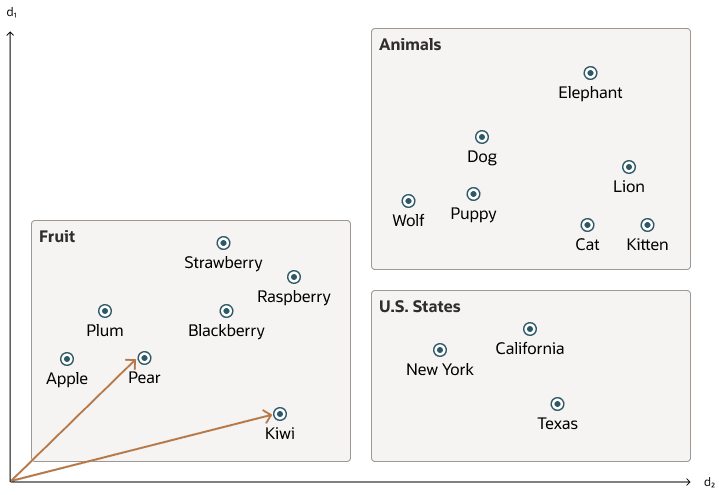
그림 vector_embeddings.png에 대한 설명
유사성 검색
이제 데이터 세트에서 의미 유사성을 검색하는 것은 쿼리 술어를 사용하여 기존 키워드 검색을 사용하는 대신 벡터 공간에서 가장 가까운 이웃을 검색하는 것과 같습니다. 다음 다이어그램에 표시된 것과 같이, 이 벡터 공간에서 dog와 wolf 사이의 거리는 dog와 kitten 사이의 거리보다 짧습니다. 이 공간에서 개는 새끼 고양이보다 늑대와 더 비슷합니다. 자세한 내용은 정확한 유사성 검색 수행을 참조하십시오.
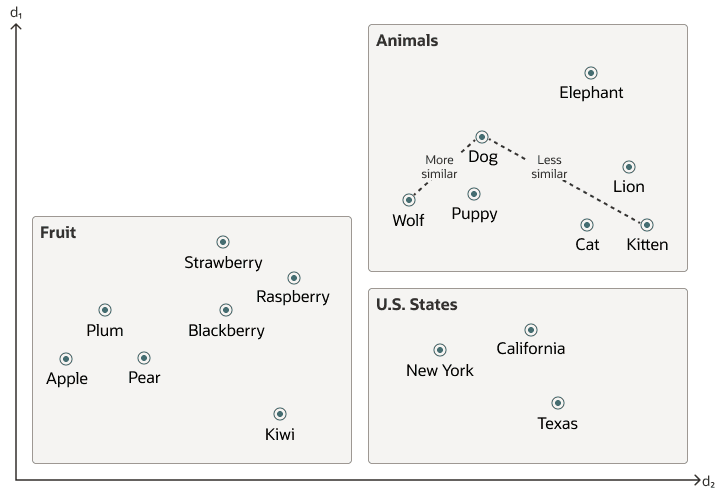
그림 vector_embeddings_similarity.png에 대한 설명
벡터 데이터는 의미상 관련된 그룹으로 불균등하게 분산되고 클러스터화되는 경향이 있습니다. 주어진 질의 벡터를 기반으로 유사성 검색을 수행하는 것은 K-가장 가까운 벡터를 벡터 공간의 질의 벡터로 검색하는 것과 같습니다. 기본적으로 벡터 순위를 지정하여 정렬된 벡터 리스트를 찾아야 합니다. 여기서 리스트의 첫번째 행은 query 벡터에 가장 가깝거나 가장 유사한 벡터이고 리스트의 두번째 행은 query 벡터에 가장 가까운 두번째 벡터입니다. 유사성 검색을 수행할 때 거리의 상대적 순서는 실제 거리보다는 실제로 중요한 것입니다.
앞의 벡터 공간을 사용하면 쿼리 벡터가 Puppy라는 단어와 가장 가까운 네 개의 단어를 식별하려는 의미 검색의 그림이 있습니다.
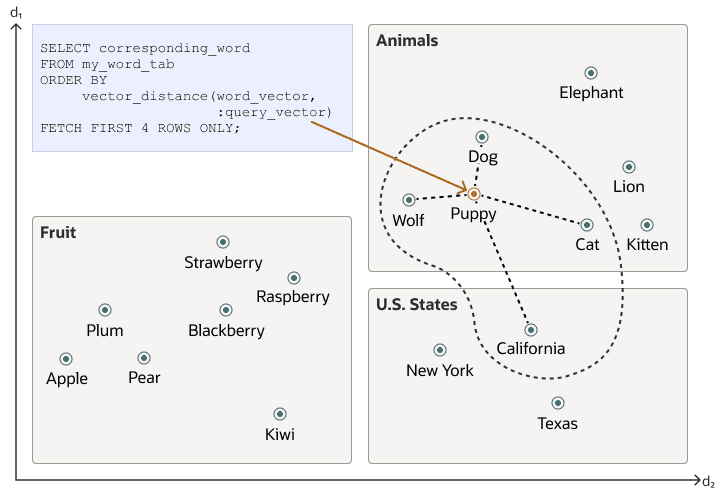
그림 vector_embeddings_similarity_search.png에 대한 설명
유사성 검색은 질의 벡터 값 및 인출 크기에 따라 하나 이상의 클러스터에서 데이터를 가져오는 경향이 있습니다.
벡터 인덱스를 사용한 대략적인 검색은 특정 클러스터로 검색을 제한할 수 있지만, 정확한 검색은 모든 클러스터의 벡터를 방문합니다. 자세한 내용은 벡터 인덱스 사용을 참조하십시오.
벡터 임베딩 모델
이러한 벡터 임베딩을 생성하는 한 가지 방법은 누군가의 도메인 전문 지식을 사용하여 처리 중인 객체 유형에 따라 모양, 텍스처, 색상, 감성 등과 같은 사전 정의된 기능 또는 치수 세트를 정량화하는 것입니다. 그러나 이 방법의 효율성은 사용 사례에 따라 달라지며 항상 비용 효율적이지는 않습니다.
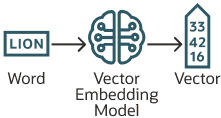
대신 벡터 임베딩은 신경망을 통해 생성됩니다. 대부분의 현대 벡터 임베딩은 다음 도표에서 설명한 것처럼 변압기 모델을 사용하지만, 컨볼루션 신경망도 사용할 수 있습니다.
그림 1: 벡터 임베딩 모델
데이터 유형에 따라 서로 다른 사전 학습 오픈 소스 모델을 사용하여 벡터 임베딩을 생성할 수 있습니다. 예:
-
텍스트 데이터의 경우 문장 변환기는 단어, 문장 또는 단락을 벡터 임베딩으로 변환합니다.
-
시각적 데이터의 경우 잔여 네트워크(ResNet)를 사용하여 벡터 임베딩을 생성할 수 있습니다.
-
오디오 데이터의 경우 오디오 데이터의 시각적 분광 프로그램 표현을 사용하여 시각적 데이터 케이스로 폴백할 수 있습니다.
각 모델에 따라 벡터의 치수도 결정됩니다. 예:
-
Cohere의 임베딩 모델 embed-english-v3.0에는 1024 차원이 있습니다.
-
OpenAI의 임베딩 모델 텍스트 임베딩-3-대형에는 3072개의 치수가 있습니다.
-
Hugging Face의 임베딩 모델 all-MiniLM-L6-v2에는 384개의 치수가 있습니다.
물론 자체 데이터 세트로 학습된 자체 모델을 항상 생성할 수 있습니다.
Oracle AI Database에 모델 포함 임포트
사전 학습된 오픈 소스 임베딩 모델 또는 자체 임베딩 모델을 사용하여 Oracle AI Database 외부에서 벡터 임베딩을 생성할 수 있지만, 해당 모델이 ONNX(Open Neural Network Exchange) 표준과 호환되는 경우 해당 모델을 Oracle AI Database로 직접 임포트할 수도 있습니다. Oracle AI Database는 데이터베이스 내에서 직접 ONNX 런타임을 구현합니다. 이를 통해 SQL을 사용하여 Oracle AI Database 내에서 직접 벡터 임베딩을 생성할 수 있습니다. 자세한 내용은 벡터 임베딩 생성을 참고하세요.
벡터 거리 척도
벡터 공간에서 거리를 측정하는 것은 주어진 쿼리 벡터에서 가장 관련성이 높은 결과를 식별하는 핵심입니다. 이 프로세스는 관계형 데이터베이스 환경에서 잘 알려진 키워드 필터링과는 매우 다릅니다.
벡터로 작업할 때 거리를 계산하여 두 벡터의 유사성 또는 유사성을 확인할 수 있는 여러 가지 방법이 있습니다. 각 거리 척도는 서로 다른 수학적 공식을 사용하여 계산됩니다. 두 벡터 사이의 거리를 계산하는 데 걸리는 시간은 벡터 치수 수 및 벡터 치수 형식과 같은 벡터 자체의 형식뿐만 아니라 사용되는 거리 척도를 포함한 여러 요인에 따라 달라집니다. 일반적으로 벡터를 생성한 벡터 임베딩 모델을 교육하는 데 사용된 거리 측정항목과 일치하는 것이 가장 좋습니다.
계층적 탐색 가능한 Small World 인덱스 개요
다음 예제를 사용하여 벡터 근사 유사성 검색에 대한 HNSW 인덱스를 생성하는 방법을 이해합니다.
NSW(Navigable Small World)를 사용하면 그래프의 각 벡터가 세 가지 특성을 기반으로 다른 벡터에 연결되는 근접 그래프를 구축하는 것이 좋습니다.
-
벡터 사이의 거리
-
삽입 중 검색의 각 단계에서 고려되는 가장 가까운 벡터 후보의 최대 수
(EFCONSTRUCTION) -
벡터당 허용되는 최대 접속 수(
NEIGHBORS)입니다.
위 임계값의 조합이 너무 높으면 조밀하게 연결된 그래프로 끝날 수 있으므로 검색 프로세스가 느려질 수 있습니다. 반면, 이러한 임계값의 조합이 너무 낮으면 그래프가 너무 희소해지거나 연결이 끊어져 검색 중 특정 벡터 간의 경로를 찾기 어려워질 수 있습니다.
벡터 검색을 위한 탐색 가능한 NSW(Small World) 그래프 순회는 그래프에서 미리 정의된 시작점으로 시작하여 밀접하게 관련된 벡터 클러스터에 액세스합니다. 검색 알고리즘은 두 가지 주요 목록을 사용합니다. 후보자, 그래프를 순회하는 동안 발생하는 동적으로 업데이트된 벡터 목록 및 지금까지 발견된 질의 벡터에 가장 가까운 벡터가 포함된 결과입니다. 검색이 진행됨에 따라 알고리즘은 그래프를 탐색하여 결과의 벡터보다 더 가까운 벡터를 탐색하고 평가함으로써 후보자를 지속적으로 세분화합니다. 이 프로세스는 후보자에 결과에서 가장 가까운 벡터보다 가까운 벡터가 없으면 로컬 최소값에 도달했으며 질의 벡터에 가장 가까운 벡터가 식별되었음을 나타냅니다.
이에 대해서는 다음 그림에 설명되어 있습니다.
그림 2: 탐색 가능한 소형 세계 그래프
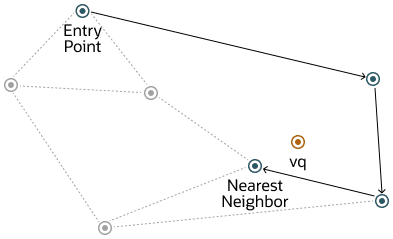
navigable-small-world-graph.png 그림에 대한 설명
설명 된 방법은 그래프에 벡터 삽입의 특정 배율까지 강력한 성능을 보여줍니다. 이 임계값 외에도 HNSW(Hierarchical Navigable Small World) 접근 방식은 확률적 건너뛰기 목록에서 관찰된 구조와 유사한 다중 계층 계층 계층 계층을 도입하여 NSW 모델을 향상시킵니다. 이 계층 구조는 그래프의 연결을 여러 계층에 분산하여 각 후속 계층이 아래 계층의 벡터 하위 집합을 포함하는 방식으로 구성함으로써 구현됩니다. 이러한 계층화를 통해 최상위 계층은 장거리 링크를 캡처하여 그래프를 가로질러 명시적 경로로 효과적으로 작동하며 하위 계층은 더 짧은 링크에 집중하여 세분화된 로컬 탐색을 용이하게 합니다. 결과적으로 검색은 상위 레이어에서 시작하여 대상 벡터의 영역을 빠르게 근사화하고 보다 정확한 검색을 위해 하위 레이어로 점진적으로 이동하여 벡터 간의 짧은 링크(더 작은 거리)를 활용하여 검색 효율성과 정확성을 크게 향상시킵니다.
HNSW의 작동 방식을 더 잘 이해하기 위해 이 계층이 확률 생략 목록 구조에 어떻게 사용되는지 살펴보겠습니다.
그림 3: 확률 생략 목록 구조
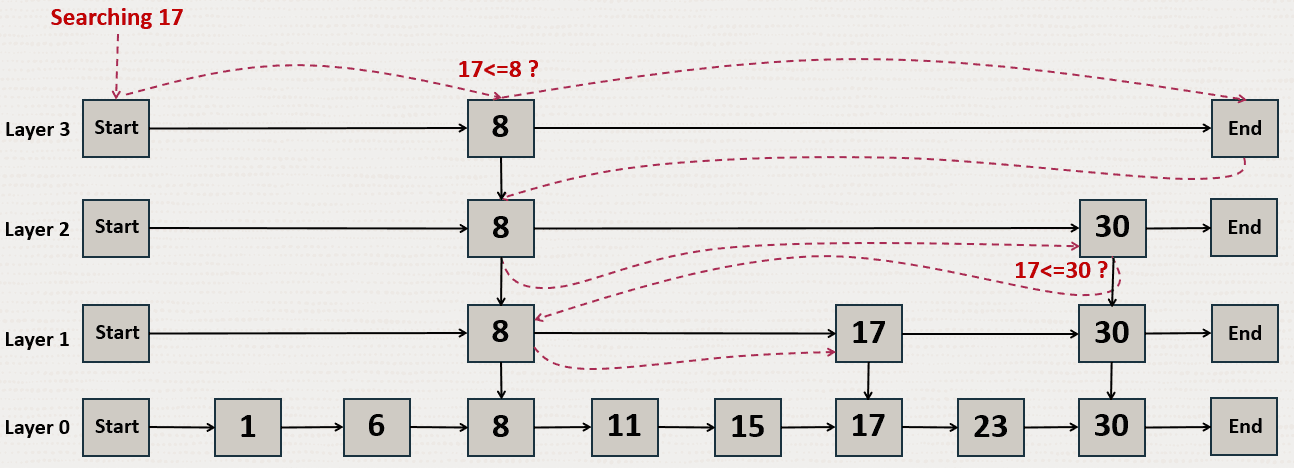
그림 probability-skip-list_01.png에 대한 설명
확률 생략 목록 구조는 위의 레이어가 하위 레이어보다 더 많은 숫자를 건너뛰는 링크된 목록의 여러 레이어를 사용합니다. 이 예제에서는 숫자 17을 검색하려고 합니다. 맨 위 레이어에서 시작하여 17을 찾거나, 목록의 끝에 도달하거나, 17보다 큰 숫자를 찾을 때까지 다음 요소로 이동합니다. 목록의 끝에 도달하거나 17보다 큰 숫자를 찾으면 17보다 작은 최신 번호의 이전 레이어에서 시작합니다.
HNSW는 NSW 레이어와 동일한 원칙을 사용하여 상위 레이어의 벡터 간 거리가 더 커집니다. 이 그림은 2D 공간의 다음 다이어그램으로 표시됩니다.
맨 위 레이어에는 가장 긴 모서리가 있고 맨 아래 레이어에는 가장 짧은 모서리가 있습니다.
그림 4: 계층적 탐색 가능 소형 세계 그래프
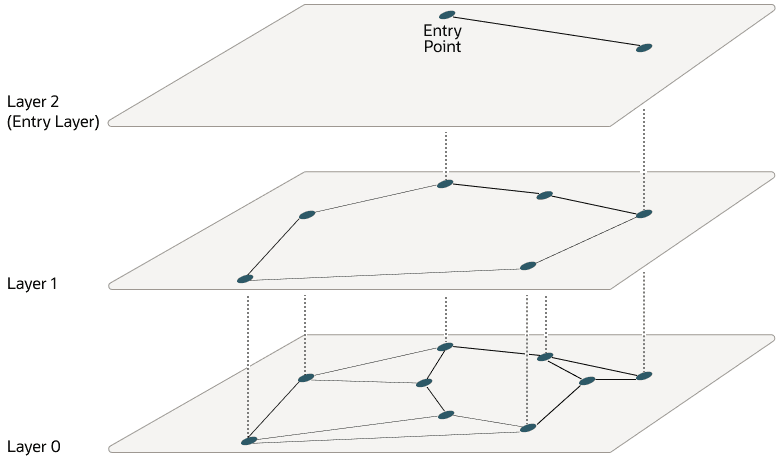
hierarchical-navigable-small-world-graph_02.png 그림에 대한 설명
맨 위 레이어부터 시작하여 한 레이어의 검색은 엔트리 벡터에서 시작됩니다. 그런 다음 각 노드에 대해 현재 노드보다 query 벡터에 가까운 이웃이 있는 경우 해당 이웃으로 이동합니다. 알고리즘은 쿼리 벡터에 대한 로컬 최소값을 찾을 때까지 이 작업을 계속 수행합니다. 로컬 최소값이 한 레이어에서 발견되면 검색은 해당 새 레이어에서 동일한 벡터를 사용하여 다음 레이어로 이동하고 검색은 해당 레이어에서 계속됩니다. 이 프로세스는 모든 벡터를 포함하는 하단 레이어의 로컬 최소값이 발견될 때까지 자체적으로 반복됩니다. 이 시점에서 검색은 최신 로컬 최소값이 발견된 NSW 알고리즘을 사용하여 쿼리 벡터에 가장 유사한 상위 k 벡터를 추출하는 대략적인 유사성 검색으로 변환됩니다. 상위 계층은 NEIGHBORS 매개변수로 설정된 각 벡터에 대해 최대 연결 수를 가질 수 있지만 계층 0은 두 배를 가질 수 있습니다. 이 프로세스는 다음 그림에서 설명됩니다.
그림 5: 계층적 탐색 가능 소형 세계 그래프 검색
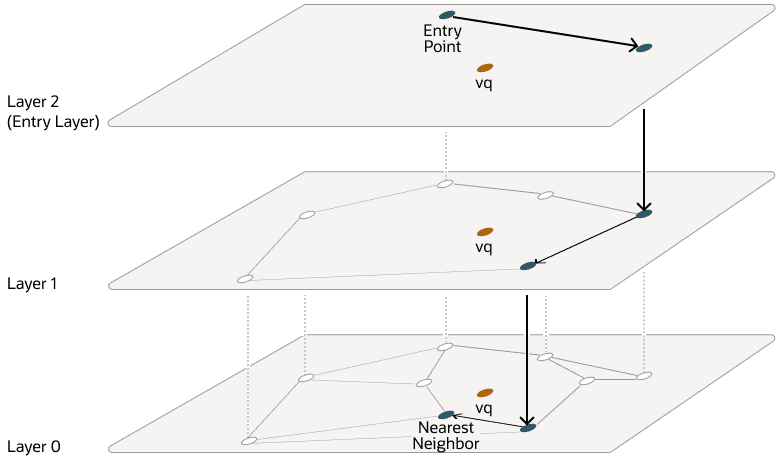
그림 hnsw-search-graph_02-png.png에 대한 설명
계층은 인메모리 그래프(Oracle Inmemory 그래프 아님)를 사용하여 구현됩니다. 각 계층은 별도의 인메모리 그래프를 사용합니다. 앞에서 살펴본 것처럼 HNSW 인덱스를 생성할 때 NEIGHBORS 매개변수를 사용하여 상위 계층의 벡터당 최대 접속 수를 미세 조정할 수 있으며, EFCONSTRUCTION 매개변수를 사용하여 삽입 중 각 검색 단계에서 고려되는 가장 가까운 벡터 후보의 최대 수를 세밀하게 조정할 수 있습니다. 여기서 EF는 Enter Factor를 나타냅니다.
앞서 설명한 것처럼, Oracle AI Vector Search를 사용하여 HNSW 인덱스를 사용하여 대략적인 검색 질의를 실행할 때 대략적인 검색을 수행할 대상 정확도를 지정할 수 있습니다.
HNSW 대략적인 검색의 경우 검색 검증을 위해 고려되는 후보자 수에 영향을 미치는 목표 정확도 백분율 값을 지정할 수 있습니다. 이는 알고리즘에 의해 자동으로 계산됩니다. 값이 100이면 시스템에서 인덱스를 계속 사용할 수 있고 정확한 검색을 수행하지는 않지만 정확한 검색과 유사한 결과가 나타납니다. 옵티마이저는 query의 술어에 따라 인덱스를 사용하는 것이 더 빠를 수 있으므로 여전히 인덱스를 사용하도록 선택할 수 있습니다. 목표 정확도 퍼센트 값을 지정하는 대신 EFSEARCH 매개변수를 지정하여 인덱스를 프로브하는 동안 고려할 특정 최대 후보 수를 지정할 수 있습니다. 값이 클수록 정확도가 높아집니다.
참고:
-
대략적인 검색 질의에서 목표 정확도를 지정하지 않으면 인덱스가 생성될 때 한 세트를 상속합니다. 인덱스 생성 시 생성 중인 인덱스 유형에 따라 백분율 값이나 파라미터 값을 사용하여 대상 정확도를 지정할 수 있습니다.
-
인덱스 생성 시의 집합과 비교하여 인덱스 검색 시의 목표 정확도를 다르게 지정할 수 있습니다. HNSW 인덱스의 경우 더 정확한 결과를 얻기 위해
EFSEARCH매개변수(인덱스 생성 시 지정된EFCONSTRUCTION값보다 높음)를 사용하여 더 많은 이웃을 확인할 수 있습니다. 인덱스 생성 중에 제공하는 대상 정확도는 인덱스 생성 파라미터를 결정하며 벡터 인덱스 검색의 기본 정확도 값으로도 사용됩니다.
반전된 파일 플랫 벡터 인덱스 이해
Inverted File Flat 벡터 인덱스는 이웃 분할 영역 또는 클러스터를 사용하여 검색 영역을 좁혀 검색 효율성을 향상시키기 위해 고안된 기술입니다.
다음 다이어그램은 2D 공간 표현을 사용하여 수행된 대략적인 검색에서 분할 영역 또는 클러스터를 생성하는 방법을 보여줍니다. 그러나 이것은 훨씬 더 높은 치수 공간으로 일반화 될 수 있습니다.
그림 6: 2D를 사용한 반전된 파일 플랫 인덱스
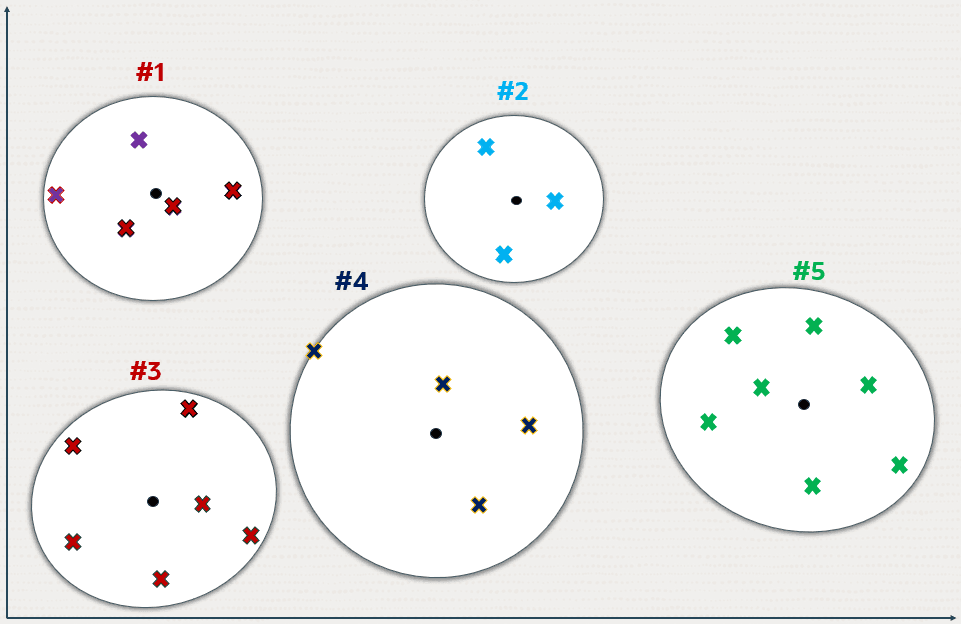
inverted-file-index_1.png 그림에 대한 설명
교차는 이 공간의 벡터 데이터 점을 나타냅니다.
작은 일반 원으로 표시된 새 데이터 포인트는 k 분할 영역 중심을 식별하기 위해 추가됩니다. 여기서 중앙 그리드 수(k)는 데이터 세트 크기(n)에 따라 결정됩니다. 일반적으로 k는 n의 제곱근으로 설정되지만, 인덱스 생성 중 NEIGHBOR PARTITIONS 매개변수를 지정하여 조정할 수 있습니다.
각 중심은 해당 분할 영역의 평균 벡터(중력 중심)를 나타냅니다.
중심선은 가장 가까운 중심선에서 각 벡터의 전체 거리를 최소화하는 것이 목표인 벡터에 대한 훈련 패스로 계산됩니다.
센트로이드는 벡터 공간을 k 파티션으로 분할합니다. 이 분할은 개념적으로 원이 만나는 동안 성장을 멈추고 고유한 분할 영역을 형성하는 원에서 원을 확장하는 것으로 설명됩니다.
그림 7: 반전된 파일 플랫 인덱스
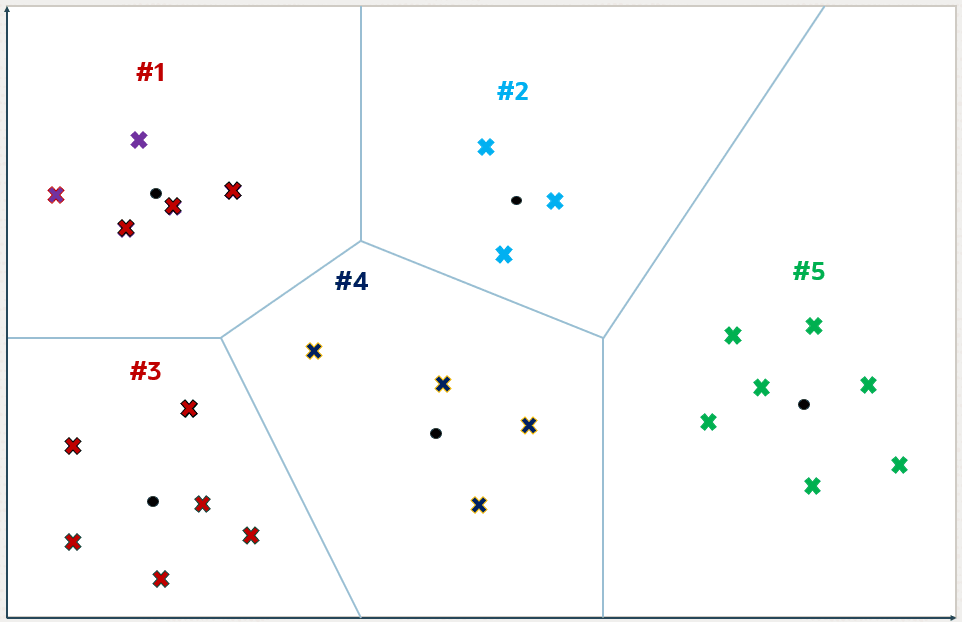
inverted-file-index_5.png 그림에 대한 설명
주변 장치의 벡터를 제외하고, 각 벡터는 센트로이드와 연관된 특정 분할 영역에 속합니다.
그림 8: 반전된 파일 플랫 인덱스
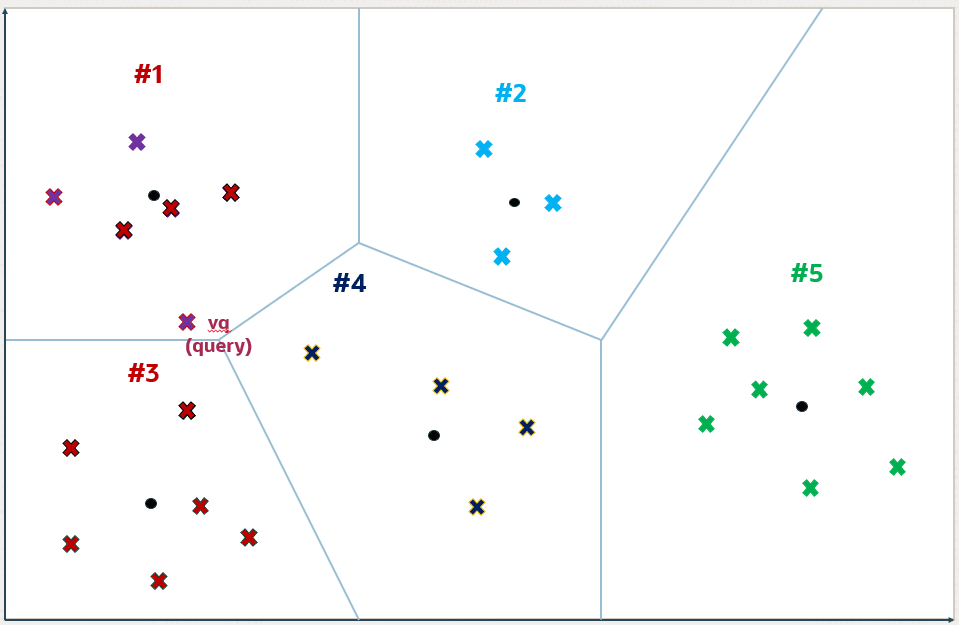
inverted-file-index_6.png 그림에 대한 설명
쿼리 벡터 vq 의 경우 검색 알고리즘은 가장 가까운 i 센트로이드를 식별합니다. 여기서 i의 기본값은 k의 제곱근이지만 NEIGHBOR PARTITION PROBES 매개변수를 설정하여 특정 쿼리에 대해 조정할 수 있습니다. 이 조정을 통해 검색 속도와 정확도를 조정할 수 있습니다.
이 매개변수의 숫자가 높을수록 정확도가 높아집니다. 이 예에서 i는 2로 설정되고 식별된 두 분할 영역은 분할 영역 번호 1과 3입니다.
그림 9: 반전된 파일 플랫 인덱스
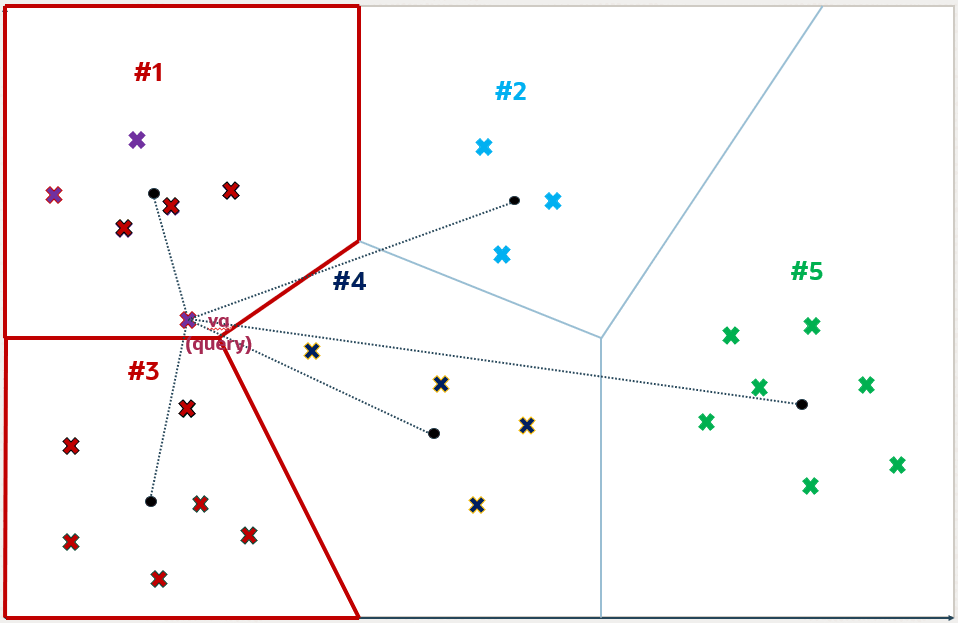
inverted-file-index_7.png 그림에 대한 설명
i 분할 영역이 결정되면 이 예에서 가장 가까운 상위 5개 벡터를 식별하기 위해 완전히 스캔됩니다. 이 숫자 5는 k와 다를 수 있으며 질의에서 이 숫자를 지정합니다. 다음 다이어그램에서는 분할 영역 번호 1과 3에 있는 vq에 가장 가까운 5개의 벡터가 강조 표시됩니다.
이 방법은 검색을 파티션의 하위 세트로 제한하여 프로세스를 가속화하지만 검사되지 않은 파티션에서 더 가까운 벡터가 누락될 수 있으므로 대략적인 검색을 구성합니다. 이 예에서는 대략적인 검색으로 vq에 가장 가까운 벡터를 반환하지 않을 수 있으며 검색 효율성과 정확성 간의 고유한 절충점을 보여줍니다.
그림 10: 반전된 파일 플랫 인덱스
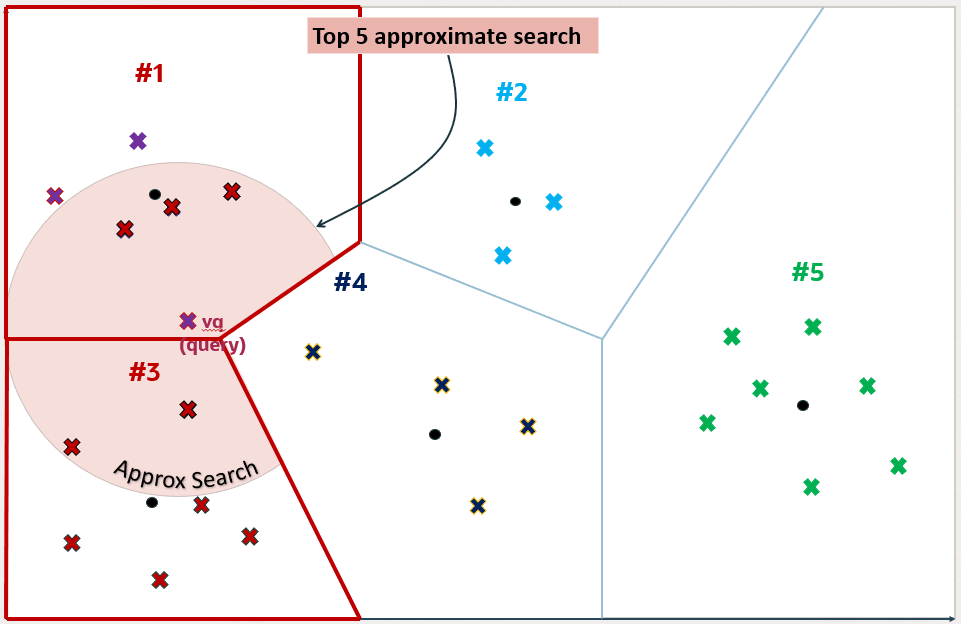
inverted-file-index_10.png 그림에 대한 설명
그러나 vq에서 가장 가까운 다섯 개의 벡터는 대략적인 검색으로 찾은 벡터가 아닙니다. 분할 영역 번호 4의 벡터 중 하나가 분할 영역 번호 3에서 검색된 벡터 중 하나보다 vq에 더 가까운 것을 확인할 수 있습니다.
그림 11: 반전된 파일 플랫 인덱스
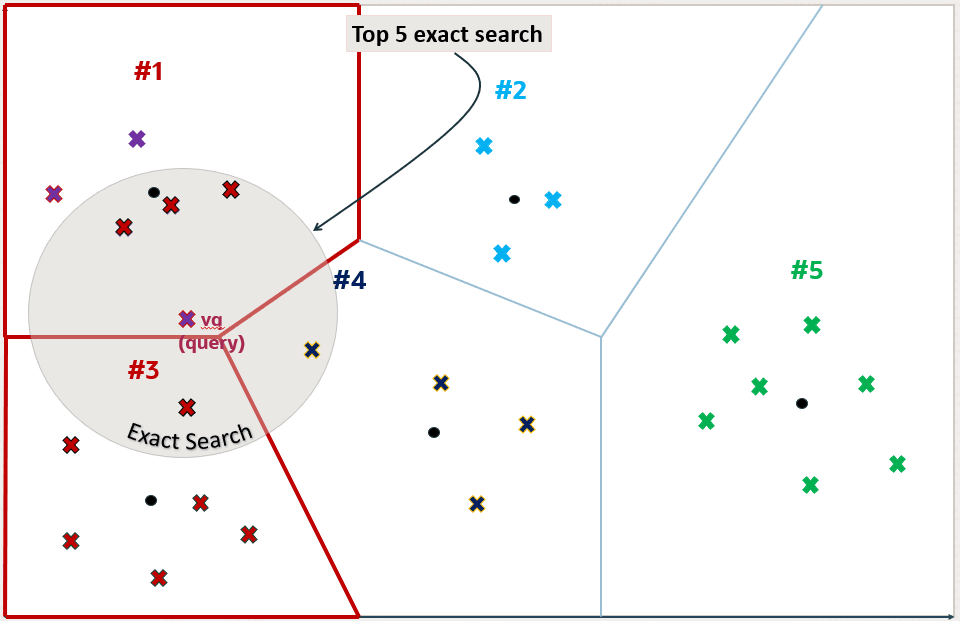
inverted-file-index_11.png 그림에 대한 설명
이제 벡터 인덱스 검색 사용이 항상 정확한 검색이 아닌 대신 대략적인 검색이라고 하는 이유를 확인할 수 있습니다. 이 예에서는 정확한 검색 벡터 결과 중 5개 중 4개만 검색했으므로 대략적인 검색 정확도는 80%에 불과합니다.
그림 12: 반전된 파일 플랫 인덱스
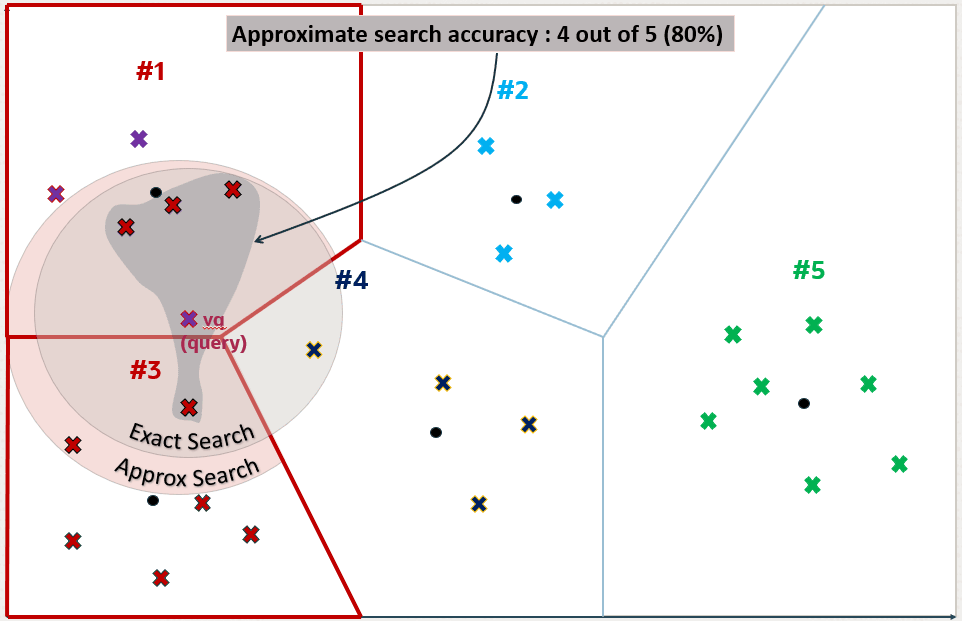
inverted-file-index_12.png 그림에 대한 설명
Oracle AI Vector Search를 사용하여 벡터 인덱스를 사용하여 대략적인 검색 쿼리를 실행할 때는 대략적인 검색이 수행되어야 하는 목표 정확도를 지정할 수 있습니다.
IVF 대략적인 검색의 경우 대상 정확도 백분율 값을 지정하여 검색을 프로브하는 데 사용되는 분할 영역 수에 영향을 줄 수 있습니다. 이는 알고리즘에 의해 자동으로 계산됩니다. 값이 100이면 시스템에서 인덱스를 계속 사용할 수 있고 정확한 검색을 수행하지는 않지만 정확한 검색을 수행하는 경향이 있습니다. 옵티마이저는 query의 술어에 따라 인덱스를 사용하는 것이 더 빠를 수 있으므로 여전히 인덱스를 사용하도록 선택할 수 있습니다. 대상 정확도 백분율 값을 지정하는 대신 NEIGHBOR PARTITION PROBES 매개변수를 지정하여 검색에서 프로브할 특정 최대 분할 영역 수를 지정할 수 있습니다. 값이 클수록 정확도가 높아집니다.
참고:
-
대략적인 검색 질의에서 목표 정확도를 지정하지 않으면 인덱스가 생성될 때 한 세트를 상속합니다. 인덱스 생성 시 생성 중인 인덱스 유형에 따라 백분율 값이나 파라미터 값을 사용하여 대상 정확도를 지정할 수 있습니다.
-
인덱스 생성 시의 집합과 비교하여 인덱스 검색 시의 목표 정확도를 다르게 지정할 수 있습니다. IVF 인덱스의 경우 보다 정확한 결과를 얻기 위해
NEIGHBOR PARTITION PROBES매개변수를 사용하여 더 많은 중심 분할 영역을 프로브할 수 있습니다. 인덱스 생성 중에 제공하는 대상 정확도는 인덱스 생성 파라미터를 결정하며 벡터 인덱스 검색의 기본 정확도 값 역할을 합니다.
유사성 검색 수행
이 절에서는 유사성 검색을 수행하는 방법에 대해 설명합니다.
-
정확한 유사성 검색 수행 유사성 검색은 쿼리 벡터와 비교하여 벡터의 상대적 순서를 찾습니다. 당연히 비교는 특정 거리 측정 단위를 사용하여 수행되지만 중요한 것은 가장 가까운 상위 벡터의 결과 집합이며 이들 사이의 거리가 아닙니다.
-
벡터 인덱스를 사용하여 대략적인 유사성 검색 이해 벡터 공간이 큰 검색 속도를 높이려면 벡터 인덱스를 사용하여 대략적인 유사성 검색을 사용할 수 있습니다.
-
다중 벡터 유사성 검색 수행 벡터 검색의 또 다른 주요 사용 사례는 다중 벡터 검색입니다. 다중 벡터 검색은 일반적으로 다중 문서 검색과 연관되며, 여기서 문서는 개별적으로 벡터에 포함된 조각으로 분할됩니다.
정확한 유사성 검색 수행
유사성 검색은 쿼리 벡터에 비해 벡터의 상대적 순서를 찾습니다. 당연히 비교는 특정 거리 측정 단위를 사용하여 수행되지만 중요한 것은 가장 가까운 상위 벡터의 결과 집합이며 이들 사이의 거리가 아닙니다.
예를 들어 특정 쿼리 벡터를 지정하면 데이터 세트의 다른 모든 벡터와의 거리를 계산할 수 있습니다. 이 유형의 검색은 플랫 검색 또는 정확한 검색이라고도 하며 완벽한 검색 품질로 가장 정확한 결과를 생성합니다. 하지만 이 작업을 수행하면 검색 시간이 상당히 많이 소요됩니다. 이에 대해서는 다음 다이어그램에서 설명합니다.
그림 13: 정확한 검색
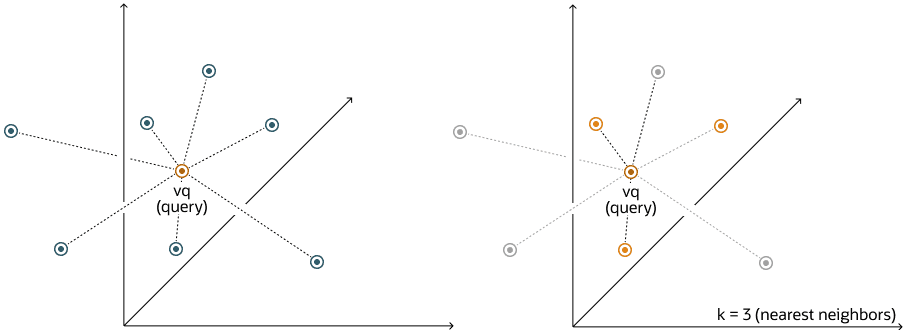
정확한 검색을 통해 질의 벡터 vq를 각 벡터에 대한 거리를 계산하여 공간의 다른 모든 벡터와 비교합니다. 이러한 거리를 모두 계산한 후 가장 가까운 일치 항목으로 가장 가까운 k를 반환합니다. 이를 k-가장 가까운 이웃(kNN) 검색이라고 합니다.
예를 들어, 유클리드 유사성 검색에는 유클리드 거리 척도 및 쿼리 벡터를 기준으로 공간에서 가장 가까운 상위 K 벡터를 검색하는 작업이 포함됩니다. 다음은 vector_tab 테이블에서 다음의 정확한 유사성 검색 질의를 사용하여 query_vector에 가장 가까운 상위 10개 벡터를 검색하는 예입니다.
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;
이 예에서 docID 및 embedding는 vector_tab 테이블에 정의된 열이고 embedding는 VECTOR 데이터 유형을 가집니다.
유클리드 거리의 경우 제곱 거리 비교는 거리를 비교하는 것과 같습니다. 따라서 거리 값 자체보다 주문이 더 중요할 때 유클리드 제곱 거리는 유클리드 거리보다 계산하는 것이 더 빠르기 때문에 매우 유용합니다 (제곱-루트 계산을 피하십시오). 따라서 다음과 같은 query를 보다 간단하고 빠르게 재작성할 수 있습니다.
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;
주: EXACT 키워드는 선택 사항입니다. ADB-S 인스턴스에 연결된 동안 생략할 경우 벡터 인덱스를 사용하는 대략적인 검색이 있는 경우 시도됩니다. 자세한 내용은 벡터 인덱스를 사용하여 대략적인 유사성 검색 수행을 참조하십시오.
주: 임베딩 모델 학습에 사용된 거리 함수를 사용해야 합니다.
참조: ROW_LIMITING_CLAUSE의 전체 구문은 Oracle AI Database SQL Language Reference
벡터 인덱스를 사용한 대략적인 유사성 검색 이해
큰 벡터 공간에서 빠른 검색 속도를 위해 벡터 인덱스를 사용하여 대략적인 유사성 검색을 사용할 수 있습니다.
유사성 검색에 벡터 인덱스를 사용하는 것을 대략적 검색이라고 합니다. 대략적인 검색은 성능을 위해 정확도를 낮추는 벡터 인덱스를 사용합니다.
큰 벡터 공간에 대한 대략적인 검색
검색 품질이 높은 우선 순위이고 검색 속도가 덜 중요한 경우 정확한 유사성 검색이 좋은 옵션입니다. 검색 속도는 더 작은 벡터 공간이나 고성능 서버에서 검색을 수행하는 경우 관련이 없습니다. 그러나 ML 알고리즘은 종종 수십억 개의 임베딩이 포함된 벡터 공간에서 유사성 검색을 수행합니다. 예를 들어, Deep1B 데이터 세트에는 CNN(Convolutional Neural Network)에서 생성된 1B 이미지가 포함됩니다. 코퍼스의 모든 벡터로 벡터 거리를 계산하여 Top-K 일치를 100% 정확도로 찾는 것은 매우 느립니다.
다행히 벡터 인덱스를 사용하여 수행할 수 있는 대략적인 검색 유형이 많이 있습니다. 벡터 인덱스는 정확도가 떨어질 수 있지만 리소스를 적게 사용할 수 있으며 효율성을 높일 수 있습니다. 기존의 데이터베이스 인덱스와 달리 벡터 인덱스는 휴리스틱 기반 알고리즘을 사용하여 생성되고 검색을 수행합니다.
100% 정확도는 휴리스틱으로 보장할 수 없으므로 벡터 인덱스 검색은 대상 정확도를 사용합니다. 내부적으로 인덱스 생성과 인덱스 검색 모두에 사용되는 알고리즘은 최대한 정확하도록 최선을 다하고 있습니다. 그러나 목표 정확도를 지정하여 해당 알고리즘에 영향을 줄 수 있습니다. 인덱스를 생성하거나 검색할 때 사용 중인 인덱스 유형에 따라 백분율 값을 지정하거나 내부 파라미터 값을 지정하여 기본이 아닌 대상 정확도 값을 지정할 수 있습니다.
목표 정확도 예
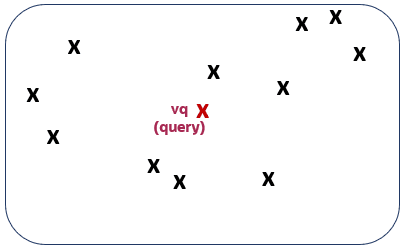
대상 정확도의 의미를 더 잘 이해하려면 다음 다이어그램을 참조하십시오. 첫 번째 다이어그램은 각 벡터가 작은 십자가로 표현되는 벡터 공간을 보여줍니다. 빨간색은 query 벡터를 나타냅니다.
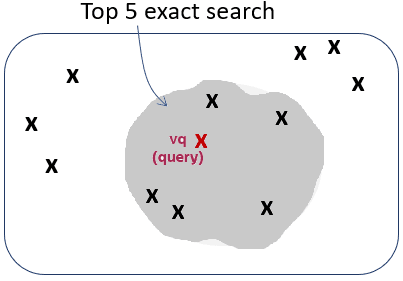
해당 컨텍스트에서 정확한 상위 5개 유사성 검색을 실행하면 두번째 다이어그램에 표시된 5개의 벡터가 반환됩니다.
벡터 인덱스가 생성된 방식에 따라 해당 컨텍스트에서 상위 5개 대략적인 유사성 검색을 실행하면 세번째 다이어그램에 표시된 5개의 벡터가 반환될 수 있습니다. 이는 인덱스 생성 프로세스에서 휴리스틱을 사용하기 때문입니다. 따라서 벡터 인덱스를 검색하면 정확한 검색과 비교하여 다른 결과가 발생할 수 있습니다.
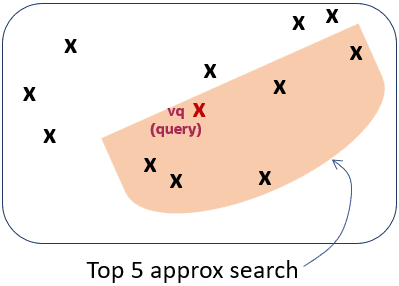
보시다시피 검색된 벡터는 서로 다르며 이 경우 벡터마다 다릅니다. 즉, 정확한 검색과 비교하여 유사성 검색은 5개의 벡터 중 4개를 올바르게 검색했습니다. 유사성 검색은 정확한 유사성 검색에 비해 정확도가 80%입니다. 다음은 네번째 다이어그램에 대한 설명입니다.
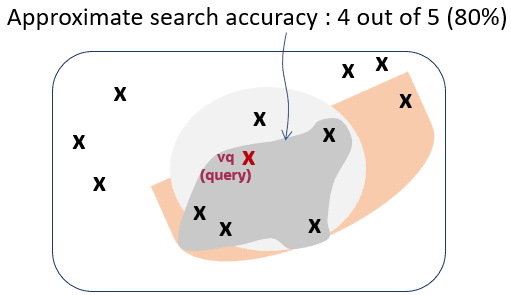
대략적인 검색 구조인 벡터 인덱스의 특성으로 인해 상위 K 유사성 검색에서 K 행보다 적은 수의 행이 반환될 수 있습니다.
벡터 인덱스를 설정하는 방법에 대한 자세한 내용은 벡터 인덱스 생성을 참조하십시오.
다중 벡터 유사성 검색 수행
벡터 검색의 또 다른 주요 사용 사례는 다중 벡터 검색입니다. 다중 벡터 검색은 일반적으로 다중 문서 검색과 연관되며, 여기서 문서는 개별적으로 벡터에 포함된 조각으로 분할됩니다.
다중 벡터 검색은 문서의 특성에 따라 분할 영역으로 알려진 그룹화 기준을 사용하여 최상위 K 벡터 일치를 검색하는 것으로 구성됩니다. SQL에서는 분할된 행 제한 절을 사용하여 청크와 검색 중인 질의 벡터의 유사성에 따라 문서에 점수를 부여할 수 있습니다.
다중 벡터 검색을 사용하면 다음과 같은 유형의 질문에 답하는 SQL 문을 작성하는 것이 더 쉽습니다.
- 그들이 존재한다면, 두 가지 가장 일치하는 책의 세 가지 가장 일치하는 단락에서 발견되는 네 가지 가장 일치하는 문장은 무엇입니까?
예를 들어, 데이터베이스의 각 장부가 벡터 포함 표현이 있는 문장을 포함하는 단락으로 구성되어 있다고 가정하면 다음과 같은 단일 SQL 문을 사용하여 이전 질문에 답할 수 있습니다.
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
다음 예에 표시된 것과 같이 정확한 유사성 검색 대신 대략적인 유사성 검색을 사용할 수도 있습니다.
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;
주: 반환되는 모든 행은 분할 영역 절별로 그룹화되지 않고 VECTOR_DISTANCE()로 정렬됩니다.
의미적으로 이전 SQL 문은 다음과 같이 해석됩니다.
-
장부 테이블의 모든 레코드를 문장과 쿼리 벡터 사이의 벡터 거리의 내림차순으로 정렬합니다.
-
본 주문서의 각 레코드에 대해
bookId및paragraphId을(를) 확인하십시오. 이 레코드는 다음 세 가지 조건이 충족되는 경우 생성됩니다.-
bookId는 정렬된 순서로 처음 두 개의 고유bookId중 하나입니다. -
paragraphId는 동일한bookId내에서 정렬된 순서로 처음 세 개의 고유paragraphId중 하나입니다. -
해당 레코드는 동일한
bookId및paragraphId조합 내에서 처음 4개 레코드 중 하나입니다.
-
-
그렇지 않으면 이 레코드가 필터링되어 제외됩니다.
다중 벡터 유사성 검색은 문서뿐만 아니라 다음 질문에 답하는 데도 사용할 수 있습니다.
-
가장 가까운 상위 K 사진을 반환하지만 다른 사람들의 사진인지 확인하십시오.
-
이 사운드 스니펫과 가장 일치하는 두 개 이상의 오디오 세그먼트가 있는 상위 K 곡을 찾습니다.
참고:
-
이 분할 영역 행 제한 절 확장은 SQL 언어의 일반적인 확장입니다. 벡터 검색에만 적용할 필요는 없습니다.
-
다중 벡터 검색은 현재 IVF 인덱스에서 지원됩니다.
참조: ROW_LIMITING_CLAUSE의 전체 구문은 Oracle AI Database SQL Language Reference