Extração Downstream para Implantação do Oracle GoldenGate
Uma implantação downstream do Oracle GoldenGate permite que você descarregue o processamento dos redo logs para um banco de dados alternativo conhecido como banco de dados de mineração. O banco de dados de mineração não precisa conter nenhum dado do banco de dados de origem, mas deve ser da mesma versão do banco de dados ou superior. Isso significa que o Oracle versão 12c como banco de dados de origem pode usar o banco de dados de mineração versão 19c ou superior, permitindo que o Oracle GoldenGate capture alterações de um banco de dados Oracle 12c sem realmente executar no banco de dados Oracle 12.
O Extract Downstream também pode ser usado em situações em que o GoldenGate não pode estabelecer uma conexão com o banco de dados de origem.
Observação: Os servidores de banco de dados de origem e downstream devem ter os mesmos tipos de endianness e processador. Por exemplo, o Extract downstream funcionará com o Linux de origem (x86) para um servidor Windows downstream (x86), mas não funcionará se o servidor de origem for HP-UX, mas o servidor downstream for AIX ou o servidor de origem for HP PA-RISC, mas o servidor downstream for HP-Itanium.
Um banco de dados de mineração downstream aceita logs arquivados e redo logs on-line de um banco de dados de origem. Isso implica que um Extract downstream pode existir em dois modos:
-
Modo de Mineração em Tempo Real: No modo de mineração em tempo real, os registros de redo são processados dos redo logs on-line ou stand-by imediatamente, portanto, não há atraso no processamento das alterações do banco de dados.
-
Modo Archive Mining: No modo archive mining, os registros redo não serão processados até que sejam arquivados em um arquivo redo log.
Em uma implantação downstream típica, o banco de dados de origem, no qual são feitas alterações nos dados, enviará seus redo logs ou logs de arquivamento para um banco de dados de mineração em que o processo Extract minerará os redo logs e gravará os arquivos de trilha. O Extract Downstream também pode ser usado em situações em que o Oracle GoldenGate não pode estabelecer uma conexão com o banco de dados de origem. No diagrama a seguir, CDBNORTH é o banco de dados de origem e CDBSOUTH é o banco de dados de destino. Há um banco de dados de mineração entre a origem e o destino com o servidor de log de banco de dados que transfere redo logs do Extract downstream para o destino.
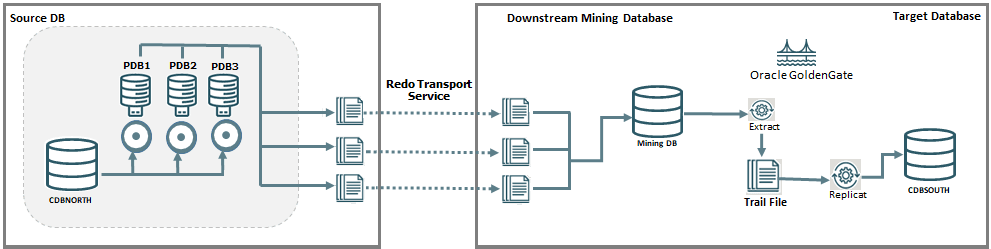
Uma opção alternativa é usar uma abordagem em cascata. Se houver um stand-by do Active Data Guard, você poderá fazer com que o stand-by envie os redo logs para o banco de dados de mineração, em vez de enviar os logs do principal. Essa opção deverá ser usada se houver largura de banda de rede limitada e o banco de dados stand-by estiver na mesma região ou data center que o banco de dados de mineração.
Essa abordagem usa um ADG configurado em um modo em cascata para transportar redo logs para um banco de dados de mineração downstream, que é então referenciado por um Extract downstream, reduzindo a sobrecarga no banco de dados de origem, conforme mostrado no diagrama a seguir.
Observação: O processo Extract para Oracle não pode estabelecer conexão com um stand-by do Data Guard ou um stand-by do Active Data Guard para capturar dados.
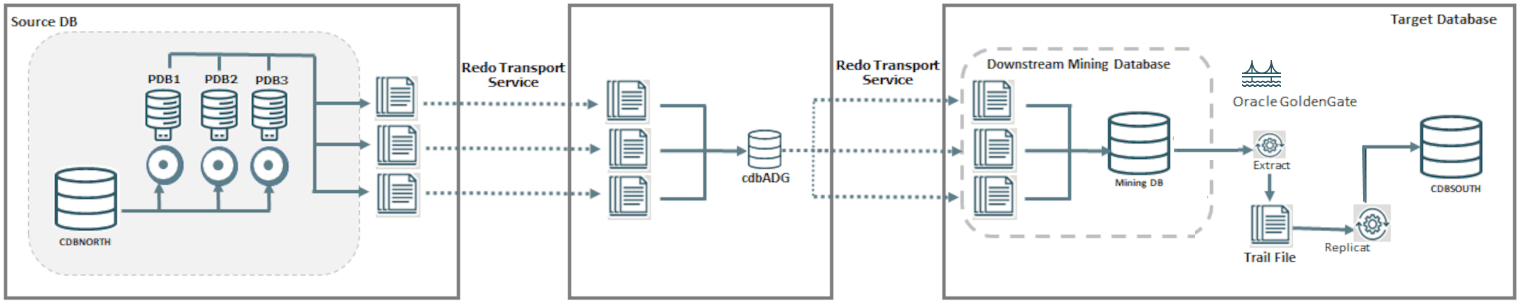
Para obter detalhes de configuração sobre como configurar um ambiente downstream em cascata, consulte Ativar Extração Downstream para Trabalhar com o ADG.
Configurar os Bancos de Dados Mining de Origem e Downstream
Nesta seção, você aprenderá sobre os parâmetros e as configurações de gerenciamento de usuários necessários no banco de dados.
Usuário do Oracle GoldenGate nos Bancos de Dados Mining de Origem e Downstream
O usuário Administrador do Oracle GoldenGate precisa existir em cada banco de dados. Nos bancos de dados contêineres, é necessário um usuário comum, pois o Extract será usado no contêiner Raiz.
Para configurar usuários para o Oracle AI Database 26ai e versões posteriores, a atribuição de usuário OGG_CAPTURE e OGG_APPLY precisa ser designada ao novo usuário. Para obter detalhes, consulte Conceder Privilégios de Usuário para o Oracle AI Database 26ai e Superior.
Para configurar usuários para o Oracle Database 21c e versões anteriores, os pacotes PL/SQL são usados. O exemplo a seguir mostra a criação de um usuário e os privilégios associados concedidos a esse usuário ao usar o Oracle GoldenGate com o Oracle Database 21c e inferior:
CREATE USER c##ggadmin IDENTIFIED BY *password* CONTAINER = all;
ALTER USER c##ggadmin SET CONTAINER_DATA = all CONTAINER = current;
GRANT ALTER SESSION TO c##ggadmin CONTAINER = all;
GRANT connect, resource TO c##ggadmin CONTAINER = all;

BEGIN
  DBMS_GOLDENGATE_AUTH.GRANT_ADMIN_PRIVILEGE
    ( grantee                 => 'C##GGADMIN'
    , privilege_type          => 'CAPTURE'
    , grant_select_privileges =>  TRUE
    , container               => 'ALL'
    );
END;
/
Observação: O usuário comum (c##ggadmin) só é necessário para o banco de dados downstream.
Configurar Conexões de Banco de Dados
Requisitos de Serviço do Database Net
Os bancos de dados de origem e downstream podem ser acessados usando os Serviços de Rede de Banco de Dados em ambas as direções.
No Oracle GoldenGate, é possível configurar conexões para o banco de dados de origem (CDBNORTH_root) e o banco de dados downstream (cdbDSC_root). A conexão com o banco de dados de origem só é necessária para armazenar dados do dicionário durante o registro do Extract. Você pode usar o parâmetro FETCHUSERIDALIAS para estabelecer conexão com o banco de dados de mineração downstream (cdbDSC_root) para extrações no runtime. Com o redirecionamento do ADG, o registro do Extract pode ser redirecionado para a origem de um ADG. Para configurar conexões, certifique-se de ter as credenciais do banco de dados para esses usuários para criar credenciais com base na implantação do Oracle GoldenGate.
Você pode testar o Serviço de Rede com o SQL*Plus, que faz parte do shiphome do Oracle GoldenGate.
Pré-requisitos do Banco de Dados de Origem
Para configurar conexões de banco de dados, certifique-se de que as seguintes definições sejam feitas nas instâncias de banco de dados de origem:
-
(Bancos de Dados de Origem e de Mineração Downstream) Todos os bancos de dados devem incluir:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
Os bancos de dados de origem devem estar no modo de log de arquivamento. Para ativar o arquivamento no banco de dados, execute o comando a seguir que informa ao banco de dados para criar um log de arquivamento ao alternar os redo logs.
ALTER DATABASE ARCHIVE LOG; -
(Recomendado) (Somente Origem) Todos os bancos de dados devem estar no modo Forçar Registro em Log.
ALTER DATABASE FORCE LOGGING; -
O banco de dados de origem deve ter o mínimo de log complementar ativado que inclui o
TRANDATA/SCHEMATRANDATAdurante o descarregamento do processo de Extração para o banco de dados do Mining porque é aqui que as transações estão ocorrendo. -
(Somente Banco de Dados de Mineração Downstream) Os arquivos de senha (
orapwSID) do banco de dados de origem e downstream são idênticos. Portanto, oremote_login_passwordfiledeve ser definido comoSHAREDouEXCLUSIVEno Oracle Database 21c e inferior.
Pré-requisitos do Banco de Dados de Mineração Downstream
Para configurar conexões de banco de dados, certifique-se de que as seguintes definições sejam feitas nas instâncias de banco de dados de origem e downstream:
-
Todos os bancos de dados devem incluir:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
STREAMS_POOL_SIZEdeve ser definido no Oracle 21c e inferior. Por exemploALTER SYSTEM SET STREAMS_POOL_SIZE = 1G; -
O banco de dados de mineração e o banco de dados de origem devem estar no modo de log de arquivamento. Para ativar o arquivamento no banco de dados, execute o comando a seguir que informa ao banco de dados para criar um log de arquivamento ao alternar os redo logs.
ALTER DATABASE ARCHIVE LOG; -
(Somente Mining Downstream) O banco de dados downstream deve ter configurações diferentes para o seguinte:
-
DBID -
DBNAME -
DB_UNIQUE_NAME -
GLOBAL_NAME
(Banco de dados Downstream Mining e banco de dados de origem) Em um ambiente downstream, o nome do banco de dados exclusivo corresponde ao nome do banco de dados.
-
-
Os arquivos de senha (
orapwSID) do banco de dados de origem e downstream são idênticos. Portanto, oremote_login_passwordfiledeve ser definido comoSHAREDouEXCLUSIVE.
Configurar Parâmetros do Banco de Dados Downstream
Use esta seção para configurar parâmetros para o modo de mineração em tempo real e o modo de mineração de arquivos, conforme necessário.
Configurações de Parâmetro para Extração Downstream no Modo de Mineração em Tempo Real
Para o Extract downstream no modo de Mining em Tempo Real, o pré-requisito principal é que o banco de dados downstream tenha arquivos de redo log stand-by configurados corretamente.
O Downstream Real-Time Mining está ativado com uma definição explícita no arquivo de Parâmetros de Extração. A configuração do LAD é independente deste modo. Se o parâmetro TRANLOGOPTIONS INTEGRATEDPARAMS (REAL_TIME_MINE Y) ainda não tiver sido definido, você precisará defini-lo para ativar o Extract downstream para o modo de mineração em tempo real:
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)Observação: Só pode haver uma Extração em tempo real no banco de dados downstream para um determinado banco de dados de origem. Outros Extratos devem ser não em tempo real. Esta é uma restrição do transporte de redo.
O seguinte comando executado no banco de dados Downstream Mining mostra o backup local que está sendo configurado usando o FRA:
ALTER SYSTEM
    SET log_archive_config='DG_CONFIG=(CDBNORTH, cdbDSC)';
ALTER SYSTEM set FAL_SERVER = 'CDBNORTH_root';
Os Arquivos de Redo Log Stand-by devem existir no banco de dados downstream. Se houver n arquivos de redo log on-line na origem, deverá haver n+1 arquivos de redo log stand-by no destino do mesmo tamanho.
Criar os Arquivos de Redo Log Stand-by no banco de dados Downstream Mining
As etapas a seguir descrevem o procedimento para adicionar arquivos de redo log stand-by ao banco de dados de mineração downstream. O seguinte resume as regras para criar os redo logs stand-by:
-
Cada arquivo de redo log stand-by deve ter pelo menos a mesma dimensão do maior arquivo de redo log do banco de dados de origem de redo. Para facilitar a administração, a Oracle recomenda que todos os arquivos de redo log no banco de dados de origem e os arquivos de redo log stand-by no banco de dados de mineração downstream tenham o mesmo tamanho.
-
O redo log stand-by deve ter pelo menos um grupo de redo log a mais do que o redo log no banco de dados de origem, para cada thread de redo no banco de dados de origem.
As etapas específicas e as instruções SQL necessárias para adicionar arquivos de redo log stand-by dependem do seu ambiente. Consulte Criando um Banco de Dados Stand-by Físico para obter instruções detalhadas sobre como adicionar arquivos de redo log stand-by a um banco de dados.
Observação: Se houver vários bancos de dados de origem enviando redo para um único banco de dados de mineração downstream, somente uma dessas origens poderá enviar redo para os redo logs stand-by do banco de dados de mineração. Um processo Extract que extrai o redo desse banco de dados de origem pode ser executado no modo em tempo real. Todos os outros bancos de dados de origem devem enviar apenas seus logs arquivados para o banco de dados de mineração downstream, e os Extracts que leem esses dados devem ser configurados para execução no modo somente log arquivado.
Para Criar Arquivos de Redo Log Stand-by
-
No SQL*Plus, conecte-se ao banco de dados de origem como um usuário administrativo.
-
Determine o tamanho do arquivo de log de origem. Anote os resultados.
SELECT BYTES FROM V$LOG; -
Determine o número de grupos de arquivos de log on-line configurados no banco de dados de origem. Anote os resultados.
SELECT COUNT(GROUP#) FROM V$LOG; -
Conecte-se ao banco de dados de mineração downstream como um usuário administrativo.
-
Adicione os grupos de arquivos de log stand-by ao banco de dados de mineração. O tamanho do arquivo de log stand-by deve ser pelo menos o tamanho do arquivo de log de origem. O número de grupos de arquivos de log stand-by deve ser pelo menos um a mais que o número de grupos de arquivos de log on-line de origem. Isso se aplica a cada instância (thread) em uma instalação RAC. Portanto, se você tiver n threads no banco de dados de origem, cada um com grupos de redo log m, configure os grupos de redo log n*(m+1) no banco de dados de mineração de downstream.
O exemplo a seguir mostra três grupos de logs stand-by.
ALTER DATABASE ADD STANDBY LOGFILE GROUP 3 ('/oracle/dbs/slog3a.rdo', '/oracle/dbs/slog3b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 4 ('/oracle/dbs/slog4.rdo', '/oracle/dbs/slog4b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 5 ('/oracle/dbs/slog5.rdo', '/oracle/dbs/slog5b.rdo') SIZE 500M; -
Confirme se os grupos de arquivos de log stand-by foram adicionados com sucesso.
SELECT GROUP#, THREAD#, SEQUENCE#, ARCHIVED, STATUS
FROM V$STANDBY_LOG;
A saída deve ser semelhante a esta:
GROUP# THREAD# SEQUENCE# ARC STATUS ---------- ---------- ---------- --- ---------- 3 0 0 YES UNASSIGNED 4 0 0 YES UNASSIGNED 5 0 0 YES UNASSIGNED -
Certifique-se de que os arquivos de log do banco de dados de origem estejam aparecendo no local especificado no atributo
LOCATIONdoLOG_ARCHIVE_DEST_nlocal definido. Talvez seja necessário alternar o arquivo de log no banco de dados de origem para ver os arquivos no diretório.
Configurar o Banco de Dados de Mineração Downstream para Arquivar Arquivos de Redo Log Stand-by Localmente
Este procedimento configura o banco de dados de mineração downstream para arquivar os redo logs stand-by que recebem dados de redo dos redo logs on-line do banco de dados de origem. Tenha em mente que os logs arquivados no exterior não devem ser arquivados na área de recuperação do banco de dados de mineração downstream.
Para Arquivar Redo Logs Stand-by Localmente:
-
No banco de dados de mineração downstream, defina o segundo destino do log de arquivamento no parâmetro de inicialização
LOG_ARCHIVE_DEST_n, conforme mostrado no exemplo a seguir.ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='LOCATION=/home/arc_dest/srl_dbms1 VALID_FOR=(STANDBY_LOGFILE,PRIMARY_ROLE)'A Oracle recomenda que os logs arquivados no exterior (logs de bancos de dados de origem remota) sejam mantidos separados dos arquivos de log do banco de dados do mining local e entre si. Não use a área de recuperação do banco de dados de mineração downstream para preparar logs arquivados externos.
-
Ative o parâmetro
LOG_ARCHIVE_DEST_2definido na etapa anterior, conforme mostrado no exemplo a seguir.ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE
Configurações de Parâmetro para Extração Downstream no Modo de Mineração de Arquivamento
Para configurar um Extract downstream no modo Archive Mining ou no modo Real-Time Mining, você deve configurar o transporte de redo. Inclua os seguintes parâmetros ao configurar o processo Extract downstream no modo Somente Log-Arquivo:
-
LOG_ARCHIVE_CONFIG -
LOG ARCHIVE DESTINATION (LAD)-
LOG_ARCHIVE_DEST_1para backup local de todos os bancos de dados -
Serviço
LOG_ARCHIVE_DEST_2para transporte de redo no banco de dados de origem
-
Observação: LOG_ARCHIVE_DEST_2 é independente do uso do Real Time Mining.
-
O destino de backup do banco de dados local é definido usando a Área de Recuperação Flash
-
FAL_SERVER -
Todos os parâmetros do sistema necessários podem ser definidos dinamicamente com
scope=both
As definições do parâmetro Destino do Log de Arquivamento (LAD) são necessárias para o destino de backup local e os serviços de transporte de redo nos bancos de dados de origem.
Configure os parâmetros LAD para o destino de backup local, usando os seguintes comandos:
ALTER SYSTEM SET db_recovery_file_dest = '/u01/app/oracle/fast_recovery_area';
ALTER SYSTEM SET db_recovery_file_dest_size = 100G;
ALTER SYSTEM SET log_archive_dest_1 = 'LOCATION=USE_DB_RECOVERY_FILE_DEST';
Configure as opções de parâmetro LAD para refazer serviços de transporte no banco de dados de origem usando os seguintes comandos:
ALTER SYSTEM SET log_archive_config = 'DG_CONFIG = (CDBNORTH, cdbDSC)';
ALTER SYSTEM
      SET log_archive_dest_2='SERVICE=cdbDSC_root
                              ASYNC
                              NOREGISTER
                              VALID_FOR=(ONLINE_LOGFILES, PRIMARY_ROLE)
                              DB_UNIQUE_NAME=cdbDSC';
Para saber mais sobre o parâmetro LOG_ARCHIVE_DEST e seus atributos, consulte LOG_ARCHIVE_DEST_n no guia Referência de Banco de Dados.
Configurar o Oracle GoldenGate Extract para Implantação Downstream
Nesta seção, você aprenderá sobre os parâmetros exigidos pelo Oracle GoldenGate para configurar conexões com bancos de dados de origem e downstream e configurar o Extract para banco de dados downstream.
Configurar o Oracle GoldenGate para Banco de Dados Downstream
O arquivo de parâmetros de Extract downstream deve incluir os seguintes parâmetros para configurar uma implantação downstream:
-
TRANLOGOPTIONS MININGUSERALIAS: Define a conexão com o banco de dados de mineração downstream para consultas internas de metadados. -
FETCHUSERIDALIAS: Estabelece conexão com o banco de dados de origem para extrair dados que não podem ser extraídos nativamente do log de transações. -
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y): Se definido como S, o Extract capturará alterações dos arquivos de redo logs stand-by no banco de dados downstream. Se não estiver definido, o Extract capturará dos arquivos de log de arquivamento.
Veja a seguir um exemplo do arquivo de parâmetros Extract, incluindo estes parâmetros:
EXTRACT EXTDSC
USERIDALIAS cgg_CDBNORTH
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)
FETCHUSERIDALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate

EXTTRAIL Downstream/ea
SOURCECATALOG CDBNORTH_PDB1
DDL INCLUDE MAPPED
TABLE HR.*;
Siga as etapas fornecidas para configurar a implantação do Oracle GoldenGate para o Extract downstream:
-
Adicione credenciais para o banco do dados de origem:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@CDBNORTH_root ALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate PASSWORD password -
Adicione credenciais para o banco de dados downstream:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@cdbDSC_root ALIAS cgg_cdbDSC DOMAIN OracleGoldenGate PASSWORD *password* -
Use
DBLOGINpara estabelecer conexão com o banco de dados de origem e o banco de dados downstream do Oracle GoldenGate:DBLOGIN USERIDALIAS cgg_CDBNORTHMININGDBLOGIN USERIDALIAS cgg_cdbDSCNeste exemplo,
cgg_CDBNORTHé o alias de credencial do banco de dados de origem CDBNORTH ecgg_cdbDSCé o alias de credencial do banco de dados de mineração. -
Adicione e registre um Extract, edite o arquivo de parâmetros para incluir os parâmetros Extract fornecidos anteriormente, adicione o nome e o local da trilha Extract e inicie o processo Extract:
ADD EXTRACT extdsc, INTEGRATED TRANLOG, BEGIN NOW
REGISTER EXTRACT extdsc, DATABASE CONTAINER (CDBNORTH_PDB01)

ADD EXTTRAIL Downstream/ea, EXTRACT extdsc
START extdsc
Configurar Extração Downstream em Cascata Usando o Active Data Guard
Se não for possível estabelecer uma conexão com o banco de dados de origem, GoldenGate poderá ser configurado para usar um banco de dados stand-by do Active Data Guard (ADG). O banco de dados stand-by está disponível para conexões somente para leitura para executar consultas de metadados e extração. Nesta seção, você aprenderá a configurar um Extract Downstream usando o ADG e sem estabelecer uma conexão com o banco de dados de origem.
Ativar Extração Downstream para Trabalhar com ADG
Em um ambiente de captura downstream em cascata, o banco de dados downstream não se conecta diretamente ao banco de dados de origem. Ele usa o Active Data Guard (ADG) para extrair e consultas de metadados.
A extração deve ser iniciada usando a opção sourceless para que não se conecte ao banco de dados de origem e, em vez disso, se conecte ao ADG usando FETCHUSERID ou FETCHUSERIDALIAS quando precisar extrair tipos de dados não nativos. Por exemplo, as operações FETCH são processadas no banco de dados ADG, pois essa instância está aberta no modo somente leitura. Outras operações que não podem ser processadas na instância do ADG, como criar o build do dicionário, são redirecionadas do ADG para o banco de dados de origem.
Ao registrar um Extract downstream, o Oracle GoldenGate se conecta ao ADG como banco de dados de origem, em vez do banco de dados no qual o redo se origina. O redirecionamento do ADG é suportado para os seguintes comandos e parâmetros:
-
SCHEMATRANDATA -
TRANDATA -
FLUSH SEQUENCE -
TRACETABLE -
HEARTBEATTABLE -
REGISTER EXTRACTObservação:SCHEMATRANDATAeTRANDATA, mesmo que o comando seja executado no redo log stand-by, os grupos de logs reais são criados e mantidos no banco de dados principal em que as operações DML reais ocorrem.
O ADG Redirection está disponível com o Oracle Database 21c e versões mais recentes. Ele também suporta o registro curinga. O exemplo a seguir mostra o arquivo de parâmetros Extract do Extract downstream quando o ADG é usado:
EXTRACT EXTDSC
NOUSERID
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC_src DOMAIN OracleGoldenGate
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y) FETCHUSERIDALIAS cgg_cdbADG_src DOMAIN OracleGoldenGate

EXTTRAIL cascade/ea
SOURCECATALOG CDBNORTH_PDB01
DDL INCLUDE MAPPED
TABLE HR.*;
Estas são as etapas para permitir que o Extract downstream funcione com o ADG Stand-by:
-
Adicione um
LOG_ARCHIVE_DESTINATION_N (LAD)adicional no stand-by ADG, conforme mostrado no seguinte exemplo:ALTER SYSTEM SET LOG_ARCHIVE_DEST_3='service=mining_db_service_name ASYNC NOREGISTER VALID_FOR(STANDBY_LOGFILES,STANDBY_ROLES) DB_UNIQUE_NAME=3rd_db_unique_name' scope=bothEssa etapa transporta e gera o
standby_logfilespara um stand-by do ADG. -
Defina o
LOG_ARCHIVE_CONFIGno stand-by ADG para enviar os logs para o banco de dados de mineração, conforme mostrado no seguinte exemplo:ALTER SYSTEM SET LOG_ARCHIVE_CONFIG = 'DG_CONFIG' = (CDBNORTH, cdbADG_src, cdbDSC)';DB_CONFIGé o nome exclusivo do primeiro, segundo e terceiro bancos de dados. -
No banco de dados de mineração, configure o local para armazenar o standby_logfiles de entrada no banco de dados de mineração, conforme mostrado no seguinte exemplo:
ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='location= /home/arc_dest/dstrm VALID_FOR=(STANDBY_LOGFILE,ALL_ROLES)' scope=bothem que
/home/arc_dest/dstrmé o local dos logs de arquivamento externos. Não use o FRA para armazenar logs de arquivo externo. -
Execute
LOG_ARCHIVE_CONFIGno banco de dados de mineração, para que o processo Extract possa lê-los no banco de dados de mineração, conforme mostrado no seguinte exemplo:ALTER SYSTEM SET LOG_ARCHIVE_CONFIG ='DG_CONFIG' scope=bothAqui,
DB_CONFIGé o nome exclusivo do primeiro, segundo e terceiro bancos de dados. -
Para um Extract downstream, você precisa garantir que as conexões do banco de dados estejam configuradas adequadamente. Ao registrar o Extract, certifique-se de que a conexão
DBLOGINseja feita com o ADG Stand-by, que está aberto para atividade somente leitura. -
Para adicionar o Extract e registrá-lo, use o seguinte comando:
DBLOGIN USERID ggadmin@cdbADG_src, PASSWORD ggadmin
MININGDBLOGIN USERID ggadmin@cgg_cdbDSC, password ggadmin
cdbADG_src não é o ADG principal.
cgg_cdbDSC é o banco de dados de mineração.
-
Agora, registre um Extract que use o parâmetro
NOUSERID:ADD EXTRACT exte, INTEGRATED TRANLOG, BEGIN NOW REGISTER EXTRACT exte DATABASE -
Depois que o Extract for registrado, você poderá usar esse Extract para extrair dados e iniciar o Extract normalmente.