Inteligência Artificial no Oracle AI Database
Este capítulo descreve os recursos de inteligência artificial fornecidos no Oracle AI Database.
-
Visão geral do Oracle AI Vector Search O Oracle AI Vector Search foi projetado para cargas de trabalho de Inteligência Artificial (IA) e permite que você consulte dados com base em semântica, em vez de palavras-chave.
-
Métricas de Distância do Vetor A medição de distâncias em um espaço vetorial está no centro da identificação dos resultados mais relevantes para um determinado vetor de consulta. Esse processo é muito diferente da conhecida filtragem de palavras-chave no mundo do banco de dados relacional.
-
Visão Geral de Índices de Mundo Pequeno Navegáveis Hierárquicos Use esses exemplos para entender como criar índices HNSW para pesquisas de similaridade aproximada do vetor.
-
Entender Índices de Vetor Simples de Arquivo Invertido O índice de vetor Simples de Arquivo Invertido é uma técnica projetada para aumentar a eficiência da pesquisa, restringindo a área de pesquisa por meio do uso de partições ou clusters vizinhos.
-
Executando Pesquisas de Similaridade Esta seção descreve os métodos para executar pesquisas de similaridade.
Visão Geral do Oracle AI Vector Search
O Oracle AI Vector Search foi projetado para cargas de trabalho de Inteligência Artificial (IA) e permite que você consulte dados com base em semântica, em vez de palavras-chave.
Tipo de Dados do VECTOR
O tipo de dados VECTOR foi introduzido com o lançamento do Oracle AI Database 26ai, fornecendo a base para armazenar incorporações de vetores juntamente com dados de negócios no banco de dados. Usando modelos de incorporação, você pode transformar dados não estruturados em incorporações vetoriais que podem ser usadas para consultas semânticas em dados de negócios. Para usar o tipo de dados VECTOR e seus recursos relacionados, o parâmetro de inicialização COMPATIBLE deve ser definido como 23.4.0 ou mais recente. Para obter mais informações sobre o parâmetro e como alterá-lo, consulte o Oracle AI Database Upgrade Guide.
Consulte o seguinte exemplo básico de como usar o tipo de dados VECTOR em uma definição de tabela:
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);Para obter mais informações sobre o tipo de dados VECTOR e como usar vetores em tabelas, consulte Criar Tabelas Usando o Tipo de Dados VECTOR.
Devido à natureza numérica do tipo de dados VECTOR, você pode usá-lo como uma entrada para os algoritmos de aprendizado de máquina, como classificação, anomalia, regressão, clusterização e extração de recursos. Mais detalhes sobre o uso do tipo de dados VECTOR no machine learning podem ser encontrados no Suporte a Tipos de Dados Vetores. Observação: O suporte para machine learning do tipo de dados VECTOR está disponível em todas as versões que começam com a versão 23.7.
Incorporações de Vetores
Se você já usou aplicativos como assistentes de voz, chatbots, tradutores de idiomas, sistemas de recomendação, detecção de anomalias ou pesquisa e reconhecimento de vídeo, você usou implicitamente recursos de incorporação de vetores.
O Oracle AI Vector Search armazena incorporações de vetores, que são representações de vetores matemáticos de pontos de dados. Essas incorporações de vetores descrevem o significado semântico por trás do conteúdo, como palavras, documentos, faixas de áudio ou imagens. Por exemplo, ao fazer pesquisas baseadas em texto, a pesquisa vetorial é muitas vezes considerada melhor do que a pesquisa por palavras-chave, pois a pesquisa vetorial é baseada no significado e no contexto por trás das palavras e não nas próprias palavras. Essa representação vetorial traduz a similaridade semântica de objetos, conforme percebido pelos humanos, em proximidade em um espaço vetorial matemático. Este espaço vetorial geralmente tem muitas centenas, se não milhares, de dimensões. Em outras palavras, incorporações de vetores são uma forma de representar quase qualquer tipo de dados, como texto, imagens, vídeos, usuários ou música como pontos em um espaço multidimensional onde as localizações desses pontos no espaço e a proximidade com os outros são semanticamente significativas.
Este diagrama simplificado ilustra um espaço vetorial onde as palavras são codificadas como vetores de 2 dimensões.
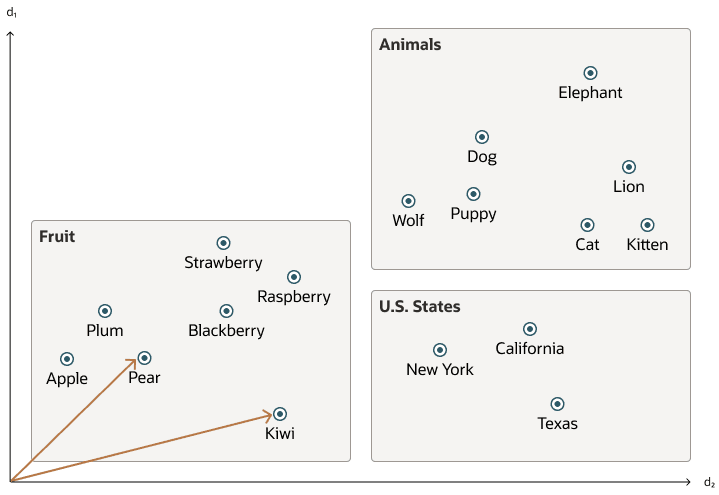
Descrição da ilustração vector_embeddings.png
Pesquisa de Similaridade
Pesquisar similaridade semântica em um conjunto de dados agora é equivalente a pesquisar vizinhos mais próximos em um espaço vetorial em vez de usar pesquisas de palavras-chave tradicionais usando predicados de consulta. Conforme ilustrado no diagrama a seguir, a distância entre dog e wolf nesse espaço vetorial é menor que a distância entre dog e kitten. Neste espaço, um cão é mais semelhante a um lobo do que a um gatinho. Consulte Executar Pesquisa de Similaridade Exata para obter mais informações.
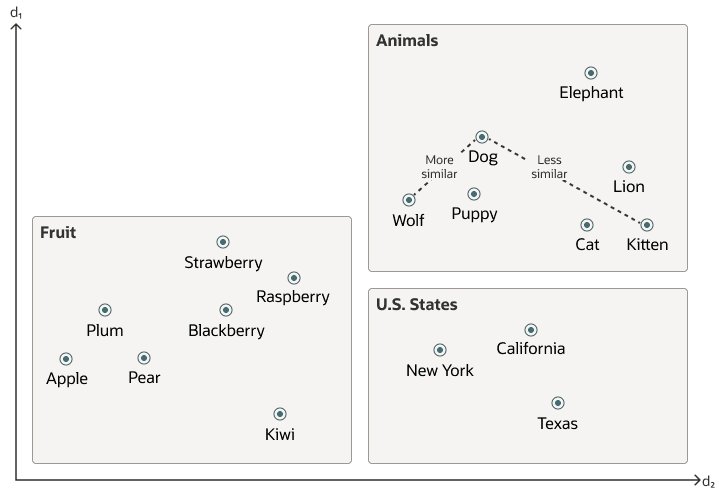
Descrição da ilustração vector_embeddings_similarity.png
Os dados vetoriais tendem a ser distribuídos de forma desigual e agrupados em grupos que são semanticamente relacionados. Fazer uma pesquisa de similaridade com base em um determinado vetor de consulta é equivalente a recuperar os vetores K-nearest para seu vetor de consulta em seu espaço vetorial. Basicamente, você precisa encontrar uma lista ordenada de vetores classificando-os, onde a primeira linha da lista é o vetor mais próximo ou mais semelhante ao vetor de consulta, a segunda linha da lista é o segundo vetor mais próximo do vetor de consulta e assim por diante. Ao fazer uma pesquisa de similaridade, a ordem relativa das distâncias é o que realmente importa, em vez da distância real.
Usando o espaço vetorial anterior, aqui está uma ilustração de uma pesquisa semântica em que seu vetor de consulta é o correspondente à palavra Cachorrinho e você deseja identificar as quatro palavras mais próximas:
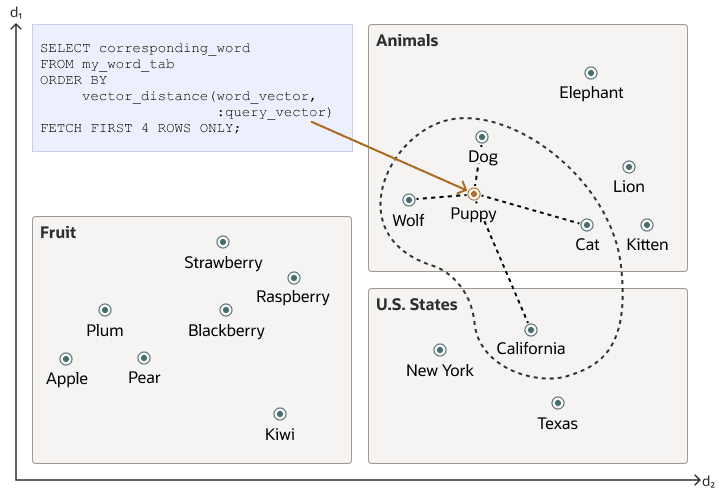
Descrição da ilustração vector_embeddings_similarity_search.png
As pesquisas de similaridade tendem a obter dados de um ou mais clusters, dependendo do valor do vetor de consulta e do tamanho da extração.
Pesquisas aproximadas usando índices vetoriais podem limitar as pesquisas a clusters específicos, enquanto pesquisas exatas visitam vetores em todos os clusters. Consulte Usar Índices de Vetor para obter mais informações.
Modelos de Incorporação de Vetor
Uma maneira de criar tais incorporações vetoriais poderia ser usar a experiência de domínio de alguém para quantificar um conjunto predefinido de recursos ou dimensões, como forma, textura, cor, sentimento e muitos outros, dependendo do tipo de objeto com o qual você está lidando. No entanto, a eficiência deste método depende do caso de uso e nem sempre é rentável.
Em vez disso, incorporações vetoriais são criadas através de redes neurais. A maioria das incorporações vetoriais modernas usa um modelo de transformador, como ilustrado pelo diagrama a seguir, mas redes neurais convolucionais também podem ser usadas.
Figura 1: Modelo de incorporação de vetores
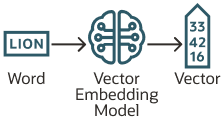
Descrição da ilustração basic_transform.png
Dependendo do tipo de dados, você pode usar diferentes modelos de código aberto pré-treinados para criar incorporações de vetores. Por exemplo:
-
Para dados textuais, os transformadores de frases transformam palavras, frases ou parágrafos em incorporações vetoriais.
-
Para dados visuais, você pode usar a Rede Residual (ResNet) para gerar incorporações de vetores.
-
Para dados de áudio, você pode usar a representação do espectrograma visual dos dados de áudio para voltar ao caso de dados visuais.
Cada modelo também determina o número de dimensões para seus vetores. Por exemplo:
-
O modelo de incorporação da Cohere em inglês-v3.0 tem 1024 dimensões.
-
O modelo de incorporação de texto-embedding-3-large da OpenAI tem 3072 dimensões.
-
O modelo de incorporação da Hugging Face all-MiniLM-L6-v2 tem 384 dimensões
Claro, você sempre pode criar seu próprio modelo que é treinado com seu próprio conjunto de dados.
Importar Modelos Incorporados para o Oracle AI Database
Embora você possa gerar incorporações de vetores fora do Oracle AI Database usando modelos de incorporação de código aberto pré-treinados ou seus próprios modelos de incorporação, você também tem a opção de importar esses modelos diretamente para o Oracle AI Database se eles forem compatíveis com o padrão Open Neural Network Exchange (ONNX). O Oracle AI Database implementa um runtime ONNX diretamente no banco de dados. Isso permite gerar incorporações de vetores diretamente no Oracle AI Database usando SQL. Consulte Gerar Incorporações de Vetor para obter mais informações.
Métricas de Distância do Vetor
Medir distâncias em um espaço vetorial é o cerne da identificação dos resultados mais relevantes para um determinado vetor de consulta. Esse processo é muito diferente da conhecida filtragem de palavras-chave no mundo do banco de dados relacional.
Ao trabalhar com vetores, existem várias maneiras de calcular distâncias para determinar o quão semelhantes, ou diferentes, dois vetores são. Cada métrica de distância é calculada usando diferentes fórmulas matemáticas. O tempo necessário para calcular a distância entre dois vetores depende de muitos fatores, incluindo a métrica de distância usada, bem como o formato dos próprios vetores, como o número de dimensões vetoriais e os formatos de dimensão vetorial. Geralmente, é melhor combinar a métrica de distância que você usa com a que foi usada para treinar o modelo de incorporação vetorial que gerou os vetores.
Visão Geral de Índices de Pequeno Mundo Navegáveis Hierárquicos
Use esses exemplos para entender como criar índices HNSW para pesquisas de similaridade aproximada do vetor.
Com Navigable Small World (NSW), a ideia é construir um gráfico de proximidade onde cada vetor no gráfico se conecta a vários outros com base em três características:
-
A distância entre os vetores
-
O número máximo de candidatos vetoriais mais próximos considerados em cada etapa da pesquisa durante a inserção
(EFCONSTRUCTION) -
O número máximo de conexões (
NEIGHBORS) permitidas por vetor
Se a combinação dos limites acima for muito alta, você poderá acabar com um gráfico densamente conectado, o que pode retardar o processo de pesquisa. Por outro lado, se a combinação desses limiares for muito baixa, o gráfico poderá se tornar muito esparso e/ou desconectado, o que torna desafiador encontrar um caminho entre determinados vetores durante a pesquisa.
A travessia do gráfico Navigable Small World (NSW) para pesquisa vetorial começa com um ponto de entrada predefinido no gráfico, acessando um cluster de vetores intimamente relacionados. O algoritmo de pesquisa emprega duas listas de chaves: Candidatos, uma lista atualizada dinamicamente de vetores que encontramos durante a travessia do gráfico, e Resultados, que contém os vetores mais próximos do vetor de consulta encontrado até agora. À medida que a pesquisa avança, o algoritmo navega pelo gráfico, refinando continuamente os Candidatos, explorando e avaliando vetores que podem estar mais próximos do que os dos Resultados. O processo conclui uma vez que não há vetores nos Candidatos mais próximos do que o mais distante nos Resultados, indicando que um mínimo local foi atingido e os vetores mais próximos do vetor de consulta foram identificados.
Isso é ilustrado no seguinte gráfico:
Figura 2: Gráfico de mundo pequeno navegável
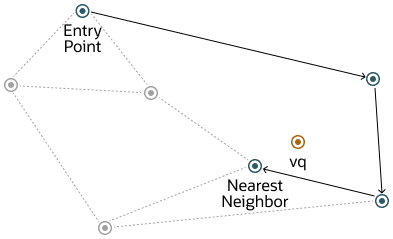
Descrição da ilustração navigable-small-world-graph.png
O método descrito demonstra desempenho robusto até uma certa escala de inserção vetorial no gráfico. Além desse limite, a abordagem Hierarchical Navigable Small World (HNSW) aprimora o modelo NSW introduzindo uma hierarquia de várias camadas, semelhante à estrutura observada nas Listas de Pular Probabilísticas. Essa arquitetura hierárquica é implementada distribuindo as conexões do gráfico em várias camadas, organizando-as de maneira que cada camada subsequente contenha um subconjunto dos vetores da camada abaixo. Essa estratificação garante que as camadas superiores capturem links de longa distância, efetivamente servindo como caminhos expressos em todo o gráfico, enquanto as camadas inferiores se concentram em links mais curtos, facilitando a navegação local refinada. Como resultado, as pesquisas começam nas camadas mais altas para se aproximar rapidamente da região do vetor alvo, movendo-se progressivamente para camadas mais baixas para uma pesquisa mais precisa, melhorando significativamente a eficiência e a precisão da pesquisa, aproveitando links mais curtos (distâncias menores) entre vetores à medida que se move da camada superior para a inferior.
Para entender melhor como isso funciona para o HNSW, vamos analisar como essa hierarquia é usada para a estrutura de Lista de Ignorar Probabilidade:
Figura 3: Estrutura da Lista de Ignorar Probabilidade
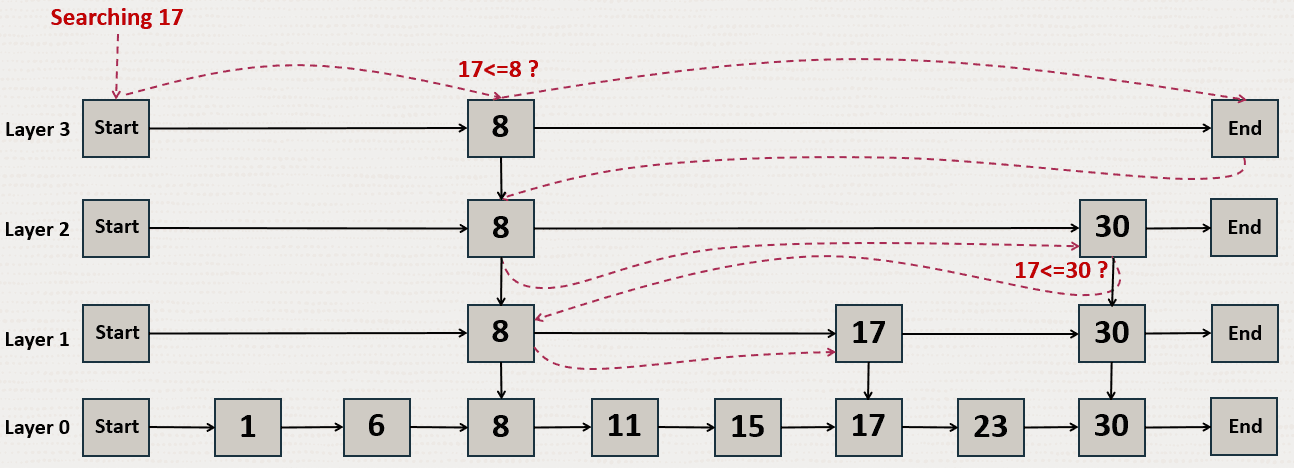
Descrição da ilustração Probabilidade de Ignorar-list_01.png
A estrutura Ignorar lista de probabilidades usa várias camadas de listas vinculadas nas quais as camadas acima estão ignorando mais números do que as inferiores. Neste exemplo, você está tentando procurar o número 17. Você começa com a camada superior e pula para o próximo elemento até encontrar 17, chegar ao final da lista ou encontrar um número maior que 17. Quando você chega ao final de uma lista ou encontra um número maior que 17, então você começa na camada anterior do número mais recente menor que 17.
O HNSW usa o mesmo princípio com as camadas NSW, onde você encontra maiores distâncias entre os vetores nas camadas superiores. Isso é ilustrado pelos seguintes diagramas em um espaço 2D:
Na camada superior estão as bordas mais longas e na camada inferior estão as mais curtas.
Figura 4: Gráficos de mundo pequeno navegável hierárquico
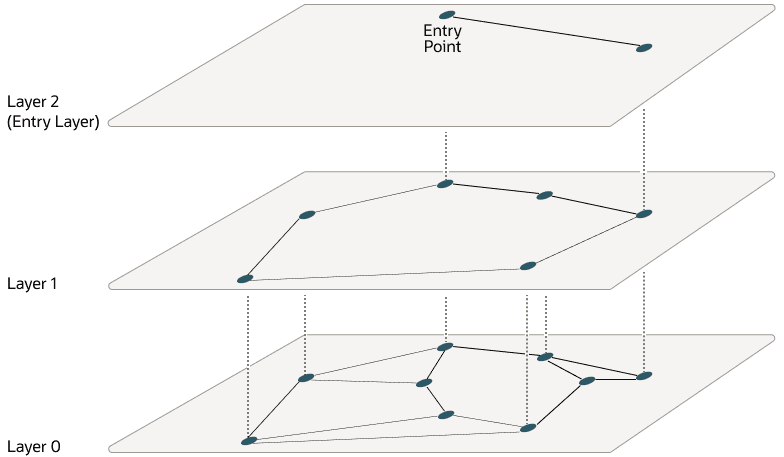
Descrição da ilustração hierarquical-navigable-small-world-graph_02.png
A partir da camada superior, a pesquisa em uma camada começa no vetor de entrada. Em seguida, para cada nó, se houver um vizinho mais próximo do vetor de consulta do que o nó atual, ele salta para esse vizinho. O algoritmo continua fazendo isso até encontrar um mínimo local para o vetor de consulta. Quando um mínimo local é encontrado em uma camada, a pesquisa vai para a próxima camada usando o mesmo vetor nessa nova camada e a pesquisa continua nessa camada. Este processo se repete até que o mínimo local da camada inferior seja encontrado, que contém todos os vetores. Neste ponto, a pesquisa é transformada em uma pesquisa de similaridade aproximada usando o algoritmo NSW em torno do último mínimo local encontrado para extrair os principais vetores k mais semelhantes ao seu vetor de consulta. Enquanto as camadas superiores podem ter um máximo de conexões para cada vetor definido pelo parâmetro NEIGHBORS, a camada 0 pode ter o dobro. Este processo é ilustrado no seguinte gráfico:
Figura 5: Busca de gráficos de mundo pequeno navegável hierárquico
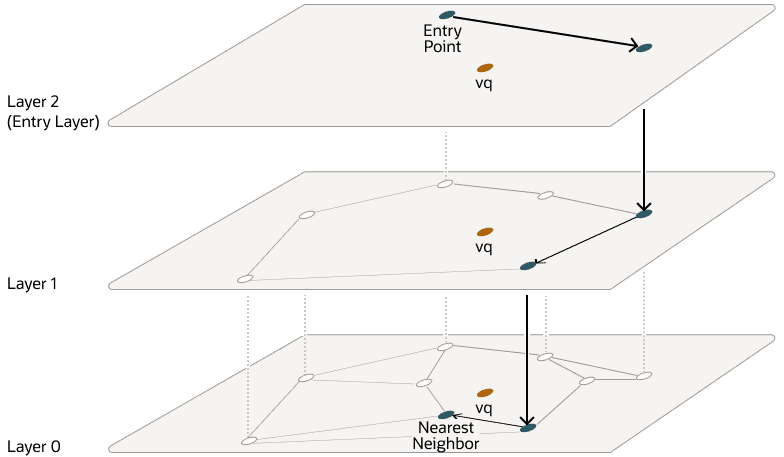
Descrição da ilustração hnsw-search-graph_02-png.png
As camadas são implementadas usando gráficos na memória (não o gráfico do Oracle Inmemory). Cada camada usa um gráfico separado na memória. Como já foi visto, ao criar um índice HNSW, você pode ajustar o número máximo de conexões por vetor nas camadas superiores usando o parâmetro NEIGHBORS, bem como o número máximo de candidatos vetoriais mais próximos considerados em cada etapa da pesquisa durante a inserção usando o parâmetro EFCONSTRUCTION, em que EF significa Enter Factor.
Conforme explicado anteriormente, ao usar o Oracle AI Vector Search para executar uma consulta de pesquisa aproximada usando índices HNSW, você tem a possibilidade de especificar uma precisão de destino na qual a pesquisa aproximada deve ser executada.
No caso de uma pesquisa aproximada HNSW, você pode especificar um valor de porcentagem de precisão de destino para influenciar o número de candidatos considerados para sondar a pesquisa. Isso é calculado automaticamente pelo algoritmo. O valor 100 tenderá a impor um resultado semelhante como uma pesquisa exata, embora o sistema ainda possa usar o índice e não executará uma pesquisa exata. O otimizador pode optar por ainda usar um índice, pois pode ser mais rápido fazê-lo, dados os predicados na consulta. Em vez de especificar um valor percentual de precisão de destino, você pode especificar o parâmetro EFSEARCH para impor um determinado número máximo de candidatos a serem considerados durante a sondagem do índice. Quanto maior esse número, maior a precisão.
Observação:
-
Se você não especificar nenhuma precisão de destino em sua consulta de pesquisa aproximada, herdará o conjunto quando o índice tiver sido criado. Você verá que, na criação do índice, é possível especificar uma precisão de destino usando um valor de porcentagem ou valores de parâmetros, dependendo do tipo de índice que você está criando.
-
É possível especificar uma precisão de destino diferente na pesquisa de índice em comparação com a definida na criação do índice. Para índices HNSW, você pode observar mais vizinhos usando o parâmetro
EFSEARCH(maior que o valorEFCONSTRUCTIONespecificado na criação do índice) para obter resultados mais precisos. A precisão do alvo que você fornece durante a criação do índice decide os parâmetros de criação do índice e também atua como os valores de precisão padrão para pesquisas de índice vetorial.
Compreender Índices de Vetor Simples de Arquivo Invertido
O índice de vetores planos de arquivos invertidos é uma técnica projetada para aumentar a eficiência da pesquisa, restringindo a área de pesquisa por meio do uso de partições ou clusters vizinhos.
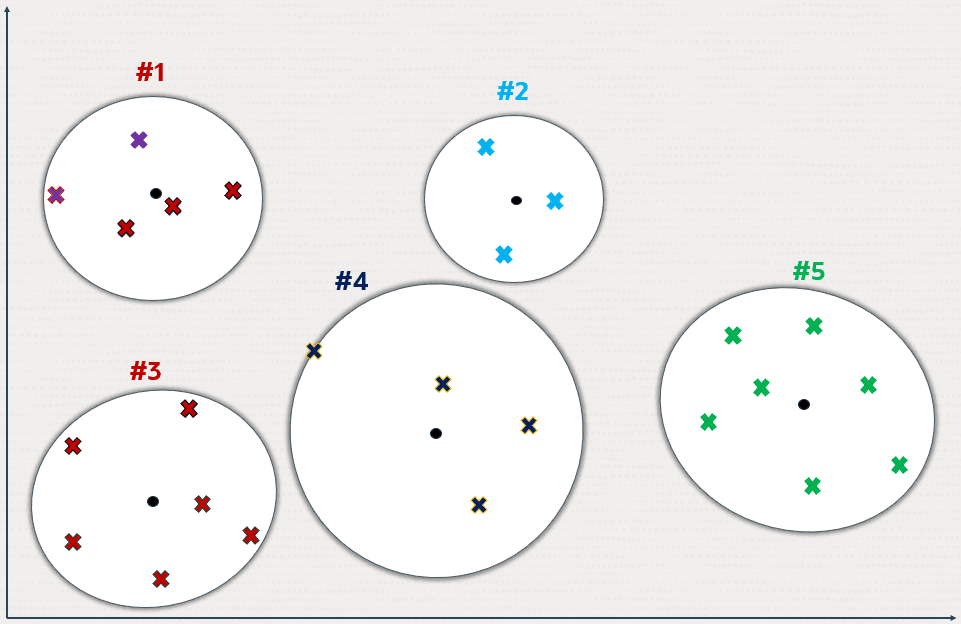
Os diagramas a seguir descrevem como as partições ou clusters são criados em uma pesquisa aproximada feita usando uma representação de espaço 2D. Mas isso pode ser generalizado para espaços dimensionais muito mais elevados.
Figura 6: Índice Simples de Arquivo Invertido Usando 2D
Descrição da ilustração inverted-file-index_1.png
As cruzes representam os pontos de dados vetoriais neste espaço.
Novos pontos de dados, mostrados como pequenos círculos simples, são adicionados para identificar os centróides da partição k, onde o número de centróides (k) é determinado pelo tamanho do conjunto de dados (n). Geralmente, k é definido como a raiz quadrada de n, embora possa ser ajustado especificando o parâmetro NEIGHBOR PARTITIONS durante a criação do índice.
Cada centroide representa o vetor médio (centro de gravidade) da partição correspondente.
Os centróides são calculados por meio de uma passagem de treinamento sobre os vetores cujo objetivo é minimizar a distância total de cada vetor do centróide mais próximo.
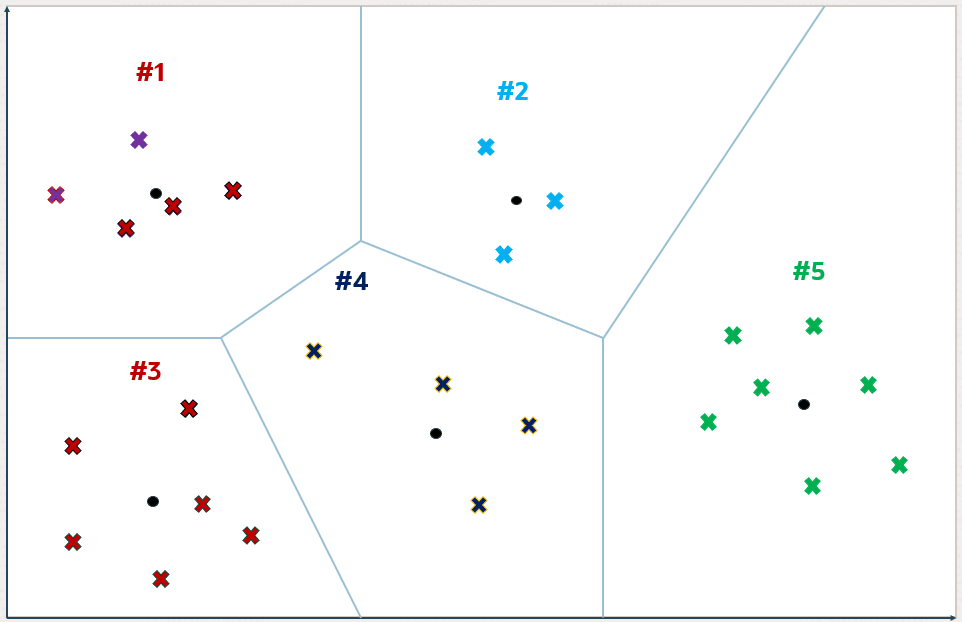
Os centróides acabam particionando o espaço vetorial em partições k. Esta divisão é conceitualmente ilustrada como círculos em expansão dos centróides que param de crescer à medida que se encontram, formando partições distintas.
Figura 7: Índice Simples de Arquivo Invertido
Descrição da ilustração inverted-file-index_5.png
Exceto para aqueles na periferia, cada vetor cai dentro de uma partição específica associada a um centroide.
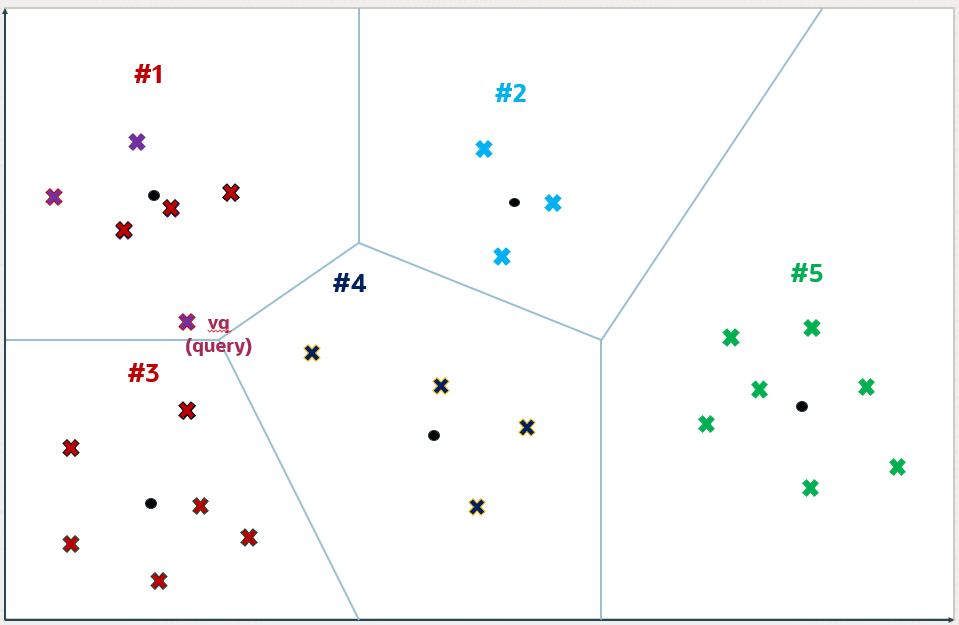
Figura 8: Índice Simples de Arquivo Invertido
Descrição da ilustração inverted-file-index_6.png
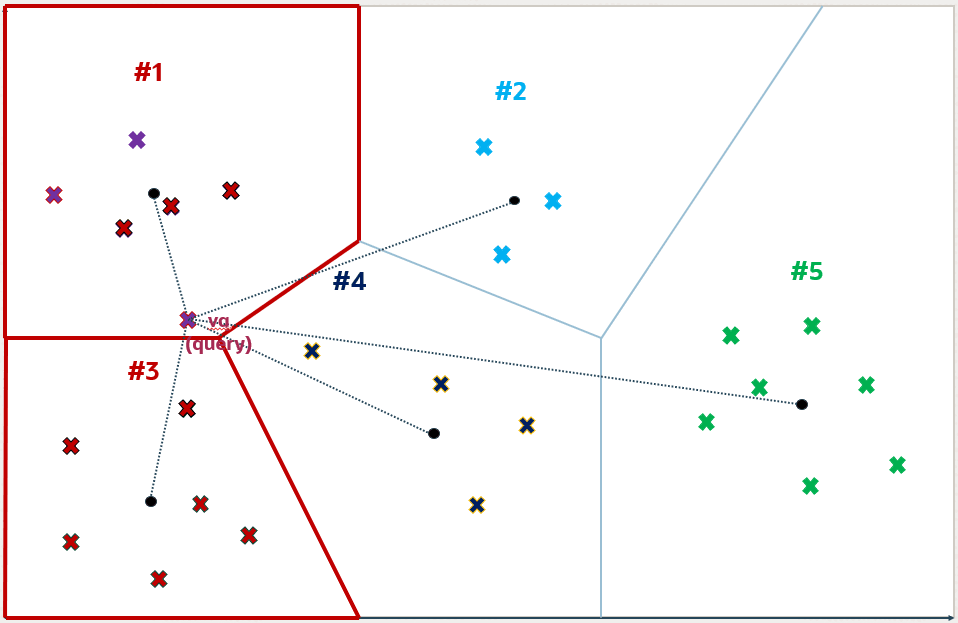
Para um vetor de consulta vq, o algoritmo de pesquisa identifica os centroides i mais próximos, em que i assume como padrão a raiz quadrada de k, mas pode ser ajustado para uma consulta específica definindo o parâmetro NEIGHBOR PARTITION PROBES. Esse ajuste permite uma compensação entre a velocidade e a precisão da pesquisa.
Números mais altos para este parâmetro resultarão em maior precisão. Neste exemplo, i é definido como 2 e as duas partições identificadas são as partições número 1 e 3.
Figura 9: Índice Simples de Arquivo Invertido
Descrição da ilustração inverted-file-index_7.png
Depois que as partições i são determinadas, elas são totalmente verificadas para identificar, neste exemplo, os 5 principais vetores mais próximos. Esse número 5 pode ser diferente de k e você especifica esse número na sua consulta. Os cinco vetores mais próximos de vq encontrados nas partições número 1 e 3 são destacados no diagrama a seguir.
Este método constitui uma busca aproximada, pois limita a busca a um subconjunto de partições, acelerando assim o processo, mas potencialmente faltando vetores mais próximos em partições não examinadas. Este exemplo ilustra que uma pesquisa aproximada pode não produzir os vetores mais próximos exatos para vq, demonstrando a compensação inerente entre a eficiência e a precisão da pesquisa.
Figura 10: Índice Simples de Arquivo Invertido
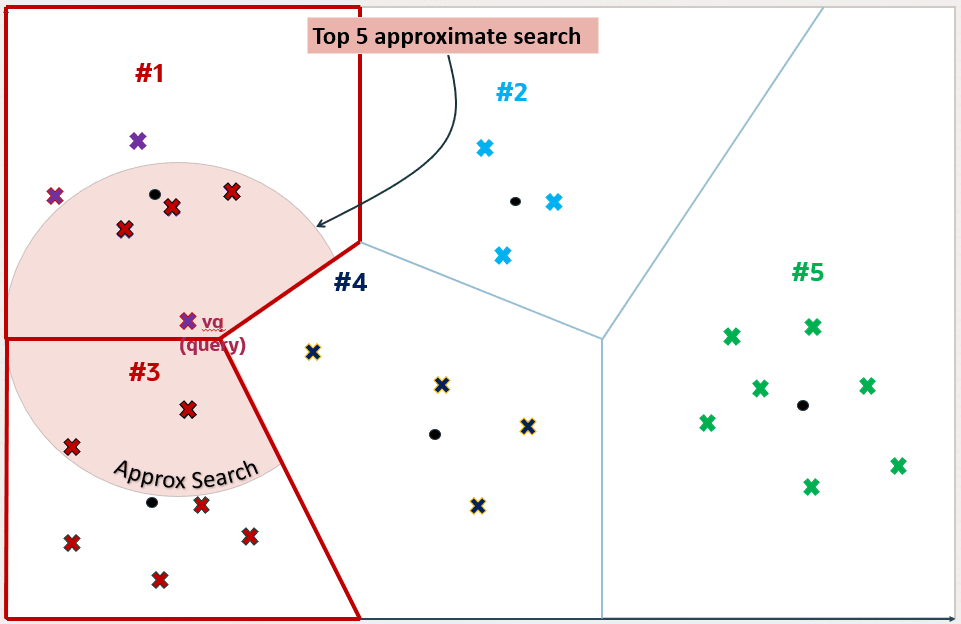
Descrição da ilustração inverted-file-index_10.png
No entanto, os cinco vetores mais próximos de vq não são os encontrados pela pesquisa aproximada. Você pode ver que um dos vetores na partição número 4 está mais próximo de vq do que um dos vetores recuperados na partição número 3.
Figura 11: Índice Simples de Arquivo Invertido
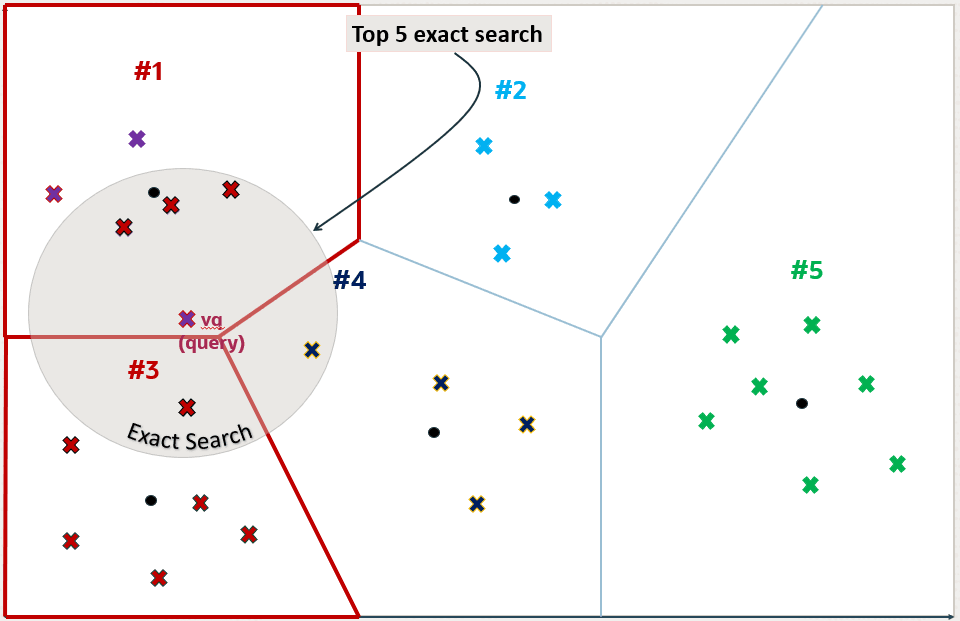
Descrição da ilustração inverted-file-index_11.png
Agora você pode ver por que usar pesquisas de índice vetorial nem sempre é uma pesquisa exata e é chamada de pesquisa aproximada. Neste exemplo, a precisão aproximada da pesquisa é de apenas 80%, pois recuperou apenas 4 de 5 dos resultados exatos dos vetores de pesquisa.
Figura 12: Índice Simples de Arquivo Invertido
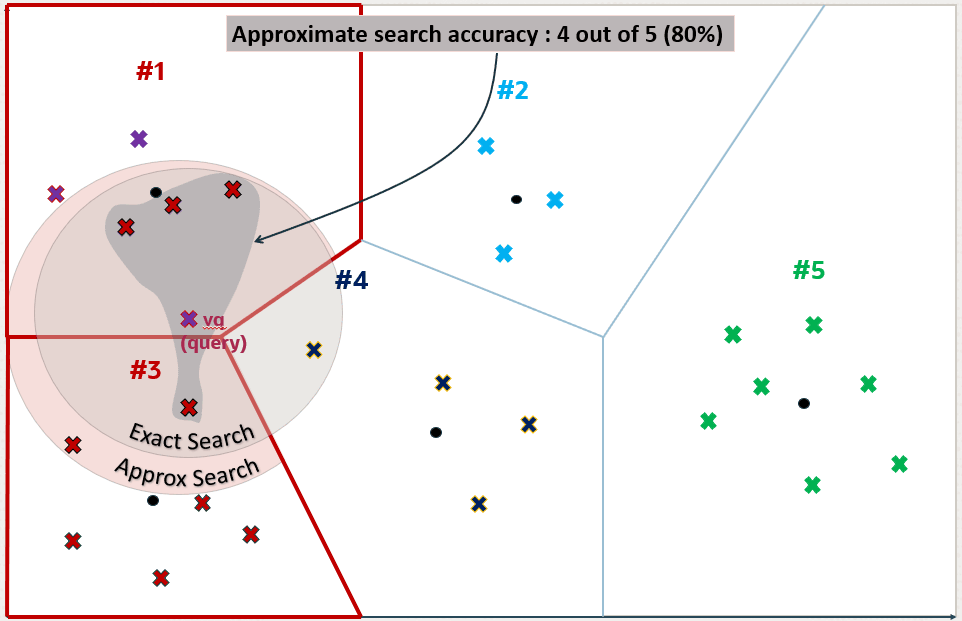
Descrição da ilustração inverted-file-index_12.png
Ao usar o Oracle AI Vector Search para executar uma consulta de pesquisa aproximada usando índices vetoriais, você tem a possibilidade de especificar uma precisão de destino na qual a pesquisa aproximada deve ser executada.
No caso de uma pesquisa aproximada de FIV, é possível especificar um valor percentual de precisão alvo para influenciar o número de partições usadas para sondar a pesquisa. Isso é calculado automaticamente pelo algoritmo. O valor 100 tenderá a impor uma pesquisa exata, embora o sistema ainda possa usar o índice e não executará uma pesquisa exata. O otimizador pode optar por ainda usar um índice, pois pode ser mais rápido fazê-lo, dados os predicados na consulta. Em vez de especificar um valor percentual de precisão de destino, você pode especificar o parâmetro NEIGHBOR PARTITION PROBES para impor um determinado número máximo de partições a serem investigadas pela pesquisa. Quanto maior esse número, maior a precisão.
Observação:
-
Se você não especificar nenhuma precisão de destino em sua consulta de pesquisa aproximada, herdará o conjunto quando o índice tiver sido criado. Você verá que, no momento da criação do índice, é possível especificar uma precisão de destino usando um valor de porcentagem ou valores de parâmetros, dependendo do tipo de índice que você está criando.
-
É possível especificar uma precisão de destino diferente na pesquisa de índice, em comparação com a definida na criação do índice. Para índices de FIV, você pode sondar partições mais centróides usando o parâmetro
NEIGHBOR PARTITION PROBESpara obter resultados mais precisos. A precisão do alvo que você fornece durante a criação do índice decide os parâmetros de criação do índice e também atua como o valor de precisão padrão para pesquisas de índice vetorial.
Executando Pesquisas de Similaridade
Esta seção descreve os métodos para executar pesquisas de similaridade.
-
Executar Pesquisa de Similaridade Exata Uma pesquisa de similaridade procura a ordem relativa dos vetores em comparação com um vetor de consulta. Naturalmente, a comparação é feita usando uma métrica de distância específica, mas o que é importante é o conjunto de resultados de seus vetores mais próximos, não a distância entre eles.
-
Entenda a Pesquisa Aproximada de Similaridade Usando Índices Vetoriais Para velocidades de pesquisa mais rápidas com grandes espaços vetoriais, você pode usar a pesquisa de similaridade aproximada usando índices vetoriais.
-
Executar Pesquisa de Similaridade de Vários Vetores Outro caso de uso principal da pesquisa de vetores é a pesquisa de vários vetores. A pesquisa com vários vetores geralmente está associada a uma pesquisa com vários documentos, na qual os documentos são divididos em partes que são incorporadas individualmente aos vetores.
Executar Pesquisa Exata de Similaridade
Uma pesquisa de similaridade procura a ordem relativa dos vetores em comparação com um vetor de consulta. Naturalmente, a comparação é feita usando uma métrica de distância específica, mas o que é importante é o conjunto de resultados de seus vetores mais próximos, não a distância entre eles.
Como exemplo, e dado um determinado vetor de consulta, você pode calcular sua distância para todos os outros vetores em seu conjunto de dados. Este tipo de pesquisa, também chamado de pesquisa plana, ou pesquisa exata, produz os resultados mais precisos com qualidade de pesquisa perfeita. No entanto, isso é feito ao custo de tempos de pesquisa significativos. Isso é ilustrado pelos seguintes diagramas:
Figura 13: Pesquisa Exata
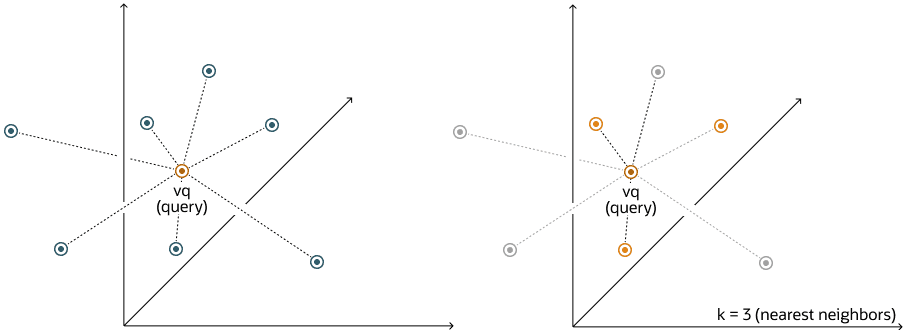
Descrição da ilustração flat-index.png
Com uma pesquisa exata, você compara o vetor de consulta vq com todos os outros vetores em seu espaço, calculando sua distância para cada vetor. Depois de calcular todas essas distâncias, a pesquisa retorna o k mais próximo delas como as correspondências mais próximas. Isso é chamado de busca de vizinhos mais próximos (kNN).
Por exemplo, a pesquisa de similaridade euclidiana envolve a recuperação dos vetores mais próximos do top-k em seu espaço em relação à métrica de distância euclidiana e a um vetor de consulta. Veja um exemplo que recupera os 10 principais vetores da tabela vector_tab mais próximos de query_vector usando a seguinte consulta de pesquisa de similaridade exata:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;
Neste exemplo, docID e embedding são colunas definidas na tabela vector_tab e embedding tem o tipo de dados VECTOR.
No caso das distâncias euclidianas, a comparação das distâncias quadradas é equivalente à comparação das distâncias. Assim, quando a ordenação é mais importante do que os próprios valores de distância, a distância do quadrado euclidiano é muito útil, pois é mais rápido de calcular do que a distância euclidiana (evitando o cálculo da raiz quadrada). Consequentemente, é mais simples e rápido reescrever a consulta desta forma:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;
Observação: A palavra-chave EXACT é opcional. Se omitido enquanto estiver conectado a uma instância ADB-S, uma pesquisa aproximada usando um índice de vetor será tentada se existir. Para obter mais informações, consulte Executar Pesquisa de Similaridade Aproximada Usando Índices de Vetor.
Observação: use a função de distância usada para treinar seu modelo de incorporação.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para obter a sintaxe completa do ROW_LIMITING_CLAUSE
Compreender Pesquisa de Similaridade Aproximada Usando Índices Vetoriais
Para velocidades de pesquisa mais rápidas com grandes espaços vetoriais, você pode usar a pesquisa de similaridade aproximada usando índices vetoriais.
O uso de índices vetoriais para uma pesquisa de similaridade é chamado de pesquisa aproximada. Pesquisas aproximadas usam índices vetoriais, que compensam a precisão do desempenho.
Pesquisa aproximada para grandes espaços vetoriais
Quando a qualidade da pesquisa é a sua alta prioridade e a velocidade de pesquisa é menos importante, a pesquisa por similaridade exata é uma boa opção. A velocidade de pesquisa pode ser irrelevante para espaços vetoriais menores ou quando você realiza pesquisas com servidores de alto desempenho. No entanto, os algoritmos de ML geralmente realizam pesquisas de similaridade em espaços vetoriais com bilhões de incorporações. Por exemplo, o conjunto de dados Deep1B contém imagens 1B geradas por uma CNN (Convolutional Neural Network). A computação de distâncias vetoriais com cada vetor no corpus para encontrar correspondências Top-K com 100% de precisão é muito lenta.
Felizmente, existem muitos tipos de pesquisas aproximadas que você pode executar usando índices vetoriais. Os índices vetoriais podem ser menos precisos, mas podem consumir menos recursos e podem ser mais eficientes. Ao contrário dos índices de banco de dados tradicionais, os índices vetoriais são construídos e realizam pesquisas usando algoritmos baseados em heurística.
Como a precisão de 100% não pode ser garantida pela heurística, as pesquisas de índice vetorial usam precisão de destino. Internamente, os algoritmos usados para criação de índices e pesquisa de índices estão fazendo o seu melhor para serem o mais precisos possível. No entanto, você tem a possibilidade de influenciar esses algoritmos especificando uma precisão de destino. Ao criar ou pesquisar o índice, você pode especificar valores de precisão de destino não padrão especificando um valor percentual ou especificando valores de parâmetros internos, dependendo do tipo de índice que estiver usando.
Exemplo de precisão de destino
Para entender melhor o que significa precisão do alvo, observe os diagramas a seguir. O primeiro diagrama ilustra um espaço vetorial onde cada vetor é representado por uma pequena cruz. O vermelho representa o vetor de consulta.
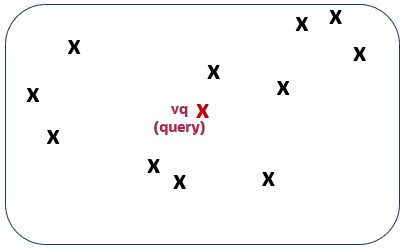
Descrição da ilustração accuracy1.png
Executar uma pesquisa de similaridade exata top-5 nesse contexto retornaria os cinco vetores mostrados no segundo diagrama:
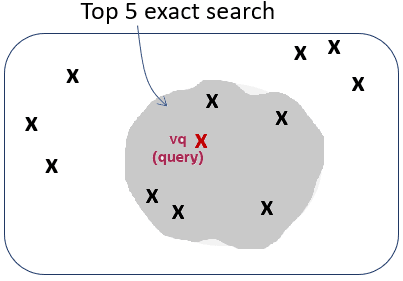
Descrição da ilustração accuracy2.png
Dependendo de como seu índice vetorial foi construído, executar uma pesquisa de similaridade aproximada top-5 nesse contexto poderia retornar os cinco vetores mostrados no terceiro diagrama. Isso ocorre porque o processo de criação do índice está usando heurísticas. Assim, a pesquisa através do índice vetorial pode levar a resultados diferentes em comparação com uma pesquisa exata:
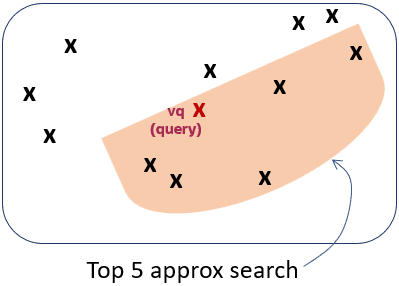
Descrição da ilustração accuracy3.png
Como você pode ver, os vetores recuperados são diferentes e, neste caso, eles diferem por um vetor. Isso significa que, em comparação com a pesquisa exata, a pesquisa de similaridade recuperou 4 de 5 vetores corretamente. A pesquisa de similaridade tem 80% de precisão em comparação com a pesquisa de similaridade exata. Isso é ilustrado no quarto diagrama:
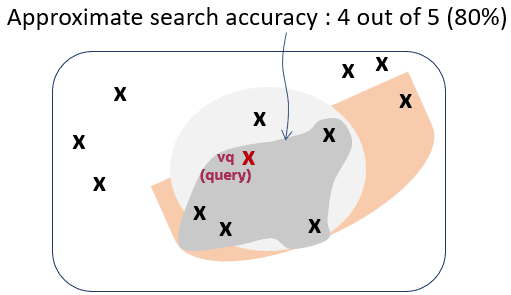
Descrição da ilustração accuracy4.png
Devido à natureza dos índices vetoriais serem estruturas de pesquisa aproximadas, é possível que menos de K linhas sejam retornadas em uma pesquisa de similaridade top-K.
Para obter informações sobre como configurar seus índices vetoriais, consulte Criar Índices Vetoriais.
Executar Pesquisa de Similaridade de Vários Vetores
Outro grande caso de uso da pesquisa vetorial é a pesquisa com vários vetores. A pesquisa com vários vetores geralmente está associada a uma pesquisa com vários documentos, na qual os documentos são divididos em partes que são incorporadas individualmente aos vetores.
Uma pesquisa com vários vetores consiste em recuperar correspondências de vetores top-K usando critérios de agrupamento conhecidos como partições com base nas características dos documentos. Essa capacidade de pontuar documentos com base na similaridade de seus chunks com um vetor de consulta que está sendo pesquisado é facilitada no SQL usando a cláusula de limitação de linha particionada.
Com a pesquisa com vários vetores, é mais fácil gravar instruções SQL para responder ao seguinte tipo de pergunta:
- Se existirem, quais são as quatro melhores frases correspondentes encontradas nos três melhores parágrafos correspondentes dos dois melhores livros correspondentes?
Por exemplo, imagine se cada livro em seu banco de dados for organizado em parágrafos contendo frases que têm representações de incorporação de vetores, você poderá responder à pergunta anterior usando uma única instrução SQL, como:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
Você também pode usar uma pesquisa de similaridade aproximada em vez de uma pesquisa de similaridade exata, conforme mostrado no seguinte exemplo:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;
Observação: Todas as linhas retornadas são ordenadas por VECTOR_DISTANCE() e não agrupadas pela cláusula de partição.
Semanticamente, a instrução SQL anterior é interpretada como:
-
Classifique todos os registros na tabela books em ordem decrescente da distância do vetor entre as frases e o vetor de consulta.
-
Para cada registro neste pedido, verifique suas
bookIdeparagraphId. Esse registro será produzido se as três condições a seguir forem atendidas:-
Seu
bookIdé um dos dois primeirosbookIddistintos na ordem classificada. -
Seu
paragraphIdé um dos três primeirosparagraphIddistintos na ordem classificada dentro do mesmobookId. -
Seu registro é um dos quatro primeiros registros dentro da mesma combinação
bookIdeparagraphId.
-
-
Caso contrário, esse registro será filtrado.
A pesquisa de similaridade de vários vetores não é apenas para documentos e também pode ser usada para responder às seguintes perguntas:
-
Devolva as fotos correspondentes mais próximas de K, mas certifique-se de que são fotos de pessoas diferentes.
-
Encontre as melhores músicas K com dois ou mais segmentos de áudio que melhor correspondam a este trecho de som.
Observação:
-
Esta extensão de cláusula limitadora de linha de partição é uma extensão genérica da linguagem SQL. Ele não precisa se aplicar apenas a pesquisas vetoriais.
-
A pesquisa de vários vetores é atualmente suportada com o índice de FIV.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para obter a sintaxe completa do ROW_LIMITING_CLAUSE