Oracle GoldenGate 部署的下游提取
通过下游 Oracle GoldenGate 部署,您可以将重做日志的处理负载转移到称为挖掘数据库的备用数据库。挖掘数据库不需要包含源数据库中的任何数据,但必须具有相同的数据库版本或更高版本。这意味着 Oracle 版本 12c 作为源数据库可以使用挖掘数据库版本 19c 或更高版本,允许 Oracle GoldenGate 从 Oracle 12c 数据库中捕获更改,而无需在 Oracle 12 数据库上实际运行。
下游提取也可用于 GoldenGate 无法与源数据库建立连接的情况。
注:源数据库服务器和下游数据库服务器必须具有相同的字节顺序和处理器类型。例如,下游 Extract 将与源 Linux (x86) 配合使用到下游 Windows (x86) 服务器,但如果源服务器是 HP-UX,但下游服务器是 AIX,或源服务器是 HP PA-RISC,但下游服务器是 HP-Itanium,则它不起作用。
下游挖掘数据库接受来自源数据库的归档日志和联机重做日志。这意味着下游提取可以存在两种模式:
-
实时挖掘模式:在实时挖掘模式下,重做记录会立即从联机或备用重做日志进行处理,因此,在处理数据库更改时不会出现延迟。
-
归档挖掘模式:在归档挖掘模式下,在将重做记录归档到重做日志文件之前,不会处理这些记录。
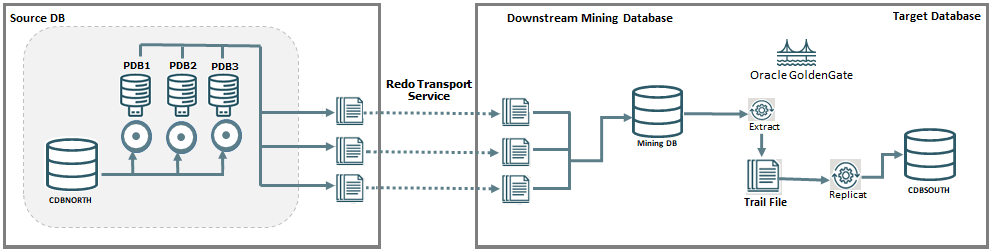
在典型的下游部署中,对数据进行更改的源数据库将将其重做日志或归档日志发送到挖掘数据库,其中提取进程将挖掘重做日志并写出线索文件。下游提取还可用于 Oracle GoldenGate 无法与源数据库建立连接的情况。在下图中, CDBNORTH 是源数据库, CDBSOUTH 是目标数据库。源和目标之间存在一个挖掘数据库,该数据库日志挖掘服务器将重做日志从下游提取传输到目标。
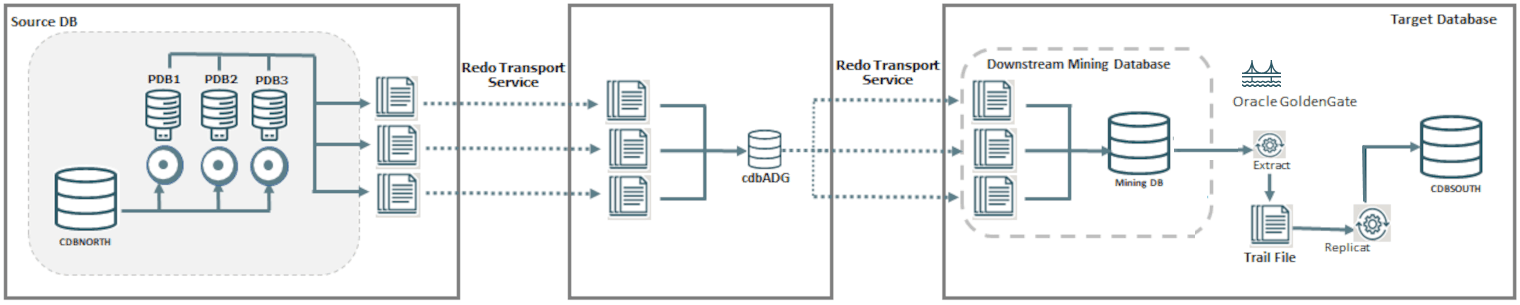
另一种选择是使用级联方法。如果存在 Active Data Guard 备用数据库,您可以让备用数据库将重做日志发运到挖掘数据库,而不是从主数据库发运日志。如果网络带宽有限且备用数据库与挖掘数据库位于同一区域或数据中心,则应使用此选项。
此方法使用在级联模式下配置的 ADG 将重做日志传输到下游挖掘数据库,然后由下游提取进行引用,从而降低源数据库的开销,如下图所示。
注:Oracle 的提取流程无法连接到 Data Guard 备用数据库或 Active Data Guard 备用数据库来捕获数据。
有关设置级联下游环境的配置详细信息,请参见 Enable Downstream Extract to Work with ADG 。
配置源和下游挖掘数据库
在本节中,您将了解数据库端所需的参数和用户管理配置。
源数据库和下游挖掘数据库中的 Oracle GoldenGate 用户
每个数据库上都需要有 Oracle GoldenGate 管理员用户。在容器数据库中,需要公用用户,因为提取将在根容器中使用。
要为 Oracle AI Database 26ai 及更高版本设置用户,需要将 OGG_CAPTURE 和 OGG_APPLY 用户角色分配给新用户。有关详细信息,请参阅授予 Oracle AI Database 26ai and Higher 的用户权限。
要为 Oracle Database 21c 及更低版本设置用户,将使用 PL/SQL 程序包。以下示例显示了在将 Oracle GoldenGate 与 Oracle Database 21c 及更低版本结合使用时创建用户以及授予此用户的关联权限:
CREATE USER c##ggadmin IDENTIFIED BY *password* CONTAINER = all;
ALTER USER c##ggadmin SET CONTAINER_DATA = all CONTAINER = current;
GRANT ALTER SESSION TO c##ggadmin CONTAINER = all;
GRANT connect, resource TO c##ggadmin CONTAINER = all;

BEGIN
  DBMS_GOLDENGATE_AUTH.GRANT_ADMIN_PRIVILEGE
    ( grantee                 => 'C##GGADMIN'
    , privilege_type          => 'CAPTURE'
    , grant_select_privileges =>  TRUE
    , container               => 'ALL'
    );
END;
/注:仅下游数据库需要公用用户 (c##ggadmin)。
配置数据库连接器
数据库网络服务要求
可以在两个方向使用 Database Net Services 访问源数据库和下游数据库。
在 Oracle GoldenGate 中,可以为源数据库 (CDBNORTH_root ) 和下游数据库 (cdbDSC_root ) 设置连接。在提取注册期间,仅需要源数据库连接来存储字典数据。您可以使用 FETCHUSERIDALIAS 参数在运行时连接到下游挖掘数据库 (cdbDSC_root ) 以进行提取。通过 ADG 重定向,可以将提取的注册重定向到 ADG 中的源。要设置连接,请确保您具有这些用户的数据库身份证明,以便从 Oracle GoldenGate 部署创建身份证明。
可以使用 SQL*Plus 测试 Net 服务,该服务是 Oracle GoldenGate 安装包的一部分。
源数据库先决条件
要配置数据库连接,请确保在源数据库实例上完成以下设置:
-
(源数据库和下游挖掘数据库)所有数据库必须包括:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
源数据库必须处于归档日志模式。要对数据库启用归档,请发出以下命令,指示数据库在切换重做日志时创建归档日志。
ALTER DATABASE ARCHIVE LOG; -
(推荐)(仅源)所有数据库必须处于强制日志记录模式。
ALTER DATABASE FORCE LOGGING; -
源数据库必须启用最少的补充日志记录,在将提取处理卸载到挖掘数据库期间包括
TRANDATA/SCHEMATRANDATA,因为这是事务处理发生的位置。 -
(仅限下游挖掘数据库)源数据库和下游数据库的密码文件 (
orapwSID) 相同。因此,在 Oracle Database 21c 及更低版本中,remote_login_passwordfile必须设置为SHARED或EXCLUSIVE。
下游挖掘数据库先决条件
要配置数据库连接,请确保在源数据库实例和下游数据库实例上完成以下设置:
-
所有数据库必须包括:
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION = TRUE; -
STREAMS_POOL_SIZE必须在 Oracle 21c 及更低版本中设置。例如:ALTER SYSTEM SET STREAMS_POOL_SIZE = 1G; -
挖掘数据库和源数据库必须处于归档日志模式。要对数据库启用归档,请发出以下命令,指示数据库在切换重做日志时创建归档日志。
ALTER DATABASE ARCHIVE LOG; -
(仅限下游挖掘)下游数据库必须具有以下各项的不同设置:
-
DBID -
DBNAME -
DB_UNIQUE_NAME -
GLOBAL_NAME
(下游挖掘数据库和源数据库)在下游环境中,唯一数据库名称与数据库名称匹配。
-
-
源数据库和下游数据库的口令文件 (
orapwSID) 相同。因此,remote_login_passwordfile必须设置为SHARED或EXCLUSIVE。
配置下游数据库的参数
使用此部分可以根据需要配置实时挖掘模式和归档挖掘模式的参数。
实时采矿模式下下游提取的参数设置
对于处于实时挖掘模式的下游提取,主要先决条件是下游数据库必须正确配置备用重做日志文件。
下游实时挖掘在提取参数文件中启用了显式设置。LAD 的配置独立于此模式。如果尚未设置 TRANLOGOPTIONS INTEGRATEDPARAMS (REAL_TIME_MINE Y) 参数,则需要将其设置为启用下游提取以实现实时挖掘模式:
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)注:给定源数据库的下游数据库中只能有一个实时提取。其他提取物必须是非实时。这是对重做传输的限制。
在下游挖掘数据库上运行的以下命令显示正在使用 FRA 设置的本地备份:
ALTER SYSTEM
    SET log_archive_config='DG_CONFIG=(CDBNORTH, cdbDSC)';
ALTER SYSTEM set FAL_SERVER = 'CDBNORTH_root';
下游数据库上必须存在备用重做日志文件。如果源上有 n 个联机重做日志文件,则目标上应有大小相同的 n+1 个备用重做日志文件。
在下游挖掘数据库上创建备用重做日志文件
以下步骤概述了向下游挖掘数据库添加备用重做日志文件的过程。下面汇总了用于创建备用重做日志的规则:
-
每个备用重做日志文件必须至少和重做源数据库中的最大重做日志文件大小相同。为了便于管理,Oracle 建议源数据库中的所有重做日志文件和下游挖掘数据库中的备用重做日志文件的大小相同。
-
对于源数据库中的每个重做线程,备用重做日志的重做日志组必须至少比源数据库中的重做日志多一个。
添加备用重做日志文件所需的特定步骤和 SQL 语句取决于您的环境。有关将备用重做日志文件添加到数据库的详细说明,请参见 Creating a Physical Standby Database 。
注:如果将有多个源数据库向单个下游挖掘数据库发送重做,则只有其中一个源可以向挖掘数据库的备用重做日志发送重做。从此源数据库挖掘重做数据的提取处理可以在实时模式下运行。所有其他源数据库必须仅将其归档日志发送到下游挖掘数据库,并且读取此数据的提取必须配置为在仅归档日志模式下运行。
创建备用重做日志文件
-
在 SQL*Plus 中,以管理用户身份连接到源数据库。
-
确定源日志文件的大小。记下结果。
SELECT BYTES FROM V$LOG; -
确定源数据库上配置的联机日志文件组数。记下结果。
SELECT COUNT(GROUP#) FROM V$LOG; -
以管理用户的身份连接到下游挖掘数据库。
-
将备用日志文件组添加到挖掘数据库。备用日志文件大小必须至少为源日志文件大小的大小。备用日志文件组的数量必须至少比源联机日志文件组的数量多一个。这适用于 RAC 安装中的每个实例(线程)。因此,如果源数据库中有 n 个线程,每个线程都有 m 个重做日志组,则应在下游挖掘数据库上配置 n*(m+1) 个重做日志组。
以下示例显示了三个备用日志组。
ALTER DATABASE ADD STANDBY LOGFILE GROUP 3 ('/oracle/dbs/slog3a.rdo', '/oracle/dbs/slog3b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 4 ('/oracle/dbs/slog4.rdo', '/oracle/dbs/slog4b.rdo') SIZE 500M; ALTER DATABASE ADD STANDBY LOGFILE GROUP 5 ('/oracle/dbs/slog5.rdo', '/oracle/dbs/slog5b.rdo') SIZE 500M; -
确认备用日志文件组已成功添加。
SELECT GROUP#, THREAD#, SEQUENCE#, ARCHIVED, STATUS
FROM V$STANDBY_LOG;
输出应与以下内容类似:
GROUP# THREAD# SEQUENCE# ARC STATUS ---------- ---------- ---------- --- ---------- 3 0 0 YES UNASSIGNED 4 0 0 YES UNASSIGNED 5 0 0 YES UNASSIGNED -
确保源数据库中的日志文件显示在您设置的本地
LOG_ARCHIVE_DEST_n的LOCATION属性中指定的位置。您可能需要切换源数据库中的日志文件以查看目录中的文件。
配置下游挖掘数据库以本地归档备用重做日志文件
此过程将下游挖掘数据库配置为归档从源数据库的联机重做日志接收重做数据的备用重做日志。请记住,外部归档日志不应归档在下游挖掘数据库的恢复区域中。
本地归档备用重做日志:
-
在下游挖掘数据库,在
LOG_ARCHIVE_DEST_n初始化参数中设置第二个归档日志目标,如以下示例所示。ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='LOCATION=/home/arc_dest/srl_dbms1 VALID_FOR=(STANDBY_LOGFILE,PRIMARY_ROLE)'Oracle 建议将外部归档日志(来自远程源数据库的日志)与本地挖掘数据库日志文件以及彼此隔离。不能使用下游挖掘数据库的恢复区暂存外部归档日志。
-
启用在上一步中设置的
LOG_ARCHIVE_DEST_2参数,如以下示例中所示。ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE
存档采矿模式下游提取的参数设置
要以“归档挖掘”模式或“实时挖掘”模式设置下游提取,必须设置重做传输。在 Archive-Log-Only 模式下设置下游提取时,包括以下参数:
-
LOG_ARCHIVE_CONFIG -
LOG ARCHIVE DESTINATION (LAD)-
LOG_ARCHIVE_DEST_1,用于所有数据库的本地备份 -
源数据库上用于重做传输的
LOG_ARCHIVE_DEST_2服务
-
注意:LOG_ARCHIVE_DEST_2 与使用实时采矿无关。
-
本地数据库备份目的地是使用快速恢复区设置的
-
FAL_SERVER -
可以使用
scope=both动态设置所有必需的系统参数
源数据库上的本地备份目标和重做传输服务需要归档日志目标 (LAD) 参数设置。
使用以下命令为本地备份目标设置 LAD 参数:
ALTER SYSTEM SET db_recovery_file_dest = '/u01/app/oracle/fast_recovery_area';
ALTER SYSTEM SET db_recovery_file_dest_size = 100G;
ALTER SYSTEM SET log_archive_dest_1 = 'LOCATION=USE_DB_RECOVERY_FILE_DEST';使用以下命令为源数据库上的重做传输服务设置 LAD 参数选项:
ALTER SYSTEM SET log_archive_config = 'DG_CONFIG = (CDBNORTH, cdbDSC)';
ALTER SYSTEM
      SET log_archive_dest_2='SERVICE=cdbDSC_root
                              ASYNC
                              NOREGISTER
                              VALID_FOR=(ONLINE_LOGFILES, PRIMARY_ROLE)
                              DB_UNIQUE_NAME=cdbDSC';
要了解有关 LOG_ARCHIVE_DEST 参数及其属性的更多信息,请参见 Database Reference 指南中的 LOG_ARCHIVE_DEST_n 。
为下游部署配置 Oracle GoldenGate 提取
在此部分中,您将了解 Oracle GoldenGate 设置与源数据库和下游数据库的连接以及为下游数据库配置提取所需的参数。
为下游数据库配置 Oracle GoldenGate
下游提取参数文件必须包括用于设置下游部署的以下参数:
-
TRANLOGOPTIONS MININGUSERALIAS:为内部元数据查询设置与下游挖掘数据库的连接。 -
FETCHUSERIDALIAS:连接到源数据库以提取无法从事务处理日志中原生提取的数据。 -
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y):如果设置为 Y,则提取将从下游数据库的备用重做日志文件捕获更改。如果未设置,则 Extract 将从归档日志文件捕获。
以下是包含以下参数的提取参数文件的示例:
EXTRACT EXTDSC
USERIDALIAS cgg_CDBNORTH
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y)
FETCHUSERIDALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate

EXTTRAIL Downstream/ea
SOURCECATALOG CDBNORTH_PDB1
DDL INCLUDE MAPPED
TABLE HR.*;
按照给定的步骤为下游提取设置 Oracle GoldenGate 部署:
-
添加源数据库的身份证明:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@CDBNORTH_root ALIAS cgg_CDBNORTH DOMAIN OracleGoldenGate PASSWORD password -
添加下游数据库的身份证明:
ALTER CREDENTIALSTORE ADD USER c##ggadmin@cdbDSC_root ALIAS cgg_cdbDSC DOMAIN OracleGoldenGate PASSWORD *password* -
使用
DBLOGIN从 Oracle GoldenGate 连接到源数据库和下游数据库:DBLOGIN USERIDALIAS cgg_CDBNORTHMININGDBLOGIN USERIDALIAS cgg_cdbDSC在此示例中,
cgg_CDBNORTH是源数据库 CDBNORTH 的身份证明别名,cgg_cdbDSC是挖掘数据库的身份证明别名。 -
添加和注册提取,编辑参数文件以包括以前提供的提取参数,添加提取线索名称和位置,启动提取:
ADD EXTRACT extdsc, INTEGRATED TRANLOG, BEGIN NOW
REGISTER EXTRACT extdsc, DATABASE CONTAINER (CDBNORTH_PDB01)

ADD EXTTRAIL Downstream/ea, EXTRACT extdsc
START extdsc
使用 Active Data Guard 配置级联下游提取
如果无法连接到源数据库,则可以将 GoldenGate 配置为使用活动数据卫士 (ADG) 备用数据库。备用数据库可用于只读连接,以执行元数据查询和提取。在本节中,您将学习如何使用 ADG 配置下游提取,而不与源数据库建立连接。
启用下游提取以与 ADG 配合使用
在级联的下游捕获环境中,下游数据库不会直接连接到源数据库。它使用 Active Data Guard (ADG) 提取和元数据查询。
必须使用无源选项启动提取,以使其不连接到源数据库,而是在需要提取任何非本机数据类型时使用 FETCHUSERID 或 FETCHUSERIDALIAS 连接到 ADG。例如,在 ADG 数据库上处理 FETCH 操作,因为此实例在只读模式下打开。无法在 ADG 实例上处理的其他操作(例如创建字典构建)将从 ADG 重定向到源数据库。
注册下游提取时,Oracle GoldenGate 将连接到 ADG 作为源数据库,而不是重做源数据库的数据库。以下命令和参数支持 ADG 重定向:
-
SCHEMATRANDATA -
TRANDATA -
FLUSH SEQUENCE -
TRACETABLE -
HEARTBEATTABLE -
REGISTER EXTRACT注:SCHEMATRANDATA和TRANDATA,即使在备用重做日志上执行命令,也会在执行实际 DML 操作的主数据库上创建和维护实际的日志组。
ADG 重定向随 Oracle Database 21c 及更高版本提供。它还支持通配符注册。以下示例显示了使用 ADG 时下游提取的提取参数文件:
EXTRACT EXTDSC
NOUSERID
TRANLOGOPTIONS MININGUSERALIAS cgg_cdbDSC_src DOMAIN OracleGoldenGate
TRANLOGOPTIONS INTEGRATEDPARAMS (DOWNSTREAM_REAL_TIME_MINE Y) FETCHUSERIDALIAS cgg_cdbADG_src DOMAIN OracleGoldenGate

EXTTRAIL cascade/ea
SOURCECATALOG CDBNORTH_PDB01
DDL INCLUDE MAPPED
TABLE HR.*;
下面是允许下游提取与 ADG 备用数据库一起使用的步骤:
-
在 ADG 备用数据库上添加其他
LOG_ARCHIVE_DESTINATION_N (LAD),如以下示例中所示:ALTER SYSTEM SET LOG_ARCHIVE_DEST_3='service=mining_db_service_name ASYNC NOREGISTER VALID_FOR(STANDBY_LOGFILES,STANDBY_ROLES) DB_UNIQUE_NAME=3rd_db_unique_name' scope=both此步骤传输并生成 ADG 备用数据库的
standby_logfiles。 -
在 ADG 备用数据库上设置
LOG_ARCHIVE_CONFIG以将日志发送到挖掘数据库,如以下示例所示:ALTER SYSTEM SET LOG_ARCHIVE_CONFIG = 'DG_CONFIG' = (CDBNORTH, cdbADG_src, cdbDSC)';DB_CONFIG是第一个、第二个和第三个数据库的数据库唯一名称。 -
在挖掘数据库上,设置位置以将传入的 standby_logfiles 存储在挖掘数据库上,如以下示例所示:
ALTER SYSTEM SET LOG_ARCHIVE_DEST_2='location= /home/arc_dest/dstrm VALID_FOR=(STANDBY_LOGFILE,ALL_ROLES)' scope=both其中
/home/arc_dest/dstrm是外部归档日志的位置。请勿使用 FRA 存储外部归档日志。 -
在挖掘数据库上运行
LOG_ARCHIVE_CONFIG,以便提取处理能够在挖掘数据库上读取它们,如以下示例所示:ALTER SYSTEM SET LOG_ARCHIVE_CONFIG ='DG_CONFIG' scope=both此处,
DB_CONFIG是第一个、第二个和第三个数据库的数据库唯一名称。 -
对于下游提取,您需要确保正确配置数据库连接。注册提取时,请确保与 ADG 备用数据库建立了
DBLOGIN连接,该连接对只读活动打开。 -
要添加提取并注册提取,请使用以下命令:
DBLOGIN USERID ggadmin@cdbADG_src, PASSWORD ggadmin
MININGDBLOGIN USERID ggadmin@cgg_cdbDSC, password ggadmin
cdbADG_src 是 ADG 不是主 ADG。
cgg_cdbDSC 是挖掘数据库。
-
现在,注册使用
NOUSERID参数的提取:ADD EXTRACT exte, INTEGRATED TRANLOG, BEGIN NOW REGISTER EXTRACT exte DATABASE -
注册提取后,可以使用此提取来挖掘数据并正常启动提取。