Oracle AI Database 中的人工智能
本章介绍 Oracle AI Database 中提供的人工智能功能。
-
Oracle AI Vector Search 概述 Oracle AI Vector Search 专为人工智能 (AI) 工作负载而设计,允许您基于语义而不是关键字查询数据。
-
向量距离度量 测量向量空间中的距离是确定给定查询向量最相关的结果的核心。这个过程与关系数据库世界中众所周知的关键字过滤非常不同。
-
Hierarchical Navigable Small World Indexes 概览 使用以下示例了解如何为向量近似相似性搜索创建 HNSW 索引。
-
了解反向文件平面向量索引 反向文件平面向量索引是一种旨在通过使用相邻分区或群集缩小搜索区域来提高搜索效率的技术。
-
执行相似性搜索本节介绍执行相似性搜索的方法。
Oracle AI Vector Search 概览
Oracle AI Vector Search 专为人工智能 (AI) 工作负载而设计,支持您基于语义(而非关键字)查询数据。
VECTOR 数据类型
Oracle AI Database 26ai 发行版引入了 VECTOR 数据类型,为在数据库中存储向量嵌入以及业务数据奠定了基础。使用嵌入模型,您可以将非结构化数据转换为向量嵌入,然后这些向量嵌入可用于业务数据的语义查询。要使用 VECTOR 数据类型及其相关功能,必须将 COMPATIBLE 初始化参数设置为 23.4.0 或更高。有关参数以及如何更改参数的详细信息,请参阅 Oracle AI Database Upgrade Guide。
请参见以下在表定义中使用 VECTOR 数据类型的基本示例:
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);有关 VECTOR 数据类型的更多信息以及如何在表中使用向量,请参阅使用 VECTOR 数据类型创建表。
由于 VECTOR 数据类型的数值性质,您可以将其用作机器学习算法的输入,例如分类、异常、回归、聚类和特征提取。有关在机器学习中使用 VECTOR 数据类型的更多详细信息,请参阅向量数据类型支持。注:从 23.7 开始,所有版本都支持 VECTOR 数据类型机器学习。
向量嵌入
如果您曾经使用过语音助手、聊天机器人、语言翻译器、推荐系统、异常检测或视频搜索和识别等应用程序,那么您已经隐式使用了矢量嵌入功能。
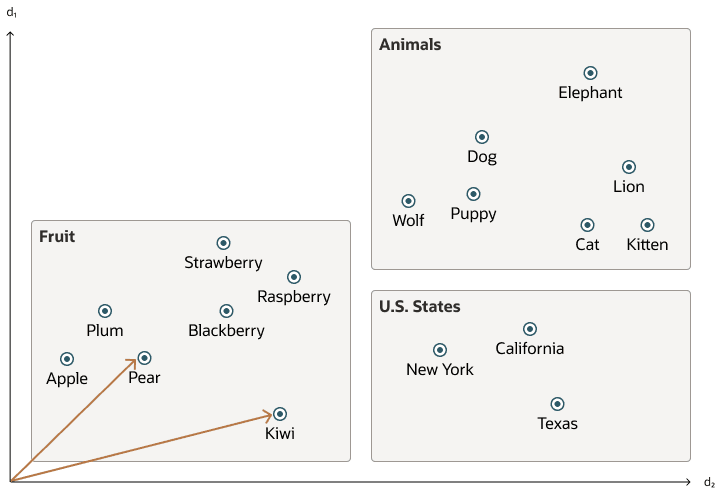
Oracle AI Vector Search 存储向量嵌入,这是数据点的数学向量表示。这些向量嵌入描述内容背后的语义含义,例如单词、文档、音频轨道或图像。例如,在进行基于文本的搜索时,向量搜索通常被认为比关键字搜索更好,因为向量搜索基于单词的含义和上下文,而不是实际单词本身。这种向量表示将人类感知的对象的语义相似性转化为数学向量空间中的邻近性。这个向量空间通常有数百个(如果不是数千个)维度。换句话说,矢量嵌入是表示几乎任何类型的数据的一种方式,如文本,图像,视频,用户或音乐作为多维空间中的点,其中这些点在空间中的位置以及与其他点的接近具有语义意义。
此简化图说明了将单词编码为二维向量的向量空间。
相似性搜索
搜索数据集中的语义相似性现在相当于在向量空间中搜索最近的邻居,而不是使用传统的关键字搜索(使用查询谓词)。如下图所示,此向量空间中的 dog 与 wolf 之间的距离比 dog 与 kitten 之间的距离短。在这个空间里,一只狗更像一只狼,而不是一只小猫。有关详细信息,请参阅执行精确相似性搜索。
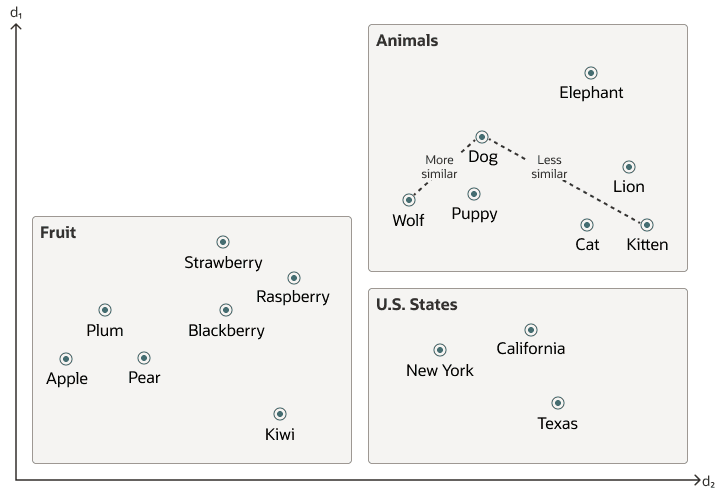
插图 vector_embeddings_similarity.png 的说明
矢量数据往往分布不均,并聚集到语义相关的组中。基于给定的查询向量执行相似性搜索相当于检索向量空间中查询向量的 K 最近向量。基本上,您需要通过对向量进行排名来查找有序的向量列表,其中列表中的第一行是最接近或最相似的向量,列表中的第二行是与查询向量最接近的第二行,依此类推。在进行相似性搜索时,距离的相对顺序是真正重要的,而不是实际的距离。
使用前面的向量空间,下面是语义搜索的示意图,其中查询向量是与单词 Puppy 对应的向量,您要标识四个最接近的单词:
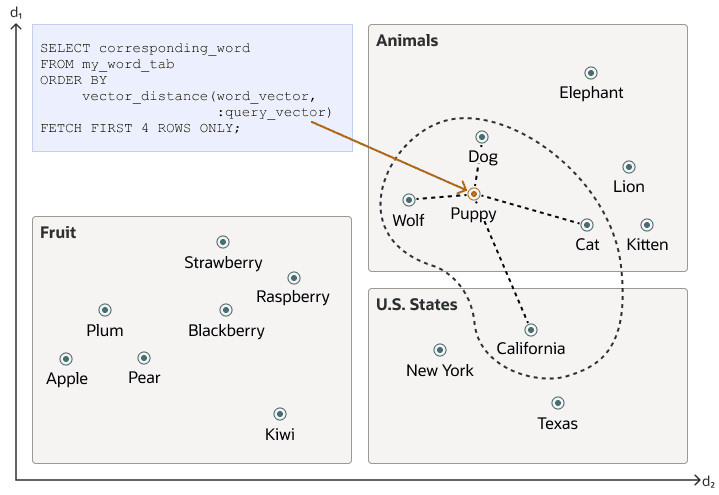
插图 vector_embeddings_similarity_search.png 的说明
相似性搜索倾向于从一个或多个集群中获取数据,具体取决于查询向量值和提取大小。
使用向量索引的近似搜索可以将搜索限制为特定群集,而精确搜索将访问所有群集中的向量。有关更多信息,请参见 Use Vector Indexes 。
向量嵌入模型
创建这种向量嵌入的一种方法可能是使用某人的领域专业知识来量化一组预定义的特征或维度,例如形状、纹理、颜色、情感以及许多其他特征或维度,具体取决于您所处理的对象类型。但是,这种方法的效率取决于用例,并不总是具有成本效益。
相反,向量嵌入是通过神经网络创建的。大多数现代矢量嵌入都使用变压器模型,如下图所示,但也可以使用卷积神经网络。
图 1:矢量嵌入模型
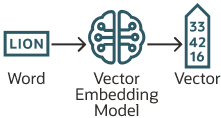
根据数据的类型,您可以使用不同的预训练开源模型来创建向量嵌入。例如:
-
对于文本数据,句子变换器将单词、句子或段落转换为向量嵌入。
-
对于可视化数据,您可以使用残余网络 (ResNet) 生成向量嵌入。
-
对于音频数据,您可以使用音频数据的可视光谱图表示形式回退到可视化数据案例中。
每个模型还确定向量的维数。例如:
-
Cohere 的嵌入模型 embed-english-v3.0 具有 1024 个维度。
-
OpenAI 的嵌入模型 text-embedding-3-large 具有 3072 个维度。
-
拥抱面嵌入模型 all-MiniLM-L6-v2 具有 384 个维
当然,您始终可以创建自己的模型,并使用自己的数据集进行训练。
将嵌入模型导入 Oracle AI Database
虽然您可以使用预训练的开源嵌入模型或您自己的嵌入模型在 Oracle AI Database 外部生成向量嵌入,但如果这些模型与开放神经网络交换 (ONNX) 标准兼容,您也可以选择将这些模型直接导入 Oracle AI Database。Oracle AI Database 直接在数据库中实施 ONNX 运行时。这允许您使用 SQL 直接在 Oracle AI Database 中生成向量嵌入。有关详细信息,请参阅生成矢量嵌入。
向量距离指标
测量向量空间中的距离是确定给定查询向量的最相关结果的核心。这个过程与关系数据库世界中众所周知的关键字过滤非常不同。
使用向量时,有几种方法可以计算距离来确定两个向量的相似程度或不同程度。每个距离度量都使用不同的数学公式进行计算。计算两个向量之间的距离所需的时间取决于许多因素,包括所使用的距离度量以及向量本身的格式,例如向量维数和向量维格式。通常,最好将您使用的距离度量与用于训练生成向量的向量嵌入模型的距离度量相匹配。
分层可导航小世界索引概览
使用这些示例可以了解如何为向量近似相似性搜索创建 HNSW 索引。
使用可导航小世界 (Navigable Small World,NSW),该想法是构建一个接近图,其中图形中的每个矢量根据三个特征连接到其他几个矢量:
-
向量之间的距离
-
在插入
(EFCONSTRUCTION)期间搜索的每个步骤中考虑的最接近的向量候选项的最大数量 -
每个向量允许的最大连接数 (
NEIGHBORS)
如果上述阈值的组合太高,则最终可能会出现一个紧密连接的图形,这可能会减慢搜索过程。另一方面,如果这些阈值的组合太低,则图形可能变得太稀疏和/或断开连接,这使得在搜索期间在特定向量之间找到路径具有挑战性。
可导航小世界 (Navigable Small World,NSW) 图形遍历以图形中的预定义入口点开始,访问由密切相关的向量组成的集群。搜索算法采用两个关键列表:候选列表、我们在遍历图形时遇到的动态更新的向量列表,以及“结果”,其中包含迄今为止找到的查询向量最接近的向量。随着搜索的进行,该算法在图形中导航,通过探索和评估可能比结果中更接近的向量来不断改进候选者。一旦求职者中没有比结果中最远的向量更接近的向量,该过程就会结束,表明已达到本地最小值,并且已确定与查询向量最接近的向量。
这一点在以下图形中进行了说明:
图 2:可导航小世界图
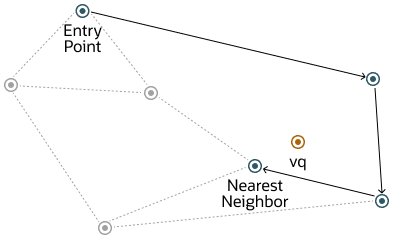
插图 navigable-small-world-graph.png 的说明
描述的方法展示了强大的性能,高达一定比例的向量插入到图形中。除了这个阈值之外,分层导航小世界 (HNSW) 方法通过引入多层层次结构来增强新南威尔士州的模型,类似于概率跳过列表中观察到的结构。此分层体系结构是通过将图形的连接分布在多个层来实现的,这些连接以每个后续层包含以下层中向量的子集的方式进行组织。这种分层可确保顶层捕获长距离链路,有效地充当横跨图形的快速通道,而下层则专注于较短的链路,从而促进细粒度本地导航。因此,搜索从较高层开始,以快速接近目标向量的区域,逐步移动到较低层以进行更精确的搜索,通过从顶层移动到底部时在向量之间利用较短的链路(较小的距离),显着提高搜索效率和准确性。
为了更好地了解 HNSW 的工作原理,让我们看看此层次结构如何用于概率跳过列表结构:
图 3:概率跳过列表结构
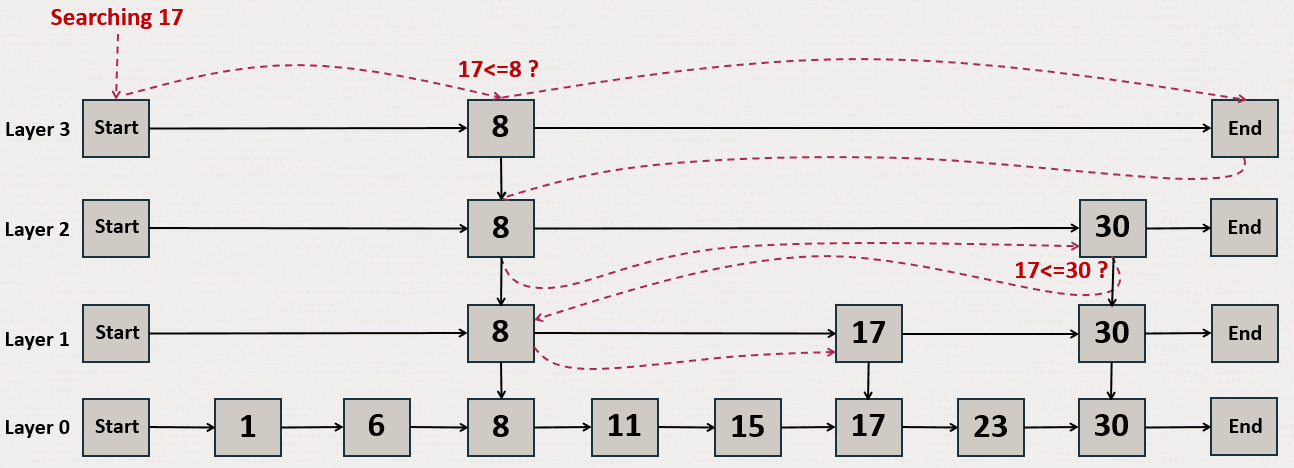
插图 probability-skip-list_01.png 的说明
“概率跳过列表”结构使用多个链接列表层,其中以上层跳过的数字多于下层。在此示例中,您正在尝试搜索数字 17。你从顶层开始,跳到下一个元素,直到你找到 17,到达列表的末尾,或者你找到一个大于 17 的数字。当您到达列表的末尾或找到大于 17 的数字时,则从小于 17 的最新数字开始在上一层中。
HNSW 使用与 NSW 层相同的原理,您可以在较高层中找到向量之间的更大距离。2D 空间中的下图说明了这一点:
在顶层是最长的边缘,在底层是最短的边缘。
图 4:分层可导航小世界图形
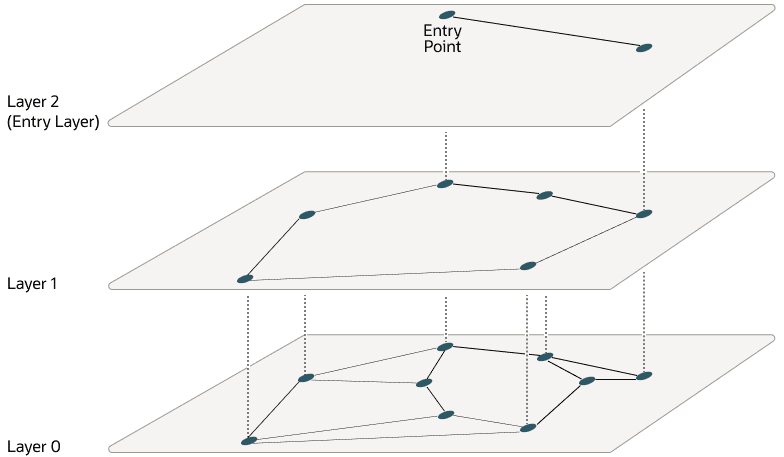
插图 hierarchical-navigable-small-world-graph_02.png 的说明
从顶层开始,一个层中的搜索从入口向量开始。然后,对于每个节点,如果存在一个比当前节点更接近查询向量的相邻节点,则它跳转到该相邻节点。算法会一直执行此操作,直到找到查询向量的本地最小值。当在一个层中找到局部最小值时,搜索通过在该新层中使用相同的矢量进入下一层,并且搜索继续在该层中。此过程会重复执行,直到找到底层的本地最小值,该最小值包含所有向量。此时,搜索将使用新南威尔士州算法将搜索转换为近似相似性搜索,该算法围绕找到的最新本地最小值提取与查询向量最相似的前 k 个向量。虽然上层可以具有由 NEIGHBORS 参数设置的每个向量的最大连接数,但是第 0 层可以具有两倍的连接数。下图对此流程进行了说明:
图 5:Hierarchical Navigable Small World 图形搜索
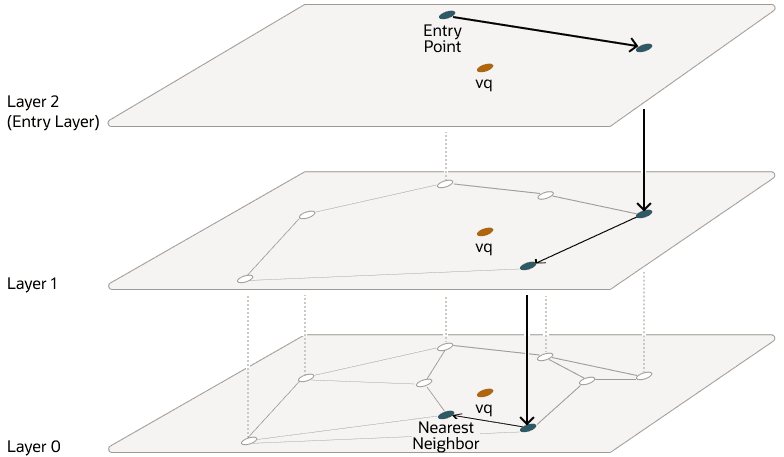
插图 hnsw-search-graph_02-png.png 的说明
层是使用内存中图形(而非 Oracle Inmemory 图)实现的。每个层使用单独的内存中图形。如前所述,在创建 HNSW 索引时,可以使用 NEIGHBORS 参数微调上层中每个向量的最大连接数,以及使用 EFCONSTRUCTION 参数(其中 EF 代表输入因子)在搜索过程的每个步骤中考虑的最接近向量候选项的最大数量。
如前所述,当使用 Oracle AI Vector Search 使用 HNSW 索引运行近似搜索查询时,您可以指定应执行近似搜索的目标准确度。
对于 HNSW 近似搜索,可以指定目标准确度百分比值,这会影响探测搜索所考虑的候选条目数。这由算法自动计算。值 100 将倾向于将类似结果强加为精确搜索,尽管系统可能仍使用该索引,并且不会执行精确搜索。优化程序可以选择仍然使用索引,因为鉴于查询中的谓词,这样做可能会更快。您可以指定 EFSEARCH 参数以强制指定在探测索引时要考虑的最大候选数,而不是指定目标准确度百分比值。数值越大,准确性就越高。
注意:
-
如果未在大致搜索查询中指定任何目标准确性,则将在创建索引时继承该集。您将看到,在创建索引时,可以使用百分比值或参数值指定目标准确度,具体取决于要创建的索引类型。
-
与在创建索引时设置的索引搜索相比,可以指定不同的目标准确度。对于 HNSW 索引,可以使用
EFSEARCH参数(高于在创建索引时指定的EFCONSTRUCTION值)查看更多相邻项,以获得更准确的结果。在创建索引期间提供的目标准确度决定了索引创建参数,并且还充当向量索引搜索的默认准确度值。
了解反向文件平面矢量索引
反向文件平面向量索引是一种旨在通过使用相邻分区或群集来缩小搜索区域以提高搜索效率的技术。
下图描述了如何使用 2D 空间表示法在大致搜索中创建分区或群集。但这可以推广到更高的维空间。
图 6:使用 2D 的反向文件平面索引
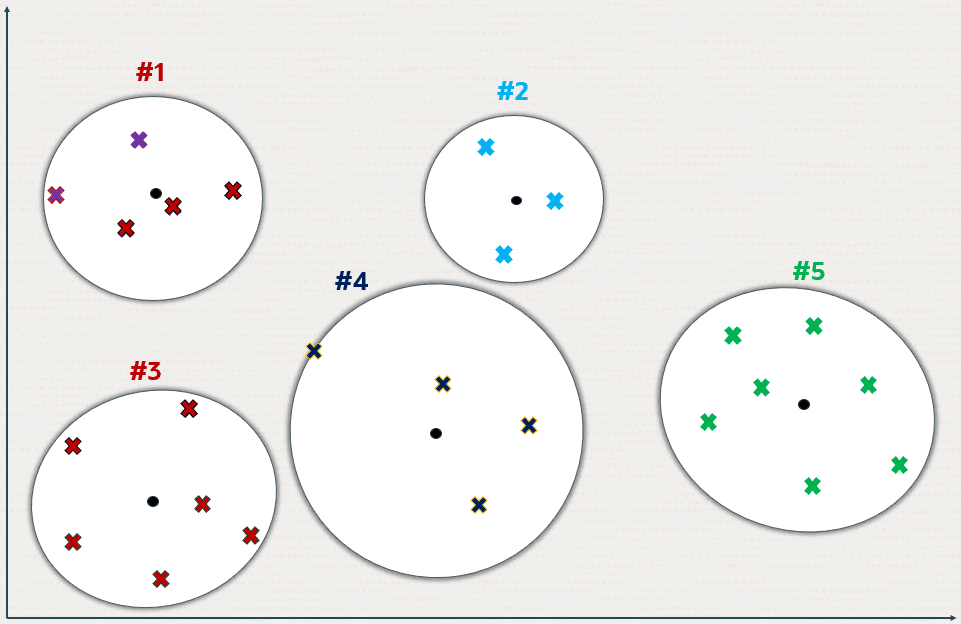
插图 inverted-file-index_1.png 的说明
交叉表示此空间中的向量数据点。
新增了显示为小平原圆的新数据点,以标识 k 分区中心,其中中心 ID 的数量 (k) 由数据集的大小 (n) 确定。通常,k 设置为 n 的平方根,但可以通过在创建索引期间指定 NEIGHBOR PARTITIONS 参数对其进行调整。
每个中心表示相应分区的平均向量(重力中心)。
中心体是通过对向量进行训练来计算的,其目标是最大限度地减少每个向量与最接近的中心体的总距离。
中心节点最终将向量空间分区为 k 分区。这种划分在概念上被证明是从中心体中扩展的圆圈,这些中心体在相遇时停止生长,形成不同的分区。
图 7:反向文件平面索引
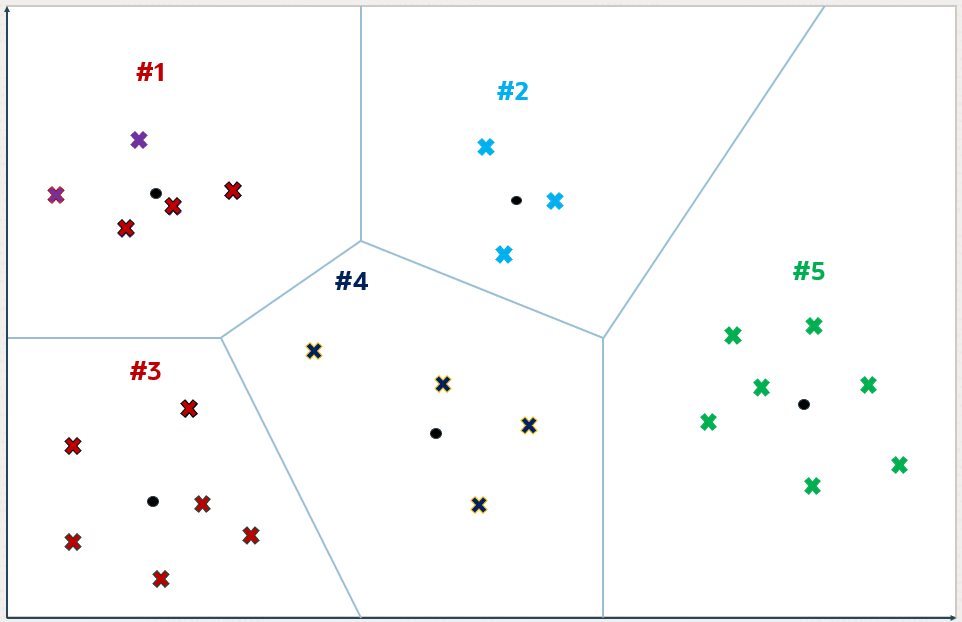
插图 inverted-file-index_5.png 的说明
除了外围设备上的那些,每个向量都位于与中心相关联的特定分区内。
图 8:反向文件平面索引
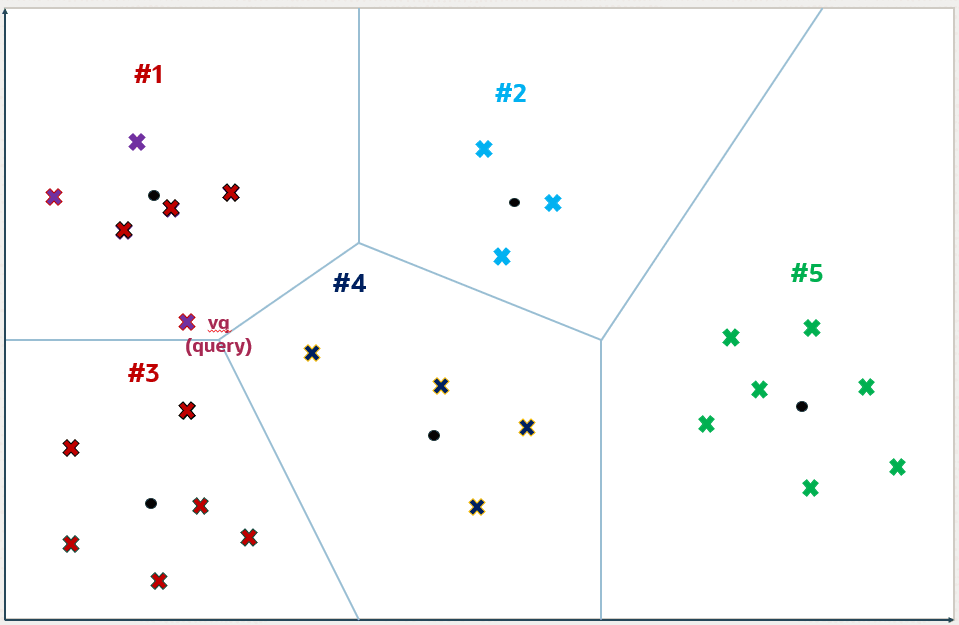
插图 inverted-file-index_6.png 的说明
对于查询向量 vq,搜索算法标识最接近的 i 中心 ID,其中 i 默认为 k 的平方根,但可以通过设置 NEIGHBOR PARTITION PROBES 参数来调整特定查询。此调整允许在搜索速度和准确性之间进行权衡。
此参数的数值越高,准确度就越高。在此示例中,i 设置为 2,两个标识的分区是编号 1 和 3 的分区。
图 9:反向文件平面索引
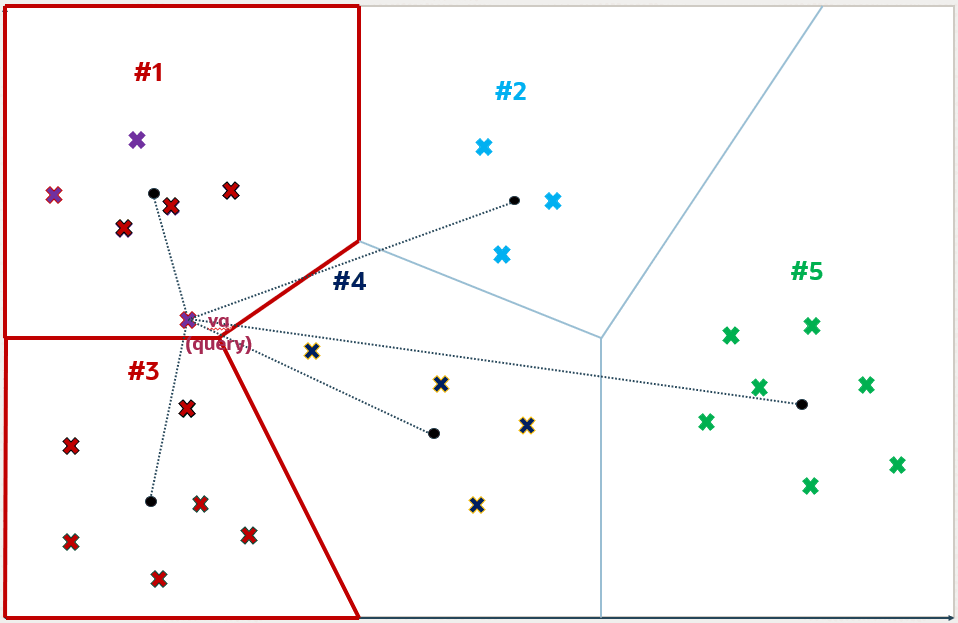
插图 inverted-file-index_7.png 的说明
确定 i 分区后,将对其进行完全扫描,以识别前 5 个最接近的向量。此数字 5 可以与 k 不同,您可以在查询中指定此数字。下图中突出显示了在第 1 和第 3 个分区中找到的 vq 的五个最接近的向量。
此方法构成了近似搜索,因为它将搜索限制为分区的子集,从而加快了过程,但在未经检查的分区中可能缺少更接近的向量。此示例说明近似搜索可能不会将最接近的向量生成到 vq ,这表明搜索效率和准确性之间固有的权衡。
图 10:反向文件平面索引
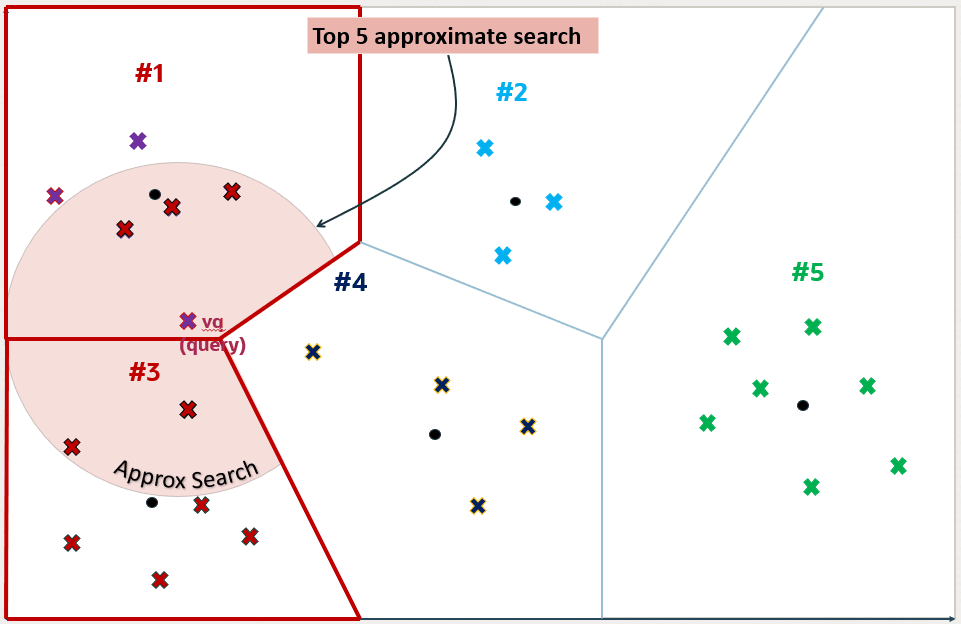
插图 inverted-file-index_10.png 的说明
但是,来自 vq 的五个精确最接近的向量不是近似搜索找到的向量。您可以看到,分区编号 4 中的一个向量比分区编号 3 中检索到的向量更接近 vq。
图 11:反向文件平面索引
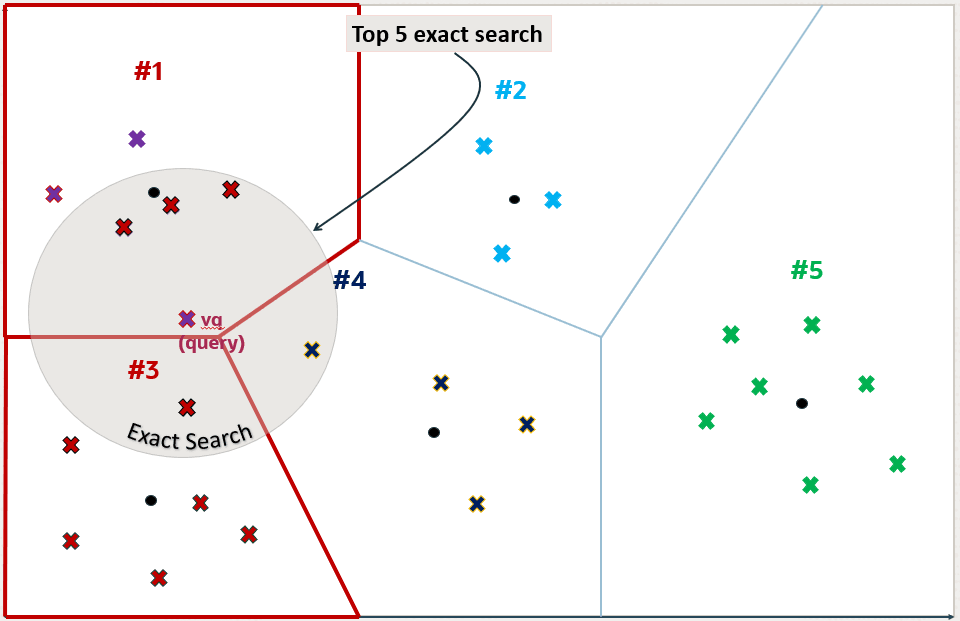
插图 inverted-file-index_11.png 的说明
现在,您可以了解为什么使用向量索引搜索并不总是准确的搜索,而是称为近似搜索。在此示例中,近似搜索准确度仅为 80%,因为它仅检索了 5 个精确搜索向量结果中的 4 个。
图 12:反向文件平面索引
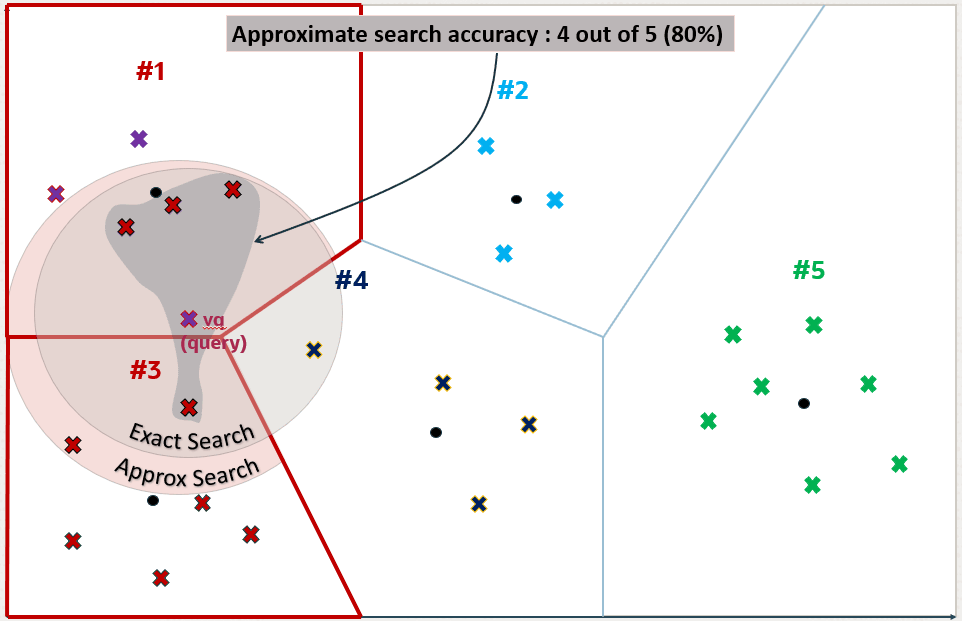
插图 inverted-file-index_12.png 的说明
使用 Oracle AI Vector Search 使用向量索引运行近似搜索查询时,您可以指定应执行近似搜索的目标准确度。
对于 IVF 大致搜索,您可以指定目标准确度百分比值,以影响用于探测搜索的分区数。这由算法自动计算。值为 100 将倾向于强制执行精确搜索,尽管系统可能仍然使用索引,并且不会执行精确搜索。优化程序可以选择仍然使用索引,因为鉴于查询中的谓词,这样做可能会更快。您可以指定 NEIGHBOR PARTITION PROBES 参数以强制执行搜索要探测的特定最大分区数,而不是指定目标准确度百分比值。数值越大,准确性就越高。
注意:
-
如果未在大致搜索查询中指定任何目标准确性,则将在创建索引时继承该集。您将看到,在创建索引时,可以使用百分比值或参数值指定目标准确度,具体取决于要创建的索引类型。
-
在索引搜索时可以指定不同的目标准确度,而索引创建时可以指定不同的目标准确度。对于 IVF 索引,您可以使用
NEIGHBOR PARTITION PROBES参数探测更多中心分区,以获得更准确的结果。在创建索引期间提供的目标准确度决定了索引创建参数,并且还充当向量索引搜索的默认准确度值。
执行相似性搜索
本节介绍执行相似性搜索的方法。
-
执行精确相似性搜索相似性搜索查找向量与查询向量相比的相对顺序。当然,比较是使用特定的距离度量完成的,但重要的是最接近向量的结果集,而不是它们之间的距离。
-
使用向量索引了解近似相似性搜索对于具有较大向量空间的较快搜索速度,可以使用向量索引进行近似相似性搜索。
-
执行多向量相似性搜索向量搜索的另一个主要用例是多向量搜索。多向量搜索通常与多文档搜索关联,其中文档拆分为单个嵌入到向量的块。
执行精确相似性搜索
相似性搜索查找向量相对于查询向量的相对顺序。当然,比较是使用特定的距离度量完成的,但重要的是最接近向量的结果集,而不是它们之间的距离。
例如,给定特定的查询向量,您可以计算它与数据集中的所有其他向量的距离。这种类型的搜索,也称为平面搜索,或精确搜索,以完美的搜索质量产生最准确的结果。但是,这需要花费大量搜索时间。这一点通过以下图表进行说明:
图 13:精确搜索
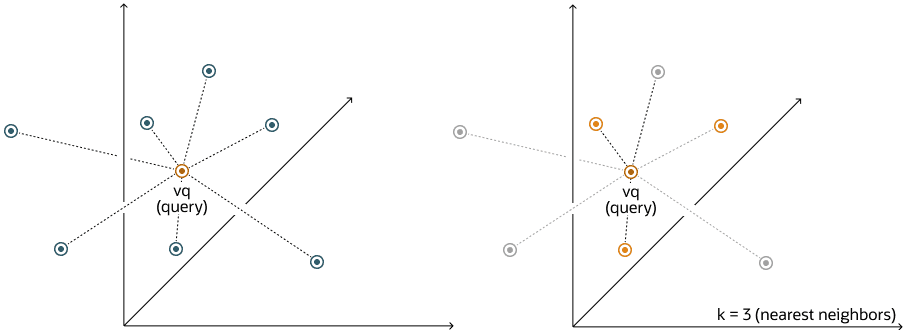
通过精确搜索,您可以通过计算查询向量与每个向量的距离,将查询向量 vq 与空间中的其他向量进行比较。计算所有这些距离后,搜索将返回最接近的 k 作为最接近的匹配项。这被称为 k-nearest neighbor(kNN) 搜索。
例如,欧几里得相似性搜索涉及相对于欧几里得距离度量和查询向量检索空间中前 k 个最接近的向量。以下示例使用以下精确相似性搜索查询从 vector_tab 表中检索最接近 query_vector 的前 10 个向量:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;在此示例中,docID 和 embedding 是 vector_tab 表中定义的列,embedding 具有 VECTOR 数据类型。
在欧几里德距离的情况下,比较平方距离相当于比较距离。因此,当排序比距离值本身更重要时,欧几里得平方距离非常有用,因为它比欧几里得距离(避免平方根计算)计算得更快。因此,按如下方式重新编写查询会更简单、更快:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;注:EXACT 关键字是可选的。如果在连接到 ADB-S 实例时省略,则尝试使用向量索引进行近似搜索(如果存在)。有关详细信息,请参阅使用向量索引执行近似相似性搜索。
注:请确保使用用于训练嵌入模型的距离函数。
另请参阅: Oracle AI Database SQL Language Reference,了解 ROW_LIMITING_CLAUSE 的完整语法
使用向量索引了解近似相似性搜索
对于具有较大向量空间的较快搜索速度,可以使用向量索引使用近似相似性搜索。
将向量索引用于相似性搜索称为近似搜索。大致搜索使用向量索引,以抵消性能的准确性。
大向量空间的近似搜索
当搜索质量是您的高优先级并且搜索速度不那么重要时,精确相似性搜索是一个不错的选择。对于较小的向量空间或使用高性能服务器执行搜索时,搜索速度可能无关紧要。然而,ML 算法通常在有数十亿个嵌入的向量空间上执行相似性搜索。例如,Deep1B 数据集包含卷积神经网络 (CNN) 生成的 1B 图像。与语料库中的每个矢量一起计算矢量距离,以 100% 的准确率找到 Top-K 匹配是非常缓慢的。
幸运的是,可以使用向量索引执行多种类型的近似搜索。向量索引可能不太准确,但它们可以消耗更少的资源,并且可以更高效。与传统数据库索引不同,向量索引是使用基于启发式算法构建和执行搜索的。
由于启发式方法无法保证 100% 的准确性,因此向量索引搜索使用目标准确性。在内部,用于索引创建和索引搜索的算法正在尽最大努力使其尽可能准确。但是,您可以通过指定目标准确性来影响这些算法。创建索引或搜索索引时,您可以通过指定百分比值或根据所使用的索引类型指定内部参数值来指定非默认目标准确度值。
目标准确度示例
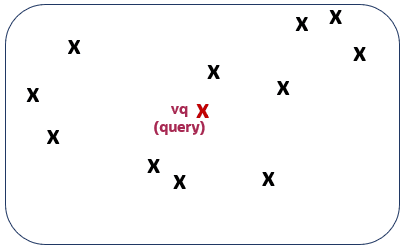
为了更好地了解目标准确性的含义,请查看以下图表。第一个图展示了向量空间,其中每个向量由一个小十字表示。红色代表您的查询向量。
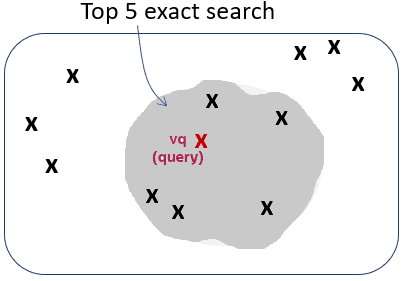
在该上下文中运行前 5 个精确相似性搜索将返回第二个图中显示的五个向量:
根据向量索引的构建方式,在该上下文中运行前 5 个近似相似性搜索可能会返回第三个图中显示的五个向量。这是因为索引创建过程正在使用启发式。因此,搜索向量索引可能会导致与精确搜索不同的结果:
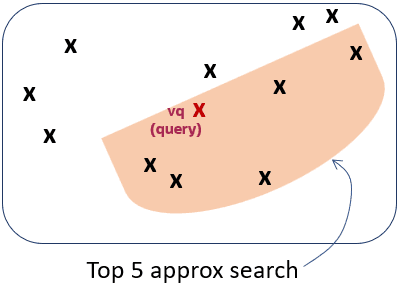
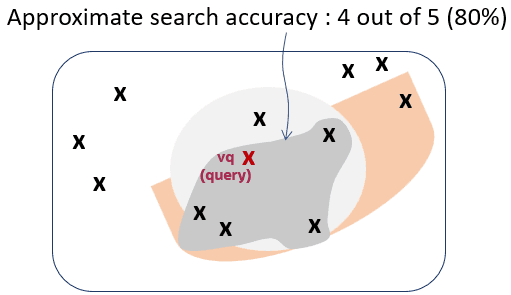
正如您所看到的,检索到的向量是不同的,在这种情况下,它们因一个向量而异。这意味着,与精确搜索相比,相似性搜索正确检索了 5 个向量中的 4 个。相似性搜索与精确相似性搜索相比具有 80% 的准确性。这在第四张图中进行了说明:
由于向量索引的性质是近似搜索结构,因此在 Top-K 相似性搜索中返回的行可能少于 K 行。
有关如何设置向量索引的信息,请参阅创建向量索引。
执行多向量相似性搜索
向量搜索的另一个主要用例是多向量搜索。多向量搜索通常与多文档搜索关联,在多文档搜索中,文档拆分为单个嵌入到向量的块。
多向量搜索包括使用基于文档特征的分组标准(称为分区)检索 top-K 向量匹配。这种基于文档块与要搜索的查询向量的相似性对文档进行评分的功能在 SQL 中使用分区行限制子句进行了简化。
通过多向量搜索,可以更轻松地编写 SQL 语句来回答以下类型的问题:
- 如果它们存在,在两个最佳匹配书籍的三个最佳匹配段落中找到四个最匹配的句子是什么?
例如,假设数据库中的每本书被组织成包含具有向量嵌入表示的句子的段落,则可以使用单个 SQL 语句回答上一个问题,例如:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
您还可以使用近似相似性搜索,而不是使用精确相似性搜索,如以下示例中所示:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;注:返回的所有行均按 VECTOR_DISTANCE() 排序,而不是按分区子句分组。
以语义上,上一 SQL 语句解释为:
-
按句子和查询向量之间的向量距离的降序对工作簿表中的所有记录进行排序。
-
对于本订购文件中的每条记录,检查其
bookId和paragraphId。如果满足以下三个条件,则生成此记录:-
其
bookId是按排序顺序排列的前两个不同的bookId之一。 -
其
paragraphId是同一bookId中按排序顺序排列的前三个不同的paragraphId之一。 -
其记录是同一
bookId和paragraphId组合中的前四个记录之一。
-
-
否则,此记录将被筛选掉。
多向量相似性搜索不仅适用于文档,还可用于回答以下问题:
-
返回顶部 K 最接近的匹配照片,但请确保它们是不同人的照片。
-
找到两个或更多音频片段最适合此声音片段的顶级 K 歌曲。
注意:
-
此分区限行子句扩展是 SQL 语言的通用扩展。它不必仅应用于向量搜索。
-
IVF 索引目前支持多向量搜索。
另请参阅: Oracle AI Database SQL Language Reference,了解 ROW_LIMITING_CLAUSE 的完整语法