Oracle AI Database 中的人工智慧
本章描述 Oracle AI Database 中提供的人工智慧功能。
-
Oracle AI Vector Search 簡介 Oracle AI Vector Search 是專為人工智慧 (AI) 工作負載設計的,可讓您根據語意而非關鍵字查詢資料。
-
向量距離度量:測量向量空間中的距離是識別指定查詢向量最相關結果的核心。該程序與關聯式資料庫世界中已知的關鍵字篩選非常不同。
-
可瀏覽階層小型世界索引概要 使用這些範例來瞭解如何建立向量近似相似性搜尋的 HNSW 索引。
-
瞭解倒轉檔案平面向量索引:倒轉檔案平面向量索引是一種技術,旨在透過使用鄰近的分割區或叢集來縮小搜尋區域,以提高搜尋效率。
-
執行相似性搜尋:本節說明執行相似性搜尋的方法。
Oracle AI Vector Search 概要
Oracle AI Vector Search 是專為人工智慧 (AI) 工作負載所設計,可讓您根據語意而非關鍵字查詢資料。
VECTOR 資料類型
Oracle AI Database 26ai 推出了 VECTOR 資料類型,為將向量內嵌和資料庫中的業務資料一起儲存的基礎。使用內嵌模型,您可以將非結構化資料轉換為向量內嵌,然後用於業務資料的語意查詢。若要使用 VECTOR 資料類型及其相關功能,必須將 COMPATIBLE 初始化參數設為 23.4.0 或更新版本。如需有關參數及其變更方式的詳細資訊,請參閱 Oracle AI Database Upgrade Guide。
請參閱下列在表格定義中使用 VECTOR 資料類型的基本範例:
CREATE TABLE docs (doc_id INT, doc_text CLOB, doc_vector VECTOR);如需有關 VECTOR 資料類型以及如何在表格中使用向量的詳細資訊,請參閱使用 VECTOR 資料類型建立表格。
由於 VECTOR 資料類型的數字性質,您可以使用它作為機器學習演算法的輸入,例如分類、異常、迴歸、叢集和功能擷取。如需有關在機器學習中使用 VECTOR 資料類型的詳細資訊,請參閱向量資料類型支援。注意:從 23.7 開始,所有版本都支援 VECTOR 資料類型機器學習。
向量內嵌項目
如果您曾經使用過語音助理、聊天機器人、語言翻譯人員、建議系統、異常偵測或視訊搜尋與辨識等應用程式,就必須使用隱含的向量內嵌功能。
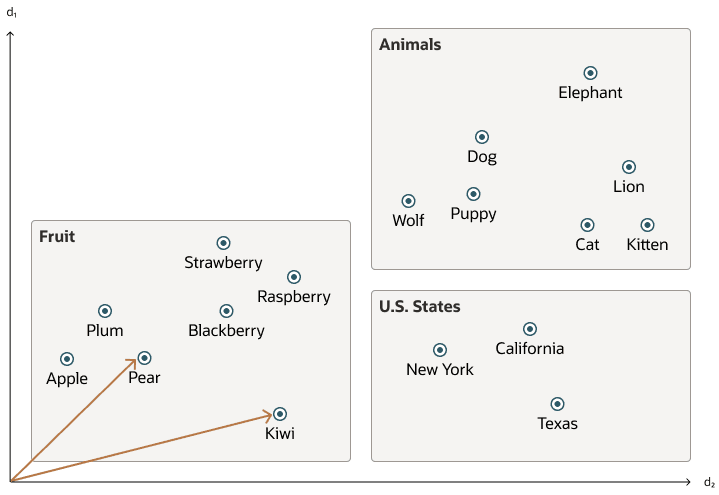
Oracle AI Vector Search 會儲存向量內嵌項目,也就是資料點的數學向量表示法。這些向量內嵌描述了文字、文件、音軌或影像等內容背後的語意意義。例如,在進行以文字為基礎的搜尋時,向量搜尋通常比關鍵字搜尋來得好,因為向量搜尋是以文字背後的意義與內容為基礎,而不是實際的文字本身。此向量表示法會將人類感知的物件語意相似性轉譯為數學向量空間中的鄰近。此向量空間通常具有數百 (如果不是千) 的維度。以不同的方式,向量內嵌是一種將幾乎任何種類的資料 (例如文字、影像、影片、使用者或音樂) 呈現為多維空間中的點,而這些點在空間中的位置和其他點相鄰的位置則具有半意義。
此簡化圖表說明將單字編碼為二維向量的向量空間。
相似性搜尋
在資料集內搜尋語意相似性現在等同於在向量空間中搜尋最接近的鄰居,而不是使用使用查詢述詞的傳統關鍵字搜尋。如下圖所示,此向量空間中 dog 與 wolf 之間的距離,比 dog 與 kitten 之間的距離短。在這個空間中,一隻狗與一隻狼類似,比牠與一隻貓更類似。請參閱執行完全相似性搜尋以瞭解詳細資訊。
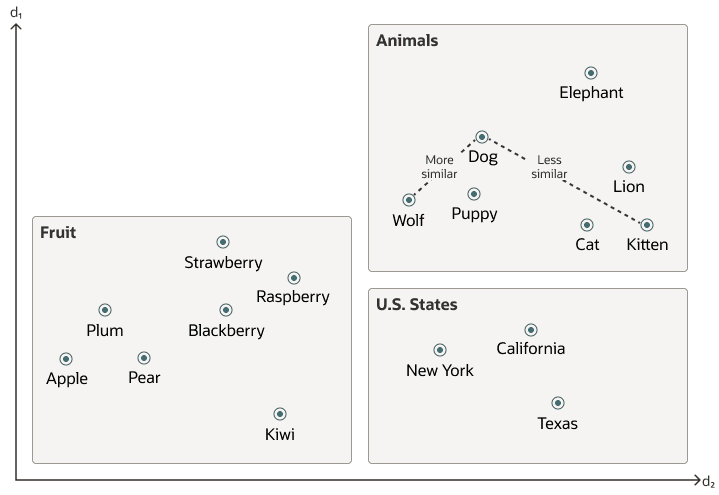
圖解描述 vector_embeddings_similarity.png
向量資料通常不會平均分配,並將其叢集化成與語意相關的群組。根據指定的查詢向量執行相似性搜尋等同於擷取向量空間中查詢向量的 K 最接近向量。基本上,您需要透過對向量進行分級來尋找排序的向量清單,其中清單中的第一個資料列是與查詢向量最接近或最相似的向量,而清單中的第二個資料列是與查詢向量最接近的第二個向量,依此類推。進行相似性搜尋時,相對距離的順序是真正重要的,而非實際距離。
使用前面的向量空間,以下是語意搜尋的插圖,其中您的查詢向量是與 Puppy 這個字相對應的文字,而您想要識別四個最接近的字:
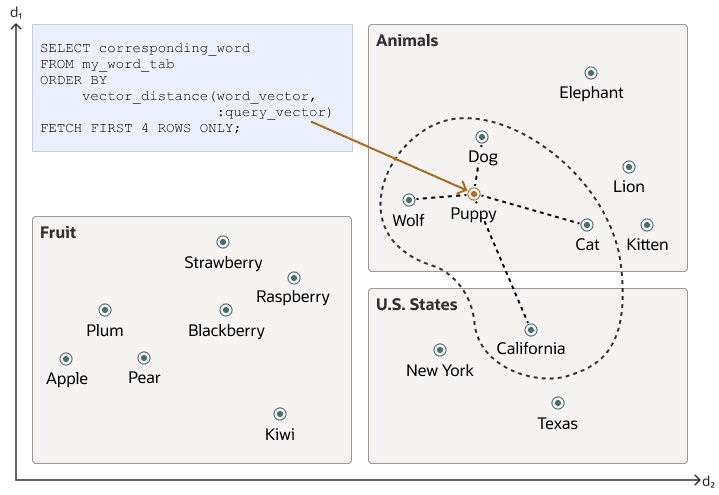
圖解描述 vector_embeddings_similarity_search.png
相似性搜尋往往會根據查詢向量的值和擷取大小,從一或多個叢集取得資料。
使用向量索引的概略搜尋可以將搜尋限制在特定叢集,而確切搜尋則是會造訪所有叢集的向量。如需詳細資訊,請參閱使用向量索引。
向量內嵌模型
建立這類向量內嵌的其中一種方式可能是使用某個人的領域專業知識來量化一組預先定義的功能或維度,例如形狀、紋理、顏色、情感等,以及其他許多功能,視您正在處理的物件類型而定。不過,此方法的效率取決於使用案例,而且不一定符合成本效益。
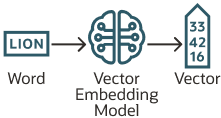
相反地,向量內嵌是透過神經網路建立的。大多數現代向量內嵌都使用變壓器模型,如下圖所示,但也可以使用迴旋神經網路。
圖 1:向量嵌入模型
視您的資料類型而定,您可以使用不同的預先訓練開放原始碼模型建立向量內嵌。舉例而言:
-
對於文字資料,句子變壓器會將文字、句子或段落轉換為向量內嵌。
-
對於視覺資料,您可以使用剩餘網路 (ResNet) 來產生向量內嵌。
-
對於音訊資料,您可以使用音訊資料的視覺頻譜圖表示法來轉回視覺資料案例。
每個模型還決定了向量的尺寸數量。舉例而言:
-
Cohere 的嵌入模型 embed-english-v3.0 有 1024 個尺寸。
-
OpenAI 的嵌入模型 text-embedding-3-large 有 3072 個尺寸。
-
Hugging Face 的嵌入模型 all-MiniLM-L6-v2 有 384 個尺寸
當然,您可以建立自己使用自己資料集訓練的模型。
將內嵌模型匯入 Oracle AI Database
雖然您可以使用預先訓練的開源內嵌模型或自己的內嵌模型,在 Oracle AI Database 外部產生向量內嵌項目,但如果這些模型與 Open Neural Network Exchange (ONNX) 標準相容,您也可以選擇將這些模型直接匯入 Oracle AI Database。Oracle AI Database 直接在資料庫內導入 ONNX 執行階段。這可讓您使用 SQL 直接在 Oracle AI Database 中產生向量內嵌項目。如需詳細資訊,請參閱產生向量內嵌。
向量距離單位標準
向量空間中的測量距離是識別指定查詢向量最相關結果的核心。該程序與關聯式資料庫世界中已知的關鍵字篩選非常不同。
使用向量時,有幾種方法可以計算距離,以確定兩個向量的相似或不相似。每個距離度量都是使用不同的數學公式計算。計算兩個向量之間的距離所需的時間取決於許多因素,包括使用的距離公制以及向量本身的格式,例如向量尺寸和向量尺寸格式。一般而言,最好將您使用的距離度量與用來訓練產生向量之向量內嵌模型的距離度量進行比對。
階層式可瀏覽小型世界索引總覽
使用這些範例來瞭解如何為向量近似相似性搜尋建立 HNSW 索引。
在可瀏覽的小型世界 (NSW) 中,概念是建立鄰近圖形,圖表中的每個向量會根據三個特性與其他向量相連接:
-
向量之間的距離
-
插入
(EFCONSTRUCTION)時,在搜尋的每個步驟中考慮的最接近向量候選項目數上限 -
每個向量允許的最大連線數 (
NEIGHBORS)
如果上述臨界值的組合過高,則您最後可能會使用密集連線的圖表來減緩搜尋處理速度。另一方面,如果這些臨界值的組合太低,則圖表可能會變得太稀疏和 (或) 中斷連線,這使得在搜尋期間尋找特定向量之間的路徑變得非常困難。
向量搜尋的可瀏覽「小型世界 (NSW)」圖形周遊從圖表中預先定義的進入點開始,存取一組與最密切相關的向量。搜尋演算法使用兩個關鍵清單:候選項目、在圖表周遊時所遇到的動態更新向量列表,以及包含目前最接近查詢向量的向量結果。隨著搜尋的進展,演算法會瀏覽整個圖表,藉由探索和評估可能比結果中的向量更接近的向量來持續縮小候選項目。一旦「候選人」中沒有比「結果」中最接近的向量,處理程序就會結束,指出已達到本端的下限,且已識別出與查詢向量最接近的向量。
這說明如下圖:
圖 2:可瀏覽的小型世界圖形
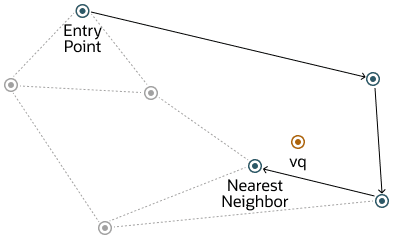
navigable-small-world-graph.png 圖解描述
所描述的方法會展示強大的效能,直到一定程度的向量插入到圖表中。除了此臨界值之外,「階層式可瀏覽小型世界」(HNSW) 方法還透過引入多層階層 (Probabilistic Skip Lists) 中觀察到的結構來增強 NSW 模型。此階層式架構是透過將圖表的連線分散到多個層來實行,並以每個後續層包含下方層之向量子集的方式進行組織。此分層可確保頂層可擷取長距離連結,有效地作為整個圖表的快速路徑,而下層則著重於較短的連結,以促進微點的本機導覽。因此,搜尋會從較高的圖層開始,以快速接近目標向量的區域,並逐步移至較低的圖層進行更精確的搜尋,並利用向量之間的較短連結 (較小的距離) 從上到下移動,大幅提升搜尋效率和準確性。
為了更加瞭解這對 HNSW 的運作方式,讓我們看看此階層如何用於「機率略過清單」結構:
圖 3:機率略過清單結構
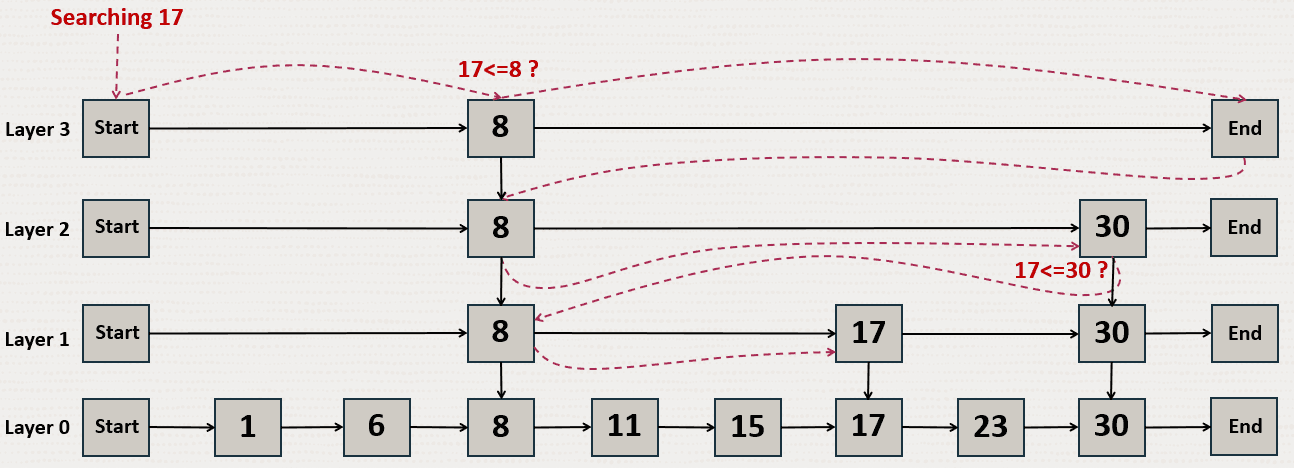
「成功率略過清單」結構使用連結清單的多個圖層,其中上述圖層略過的數目超過較低的數目。在此範例中,您正嘗試搜尋數字 17。從最上層開始,然後跳至下一個元素,直到找到 17,然後到達清單的結尾處,或是找到大於 17 的數字。當您到達清單的結尾或找到大於 17 的數字時,則從小於 17 的最新數字開始於上一層。
HNSW 與 NSW 圖層使用相同的原理,在這些圖層中,您會在向量之間找到較大的距離。這會在 2D 空間中以下列圖表說明:
頂層是最長的邊,底層是最短的邊。
圖 4:可瀏覽階層的小型世界圖形
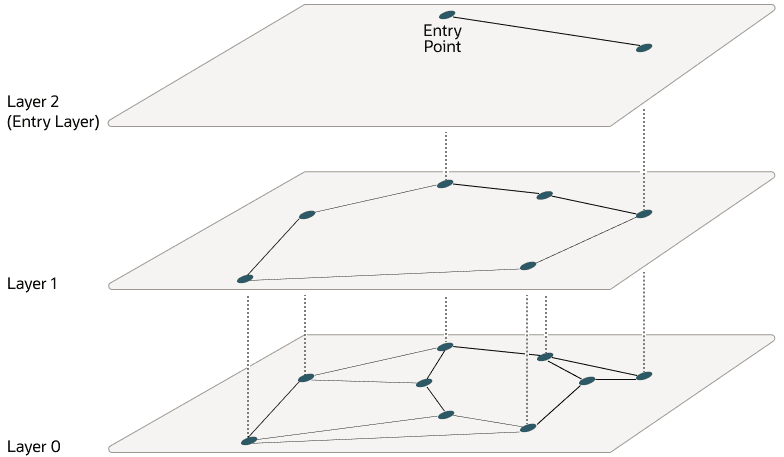
hierarchical-navigable-small-world-graph_02.png 圖解描述
從頂層開始,一層的搜尋會從進入向量開始。然後,針對每個節點,如果有比目前節點更接近查詢向量的鄰居,就會跳到該鄰居。演算法會持續執行此動作,直到找到查詢向量的區域最小值為止。在一個圖層中找到本端最小值時,在該新圖層中使用相同的向量搜尋到下一個圖層,然後在該圖層中繼續搜尋。此過程會重複自身,直到找到包含所有向量的底層本端最小值為止。此時,搜尋會使用 NSW 演算法將找到的最新本機最小值轉換為約略相似度搜尋,以將前 k 個最相似的向量擷取至查詢向量。雖然上層可以對由 NEIGHBORS 參數設定的每個向量最多連接,但層 0 可以擁有兩倍多。此程序說明如下圖:
圖 5:可瀏覽階層的小型世界圖形搜尋
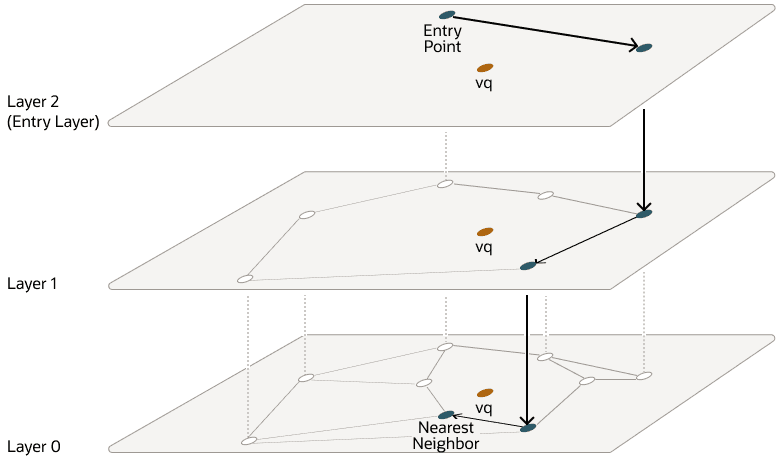
hnsw-search-graph_02-png.png 圖解描述
圖層是使用記憶體內圖表 (不是 Oracle Inmemory 圖表) 來實行。每個圖層都使用個別的記憶體內圖形。如先前所見,建立 HNSW 索引時,您可以使用 NEIGHBORS 參數,微調上層中每個向量的最大連線數,以及使用 EFCONSTRUCTION 參數,在插入期間,每個搜尋步驟中考慮的最接近向量候選項目數上限,其中 EF 代表 Enter Factor。
如先前所述,使用 Oracle AI Vector Search 使用 HNSW 索引執行概略搜尋查詢時,您可以指定應執行概略搜尋的目標準確度。
若為 HNSW 概略搜尋,您可以指定目標準確度百分比值,以影響被視為探查搜尋的候選項目數目。這是由演算法自動計算。值 100 往往會將類似的結果視為完全相符的搜尋,但系統仍可能使用索引,且不會執行完全相符的搜尋。最佳化處理程式可以選擇仍使用索引,因為只要在查詢中有述詞,索引的執行速度就會比較快。除了指定目標精確度百分比值之外,您可以指定 EFSEARCH 參數,在偵測索引時,指定要考慮的候選項目數目上限。數字越高,準確度就越高。
備註:
-
如果您未在概略搜尋查詢中指定任何目標準確性,則在建立索引時,將會繼承一個集合。您會在建立索引時看到,根據您正在建立的索引類型,您可以使用百分比值或參數值來指定目標準確性。
-
在索引搜尋時,可以指定與建立索引時設定的不同目標準確度。對於 HNSW 索引,您可以使用
EFSEARCH參數 (比建立索引時指定的EFCONSTRUCTION值高) 來查看更多鄰近項目,以取得更精確的結果。您在建立索引時所提供的目標準確性會決定索引建立參數,並作為向量索引搜尋的預設準確性值。
瞭解反轉檔案平面向量索引
反轉檔案平面向量索引是一種技術,旨在透過使用鄰近的分割區或叢集來縮小搜尋區域範圍,以提升搜尋效率。
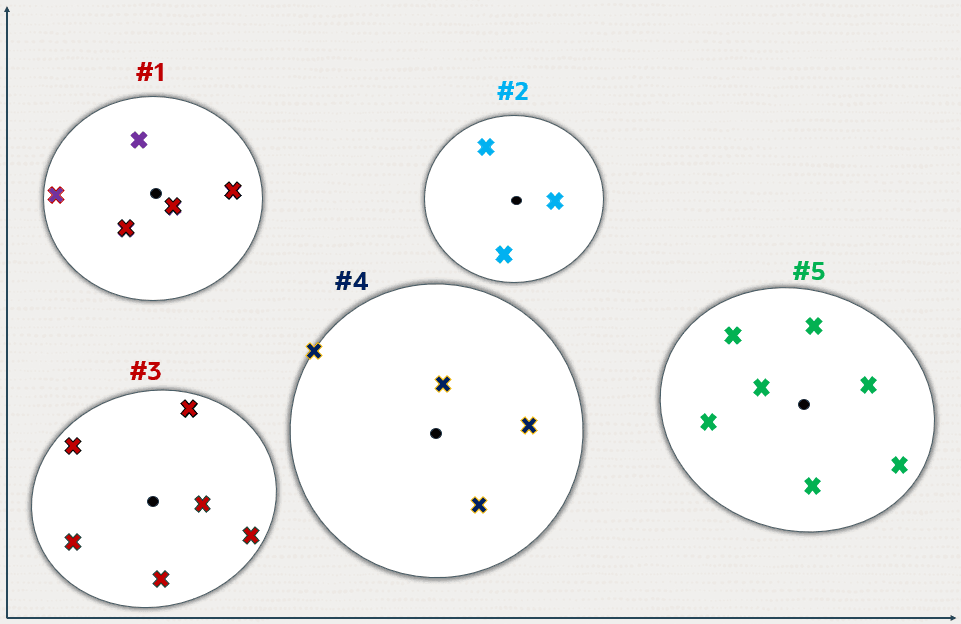
下列圖表描述如何使用 2D 空間表示法,在大約搜尋中建立分割區或叢集的方式。不過,這可以通識到更高的維度空間。
圖 6:使用 2D 的倒轉檔案均一索引
inverted-file-index_1.png 圖解描述
交叉表示此空間中的向量資料點。
新增的資料點 (顯示為小平面的圓形) 可識別 k 分割區甲狀腺,其中甲狀腺 (k) 的數目是由資料集的大小 (n) 決定。一般而言,k 會設為 n 的平方根,但在建立索引時指定 NEIGHBOR PARTITIONS 參數可加以調整。
每個形心均代表相應分割的平均向量 (重心)。
甲狀腺的計算方式是通過向量的訓練,其目標是將每個向量與最接近的甲狀腺的總距離降到最低。
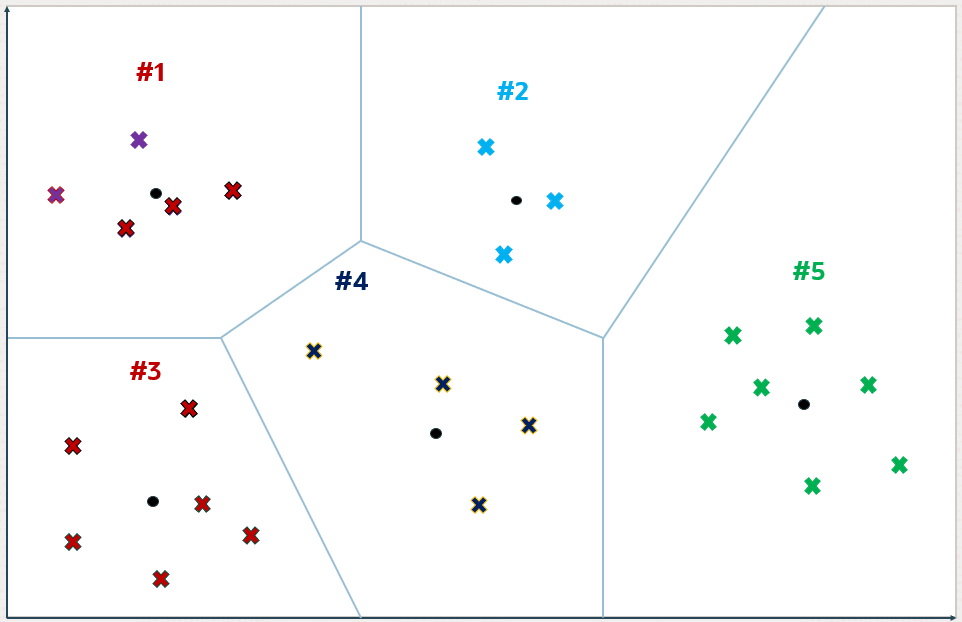
甲狀腺最後將向量空間分割成 k 分割區。此部門的概念性說明為從甲狀腺展開圓,在滿足時停止成長,形成不同的分割區。
圖 7:倒轉檔案均一索引
inverted-file-index_5.png 圖解描述
除了周邊設備之外,每個向量都位於與甲狀腺關聯的特定分割區內。
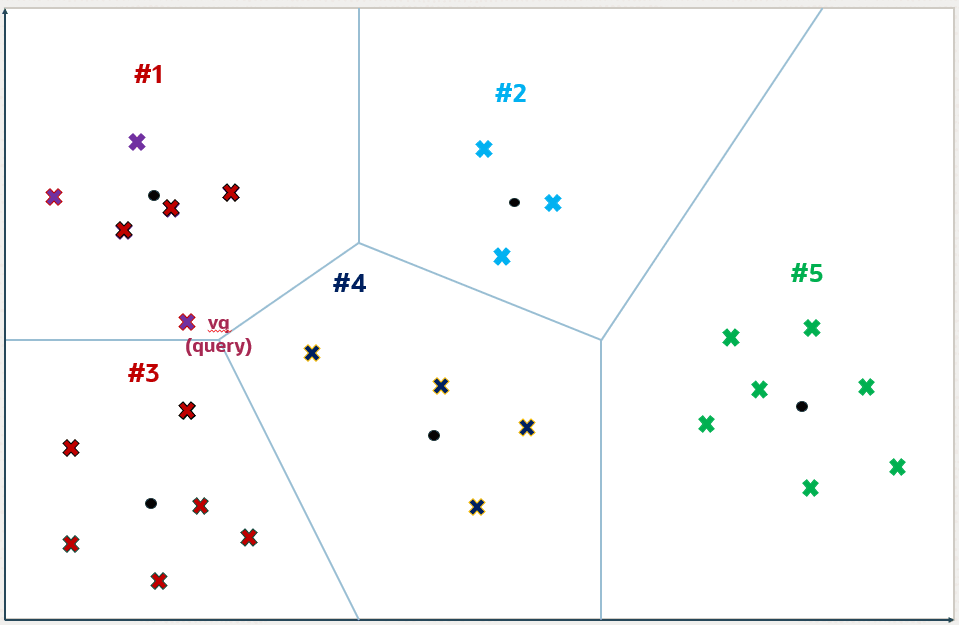
圖 8:倒轉檔案均一索引
inverted-file-index_6.png 圖解描述
對於查詢向量 vq,搜尋演算法會識別最近的 i 中心,其中 i 預設為 k 的平方根,但可藉由設定 NEIGHBOR PARTITION PROBES 參數來調整特定查詢。此調整允許在搜尋速度與準確度之間進行權衡。
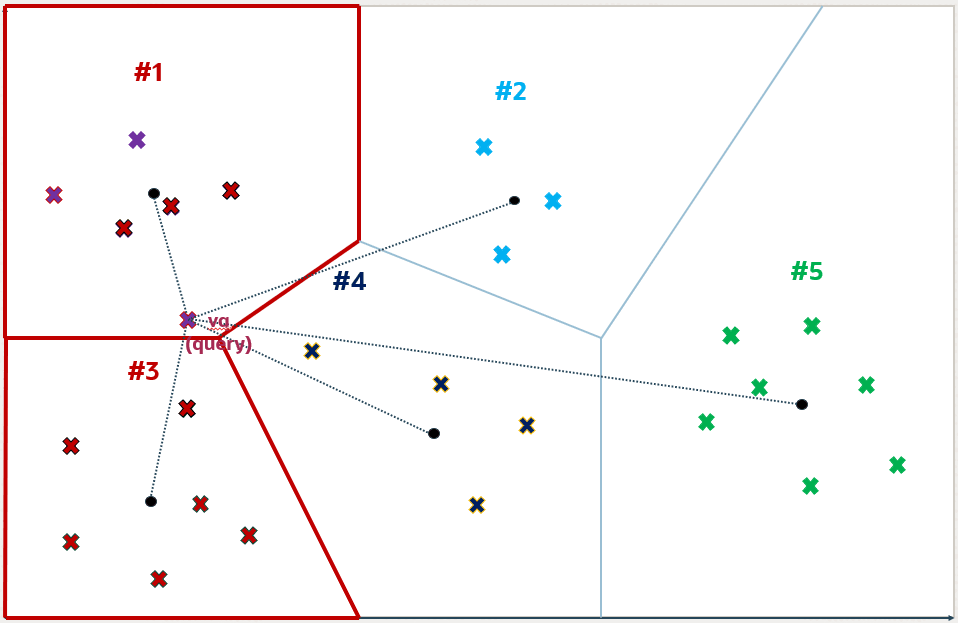
此參數的數字越高,準確性就越高。在本範例中,i 設為 2,而兩個識別的分割區為分割區編號 1 和 3。
圖 9:倒轉檔案均一索引
inverted-file-index_7.png 圖解描述
決定 i 分割區之後,會完整掃描這些分割區,以識別最接近的前 5 個向量。此數字 5 可以與 k 不同,而且您可以在查詢中指定此數字。在分割區編號 1 和 3 中找到的 5 個最接近 vq 的向量,在下圖中重點顯示。
此方法構成概略搜尋,因為它會將搜尋限制在分割區的子集,因此可加速處理作業,但可能會在未檢查的分割區中遺漏較接近的向量。此範例說明概略搜尋可能不會將最接近的向量產生至 vq,以示範搜尋效率與準確性之間固有的權衡。
圖 10:倒轉檔案均一索引
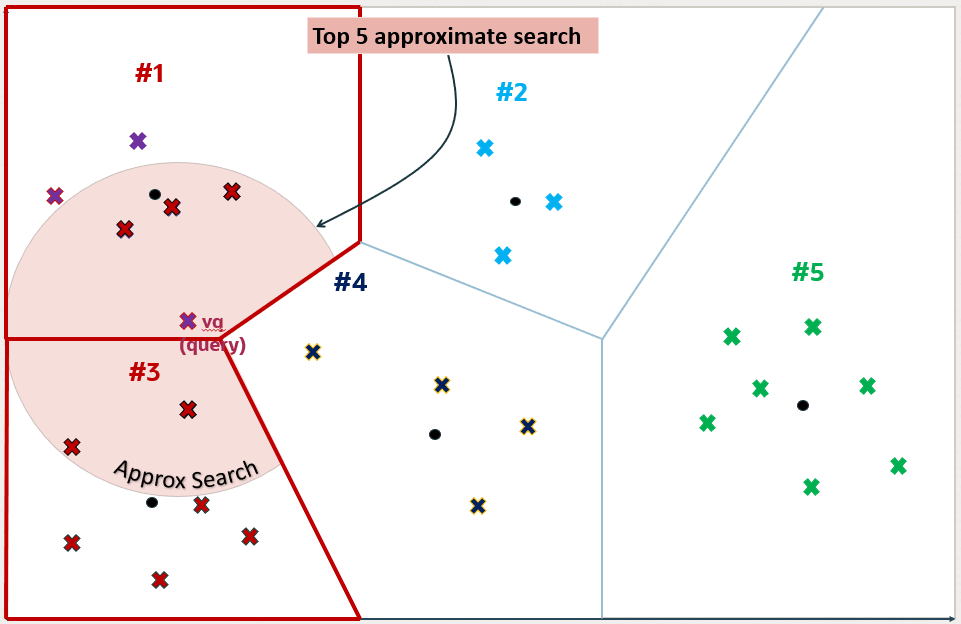
inverted-file-index_10.png 圖解描述
不過,vq 中 5 個最接近的向量並非大概搜尋所找到的向量。您可以在分割區編號 4 中看到其中一個向量比分割區編號 3 中擷取的向量要接近 vq。
圖 11:倒轉檔案均一索引
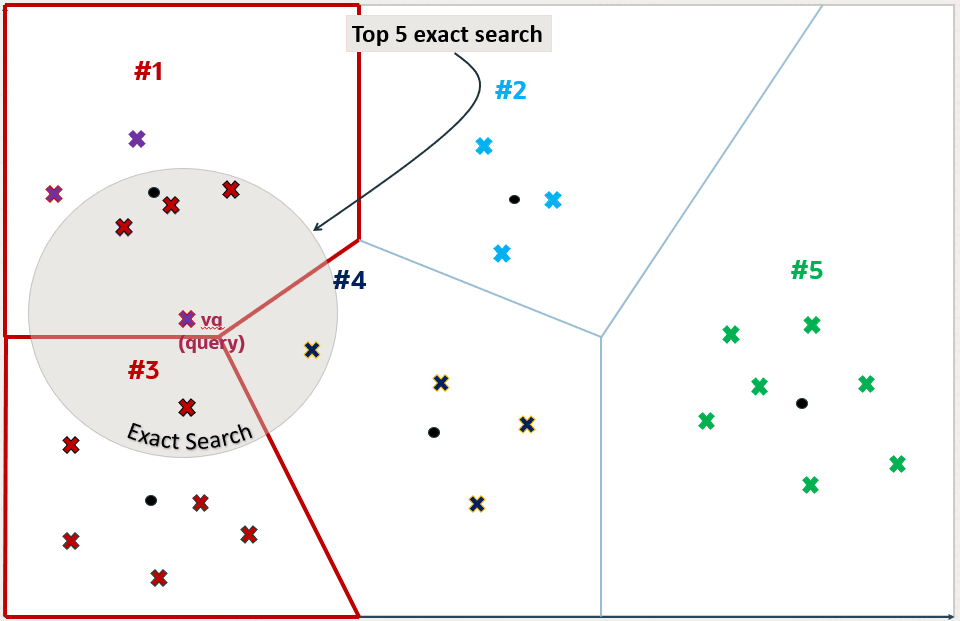
inverted-file-index_11.png 圖解描述
您現在可以查看為何使用向量索引搜尋不一定是完全相同的搜尋,這稱為概略搜尋。在此範例中,大約搜尋準確度僅為 80%,因為它只擷取了 5 個精確搜尋向量結果中的 4 個。
圖 12:倒轉檔案均一索引
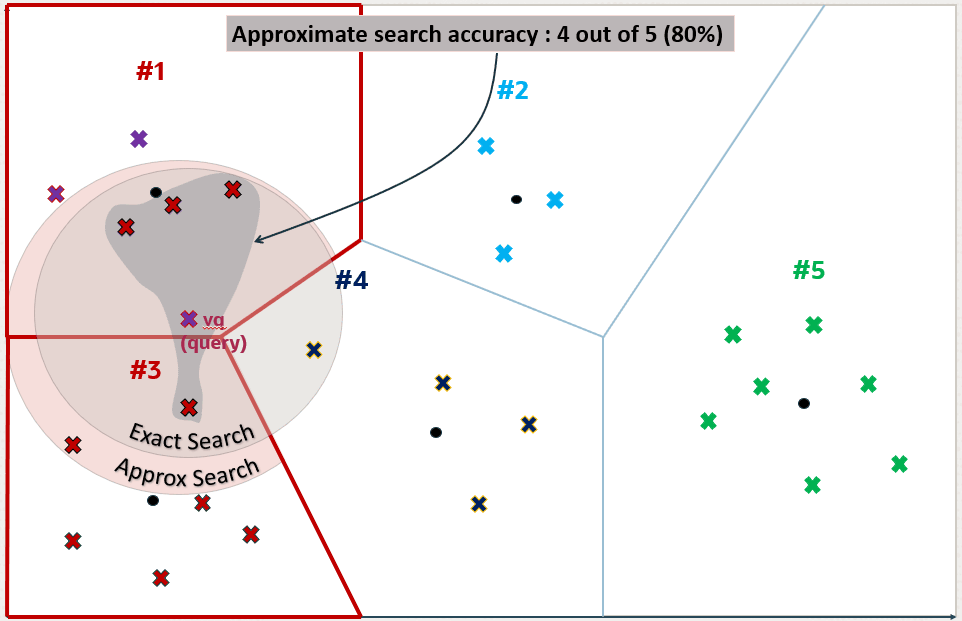
inverted-file-index_12.png 圖解描述
使用 Oracle AI Vector Search 使用向量索引執行概略搜尋查詢時,您可以指定應執行概略搜尋的目標準確性。
如果是 IVF 大約搜尋,您可以指定目標準確度百分比值,以影響用來探測搜尋的分割區數目。這是由演算法自動計算。值 100 往往會執行完全相同的搜尋,但系統仍可能使用索引,且不會執行完全相同的搜尋。最佳化處理程式可以選擇仍使用索引,因為只要在查詢中有述詞,索引的執行速度就會比較快。您可以指定 NEIGHBOR PARTITION PROBES 參數來指定搜尋所要偵測的特定分割區數目上限,而非指定目標精確度百分比值。數字越高,準確度就越高。
備註:
-
如果您未在概略搜尋查詢中指定任何目標準確性,則在建立索引時,將會繼承一個集合。您會在建立索引時看到,您可以根據正在建立的索引類型,使用百分比值或參數值來指定目標準確性。
-
與建立索引時設定的目標準確度相比,您可以在索引搜尋時指定不同的目標準確度。對於 IVF 索引,您可以使用
NEIGHBOR PARTITION PROBES參數來探測更多 Centroid 分割區以取得更精確的結果。您在建立索引時提供的目標準確性會決定索引建立參數,並作為向量索引搜尋的預設準確性值。
執行相似性搜尋
本節說明執行相似性搜尋的方法。
-
執行完全相似性搜尋:相似性搜尋會尋找與查詢向量比較的向量相對順序。基本上,比較是使用特定的距離度量進行,但最重要的是最接近向量的結果集,而不是它們之間的距離。
-
瞭解使用向量索引的概略相似性搜尋:若要加快具有大型向量空間的搜尋速度,您可以使用向量索引的概略相似性搜尋。
-
執行多向量相似性搜尋向量搜尋的另一個主要使用案例是多向量搜尋。多向量搜尋通常與多文件搜尋相關聯,其中文件會分割成個別內嵌在向量中的區塊。
執行完全相似性搜尋
相似性搜尋會尋找向量與查詢向量比較的相對順序。基本上,比較是使用特定的距離度量進行,但最重要的是最接近向量的結果集,而不是它們之間的距離。
例如,如果指定特定查詢向量,您可以計算與資料集內所有其他向量的距離。這種搜尋類型 (亦稱為平面搜尋或精確搜尋) 會產生具有完美搜尋品質的最準確結果。不過,搜尋時間的成本相當高。這由下列圖表說明:
圖 13:精確搜尋
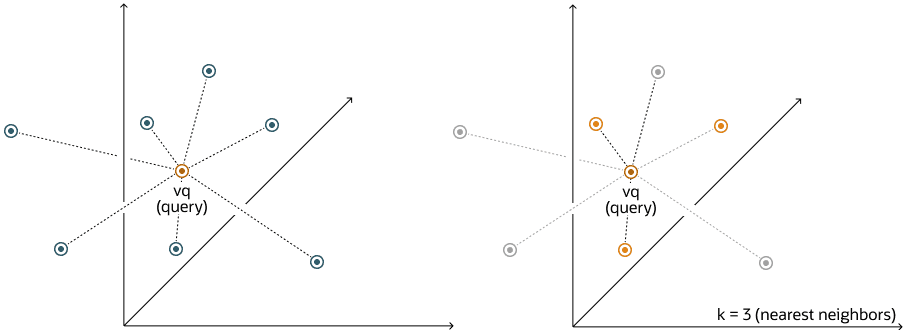
使用精確的搜尋,您可以透過計算查詢向量 vq 與空間中其他向量的距離,來比較其與每個向量的距離。計算所有這些距離之後,搜尋會傳回最接近的相符項目 k。這稱為 k- 最接近的鄰居 (kNN) 搜尋 。
例如,Euclidean 相似性搜尋涉及擷取空間中最接近的向量 (相對於 Euclidean 距離度量和查詢向量)。以下範例使用下列精確相似度搜尋查詢,從最接近 query_vector 的 vector_tab 表格擷取前 10 個向量:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN )
FETCH EXACT FIRST 10 ROWS ONLY;在此範例中,docID 和 embedding 是 vector_tab 表格中定義的資料欄,而 embedding 具有 VECTOR 資料類型。
在歐氏距離的情況下,比較平方距離等同於比較距離。因此,當訂購比距離值本身更重要時,Euclidean Squared 距離非常有用,因為計算速度比 Euclidean 距離快 (避開平方根計算)。因此,重新寫入查詢的方式較簡單且更快,如下所示:
SELECT docID
FROM vector_tab
ORDER BY VECTOR_DISTANCE( embedding, :query_vector, EUCLIDEAN_SQUARED)
FETCH FIRST 10 ROWS ONLY;注意:EXACT 關鍵字是選擇性的。如果在連線至 ADB-S 執行處理時省略,系統會嘗試使用向量索引進行概略搜尋 (如果有的話)。如需詳細資訊,請參閱使用向量索引執行近似相似性搜尋。
注意:請確定您使用用來訓練內嵌模型的距離函數。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 ROW_LIMITING_CLAUSE 的完整語法
瞭解使用向量索引的近似相似性搜尋
為了加快具有大型向量空間的搜尋速度,您可以使用向量索引的近似相似性搜尋。
對相似性搜尋使用向量索引稱為概略搜尋。概略搜尋使用向量索引,以消除效能的準確性。
大向量空間概略搜尋
當搜尋品質是您的高優先順序且搜尋速度較不重要時,「精確相似度」搜尋是不錯的選擇。搜尋速度與較小的向量空間無關,或是在使用高效能伺服器執行搜尋時。然而,ML 演算法通常會對具有數十億個內嵌項目的向量空間執行相似性搜尋。例如,Deep1B 資料集包含由 Convolutional Neural Network (CNN) 產生的 1B 影像。計算向量距離與語料庫中的每個向量,以 100% 的精確度尋找 Top-K 比對非常緩慢。
幸運的是,您可以使用向量索引執行許多類型的概略搜尋。向量索引可能較不準確,但會消耗較少的資源,並提高效率。與傳統資料庫索引不同,會使用試探式演算法建構向量索引並執行搜尋。
由於試探無法保證百分之百的準確性,因此向量索引搜尋使用目標準確性。在內部,用於建立索引和搜尋索引的演算法會盡可能準確。不過,您可以藉由指定目標準確性來影響這些演算法。建立索引或搜尋索引時,您可以指定百分比值或指定內部參數值 (視您正在使用的索引類型而定),來指定非預設的目標準確性值。
目標準確度範例
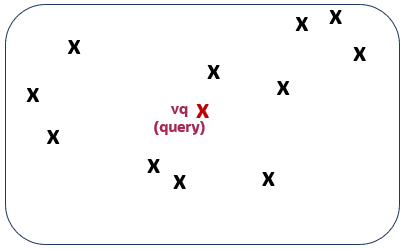
為了更加瞭解目標準確性所代表的意義,請查看下列圖表。第一個圖說明一個向量空間,其中每個向量由一個小交叉表示。紅色代表您的查詢向量。
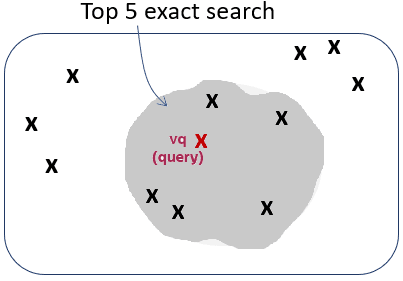
在該環境定義中執行前 5 個完全相似性搜尋會傳回第二個圖表中顯示的五個向量:
視向量索引的建構方式而定,在該環境定義中執行前 5 個近似相似性搜尋可能會傳回第三個圖表中顯示的 5 個向量。這是因為索引建立處理正在使用經驗法則。因此,搜尋整個向量索引可能會導致與精確搜尋相比的結果不同:
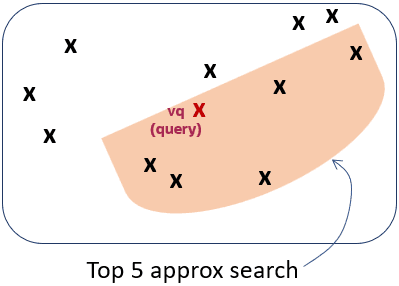
如您所見,擷取的向量不同,在此情況下,它們會因一個向量而不同。這表示相較於確切的搜尋,相似性搜尋擷取了 5 個向量中的 4 個。相較於完全相似度搜尋,相似度搜尋的準確度為 80%。這說明於第四個圖表中:
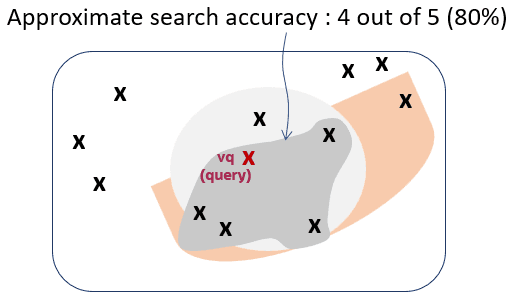
由於向量索引的性質為近似搜尋結構,因此在頂層相似性搜尋中傳回的列數可能少於 K。
如需有關如何設定向量索引的資訊,請參閱建立向量索引。
執行多向量相似性搜尋
向量搜尋的另一個主要使用案例是多向量搜尋。多向量搜尋通常與多文件搜尋相關聯,其中文件會分割成個別內嵌在向量中的區塊。
多向量搜尋包含使用群組準則 (稱為根據文件特性的分割區) 來擷取前 K 個向量相符項目。此功能可根據文件區塊與要搜尋之查詢向量的相似性,在 SQL 中使用分割的資料列限制子句進行文件評分。
透過多向量搜尋,可以更容易撰寫 SQL 敘述句來回答下列類型的問題:
- 如果它們存在,在兩個最佳匹配書的三個最佳匹配段落中有四個最匹配的句子?
例如,假設您資料庫中的每個書本都組織成包含具有向量內嵌表示法之句子的段落,則您可以使用單一 SQL 陳述式來回答上一個問題,例如:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY;
您也可以使用概略相似性搜尋,而非完全相似性搜尋,如下列範例所示:
SELECT bookId, paragraphId, sentence
FROM books
ORDER BY vector_distance(sentence_embedding, :sentence_query_vector)
FETCH APPROXIMATE FIRST 2 PARTITIONS BY bookId, 3 PARTITIONS BY paragraphId, 4 ROWS ONLY
WITH TARGET ACCURACY 90;注意:所有傳回的資料列都會依 VECTOR_DISTANCE() 排序,不會依分割區子句分組。
有語意地,上一個 SQL 敘述句會解譯為:
-
以句子與查詢向量之間的向量距離遞減順序,排序報表簿表格中的所有記錄。
-
對於此順序中的每筆記錄,請檢查其
bookId和paragraphId。如果符合下列三個條件,就會產生此記錄:-
其
bookId是排序順序中前兩個不同的bookId之一。 -
其
paragraphId是相同bookId內依排序順序排列的前三個不同paragraphId之一。 -
其記錄是相同
bookId與paragraphId組合中的前四個記錄之一。
-
-
否則,此記錄會被篩除。
多向量相似性搜尋不僅適用於文件,也可用於回答下列問題:
-
傳回 K 頂端最接近的相符相片,但確保它們是不同人的相片。
-
尋找 K 首歌曲,其中包含兩個或更多最符合此音效片段的音訊片段。
備註:
-
此分割區資料列限制子句擴充是 SQL 語言的一般擴充。它不需要僅套用至向量搜尋。
-
IVF 索引目前支援多向量搜尋。
另請參閱:Oracle AI Database SQL Language Reference,瞭解 ROW_LIMITING_CLAUSE 的完整語法