導入 Oracle Modern Data Platform 以進行業務報告和預測

本節描述如何佈建 OCI 服務、實作使用案例、將資料視覺化,以及建立預測。

佈建 OCI 服務

讓我們逐步介紹佈建資源的主要步驟,以進行此使用案例的簡單示範。

  1. 建立 OCI 物件儲存儲存桶。
    如需詳細資訊,請參閱建立儲存桶。
  2. 佈建 Oracle Big Data Service 和 Autonomous Data Warehouse 。

導入 Oracle Modern Data Platform 使用案例

進入導入明細之前,請讓我們查看整體流程。

  1. 原始資料將位於 OCI 物件儲存中。
  2. 在 Oracle Big Data Service 上原生執行的 Spark 將會從 OCI Object Storage 讀取資料。它會清理、轉換資料並將其匿名化,最後將資料保存至 Autonomous Data Warehouse 。
  3. 使用者將利用 Oracle Analytics Cloud 將資料視覺化並進行預測。
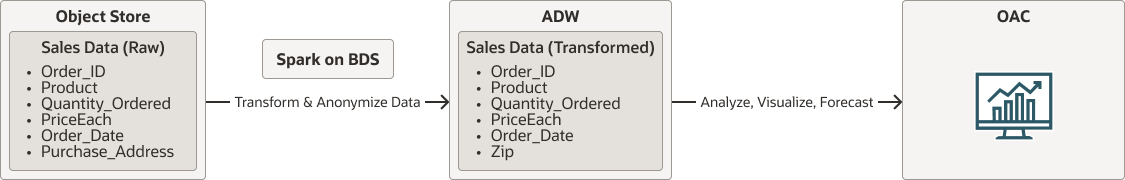

oci-modern-data-reporting-flow-oracle.zip

附註:

選擇的資料流程是一個簡單範例,實際的業務使用案例可能更涉及。

以下小節描述如何上傳範例資料、設定 OCI Object Storage 、Oracle Big Data Service ,以及呼叫簡單的 Spark scala 工作來轉換資料並將資料移至 Autonomous Data Warehouse

  1. 取得範例資料並上傳至您建立的 OCI Object Storage 儲存桶。此解決方案中用於示範實作的資料是從 Kaggle 下載的時間序列銷售資料。此資料集中的每筆記錄都有下列欄位:
    1. 訂單識別碼
    2. 產品名稱
    3. 訂購數量
    4. 銷售價格
    5. Order Date
    6. 採購地址
    如需有關範例資料的詳細資訊,請參閱瀏覽更多區段中的 Kaggle:Sample Sales Data 連結。
  2. 設定 OCI 物件儲存存取:Oracle Big Data Service 叢集需要存取物件儲存的儲存桶,才能建立外部 hive 表格。
    如需實作詳細資訊,請依照本文件中的步驟進行:使用物件儲存 API 金鑰。
  3. 登入 Oracle Big Data Service 並呼叫 Hive。以包含我們範例銷售資料的 Object Storage 貯體為基礎建立外部表格。
    create external table if not exists sales_obj_store
    (Order_ID bigint,
    Product string,
    Quantity_Ordered int,
    PriceEach double,
    Order_Date string,
    Purchase_Address string)
    row format delimited
    fields terminated by ','
    stored as TEXTFILE
    location 'oci://bucket_namej@namespace/sales_data/'
  4. 確認您可以使用上面的外部表格查詢資料。
     select * from sales_obj_store limit 20;
  5. 設定 Oracle Big Data Service 存取 Autonomous Data Warehouse :下載 Autonomous Data Warehouse 公事包檔案、瀏覽至 Autonomous Data Warehouse 叢集、按一下資料庫連線,然後下載公事包檔案。將公事包儲存在 Oracle Big Data Service 叢集的目錄中。
  6. 下載 Oracle Big Data Service 叢集上的 Oracle JDBC 驅動程式和相關 jar 檔案。您可以從以下連結下載驅動程式:Oracle Database JDBC 驅動程式和 Companion Jars 下載。在呼叫您的 Spark 工作時傳入這些 Jar。
  7. 叫用簡單的 Spark scala 工作來轉換資料,並將資料移至 Autonomous Data Warehouse 。
    1. 此工作會執行簡單的轉換,將字串欄位轉換成時戳欄位。
    2. 此工作也會藉由移除完整客戶地址並從其中擷取壓縮欄位來匿名資料。
    import com.oracle.bmc.auth.AbstractAuthenticationDetailsProvider
    
    import java.util.Properties
    
    import org.apache.spark.sql.Dataset
    import org.apache.spark.sql.Row
    import org.apache.spark.sql.SaveMode
    import org.apache.spark.sql.SparkSession
    import oracle.jdbc.OracleConnection
    
    val jdbcUrl = s"jdbc:oracle:thin:@(description=(retry_count=20)(retry_delay=3)(address=(protocol=tcps)(port=1522)(host=adb.us-ashburn-1.oraclecloud.com))(connect_data=(service_name=xxxx_high.adb.oraclecloud.com))(security=(ssl_server_dn_match=yes)))?TNS_ADMIN=/home/xxx/wallet"
    
    val connectionProperties = new Properties()
    var options = collection.mutable.Map[String, String]()
    options += ("driver" -> "oracle.jdbc.driver.OracleDriver")
    options += ("url" -> jdbcUrl)
    options += (OracleConnection.CONNECTION_PROPERTY_USER_NAME -> "xxxx")
    options += (OracleConnection.CONNECTION_PROPERTY_PASSWORD -> "xxxxx")
    options += (OracleConnection.CONNECTION_PROPERTY_TNS_ADMIN -> "/home/xxx/wallet")
    options += ("dbtable" -> "schema_name.sales")
    
    /* read from hive */
    val dfsales = spark.sql("select * from sales")
    
    /* transform */
    val ts = to_timestamp($"order_date", "MM/dd/yy HH:mm")
    val dfsales_orcl = dfsales.withColumn("order_date",ts)
    val dfsales_orcl_zip = dfsales_orcl.select(col("*"), substring_index(col("purchase_address"), " ", -1).as("zip"))
    val dfsales_orcl_transformed = dfsales_orcl_zip.drop("purchase_address")
    
    /* write to ADW */
    dfsales_orcl_transformed.write.format("jdbc").options(options).mode("append").save()
資料轉換工作完成後,請確認您可以在 Autonomous Data Warehouse 中查看資料。