Einführung in Oracle AI Database
In diesem Kapitel erhalten Sie einen Überblick über Oracle AI Database.
Dieses Kapitel enthält die folgenden Themen:
-
Informationen zu Informationssystemen Jedes Unternehmen verfügt über Informationen, die es speichern und verwalten muss, um seine Anforderungen zu erfüllen. Beispiel: Ein Unternehmen muss Personaldatensätze für seine Mitarbeiter erfassen und verwalten. Diese Informationen müssen denjenigen zur Verfügung stehen, die sie benötigen.
-
Schemaobjekte Ein Merkmal eines RDBMS ist die Unabhängigkeit des physischen Datenspeichers von logischen Datenstrukturen.
-
Datenzugriff Eine allgemeine Anforderung für ein DBMS ist die Einhaltung anerkannter Industriestandards für eine Datenzugriffssprache.
-
Transaktionsmanagement Oracle AI Database ist als Mehrbenutzerdatenbank konzipiert. Die Datenbank muss sicherstellen, dass mehrere Benutzer gleichzeitig arbeiten können, ohne die Daten des anderen zu beschädigen.
-
Oracle AI Database-Architektur Ein Datenbankserver ist der Schlüssel zur Informationsverwaltung.
Informationssysteme
Jede Organisation hat Informationen, die sie speichern und verwalten muss, um ihre Anforderungen zu erfüllen. Beispiel: Ein Unternehmen muss Personaldatensätze für seine Mitarbeiter erfassen und verwalten. Diese Informationen müssen denjenigen zur Verfügung stehen, die sie benötigen.
Ein Informationssystem ist ein formales System zum Speichern und Verarbeiten von Informationen. Eine Datenbank ist eine organisierte Sammlung von Informationen, die als Einheit behandelt werden. Der Zweck einer Datenbank besteht darin, zugehörige Informationen zur Verwendung durch Datenbankanwendungen zu sammeln, zu speichern und abzurufen.
Als Datenbanksysteme zum ersten Mal erfunden wurden, wurden sie für eine bestimmte Workload entwickelt. Im Laufe der Jahre hat sich gezeigt, dass Einzweck-Datenbanken nicht mehr alle Anforderungen erfüllen: Zusätzlich zu relationalen Workloads mussten Entwickler Daten in anderen Formaten wie XML, räumlich, grafisch, JSON und zuletzt Vektordaten für das KI-Zeitalter speichern.
Oracle AI Database hat sich von einer relationalen Datenbank-Engine zu einer konvergierten Engine entwickelt, sodass Entwickler fast jede Art von Daten in dem Format speichern können, das ihre Anwendung nativ benötigt, und vollständig in ihre Unternehmensarchitektur integriert sind.
-
Datenbankmanagementsystem (DBMS) Ein Datenbankmanagementsystem (DBMS) ist eine Software, mit der die Speicherung, Organisation und der Abruf von Daten gesteuert werden.
-
Relationales Modell In seinem bahnbrechenden Papier "A Relational Model of Data for Large Shared Data Banks" aus dem Jahr 1970 definierte E. F. Codd ein relationales Modell, das auf der mathematischen Satztheorie basiert. Heute ist das am weitesten verbreitete Datenbankmodell das relationale Modell.
-
Relationales Datenbankmanagementsystem (RDBMS) Das relationale Modell ist die Grundlage für ein relationales Datenbankmanagementsystem (RDBMS). Ein RDBMS verschiebt Daten in eine Datenbank, speichert die Daten und ruft sie ab, damit Anwendungen sie bearbeiten können.
DBMS (Database Management System)
Ein Datenbankmanagementsystem (DBMS) ist eine Software, mit der die Speicherung, Organisation und der Abruf von Daten gesteuert werden.
In der Regel enthält ein DBMS die folgenden Elemente:
-
Kernel-Code
Dieser Code verwaltet Speicher und Speicher für das DBMS.
-
Repository der Metadaten
Dieses Repository wird in der Regel als Data Dictionary oder Metadatenkatalog bezeichnet.
-
Abfragesprachen
Abfragesprachen erleichtern den Zugriff auf Daten. Konvergierte Datenbanken wie Oracle AI Database unterstützen mehrere Abfragesprachen.
Eine Datenbankanwendung ist ein Softwareprogramm, das mit einer Datenbank interagiert, um auf Daten zuzugreifen und diese zu bearbeiten. Oracle AI Database war eine der ersten Datenbank-Engines, die das relationale Modell unterstützte. Seit seiner Gründung hat es sich zu einer konvergenten Datenbank-Engine entwickelt, die fast jeden Datentyp und viele verschiedene Workloads unterstützt.
Relationales Modell
In seinem bahnbrechenden Papier "A Relational Model of Data for Large Shared Data Banks" aus dem Jahr 1970 definierte E. F. Codd ein relationales Modell, das auf der mathematischen Satztheorie basiert. Heute ist das am weitesten verbreitete Datenbankmodell das relationale Modell.
Eine relationale Datenbank ist eine Datenbank, die dem relationalen Modell entspricht. Das relationale Modell hat die folgenden Hauptaspekte:
-
Strukturen
Gut definierte Objekte speichern oder greifen auf die Daten einer Datenbank zu.
-
Vorgänge
Durch klar definierte Aktionen können Anwendungen die Daten und Strukturen einer Datenbank bearbeiten.
-
Integritätsregeln
Integritätsregeln steuern Vorgänge für die Daten und Strukturen einer Datenbank.
Eine relationale Datenbank speichert Daten in einer Gruppe einfacher Beziehungen. Eine Relation ist ein Set von Tupeln. Ein Tupel ist ein nicht sortiertes Set von Attributwerten.
Eine Tabelle ist eine zweidimensionale Darstellung einer Beziehung in Form von Zeilen (Tupeln) und Spalten (Attributen). Jede Zeile in einer Tabelle hat dieselbe Gruppe von Spalten. Eine relationale Datenbank ist eine Datenbank, die Daten in Relationen (Tabellen) speichert. Beispiel: Eine relationale Datenbank könnte Informationen zu Unternehmensmitarbeitern in einer Mitarbeitertabelle, einer Abteilungstabelle und einer Gehaltstabelle speichern.
Verwandte Themen
Relationales Datenbanksystem (RDBMS)
Das relationale Modell ist die Grundlage für ein relationales Datenbankmanagementsystem (RDBMS). Ein RDBMS verschiebt Daten in eine Datenbank, speichert die Daten und ruft sie ab, damit Anwendungen sie bearbeiten können.
Ein RDBMS unterscheidet zwischen den folgenden Arten von Vorgängen:
-
Logische Operationen
In diesem Fall gibt eine Anwendung an, welcher Inhalt erforderlich ist. Beispiel: Eine Anwendung fordert einen Mitarbeiternamen an oder fügt einen Mitarbeiterdatensatz zu einer Tabelle hinzu.
-
Physische Operationen
In diesem Fall bestimmt das RDBMS, wie Dinge ausgeführt werden sollen und führt den Vorgang aus. Beispiel: Nachdem eine Anwendung eine Tabelle abgefragt hat, kann die Datenbank einen Index verwenden, um die angeforderten Zeilen zu suchen, die Daten in den Speicher zu lesen und viele andere Schritte auszuführen, bevor ein Ergebnis an den Benutzer zurückgegeben wird. Das RDBMS speichert und ruft Daten ab, sodass physische Vorgänge für Datenbankanwendungen transparent sind.
Oracle AI Database ist ein RDBMS im Kern. Ein RDBMS, das objektorientierte Features wie benutzerdefinierte Typen, Vererbung und Polymorphie implementiert, wird als objektrelationales Datenbankmanagementsystem (ORDBMS) bezeichnet. Oracle AI Database erweitert das relationale Modell auf ein objektrelationales Modell, sodass komplexe Geschäftsmodelle in einer relationalen Datenbank gespeichert werden können. Im Laufe der Zeit hat sich die Kerndaten-Engine von Oracle zu einem viel leistungsfähigeren Modell entwickelt, das jetzt als konvergente Datenbank bezeichnet wird.
Konvergente Datenbankarchitektur
Oracle AI Database ist eine konvergierte Datenbank, die mehrere Datenmodelle und Workloads in einer einzigen Datenbank-Engine unterstützt. Zusätzlich zu relationalen Daten kann es JSON-Dokumente, Diagrammdaten, räumliche Daten, Text, Vektoren und andere spezialisierte Datentypen verwalten.
Diese Funktionen nutzen gemeinsame Datenbankservices, einschließlich Transaktionen, Sicherheit, Backup und Recovery, High Availability, Auditing und Abfrageoptimierung. Anwendungen können daher unterschiedliche Datenmodelle verwenden, ohne dass für jedes Datenmodell eine separate Datenbank erforderlich ist.
Beispiel: Eine Anwendung kann Kunden- und Transaktionsdaten in relationalen Tabellen, flexible Attribute in JSON-Dokumenten, geografische Informationen als räumliche Daten und Vektoreinbettungen für die semantische Suche speichern. Mit SQL können Sie diese Datenformen in einer einzigen Operation abfragen und kombinieren. Eine API im Dokumentstil ist für Entwickler verfügbar, die diesen NoSQL-Stil bevorzugen.
Eine konvergierte Datenbank bietet die folgenden Vorteile:
- Geringere Datenverschiebung zwischen spezialisierten Systemen
- Konsistente Sicherheit und Steuerung
- Integrierte Transaktionen über zugehörige Daten hinweg
- Vereinfachte Anwendungs- und Betriebsarchitektur
- Einheitliche Analyse mehrerer Datentypen
- Einheitliches Audit von Datenbankvorgängen
Konvergenz erfordert nicht jede Workload, um jede Funktion zu nutzen oder sich in einer physischen Datenbank zu befinden. Anwendungen können nur die Funktionen verwenden, die sie benötigen. Die flexible Architektur von Oracle ermöglicht es Entwicklern, Anwendungen über mehrere integrierbare Datenbanken zu verteilen.
Oracle Database bleibt im Kern relational. Die konvergierte Architektur erweitert diese Grundlage, sodass Anwendungen mit mehreren Datenmodellen arbeiten können und gleichzeitig einen gemeinsamen Satz von Datenbankservices verwenden, die fast alle Workloads verarbeiten.
Schemaobjekte
Ein Merkmal eines RDBMS ist die Unabhängigkeit der physischen Datenspeicherung von logischen Datenstrukturen.
In Oracle AI Database ist ein Datenbank-Schema eine Sammlung logischer Datenstrukturen oder Schemaobjekte. Ein Datenbankbenutzer ist Eigentümer eines Datenbankschemas, das denselben Namen wie der Benutzername hat.
Schemaobjekte sind vom Benutzer erstellte Strukturen, die sich direkt auf die Daten in der Datenbank beziehen. Die Datenbank unterstützt viele Typen von Schemaobjekten. Die wichtigsten davon sind Tabellen und Indizes. Benutzer, die eine dokumentorientierte API für den Zugriff auf ihre Daten bevorzugen, können (JSON-)Collections oder JSON-relationale Dualitätsansichten erstellen.
Ein Schemaobjekt ist ein Typ eines Datenbankobjekts. Einige Datenbankobjekte, wie Profile und Rollen, befinden sich nicht in Schemas.
-
Tabellen In einer Tabelle werden Entitäten wie Mitarbeiter beschrieben.
-
Indizes Ein Index ist eine optionale Datenstruktur, die Sie für eine oder mehrere Spalten einer Tabelle erstellen können. Indizes können die Performance des Datenabrufs erhöhen.
Verwandte Themen
Tabellen
Eine Tabelle beschreibt eine Entität, wie z.B. Mitarbeiter.
Sie definieren eine Tabelle mit einem Tabellennamen, wie employees, und einer Gruppe von Spalten. Im Allgemeinen geben Sie jeder Spalte beim Erstellen der Tabelle einen Namen, einen Datentyp und eine Breite an.
Eine Tabelle ist eine Gruppe von Zeilen. Eine Spalte identifiziert ein Attribut der in der Tabelle beschriebenen Entity, während eine Zeile eine Instanz der Entity identifiziert. Beispiel: Attribute der Mitarbeiterentität entsprechen Spalten für die Personalnummer und den Nachnamen. Ein Datensatz kennzeichnet einen bestimmten Mitarbeiter.
Sie können optional eine Regel angeben, die als Integritäts-Constraint bezeichnet wird, für eine Spalte. Ein Beispiel ist ein Integritäts-Constraint NOT NULL. Diese Einschränkung zwingt die Spalte dazu, einen Wert in jeder Zeile zu enthalten. Constraints, die mehrere Tabellen umfassen, können als SQL-Assertions definiert werden. Vor Oracle AI Database 26ai konnten Sie Datenbank-Trigger verwenden, um Geschäftslogik als Teil einer Transaktion durchzusetzen.
Verwandte Themen
Indizes
Ein Index ist eine optionale Datenstruktur, die Sie für eine oder mehrere Spalten einer Tabelle erstellen können. Indizes können die Performance des Datenabrufs erhöhen.
Bei der Verarbeitung einer Anforderung kann die Datenbank verfügbare Indizes verwenden, um die angeforderten Zeilen effizient zu suchen. Indizes sind nützlich, wenn Anwendungen häufig eine bestimmte Zeile oder einen bestimmten Zeilenbereich abfragen.
Indizes sind logisch und physisch unabhängig von den Daten. So können Sie Indizes löschen und erstellen, die sich nicht auf die Tabellen oder anderen Indizes auswirken. Alle Anwendungen funktionieren weiterhin, nachdem Sie einen Index gelöscht haben.
Verwandte Themen
Datenzugriff
Eine allgemeine Anforderung für ein DBMS ist die Einhaltung anerkannter Industriestandards für eine Datenzugriffssprache. Hinweis: Für JavaScript muss Oracle 26ai unter Linux x86-64 oder Linux aarch64 ausgeführt werden.
-
Structured Query Language (SQL) SQL ist eine setbasierte deklarative Sprache, die eine Schnittstelle zu einem RDBMS wie Oracle AI Database bereitstellt.
-
PL/SQL ist eine prozedurale Erweiterung von Oracle SQL. Java und JavaScript sind zusätzliche Optionen, mit denen Sie Geschäftslogik in der Datenbank speichern können.
SQL (Structured Query Language)
SQL ist eine setbasierte deklarative Sprache, die eine Schnittstelle zu einem RDBMS wie Oracle AI Database bereitstellt.
Verfahrenssprachen wie C beschreiben, wie die Dinge getan werden sollten. SQL ist nicht prozedural und beschreibt, was getan werden soll.
SQL ist die ANSI-Standardsprache für relationale Datenbanken. Alle Vorgänge an den Daten in einer Oracle-Datenbank werden mit SQL-Anweisungen ausgeführt. Beispiel: Sie verwenden SQL, um Tabellen zu erstellen und Daten in Tabellen abzufragen und zu ändern.
Eine SQL-Anweisung kann als ein sehr einfaches, aber leistungsstarkes Computerprogramm oder eine Anweisung angesehen werden. Benutzer geben das gewünschte Ergebnis an (z.B. die Namen der Mitarbeiter) und nicht, wie es abgeleitet werden soll. Eine SQL-Anweisung ist eine Zeichenfolge mit SQL-Text wie:
SELECT first_name, last_name FROM employees;Mit SQL-Anweisungen können Sie die folgenden Aufgaben ausführen:
-
Daten abfragen
-
Zeilen in einer Tabelle einfügen, aktualisieren und löschen
-
Objekte erstellen, ersetzen, ändern und löschen
-
Zugriff auf die Datenbank und ihre Objekte steuern
-
Datenbankkonsistenz und -integrität gewährleisten
SQL vereint die vorherigen Aufgaben in einer konsistenten Sprache. Oracle SQL ist eine Implementierung des ANSI-Standards. Oracle SQL unterstützt zahlreiche Features, die über Standard-SQL hinausgehen.
Verwandte Themen
PL/SQL, Java und JavaScript
PL/SQL ist eine prozedurale Erweiterung von Oracle SQL. Java und JavaScript sind zusätzliche Optionen, mit denen Sie Geschäftslogik in der Datenbank speichern können.
PL/SQL ist in Oracle AI Database integriert, sodass Sie alle SQL-Anweisungen, Funktionen und Datentypen von Oracle AI Database verwenden können. Mit PL/SQL können Sie den Ablauf eines SQL-Programms steuern, Variablen verwenden und Prozeduren zur Fehlerbehebung schreiben.
Ein Hauptvorteil von PL/SQL ist die Möglichkeit, Anwendungslogik in der Datenbank selbst zu speichern. Eine PL/SQL-Prozedur oder Funktion ist ein Schemaobjekt, das aus einer Gruppe von SQL-Anweisungen und anderen PL/SQL-Konstrukten besteht, zusammen gruppiert, in der Datenbank gespeichert ist und als eine Einheit ausgeführt wird, um ein bestimmtes Problem zu lösen oder eine Reihe von zusammengehörigen Aufgaben durchzuführen. Der Hauptvorteil der serverseitigen Programmierung besteht darin, dass die integrierte Funktionalität überall bereitgestellt werden kann.
Oracle AI Database kann auch Programmeinheiten speichern, die in Java und JavaScript geschrieben sind. Eine gespeicherte Java-Prozedur ist eine Java-Methode, die in SQL veröffentlicht und zur allgemeinen Verwendung in der Datenbank gespeichert wird. Sie können vorhandene PL/SQL-Programme aus Java- und JavaScript- sowie Java- und JavaScript-Programmen aus PL/SQL aufrufen.
Multilingual Engine (MLE) bietet Ihnen die Möglichkeit, Geschäftslogik in JavaScript zu schreiben und den Code in der Datenbank als MLE-Module zu speichern. Von MLE-Modulen exportierte Funktionen können über Aufrufspezifikationen in SQL und PL/SQL bereitgestellt werden. Diese Aufrufspezifikationen sind PL/SQL-Einheiten (Funktionen, Prozeduren und Packages) und können überall aufgerufen werden, wo PL/SQL aufgerufen wird.
Verwandte Themen
NoSQL APIs für den Dokumentzugriff
Simple Oracle Document Access (SODA) ist eine Gruppe von APIs im NoSQL-Stil zur Verwaltung von Dokumentsammlungen, insbesondere JSON-Dokumenten, in Oracle AI Database. Anwendungen können Collections erstellen und Dokumente einfügen, abrufen, aktualisieren, löschen und abfragen, ohne dass Kenntnisse über SQL oder das zugrunde liegende Datenbankschema erforderlich sind.
SODA bietet ein dokumentenzentriertes Programmiermodell, das auf Sammlungen, Dokumenten und Abfrage-für-Beispiel-Filtern basiert. Dies ist das Gegenteil von SQL, das eine deklarative, setorientierte Schnittstelle zum Abfragen und Ändern relationaler Daten bereitstellt und Joins, Aggregationen und Vorgänge über mehrere Datentypen hinweg ausdrücken kann.
SODA ist nützlich, wenn eine Anwendung in erster Linie mit JSON-Dokumenten arbeitet und eine einfache Dokument-API erfordert, und es kann eine Alternative für Entwickler sein, die eine NoSQL-API verwenden möchten.
Entwickler, die Dokument-Workloads von einem Single-Purpose-Datenspeicher eines Drittanbieters in die Oracle AI-Datenbank portieren, haben die Möglichkeit, die Mongo DB API für Oracle AI Database zu verwenden, die SODA ähnelt, aber Migrationen vereinfacht. Im einfachsten Fall ist das Ändern der Verbindungszeichenfolge der Anwendung vom Einzweck-Datenspeicher in Oracle AI Database alles, was getan werden muss.
Transaktionsmanagement
Oracle AI Database ist als Mehrbenutzerdatenbank konzipiert. Die Datenbank muss sicherstellen, dass mehrere Benutzer gleichzeitig arbeiten können, ohne die Daten des anderen zu beschädigen.
-
Transaktionen Eine Transaktion ist eine logische, atomare Arbeitseinheit, die eine oder mehrere SQL-Anweisungen enthält.
-
Datennebenläufigkeit Eine Anforderung an ein Mehrbenutzer-RDBMS ist die Kontrolle der Datennebenläufigkeit, d.h. des gleichzeitigen Zugriffs auf dieselben Daten durch mehrere Benutzer.
-
Datenkonsistenz In Oracle AI Database muss jeder Benutzer eine konsistente Ansicht der Daten sehen, einschließlich sichtbarer Änderungen, die von den eigenen Transaktionen eines Benutzers und festgeschriebenen Transaktionen anderer Benutzer vorgenommen wurden.
Transaktionen
Eine Transaktion ist eine logische, atomare Arbeitseinheit, die eine oder mehrere SQL-Anweisungen enthält.
Ein RDBMS muss in der Lage sein, SQL-Anweisungen so zu gruppieren, dass sie entweder alle festgeschrieben sind, was bedeutet, dass sie auf die Datenbank angewendet werden, oder alle zurückgerollt werden, was bedeutet, dass sie rückgängig gemacht werden.
Ein Beispiel für die Notwendigkeit von Transaktionen ist ein Geldtransfer von einem Sparkonto auf ein Girokonto. Die Übertragung umfasst die folgenden separaten Vorgänge:
-
Senken Sie das Sparkonto.
-
Girokonto erhöhen.
-
Zeichnen Sie die Transaktion im Transaktionsjournal auf.
Oracle AI Database garantiert, dass alle drei Vorgänge als Einheit erfolgreich oder nicht erfolgreich ausgeführt werden. Beispiel: Wenn ein Hardwarefehler verhindert, dass eine Anweisung in der Transaktion ausgeführt wird, müssen die anderen Anweisungen zurückgesetzt werden.
Transaktionen sind ein Feature, das Oracle AI Database von einem Dateisystem unterscheidet. Wenn Sie einen atomaren Vorgang ausführen, der mehrere Dateien aktualisiert, und wenn das System auf halbem Wege ausfällt, sind die Dateien nicht konsistent. Im Gegensatz dazu verschiebt eine Transaktion eine Oracle-Datenbank von einem konsistenten in einen anderen. Das Grundprinzip einer Transaktion ist "all or nothing": Eine atomare Operation gelingt oder scheitert als Ganzes.
Verwandte Themen
Gleichzeitiger Datenzugriff
Eine Anforderung an ein Mehrbenutzer-RDBMS ist die Kontrolle der Datennebenläufigkeit, d.h. des gleichzeitigen Zugriffs auf dieselben Daten durch mehrere Benutzer.
Ohne Nebenläufigkeitskontrollen könnten Benutzer Daten falsch ändern und so die Datenintegrität beeinträchtigen. Beispiel: Ein Benutzer kann eine Zeile aktualisieren, während ein anderer Benutzer sie gleichzeitig aktualisiert.
Wenn mehrere Benutzer auf dieselben Daten zugreifen, besteht eine Möglichkeit zur Verwaltung des gleichzeitigen Zugriffs darin, Benutzer zu warten. Das Ziel eines DBMS besteht jedoch darin, die Wartezeit zu verkürzen, sodass sie entweder nicht vorhanden oder vernachlässigbar ist. Alle SQL-Anweisungen, die Daten ändern, müssen so wenig wie möglich eingreifen. Destruktive Interaktionen, bei denen es sich um Interaktionen handelt, die Daten falsch aktualisieren oder zugrunde liegende Datenstrukturen verändern, müssen vermieden werden.
Oracle AI Database verwendet Sperren, um den gleichzeitigen Zugriff auf Daten zu kontrollieren. Ein Sperre ist ein Mechanismus, der eine destruktive Interaktion zwischen Transaktionen verhindert, die auf eine gemeinsam genutzte Ressource zugreifen. Sperren gewährleisten die Datenintegrität und ermöglichen gleichzeitig maximalen gleichzeitigen Zugriff auf Daten.
Verwandte Themen
Datenkonsistenz
In Oracle AI Database muss jeder Benutzer eine konsistente Ansicht der Daten sehen, einschließlich sichtbarer Änderungen, die von eigenen Transaktionen eines Benutzers und festgeschriebenen Transaktionen anderer Benutzer vorgenommen werden.
Beispiel: Die Datenbank muss das Problem dirty read verhindern, das auftritt, wenn eine Transaktion nicht festgeschriebene Änderungen durch eine andere gleichzeitige Transaktion erkennt.
Oracle AI Database setzt immer die Lesekonsistenz auf Anweisungsebene durch, die garantiert, dass die Daten, die eine einzelne Abfrage zurückgibt, für einen einzigen Zeitpunkt festgeschrieben und konsistent sind. Je nach Transaktionsisolationsebene ist dieser Zeitpunkt der Zeitpunkt, zu dem die Anweisung geöffnet oder die Transaktion gestartet wurde. Mit dem Feature Oracle Flashback Query können Sie diesen Zeitpunkt explizit angeben.
Die Datenbank kann auch Lesekonsistenz für alle Abfragen in einer Transaktion bereitstellen, die als Lesekonsistenz auf Transaktionsebene bezeichnet wird. In diesem Fall sieht jede Anweisung in einer Transaktion Daten vom selben Zeitpunkt, zu dem die Transaktion begann.
Verwandte Themen
Oracle AI Database-Architektur
Ein Datenbankserver ist der Schlüssel zur Informationsverwaltung.
Im Allgemeinen verwaltet ein Server eine große Datenmenge in einer Mehrbenutzerumgebung zuverlässig, sodass Benutzer gleichzeitig auf dieselben Daten zugreifen können. Ein Datenbankserver verhindert auch unbefugten Zugriff und bietet effiziente Lösungen für die Fehlerwiederherstellung.
-
Datenbank und Instanz Ein Oracle-Datenbankserver besteht aus einer Datenbank und mindestens einer Datenbankinstanz, die allgemein als einfache Instanz bezeichnet wird.
-
Datenbankspeicherstrukturen Eine Datenbank kann sowohl physisch als auch logisch betrachtet werden.
-
Datenbankinstanzstrukturen Eine Oracle-Datenbank verwendet Speicherstrukturen und Prozesse, um die CDB zu verwalten und darauf zuzugreifen. Alle Speicherstrukturen befinden sich im Hauptspeicher der Computer, die das RDBMS bilden.
-
Anwendungs- und Netzwerkarchitektur Um ein bestimmtes Computersystem oder Netzwerk in vollem Umfang nutzen zu können, ermöglicht Oracle AI Database, dass die Verarbeitung zwischen dem Datenbankserver und den Clientprogrammen aufgeteilt wird. Der Computer, auf dem das RDBMS ausgeführt wird, übernimmt die Verantwortung für den Datenbankserver, während die Computer, auf denen die Anwendungen ausgeführt werden, die Interpretation und Anzeige von Daten übernehmen.
Datenbank und Instanz
Ein Oracle-Datenbankserver besteht aus einer Datenbank und mindestens einer Datenbankinstanz, die allgemein als einfache Instanz bezeichnet wird.
Da eine Instanz und eine Datenbank so eng verbunden sind, bezieht sich der Begriff Oracle-Datenbank manchmal sowohl auf Instanz als auch auf Datenbank. Im engeren Sinne haben die Begriffe folgende Bedeutungen:
-
Datenbank
Eine Datenbank ist eine Gruppe von Dateien, die auf Platte gespeichert sind und Benutzerdaten speichern. Diese Datendateien können unabhängig von einer Datenbankinstanz vorhanden sein. Ab Oracle Database 21c bezieht sich "Datenbank" speziell auf die Datendateien einer Multitenant-Containerdatenbank (CDB), einer integrierbaren Datenbank (PDB) oder eines Anwendungscontainers.
-
Datenbankinstanz
Eine Instanz ist eine benannte Gruppe von Speicherstrukturen, die Datenbankdateien verwalten. Eine Datenbankinstanz besteht aus einem Shared Memory-Bereich, der als System Global Area (SGA) bezeichnet wird, und einer Reihe von Hintergrundprozessen. Eine Instanz kann unabhängig von Datenbankdateien vorhanden sein.
-
Multitenant-Architektur Mit der Multitenant-Architektur kann eine Oracle AI Database eine CDB sein.
-
Globally Distributed Database Architecture Oracle Globally Distributed Database (früher Oracle Sharding genannt) ist eine Datenbankskalierungstechnik, die auf der horizontalen Partitionierung von Daten über mehrere PDBs hinweg basiert. Anwendungen betrachten den Pool von PDBs als eine einzige logische Datenbank. Jede Partition wird als Shard bezeichnet.
Mehrmandantenfähige Architektur
Mit der Multitenant-Architektur kann eine Oracle AI Database eine CDB sein.
Jede Oracle AI Database muss eine andere Datenbank enthalten oder darin enthalten sein können. Beispiel: Eine CDB enthält PDBs und ein Anwendungscontainer enthält Anwendungs-PDBs. Eine PDB ist in einer CDB oder einem Anwendungscontainer enthalten, und ein Anwendungscontainer ist in einer CDB enthalten.
Ab Oracle Database 21c ist eine mehrmandantenfähige Containerdatenbank die einzige unterstützte Architektur. In früheren Releases unterstützten Oracle Nicht-Containerdatenbanken (Nicht-CDBs).
-
Containerdatenbanken Eine CDB enthält eine oder mehrere vom Benutzer erstellte PDBs und Anwendungscontainer.
-
Integrierbare Datenbanken Eine PDB ist eine portierbare Sammlung von Schemas, Schemaobjekten und Nichtschemaobjekten, die einer Anwendung als separate Datenbank angezeigt werden.
-
Anwendungscontainer Ein Anwendungscontainer ist ein optionaler, vom Benutzer erstellter Container in einer CDB, in dem Daten und Metadaten für eine oder mehrere Anwendungen gespeichert werden.
Containerdatenbanken
Eine CDB enthält eine oder mehrere vom Benutzer erstellte PDBs und Anwendungscontainer.
Auf der physischen Ebene besteht eine CDB aus einer Gruppe von Dateien: Kontrolldatei, Online Redo Log-Dateien und Datendateien. Die Datenbankinstanz verwaltet die Dateien, aus denen die CDB besteht.
Die folgende Abbildung zeigt eine CDB und eine zugehörige Datenbankinstanz.
Abbildung 1: Datenbankinstanz und CDB
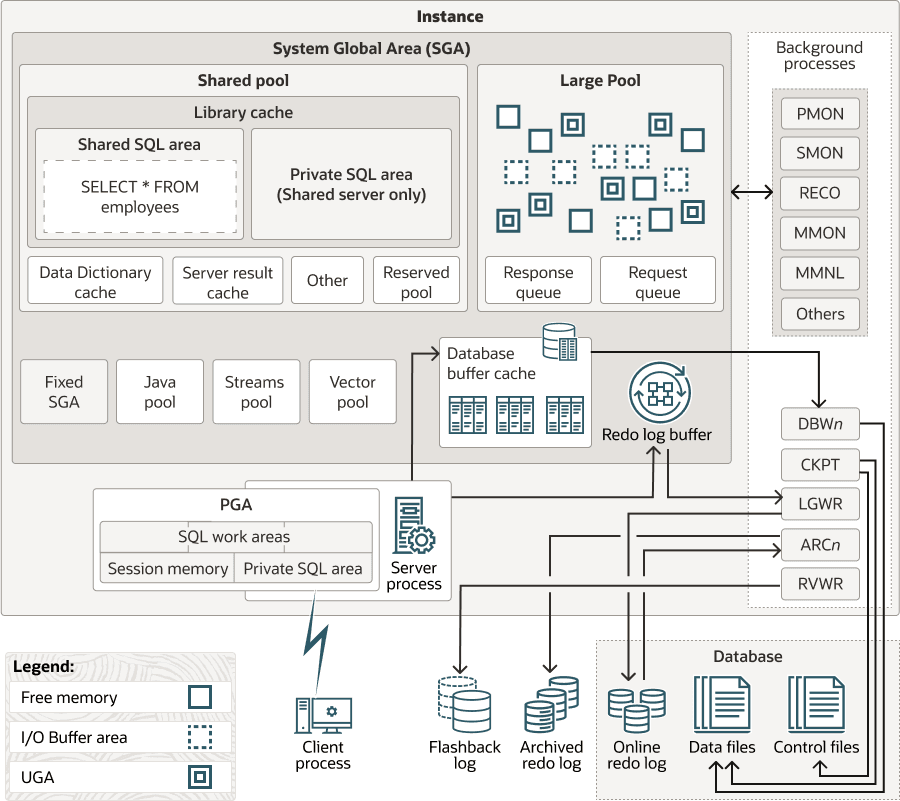
Beschreibung der Abbildung cncpt233.png
Integrierbare Datenbanken
Eine PDB ist eine portierbare Sammlung von Schemas, Schemaobjekten und Nichtschemaobjekten, die einer Anwendung als separate Datenbank angezeigt wird.
Auf der physischen Ebene verfügt jede PDB über eine eigene Gruppe von Datendateien, in denen die Daten für die PDB gespeichert werden. Die CDB enthält alle Datendateien für die darin enthaltenen PDBs sowie eine Gruppe von Systemdatendateien, in denen Metadaten für die CDB selbst gespeichert sind.
Um eine PDB zu verschieben oder zu archivieren, können Sie sie trennen. Eine nicht integrierte PDB besteht aus den PDB-Datendateien und einer Metadatendatei. Eine nicht integrierte PDB kann erst verwendet werden, wenn sie an eine CDB angeschlossen ist.
Die folgende Abbildung zeigt eine CDB mit dem Namen MYCDB.
Abbildung 2: PDBs in einer CDB
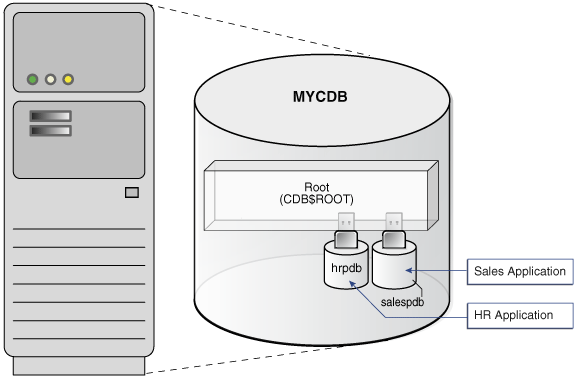
Beschreibung der Abbildung cncpt352.png
Physisch ist MYCDB eine Oracle AI Database im Sinne einer Gruppe von Datendateien, die mit einer Instanz verknüpft sind. MYCDB verfügt über eine Datenbankinstanz, obwohl mehrere Instanzen in Oracle Real Application Clusters und eine Gruppe von Datenbankdateien möglich sind.
MYCDB enthält zwei PDBs: hrpdb und salespdb. Wie in Abbildung 1-2 dargestellt, werden diese PDBs in ihren jeweiligen Anwendungen als separate, unabhängige Datenbanken angezeigt. Eine Anwendung weiß nicht, ob sie eine Verbindung zu einer CDB oder PDB herstellt.
Um die CDB selbst oder eine beliebige PDB darin zu verwalten, können Sie eine Verbindung zur CDB-Root herstellen. Die Root ist eine Sammlung von Schemas, Schemaobjekten und Nichtschemaobjekten, zu denen alle PDBs und Anwendungscontainer gehören.
Anwendungscontainer
Ein Anwendungscontainer ist ein optionaler, vom Benutzer erstellter Container in einer CDB, in dem Daten und Metadaten für eine oder mehrere Anwendungen gespeichert werden.
In diesem Kontext ist eine Anwendung (auch als Masteranwendungsdefinition bezeichnet) ein benannter, versionierter Satz allgemeiner Daten und Metadaten, die im Anwendungs-Root gespeichert sind. Beispiel: Die Anwendung kann Definitionen von Tabellen, Views, Benutzeraccounts und PL/SQL-Packages enthalten, die einer Gruppe von PDBs gemeinsam sind.
In gewisser Weise fungiert ein Anwendungscontainer als anwendungsspezifische CDB innerhalb einer CDB. Ein Anwendungscontainer wie die CDB selbst kann mehrere Anwendungs-PDBs enthalten und ermöglicht diesen PDBs die gemeinsame Nutzung von Metadaten und Daten. Auf der physischen Ebene verfügt ein Anwendungscontainer wie eine PDB über eine eigene Gruppe von Datendateien.
Beispiel: Bei einem SaaS-Deployment können mehrere Anwendungs-PDBs für jeweils einen separaten Kunden verwendet werden, die Anwendungsmetadaten und -daten gemeinsam verwenden. Beispiel: In der folgenden Abbildung ist sales_app das Anwendungsmodell im Anwendungs-Root. Die Anwendungs-PDB mit dem Namen cust1_pdb enthält nur Umsatzdaten für Kunde 1, während die Anwendungs-PDB mit dem Namen cust2_pdb nur Umsatzdaten für Kunde 2 enthält. Plug-in, Trennen, Klonen und andere Vorgänge auf PDB-Ebene sind für einzelne Kunden-PDBs verfügbar.
Abbildung 3: SaaS Anwendungsfall
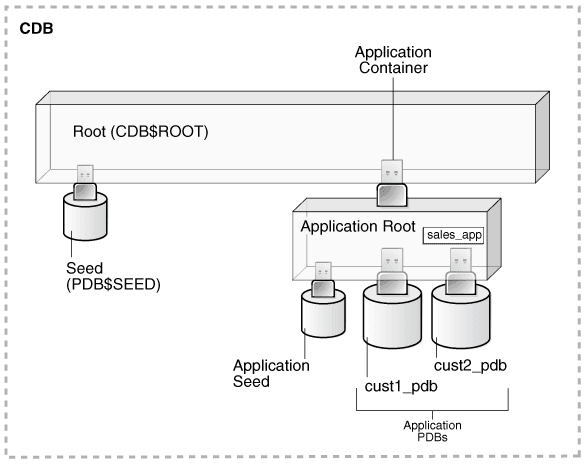
Beschreibung der Abbildung cncpt389.png
Global verteilte Datenbankarchitektur
Oracle Globally Distributed Database (früher Oracle Sharding genannt) ist eine Datenbankskalierungsmethode, die auf der horizontalen Partitionierung von Daten über mehrere PDBs hinweg basiert. Anwendungen betrachten den Pool von PDBs als eine einzige logische Datenbank. Jede Partition wird als Shard bezeichnet.
Die wichtigsten Vorteile von Sharding für Anwendungen sind lineare Skalierbarkeit, Fehlerbegrenzung und geografische Datenverteilung. Globally Distributed Database eignet sich gut für das Deployment in der Oracle Cloud. Im Gegensatz zu NoSQL-Datenspeichern, die Sharding implementieren, bietet Globally Distributed Database die Vorteile von Sharding, ohne die Funktionen eines Unternehmens-RDBMS zu beeinträchtigen.
In einer Sharding-Architektur wird jede CDB auf einem dedizierten Server mit eigenen lokalen Ressourcen gehostet: CPU, Speicher, Flash oder Datenträger. Sie können eine PDB als Shard angeben. PDB-Shards aus verschiedenen CDBs bilden eine einzelne logische Datenbank, die als gemeinsam verwendete Datenbank bezeichnet wird. Zwei Shards in derselben CDB können nicht Mitglieder der gleichen in Shards unterteilten Datenbank sein. Innerhalb derselben CDB kann sich jedoch eine PDB in einer in Shards unterteilten Datenbank befinden, und eine andere PDB könnte sich in einer separaten in Shards unterteilten Datenbank befinden.
Bei der horizontalen Partitionierung wird eine Datenbanktabelle auf Shards aufgeteilt, sodass jedes Shard die Tabelle mit denselben Spalten, aber einer anderen Teilmenge von Zeilen enthält. Eine Tabelle, die auf diese Weise aufgeteilt wird, wird auch als gemeinsam verwendete Tabelle bezeichnet. Die folgende Abbildung zeigt eine in Shards unterteilte Tabelle, die horizontal über drei Shards partitioniert ist. Dabei handelt es sich jeweils um eine PDB in einer separaten CDB.
Abbildung 4: Horizontale Partitionierung einer Tabelle über Shards
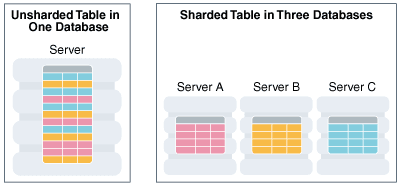
Beschreibung der Abbildung admin_3v_134a.png
Ein Anwendungsfall ist die Verteilung von Kundenaccountdaten auf mehrere CDBs. Beispiel: Ein Kunde mit der ID 28459361 kann seine Datensätze nachschlagen. Die folgende Abbildung zeigt eine mögliche Architektur. Die Kundenanforderung wird über einen Verbindungspool weitergeleitet, in dem Sharding Directors (Netzwerk-Listener) die Anforderung an das entsprechende PDB-Shard weiterleiten, das alle Kundenzeilen enthält.
Abbildung 5: Oracle Globally Distributed Database-Architektur
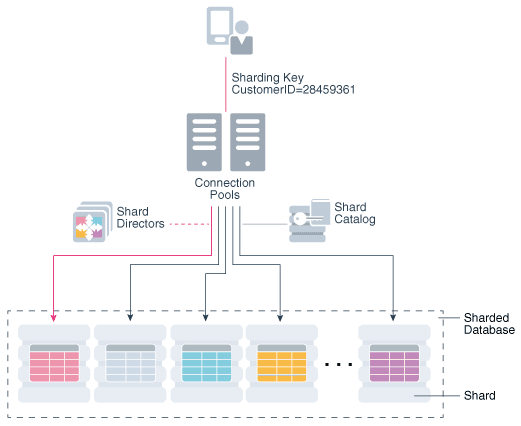
Beschreibung der Abbildung admin_3v_143d.png
Verwandte Themen
Datenbank-Speicherungsstrukturen
Eine Datenbank kann sowohl physisch als auch logisch betrachtet werden.
Physische Daten können auf Betriebssystemebene angezeigt werden. Beispiel: Betriebssystem-Utilitys wie Linux ls und ps können Datenbankdateien und -prozesse auflisten. Logische Daten wie eine Tabelle sind nur für die Datenbank aussagekräftig. Eine SQL-Anweisung kann die Tabellen in einer Oracle-Datenbank auflisten, ein Betriebssystem-Utility jedoch nicht.
Die Datenbank verfügt über physische Strukturen und logische Strukturen. Da die physischen und logischen Strukturen getrennt sind, können Sie den physischen Speicher von Daten verwalten, ohne den Zugriff auf logische Speicherstrukturen zu beeinträchtigen. Beispiel: Wenn Sie eine physische Datenbankdatei umbenennen, werden die Tabellen, deren Daten in dieser Datei gespeichert sind, nicht umbenannt.
-
Physische Speicherstrukturen Die physischen Datenbankstrukturen sind die Dateien, in denen die Daten gespeichert werden.
-
Logische Speicherstrukturen Mit logischen Speicherstrukturen kann Oracle AI Database die Nutzung des Festplattenspeichers fein granuliert steuern.
Physische Speicherstrukturen
Die physischen Datenbankstrukturen sind die Dateien, in denen die Daten gespeichert werden.
Wenn Sie einen Befehl CREATE DATABASE ausführen, erstellen Sie eine CDB. Die folgenden Dateien werden erstellt:
-
Datendateien
Jede CDB verfügt über eine oder mehrere physische Datendateien, die alle Datenbankdaten enthalten. Die Daten logischer Datenbankstrukturen, wie Tabellen und Indizes, werden physisch in den Datendateien gespeichert.
-
Kontrolldateien
Jede CDB verfügt über eine Kontrolldatei. Eine Kontrolldatei enthält Metadaten zur Angabe der physischen Struktur der Datenbank, einschließlich des Datenbanknamens und der Namen und Speicherorte der Datenbankdateien.
-
Online Redo Log-Dateien
Jede CDB verfügt über ein Online-Redo-Log, bei dem es sich um eine Gruppe von zwei oder mehr Online-Redo-Logdateien handelt. Ein Online-Redo-Log besteht aus Redo-Einträgen (auch als Redo-Logdatensätze bezeichnet), in denen alle an Daten vorgenommenen Änderungen aufgezeichnet werden.
Wenn Sie einen CREATE PLUGGABLE DATABASE-Befehl in einer CDB ausführen, erstellen Sie eine PDB. Die PDB enthält ein dediziertes Set von Datendateien innerhalb der CDB. Eine PDB verfügt über keine separate, dedizierte Kontrolldatei und kein Online-Redo-Log: Diese Dateien werden von den PDBs gemeinsam verwendet.
Viele andere Dateien sind wichtig für die Funktionsweise einer CDB. Dazu gehören Parameterdateien und Netzwerkdateien. Backupdateien und archivierte Redo Log-Dateien sind Offlinedateien, die für Backup und Recovery wichtig sind.
Verwandte Themen
Siehe auch: "Physische Speicherstrukturen"
Logische Speicherstrukturen
Mit logischen Speicherstrukturen kann Oracle AI Database die Belegung des Festplattenspeichers genau steuern.
In diesem Thema werden logische Speicherstrukturen erläutert:
-
Datenblöcke
Auf der höchsten Granularitätsebene werden Oracle AI Database-Daten in Datenblöcken gespeichert. Ein Datenblock entspricht einer bestimmten Anzahl von Byte auf dem Datenträger.
-
Extents
Ein Extent umfasst eine bestimmte Anzahl von zusammenhängenden Datenblöcken, die bei einer Zuweisung entstehen und zum Speichern bestimmter Informationstypen verwendet werden.
-
Segmente
Ein Segment ist eine Gruppe von Extents, die einem Benutzerobjekt (z.B. einer Tabelle oder einem Index), Undo-Daten oder temporären Daten zugewiesen sind.
-
Tablespaces
Eine Datenbank ist in logische Speichereinheiten, die als Tablespaces bezeichnet werden, unterteilt. Ein Tablespace ist der logische Container für Segmente. Jeder Tablespace besteht aus mindestens einer Datendatei.
Verwandte Themen
Datenbankinstanzstrukturen
Eine Oracle-Datenbank verwendet Speicherstrukturen und -prozesse, um die CDB zu verwalten und darauf zuzugreifen. Alle Speicherstrukturen befinden sich im Hauptspeicher der Computer, die das RDBMS bilden.
Wenn Anwendungen eine Verbindung zu einer CDB oder PDB herstellen, stellen sie eine Verbindung zu einer Datenbankinstanz her. Die Instance bedient Anwendungen, indem neben der SGA auch andere Speicherbereiche zugewiesen und neben Hintergrundprozessen weitere Prozesse gestartet werden.
-
Oracle AI Database-Prozesse Ein Prozess ist ein Mechanismus in einem Betriebssystem, der eine Reihe von Schritten ausführen kann. Einige Betriebssysteme verwenden die Begriffe job, task oder thread.
-
Instance Memory Structures Oracle AI Database erstellt und verwendet Speicherstrukturen für Programmcode, Daten, die von Benutzern gemeinsam verwendet werden, und private Datenbereiche für jeden verbundenen Benutzer.
Oracle AI Database-Prozesse
Ein Prozess ist ein Mechanismus in einem Betriebssystem, der eine Reihe von Schritten ausführen kann. Einige Betriebssysteme verwenden die Begriffe job, task oder thread.
Für die Zwecke dieses Themas entspricht ein Thread einem Prozess. Eine Oracle-Datenbankinstanz verfügt über die folgenden Prozesstypen:
-
Clientprozesse
Diese Prozesse werden erstellt und verwaltet, um den Softwarecode eines Anwendungsprogramms oder eines Oracle-Tools auszuführen. Die meisten Umgebungen verfügen über separate Computer für Clientprozesse.
-
Hintergrundprozesse
Diese Prozesse konsolidieren Funktionen, die andernfalls von mehreren Oracle AI Database-Programmen behandelt werden würden, welche für jeden Clientprozess ausgeführt würden. Hintergrundprozesse führen I/O asynchron aus und überwachen andere Oracle AI Database-Prozesse, um eine höhere Parallelität für bessere Performance und Zuverlässigkeit bereitzustellen.
-
Serverprozesse
Diese Prozesse kommunizieren mit Clientprozessen und interagieren mit Oracle AI Database, um Anforderungen zu erfüllen.
Oracle-Prozesse umfassen Serverprozesse und Hintergrundprozesse. In den meisten Umgebungen werden Oracle-Prozesse und -Clientprozesse auf separaten Computern ausgeführt.
Verwandte Themen
Instanzspeicherstrukturen
Oracle AI Database erstellt und verwendet Speicherstrukturen für Programmcode, Daten, die von Benutzern gemeinsam verwendet werden, und private Datenbereiche für jeden verbundenen Benutzer.
Die folgenden Speicherstrukturen sind mit einer Datenbankinstanz verknüpft:
-
System Global Area (SGA)
Die SGA ist eine Gruppe von Shared Memory-Strukturen, die Daten und Kontrollinformationen für eine Datenbankinstanz enthalten. Beispiele für SGA-Komponenten sind der Datenbank-Buffer Cache und Shared SQL-Bereiche. Die SGA kann einen optionalen In-Memory Column Store (IM-Spaltenspeicher) enthalten, mit dem Daten IM Speicher in einem Spaltenformat aufgefüllt werden können.
-
Program Global Areas (PGA)
Eine PGA ist ein Speicherbereich, der Daten und Steuerungsinformationen für einen Server- oder Hintergrundprozess enthält. Der Zugriff auf die PGA ist exklusiv für den Prozess. Jeder Serverprozess und Hintergrundprozess hat seine eigene PGA.
Verwandte Themen
Anwendungs- und Netzwerkarchitektur
Um die Vorteile eines bestimmten Computersystems oder Netzwerks voll auszuschöpfen, ermöglicht Oracle AI Database, dass die Verarbeitung zwischen dem Datenbankserver und den Clientprogrammen aufgeteilt wird. Der Computer, auf dem das RDBMS ausgeführt wird, übernimmt die Verantwortung für den Datenbankserver, während die Computer, auf denen die Anwendungen ausgeführt werden, die Interpretation und Anzeige von Daten übernehmen.
-
Anwendungsarchitektur Die Anwendungsarchitektur ist die Computing-Umgebung, in der eine Datenbankanwendung eine Verbindung zu einer Oracle-Datenbank herstellt. Die beiden gebräuchlichsten Datenbankarchitekturen sind Client/Server und Multi-Tier.
-
Oracle Net Services-Architektur
Oracle Net Services ist die Schnittstelle zwischen der Datenbank und den Netzwerkkommunikationsprotokollen, die eine verteilte Verarbeitung und verteilte Datenbanken ermöglichen.
Anwendungsarchitektur
Die Anwendungsarchitektur ist die Computing-Umgebung, in der sich eine Datenbankanwendung bei einer Oracle-Datenbank anmeldet. Die beiden gebräuchlichsten Datenbankarchitekturen sind Client/Server und Multi-Tier.
Client/Server-Architektur
In einer Client/Server-Architektur initiiert die Clientanwendung eine Anforderung für einen Vorgang, der auf dem Datenbankserver ausgeführt werden soll. Der Server führt die Oracle AI Database-Software aus und verarbeitet die Funktionen, die für den gleichzeitigen, gemeinsamen Datenzugriff erforderlich sind. Der Server empfängt und verarbeitet Anforderungen, die von Clients stammen.
Multitier-Architektur
In einer Multitier-Architektur führen ein oder mehrere Anwendungsserver Teile des Vorgangs aus. Ein Anwendungsserver enthält einen großen Teil der Anwendungslogik, ermöglicht den Zugriff auf die Daten für den Client und führt eine gewisse Abfrageverarbeitung durch. Auf diese Weise verringert sich die Belastung der Datenbank. Der Anwendungsserver kann als Schnittstelle zwischen Clients und mehreren Datenbanken dienen und eine zusätzliche Sicherheitsebene bieten.
Eine serviceorientierte Architektur (Service-Oriented Architecture, SAA) ist eine Multi-Tier-Architektur, in der Anwendungsfunktionen in Services gekapselt sind. SOA-Services werden in der Regel als Web-Services implementiert. Web Services sind über HTTP zugänglich und basieren auf XML-basierten Standards wie Web Services Description Language (WSDL) und SOAP. Oracle AI Database kann als Web Service Provider in einer traditionellen Multi-Tier- oder SOA-Umgebung fungieren.
Eine Microservices-Architektur unterteilt eine Anwendung in kleine, unabhängig entwickelte und bereitgestellte Services. Jeder Service besitzt seine Geschäftslogik und im Idealfall seine Daten, wodurch die Kopplung reduziert wird und Teams Services unabhängig skalieren, aktualisieren und betreiben können.
Die mehrmandantenfähige Architektur von Oracle ist natürlich dem Muster "Database-per-Service" zugeordnet. Jeder Microservice kann seine eigene integrierbare Datenbank (PDB) verwenden und eine separate Daten-, Sicherheits- und Administrationsgrenze bereitstellen, während mehrere PDBs die Ressourcen einer gemeinsamen Containerdatenbank (CDB) gemeinsam nutzen.
Dieser Ansatz kombiniert die Serviceisolierung mit einer effizienten Konsolidierung. PDBs können unabhängig bereitgestellt, geklont, gepatcht, gesichert, umgespeichert und skaliert werden, während Administratoren die zentrale Kontrolle über die zugrunde liegende Datenbankinfrastruktur behalten.
Verwandte Themen
Oracle Net Services-Architektur
Oracle Net Services sind die Schnittstelle zwischen der Datenbank und den Netzwerkkommunikationsprotokollen, die eine verteilte Verarbeitung und verteilte Datenbanken ermöglichen.
Kommunikationsprotokolle definieren die Art und Weise, wie Daten in einem Netzwerk übertragen und empfangen werden. Oracle Net Services unterstützt die Kommunikation mit allen wichtigen Netzwerkprotokollen, einschließlich TCP/IP, HTTP, FTP und WebDAV. Oracle Net, eine Komponente von Oracle Net Services, erstellt und verwaltet eine Netzwerksession von einer Clientanwendung zu einem Datenbankserver. Nachdem eine Netzwerksession aufgebaut wurde, fungiert Oracle Net als Datenkurier für die Clientanwendung und den Datenbank-Server und tauscht Nachrichten zwischen ihnen aus. Oracle Net können diese Aufgaben ausführen, da es sich auf jedem Rechner in dem Netzwerk befindet.
Eine wichtige Komponente von Net Services ist der Oracle Net Listener (als Listener bezeichnet), ein Prozess, der in der Datenbank oder an anderer Stelle im Netzwerk ausgeführt wird. Clientanwendungen senden Verbindungsanforderungen an den Listener, der den Datenverkehr dieser Anforderungen an die Datenbank verwaltet. Wenn eine Verbindung hergestellt wird, kommunizieren Client und Datenbank direkt.
Oracle REST Data Services
Oracle REST Data Services (ORDS) stellt ein HTTPS-Gateway zu Oracle AI Database bereit. Damit können Anwendungen Tabellen, Views und Stored Procedures, die in PL/SQL, JavaScript und Java geschrieben wurden, sowie benutzerdefinierte Datenbankvorgänge als sichere REST-APIs bereitstellen, oft ohne dass ein separater Anwendungsserver oder umfangreicher Middleware-Code erforderlich ist.
ORDS unterstützt auch die Oracle Database API for MongoDB, sodass Anwendungen kompatible MongoDB-Treiber, -Tools und -Befehle verwenden können, um auf JSON-Dokumentsammlungen zuzugreifen, die in Oracle Database gespeichert sind. Das Wire-Protokoll MongoDB wird über ORDS in Datenbankvorgänge übersetzt, sodass REST-, MongoDB- und SQL-Anwendungen mit Daten arbeiten können, die von derselben konvergierten Datenbank verwaltet werden.
Verwandte Themen