Physische Speicherstrukturen
Die physischen Datenbankstrukturen einer Oracle-Datenbank können auf Betriebssystemebene angezeigt werden.
-
Einführung in physische Speicherstrukturen Ein Merkmal eines RDBMS ist die Unabhängigkeit logischer Datenstrukturen wie Tabellen, Views und Indizes von physischen Speicherstrukturen wie Dateien.
-
Überblick über Datendateien Auf Betriebssystemebene speichert Oracle AI Database Daten in Strukturen, die als Datendateien bezeichnet werden. Jede Oracle-Datenbank, ob CDB oder PDB, muss mindestens eine Datendatei aufweisen.
-
Überblick über Kontrolldateien Die Kontrolldatei der Datenbank ist eine kleine Binärdatei, die nur einer CDB zugeordnet ist.
-
Überblick über das Online-Redo-Log Die wichtigste Struktur für das Recovery ist das Online-Redo-Log, das aus zwei oder mehr vorab zugewiesenen Dateien besteht, in denen Änderungen an der Datenbank gespeichert werden, sobald sie auftreten. Die Online Redo Log-Datensätze ändern sich in den Datendateien.
Physische Speicherstrukturen - Einführung
Ein Merkmal eines RDBMS ist die Unabhängigkeit logischer Datenstrukturen wie Tabellen, Views und Indizes von physischen Speicherstrukturen wie Dateien.
Da physische und logische Strukturen voneinander getrennt sind, können Sie die physische Speicherung von Daten verwalten, ohne den Zugriff auf logische Strukturen zu beeinträchtigen. Beispiel: Wenn Sie eine Datenbankdatei umbenennen, werden die darin gespeicherten Tabellen nicht umbenannt.
Eine Oracle-Datenbank ist eine Gruppe von Dateien, in denen Oracle-Daten im persistenten Speicher gespeichert werden. Ab Oracle Database 21c ist eine mehrmandantenfähige Containerdatenbank (CDB) die einzige unterstützte Architektur. Eine CDB enthält mindestens eine PDB.
In diesem Abschnitt werden die Datenbankdateien beschrieben, die generiert werden, wenn Sie eine CREATE DATABASE-Anweisung zum Erstellen einer CDB absetzen:
-
Datendateien und temporäre Dateien
Eine Datendatei ist eine physische Datei im persistenten Speicher, die von Oracle AI Database erstellt wurde und Datenstrukturen wie Tabellen und Indizes enthält. Eine Temp-Datei ist eine Datendatei, die zu einem Temporary Tablespace gehört. Die Datenbank schreibt Daten in diese Dateien in einem Oracle-spezifischen Format, das von anderen Programmen aus nicht gelesen werden kann.
Wenn Sie eine PDB innerhalb einer PDB erstellen, verfügt die PDB über eine eigene Gruppe von Datendateien innerhalb der gesamten Gruppe von Datendateien, aus denen die CDB besteht. Beispiel: Sie können eine CDB namens
mycdberstellen und dann zwei PDBs darin erstellen:hrpdbundsalespdb. In diesem Fall hättemycdbeine eigene Gruppe von Datendateien und temporären Dateien, wiehrpdbundsalespdb. -
Kontrolldateien
Eine Kontrolldatei ist eine Root-Datei, in der die physischen Komponenten der CDB verfolgt werden. PDBs verfügen nicht über eigene separate Kontrolldateien.
-
Online Redo Log-Dateien
Das Online-Redo-Log ist eine Gruppe von Dateien, die Datensätze mit Änderungen enthalten, die an Daten innerhalb der CDB vorgenommen wurden. PDBs verfügen nicht über eigene separate Online Redo Log-Dateien.
Eine Datenbankinstanz ist eine Gruppe von Speicherstrukturen, die Datenbankdateien in einer CDB verwalten. Die folgende Grafik zeigt die Beziehung zwischen der Instanz und den von ihr verwalteten Dateien.
Abbildung 1: Datenbankinstanz- und Datenbankdateien
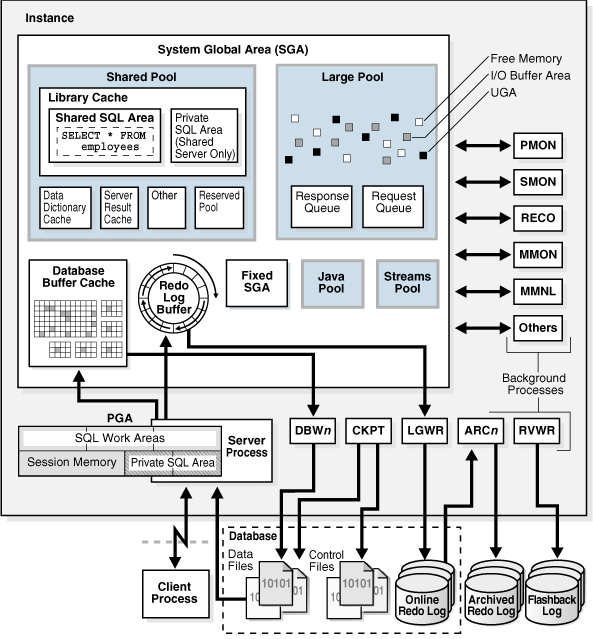
Beschreibung der Abbildung cncpt223.gif
-
Mechanismen zum Speichern von Datenbankdateien Zum Zuweisen und Verwalten des Speichers dieser Dateien stehen mehrere Mechanismen zur Verfügung.
-
Oracle Managed Files und benutzerverwaltete Dateien Oracle Managed Files ist eine Dateibenennungsstrategie, mit der Sie Vorgänge in Bezug auf Datenbankobjekte und nicht in Dateinamen angeben können. Beispiel: Sie können einen Tablespace erstellen, ohne die Namen der zugehörigen Datendateien anzugeben.
-
Oracle Automatic Storage Management (Oracle ASM) Oracle ASM ist eine leistungsstarke Speicherlösung mit einfacher Verwaltung für Oracle AI Database-Dateien. Oracle ASM ist ein Volume Manager und stellt ein Dateisystem bereit, das ausschließlich für die Verwendung durch die Datenbank entwickelt wurde.
-
Oracle Persistent Memory Filestore (PMEM Filestore) PMEM ist ein Byte-adressierbarer persistenter Speicher. In Oracle Persistent Memory Filestore (PMEM Filestore) können Datendateien, Online Redo Log-Dateien und Kontrolldateien gespeichert werden.
Siehe:
-
Oracle AI Database Administrator's Guide zum Erstellen einer Datenbank
-
Oracle AI Database SQL Language Reference für Semantik und Syntax von
CREATE DATABASE
Mechanismen zum Speichern von Datenbankdateien
Für die Zuordnung und Verwaltung der Speicherung dieser Dateien stehen mehrere Mechanismen zur Verfügung.
Zu den Mechanismen gehören:
-
Dateisystem des Betriebssystems
Die meisten Oracle-Datenbanken speichern Dateien in einem Dateisystem. Dies ist eine Struktur zum Speichern und Abrufen von Daten.
Ein Dateisystem ermöglicht die standardmäßige und konsistente Verwendung von Speicherplatz für Anwendungsdaten. Jede Datei hat einen Namen und wird als zusammenhängender Adressraum für Anwendungen wie Oracle AI Database angezeigt. Die Datenbank kann Dateien erstellen, lesen, schreiben, skalieren und löschen.
Ein Dateisystem basiert im Allgemeinen auf einem logischen Volume, das von einem Softwarepackage namens Logical Volume Manager (LVM) erstellt wird. Mit dem LVM können Teile mehrerer physischer Datenträger zu einem einzelnen zusammenhängenden Adressraum kombiniert werden.
-
Clusterdateisystem
Ein Clusterdateisystem ist ein verteiltes Dateisystem, bei dem es sich um ein Cluster von Servern handelt, die zusammenarbeiten, um ihren Clients Konsistenz und hohe Performance zu bieten. In einer Oracle RAC-Umgebung zeigt ein Clusterdateisystem Shared Storage als Dateisystem an, das von vielen Computern in einer Clusterumgebung gemeinsam verwendet wird. Bei einem Clusterdateisystem macht der Ausfall eines Computers im Cluster das Dateisystem nicht verfügbar. In einem Betriebssystem-Dateisystem ist das Dateisystem jedoch nicht verfügbar, wenn ein Computer Dateien über NFS oder andere Mittel freigibt.
-
Oracle Persistent Memory Filestore (PMEM-Filestore)
PMEM Filestore wurde entwickelt, um Datenbankdateien im persistenten Speicher (Persistent Memory, PMEM) zu speichern, d.h. im Byte-adressierbaren persistenten Speicher. Sie erstellen einen Filestore mit dem Befehl
CREATE PMEM FILESTORE. Auf der Linux-Betriebssystemebene speichert der Filestore Daten in einem großen ext4-Dateisystem, das imfsdax-Modus gemountet ist. PMEM Filestore erscheint Oracle AI Database als natives Dateisystem unter Linux.Hinweis: Im Gegensatz zu einem POSIX-konformen Dateisystem kann PMEM Filestore nicht von mehreren Oracle-Datenbanken gemeinsam verwendet werden.
-
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM umfasst ein Dateisystem, das ausschließlich für die Verwendung durch Oracle AI Database entwickelt wurde.
Eine Datenbank kann eine Kombination der vorhergehenden Speichermechanismen verwenden. Beispiel: Eine Datenbank könnte die Server Parameter File in einem herkömmlichen Dateisystem speichern, Datenbankdateien in PMEM Filestore speichern und dann die Redo Log-Dateien in einem Cluster File System archivieren.
Siehe:
-
Oracle AI Database Administrator's Guide zum Anzeigen von Datenbankspeicherstrukturen durch Abfragen von Datenbankansichten
Oracle Managed Files und benutzerverwaltete Dateien
Oracle Managed Files ist eine Dateibenennungsstrategie, mit der Sie Vorgänge in Bezug auf Datenbankobjekte und nicht auf Dateinamen angeben können. Beispiel: Sie können einen Tablespace erstellen, ohne die Namen der zugehörigen Datendateien anzugeben.
Mit Oracle Managed Files müssen Administratoren die Betriebssystemdateien in einer Datenbank nicht mehr direkt verwalten. Für Oracle ASM sind Oracle Managed Files erforderlich.
Hinweis: Diese Funktion hat keine Auswirkungen auf die Erstellung oder Benennung von administrativen Dateien wie Trace-Dateien, Auditdateien und Alertlogs.
Mit benutzerverwalteten Dateien verwalten Sie direkt die Betriebssystemdateien in der Datenbank. Sie treffen die Entscheidungen in Bezug auf Dateistruktur und Benennung. Beispiel: Wenn Sie einen Tablespace erstellen, legen Sie den Namen und Pfad der Tablespace-Datendateien fest.
Über Initialisierungsparameter geben Sie das Dateisystemverzeichnis für einen bestimmten Dateityp an. Mit dem Feature "Oracle Managed Files" wird sichergestellt, dass die Datenbank eine eindeutige Datei erstellt und löscht, wenn sie nicht mehr benötigt wird. Die Datenbank verwendet intern Standarddateisystemschnittstellen, um Dateien für Datendateien und temporäre Dateien, Kontrolldateien und Recovery-bezogene Dateien zu erstellen und zu löschen, die im Fast Recovery-Bereich gespeichert sind.
In Oracle Managed Files werden vorhandene Funktionen nicht eliminiert. Sie können neue Dateien erstellen, während Sie alte Dateien manuell verwalten. Daher kann eine Datenbank eine Mischung aus Oracle Managed Files und benutzerverwalteten Dateien enthalten.
Siehe:
-
Oracle AI Database - Administratordokumentation zur Verwendung von Oracle Managed Files
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM ist eine leistungsstarke Speicherlösung mit einfacher Verwaltung für Oracle AI Database-Dateien. Oracle ASM ist ein Volume Manager und stellt ein Dateisystem bereit, das ausschließlich für die Verwendung durch die Datenbank entwickelt wurde.
Oracle ASM bietet mehrere Vorteile gegenüber herkömmlichen Dateisystemen und Storage Managern, darunter:
-
Vereinfacht speicherbezogene Aufgaben wie das Erstellen und Erstellen von Datenbanken und das Verwalten von Festplattenspeicher
-
Verteilt Daten auf physische Datenträger, um Hot Spots zu eliminieren und eine gleichmäßige Performance auf allen Datenträgern bereitzustellen
-
Rebalancing von Daten automatisch nach Änderungen der Speicherkonfiguration
Um Oracle ASM zu verwenden, weisen Sie partitionierte Datenträger für Oracle AI Database mit Voreinstellungen für Striping und Mirroring zu. Oracle ASM verwaltet den Festplattenspeicher und verteilt die I/O-Last auf alle verfügbaren Ressourcen, um die Performance zu optimieren, ohne dass eine manuelle I/O-Optimierung erforderlich ist. Beispiel: Sie können die Größe der Festplatte für die Datenbank erhöhen oder Teile der Datenbank auf neue Geräte verschieben, ohne die Datenbank herunterfahren zu müssen.
-
Oracle ASM Storage Components Oracle AI Database kann eine Datendatei als Oracle ASM-Datei in einer Oracle ASM-Datenträgergruppe speichern. Innerhalb einer Plattengruppe stellt Oracle ASM eine Dateisystemschnittstelle für Datenbankdateien bereit.
-
Oracle ASM-Instanzen Eine Oracle ASM-Instanz ist eine spezielle Oracle-Instanz, die Oracle ASM-Datenträger verwaltet.
Oracle ASM-Speicherkomponenten
Oracle AI Database kann eine Datendatei als Oracle ASM-Datei in einer Oracle ASM-Datenträgergruppe speichern. Innerhalb einer Plattengruppe stellt Oracle ASM eine Dateisystemschnittstelle für Datenbankdateien bereit.
Die folgende Abbildung zeigt die Beziehungen zwischen Speicherkomponenten in einer Datenbank, die Oracle ASM verwendet. Das Diagramm zeigt die Beziehung zwischen einer Oracle ASM-Datei und einer Datendatei, obwohl Oracle ASM andere Dateitypen speichern kann. Die Fußnotation der Krähe stellt eine Eins-zu-Viele-Beziehung dar.
Abbildung 2: Oracle ASM-Komponenten
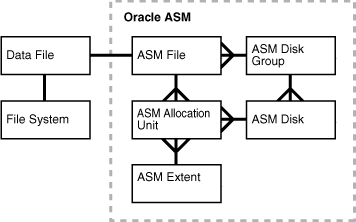
Beschreibung der Abbildung cncpt267.gif
In Abbildung 14-2 werden die folgenden Oracle ASM-Konzepte dargestellt:
-
Oracle ASM-Datenträger
Ein Oracle ASM-Datenträger ist ein Speichergerät, das einer Oracle ASM-Datenträgergruppe durch Provisioning bereitgestellt wird. Eine Oracle ASM-Festplatte kann eine physische Festplatte oder Partition, eine LUN (Logical Unit Number) aus einem Speicher-Array, ein logisches Volume oder eine über das Netzwerk angehängte Datei sein.
Oracle ASM-Platten können einer Plattengruppe hinzugefügt oder daraus entfernt werden, während die Datenbank ausgeführt wird. Wenn Sie einer Datenträgergruppe einen Datenträger hinzufügen, weisen Sie entweder einen Datenträgernamen zu, oder der Datenträger erhält automatisch einen Oracle ASM-Datenträgernamen.
-
Oracle ASM-Datenträgergruppen
Eine Oracle ASM-Datenträgergruppe ist eine Zusammenstellung von Oracle ASM-Datenträgern, die als logische Einheit verwaltet werden. Die Datenstrukturen in einer Plattengruppe sind eigenständig und belegen einen Teil des Plattenspeichers in einer Plattengruppe.
Innerhalb einer Plattengruppe stellt Oracle ASM eine Dateisystemschnittstelle für Oracle-Datenbankdateien bereit. Der Inhalt von Dateien, die in einer Plattengruppe gespeichert sind, wird gleichmäßig verteilt oder gestreift, um Hot Spots zu eliminieren und eine gleichmäßige Performance auf den Platten zu gewährleisten.
-
Oracle ASM-Dateien
Eine Oracle ASM-Datei ist eine Datei, die in einer Oracle ASM-Datenträgergruppe gespeichert ist. Oracle AI Database kommuniziert in Form von Dateien mit Oracle ASM. Die Datenbank kann Datendateien, Kontrolldateien, Online Redo Log-Dateien und andere Dateitypen als Oracle ASM-Dateien speichern. Auf Anforderung der Datenbank erstellt Oracle ASM eine Oracle ASM-Datei und weist ihr einen Namen zu, der mit einem Pluszeichen (
+) gefolgt von einem Datenträgergruppennamen beginnt, wie in+DISK1.Hinweis: Oracle ASM-Dateien können zusammen mit anderen Speicherverwaltungsoptionen wie Dateisystemen von Drittanbietern vorhanden sein. Diese Funktion vereinfacht die Integration von Oracle ASM in bereits vorhandene Umgebungen.
-
Oracle ASM - Extents
Ein Oracle ASM-Extent ist ein Abschnitt einer Oracle ASM-Datei. Eine Oracle ASM-Datei enthält mindestens ein Datei-Extent. Jedes Oracle ASM-Extent besteht aus einer oder mehreren Zuweisungseinheiten auf einem bestimmten Datenträger.
Hinweis: Ein Oracle ASM-Extent unterscheidet sich vom Extent, mit dem Daten in einem Segment gespeichert werden.
-
Oracle ASM - Umlageeinheiten
Eine Oracle ASM-Zuweisungseinheit ist die grundlegende Zuweisungseinheit innerhalb einer Plattengruppe. Eine Zuordnungseinheit ist der kleinste zusammenhängende Datenträgerspeicherplatz, den Oracle ASM zuweist. Mindestens eine Umlageeinheit bildet ein Oracle ASM-Extent.
Siehe auch: Oracle Automatic Storage Management Administrator's Guide, um mehr über Oracle ASM zu erfahren
Oracle ASM-Instanzen
Eine Oracle ASM-Instanz ist eine spezielle Oracle-Instanz, die Oracle ASM-Datenträger verwaltet.
Sowohl die Oracle ASM- als auch die Datenbankinstanzen benötigen gemeinsamen Zugriff auf die Datenträger in einer Oracle ASM-Datenträgergruppe. Oracle ASM-Instanzen verwalten die Metadaten der Plattengruppe und stellen den Datenbankinstanzen Informationen zum Dateilayout bereit. Datenbankinstanzen leiten I/O an Oracle ASM-Datenträger weiter, ohne eine Oracle ASM-Instanz zu durchlaufen.
Eine Oracle ASM-Instanz basiert auf derselben Technologie wie eine Datenbankinstanz. Beispiel: Eine Oracle ASM-Instanz verfügt über eine System Global Area (SGA) und Hintergrundprozesse, die denen einer Datenbankinstanz ähnlich sind. Eine Oracle ASM-Instanz kann jedoch keine Datenbank mounten und führt weniger Aufgaben aus als eine Datenbankinstanz. In Abbildung 14-3 ist eine Einzelknotenkonfiguration mit einer Oracle ASM-Instanz und zwei Datenbankinstanzen dargestellt, die jeweils mit einer anderen Einzelinstanzdatenbank verknüpft sind. Die Oracle ASM-Instanz verwaltet die Metadaten und stellt die Speicherplatzzuweisung für die Oracle ASM-Dateien bereit, in denen die Daten für die beiden Datenbanken gespeichert sind. Eine Oracle ASM-Datenträgergruppe verfügt über vier Oracle ASM-Datenträger, die andere über zwei Datenträger. Beide Datenbankinstanzen können auf die Datenträgergruppen zugreifen.
Abbildung 3: Oracle ASM-Instanz und -Datenbankinstanzen
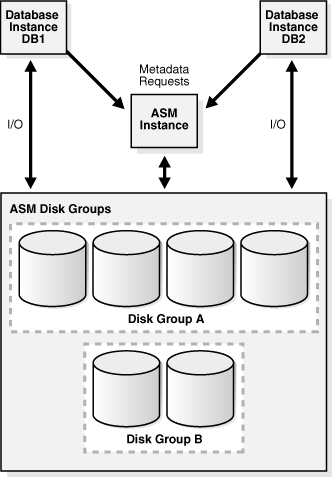
Beschreibung der Abbildung cncpt266.gif
Siehe auch: Oracle Automatic Storage Management Administrator's Guide, um mehr über Oracle ASM zu erfahren
Oracle Persistent Memory Filestore (PMEM-Filestore)
PMEM ist Byte-adressierbarer persistenter Speicher. In Oracle Persistent Memory Filestore (PMEM Filestore) können Datendateien, Online Redo Log-Dateien und Kontrolldateien gespeichert werden.
Abfragen können Byte direkt aus PMEM lesen, ohne zuerst Blöcke in den Datenbankpuffercache zu migrieren. Dieser leistungsstarke Mechanismus vermeidet Datenredundanz und unnötiges I/O. Hinweis: Ein PMEM-Dateispeicher kann keine Tracedateien, Auditdateien oder Serverparameterdateien speichern. Die unterstützten Dateitypen für PMEM ähneln den Typen für Oracle ASM.
-
Direkt zugeordneter Puffercache In der herkömmlichen Speicherpyramide befindet sich PMEM zwischen DRAM, das nicht persistent ist, und Flash, das persistent (nicht flüchtig) ist.
-
File System Interface for PMEM Filestore PMEM Filestore implementiert ein Protokoll namens Filesystem in Userspace (FUSE).
-
Benutzeroberfläche für PMEM-Filestore Um einen PMEM-Filestore zu erstellen, verwenden Sie den Befehl
CREATE PMEM FILESTORE.
Direkt zugeordneter Puffercache
In der herkömmlichen Speicherpyramide sitzt PMEM zwischen DRAM, das nicht persistent ist, und Flash, das persistent ist (nicht flüchtig).
Abbildung 4: Speicherpyramide
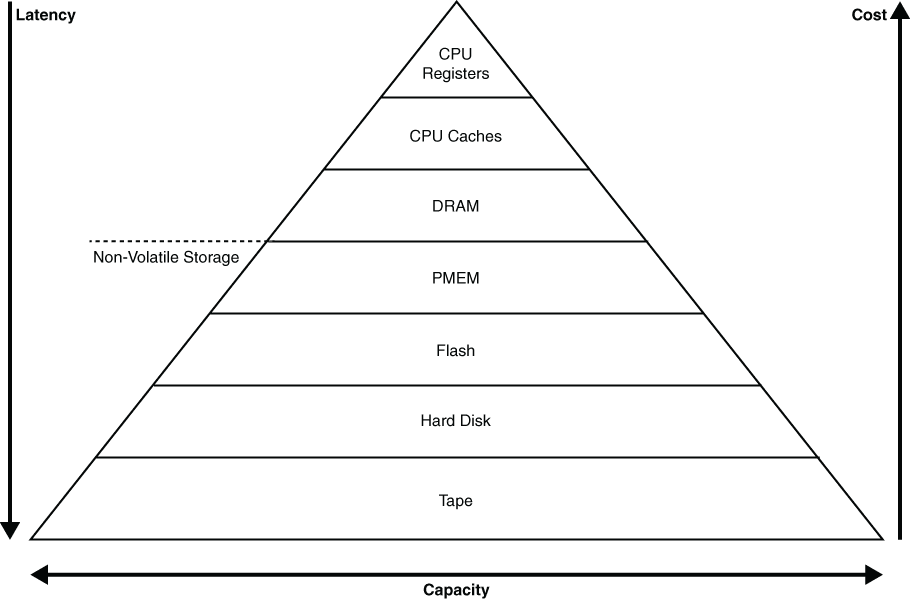
Beschreibung der Abbildung pmem.png
Der Datenbankpuffercache befindet sich in DRAM. Oracle-Prozesse haben direkten byteadressierbaren Zugriff auf Blöcke in einem PMEM-Dateispeicher, die dem Datenbankpuffercache zugeordnet sind. Der Zuordnungsmechanismus wird automatisch aufgerufen, wenn Sie eine Datendatei in einem PMEM-Dateispeicher speichern.
Oracle AI Database verwendet einen internen Algorithmus, um zu entscheiden, ob Datenblöcke aus dem PMEM-Dateispeicher in DRAM migriert werden. Typische Gründe für die Migration sind DML-Änderungen, Lesekonsistenz und schnellerer Zugriff für Hot Data Blöcke.
Siehe auch: "DRAM- und PMEM-Puffer"
Dateisystemschnittstelle für PMEM Filestore
PMEM Filestore implementiert ein Protokoll namens Filesystem in Userspace (FUSE).
Mit FUSE können nicht privilegierte Betriebssystembenutzer, wie der Eigentümer der Oracle AI Database-Software, Dateisysteme sowie die darin enthaltenen Verzeichnisse und Dateien erstellen und verwalten. Beispiel: Sie können die Befehle cp, rm und ls verwenden.
Ein typisches Dateisystem verwendet Raw Storage als Backing-Speicher, während PMEM Filestore Speicher aus einer nativen Betriebssystemdatei in einem PMEM DAX-Dateisystem bezieht. Diese Datei wird als Backing-Datei bezeichnet und ist als Datei im Betriebssystem sichtbar. PMEM Filestore unterteilt den Speicher innerhalb der Sicherungsdatei und stellt ihn als lokales Dateisystem dar.
Siehe:
- Oracle AI Database Administrator's Guide für weitere Informationen zu PMEM Filestore
Benutzeroberfläche für PMEM Filestore
Um einen PMEM-Filestore zu erstellen, verwenden Sie den Befehl CREATE PMEM FILESTORE.
Der PMEM-Filestore wird automatisch gemountet, nachdem er erstellt wurde. Der PMEM-Dateispeicher wird unter dem angegebenen Einhängepunkt angezeigt, als wäre er ein natives Dateisystem.
Der Initialisierungsparameter PMEM_FILESTORE gibt einen PMEM-Dateispeicher an, den die Datenbankinstanz automatisch mountet, wenn sie gestartet wird. Der Parameter wird auf ein geordnetes Zeichenfolgenpaar gesetzt. Die erste Zeichenfolge in der Parameterwerteliste ist das Verzeichnis, in dem PMEM Filestore gemountet ist. Die zweite Zeichenfolge ist die Sicherungsdatei.
V$PMEM_FILESTORE zeigt Metadaten zu einem PMEM-Filestore. Beispiel: Sie können den Verzeichnispfad des Mount Points, den Dateipfad für die Sicherungsdatei und die Filestore-Größe anzeigen.
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie einen PMEM-Dateispeicher erstellen und verwalten.
Übersicht über Datendateien
Auf Betriebssystemebene speichert Oracle AI Database Daten in Strukturen, die als Datendateien bezeichnet werden. Jede Oracle-Datenbank, ob CDB oder PDB, muss mindestens eine Datendatei aufweisen.
-
Verwendung von Datendateien Oracle AI Database speichert Tablespace-Daten physisch in Datendateien.
-
Dauerhafte und temporäre Datendateien Ein permanenter Tablespace enthält persistente Schemaobjekte. Objekte in Permanent Tablespaces werden in Datendateien gespeichert.
-
Online- und Offlinedatendateien Jede Datendatei ist entweder online (verfügbar) oder offline (nicht verfügbar).
-
Datendateistruktur Oracle AI Database erstellt eine Datendatei für einen Tablespace, indem der angegebene Speicherplatz plus der Overhead für den Datendatei-Header zugewiesen wird. Das Betriebssystem, unter dem Oracle AI Database ausgeführt wird, ist dafür verantwortlich, alte Informationen und Autorisierungen aus einer Datei zu löschen, bevor sie der Datenbank zugewiesen werden.
Verwendung von Datendateien
Oracle AI Database speichert Tablespace-Daten physisch in Datendateien.
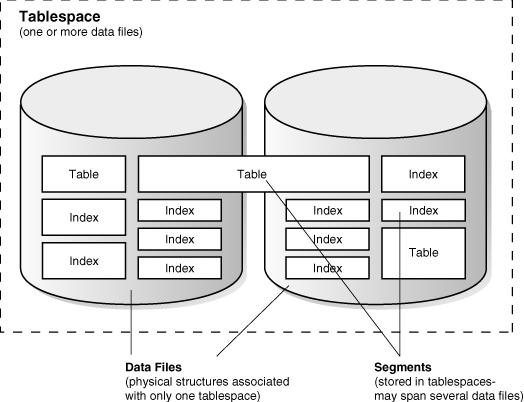
Jedes nicht partitionierte Schemaobjekt und jede Partition eines Objekts wird in einem eigenen Segment gespeichert, das nur zu einem Tablespace gehört. Beispiel: Die Daten für eine nicht partitionierte Tabelle werden in einem einzelnen Segment gespeichert, das wiederum in einem Tablespace gespeichert wird. Tablespaces und Datendateien sind eng miteinander verknüpft, weisen jedoch wichtige Unterschiede auf:
-
Jeder Tablespace besteht aus einer oder mehreren Datendateien, die dem Betriebssystem entsprechen, in dem Oracle AI Database ausgeführt wird.
-
Die Daten für eine Datenbank werden gemeinsam in den Datendateien gespeichert, die sich in jedem Tablespace der Datenbank befinden.
-
Ein Segment kann sich über eine oder mehrere Datendateien erstrecken, sich jedoch nicht über mehrere Tablespaces erstrecken.
-
Eine CDB muss die Tablespaces
SYSTEMundSYSAUXaufweisen. Jede PDB innerhalb einer CDB verfügt über eigene TablespacesSYSTEMundSYSAUX. Oracle AI Database weist während der Datenbankerstellung automatisch die ersten Datendateien einer Datenbank für den TablespaceSYSTEMzu.Der Tablespace
SYSTEMenthält das Data Dictionary, eine Gruppe von Tabellen, die Datenbankmetadaten enthält. In der Regel verfügt eine Datenbank auch über einen Undo Tablespace und einen temporären Tablespace (in der RegelTEMP).
Die folgende Abbildung zeigt die Beziehung zwischen Tablespaces, Datendateien und Segmenten.
Abbildung 5: Datendateien und Tablespaces
Beschreibung der Abbildung cncpt037.gif
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten von Datendateien
Permanente und temporäre Datendateien
Ein permanenter Tablespace enthält persistente Schemaobjekte. Objekte in Permanent Tablespaces werden in Datendateien gespeichert.
Ein temporärer Tablespace enthält Schemaobjekte nur für die Dauer einer Session. Lokal verwaltete Temporary Tablespaces verfügen über temporäre Dateien (Temp-Dateien), bei denen es sich um spezielle Dateien handelt, die zum Speichern von Daten in Hash-, Sortier- und anderen Vorgängen entwickelt wurden. Temp-Dateien speichern auch Ergebnissatzdaten, wenn nicht genügend Speicherplatz im Speicher vorhanden ist.
Temp-Dateien ähneln permanenten Datendateien, mit folgenden Ausnahmen:
-
Permanente Datenbankobjekte wie Tabellen werden niemals in temporären Dateien gespeichert.
-
Temp-Dateien werden immer auf den Modus
NOLOGGINGgesetzt. Das bedeutet, dass für sie nie Redo generiert wurde. Media Recovery erkennt temporäre Dateien nicht. -
Eine temporäre Datei kann nicht schreibgeschützt sein.
-
Sie können keine temporäre Datei mit der
ALTERDATABASE-Anweisung erstellen. -
Wenn Sie temporäre Dateien erstellen oder deren Größe ändern, wird ihnen nicht immer garantiert, dass Speicherplatz für die angegebene Dateigröße zugewiesen wird. Auf Dateisystemen wie Linux und UNIX werden temporäre Dateien als sparse-Dateien erstellt. In diesem Fall werden Festplattenblöcke nicht beim Erstellen oder Ändern der Dateigröße zugewiesen, sondern beim ersten Zugriff auf die Blöcke.
Hinweis: Sparse-Dateien ermöglichen das schnelle Erstellen und Ändern der Größe von temporären Dateien. Der Speicherplatz kann jedoch später erschöpft sein, wenn auf die temporären Dateien zugegriffen wird.
-
Informationen zu temporären Dateien werden in der Data Dictionary View
DBA_TEMP_FILESund der dynamischen Performance ViewV$TEMPFILEangezeigt, nicht jedoch in der ViewDBA_DATA_FILESoderV$DATAFILE.
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten von temporären Dateien
Online- und Offlinedatendateien
Jede Datendatei ist entweder online (verfügbar) oder offline (nicht verfügbar).
Sie können die Verfügbarkeit einzelner Datendateien oder temporärer Dateien ändern, indem Sie sie offline setzen oder online stellen. Die Datenbank kann erst auf Offlinedatendateien zugreifen, wenn sie online gesetzt wurden.
Sie können Datendateien aus vielen Gründen offline setzen, einschließlich Offlinebackups oder Blockbeschädigungen. Die Datenbank setzt eine Datendatei automatisch offline, wenn sie nicht in die Datenbank geschrieben werden kann.
Wie eine Datendatei ist auch ein Tablespace offline oder online. Wenn Sie eine Datendatei in einem Online Tablespace offline setzen, bleibt der Tablespace selbst online. Sie können alle Datendateien eines Tablespace vorübergehend nicht verfügbar machen, indem Sie den Tablespace selbst offline setzen.
Ab Oracle Database 12c können Sie mit der Anweisung ALTER DATABASE MOVE DATAFILE eine Onlinedatendatei von einer physischen Datei in eine andere verschieben, während die Datenbank geöffnet ist, und auf die Datei zugreifen. Mit dieser Technik können Sie die folgenden Ziele erreichen:
-
Tablespace von einer Speicherart in eine andere verschieben
-
Verschieben von Datendateien, auf die selten zugegriffen wird, auf kostengünstigeren Speicher
-
Schreibgeschützte Tablespaces erstellen und ihre Datendateien in einen Write-Once-Speicher verschieben, z. B. ein Write Once Read Many-(WORM-)Laufwerk
-
Datenbank in Oracle ASM verschieben
Siehe:
-
Oracle AI Database Administrator's Guide zum Ändern der Verfügbarkeit von Datendateien
-
Oracle AI Database Administrator's Guide zum Verschieben von Online-Datendateien
-
Oracle AI Database SQL Language Reference, um mehr über
ALTER DATABASE . . . MOVE DATAFILEzu erfahren
Datendateistruktur
Oracle AI Database erstellt eine Datendatei für einen Tablespace, indem der angegebene Speicherplatz plus der Overhead für den Datendatei-Header zugewiesen wird. Das Betriebssystem, unter dem Oracle AI Database ausgeführt wird, ist dafür verantwortlich, alte Informationen und Autorisierungen aus einer Datei zu löschen, bevor sie der Datenbank zugewiesen werden.
Der Datendatei-Header enthält Metadaten zur Datendatei, wie Größe und Checkpoint-SCN. Jeder Header enthält eine absolute Dateinummer, mit der die Datendatei in der Datenbank eindeutig identifiziert wird, und eine relative Dateinummer, mit der eine Datendatei in einem Tablespace eindeutig identifiziert wird.
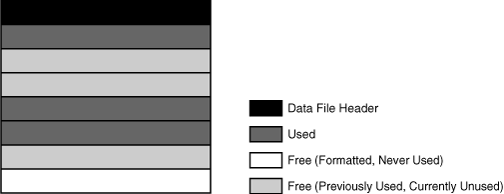
Wenn Oracle AI Database zum ersten Mal eine Datendatei erstellt, wird der zugewiesene Festplattenspeicher formatiert, enthält jedoch keine Benutzerdaten. Die Datenbank reserviert jedoch den Speicherplatz, um die Daten für zukünftige Segmente des zugehörigen Tablespace zu speichern. Wenn die Daten in einem Tablespace wachsen, verwendet Oracle AI Database den freien Speicherplatz in den Datendateien, um Extents für das Segment zuzuweisen.
Die folgende Abbildung veranschaulicht die verschiedenen Arten von Speicherplatz in einer Datendatei. Extents werden entweder verwendet, was bedeutet, dass sie Segmentdaten enthalten, oder frei, was bedeutet, dass sie wiederverwendet werden können. Mit der Zeit können durch das Aktualisieren und Löschen von Objekten in einem Tablespace leere Speicherbereiche entstehen, die einzeln nicht groß genug sind, damit sie für neue Daten wiederzuverwenden sind. Dieser Typ von leerem Speicherplatz wird als fragmentierter freier Speicherplatz bezeichnet.
Abbildung 6: Speicherplatz in einer Datendatei
Beschreibung der Abbildung cncpt273.gif
Siehe auch: Oracle AI Database Administrator's Guide enthält Informationen zum Anzeigen von Datendateiinformationen.
Überblick über Kontrolldateien
Die Kontrolldatei der Datenbank ist eine kleine Binärdatei, die nur einer CDB zugeordnet ist.
Jede CDB verfügt über eine eindeutige Kontrolldatei, obwohl mehrere identische Kopien zulässig sind. PDBs verfügen nicht über separate Kontrolldateien.
-
Verwendung von Kontrolldateien Oracle AI Database verwendet die Kontrolldatei, um Datenbankdateien zu suchen und den Status der Datenbank allgemein zu verwalten.
-
Mehrere Kontrolldateien Mit Oracle AI Database können mehrere identische Kontrolldateien gleichzeitig geöffnet und in dieselbe Datenbank geschrieben werden. Durch das Multiplexen einer Kontrolldatei auf verschiedenen Platten kann die Datenbank Redundanz erreichen und so einen Single Point of Failure vermeiden.
-
Struktur der Kontrolldatei Informationen zur Datenbank werden in verschiedenen Abschnitten der Kontrolldatei gespeichert. Jeder Abschnitt enthält eine Gruppe von Datensätzen zu einem Aspekt der Datenbank.
Verwendung von Kontrolldateien
Oracle AI Database verwendet die Kontrolldatei, um Datenbankdateien zu suchen und den Status der Datenbank allgemein zu verwalten.
Eine Kontrolldatei enthält Informationen wie die folgenden:
-
Datenbankname und eindeutige Datenbank-ID (DBID)
-
Der Zeitstempel der Datenbankerstellung
-
Informationen zu Datendateien, Online Redo Log-Dateien und archivierten Redo Log-Dateien
-
Tablespace-Informationen
-
RMAN-Sicherungen
Die Kontrolldatei dient folgenden Zwecken:
-
Es enthält Informationen zu Datendateien, Online Redo Log-Dateien usw., die zum Öffnen der Datenbank erforderlich sind.
Die Kontrolldatei verfolgt strukturelle Änderungen an der Datenbank. Beispiel: Wenn ein Administrator eine Datendatei oder Online-Redo-Logdatei hinzufügt, umbenennt oder löscht, aktualisiert die Datenbank die Kontrolldatei entsprechend dieser Änderung.
-
Sie enthält Metadaten, auf die zugegriffen werden muss, wenn die Datenbank nicht geöffnet ist.
Beispiel: Die Kontrolldatei enthält Informationen, die zum Recovery der Datenbank erforderlich sind, einschließlich Checkpoints. Ein Checkpoint gibt die SCN im Redo-Stream an, bei der das Instanz-Recovery beginnen muss. Jede festgeschriebene Änderung vor einer Checkpoint-SCN wird garantiert auf dem Datenträger in den Datendateien gespeichert. Mindestens alle drei Sekunden zeichnet der Checkpoint-Prozess Informationen in der Kontrolldatei über die Checkpoint-Position im Online Redo Log auf.
Oracle AI Database liest und schreibt während der Datenbanknutzung kontinuierlich in die Kontrolldatei und muss zum Schreiben verfügbar sein, wenn die Datenbank geöffnet ist. Beispiel: Beim Recovery einer Datenbank werden die Namen aller in der Datenbank enthaltenen Datendateien aus der Kontrolldatei gelesen. Andere Vorgänge, wie das Hinzufügen einer Datendatei, aktualisieren die in der Kontrolldatei gespeicherten Informationen.
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten der Kontrolldatei
Mehrere Kontrolldateien
Mit Oracle AI Database können mehrere identische Kontrolldateien gleichzeitig geöffnet und in dieselbe Datenbank geschrieben werden. Durch das Multiplexen einer Kontrolldatei auf verschiedenen Platten kann die Datenbank Redundanz erreichen und so einen Single Point of Failure vermeiden. Hinweis: Oracle empfiehlt, mehrere Kopien von Kontrolldateien auf einer anderen Festplatte zu verwalten.
Wenn eine Kontrolldatei nicht mehr verwendet werden kann, schlägt die Datenbankinstanz fehl, wenn sie versucht, auf die beschädigte Kontrolldatei zuzugreifen. Wenn andere Kopien der aktuellen Kontrolldatei vorhanden sind, können Sie die Datenbank erneut mounten und ohne Medien-Recovery öffnen. Wenn jedoch alle Kontrolldateien einer Datenbank verloren gehen, verläuft die Datenbankinstanz nicht erfolgreich, und ein Media Recovery ist erforderlich. Das Media Recovery ist nicht einfach, wenn ein älteres Backup einer Kontrolldatei verwendet werden muss, da keine aktuelle Kopie verfügbar ist.
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten mehrerer Kontrolldateien
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch zum Sichern und Wiederherstellen von Kontrolldateien
Kontrolldateistruktur
Informationen zur Datenbank werden in verschiedenen Abschnitten der Kontrolldatei gespeichert. Jeder Abschnitt enthält eine Gruppe von Datensätzen zu einem Aspekt der Datenbank.
Beispiel: Ein Abschnitt in der Kontrolldatei verfolgt Datendateien und enthält eine Gruppe von Datensätzen, eine für jede Datendatei. Jeder Abschnitt ist in mehreren logischen Kontrolldateiblöcken gespeichert. Datensätze können Blöcke innerhalb eines Abschnitts umfassen.
Die Kontrolldatei enthält die folgenden Datensatztypen:
-
Datensätze für zirkuläre Wiederverwendung
Ein Datensatz für die zirkuläre Wiederverwendung enthält nicht kritische Informationen, die bei Bedarf überschrieben werden können. Wenn alle verfügbaren Datensatz-Slots voll sind, erweitert die Datenbank entweder die Kontrolldatei, um Platz für einen neuen Datensatz zu schaffen, oder überschreibt den ältesten Datensatz. Beispiele sind Datensätze zu archivierten Redo Log-Dateien und RMAN-Backups.
-
Nicht zirkuläre Wiederverwendungsdatensätze
Ein nicht zirkulärer Wiederverwendungsdatensatz enthält kritische Informationen, die sich nicht häufig ändern und nicht überschrieben werden können. Beispiele für Informationen sind Tablespaces, Datendateien, Online Redo Log-Dateien und Redo Threads. Oracle AI Database verwendet diese Datensätze nur dann wieder, wenn das entsprechende Objekt aus dem Tablespace gelöscht wird.
Sie können die dynamischen Performance-Views (auch als V$-Views bezeichnet) abfragen, um die in der Kontrolldatei gespeicherten Informationen anzuzeigen. Beispiel: Sie können V$DATABASE abfragen, um den Datenbanknamen und die DBID abzurufen. Die Informationen in der Kontrolldatei können jedoch nur von der Datenbank geändert werden.
Das Lesen und Schreiben der Kontrolldateiblöcke unterscheidet sich vom Lesen und Schreiben von Datenblöcken. Bei der Kontrolldatei liest und schreibt Oracle AI Database direkt von der Platte in die Programm-Global Area (PGA). Jeder Prozess weist eine bestimmte Menge seines PGA-Speichers für Kontrolldateiblöcke zu.
Siehe:
-
Oracle AI Database-Referenz zur
V$CONTROLFILE_RECORD_SECTION-Ansicht -
Oracle AI Database Reference zum
CONTROL_FILE_RECORD_KEEP_TIME-Initialisierungsparameter
Überblick über das Online Redo Log
Die wichtigste Struktur für das Recovery ist das Online-Redo-Log, das aus zwei oder mehr vorab zugewiesenen Dateien besteht, in denen Änderungen an der Datenbank gespeichert werden, sobald sie auftreten. Die Online Redo Log-Datensätze ändern sich in den Datendateien.
-
Online-Redo-Log verwenden: Die Datenbank verwaltet Online-Redo-Logdateien zum Schutz vor Datenverlust. Insbesondere ermöglichen die Online Redo Log-Dateien nach einem Instanzfehler Oracle AI Database, festgeschriebene Daten wiederherzustellen, die noch nicht in die Datendateien geschrieben wurden.
-
Schreiben von Oracle AI Database in das Online-Redo-Log Das Online-Redo-Log für eine Datenbankinstanz wird als Redo-Thread bezeichnet.
-
Struktur des Online-Redo-Logs Online-Redo-Logdateien enthalten Redo-Datensätze.
Online-Redo-Log verwenden
Die Datenbank verwaltet Online Redo Log-Dateien zum Schutz vor Datenverlust. Insbesondere ermöglichen die Online Redo Log-Dateien nach einem Instanzfehler Oracle AI Database, festgeschriebene Daten wiederherzustellen, die noch nicht in die Datendateien geschrieben wurden.
Serverprozesse schreiben jede Transaktion synchron in den Redo-Logpuffer, den der LGWR-Prozess dann in das Online-Redo-Log schreibt. Der Inhalt des Online-Redo-Logs umfasst nicht festgeschriebene Transaktionen sowie Anweisungen zur Schema- und Objektverwaltung.
Wenn die Datenbank Änderungen an den Undo-Segmenten vornimmt, schreibt die Datenbank diese Änderungen auch in die Online Redo Logs. Folglich enthält das Online Redo Log immer die Undo-Daten für permanente Objekte. Sie können die Datenbank so konfigurieren, dass alle Undo-Daten für temporäre Objekte in einem temporären Undo-Segment gespeichert werden. Dadurch wird Speicherplatz gespart und die Performance verbessert, oder die Datenbank kann sowohl permanente als auch temporäre Undo-Daten im Online-Redo-Log speichern.
Oracle AI Database verwendet das Online-Redo-Log nur für das Recovery. Administratoren können Online Redo Log-Dateien jedoch über eine SQL-Schnittstelle im Oracle LogMiner-Utility abfragen. Redo Log-Dateien sind eine nützliche Quelle historischer Informationen über die Datenbankaktivität.
Siehe:
-
"Prozessarchitektur", um mehr über Oracle-Prozesse zu erfahren
-
Oracle AI Database Administrator's Guide, um mehr über temporäre Undo-Segmente zu erfahren
-
Oracle AI Database Reference zum
TEMP_UNDO_ENABLED-Initialisierungsparameter
Schreiben von Oracle AI Database in das Online-Redo-Log
Das Online-Redo-Log für eine Datenbankinstanz wird als Redo-Thread bezeichnet.
In Einzelinstanzkonfigurationen greift nur eine Instanz auf eine Datenbank zu, sodass nur ein Redo Thread vorhanden ist. In einer Oracle Real Application Clusters-(Oracle RAC-)Konfiguration greifen jedoch mehrere Instanzen gleichzeitig auf eine Datenbank zu, wobei jede Instanz einen eigenen Redo-Thread aufweist. Ein separater Redo Thread für jede Instance vermeidet Zugriffskonflikte bei einer einzelnen Gruppe von Online Redo Log-Dateien.
Ein Online Redo Log besteht aus zwei oder mehr Online Redo Log-Dateien. Oracle AI Database erfordert mindestens zwei Dateien, um sicherzustellen, dass eine Datei immer zum Schreiben verfügbar ist, falls die andere Datei gerade gelöscht oder archiviert wird.
-
Online-Redo-Log-Switches Oracle AI Database verwendet jeweils nur eine Online-Redo-Logdatei, um Datensätze zu speichern, die aus dem Redo-Logpuffer geschrieben wurden.
-
Mehrere Kopien von Online-Redo-Logdateien Oracle AI Database kann automatisch zwei oder mehr identische Kopien des Online-Redo-Logs an separaten Speicherorten verwalten.
-
Archivierte Redo-Logdateien Eine archivierte Redo-Logdatei ist eine Kopie eines gefüllten Members einer Online-Redo-Loggruppe.
Siehe auch: Oracle Real Application Clusters Administration and Deployment Guide enthält Informationen zu Online-Redo-Loggruppen in Oracle RAC
Online Redo Log-Switches
Oracle AI Database verwendet jeweils nur eine Online-Redo-Logdatei, um Datensätze zu speichern, die aus dem Redo-Logpuffer geschrieben wurden.
Die Online Redo Log-Datei, in die der Log Writer-Prozess (LGWR) aktiv schreibt, wird als aktuelle Online Redo Log-Datei bezeichnet.
Ein Log-Switch wird ausgeführt, wenn die Datenbank das Schreiben in eine Online-Redo-Logdatei stoppt und mit dem Schreiben in eine andere beginnt. Normalerweise erfolgt ein Switch, wenn die aktuelle Online Redo Log-Datei voll ist und das Schreiben fortgesetzt werden muss. Sie können jedoch Log Switches so konfigurieren, dass sie in regelmäßigen Abständen stattfinden, unabhängig davon, ob die aktuelle Online Redo Log-Datei gefüllt ist, und Log Switches manuell erzwingen.
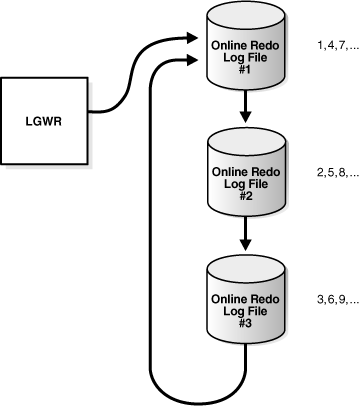
Log Writer schreibt zyklisch in Online Redo Log-Dateien. Wenn Log Writer die letzte verfügbare Online Redo Log-Datei ausfüllt, schreibt der Prozess in die erste Log-Datei und startet den Zyklus neu. In Abbildung 14-7 wird das zirkuläre Schreiben des Redo-Logs dargestellt.
Abbildung 7: Wiederverwendung von Online Redo Log-Dateien
Beschreibung der Abbildung admin054.gif
Die Zahlen in Abbildung 14-7 zeigen die Reihenfolge, in der LGWR in jede Online Redo Log-Datei schreibt. Die Datenbank weist jeder Datei eine neue Logsequenznummer zu, wenn Log Switches und Log Writer mit dem Schreiben in die Datei beginnen. Wenn die Datenbank eine Online Redo Log-Datei wiederverwendet, erhält diese Datei die nächste verfügbare Log-Folgenummer.
Gefüllte Online Redo Log-Dateien können je nach Archivierungsmodus wiederverwendet werden:
-
Wenn die Archivierung deaktiviert ist, was bedeutet, dass sich die Datenbank im
NOARCHIVELOG-Modus befindet, ist eine ausgefüllte Online-Redo-Logdatei verfügbar, nachdem die darin aufgezeichneten Änderungen von Datenbank-Writer (DBW) auf Datenträger geprüft (geschrieben) wurden. -
Wenn die Archivierung aktiviert ist, was bedeutet, dass sich die Datenbank im ARCHIVELOG-Modus befindet, ist eine ausgefüllte Online-Redo-Logdatei für den Log Writer verfügbar, nachdem die Änderungen in die Datendateien geschrieben wurden und die Datei archiviert wurde.
In einigen Fällen kann Log Writer daran gehindert werden, eine vorhandene Online Redo Log-Datei wiederzuverwenden. Für das Instanz-Recovery ist eine aktive Online-Redo-Logdatei erforderlich, bei der keine inaktive Online-Redo-Logdatei für das Instanz-Recovery erforderlich ist. Außerdem wird möglicherweise gerade eine Online Redo Log-Datei gelöscht.
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten des Online-Redo-Logs
Mehrere Kopien von Online Redo Log-Dateien
Oracle AI Database kann automatisch zwei oder mehr identische Kopien des Online-Redo-Logs an separaten Speicherorten verwalten.
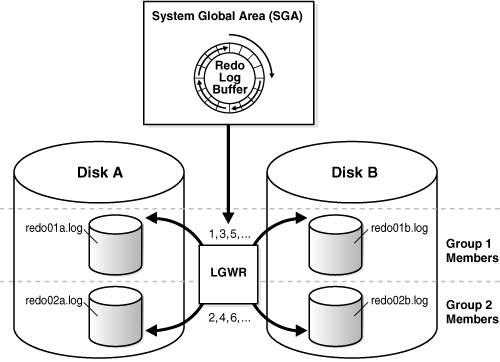
Eine Online-Redo-Loggruppe besteht aus einer Online-Redo-Logdatei und ihren redundanten Kopien. Jede identische Kopie ist Mitglied der Online Redo Log-Gruppe. Die einzelnen Gruppen sind durch Zahlen definiert, zum Beispiel Gruppe 1, Gruppe 2 usw.
Die Verwaltung mehrerer Member einer Online Redo Log-Gruppe schützt vor dem Verlust des Redo Log. Idealerweise sollten sich die Speicherorte der Member auf separaten Platten befinden, sodass der Ausfall einer Platte nicht zum Verlust des gesamten Online Redo Log führt.
In Abbildung 14-8 sind A_LOG1 und B_LOG1 identische Mitglieder von Gruppe 1, während A_LOG2 und B_LOG2 identische Mitglieder von Gruppe 2 sind. Jedes Mitglied in einer Gruppe muss dieselbe Größe haben. LGWR schreibt gleichzeitig in Gruppe 1 (die Mitglieder A_LOG1 und B_LOG1), schreibt dann gleichzeitig in Gruppe 2 (die Mitglieder A_LOG2 und B_LOG2), schreibt dann in Gruppe 1 usw. LGWR schreibt niemals gleichzeitig an Mitglieder verschiedener Gruppen.
Abbildung 8: Mehrere Kopien von Online Redo Log-Dateien
Beschreibung der Abbildung cncpt270.gif
Hinweis: Oracle empfiehlt, dass Sie das Online-Redo-Log spiegeln. Der Verlust von Logdateien kann katastrophal sein, wenn eine Wiederherstellung erforderlich ist. Beim Multiplexen des Online-Redo-Logs muss die Datenbank die I/O-Anzahl erhöhen, die sie durchführt. Je nach System kann sich diese zusätzliche E/A auf die Gesamtperformance der Datenbank auswirken.
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten mehrerer Kopien der Online-Redo-Logdateien
-
Oracle Data Guard - Konzepte und Administration, um mehr über die automatisierte Übertragung von Redo-Daten zwischen Mitgliedern einer Data Guard-Konfiguration zu erfahren
Archivierte Redo-Logdateien
Eine archivierte Redo-Logdatei ist eine Kopie eines gefüllten Mitglieds einer Online-Redo-Loggruppe.
Eine archivierte Redo Log-Datei wird nicht als Teil der Datenbank betrachtet. Es handelt sich vielmehr um eine Offlinekopie einer von der Datenbank erstellten Online Redo Log-Datei, die in ein benutzerdefiniertes Verzeichnis geschrieben wird.
Archivierte Redo Log-Dateien sind ein wesentlicher Bestandteil einer Backup- und Recovery-Strategie. Sie können archivierte Redo-Logdateien für folgende Zwecke verwenden:
-
Datenbankbackup wiederherstellen
-
Standbydatenbank aktualisieren
-
Informationen zur Historie einer Datenbank mit dem Oracle LogMiner-Utility abrufen
Der Vorgang zum Generieren einer archivierten Redo-Logdatei wird als Archivierung bezeichnet. Diese Operation ist entweder automatisch oder manuell. Dies ist nur möglich, wenn sich die Datenbank im ARCHIVELOG-Modus befindet.
Eine archivierte Redo Log-Datei enthält die Redo-Einträge und die Log-Folgenummer des identischen Members der Online Redo Log-Gruppe. Unter "Mehrere Kopien von Online-Redo-Logdateien" sind die Dateien A_LOG1 und B_LOG1 identische Mitglieder von Gruppe 1. Wenn sich die Datenbank im ARCHIVELOG-Modus befindet und die automatische Archivierung aktiviert ist, archiviert der Archiver-Prozess (ARCn) eine dieser Dateien. Wenn A_LOG1 beschädigt ist, kann der Prozess B_LOG1 archivieren. Das archivierte Redo Log enthält eine Kopie jeder Redo Log-Gruppe, die seit der Aktivierung der Archivierung vorhanden war.
Siehe:
-
Oracle AI Database Utilities, um mehr über Oracle LogMiner zu erfahren
-
Oracle AI Database Administrator's Guide zum Verwalten des archivierten Redo-Logs
-
Oracle Data Guard - Konzepte und Administration zum Konfigurieren der Standby-Redo-Logarchivierung
Struktur des Online-Redo-logs
Online-Redo-Logdateien enthalten Redo-Datensätze.
Ein Redo-Datensatz besteht aus einer Gruppe von Änderungsvektoren, von denen jede eine Änderung an einem Datenblock beschreibt. Beispiel: Bei einer Gehaltsaktualisierung in der Tabelle employees wird ein Redo-Datensatz generiert, der Änderungen am Datensegment-Block für die Tabelle, den Undo-Segmentdatenblock und die Transaktionstabelle der Undo-Segmente beschreibt.
Die Redo-Datensätze enthalten alle relevanten Metadaten für die Änderung, einschließlich der folgenden:
-
SCN und Zeitstempel der Änderung
-
Transaktions-ID der Transaktion, von der die Änderung generiert wurde
-
SCN und Zeitstempel beim Festschreiben der Transaktion (falls festgeschrieben)
-
Vorgangstyp, mit dem die Änderung vorgenommen wurde
-
Name und Typ des geänderten Datensegments
Siehe auch: "Überblick über Datenblöcke"