Oracle AI Database-Instanz
In diesem Kapitel werden die Art einer Oracle-Datenbankinstanz, die Parameter- und Diagnosedateien für eine Instanz sowie die Vorgänge beim Erstellen und Schließen einer Datenbank erläutert.
Hinweis: Für die Zwecke dieses Kapitels bezieht sich der Begriff "Datenbank" auf eine mehrmandantenfähige Containerdatenbank (CDB), sofern nicht anders angegeben.
-
Einführung in die Oracle AI Database-Instanz Eine Datenbankinstanz ist eine Gruppe von Speicherstrukturen, die Datenbankdateien verwalten.
-
Überblick über das Hoch- und Herunterfahren von Datenbankinstanzen Eine Datenbankinstanz bietet Benutzerzugriff auf eine Datenbank. Die Instance und die Datenbank können sich in verschiedenen Status befinden.
-
Checkpoints - Überblick Ein Checkpoint ist ein entscheidender Mechanismus für konsistente Datenbank-Shutdowns, Instanz-Recovery und Oracle AI Database-Vorgänge im Allgemeinen.
-
Instanz-Recovery ist der Prozess, bei dem Datensätze im Online-Redo-Log auf Datendateien angewendet werden, um Änderungen nach dem letzten Checkpoint wiederherzustellen.
-
Überblick über Parameterdateien Um eine Datenbankinstanz zu starten, muss Oracle AI Database entweder eine empfohlene Serverparameterdatei oder eine Textinitialisierungsparameterdatei lesen, die eine Legacy-Implementierung ist. Diese Dateien enthalten eine Liste der Konfigurationsparameter.
-
Diagnosedateien - Überblick Oracle AI Database umfasst eine Faultdiagnosability-Infrastruktur zum Verhindern, Erkennen, Diagnostizieren und Beheben von Datenbankproblemen. Zu den Problemen gehören kritische Fehler wie Codebugs, Metadatenbeschädigung und Beschädigung von Kundendaten.
Einführung in die Oracle AI Database-Instanz
Eine Datenbankinstanz ist eine Gruppe von Speicherstrukturen, die Datenbankdateien verwalten.
Auf der physischen Ebene ist eine CDB eine Gruppe von Dateien auf dem Datenträger, die von der CREATE DATABASE-Anweisung erstellt werden. Eine CDB enthält mindestens eine vom Benutzer erstellte PDB. Eine PDB enthält eine eigene Gruppe von Datendateien innerhalb der gesamten Gruppe von Datendateien, die zur CDB gehören. Die Datenbankinstanz verwaltet die mit der CDB und ihren PDBs verknüpften Daten und bedient ihre Benutzer.
Jede ausgeführte CDB ist mit mindestens einer Oracle-Datenbankinstanz verknüpft. Da eine Instanz im Speicher vorhanden ist und eine Datenbank (im engeren Sinne des Begriffs) eine Gruppe von Dateien auf Platte ist, kann eine Instanz ohne Datenbank und eine Datenbank ohne Instanz existieren.
-
Datenbankinstanzstruktur Wenn eine Instanz gestartet wird, weist Oracle AI Database einen Speicherbereich zu, der als System Global Area (SGA) bezeichnet wird, und startet mindestens einen Hintergrundprozess.
-
Datenbankinstanzkonfigurationen Oracle AI Database wird entweder in einer Einzelinstanzkonfiguration oder in einer Oracle Real Application Clusters-(Oracle RAC-)Konfiguration ausgeführt. Diese Konfigurationen schließen sich gegenseitig aus.
-
Lese-/Schreib- und schreibgeschützte Instanzen Jede Datenbankinstanz ist schreibgeschützt oder schreibgeschützt.
-
Dauer einer Datenbankinstanz Eine Datenbankinstanz beginnt, wenn sie mit dem Befehl
STARTUPerstellt wird, und endet, wenn sie beendet wird. -
Identifizierung einer Datenbankinstanz Mehrere Datenbankinstanzen können sich auf einem einzelnen Host befinden. Aus diesem Grund müssen Sie angeben, auf welche Instanz Sie zugreifen möchten.
Datenbankinstanzstruktur
Wenn eine Instanz gestartet wird, weist Oracle AI Database einen Speicherbereich zu, der als System Global Area (SGA) bezeichnet wird, und startet mindestens einen Hintergrundprozess.
Die SGA dient verschiedenen Zwecken, darunter:
-
Verwaltung interner Datenstrukturen, auf die viele Prozesse und Threads gleichzeitig zugreifen
-
Von Datenträger gelesene Datenblöcke im Cache speichern
-
Redo-Daten werden gepuffert, bevor sie in die Online Redo Log-Dateien geschrieben werden
-
SQL-Ausführungspläne speichern
Oracle-Prozesse, die auf einem einzelnen Rechner ausgeführt werden, verwenden die SGA gemeinsam. Die Art und Weise, wie Oracle-Prozesse mit der SGA assoziiert werden, variiert je nach Betriebssystem.
Eine Datenbankinstanz umfasst auch Hintergrundprozesse und Serverprozesse. Jeder Prozess verfügt über einen eigenen dedizierten Speicher, der als Teil der Instanz betrachtet wird. Die Instanz funktioniert weiterhin, wenn Serverprozesse beendet werden.
Die folgende Grafik zeigt die Hauptkomponenten einer Oracle-Datenbankinstanz.
Abbildung 1: Datenbankinstanz
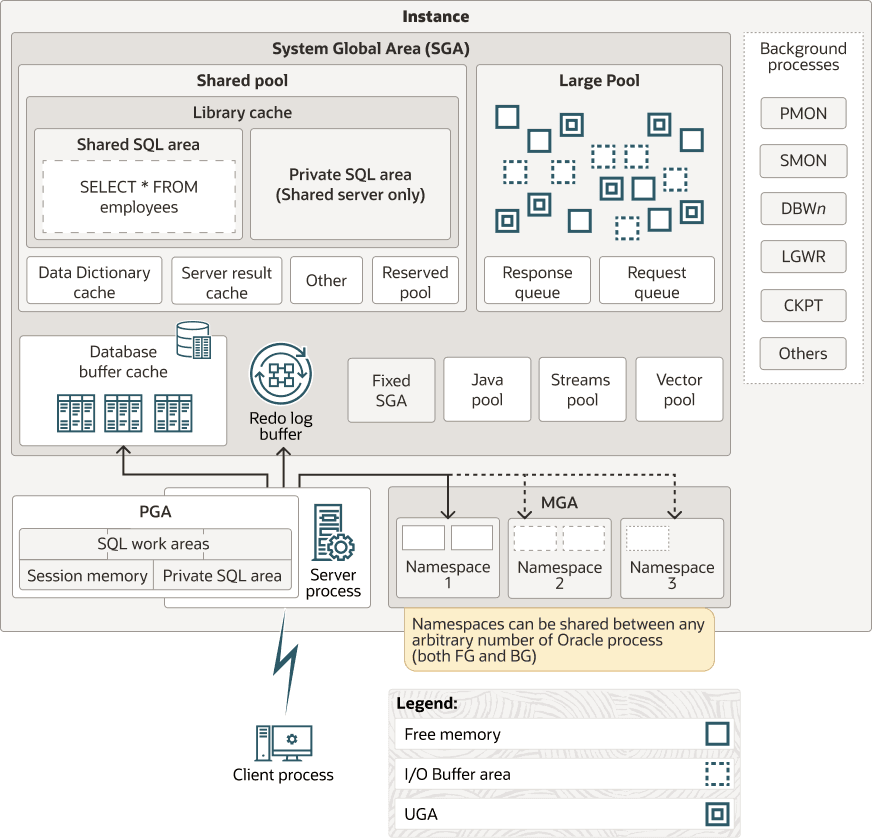
Beschreibung der Abbildung cncpt325.png
Datenbankinstanzkonfigurationen
Oracle AI Database wird entweder in einer Einzelinstanzkonfiguration oder in einer Oracle Real Application Clusters-(Oracle RAC-)Konfiguration ausgeführt. Diese Konfigurationen schließen sich gegenseitig aus.
In einer Einzelinstanzkonfiguration besteht eine Eins-zu-Eins-Beziehung zwischen der Datenbank und einer Datenbankinstanz. In Oracle RAC besteht eine Eins-zu-Viele-Beziehung zwischen der Datenbank und den Datenbankinstanzen.
Die folgende Abbildung zeigt mögliche Konfigurationen von Datenbankinstanzen.
Abbildung 2: Datenbankinstanzkonfigurationen
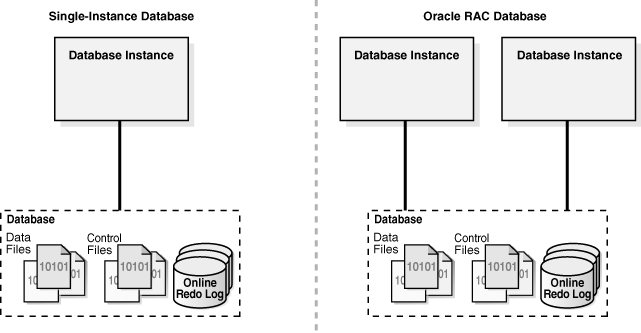
Beschreibung der Abbildung cncpt296.gif
Ob in einer Einzelinstanz- oder Oracle RAC-Konfiguration, eine Datenbankinstanz ist jeweils nur einer Datenbank zugeordnet. Sie können eine Datenbankinstanz starten und eine Datenbank mounten (die Instanz verknüpfen), aber nicht zwei Datenbanken gleichzeitig mit derselben Instanz mounten. Hinweis: In diesem Kapitel wird eine Einzelinstanz-Datenbankkonfiguration beschrieben, sofern nicht anders angegeben.
Mehrere Instanzen können gleichzeitig auf demselben Computer ausgeführt werden, wobei jede auf ihre eigene Datenbank zugreift. Beispiel: Ein Computer kann zwei eindeutige Datenbanken hosten: prod1 und prod2. Eine Datenbankinstanz verwaltet prod1, während eine separate Instanz prod2 verwaltet.
Siehe auch: Oracle Real Application Clusters Administration and Deployment Guide für spezifische Informationen zu Oracle RAC
Lese-/Schreib- und schreibgeschützte Instanzen
Jede Datenbankinstanz ist entweder schreibgeschützt oder schreibgeschützt.
Eine Datenbankinstanz mit Lese-/Schreibzugriff (Standard) kann DML verarbeiten und direkte Verbindungen von Clientanwendungen unterstützen. Im Gegensatz dazu kann eine schreibgeschützte Datenbankinstanz Abfragen verarbeiten, unterstützt jedoch keine Änderungs-DML (UPDATE, DELETE, INSERT und MERGE) oder direkte Clientverbindungen.
Hinweis: Sofern in diesem Handbuch nicht anders angegeben, sind alle Referenzen auf Datenbankinstanzen Lese-/Schreibinstanzen.
In früheren Releases wurden alle Datenbankinstanzen gelesen/geschrieben, es sei denn, sie haben auf eine Standbydatenbank zugegriffen. Ab Oracle Database 12c Release 2 (12.2) können schreibgeschützte und Lese-/Schreibinstanzen in einer einzelnen Datenbank gleichzeitig vorhanden sein. Diese Konfiguration ist nützlich für parallele SQL-Anweisungen, die Daten abfragen und ändern, da sowohl Lese-/Schreib- als auch schreibgeschützte Instanzen abfragen können, während die Lese-/Schreibinstanzen geändert werden.
Im Gegensatz zu Lese-/Schreibinstanzen weisen schreibgeschützte Instanzen die folgenden Eigenschaften auf:
-
Es kann nur eine Datenbank geöffnet werden, die bereits von einer Lese-/Schreibinstanz geöffnet wurde
-
Viele Hintergrundprozesse deaktivieren, einschließlich Checkpoint- und Archivierungsprozesse, die nicht erforderlich sind
-
Kann einen deaktivierten Redo-Thread oder einen Thread ohne Online-Redo-Log mounten
Um eine Instanz als schreibgeschützt festzulegen, setzen Sie den Initialisierungsparameter INSTANCE_MODE auf READ_ONLY. Der Standardwert für den Parameter ist READ_WRITE.
Siehe:
-
"Überblick über Hintergrundprozesse", um mehr über die Checkpoint- und Archivierungshintergrundprozesse zu erfahren
-
Oracle AI Database Reference, um mehr über den Initialisierungsparameter
INSTANCE_MODEzu erfahren
Dauer einer Datenbankinstanz
Eine Datenbankinstanz beginnt, wenn sie mit dem Befehl STARTUP erstellt wird, und endet, wenn sie beendet wird.
In diesem Zeitraum kann sich eine Datenbank-Instance nur mit einer einzigen Datenbank verknüpfen. Darüber hinaus kann die Instance eine Datenbank nur einmal mounten, nur einmal schließen und nur einmal öffnen. Nachdem eine Datenbank geschlossen oder heruntergefahren wurde, müssen Sie eine andere Instanz starten, um diese Datenbank zu mounten und zu öffnen.
Die folgende Tabelle veranschaulicht eine Datenbankinstanz, die versucht, eine zuvor geschlossene Datenbank erneut zu öffnen.
Tabelle 1: Dauer einer Instanz
| Kontoauszug | Erläuterung |
|---|---|
|
Der Befehl STARTUP erstellt eine Instanz, mit der die Datenbank gemountet und geöffnet wird. |
|
Diese Abfrage zeigt die Uhrzeit an, zu der die aktuelle Instanz gestartet wurde. |
|
Die Instanz schließt die Datenbank und fährt herunter, wodurch die Lebensdauer dieser Instanz beendet wird. |
|
Der Befehl STARTUP erstellt eine neue Instanz und mountet und öffnet die Datenbank. |
|
Diese Abfrage zeigt die Uhrzeit an, zu der die aktuelle Instanz gestartet wurde. Die unterschiedliche Startzeit zeigt, dass sich diese Instanz von der Instanz unterscheidet, mit der die Datenbank heruntergefahren wird. |
Datenbankinstanzen identifizieren
Mehrere Datenbankinstanzen können sich auf einem einzelnen Host befinden. Aus diesem Grund müssen Sie angeben, auf welche Instanz Sie zugreifen möchten. Oracle Optimal Flexible Architecture-(OFA-)Regeln sind eine Reihe von Konfigurationsrichtlinien, die erstellt wurden, um eine gut organisierte Oracle-Installation sicherzustellen. Die Beispiele in diesem Abschnitt gehen von einer OFA-Architektur aus.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Oracle Base Directory Im Oracle Base-Verzeichnis werden die Binärdateien für Oracle-Produkte gespeichert.
-
Oracle Home-Verzeichnis Das Oracle Home ist der Softwarespeicherort für eine Oracle-Datenbank.
-
Oracle-System-ID (SID) Die System-ID (SID) ist ein eindeutiger Name für eine Oracle-Datenbankinstanz auf einem bestimmten Host. Siehe auch: Oracle AI Database Installation Guide for Linux für einen Überblick über OFA
Oracle Base-Verzeichnis
Im Oracle Base-Verzeichnis werden die Binärdateien für Oracle-Produkte gespeichert.
Das Oracle Base-Verzeichnis ist das Datenbank-Home-Verzeichnis für Oracle AI Database-Installationseigentümer. Es können viele Oracle AI Database-Installationen auf einem Host und viele Eigentümer der Oracle AI Database-Softwareinstallation vorhanden sein.
Das folgende Beispiel zeigt das Oracle-Basisverzeichnis des Betriebssystembenutzeraccounts oracle:
/u01/app/oracleIm vorherigen Pfad ist /u01/ der Mount Point, und /u01/app/ ist der Unterbaum für Anwendungssoftware.
Siehe auch: Oracle AI Database Installation Guide for Linux für einen Überblick über die Oracle Base
Oracle Home-Verzeichnis
Das Oracle Home ist der Softwarespeicherort für eine Oracle-Datenbank.
Sie müssen für jede neue Installation von Oracle AI Database-Software jeweils ein neues Oracle-Home-Verzeichnis angeben. Ab Oracle Database 21c ist das Oracle Home schreibgeschützt. Im Oracle Home werden statische Dateien wie Binärdateien gespeichert.
Standardmäßig ist das Oracle Home-Verzeichnis ein untergeordnetes Verzeichnis innerhalb des Oracle Base-(ORACLE_BASE-)Verzeichnisbaums. Sie können dieses Release oder frühere Releases der Datenbanksoftware mehrmals auf demselben Host in verschiedenen Oracle Home-Verzeichnissen innerhalb einer einzigen Oracle Base installieren. Mehrere Datenbanken unterschiedlicher Versionen, deren Eigentümer verschiedene Benutzerkonten sind, können gleichzeitig vorhanden sein.
Das folgende Beispiel zeigt die vollständigen Pfadnamen von drei verschiedenen Oracle Homes, die sich alle im selben Oracle Base-Verzeichnis von /u01/app/oracle/ befinden:
/u01/app/oracle/product/19.3.0/dbhome_1
/u01/app/oracle/product/19.3.0/dbhome_2
/u01/app/oracle/product/20.1.0/dbhome_1
Der Teil des Pfadnamens nach der Oracle Base (/u01/app/oracle/) enthält die Produktreleasenummer (z.B. 19.3.0) und das relative Oracle Home-Verzeichnis (z.B. dbhome_1). Das Verzeichnis /u01/app/oracle/product/19.3.0/ enthält zwei separate Oracle Homes: dbhome_1 und dbhome_2.
Das Oracle Base Home-(ORACLE_BASE_HOME-)Verzeichnis, das sich in ORACLE_BASE/homes/home_name befindet, speichert dynamische Dateien, die für ein Oracle Home spezifisch sind. Das Oracle Base-Konfigurationsverzeichnis (ORACLE_BASE_CONFIG), das von allen Oracle Homes in einer Oracle Base gemeinsam verwendet wird, speichert instanzspezifische dynamische Dateien.
Im folgenden Beispiel ist der erste Pfad ein Oracle Home, und der zweite Pfad ist das Oracle Base Home für dieses Oracle Home:
/u01/app/oracle/product/20.1.0/dbhome_1
/u01/app/oracle/homes/dbhome_1
Siehe auch: Oracle AI Database Installation Guide for Linux für einen Überblick über das Oracle Home
Oracle-System-ID (SID)
Die System-ID (SID) ist ein eindeutiger Name für eine Oracle-Datenbankinstanz auf einem bestimmten Host.
Unter UNIX und Linux verwendet Oracle AI Database die SID- und Oracle Home-Werte, um einen Schlüssel für den gemeinsamen Speicher zu erstellen. Außerdem verwendet Oracle AI Database standardmäßig die SID, um die Initialisierungsparameterdatei zu suchen, in der relevante Dateien wie die Datenbankkontrolldateien lokalisiert werden.
Auf den meisten Plattformen legt die Umgebungsvariable ORACLE_SID die SID fest, und die Variable ORACLE_HOME legt das Oracle Home fest. Bei der Anmeldung bei einer Datenbankinstanz können Clients die SID in einer Oracle Net-Verbindung angeben oder einen Net Service-Namen verwenden. Oracle AI Database konvertiert einen Net Service-Namen in ORACLE_HOME und ORACLE_SID.
Instance-spezifische Dateien werden separat in der Oracle Base gespeichert. Dateien, deren Namen die SID enthalten, befinden sich im Unterverzeichnis dbs des Oracle Base-Konfigurationsverzeichnisses (ORACLE_BASE_CONFIG). Aufgrund dieser Trennung können Sie eine Datenbank mit Software in einem vorhandenen Oracle Home erstellen und dann eine Instanz für diese Datenbank mit Software starten, die sich in einem neuen Oracle Home befindet.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie eine Oracle SID angeben
Hochfahren und Herunterfahren von Datenbankinstanzen - Überblick
Eine Datenbankinstanz bietet Benutzerzugriff auf eine Datenbank. Die Instance und die Datenbank können sich in verschiedenen Status befinden.
-
Überblick über Instanz- und Datenbankstart In der Regel starten Sie eine Instanz manuell, mounten und öffnen die Datenbank, sodass sie für Benutzer verfügbar ist. Um diese Schritte auszuführen, können Sie den SQL*Plus-Befehl
STARTUP, Oracle Enterprise Manager (Enterprise Manager) oder das Utility SRVCTL verwenden. -
Datenbank- und Instanz-Shutdown - Überblick In einem typischen Anwendungsfall fahren Sie die Datenbank manuell herunter, sodass sie für Benutzer nicht verfügbar ist, während Sie Wartungs- oder andere administrative Aufgaben ausführen. Um diese Schritte auszuführen, können Sie den SQL*Plus-Befehl
SHUTDOWNoder Enterprise Manager verwenden.
Instanz und Datenbankstart - Überblick
In der Regel starten Sie eine Instanz manuell, mounten und öffnen die Datenbank, sodass sie für Benutzer verfügbar ist. Um diese Schritte auszuführen, können Sie den SQL*Plus-Befehl STARTUP, Oracle Enterprise Manager (Enterprise Manager) oder das Utility SRVCTL verwenden.
Um eine Datenbankinstanz mit Oracle Net zu starten, muss Folgendes zutreffen:
-
Die Datenbank wird statisch bei einem Oracle Net-Listener registriert.
-
Der Client ist mit der Berechtigung
SYSDBAbei der Datenbank angemeldet.
Der Listener erstellt einen dedizierten Server, der die Datenbankinstanz starten kann.
Die folgende Grafik zeigt, wie die Datenbank vom Status "Herunterfahren" in den Status "Offen" übergeht.
Abbildung 3: Instanz- und Datenbankstartfolge
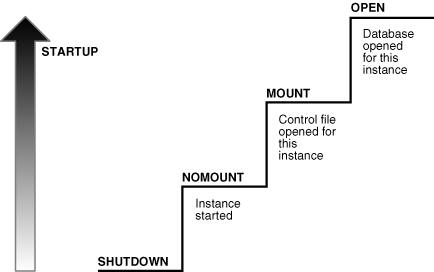
Beschreibung der Abbildung cncpt212.gif
Eine Datenbank durchläuft die folgenden Phasen, wenn sie von einem heruntergefahrenen Status in einen geöffneten Datenbankstatus übergeht.
Tabelle 2: Schritte beim Hochfahren der Instanz
| Phase | Mountstatus | Beschreibung | Weitere Infos |
|---|---|---|---|
| 1 | Instanz gestartet, ohne Datenbank zu mounten | Die Instanz wird gestartet, ist aber noch nicht mit einer Datenbank verknüpft. | "Starten einer Instanz" |
| 2 | Datenbank gemountet | Die Instanz wird gestartet und mit einer Datenbank verknüpft, indem die Kontrolldatei gelesen wird. Die Datenbank ist für Benutzer geschlossen. | "Mounten einer Datenbank" |
| 3 | Datenbank öffnen | Die Instanz wird gestartet und mit einer geöffneten Datenbank verknüpft. Die in den Datendateien enthaltenen Daten sind für autorisierte Benutzer zugänglich. | "So wird eine Datenbank geöffnet" |
-
Verbindung mit Administratorberechtigungen Das Hoch- und Herunterfahren der Datenbank sind leistungsstarke administrative Optionen, die auf Benutzer beschränkt sind, die mit Administratorberechtigungen eine Verbindung zu Oracle AI Database herstellen.
-
Starten einer Instanz Wenn Oracle AI Database eine Instanz startet, wird diese schrittweise fortgesetzt.
-
So wird eine Datenbank gemountet Die Instanz mountet eine Datenbank, um die Datenbank mit dieser Instanz zu verknüpfen.
-
So wird eine Datenbank geöffnet Wenn Sie eine gemountete Datenbank öffnen, ist sie für den normalen Datenbankvorgang verfügbar.
Siehe:
-
Oracle AI Database - Administratordokumentation zum Starten einer Instanz
-
Oracle AI Database - Administratordokumentation zur Verwendung von SRVCTL
Verbindung mit Administratorberechtigungen
Das Hoch- und Herunterfahren von Datenbanken sind leistungsstarke administrative Optionen, die auf Benutzer beschränkt sind, die eine Verbindung zu Oracle AI Database mit Administratorberechtigungen herstellen.
Normale Benutzer haben keine Kontrolle über den aktuellen Status einer Oracle-Datenbank. Je nach Betriebssystem legt eine der folgenden Bedingungen Administratorberechtigungen für einen Benutzer fest:
-
Mit den Betriebssystemprivilegien des Benutzers kann sich der Benutzer über Administratorprivilegien anmelden.
-
Dem Benutzer werden spezielle Systemberechtigungen erteilt, und die Datenbank verwendet Kennwortdateien, um Datenbankadministratoren über das Netzwerk zu authentifizieren.
Die folgenden speziellen Systemberechtigungen ermöglichen den Zugriff auf eine Datenbankinstanz, auch wenn die Datenbank nicht geöffnet ist:
-
SYSDBA -
SYSOPER -
SYSBACKUP -
SYSDG -
SYSKM
Die Kontrolle der vorherigen Privilegien liegt außerhalb der Datenbank selbst. Wenn Sie eine Verbindung zu einer Datenbank mit der Systemberechtigung SYSDBA herstellen, befinden Sie sich in dem Schema, dessen Eigentümer SYS ist. Wenn Sie sich als SYSOPER anmelden, befinden Sie sich im öffentlichen Schema. SYSOPER-Berechtigungen sind eine Teilmenge der SYSDBA-Berechtigungen.
Siehe:
-
Oracle AI Database - Sicherheitshandbuch, um mehr über vordefinierte administrative Konten zu erfahren
-
Oracle AI Database Administrator's Guide für Informationen zu Systemberechtigungen
-
Oracle AI Database Installation Guide, um mehr über Betriebssystemberechtigungsgruppen zu erfahren
So wird eine Instanz gestartet
Wenn Oracle AI Database eine Instanz startet, durchläuft sie Phasen.
Die Stufen sind wie folgt:
-
Sucht nach einer Serverparameterdatei in einem plattformspezifischen Standardspeicherort und, falls nicht gefunden, nach einer textbasierten Initialisierungsparameterdatei (wenn Sie
STARTUPmit den ParameternSPFILEoderPFILEangeben, wird das Standardverhalten außer Kraft gesetzt) -
Liest die Parameterdatei, um die Werte der Initialisierungsparameter zu bestimmen
-
Weist die SGA basierend auf den Initialisierungsparametereinstellungen zu
-
Oracle-Hintergrundprozesse starten
-
Öffnet das Alertlog und Tracedateien und schreibt alle expliziten Parametereinstellungen in das Alertlog in gültiger Parametersyntax
Zu diesem Zeitpunkt ist keine Datenbank mit der Instanz verknüpft. Szenarios, die einen NOMOUNT-Status erfordern, umfassen die Datenbankerstellung und bestimmte Backup- und Recovery-Vorgänge.
Siehe auch: Im Oracle AI Database Administrator's Guide wird beschrieben, wie Initialisierungsparameter mit einer Serverparameterdatei verwaltet werden.
Mounten einer Datenbank
Die Instanz mountet eine Datenbank, um die Datenbank mit dieser Instanz zu verknüpfen.
Um die Datenbank zu mounten, ruft die Instanz die Namen der Datenbankkontrolldateien ab, die im Initialisierungsparameter CONTROL_FILES angegeben sind, und öffnet die Dateien. Oracle AI Database liest die Kontrolldateien, um die Namen der Datendateien und die Online-Redo-Logdateien zu suchen, auf die sie beim Öffnen der Datenbank zugreifen.
In einer gemounteten Datenbank ist die Datenbank geschlossen und nur für Datenbankadministratoren zugänglich. Administratoren können die Datenbank schließen, während sie bestimmte Wartungsvorgänge ausführen. Die Datenbank ist jedoch nicht für normale Vorgänge verfügbar.
Wenn Oracle AI Database zulässt, dass mehrere Instanzen dieselbe Datenbank gleichzeitig mounten, kann die Initialisierungsparametereinstellung CLUSTER_DATABASE die Datenbank für mehrere Instanzen verfügbar machen. Das Datenbankverhalten hängt von der Einstellung ab:
-
Wenn
CLUSTER_DATABASEfür die erste Instanz, die eine Datenbank mountet,false(Standard) ist, kann nur diese Instanz die Datenbank mounten. -
Wenn
CLUSTER_DATABASEfür die erste Instanztrueist, können andere Instanzen die Datenbank mounten, wenn ihre Parametereinstellungen fürCLUSTER_DATABASEauftruegesetzt sind. Die Anzahl der Instanzen, die eine Datenbank mounten können, unterliegt einem vorgegebenen Maximum, das beim Erstellen der Datenbank angegeben wird.
Siehe:
-
Oracle AI Database Administrator's Guide zum Mounten einer Datenbank
-
Oracle Real Application Clusters Administration and Deployment Guide für weitere Informationen zur Verwendung mehrerer Instanzen mit einer einzelnen Datenbank
So wird eine Datenbank geöffnet
Wenn Sie eine gemountete Datenbank öffnen, ist sie für den normalen Datenbankbetrieb verfügbar.
Jeder gültige Benutzer kann sich bei einer geöffneten Datenbank anmelden und auf die zugehörigen Informationen zugreifen. In der Regel öffnet ein Datenbankadministrator die Datenbank, um sie für die allgemeine Verwendung verfügbar zu machen.
Wenn Sie die Datenbank öffnen, führt Oracle AI Database die folgenden Aktionen aus:
-
Öffnet Onlinedatendateien in Tablespaces, die keine Undo Tablespaces sind
Wenn ein Tablespace offline war, als die Datenbank zuvor heruntergefahren wurde, sind der Tablespace und die zugehörigen Datendateien beim erneuten Öffnen der Datenbank offline.
-
Erwirbt einen Undo Tablespace
Wenn mehrere Undo Tablespaces vorhanden sind, gibt der Initialisierungsparameter
UNDO_TABLESPACEden zu verwendenden Undo Tablespace an. Wenn dieser Parameter nicht festgelegt ist, wird der erste verfügbare Undo Tablespace gewählt. -
Öffnet die Online Redo-Logdateien
-
Schreibgeschützter Modus Standardmäßig wird die Datenbank im Lese-/Schreibmodus geöffnet. In diesem Modus können Benutzer Änderungen an den Daten vornehmen und im Online-Redo Log Redo generieren. Alternativ können Sie im schreibgeschützten Modus öffnen, um Datenänderungen durch Benutzertransaktionen zu verhindern.
-
Prüfungen der Datenbankdatei Wenn keine Datendateien oder Redo-Logdateien vorhanden sind, wenn die Instanz versucht, die Datenbank zu öffnen, oder wenn die Dateien vorhanden sind, aber Konsistenztests nicht erfolgreich sind, gibt die Datenbank einen Fehler zurück. Möglicherweise ist eine Medienwiederherstellung erforderlich.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch, um mehr über die Datenreparatur zu erfahren
Modus "Schreibgeschützt"
Standardmäßig wird die Datenbank im Lese-/Schreibmodus geöffnet. In diesem Modus können Benutzer Änderungen an den Daten vornehmen und im Online-Redo Log Redo generieren. Alternativ können Sie im schreibgeschützten Modus öffnen, um Datenänderungen durch Benutzertransaktionen zu verhindern. Hinweis: Standardmäßig wird eine physische Standbydatenbank im schreibgeschützten Modus geöffnet.
Der schreibgeschützte Modus schränkt den Datenbankzugriff auf schreibgeschützte Transaktionen ein, die nicht in Datendateien oder Online-Redo Log-Dateien schreiben können. Die Datenbank kann jedoch Recovery oder Vorgänge ausführen, die den Datenbankstatus ändern, ohne Redo zu generieren. Beispiel: Im schreibgeschützten Modus:
-
Datendateien können offline und online gesetzt werden. Permanent Tablespaces können jedoch nicht offline gesetzt werden.
-
Offlinedatendateien und Tablespaces können wiederhergestellt werden.
-
Die Kontrolldatei bleibt für Aktualisierungen des Status der Datenbank verfügbar.
-
Temporary Tablespaces, die mit der
CREATE TEMPORARY TABLESPACE-Anweisung erstellt wurden, sind mit Lese-/Schreibzugriff. -
Schreibvorgänge in Audittrails des Betriebssystems, Tracedateien und Alertlogs können fortgesetzt werden.
Siehe:
-
Oracle AI Database - Administratordokumentation zum Öffnen einer Datenbank im schreibgeschützten Modus
Datenbankdateiüberprüfungen
Wenn eine der Datendateien oder Redo Log-Dateien nicht vorhanden ist, wenn die Instanz versucht, die Datenbank zu öffnen, oder wenn die Dateien vorhanden sind, aber Konsistenztests nicht erfolgreich sind, gibt die Datenbank einen Fehler zurück. Möglicherweise ist eine Medienwiederherstellung erforderlich.
Siehe auch: Oracle AI Database Backup and Recovery - Benutzerhandbuch für einen Überblick über Backup und Recovery
Herunterfahren von Datenbanken und Instanzen - Überblick
In einem typischen Anwendungsfall fahren Sie die Datenbank manuell herunter, sodass sie für Benutzer nicht verfügbar ist, während Sie Wartungs- oder andere administrative Aufgaben ausführen. Um diese Schritte auszuführen, können Sie den SQL*Plus-Befehl SHUTDOWN oder Enterprise Manager verwenden.
Die folgende Abbildung zeigt den Fortschritt von einem offenen Status zu einem konsistenten Herunterfahren.
Abbildung 4: Reihenfolge beim Herunterfahren der Instanz und Datenbank
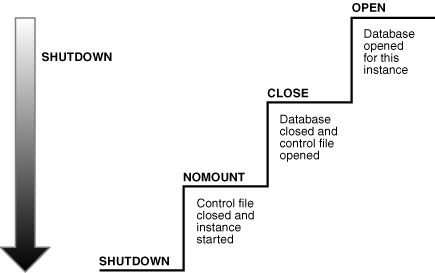
Beschreibung der Abbildung cncpt281.gif
Oracle AI Database führt automatisch die folgenden Schritte aus, wenn eine offene Datenbank konsistent heruntergefahren wird.
Tabelle 3: Schritte beim konsistenten Herunterfahren
| Phase | Mountstatus | Beschreibung | Weitere Infos |
|---|---|---|---|
| 1 | Database closed | Die Datenbank wird gemountet, Online-Datendateien und Redo Log-Dateien werden jedoch geschlossen. | "So wird eine Datenbank geschlossen" |
| 2 | Datenbank ausgehängt | Die Instanz wird gestartet, ist jedoch nicht mehr mit der Kontrolldatei der Datenbank verknüpft. | "So wird eine Datenbank ausgehängt" |
| 3 | Datenbankinstanz heruntergefahren | Die Datenbankinstanz wird nicht mehr gestartet. | "Herunterfahren einer Instanz" |
Oracle AI Database durchläuft nicht alle vorherigen Schritte bei einem Instanzfehler oder SHUTDOWN ABORT, wodurch die Instanz sofort beendet wird.
-
Shutdown-Modi Ein Datenbankadministrator mit
SYSDBA- oderSYSOPER-Berechtigungen kann die Datenbank mit dem SQL*Plus-BefehlSHUTDOWNoder Enterprise Manager herunterfahren. Der BefehlSHUTDOWNenthält Optionen, mit denen das Herunterfahren bestimmt wird. -
So wird eine Datenbank geschlossen Der Vorgang zum Schließen der Datenbank ist beim Herunterfahren der Datenbank implizit. Die Art des Vorgangs hängt davon ab, ob das Herunterfahren der Datenbank normal oder abnormal ist.
-
So wird eine Datenbank nicht gemountet Nachdem die Datenbank geschlossen wurde, mountet Oracle AI Database die Datenbank aus, um die Verknüpfung mit der Instanz aufzuheben.
-
Herunterfahren einer Instanz Der letzte Schritt beim Herunterfahren der Datenbank ist das Herunterfahren der Instanz. Wenn die Datenbankinstanz heruntergefahren wird, belegt die SGA nicht mehr den Speicher, und die Hintergrundprozesse werden beendet. Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie eine Datenbank herunterfahren.
Herunterfahren-Modi
Ein Datenbankadministrator mit SYSDBA- oder SYSOPER-Berechtigungen kann die Datenbank mit dem SQL*Plus-Befehl SHUTDOWN oder Enterprise Manager herunterfahren. Der Befehl SHUTDOWN enthält Optionen, mit denen das Herunterfahren bestimmt wird.
In der folgenden Tabelle wird das Verhalten der verschiedenen Herunterfahrmodi zusammengefasst.
Tabelle 4: Modi zum Herunterfahren der Datenbank
| Datenbankverhalten | ABBRECHEN | IMMEDIATE | TRANSAKTIONAL | NORMAL |
|---|---|---|---|---|
| Ermöglicht neue Benutzerverbindungen | Nein | Nein | Nein | Nein |
| Warten, bis die aktuellen Sessions beendet sind | Nein | Nein | Nein | Ja |
| Warten, bis die aktuellen Transaktionen beendet sind | Nein | Nein | Ja | Ja |
| Führt einen Checkpoint aus und schließt geöffnete Dateien | Nein | Ja | Ja | Ja |
Mögliche SHUTDOWN-Anweisungen:
-
SHUTDOWN ABORTDieser Modus ist für Notsituationen gedacht, z. B. wenn keine andere Form des Herunterfahrens erfolgreich ist. Dieser Modus des Herunterfahrens ist der schnellste. Ein späteres Öffnen dieser Datenbank kann jedoch wesentlich länger dauern, da ein Instanz-Recovery durchgeführt werden muss, um die Datendateien konsistent zu machen.
Da
SHUTDOWN ABORTdie geöffneten Datendateien nicht prüft, ist ein Instanz-Recovery erforderlich, bevor die Datenbank erneut geöffnet werden kann. Für die anderen Herunterfahrmodi ist kein Instanz-Recovery erforderlich, bevor die Datenbank erneut geöffnet werden kann.Hinweis: In einer PDB entspricht die Ausgabe von
SHUTDOWN ABORTder Ausgabe vonSHUTDOWN IMMEDIATEauf CDB-Ebene. -
SHUTDOWN IMMEDIATEDieser Modus ist normalerweise der schnellste neben
SHUTDOWN ABORT. Oracle AI Database beendet alle ausgeführten SQL-Anweisungen und trennt Benutzer. Aktive Transaktionen werden beendet, und nicht festgeschriebene Änderungen werden zurückgesetzt. -
SHUTDOWN TRANSACTIONALDieser Modus verhindert, dass Benutzer neue Transaktionen starten, wartet jedoch, bis alle aktuellen Transaktionen abgeschlossen sind, bevor sie heruntergefahren werden. Dieser Modus kann je nach Art der aktuellen Transaktionen viel Zeit in Anspruch nehmen.
-
SHUTDOWN NORMALDies ist der Standardmodus für das Herunterfahren. Die Datenbank wartet, bis alle angemeldeten Benutzer die Verbindung trennen, bevor sie heruntergefahren wird.
Siehe:
-
Oracle AI Database - Administratordokumentation mit Informationen zu den verschiedenen Herunterfahrmodi
-
SQL*Plus User's Guide and Reference zum
SHUTDOWN-Befehl
Wie eine Datenbank geschlossen wird
Der Vorgang zum Schließen der Datenbank ist beim Herunterfahren der Datenbank implizit. Die Art des Vorgangs hängt davon ab, ob das Herunterfahren der Datenbank normal oder abnormal ist.
-
So wird eine Datenbank beim normalen Herunterfahren geschlossen Wenn eine Datenbank als Teil einer
SHUTDOWNmit einer anderen Option alsABORTgeschlossen wird, schreibt Oracle AI Database Daten in der SGA in die Datendateien und Online-Redo-Logdateien.
Datenbank beim normalen Herunterfahren schließen
Wenn eine Datenbank als Teil einer SHUTDOWN mit einer anderen Option als ABORT geschlossen wird, schreibt Oracle AI Database Daten in der SGA in die Datendateien und Online-Redo-Logdateien.
Anschließend schließt die Datenbank Online-Datendateien und Online Redo Log-Dateien. Alle Offlinedatendateien von Offline Tablespaces wurden bereits geschlossen. Wenn die Datenbank erneut geöffnet wird, bleibt jeder offline geschaltete Tablespace offline.
In dieser Phase wird die Datenbank geschlossen und ist für normale Vorgänge nicht zugänglich. Die Kontrolldateien bleiben geöffnet, nachdem eine Datenbank geschlossen wurde.
Wie eine Datenbank beim abnormen Herunterfahren geschlossen wird
Bei einem SHUTDOWN ABORT oder einer anormalen Beendigung wird die Instanz der geöffneten Datenbank geschlossen und die Datenbank wird sofort heruntergefahren.
Bei einem anormalen Herunterfahren schreibt Oracle AI Database keine Daten aus den Puffern der SGA in die Datendateien und Redo-Logdateien. Für das spätere erneute Öffnen der Datenbank ist ein Instanz-Recovery erforderlich, das Oracle AI Database automatisch ausführt.
Wie eine Datenbank gemountet wird
Nachdem die Datenbank geschlossen wurde, mountet Oracle AI Database die Datenbank, um die Verknüpfung mit der Instanz aufzuheben.
Nachdem eine Datenbank unmountet wurde, schließt Oracle AI Database die Kontrolldateien der Datenbank. Zu diesem Zeitpunkt bleibt die Datenbankinstanz im Speicher.
Herunterfahren einer Instanz
Der letzte Schritt beim Herunterfahren der Datenbank besteht darin, die Instance herunterzufahren. Wenn die Datenbankinstanz heruntergefahren wird, belegt die SGA nicht mehr den Speicher, und die Hintergrundprozesse werden beendet.
In ungewöhnlichen Fällen kann das Herunterfahren einer Datenbankinstanz nicht ordnungsgemäß erfolgen. Speicherstrukturen können nicht aus dem Speicher entfernt werden, oder einer der Hintergrundprozesse kann nicht beendet werden. Wenn Reste einer vorherigen Instanz vorhanden sind, kann ein nachfolgendes Hochfahren der Instanz fehlschlagen. In solchen Situationen können Sie den Start der neuen Instanz erzwingen, indem Sie die Reste der vorherigen Instanz entfernen und dann eine neue Instanz starten oder eine SHUTDOWN ABORT-Anweisung absetzen.
In einigen Fällen kann die Prozessbereinigung selbst zu Fehlern führen, die zum Beenden von Process Monitor (PMON) oder der Instanz führen können. Der dynamische Initialisierungsparameter INSTANCE_ABORT_DELAY_TIME gibt an, wie viele Sekunden ein intern generierter Instanzfehler verzögert werden soll. Diese Verzögerung gibt Ihnen die Möglichkeit zu reagieren. Die Datenbank schreibt eine Meldung in das Alertlog, wenn der verzögerte Abschluss initiiert wird. In einigen Fällen kann die Instanz eine Beendigung vermeiden, indem bestimmte Datenbankressourcen unter Quarantäne gestellt werden.
Siehe:
-
Oracle AI Database - Administratordokumentation für weitere Informationen zum Herunterfahren der Datenbank
-
Oracle AI Database Reference, um mehr über den Initialisierungsparameter
INSTANCE_ABORT_DELAY_TIMEzu erfahren
Überblick über Checkpoints
Ein Checkpoint ist ein wichtiger Mechanismus für konsistente Datenbank-Shutdowns, Instanz-Recovery und Oracle AI Database-Vorgänge im Allgemeinen.
Der Begriff hat folgende Bedeutungen:
-
Eine Datenstruktur, die die Checkpointposition angibt. Dies ist die SCN im Redo-Stream, bei der das Instanz-Recovery beginnen muss
Die Checkpoint-Position wird durch den ältesten Dirty Buffer im Datenbank-Buffer Cache bestimmt. Die Checkpoint-Position fungiert als Zeiger auf den Redo-Stream und wird in der Kontrolldatei und in jedem Datendatei-Header gespeichert.
-
Das Schreiben von geänderten Datenbankpuffern im Datenbankpuffercache auf den Datenträger
-
Zweck von Checkpoints Oracle AI Database verwendet Checkpoints, um mehrere Ziele zu erreichen.
-
Wenn Oracle AI Database Checkpoints auslöst Der Checkpoint-Prozess (CKPT) ist dafür verantwortlich, Checkpoints in die Datendatei-Header und die Kontrolldatei zu schreiben. Siehe auch: "Systemänderungsnummern (SCNs)"
Zweck von Checkpoints
Oracle AI Database nutzt Checkpoints, um mehrere Ziele zu erreichen.
Ziele umfassen:
-
Reduzieren Sie den Zeitaufwand für das Recovery bei einem Instanz- oder Medienfehler
-
Stellen Sie sicher, dass die Datenbank regelmäßig Dirty Buffer im Puffercache auf Platte schreibt
-
Sicherstellen, dass die Datenbank alle festgeschriebenen Daten beim konsistenten Herunterfahren auf den Datenträger schreibt
Wenn Oracle AI Database Checkpoints initiiert
Der Checkpoint-Prozess (CKPT) ist dafür verantwortlich, Checkpoints in die Datendatei-Header und die Kontrolldatei zu schreiben.
Checkpoints treten in verschiedenen Situationen auf. Beispiel: Oracle AI Database verwendet die folgenden Typen von Checkpoints:
-
Thread-Checkpoints
Die Datenbank schreibt alle durch Redo geänderten Puffer in einem bestimmten Thread vor einem bestimmten Ziel auf Platte. Das Set von Thread-Checkpoints für alle Instanzen in einer Datenbank ist ein Datenbank-Checkpoint. Thread-Checkpoints treten in folgenden Situationen auf:
-
Konsistentes Herunterfahren der Datenbank
-
ALTER SYSTEM CHECKPOINT-Anweisung -
Online Redo Log Switch
-
ALTER DATABASE BEGIN BACKUP-Anweisung
-
-
Tablespace- und Datendatei-Checkpoints
Die Datenbank schreibt alle durch Redo geänderten Puffer vor einem bestimmten Ziel auf Platte. Ein Tablespace Checkpoint ist eine Gruppe von Datendatei Checkpoints, einer für jede Datendatei im Tablespace. Diese Checkpoints treten in verschiedenen Situationen auf, z.B. wenn Sie einen Tablespace schreibgeschützt machen oder offline setzen, eine Datendatei verkleinern oder
ALTER TABLESPACE BEGIN BACKUPausführen. -
Inkrementelle Checkpoints
Ein inkrementeller Checkpoint ist ein Thread-Checkpoint, der teilweise verhindern soll, dass eine große Anzahl von Blöcken an Online Redo Log Switches geschrieben wird. DBW prüft mindestens alle drei Sekunden, um festzustellen, ob es eine Aufgabe hat. Wenn DBW Dirty Buffer schreibt, wird die Checkpoint-Position erhöht, sodass CKPT die Checkpoint-Position in die Kontrolldatei, nicht aber in die Datendatei-Header schreibt.
Weitere Checkpoints sind Checkpoints für Instanz- und Media-Recovery und Checkpoints, wenn Schemaobjekte gelöscht oder abgeschnitten werden.
Siehe:
-
Oracle Real Application Clusters Administration and Deployment Guide für Informationen zu globalen Checkpoints in Oracle RAC
Instanz-Recoverys - Überblick
Instanz-Recovery ist der Prozess, bei dem Datensätze im Online-Redo-Log auf Datendateien angewendet werden, um Änderungen nach dem letzten Checkpoint wiederherzustellen.
Das Instanz-Recovery erfolgt automatisch, wenn ein Administrator versucht, eine Datenbank zu öffnen, die zuvor inkonsistent heruntergefahren wurde.
-
Mit dem Instanz-Recovery Zweck des Instanz-Recoverys wird sichergestellt, dass die Datenbank nach einem Instanzfehler konsistent ist. Die Dateien einer Datenbank können in einem inkonsistenten Status bleiben, da Oracle AI Database Datenbankänderungen verwaltet.
-
Wenn Oracle AI Database ein Instanz-Recovery ausführt Ob ein Instanz-Recovery erforderlich ist, hängt vom Status der Redo-Threads ab.
-
Das Instanz-Recovery von Checkpoints für Instanz-Recovery verwendet Checkpoints, um zu bestimmen, welche Änderungen auf die Datendateien angewendet werden müssen. Die Checkpoint-Position garantiert, dass jede festgeschriebene Änderung mit einer SCN unter der Checkpoint-SCN in den Datendateien gespeichert wird.
-
Instanz-Recovery-Phasen Die erste Phase des Instanz-Recoverys wird als Cache-Recovery oder Vorwärtsrollen bezeichnet und wendet alle im Online-Redo-Log aufgezeichneten Änderungen erneut auf die Datendateien an.
Zweck des Instanz-Recoverys
Mit dem Instanz-Recovery wird sichergestellt, dass die Datenbank nach einem Instanzfehler konsistent ist. Die Dateien einer Datenbank können in einem inkonsistenten Status bleiben, da Oracle AI Database Datenbankänderungen verwaltet.
Ein Redo-Thread ist ein Datensatz aller Änderungen, die von einer Instanz generiert werden. Eine Single-Instance-Datenbank verfügt über einen Redo-Thread, während eine Oracle RAC-Datenbank über mehrere Redo-Threads verfügt, einen Thread für jede Datenbankinstanz.
Wenn eine Transaktion festgeschrieben wird, schreibt der Log Writer-Prozess (LGWR) die verbleibenden Redo-Einträge im Speicher und die Transaktions-SCN in das Online-Redo-Log. Der Datenbank-Writer-(DBW-)Prozess schreibt geänderte Datenblöcke jedoch immer dann in die Datendateien, wenn er am effizientesten ist. Aus diesem Grund können nicht festgeschriebene Änderungen vorübergehend in den Datendateien vorhanden sein, während festgeschriebene Änderungen noch nicht in den Datendateien vorhanden sind.
Wenn eine Instanz einer geöffneten Datenbank ausfällt, entweder aufgrund einer SHUTDOWN ABORT-Anweisung oder einer anormalen Beendigung, können folgende Situationen auftreten:
-
Von einer Transaktion festgeschriebene Datenblöcke werden nicht in die Datendateien geschrieben und nur im Online-Redo-Log angezeigt. Diese Änderungen müssen erneut auf die Datendateien angewendet werden.
-
Die Datendateien enthalten Änderungen, die nicht festgeschrieben wurden, als die Instanz nicht erfolgreich war. Diese Änderungen müssen zurückgesetzt werden, um die Transaktionskonsistenz sicherzustellen.
Beim Instanz-Recovery werden nur Online Redo Log-Dateien und aktuelle Online-Datendateien verwendet, um die Datendateien zu synchronisieren und ihre Konsistenz sicherzustellen.
Siehe:
Instanz-Recoverys mit Oracle AI Database ausführen
Ob ein Instanz-Recovery erforderlich ist, hängt vom Status der Redo-Threads ab.
Ein Redo-Thread wird in der Kontrolldatei als geöffnet markiert, wenn eine Datenbankinstanz im Lese-/Schreibmodus geöffnet wird. Er wird als geschlossen markiert, wenn die Instanz konsistent heruntergefahren wird. Wenn Redo-Threads in der Kontrolldatei als geöffnet markiert sind, aber keine Liveinstanzen die Thread-Enqueues enthalten, die diesen Threads entsprechen, erfordert die Datenbank ein Instanz-Recovery.
Oracle AI Database führt das Instanz-Recovery in den folgenden Situationen automatisch aus:
-
Die Datenbank wird zum ersten Mal geöffnet, nachdem eine Einzelinstanzdatenbank oder alle Instanzen einer Oracle RAC-Datenbank ausfallen. Diese Form des Instanz-Recoverys wird auch als Crash Recovery bezeichnet. Oracle AI Database stellt die Online-Redo-Threads der beendeten Instanzen zusammen wieder her.
-
Einige, aber nicht alle Instanzen einer Oracle RAC-Datenbank sind nicht erfolgreich. Das Instanz-Recovery wird automatisch von einer verbleibenden Instanz in der Konfiguration ausgeführt.
Der SMON-Hintergrundprozess führt ein Instanz-Recovery durch und wendet Online Redo automatisch an. Es ist kein Benutzereingriff erforderlich.
Siehe:
-
Oracle Real Application Clusters Administration and Deployment Guide mit Informationen zum Instanz-Recovery in einer Oracle RAC-Datenbank
Bedeutung von Checkpoints für das Instanz-Recovery
Das Instanz-Recovery verwendet Checkpoints, um zu bestimmen, welche Änderungen auf die Datendateien angewendet werden müssen. Die Checkpoint-Position garantiert, dass jede festgeschriebene Änderung mit einer SCN unter der Checkpoint-SCN in den Datendateien gespeichert wird.
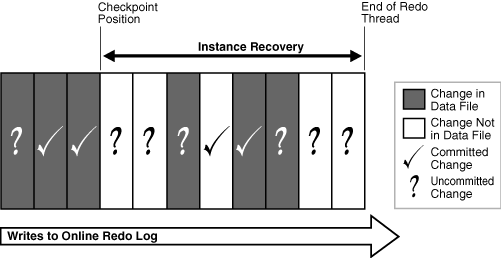
Die folgende Abbildung zeigt den Redo Thread im Online-Redo-Log.
Abbildung 5: Checkpointposition im Online Redo Log
Beschreibung der Abbildung cncpt282.gif
Beim Instanz-Recovery muss die Datenbank die Änderungen anwenden, die zwischen der Checkpoint-Position und dem Ende des Redo-Threads auftreten. Wie in Abbildung 16-5 dargestellt, wurden möglicherweise bereits einige Änderungen in die Datendateien geschrieben. Allerdings sind nur Änderungen mit SCNs, die niedriger als die Checkpoint-Position sind, garantiert, um auf dem Datenträger zu sein.
Siehe auch: In Oracle AI Database Performance Tuning Guide erfahren Sie, wie Sie die Instanz-Recovery-Zeit begrenzen.
Instanz-Recoverys - Phasen
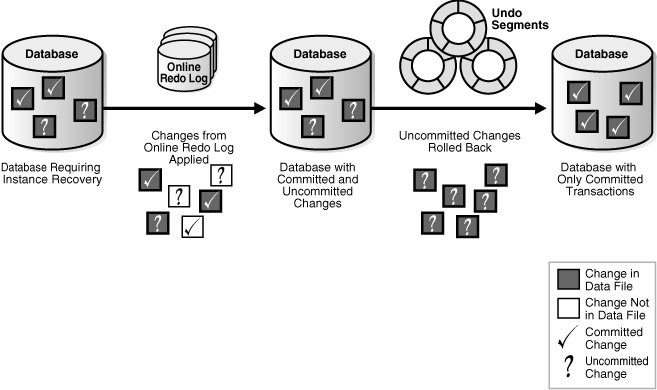
Die erste Phase des Instanz-Recoverys wird Cache-Recovery oder Vorwärtsrollen genannt und wendet alle im Online-Redo-Log aufgezeichneten Änderungen erneut auf die Datendateien an.
Da das Online Redo Log Undo-Daten enthält, generiert das Roll Forward auch die entsprechenden Undo-Segmente neu. Das Roll Forward durchläuft so viele Online Redo Log-Dateien wie nötig, um die Datenbank rechtzeitig voranzubringen. Nach dem Roll Forward enthalten die Datenblöcke alle festgeschriebenen Änderungen, die in den Online Redo Log-Dateien aufgezeichnet wurden. Diese Dateien können auch nicht festgeschriebene Änderungen enthalten, die entweder vor dem Fehler in den Datendateien gespeichert oder im Online-Redo-Log aufgezeichnet und beim Cache-Recovery eingeführt wurden.
Nach dem Roll Forward müssen alle nicht festgeschriebenen Änderungen rückgängig gemacht werden. Oracle AI Database verwendet die Checkpoint-Position. Dadurch wird sichergestellt, dass jede festgeschriebene Änderung mit einer SCN, die kleiner als die Checkpoint-SCN ist, auf dem Datenträger gespeichert wird. Oracle AI Database wendet Undo-Blöcke an, um nicht festgeschriebene Änderungen in Datenblöcken zurückzusetzen, die vor dem Fehler geschrieben oder beim Cache-Recovery eingeführt wurden. Diese Phase wird Zurückrollen oder Transaktionswiederherstellung genannt.
Die folgende Abbildung veranschaulicht das Roll Forward und das Rollback. Dabei handelt es sich um die beiden Schritte, die zum Recovery nach einem Ausfall der Datenbankinstanz erforderlich sind.
Abbildung 6: Einfache Instanz-Recovery-Schritte: Roll Forward und Rollback
Beschreibung der Abbildung cncpt196.gif
Oracle AI Database kann bei Bedarf mehrere Transaktionen gleichzeitig zurücksetzen. Alle Transaktionen, die zum Zeitpunkt des Fehlers aktiv waren, werden als beendet markiert. Anstatt darauf zu warten, dass der SMON-Prozess beendete Transaktionen zurücksetzt, können neue Transaktionen einzelne Blöcke selbst zurückrollen, um die erforderlichen Daten zu erhalten.
Siehe:
-
"Segmente rückgängig machen", um mehr über Undo-Daten zu erfahren
-
Oracle AI Database Performance Tuning Guide für eine Erläuterung der Instanz-Recovery-Mechaniken und -Optimierung
Überblick über Parameterdateien
Um eine Datenbankinstanz zu starten, muss Oracle AI Database entweder eine Serverparameterdatei lesen, die empfohlen wird, oder eine Textinitialisierungsparameterdatei, die eine Legacy-Implementierung ist. Diese Dateien enthalten eine Liste der Konfigurationsparameter.
Um eine Datenbank manuell zu erstellen, müssen Sie eine Instanz mit einer Parameterdatei starten und dann eine CREATE DATABASE-Anweisung absetzen. Daher können die Instanz- und Parameterdatei auch dann vorhanden sein, wenn die Datenbank selbst nicht vorhanden ist.
-
Initialisierungsparameter sind Konfigurationsparameter, die sich auf den grundlegenden Vorgang einer Instanz auswirken. Die Instanz liest Initialisierungsparameter beim Hochfahren von einer Datei.
-
Serverparameterdateien Eine Serverparameterdatei ist ein Repository für Initialisierungsparameter.
-
Textinitialisierungsparameterdateien Eine Textinitialisierungsparameterdatei ist eine Textdatei, die eine Liste der Initialisierungsparameter enthält.
-
Änderung von Initialisierungsparameterwerten Sie können Initialisierungsparameter anpassen, um das Verhalten einer Datenbank zu ändern. Die Klassifizierung von Parametern als statisch oder dynamisch bestimmt, wie sie geändert werden können.
Initialisierungsparameter
Initialisierungsparameter sind Konfigurationsparameter, die sich auf den grundlegenden Vorgang einer Instanz auswirken. Die Instanz liest Initialisierungsparameter beim Hochfahren von einer Datei.
Oracle AI Database bietet viele Initialisierungsparameter, um seinen Betrieb in verschiedenen Umgebungen zu optimieren. Nur wenige dieser Parameter müssen explizit festgelegt werden, da die Standardwerte in der Regel ausreichend sind.
-
Initialisierungsparameter für Funktionsgruppen von Initialisierungsparametern fallen in verschiedene Funktionsgruppen.
-
Grundlegende und erweiterte Initialisierungsparameter: Initialisierungsparameter sind in zwei Gruppen unterteilt: "Basic" und "Advanced".
Funktionsgruppen von Initialisierungsparametern
Initialisierungsparameter fallen in verschiedene funktionale Gruppen.
Die meisten Initialisierungsparameter gehören zu einer der folgenden Gruppen:
-
Parameter, die Entitys wie Dateien oder Verzeichnisse benennen
-
Parameter, die Grenzwerte für einen Prozess, eine Datenbankressource oder die Datenbank selbst festlegen
-
Parameter, die sich auf die Kapazität auswirken, wie die Größe der SGA (diese Parameter werden als Variablenparameter bezeichnet)
Variablenparameter sind für Datenbankadministratoren von besonderem Interesse, da sie diese Parameter zur Verbesserung der Datenbankperformance verwenden können.
Grundlegende und erweiterte Initialisierungsparameter
Initialisierungsparameter sind in zwei Gruppen unterteilt: Basic und Advanced.
In der Regel müssen Sie nur die ungefähr 30 Basisparameter festlegen und optimieren, um eine angemessene Leistung zu erzielen. Die grundlegenden Parameter legen Eigenschaften fest, wie Datenbankname, Speicherorte der Kontrolldateien, Datenbankblockgröße und Undo Tablespace.
In seltenen Fällen kann eine Änderung der erweiterten Parameter für eine optimale Leistung erforderlich sein. Mit den erweiterten Parametern können erfahrene DBAs das Verhalten der Oracle AI Database anpassen, um einzigartige Anforderungen zu erfüllen.
Oracle AI Database stellt Werte in der Startinitialisierungsparameterdatei bereit, die mit Ihrer Datenbanksoftware bereitgestellt wird, oder wie sie vom Datenbankkonfigurationsassistenten (DBCA) für Sie erstellt wurde. Sie können diese von Oracle bereitgestellten Initialisierungsparameter bearbeiten und je nach Konfiguration und Planung der Datenbank weitere Parameter hinzufügen. Für relevante Initialisierungsparameter, die nicht in der Parameterdatei enthalten sind, stellt Oracle AI Database Standardwerte bereit.
Siehe:
-
Oracle AI Database Administrator's Guide, in dem Sie erfahren, wie Initialisierungsparameter angegeben werden
-
Oracle AI Database Reference zur Erläuterung der Typen von Initialisierungsparametern
-
Oracle AI Database Reference zur Beschreibung der Syntax
V$PARAMETERund SQL*Plus User's Guide and Reference fürSHOW PARAMETER
Server Parameter Files
Eine Server Parameter File ist ein Repository für Initialisierungsparameter.
Eine Server Parameter File weist die folgenden Schlüsseleigenschaften auf:
-
Nur Oracle AI Database liest und schreibt in die Serverparameterdatei.
-
Für eine Datenbank ist nur eine Serverparameterdatei vorhanden. Diese Datei muss sich auf dem Datenbankhost befinden.
-
Die Server Parameter File ist binär und kann nicht von einem Texteditor geändert werden.
-
Initialisierungsparameter, die in der Server Parameter File gespeichert sind, sind persistent. Alle Änderungen, die während der Ausführung einer Datenbankinstanz an den Parametern vorgenommen wurden, können nach dem Herunterfahren und Hochfahren der Instanz beibehalten werden.
Durch eine Server Parameter File entfällt die Notwendigkeit, mehrere Text-Initialisierungsparameter-Dateien für Client-Anwendungen zu verwalten. Eine Serverparameterdatei wird zunächst mit der Anweisung CREATE SPFILE aus einer textbasierten Initialisierungsparameterdatei erstellt. Er kann auch direkt vom Datenbankkonfigurationsassistenten erstellt werden.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über Serverparameterdateien zu erfahren
-
Oracle AI Database SQL Language Reference, um mehr über
CREATE SPFILEzu erfahren
Textinitialisierungsparameterdateien
Eine Textinitialisierungsparameterdatei ist eine Textdatei, die eine Liste der Initialisierungsparameter enthält.
Dieser Typ von Parameterdatei (eine Legacy-Implementierung der Parameterdatei) weist die folgenden Schlüsseleigenschaften auf:
-
Wenn Sie eine Datenbank starten oder herunterfahren, muss sich die Textinitialisierungsparameterdatei auf demselben Host befinden wie die Clientanwendung, die sich bei der Datenbank anmeldet.
-
Eine Textinitialisierungsparameterdatei ist textbasiert, nicht binär.
-
Oracle AI Database kann die Textinitialisierungsparameterdatei lesen, aber nicht in diese schreiben. Um die Parameterwerte zu ändern, müssen Sie die Datei manuell mit einem Texteditor ändern.
-
Änderungen an Initialisierungsparameterwerten durch
ALTER SYSTEMsind nur für die aktuelle Instanz wirksam. Sie müssen die Textinitialisierungsparameterdatei manuell aktualisieren und die Instanz neu starten, damit die Änderungen bekannt sind.
Die Textinitialisierungsparameterdatei enthält eine Reihe von key=value-Paaren, eines pro Zeile. Beispiel: Ein Teil einer Initialisierungsparameterdatei könnte wie folgt aussehen:
db_name=sample
control_files=/disk1/oradata/sample_cf.dbf
db_block_size=8192
open_cursors=52
undo_management=auto
shared_pool_size=280M
pga_aggregate_target=29M
.
.
.
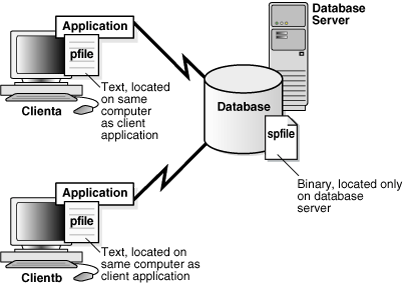
Um die Verwaltbarkeitsprobleme zu veranschaulichen, die Textparameterdateien erstellen können, nehmen Sie an, dass Sie die Computer clienta und clientb verwenden und die Datenbank mit SQL*Plus auf beiden Computern starten können. In diesem Fall müssen zwei separate Textinitialisierungsparameterdateien vorhanden sein, eine auf jedem Computer, wie in Abbildung 16-7 dargestellt. Eine Server Parameter File löst das Problem der Verbreitung von Parameter Files.
Abbildung 7: Mehrere Initialisierungsparameterdateien
Beschreibung der Abbildung cncpt247.gif
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über Textinitialisierungsparameterdateien zu erfahren
-
Oracle AI Database SQL Language Reference, um mehr über
CREATE PFILEzu erfahren
Änderung von Initialisierungsparameterwerten
Sie können Initialisierungsparameter anpassen, um das Verhalten einer Datenbank zu ändern. Die Klassifizierung von Parametern als statisch oder dynamisch bestimmt, wie sie geändert werden können.
In der folgenden Tabelle werden die Unterschiede zusammengefasst.
Tabelle 5 - Statische und dynamische Initialisierungsparameter
| Eigenschaft | Statisch | Dynamisch |
|---|---|---|
| Erfordert Änderung der Parameterdatei (Text oder Server) | Ja | Nein |
| Datenbankinstanz muss neu gestartet werden, bevor die Einstellung wirksam wird | Ja | Nein |
| Wird im Initialisierungsparametereintrag in der Oracle AI Database Reference als "Modifizierbar" beschrieben | Nein | Ja |
| Nur für die Datenbank oder Instanz änderbar | Ja | Nein |
Statische Parameter umfassen DB_BLOCK_SIZE, DB_NAME und COMPATIBLE. Dynamische Parameter werden in Parameter auf Sessionebene gruppiert, die sich nur auf die aktuelle Benutzersession auswirken, und in Parameter auf Systemebene, die sich auf die Datenbank und alle Sessions auswirken. Beispiel: MEMORY_TARGET ist ein Parameter auf Systemebene, während NLS_DATE_FORMAT ein Parameter auf Sessionebene ist.
Der Geltungsbereich einer Parameteränderung hängt davon ab, wann die Änderung wirksam wird. Wenn eine Instanz mit einer Serverparameterdatei gestartet wurde, können Sie die Werte für Parameter auf Systemebene mit der Anweisung ALTER SYSTEM SET wie folgt ändern:
-
SCOPE=MEMORYÄnderungen gelten nur für die Datenbankinstanz. Die Änderung wird nicht beibehalten, wenn die Datenbank heruntergefahren und neu gestartet wird.
-
SCOPE=SPFILEDie Änderungen gelten für die Server Parameter File, wirken sich jedoch nicht auf die aktuelle Instanz aus. Daher werden die Änderungen erst wirksam, wenn die Instanz neu gestartet wird.
Hinweis: Sie müssen
SPFILEangeben, wenn Sie den Wert eines Parameters ändern, der in der Oracle AI Database-Referenz als nicht änderbar beschrieben wird. -
SCOPE=BOTHOracle AI Database schreibt Änderungen sowohl in den Arbeitsspeicher als auch in die Serverparameterdatei. Dies ist der Standardgeltungsbereich, wenn die Datenbank eine Server Parameter File verwendet.
Die Datenbank gibt den neuen Wert und den alten Wert eines Initialisierungsparameters in das Alert Log aus. Als präventive Maßnahme validiert die Datenbank Änderungen des Basisparameters, um zu verhindern, dass ungültige Werte in die Serverparameterdatei geschrieben werden.
Siehe:
-
Oracle AI Database Globalization Support Guide enthält Informationen zur Auswahl eines Gebietsschemas mit der Umgebungsvariablen
NLS_LANG -
Oracle AI Database - Administratordokumentation zum Ändern der Initialisierungsparametereinstellungen
-
Oracle AI Database Reference für Beschreibungen aller Initialisierungsparameter
-
Oracle AI Database SQL Language Reference für
ALTER SYSTEM-Syntax und Semantik
Überblick über Diagnosedateien
Oracle AI Database umfasst eine Faultdiagnosability-Infrastruktur zum Verhindern, Erkennen, Diagnostizieren und Lösen von Datenbankproblemen. Zu den Problemen gehören kritische Fehler wie Codebugs, Metadatenbeschädigung und Beschädigung von Kundendaten.
Die fortschrittliche Infrastruktur zur Fehlerdiagnose hat folgende Ziele:
-
Probleme proaktiv erkennen
-
Beschränkung von Schäden und Unterbrechungen, nachdem ein Problem erkannt wurde
-
Reduzierung der Diagnose- und Lösungszeit von Problemen
-
Verbesserung der Verwaltbarkeit, indem Trace-Dateien partitioniert werden können, sodass der Benutzer die Größe pro Stück und die maximale Anzahl der beizubehaltenden Teile definieren und das Tracing deaktivieren kann, nachdem ein benutzerdefinierter Grenzwert für den Festplattenspeicher erreicht wurde
-
Vereinfachung der Kundeninteraktion mit Oracle Support
-
Automatic Diagnostic Repository Automatic Diagnostic Repository (ADR) ist ein dateibasiertes Repository, in dem Datenbankdiagnosedaten wie Tracedateien, das Alertlog, das DDL-Log und Health Monitor-Berichte gespeichert werden.
-
Alertlog Jede Datenbank verfügt über ein Alertlog, bei dem es sich um eine Datei handelt, die ein chronologisches Log mit Datenbankmeldungen und Fehlern enthält.
-
Aufmerksamkeitslog Jede Datenbank verfügt über ein Aufmerksamkeitslog, das kritische und gut sichtbare Datenbankereignisse enthält.
-
DDL-Log: Das DDL-Log hat dasselbe Format und dasselbe allgemeine Verhalten wie das Alertlog, enthält jedoch nur DDL-Anweisungen und -Details. Die Datenbank schreibt DDL-Informationen in ihre eigene Datei, um die Unordnung im Alert Log zu reduzieren.
-
Verfolgungsdateien Eine Verfolgungsdatei ist eine Datei, die Diagnosedaten enthält, mit denen Probleme untersucht werden. Darüber hinaus können Trace-Dateien Anleitungen zum Optimieren von Anwendungen oder einer Instanz enthalten.
-
Diagnose-Dumps Eine Diagnose-Dumpdatei ist ein spezieller Tracedatei-Typ, der detaillierte Point-in-Time-Informationen zu einem Status oder einer Struktur enthält. Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Diagnosedateien verwaltet werden.
Automatic Diagnostic Repository
Automatic Diagnostic Repository (ADR) ist ein dateibasiertes Repository, in dem Datenbankdiagnosedaten wie Tracedateien, das Alertlog, das DDL-Log und Health Monitor-Berichte gespeichert werden.
Zu den wichtigsten Merkmalen von ADR gehören:
-
Einheitliche Verzeichnisstruktur
-
Konsistente Diagnosedatenformate
-
Einheitliches Toolset
Die oben genannten Merkmale ermöglichen es Kunden und Oracle Support, Diagnosedaten über mehrere Oracle Instanzen, Komponenten und Produkte hinweg zu korrelieren und zu analysieren.
ADR befindet sich außerhalb der Datenbank. Dadurch kann Oracle AI Database auf ADR zugreifen und diese verwalten, wenn die physische Datenbank nicht verfügbar ist. Eine Datenbankinstanz kann ADR erstellen, bevor eine Datenbank erstellt wurde.
-
Probleme und Vorfälle ADR verfolgt proaktiv Probleme, die kritische Fehler in der Datenbank sind.
-
ADR-Struktur Die ADR-Basis ist das ADR-Root-Verzeichnis.
Probleme und Vorfälle
ADR verfolgt proaktiv Probleme, die kritische Fehler in der Datenbank sind.
Kritische Fehler manifestieren sich als interne Fehler, wie ORA-600, oder andere schwerwiegende Fehler. Jedes Problem hat einen Problemschlüssel, bei dem es sich um eine Textzeichenfolge handelt, die das Problem beschreibt.
Wenn ein Problem mehrmals auftritt, erstellt ADR einen mit Zeitstempel versehenen Vorfall für jedes Vorkommen. Ein Vorfall wird durch eine numerische Vorfall-ID eindeutig identifiziert. Wenn ein Vorfall eintritt, sendet ADR einen Vorfallalert an Enterprise Manager. Die Diagnose und Behebung eines kritischen Fehlers beginnt in der Regel mit einem Vorfallalert.
Da ein Problem in kurzer Zeit viele Vorfälle generieren könnte, wendet ADR die Hochwasserkontrolle auf die Vorfallgenerierung an, nachdem bestimmte Schwellenwerte erreicht wurden. Ein flutkontrollierter Vorfall generiert einen Alertlogeintrag, generiert jedoch keine Incident-Dumps. Auf diese Weise informiert ADR Sie darüber, dass ein kritischer Fehler ausgeführt wird, ohne dass das System mit Diagnosedaten überlastet wird.
Siehe auch: Oracle AI Database Administrator's Guide enthält detaillierte Informationen zur Infrastruktur für die Fehlerdiagnose
ADR-Struktur
Die ADR-Basis ist das ADR-Root-Verzeichnis.
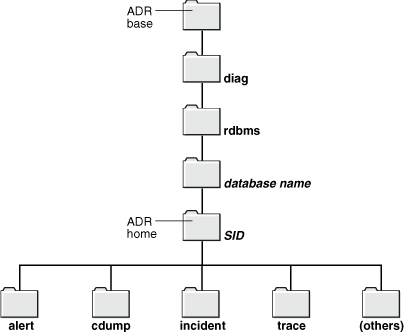
Die ADR-Basis kann mehrere ADR-Homes enthalten, wobei jedes ADR-Home das Root-Verzeichnis für alle Diagnosedatentraces, Dumps, das Alertlog usw. für eine Instanz eines Oracle-Produkts oder einer Oracle-Komponente ist. Beispiel: In einer Oracle RAC-Umgebung mit Shared Storage und Oracle ASM verfügt jede Datenbankinstanz und jede Oracle ASM-Instanz über ein eigenes ADR-Home. In Abbildung 16-8 wird die ADR-Verzeichnishierarchie für eine Datenbankinstanz dargestellt. Andere ADR-Homes für andere Oracle-Produkte oder -Komponenten, wie Oracle ASM oder Oracle Net Services, können in dieser Hierarchie unter derselben ADR-Basis vorhanden sein.
Abbildung 8: ADR-Verzeichnisstruktur für eine Oracle AI Database-Instanz
Beschreibung der Abbildung admin077.gif
Wie das folgende Linux-Beispiel zeigt, erstellt Oracle AI Database standardmäßig ADR als Verzeichnisstruktur im Hostdateisystem, wenn Sie eine Instanz mit einer eindeutigen SID und einem Datenbanknamen starten, bevor Sie eine Datenbank erstellen. Die SID und der Datenbankname sind Teil des Pfadnamens für Dateien im ADR-Home.
Beispiel 16-1: ADR erstellen
% setenv ORACLE_SID osi
% echo "DB_NAME=dbn" > init.ora
% sqlplus / as sysdba
.
.
.
Connected to an idle instance.

SQL> STARTUP NOMOUNT PFILE="./init.ora"
ORACLE instance started.

Total System Global Area  146472960 bytes
Fixed Size                  1317424 bytes
Variable Size              92276176 bytes
Database Buffers           50331648 bytes
Redo Buffers                2547712 bytes

SQL> COL NAME FORMAT a21
SQL> COL VALUE FORMAT a60
SQL> SELECT NAME, VALUE FROM V$DIAG_INFO;

NAME                  VALUE
--------------------- --------------------------------------------------------
Diag Enabled          TRUE
ADR Base              /d1/3910926111/oracle/log
ADR Home              /d1/3910926111/oracle/log/diag/rdbms/dbn/osi
Diag Trace            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace
Diag Alert            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/alert
Diag Incident         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/incident
Diag Cdump            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/cdump
Health Monitor        /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/hm
Default Trace File    /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/osi_ora_29229.trc
Active Problem Count  0
Active Incident Count 0
ORACLE_HOME           /d1/3910926111/oracle
Attention Log         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/attention_osi.log
13 rows selected.
Alertlog
Jede Datenbank verfügt über ein Alertlog, eine Datei, die ein chronologisches Log mit Datenbankmeldungen und Fehlern enthält.
Der Inhalt des Alertlogs umfasst Folgendes:
-
Alle internen Fehler (
ORA-600), Fehler bei Blockbeschädigung (ORA-1578) und deadlock-Fehler (ORA-60) -
Administrative Vorgänge, wie die SQL*Plus-Befehle
STARTUP,SHUTDOWN,ARCHIVE LOGundRECOVER -
Mehrere Meldungen und Fehler in Bezug auf die Funktionen von Shared Server- und Dispatcher-Prozessen
-
Fehler bei der automatischen Aktualisierung einer Materialized View
Wenn ein administrativer Vorgang erfolgreich ist, schreibt Oracle AI Database eine Meldung zusammen mit einem Zeitstempel als "abgeschlossen" in das Alertlog.
Oracle AI Database erstellt ein Alertlog im Unterverzeichnis alert, das in Abbildung 16-8 dargestellt ist, wenn Sie eine Datenbankinstanz zum ersten Mal starten, selbst wenn noch keine Datenbank erstellt wurde. Diese Datei ist im XML-Format gespeichert. Das Unterverzeichnis trace enthält ein Nur-Text-Alertlog.
Fragen Sie V$DIAG_INFO ab, um das Alertlog zu suchen.
Maßnahmenlog
Jede Datenbank verfügt über ein Aufmerksamkeitslog, das kritische und gut sichtbare Datenbankereignisse enthält.
Das Aufmerksamkeitslog enthält nur kritische und gut sichtbare Datenbankereignisse, mit denen Sie einen Alert identifizieren und die entsprechende Aktion ausführen können. Jede Aufmerksamkeitslogmeldung weist verschiedene Attribute auf, darunter Zielgruppe, Ursache und eine auszuführende Aktion. Das Aufmerksamkeitsprotokoll enthält Informationen im folgenden Format:
-
Aufmerksamkeitsnachrichten-ID
-
Warnmeldungstyp: Fehler, Benachrichtigung, Warnung
-
Aufmerksamkeitsbotschaft Dringlichkeit: DEFERABLE, IMMEDIATE, INFO, SOON
-
Geltungsbereich der Nachricht: CDB, CDB-Cluster, CDB-Instanz, PDB, Session, PDB-Instanz, Prozess, Session
-
Hinweistext
-
Zielbenutzer der Nachricht: CDB-Admin, Clusterware-Admin, PDB-Admin
-
Ursache
-
Aktion
Oracle AI Database erstellt ein Aufmerksamkeitslog mit dem Namen attention_ORACLE_SID.log im Unterverzeichnis trace, das in Abbildung 16-8 dargestellt ist. Sie können auch V$DIAG_INFO abfragen, um das Aufmerksamkeitslog zu suchen.
DDL-Log
Das DDL-Log hat dasselbe Format und dasselbe allgemeine Verhalten wie das Alertlog, enthält jedoch nur DDL-Anweisungen und -Details. Die Datenbank schreibt DDL-Informationen in ihre eigene Datei, um die Unordnung im Alert Log zu reduzieren.
DDL-Logdatensätze sind DDL-Text, der optional um zusätzliche Informationen ergänzt wird. Für jede DDL-Anweisung ist ein Logdatensatz vorhanden. Das DDL-Log wird im Unterverzeichnis log/ddl des ADR-Homes gespeichert.
Tracedateien
Eine trace-Datei ist eine Datei, die Diagnosedaten zur Untersuchung von Problemen enthält. Darüber hinaus können Trace-Dateien Anleitungen zum Optimieren von Anwendungen oder einer Instanz enthalten.
-
Typen von Tracedateien Jeder Server und Hintergrundprozess kann regelmäßig in eine zugehörige Tracedatei schreiben. Die Dateien enthalten Informationen zur Prozessumgebung, zum Status, zu Aktivitäten und zu Fehlern.
-
Tracedateien speichern ADR speichert Tracedateien im Unterverzeichnis
trace. Trace-Dateinamen sind plattformabhängig und verwenden die Erweiterung.trc. -
Segmentierung von Tracedateien Wenn die Größe der Tracedatei begrenzt ist, kann die Datenbank sie automatisch in maximal fünf Segmente aufteilen. Segmente sind separate Dateien, die denselben Namen wie die aktive Tracedatei haben, aber mit einer angehängten Segmentnummer, wie in
ora_1234_2.trc. Siehe auch: Oracle AI Database – Erste Schritte mit Performance Tuning
Trace-Dateitypen
Jeder Server- und Hintergrundprozess kann regelmäßig in eine zugehörige Tracedatei schreiben. Die Dateien enthalten Informationen zur Prozessumgebung, zum Status, zu Aktivitäten und zu Fehlern.
Die SQL-Trace-Funktion erstellt auch Trace-Dateien, die Performance-Informationen zu einzelnen SQL-Anweisungen bereitstellen. Sie können das Tracing für einen Client-Identifier, einen Service, ein Modul, eine Aktion, eine Session, eine Instanz oder eine Datenbank auf verschiedene Weise aktivieren. Beispiel: Sie können die entsprechenden Prozeduren im Package DBMS_MONITOR ausführen oder Ereignisse festlegen.
Siehe:
-
Oracle AI Database Administrator's Guide mit Informationen zu Tracedateien, Dumps und Core-Dateien
-
SQL-Tuning-Handbuch für Oracle AI Database mit Informationen zum Application Tracing
Speicherorte der Tracedateien
ADR speichert Tracedateien im Unterverzeichnis trace. Trace-Dateinamen sind plattformabhängig und verwenden die Erweiterung .trc.
Im Allgemeinen enthalten Trace-Dateinamen für den Datenbankhintergrundprozess die Oracle-SID, den Hintergrundprozessnamen und die Betriebssystemprozessnummer. Ein Beispiel für eine Tracedatei für den Prozess RECO ist mytest_reco_10355.trc.
Die Trace-Dateinamen des Serverprozesses enthalten die Oracle-SID, die Zeichenfolge ora und die Betriebssystemprozessnummer. Ein Beispiel für einen Trace-Dateinamen eines Serverprozesses ist mytest_ora_10304.trc.
Manchmal enthalten Tracedateien entsprechende Tracemetadatendateien, die mit der Erweiterung .trm enden. Diese Dateien enthalten strukturelle Informationen, die als Trace Maps bezeichnet werden und die von der Datenbank für die Suche und Navigation verwendet werden.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie Tracedateien finden
Segmentierung von Tracedateien
Wenn die Größe der Tracedatei begrenzt ist, kann die Datenbank sie automatisch in maximal fünf Segmente aufteilen. Segmente sind separate Dateien, die denselben Namen wie die aktive Tracedatei haben, aber mit einer angehängten Segmentnummer, wie in ora_1234_2.trc.
Jedes Segment entspricht in der Regel 20% des durch MAX_DUMP_FILE_SIZE festgelegten Limits. Wenn die kombinierte Größe aller Segmente das Limit überschreitet, löscht die Datenbank das älteste Segment (obwohl nie das erste Segment, das relevante Informationen über den anfänglichen Status des Prozesses enthalten kann), und erstellt dann ein neues, leeres Segment.
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie die Größe von Tracedateien steuern.
Diagnosedumps
Eine Diagnosedumpdatei ist ein spezieller Trace-Dateityp, der detaillierte Point-in-Time-Informationen zu einem Status oder einer Struktur enthält.
Ein Trace ist in der Regel eine kontinuierliche Ausgabe von Diagnosedaten. Im Gegensatz dazu ist ein Dump in der Regel eine einmalige Ausgabe von Diagnosedaten als Reaktion auf ein Ereignis.
- Trace-Dumps und -Vorfälle Die meisten Dumps treten aufgrund von Vorfällen auf.
Trace-Dumps und -Vorfälle
Die meisten Dumps treten aufgrund von Vorfällen auf.
Wenn ein Vorfall eintritt, schreibt die Datenbank einen oder mehrere Dumps in das Ereignisverzeichnis, das für den Vorfall erstellt wurde. Vorfall-Dumps enthalten auch die Vorgangsnummer im Dateinamen.
Während der Erstellung eines Vorfalls kann eine Anwendung einen Heap- oder Systemstatus-Dump als Teil einer Aktion ausführen. In solchen Fällen hängt die Datenbank den Dumpnamen an den Namen der Vorfallsdatei an und nicht an den Standardnamen der Trace-Datei. Beispiel: Aufgrund eines Vorfalls in einem Prozess erstellt die Datenbank die Datei prod_ora_90348.trc. Ein Dump im Vorfall generiert die Datei prod_ora_90348_incident_id.trc, wobei incident_id die numerische ID des Vorfalls ist. Eine Heap-Dumpaktion, die als Teil des Vorfalls erstellt wurde, generiert die Heap-Dumpdatei prod_ora_90348_incident_id_dump_id.trc, wobei dump_id die numerische ID des Trace-Dumps ist.