Architektur von Anwendungen und Oracle Net Services
In diesem Kapitel wird die Anwendungsarchitektur definiert und die Funktionsweise von Oracle-Datenbank- und -Datenbankanwendungen in einer verteilten Verarbeitungsumgebung beschrieben. Dieses Material gilt für fast jede Art von Oracle AI Database-Umgebung.
-
Überblick über die Oracle Application Architecture Im Kontext dieses Kapitels bezieht sich die Anwendungsarchitektur auf die Computing-Umgebung, in der eine Datenbankanwendung eine Verbindung zu einer Oracle-Datenbank herstellt.
-
Architektur von Oracle Net Services - Überblick
Oracle Net Services ist eine Suite von Netzwerkkomponenten, die unternehmensweite Konnektivitätslösungen in verteilten, heterogenen Computing-Umgebungen bereitstellt.
-
Überblick über die Programmschnittstelle Die Programmschnittstelle ist die Softwareschicht zwischen einer Datenbankanwendung und Oracle AI Database.
-
Überblick über Oracle True Cache True Cache ist ein speicherinterner, schreibgeschützter Cache vor einer Oracle AI Database.
Oracle Application Architecture - Überblick
Im Kontext dieses Kapitels bezieht sich die Anwendungsarchitektur auf die Computing-Umgebung, in der eine Datenbankanwendung eine Verbindung zu einer Oracle-Datenbank herstellt.
-
Überblick über Client/Server-Architektur In der Oracle AI Database-Umgebung werden die Datenbankanwendung und die Datenbank in eine Client/Server-Architektur unterteilt.
-
Überblick über die Multitier-Architektur In einer traditionellen Multi-Tier-Architektur stellt ein Anwendungsserver Daten für Clients bereit und dient als Schnittstelle zwischen Clients und Datenbankservern.
-
Überblick über Grid Architecture In einer Oracle AI Database-Umgebung ist grid computing eine Computing-Architektur, die eine große Anzahl von Servern und Speicher effektiv in einer flexiblen On-Demand-Computing-Ressource bündelt.
Überblick über die Client-/Serverarchitektur
In der Oracle AI Database-Umgebung werden die Datenbankanwendung und die Datenbank in eine Client/Server-Architektur unterteilt.
Die Komponenten lauten wie folgt:
-
Der Client führt die Datenbankanwendung aus, z.B. SQL*Plus oder ein Visual Basic-Dateneingabeprogramm, das auf Datenbankinformationen zugreift und mit einem Benutzer interagiert.
-
Der Server führt die Oracle AI Database-Software aus und verarbeitet die Funktionen, die für den gleichzeitigen, gemeinsamen Datenzugriff auf eine Oracle-Datenbank erforderlich sind.
Obwohl die Client-Anwendung und -Datenbank auf demselben Computer ausgeführt werden können, wird häufig eine höhere Effizienz erreicht, wenn die Client-Anteile und der Server-Anteil von verschiedenen Computern ausgeführt werden, die über ein Netzwerk verbunden sind. In den folgenden Abschnitten werden Variationen in der Client/Server-Architektur von Oracle AI Database beschrieben.
-
Verteilte Verarbeitung Die Verwendung mehrerer Hosts zum Verarbeiten einer einzelnen Aufgabe wird als verteilte Verarbeitung bezeichnet.
-
Vorteile einer Client/Server-Architektur Die Oracle AI Database-Client/Server-Architektur in einer verteilten Verarbeitungsumgebung bietet eine Reihe von Vorteilen.
Verteilte Verarbeitung
Die Verwendung mehrerer Hosts zum Verarbeiten einer einzelnen Aufgabe wird als verteilte Verarbeitung bezeichnet.
Front-End- und Backend-Verarbeitung findet auf verschiedenen Computern statt. In Abbildung 19-1 befinden sich Client und Server auf verschiedenen Hosts, die über Oracle Net Services verbunden sind.
Abbildung 1: Client/Server-Architektur und verteilte Verarbeitung
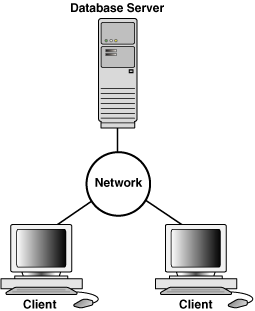
Beschreibung der Abbildung cncpt083.gif
Abbildung 19-2 ist eine Variante, die eine verteilte Datenbank darstellt. In diesem Beispiel greift eine Datenbank auf einem Host auf Daten in einer separaten Datenbank zu, die sich auf einem anderen Host befindet.
Abbildung 2: Client/Server-Architektur und verteilte Datenbank
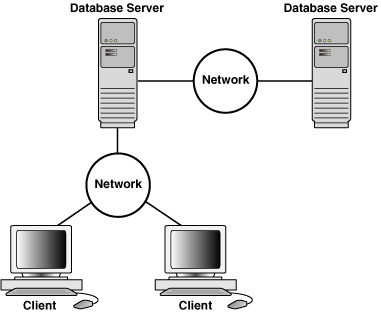
Beschreibung der Abbildung cncpt240.gif
Hinweis: Dieser Rest dieses Kapitels gilt für Umgebungen mit einer Datenbank auf einem Server.
Vorteile einer Client/Server-Architektur
Die Client/Server-Architektur von Oracle AI Database in einer verteilten Verarbeitungsumgebung bietet eine Reihe von Vorteilen.
Zu den Vorteilen zählen:
-
Client-Anwendungen sind nicht für die Datenverarbeitung verantwortlich. Vielmehr fordern sie Eingabe von Benutzern an, fordern Daten vom Server an und analysieren und präsentieren diese Daten mithilfe der Anzeigefunktionen der Client-Workstation oder des Terminals (z. B. mithilfe von Grafiken oder Tabellen).
-
Clientanwendungen hängen nicht vom physischen Speicherort der Daten ab. Auch wenn die Daten verschoben oder auf andere Datenbankserver verteilt werden, funktioniert die Anwendung mit wenig oder keiner Änderung.
-
Oracle AI Database nutzt die Multitasking- und Shared Memory-Funktionen seines zugrunde liegenden Betriebssystems. Folglich bietet es seinen Clientanwendungen den höchstmöglichen Grad an gleichzeitigem Zugriff, Datenintegrität und Performance.
-
Client-Arbeitsplätze oder -Terminals können für die Darstellung von Daten optimiert werden (z.B. durch die Bereitstellung von Grafik- und Mausunterstützung), während der Server für die Verarbeitung und Speicherung von Daten optimiert werden kann (z.B. durch große Mengen an Speicher und Speicherplatz).
-
In vernetzten Umgebungen können Sie kostengünstige Client-Workstations verwenden, um effektiv auf die Remote-Daten des Servers zuzugreifen.
-
Die Datenbank kann an das Wachstum Ihres Systems angepasst werden. Sie können mehrere Server hinzufügen, um die Datenbankverarbeitungslast im gesamten Netzwerk zu verteilen (horizontal skaliert), oder Sie können die Datenbank zu einem Minicomputer oder Mainframe verschieben, um die Performance eines größeren Systems (vertikal skaliert) zu nutzen. In beiden Fällen werden Daten und Anwendungen mit wenig oder keiner Änderung verwaltet, da Oracle AI Database zwischen Systemen portierbar ist.
-
In vernetzten Umgebungen werden gemeinsam genutzte Daten auf den Servern und nicht auf allen Computern gespeichert, sodass der gleichzeitige Zugriff einfacher und effizienter verwaltet werden kann.
-
In vernetzten Umgebungen leiten Clientanwendungen Datenbankanforderungen mit SQL-Anweisungen an den Server weiter. Nach dem Empfang wird jede SQL-Anweisung vom Server verarbeitet, der Ergebnisse an den Client zurückgibt. Der Netzwerkverkehr wird minimiert, da nur die Anforderungen und Ergebnisse über das Netzwerk gesendet werden.
Siehe auch: Oracle AI Database Administrator's Guide, um mehr über verteilte Datenbanken zu erfahren
Multitier-Architektur – Überblick
In einer traditionellen Multi-Tier-Architektur stellt ein Anwendungsserver Daten für Clients bereit und dient als Schnittstelle zwischen Clients und Datenbankservern.
Diese Architektur ermöglicht die Verwendung eines Anwendungsservers für:
-
Zugangsdaten eines Clients, z. B. eines Webbrowsers, validieren
-
Verbindung zu einem Datenbankserver herstellen
-
Angeforderten Vorgang ausführen
Ein Beispiel für eine Multi-Tier-Architektur wird in Abbildung 19-3 dargestellt.
Abbildung 3: Eine Multitier-Architekturumgebung
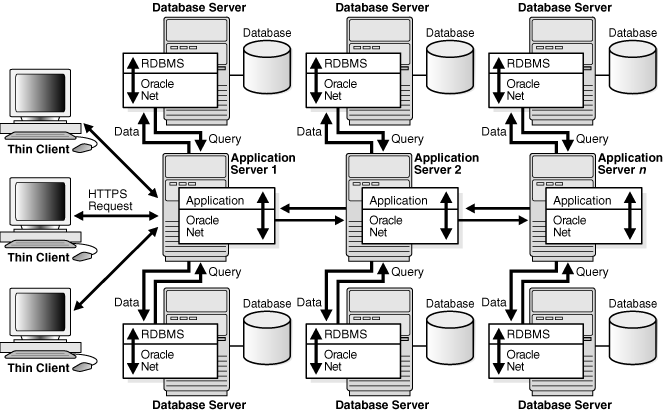
Beschreibung der Abbildung cncpt121.gif
-
Clients Ein Client initiiert eine Anforderung für einen Vorgang, der auf dem Datenbankserver ausgeführt werden soll.
-
Anwendungsserver Ein Anwendungsserver ermöglicht den Zugriff auf die Daten für den Client. Sie dient als Schnittstelle zwischen dem Client und einem oder mehreren Datenbankservern und hostet die Anwendungen.
-
Datenbankserver Ein Datenbankserver stellt die Daten bereit, die von einem Anwendungsserver im Namen eines Clients angefordert werden. Die Datenbank führt die Abfrageverarbeitung aus.
-
Service-Oriented Architecture (SOA) Die Datenbank kann als Webserviceanbieter in traditionellen Multi-Tier- oder Service-Oriented Architecture-(SOA-)Umgebungen dienen.
Clients
Ein Client initiiert eine Anforderung für einen Vorgang, der auf dem Datenbankserver ausgeführt werden soll.
Der Client kann ein Webbrowser oder ein anderes Endbenutzerprogramm sein. In einer Multi-Tier-Architektur meldet sich der Client über einen oder mehrere Anwendungsserver beim Datenbankserver an.
Application Server
Ein Anwendungsserver ermöglicht den Zugriff auf die Daten für den Client. Sie dient als Schnittstelle zwischen dem Client und einem oder mehreren Datenbankservern und hostet die Anwendungen.
Ein Anwendungsserver ermöglicht es Thin Clients, die mit minimalen Softwarekonfigurationen ausgestattet sind, auf Anwendungen zuzugreifen, ohne dass die Clientcomputer ständig gewartet werden müssen. Der Anwendungsserver kann auch eine Datenneuformatierung für den Client ausführen, wodurch die Belastung der Client-Workstation verringert wird.
Der Anwendungsserver nimmt die Identität des Clients an, wenn er Vorgänge auf dem Datenbankserver für diesen Client ausführt. Die Best Practice besteht darin, die Berechtigungen des Anwendungsservers einzuschränken, um zu verhindern, dass er während eines Clientvorgangs unnötige und unerwünschte Vorgänge ausführt.
Datenbankserver
Ein Datenbankserver stellt die von einem Anwendungsserver angeforderten Daten für einen Client bereit. Die Datenbank führt die Abfrageverarbeitung aus.
Der Datenbankserver kann Vorgänge prüfen, die vom Anwendungsserver im Auftrag von Clients und in eigenem Namen ausgeführt werden. Beispiel: Ein Clientvorgang kann Informationen anfordern, die auf dem Client angezeigt werden sollen, während ein Anwendungsservervorgang eine Verbindung zum Datenbankserver anfordern kann.
Beim einheitlichen Auditing kann die Datenbank Anwendungskontexte, die anwendungsspezifische Name/Wert-Paare sind, an Datensätze im einheitlichen Audittrail anhängen. Sie können konfigurieren, welche Anwendungskontexte die Datenbank in Datenbankauditdatensätze schreibt.
Siehe auch: Oracle AI Database - Sicherheitshandbuch für eine Einführung in das Auditing
Service-orientierte Architektur (SOA)
Die Datenbank kann als Webserviceprovider in herkömmlichen Multi-Tier- oder serviceorientierten Architekturumgebungen (SOA) dienen.
SOA ist eine Multi-Tier-Architektur, die auf Services basiert, die Computer-zu-Computer-Interaktionen über ein Netzwerk unterstützen. Im Kontext von SOA ist ein Service ein autarker funktionaler Endpunkt, der über eine gut definierte Funktionalität und Service-Level-Vereinbarung verfügt, überwacht und verwaltet werden kann und zur Durchsetzung der Policy-Compliance beitragen kann.
SOA-Services werden in der Regel als Webservices implementiert, auf die über das HTTP-Protokoll zugegriffen werden kann. Sie basieren auf XML-Standards wie WSDL und SOAP.
Die Oracle AI Database-Webservicefunktion, die als Teil von Oracle XML DB implementiert ist, muss vom DBA speziell aktiviert werden. Anwendungen können dann über Datenbank-Web-Services Folgendes ausführen:
-
SQL- oder XQuery-Abfragen weiterleiten und Ergebnisse als XML empfangen
-
Standalone-PL/SQL-Funktionen aufrufen und Ergebnisse empfangen
-
PL/SQL-Packagefunktionen aufrufen und Ergebnisse empfangen
Datenbank-Web-Services bieten eine einfache Möglichkeit, Web-Services zu einer Anwendungsumgebung hinzuzufügen, ohne dass ein Anwendungsserver erforderlich ist. Der Aufruf von Web Services über Anwendungsserver wie Oracle Fusion Middleware bietet jedoch Sicherheit, Skalierbarkeit, UDDI-Registrierung und zuverlässiges Messaging in einer SOA-Umgebung. Da Datenbank-Web-Services jedoch problemlos in Oracle Fusion Middleware integriert werden können, eignen sie sich möglicherweise für die Optimierung von SOA-Lösungen.
Siehe:
-
Oracle XML Developer's Kit Programmer's Guide: Informationen zum Aktivieren und Verwenden von Datenbank-Webservices
-
Oracle Fusion Middleware-Dokumentation für weitere Informationen zu SOA und Webservices
Grid Architecture - Überblick
In einer Oracle AI Database-Umgebung ist Grid Computing eine Computing-Architektur, die eine große Anzahl von Servern und Speicher effektiv in einer flexiblen On-Demand-Computing-Ressource bündelt.
Modulare Hardware- und Softwarekomponenten können bei Bedarf verbunden und wieder zusammengefügt werden, um den sich ändernden Anforderungen von Unternehmen gerecht zu werden.
Siehe auch: Oracle Clusterware Administration and Deployment Guide für ausführlichere Informationen zu Server- und Speicher-Grids
Architektur von Oracle Net Services - Überblick
Oracle Net Services ist eine Suite von Netzwerkkomponenten, die unternehmensweite Konnektivitätslösungen in verteilten, heterogenen Computing-Umgebungen bereitstellt.
Oracle Net Services aktiviert eine Netzwerksession von einer Anwendung zu einer Datenbankinstanz und eine Datenbankinstanz zu einer anderen Datenbankinstanz.
Oracle Net Services bieten Standorttransparenz, zentralisierte Konfiguration und Verwaltung sowie schnelle Installation und Konfiguration. Außerdem können Sie damit die Systemressourcen maximieren und die Performance verbessern. Die Shared Server-Architektur erhöht die Skalierbarkeit von Anwendungen und die Anzahl der Clients, die gleichzeitig mit der Datenbank verbunden sind. Das Virtual Interface (VI)-Protokoll stellt den größten Teil der Messaging-Belastung auf High-Speed-Netzwerkhardware, wodurch die CPU freigesetzt wird.
Oracle Net Services verwendet die Kommunikationsprotokolle oder Application Programmatic Interfaces (APIs), die von einer breiten Palette von Netzwerken unterstützt werden, um verteilte Datenbanken und verteilte Verarbeitung bereitzustellen. Nachdem eine Netzwerksession eingerichtet wurde, fungiert Oracle Net Services als Datenkurier für die Clientanwendung und den Datenbankserver. Dabei wird eine Verbindung hergestellt und verwaltet und Nachrichten ausgetauscht. Oracle Net Services kann diese Aufgaben ausführen, da sie auf jedem Computer im Netzwerk vorhanden sind.
-
Funktionsweise von Oracle Net Services Oracle AI Database-Protokolle akzeptieren SQL-Anweisungen von der Schnittstelle der Oracle-Anwendungen und verpacken sie dann zur Übertragung an Oracle AI Database.
-
Oracle Net Listener Der Oracle Net Listener (der Listener) ist ein serverseitiger Prozess, der auf eingehende Clientverbindungsanforderungen horcht und Traffic zur Datenbank verwaltet. Wenn eine Datenbank-Instance gestartet wird und zu verschiedenen Zeitpunkten während ihres Lebenszyklus, kontaktiert die Instance einen Listener und erstellt einen Kommunikationspfad zu dieser Instance.
-
Dedizierte Serverarchitektur In einer dedizierten Serverarchitektur wird der Serverprozess, der für jeden Clientprozess erstellt wird, als dedizierter Serverprozess (oder Schattenprozess) bezeichnet.
-
Shared Server-Architektur In einer Shared Server-Architektur leitet ein Dispatcher mehrere eingehende Netzwerksessionanforderungen an einen Pool von Shared Server-Prozessen weiter.
-
Das Database Resident Connection Pooling Database Resident Connection Pooling (DRCP) stellt einen Verbindungspool mit dedizierten Servern für typische Webanwendungsszenarios bereit. Siehe auch: Oracle AI Database Net Services Administrator's Guide für einen Überblick über die Oracle Net-Architektur
Funktionsweise von Oracle Net Services
Oracle AI Database-Protokolle akzeptieren SQL-Anweisungen von der Schnittstelle der Oracle-Anwendungen und verpacken sie dann für die Übertragung an Oracle AI Database.
Die Übertragung erfolgt über ein unterstütztes branchenübliches Protokoll oder eine API auf höherer Ebene. Antworten von Oracle AI Database werden über denselben Kommunikationsmechanismus auf höherer Ebene verpackt. Diese Arbeit erfolgt unabhängig vom Netzwerkbetriebssystem.
Je nach Betriebssystem, auf dem Oracle AI Database ausgeführt wird, könnte die Oracle Net Services-Software des Datenbankservers die Treibersoftware enthalten und einen zusätzlichen Hintergrundprozess starten.
Siehe auch: Oracle AI Database Net Services Administrator's Guide für weitere Informationen zur Funktionsweise von Oracle Net Services
Der Oracle Net Listener
Der Oracle Net Listener (der Listener) ist ein serverseitiger Prozess, der auf eingehende Clientverbindungsanforderungen horcht und Traffic zur Datenbank verwaltet. Wenn eine Datenbank-Instance gestartet wird und zu verschiedenen Zeitpunkten während ihres Lebenszyklus, kontaktiert die Instance einen Listener und erstellt einen Kommunikationspfad zu dieser Instance.
Mit der Service-Registrierung kann der Listener bestimmen, ob ein Datenbankservice und seine Service-Handler verfügbar sind. Ein Service-Handler ist ein dedizierter Serverprozess oder Dispatcher, der als Verbindungspunkt zu einer Datenbank fungiert. Während der Registrierung stellt der LREG-Prozess dem Listener den Instanznamen, die Datenbankservicenamen sowie den Typ und die Adressen der Service-Handler zur Verfügung. Mit diesen Informationen kann der Listener einen Service-Handler starten, wenn eine Clientanforderung eintrifft.
Die folgende Grafik zeigt zwei Datenbanken, die jeweils auf einem separaten Host ausgeführt werden. Die Datenbankumgebung wird von zwei Listenern bedient, die sich jeweils auf einem separaten Host befinden. Der LREG-Prozess, der in jeder Datenbankinstanz ausgeführt wird, kommuniziert mit beiden Listenern, um die Datenbank zu registrieren.
Abbildung 4: Zwei Hörer
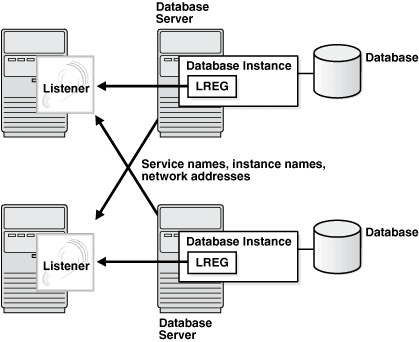
Beschreibung der Abbildung cncpt315.png
Abbildung 19-5 zeigt einen Browser, der eine HTTP-Verbindung herstellt, und einen Client, der eine Datenbankverbindung über einen Listener herstellt. Der Listener muss sich nicht auf dem Datenbankhost befinden.
Abbildung 5: Listener-Architektur
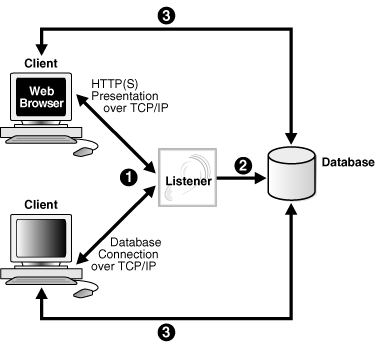
Beschreibung der Abbildung cncpt311.gif
Die grundlegenden Schritte, mit denen ein Client eine Verbindung über einen Listener herstellt, sind:
-
Ein Clientprozess oder eine andere Datenbank fordert eine Verbindung an.
-
Der Listener wählt einen geeigneten Service-Handler aus, um die Clientanforderung zu bearbeiten und die Anforderung an den Handler weiterzuleiten.
-
Der Clientprozess stellt eine direkte Verbindung zum Service-Handler her. Der Listener ist nicht mehr an der Kommunikation beteiligt.
-
Servicenamen Ein Servicename ist eine logische Darstellung eines Service, der für Clientverbindungen verwendet wird.
-
Clients mit Services in einer mehrmandantenfähigen Umgebung müssen über Services eine Verbindung zu PDBs oder Anwendungs-Roots herstellen.
-
Serviceregistrierung In Oracle Net ist die Serviceregistrierung ein Feature, mit dem der LREG-Prozess Instanzinformationen dynamisch bei einem Listener registriert. Siehe auch: "Überblick über Clientprozesse" und "Überblick über Serverprozesse"
Servicenamen
Ein Servicename ist eine logische Darstellung eines Service, der für Clientverbindungen verwendet wird.
Wenn ein Client eine Verbindung zu einem Listener herstellt, fordert er eine Verbindung zu einem Service an. Wenn eine Datenbankinstanz gestartet wird, registriert sie sich bei einem Listener, indem sie einen oder mehrere Services nach Namen bereitstellt. Daher fungiert der Listener als Vermittler zwischen Client und Instances und leitet die Verbindungsanforderung an die richtige Stelle weiter.
Ein einzelner Service, wie er von einem Listener bekannt ist, kann eine oder mehrere Datenbankinstanzen identifizieren. Außerdem kann eine einzelne Datenbankinstanz einen oder mehrere Services bei einem Listener registrieren. Clients, die eine Verbindung zu einem Service herstellen, müssen nicht angeben, welche Instanz sie benötigen. Abbildung 19-6 zeigt eine Einzelinstanzdatenbank, die mit zwei Services verknüpft ist, book.example.com und soft.example.com. Mit den Services kann dieselbe Datenbank von verschiedenen Clients unterschiedlich identifiziert werden. Ein Datenbankadministrator kann Systemressourcen einschränken oder reservieren, sodass Clients, die einen dieser Services anfordern, eine bessere Ressourcenzuweisung erhalten.
Abbildung 6: Mehrere mit einer Datenbank verknüpfte Services
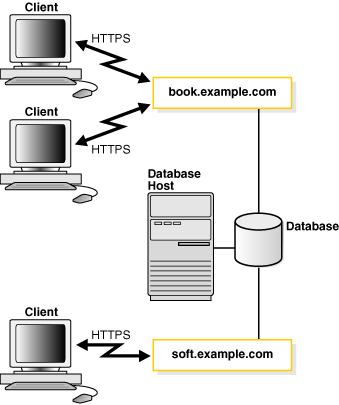
Beschreibung der Abbildung cncpt314.gif
Siehe auch: Oracle AI Database Net Services Administrator's Guide, um mehr über Benennungsmethoden zu erfahren
Services in einer mehrmandantenfähigen Umgebung
Clients müssen über Services eine Verbindung zu PDBs oder Anwendungs-Roots herstellen.
Eine Verbindung mit einem Servicenamen startet eine neue Session in einer PDB oder Anwendungs-Root. Ein Vordergrundprozess und damit eine Sitzung zu jedem Zeitpunkt ihrer Lebensdauer hat einen eindeutig definierten aktuellen Container.
Die folgende Abbildung zeigt zwei Clients, die mit zwei verschiedenen Listenern eine Verbindung zu PDBs herstellen.
Abbildung 7: Services in einer CDB
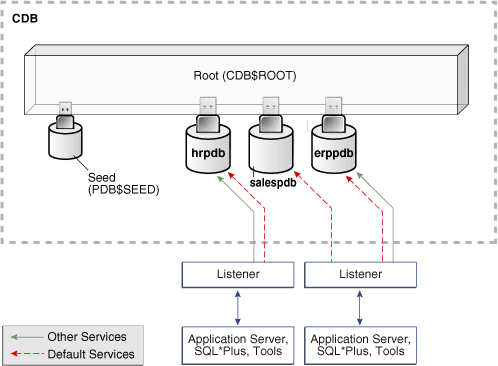
Beschreibung der Abbildung cncpt368.png
-
Serviceerstellung Wenn Sie die
CREATE PLUGGABLE DATABASE-Anweisung zum Erstellen einer PDB ausführen, erstellt und startet die Datenbank automatisch einen Service innerhalb der CDB. -
Verbindungen zu Containern in einer CDB Normalerweise muss ein CDB-Administrator über die entsprechenden Berechtigungen verfügen, um PDBs bereitzustellen und eine Verbindung zu verschiedenen Containern herzustellen. CDB-Administratoren sind häufige Benutzer.
Erstellen des Service
Wenn Sie die CREATE PLUGGABLE DATABASE-Anweisung zum Erstellen einer PDB ausführen, erstellt und startet die Datenbank automatisch einen Service innerhalb der CDB.
Der Standardservice verfügt über eine Eigenschaft, mit der die PDB als aktueller anfänglicher Container für den Service identifiziert wird. Die Eigenschaft wird in der Spalte DBA_SERVICES.PDB angezeigt.
-
Standardservices Der Standardservice hat denselben Namen wie die PDB. Der PDB-Name muss ein gültiger Servicename sein, der innerhalb der CDB eindeutig sein muss.
-
Nondefault-Services Sie können zusätzliche Services für jede PDB bis zu einem Maximum von 10.000 pro CDB erstellen. Jeder zusätzliche Service kennzeichnet seine PDB als den anfänglichen aktuellen Container.
Standard-Services
Der Standardservice hat denselben Namen wie die PDB. Der PDB-Name muss ein gültiger Servicename sein, der innerhalb der CDB eindeutig sein muss.
Wenn Sie einen Anwendungscontainer erstellen, für den die Klausel AS APPLICATION CONTAINER angegeben werden muss, erstellt Oracle AI Database automatisch einen neuen Standardservice für die Anwendungs-Root. Der Service hat denselben Namen wie der Anwendungscontainer. Oracle Net Services muss ordnungsgemäß konfiguriert sein, damit Clients auf diesen Service zugreifen können. Ebenso verfügt jede Anwendungs-PDB über einen eigenen Standardservicenamen, und eine Anwendungs-Seed-PDB hat einen eigenen Standardservicenamen.
Beispiel 19-1: Mit einem Standardservice zu einer PDB wechseln
In diesem Beispiel wird mit dem Standardservice, der denselben Namen wie die PDB hat, zu den PDB-Namen salespdb gewechselt:
ALTER SESSION SET CONTAINER = salespdb;Nicht standardmäßige Services
Sie können zusätzliche Services für jede PDB erstellen, maximal 10.000 pro CDB. Jeder zusätzliche Service kennzeichnet seine PDB als den anfänglichen aktuellen Container.
In Abbildung 19-7 sind nicht standardmäßige Services für erppdb und hrpdb vorhanden. Beispiel: In Abbildung 19-7 hat die PDB hrpdb einen Standardservice namens hrpdb. Der Standarddienst kann nicht gelöscht werden.
Wenn Sie mit ALTER SESSION SET CONTAINER zu einem Container wechseln, verwendet die Session den Standardservice für den Container. Optional können Sie einen anderen Service für den Container verwenden, indem Sie SERVICE = service_name angeben, wobei service_name der Name des Service ist. Möglicherweise möchten Sie einen bestimmten Service verwenden, damit die Session die Serviceattribute und -features wie Service-Metriken, Load Balancing, Resource Manager-Einstellungen usw. nutzen kann.
Beispiel 19-2: Mit einem Nicht-Standardservice zu einer PDB wechseln
In diesem Beispiel unterstützt der Standardservice für hrpdb nicht alle Serviceattribute und -features, wie Servicemetriken, FAN, Load Balancing, Oracle AI Database Resource Manager, Transaction Guard, Application Continuity usw. Sie wechseln wie folgt zu einem Nicht-Default-Service:
ALTER SESSION SET CONTAINER = hrpdb SERVICE = hrpdb_full;Verbindungen zu Containern in einer CDB
In der Regel muss ein CDB-Administrator über die entsprechenden Berechtigungen verfügen, um PDBs bereitzustellen und eine Verbindung zu verschiedenen Containern herzustellen. CDB-Administratoren sind häufige Benutzer.
Der CDB-Administrator kann eine der folgenden Methoden verwenden:
-
Stellen Sie eine direkte Verbindung zu einer PDB oder Anwendungs-Root her.
Der Benutzer benötigt die Berechtigung
CREATE SESSIONim Container. -
Verwenden Sie die
ALTER SESSION SET CONTAINER-Anweisung, die sowohl für das Connection Pooling als auch für die erweiterte CDB-Administration nützlich ist, um zwischen Containern zu wechseln. Die Syntax lautetALTER SESSION SET CONTAINER = container_name [SERVICE = service_name].Beispiel: Ein CDB-Administrator kann sich in einer Session bei der Root anmelden und dann in derselben Session zu einer PDB wechseln. In diesem Fall benötigt der Benutzer die Systemberechtigung
SET CONTAINERim Container.
In der folgenden Tabelle wird ein Szenario beschrieben, das die CDB in Abbildung 19-7 umfasst. Jede Zeile beschreibt eine Aktion, die nach der Aktion in der vorhergehenden Zeile erfolgt. Der allgemeine Benutzer SYSTEM fragt den Namen des aktuellen Containers und die Namen der PDBs in der CDB ab.
Tabelle 1: Services in einer CDB
| Arbeitsvorgang | Beschreibung |
|---|---|
|
Der Benutzer SYSTEM, der allen Containern in der CDB gemeinsam ist, stellt mit dem Service prod eine Verbindung zum Root her. |
|
SYSTEM verwendet den SQL*Plus-Befehl SHOW CON_NAME, um den Namen des Containers aufzulisten, mit dem der Benutzer derzeit verbunden ist. CDB$ROOT ist der Name des Root-Containers. |
|
Eine Abfrage von V$SERVICES zeigt, dass drei PDBs mit Servicenamen vorhanden sind, die mit dem PDB-Namen übereinstimmen. Sowohl hrpdb als auch erppdb verfügen über einen zusätzlichen Service. |
|
SYSTEM verwendet ALTER SESSION, um eine Verbindung zu hrpdb herzustellen. |
|
Eine Abfrage bestätigt, dass der aktuelle Container jetzt hrpdb ist. |
Siehe auch: Oracle AI Database SQL Language Reference für die Syntax und Semantik von ALTER SESSION SET CONTAINER
Serviceregistrierung
In Oracle Net ist die Serviceregistrierung ein Feature, mit dem der LREG-Prozess Instanzinformationen dynamisch bei einem Listener registriert.
Mit diesen Informationen kann der Listener Client-Verbindungsanforderungen an den entsprechenden Service-Handler weiterleiten. LREG stellt dem Listener Informationen zu folgenden Themen zur Verfügung:
-
Namen der von der Datenbank bereitgestellten Datenbankservices
-
Name der Datenbankinstanz, die mit den Services verknüpft ist, sowie die aktuelle und maximale Last
-
Service-Handler (Dispatcher und dedizierte Server) für die Instanz verfügbar, einschließlich Typ, Protokolladressen sowie aktuelle und maximale Last
Serviceregistrierung ist dynamisch und erfordert keine Konfiguration in der Datei listener.ora. Die dynamische Registrierung reduziert den administrativen Overhead für mehrere Datenbanken oder Instanzen.
Der Initialisierungsparameter SERVICE_NAMES listet die Services auf, zu denen eine Instanz gehört. Beim Hochfahren registriert sich jede Instanz bei den Listenern anderer Instanzen, die zu denselben Services gehören. Während der Datenbankvorgänge übergeben die Instanzen jedes Service Informationen über die CPU-Auslastung und die aktuelle Verbindungsanzahl an alle Listener in denselben Services. Diese Kommunikation ermöglicht dynamisches Load Balancing und Verbindungs-Failover.
Siehe:
-
Oracle AI Database Net Services Administrator's Guide für weitere Informationen zur Serviceregistrierung
-
Oracle Real Application Clusters Administration and Deployment Guide enthält Informationen zur Instanzregistrierung und zu Client/Service-Verbindungen in Oracle RAC
Dedizierte Serverarchitektur
In einer dedizierten Serverarchitektur wird der Serverprozess, der für jeden Clientprozess erstellt wird, als dedizierter Serverprozess (oder Schattenprozess) bezeichnet.
Ein dedizierter Serverprozess ist vom Clientprozess getrennt und wirkt nur in seinem Namen, wie in Abbildung 19-8 dargestellt.
Abbildung 8: Oracle AI Database mit dedizierten Serverprozessen
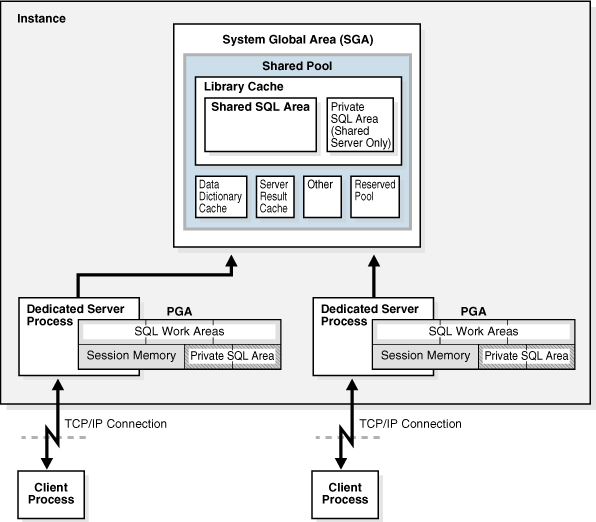
Beschreibung der Abbildung cncpt303.gif
Zwischen den Client-Prozessen und den Server-Prozessen besteht ein Eins-zu-Eins-Verhältnis. Selbst wenn der Benutzer eine Datenbankanforderung nicht aktiv stellt, bleibt der dedizierte Serverprozess inaktiv, obwohl er inaktiv ist und auf einigen Betriebssystemen ausgelagert werden kann. Abbildung 19-8 zeigt Benutzer- und Serverprozesse, die auf vernetzten Computern ausgeführt werden. Die dedizierte Serverarchitektur wird jedoch auch verwendet, wenn derselbe Computer sowohl die Clientanwendung als auch den Datenbankcode ausführt, aber das Hostbetriebssystem die Trennung der beiden Programme nicht aufrechterhalten konnte, wenn sie in einem einzigen Prozess ausgeführt wurden. Linux ist ein Beispiel für ein solches Betriebssystem.
In der dedizierten Serverarchitektur kommunizieren Benutzer- und Serverprozesse über verschiedene Mechanismen:
-
Wenn der Clientprozess und der dedizierte Serverprozess auf demselben Computer ausgeführt werden, verwendet die Programmschnittstelle den Interprozess-Kommunikationsmechanismus des Hostbetriebssystems, um seinen Job auszuführen.
-
Wenn der Clientprozess und der dedizierte Serverprozess auf verschiedenen Computern ausgeführt werden, stellt die Programmschnittstelle die Kommunikationsmechanismen (wie die Netzwerksoftware und Oracle Net Services) zwischen den Programmen bereit.
Nicht ausgelastete dedizierte Server führen manchmal zu einer ineffizienten Nutzung von Betriebssystemressourcen. Betrachten Sie ein Anforderungseingabesystem mit dedizierten Serverprozessen. Ein Kunde erteilt eine Bestellung als Sachbearbeiter in die Datenbank. Für den größten Teil der Transaktion spricht der Sachbearbeiter mit dem Kunden, während der Serverprozess, der dem Clientprozess des Sachbearbeiters zugewiesen ist, inaktiv ist. Der Serverprozess wird während des größten Teils der Transaktion nicht benötigt, und das System kann für andere Sachbearbeiter, die Aufträge eingeben, langsamer sein, wenn das System zu viele Prozesse verwaltet. Für Anwendungen dieses Typs kann die Shared Server-Architektur bevorzugt sein.
Siehe auch: Oracle AI Database Net Services Administrator's Guide, um mehr über dedizierte Serverprozesse zu erfahren
Shared Server-Architektur
In einer Shared Server-Architektur leitet ein Dispatcher mehrere eingehende Netzwerksessionanforderungen an einen Pool von Shared Server-Prozessen weiter.
Durch den Shared Pool ist kein dedizierter Serverprozess für jede Verbindung erforderlich. Ein leerer Shared-Server-Prozess aus einem Pool nimmt eine Anforderung aus einer gemeinsamen Queue.
Shared Server bietet folgende potenzielle Vorteile:
-
Reduziert die Anzahl der Prozesse auf dem Betriebssystem
Eine kleine Anzahl von Shared Servern kann dieselbe Verarbeitungsmenge wie viele dedizierte Server ausführen.
-
Reduziert den PGA-Speicher der Instanz
Jeder dedizierte oder Shared Server verfügt über eine PGA. Weniger Serverprozesse bedeuten weniger PGAs und weniger Prozessmanagement.
-
Erhöht die Anwendungsskalierbarkeit und die Anzahl der Clients, die gleichzeitig eine Verbindung zur Datenbank herstellen können
-
Kann schneller sein als dedizierter Server, wenn die Rate der Clientverbindungen und -trennungen hoch ist
Shared Server hat mehrere Nachteile, darunter in einigen Fällen eine langsamere Antwortzeit, unvollständige Featureunterstützung und eine erhöhte Komplexität für Setup und Tuning. Als allgemeine Richtlinie sollten Sie Shared Server nur verwenden, wenn Sie mehr gleichzeitige Verbindungen zur Datenbank haben, als das Betriebssystem verarbeiten kann.
In einer Shared Server-Architektur sind die folgenden Prozesse erforderlich:
-
Ein Netzwerk-Listener, der die Clientprozesse mit Dispatchern oder dedizierten Servern verbindet (der Listener ist Teil von Oracle Net Services, nicht von Oracle AI Database)
Hinweis: Um Shared Server zu verwenden, muss ein Clientprozess eine Verbindung über Oracle Net Services herstellen, auch wenn der Prozess auf demselben Computer wie die Oracle AI Database-Instanz ausgeführt wird.
-
Mindestens ein Dispatcher-Prozess (Dnnn)
-
Ein oder mehrere Shared Server-Prozesse
Eine Datenbank kann sowohl Shared Server- als auch dedizierte Serververbindungen gleichzeitig unterstützen. Beispiel: Ein Client kann über einen dedizierten Server eine Verbindung herstellen, während ein anderer Client über einen Shared Server eine Verbindung zu derselben Datenbank herstellt.
-
Dispatcher-Anforderungs- und -Antwortqueues Eine Anforderung eines Benutzers ist ein einzelner API-Aufruf, der Teil der SQL-Anweisung des Benutzers ist.
-
Eingeschränkte Vorgänge des Shared Servers Bestimmte administrative Aktivitäten können nicht ausgeführt werden, während eine Verbindung zu einem Dispatcher-Prozess hergestellt wird, einschließlich Herunterfahren oder Starten einer Instanz und eines Media-Recoverys.
Siehe:
-
Oracle AI Database Net Services Administrator's Guide für weitere Informationen zur Shared Server-Architektur
-
Oracle AI Database Administrator's Guide zum Konfigurieren einer Datenbank für Shared Server
Dispatcher-Anforderungs- und -Antwortwarteschlangen
Eine Anforderung eines Benutzers ist ein einzelner API-Aufruf, der Teil der SQL-Anweisung des Benutzers ist.
Wenn ein Benutzer einen Anruf tätigt, geschieht Folgendes:
-
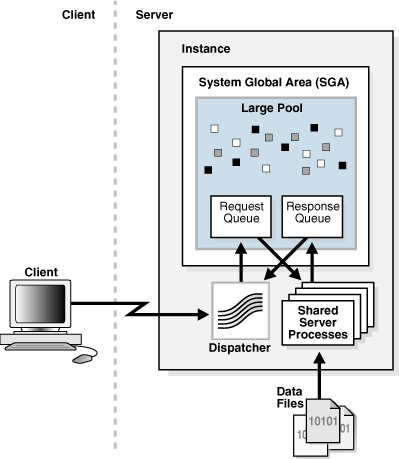
Der Dispatcher platziert die Anforderung in der Anforderungswarteschlange, wo sie vom nächsten verfügbaren Shared Server-Prozess abgerufen wird.
Die Request Queue befindet sich in der SGA und ist allen Dispatcher-Prozessen einer Instance gemeinsam.
-
Die Shared Server-Prozesse prüfen die gemeinsame Anforderungswarteschlange auf neue Anforderungen und nehmen neue Anforderungen auf First-in-First-out-Basis auf.
-
Ein Shared Server-Prozess nimmt eine Anforderung in der Queue auf und ruft alle erforderlichen Aufrufe an die Datenbank ab, um diese Anforderung abzuschließen.
Ein anderer Serverprozess kann jeden Datenbankaufruf verarbeiten. Daher können Anforderungen zum Parsen einer Abfrage, zum Abrufen der ersten Zeile, zum Abrufen der nächsten Zeile und zum Schließen der Ergebnismenge jeweils von einem anderen Shared Server verarbeitet werden.
-
Wenn der Serverprozess die Anforderung abschließt, platziert er die Antwort in der Antwortqueue des aufrufenden Dispatchers. Jeder Dispatcher verfügt über eine eigene Antwortqueue.
-
Der Dispatcher gibt die abgeschlossene Anforderung an den entsprechenden Clientprozess zurück.
Beispiel: In einem Anforderungseingabesystem stellt der Clientprozess jedes Sachbearbeiters eine Verbindung zu einem Dispatcher her. Jede Anforderung des Sachbearbeiters wird an diesen Dispatcher gesendet, der die Anforderung in die Queue stellt. Der nächste verfügbare Shared Server nimmt die Anforderung auf, bedient sie und stellt die Antwort in die Antwortqueue. Wenn eine Anforderung abgeschlossen ist, bleibt der Sachbearbeiter mit dem Dispatcher verbunden. Der Shared Server, der die Anforderung verarbeitet hat, wird jedoch freigegeben und ist für andere Anforderungen verfügbar. Während ein Sachbearbeiter mit einem Kunden spricht, kann ein anderer Sachbearbeiter denselben Shared Server-Prozess verwenden. Abbildung 19-9 zeigt, wie Clientprozesse mit dem Dispatcher über die API kommunizieren und wie der Dispatcher Benutzeranforderungen an Shared Server-Prozesse kommuniziert.
Abbildung 9: Konfiguration und Prozesse des Shared Servers
Beschreibung der Abbildung cncpt067.gif
-
Dispatcher-Prozesse (Dnnn) Mit den Dispatcher-Prozessen können Clientprozesse eine begrenzte Anzahl von Serverprozessen gemeinsam nutzen.
-
Shared Server-Prozesse (Snnn) Jeder Shared Server-Prozess bedient mehrere Client-Anforderungen in der Shared Server-Konfiguration. Siehe auch: "Großer Pool"
Dispatcher-Prozesse (D nnn)
Mit den Dispatcher-Prozessen können Clientprozesse eine begrenzte Anzahl von Serverprozessen gemeinsam nutzen.
Sie können mehrere Dispatcher-Prozesse für eine einzelne Datenbankinstanz erstellen. Die optimale Anzahl von Dispatcher-Prozessen abhängig von der Betriebssystembegrenzung und der Anzahl der Verbindungen für jeden Prozess.
Hinweis: Jeder Clientprozess, der eine Verbindung zu einem Dispatcher herstellt, muss Oracle Net Services verwenden, auch wenn beide Prozesse auf demselben Host ausgeführt werden.
Dispatcher-Prozesse stellen die Kommunikation wie folgt her:
-
Wenn eine Instanz gestartet wird, wird der Network Listener-Prozess geöffnet, und es wird ein Kommunikationspfad eingerichtet, über den Benutzer eine Verbindung zu Oracle AI Database herstellen können.
-
Jeder Dispatcher-Prozess gibt dem Listener-Prozess eine Adresse, an der der Dispatcher auf Verbindungsanforderungen horcht.
Für jedes Netzwerkprotokoll, das die Datenbankclients verwenden, muss mindestens ein Dispatcher-Prozess konfiguriert und gestartet werden.
-
Wenn ein Clientprozess eine Verbindungsanforderung stellt, bestimmt der Listener, ob der Clientprozess einen Shared Server-Prozess verwenden soll:
-
Wenn der Listener feststellt, dass ein Shared Server-Prozess erforderlich ist, gibt der Listener die Adresse des Dispatcher-Prozesses zurück, der die geringste Last aufweist, und der Clientprozess stellt eine direkte Verbindung zum Dispatcher her.
-
Wenn der Prozess nicht mit dem Dispatcher kommunizieren kann oder wenn der Clientprozess einen dedizierten Server anfordert, erstellt der Listener einen dedizierten Serverprozess und stellt eine entsprechende Verbindung her.
-
Siehe auch: Im Oracle AI Database Net Services Administrator's Guide erfahren Sie, wie Dispatcher konfiguriert werden.
Shared Server-Prozesse (S nnn)
Jeder Shared Server-Prozess bedient mehrere Client-Anforderungen in der Shared Server-Konfiguration.
Shared Server-Prozesse und dedizierte Server-Prozesse bieten dieselbe Funktionalität, nur sind Shared Server-Prozesse nicht mit einem bestimmten Clientprozess verknüpft. Stattdessen bedient ein Shared-Serverprozess eine beliebige Clientanforderung in der Shared-Server-Konfiguration.
Die PGA eines Shared Server-Prozesses enthält keine UGA-Daten (auf die alle Shared Server-Prozesse zugreifen müssen). Die Shared Server-PGA enthält nur prozessspezifische Daten.
Alle sessionbezogenen Informationen sind in der SGA enthalten. Jeder Shared-Serverprozess muss in der Lage sein, auf alle Datenbereiche der Sessions zuzugreifen, sodass jeder Server Anforderungen von jeder Session bearbeiten kann. In der SGA wird Speicherplatz für jeden Datenbereich der Session zugewiesen.
Siehe auch: "Überblick über die Programm-Global Area (PGA)"
Eingeschränkte Vorgänge des Shared Servers
Bestimmte administrative Aktivitäten können nicht ausgeführt werden, während Sie bei einem Dispatcher-Prozess angemeldet sind, einschließlich Herunterfahren oder Starten einer Instanz und eines Media Recoverys.
Diese Aktivitäten werden normalerweise ausgeführt, wenn sie mit Administratorberechtigungen verbunden sind. Um eine Verbindung mit Administratorberechtigungen in einem System herzustellen, das mit Shared Servern konfiguriert ist, müssen Sie angeben, dass Sie einen dedizierten Serverprozess verwenden.
Siehe auch: Oracle AI Database Net Services Administrator's Guide für die korrekte Syntax der Verbindungszeichenfolge
Datenbank-residentes Verbindungspooling
Database Resident Connection Pooling (DRCP) stellt einen Connection Pool von dedizierten Servern für typische Webanwendungsszenarien bereit.
Eine Webanwendung stellt in der Regel eine Datenbankverbindung her, verwendet die Verbindung kurz und gibt sie dann frei. Durch DRCP kann die Datenbank auf Zehntausende gleichzeitiger Verbindungen skaliert werden.
DRCP bietet die folgenden Vorteile:
-
Ergänzt Middle Tier Connection Pools, die Verbindungen zwischen Threads in einem Middle Tier-Prozess gemeinsam nutzen.
-
Ermöglicht die gemeinsame Verwendung von Datenbankverbindungen über mehrere Middle Tier-Prozesse hinweg. Diese Middle Tier-Prozesse können demselben oder einem anderen Middle Tier-Host angehören.
-
Ermöglicht eine signifikante Reduzierung der wichtigen Datenbankressourcen, die für die Unterstützung vieler Clientverbindungen erforderlich sind. Beispiel: DRCP reduziert den für die Datenbank erforderlichen Speicher und erhöht die Skalierbarkeit der Datenbank und der Middle Tier. Der Pool verfügbarer Server reduziert außerdem die Kosten für die Neuerstellung von Clientverbindungen.
-
Bietet Pooling für Architekturen mit Single-Threaded-Anwendungsservern mit mehreren Prozessen, wie PHP und Apache, die kein Middle Tier Connection Pooling ausführen können.
DRCP verwendet einen gepoolten Server, der einem dedizierten Serverprozess (kein Shared Server-Prozess) und einer kombinierten Datenbanksession entspricht. Das gepoolte Servermodell vermeidet den Overhead der Dedizierung eines Servers für jede Verbindung, die den Server für einen kurzen Zeitraum benötigt.
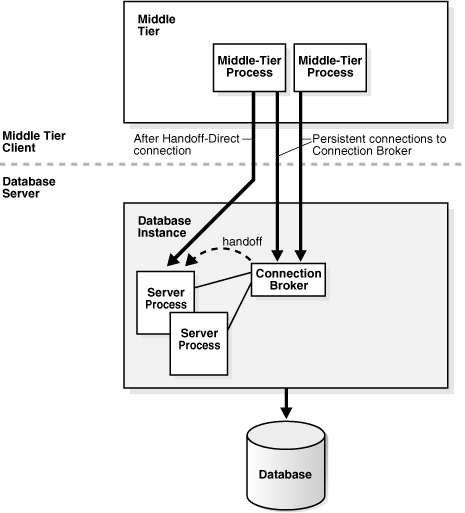
Clients, die Verbindungen aus dem Connection Pool der Datenbank abrufen, melden sich bei einem Oracle-Hintergrundprozess an, der als Connection Broker bezeichnet wird. Der Connection Broker implementiert die Pool-Funktionalität und spiegelt gepoolte Server zwischen eingehenden Verbindungen von Clientprozessen.
Wie in Abbildung 19-10 dargestellt, nimmt der Connection Broker, wenn ein Client Datenbankzugriff benötigt, einen Serverprozess aus dem Pool auf und übergibt ihn an den Client. Der Client ist direkt mit dem Serverprozess verbunden, bis die Anforderung verarbeitet wird. Nachdem der Server beendet ist, wird der Serverprozess in den Pool freigegeben. Die Verbindung vom Client zum Broker wird wiederhergestellt.
Abbildung 10: DRCP
Beschreibung der Abbildung cncpt312.gif
In DRCP bleibt die Freigabe von Ressourcen intakt, ist aber nicht mehr mit einer Verbindung (Serverprozess) verknüpft. Im Gegensatz zum Shared Server speichert diese Session ihre UGA in der PGA, nicht in der SGA. Ein Client kann eine Verbindung transparent wiederherstellen, wenn eine Aktivität erkannt wird.
Siehe:
-
Oracle AI Database Administrator's Guide und Oracle Call Interface Developer's Guide, um mehr über DRCP zu erfahren
Übersicht über die Programmschnittstelle
Die Programmschnittstelle ist die Softwareschicht zwischen einer Datenbankanwendung und Oracle AI Database.
Die Programmschnittstelle führt folgende Funktionen aus:
-
Bietet eine Sicherheitsbarriere und verhindert den destruktiven Zugriff auf die SGA durch Clientprozesse
-
fungiert als Kommunikationsmechanismus, formatiert Informationsanforderungen, übergibt Daten und fängt Fehler ab und gibt sie zurück
-
Konvertiert und übersetzt Daten, insbesondere zwischen verschiedenen Computertypen oder in externe Benutzerprogrammdatentypen
Der Oracle-Code fungiert als Server und führt Datenbankaufgaben im Namen einer Anwendung (eines Clients) aus, wie das Abrufen von Zeilen aus Datenblöcken. Die Programmschnittstelle besteht aus mehreren Teilen, die sowohl von der Oracle AI Database-Software als auch von betriebssystemspezifischer Software bereitgestellt werden.
-
Programmschnittstellenstruktur Die Programmschnittstelle besteht aus mehreren verschiedenen Komponenten.
-
Programmschnittstellentreiber Ein Treiber ist eine Software, die Daten in der Regel über ein Netzwerk transportiert.
-
Kommunikationssoftware für das Betriebssystem Die Software der untersten Ebene, die den Benutzer mit der Oracle AI Database-Seite der Programmschnittstelle verbindet, ist die Kommunikationssoftware, die das Hostbetriebssystem bereitstellt.
Programmschnittstellenstruktur
Die Programmschnittstelle besteht aus mehreren verschiedenen Komponenten.
Diese Komponenten umfassen unter anderem:
-
Oracle Call Interface (OCI) oder die Oracle Runtime Library (SQLLIB)
-
Die Client- oder Benutzerseite der Programmschnittstelle
-
Verschiedene Oracle Net Services-Treiber (protocol-spezifische Kommunikationssoftware)
-
Kommunikationssoftware für Betriebssysteme
-
Server- oder Oracle AI Database-Seite der Programmschnittstelle (auch als OPI bezeichnet)
Die Benutzer- und Oracle AI Database-Seiten der Programmschnittstelle führen Oracle-Software aus, ebenso wie die Treiber.
Programmschnittstellentreiber
Ein Treiber ist eine Software, die Daten in der Regel über ein Netzwerk transportiert.
Treiber führen Vorgänge wie Verbinden, Trennen, Signalfehler aus und testen auf Fehler. Treiber sind spezifisch für ein Kommunikationsprotokoll.
Es ist immer ein Standardtreiber vorhanden. Sie können mehrere Treiber installieren, z. B. die asynchronen oder DECnet-Treiber, und einen als Standardtreiber auswählen. Ein Benutzer kann jedoch andere Treiber verwenden, indem er beim Verbinden einen Treiber angibt.
Verschiedene Prozesse können unterschiedliche Treiber verwenden. Ein Prozess kann über gleichzeitige Verbindungen zu einer einzelnen Datenbank oder zu mehreren Datenbanken verfügen, die verschiedene Oracle Net Services-Treiber verwenden.
Siehe:
-
Ihr Systeminstallations- und Konfigurationshandbuch für Details zur Auswahl, Installation und zum Hinzufügen von Treibern
-
Oracle AI Database Net Services Administrator's Guide für Informationen zu JDBC-Treibern
Kommunikationssoftware für das Betriebssystem
Die Software der untersten Ebene, die den Benutzer mit der Oracle AI Database-Seite der Programmschnittstelle verbindet, ist die Kommunikationssoftware, die das Hostbetriebssystem bereitstellt.
Beispiele sind DECnet, TCP/IP, LU6.2 und ASYNC. Die Kommunikationssoftware kann von Oracle bereitgestellt werden, wird jedoch in der Regel separat vom Hardwareanbieter oder einem Softwareanbieter eines Drittanbieters erworben.
Überblick über Oracle True Cache
True Cache ist ein speicherresidenter, schreibgeschützter Cache vor einer Oracle AI Database.
Wie Oracle Active Data Guard ist True Cache ein voll funktionsfähiges, schreibgeschütztes Replikat der primären Datenbank, mit der Ausnahme, dass es größtenteils plattenlos ist.
Moderne Anwendungen erfordern oft eine hohe Anzahl von Verbindungen und einen schnellen, latenzarmen Zugriff auf die Daten. Ein gängiger Ansatz besteht darin, Caches vor der Datenbank zu platzieren, da Anwendungen in der Regel viel mehr Lesevorgänge als Updates ausführen und aus dem Cache lesen können, ohne die Datenbankperformance zu beeinträchtigen. Zum Beispiel liest ein Flugreservierungssystem häufig Daten, wenn Menschen Flüge kaufen, und es ist in Ordnung, wenn die Daten nicht die aktuellsten im Vergleich zu den Daten in der Datenbank sind. Die Anwendung muss nur dann auf die aktuellsten Daten zugreifen, wenn jemand einen Flug reserviert.
Im Gegensatz zu herkömmlichen Caches speichert True Cache automatisch die Daten, auf die am häufigsten zugegriffen wird, im Cache. Dadurch bleibt der Cache konsistent mit der primären Datenbank, anderen Objekten im selben Cache und anderen Caches. Es cacht alle Oracle AI Database-Objekte und -Datentypen, einschließlich JSON.
Da True Cache Sicherheits-Policys von Oracle AI Database implementiert, können Sie den Zugriff auf den Cache kontrollieren. Auf diese Weise können Sie sensible Daten, wie private persönliche Informationen, zwischenspeichern, die Sie normalerweise nicht cachen.
Verwandte Themen