Prozessarchitektur
In diesem Kapitel werden die Prozesse in einer Oracle-Datenbank erläutert.
-
Einführung in Prozesse Ein Prozess ist ein Mechanismus in einem Betriebssystem, der eine Reihe von Schritten ausführen kann.
-
Überblick über Clientprozesse Wenn ein Benutzer eine Anwendung wie ein Pro*C-Programm oder SQL*Plus ausführt, erstellt das Betriebssystem einen Clientprozess (auch als Benutzerprozess bezeichnet), um die Benutzeranwendung auszuführen. Mit der Clientanwendung sind Oracle AI Database-Librarys verknüpft, die die APIs bereitstellen, die für die Kommunikation mit der Datenbank erforderlich sind.
-
Überblick über Serverprozesse Oracle AI Database erstellt Serverprozesse, um die Anforderungen von Clientprozessen zu verarbeiten, die mit der Instanz verbunden sind. Ein Client-Prozess kommuniziert immer über einen separaten Server-Prozess mit einer Datenbank.
-
Überblick über Hintergrundprozesse Hintergrundprozesse sind zusätzliche Prozesse, die von einer Oracle-Datenbank mit mehreren Prozessen verwendet werden. Die Hintergrundprozesse führen Wartungsaufgaben aus, die erforderlich sind, um die Datenbank zu betreiben und die Performance für mehrere Benutzer zu maximieren.
Einführung in Prozesse
Ein Prozess ist ein Mechanismus in einem Betriebssystem, der eine Reihe von Schritten ausführen kann.
Die Architektur der Prozessausführung hängt vom Betriebssystem ab. Beispiel: Unter Windows ist ein Oracle-Hintergrundprozess ein Ausführungs-Thread innerhalb eines Prozesses. Unter Linux und UNIX ist ein Oracle-Prozess entweder ein Betriebssystemprozess oder ein Thread innerhalb eines Betriebssystemprozesses.
Prozesse führen Codemodule aus. Alle verbundenen Oracle AI Database-Benutzer müssen die folgenden Module ausführen, um auf eine Datenbankinstanz zuzugreifen:
-
Anwendungs- oder Oracle AI Database-Utility
Ein Datenbankbenutzer führt eine Datenbankanwendung aus, z.B. ein Precompiler-Programm oder ein Datenbanktool wie SQL*Plus, das SQL-Anweisungen an eine Datenbank abgibt.
-
Oracle-Datenbankcode
Jeder Benutzer hat Oracle-Datenbankcode, der in seinem Namen ausgeführt wird und die SQL-Anweisungen der Anwendung interpretiert und verarbeitet.
Ein Prozess wird normalerweise in einem eigenen privaten Speicherbereich ausgeführt. Die meisten Prozesse können regelmäßig in eine zugehörige Trace-Datei schreiben.
-
Prozesstypen Eine Datenbankinstanz enthält oder interagiert mit mehreren Prozessen.
-
Multiprozess- und Multithread-Oracle AI Database-Systeme Multiprozess Oracle AI Database (auch Mehrbenutzer-Oracle AI Database genannt) verwendet mehrere Prozesse, um verschiedene Teile des Oracle AI Database-Codes und zusätzliche Oracle-Prozesse für die Benutzer auszuführen - entweder einen Prozess für jeden verbundenen Benutzer oder einen oder mehrere Prozesse, die von mehreren Benutzern gemeinsam verwendet werden.
Prozesstypen
Eine Datenbankinstanz enthält oder interagiert mit mehreren Prozessen.
Prozesse sind in folgende Typen unterteilt:
-
Ein Clientprozess führt die Anwendung oder den Oracle-Toolcode aus.
-
Ein Oracle-Prozess ist eine Ausführungseinheit, in der der Oracle-Datenbankcode ausgeführt wird. In der Multithread-Architektur kann ein Oracle-Prozess ein Betriebssystemprozess oder ein Thread innerhalb eines Betriebssystemprozesses sein. Oracle-Prozesse umfassen die folgenden Subtypen:
-
Ein Hintergrundprozess beginnt mit der Datenbankinstanz und führt Wartungsaufgaben aus, wie Instanz-Recovery, Bereinigung von Prozessen, Schreiben von Redo-Puffern auf Datenträger usw.
-
Ein Serverprozess führt Arbeiten basierend auf einer Clientanforderung aus.
Beispiel: Diese Prozesse parsen SQL-Abfragen, platzieren sie im gemeinsam verwendeten Pool, erstellen und führen einen Abfrageplan für jede Abfrage aus und lesen Puffer aus dem Datenbankpuffercache oder von der Festplatte.
Hinweis: Serverprozesse und der in diesen Prozessen zugewiesene Prozessspeicher werden in der Datenbankinstanz ausgeführt. Die Instanz funktioniert weiterhin, wenn Serverprozesse beendet werden.
-
Ein untergeordneter Prozess führt zusätzliche Aufgaben für einen Hintergrund- oder Serverprozess aus.
-
Die Prozessstruktur variiert je nach Betriebssystem und der Auswahl der Oracle AI Database-Optionen. Beispiel: Sie können den Code für verbundene Benutzer für dedizierte Server- oder Shared Server-Verbindungen konfigurieren. In einer Shared Server-Architektur kann jeder Server-Prozess, der Datenbankcode ausführt, mehrere Client-Prozesse bedienen. Abbildung 18-1 zeigt eine System Global Area (SGA) und Hintergrundprozesse, die dedizierte Serververbindungen verwenden. Für jede Benutzerverbindung führt ein Clientprozess die Anwendung aus. Dieser Client-Prozess unterscheidet sich von dem dedizierten Server-Prozess, der den Datenbankcode ausführt. Jeder Clientprozess ist mit einem eigenen Serverprozess verknüpft, der über einen eigenen Programm-Global Area (PGA) verfügt.
Abbildung 1: Oracle-Prozesse und SGA
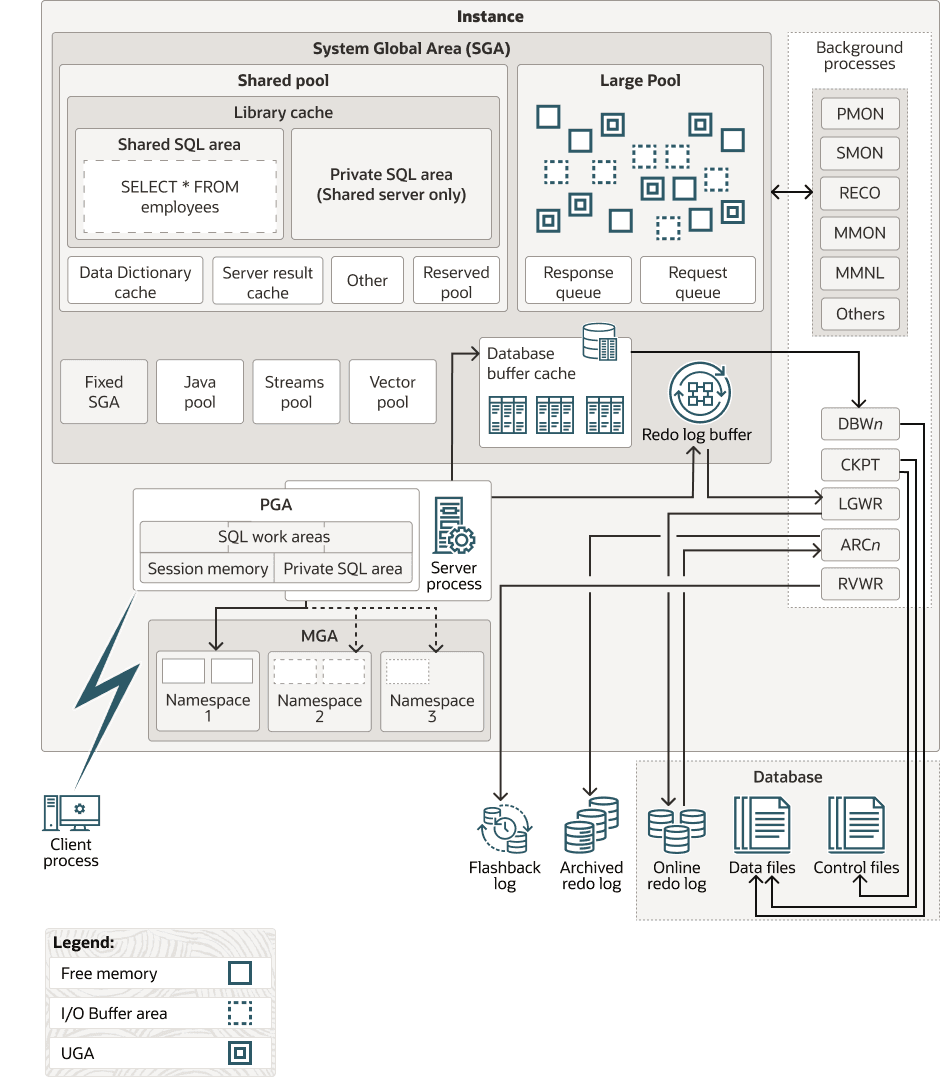
Beschreibung der Abbildung cncpt283.png
Siehe:
-
"Dedicated Server Architecture" und "Shared Server Architecture"
-
Weitere Informationen zu den Konfigurationsoptionen finden Sie in der betriebssystemspezifischen Dokumentation zu Oracle AI Database
-
Oracle AI Database-Referenz zur
V$PROCESS-Ansicht
Multiprozess- und Multithread-Systeme von Oracle AI Database
Oracle AI Database mit mehreren Prozessen (auch als Mehrbenutzer-Oracle AI Database bezeichnet) verwendet mehrere Prozesse, um verschiedene Teile des Oracle AI Database-Codes und zusätzliche Oracle-Prozesse für die Benutzer auszuführen - entweder einen Prozess für jeden verbundenen Benutzer oder einen oder mehrere Prozesse, die von mehreren Benutzern gemeinsam verwendet werden.
Die meisten Datenbanken sind mehrbenutzerfähig, da ein primärer Vorteil einer Datenbank darin besteht, Daten zu verwalten, die von mehreren Benutzern gleichzeitig benötigt werden. Jeder Prozess in einer Datenbankinstanz führt einen bestimmten Job aus. Durch die Aufteilung der Arbeit der Datenbank und der Anwendungen in mehrere Prozesse können sich mehrere Benutzer und Anwendungen gleichzeitig bei einer Instanz anmelden, während das System eine gute Performance bietet.
In Releases vor Oracle Database 12c wurden Oracle-Prozesse nicht als Threads auf UNIX- und Linux-Systemen ausgeführt. Ab Oracle Database 12c ermöglicht das Multithreaded Oracle AI Database-Modell die Ausführung von Oracle-Prozessen als Betriebssystem-Threads in separaten Adressräumen. Wenn Oracle AI Database installiert ist, wird die Datenbank im Prozessmodus ausgeführt. Sie müssen den Initialisierungsparameter THREADED_EXECUTION auf TRUE setzen, um die Datenbank im Thread-Modus auszuführen. Im Thread-Modus werden einige Hintergrundprozesse unter UNIX und Linux als Prozesse ausgeführt (jeder Prozess enthält einen Thread), während die restlichen Oracle-Prozesse als Threads innerhalb von Prozessen ausgeführt werden.
In einer Datenbank, die im Thread-Modus ausgeführt wird, können PMON und DBW als Betriebssystemprozesse ausgeführt werden, während LGWR und CMON als Threads innerhalb eines einzelnen Prozesses ausgeführt werden können. Zwei Vordergrundprozesse und ein PX-Serverprozess (Parallel Execution) können als Threads in einem zweiten Betriebssystemprozess ausgeführt werden. Ein dritter Betriebssystemprozess kann mehrere Vordergrundthreads enthalten. Daher bedeutet "Oracle-Prozess" nicht immer "Betriebssystemprozess". Hinweis: Wenn der Initialisierungsparameter THREADED_EXECUTION auf TRUE gesetzt ist, wird die Betriebssystemauthentifizierung nicht unterstützt.
Beispiel 18-1: Oracle Process-Metadaten anzeigen
Die View V$PROCESS enthält eine Zeile für jeden Oracle-Prozess, der mit einer Datenbankinstanz verbunden ist. Beispiel: Sie können die folgende Abfrage in SQL*Plus ausführen, um die Betriebssystemprozess-ID und die Betriebssystem-Thread-ID für jeden Prozess abzurufen:
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
Die Abfrage ergibt die folgende Teilprobenausgabe:
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
Siehe:
-
Oracle AI Database Performance Tuning Guide zum Verwenden der
V$PROCESS-Ansicht -
Oracle AI Database Reference zum
THREADED_EXECUTION-Initialisierungsparameter
Übersicht über Clientprozesse
Wenn ein Benutzer eine Anwendung wie ein Pro*C-Programm oder SQL*Plus ausführt, erstellt das Betriebssystem einen Clientprozess (auch als Benutzerprozess bezeichnet), um die Benutzeranwendung auszuführen. Mit der Clientanwendung sind Oracle AI Database-Librarys verknüpft, die die APIs bereitstellen, die für die Kommunikation mit der Datenbank erforderlich sind.
-
Client- und Serverprozesse Clientprozesse unterscheiden sich auf wichtige Weise von den Oracle-Prozessen, die direkt mit der Instanz interagieren.
-
Verbindungen und Sessions Eine Datenbank-Verbindung ist ein physischer Kommunikationspfad zwischen einem Clientprozess und einer Datenbankinstanz.
-
Aktueller Container Eine Datenbanksession ist eine logische Entity im Speicher der Datenbankinstanz, die den Status einer aktuellen Benutzeranmeldung bei einer Datenbank darstellt.
-
Datenbankvorgänge Im Kontext der Datenbanküberwachung stellt ein Datenbankvorgang eine Sessionaktivität zwischen zwei Zeitpunkten dar, wie von den Endbenutzern oder dem Anwendungscode definiert.
Client- und Serverprozesse
Clientprozesse unterscheiden sich auf wichtige Weise von den Oracle-Prozessen, die direkt mit der Instanz interagieren.
Die Oracle-Prozesse, die den Client-Prozess bedienen, können aus der SGA lesen und in diese schreiben, während der Client-Prozess dies nicht tun kann. Ein Clientprozess kann auf einem anderen Host als dem Datenbankhost ausgeführt werden, Oracle-Prozesse hingegen nicht.
Beispiel: Ein Benutzer auf einem Clienthost startet SQL*Plus und meldet sich dann über das Netzwerk bei der Datenbank sample auf einem anderen Host an, wenn die Datenbankinstanz nicht gestartet wird:
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.
Auf dem Clienthost zeigt eine Suche nach den Prozessen für sqlplus oder sample nur den sqlplus-Clientprozess an:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436  0 15:40 pts/1    00:00:00 sqlplus           as sysdba
Auf dem Datenbankhost zeigt eine Suche nach den Prozessen für sqlplus oder sample einen Serverprozess mit einer nicht-lokalen Verbindung, jedoch ohne Clientprozess:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441     1  0 15:40 ?        00:00:00 oraclesample (LOCAL=NO)
Siehe auch: "Instanz gestartet", um zu erfahren, wie ein Client eine Verbindung zu einer Datenbank herstellen kann, wenn die Instanz nicht gestartet wird
Verbindungen und Sitzungen
Eine Datenbankverbindung ist ein physischer Kommunikationspfad zwischen einem Clientprozess und einer Datenbankinstanz.
Während einer Verbindung wird ein Kommunikationspfad mithilfe verfügbarer prozessübergreifender Kommunikationsmechanismen oder Netzwerksoftware eingerichtet. In der Regel erfolgt eine Verbindung zwischen einem Clientprozess und einem Serverprozess oder Dispatcher. Sie kann jedoch auch zwischen einem Clientprozess und Oracle Connection Manager (CMAN) erfolgen.
Aktueller Container
Eine Datenbanksession ist eine logische Entity im Speicher der Datenbankinstanz, die den Status einer aktuellen Benutzeranmeldung bei einer Datenbank darstellt.
Beispiel: Wenn ein Benutzer von der Datenbank mit einem Kennwort authentifiziert wird, wird für diesen Benutzer eine Session eingerichtet. Eine Session dauert von dem Zeitpunkt an, an dem der Benutzer von der Datenbank authentifiziert wird, bis der Benutzer die Datenbankanwendung abmeldet oder beendet.
Sessions und Container
Für eine bestimmte Session ist der aktuelle Container in der CDB derjenige, in dem eine Session ausgeführt wird. Der aktuelle Container kann die CDB-Root, eine Anwendungs-Root oder eine PDB sein.
Jede Sitzung hat jeweils genau einen aktuellen Container. Da das Data Dictionary in jedem Container separat ist, verwendet Oracle AI Database das Data Dictionary im aktuellen Container zur Namensauflösung und Berechtigungsautorisierung.
Beziehung zwischen Verbindungen und Sessions
Eine einzelne Verbindung kann 0, 1 oder mehr Sessions enthalten. Die Sessions sind unabhängig: Ein Commit in einer Session wirkt sich nicht auf Transaktionen in anderen Sessions aus.
Hinweis: Wenn Oracle Net Verbindungspooling konfiguriert ist, kann eine Verbindung gelöscht werden, aber die Sessions bleiben intakt.
Für einen einzelnen Datenbankbenutzer können mehrere Sessions gleichzeitig vorhanden sein. Wie in der folgenden Abbildung dargestellt, kann der Benutzer hr mehrere Verbindungen zu einer Datenbank haben. Bei dedizierten Serververbindungen erstellt die Datenbank für jede Verbindung einen Serverprozess. Nur der Clientprozess, durch den der dedizierte Server erstellt wird, verwendet ihn. Bei einer Shared Server-Verbindung greifen viele Client-Prozesse auf einen einzelnen Shared Server-Prozess zu.
Abbildung 2: Eine Sitzung für jede Verbindung
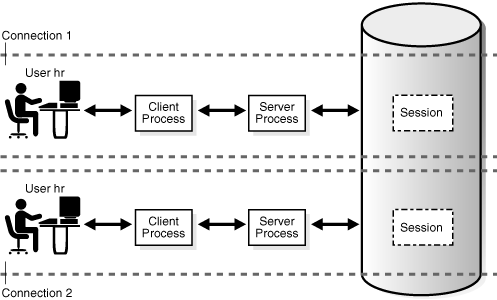
Beschreibung der Abbildung cncpt237.gif
In Abbildung 18-3 wird ein Fall dargestellt, in dem der Benutzer hr eine einzelne Verbindung zu einer Datenbank hat, diese Verbindung jedoch zwei Sessions aufweist.
Abbildung 3: Zwei Sessions in einer Verbindung
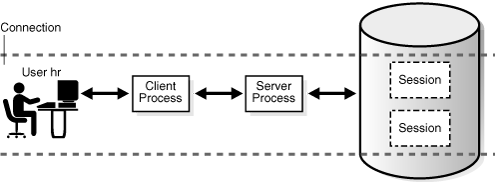
Beschreibung der Abbildung cncpt238.gif
Wenn Sie einen Autotrace-Bericht mit Ausführungsstatistiken für SQL-Anweisungen generieren, wird das Szenario in Abbildung 18-3 neu erstellt.
Der Befehl DISCONNECT in Beispiel 18-2 beendet die Sessions, nicht die Verbindung.
Beispiel 18-2: Verbindungen und Sessions
Im folgenden Beispiel wird SQL*Plus als Benutzer SYSTEM bei der Datenbank angemeldet und ermöglicht das Tracing. Dadurch wird eine neue Session erstellt (Beispielausgabe enthalten):
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECT
Der Befehl DISCONNECT beendet die Sessions, nicht die Verbindung. Wenn Sie ein neues Terminal öffnen und eine Verbindung zur Instanz als anderer Benutzer herstellen, zeigt die folgende Abfrage an, dass die Verbindung mit der Adresse 3BE2E41C noch aktiv ist.
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)
Siehe auch: "Shared Server-Architektur"
Datenbankvorgänge
Im Kontext der Datenbanküberwachung ist ein Datenbankvorgang eine Sessionaktivität zwischen zwei Zeitpunkten, wie von den Endbenutzern oder dem Anwendungscode definiert.
Ein einfacher Datenbankvorgang ist entweder eine einzelne SQL-Anweisung oder eine einzelne PL/SQL-Prozedur oder -Funktion. Ein Zusammengesetzter Datenbankvorgang ist ein Set aus einzelnen oder zusammengesetzten Vorgängen.
Um Aufgaben zu überwachen, zu vergleichen und zu optimieren, können Sie eine große Gruppe von Aufgaben in Datenbankvorgänge aufteilen und Vorgänge in Phasen unterteilen. Ein Anwendungsfall ist ein PL/SQL-Batchjob, der langsamer als normal ausgeführt wird. Wenn Sie den Job als Datenbankvorgang konfigurieren, können Sie die kostspieligen Schritte im Job identifizieren und optimieren.
Jede Ausführung eines Datenbankvorgangs wird eindeutig durch ein Attributpaar identifiziert: Vorgangsname und Ausführungs-ID. Eine Session kann einen Datenbankvorgang in einer anderen Session starten oder stoppen, indem ihre Session-ID und Seriennummer angegeben werden.
Zwei Vorkommen desselben Datenbankvorgangs können gleichzeitig mit demselben Namen, aber unterschiedlichen Ausführungs-IDs ausgeführt werden. Jede Ausführung eines Datenbankvorgangs mit demselben Namen kann unterschiedliche Anweisungen enthalten.
Sie erstellen und verwalten Datenbankvorgänge mit dem PL/SQL-Package DBMS_SQL_MONITOR. Sie können Vorgänge mit V$SQL_MONITOR, V$SQL_PLAN_MONITOR und V$SQL_MONITOR_SESSTAT überwachen.
Siehe:
-
Oracle AI Database SQL Tuning Guide zum Überwachen von Datenbankvorgängen
-
Oracle AI Database Data Warehousing Guide zum Überwachen von Lasten mit langer Ausführungszeit
-
Oracle AI Database PL/SQL Packages and Types Reference, um mehr über
DBMS_SQL_MONITORzu erfahren -
Oracle AI Database Reference, um mehr über
V$SQL_MONITORzu erfahren
Übersicht über Serverprozesse
Oracle AI Database erstellt Serverprozesse, um die Anforderungen von Clientprozessen zu verarbeiten, die mit der Instanz verbunden sind. Ein Client-Prozess kommuniziert immer über einen separaten Server-Prozess mit einer Datenbank.
Serverprozesse, die für eine Datenbankanwendung erstellt werden, können eine oder mehrere der folgenden Aufgaben ausführen:
-
Durch die Anwendung abgesetzte SQL-Anweisungen parsen und ausführen, einschließlich Erstellen und Ausführen des Abfrageplans
-
PL/SQL-Code ausführen
-
Datenblöcke aus Datendateien in den Datenbank-Buffer-Cache lesen (der DBW-Hintergrundprozess hat die Aufgabe, geänderte Blöcke wieder auf Platte zu schreiben)
-
Ergebnisse so zurückgeben, dass die Anwendung die Informationen verarbeiten kann
-
Dedizierte Serverprozesse Bei dedizierten Serververbindungen wird die Clientverbindung mit einem einzigen Serverprozess verknüpft.
-
Shared Server-Prozesse Bei Shared Server-Verbindungen stellen Clientanwendungen über ein Netzwerk eine Verbindung zu einem Dispatcher-Prozess und nicht zu einem Server-Prozess her. Beispiel: 20 Clientprozesse können eine Verbindung zu einem einzelnen Dispatcher-Prozess herstellen.
-
So erstellt Oracle AI Database Serverprozesse Die Datenbank erstellt Serverprozesse auf verschiedene Weise, je nach Verbindungsmethoden. Siehe auch: "Stufen der SQL-Verarbeitung"
Dedizierte Serverprozesse
Bei dedizierten Serververbindungen wird die Clientverbindung mit einem einzigen Serverprozess verknüpft.
Unter Linux werden 20 Clientprozesse, die mit einer Datenbankinstanz verbunden sind, von 20 Serverprozessen bedient. Jeder Client-Prozess kommuniziert direkt mit seinem Server-Prozess. Dieser Server-Prozess ist seinem Client-Prozess für die Dauer der Session zugewiesen. Der Serverprozess speichert prozessspezifische Informationen und die UGA in seiner PGA.
Shared Server-Prozesse
Bei Shared Server-Verbindungen stellen Clientanwendungen über ein Netzwerk eine Verbindung zu einem Dispatcher-Prozess und nicht zu einem Serverprozess her. Beispiel: 20 Clientprozesse können eine Verbindung zu einem einzelnen Dispatcher-Prozess herstellen.
Der Dispatcher-Prozess empfängt Anforderungen von verbundenen Clients und stellt sie in eine Request Queue im Large Pool. Der erste verfügbare Shared Server-Prozess nimmt die Anforderung aus der Queue und verarbeitet sie. Anschließend platziert der Shared Server das Ergebnis in die Dispatcher Response Queue. Der Dispatcher-Prozess überwacht diese Queue und überträgt das Ergebnis an den Client.
Wie ein dedizierter Serverprozess verfügt ein Shared Server-Prozess über eine eigene PGA. Die UGA für eine Session befindet sich jedoch in der MGA, sodass jeder Shared Server auf Sessiondaten zugreifen kann.
Siehe:
So erstellt Oracle AI Database Serverprozesse
Die Datenbank erstellt je nach Verbindungsmethode Serverprozesse auf unterschiedliche Weise.
Die Verbindungsmethoden lauten wie folgt:
-
Bequeath
SQL*Plus, ein OCI-Client oder eine andere Clientanwendung startet den Serverprozess direkt.
-
Oracle Net-Listener
Die Clientanwendung stellt über einen Listener eine Verbindung zur Datenbank her.
-
Dedizierter Broker
Dies ist ein Datenbankprozess, der Vordergrundprozesse erstellt. Im Gegensatz zum Listener befindet sich der Broker in der Datenbankinstanz. Wenn Sie einen dedizierten Broker verwenden, stellt der Client eine Verbindung zum Listener her, der die Verbindung dann an den dedizierten Broker weiterleitet.
Wenn eine Verbindung nicht Bequeath verwendet, erstellt die Datenbank den Serverprozess wie folgt:
-
Die Clientanwendung fordert eine neue Verbindung vom Listener oder Broker an.
-
Der Listener oder Broker initiiert die Erstellung eines neuen Prozesses oder Threads.
-
Das Betriebssystem erstellt den neuen Prozess oder Thread.
-
Oracle AI Database initialisiert verschiedene Komponenten und Benachrichtigungen.
-
Die Datenbank übergibt den verbindungs- und verbindungsspezifischen Code.
Wenn Sie optional die dedizierte Broker-Verbindungsmethode verwenden, können Sie einen Pool von Serverprozessen mit dem Package DBMS_PROCESS vorab erstellen. In diesem Fall überwacht der Process Manager-(PMAN-)Hintergrundprozess den Pool der vorab erstellten Prozesse, die auf die Zuordnung zu einer Clientanforderung warten. Wenn eine Verbindung einen Serverprozess erfordert, überspringt die Datenbank die Schritte 2 bis 4 der Prozesserstellung und führt nur den 5. Schritt aus. Diese Optimierung verbessert die Leistung.
Hinweis:
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zum PL/SQL-Package
DBMS_PROCESS -
Oracle AI Database Reference zum PMAN-Hintergrundprozess
Übersicht über Hintergrundprozesse
Hintergrundprozesse sind zusätzliche Prozesse, die von einer Oracle-Datenbank mit mehreren Prozessen verwendet werden. Die Hintergrundprozesse führen Wartungsaufgaben aus, die erforderlich sind, um die Datenbank zu betreiben und die Performance für mehrere Benutzer zu maximieren.
Jeder Hintergrundprozess hat eine eigene Aufgabe, arbeitet jedoch mit den anderen Prozessen zusammen. Beispiel: Der LGWR-Prozess schreibt Daten aus dem Redo Log Buffer in das Online-Redo Log. Wenn eine gefüllte Redo Log-Datei zur Archivierung bereit ist, signalisiert LGWR einen anderen Prozess zur Archivierung der Redo Log-Datei.
Oracle AI Database erstellt automatisch Hintergrundprozesse, wenn eine Datenbankinstanz gestartet wird. Eine Instanz kann viele Hintergrundprozesse aufweisen, die nicht alle immer in jeder Datenbankkonfiguration vorhanden sind. Die folgende Abfrage listet die Hintergrundprozesse auf, die in Ihrer Datenbank ausgeführt werden:
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
Es werden folgende Themen behandelt:
-
Erforderliche Hintergrundprozesse Obligatorische Hintergrundprozesse sind in allen typischen Datenbankkonfigurationen vorhanden.
-
Optionale Hintergrundprozesse Ein optionaler Hintergrundprozess ist ein beliebiger Hintergrundprozess, der nicht als obligatorisch definiert ist.
-
Sekundäre Prozesse Sekundäre Prozesse sind Hintergrundprozesse, die im Auftrag anderer Prozesse arbeiten. Siehe auch: Oracle AI Database Reference für Beschreibungen aller Hintergrundprozesse
Erforderliche Hintergrundprozesse
Obligatorische Hintergrundprozesse sind in allen typischen Datenbankkonfigurationen vorhanden.
Diese Prozesse werden standardmäßig in einer Datenbankinstanz mit Lese-/Schreibzugriff ausgeführt, die mit einer minimal konfigurierten Initialisierungsparameterdatei gestartet wurde. Eine schreibgeschützte Datenbankinstanz deaktiviert einige dieser Prozesse.
In diesem Abschnitt werden die folgenden obligatorischen Hintergrundprozesse beschrieben:
-
Process Monitor Process-(PMON-)Gruppe Die PMON-Gruppe umfasst PMON, Cleanup Main Process (CLMN) und Cleanup Helper Processes (CLnn). Diese Prozesse sind für die Überwachung und Bereinigung anderer Prozesse verantwortlich.
-
Process Manager (PMAN) Process Manager (PMAN) überwacht verschiedene Hintergrundprozesse, darunter Shared Server, Pool-Server und Jobqueueprozesse.
-
Listener-Registrierungsprozess (LREG) Der Listener-Registrierungsprozess (LREG) registriert Informationen über die Datenbankinstanz und Dispatcher-Prozesse beim Oracle Net Listener.
-
System Monitor-Prozess (SMON) Der System Monitor-Prozess (SMON) übernimmt eine Reihe von Bereinigungsaufgaben auf Systemebene.
-
Database Writer-Prozess (DBW) Der Database Writer-Prozess (DBW) schreibt den Inhalt von Datenbankpuffern in Datendateien. DBW verarbeitet geänderte Schreibpuffer im Datenbankpuffercache auf Platte.
-
Log Writer-Prozess (LGWR) Der Log Writer-Prozess (LGWR) verwaltet den Online-Redo-Logpuffer.
-
Checkpoint Process (CKPT) Der Checkpoint-Prozess (CKPT) aktualisiert die Header der Kontrolldatei und der Datendatei mit Checkpoint-Informationen und signalisiert DBW, Blöcke auf den Datenträger zu schreiben. Checkpoint-Informationen umfassen die Checkpoint-Position, SCN und den Speicherort im Online Redo Log, um mit dem Recovery zu beginnen.
-
Manageability Monitor-Prozesse (MMON und MMNL) Der Manageability Monitor-Prozess (MMON) führt viele Aufgaben im Zusammenhang mit dem Automatic Workload Repository (AWR) aus.
-
Recoverer-Prozess (RECO) In einer verteilten Datenbank löst der Recoverer-Prozess (RECO) automatisch Fehler in verteilten Transaktionen auf.
-
Hintergrundprozess (BGnn) Der Hintergrundprozess (BGnn) ist ein standardmäßiger Hintergrundprozess in Oracle RAC-Umgebungen, der verschiedene Wartungs- und Überwachungsaufgaben ausführt.
-
Virtual Operating System Daemon Process (VOSD) Der virtuelle Betriebssystem-Daemon-Prozess (VOSD) führt zeitgebundene Aktionen des Oracle-Datenbankservice aus.
-
Network Monitor Process (NMON) Der Network Monitor-Prozess (NMON) ist ein einfacher Netzwerküberwachungsservice.
Siehe:
-
Oracle AI Database-Referenz für Beschreibungen anderer obligatorischer Prozesse, einschließlich MMAN, DIAG, VKTM, DBRM und PSP0
-
Oracle Real Application Clusters Administration and Deployment Guide und Oracle Clusterware Administration and Deployment Guide für weitere Informationen zu Hintergrundprozessen für Oracle RAC und Oracle Clusterware
Process Monitor-Prozessgruppe (PMON)
Die PMON-Gruppe umfasst PMON, Cleanup Main Process (CLMN) und Cleanup Helper Processes (CLnn). Diese Prozesse sind für die Überwachung und Bereinigung anderer Prozesse verantwortlich.
Die PMON-Gruppe überwacht die Bereinigung des Buffer Caches und die Freigabe von Ressourcen, die von einem Client-Prozess verwendet werden. Beispiel: Die PMON-Gruppe ist dafür verantwortlich, den Status der aktiven Transaktionstabelle zurückzusetzen, nicht mehr benötigte Sperren freizugeben und die Prozess-ID der beendeten Prozesse aus der Liste der aktiven Prozesse zu entfernen.
Die Datenbank muss sicherstellen, dass Ressourcen, die von beendeten Prozessen gehalten werden, freigegeben werden, damit sie von anderen Prozessen verwendet werden können. Andernfalls kann der Prozess blockiert oder in Konflikten stecken bleiben.
-
Process Monitor Process (PMON) Process Monitor (PMON) erkennt die Beendigung anderer Hintergrundprozesse. Wenn ein Server- oder Dispatcher-Prozess nicht ordnungsgemäß beendet wird, ist die PMON-Gruppe für das Prozess-Recovery verantwortlich. Prozessbeendigung kann mehrere Ursachen haben, einschließlich Befehle zum Beenden des Betriebssystems oder
ALTER SYSTEM KILL SESSION-Anweisungen. -
Hauptprozess bereinigen (CLMN) PMON delegiert Bereinigungsarbeiten an den Hauptprozess für die Bereinigung (Cleanup Main Process, CLMN). Die Aufgabe, eine anormale Beendigung zu erkennen, bleibt bei PMON.
-
Cleanup Helper Processes (CLnn) CLMN delegiert Bereinigungsarbeit an die CLnn-Helperprozesse.
-
Datenbankressourcenquarantäne Wenn ein Prozess oder eine Session beendet wird, gibt die PMON-Gruppe die gespeicherten Ressourcen für die Datenbank frei. In einigen Fällen kann die PMON-Gruppe beschädigte, nicht behebbare Ressourcen automatisch unter Quarantäne stellen, sodass die Datenbankinstanz nicht sofort zum Beenden gezwungen wird.
Prozessüberwachung (PMON)
Der Process Monitor (PMON) erkennt die Beendigung anderer Hintergrundprozesse. Wenn ein Server- oder Dispatcher-Prozess nicht ordnungsgemäß beendet wird, ist die PMON-Gruppe für das Prozess-Recovery verantwortlich. Prozessbeendigung kann mehrere Ursachen haben, einschließlich Befehle zum Beenden des Betriebssystems oder ALTER SYSTEM KILL SESSION-Anweisungen.
Hauptprozess bereinigen (CLMN)
PMON delegiert Bereinigungsarbeiten an den Cleanup-Hauptprozess (CLMN). Die Aufgabe, eine anormale Beendigung zu erkennen, bleibt bei PMON.
CLMN führt in regelmäßigen Abständen Bereinigungen von beendeten Prozessen, beendeten Sessions, Transaktionen, Netzwerkverbindungen, inaktiven Sessions, getrennten Transaktionen und getrennten Netzwerkverbindungen durch, die ihren Leerlauf-Timeout überschritten haben.
Helper-Prozesse bereinigen (CLnn)
CLMN delegiert Bereinigungsarbeiten an die CLnn-Helperprozesse.
Die CLnn-Prozesse unterstützen die Bereinigung beendeter Prozesse und Sessions. Die Anzahl der Helferprozesse ist proportional zur Menge der durchzuführenden Bereinigungsarbeiten und der aktuellen Effizienz der Bereinigung.
Ein Bereinigungsprozess kann blockiert werden, wodurch verhindert wird, dass andere Prozesse bereinigt werden. Wenn mehrere Prozesse bereinigt werden müssen, kann die Bereinigungszeit von Bedeutung sein. Aus diesen Gründen kann Oracle AI Database mehrere Helper-Prozesse parallel zur Bereinigung verwenden und so die langsame Performance reduzieren.
Die Views V$CLEANUP_PROCESS und V$DEAD_CLEANUP enthalten Metadaten zur CLMN-Bereinigung. Die Ansicht V$CLEANUP_PROCESS enthält eine Zeile für jeden Bereinigungsprozess. Beispiel: Wenn V$CLEANUP_PROCESS.STATE BUSY ist, wird der Prozess derzeit bereinigt.
Siehe auch: Oracle AI Database Reference, um mehr über V$CLEANUP_PROCESS zu erfahren
Datenbankressourcenquarantäne
Wenn ein Prozess oder eine Session beendet wird, gibt die PMON-Gruppe die bereitgestellten Ressourcen für die Datenbank frei. In einigen Fällen kann die PMON-Gruppe beschädigte, nicht behebbare Ressourcen automatisch unter Quarantäne stellen, sodass die Datenbankinstanz nicht sofort zum Beenden gezwungen wird.
Die PMON-Gruppe führt weiterhin so viel Bereinigung wie möglich für den Prozess oder die Session durch, in dem bzw. der die unter Quarantäne gestellte Ressource gespeichert war. Die Ansicht V$QUARANTINE enthält Metadaten wie den Ressourcentyp, die belegte Speichermenge, den Oracle-Fehler, der die Quarantäne verursacht usw.
Siehe auch: Oracle AI Database Reference, um mehr über V$QUARANTINE zu erfahren
Prozessmanager (PMAN)
Process Manager (PMAN) überwacht mehrere Hintergrundprozesse, darunter Shared Server, Pool-Server und Jobqueueprozesse.
PMAN überwacht, startet und stoppt die folgenden Prozesstypen:
-
Dispatcher- und Shared Server-Prozesse
-
Connection Broker- und Pool-Serverprozesse für datenbankresidente Connection Pools
-
Jobqueueprozesse
-
Neustartbare Hintergrundprozesse
Listener-Registrierungsprozess (LREG)
Der Listener-Registrierungsprozess (LREG) registriert Informationen über die Datenbankinstanz und Dispatcher-Prozesse beim Oracle Net Listener.
Wenn eine Instanz gestartet wird, fragt LREG den Listener ab, um zu bestimmen, ob sie ausgeführt wird. Wenn der Listener ausgeführt wird, übergibt LREG die relevanten Parameter. Wenn er nicht ausgeführt wird, versucht LREG regelmäßig, ihn zu kontaktieren.
Hinweis: In Releases vor Oracle Database 12c hat PMON die Listener-Registrierung ausgeführt.
Siehe auch: "Oracle Net Listener"
System Monitor-Prozess (SMON)
Der System Monitor-Prozess (SMON) übernimmt eine Reihe von Bereinigungsaufgaben auf Systemebene.
Zu den Aufgaben von SMON gehören:
-
Instanz-Recovery wird gegebenenfalls beim Hochfahren der Instanz ausgeführt. In einer Oracle RAC-Datenbank kann der SMON-Prozess einer Datenbankinstanz ein Instanz-Recovery für eine ausgefallene Instanz ausführen.
-
Beendete Transaktionen wiederherstellen, die beim Instanz-Recovery aufgrund von Dateilese- oder Tablespace-Offlinefehlern übersprungen wurden. SMON stellt die Transaktionen wieder her, wenn der Tablespace oder die Datei wieder online gesetzt wird.
-
Nicht verwendete temporäre Segmente in permanenten Tablespaces werden bereinigt. Beispiel: Oracle AI Database weist Extents zu, wenn ein Index erstellt wird. Wenn der Vorgang fehlschlägt, bereinigt SMON den temporären Speicherplatz.
-
Zusammenhängende freie Extents innerhalb von Dictionary-verwalteten Tablespaces zusammenführen
SMON prüft regelmäßig, ob sie benötigt wird. Andere Prozesse können SMON aufrufen, wenn sie einen Bedarf dafür erkennen.
Database Writer-Prozess (DBW)
Der Database Writer-Prozess (DBW) schreibt den Inhalt von Datenbankpuffern in Datendateien. DBW verarbeitet geänderte Schreibpuffer im Datenbankpuffercache auf Platte.
Obwohl ein Database Writer-Prozess (DBW0) für die meisten Systeme geeignet ist, können Sie zusätzliche Prozesse konfigurieren - DBW1 bis DBW9, DBWa bis DBWz und BW36 bis BW99 - um die Schreibperformance zu verbessern, wenn Ihr System Daten stark ändert. Diese zusätzlichen DBW-Prozesse sind für Nicht-Prozessorsysteme nicht nützlich.
Der DBW-Prozess schreibt Dirty Buffer unter den folgenden Bedingungen auf den Datenträger:
-
Wenn ein Serverprozess keinen sauberen wiederverwendbaren Puffer finden kann, nachdem ein Schwellwert von Puffer gescannt wurde, signalisiert er, dass DBW geschrieben werden muss. DBW schreibt Dirty-Puffer asynchron auf Platte, wenn möglich während einer anderen Verarbeitung.
-
DBW schreibt regelmäßig Puffer, um den Checkpoint voranzubringen. Dies ist die Position im Redo-Thread, von dem das Instanz-Recovery beginnt. Die Logposition des Checkpoints wird durch den ältesten Dirty Buffer im Puffercache bestimmt.
In vielen Fällen sind die Blöcke, die DBW schreibt, über den gesamten Datenträger verteilt. Daher sind die Schreibvorgänge tendenziell langsamer als die sequenziellen Schreibvorgänge von LGWR. DBW führt nach Möglichkeit Multiblock-Schreibvorgänge aus, um die Effizienz zu verbessern. Die Anzahl der in einem Multiblock-Schreibvorgang geschriebenen Blöcke variiert je nach Betriebssystem.
Siehe:
-
Informationen zum Konfigurieren, Überwachen und Optimieren von DBW finden Sie in der Oracle AI Database Performance Tuning Guide.
Log Writer-Prozess (LGWR)
Der Log Writer-Prozess (LGWR) verwaltet den Online-Redo-Logpuffer.
LGWR schreibt einen Teil des Buffers in das Online Redo Log. Durch das Trennen der Aufgaben beim Ändern von Datenbankpuffern, das Durchführen verstreuter Schreibvorgänge von Dirty-Puffern auf Platte und das schnelle sequenzielle Schreiben von Redo-Daten auf Platte verbessert die Datenbank die Performance.
In den folgenden Fällen schreibt LGWR alle Redo-Einträge, die seit dem letzten Schreibvorgang in den Puffer kopiert wurden:
-
Ein Benutzer schreibt eine Transaktion fest.
-
Ein Online-Redo-Log Switch wird ausgeführt.
-
Drei Sekunden sind vergangen, seit LGWR zuletzt geschrieben hat.
-
Der Redo Log-Puffer ist ein Drittel voll oder enthält 1 MB gepufferte Daten.
-
DBW muss geänderte Puffer auf Datenträger schreiben.
Bevor DBW einen Dirty-Puffer schreiben kann, muss die Datenbank die Redo-Datensätze, die mit Änderungen am Puffer verknüpft sind, auf Datenträger schreiben (das Write-Ahead-Protokoll). Wenn DBW feststellt, dass einige Redo-Datensätze nicht geschrieben wurden, signalisiert es LGWR, die Datensätze auf den Datenträger zu schreiben, und wartet, bis LGWR abgeschlossen ist, bevor die Datenpuffer auf den Datenträger geschrieben werden.
-
LGWR and Commits Oracle AI Database verwendet einen Fast Commit-Mechanismus, um die Performance für festgeschriebene Transaktionen zu verbessern.
-
LGWR- und nicht zugängliche Dateien LGWR schreibt synchron in die aktive gespiegelte Gruppe von Online-Redo-Logdateien. Siehe auch: "Commits of Transactions"
LGWR und Commits
Oracle AI Database verwendet einen Fast Commit-Mechanismus, um die Performance für festgeschriebene Transaktionen zu verbessern.
Wenn ein Benutzer eine COMMIT-Anweisung ausgibt, wird der Transaktion eine System Change Number (SCN) zugewiesen. LGWR fügt einen Commit-Datensatz in den Redo Log-Puffer ein und schreibt ihn sofort zusammen mit der Commit-SCN und den Redo-Einträgen der Transaktion auf den Datenträger.
Der Redo Log-Puffer ist zirkulär. Wenn LGWR Redo-Einträge aus dem Redo Logpuffer in eine Online Redo Log-Datei schreibt, können Serverprozesse neue Einträge über die Einträge im Redo Log-Puffer kopieren, die auf Platte geschrieben wurden. LGWR schreibt normalerweise schnell genug, um sicherzustellen, dass im Puffer stets Platz für neue Einträge verfügbar ist, selbst wenn stark auf das Redo-Log zugegriffen wird.
Der atomare Schreibvorgang des Redo-Eintrags, der den Commit-Datensatz der Transaktion enthält, ist das einzige Ereignis, das bestimmt, dass die Transaktion festgeschrieben wurde. Oracle AI Database gibt einen Erfolgscode an die Commit-Transaktion zurück, obwohl die Datenpuffer noch nicht auf den Datenträger geschrieben wurden. Die entsprechenden Änderungen an Datenblöcken werden verzögert, bis DBW sie effizient in die Datendateien schreiben kann.
Hinweis: LGWR kann Redo-Logeinträge auf Datenträger schreiben, bevor eine Transaktion festgeschrieben wird. Änderungen, die durch die Redo-Einträge geschützt werden, werden nur dann dauerhaft, wenn die Transaktion später festgeschrieben wird.
Wenn die Aktivität hoch ist, kann LGWR Group Commits verwenden. Beispiel: Ein Benutzer schreibt fest, wodurch LGWR die Redo-Einträge der Transaktion auf den Datenträger schreibt. Während dieses Schreibvorgangs schreiben andere Benutzer fest. LGWR kann nicht auf Datenträger schreiben, um diese Transaktionen festzuschreiben, bis der vorherige Schreibvorgang abgeschlossen ist. Nach Abschluss kann LGWR die Liste der Redo-Einträge wartender Transaktionen (noch nicht festgeschrieben) in einem Vorgang schreiben. Auf diese Weise minimiert die Datenbank das Platten-I/O und maximiert die Performance. Wenn Commit-Anforderungen mit einer hohen Rate fortgesetzt werden, kann jeder Schreibvorgang von LGWR mehrere Commit-Datensätze enthalten.
LGWR und unzugängliche Dateien
LGWR schreibt synchron in die aktive gespiegelte Gruppe von Online Redo Log-Dateien.
Wenn auf eine Logdatei nicht zugegriffen werden kann, schreibt LGWR weiterhin in andere Dateien in der Gruppe und schreibt einen Fehler in die LGWR-Tracedatei und das Alertlog. Wenn alle Dateien in einer Gruppe beschädigt sind oder die Gruppe nicht verfügbar ist, weil sie nicht archiviert wurde, kann LGWR nicht weiter funktionieren.
Siehe:
-
"So schreibt Oracle AI Database in das Online-Redo-Log" und "Redo-Logpuffer"
-
Oracle AI Database Performance Tuning Guide für Informationen zum Überwachen und Optimieren der Performance von LGWR
Checkpoint-Prozess (CKPT)
Der Checkpoint-Prozess (CKPT) aktualisiert die Header der Kontrolldatei und der Datendatei mit Checkpoint-Informationen und signalisiert DBW, Blöcke auf Datenträger zu schreiben. Checkpoint-Informationen umfassen die Checkpoint-Position, SCN und den Speicherort im Online Redo Log, um mit dem Recovery zu beginnen.
Wie in Abbildung 18-4 dargestellt, schreibt CKPT keine Datenblöcke in Datendateien oder Redo-Blöcke in Online-Redo-Logdateien.
Abbildung 4: Checkpoint-Prozess
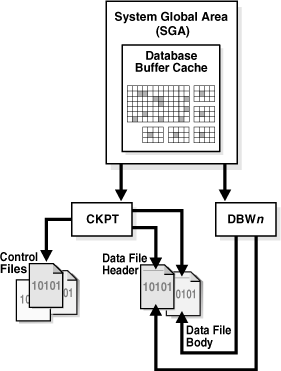
Beschreibung der Abbildung cncpt228.gif
Siehe auch: "Überblick über Checkpoints"
Manageability Monitor-Prozesse (MMON und MMNL)
Der Manageability Monitor-Prozess (MMON) führt viele Aufgaben im Zusammenhang mit dem Automatic Workload Repository (AWR) aus.
Beispiel: MMON schreibt, wenn eine Metrik den Schwellenwert verletzt, Snapshots erstellt und Statistikwerte für zuletzt geänderte SQL-Objekte erfasst werden.
Der Manageability Monitor Lite-Prozess (MMNL) schreibt Statistiken aus dem Active Session History-(ASH-)Buffer in der SGA auf Platte. MMNL schreibt auf Platte, wenn der ASH-Puffer voll ist.
Siehe auch: "Oracle AI Database - Erste Schritte mit Performance Tuning" und "Überblick über die aktive Sessionhistorie"
Recoverer-Prozess (RECO)
In einer verteilten Datenbank löst der Recoverer-Prozess (RECO) automatisch Fehler in verteilten Transaktionen auf.
Der RECO-Prozess eines Knotens stellt automatisch eine Verbindung zu anderen Datenbanken her, die an einer verteilten zweifelhaften Transaktion beteiligt sind. Wenn RECO eine Verbindung zwischen den Datenbanken wieder herstellt, werden automatisch alle in-doubt-Transaktionen aufgelöst, und alle Zeilen, die den aufgelösten Transaktionen entsprechen, werden aus der Tabelle der ausstehenden Transaktionen jeder Datenbank entfernt.
Siehe auch: Oracle AI Database Administrator's Guide für weitere Informationen zur Transaktionswiederherstellung in verteilten Systemen
Hintergrundprozess (BG nn)
Der Hintergrundprozess (BGnn) ist ein standardmäßiger Hintergrundprozess in Oracle RAC-Umgebungen, der verschiedene Wartungs- und Überwachungsaufgaben ausführt.
Der Hintergrundprozess ist für die Puffercacheverwaltung, Log Writer-(LGWR-)Prozessunterstützung, Checkpointkoordination, Hintergrundprozessüberwachung und Statistiksammlung verantwortlich.
Virtual Operating System Daemon Process (VOSD)
Der virtuelle Betriebssystem-Daemon-Prozess (VOSD) führt zeitgebundene Oracle-Datenbankserviceaktionen aus.
Dieser Prozess wird beim Hochfahren der Instanz gestartet und ist für die Ausführung von Systemdienstaktionen verantwortlich, die für die Datenbank kritisch sind. Dieser Prozess wird von Datenbankinstanzen, Oracle ASM-Instanzen und Oracle RAC verwendet.
Netzwerküberwachungsprozess (NMON)
Der Network Monitor Process (NMON) ist ein einfacher Netzwerküberwachungsservice.
Network Monitor (NMON) ist ein Netzwerküberwachungsservice mit geringem Overhead, der erweiterte Kernel-Funktionen nutzt, um eine stets aktive, umfassende Überwachung bereitzustellen. Es erfasst kontinuierlich Netzwerkstatistiken und -ereignisse auf mehreren Ebenen, einschließlich systemweit, pro Schnittstelle, pro IP und pro Fluss, und stellt detaillierte Metriken für Services auf höherer Ebene bereit. Der Health Score-Service basiert auf NMON und vereinfacht die Bewertung der Netzwerkintegrität mit einem standardisierten Score von 0 bis 100 und adressiert proaktiv Probleme, indem er bei Bedarf Diagnosen sammelt. NMON bietet effiziente und umsetzbare Netzwerkstatistiken, die eine rechtzeitige Erkennung von Anomalien und eine effektive Korrelation mit Datenbankaktivitäten ermöglichen.
Optionale Hintergrundprozesse
Ein optionaler Hintergrundprozess ist ein beliebiger Hintergrundprozess, der nicht als erforderlich definiert ist.
Die meisten optionalen Hintergrundprozesse sind spezifisch für Aufgaben oder Features. Beispiel: Hintergrundprozesse, die Oracle ASM unterstützen, sind nur verfügbar, wenn diese Funktion aktiviert ist.
In diesem Abschnitt werden einige allgemeine optionale Prozesse beschrieben:
-
Archiver-Prozesse (ARCn) Ein Archiver-Prozess (ARCn) kopiert Online-Redo-Logdateien in den Offlinespeicher, nachdem ein Redo-Logwechsel erfolgt ist.
-
Jobqueue-Prozesse (CJQ0 und Jnnn) Ein Queue-Prozess führt Benutzerjobs aus, die sich häufig im Batchmodus befinden. Ein Job ist eine benutzerdefinierte Aufgabe, die ein- oder mehrmals ausgeführt werden soll.
-
Flashback Data Archive Process (FBDA) Der Flashback Data Archive-Prozess (FBDA) archiviert historische Zeilen von überwachten Tabellen in Flashback Data Archives.
-
Space Management Coordinator Process (SMCO) Der SMCO-Prozess (Space Management Coordinator Process) wird von SMON gestartet und koordiniert die Ausführung verschiedener Aufgaben im Zusammenhang mit der Speicherplatzverwaltung.
Siehe:
-
Oracle AI Database Transactional Event Queues and Advanced Queuing - Benutzerhandbuch für eine Einführung in Advanced Queuing (AQ)
-
Oracle AI Database-Referenz für Beschreibungen von Hintergrundprozessen für AQ und Oracle ASM
Archiver-Prozesse (ARC n)
Ein archiver-Prozess (ARCn) kopiert Online-Redo-Logdateien in den Offlinespeicher, nachdem ein Redo-Logwechsel erfolgt ist.
Diese Prozesse können auch Transaktions-Redo-Daten erfassen und an Standbydatenbank-Ziele übertragen. ARCn-Prozesse sind nur vorhanden, wenn sich die Datenbank im ARCHIVELOG-Modus befindet und die automatische Archivierung aktiviert ist.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie die Anzahl der Archivierungsprozesse anpassen können
-
Oracle AI Database Performance Tuning Guide zum Optimieren der Archivierungsperformance
Jobqueueprozesse (CJQ0 und Jnnn)
Ein Queueprozess führt Benutzerjobs aus, die sich häufig im Batchmodus befinden. Ein Job ist eine benutzerdefinierte Aufgabe, die ein- oder mehrmals ausgeführt werden soll.
Beispiel: Sie können eine Jobqueue verwenden, um ein Update mit langer Ausführungszeit im Hintergrund zu planen. Bei einem Startdatum und einem Zeitintervall versuchen die Jobqueueprozesse, den Job beim nächsten Vorkommen des Intervalls auszuführen.
Oracle AI Database verwaltet Jobqueueprozesse dynamisch, sodass Jobqueueclients bei Bedarf mehr Jobqueueprozesse verwenden können. Die Datenbank gibt Ressourcen frei, die von den neuen Prozessen verwendet werden, wenn sie im Leerlauf sind.
Dynamische Jobqueueprozesse können in einem bestimmten Intervall viele Jobs gleichzeitig ausführen. Die Reihenfolge der Ereignisse ist wie folgt:
-
Der Job Coordinator-Prozess (CJQ0) wird nach Bedarf von Oracle Scheduler automatisch gestartet und gestoppt. Der Koordinatorprozess wählt regelmäßig Jobs aus, die aus der Systemtabelle
JOB$ausgeführt werden müssen. Die ausgewählten neuen Jobs werden nach Zeit sortiert. -
Der Koordinatorprozess startet dynamisch untergeordnete Prozesse der Jobqueue (Jnnn), um die Jobs auszuführen.
-
Der Jobqueueprozess führt einen der Jobs aus, die vom Prozess CJQ0 zur Ausführung ausgewählt wurden. Jeder Jobqueueprozess führt jeweils einen Job aus.
-
Nachdem der Prozess die Ausführung eines einzelnen Jobs abgeschlossen hat, sucht er nach weiteren Jobs. Wenn keine Jobs zur Ausführung geplant sind, wechselt sie in einen Ruhezustand, aus dem sie in regelmäßigen Abständen aufwacht und weitere Jobs abfragt. Wenn der Prozess keine neuen Jobs findet, wird er nach einem voreingestellten Intervall beendet.
Der Initialisierungsparameter JOB_QUEUE_PROCESSES stellt die maximale Anzahl von Jobqueueprozessen dar, die gleichzeitig auf einer Instanz ausgeführt werden können. Clients dürfen jedoch nicht davon ausgehen, dass alle Jobqueueprozesse für die Jobausführung verfügbar sind. Hinweis: Der Koordinatorprozess wird nicht gestartet, wenn der Initialisierungsparameter JOB_QUEUE_PROCESSES auf 0 gesetzt ist.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über Oracle Scheduler zu erfahren
-
Oracle AI Database Transactional Event Queues and Advanced Queuing - Benutzerdokumentation für Informationen zu AQ-Hintergrundprozessen
Flashback Data Archive Process (FBDA)
Der Flashback Data Archive-Prozess (FBDA) archiviert historische Zeilen von überwachten Tabellen in Flashback Data Archives.
Wenn eine Transaktion, die DML in einer verfolgten Tabelle enthält, festgeschrieben wird, speichert dieser Prozess das Pre-Image der geänderten Zeilen im Flashback Data Archive. Außerdem werden Metadaten in den aktuellen Zeilen gespeichert.
FBDA verwaltet das Flashback Data Archive automatisch für Speicherplatz, Organisation und Aufbewahrung. Darüber hinaus verfolgt der Prozess, wie lange die Archivierung von verfolgten Transaktionen stattgefunden hat.
Space Management Coordinator Process (SMCO)
Der SMCO-Prozess (Space Management Coordinator Process) wird von SMON gestartet und koordiniert die Ausführung verschiedener Aufgaben im Zusammenhang mit der Speicherplatzverwaltung.
Der SMCO-Prozess koordiniert die Ausführung verschiedener Aufgaben im Zusammenhang mit der Speicherplatzverwaltung.
Typische Aufgaben umfassen die proaktive Speicherplatzzuweisung und -freigabe sowie die Verwaltung von temporären Tablespaces. SMCO startet dynamisch untergeordnete Prozesse (Wnn) zur Implementierung der Aufgabe.
Siehe auch: Oracle AI Database Development Guide enthält Informationen zum Flashback Data Archive und zum Feature "Zeitliche Historie".
Sekundäre Prozesse
Sekundäre Prozesse sind Hintergrundprozesse, die Arbeiten für andere Prozesse ausführen.
In diesem Abschnitt werden einige sekundäre Prozesse beschrieben, die von Oracle AI Database verwendet werden.
-
I/O-Sekundärprozesse I/O-Sekundärprozesse (Innn) simulieren asynchrones I/O für Systeme und Geräte, die es nicht unterstützen.
-
PX-Serverprozesse (Parallel Execution) Bei der parallelen Ausführung arbeiten mehrere Prozesse gleichzeitig zusammen, um eine einzelne SQL-Anweisung auszuführen. Siehe auch: Oracle AI Database Reference für Beschreibungen der sekundären Prozesse von Oracle AI Database.
Sekundäre I/O-Prozesse
Sekundäre I/O-Prozesse (Innn) simulieren asynchrones I/O für Systeme und Geräte, die es nicht unterstützen.
Bei asynchronem I/O gibt es keine zeitliche Anforderung für die Übertragung, sodass andere Prozesse gestartet werden können, bevor die Übertragung abgeschlossen ist.
Beispiel: Eine Anwendung schreibt 1000 Blöcke auf eine Festplatte auf einem Betriebssystem, das kein asynchrones I/O unterstützt. Jeder Schreibvorgang erfolgt sequenziell und wartet auf eine Bestätigung, dass der Schreibvorgang erfolgreich war. Bei einem asynchronen Datenträger kann die Anwendung die Blöcke im Bulkverfahren schreiben und andere Aufgaben ausführen, während sie auf eine Antwort des Betriebssystems wartet, die besagt, dass alle Blöcke geschrieben wurden.
Um asynchrones I/O zu simulieren, überwacht ein Prozess mehrere sekundäre Prozesse. Der ausführende Prozess weist jedem sekundären Prozess Arbeit zu. Er wartet, bis jeder Schreibvorgang abgeschlossen ist, und meldet den ausführenden Prozess. Bei echtem asynchronem I/O wartet das Betriebssystem, bis das I/O abgeschlossen ist, und berichtet an den Prozess zurück. Bei simuliertem asynchronem I/O warten die sekundären Prozesse und melden sich an den ausführenden Benutzer zurück.
Die Datenbank unterstützt verschiedene Typen von sekundären I/O-Prozessen, darunter:
-
Sekundäre I/O-Prozesse für Recovery Manager (RMAN)
Wenn Sie mit RMAN Daten sichern oder wiederherstellen, können Sie sekundäre I/O-Prozesse sowohl für Datenträger- als auch für Band-Devices verwenden.
-
Sekundäre Prozesse für Database Writer
Wenn es nicht praktisch ist, mehrere Database Writer-Prozesse zu verwenden, z. B. wenn der Computer über eine CPU verfügt, kann die Datenbank I/O über mehrere sekundäre Prozesse verteilen. DBW ist der einzige Prozess, der die LRU-Liste des Puffercaches auf Blöcke durchsucht, die auf den Datenträger geschrieben werden sollen. Sekundäre I/O-Prozesse führen jedoch I/O für diese Blöcke aus.
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch, um mehr über sekundäre I/O-Prozesse für Backup- und Restore-Vorgänge zu erfahren
-
Oracle AI Database Performance Tuning Guide, um mehr über sekundäre Prozesse für Database Writer zu erfahren
PX-Serverprozesse (Parallel Execution)
Bei der parallelen Ausführung arbeiten mehrere Prozesse gleichzeitig zusammen, um eine einzelne SQL-Anweisung auszuführen.
Durch die Aufteilung der Arbeit auf mehrere Prozesse kann Oracle AI Database die Anweisung schneller ausführen. Beispiel: Vier Prozesse verarbeiten vier unterschiedliche Quartale eines Jahres, statt einem Prozess alle vier Quartale selbst zu übertragen.
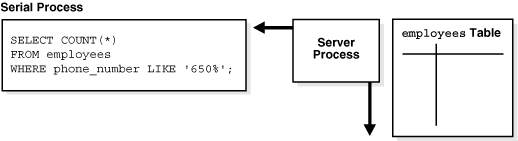
Die parallele Ausführung steht im Gegensatz zur Serienausführung, bei der ein einzelner Serverprozess die gesamte erforderliche Verarbeitung für die sequenzielle Ausführung einer SQL-Anweisung ausführt. Beispiel: Um einen vollständigen Tabellenscan wie SELECT * FROM employees durchzuführen, führt ein Serverprozess die gesamte Arbeit aus, wie in Abbildung 18-5 dargestellt.
Abbildung 5: Vollständiger serieller Tabellenscan
Beschreibung der Abbildung cncpt016.gif
Die parallele Ausführung reduziert die Reaktionszeit für datenintensive Vorgänge in großen Datenbanken wie Data Warehouses. Symmetrisches Multiprocessing (SMP) und geclustertes System profitieren von der parallelen Ausführung am meisten, da die Anweisungsverarbeitung auf mehrere CPUs aufgeteilt werden kann. Die parallele Ausführung kann auch von bestimmten Typen von OLTP und Hybrid-Systemen profitieren.
In Oracle RAC-Systemen kontrolliert die Serviceplatzierung eines bestimmten Service die parallele Ausführung. Insbesondere werden parallele Prozesse auf den Knoten ausgeführt, auf denen der Service konfiguriert ist. Standardmäßig führt Oracle AI Database parallele Prozesse nur auf einer Instanz aus, die den Service für die Anmeldung bei der Datenbank anbietet. Dies wirkt sich nicht auf andere parallele Vorgänge wie paralleles Recovery oder die Verarbeitung von GV$-Abfragen aus.
-
Abfragekoordinator Bei der parallelen Ausführung fungiert der Serverprozess als Abfragekoordinator (auch als Koordinator für parallele Ausführung bezeichnet).
-
Producer und Consumer Parallel Execution Server sind in Producer und Consumer unterteilt. Die Hersteller sind dafür verantwortlich, ihre Daten zu verarbeiten und dann an die Verbraucher zu verteilen, die sie benötigen.
-
Granules Bei der parallelen Ausführung wird eine Tabelle dynamisch in Ladeeinheiten unterteilt. Jede Einheit, die als Granule bezeichnet wird, ist die kleinste Arbeitseinheit beim Zugriff auf Daten.
Siehe:
-
Oracle AI Database VLDB and Partitioning Guide, um mehr über die parallele Ausführung zu erfahren
-
Oracle Real Application Clusters Administration and Deployment Guide für Überlegungen zur parallelen Ausführung in Oracle RAC-Umgebungen
Abfragekoordinator
Bei der parallelen Ausführung fungiert der Serverprozess als Abfragekoordinator (auch als Parallel Execution Coordinator bezeichnet).
Der Abfragekoordinator ist für Folgendes verantwortlich:
-
Abfragen parsen
-
Prozesse des Parallel Execution Servers zuweisen und steuern
-
Ausgabe wird an den Benutzer gesendet
Bei einem Abfrageplan für eine Abfrage gliedert der Koordinator jeden Operator in einer SQL-Abfrage in parallele Teile auf, führt sie in der in der Abfrage angegebenen Reihenfolge aus und integriert die Teilergebnisse, die von den Parallel Execution-Servern erzeugt werden, welche die Operatoren ausführen.
Die Anzahl von Prozessen für die Parallelverarbeitung, die einem einzelnen Vorgang zugewiesen ist, entspricht einem Parallelitätsgrad für einen Vorgang. Mehrere Vorgänge innerhalb derselben SQL-Anweisung haben alle denselben Parallelitätsgrad.
Erzeuger und Verbraucher
Server für die parallele Ausführung sind in Producer und Consumer unterteilt. Die Hersteller sind dafür verantwortlich, ihre Daten zu verarbeiten und dann an die Verbraucher zu verteilen, die sie benötigen.
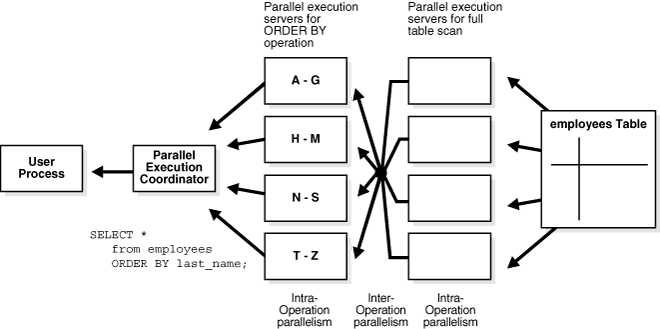
Die Datenbank kann die Verteilung mit einer Vielzahl von Techniken durchführen. Zwei gängige Techniken sind eine Sendung und ein Hash. Bei einer Übertragung sendet jeder Producer die Zeilen an alle Consumer. In einem Hash berechnet die Datenbank eine Hash-Funktion für eine Schlüsselgruppe und macht jeden Consumer für eine Teilmenge von Hash-Werten verantwortlich. Abbildung 18-6 stellt das Zusammenspiel zwischen Producern und Consumern bei der parallelen Ausführung der folgenden Anweisung dar:
SELECT * FROM employees ORDER BY last_name;Der Ausführungsplan implementiert einen vollständigen Scan der Tabelle employees. Auf den Scan folgt eine Art der abgerufenen Zeilen. Alle Producer-Prozesse, die am Scanvorgang beteiligt sind, senden Zeilen an den entsprechenden Consumer-Prozess, der die Sortierung durchführt.
Abbildung 6: Producer und Consumer
Beschreibung der Abbildung vldbg013.gif
Granulat
Bei der parallelen Ausführung wird eine Tabelle dynamisch in Ladeeinheiten unterteilt. Jede Einheit, die als Granule bezeichnet wird, ist die kleinste Arbeitseinheit beim Zugriff auf Daten.
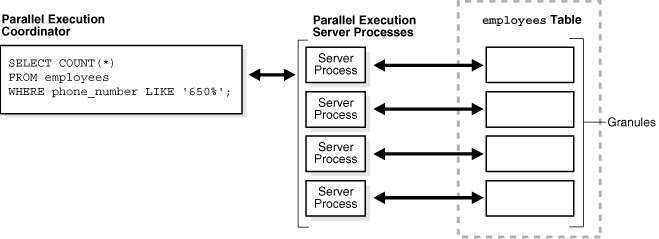
Ein blockbasiertes Granulat ist ein Bereich von Datenblöcken der Tabelle, die von einem einzelnen Parallel Execution Server (auch als PX-Server bezeichnet) gelesen werden. Dabei wird Pnnn als Namensformat verwendet. Um eine gleichmäßige Verteilung der Arbeit auf parallele Serverprozesse zu erreichen, ist die Anzahl der Granulate immer viel höher als der angeforderte DOP. Abbildung 18-7 zeigt einen parallelen Scan der Tabelle employees.
Abbildung 7: Paralleler Full Table Scan
Beschreibung der Abbildung cncpt017.gif
Die Datenbank ordnet Granulate zur Ausführungszeit parallelen Ausführungsservern zu. Wenn ein Server für die parallele Ausführung die Zeilen liest, die einem Granulat entsprechen, und wenn Granulate verbleiben, erhält er ein weiteres Granulat vom Abfragekoordinator. Dieser Vorgang wird fortgesetzt, bis die Tabelle gelesen wurde. Die Ausführungsserver senden Ergebnisse zurück an den Koordinator, der die Teile in den gewünschten vollständigen Tabellenscan zusammenfasst.
Siehe:
-
Oracle AI Database VLDB and Partitioning Guide enthält Informationen zur Verwendung der parallelen Ausführung
-
Oracle AI Database Data Warehousing Guide mit Informationen zu empfohlenen Initialisierungsparametern für Parallelität