Speicherarchitektur
In diesem Kapitel wird die Speicherarchitektur einer Datenbankinstanz erläutert.
-
Einführung in Oracle AI Database-Speicherstrukturen Wenn eine Instanz gestartet wird, weist Oracle AI Database einen Speicherbereich zu und startet Hintergrundprozesse.
-
Überblick über die System Global Area (SGA) Die SGA ist ein Lese-/Schreibspeicherbereich, der zusammen mit den Oracle-Hintergrundprozessen eine Datenbankinstanz bildet.
-
Überblick über die Program Global Area (PGA) Die PGA ist speicherspezifisch für einen Betriebssystemprozess oder Thread, der nicht von anderen Prozessen oder Threads im System gemeinsam verwendet wird. Da die PGA prozessspezifisch ist, wird sie niemals in der SGA zugewiesen.
-
Überblick über den globalen Benutzerbereich Die UGA ist der Sessionspeicher, der Sessionvariablen zugewiesen wird, wie Anmeldeinformationen und andere Informationen, die für eine Datenbanksession erforderlich sind. Im Wesentlichen speichert die UGA den Sessionzustand.
-
Überblick über die Managed Global Area (MGA) Die Managed Global Area (MGA) ist ein einzigartiges Speicher-Framework, mit dem Speicher über eine Reihe vertrauenswürdiger Oracle-Prozesse hinweg gemeinsam genutzt und koordiniert werden kann.
-
Überblick über Softwarecodebereiche Ein Softwarecodebereich ist ein Teil des Speichers, in dem Code gespeichert ist, der ausgeführt wird oder ausgeführt werden kann. Oracle AI Database-Code wird in einem Softwarebereich gespeichert, der in der Regel exklusiver und geschützter ist als der Speicherort von Benutzerprogrammen. Siehe auch: Oracle AI Database Administrator's Guide enthält Anweisungen zum Konfigurieren und Verwalten von Arbeitsspeicher.
Arbeitsspeicherstrukturen in Oracle AI Database - Einführung
Wenn eine Instanz gestartet wird, weist Oracle AI Database einen Speicherbereich zu und startet Hintergrundprozesse.
Im Speicherbereich werden Informationen wie die folgenden gespeichert:
-
Programmcode
-
Informationen zu jeder verbundenen Session, auch wenn sie derzeit nicht aktiv ist
-
Informationen, die während der Programmausführung benötigt werden, z.B. der aktuelle Status einer Abfrage, aus der Zeilen abgerufen werden
-
Informationen wie Sperren von Daten, die von Prozessen gemeinsam genutzt und kommuniziert werden
-
Zwischengespeicherte Daten, wie Datenblöcke und Redo-Datensätze, die ebenfalls auf dem Datenträger vorhanden sind
-
Grundlegende Arbeitsspeicherstrukturen Oracle AI Database umfasst mehrere Speicherbereiche, von denen jede mehrere Unterkomponenten enthält.
-
Die Speicherverwaltung von Oracle AI Database Memory Management umfasst die Aufrechterhaltung optimaler Größen für die Speicherstrukturen für die Oracle-Instanz, während sich Anforderungen an die Datenbank ändern. Oracle AI Database verwaltet den Speicher basierend auf den Einstellungen der speicherbezogenen Initialisierungsparameter. Siehe auch: "Prozessarchitektur"
Grundlegende Arbeitsspeicherstrukturen
Oracle AI Database umfasst mehrere Speicherbereiche, die jeweils mehrere Unterkomponenten enthalten.
Die grundlegenden Speicherstrukturen, die mit Oracle AI Database verknüpft sind, umfassen:
-
System-Global Area (SGA)
Die SGA ist eine Gruppe von Shared Memory-Strukturen, die als SGA-Komponenten bezeichnet werden und Daten und Kontrollinformationen für eine Oracle AI Database-Instanz enthalten. Alle Server- und Hintergrundprozesse verwenden die SGA gemeinsam. Beispiele für in der SGA gespeicherte Daten sind gecachte Datenblöcke und Shared SQL-Bereiche.
-
Programm-Global Area (PGA)
Eine PGA ist ein nicht gemeinsam verwendeter Speicherbereich, der Daten und Kontrollinformationen enthält, die ausschließlich von einem Oracle-Prozess verwendet werden. Oracle AI Database erstellt die PGA, wenn ein Oracle-Prozess gestartet wird.
Für jeden Serverprozess und Hintergrundprozess ist eine PGA vorhanden. Die Sammlung einzelner PGAs ist die gesamte Instanz-PGA oder Instanz-PGA. Datenbankinitialisierungsparameter legen die Größe der Instanz-PGA fest, nicht einzelne PGAs.
-
User Global Area (UGA)
Die UGA ist Speicher, der einer Benutzersession zugeordnet ist.
-
Managed Global Area (MGA)
Die MGA ist eine Semi-Shared Memory-Komponente, die von einer Oracle AI Database-Instanz verwendet wird. Es kann Speicher für eine kleine Gruppe vertrauenswürdiger Oracle-Prozesse freigeben und koordinieren. Es kann konfiguriert, elastisch, modular, bedarfsgesteuert und wiederverwendet werden. Im Gegensatz zur SGA können Oracle AI Database-Module wählen, welche Prozesse diesem Bereich zugeordnet sind und dieses Verhalten dynamisch ist.
-
Softwarecodebereiche
Software-Codebereiche sind Teile des Speichers, die zum Speichern von Code verwendet werden, der ausgeführt wird oder ausgeführt werden kann. Oracle AI Database-Code wird in einem Softwarebereich gespeichert, der sich in der Regel an einem anderen Ort als Benutzerprogramme befindet – einem exklusiveren oder geschützten Ort.
Die folgende Abbildung veranschaulicht die Beziehungen zwischen diesen Gedächtnisstrukturen.
Abbildung 1: Oracle AI Database - Arbeitsspeicherstrukturen
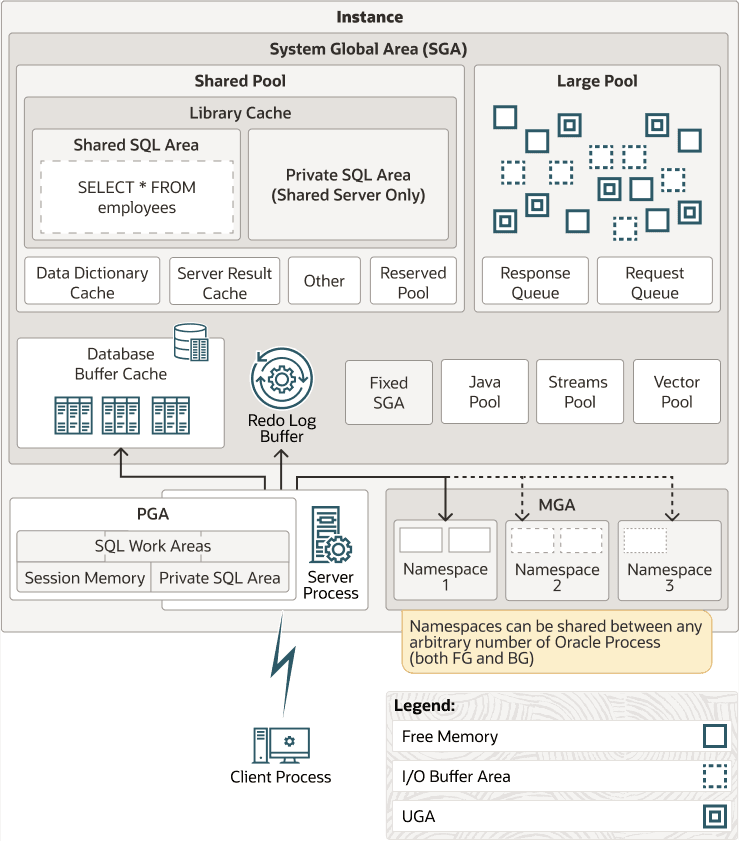
Beschreibung der Abbildung cncpt217.png
Oracle AI Database-Speicherverwaltung
Zur Speicherverwaltung gehört die Verwaltung optimaler Größen für die Speicherstrukturen für die Oracle-Instanzen, während sich der Bedarf an der Datenbank ändert. Oracle AI Database verwaltet den Speicher basierend auf den Einstellungen der speicherbezogenen Initialisierungsparameter.
Grundlegende Optionen für die Speicherverwaltung sind:
-
Einheitliche Speicherverwaltung
Unified Memory konfiguriert den Datenbankinstanzspeicher mit einem einzigen Parameter,
MEMORY_SIZE. Die Datenbank kann diesen Speicher dynamisch für jedes Verhältnis von SGA, PGA, MGA, UGA und anderen Speichersegmenten basierend auf der aktuellen Workload verwenden. Die Aufteilung zwischen verschiedenen Speichersegmenten basiert auf der Speichergröße der aktuell in der CDB geöffneten PDBs. Wenn riesige Seiten konfiguriert sind, können sie sowohl für SGA als auch für PGA verwendet werden. Unified Memory bietet eine extrem flexible Speicherkonfiguration. -
Automatic Memory Management
Sie geben die Zielgröße für den Datenbankinstanzspeicher an. Die Instance passt sich automatisch an die Zielspeichergröße an und verteilt den Speicher je nach Bedarf zwischen der SGA und der Instanz-PGA.
-
Automatische Shared Memory-Verwaltung
Dieser Verwaltungsmodus ist teilweise automatisiert. Sie legen eine Zielgröße für die SGA fest und haben dann die Möglichkeit, eine aggregierte Zielgröße für die PGA festzulegen oder PGA-Arbeitsbereiche einzeln zu verwalten.
-
Manuelle Speicherverwaltung
Anstatt die Gesamtspeichergröße festzulegen, legen Sie viele Initialisierungsparameter fest, um die Komponenten der SGA und der Instanz-PGA einzeln zu verwalten.
Wenn Sie eine Datenbank mit Database Configuration Assistant (DBCA) erstellen und die grundlegende Installationsoption auswählen, ist die automatische Speicherverwaltung die Standardeinstellung.
Siehe:
-
Weitere Informationen zu Speicherverwaltungsoptionen für DBAs finden Sie im Oracle AI Database Performance Tuning Guide.
-
Oracle AI Database Administrator's Guide, um mehr über Speicherverwaltungsoptionen zu erfahren.
-
Oracle AI Database Reference, um Informationen zu Initialisierungsparametern zu erhalten.
System Global Area (SGA) - Überblick
Die SGA ist ein Lese-/Schreibspeicherbereich, der zusammen mit den Oracle-Hintergrundprozessen eine Datenbankinstanz bildet. Hinweis: Die Server- und Hintergrundprozesse befinden sich nicht innerhalb der SGA, sondern in einem separaten Speicherbereich.
Alle Serverprozesse, die im Auftrag von Benutzern ausgeführt werden, können Informationen in der Instance SGA lesen. Während des Datenbankvorgangs werden mehrere Prozesse in die SGA geschrieben.
Jede Datenbankinstanz verfügt über eine eigene SGA. Oracle AI Database weist beim Hochfahren der Instanz automatisch Speicher für eine SGA zu und setzt den Speicher beim Herunterfahren der Instanz zurück. Wenn Sie eine Instanz mit SQL*Plus oder Oracle Enterprise Manager starten, wird die Größe der SGA wie im folgenden Beispiel gezeigt:
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.
Wie in Abbildung 17-1 dargestellt, besteht die SGA aus mehreren Speicherkomponenten, bei denen es sich um Speicherpools handelt, die zur Erfüllung einer bestimmten Klasse von Speicherzuweisungsanforderungen verwendet werden. Alle SGA-Komponenten mit Ausnahme des Redo-Logpuffers weisen Speicherplatz in Einheiten mit zusammenhängendem Speicher zu, die als Granules bezeichnet werden. Die Granulatgröße ist plattformspezifisch und wird durch die gesamte SGA-Größe bestimmt.
Sie können die View V$SGASTAT nach Informationen zu SGA-Komponenten abfragen.
Die wichtigsten SGA-Komponenten sind:
-
Datenbankpuffercache Der Datenbankpuffercache, auch Puffercache genannt, ist der Speicherbereich, in dem Kopien von Datenblöcken gespeichert werden, die aus Datendateien gelesen werden.
-
Redo-Logpuffer Der Redo-Logpuffer ist ein zyklischer Puffer in der SGA, der Redo-Einträge speichert, die an der Datenbank vorgenommene Änderungen beschreiben.
-
Shared Pool Der Shared Pool speichert verschiedene Arten von Programmdaten im Cache.
-
Large Pool Der Large Pool ist ein optionaler Speicherbereich, der für Speicherzuweisungen gedacht ist, die größer sind als für den Shared Pool geeignet.
-
Java-Pool: Der Java-Pool ist ein Speicherbereich, in dem der gesamte sessionspezifische Java-Code und alle Daten innerhalb der Java Virtual Machine (JVM) gespeichert werden. Dieser Speicher umfasst Java-Objekte, die am Ende des Aufrufs in den Java-Sessionbereich migriert werden.
-
Feste SGA Die feste SGA ist ein interner Housekeeping-Bereich.
-
Optionale leistungsbezogene SGA-Subbereiche Einige SGA-Subbereiche sind nur für bestimmte Performancefeatures aktiviert.
Siehe:
-
Oracle AI Database Performance Tuning Guide, um mehr über die Granulatgröße zu erfahren
Datenbankpuffercache
Der Datenbankpuffercache, auch als Puffercache bezeichnet, ist der Speicherbereich, in dem Kopien von Datenblöcken gespeichert werden, die aus Datendateien gelesen werden.
Ein Puffer ist eine Hauptspeicheradresse, in der der Puffermanager einen aktuell oder zuletzt verwendeten Datenblock temporär zwischenspeichert. Alle Benutzer, die gleichzeitig bei einer Datenbankinstanz angemeldet sind, haben Zugriff auf den Puffercache.
-
Zweck des Datenbankpuffercaches Oracle AI Database verwendet den Puffercache, um mehrere Ziele zu erreichen.
-
Pufferstatus Die Datenbank verwendet interne Algorithmen, um Puffer im Cache zu verwalten.
-
Puffermodi Wenn ein Client Daten anfordert, ruft Oracle AI Database Puffer entweder im aktuellen oder im konsistenten Modus aus dem Datenbankpuffercache ab.
-
Puffer-I/O Ein logisches I/O, auch als Puffer-I/O bezeichnet, bezieht sich auf Lese- und Schreibvorgänge von Puffern im Puffercache.
-
Pufferpools Ein Pufferpool ist eine Sammlung von Puffern.
-
Puffer und Full Table Scans Die Datenbank verwendet einen komplizierten Algorithmus zur Verwaltung von Table Scans. Wenn Puffer vom Datenträger gelesen werden müssen, fügt die Datenbank die Puffer standardmäßig in die Mitte der LRU-Liste ein. Auf diese Weise können Hot-Blöcke im Cache verbleiben, sodass sie nicht erneut von der Festplatte gelesen werden müssen.
-
DRAM- und PMEM-Puffer Standard-(DRAM-)Datenbankpuffer unterscheiden sich von PMEM-Puffern, weisen jedoch gemeinsame Eigenschaften auf.
Zweck des Datenbankpuffercaches
Oracle AI Database verwendet den Puffercache, um mehrere Ziele zu erreichen.
Die Ziele umfassen:
-
Physische I/O optimieren
Die Datenbank aktualisiert Datenblöcke im Cache und speichert Metadaten zu den Änderungen im Redo Log-Buffer. Nach einem
COMMITschreibt die Datenbank die Redo-Puffer in das Online-Redo-Log, schreibt jedoch nicht sofort Datenblöcke in die Datendateien. Stattdessen führt Datenbank-Writer (DBW) faire Schreibvorgänge im Hintergrund aus. -
Blöcke, auf die häufig zugegriffen wird, im Puffercache beibehalten und Blöcke, auf die selten zugegriffen wird, auf Platte schreiben
Wenn Database Smart Flash Cache (Flashcache) aktiviert ist, kann sich ein Teil des Buffer Caches im Flashcache befinden. Diese Puffercacheerweiterung wird auf einem oder mehreren Flash-Devices gespeichert. Die Datenbank kann die Performance verbessern, indem Puffer im Flashspeicher gecacht werden, anstatt von einer Magnetplatte zu lesen.
Verwenden Sie die Initialisierungsparameter
DB_FLASH_CACHE_FILEundDB_FLASH_CACHE_SIZE, um mehrere Flash-Geräte zu konfigurieren. Der Puffercache verfolgt jedes Gerät und verteilt Puffer gleichmäßig auf die Geräte.Hinweis: Database Smart Flash Cache ist nur in Solaris und Oracle Linux verfügbar.
-
Pufferheader verwalten, die auf Datendateien im Oracle Persistent Memory Filestore (PMEM Filestore) verweisen
Wenn Sie PMEM Filestore aktivieren, werden Datenbankdateien für den direkten schreibgeschützten Zugriff zugeordnet. Abfragen können den herkömmlichen Puffercache-Mechanismus umgehen und unnötiges I/O vermeiden. In diesem Fall müssen Pufferheader Metadaten speichern, die den PMEM-Blöcken entsprechen. Die Datenbank kann weiterhin den herkömmlichen (DRAM-)Puffercache für Änderungen, Lesekonsistenz und schnelleren Zugriff auf "heiße" Datenblöcke verwenden.
Siehe:
-
Oracle AI Database Reference zum
DB_FLASH_CACHE_FILE-Initialisierungsparameter
Pufferstatus
Die Datenbank verwendet interne Algorithmen, um Puffer im Cache zu verwalten.
Ein Puffer kann einen der folgenden sich gegenseitig ausschließenden Status aufweisen:
-
Nicht verwendet
Der Puffer kann verwendet werden, da er nie verwendet wurde oder derzeit nicht verwendet wird. Diese Art von Puffer ist für die Datenbank am einfachsten zu verwenden.
-
Bereinigen
Dieser Puffer wurde früher verwendet und enthält jetzt eine lesekonsistente Version eines Blocks zu einem bestimmten Zeitpunkt. Der Block enthält Daten, ist aber "sauber", so dass er nicht überprüft werden muss. Die Datenbank kann den Block pinnen und wiederverwenden.
-
Schmutzig
Der Puffer enthält geänderte Daten, die noch nicht auf den Datenträger geschrieben wurden. Die Datenbank muss den Block vor der Wiederverwendung prüfen.
Jeder Puffer hat einen Zugriffsmodus: Pinned oder Free (unpinned). Ein Puffer wird im Cache "gepinnt", sodass er während des Zugriffs einer Benutzersession nicht über den Speicher hinausgeht. Mehrere Sessions können einen gepinnten Puffer nicht gleichzeitig ändern.
Puffermodi
Wenn ein Client Daten anfordert, ruft Oracle AI Database Puffer entweder im aktuellen oder im konsistenten Modus aus dem Datenbankpuffercache ab.
Die Modi unterscheiden sich wie folgt:
-
Derzeitiger Modus
Ein aktueller Modus get, auch als db block get bezeichnet, ist ein Abruf eines Blocks, wie er derzeit im Puffercache angezeigt wird. Beispiel: Wenn eine nicht festgeschriebene Transaktion zwei Zeilen in einem Block aktualisiert hat, ruft ein aktueller Modus "get" den Block mit diesen nicht festgeschriebenen Zeilen ab. Die Datenbank verwendet db block gets am häufigsten während change-Anweisungen, die nur die aktuelle Version des Blocks aktualisieren müssen.
-
Konsistenter Modus
Ein konsistenter Lesezugriff ist ein Abruf einer lesekonsistenten Version eines Blocks. Dieser Abruf kann Undo-Daten verwenden. Beispiel: Wenn eine nicht festgeschriebene Transaktion zwei Zeilen in einem Block aktualisiert hat und eine Abfrage in einer separaten Session den Block anfordert, verwendet die Datenbank Undo-Daten, um eine lesekonsistente Version dieses Blocks (als konsistenter Leseklon bezeichnet) zu erstellen, der die nicht festgeschriebenen Updates nicht enthält. In der Regel ruft eine Abfrage Blöcke im konsistenten Modus ab.
Siehe:
-
Oracle AI Database-Referenz für Beschreibungen von Datenbankstatistiken wie DB-Block-Get und konsistenter Lesezugriff
Puffer-I/O
Ein logischer I/O, auch als Puffer-I/O bezeichnet, bezieht sich auf Lese- und Schreibvorgänge von Puffern im Puffercache.
Wenn kein angeforderter Puffer im Speicher gefunden wird, führt die Datenbank ein physisches I/O aus, um den Puffer aus dem Flashcache oder der Festplatte in den Speicher zu kopieren. Die Datenbank führt dann ein logisches I/O aus, um den gecachten Puffer zu lesen.
-
Pufferersetzungsalgorithmen Um den Pufferzugriff effizient zu gestalten, muss die Datenbank entscheiden, welche Puffer im Speicher gecacht werden und auf welche von der Festplatte zugegriffen werden soll.
-
Pufferschreibvorgänge Der Datenbank-Writer-(DBW-)Prozess schreibt regelmäßig Cold-Dirty-Puffer auf Datenträger.
-
Pufferlesezugriffe Wenn die Anzahl der nicht verwendeten Puffer gering ist, muss die Datenbank Puffer aus dem Puffercache entfernen.
-
Puffer-Touch-Counts Die Datenbank misst die Häufigkeit des Zugriffs auf Puffer in der LRU-Liste mit einem Touch-Count. Mit diesem Mechanismus kann die Datenbank einen Zähler erhöhen, wenn ein Puffer gepinnt wird, anstatt Puffer in der LRU-Liste ständig zu mischen.
Pufferersetzungsalgorithmen
Um den Pufferzugriff effizient zu gestalten, muss die Datenbank entscheiden, welche Puffer im Speicher gecacht werden und auf welche von der Festplatte zugegriffen werden soll.
Die Datenbank verwendet die folgenden Algorithmen:
-
LRU-basierter Ersetzungsalgorithmus auf Blockebene
Dieser hochentwickelte Algorithmus, der Standardwert, verwendet eine LRU-Liste (Least Recently Used), die Zeiger auf schmutzige und nicht schmutzige Puffer enthält. Die LRU-Liste hat ein heißes Ende und ein kaltes Ende. Ein kalter Puffer ist ein Puffer, der in letzter Zeit nicht verwendet wurde. Auf einen Hot-Puffer wird häufig zugegriffen und wurde kürzlich verwendet. Grundsätzlich gibt es nur eine LRU, aber für Datennebenläufigkeit verwendet die Datenbank tatsächlich mehrere LRUs.
-
Temperaturbasierter Ersatzalgorithmus auf Objektebene
Ab Oracle Database 12c Release 1 (12.1.0.2) ermöglicht das automatische Big-Table-Caching, dass Table Scans in den folgenden Szenarios einen anderen Algorithmus verwenden:
-
Parallele Abfragen
In Einzelinstanz- und Oracle Real Applications Cluster-(Oracle RAC-)Datenbanken können parallele Abfragen den Big-Table-Cache verwenden, wenn der Initialisierungsparameter
DB_BIG_TABLE_CACHE_PERCENT_TARGETauf einen Wert ungleich null gesetzt ist undPARALLEL_DEGREE_POLICYaufautooderadaptivegesetzt ist. -
Serielle Abfragen
Nur bei einer Einzelinstanzkonfiguration können serielle Abfragen den Big-Table-Cache verwenden, wenn der Initialisierungsparameter
DB_BIG_TABLE_CACHE_PERCENT_TARGETauf einen Wert ungleich Null gesetzt ist.
Wenn eine Tabelle nicht in den Speicher passt, entscheidet die Datenbank basierend auf den Zugriffsmustern, welche Puffer gecacht werden sollen. Beispiel: Wenn nur 95% einer gängigen Tabelle in den Speicher passen, kann die Datenbank 5% der Blöcke auf der Festplatte belassen, anstatt Blöcke zyklisch in den Speicher zu lesen und Blöcke auf die Festplatte zu schreiben – ein Phänomen, das als Thrashing bezeichnet wird. Beim Zwischenspeichern mehrerer großer Objekte betrachtet die Datenbank häufigere Tabellen als heißer und weniger beliebte Tabellen als kühler. Dies beeinflusst, welche Blöcke gecacht werden. Der Initialisierungsparameter
DB_BIG_TABLE_CACHE_PERCENT_TARGETlegt den Prozentsatz des Puffercaches fest, der diesen Algorithmus verwendet.Hinweis: In diesem Dokument wird der LRU-basierte Ersetzungsalgorithmus auf Blockebene erläutert.
-
Siehe auch: Oracle AI Database VLDB and Partitioning Guide, um mehr über den temperaturbasierten Algorithmus zu erfahren
Pufferschreibvorgänge
Der Database Writer-(DBW-)Prozess schreibt regelmäßig Cold-Dirty-Puffer auf den Datenträger.
DBW schreibt Puffer unter folgenden Umständen:
-
Ein Serverprozess kann keine bereinigten Puffer finden, um neue Blöcke in den Datenbankpuffercache zu lesen.
Während Puffer geändert werden, verringert sich die Anzahl von freien Puffern. Wenn die Zahl unter einen internen Schwellenwert fällt und saubere Puffer erforderlich sind, signalisiert der Server DBW zum Schreiben.
Die Datenbank bestimmt anhand der LRU, welche Dirty Buffer geschrieben werden. Wenn schmutzige Puffer das kalte Ende der LRU erreichen, verschiebt die Datenbank sie von der LRU in eine Schreibwarteschlange. DBW schreibt Puffer in der Queue auf Platte, wenn möglich mit Multiblock-Schreibvorgängen. Dieser Mechanismus verhindert, dass das Ende der LRU mit schmutzigen Puffern verstopft wird und ermöglicht es, saubere Puffer zur Wiederverwendung zu finden.
-
Die Datenbank muss den Checkpoint voranstellen, der die Position im Redo-Thread ist, von der aus das Instanz-Recovery beginnen muss.
-
Tablespaces werden in den schreibgeschützten Status geändert oder offline gesetzt.
Siehe:
-
Oracle AI Database Performance Tuning Guide zum Diagnostizieren und Optimieren von Pufferschreibproblemen
Pufferlesezugriffe
Wenn die Anzahl der nicht verwendeten Puffer gering ist, muss die Datenbank Puffer aus dem Puffercache entfernen.
Der Algorithmus hängt davon ab, ob der Flashcache aktiviert ist:
-
Flashcache deaktiviert
Die Datenbank verwendet jeden sauberen Puffer nach Bedarf erneut und überschreibt ihn. Wenn der überschriebene Puffer später benötigt wird, muss die Datenbank ihn von der Magnetplatte lesen.
-
Flashcache aktiviert
DBW kann den Body eines sauberen Buffers in den Flashcache schreiben und so den In-Memory-Buffer wiederverwenden. Die Datenbank speichert den Pufferheader in einer LRU-Liste im Hauptspeicher, um den Status und den Speicherort des Pufferbodys im Flashcache zu verfolgen. Wenn dieser Puffer später benötigt wird, kann die Datenbank ihn aus dem Flashcache und nicht von einer Magnetplatte lesen.
Wenn ein Clientprozess einen Puffer anfordert, durchsucht der Serverprozess den Puffercache nach dem Puffer. Ein Cache-Treffer tritt auf, wenn die Datenbank den Puffer im Speicher findet. Die Suchreihenfolge lautet wie folgt:
-
Der Serverprozess sucht nach dem gesamten Puffer im Puffercache.
Wenn der Prozess den gesamten Puffer findet, führt die Datenbank einen logischen Lesevorgang dieses Puffers aus.
-
Der Serverprozess sucht in der LRU-Liste des Flashcaches nach dem Pufferheader.
Wenn der Prozess den Pufferheader findet, führt die Datenbank einen optimierten physischen Lesevorgang des Pufferbodys aus dem Flashcache in den In-Memory-Cache aus.
-
Wenn der Prozess den Puffer nicht im Speicher findet (ein Cachefehlschlag), führt der Serverprozess die folgenden Schritte aus:
-
Kopiert den Block aus einer Datendatei auf dem Datenträger in den Speicher (physischer Lesevorgang)
-
Führt einen logischen Lesevorgang des Buffers durch, der in den Speicher eingelesen wurde
-
Die Buffer-Suchreihenfolge wird in Abbildung 17-2 dargestellt. Der erweiterte Buffer Cache umfasst sowohl den speicherresidenten Buffer Cache, der ganze Buffer enthält, als auch den Flash Cache, der Buffer Bodies enthält. In der Abbildung sucht die Datenbank nach einem Puffer im Puffercache und liest ihn, ohne den Puffer zu finden, von einer Magnetplatte in den Speicher.
Abbildung 2: Puffersuche
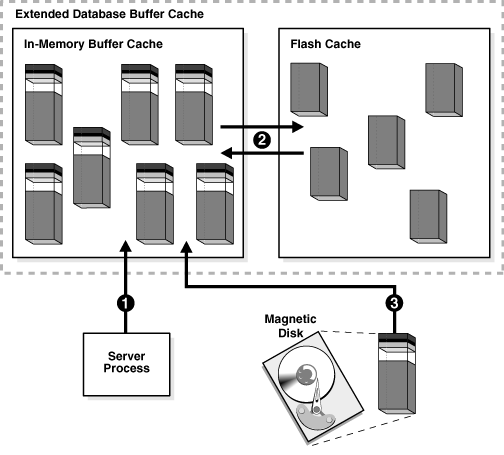
Beschreibung der Abbildung cncpt304.gif
Im Allgemeinen ist der Zugriff auf Daten über einen Cache-Treffer schneller als über einen Cache-Fehler. Die Puffercache-Trefferrate misst, wie oft die Datenbank einen angeforderten Block im Puffercache gefunden hat, ohne ihn von der Festplatte lesen zu müssen.
Die Datenbank kann physische Lesevorgänge aus einer Datendatei oder einer temp-Datei ausführen. Auf Lesezugriffe aus einer Datendatei folgen logische I/Os. Lesevorgänge aus einer temporären Datei treten auf, wenn zu wenig Speicher die Datenbank zwingt, Daten in eine temporäre Tabelle zu schreiben und später wieder zu lesen. Diese physischen Lesevorgänge umgehen den Puffercache und verursachen kein logisches I/O.
Siehe auch: In der Oracle AI Database Performance Tuning Guide erfahren Sie, wie Sie die Puffercache-Trefferrate berechnen.
Pufferanzahl
Die Datenbank misst die Häufigkeit des Zugriffs auf Puffer in der LRU-Liste mit einem Touch Count. Mit diesem Mechanismus kann die Datenbank einen Zähler erhöhen, wenn ein Puffer gepinnt wird, anstatt Puffer in der LRU-Liste ständig zu mischen.
Hinweis: Die Datenbank verschiebt keine Blöcke im Speicher. Die Bewegung ist die Änderung der Position eines Zeigers auf einer Liste.
Wenn ein Puffer gepinnt wird, bestimmt die Datenbank, wann die Anzahl der Berührungen zuletzt erhöht wurde. Wenn die Anzahl vor mehr als drei Sekunden erhöht wurde, wird die Anzahl erhöht. Andernfalls bleibt die Anzahl gleich. Die Drei-Sekunden-Regel verhindert, dass Pins auf einem Puffer so viele Berührungen zählen. Beispiel: Eine Session kann mehrere Zeilen in einen Datenblock einfügen. Die Datenbank betrachtet diese Einfügungen jedoch als eine Berührung.
Wenn sich ein Puffer am kalten Ende der LRU befindet, die Anzahl der Berührungen jedoch hoch ist, wird der Puffer an das heiße Ende verschoben. Wenn die Anzahl der Berührungen niedrig ist, wird der Puffer aus dem Cache entfernt.
Pufferpools
Ein Pufferpool ist eine Sammlung von Puffern.
Der Datenbank-Puffercache ist in einen oder mehrere Pufferpools unterteilt, die Blöcke in der Regel auf die gleiche Weise verwalten. Die Pools verfügen über keine radikal unterschiedlichen Algorithmen für Alterungs- oder Caching-Blöcke.
Sie können separate Pufferpools manuell konfigurieren, die entweder Daten im Puffercache speichern oder die Puffer unmittelbar nach der Verwendung der Datenblöcke für neue Daten verfügbar machen. Anschließend können Sie dem entsprechenden Pufferpool bestimmte Schemaobjekte zuweisen, um zu steuern, wie Blöcke aus dem Cache entfernt werden. Beispiel: Sie können Segmente in Hot-, Warm- und Cold-Pufferpools trennen.
Folgende Pufferpools sind möglich:
-
Standardpool
Dieser Pool ist der Speicherort, an dem Blöcke normalerweise gecacht werden. Sofern Sie keine separaten Pools manuell konfigurieren, ist der Standard-Pool der einzige Puffer-Pool. Die optionale Konfiguration der anderen Pools wirkt sich nicht auf den Standardpool aus.
Der große Tabellencache ist ein optionaler Abschnitt des Standardpools, der einen temperaturbasierten Ersatzalgorithmus auf Objektebene verwendet. In Einzelinstanz- und Oracle RAC-Datenbanken können parallele Abfragen den Big-Table-Cache verwenden, wenn der Initialisierungsparameter
DB_BIG_TABLE_CACHE_PERCENT_TARGETauf einen Wert ungleich Null gesetzt ist undPARALLEL_DEGREE_POLICYaufautooderadaptivegesetzt ist. Nur bei Einzelinstanzkonfigurationen können serielle Abfragen den Big-Table-Cache verwenden, wennDB_BIG_TABLE_CACHE_PERCENT_TARGETfestgelegt ist. -
Pool beibehalten
Dieser Pool ist für Blöcke gedacht, auf die häufig zugegriffen wurde, die jedoch aufgrund des fehlenden Speicherplatzes aus dem Standardpool entfernt wurden. Der Keep-Pufferpool dient dazu, Objekte im Speicher zu behalten und somit I/O-Vorgänge zu vermeiden.
Hinweis: Der Keep-Pool verwaltet Puffer auf dieselbe Weise wie die anderen Pools: Es wird kein spezieller Algorithmus zum Pinnen von Puffern verwendet. Das Wort "keep" ist eine Namenskonvention. Sie können Tabellen, die Sie behalten möchten, im größeren Keep-Pool platzieren und Tabellen, die Sie nicht im kleineren Recycle-Pool behalten möchten, platzieren.
-
Pool recyceln
Dieser Pool ist für Blöcke gedacht, die selten verwendet werden. Ein Recycling-Pool verhindert, dass Objekte unnötigen Speicherplatz im Cache belegen.
Eine Datenbank hat eine Standardblockgröße. Sie können einen Tablespace mit einer Blockgröße erstellen, die sich von der Standardgröße unterscheidet. Jede nicht standardmäßige Blockgröße verfügt über einen eigenen Pool. Oracle AI Database verwaltet die Blöcke in diesen Pools auf die gleiche Weise wie im Standardpool.
Die folgende Abbildung zeigt die Struktur des Puffercaches, wenn mehrere Pools verwendet werden. Der Cache enthält Standard-, Keep- und Recycle-Pools. Die Standardblockgröße ist 8 KB. Der Cache enthält separate Pools für Tablespaces, die nicht standardmäßige Blockgrößen von 2 KB, 4 KB und 16 KB verwenden.
Abbildung 3: Datenbankpuffercache
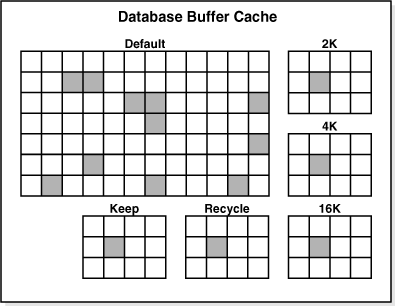
Beschreibung der Abbildung cncpt220.gif
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über Pufferpools zu erfahren
-
Oracle AI Database Performance Tuning Guide enthält Informationen zur Verwendung mehrerer Pufferpools
-
Oracle AI Database Reference zum
DB_BIG_TABLE_CACHE_PERCENT_TARGET-Initialisierungsparameter
Puffer und Full Table Scans
Die Datenbank verwendet einen komplizierten Algorithmus zur Verwaltung von Tabellenscans. Wenn Puffer vom Datenträger gelesen werden müssen, fügt die Datenbank die Puffer standardmäßig in die Mitte der LRU-Liste ein. Auf diese Weise können Hot-Blöcke im Cache verbleiben, sodass sie nicht erneut von der Festplatte gelesen werden müssen.
Ein Problem wird durch einen vollständigen Table Scan verursacht, der alle Zeilen unter der Tabelle High Water Mark (HWM) sequenziell liest. Angenommen, die Gesamtgröße der Blöcke in einem Tabellensegment ist größer als die Größe des Buffer Caches. Ein vollständiger Scan dieser Tabelle könnte den Puffercache bereinigen und verhindern, dass die Datenbank einen Cache mit Blöcken verwaltet, auf die häufig zugegriffen wird.
-
Standardmodus für Full Table Scans Standardmäßig verfolgt die Datenbank einen konservativen Ansatz bei Full Table Scans. Dabei wird eine kleine Tabelle nur dann in den Speicher geladen, wenn die Tabellengröße einen kleinen Prozentsatz des Puffercaches beträgt.
-
Parallele Abfrageausführung Bei der Ausführung eines Full Table Scans kann die Datenbank die Antwortzeit manchmal verbessern, indem mehrere Server für die Parallelverarbeitung verwendet werden.
-
CACHE-Attribut In seltenen Fällen, in denen das standardmäßige Caching-Verhalten nicht erwünscht ist, können Sie mit
ALTER TABLE ... CACHEändern, wie Blöcke aus großen Tabellen in den Datenbankpuffercache eingelesen werden. -
KEEP-Attribut Bei großen Tabellen können Sie
ALTER TABLE ... STORAGE BUFFER_POOL KEEPverwenden, um zu veranlassen, dass Scans Blöcke für diese Tabellen in den KEEP Pool laden. -
Vollständigen Datenbank-Caching-Modus erzwingen Um die Performance in einigen Situationen zu verbessern, können Sie die Anweisung
ALTER DATABASE ... FORCE FULL DATABASE CACHINGexplizit ausführen, um den Vollständigen Datenbank-Caching-Modus erzwingen zu aktivieren. Siehe auch: "Segmentraum und Hochwassermarke"
Standardmodus für Full Table Scans
Standardmäßig verfolgt die Datenbank einen konservativen Ansatz bei Full Table Scans und lädt nur dann eine kleine Tabelle in den Speicher, wenn die Tabellengröße einen kleinen Prozentsatz des Puffercaches beträgt.
Um zu bestimmen, ob Tabellen mittlerer Größe gecacht werden sollen, verwendet die Datenbank einen Algorithmus, der das Intervall zwischen dem letzten Table Scan, dem Alterungszeitstempel des Puffercaches und dem im Puffercache verbleibenden Speicherplatz enthält.
Bei sehr großen Tabellen verwendet die Datenbank in der Regel einen Direct Path-Lesevorgang, der Blöcke direkt in die PGA lädt und die SGA insgesamt umgeht, um zu vermeiden, dass der Puffercache gefüllt wird. Bei Tabellen mittlerer Größe kann die Datenbank einen direkten Lese- oder Cache-Lesevorgang verwenden. Wenn ein Cache-Lesevorgang verwendet werden soll, platziert die Datenbank die Blöcke am Ende der LRU-Liste, um zu verhindern, dass der Scan den Puffercache effektiv bereinigt.
Ab Oracle Database 12c Release 1 (12.1.0.2) führt der Puffercache einer Datenbankinstanz automatisch eine interne Berechnung aus, um zu bestimmen, ob der Speicher ausreicht, damit die Datenbank vollständig in der Instanz-SGA gecacht wird, und ob das Caching von Tabellen beim Zugriff für die Performance von Vorteil wäre. Wenn die gesamte Datenbank vollständig in den Speicher passen kann und verschiedene andere interne Kriterien erfüllt sind, behandelt Oracle AI Database alle Tabellen in der Datenbank als kleine Tabellen und betrachtet sie als für das Caching geeignet. Die Datenbank cacht jedoch keine LOBs, die mit dem Attribut NOCACHE markiert sind.
Parallele Abfrageausführung
Bei einem Full Table Scan kann die Datenbank manchmal die Antwortzeit verbessern, indem mehrere Server für die Parallelverarbeitung verwendet werden.
In einigen Fällen kann die Datenbank parallele Abfragedaten in der System Global Area (SGA) cachen, anstatt Direct Path-Lesevorgänge in die Programm Global Area (PGA) zu verwenden. In der Regel werden parallele Abfragen in Data Warehouses mit geringer Währung aufgrund der potenziellen Ressourcennutzung ausgeführt.
Siehe:
-
Oracle AI Database Data Warehousing Guide für eine Einführung in Data Warehouses
-
Oracle AI Database VLDB and Partitioning Guide, um mehr über die parallele Ausführung zu erfahren
CACHE-Attribut
In seltenen Fällen, in denen das Standard-Caching-Verhalten nicht erwünscht ist, können Sie mit ALTER TABLE ... CACHE ändern, wie Blöcke aus großen Tabellen in den Datenbankpuffercache gelesen werden.
Bei Tabellen mit dem Attribut CACHE erzwingt oder pinnt die Datenbank die Blöcke im Puffercache nicht. Stattdessen altert die Datenbank die Blöcke aus dem Cache auf die gleiche Weise wie jeder andere Tabellenblock. Verwenden Sie bei der Ausübung dieser Option Vorsicht, da ein vollständiger Scan einer großen Tabelle die meisten anderen Blöcke aus dem Cache entfernen kann. Hinweis: Wenn Sie ALTER TABLE ... CACHE ausführen, verursacht keine Tabelle, die gecacht werden soll.
KEEP-Attribut
Bei großen Tabellen können Sie ALTER TABLE ... STORAGE BUFFER_POOL KEEP verwenden, damit Scans Blöcke für diese Tabellen in den Keep Pool laden.
Wenn Sie eine Tabelle in den Keep Pool einfügen, ändert sich der Teil des Buffer Caches, in dem die Blöcke gespeichert sind. Anstatt Blöcke im Standardpufferpool zwischenzuspeichern, speichert die Datenbank sie im Keep-Pufferpool. Keine separaten Algorithmen steuern das Pool-Caching.
Siehe:
-
Oracle AI Database SQL Language Reference für Informationen zur Klausel
CACHEund zum AttributKEEP -
Oracle AI Database Performance Tuning Guide zum Interpretieren von Puffercache-Advisory-Statistiken
Vollständigen Datenbank-Caching-Modus erzwingen
Um die Performance in einigen Situationen zu verbessern, können Sie die Anweisung ALTER DATABASE ... FORCE FULL DATABASE CACHING explizit ausführen, um den Vollständigen Datenbank-Caching-Modus erzwingen zu aktivieren.
Im Gegensatz zum automatischen Standardmodus betrachtet der Modus "Vollständiges Datenbank-Caching erzwingen" die gesamte Datenbank, einschließlich NOCACHE-LOBs, als für das Caching im Datenbankpuffercache geeignet. Dieser Modus ist ab Oracle Database 12c Release 1 (12.1.0.2) verfügbar. Hinweis: Wenn Sie den Modus "Vollständiges Datenbank-Caching erzwingen" aktivieren, wird die Datenbank nicht in den Speicher erzwungen. Stattdessen kann die gesamte Datenbank nicht im Puffercache gecacht werden. Oracle AI Database cacht Tabellen nur, wenn auf sie zugegriffen wird.
Oracle empfiehlt, den vollständigen Datenbank-Caching-Modus nur dann zu aktivieren, wenn die Puffercachegröße jeder einzelnen Instance größer als die Datenbankgröße ist. Diese Richtlinie gilt sowohl für Einzelinstanz- als auch für Oracle RAC-Datenbanken. Wenn Oracle RAC-Anwendungen jedoch gut partitioniert sind, können Sie den Modus "Vollständiges Datenbank-Caching erzwingen" aktivieren, wenn der kombinierte Puffercache aller Instanzen mit zusätzlichem Speicherplatz für die Verarbeitung doppelt gecachter Blöcke zwischen Instanzen größer als die Datenbankgröße ist.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie den vollständigen Datenbank-Caching-Modus aktivieren
-
Oracle AI Database SQL Language Reference für weitere Informationen zur
ALTER DATABASE ... FORCE FULL DATABASE CACHING-Anweisung
DRAM- und PMEM-Puffer
Standard-Datenbankpuffer (DRAM) unterscheiden sich von PMEM-Puffern, weisen jedoch gemeinsame Merkmale auf.
Wenn Oracle Persistent Memory Filestore (PMEM Filestore) konfiguriert ist, wird jeder Datenblock direkt dem Puffercache in DRAM zugeordnet. Im Gegensatz zu DRAM-Puffern kopieren PMEM-Puffer den Inhalt von Datenblöcken nicht. Stattdessen verweisen PMEM-Pufferheader auf Datenblöcke, die in PMEM Filestore gespeichert sind. Bei den meisten Lesevorgängen speichert die Datenbank nur die Blockmetadaten, nicht den Inhalt. PMEM-Puffer verwenden einen speziellen Granulattyp, dessen Struktur sich von den Standard-Puffercache-Granulaten unterscheidet.
Hinweis: Der Initialisierungsparameter DB_CACHE_SIZE gibt die Mindestgröße des DRAM-Cache an. PMEM-Metadaten-Overhead ist in dieser Zuweisung nicht enthalten.
PMEM-Puffer können folgende Statusangaben haben:
-
Aktuell
Dies ist die aktuelle Version eines PMEM-Puffers. Es kann direkt aus dem Filestore abgerufen werden.
Mit Oracle AI Database wird die aktuelle PMEM-Version von der aktuellen Standardversion des DRAM-Puffers getrennt. Diese Trennung trägt dazu bei, die Code-Komplexität während des PMEM-Block-Pinning, der Bereinigung und der Migration zu DRAM zu reduzieren.
-
Konsistent
Dies ist die konsistente Leseversion eines PMEM-Puffers. Er wird erstellt, nachdem die Datenbank einen Klon in DRAM erstellt hat. Der PMEM-Puffer kann direkt aus dem Filestore abgerufen werden.
-
Frei
Dies ist ein kostenloser PMEM-Puffer. Es kann von einem PMEM-Block wiederverwendet werden. Nach dem Hochfahren der Instanz befinden sich alle PMEM-Puffer in einem freien Status.
PMEM hat eine höhere Latenz als DRAM. Oracle AI Database verwendet einen internen, Workload-basierten Algorithmus, um zu entscheiden, welche Blöcke von PMEM zu DRAM migriert werden sollen.
Siehe:
-
Oracle AI Database Administrator's Guide zum Einrichten von PMEM Filestore
Redo-Logpuffer
Der Redo-Logpuffer ist ein zyklischer Puffer in der SGA, der Redo-Einträge speichert, die an der Datenbank vorgenommene Änderungen beschreiben.
Ein Redo-Datensatz ist eine Datenstruktur mit den Informationen, die zum Rekonstruieren oder Wiederholen von Änderungen an der Datenbank durch DML- oder DDL-Vorgänge erforderlich sind. Beim Datenbank-Recovery werden Redo-Einträge auf Datendateien angewendet, um verlorene Änderungen wiederherzustellen.
Die Datenbankprozesse kopieren Redo-Einträge aus dem Benutzerspeicherplatz in den Redo Log-Buffer in der SGA. Die Redo-Einträge belegen fortlaufenden, sequenziellen Speicherplatz im Puffer. Der Log Writer-Prozess (LGWR) im Hintergrundprozess schreibt den Redo-Logpuffer in die aktive Online-Redo-Loggruppe auf Datenträger. Abbildung 17-4 zeigt diese Redo-Pufferaktivität.
Abbildung 4: Redo-Logpuffer
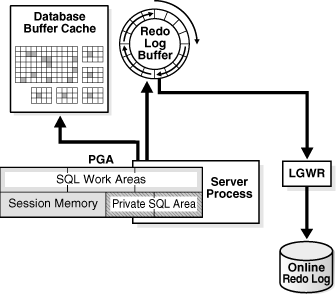
Beschreibung der Abbildung cncpt226.gif
LGWR schreibt Redo sequenziell auf Platte, während DBW verstreute Schreibvorgänge von Datenblöcken auf Platte durchführt. Verstreute Schreibvorgänge sind in der Regel viel langsamer als sequenzielle Schreibvorgänge. Da LGWR es Benutzern ermöglicht, nicht darauf zu warten, dass DBW seine langsamen Schreibvorgänge abschließt, liefert die Datenbank eine bessere Performance.
Der Initialisierungsparameter LOG_BUFFER gibt die Speichermenge an, die Oracle AI Database beim Puffern von Redo-Einträgen verwendet. Im Gegensatz zu anderen SGA-Komponenten teilen der Redo Log-Puffer und der feste SGA-Puffer den Speicher nicht in Granulate auf.
Siehe:
-
"Log Writer-Prozess (LGWR)" und "Wichtigkeit von Checkpoints für Instanz-Recovery"
-
Oracle AI Database Administrator's Guide für Informationen zum Online Redo Log
Shared Pool
Der Shared Pool speichert verschiedene Arten von Programmdaten im Cache.
Beispiel: Der Shared Pool speichert geparste SQL-, PL/SQL-Code-, Systemparameter- und Data Dictionary-Informationen. Der Shared Pool ist an fast jedem Vorgang in der Datenbank beteiligt. Beispiel: Wenn ein Benutzer eine SQL-Anweisung ausführt, greift Oracle AI Database auf den Shared Pool zu.
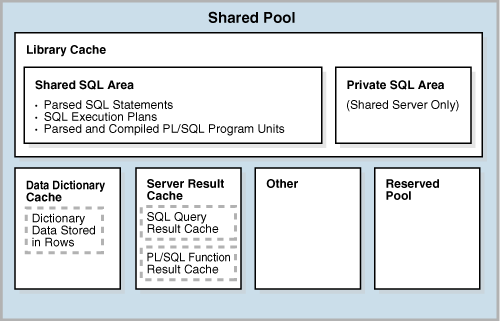
Der Shared Pool ist in mehrere Unterkomponenten unterteilt, von denen die wichtigsten in Abbildung 17-5 dargestellt sind.
Abbildung 5: Shared Pool
Beschreibung der Abbildung cncpt225.gif
Es werden folgende Themen behandelt:
-
Bibliothekscache Der Bibliothekscache ist eine Shared Pool-Speicherstruktur, in der ausführbarer SQL- und PL/SQL-Code gespeichert wird.
-
Data Dictionary-Cache Das Data Dictionary ist eine geschützte Sammlung von Datenbanktabellen und Views, die Referenzinformationen über die Datenbank, ihre Strukturen und ihre Benutzer enthalten.
-
Serverergebniscache Der Serverergebniscache ist ein Speicherpool im Shared Pool. Im Gegensatz zu den Pufferpools enthält der Serverergebniscache Ergebnismengen und keine Datenblöcke.
-
Reservierter Pool Der reservierte Pool ist ein Speicherbereich im Shared Pool, mit dem Oracle AI Database große zusammenhängende Speicherblöcke zuweisen kann.
Bibliotheks-Cache
Der Bibliothekscache ist eine Shared Pool-Speicherstruktur, in der ausführbarer SQL- und PL/SQL-Code gespeichert wird.
Dieser Cache enthält die Shared SQL- und PL/SQL-Bereiche sowie Kontrollstrukturen wie Sperren und Library-Cache-Handles. In einer Shared Server-Architektur enthält der Library-Cache auch private SQL-Bereiche.
Wenn eine SQL-Anweisung ausgeführt wird, versucht die Datenbank, zuvor ausgeführten Code wiederzuverwenden. Wenn eine geparste Darstellung einer SQL-Anweisung im Library-Cache vorhanden ist und gemeinsam verwendet werden kann, verwendet die Datenbank den Code erneut, der als Soft Parse oder Treffer des Library-Caches bezeichnet wird. Andernfalls muss die Datenbank eine neue ausführbare Version des Anwendungscodes erstellen, die als Hard Parse oder Library Cache Miss (Fehler im Bibliothekscache) bezeichnet wird.
-
Shared SQL-Bereiche Die Datenbank stellt jede SQL-Anweisung dar, die sie im Shared SQL-Bereich und im privaten SQL-Bereich ausführt.
-
Programmeinheiten und Library-Cache Der Library-Cache enthält ausführbare Formen von PL/SQL-Programmen und Java-Klassen. Diese Elemente werden zusammen als Programmeinheiten bezeichnet.
-
Speicherzuweisung und Wiederverwendung im Shared Pool Die Datenbank weist Shared Pool-Speicher zu, wenn eine neue SQL-Anweisung geparst wird, es sei denn, die Anweisung ist DDL, was nicht als gemeinsam nutzbar betrachtet wird. Die Größe des zugewiesenen Speichers hängt von der Komplexität der Anweisung ab.
Gemeinsame SQL-Bereiche
Die Datenbank stellt jede SQL-Anweisung dar, die sie im Shared SQL-Bereich und im privaten SQL-Bereich ausführt.
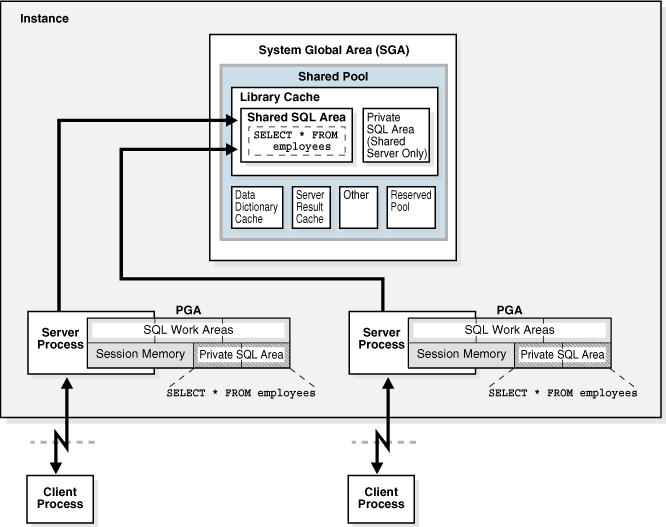
Die Datenbank verwendet den Shared SQL-Bereich, um das erste Auftreten einer SQL-Anweisung zu verarbeiten. Dieser Bereich ist für alle Benutzer zugänglich und enthält den Anweisungsparsebaum und den Ausführungsplan. Für eine eindeutige Anweisung ist nur ein Shared SQL-Bereich vorhanden. Jede Session, die eine SQL-Anweisung absetzt, verfügt über einen privaten SQL-Bereich in ihrer PGA. Jeder Benutzer, der dieselbe Anweisung weiterleitet, verfügt über einen privaten SQL-Bereich, der auf denselben Shared SQL-Bereich verweist. Daher können viele private SQL-Bereiche in separaten PGAs mit demselben Shared SQL-Bereich verknüpft werden.
Die Datenbank bestimmt automatisch, wann Anwendungen ähnliche SQL-Anweisungen weiterleiten. Die Datenbank berücksichtigt sowohl SQL-Anweisungen, die direkt von Benutzern und Anwendungen abgesetzt wurden, als auch rekursive SQL-Anweisungen, die intern von anderen Anweisungen abgesetzt wurden.
Die Datenbank führt die folgenden Schritte aus:
-
Prüft, ob ein Shared SQL-Bereich für eine syntaktisch und semantisch identische Anweisung vorhanden ist:
-
Wenn eine identische Anweisung vorhanden ist, verwendet die Datenbank den Shared SQL-Bereich für die Ausführung der nachfolgenden neuen Instanzen der Anweisung, wodurch der Speicherverbrauch reduziert wird.
-
Wenn keine identische Anweisung vorhanden ist, weist die Datenbank einen neuen Shared SQL-Bereich im Shared Pool zu. Eine Anweisung mit derselben Syntax, aber unterschiedlicher Semantik verwendet einen untergeordneten Cursor.
In beiden Fällen verweist der private SQL-Bereich für den Benutzer auf den Shared SQL-Bereich, der die Anweisung und den Ausführungsplan enthält.
-
-
Ordnet einen privaten SQL-Bereich für die Session zu
Der Speicherort des privaten SQL-Bereichs hängt von der Verbindung ab, die für die Session hergestellt wurde. Wenn eine Session über einen Shared Server verbunden ist, wird ein Teil des privaten SQL-Bereichs in der SGA beibehalten.
Abbildung 17-6 zeigt eine dedizierte Serverarchitektur, in der zwei Sessions eine Kopie derselben SQL-Anweisung in ihren eigenen PGAs speichern. In einem Shared Server befindet sich diese Kopie in der UGA, die sich in der MGA befindet.
Abbildung 6: Private SQL-Bereiche und Shared SQL-Bereich
Beschreibung der Abbildung cncpt252.gif
Siehe:
-
Oracle AI Database Performance Tuning Guide, um mehr über die Verwaltung des Library-Caches zu erfahren
-
Oracle AI Database Development Guide für weitere Informationen zu Shared SQL
Programmeinheiten und der Library Cache
Der Library-Cache enthält ausführbare Formen von PL/SQL-Programmen und Java-Klassen. Diese Elemente werden zusammen als Programmeinheiten bezeichnet.
Die Datenbank verarbeitet Programmeinheiten ähnlich wie SQL-Anweisungen. Beispiel: Die Datenbank weist einen Shared Area zu, der die geparste, kompilierte Form eines PL/SQL-Programms enthält. Die Datenbank weist einen privaten Bereich zu, der bestimmte Werte für die Session enthält, in der das Programm ausgeführt wird. Dazu gehören lokale, globale und Packagevariablen sowie Puffer für die Ausführung von SQL. Wenn mehrere Benutzer dasselbe Programm ausführen, verwaltet jeder Benutzer eine separate Kopie seines privaten SQL-Bereichs, der sessionspezifische Werte enthält, und greift auf einen einzelnen Shared SQL-Bereich zu.
Die Datenbank verarbeitet einzelne SQL-Anweisungen innerhalb einer PL/SQL-Programmeinheit wie zuvor beschrieben. Trotz ihrer Ursprünge innerhalb einer PL/SQL-Programmeinheit verwenden diese SQL-Anweisungen einen Shared Area, um ihre geparsten Darstellungen zu speichern, und einen privaten Bereich für jede Session, in der die Anweisung ausgeführt wird.
Zuweisung und Wiederverwendung von Speicher im Shared Pool
Die Datenbank weist Shared Pool-Speicher zu, wenn eine neue SQL-Anweisung geparst wird, es sei denn, die Anweisung ist DDL, was nicht als gemeinsam verwendbar gilt. Die Größe des zugewiesenen Speichers hängt von der Komplexität der Anweisung ab.
Im Allgemeinen bleibt ein Element im Shared Pool so lange erhalten, bis die Datenbank es gemäß einem LRU-(Least Recently Used-)Algorithmus entfernt. Die Datenbank ermöglicht, dass Shared Pool-Elemente, die von vielen Sessions verwendet werden, im Speicher bleiben, solange sie nützlich sind, selbst wenn der Datenbankprozess, der das Element erstellt hat, beendet wird. Dieser Mechanismus minimiert den Overhead und die Verarbeitung von SQL-Anweisungen. Wenn Speicherplatz für neue Elemente benötigt wird, gibt die Datenbank Speicherplatz frei, der von selten verwendeten Elementen belegt wird.
Die Anweisung ALTER SYSTEM FLUSH SHARED_POOL entfernt alle Informationen im Shared Pool, ebenso wie die Änderung des globalen Datenbanknamens.
Siehe:
-
Oracle AI Database SQL Tuning Guide für einen Überblick über den Lebenszyklus eines Shared SQL-Bereichs
-
Oracle AI Database SQL Language Reference für Informationen zur Verwendung von
ALTER SYSTEM FLUSH SHARED_POOL -
Oracle AI Database Reference für Informationen zu dynamischen Ansichten
V$SQLundV$SQLAREA
Data-Dictionary-Cache
Das Data Dictionary ist eine geschützte Sammlung von Datenbanktabellen und Views, die Referenzinformationen über die Datenbank, ihre Strukturen und ihre Benutzer enthalten.
Oracle AI Database greift beim Parsen von SQL-Anweisungen häufig auf das Data Dictionary zu. Oracle AI Database greift so oft auf das Data Dictionary zu, dass die folgenden speziellen Speicherorte für Dictionary-Daten bestimmt sind:
-
Data Dictionary-Cache
Dieser Cache enthält Informationen zu Datenbankobjekten. Der Cache wird auch als Zeilencache bezeichnet, da er Daten als Zeilen statt als Puffer speichert.
-
Library-Cache
Alle Serverprozesse verwenden diese Caches für den Zugriff auf Data Dictionary-Informationen gemeinsam.
Siehe:
-
Oracle AI Database Performance Tuning Guide, um zu erfahren, wie Sie dem Data Dictionary-Cache zusätzlichen Speicher zuweisen
Serverergebniscache
Der Serverergebniscache ist ein Speicherpool im Shared Pool. Im Gegensatz zu den Pufferpools enthält der Serverergebniscache Ergebnismengen und keine Datenblöcke. Hinweis: Ein Clientergebniscache unterscheidet sich vom Serverergebniscache. Ein Clientcache wird auf Anwendungsebene konfiguriert und befindet sich im Clientspeicher, nicht im Datenbankspeicher.
-
SQL-Abfrageergebniscache Der SQL-Abfrageergebniscache ist eine Teilmenge des Serverergebniscache, in dem die Ergebnisse von Abfragen und Abfragefragmenten gespeichert werden. Sie können das Ergebnis-Caching auf Datenbank- oder Anweisungsebene aktivieren oder deaktivieren.
-
PL/SQL-Funktionsergebniscache Der PL/SQL-Funktionsergebniscache ist eine Teilmenge des Serverergebniscaches, in dem Funktionsergebnismengen gespeichert werden.
-
Serverergebnis-Cache-Infrastruktur Der Abfrageergebniscache und der PL/SQL-Funktionsergebniscache verwenden dieselbe Infrastruktur.
-
Benutzeroberfläche für Serverergebniscache Der Initialisierungsparameter
RESULT_CACHE_MODEbestimmt, ob der SQL-Abfrageergebniscache für alle möglichen Abfragen oder nur für angezeigte Abfragen verwendet wird.
SQL-Abfrageergebniscache
Der SQL-Abfrageergebniscache ist eine Teilmenge des Serverergebniscaches, in dem die Ergebnisse von Abfragen und Abfragefragmenten gespeichert werden. Sie können das Ergebnis-Caching auf Datenbank- oder Anweisungsebene aktivieren oder deaktivieren.
Wenn eine Abfrage ausgeführt wird, bestimmt die Datenbank, ob das Ergebnis im Abfrageergebniscache vorhanden ist. Wenn das Ergebnis nicht im Cache gespeichert wird und das Caching für die Abfrage aktiviert ist, führt die Datenbank die Abfrage aus, gibt das Ergebnis zurück und speichert es anschließend. Wenn das Ergebnis jedoch vorhanden ist, ruft die Datenbank es aus dem Cache ab, anstatt die Abfrage auszuführen.
Die Datenbank invalidiert automatisch ein gecachtes Ergebnis, wenn eine Transaktion die Daten oder Metadaten von Datenbankobjekten ändert, die zum Erstellen des Ergebnisses verwendet werden. Die nächste Abfrage kann das gecachte Ergebnis nicht verwenden. Daher berechnet die Datenbank automatisch ein neues Ergebnis und speichert es anschließend zur Verwendung durch nachfolgende Abfragen im Cache. Der Cacheaktualisierungsprozess ist für die Anwendung transparent.
Tatsächlich fungiert der Abfrageergebniscache als "Just-in-Time"-Materialized View, die von der Datenbank nach Bedarf erstellt und verwaltet wird. Der Cache ermöglicht es der Datenbank, den aufwändigen Vorgang des erneuten Lesens von Datenblöcken und der Neuberechnung von Ergebnissen zu vermeiden. Die meisten Anwendungen profitieren von dieser Leistungssteigerung.
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie die Antwortzeit mit dem Abfrageergebniscache optimieren.
Ergebniscache für PL/SQL-Funktionen
Der PL/SQL-Funktionsergebniscache ist eine Teilmenge des Serverergebniscaches, in dem Funktionsergebnismengen gespeichert werden.
Ohne Caching würden 1000 Aufrufe einer PL/SQL-Funktion bei 1 Sekunde pro Aufruf 1000 Sekunden dauern. Beim Caching können 1000 Funktionsaufrufe mit den gleichen Eingaben 1 Sekunde gesamt dauern. Gute Kandidaten für das Ergebnis-Caching sind häufig aufgerufene Funktionen, die von relativ statischen Daten abhängen.
Der PL/SQL-Funktionscode kann eine Anforderung zum Cachen der Ergebnisse enthalten. Beim Aufruf dieser Funktion prüft das System den Cache. Wenn der Cache das Ergebnis eines vorherigen Funktionsaufrufs mit denselben Parameterwerten enthält, gibt das System das Ergebnis an den ausführenden Benutzer zurück und führt den Funktionsbody nicht erneut aus. Wenn der Cache das Ergebnis nicht enthält, führt das System den Funktionsbody aus und fügt das Ergebnis (für diese Parameterwerte) dem Cache hinzu, bevor die Kontrolle an den ausführenden Benutzer zurückgegeben wird.
Hinweis: Sie können die Datenbankobjekte angeben, mit denen ein gecachtes Ergebnis berechnet wird. Wenn eines davon aktualisiert wird, wird das gecachte Ergebnis ungültig und muss neu berechnet werden.
Eine Funktion, die häufig mit unterschiedlichen Argumenten aufgerufen wird, kann Ergebnisse generieren, die selten wiederverwendet werden, was zu einer Performanceverschlechterung führt. Oracle AI Database verfolgt zuletzt verwendete PL/SQL-Funktionen mit dem Hint RESULT_CACHE. Mit dieser Historie cacht die Datenbank eine PL/SQL-Funktion und ein Argumentpaar nur, wenn sie x mal in der letzten Historie gesehen hat, wobei x durch einen internen Schwellenwert festgelegt ist. Wenn die Datenbank mehr Speicher benötigt, weil zu viele Ergebnisse im Cache gespeichert werden, werden mindestens ein gecachtes Ergebnis überschrieben.
RESULT_CACHE_EXECUTION_THRESHOLD gibt an, wie oft eine Funktion und eine bestimmte Gruppe von Argumenten angezeigt werden müssen, bis sie gecacht wird. Beachten Sie, dass Funktionen als eindeutig gelten, wenn sie unterschiedliche Argumente aufweisen, z.B. MYFUNC(1,2) und MYFUNC(1,3). Sie können diesen Parameter nur auf Systemebene und nicht auf Sessionebene festlegen.
Siehe:
-
Oracle AI Database Development Guide, um mehr über den Ergebniscache der PL/SQL-Funktion zu erfahren
-
Oracle AI Database PL/SQL Language Reference, um mehr über den Ergebniscache der PL/SQL-Funktion zu erfahren
Serverergebnis-Cache-Infrastruktur
Der Abfrageergebniscache und der PL/SQL-Funktionsergebniscache nutzen dieselbe Infrastruktur.
Objekttypen: Ergebnis, Abhängigkeit und Temp
Im Serverergebniscache ist ein Ergebnisobjekt eine Datenstruktur, in der die von einer Abfrage oder PL/SQL-Funktion zurückgegebenen Zeilen gespeichert werden. Ein Abhängigkeitsobjekt speichert die Metadaten für Objekte, auf die Abfragen verweisen, die als Ergebnisobjekte gespeichert sind.
Ein typisches Abfrageergebnis ist klein, teuer zu berechnen, oft wiederverwendet und basiert auf nichtflüchtigen Tabellen. Die Ergebnisse können jedoch manchmal groß sein. Wenn ein Abfrageergebnis das Größenlimit überschreitet, speichert die Datenbank einen Teil des Ergebnisses als temp-Objekt und einen Teil als Standardergebnisobjekt. Ein temporäres Objekt ist eine Sammlung von Ergebnis-Cache-Metadaten, die auf ein temporäres Tablespace-Segment verweisen, das das tatsächliche Abfrageergebnis enthält.
Ergebnis-Untercaches
Je nach Workload kann die Datenbank Ergebnis-Untercaches erstellen, um einen höheren gleichzeitigen Zugriff während des Lese-/Schreibzugriffs zu unterstützen. Oracle AI Database verwendet einen internen Algorithmus, um zu entscheiden, ob Untercaches erstellt werden sollen, und wenn ja, wie viele erstellt werden sollen.
Benutzeroberfläche des Serverergebniscaches
Der Initialisierungsparameter RESULT_CACHE_MODE bestimmt, ob der SQL-Abfrageergebniscache für alle möglichen Abfragen oder nur für angezeigte Abfragen verwendet wird.
Der Initialisierungsparameter RESULT_CACHE_MAX_TEMP_SIZE steuert den maximalen Temporary Tablespace-Speicher, den der Ergebniscache in der PDB belegen kann. RESULT_CACHE_MAX_TEMP_RESULT steuert den maximalen Temporary Tablespace-Speicher, den eine gecachte Abfrage belegen kann.
Um die Parametereinstellung RESULT_CACHE_MODE außer Kraft zu setzen, können Sie eine Abfrage oder ein Abfragefragment mit einem RESULT_CACHE-Hinweis annotieren. Ab Oracle Database 21c akzeptiert der Hint die Option TEMP={TRUE|FALSE}, mit der gesteuert wird, ob die Ergebnisse in einem temporären Tablespace gespeichert werden können.
Mit dem Package DBMS_RESULT_CACHE können Sie den Teil des Shared Pools verwalten, der vom SQL-Ergebniscache und dem Ergebniscache der PL/SQL-Funktion verwendet wird. Sie können Objekte, Sperrlistenabfragen und Objekte invalidieren und zugehörige Vorgänge ausführen.
Die Spalte V$RESULT_CACHE_OBJECTS.TYPE gibt den Typ der Objekte im Cache an. Wenn Abfrageergebnisse im temporären Tablespace gespeichert werden, zeigt TYPE zwei Objekte an: Result und Temp. Auf Subcache-Metadaten kann über V$RESULT_SUBCACHE_STATISTICS und zugehörige Ansichten zugegriffen werden.
Siehe:
-
Oracle AI Database - Administratordokumentation mit Informationen zur Größenbestimmung und Kontrolle des Verhaltens des Ergebniscaches
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zum
DBMS_RESULT_CACHE-Package -
Oracle AI Database Performance Tuning Guide für weitere Informationen zum Clientergebniscache
-
Oracle AI Database Reference, um mehr über den Initialisierungsparameter
RESULT_CACHE_MODEzu erfahren -
Oracle AI Database SQL Language Reference, um mehr über den Hint
RESULT_CACHEzu erfahren
Reservierter Pool
Der reservierte Pool ist ein Speicherbereich im Shared Pool, mit dem Oracle AI Database große zusammenhängende Speicherblöcke zuweisen kann.
Die Datenbank weist Speicher aus dem Shared Pool in Blöcken zu. Durch Chunking können große Objekte (über 5 KB) in den Cache geladen werden, ohne dass ein einzelner zusammenhängender Bereich erforderlich ist. Auf diese Weise verringert die Datenbank die Möglichkeit, dass der zusammenhängende Speicher aufgrund der Fragmentierung ausgeht.
In seltenen Fällen können Java-, PL/SQL- oder SQL-Cursor Zuweisungen aus dem Shared Pool vornehmen, die größer als 5 KB sind. Damit diese Zuweisungen am effizientesten erfolgen können, trennt die Datenbank einen kleinen Teil des Shared Pools für den reservierten Pool.
Siehe auch: In Oracle AI Database Performance Tuning Guide erfahren Sie, wie Sie den reservierten Pool konfigurieren.
Large Pool
Der große Pool ist ein optionaler Speicherbereich, der für Speicherzuweisungen gedacht ist, die größer sind, als für den Shared Pool geeignet ist.
Der Large Pool kann große Speicherzuweisungen für Folgendes bereitstellen:
-
Bei paralleler Ausführung verwendete Nachrichtenpuffer
-
Puffer für untergeordnete Recovery Manager-(RMAN-)I/O-Prozesse
-
Puffer für verzögerte Einfügungen (einfügt mit dem Hint
MEMOPTIMIZE_WRITE)
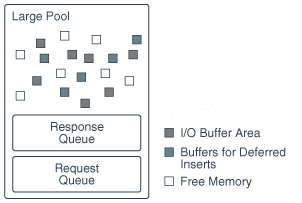
Die folgende Abbildung zeigt den großen Pool.
Abbildung 7: Großer Pool
Beschreibung der Abbildung cncpt221.png
-
Large Pool Memory Management Der Large Pool verwaltet den Speicher anders als der Shared Pool, der eine LRU-Liste verwendet, sodass Teile des Speichers veraltet werden können.
-
Große Pool-Puffer für verzögerte Einfügungen Bei einem speziellen Einfügetyp, der als verzögerte Einfügung bezeichnet wird, weist die Datenbank Puffer aus dem großen Pool zu.
Siehe:
-
"Abfragekoordinator" für Informationen zur Speicherzuweisung für die parallele Ausführung
-
"Dispatcher Request and Response Queues", um mehr über die Zuweisung von Session-Speicher für Shared Server zu erfahren
-
Oracle AI Database – Entwicklungshandbuch, um mehr über Oracle XA zu erfahren
-
Oracle AI Database Performance Tuning Guide für weitere Informationen zum Large Pool
Speicherverwaltung für große Pools
Der Large Pool verwaltet den Speicher anders als der Shared Pool, der eine LRU-Liste verwendet, sodass Teile des Speichers veraltet sein können.
Der Large Pool hat keine LRU-Liste. Wenn die Datenbank einer Datenbank-Session großen Pool-Speicher zuweist, kann dieser Speicher nur freigegeben werden, wenn er von der Session freigegeben wird. Sobald ein Teil des Speichers freigegeben wird, können andere Prozesse ihn verwenden. Durch die Zuweisung von Sitzungsspeicher aus dem Large Pool vermeidet die Datenbank die Fragmentierung, die im Shared Pool auftreten kann.
Große Poolpuffer für verzögerte Einfügungen
Bei einem speziellen Einfügetyp, der als verzögerter Einfügevorgang bezeichnet wird, weist die Datenbank Puffer aus dem Large Pool zu.
Für schnelle "fire and forget"-Einfügungen aus Internet of Things-(IoT-)Anwendungen verursacht die Datenbankinfrastruktur einen Performance-Overhead. Der Codepfad umfasst beispielsweise die Navigation im Puffercache, Puffer-Pins und den Schutz vor gleichzeitigem Zugriff. Array-Einfügungen minimieren diese Kosten, aber das Array muss auf der Clientseite erstellt werden, was nicht typisch für Internet of Things-Anwendungen ist. Um dieses Problem zu beheben, kann eine Oracle-Anwendung mit einem Hint Zeilen in eine Tabelle einfügen, die als MEMOPTIMIZE FOR WRITE angegeben ist.
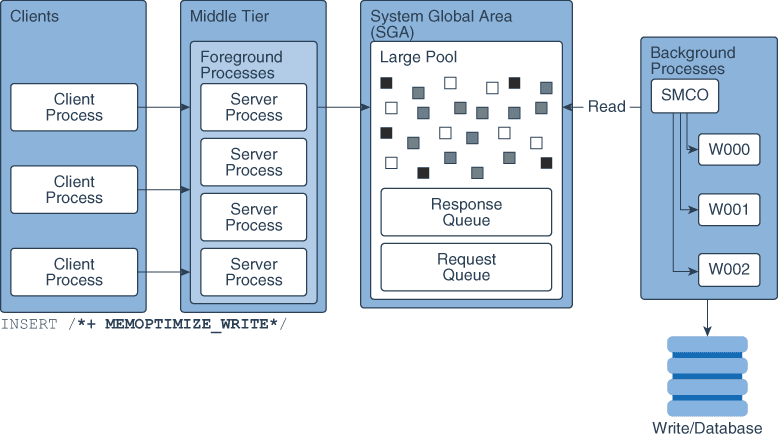
Die Einfügungen werden verzögert, weil sie im Large Pool gepuffert und später asynchron von Hintergrundprozessen auf die Festplatte geschrieben werden. Die Datenbank verarbeitet verzögerte Einfügungen wie folgt:
-
Die Anwendung sendet
MEMOPTIMIZE_WRITE-Einfügungen an eine Middle Tier, die Daten aggregieren kann. Während eine IoT-Anwendung fast immer Einfügungen an die Middle Tier sendet, ist es auch möglich, Einfügungen direkt an die Datenbank zu senden. Beispiel: Mit SQL*Plus werden die Einfügungen direkt an die Datenbank gesendet. -
Die Middle Tier schreibt die Aggregation von Einfügungen auf den Datenbankserver.
-
Optional bewahrt der Middle Tier-Client eine lokale Kopie der Daten auf, die er im vorherigen Schritt geschrieben hat.
-
Ein Serverprozess schreibt Daten in einen Puffer oder Puffer im Large Pool.
Um Konflikte zu vermeiden, verfügt jeder Puffer über einen eigenen internen Verriegelungsmechanismus. Dieser Sperrmechanismus ist von dem Sperrmechanismus getrennt, den der Datenbankpuffercache für seine Puffer verwendet. Der grundlegende Schreibprozess lautet wie folgt:
-
Nach dem Hochfahren der Instanz weist die erste
MEMOPTIMIZE_WRITEinsert die Puffer aus dem Large Pool zu. -
Der Writer wählt einen Puffer aus der Liste der verfügbaren Puffer.
-
Wenn der gewählte Puffer nicht gesperrt ist und dieser Puffer über freien Speicherplatz verfügt, schreibt der Client in den Puffer, wobei jeder Pufferschreibvorgang mit einer sessionspezifischen Folgenummer versehen wird. Wenn nicht, kehrt der Writer zum vorherigen Schritt zurück und fährt auf diese Weise fort, bis entweder ein Puffer gefunden wird oder genügend Speicherplatz im Large Pool freigegeben wurde.
-
-
Die Datenbank erstellt aus den gepufferten Daten ein serverseitiges Array.
-
Der Space Management Coordinator (SMCO) und seine Helper-Prozesse (Wnnn) schreiben das Array asynchron mit dem Standarddatenblockformat auf den Datenträger.
Im Gegensatz zu Standard-Einfügungen werden verzögerte Einfügungen automatisch festgeschrieben und können nicht zurückgesetzt werden. Die Datenbank schreibt die Einfügungen für ein bestimmtes Objekt in der Reihenfolge fest, in der sie in einer Session angezeigt werden. Es gibt keine Garantie, zwischen Objekten oder Sessions zu sortieren.
Die Datenbank unterstützt Constraints und Indexverwaltung genauso wie bei regulären Einfügungen. Die Datenbank führt jedoch beim Schreiben auf die Festplatte Auswertungen durch, nicht beim Schreiben in den Large Pool.
Hinweis: Um eine optimale Performance zu erzielen, empfiehlt Oracle, Constraints zu deaktivieren.
Die folgende Abbildung zeigt den Workflow für verzögerte Einfügungen.
Abbildung 8: Verzögert InsertMechanism
Beschreibung der Abbildung cncpt_pb_002a.png
Siehe:
-
Oracle AI Database Performance Tuning Guide, um zu erfahren, wie Tabellen als
MEMOPTIMIZE FOR WRITEangegeben werden -
Oracle AI Database SQL Language Reference für
INSERT-Syntax und Semantik -
Oracle AI Database Reference, um mehr über
MEMOPTIMIZE_POOL_SIZEzu erfahren
Java Pool
Beim Java-Pool handelt es sich um einen Speicherbereich, der für die gesamten sessionspezifischen Java-Code und Daten innerhalb der Java Virtual Machine (JVM) speichert. Dieser Speicher umfasst Java-Objekte, die am Ende des Aufrufs in den Java-Sessionbereich migriert werden.
Bei dedizierten Serververbindungen enthält der Java-Pool den gemeinsamen Teil jeder Java-Klasse, einschließlich Methoden und schreibgeschütztem Speicher, wie Codevektoren, aber nicht den Java-Status jeder Session pro Session. Für Shared Server umfasst der Pool den Shared-Teil jeder Klasse und einige UGA, die für den Status jeder Session verwendet werden. Jede UGA wächst und verkleinert sich nach Bedarf. Die gesamte UGA-Größe muss jedoch in den Java-Poolbereich passen.
Die Java Pool Advisor-Statistiken enthalten Informationen zum Library-Cachespeicher, der für Java verwendet wird, und prognostizieren, wie sich Änderungen der Größe des Java-Pools auf die Parse-Rate auswirken können. Java Pool Advisor ist intern aktiviert, wenn statistics_level auf TYPICAL oder höher gesetzt ist. Diese Statistiken werden zurückgesetzt, wenn der Advisor deaktiviert ist.
Siehe:
-
Oracle AI Database Performance Tuning Guide mit Informationen zu Ansichten mit Java Pool Advisory-Statistiken
Feste SGA
Die feste SGA ist ein interner Housekeeping-Bereich.
Beispiel: Die feste SGA enthält:
-
Allgemeine Informationen zum Status der Datenbank und der Instanz, auf die Hintergrundprozesse zugreifen müssen
-
Informationen, die zwischen Prozessen kommuniziert werden, z. B. Informationen zu Sperren
Die Größe der festen SGA wird von Oracle AI Database festgelegt und kann nicht manuell geändert werden. Die feste SGA-Größe kann von Release zu Release geändert werden.
Siehe auch: "Überblick über automatische Sperren"
Optionale leistungsbezogene SGA-Subareas
Einige SGA-Unterbereiche sind nur für bestimmte Performance-Features aktiviert.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
In-Memory-Bereich Der In-Memory-Bereich ist eine optionale SGA-Komponente, die den In-Memory Column Store (IM-Spaltenspeicher) enthält.
-
Memoptimize Pool Der memoptimize pool speichert Puffer und zugehörige Strukturen für Heap-organisierte Tabellen, die als
MEMOPTIMIZE FOR READangegeben sind.
Speicherresidenter Bereich
Der In-Memory-Bereich ist eine optionale SGA-Komponente, die den In-Memory Column Store (IM-Spaltenspeicher) enthält.
Der IM-Spaltenspeicher enthält Kopien von Tabellen, Partitionen und Materialized Views in einem Spaltenformat, das für schnelle Scans optimiert ist. Der IM-Spaltenspeicher ergänzt den Datenbankpuffercache, in dem Daten IM herkömmlichen Zeilenformat gespeichert werden.
Hinweis: Um einen IM-Spaltenspeicher zu aktivieren, muss die Option "Oracle AI Database In-Memory" aktiviert sein.
Siehe auch: Oracle AI Database In-Memory Guide, um mehr über den In-Memory-Bereich und den IM-Spaltenspeicher zu erfahren
Speicheroptimierungspool
Im memoptimize pool werden Puffer und zugehörige Strukturen für Heap-organisierte Tabellen gespeichert, die als MEMOPTIMIZE FOR READ angegeben sind.
Diese Struktur bietet hohe Performance und Skalierbarkeit für schlüsselbasierte Abfragen wie SELECT * FROM cust WHERE cid = 10. Um die End-to-End-Reaktionszeit zu reduzieren, ziehen Clients angeforderte Puffer direkt aus der SGA über das Netzwerk, wodurch CPU- und Betriebssystem-Overhead vermieden werden. Anwendungen können vom memoptimize-Pool profitieren, ohne dass Codeänderungen erforderlich sind.
Der memoptimierungs-Pool enthält zwei Teile:
-
Speicherbereich optimieren
Um Datenträger-I/O zu vermeiden, sperrt die Datenbank Puffer für
MEMOPTIMIZE FOR READ-Tabellen im memoptimize-Pool dauerhaft, bis die Tabelle alsNO MEMOPTIMIZE FOR READmarkiert ist. Die memoptimize-Puffer verwenden dieselbe Struktur wie die Puffer im Datenbank-Puffercache. Die Puffer im memoptimize-Pool sind jedoch vollständig vom Datenbankpuffercache getrennt und werden nicht auf ihre Größe angerechnet. Der memoptimize-Pufferbereich belegt 75% des memoptimize-Pools. -
Hash-Index
Ein Hash-Index ist eine nicht persistente Segmentdatenstruktur. Die Datenbank weist den Hash-Index als mehrere, nicht aufeinanderfolgende Speichereinheiten zu. Jede Einheit enthält eine Reihe von Hash Buckets. Eine separate Kartenstruktur korreliert eine Speichereinheit mit einem Primärschlüssel. Der Hash-Index belegt 25% des Memoptimize-Pools. Abbildung 9: Memoptimize-Pool
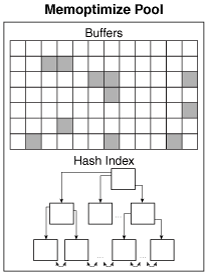
Beschreibung der Abbildung cncpt_pb_001a.png
Um den memoptimize-Pool zu aktivieren, setzen Sie den Initialisierungsparameter MEMOPTIMIZE_POOL_SIZE auf einen ganzzahligen Wert (der Pool ist standardmäßig deaktiviert). Der Wert gibt die Menge der SGA an, die dem Pool zugewiesen werden soll. Der Wert MEMOPTIMIZE_POOL_SIZE wird auf SGA_TARGET angerechnet, aber die Datenbank vergrößert und verkleinert den memoptimize-Pool nicht automatisch. Beispiel: Wenn SGA_TARGET 10 GB beträgt und MEMOPTIMIZE_POOL_SIZE 1 GB beträgt, sind insgesamt 9 GB für SGA-Speicher außer dem memoptimize-Pool verfügbar.
Um die Größe des memoptimize-Pools zu ändern, müssen Sie MEMOPTIMIZE_POOL_SIZE manuell festlegen und die Datenbankinstanz neu starten. Sie können die Poolgröße nicht dynamisch mit ALTER SYSTEM ändern.
Mit dem Package DBMS_MEMOPTIMIZE können Sie eine Tabelle explizit in den Memoptimize-Pool auffüllen.
Siehe:
-
Oracle AI Database Performance Tuning Guide, um zu erfahren, wie Sie die Abfrageperformance verbessern, indem Sie den Memoptimize-Pool aktivieren
-
Oracle AI Database PL/SQL Packages and Types Reference für weitere Informationen zum
DBMS_MEMOPTIMIZE-Package -
Oracle AI Database SQL Language Reference, um mehr über
CREATE TABLE ... MEMOPTIMIZE FOR READzu erfahren -
Oracle AI Database Reference, um mehr über
MEMOPTIMIZE_POOL_SIZEzu erfahren
Program Global Area (PGA) - Überblick
Die PGA ist speicherspezifisch für einen Betriebssystemprozess oder Thread, der nicht von anderen Prozessen oder Threads im System gemeinsam verwendet wird. Da die PGA prozessspezifisch ist, wird sie niemals in der SGA zugewiesen.
Die PGA ist ein Memory Heap, der sessionabhängige Variablen enthält, die von einem dedizierten oder Shared Server-Prozess benötigt werden. Der Serverprozess weist Speicherstrukturen zu, die er in der PGA benötigt.
Eine Analogie zu einer PGA ist ein temporärer Arbeitsbereich, der von einem Dateikler verwendet wird. In dieser Analogie ist der Datei-Sachbearbeiter der Server-Prozess, der im Auftrag des Kunden arbeitet (Client-Prozess). Der Sachbearbeiter löscht einen Abschnitt der Arbeitsplatte, verwendet den Arbeitsbereich, um Details über die Kundenanforderung zu speichern und die vom Kunden angeforderten Ordner zu sortieren, und gibt dann den Platz auf, wenn die Arbeit abgeschlossen ist.
Die folgende Abbildung zeigt eine Instanz-PGA (Sammlung aller PGAs) für eine Instanz, die nicht für Shared Server konfiguriert ist. Mit einem Initialisierungsparameter können Sie die maximale Zielgröße der Instanz-PGA festlegen. Einzelne PGAs können je nach Bedarf bis zu dieser Zielgröße wachsen.
Abbildung 10: Instanz-PGA
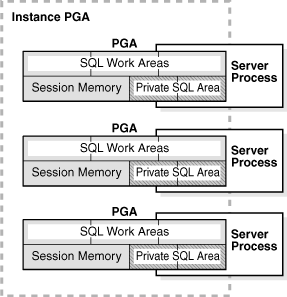
Beschreibung der Abbildung cncpt218.gif
Hinweis: Hintergrundprozesse weisen auch eigene PGAs zu. Diese Diskussion konzentriert sich nur auf Serverprozess-PGAs.
-
Inhalt der PGA Die PGA ist in verschiedene Bereiche unterteilt, die jeweils einen anderen Zweck haben.
-
PGA-Auslastung in dedizierten und Shared Server-Modi Die PGA-Speicherzuweisung hängt davon ab, ob die Datenbank dedizierte oder Shared Server-Verbindungen verwendet. Siehe auch: Oracle AI Database Performance Tuning Guide für einen Überblick über die PGA-Speicherverwaltung
Inhalt der PGA
Die PGA ist in verschiedene Bereiche unterteilt, die jeweils einen anderen Zweck haben.
Die folgende Abbildung zeigt den möglichen Inhalt der PGA für eine dedizierte Server-Session. Nicht alle PGA-Bereiche werden in jedem Fall existieren.
Abbildung 11: PGA-Inhalt
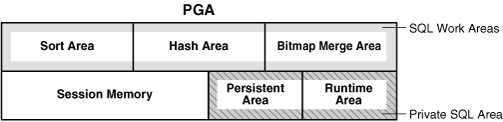
Beschreibung der Abbildung cncpt219.gif
-
Privater SQL-Bereich Ein privater SQL-Bereich enthält Informationen zu einer geparsten SQL-Anweisung und anderen sitzungsspezifischen Informationen zur Verarbeitung.
-
SQL-Arbeitsbereiche Ein Arbeitsbereich ist eine private Zuweisung von PGA-Speicher, der für speicherintensive Vorgänge verwendet wird.
Privater SQL-Bereich
Ein privater SQL-Bereich enthält Informationen zu einer geparsten SQL-Anweisung und anderen sitzungsspezifischen Informationen zur Verarbeitung.
Wenn ein Serverprozess SQL- oder PL/SQL-Code ausführt, verwendet der Prozess den privaten SQL-Bereich, um Variablenwerte, Informationen zum Ausführungsstatus der Abfrage und Arbeitsbereiche für die Abfrageausführung zu speichern.
Verwechseln Sie einen privaten SQL-Bereich, der sich in der PGA befindet, nicht mit dem SQL-Bereich Shared, in dem Ausführungspläne in der SGA gespeichert werden. Mehrere private SQL-Bereiche in denselben oder verschiedenen Sessions können auf einen einzelnen Ausführungsplan in der SGA verweisen. Beispiel: 20 Ausführungen von SELECT * FROM sales in einer Session und 10 Ausführungen derselben Abfrage in einer anderen Session können denselben Plan gemeinsam verwenden. Die privaten SQL-Bereiche für jede Ausführung werden nicht gemeinsam verwendet und können unterschiedliche Werte und Daten enthalten.
Ein Cursor ist ein Name oder ein Handle für einen bestimmten privaten SQL-Bereich. Wie in der folgenden Grafik dargestellt, können Sie einen Cursor als Zeiger auf der Clientseite und als Status auf der Serverseite betrachten. Da Cursor eng mit privaten SQL-Bereichen verknüpft sind, werden die Begriffe manchmal austauschbar verwendet.
Abbildung 12: Cursor
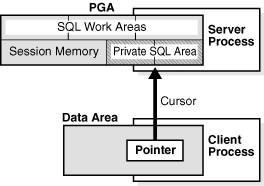
Beschreibung der Abbildung cncpt324.gif
Ein privater SQL-Bereich ist in folgende Bereiche unterteilt:
-
Der Laufzeitbereich
Dieser Bereich enthält Informationen zum Ausführungsstatus der Abfrage. Beispiel: Der Laufzeitbereich verfolgt die Anzahl der Zeilen, die bisher in einem vollständigen Tabellenscan abgerufen wurden.
Oracle AI Database erstellt den Laufzeitbereich als ersten Schritt einer Ausführungsanforderung. Bei DML-Anweisungen wird der Laufzeitbereich freigegeben, wenn die SQL-Anweisung geschlossen wird.
-
Der persistente Bereich
Dieser Bereich enthält bind variable Werte. Ein Bind-Variablenwert wird zur Laufzeit einer SQL-Anweisung bereitgestellt, wenn die Anweisung ausgeführt wird. Der persistente Bereich wird nur freigegeben, wenn der Cursor geschlossen ist.
Der Clientprozess ist für die Verwaltung privater SQL-Bereiche verantwortlich. Die Zuweisung und Aufhebung der Zuweisung privater SQL-Bereiche hängt weitgehend von der Anwendung ab, obwohl die Anzahl der privaten SQL-Bereiche, die ein Clientprozess zuweisen kann, durch den Initialisierungsparameter OPEN_CURSORS begrenzt ist.
Obwohl die meisten Benutzer auf die automatische Cursorbehandlung von Datenbankutilitys angewiesen sind, bieten die programmatischen Schnittstellen von Oracle AI Database Entwicklern mehr Kontrolle über Cursor. Im Allgemeinen sollten Anwendungen alle geöffneten Cursor schließen, die nicht erneut verwendet werden, um den persistenten Bereich freizugeben und den für Anwendungsbenutzer erforderlichen Speicher zu minimieren.
Siehe:
-
Oracle AI Database Development Guide und Oracle AI Database PL/SQL Language Reference, um zu erfahren, wie Cursor verwendet werden
SQL-Arbeitsbereiche
Ein Arbeitsbereich ist eine private Zuweisung von PGA-Speicher, der für speicherintensive Vorgänge verwendet wird.
Beispiel: Ein Sortieroperator verwendet den Sortierbereich, um eine Reihe von Zeilen zu sortieren. Ebenso verwendet ein Hash Join-Operator einen Hash-Bereich, um eine Hash-Tabelle aus der linken Eingabe zu erstellen, während eine Bitmapzusammenführung den Bitmapzusammenführungsbereich verwendet, um Daten zusammenzuführen, die aus Scans mehrerer Bitmapindizes abgerufen wurden.
Das folgende Beispiel zeigt einen Join von employees und departments mit dem zugehörigen Abfrageplan:
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------
Im vorherigen Beispiel verfolgt der Laufzeitbereich den Fortschritt der Full Table Scans. Die Session führt einen Hash Join im Hash-Bereich aus, um Zeilen aus den beiden Tabellen abzugleichen. Die Sortierung ORDER BY erfolgt im Sortierbereich.
Wenn die von den Operatoren zu verarbeitende Datenmenge nicht in einen Arbeitsbereich passt, teilt Oracle AI Database die Eingabedaten in kleinere Teile auf. Auf diese Weise verarbeitet die Datenbank einige Datenteile im Speicher, während der Rest zur späteren Verarbeitung in den temporären Datenträgerspeicher geschrieben wird.
Die Datenbank optimiert automatisch die Arbeitsbereichsgrößen, wenn die automatische PGA-Speicherverwaltung aktiviert ist. Sie können die Größe eines Arbeitsbereichs auch manuell steuern und optimieren.
Im Allgemeinen können größere Arbeitsbereiche die Leistung eines Operators erheblich verbessern, wenn der Speicherverbrauch höher ist. Optimal ist die Größe eines Arbeitsbereichs ausreichend, um die vom zugehörigen SQL-Operator zugewiesenen Eingabedaten und Auxiliary-Speicherstrukturen aufzunehmen. Andernfalls erhöht sich die Antwortzeit, da ein Teil der Eingabedaten auf dem Datenträger gecacht werden muss. Wenn die Größe eines Arbeitsbereichs im Vergleich zur Größe der Eingabedaten zu klein ist, muss die Datenbank im Extremfall mehrere Durchläufe über die Datenelemente durchführen, was die Antwortzeit drastisch erhöht.
Siehe:
-
Oracle AI Database Administrator's Guide, in dem Sie erfahren, wie Sie das automatische PGA-Management verwenden
-
Oracle AI Database Performance Tuning Guide zum Optimieren des PGA-Speichers
PGA-Nutzung in dedizierten und Shared Server-Modi
Die Zuweisung des PGA-Speichers hängt davon ab, ob die Datenbank dedizierte oder Shared Server-Verbindungen verwendet.
In der folgenden Tabelle werden die Unterschiede aufgeführt.
Tabelle 1: Unterschiede bei der Speicherzuweisung zwischen dedizierten und Shared Servern
| Speicherbereich | Dedizierter Server | Shared Server |
|---|---|---|
| Art des Sitzungsgedächtnisses | Privat | Gemeinsam |
| Speicherort des persistenten Bereichs | PGA | SGA |
| Speicherort des Laufzeitbereichs für DML- und DDL-Anweisungen | PGA | PGA |
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie eine Datenbank für Shared Server konfigurieren.
Überblick über den globalen Benutzerbereich
Bei der UGA handelt es sich um den Session-Speicher, der Session-Variablen zugewiesen wird, z. B. Anmeldeinformationen, und andere Informationen, die von einer Datenbank-Session benötigt werden. Im Wesentlichen speichert die UGA den Sessionzustand.
Die folgende Abbildung zeigt die UGA.
Abbildung 13: User Global Area (UGA)
Beschreibung der Abbildung cncpt222.gif
Wenn eine Session ein PL/SQL-Package in den Speicher lädt, enthält die UGA den Packagestatus. Dabei handelt es sich um das Werteset, das zu einem bestimmten Zeitpunkt in allen Packagevariablen gespeichert ist. Der Paketstatus ändert sich, wenn ein Paketunterprogramm die Variablen ändert. Standardmäßig sind die Packagevariablen für die Dauer der Session eindeutig und werden beibehalten.
Der OLAP-Seitenpool wird ebenfalls in der UGA gespeichert. Dieser Pool verwaltet OLAP-Datenseiten, die Datenblöcken entsprechen. Der Seitenpool wird zu Beginn einer OLAP-Session zugewiesen und am Ende der Session freigegeben. Eine OLAP-Session wird automatisch geöffnet, wenn ein Benutzer ein Dimensionsobjekt abfragt, z.B. einen Cube.
Die UGA muss für die Dauer der Session für eine Datenbank-Session verfügbar sein. Aus diesem Grund kann die UGA nicht in der PGA gespeichert werden, wenn eine Shared Server-Verbindung verwendet wird, da die PGA für einen einzelnen Prozess spezifisch ist. Daher wird die UGA in der MGA gespeichert, wenn Shared Server-Verbindungen verwendet werden, sodass alle Shared Server-Prozesse darauf zugreifen können. Wenn Sie eine dedizierte Server-Verbindung verwenden, wird die UGA in der PGA gespeichert.
Siehe:
-
Oracle AI Database Net Services Administrator's Guide für Informationen zu Shared Server-Verbindungen
Überblick über die Managed Global Area (MGA)
Die Managed Global Area (MGA) ist ein einzigartiges Speicher-Framework, mit dem Speicher über eine Reihe vertrauenswürdiger Oracle-Prozesse hinweg gemeinsam genutzt und koordiniert werden kann.
Es kann ein konfigurierbarer, elastischer, modularer, On-Demand-wiederherstellbarer Shared Memory-Bereich sein. Mit MGA können Sie verschiedene Typen von Shared Memory-Bereichen in der Datenbank verwenden. Sie wird als Namespaces für interne Datenbanklayer bereitgestellt, die jeweils nur zu einem dieser Layer gehören. Ein Namespace besteht hauptsächlich aus einer Gruppe von Shared Memory-Segmenten und Metadaten, die zusammen mit ihm verwendet werden.
Die Schichten in der Datenbank können die Eigenschaften, den Geltungsbereich, die Lebensdauer und die interne Segmentgröße des Namespace definieren. Alle MGA werden unter dem PGA-Aggregatgrenzwert gebucht.
Bei Linux erfordert die MGA tempfs, das auf /dev/shm gemountet ist, und ist so konfiguriert, dass sie mindestens die Größe des PGA-Aggregatlimits aufweist. Wenn mehrere Instanzen auf demselben Rechner ausgeführt werden, muss die Größe von /dev/shm über alle Instanzen hinweg mindestens sum(PGA_AGGREGATE_LIMIT) betragen.
Siehe:
-
Oracle AI Database Performance Tuning Guide, um mehr über die Granulatskalierung zu erfahren
Überblick über Softwarecodebereiche
Ein Softwarecodebereich ist ein Teil des Speichers, in dem Code gespeichert ist, der ausgeführt oder ausgeführt werden kann. Oracle AI Database-Code wird in einem Softwarebereich gespeichert, der in der Regel exklusiver und geschützter ist als der Speicherort von Benutzerprogrammen.
Softwarebereiche sind in der Regel statisch und ändern sich nur, wenn die Software aktualisiert oder neu installiert wird. Die erforderliche Größe dieser Bereiche variiert je nach Betriebssystem.
Softwarebereiche sind schreibgeschützt und können gemeinsam genutzt oder nicht gemeinsam verwendet werden. Einige Datenbanktools und -utilitys, wie Oracle Forms und SQL*Plus, können gemeinsam installiert werden, einige jedoch nicht. Wenn möglich, wird Datenbankcode gemeinsam verwendet, sodass alle Benutzer darauf zugreifen können, ohne mehrere Kopien im Speicher zu haben, was zu einer Verringerung des Hauptspeichers und einer allgemeinen Verbesserung der Leistung führt. Mehrere Instanzen einer Datenbank können denselben Datenbankcodebereich mit verschiedenen Datenbanken verwenden, wenn sie auf demselben Computer ausgeführt werden. Hinweis: Die Option zum Installieren von gemeinsam genutzter Software ist nicht für alle Betriebssysteme verfügbar, z.B. auf PCs mit Microsoft Windows. Weitere Informationen finden Sie in der Dokumentation zu Ihrem Betriebssystem.