Logische Speicherstrukturen
In diesem Kapitel werden die Art und die Beziehungen zwischen logischen Speicherstrukturen beschrieben. Diese Strukturen werden von Oracle AI Database erstellt und erkannt und sind dem Betriebssystem nicht bekannt.
-
Einführung in logische Speicherstrukturen Oracle AI Database weist logischen Speicherplatz für alle Daten in der Datenbank zu.
-
Überblick über Datenblöcke Oracle AI Database verwaltet den logischen Speicherplatz in den Datendateien einer Datenbank in einer Einheit, die als Datenblock bezeichnet wird und auch als Oracle-Block oder Seite bezeichnet wird. Ein Datenblock ist die minimale Einheit für Datenbank-I/O.
-
Überblick über Extents Ein Extent ist eine Einheit des Datenbankspeichers, die aus logisch zusammenhängenden Datenblöcken besteht. Datenblöcke können aufgrund von RAID-Striping- und Dateisystemimplementierungen physisch auf der Festplatte verteilt werden.
-
Überblick über Segmente Ein Segment ist ein Set von Extents, das alle Daten für eine logische Speicherungsstruktur innerhalb eines Tablespaces enthält.
-
Überblick über Tablespaces Ein Tablespace ist ein logischer Speichercontainer für Segmente.
Logische Speicherstrukturen - Einführung
Oracle AI Database weist allen Daten in der Datenbank logischen Speicherplatz zu.
Die logischen Einheiten der Zuweisung von Datenbankspeicherplatz sind Datenblöcke, Extents, Segmente und Tablespaces. Auf physischer Ebene werden die Daten in Datendateien auf Platte gespeichert. Die Daten in den Datendateien werden in Betriebssystemblöcken gespeichert.
Die folgende Abbildung ist ein Entity-Relationship-Diagramm für die physische und logische Speicherung. Die Fußnotation der Krähe stellt eine Eins-zu-Viele-Beziehung dar.
Abbildung 1: Logischer und physischer Speicher
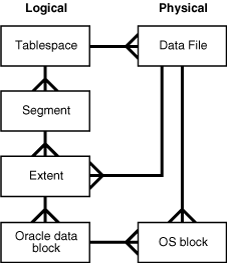
Beschreibung der Abbildung cncpt227.gif
-
Logische Speicherhierarchie Ein Segment enthält mindestens ein Extent, von dem jedes mehrere Datenblöcke enthält.
-
Logical Space Management Oracle AI Database muss die logische Speicherplatzverwaltung verwenden, um die Extents in einem Tablespace zu verfolgen und zuzuweisen. Siehe auch: "Physische Speicherstrukturen"
Logische Speicherhierarchie
Ein Segment enthält mindestens ein Extent, von dem jedes mehrere Datenblöcke enthält.
Die folgende Abbildung zeigt die Beziehungen zwischen Datenblöcken, Extents und Segmenten in einem Tablespace. In diesem Beispiel enthält ein Segment zwei Extents, die in verschiedenen Datendateien gespeichert sind.
Abbildung 2: Segmente, Extents und Datenblöcke in einem Tablespace
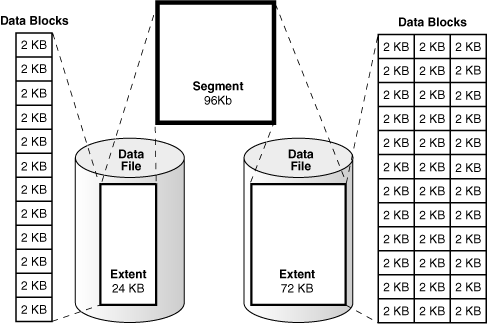
Beschreibung der Abbildung cncpt027.gif
Von der niedrigsten bis zur höchsten Granularitätsebene speichert Oracle AI Database Daten wie folgt:
-
Ein Datenblock ist die kleinste logische Datenspeichereinheit in Oracle AI Database.
Ein logischer Datenblock entspricht einer bestimmten Anzahl von Byte persistenten Speichers, z.B. 2 KB. Datenblöcke sind die kleinsten Speichereinheiten, die Oracle AI Database verwenden oder zuweisen kann.
Traditionell werden Datendateien auf Magnetplatten oder Solid State Disk (SSD) gespeichert. Oracle AI Database unterstützt auch Persistent Memory (PMEM) für die Speicherung von Datenbankdateien. Unabhängig davon, wie die zugrunde liegenden Daten physisch gespeichert werden, verarbeitet Oracle immer logische Datenblöcke, die gelesen und geschrieben werden.
-
Ein Extent ist eine Gruppe logisch zusammenhängender Datenblöcke, die zum Speichern eines bestimmten Informationstyps zugewiesen sind
In der vorherigen Grafik hat das 24-KB-Extent 12 Datenblöcke, während das 72-KB-Extent 36 Datenblöcke aufweist.
-
Ein Segment ist eine Gruppe von Extents, die einem bestimmten Datenbankobjekt zugewiesen sind, z.B. einer Tabelle.
Beispiel: Die Daten für die Tabelle
employeeswerden in ihrem eigenen Datensegment gespeichert, während jeder Index füremployeesin seinem eigenen Indexsegment gespeichert ist. Jedes Datenbankobjekt, das Speicher belegt, besteht aus einem einzelnen Segment. -
Ein Tablespace ist eine Datenbankspeichereinheit, die ein oder mehrere Segmente enthält.
Jedes Segment gehört zu einem einzigen Tablespace. Daher werden alle Extents für ein Segment im selben Tablespace gespeichert. In einem Tablespace kann ein Segment Extents aus mehreren Datendateien enthalten, wie in der vorherigen Grafik dargestellt. Beispiel: Ein Extent für ein Segment kann in
users01.dbfgespeichert werden, während ein anderes inusers02.dbfgespeichert wird. Ein einzelnes Extent kann sich nie über Datendateien erstrecken.
Siehe auch: "Einführung in physische Speicherstrukturen"
Logische Speicherplatzverwaltung
Oracle AI Database muss die logische Speicherplatzverwaltung verwenden, um die Extents in einem Tablespace zu verfolgen und zuzuweisen.
Wenn ein Datenbankobjekt ein Extent erfordert, muss die Datenbank über eine Methode zum Suchen und Bereitstellen verfügen. Wenn ein Objekt kein Extent mehr benötigt, muss die Datenbank über eine Methode verfügen, um das freie Extent verfügbar zu machen.
Oracle AI Database verwaltet Speicherplatz in einem Tablespace basierend auf dem von Ihnen erstellten Typ. Sie können einen der folgenden Typen von Tablespaces erstellen:
-
Lokal verwaltete Tablespace (Standard)
Die Datenbank verwaltet Extents mit Bitmaps in den Tablespaces selbst. Daher wird bei lokal verwalteten Tablespaces ein Teil des Tablespace für ein Bitmap beiseite gesetzt. Innerhalb eines Tablespace kann die Datenbank Segmente mit automatischer Segmentspeicherplatz-Verwaltung (ASSM) oder manueller Segmentspeicherplatz-Verwaltung (MSSM) verwalten.
-
Dictionary-verwaltete Tablespaces
Die Datenbank verwaltet Extents mit dem Data Dictionary.
In Abbildung 15-3 sind die Alternativen für die logische Speicherplatzverwaltung in einem Tablespace dargestellt.
Abbildung 3: Logische Speicherplatzverwaltung
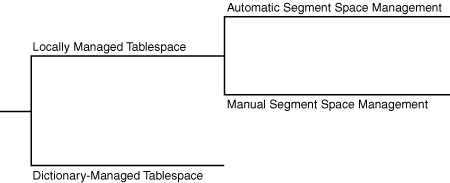
Beschreibung der Abbildung cncpt268.gif
-
Lokal verwaltete Tablespaces Ein lokal verwalteter Tablespace verwaltet ein Bitmap im Datendatei-Header, um freien und belegten Speicherplatz im Datendateibody zu verfolgen.
-
Dictionary-Managed Tablespaces Ein Dictionary-Managed Tablespace verwendet das Data Dictionary zur Verwaltung seiner Extents. Siehe auch: "Data Dictionary - Überblick"
Lokal verwaltete Tablespaces
Ein lokal verwalteter Tablespace verwaltet ein Bitmap im Datendatei-Header, um freien und belegten Speicherplatz im Datendateibody zu verfolgen.
Jedes Bit entspricht einer Blockgruppe. Wenn Speicherplatz zugewiesen oder freigegeben wird, ändert Oracle AI Database die Bitmap-Werte so, dass sie den neuen Status der Blöcke wiedergeben.
Die folgende Grafik ist eine konzeptionelle Darstellung der Bitmap-verwalteten Speicherung. Ein 1 im Header bezieht sich auf belegten Speicherplatz, während ein 0 auf freien Speicherplatz verweist.
Abbildung 4: Bitmap-verwalteter Speicher
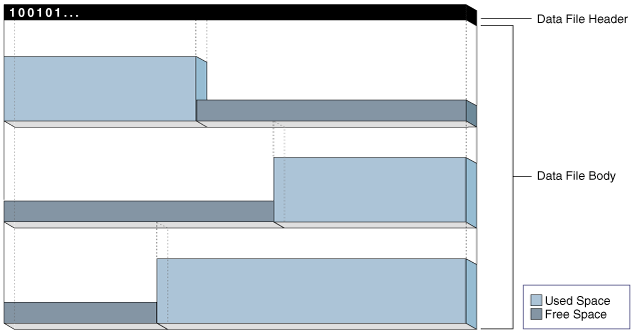
Beschreibung der Abbildung cncpt332.gif
Ein lokal verwalteter Tablespace bietet die folgenden Vorteile:
-
vermeidet die Verwendung des Data Dictionarys zur Verwaltung von Extents
Rekursive Vorgänge können in Dictionary-verwalteten Tablespaces vorkommen, wenn der Belegung oder die Freigabe des Platzes in einem Extent auf einen anderen Vorgang führt, der Platz in einer Data Dictionary-Tabelle oder einer Data Dictionary-Tabelle belegt bzw. freigibt.
-
Verfolgt angrenzenden freien Speicherplatz automatisch
Auf diese Weise entfällt die Notwendigkeit, freie Extents zusammenzuführen.
-
Legt die Größe von lokal verwalteten Extents automatisch fest
Alternativ können alle Extents dieselbe Größe in einem lokal verwaltete Tablespace haben und Objektspeicheroptionen außer Kraft setzen. Hinweis: Oracle empfiehlt dringend die Verwendung von lokal verwalteten Tablespaces mit automatischer Segmentspeicherplatz-Verwaltung.
Die Segmentspeicherplatz-Verwaltung ist ein Attribut, das aus dem Tablespace geerbt wird, der das Segment enthält. Innerhalb eines lokal verwalteten Tablespace kann die Datenbank Segmente automatisch oder manuell verwalten. Beispiel: Segmente in Tablespace users können automatisch verwaltet werden, während Segmente in Tablespace tools manuell verwaltet werden.
-
Automatische Segmentspeicherplatz-Verwaltung Die Methode Automatic Segment Space Management (ASSM) verwendet Bitmaps, um Speicherplatz in einem Tablespace zu verwalten.
-
Manuelle Speicherplatzverwaltung für Segmente Die Legacy-Methode Manual Segment Space Management (MSSM) verwendet eine verknüpfte Liste, die als Freiliste bezeichnet wird, um freien Speicherplatz im Segment zu verwalten.
Automatische Segment-Speicherplatzverwaltung
Die Methode Automatic Segment Space Management (ASSM) verwendet Bitmaps, um den Speicherplatz in einem Tablespace zu verwalten.
Bitmaps bieten die folgenden Vorteile:
-
Einfachere Administration
ASSM vermeidet die Notwendigkeit, die richtigen Einstellungen für viele Speicherparameter manuell zu bestimmen. Nur ein wichtiger SQL-Parameter steuert die Speicherplatzzuweisung:
PCTFREE. Dieser Parameter gibt den Prozentsatz des Speicherplatzes an, der für zukünftige Aktualisierungen in einem Block reserviert werden soll (siehe "Prozentsatz des freien Speicherplatzes in Datenblöcken"). -
Erhöhter gleichzeitiger Zugriff
Mehrere Transaktionen können separate Listen mit freien Datenblöcken durchsuchen und so Zugriffskonflikte und Waits reduzieren. Bei vielen Standard-Workloads ist die Anwendungsperformance mit ASSM besser als die Performance einer optimierten Anwendung, die MSSM verwendet.
-
Dynamische Affinität von Speicherplatz zu Instanzen in einer Oracle Real Application Clusters-(Oracle RAC-)Umgebung
ASSM ist effizienter und ist der Standard für permanente, lokal verwaltete Tablespaces.
Hinweis: In diesem Kapitel wird davon ausgegangen, dass ASSM in allen Diskussionen über logischen Speicherplatz verwendet wird.
Manuelle Verwaltung des Segmentbereichs
Die Legacy-Methode Manual Segment Space Management (MSSM) verwendet eine verknüpfte Liste, die als Freiliste bezeichnet wird, um freien Speicherplatz im Segment zu verwalten.
Bei einem Datenbankobjekt mit freiem Speicherplatz verfolgt eine Freeliste die Blöcke unter der High Water Mark (HWM) (HWM), der Trennlinie zwischen belegtem und noch nicht belegtem Segmentspeicher. Wenn Blöcke verwendet werden, setzt die Datenbank Blöcke auf oder entfernt Blöcke nach Bedarf aus der Freeliste.
Zusätzlich zu PCTFREE müssen Sie bei MSSM die Speicherplatzzuweisung mit SQL-Parametern wie PCTUSED, FREELISTS und FREELIST GROUPS steuern. PCTUSED legt den Prozentsatz des freien Speicherplatzes fest, der in einem aktuell verwendeten Block vorhanden sein muss, damit die Datenbank ihn in die Freeliste aufnehmen kann. Beispiel: Wenn Sie PCTUSED in einer CREATE TABLE-Anweisung auf 40 setzen, können Sie erst Zeilen in einen Block im Segment einfügen, wenn weniger als 40% des Blockspeicherplatzes belegt sind.
Beispiel: Sie fügen eine Zeile in eine Tabelle ein. Die Datenbank prüft eine Freelist der Tabelle auf den ersten verfügbaren Block. Wenn die Zeile nicht in den Block passt und der belegte Speicherplatz im Block größer oder gleich PCTUSED ist, entfernt die Datenbank den Block aus der Liste und sucht nach einem anderen Block. Wenn Sie Zeilen aus dem Block löschen, prüft die Datenbank, ob der belegte Speicherplatz im Block jetzt kleiner als PCTUSED ist. Wenn dies der Fall ist, platziert die Datenbank den Block am Anfang der Freelist.
Ein Objekt kann mehrere Freelists enthalten. Auf diese Weise können mehrere Sessions, die DML für eine Tabelle ausführen, verschiedene Listen verwenden, was Konflikte reduzieren kann. Jede Datenbank-Session verwendet nur eine Freelist für die Dauer ihrer Session.
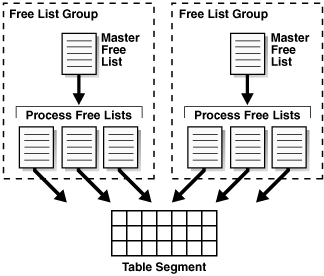
Wie in Abbildung 15-5 dargestellt, können Sie auch ein Objekt mit einer oder mehreren Freilistengruppen erstellen, bei denen es sich um Sammlungen von Freelists handelt. Jede Gruppe verfügt über eine Master-Freiliste, mit der die einzelne Prozessfreiliste in der Gruppe verwaltet wird. Der Speicherplatz für Freelists, insbesondere für Freelist-Gruppen, kann erheblich sein.
Abbildung 5: Freelist-Gruppen
Beschreibung der Abbildung cncpt320.gif
Die manuelle Verwaltung des Segmentspeicherplatzes kann komplex sein. Sie müssen PCTFREE und PCTUSED anpassen, um die Zeilenmigration zu reduzieren und Speicherplatz zu vermeiden. Beispiel: Wenn jeder verwendete Block in einem Segment halb voll ist und PCTUSED 40 ist, lässt die Datenbank keine Einfügungen in einen dieser Blöcke zu. Aufgrund der Schwierigkeiten bei der Feinabstimmung von Speicherplatzzuweisungsparametern empfiehlt Oracle dringend ASSM. In ASSM bestimmt PCTFREE, ob eine neue Zeile in einen Block eingefügt werden kann. Es werden jedoch keine Freelists verwendet, und PCTUSED wird ignoriert.
Siehe:
-
Oracle AI Database Administrator's Guide mit Informationen zu lokal verwalteten Tablespaces
-
Oracle AI Database Administrator's Guide, um mehr über die automatische Speicherplatzverwaltung für Segmente zu erfahren
-
Oracle AI Database SQL Language Reference, um Informationen zu Speicherparametern wie
PCTFREEundPCTUSEDzu erhalten
Dictionary-verwaltete Tablespace
Ein Dictionary-verwalteter Tablespace verwaltet seine Extents mit dem Data Dictionary.
Oracle AI Database aktualisiert die Tabellen in dem Data Dictionary, wenn ein Extent zugewiesen ist oder für die Wiederverwendung freigegeben wird. Beispiel: Wenn eine Tabelle ein Extent benötigt, fragt die Datenbank die Data Dictionary-Tabellen ab und sucht nach freien Extents. Wenn die Datenbank Speicherplatz findet, ändert sie eine Data Dictionary-Tabelle und fügt eine Zeile in eine andere ein. Auf diese Weise verwaltet die Datenbank Speicherplatz, indem Daten geändert und verschoben werden.
Die SQL, die von der Datenbank im Hintergrund ausgeführt wird, um Speicherplatz für Datenbankobjekte zu erhalten, ist rekursives SQL. Die häufige Verwendung von rekursivem SQL kann sich negativ auf die Performance auswirken, da Aktualisierungen des Data Dictionarys serialisiert werden müssen. Lokal verwaltete Tablespaces, die standardmäßig verwendet werden, vermeiden dieses Performanceproblem.
Siehe auch: In Oracle AI Database Administrator's Guide erfahren Sie, wie Sie Tablespaces von dictionary-managed zu lokal verwaltetem Tablespace migrieren.
Überblick über Datenblöcke
Oracle AI Database verwaltet den logischen Speicherplatz in den Datendateien einer Datenbank in einer Einheit, die als Datenblock bezeichnet wird und auch als Oracle-Block oder Seite bezeichnet wird. Ein Datenblock ist die minimale Einheit für Datenbank-I/O.
-
Datenblöcke und Betriebssystemblöcke Auf der physischen Ebene werden Datenbankdaten in Festplattendateien gespeichert, die aus Betriebssystemblöcken bestehen.
-
Datenblockformat Jeder Datenblock hat ein Format oder eine interne Struktur, mit der die Datenbank die Daten und den freien Speicherplatz im Block verfolgen kann. Dieses Format ist ähnlich, unabhängig davon, ob der Datenblock Tabellen-, Index- oder Tabellenclusterdaten enthält.
-
Datenblockkomprimierung Die Datenbank kann Tabellenkomprimierung verwenden, um doppelte Werte in einem Datenblock zu eliminieren. In diesem Abschnitt wird das Format von Datenblöcken beschrieben, die Komprimierung verwenden.
-
Speicherplatzverwaltung in Datenblöcken Wenn die Datenbank einen Datenblock von unten nach oben füllt, verringert sich der freie Speicherplatz zwischen den Zeilendaten und dem Blockheader.
-
Überblick über Indexblöcke Ein Indexblock ist ein spezieller Datenblocktyp, der Speicherplatz anders verwaltet als Tabellenblöcke. Oracle AI Database verwendet Indexblöcke zur Verwaltung des logischen Speicherplatzes in einem Index.
Datenblöcke und Betriebssystemblöcke
Auf der physischen Ebene werden Datenbankdaten in Plattendateien gespeichert, die aus Betriebssystemblöcken bestehen.
Ein Betriebssystemblock ist die Mindestdateneinheit, die das Betriebssystem lesen oder schreiben kann. Ein Oracle-Block ist dagegen eine logische Speicherstruktur, deren Größe und Struktur dem Betriebssystem nicht bekannt sind.
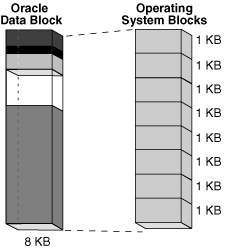
Die folgende Abbildung zeigt, dass sich Betriebssystemblöcke von Datenblöcken unterscheiden können. Die Datenbank fordert Daten in mehreren Datenblöcken an, nicht in Betriebssystemblöcken.
Abbildung 6: Datenblöcke und Betriebssystemblöcke
Beschreibung der Abbildung cncpt293.gif
Wenn die Datenbank einen Datenblock anfordert, übersetzt das Betriebssystem diesen Vorgang in Anforderungen für Daten im permanenten Speicher. Die logische Trennung von Datenblöcken von Betriebssystemblöcken hat folgende Auswirkungen:
-
Anwendungen müssen die physischen Adressen der Daten auf der Festplatte nicht bestimmen.
-
Datenbankdaten können mit Striping oder auf mehreren physischen Datenträgern gespiegelt werden.
-
Datenbankblockgröße Jede Datenbank hat eine Datenbankblockgröße.
-
Tablespace-Blockgröße Sie können einzelne Tablespaces erstellen, deren Blockgröße von der Einstellung
DB_BLOCK_SIZEabweicht.
Datenbankblockgröße
Jede Datenbank hat eine Datenbankblockgröße.
Der Initialisierungsparameter DB_BLOCK_SIZE legt die Datenblockgröße für eine Datenbank fest, wenn sie erstellt wird. Die Größe wird für die Tablespaces SYSTEM und SYSAUX festgelegt und ist der Standard für alle anderen Tablespaces. Die Datenbankblockgröße kann nicht geändert werden, es sei denn, Sie erstellen die Datenbank neu.
Wenn DB_BLOCK_SIZE nicht festgelegt ist, ist die Standarddatenblockgröße betriebssystemspezifisch. Die Standard-Datenblockgröße für eine Datenbank beträgt 4 KB oder 8 KB. Wenn die Größe für Datenblöcke und Betriebssystemblöcke unterschiedlich ist, muss die Datenblockgröße ein Vielfaches der Betriebssystemblockgröße sein.
Siehe:
-
Oracle AI Database Reference zum
DB_BLOCK_SIZE-Initialisierungsparameter -
Oracle AI Database Administrator's Guide und Oracle AI Database Performance Tuning Guide, um zu erfahren, wie Sie Blockgrößen auswählen
Tablespace-Blockgröße
Sie können einzelne Tablespaces erstellen, deren Blockgröße von der Einstellung DB_BLOCK_SIZE abweicht.
Eine nicht standardmäßige Blockgröße kann nützlich sein, wenn ein Transportable Tablespace auf eine andere Plattform verschoben wird.
Siehe auch: Im Oracle AI Database Administrator's Guide wird beschrieben, wie Sie eine nicht standardmäßige Blockgröße für einen Tablespace angeben.
Datenblockformat
Jeder Datenblock hat ein Format oder eine interne Struktur, die es der Datenbank ermöglicht, die Daten und den freien Speicherplatz im Block zu verfolgen. Dieses Format ist ähnlich, unabhängig davon, ob der Datenblock Tabellen-, Index- oder Tabellenclusterdaten enthält.
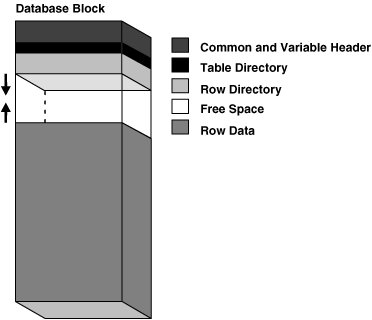
Die folgende Abbildung zeigt das Format eines unkomprimierten Datenblocks.
Abbildung 7: Datenblockformat
Beschreibung der Abbildung cncpt028.gif
-
Data Block Overhead Oracle AI Database verwendet den Block-Overhead, um den Block selbst zu verwalten. Der Block-Overhead ist nicht zum Speichern von Benutzerdaten verfügbar.
-
Zeilenformat Der Zeilendatenteil des Blocks enthält die tatsächlichen Daten, wie Tabellenzeilen oder Indexschlüsseleinträge. So wie jeder Datenblock ein internes Format aufweist, verfügt jede Zeile über ein Zeilenformat, mit dem die Datenbank die Daten in der Zeile verfolgen kann. Siehe auch: "Datenblockkomprimierung", um mehr über komprimierte Blöcke zu erfahren
Datenblock-Overhead
Oracle AI Database verwendet den Block-Overhead, um den Block selbst zu verwalten. Der Block-Overhead ist nicht zum Speichern von Benutzerdaten verfügbar.
Wie in "Datenblockformat" dargestellt, enthält der Block-Overhead die folgenden Teile:
-
Blockheader
Dieser Teil enthält allgemeine Informationen über den Block, einschließlich Datenträgeradresse und Segmenttyp. Bei Blöcken, die transaktionsverwaltet werden, enthält der Blockheader aktive und historische Transaktionsinformationen.
Für jede Transaktion, die den Block aktualisiert, ist ein Transaktionseintrag erforderlich. Oracle AI Database reserviert anfänglich Speicherplatz im Blockheader für Transaktionseinträge. In Datenblöcken, die Segmenten zugewiesen werden, die Transaktionsänderungen unterstützen, kann freier Speicherplatz auch Transaktionseinträge enthalten, wenn der Headerspeicherplatz aufgebraucht ist. Der für Transaktionseinträge erforderliche Speicherplatz ist vom Betriebssystem abhängig. Die Transaktionseinträge in den meisten Betriebssystemen benötigen jedoch etwa 23 Byte.
-
Tabellenverzeichnis
Bei einer heap-organisierten Tabelle enthält dieses Verzeichnis Metadaten zu Tabellen, deren Zeilen in diesem Block gespeichert sind. In einem Tabellencluster können mehrere Tabellen Zeilen im selben Block speichern.
-
Zeilenverzeichnis
Bei einer Heap-organisierten Tabelle beschreibt dieses Verzeichnis die Position von Zeilen im Datenteil des Blocks. Die Datenbank kann eine Zeile an einer beliebigen Stelle im unteren Bereich des Blocks platzieren. Die Zeilenadresse wird in einem der Slots des Zeilenverzeichnisvektors aufgezeichnet.
Eine ROWID verweist auf eine bestimmte Datei, einen bestimmten Block und eine bestimmte Zeilennummer. Beispiel: In der Zeilen-ID
AAAPecAAFAAAABSAAAstellt die letzteAAAdie Zeilennummer dar. Die Zeilennummer ist ein Index in einem Eintrag im Zeilenverzeichnis. Der Zeilenverzeichniseintrag enthält einen Zeiger auf die Position der Zeile im Datenblock. Wenn die Datenbank eine Zeile innerhalb eines Blocks verschiebt, aktualisiert die Datenbank den Zeilenverzeichniseintrag, um den Zeiger zu ändern. Die Rowid bleibt konstant.Nachdem die Datenbank Speicherplatz im Zeilenverzeichnis zugewiesen hat, wird dieser Speicherplatz nach dem Löschen von Zeilen nicht mehr freigegeben. Somit sind einem Block, der derzeit leer ist, aber früher bis zu 50 Zeilen hatte, weiterhin 100 Byte für das Zeilenverzeichnis zugewiesen. Die Datenbank verwendet diesen Speicherplatz nur dann wieder, wenn eine Session neue Zeilen in den Block einfügt.
Einige Teile des Block-Overheads sind fest dimensioniert, die Gesamtgröße ist jedoch variabel. Der Block-Overhead beträgt im Durchschnitt 84 bis 107 Byte.
Zeilenformat
Der Zeilendatenteil des Blocks enthält die tatsächlichen Daten, wie Tabellenzeilen oder Indexschlüsseleinträge. So wie jeder Datenblock ein internes Format hat, hat jede Zeile ein Zeilenformat, mit dem die Datenbank die Daten in der Zeile verfolgen kann.
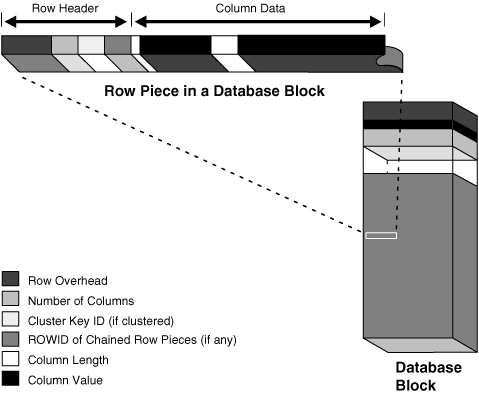
Oracle AI Database speichert Zeilen als Datensätze mit variabler Länge. Eine Zeile ist in einem oder mehreren Abschnitten enthalten. Jeder Abschnitt wird als Zeilenstück bezeichnet. Jedes Zeilenteil hat einen Zeilenheader und Spaltendaten.
Die folgende Abbildung zeigt das Format einer Zeile.
Abbildung 8: Das Format eines Zeilenstücks
Beschreibung der Abbildung cncpt043.gif
-
Zeilenheader Oracle AI Database verwendet den Zeilenheader, um das im Block gespeicherte Zeilenteil zu verwalten.
-
Spaltendaten Nach dem Zeilenheader speichert der Spaltendatenabschnitt die tatsächlichen Daten in der Zeile. Das Zeilenteil speichert normalerweise Spalten in der Reihenfolge, die in der
CREATE TABLE-Anweisung aufgeführt ist. Diese Reihenfolge ist jedoch nicht garantiert. Beispiel: Spalten vom TypLONGwerden zuletzt erstellt. -
Rowid-Format Oracle AI Database verwendet eine rowid, um eine Zeile eindeutig zu identifizieren. Intern ist die ROWID eine Struktur, die Informationen enthält, auf die die Datenbank für den Zugriff auf eine Zeile zugreifen muss. Eine ROWID wird nicht physisch in der Datenbank gespeichert, sondern aus der Datei und dem Block abgeleitet, in dem die Daten gespeichert werden.
Zeilenheader
Oracle AI Database verwendet den Zeilenheader, um das im Block gespeicherte Zeilenteil zu verwalten.
Der Zeilenheader enthält Informationen wie die folgenden:
-
Spalten im Zeilenteil
-
Zeilen in anderen Datenblöcken
Wenn eine ganze Zeile in einen einzelnen Datenblock eingefügt werden kann, speichert Oracle AI Database die Zeile als ein Zeilenteil. Wenn jedoch nicht alle Zeilendaten in einen einzelnen Block eingefügt werden können oder eine Aktualisierung dazu führt, dass eine vorhandene Zeile ihren Block überschreitet, speichert die Datenbank die Zeile in mehreren Zeilenteilen. Ein Datenblock enthält in der Regel nur ein Zeilenteil pro Zeile.
-
Clusterschlüssel für Tabellencluster
Eine Zeile, die vollständig in einem Block enthalten ist, enthält mindestens 3 Byte Zeilenheader.
Spaltendaten
Nach dem Zeilenheader werden die tatsächlichen Daten im Spaltendatenabschnitt in der Zeile gespeichert. Das Zeilenteil speichert normalerweise Spalten in der Reihenfolge, die in der CREATE TABLE-Anweisung aufgeführt ist. Diese Reihenfolge ist jedoch nicht garantiert. Beispiel: Spalten vom Typ LONG werden zuletzt erstellt.
Wie in der Abbildung in "Zeilenformat" dargestellt, speichert Oracle AI Database die Spaltenlänge und die Daten für jede Spalte in einem Zeilenteil separat. Der erforderliche Speicherplatz hängt vom Datentyp ab. Wenn der Datentyp einer Spalte eine variable Länge hat, kann der für einen Wert erforderliche Speicherplatz durch Aktualisierungen der Daten vergrößert und verkleinert werden.
Jede Zeile hat einen Slot im Zeilenverzeichnis des Datenblockheaders. Der Slot zeigt auf den Anfang der Zeile.
Siehe auch: "Table Storage" und "Index Storage"
Zeilen-ID-Format
Oracle AI Database verwendet eine rowid, um eine Zeile eindeutig zu identifizieren. Intern ist die ROWID eine Struktur, die Informationen enthält, auf die die Datenbank für den Zugriff auf eine Zeile zugreifen muss. Eine ROWID wird nicht physisch in der Datenbank gespeichert, sondern aus der Datei und dem Block abgeleitet, in dem die Daten gespeichert werden.
Eine erweiterte Zeilen-ID enthält eine Datenobjektnummer. Dieser Rowid-Typ verwendet eine Basis-64-Codierung der physischen Adresse für jede Zeile. Die Codierungszeichen sind A-Z, a-z, 0-9, + und /.
Beispiel 15-1: ROWID-Pseudospalte
Im folgenden Beispiel wird die ROWID-Pseudospalte abgefragt, um die erweiterte Zeilen-ID der Zeile in der Tabelle employees für Mitarbeiter 100 anzuzeigen:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
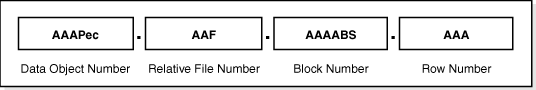
In der folgenden Abbildung wird das Format einer erweiterten Zeilen-ID dargestellt.
Abbildung 9: ROWID-Format
Beschreibung der Abbildung cncpt249.gif
Eine erweiterte Zeilen-ID wird im vierteiligen Format OOOOOOFFFBBBBBBRRR angezeigt, wobei das Format in die folgenden Komponenten unterteilt ist:
-
OOOOOODie Datenobjektnummer identifiziert das Segment (Datenobjekt
AAAPecin der Beispielabfrage). Jedem Datenbanksegment wird eine Datenobjektnummer zugewiesen. Schemaobjekte im selben Segment, z.B. ein Tabellencluster, haben dieselbe Datenobjektnummer. -
FFFDie Tablespace-relative Datendateinummer gibt die Datendatei an, in der die Zeile enthalten ist (Datei
AAFin der Beispielabfrage). -
BBBBBBDie Datenblocknummer gibt den Block an, der die Zeile enthält (Block
AAAABSin der Beispielabfrage). Blocknummern beziehen sich auf ihre Datendatei und nicht auf ihren Tablespace. Daher könnten sich zwei Zeilen mit identischen Blocknummern in verschiedenen Datendateien desselben Tablespace befinden. -
RRRDie Zeilennummer gibt die Zeile im Block an (Zeile
AAAin der Beispielabfrage).
Nachdem eine Rowid einem Row Piece zugewiesen wurde, kann sich die Rowid unter besonderen Umständen ändern. Beispiel: Wenn das Verschieben von Zeilen aktiviert ist, kann sich die Zeilen-ID aufgrund von Partitionsschlüsselaktualisierungen, Flashback Table-Vorgängen, Verkleinern von Tabellenvorgängen usw. ändern. Wenn das Verschieben von Zeilen deaktiviert ist, kann sich eine Zeilen-ID ändern, wenn die Zeile mit Oracle AI Database-Utilitys exportiert und importiert wird. Hinweis: Intern führt die Datenbank eine Zeilenverschiebung aus, als ob die Zeile physisch gelöscht und wieder eingefügt würde. Die Zeilenverschiebung wird jedoch als Update betrachtet, was Auswirkungen auf Trigger hat.
Siehe:
-
Oracle AI Database SQL Language Reference, um mehr über Rowids zu erfahren
Datenblockkomprimierung
Die Datenbank kann die Tabellenkomprimierung verwenden, um doppelte Werte in einem Datenblock zu beseitigen. In diesem Abschnitt wird das Format von Datenblöcken beschrieben, die Komprimierung verwenden.
Das Format eines Datenblocks, der Basistabellen und erweiterte Zeilenkomprimierung verwendet, ist im Wesentlichen dasselbe wie ein unkomprimierter Block. Der Unterschied besteht darin, dass eine Symboltabelle am Anfang des Blocks doppelte Werte für die Zeilen und Spalten speichert. Die Datenbank ersetzt Vorkommen dieser Werte durch einen kurzen Verweis auf die Symboltabelle.
Beispiel 15-2: Format komprimierter Datenblöcke
Angenommen, die folgenden Zeilen werden in einem Datenblock für die Tabelle sales mit sieben Spalten gespeichert:
2190,13770,25-NOV-00,S,9999,23,161
2225,15720,28-NOV-00,S,9999,25,1450
34005,120760,29-NOV-00,P,9999,44,2376
9425,4750,29-NOV-00,I,9999,11,979
1675,46750,29-NOV-00,S,9999,19,1121
Wenn die Basistabelle oder erweiterte Zeilenkomprimierung auf diese Tabelle angewendet wird, ersetzt die Datenbank doppelte Werte durch eine Symbolreferenz. Die folgende konzeptionelle Darstellung der Komprimierung zeigt das Symbol *, das 29-NOV-00 und % ersetzt und 9999 ersetzt:
2190,13770,25-NOV-00,S,%,23,161
2225,15720,28-NOV-00,S,%,25,1450
34005,120760,*,P,%,44,2376
9425,4750,*,I,%,11,979
1675,46750,*,S,%,19,1121
Tabelle 15-1 stellt konzeptuell die Symboltabelle dar, die Symbole Werten zuordnet.
Tabelle 1: Symboltabelle
| Symbol | Wert | Spalte | Zeilen |
|---|---|---|---|
| * | 29-NOV-00 | 3 | 958-960 |
| % | 9.999 | 5 | 956-960 |
Siehe auch: "Tabellenkomprimierung"
Speicherplatzverwaltung in Datenblöcken
Wenn die Datenbank einen Datenblock von unten nach oben füllt, verringert sich der freie Speicherplatz zwischen den Zeilendaten und dem Block-Header.
Freier Speicherplatz in einem Datenblock kann auch bei Aktualisierungen verkleinert werden, wie beim Ändern eines nachgestellten Nullwertes in einen Wert, der nicht Null ist. Die Datenbank verwaltet freien Speicherplatz im Datenblock, um die Performance zu optimieren und unnötigen Speicherplatz zu vermeiden.
Hinweis: In diesem Abschnitt wird die automatische Speicherplatzverwaltung für Segmente vorausgesetzt.
-
Prozentsatz des freien Speicherplatzes in Datenblöcken Der SQL-Parameter
PCTFREElegt den Mindestprozentsatz eines Datenblocks fest, der als freier Speicherplatz für Aktualisierungen vorhandener Zeilen reserviert ist.PCTFREEist wichtig, um die Zeilenmigration zu verhindern und unnötigen Speicherplatz zu vermeiden. -
Optimierung des freien Speicherplatzes in Datenblöcken Während der Prozentsatz des freien Speicherplatzes nicht weniger als
PCTFREEsein darf, kann die Menge des freien Speicherplatzes größer sein. Beispiel: Wenn SiePCTFREEauf 20% setzen, wird verhindert, dass der gesamte freie Speicherplatz auf 5% des Blocks fällt, aber 50% des Blocks können frei sein. -
Chained und Migrated Rows Oracle AI Database verwendet Verkettung und Migration, um Zeilen zu verwalten, die zu groß sind, um in einen einzelnen Block passen zu können.
Prozentsatz des freien Speicherplatzes in Datenblöcken
Der SQL-Parameter PCTFREE legt den Mindestprozentsatz eines Datenblocks fest, der als freier Speicherplatz für Aktualisierungen vorhandener Zeilen reserviert ist. PCTFREE ist wichtig, um die Zeilenmigration zu verhindern und unnötigen Speicherplatz zu vermeiden.
Angenommen, Sie erstellen eine Tabelle, die nur gelegentliche Aktualisierungen erfordert, von denen die meisten die Größe der vorhandenen Daten nicht erhöhen. Sie geben den Parameter PCTFREE in einer CREATE TABLE-Anweisung wie folgt an:
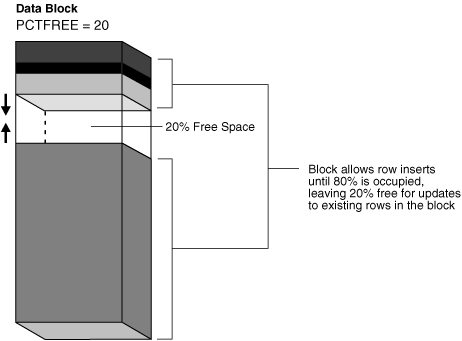
CREATE TABLE test_table (n NUMBER) PCTFREE 20;Abbildung 15-10 zeigt, wie sich eine PCTFREE-Einstellung von 20 auf die Speicherplatzverwaltung auswirkt. Die Datenbank fügt dem Block im Laufe der Zeit Zeilen hinzu, wodurch die Zeilendaten in Richtung des Blockheaders nach oben wachsen, der sich wiederum nach unten zu den Zeilendaten ausdehnt. Mit der Einstellung PCTFREE wird sichergestellt, dass mindestens 20% des Datenblocks frei sind. Beispiel: Die Datenbank verhindert, dass eine INSERT-Anweisung den Block ausfüllt, sodass die Zeilendaten und der Header zusammen 90% des gesamten Blockspeicherplatzes belegen und nur 10% frei bleiben.
Abbildung 10: PCTFREE
Beschreibung der Abbildung cncpt029.gif
Hinweis: Diese Erläuterung gilt nicht für LOB-Datentypen, die weder den Speicherparameter PCTFREE noch Freelists verwenden.
Siehe:
-
Entwicklerhandbuch für Oracle AI Database SecureFiles und Large Objects
-
Oracle AI Database SQL Language Reference für die Syntax und Semantik des Parameters
PCTFREE
Optimierung von freiem Speicherplatz in Datenblöcken
Der Prozentsatz des freien Speicherplatzes darf zwar nicht kleiner als PCTFREE sein, der freie Speicherplatz kann jedoch größer sein. Beispiel: Wenn Sie PCTFREE auf 20% setzen, wird verhindert, dass der gesamte freie Speicherplatz auf 5% des Blocks fällt, aber 50% des Blocks können frei sein.
-
Optimierung durch Erhöhung des freien Speicherplatzes Einige DML-Anweisungen können den freien Speicherplatz in Datenblöcken erhöhen.
-
Optimierung durch Koaleszierung von fragmentiertem Speicherplatz Freigegebener Speicherplatz kann oder darf nicht mit dem Hauptbereich von freiem Speicherplatz in einem Datenblock zusammenhängen. Nicht zusammenhängender freier Speicherplatz wird als fragmentierter Speicherplatz bezeichnet.
Optimierung durch Erhöhung des freien Speicherplatzes
Einige DML-Anweisungen können den freien Speicherplatz in Datenblöcken erhöhen.
Die folgenden Anweisungen können den Speicherplatz erhöhen:
-
DELETE-Anweisungen -
UPDATE-Anweisungen, die vorhandene Werte entweder auf kleinere Werte aktualisieren oder vorhandene Werte erhöhen und die Migration einer Zeile erzwingen -
INSERT-Anweisungen in einer Tabelle, die erweiterte Zeilenkomprimierung verwendetWenn
INSERT-Anweisungen einen Block mit Daten füllen, ruft die Datenbank die Blockkomprimierung auf. Dies kann dazu führen, dass der Block mehr freien Speicherplatz hat.
Der freigegebene Speicherplatz ist für INSERT-Anweisungen unter den folgenden Bedingungen verfügbar:
-
Wenn sich die
INSERT-Anweisung in derselben Transaktion befindet und sich hinter der Anweisung befindet, die Speicherplatz freigibt, kann die Anweisung den Speicherplatz verwenden. -
Wenn sich die
INSERT-Anweisung in einer separaten Transaktion von der Anweisung befindet, die Speicherplatz freigibt (möglicherweise von einem anderen Benutzer ausgeführt) und Speicherplatz benötigt wird, kann die Anweisung den zur Verfügung gestellten Speicherplatz verwenden, jedoch erst nach dem Festschreiben der anderen Transaktion.
Siehe auch: Oracle AI Database Administrator's Guide, um mehr über die erweiterte Zeilenkomprimierung zu erfahren
Optimierung durch Koaleszierung von fragmentiertem Speicherplatz
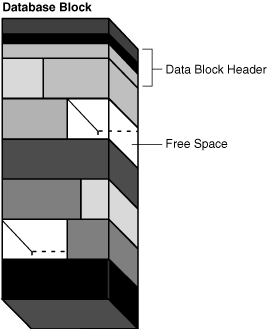
Freigegebener Speicherplatz kann oder darf nicht mit dem Hauptbereich des freien Speicherplatzes in einem Datenblock zusammenhängen. Nicht zusammenhängender freier Speicherplatz wird als fragmentierter Speicherplatz bezeichnet.
Die folgende Abbildung zeigt einen Datenblock mit nicht zusammenhängendem freien Speicherplatz.
Abbildung 11: Datenblock mit fragmentiertem Speicherplatz
Beschreibung der Abbildung cncpt210.gif
Oracle AI Database vereinheitlicht den freien Speicherplatz eines Datenblocks automatisch und transparent nur, wenn die folgenden Bedingungen zutreffen:
-
Eine
INSERT- oderUPDATE-Anweisung versucht, einen Block zu verwenden, der genügend freien Speicherplatz enthält, um ein neues Zeilenteil zu enthalten. -
Der freie Speicherplatz ist so fragmentiert, dass das Zeilenteil nicht in einen zusammenhängenden Abschnitt des Blocks eingefügt werden kann.
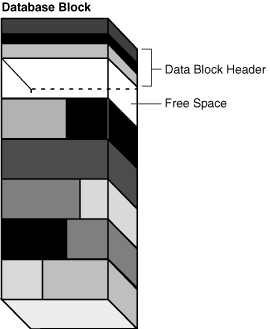
Nach der Koaleszierung ist die Menge an freiem Speicherplatz identisch mit der Menge vor der Operation, aber der Speicherplatz ist jetzt zusammenhängend. Abbildung 15-12 zeigt einen Datenblock, nachdem der Speicherplatz zusammengeführt wurde.
Abbildung 12: Datenblock nach Koaleszierung von freiem Speicherplatz
Beschreibung der Abbildung cncpt211.gif
Oracle AI Database führt Coalescing nur in den vorhergehenden Situationen durch, da sonst die Performance aufgrund der kontinuierlichen Koaleszierung des freien Speicherplatzes in Datenblöcken sinken würde.
Verkettete und migrierte Zeilen
Oracle AI Database verwendet Verkettung und Migration, um Zeilen zu verwalten, die zu groß sind, um in einen einzelnen Block passen zu können. Hinweis: Eine verkettete Zeile in einer Standardtabelle unterscheidet sich von einer Zeilenkette in einer Blockchain-Tabelle. Oracle AI Database verwendet verschiedene Technologien, um Zeilen in einer Blockchain-Tabelle zu verwalten.
Folgende Situationen sind möglich:
-
Die Zeile ist zu groß für einen Datenblock, wenn sie das erste Mal eingefügt wird.
In Zeilenverkettung speichert Oracle AI Database die Daten für die Zeile in einer Kette von mindestens einem Datenblock, der für das Segment reserviert ist. Zeilenverkettung tritt am häufigsten bei großen Zeilen auf. Beispiele sind Zeilen, die eine Spalte des Datentyps
LONGoderLONG RAWoder eine Zeile mit einer großen Anzahl von Spalten enthalten. In diesen Fällen ist ein Zeilenverkettungsvorgang unvermeidbar. -
Eine Zeile, die ursprünglich in einen Datenblock passt, wird aktualisiert, sodass die gesamte Zeilenlänge zunimmt. Für die aktualisierte Zeile ist jedoch nicht genügend freier Speicherplatz vorhanden.
Bei der Zeilenmigration verschiebt Oracle AI Database die gesamte Zeile in einen neuen Datenblock, vorausgesetzt, die Zeile kann in einen neuen Block passen. Das ursprüngliche Zeilenteil einer migrierten Zeile enthält einen Zeiger oder eine Weiterleitungsadresse zum neuen Block, der die migrierte Zeile enthält. Die ROWID einer migrierten Zeile ändert sich nicht.
-
Eine Zeile enthält mehr als 255 Spalten.
Oracle AI Database kann nur 255 Spalten in einem Zeilenteil speichern. Wenn Sie also eine Zeile in eine Tabelle einfügen, die 1000 Spalten enthält, erstellt die Datenbank 4 Zeileneinheiten, die in der Regel über mehrere Blöcke verkettet sind.
In Abbildung 15-13 wird das Einfügen einer großen Zeile in einen Datenblock dargestellt. Die Zeile ist zu groß für den linken Block. Daher ketten die Datenbank die Zeile, indem sie das erste Zeilenteil im linken Block und das zweite Zeilenteil im rechten Block platzieren.
Abbildung 13: Zeilenverkettung
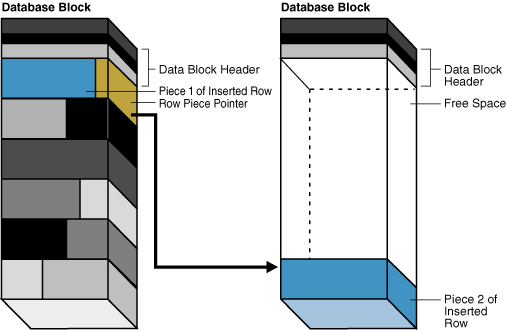
Beschreibung der Abbildung cncpt316.gif
Abbildung 15-14: Der linke Block enthält eine Zeile, die aktualisiert wird, sodass die Zeile jetzt zu groß für den Block ist. Die Datenbank verschiebt die gesamte Zeile in den rechten Block und zeigt auf die migrierte Zeile im linken Block.
Abbildung 14: Zeilenmigration
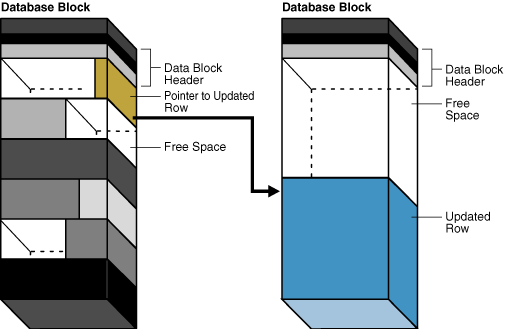
Beschreibung der Abbildung cncpt306.gif
Wenn eine Zeile verkettet oder migriert wird, erhöht sich der I/O, der zum Abrufen der Daten erforderlich ist. Diese Situation führt dazu, dass Oracle AI Database mehrere Blöcke scannen muss, um die Informationen für die Zeile abzurufen. Beispiel: Wenn die Datenbank ein I/O durchführt, um einen Index zu lesen, und ein I/O, um eine nicht migrierte Tabellenzeile zu lesen, ist ein zusätzliches I/O erforderlich, um die Daten für eine migrierte Zeile abzurufen.
Der Segment Advisor, der sowohl manuell als auch automatisch ausgeführt werden kann, ist eine Oracle AI Database-Komponente, die Segmente identifiziert, für die Speicherplatz zur Reklamation verfügbar ist. Der Advisor kann Empfehlungen zu Objekten geben, die über erheblichen freien Speicherplatz oder zu viele verkettete Zeilen verfügen.
Siehe:
-
"Zeilenspeicher" und "Zeilenspeicher"
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie verschwendeten Speicherplatz wiederherstellen können
-
Oracle AI Database Performance Tuning Guide zum Reduzieren von verketteten und migrierten Zeilen
Überblick über Indexblöcke
Ein Indexblock ist ein spezieller Datenblocktyp, der Speicherplatz anders verwaltet als Tabellenblöcke. Oracle AI Database verwendet Indexblöcke zur Verwaltung des logischen Speicherplatzes in einem Index.
-
Typen von Indexblöcken Ein Index enthält einen Root-Block, Verzweigungsblöcke und Leaf-Blöcke.
-
Speicher von Indexeinträgen Indexeinträge werden wie Tabellenzeilen in einem Datenblock in Indexblöcken gespeichert. Die Indexeinträge im Blockabschnitt werden nicht in binärer Reihenfolge, sondern in einem Heap gespeichert.
-
Wiederverwendung von Slots in einem Indexblock Die Datenbank kann Speicherplatz in einem Indexblock wiederverwenden.
-
Indexblock gemeinsam skalieren Index, der vorhandene Indexdaten komprimiert und die freien Blöcke in der Indexstruktur verlässt, wenn die Reorganisation Blöcke freigibt. Daher gibt das Coalescing keine Indexblöcke für andere Verwendungen frei oder bewirkt, dass der Index Blöcke neu zuweist.
Arten von Indexblöcken
Ein Index enthält einen Root-Block, Verzweigungsblöcke und Leaf-Blöcke.
Die Blocktypen sind wie folgt definiert:
-
Stammblock
Dieser Block identifiziert den Einstiegspunkt in den Index.
-
Verzweigungsblöcke
Die Datenbanken navigieren bei der Suche nach einem Indexschlüssel durch Verzweigungsblöcke.
-
Blattblöcke
Diese Blöcke enthalten die indizierten Zeilen-IDs der Schlüsselwerte, die auf die zugehörigen Zeilen verweisen. Die Leaf-Blöcke speichern Schlüsselwerte in sortierter Reihenfolge, damit die Datenbank effizient nach allen Zeilen in einem Bereich von Schlüsselwerten suchen kann.
Speicherung von Indexeinträgen
Indexeinträge werden wie Tabellenzeilen in einem Datenblock in Indexblöcken gespeichert. Die Indexeinträge im Blockteil werden nicht in binärer Reihenfolge, sondern in einem Heap gespeichert.
Die Datenbank verwaltet das Zeilenverzeichnis in einem Indexblock anders als das Verzeichnis in einem Datenblock. Die Einträge im Zeilenverzeichnis (nicht die Einträge im Hauptteil des Indexblocks) werden nach Schlüsselwert sortiert. Beispiel: Im Zeilenverzeichnis steht der Verzeichniseintrag für den Indexschlüssel 000000 vor dem Verzeichniseintrag für den Indexschlüssel 111111 usw.
Die Reihenfolge der Einträge im Zeilenverzeichnis verbessert die Effizienz von Index-Scans. Bei einem Range Scan muss die Datenbank alle im Bereich angegebenen Indexschlüssel lesen. Die Datenbank durchläuft die Verzweigungsblöcke, um den Leaf-Block zu identifizieren, der den ersten Schlüssel enthält. Da die Einträge im Zeilenverzeichnis sortiert sind, kann die Datenbank mit einer binären Suche den ersten Indexschlüssel im Bereich suchen und dann die Einträge im Zeilenverzeichnis sequenziell durchlaufen, bis der letzte Schlüssel gefunden wird. Auf diese Weise vermeidet die Datenbank das Lesen aller Schlüssel im Leaf-Blockbody.
Siehe auch: "Data Block Overhead"
Wiederverwendung von Slots in einem Indexblock
Die Datenbank kann Speicherplatz in einem Indexblock wiederverwenden.
Beispiel: Eine Anwendung kann einen Wert in eine Spalte einfügen und dann den Wert löschen. Wenn für eine Zeile Speicherplatz erforderlich ist, kann die Datenbank den Index-Slot wiederverwenden, der zuvor vom gelöschten Wert belegt wurde.
Ein Indexblock enthält in der Regel viel mehr Zeilen als ein Heap-organisierter Tabellenblock. Die Möglichkeit, viele Zeilen in einem einzelnen Indexblock zu speichern, erleichtert es der Datenbank, einen Index zu verwalten, da dadurch häufige Teilungen des Blocks zum Speichern neuer Daten vermieden werden.
Ein Index kann sich nicht zusammenfassen. Sie können ihn jedoch manuell mit einer ALTER INDEX-Anweisung mit den Optionen REBUILD oder COALESCE zusammenfassen. Beispiel: Wenn Sie eine Spalte mit den Werten 1 bis 500000 auffüllen und dann die Zeilen löschen, die gerade Zahlen enthalten, enthält der Index 250.000 leere Slots. Die Datenbank verwendet einen Slot nur dann wieder, wenn sie Daten einfügen kann, die in einen Indexblock passen, der einen leeren Slot enthält.
Indexblöcke zusammenfassen
Index-Coalescing komprimiert vorhandene Indexdaten und verlässt, wenn die Reorganisation Blöcke freigibt, die freien Blöcke in der Indexstruktur. Daher gibt das Coalescing keine Indexblöcke für andere Verwendungen frei oder bewirkt, dass der Index Blöcke neu zuweist.
Oracle AI Database komprimiert den Index nicht automatisch: Sie müssen eine ALTER INDEX-Anweisung mit den Optionen REBUILD oder COALESCE ausführen. Abbildung 15-15 zeigt einen Index der Spalte employees.department_id, bevor der Index zusammengeführt wird. Die ersten drei Blöcke sind nur teilweise voll, wie durch die grauen Fülllinien angegeben.
Abbildung 15: Index vor der Koaleszierung
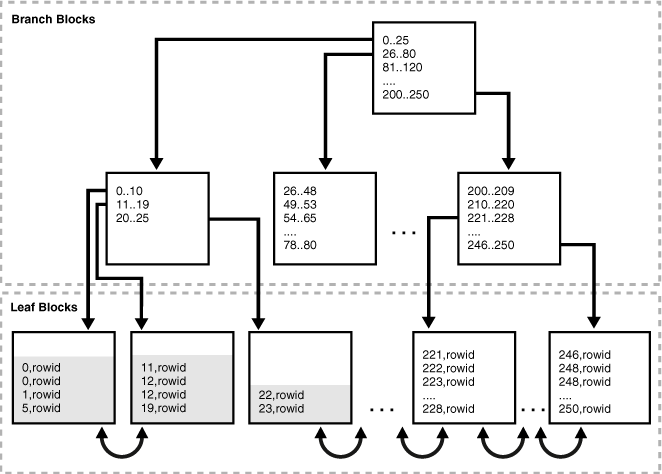
Beschreibung der Abbildung cncpt294.gif
Abbildung 15-16 zeigt den Index in Abbildung 15-15, nachdem der Index zusammengeführt wurde. Die ersten beiden Leaf-Blöcke sind nun voll, wie durch die grauen Fülllinien angedeutet, und der dritte Leaf-Block wurde freigegeben.
Abbildung 16: Index nach Koaleszierung
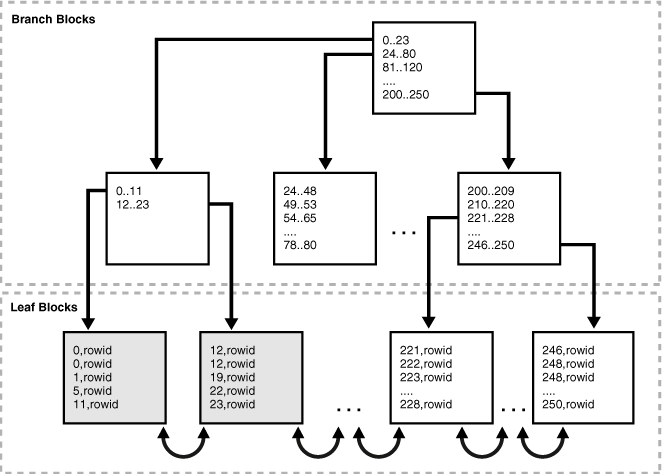
Beschreibung der Abbildung cncpt295.gif
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Indizes zusammengeführt und neu erstellt werden
-
Oracle AI Database SQL Language Reference, um mehr über die
COALESCE-Anweisung zu erfahren
Extents - Überblick
Ein Extent ist eine Einheit des Datenbankspeichers, die aus logisch zusammenhängenden Datenblöcken besteht. Datenblöcke können aufgrund von RAID-Striping- und Dateisystemimplementierungen physisch auf der Festplatte verteilt werden.
-
Zuweisung von Extents Standardmäßig weist die Datenbank ein anfängliches Extent für ein Datensegment zu, wenn das Segment erstellt wird. Ein Extent ist immer in einer Datendatei enthalten.
-
Deallocation of Extents Im Allgemeinen kehren die Extents eines Benutzersegments nicht in den Tablespace zurück, es sei denn, Sie löschen das Objekt mit einer
DROP-Anweisung. -
Speicherparameter für Extents Jedes Segment wird durch Speicherparameter definiert, die in Extents ausgedrückt werden. Diese Parameter steuern, wie Oracle AI Database freien Speicherplatz für ein Segment zuweist.
Zuweisung von Extents
Standardmäßig weist die Datenbank ein anfängliches Extent für ein Datensegment zu, wenn das Segment erstellt wird. Ein Extent ist immer in einer Datendatei enthalten.
Obwohl dem Segment keine Daten hinzugefügt wurden, sind Datenblöcke im anfänglichen Extent ausschließlich für dieses Segment reserviert. Der erste Datenblock jedes Segments enthält ein Verzeichnis der Extents im Segment. Abbildung 15-17 zeigt das anfängliche Extent in einem Segment in einer Datendatei, die zuvor keine Daten enthielt.
Abbildung 17: Anfänglicher Extent eines Segments
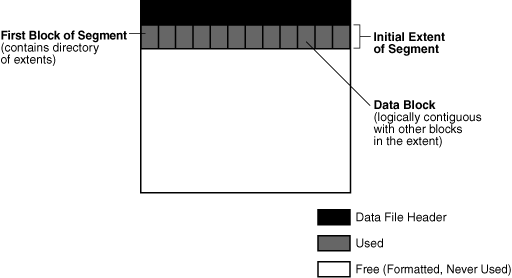
Beschreibung der Abbildung cncpt274.gif
Wenn das anfängliche Extent voll wird und mehr Speicherplatz benötigt wird, weist die Datenbank automatisch ein inkrementelles Extent für dieses Segment zu. Ein inkrementeller Extent ist ein nachfolgendes Extent, das für das Segment erstellt wird.
Der Zuordnungsalgorithmus hängt davon ab, ob der Tablespace lokal verwaltet oder vom Dictionary verwaltet wird. Im lokal verwalteten Fall durchsucht die Datenbank das Bitmap einer Datendatei nach benachbarten freien Blöcken. Wenn in der Datendatei nicht genügend Speicherplatz vorhanden ist, sucht die Datenbank in einer anderen Datendatei. Extents für ein Segment befinden sich immer im selben Tablespace, können sich jedoch in unterschiedlichen Datendateien befinden. Abbildung 15-18 zeigt, dass die Datenbank Extents für ein Segment in einer beliebigen Datendatei im Tablespace zuweisen kann. Beispiel: Das Segment kann das anfängliche Extent in users01.dbf zuweisen, das erste inkrementelle Extent in users02.dbf zuweisen und dann das nächste Extent in users01.dbf zuweisen.
Abbildung 18: Inkrementelle Ausdehnung eines Segments
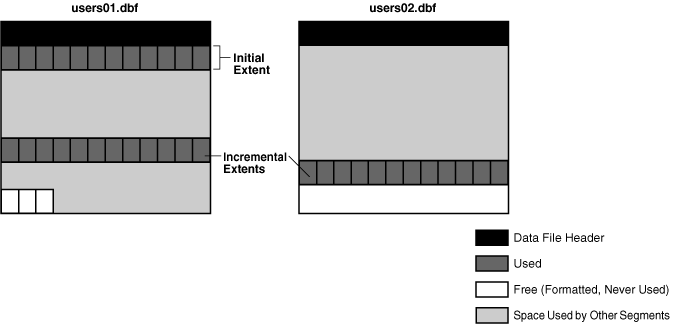
Beschreibung der Abbildung cncpt278.gif
Die Blöcke eines neu zugewiesenen Extents, obwohl sie frei waren, sind möglicherweise nicht leer von alten Daten. In ASSM formatiert Oracle AI Database die Blöcke eines neu zugewiesenen Extents, wenn das Extent verwendet wird, jedoch nur nach Bedarf. Hinweis: Dieser Abschnitt gilt für serielle Vorgänge, bei denen ein Serverprozess eine Anweisung parst und ausführt. Die Datenbank weist Extents in parallelen SQL-Anweisungen unterschiedlich zu, was mehrere Serverprozesse umfasst.
Siehe:
-
Oracle AI Database - Administratordokumentation, in der beschrieben wird, wie Extents manuell zugewiesen werden
Deallocation von Extents
Im Allgemeinen kehren die Extents eines Benutzersegments nicht in den Tablespace zurück, es sei denn, Sie löschen das Objekt mit einer DROP-Anweisung.
Beispiel: Wenn Sie alle Zeilen in einer Tabelle löschen, fordert die Datenbank die Datenblöcke nicht zur Verwendung durch andere Objekte im Tablespace zurück. Sie können das Segment auch mit dem Package DBMS_SPACE_ADMIN löschen.
Hinweis: In einem Undo-Segment deallokiert Oracle AI Database regelmäßig ein oder mehrere Extents, wenn die Größe OPTIMAL angegeben ist oder wenn sich die Datenbank im automatischen Undo-Managementmodus befindet.
Unter bestimmten Umständen können Sie die Zuweisung von Speicherplatz manuell aufheben. Mit Oracle Segment Advisor können Sie bestimmen, ob für ein Objekt Speicherplatz zur Reklamation verfügbar ist, basierend auf der Fragmentierungsebene im Objekt. Die folgenden Techniken können Extents freisetzen:
-
Verwenden Sie eine Online-Segmentverkleinerung, um fragmentierten Speicherplatz in einem Segment freizugeben. Die Segmentverkleinerung ist ein Online-Vorgangsvorgang. Im Allgemeinen führt die Datenkomprimierung zu einer besseren Cacheauslastung und erfordert, dass weniger Blöcke in einem vollständigen Tabellenscan gelesen werden.
-
Verschieben Sie die Daten einer nicht partitionierten Tabelle oder Tabellenpartition in ein neues Segment und optional in einen anderen Tablespace, für den Sie eine Quota haben.
-
Index neu erstellen oder zusammenführen
-
Schneiden Sie eine Tabelle oder ein Tabellencluster ab, wodurch alle Zeilen entfernt werden. Standardmäßig deallokiert Oracle AI Database den gesamten von den entfernten Zeilen belegten Speicherplatz, mit Ausnahme des durch den Speicherparameter
MINEXTENTSangegebenen Speicherplatzes. Ab Oracle Database 11g Release 2 (11.2.0.2) können Sie auchTRUNCATEmit der OptionDROP ALL STORAGEverwenden, um ganze Segmente zu löschen. -
Heben Sie die Zuweisung von ungenutztem Speicherplatz auf. Dadurch wird der ungenutzte Speicherplatz am High Water Mark-Ende des Datenbanksegments freigegeben, und der Speicherplatz wird für andere Segmente im Tablespace verfügbar.
Wenn Extents freigegeben werden, ändert Oracle AI Database das Bitmap in der Datendatei für lokal verwaltete Tablespaces, um die wiedergewonnenen Extents als verfügbaren Speicherplatz wiederzugeben. Auf Daten in den Blöcken von befreiten Extents kann nicht mehr zugegriffen werden.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie den Segmentspeicherplatz wiederherstellen können
Speicherparameter für Extents
Jedes Segment wird durch Speicherparameter definiert, die in Extents ausgedrückt werden. Diese Parameter steuern, wie Oracle AI Database freien Speicherplatz für ein Segment zuweist.
Die Speichereinstellungen werden in der folgenden Prioritätsreihenfolge festgelegt, wobei die Einstellungen in der Liste höher sind und die Einstellungen weiter unten in der Liste überschrieben werden:
-
Segmentspeicherklausel
-
Tablespace-Speicherklausel
-
Oracle AI Database-Standard
Ein lokal verwalteter Tablespace kann entweder einheitliche Extent-Größen oder variable Extent-Größen aufweisen, die automatisch vom System bestimmt werden:
-
Bei einheitlichen Extents können Sie eine Extent-Größe angeben oder die Standardgröße von 1 MB verwenden. Alle Extents im Tablespace haben diese Größe. Lokal verwaltete Temporary Tablespaces können nur diesen Zuweisungstyp verwenden.
-
Bei automatisch zugewiesenen Extents bestimmt Oracle AI Database die optimale Größe zusätzlicher Extents.
Bei lokal verwalteten Tablespaces können einige Speicherparameter nicht auf Tablespace-Ebene angegeben werden. Sie können diese Parameter jedoch auf Segmentebene angeben. In diesem Fall verwendet die Datenbank alle Parameter zusammen, um die Anfangsgröße des Segments zu berechnen. Interne Algorithmen bestimmen die nachfolgende Größe jedes Extents.
Siehe:
-
Oracle AI Database Administrator's Guide enthält Informationen zu den Überlegungen zur Extent-Verwaltung beim Erstellen eines lokal verwalteten Tablespace
-
Oracle AI Database SQL Language Reference, um Informationen zu Optionen in der Speicherklausel zu erhalten
Überblick über Segmente
Ein Segment ist ein Extentset, das alle Daten für eine logische Speicherungsstruktur innerhalb eines Tablespaces enthält.
Beispiel: Oracle AI Database weist ein oder mehrere Extents zu, um das Datensegment für eine Tabelle zu bilden. Die Datenbank weist auch ein oder mehrere Extents zu, um das Indexsegment für einen Index für eine Tabelle zu bilden.
Oracle AI Database verwaltet den Segmentspeicherplatz automatisch oder manuell. In diesem Abschnitt wird von ASSM ausgegangen.
-
Benutzersegmente Ein einzelnes Datensegment in einer Datenbank speichert die Daten für ein Benutzerobjekt.
-
Temporäre Segmente Bei der Verarbeitung einer Abfrage benötigt Oracle AI Database häufig einen temporären Workspace für Zwischenstufen der Ausführung von SQL-Anweisungen.
-
Undo-Segmente Oracle AI Database verwaltet Aufzeichnungen über die Aktionen von Transaktionen, die zusammen als Undo-Daten bezeichnet werden.
-
Segmentspeicherplatz und High Water Mark Um Speicherplatz zu verwalten, verfolgt Oracle AI Database den Status von Blöcken im Segment. Die High Water Mark (HWM) ist der Punkt in einem Segment, über den Datenblöcke unformatiert sind und noch nie verwendet wurden. Siehe auch: "Logische Speicherplatzverwaltung", um mehr über ASSM zu erfahren
Benutzersegmente
Ein einzelnes Datensegment in einer Datenbank speichert die Daten für ein Benutzerobjekt.
Es gibt verschiedene Segmenttypen. Beispiele für Benutzersegmente:
-
Tabelle, Tabellenpartition oder Tabellencluster
-
LOB- oder LOB-Partition
-
Index- oder Indexpartition
Jedes nicht partitionierte Objekt und jede Objektpartition wird in einem eigenen Segment gespeichert. Beispiel: Wenn ein Index fünf Partitionen aufweist, enthalten fünf Segmente die Indexdaten.
- Benutzersegmenterstellung Standardmäßig verwendet die Datenbank die verzögerte Segmenterstellung, um beim Erstellen von Tabellen, Indizes und Partitionen nur Datenbankmetadaten zu aktualisieren.
Benutzersegmenterstellung
Standardmäßig verwendet die Datenbank die verzögerte Segmenterstellung, um beim Erstellen von Tabellen, Indizes und Partitionen nur Datenbankmetadaten zu aktualisieren.
Wenn ein Benutzer die erste Zeile in eine Tabelle oder Partition einfügt, erstellt die Datenbank Segmente für die Tabelle oder Partition, ihre LOB-Spalten und ihre Indizes. Durch verzögerte Segmenterstellung wird die unnötige Verwendung von Datenbankressourcen vermieden. Beispiel: Bei der Installation einer Anwendung können Tausende von Objekten erstellt werden, die erheblichen Festplattenspeicher belegen. Viele dieser Objekte können niemals verwendet werden.
Das Package DBMS_SPACE_ADMIN verwaltet Segmente für leere Objekte. Mit diesem PL/SQL-Package können Sie folgende Aufgaben ausführen:
-
Segmente für leere Tabellen oder Partitionen, für die keine Segmente erstellt wurden, manuell materialisieren
-
Segmente aus leeren Tabellen oder Partitionen entfernen, denen derzeit ein leeres Segment zugewiesen ist
Um die Beziehung zwischen der Objekterstellung und der Segmenterstellung am besten zu veranschaulichen, gehen Sie davon aus, dass die verzögerte Segmenterstellung deaktiviert ist. Sie erstellen eine Tabelle wie folgt.
CREATE TABLE test_table (my_column NUMBER);Wie in Abbildung 15-19 dargestellt, erstellt die Datenbank ein Segment für die Tabelle.
Abbildung 19: Erstellen eines Benutzersegments
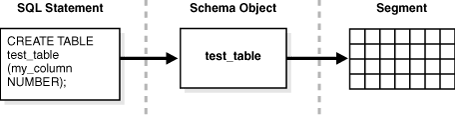
Beschreibung der Abbildung cncpt246.gif
Wenn Sie eine Tabelle mit einem Primärschlüssel oder eindeutigen Schlüssel erstellen, erstellt Oracle AI Database automatisch einen Index für diesen Schlüssel. Gehen Sie erneut davon aus, dass die verzögerte Segmenterstellung deaktiviert ist. Eine Tabelle wird wie folgt erstellt:
CREATE TABLE lob_table (my_column NUMBER PRIMARY KEY, clob_column CLOB);Abbildung 15-20 zeigt, dass die Daten für lob_table in einem Segment gespeichert sind, während sich der implizit erstellte Index in einem anderen Segment befindet. Außerdem werden die CLOB-Daten in einem eigenen Segment gespeichert, ebenso wie der zugehörige CLOB-Index. Daher führt die CREATE TABLE-Anweisung dazu, dass vier verschiedene Segmente erstellt werden.
Abbildung 20: Mehrere Segmente
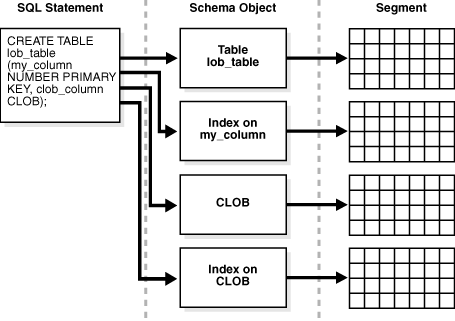
Beschreibung der Abbildung cncpt245.gif
Hinweis: Die Segmente einer Tabelle und der Index für diese Tabelle müssen nicht denselben Tablespace belegen.
Die Datenbank weist mindestens ein Extent zu, wenn ein Segment erstellt wird. Speicherparameter für das Objekt bestimmen, wie die Extents für jedes Segment zugewiesen werden. Die Parameter beeinflussen die Effizienz des Datenabrufs und -speichers für das dem Objekt zugeordnete Datensegment.
Siehe:
-
Oracle AI Database SecureFiles and Large Objects Developer's Guide, um mehr über interne LOBs zu erfahren
-
Oracle AI Database Administrator's Guide zum Verwalten der verzögerten Segmenterstellung
-
Oracle AI Database SQL Language Reference für die
CREATE TABLE-Syntax
Temporäre Segmente
Bei der Verarbeitung einer Abfrage benötigt Oracle AI Database häufig einen temporären Workspace für Zwischenstufen der Ausführung von SQL-Anweisungen.
Typische Vorgänge, bei denen ein temporäres Segment erforderlich sein kann, sind das Sortieren, Hashing und das Zusammenführen von Bitmaps. Während der Erstellung eines Index platziert Oracle AI Database Indexsegmente auch in temporäre Segmente und konvertiert sie dann in permanente Segmente, wenn der Index abgeschlossen ist.
Oracle AI Database erstellt kein temporäres Segment, wenn ein Vorgang im Speicher ausgeführt werden kann. Wenn die Speicherauslastung jedoch nicht möglich ist, weist die Datenbank automatisch ein temporäres Segment auf der Platte zu.
-
Zuteilung temporärer Segmente für Abfragen Oracle AI Database weist während einer Benutzersession nach Bedarf temporäre Segmente für Abfragen zu und löscht sie, wenn die Abfrage abgeschlossen ist. Änderungen an temporären Segmenten werden nicht im Online-Redo-Log aufgezeichnet, mit Ausnahme von Speicherplatzverwaltungsvorgängen im temporären Segment.
-
Zuweisung von Segmenten für temporäre Tabellen und Indizes Oracle AI Database kann temporäre Segmente für temporäre Tabellen und deren Indizes zuweisen.
Zuordnung temporärer Segmente für Abfragen
Oracle AI Database weist während einer Benutzersession nach Bedarf temporäre Segmente für Abfragen zu und löscht sie, wenn die Abfrage abgeschlossen ist. Änderungen an temporären Segmenten werden nicht im Online-Redo-Log aufgezeichnet, mit Ausnahme von Speicherplatzverwaltungsvorgängen im temporären Segment.
Die Datenbank erstellt temporäre Segmente im temporären Tablespace, der dem Benutzer zugewiesen ist. Die Default-Speichereigenschaften des Tablespace bestimmen die Eigenschaften der Extents im temporären Segment. Da die Zuweisung und Aufhebung der Zuweisung von temporären Segmenten häufig erfolgt, empfiehlt es sich, mindestens einen speziellen Tablespace für temporäre Segmente zu erstellen. Die Datenbank verteilt I/O auf Datenträger und vermeidet das Fragmentieren von SYSTEM und anderen Tablespaces mit temporären Segmenten.
Hinweis: Wenn SYSTEM lokal verwaltet wird, müssen Sie beim Erstellen der Datenbank einen Default Temporary Tablespace definieren. Ein lokal verwalteter SYSTEM Tablespace kann nicht als temporärer Standardspeicher verwendet werden.
Siehe:
-
Oracle AI Database Administrator's Guide zum Erstellen von Temporary Tablespaces
-
Oracle AI Database SQL Language Reference für
CREATE TEMPORARY TABLESPACE-Syntax und Semantik
Zuordnung von Segmenten für temporäre Tabellen und Indizes
Oracle AI Database kann temporäre Segmente für temporäre Tabellen und deren Indizes zuweisen.
In temporären Tabellen werden personenbezogene Daten gespeichert, die nur für die Dauer einer Transaktion oder Session vorhanden sein. Jede Session greift nur auf die Extents zu, die sich selbst zugewiesen sind, und kann nicht auf Extents zugreifen, die anderen Sessions zugewiesen sind.
Oracle AI Database weist Segmente für eine globale temporäre Tabelle zu, wenn die erste INSERT in der Tabelle auftritt, und für eine private temporäre Tabelle nur, wenn dies erforderlich ist. Die Einfügung kann explizit oder aufgrund von CREATE TABLE AS SELECT erfolgen. Die Datenbank weist die Segmente für die Tabelle und ihre Indizes zu, erstellt die Root-Seite für die Indizes und weist alle LOB-Segmente zu.
Ein temporärer Tablespace des aktuellen Benutzers weist einer temporären Tabelle Segmente zu. Beispiel: Der Temporary Tablespace, der user1 zugewiesen ist, ist temp1, und der Temporary Tablespace, der user2 zugewiesen ist, ist temp2. In diesem Fall speichert user1 temporäre Daten in den temp1-Segmenten, während user2 temporäre Daten in den temp2-Segmenten speichert.
Siehe:
-
Oracle AI Database Administrator's Guide zum Erstellen temporärer Tabellen
Segmente rückgängig machen
Oracle AI Database führt Aufzeichnungen über die Aktionen von Transaktionen, die zusammen als Undo-Daten bezeichnet werden.
Oracle AI Database verwendet Undo-Daten für Folgendes:
-
Rollback einer aktiven Transaktion
-
Beendete Transaktionen wiederherstellen
-
Lesekonsistenz bereitstellen
-
Einige logische Flashback-Vorgänge ausführen
Oracle AI Database speichert Undo-Daten in der Datenbank und nicht in externen Logs. Undo-Daten werden in Blöcken gespeichert, die genau wie Datenblöcke aktualisiert werden, wobei Änderungen an diesen Blöcken Redo-Datensätze generieren. Auf diese Weise kann Oracle AI Database effizient auf Undo-Daten zugreifen, ohne externe Protokolle lesen zu müssen.
Undo-Daten für permanente Objekte werden in einem Undo Tablespace gespeichert. Oracle AI Database bietet einen vollständig automatisierten Mechanismus, der als automatischer Undo-Managementmodus bezeichnet wird, um Undo-Segmente und Speicherplatz in einem Undo Tablespace zu verwalten.
Die Datenbank teilt Undo-Daten in zwei Streams auf. Ein temporärer Undo-Stream kapselt nur Undo-Datensätze, die durch Änderungen an temporären Objekten generiert werden, während ein permanenter Undo-Stream nur Undo-Datensätze für permanente Objekte kapselt. Die Datenbank verwaltet temporäres und permanentes Undo unabhängig voneinander. Die Undo-Trennung verringert den Speicher und verbessert die Performance, indem folgende Schritte ausgeführt werden:
-
Konfigurieren von permanenten und Undo Tablespace-Größen, die am besten zu den Workloads für permanente und temporäre Tabellen passen
-
Größe der in das Online Redo Log geschriebenen Redo Log-Dateien verringern
-
Vermeidung der Notwendigkeit, temporäre Undo-Daten zu sichern
Bei einer Active Data Guard-Instanz erfordert DML in globalen temporären Tabellen, dass Undo in temporären Undo-Segmenten generiert wird.
-
Segmente und Transaktionen rückgängig machen Wenn eine Transaktion gestartet wird, bindet die Datenbank die Transaktion an ein Undo-Segment und damit an eine Transaktionstabelle im aktuellen Undo Tablespace. In seltenen Fällen, wenn die Datenbankinstanz keinen angegebenen Undo Tablespace hat, bindet die Transaktion an das System-Undo-Segment.
-
Transaktions-Rollback Wenn eine
ROLLBACK-Anweisung abgesetzt wird, verwendet die Datenbank Undo-Datensätze, um Änderungen, die von der nicht festgeschriebenen Transaktion an der Datenbank vorgenommen wurden, zurückzusetzen. -
Temporäre Undo-Segmente Ein temporäres Undo-Segment ist ein optionaler Speicherplatzverwaltungscontainer nur für temporäre Undo-Daten.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über temporäre Undo-Segmente zu erfahren
-
Oracle AI Database Reference zum
TEMP_UNDO_ENABLED-Initialisierungsparameter
Segmente und Transaktionen rückgängig machen
Wenn eine Transaktion gestartet wird, bindet die Datenbank die Transaktion an ein Undo-Segment und damit an eine Transaktionstabelle im aktuellen Undo Tablespace. In seltenen Fällen, wenn die Datenbankinstanz keinen angegebenen Undo Tablespace hat, bindet die Transaktion an das System-Undo-Segment.
Mehrere aktive Transaktionen können gleichzeitig in dasselbe Undo-Segment oder in verschiedene Segmente schreiben. Beispiel: Die Transaktionen T1 und T2 können beide in das Undo-Segment U1 schreiben, oder T1 kann in U1 schreiben, während T2 in das Undo-Segment U2 schreibt.
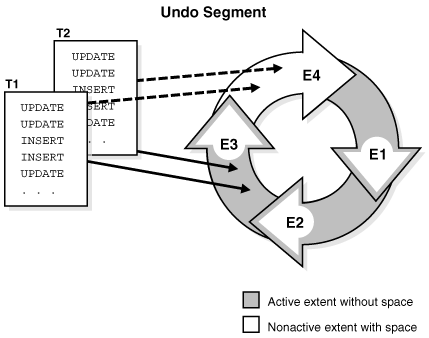
Konzeptionell bilden die Extents in einem Undo-Segment einen Ring. Transaktionen schreiben in einem Undo-Extent und dann im nächsten Extent im Ring usw. zyklisch. Abbildung 15-21 zeigt zwei Transaktionen, T1 und T2, die im dritten Extent (E3) eines Undo-Segments schreiben und weiterhin im vierten Extent (E4) schreiben.
Abbildung 21: Ring der zugewiesenen Extents in einem Undo-Segment
Beschreibung der Abbildung cncpt328.gif
Zu einem bestimmten Zeitpunkt schreibt eine Transaktion sequenziell nur ein Extent in ein Undo-Segment, das als aktueller Extent für die Transaktion bezeichnet wird. Mehrere aktive Transaktionen können gleichzeitig in denselben aktuellen Extent oder in andere aktuelle Extents schreiben. Abbildung 15-21 zeigt Transaktionen T1 und T2, die gleichzeitig in Extent E3 schreiben. Innerhalb eines Undo Extents enthält ein Datenblock Daten für nur eine Transaktion.
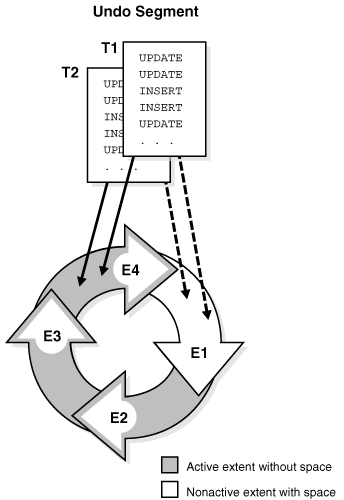
Während das aktuelle Undo Extent gefüllt wird, prüft die erste Transaktion, die Speicherplatz benötigt, die Verfügbarkeit des nächsten zugewiesenen Extents im Ring. Wenn das nächste Extent keine Daten aus einer aktiven Transaktion enthält, wird dieses Extent zum aktuellen Extent. Jetzt können alle Transaktionen, die Speicherplatz benötigen, in den neuen aktuellen Extent schreiben. Wenn E4 voll ist, schreiben T1 und T2 in Abbildung 15-22 weiterhin in E1. Dabei werden die nicht aktiven Undo-Daten in E1 überschrieben.
Abbildung 22: Zyklische Verwendung von zugewiesenen Extents in einem Undo-Segment
Beschreibung der Abbildung cncpt327.gif
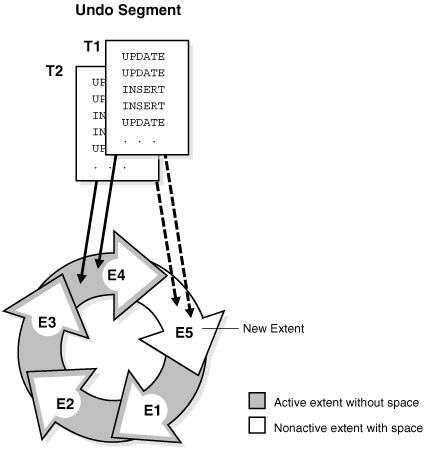
Wenn das nächste Extent Daten aus einer aktiven Transaktion enthält, muss die Datenbank ein neues Extent zuweisen. Abbildung 15-23 zeigt ein Szenario, in dem T1 und T2 in E4 schreiben. Wenn E4 gefüllt wird, können die Transaktionen nicht weiter in E1 schreiben, da E1 aktive Undo-Einträge enthält. Daher weist die Datenbank diesem Undo-Segment ein neues Extent (E5) zu. Die Transaktionen werden weiterhin in E5 geschrieben.
Abbildung 23: Zuweisung eines neuen Extents für ein Undo-Segment
Beschreibung der Abbildung cncpt326.gif
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Undo-Segmente verwaltet werden.
Transaktions-Rollback
Wenn eine ROLLBACK-Anweisung abgesetzt wird, verwendet die Datenbank Undo-Datensätze, um Änderungen, die von der nicht festgeschriebenen Transaktion an der Datenbank vorgenommen wurden, zurückzusetzen.
Beim Recovery setzt die Datenbank alle nicht festgeschriebenen Änderungen zurück, die aus dem Online Redo Log in die Datendateien angewendet wurden. Undo-Datensätze bieten Lesekonsistenz, indem sie das Before Image der Daten für Benutzer, die gleichzeitig auf Daten zugreifen, während ein anderer Benutzer sie ändert, beibehalten.
Temporäre Undo-Segmente
Ein temporäres Undo-Segment ist ein optionaler Speicherplatzverwaltungscontainer nur für temporäre Undo-Daten.
Undo-Datensätze für Änderungen an temporären Tabellen sind sowohl session-spezifisch als auch nur für Lesekonsistenz und Transaktions-Rollback nützlich. Vor Oracle Database 12c hat die Datenbank diese Datensätze immer im Online Redo Log gespeichert. Da Änderungen an temporären Objekten nicht im Online Redo Log protokolliert werden, spart das Schreiben von Undo für temporäre Objekte in temporäre Undo-Segmente Speicherplatz im Online Redo Log und in archivierten Redo Log-Dateien. Die Datenbank protokolliert keine Änderungen am Undo oder Änderungen an der temporären Tabelle, was die Performance verbessert.
Sie können den Initialisierungsparameter TEMP_UNDO_ENABLED so einstellen, dass temporäre Tabellen Undo-Daten in einem temporären Undo-Segment speichern. Wenn dieser Parameter TRUE lautet, weist die Datenbank temporäre Undo-Segmente aus Temporary Tablespaces zu.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über temporäre Undo-Segmente zu erfahren
-
Oracle AI Database Reference zum
TEMP_UNDO_ENABLED-Initialisierungsparameter
Segment Space und die High Water Mark
Um Speicherplatz zu verwalten, verfolgt Oracle AI Database den Status von Blöcken im Segment. Die High Water Mark (HWM) ist der Punkt in einem Segment, über den Datenblöcke unformatiert sind und noch nie verwendet wurden.
MSSM verwendet Freelists zur Verwaltung des Segmentspeicherplatzes. Beim Erstellen der Tabelle werden keine Blöcke im Segment formatiert. Wenn eine Session zum ersten Mal Zeilen in die Tabelle einfügt, durchsucht die Datenbank die Freeliste nach verwendbaren Blöcken. Wenn die Datenbank keine verwendbaren Blöcke findet, formatiert sie eine Gruppe von Blöcken vor, platziert sie in der Freeliste und beginnt mit dem Einfügen von Daten in die Blöcke. In MSSM liest ein Full Table Scan alle Blöcke unter der HWM.
ASSM verwendet keine Freelists und muss daher den Speicherplatz anders verwalten. Wenn eine Session zum ersten Mal Daten in eine Tabelle einfügt, formatiert die Datenbank einen einzelnen Bitmap-Block, anstatt wie in MSSM eine Gruppe von Blöcken vorab zu formatieren. Die Bitmap verfolgt den Zustand von Blöcken im Segment und nimmt die Stelle der Freelist ein. Die Datenbank verwendet das Bitmap, um freie Blöcke zu finden und dann jeden Block zu formatieren, bevor er mit Daten gefüllt wird. ASSM verteilt Einfügungen auf Blöcke, um Nebenläufigkeitsprobleme zu vermeiden.
Jeder Datenblock in einem ASSM-Segment weist einen der folgenden Status auf:
-
Über dem HWM
Diese Blöcke sind unformatiert und wurden noch nie verwendet.
-
Unterhalb der HWM
Diese Blöcke haben einen der folgenden Status:
-
Zugewiesen, aber derzeit nicht formatiert und nicht verwendet
-
Formatiert und enthält Daten
-
Formatiert und leer, weil die Daten gelöscht wurden
-
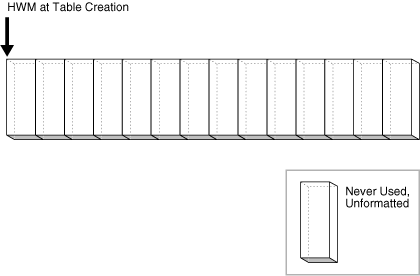
In Abbildung 15-24 wird ein ASSM-Segment als horizontale Blöcke dargestellt. Bei der Tabellenerstellung befindet sich die HWM am Anfang des Segments auf der linken Seite. Da noch keine Daten eingefügt wurden, sind alle Blöcke im Segment unformatiert und werden nie verwendet.
Abbildung 24: HWM bei Tabellenerstellung
Beschreibung der Abbildung cncpt275.gif
Angenommen, eine Transaktion fügt Zeilen in das Segment ein. Die Datenbank muss eine Gruppe von Blöcken für die Zeilen zuweisen. Die zugewiesenen Blöcke fallen unter die HWM. Die Datenbank formatiert einen Bitmap-Block in dieser Gruppe, um die Metadaten zu speichern, formatiert die restlichen Blöcke in der Gruppe jedoch nicht vor.
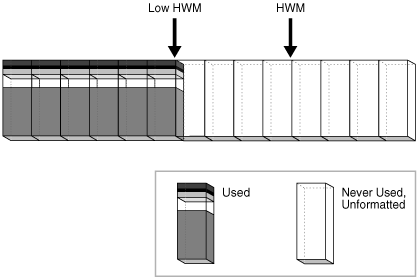
In Abbildung 15-25 werden die Blöcke unterhalb der HWM zugewiesen, während Blöcke oberhalb der HWM weder zugewiesen noch formatiert sind. Wenn Einfügungen vorgenommen werden, kann die Datenbank in jeden Block mit verfügbarem Speicherplatz schreiben. Die Low High Water Mark (low HWM) markiert den Punkt, unter dem alle Blöcke bekanntlich formatiert sind, weil sie entweder Daten enthalten oder früher Daten enthalten.
Abbildung 25: HWM und niedrige HWM
Beschreibung der Abbildung cncpt276.gif
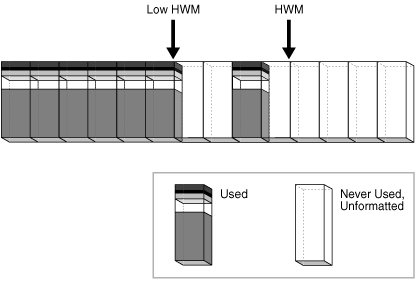
In Abbildung 15-26 wählt die Datenbank einen Block zwischen der HWM und der niedrigen HWM und schreibt darin. Die Datenbank hätte genauso einfach jeden anderen Block zwischen HWM und niedriger HWM oder jeden Block unterhalb der niedrigen HWM wählen können, der verfügbaren Speicherplatz hatte. In Abbildung 15-26 sind die Blöcke auf beiden Seiten des neu gefüllten Blocks unformatiert.
Abbildung 26: HWM und niedrige HWM
Beschreibung der Abbildung cncpt333.gif
Die niedrige HWM ist bei einem vollständigen Table Scan wichtig. Da Blöcke unterhalb der HWM nur bei Verwendung formatiert werden, können einige Blöcke unformatiert sein, wie in Abbildung 15-26 dargestellt. Aus diesem Grund liest die Datenbank den Bitmap-Block, um den Speicherort der niedrigen HWM abzurufen. Die Datenbank liest alle Blöcke bis zur niedrigen HWM, da sie bekanntermaßen formatiert sind, und liest dann sorgfältig nur die formatierten Blöcke zwischen der niedrigen HWM und der HWM.
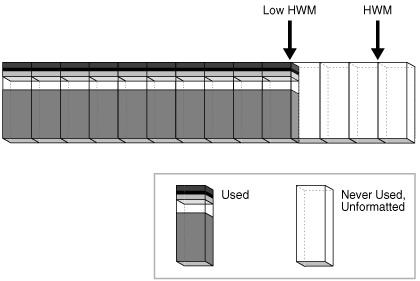
Angenommen, eine neue Transaktion fügt Zeilen in die Tabelle ein. Das Bitmap gibt jedoch an, dass unter der HWM nicht genügend freier Speicherplatz vorhanden ist. In Abbildung 15-27 erweitert die Datenbank die HWM nach rechts und weist eine neue Gruppe unformatierter Blöcke zu.
Abbildung 27: Weiterentwicklung von HWM und niedriger HWM
Beschreibung der Abbildung cncpt277.gif
Wenn die Blöcke zwischen der HWM und der niedrigen HWM voll sind, schreitet die HWM nach rechts und die niedrige HWM zur Position der alten HWM vor. Während die Datenbank Daten im Laufe der Zeit einfügt, geht die HWM weiter nach rechts, wobei die niedrige HWM immer hinter ihr liegt. Wenn Sie das Objekt nicht manuell neu erstellen, kürzen oder verkleinern, zieht sich die HWM nie zurück.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Segmente online verkleinert werden können
-
Oracle AI Database SQL Language Reference für
TRUNCATE TABLE-Syntax und Semantik
Überblick über Tablespaces
Ein Tablespace ist ein logischer Speichercontainer für Segmente.
Segmente sind Datenbankobjekte, wie Tabellen und Indizes, die Speicherplatz belegen. Auf der physischen Ebene speichert ein Tablespace Daten in einer oder mehreren Datendateien oder temporären Dateien.
-
Tablespaces in einer mehrmandantenfähigen Umgebung In einer CDB verfügt jede PDB und jede Anwendungs-Root über eine eigene Gruppe von Tablespaces.
-
Permanente Tablespaces Ein permanenter Tablespace gruppiert persistente Schemaobjekte. Die Segmente für Objekte im Tablespace werden physisch in Datendateien gespeichert.
-
Temporary Tablespaces Ein Temporary Tablespace enthält transiente Daten, die nur für die Dauer einer Session beibehalten werden. In einem temporären Tablespace können sich keine permanenten Schemaobjekte befinden. In einer temp-Datei werden temporäre Tablespace-Daten gespeichert.
-
Tablespace-Modi Der Tablespace-Modus bestimmt die Zugänglichkeit des Tablespace.
-
Tablespace-Dateigröße Ein Tablespace ist entweder ein Bigfile Tablespace oder ein Smallfile Tablespace. Diese Tablespaces sind hinsichtlich der Ausführung von SQL-Anweisungen, die nicht explizit auf Datendateien oder temporäre Dateien verweisen, nicht zu unterscheiden.
Tablespaces in einer mehrmandantenfähigen Umgebung
In einer CDB verfügt jede PDB und jede Anwendungs-Root über eine eigene Gruppe von Tablespaces.
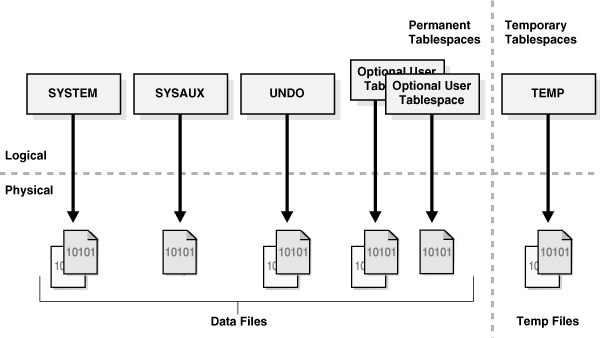
Jede CDB-Root, PDB und Anwendungs-Root muss die Tablespaces SYSTEM und SYSAUX aufweisen. Die folgende Abbildung zeigt die Tablespaces in einem typischen Container.
Abbildung 28: Tablespaces
Beschreibung der Abbildung cncpt319.gif
Eine CDB enthält Folgendes:
-
Eine Kontrolldatei
-
Ein Online Redo Log
-
Ein oder mehrere Undo Tablespaces
Nur ein allgemeiner Benutzer, der über die entsprechenden Berechtigungen verfügt und dessen aktueller Container die CDB-Root ist, kann einen Undo Tablespace erstellen. Eine CDB befindet sich zu jedem Zeitpunkt in einem der folgenden Undo-Modi:
-
Lokaler Undo-Modus
In diesem Fall verfügt jede PDB über einen eigenen Undo Tablespace. Wenn eine CDB den lokalen Undo-Modus verwendet, erstellt die Datenbank automatisch einen Undo Tablespace in jeder PDB. Lokales Undo bietet Vorteile wie die Möglichkeit, einen Hot Clone einer PDB auszuführen und PDBs schnell umzuspeichern. Darüber hinaus bietet lokales Undo eine Isolationsstufe und ermöglicht schnellere Recovery-Vorgänge beim Trennen und beim Point-in-Time.
Für jeden Knoten in einem Oracle Real Application Clusters-(RAC-)Cluster, in dem die PDB geöffnet ist, ist ein lokaler Undo Tablespace erforderlich. Beispiel: Wenn Sie eine PDB aus einem Cluster mit zwei Knoten in ein Cluster mit vier Knoten verschieben und die PDB auf allen Knoten geöffnet ist, erstellt die Datenbank automatisch die zusätzlichen erforderlichen Undo Tablespaces. Wenn Sie die PDB erneut verschieben, können Sie die redundanten Undo Tablespaces löschen.
Hinweis: Der Datenbankkonfigurationsassistent (DBCA) erstellt standardmäßig neue CDBs mit aktiviertem lokalem Undo.
-
Shared Undo-Modus
In einer Einzelinstanz-CDB ist nur ein aktiver Undo Tablespace vorhanden. Bei einer Oracle RAC-CDB ist für jede Instance ein aktiver Undo Tablespace vorhanden. Alle Undo Tablespaces sind in den Data Dictionarys und zugehörigen Views aller Container sichtbar.
Der Undo-Modus gilt für die gesamte CDB. Das bedeutet, dass entweder jeder Container Shared Undo verwendet oder jeder Container lokales Undo verwendet. Sie können zwischen Undo-Modi in einer CDB wechseln, sodass die Datenbank neu gestartet werden muss.
-
-
Tablespaces
SYSTEMundSYSAUXfür jeden ContainerDie CDB-Root, jede Anwendungs-Root und jede PDB haben ihre eigenen Tablespaces
SYSTEMundSYSAUX. Jeder Container verfügt auch über eine eigene Gruppe von Data Dictionary-Tabellen, in denen die Objekte beschrieben werden, die sich im Container befinden. -
Null oder mehr vom Benutzer erstellte Tablespaces
In einem typischen Anwendungsfall verfügt jede PDB über eine eigene Gruppe von Nicht-System-Tablespaces. Diese Tablespaces enthalten die Daten für benutzerdefinierte Schemas und Objekte in der PDB. Sie können die Speichermenge begrenzen, die von den Datendateien für eine PDB verwendet wird, indem Sie die Klausel
STORAGEin einerCREATE PLUGGABLE DATABASE- oderALTER PLUGGABLE DATABASE-Anweisung verwenden.Durch die Speicherung des Data Dictionarys in der PDB kann es portierbar sein. Sie können eine PDB von einer CDB trennen und an eine andere CDB anschließen.
-
Eine Gruppe von temporären Dateien für jeden Container
Für die CDB-Root ist ein Default Temporary Tablespace und für jede Anwendungs-Root, Anwendungs-PDB und PDB ein Default Temporary Tablespace vorhanden.
Beispiel 15-3: CDB im lokalen Undo-Modus
Dieses Beispiel zeigt Aspekte der physischen Speicherarchitektur einer CDB mit zwei PDBs: hrpdb und salespdb. In diesem Beispiel verwendet die Datenbank den lokalen Undo-Modus sowie Undo-Datendateien im CDB-Root, hrpdb und salespdb.
Abbildung 29: Physikalische Architektur einer CDB im lokalen Undo-Modus
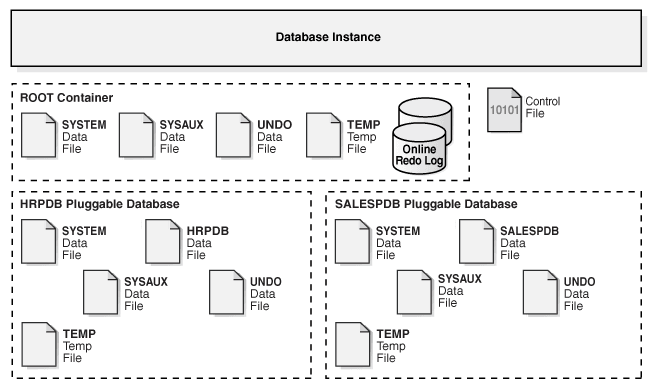
Beschreibung der Abbildung cncpt386.png
Siehe auch: "Data Dictionary-Trennung in einer CDB"
Permanent Tablespaces
Ein permanenter Tablespace gruppiert persistente Schemaobjekte. Die Segmente für Objekte im Tablespace werden physisch in Datendateien gespeichert.
Jedem Datenbankbenutzer wird ein permanenter Standard-Tablespace zugewiesen. Eine sehr kleine Datenbank benötigt möglicherweise nur die Standard-Tablespaces SYSTEM und SYSAUX. Oracle empfiehlt jedoch, mindestens einen Tablespace zum Speichern von Benutzer- und Anwendungsdaten zu erstellen. Mit Tablespaces können Sie die folgenden Ziele erreichen:
-
Speicherplatzzuweisung für Datenbankdaten steuern
-
Quota (Speicherplatzbegrenzung oder Speicherplatzbegrenzung) einem Datenbankbenutzer zuweisen
-
Einzelne Tablespaces online oder offline setzen, ohne die Verfügbarkeit der gesamten Datenbank zu beeinträchtigen
-
Backup und Recovery einzelner Tablespaces durchführen
-
Anwendungsdaten mit dem Oracle Data Pump-Utility importieren oder exportieren
-
Erstellen Sie einen Transportable Tablespace, den Sie kopieren oder von einer Datenbank in eine andere verschieben können, auch plattformübergreifend
Das Verschieben von Daten durch den Transport von Tablespaces kann um Größenordnungen schneller sein als das Exportieren/Importieren oder Entladen/Laden derselben Daten, da beim Transport eines Tablespace nur Datendateien kopiert und die Tablespace-Metadaten integriert werden. Beim Transport von Tablespaces können Sie auch Indexdaten verschieben.
-
SYSTEM Tablespace Der Tablespace
SYSTEMist ein notwendiger administrativer Tablespace, der bei seiner Erstellung in der Datenbank enthalten ist. Oracle AI Database verwaltet die Datenbank mitSYSTEM. -
SYSAUX-Tablespace Der
SYSAUX-Tablespace ist ein Auxiliary-Tablespace für denSYSTEM-Tablespace. -
Undo Tablespaces Ein Undo Tablespace ist ein lokal verwalteter Tablespace, der für systemverwaltete Undo-Daten reserviert ist.
-
Schatten-Tablespaces Ein Schatten-Tablespace ist ein Bigfile Tablespace, der für den Schattenverlustschutz bestimmt ist.
Siehe:
-
Oracle AI Database - Administratordokumentation zum Transport von Tablespaces
-
Oracle AI Database-Utilitys für Informationen zu Oracle Data Pump
Der SYSTEM Tablespace
Der Tablespace SYSTEM ist ein notwendiger administrativer Tablespace, der bei seiner Erstellung in der Datenbank enthalten ist. Oracle AI Database verwendet SYSTEM zur Verwaltung der Datenbank.
Der Tablespace SYSTEM enthält die folgenden Informationen, die alle dem Benutzer SYS gehören:
-
Das Data Dictionary
-
Tabellen und Views mit Verwaltungsinformationen zur Datenbank
-
Kompilierte gespeicherte Objekte wie Trigger, Prozeduren und Packages
Der Tablespace SYSTEM wird wie jeder andere Tablespace verwaltet, erfordert jedoch eine höhere Berechtigungsebene und ist in gewisser Weise eingeschränkt. Beispiel: Sie können den Tablespace SYSTEM nicht umbenennen oder löschen.
Standardmäßig legt Oracle AI Database fest, dass alle neu erstellten Benutzer-Tablespaces lokal verwaltet werden. In einer Datenbank mit einem lokal verwalteten SYSTEM Tablespace können Sie keine Dictionary-verwalteten Tablespaces erstellen (die veraltet sind). Wenn Sie die Anweisung CREATE DATABASE jedoch manuell ausführen und die Standardwerte übernehmen, wird der Tablespace SYSTEM vom Dictionary verwaltet. Sie können einen vorhandenen Dictionary-verwalteten SYSTEM Tablespace in ein lokal verwaltetes Format migrieren. Hinweis: Oracle empfiehlt dringend, dass Sie mit Database Configuration Assistant (DBCA) neue Datenbanken erstellen, sodass alle Tablespaces, einschließlich SYSTEM, standardmäßig lokal verwaltet werden.
Siehe:
-
"Online- und Offline-Tablespaces" für Informationen zur permanenten Online-Bedingung des Tablespace
SYSTEM -
Oracle AI Database Administrator's Guide enthält Informationen zum Erstellen oder Migrieren in einen lokal verwalteten
SYSTEMTablespace -
Oracle AI Database SQL Language Reference für
CREATE DATABASE-Syntax und Semantik
Der SYSAUX Tablespace
Der SYSAUX-Tablespace dient als Auxiliary-Tablespace für den SYSTEM Tablespace.
Da SYSAUX der Default Tablespace für viele Oracle AI Database-Features und -Produkte ist, die vorher ihre eigenen Tablespaces erforderten, reduziert es die Anzahl der Tablespaces, welche von der Datenbank benötigt werden. Außerdem wird die Last für den Tablespace SYSTEM verringert.
Beim Erstellen oder Upgrade der Datenbank wird automatisch der Tablespace SYSAUX erstellt. Während des normalen Datenbankvorgangs lässt die Datenbank nicht zu, dass der Tablespace SYSAUX gelöscht oder umbenannt wird. Wenn der Tablespace SYSAUX nicht mehr verfügbar ist, bleibt die Core-Datenbankfunktionalität betriebsbereit. Die Datenbankfeatures, die den Tablespace SYSAUX verwenden, können fehlschlagen oder mit eingeschränkter Funktionalität funktionieren.
Siehe auch: Oracle AI Database Administrator's Guide, um mehr über den Tablespace SYSAUX zu erfahren
UNDO-Tablespaces
Ein Undo Tablespace ist ein lokal verwalteter Tablespace, der für systemverwaltete Undo-Daten reserviert ist.
Wie andere permanente Tablespaces enthalten Undo Tablespaces Datendateien. Undo-Blöcke in diesen Dateien werden in Extents gruppiert.
-
Automatischer Undo-Managementmodus Für Undo-Tablespaces muss sich die Datenbank im Standardmodus für automatisches Undo befinden.
-
Automatische Undo-Aufbewahrung Der Undo-Aufbewahrungszeitraum ist die Mindestzeit, die Oracle AI Database versucht, alte Undo-Daten beizubehalten, bevor sie überschrieben werden. Siehe auch: "Segmente rückgängig machen"
Automatischer Undo-Verwaltungsmodus
Für Undo Tablespaces muss sich die Datenbank im automatischen Undo-Standardmodus befinden.
Der automatische Modus eliminiert die Komplexität der manuellen Verwaltung von Undo-Segmenten. Die Datenbank optimiert sich automatisch, um die bestmögliche Aufbewahrung von Undo-Daten bereitzustellen, um Abfragen mit langer Ausführungszeit zu erfüllen, die diese Daten möglicherweise erfordern.
Bei einer Neuinstallation von Oracle AI Database wird automatisch ein Undo Tablespace erstellt. Frühere Versionen von Oracle AI Database enthalten möglicherweise keinen Undo Tablespace und verwenden stattdessen Legacy-Rollback-Segmente, die als manueller Undo-Verwaltungsmodus bezeichnet werden. Oracle AI Database enthält einen Undo Advisor, der Ihnen Ratschläge zur Automatisierung Ihrer Undo-Umgebung gibt.
Eine Datenbank kann mehrere Undo Tablespaces enthalten, wobei jeweils nur ein Tablespace verwendet werden kann. Wenn eine Instanz versucht, eine Datenbank zu öffnen, wählt Oracle AI Database automatisch den ersten verfügbaren Undo Tablespace aus. Wenn kein Undo Tablespace verfügbar ist, wird die Instanz ohne Undo Tablespace gestartet und speichert Undo-Daten im Tablespace SYSTEM. Das Speichern von Undo-Daten in SYSTEM wird nicht empfohlen.
Siehe:
-
Oracle AI Database Administrator's Guide für Informationen zum automatischen Undo-Management
-
Oracle AI Database Upgrade Guide, um zu erfahren, wie Sie in den automatischen Undo-Managementmodus migrieren
Automatische Undo-Erhaltung
Der Undo-Aufbewahrungszeitraum ist die Mindestdauer, die Oracle AI Database versucht, alte Undo-Daten aufzubewahren, bevor sie überschrieben werden.
Die Undo-Aufbewahrung ist wichtig, da Abfragen mit langer Ausführungszeit möglicherweise ältere Blockimages erfordern, um Lesekonsistenz bereitzustellen. Einige Oracle Flashback-Features können auch von der Undo-Verfügbarkeit abhängen.
Im Allgemeinen ist es wünschenswert, alte Undo-Daten so lange wie möglich zu speichern. Nach dem Festschreiben einer Transaktion werden Undo-Daten nicht mehr für Rollback oder Transaktions-Recovery benötigt. Die Datenbank kann alte Undo-Daten beibehalten, wenn der Undo Tablespace Speicherplatz für neue Transaktionen hat. Wenn der verfügbare Speicherplatz gering ist, überschreibt die Datenbank alte Undo-Daten für festgeschriebene Transaktionen.
Oracle AI Database bietet automatisch die bestmögliche Undo-Aufbewahrung für den aktuellen Undo Tablespace. Die Datenbank sammelt Nutzungsstatistiken und optimiert den Aufbewahrungszeitraum basierend auf diesen Statistiken und der Größe des Undo Tablespace. Wenn der Undo Tablespace mit der Option AUTOEXTEND konfiguriert ist und die maximale Größe nicht angegeben ist, unterscheidet sich das Undo-Aufbewahrungs-Tuning. In diesem Fall optimiert die Datenbank den Undo-Aufbewahrungszeitraum so, dass er etwas länger ist als die Abfrage mit der längsten Ausführungszeit, wenn der Speicherplatz dies zulässt.
Siehe auch: Oracle AI Database Administrator's Guide für weitere Details zum automatischen Tuning der Undo-Aufbewahrung
Schatten-Tablespaces
Ein Schatten-Tablespace ist ein Bigfile Tablespace, der für den Schattenverlust-Schreibschutz bestimmt ist.
Hinweis: Der Schutz vor Schattenverlust bezieht sich nicht auf den Schutz vor Verlust von Schreibvorgängen, der mit dem Initialisierungsparameter DB_LOST_WRITE_PROTECT und einer Standbydatenbank konfiguriert ist.
-
Zweck von Schatten-Tablespaces Der Schatten-Schreibschutz ermöglicht eine schnelle Erkennung und sofortige Reaktion auf einen verlorenen Schreibvorgang.
-
Funktionsweise von Shadow Tablespaces Der Schutz für verlorene Schreibvorgänge erfordert zwei Tablespaces: einen Schatten-Tablespace und einen Nicht-Schatten-Tablespace, dessen Blöcke vom Schatten-Tablespace verfolgt werden.
-
Benutzeroberfläche für Schatten-Tablespaces Sie aktivieren und deaktivieren den Schatten-Schreibschutz mit dem Befehl
ALTER PLUGGABLE DATABASE. -
Beispiel: Schutz vor verlorenem Schreibzugriff konfigurieren Dieses Beispiel aktiviert das Shadow Write Tracking für eine Gruppe von Tablespaces.
Zweck von Shadow Tablespaces
Der Schutz vor Schattenverlusten ermöglicht eine schnelle Erkennung und sofortige Reaktion auf einen verlorenen Schreibvorgang.
Ein verlorener Schreibvorgang eines Datenblocks tritt auf, wenn ein I/O-Subsystem den Abschluss des Blockschreibvorgangs bestätigt, obwohl der Schreibvorgang nicht stattgefunden hat oder wenn ein ehemaliges Abbild des Blocks das aktuelle Abbild überschreibt.
Ein nicht erkannter verlorener Schreibvorgang kann zu einer Datenbeschädigung führen, da die falschen Daten für andere DML-Transaktionen verwendet werden können. Beispiel: Eine Transaktion kann alte und falsche Daten aus einer Tabelle lesen und dann Hunderte anderer Tabellen aktualisieren, die auf diesen Daten basieren. Auf diese Weise kann die Datenbeschädigung in der gesamten Datenbank verteilt werden.
Schattenverlust-Schreibschutz bietet die folgenden Vorteile:
-
Er erkennt einen verlorenen Schreibvorgang, bevor er für Standard-DML-, konventionelle SQL*Loader-Pfadladevorgänge, Direct Path-Ladevorgänge und RMAN-Backups verwendet wird.
-
Sie können den Schatten-Schreibschutz für bestimmte Tablespaces und Datendateien aktivieren. Sie müssen nicht alle Daten verfolgen.
-
Sie können einen Shadow Tablespace durch einen anderen ersetzen, um seine Konfiguration oder seinen Speicherort zu ändern.
-
Sie können den Schattenschreibschutz für einen Tablespace oder eine Datendatei unterbrechen und wiederaufnehmen.
-
Sie können sie mit einer einzelnen
ALTER DATABASE ... LOST WRITE PROTECTION-Anweisung für eine PDB aktivieren oder deaktivieren. Die TabellePROP$gibt an, ob das Tracking für eine PDB aktiviert ist.
Siehe auch: Oracle AI Database SQL Language Reference, um mehr über die LOST WRITE PROTECTION-Klausel zu erfahren
Funktionsweise von Schatten-Tablespaces
Für den Schutz vor verlorenem Schreibzugriff sind zwei Tablespaces erforderlich: ein Schatten-Tablespace und ein Nicht-Schatten-Tablespace, dessen Blöcke vom Schatten-Tablespace verfolgt werden.
Die folgende Abbildung enthält ein Beispielszenario. Die Datendateien in den Tablespaces TBS1 und TBS2 werden von einem Schatten-Tablespace verfolgt. Nur die Datendatei DBF6 in Tablespace TBS3 wird vom Schatten-Tablespace verfolgt.
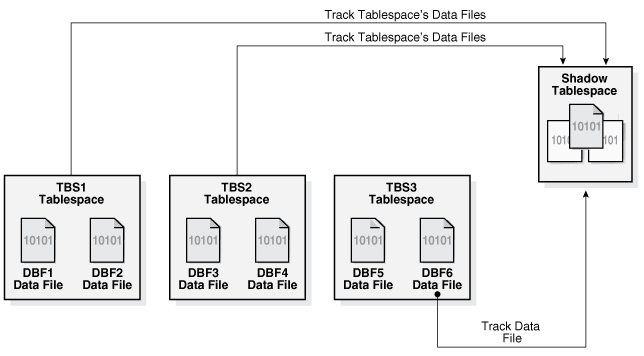
Beschreibung der Abbildung cncpt390.png
Eine verfolgte Datendatei ist einem Schatten-Extent in einem Schatten-Tablespace zugeordnet. Jeder Datenblock in einer verfolgten Datendatei hat einen entsprechenden Eintrag in einem Schattenblock. Dieser Eintrag enthält die SCN des verfolgten Datenblocks. Wenn ein verfolgter Datenblock vom Datenträger gelesen wird, vergleicht der Schattenschutz beim Schreiben die SCN für den Block im Schatten-Tablespace mit der SCN des letzten Schreibvorgangs im verfolgten Datenblock. Wenn der Schatteneintrag eine SCN aufweist, die größer ist als der zu lesende Datenblock, ist ein verlorener Schreibvorgang aufgetreten, und ein Fehler wird ausgegeben.
Die Größe des Schatten-Extents ist mit einem erheblichen zusätzlichen Platz bemessen, um zu verhindern, dass die automatische Größenänderung von Datendateien dazu führt, dass das Schatten-Extent zu groß wird. Wenn die Größe einer verfolgten Datendatei manuell oder automatisch geändert wird und das Schatten-Extent wachsen muss, versucht die Datenbank, die Größe der Verfolgungsdaten zu ändern. Wenn nicht genügend Speicherplatz in den Schatten-Tablespaces vorhanden ist, schreibt die Datenbank eine Warnung in das Alert Log und verfolgt so viele Datenblöcke wie möglich.
Siehe auch: Oracle AI Database - Administratordokumentation, in dem Sie erfahren, wie Sie den Schattenschutz beim Verlust von Schreibschutz verwalten
Benutzeroberfläche für Shadow Tablespaces
Mit dem Befehl ALTER PLUGGABLE DATABASE aktivieren und deaktivieren Sie den Schreibschutz für Schattenverluste.
Um einen bestimmten Tablespace oder eine bestimmte Datendatei zu schützen, müssen die folgenden Bedingungen erfüllt sein:
-
Sie müssen den Schatten-Schreibschutz für die gesamte PDB mit der Anweisung
ALTER PLUGGABLE DATABASE ENABLE LOST WRITE PROTECTIONaktiviert haben.Hinweis: Wenn Sie in einer CDB den Schattenschutz für verlorene Schreibvorgänge in der Root aktivieren, erben die PDBs sie nicht. Sie müssen den Schattenschutz für verlorene Schreibvorgänge für jede PDB aktivieren, die Sie schützen möchten.
-
Sie müssen den Schatten-Schreibschutz für den Tablespace oder die Datendatei aktiviert haben, um mit der Klausel
ENABLE LOST WRITE PROTECTIONgeschützt zu werden.Wenn Sie den Schatten-Schreibschutz für einen Tablespace aktivieren, werden alle Datendateien des Tablespace geschützt, und alle dem Tablespace hinzugefügten Datendateien werden ebenfalls geschützt. Beachten Sie, dass Sie den Schutz vor verlorenem Schreibzugriff für temporäre Tablespaces oder einen anderen Tablespace mit verlorenem Schreibzugriff nicht aktivieren können.
-
Sie müssen einen oder mehrere Shadow Tablespaces mit der Anweisung
CREATE BIGFILE TABLESPACEund der KlauselLOST WRITE PROTECTIONerstellt haben.
Oracle AI Database weist einem bestimmten Shadow Tablespace automatisch eine verfolgte Datendatei zu. Sie können nicht angeben, welcher Schatten-Tablespace für eine bestimmte Datendatei verwendet wird.
Die folgenden Data Dictionary Views überwachen Schatten-Tablespaces:
-
DBA_TABLESPACESZeigt an, welche Tablespaces durch Abfragen Schatten-Tablespaces sind.
-
DBA_DATA_FILES.LOST_WRITE_PROTECTZeigt an, ob der Schreibschutz bei Verlust für eine Datendatei aktiviert ist
-
USER_TABLESPACES.LOST_WRITE_PROTECTZeigt an, ob der Schutz vor verlorenem Schreibzugriff für einen bestimmten Tablespace aktiviert ist.
DBA_DATA_FILESgibt nicht an, ob verlorene Schreibvorgänge für einen Tablespace aktiviert sind: Sie müssen stattdessenUSER_TABLESPACESprüfen.
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten des Schutzes verlorener Schreibvorgänge mit Schatten-Tablespaces
-
Oracle AI Database SQL Language Reference, um mehr über die
CREATE TABLESPACE-Anweisung zu erfahren -
Oracle AI Database Reference, um mehr über
DBA_TABLESPACESzu erfahren
Beispiel: Konfigurieren des Schutzes verlorener Schreibvorgänge
In diesem Beispiel wird das Shadow Lost Write Tracking für eine Gruppe von Tablespaces aktiviert.
In diesem Beispiel ist es Ihr Ziel, die Tablespaces salestbs und hrtbs innerhalb einer PDB zu schützen. Sie möchten auch die Datendatei oetbs01.dbf und nur diese Datendatei im Tablespace oetbs schützen. Sie führen folgende Schritte aus:
-
Melden Sie sich bei der PDB als Administrator an.
-
Erstellen Sie einen einzelnen Shadow Tablespace wie folgt:
CREATE BIGFILE TABLESPACE shadow_lwp1 DATAFILE 'shadow_lwp1_df' SIZE 10M LOST WRITE PROTECTION; -
Aktivieren Sie den Schutz für verlorene Schreibvorgänge für die PDB wie folgt:
ALTER DATABASE ENABLE LOST WRITE PROTECTION; -
Aktivieren Sie den Schatten-Schreibschutz für die Tablespaces
salestbsundhrtbswie folgt:ALTER TABLESPACE salestbs ENABLE LOST WRITE PROTECTION; ALTER TABLESPACE hrtbs ENABLE LOST WRITE PROTECTION; -
Aktivieren Sie den Schattenschreibschutz für die Datendatei
oetbs01.dbfwie folgt:ALTER DATABASE DATAFILE 'oetbs01.dbf' ENABLE LOST WRITE PROTECTION;
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten von Shadow Tablespaces
-
Oracle AI Database SQL Language Reference, um mehr über die
CREATE TABLESPACE-Anweisung zu erfahren
Temporary Tablespaces
Ein temporärer Tablespace enthält transiente Daten, die nur für die Dauer einer Session beibehalten werden. In einem temporären Tablespace können sich keine permanenten Schemaobjekte befinden. In einer temp-Datei werden temporäre Tablespace-Daten gespeichert.
Temporäre Tablespaces können den gleichzeitigen Zugriff auf mehrere Sortiervorgänge verbessern, die nicht in den Speicher passen. Diese Tablespaces verbessern auch die Effizienz von Speicherplatzverwaltungsvorgängen während Sortierungen.
-
Gemeinsame und lokale Temporary Tablespaces Temporary Tablespaces sind entweder gemeinsam verwendet oder lokal.
-
Standard-Temporary Tablespaces Jedem Datenbankbenutzeraccount wird ein Standard-Shared Temporary Tablespace zugewiesen. Wenn die Datenbank lokale Temporary Tablespaces enthält, wird jedem Benutzeraccount auch der standardmäßige lokale Temporary Storage zugewiesen.
Gemeinsam genutzte und lokale Temporary Tablespaces
Temporary Tablespaces werden entweder gemeinsam verwendet oder lokal verwendet.
Ein gemeinsam verwendeter temporärer Tablespace speichert temporäre Dateien auf einem gemeinsam genutzten Datenträger, sodass der temporäre Speicherplatz für alle Datenbankinstanzen zugänglich ist. Im Gegensatz dazu speichert ein lokaler temporärer Tablespace separate, nicht gemeinsam verwendete temporäre Dateien für jede Datenbankinstanz. Lokale Temporary Tablespaces sind für Oracle Real Application Clusters oder Oracle Flex-Cluster nützlich.
Sie können lokale Temporary Tablespaces sowohl für schreibgeschützte als auch für Datenbankinstanzen mit Lese-/Schreibzugriff erstellen. Wenn viele schreibgeschützte Instanzen auf eine einzelne Datenbank zugreifen, können lokale Temporary Tablespaces die Performance für Abfragen verbessern, die Sortierungen, Hashaggregationen und Joins umfassen. Die Vorteile sind:
-
Verbesserung der I/O-Performance durch Verwendung von lokalem statt gemeinsam genutztem Datenträgerspeicher
-
Vermeidung kostspieliger instanzübergreifender temporärer Speicherplatzverwaltung
-
Verbesserung der Startleistung der Instanz durch Eliminierung der Verwaltung von Speicherplatzmetadaten auf Datenträger
In der folgenden Tabelle werden die Eigenschaften von gemeinsam genutzten und lokalen Temporary Tablespaces verglichen.
Tabelle 2: Gemeinsam genutzte und lokale Temporary Tablespaces
| Shared Temporary Tablespace | Lokaler Temporary Tablespace |
|---|---|
Mit der Anweisung CREATE TEMPORARY TABLESPACE erstellt. |
Mit der Anweisung Hinweis: Ein lokaler Temporary Tablespace ist immer ein Bigfile Tablespace, aber das Schlüsselwort |
| Erstellt einen einzelnen temporären Tablespace für die Datenbank. | Erstellt separate Temporary Tablespaces für jede Datenbankinstanz. Mit der Option FOR LEAF werden Tablespaces nur für schreibgeschützte Instanzen erstellt. Mit der Option FOR ALL werden Tablespaces für alle Instanzen erstellt, sowohl schreibgeschützt als auch mit Lese-/Schreibzugriff. |
| Unterstützt Tablespace-Gruppen. | Unterstützt keine Tablespace-Gruppen. |
| Speichert Metadaten der temporären Datei in der Kontrolldatei. | Speichert Metadaten der temporären Datei, die für alle Instanzen in der Kontrolldatei gemeinsam sind, und instanzspezifische Metadaten (z.B. Bitmaps für die Zuweisung, aktuelle Größe der temporären Datei und Dateistatus) in der SGA. |
Siehe auch: "Einführung in die Oracle AI Database-Instanz"
Standard-Temporary Tablespaces
Jedem Datenbankbenutzeraccount wird ein gemeinsamer Default Temporary Tablespace zugewiesen. Wenn die Datenbank lokale Temporary Tablespaces enthält, wird jedem Benutzeraccount auch der standardmäßige lokale Temporary Storage zugewiesen.
Mit den Anweisungen CREATE USER oder ALTER USER können Sie einen anderen Temporary Tablespace für einen Benutzeraccount angeben. Oracle AI Database verwendet den Default Temporary Tablespace auf Systemebene für Benutzer, für die Sie keinen anderen Temporary Tablespace angeben.
-
Standard-Temporary Tablespaces erstellen Beim Erstellen einer Datenbank hängt der temporäre Standardspeicher davon ab, ob der Tablespace
SYSTEMlokal verwaltet wird. -
Zugriff auf Temporary Storage Wenn einem Benutzer ein Temporary Tablespace zugewiesen ist, greift die Datenbank zuerst darauf zu. Andernfalls greift die Datenbank auf den Default Temporary Tablespace zu. Wenn die Datenbank auf einen temporären Tablespace für eine Abfrage zugreift, wechselt sie nicht zu einem anderen Tablespace. Siehe auch: Oracle AI Database SQL Language Reference, um mehr über die
CREATE USER-Anweisung zu erfahren
Standard-Temporary Tablespaces erstellen
Beim Erstellen einer Datenbank hängt der temporäre Standardspeicher davon ab, ob der Tablespace SYSTEM lokal verwaltet wird.
In der folgenden Tabelle wird dargestellt, wie Oracle AI Database Default Temporary Tablespaces beim Erstellen der Datenbank auswählt.
Tabelle 3: Erstellen von Standard-Temporary Tablespaces
| Wird der SYSTEM Tablespace lokal verwaltet? | Gibt die Anweisung CREATE DATABASE einen Default Temporary Tablespace an? | Dann die Datenbank … |
|---|---|---|
| Ja | Ja | Verwendet den angegebenen Tablespace als Default. |
| Ja | Nein | Erstellt einen temporären Tablespace. |
| Nein | Ja | Verwendet den angegebenen Tablespace als Default. |
| Nein | Nein | Verwendet SYSTEM als temporären Standardspeicher. Die Datenbank schreibt eine Warnung in das Alertlog, die besagt, dass ein Default Temporary Tablespace empfohlen wird. |
Nach der Datenbankerstellung können Sie den Default Temporary Tablespace für die Datenbank mit der Anweisung ALTER DATABASE DEFAULT TEMPORARY TABLESPACE ändern. Hinweis: Sie können einen temporären Default Tablespace nicht permanent machen.
Siehe:
-
Oracle AI Database Administrator's Guide zum Erstellen eines Default Temporary Tablespace
-
Oracle AI Database SQL Language Reference für die Syntax der
DEFAULT TEMPORARY TABLESPACE-Klausel vonCREATE DATABASEundALTER DATABASE
Zugriff auf temporären Speicher
Wenn einem Benutzer ein Temporary Tablespace zugewiesen ist, greift die Datenbank zuerst darauf zu. Andernfalls greift die Datenbank auf den Default Temporary Tablespace zu. Wenn die Datenbank auf einen temporären Tablespace für eine Abfrage zugreift, wechselt sie nicht zu einem anderen Tablespace.
Eine Benutzerabfrage kann auf gemeinsamen oder lokalen temporären Speicher zugreifen. Darüber hinaus kann einem Benutzer ein lokaler Default Temporary Tablespace für schreibgeschützte Instanzen und ein anderer lokaler Default Temporary Tablespace für Lese-/Schreibinstanzen zugewiesen sein.
Bei Lese-/Schreibinstanzen hat die Datenbank für Shared Temporary Tablespaces eine höhere Priorität. Bei schreibgeschützten Instanzen hat die Datenbank eine höhere Priorität für lokale Temporary Tablespaces. Wenn die Datenbankinstanz mit Lese-/Schreibzugriff versehen ist, sucht die Datenbank nach Speicherplatz in der folgenden Reihenfolge:
-
Ist dem Benutzer ein Shared Temporary Tablespace zugewiesen?
-
Ist dem Benutzer ein lokaler temporärer Tablespace zugewiesen?
-
Verfügt der Default Temporary Tablespace der Datenbank über Speicherplatz?
Wenn die Antwort auf eine vorhergehende Frage "Ja" lautet, stoppt die Datenbank die Suche und weist Speicherplatz aus dem angegebenen Tablespace zu. Andernfalls wird Speicherplatz aus dem lokalen Default Tablespace der Datenbank zugewiesen.
Wenn die Datenbankinstanz schreibgeschützt ist, sucht die Datenbank nach Speicherplatz in der folgenden Reihenfolge:
-
Ist dem Benutzer ein lokaler temporärer Tablespace zugewiesen?
-
Verfügt der zugewiesene lokale Default Temporary Tablespace der Datenbank über Speicherplatz?
-
Ist dem Benutzer ein Shared Temporary Tablespace zugewiesen?
Wenn die Antwort auf die obigen Fragen "Ja" lautet, stoppt die Datenbank die Suche und weist Speicherplatz aus dem angegebenen Tablespace zu. Andernfalls wird Speicherplatz aus dem standardmäßigen Shared Temporary Tablespace der Datenbank zugewiesen.
Tablespace-Modi
Der Tablespace-Modus bestimmt die Zugänglichkeit des Tablespace.
-
Lese-/Schreib- und schreibgeschützte Tablespaces Jeder Tablespace befindet sich in einem Schreibmodus, der angibt, ob er geschrieben werden kann.
-
Online- und Offline-Tablespaces Ein Tablespace kann online (zugänglich) oder offline (nicht zugänglich) sein, wenn die Datenbank geöffnet ist.
Read/Write- und Read-Only Tablespaces
Jeder Tablespace befindet sich in einem Schreibmodus, der angibt, ob er geschrieben werden kann.
Die sich gegenseitig ausschließenden Modi lauten wie folgt:
-
Lese-/Schreibmodus
Benutzer können den Tablespace lesen und in ihn schreiben. Alle Tablespaces werden zunächst mit Lese-/Schreibzugriff erstellt. Die Tablespaces
SYSTEMundSYSAUXund Temporary Tablespaces sind permanent schreibgeschützt. Dies bedeutet, dass sie nicht schreibgeschützt sein können. -
Schreibgeschützter Modus
Schreibvorgänge in die Datendateien im Tablespace werden verhindert. Ein Read-Only Tablespace kann auf schreibgeschützten Medien wie DVDs oder WORM-Laufwerken gespeichert werden.
Mit Read-Only Tablespaces müssen keine großen, statischen Teile einer Datenbank gesichert und wiederhergestellt werden. Schreibgeschützte Tablespaces ändern sich nicht und erfordern daher kein wiederholtes Backup. Wenn Sie eine Datenbank nach einem Media-Fehler wiederherstellen, müssen Sie keine Read-Only Tablespaces wiederherstellen.
Siehe:
-
Oracle AI Database - Administratordokumentation, in der beschrieben wird, wie Sie einen Tablespace in den schreibgeschützten oder Lese-/Schreibmodus ändern
-
Oracle AI Database SQL Language Reference für
ALTER TABLESPACE-Syntax und Semantik -
Oracle AI Database Backup and Recovery - Benutzerhandbuch für weitere Informationen zum Recovery
Online- und Offline-Tablespaces
Ein Tablespace kann online (zugänglich) oder offline (nicht zugänglich) sein, wenn die Datenbank geöffnet ist.
Ein Tablespace ist in der Regel online, sodass seine Daten den Benutzern zur Verfügung stehen. Der Tablespace SYSTEM und Temporary Tablespaces können nicht offline gesetzt werden.
Ein Tablespace kann automatisch oder manuell offline gesetzt werden. Beispiel: Sie können einen Tablespace für Wartung oder Backup und Recovery offline setzen. Die Datenbank setzt einen Tablespace automatisch offline, wenn bestimmte Fehler auftreten, z.B. wenn der Datenbank-Writer-(DBW-)Prozess bei mehreren Schreibversuchen in eine Datendatei ausfällt. Benutzer, die versuchen, auf Tabellen in einem Offline Tablespace zuzugreifen, erhalten einen Fehler.
Wenn ein Tablespace offline gesetzt wird, führt die Datenbank folgende Aktionen aus:
-
Die Datenbank lässt nicht zu, dass nachfolgende DML-Anweisungen Objekte im Offline Tablespace referenzieren. Ein Offline Tablespace kann nicht von einem anderen Utility als Oracle AI Database gelesen oder bearbeitet werden.
-
Aktive Transaktionen mit abgeschlossenen Anweisungen, die sich auf Daten in diesem Tablespace beziehen, sind auf Transaktionsebene nicht betroffen.
-
Die Datenbank speichert Undo-Daten, die diesen abgeschlossenen Anweisungen in einem verzögerten Undo-Segment im Tablespace
SYSTEMentsprechen. Wenn der Tablespace online gesetzt wird, wendet die Datenbank die Undo-Daten gegebenenfalls auf den Tablespace an.
Siehe:
-
Oracle AI Database Administrator's Guide zum Ändern der Tablespace-Verfügbarkeit
Tablespace-Dateigröße
Ein Tablespace ist entweder ein Bigfile Tablespace oder ein Smallfile Tablespace. Diese Tablespaces sind hinsichtlich der Ausführung von SQL-Anweisungen, die nicht explizit auf Datendateien oder temporäre Dateien verweisen, nicht zu unterscheiden.
Der Unterschied ist wie folgt:
-
Ein Smallfile Tablespace kann mehrere Datendateien oder temporäre Dateien enthalten, die Dateien dürfen jedoch nicht so groß sein wie in einem Bigfile Tablespace. Dies ist der Default Tablespace-Typ.
-
Ein Bigfile Tablespace enthält eine sehr große Datendatei oder temporäre Datei. Dieser Tablespace-Typ kann folgende Aufgaben ausführen:
-
Erhöhung der Speicherkapazität einer Datenbank
Die maximale Anzahl von Datendateien in einer Datenbank ist begrenzt. Wenn Sie also die Größe jeder Datendatei erhöhen, erhöht sich der Gesamtspeicher.
-
Weniger Aufwand bei der Verwaltung vieler Datendateien und temporärer Dateien
Bigfile Tablespaces vereinfachen die Dateiverwaltung mit Oracle Managed Files und Automatic Storage Management (Oracle ASM), da keine neuen Dateien hinzugefügt und mehrere Dateien bearbeitet werden müssen.
-
Operationen für Tablespaces statt für einzelne Dateien ausführen
Bigfile Tablespaces machen den Tablespace zur Haupteinheit für Verwaltung, Backup und Recovery des Festplattenspeichers usw.
Bigfile Tablespaces werden nur für lokal verwaltete Tablespaces mit ASSM unterstützt. Lokal verwaltete Undo- und Temporary Tablespaces können jedoch Bigfile Tablespaces sein, selbst wenn Segmente manuell verwaltet werden.
Ab Oracle AI Database 26ai werden die Tablespaces SYSTEM, SYSAUX und USER standardmäßig als Bigfile Tablespaces erstellt. Eine Datenbank, die von einem früheren Release upgegradet wurde, behält ihren Tablespace-Typ bei.
-
Siehe:
-
Oracle AI Database Backup and Recovery - Benutzerhandbuch, um mehr über Backup und Recovery zu erfahren
-
Oracle AI Database Administrator's Guide zum Verwalten von Bigfile Tablespaces