Indizes und indexorganisierte Tabellen
Indizes sind Schemaobjekte, die den Zugriff auf Tabellenzeilen beschleunigen können. Index-organisierte Tabellen sind Tabellen, die in einer Indexstruktur gespeichert sind.
-
Einführung in Indizes Ein Index ist eine optionale Struktur, die mit einer Tabelle oder einem Tabellencluster verknüpft ist und den Datenzugriff manchmal beschleunigen kann.
-
Überblick über B*-Baumindizes B-Bäume, kurz für balancierte Bäume, sind der häufigste Typ von Datenbankindex. Ein B*-Baumindex ist eine geordnete Werteliste, die in Bereiche unterteilt ist. Durch die Zuordnung eines Schlüssels zu einer Zeile oder einem Zeilenbereich bieten B-Bäume eine hervorragende Abrufleistung für eine Vielzahl von Abfragen, einschließlich exakter Übereinstimmungen und Bereichssuchen.
-
Überblick über Bitmapindizes In einem Bitmapindex speichert die Datenbank ein Bitmap für jeden Indexschlüssel. In einem herkömmlichen B*-Baumindex zeigt ein Indexeintrag auf eine einzelne Zeile. In einem Bitmap-Index speichert jeder Indexschlüssel Zeiger auf mehrere Zeilen.
-
Überblick über funktionsbasierte Indizes Ein funktionsbasierter Index berechnet den Wert einer Funktion oder eines Ausdrucks, der eine oder mehrere Spalten umfasst, und speichert ihn in einem Index. Ein funktionsbasierter Index kann entweder ein B*-Baum oder ein Bitmap-Index sein.
-
Überblick über Anwendungsdomainindizes Ein Anwendungsdomainindex ist ein benutzerdefinierter Index, der für eine Anwendung spezifisch ist.
-
Überblick über skalare quantisierte HNSW-Indizes Skalare quantisierte hierarchische navigierbare kleine Weltindizes (HNSW) können verwendet werden, um den Speicherbedarf zu reduzieren und die Ähnlichkeitssuche zu beschleunigen.
-
Übersicht über indexorganisierte Tabellen Eine indexorganisierte Tabelle ist eine Tabelle, die in einer Variation einer B*-Baumindexstruktur gespeichert ist. Im Gegensatz dazu fügt eine heap-organisierte Tabelle Zeilen dort ein, wo sie passen.
Indizes – Einführung
Ein Index ist eine optionale Struktur, die mit einer Tabelle oder einem Tabellencluster verknüpft ist und den Datenzugriff manchmal beschleunigen kann.
Indizes sind Schemaobjekte, die logisch und physisch unabhängig von den Daten in den Objekten sind, mit denen sie verknüpft sind. So können Sie einen Index löschen oder erstellen, ohne dass sich dies auf die indizierte Tabelle auswirkt.
Hinweis: Wenn Sie einen Index löschen, funktionieren die Anwendungen weiterhin. Der Zugriff auf zuvor indizierte Daten kann jedoch langsamer sein.
Angenommen, ein HR-Manager hat ein Regal aus Kartons. Ordner mit Mitarbeiterinformationen werden zufällig in die Felder eingefügt. Der Ordner für Mitarbeiter Whalen (ID 200) ist 10 Ordner von unten in Feld 1, während der Ordner für King (ID 100) unten in Feld 3 steht. Um einen Ordner zu suchen, prüft der Manager jeden Ordner in Feld 1 von unten nach oben und wechselt dann von Feld zu Feld, bis der Ordner gefunden wird. Um den Zugriff zu beschleunigen, könnte der Manager einen Index erstellen, der jede Personalnummer nacheinander mit ihrem Ordnerort auflistet:
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
Ebenso kann der Manager separate Indizes für Nachnamen, Abteilungskennungen usw. von Mitarbeitern erstellen.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Vorteile und Nachteile von Indizes Das Fehlen oder Vorhandensein eines Index erfordert keine Änderung des Wortlauts einer SQL-Anweisung.
-
Indexverwendbarkeit und Sichtbarkeit Indizes sind verwendbar (Standardwert) oder nicht verwendbar, sichtbar (Standardwert) oder unsichtbar.
-
Schlüssel und Spalten Ein Schlüssel ist eine Gruppe von Spalten oder Ausdrücken, auf denen Sie einen Index erstellen können.
-
Zusammengesetzte Indizes Ein zusammengesetzter Index, der auch als zusammengesetzter Index bezeichnet wird, ist ein Index für mehrere Spalten in einer Tabelle.
-
Eindeutige und nicht eindeutige Indizes können eindeutig oder nicht eindeutig sein. Eindeutige Indizes garantieren, dass keine zwei Zeilen einer Tabelle doppelte Werte in der Schlüsselspalte oder den Schlüsselspalten aufweisen.
-
Indizesstypen Oracle AI Database bietet mehrere Indexierungsschemas, die eine ergänzende Leistungsfunktionalität bieten.
-
So verwaltet die Datenbank Indizes Die Datenbank verwaltet und verwendet Indizes automatisch, nachdem sie erstellt wurden.
-
Index Storage Oracle AI Database speichert Indexdaten in einem Indexsegment.
Vor- und Nachteile von Indizes
Das Fehlen oder Vorhandensein eines Index erfordert keine Änderung des Wortlauts einer SQL-Anweisung.
Ein Index ist ein schneller Zugriffspfad zu einer einzelnen Datenzeile. Es wirkt sich nur auf die Geschwindigkeit der Ausführung aus. Bei einem indizierten Datenwert verweist der Index direkt auf die Position der Zeilen, die diesen Wert enthalten.
Wenn ein Index für eine oder mehrere Spalten einer Tabelle vorhanden ist, kann die Datenbank in einigen Fällen eine kleine Gruppe zufällig verteilter Zeilen aus der Tabelle abrufen. Indizes sind eine von vielen Möglichkeiten zur Reduzierung von Datenträger-I/O. Wenn eine Heap-organisierte Tabelle keine Indizes enthält, muss die Datenbank einen vollständigen Tabellenscan durchführen, um einen Wert zu finden. Beispiel: Bei einer Abfrage des Speicherorts 2700 in der nicht indizierten Tabelle hr.departments muss die Datenbank jede Zeile in jedem Block durchsuchen. Dieser Ansatz lässt sich nicht skalieren, da die Datenmengen steigen.
Nachteile von Indizes sind:
-
Das manuelle Erstellen von Indizes erfordert häufig umfassende Kenntnisse in Bezug auf Datenmodell, Anwendung und Datenverteilung.
-
Wenn sich die Daten ändern, müssen Sie frühere Entscheidungen über Indizes erneut prüfen. Möglicherweise ist ein Index nicht mehr nützlich, oder es sind neue Indizes erforderlich.
-
Indizes belegen Speicherplatz.
-
Die Datenbank muss den Index aktualisieren, wenn DML für die indizierten Daten auftritt, wodurch Performance-Overhead entsteht. Hinweis: Ab Oracle Database 19c kann die Oracle-Datenbank die Anwendungs-Workload ständig überwachen und Indizes automatisch erstellen und verwalten. Die automatisierte Indizierung wird als Datenbankaufgabe implementiert, die in einem festen Intervall ausgeführt wird.
Erstellen Sie einen Index in den folgenden Situationen:
-
Die indizierten Spalten werden häufig abgefragt und geben einen kleinen Prozentsatz der Gesamtzahl der Zeilen in der Tabelle zurück.
-
Für die indizierte(n) Spalte(n) ist ein referenzielles Integritäts-Constraint vorhanden. Der Index ist ein Mittel, um eine vollständige Sperre der Tabelle zu vermeiden, die andernfalls erforderlich wäre, wenn Sie den Primärschlüssel der übergeordneten Tabelle aktualisieren, in der übergeordneten Tabelle zusammenführen oder aus der übergeordneten Tabelle löschen.
-
Ein eindeutiger Schlüssel-Constraint wird in die Tabelle eingefügt, und Sie möchten den Index und alle Indexoptionen manuell angeben.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über die automatisierte Indizierung zu erfahren
-
Benutzerhandbuch zu Oracle AI Database-Lizenzierungsinformationen für Details, welche Features für verschiedene Editionen und Services unterstützt werden
Benutzerfreundlichkeit und Sichtbarkeit von Indizes
Indizes sind verwendbar (Standardwert) oder nicht verwendbar, sichtbar (Standardwert) oder unsichtbar.
Diese Eigenschaften sind wie folgt definiert:
-
Benutzerfreundlichkeit
Ein nicht verwendbarer Index, der vom Optimizer ignoriert wird, wird von DML-Vorgängen nicht verwaltet. Ein unbrauchbarer Index kann die Performance von Bulk Loads verbessern. Anstatt einen Index zu löschen und ihn später neu zu erstellen, können Sie ihn unbrauchbar machen und dann neu erstellen. Nicht verwendbare Indizes und Indexpartitionen belegen keinen Speicherplatz. Wenn Sie einen verwendbaren Index unbrauchbar machen, löscht die Datenbank das zugehörige Indexsegment.
-
Sichtbarkeit
Ein unsichtbarer Index wird von DML-Vorgängen verwaltet, aber nicht standardmäßig vom Optimizer verwendet. Ein Index unsichtbar zu machen ist eine Alternative, um ihn unbrauchbar zu machen oder zu löschen. Unsichtbare Indizes sind besonders nützlich, um das Entfernen eines Index zu testen, bevor er gelöscht wird, oder um Indizes vorübergehend zu verwenden, ohne die Gesamtanwendung zu beeinträchtigen.
Siehe auch: "Überblick über den Optimizer", um zu erfahren, wie der Optimizer Ausführungspläne auswählt
Schlüssel und Spalten
Ein Schlüssel ist eine Gruppe von Spalten oder Ausdrücken, auf denen Sie einen Index erstellen können.
Obwohl die Begriffe häufig synonym verwendet werden, unterscheiden sich Indizes und Schlüssel. Indizes sind in der Datenbank gespeicherte Strukturen, die Benutzer mit SQL-Anweisungen verwalten. Schlüssel sind ein logisches Konzept.
Die folgende Anweisung erstellt einen Index für die Spalte customer_id der Beispieltabelle oe.orders:
CREATE INDEX ord_customer_ix ON orders (customer_id);In der vorherigen Anweisung ist die Spalte customer_id der Indexschlüssel. Der Index selbst heißt ord_customer_ix.
Hinweis: Primärschlüssel und eindeutige Schlüssel weisen automatisch Indizes auf. Möglicherweise möchten Sie jedoch einen Index für einen Fremdschlüssel erstellen.
Siehe:
-
Oracle AI Database SQL Language Reference
CREATE INDEX– Syntax und Semantik
Zusammengesetzte Indizes
Ein zusammengesetzter Index, der auch als zusammengesetzter Index bezeichnet wird, ist ein Index für mehrere Spalten in einer Tabelle.
Platzieren Sie Spalten in einem zusammengesetzten Index in der Reihenfolge, die für die Abfragen, die Daten abrufen, am sinnvollsten ist. Die Spalten müssen in der Tabelle nicht nebeneinander liegen.
Zusammengesetzte Indizes können den Abruf von Daten für SELECT-Anweisungen beschleunigen, in denen die WHERE-Klausel alle oder den führenden Teil der Spalten im zusammengesetzten Index referenziert. Daher ist die Reihenfolge der in der Definition verwendeten Spalten wichtig. Im Allgemeinen gehen die am häufigsten aufgerufenen Spalten zuerst.
Beispiel: Eine Anwendung fragt häufig die Spalten last_name, job_id und salary in der Tabelle employees ab. Gehen Sie auch davon aus, dass last_name eine hohe Kardinalität aufweist. Dies bedeutet, dass die Anzahl der eindeutigen Werte im Vergleich zur Anzahl der Tabellenzeilen groß ist. Sie erstellen einen Index mit der folgenden Spaltenreihenfolge:
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
Abfragen, die auf alle drei Spalten zugreifen, nur auf die Spalte last_name, oder nur auf die Spalten last_name und job_id verwenden diesen Index. In diesem Beispiel verwenden Abfragen, die nicht auf die Spalte last_name zugreifen, den Index nicht.
Hinweis: In einigen Fällen, z.B. wenn die führende Spalte eine sehr geringe Kardinalität aufweist, kann die Datenbank einen Skip Scan dieses Index verwenden (siehe "Index Skip Scan").
Mehrere Indizes können in derselben Tabelle mit derselben Spaltenreihenfolge vorhanden sein, wenn sie eine der folgenden Bedingungen erfüllen:
-
Die Indizes weisen unterschiedliche Typen auf.
Beispiel: Sie können Bitmap- und B*-Baumindizes für dieselben Spalten erstellen.
-
Die Indizes verwenden unterschiedliche Partitionierungsschemas.
Beispiel: Sie können Indizes erstellen, die lokal partitioniert sind, und Indizes, die global partitioniert sind.
-
Die Indizes weisen unterschiedliche Eindeutigkeitseigenschaften auf.
Beispiel: Sie können einen eindeutigen und einen nicht eindeutigen Index für dieselbe Gruppe von Spalten erstellen.
Beispiel: Ein nicht partitionierter Index, ein globaler partitionierter Index und ein lokal partitionierter Index können für dieselben Tabellenspalten in derselben Reihenfolge vorhanden sein. Es kann jeweils nur ein Index mit derselben Spaltenanzahl in derselben Reihenfolge angezeigt werden.
Mit dieser Funktion können Sie Anwendungen migrieren, ohne einen vorhandenen Index löschen und mit anderen Attributen neu erstellen zu müssen. Außerdem ist diese Funktion in einer OLTP-Datenbank nützlich, wenn ein Indexschlüssel weiter zunimmt. Dadurch fügt die Datenbank neue Einträge in dieselbe Gruppe von Indexblöcken ein. Um solche "Hot Spots" zu lindern, könnten Sie den Index von einem nicht partitionierten Index zu einem globalen partitionierten Index entwickeln.
Wenn sich Indizes für dieselbe Gruppe von Spalten im Typ- oder Partitionierungsschema nicht unterscheiden, müssen diese Indizes unterschiedliche Spaltenpermutationen verwenden. Beispiel: Die folgenden SQL-Anweisungen geben gültige Spaltenpermutationen an:
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);
Siehe auch: Oracle AI Database SQL Tuning Guide enthält weitere Informationen zum Erstellen mehrerer Indizes für dasselbe Spaltenset
Eindeutige und nicht eindeutige Indizes
Indizes können eindeutig oder nicht eindeutig sein. Eindeutige Indizes garantieren, dass keine zwei Zeilen einer Tabelle doppelte Werte in der Schlüsselspalte oder den Schlüsselspalten aufweisen.
Beispiel: In Ihrer Bewerbung ist es erforderlich, dass nicht zwei Mitarbeiter dieselbe Personalnummer haben. In einem eindeutigen Index ist für jeden Datenwert eine rowid vorhanden. Die Daten in den Leaf-Blöcken werden nur nach Schlüssel sortiert.
Nicht eindeutige Indizes ermöglichen doppelte Werte in der indizierten Spalte oder den indizierten Spalten. Beispiel: Die Spalte first_name der Tabelle employees kann mehrere Mike-Werte enthalten. Bei einem nicht eindeutigen Index wird die ROWID in sortierter Reihenfolge in den Schlüssel aufgenommen, sodass nicht eindeutige Indizes nach Indexschlüssel und ROWID (aufsteigend) sortiert werden.
Oracle AI Database indexiert keine Tabellenzeilen, in denen alle Schlüsselspalten null sind, mit Ausnahme von Bitmap-Indizes oder wenn der Clusterschlüsselspaltenwert null ist.
Indextypen
Oracle AI Database bietet mehrere Indexierungsschemas, die ergänzende Leistungsfunktionen bereitstellen.
B*-Baumindizes sind der Standardindextyp. Sie eignen sich hervorragend für hochselektive Indizes (nur wenige Zeilen entsprechen jedem Indexeintrag) und Primärschlüsselindizes. Als verkettete Indizes verwendet, kann ein B*-Baumindex Daten abrufen, die nach den indizierten Spalten sortiert sind. B*-Baumindizes haben die in der folgenden Tabelle gezeigten Subtypen.
Tabelle 1: B*-Baumindex-Subtypen
| B*-Baumindex-Subtyp | Beschreibung | Weitere Infos |
|---|---|---|
| Indexorganisierte Tabellen | Eine indexorganisierte Tabelle unterscheidet sich von einer Heap-organisierten Tabelle, da die Daten selbst der Index sind. | "Übersicht über Index Organized Tables" |
| Reverse Key-Indizes | Bei dieser Art von Index werden die Byte des Indexschlüssels umgekehrt, z.B. 103 wird als 301 gespeichert. Die Umkehrung von Byte verteilt Einfügungen in den Index über viele Blöcke. | "Reverse-Schlüsselindizes" |
| Absteigende Indizes | Dieser Indextyp speichert Daten in einer oder mehreren Spalten in absteigender Reihenfolge. | "Aufsteigend und absteigend Indizes" |
| B*-Baumclusterindizes | Dieser Indextyp speichert Daten in einer oder mehreren Spalten in absteigender Reihenfolge. | "Aufsteigend und Absteigend Indizes" |
In der folgenden Tabelle werden Indextypen angezeigt, die keine B*-Baumstruktur verwenden.
Tabelle 2: Indizes ohne B*-Baumstruktur
| Typ | Beschreibung | Weitere Infos |
|---|---|---|
| Bitmap- und Bitmap Join-Indizes | In einem Bitmap-Index verwendet ein Indexeintrag ein Bitmap, um auf mehrere Zeilen zu zeigen. Im Gegensatz dazu zeigt ein B*-Baumindexeintrag auf eine einzelne Zeile. Ein Bitmap Join-Index ist ein Bitmap-Index für den Join von zwei oder mehr Tabellen. | "Überblick über Bitmapindizes" |
| Funktionsbasierte Indizes | Dieser Indextyp enthält Spalten, die entweder von einer Funktion wie der Funktion UPPER transformiert oder in einen Ausdruck eingeschlossen werden. B*-Baum- oder Bitmap-Indizes können funktionsbasiert sein. |
"Übersicht über funktionsbasierte Indizes" |
| Anwendungsdomänenindizes | Ein Benutzer erstellt diesen Indextyp für Daten in einer anwendungsspezifischen Domain. Der physische Index muss keine herkömmliche Indexstruktur verwenden und kann entweder in der Oracle-Datenbank als Tabellen oder extern als Datei gespeichert werden. | "Überblick über Anwendungsdomainindizes" |
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten von Indizes
-
Oracle AI Database SQL Tuning Guide, um mehr über verschiedene Indexzugriffspfade zu erfahren
So verwaltet die Datenbank Indizes
Die Datenbank verwaltet und verwendet Indizes automatisch, nachdem sie erstellt wurden.
Indizes geben automatisch Datenänderungen an den zugrunde liegenden Tabellen wieder. Beispiele für Änderungen sind das Hinzufügen, Aktualisieren und Löschen von Datensätzen. Es sind keine Benutzeraktionen erforderlich.
Die Abrufleistung indizierter Daten bleibt nahezu konstant, auch wenn Zeilen eingefügt werden. Das Vorhandensein vieler Indizes für eine Tabelle beeinträchtigt jedoch die DML-Performance, da die Datenbank auch die Indizes aktualisieren muss.
Siehe:
-
Oracle AI Database Administrator's Guide, um mehr über die automatisierte Indizierung zu erfahren
-
Benutzerhandbuch zu Oracle AI Database-Lizenzierungsinformationen für Details, welche Features für verschiedene Editionen und Services unterstützt werden
Indexspeicherung
Oracle AI Database speichert Indexdaten in einem Indexsegment.
Verfügbarer Speicherplatz für Indexdaten in einem Datenblock ist die Datenblockgröße minus Block-Overhead, Eintrag-Overhead, Zeilen-ID und ein Längen-Byte für jeden indexierten Wert.
Der Tablespace eines Indexsegments ist entweder der Standard-Tablespace des Eigentümers oder ein Tablespace, der speziell in der CREATE INDEX-Anweisung benannt ist. Um die Administration zu vereinfachen, können Sie einen Index in einem separaten Tablespace von der zugehörigen Tabelle speichern. Beispiel: Sie können Tablespaces, die nur Indizes enthalten und neu erstellt werden können, nicht sichern und so die Zeit und den Speicher reduzieren, die für Backups erforderlich sind.
Siehe auch: "Übersicht über Indexblöcke", um mehr über die Typen von Indexblöcken (Root, Verzweigung und Leaf) und darüber zu erfahren, wie Indexeinträge in einem Block gespeichert werden
B*-Baumindizes - Überblick
B-Bäume, kurz für ausgeglichene Bäume, sind der häufigste Typ von Datenbankindex. Ein B*-Baumindex ist eine geordnete Werteliste, die in Bereiche unterteilt ist. Durch die Zuordnung eines Schlüssels zu einer Zeile oder einem Zeilenbereich bieten B-Bäume eine hervorragende Abrufleistung für eine Vielzahl von Abfragen, einschließlich exakter Übereinstimmungen und Bereichssuchen.
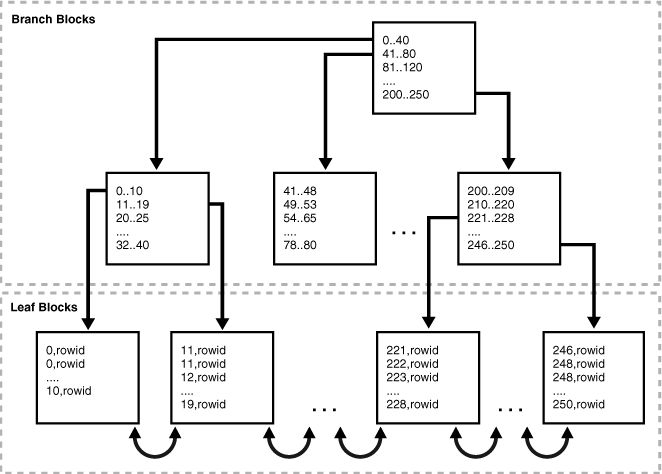
Die folgende Abbildung veranschaulicht die Struktur eines B*-Baumindex. Das Beispiel zeigt einen Index für die Spalte department_id, die eine Fremdschlüsselspalte in der Tabelle employees ist.
Abbildung 1: Interne Struktur eines B*-Baumindex
Beschreibung der Abbildung cncpt244.gif
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Verzweigungsblöcke und Blattblöcke Ein B*-Baumindex weist zwei Blocktypen auf: den Verzweigungsblock für die Suche und den Blattblock zum Speichern von Schlüsselwerten. Die Verzweigungsblöcke der oberen Ebene eines B*-Baumindex enthalten Indexdaten, die auf Indexblöcke der unteren Ebene verweisen.
-
Index-Scans In einem Index-Scan ruft die Datenbank eine Zeile ab, indem sie den Index mit den von der Anweisung angegebenen indizierten Spaltenwerten durchläuft. Wenn die Datenbank den Index nach einem Wert durchsucht, wird dieser Wert in n I/Os gefunden, wobei n die Höhe des B*-Baumindex ist. Dies ist das Grundprinzip hinter Oracle AI Database-Indizes.
-
Reverse-Key-Indizes Ein Reverse-Key-Index ist ein Typ von B*-Baumindex, der die Byte jedes Indexschlüssels physisch umkehrt, während die Spaltenreihenfolge beibehalten wird.
-
Aufsteigende und absteigende Indizes In einem aufsteigenden Index speichert Oracle AI Database Daten in aufsteigender Reihenfolge. Standardmäßig werden Zeichendaten nach Binärwerten sortiert, die in jedem Byte des Werts enthalten sind, numerische Daten von der kleinsten bis zur größten Zahl und das Datum vom frühesten bis zum letzten Wert.
-
Indexkomprimierung Um Speicherplatz in Indizes zu reduzieren, kann Oracle AI Database verschiedene Komprimierungsalgorithmen verwenden.
Filialblöcke und Blattblöcke
Ein B*-Baumindex weist zwei Blocktypen auf: den Verzweigungsblock für die Suche und den Blattblock zum Speichern von Schlüsselwerten. Die Verzweigungsblöcke der oberen Ebene eines B*-Baumindex enthalten Indexdaten, die auf Indexblöcke der unteren Ebene verweisen.
In Abbildung 5-1 weist der Root-Verzweigungsblock den Eintrag 0-40 auf, der auf den Block ganz links in der nächsten Verzweigungsebene zeigt. Dieser Verzweigungsblock enthält Einträge wie 0-10 und 11-19. Jeder dieser Einträge verweist auf einen Leaf-Block, der Schlüsselwerte enthält, die in den Bereich fallen.
Ein B*-Baumindex wird ausgeglichen, da alle Leaf-Blöcke automatisch in derselben Tiefe bleiben. Daher dauert das Abrufen eines beliebigen Datensatzes von einer beliebigen Stelle im Index ungefähr die gleiche Zeit. Die Höhe des Index ist die Anzahl der Blöcke, die erforderlich sind, um vom Root-Block zu einem Leaf-Block zu wechseln. Die Verzweigungsebene ist die Höhe minus 1. In Abbildung 5-1 hat der Index eine Höhe von 3 und eine Verzweigungsebene von 2.
Verzweigungsblöcke speichern das Mindestschlüsselpräfix, das erforderlich ist, um eine Verzweigungsentscheidung zwischen zwei Schlüsseln zu treffen. Mit dieser Technik kann die Datenbank so viele Daten wie möglich an jeden Verzweigungsblock anpassen. Die Verzweigungsblöcke enthalten einen Zeiger auf den untergeordneten Block, der den Schlüssel enthält. Die Anzahl der Schlüssel und Zeiger wird durch die Blockgröße begrenzt.
Die Leaf-Blöcke enthalten jeden indizierten Datenwert und eine entsprechende Zeilen-ID, mit der die tatsächliche Zeile gesucht wird. Jeder Eintrag ist sortiert nach (Schlüssel, Zeilen-ID). Innerhalb eines Leaf-Blocks werden ein Schlüssel und eine Rowid mit den entsprechenden Einträgen links und rechts verknüpft. Auch die Blöcke selbst sind doppelt miteinander verknüpft. In Abbildung 5-1 ist der Blattblock ganz links (0-10) mit dem zweiten Blattblock (11-19) verknüpft. Hinweis: Indizes in Spalten mit Zeichendaten basieren auf den Binärwerten der Zeichen im Datenbankzeichensatz.
Indexscans
In einem Index-Scan ruft die Datenbank eine Zeile ab, indem sie den Index durchläuft. Dabei werden die von der Anweisung angegebenen indizierten Spaltenwerte verwendet. Wenn die Datenbank den Index nach einem Wert durchsucht, wird dieser Wert in n I/Os gefunden, wobei n die Höhe des B*-Baumindex ist. Dies ist das Grundprinzip hinter Oracle AI Database-Indizes.
Wenn eine SQL-Anweisung nur auf indizierte Spalten zugreift, liest die Datenbank Werte direkt aus dem Index und nicht aus der Tabelle. Wenn die Anweisung zusätzlich zu den indizierten Spalten auf nicht indizierte Spalten zugreift, verwendet die Datenbank Zeilen-IDs, um die Zeilen in der Tabelle zu suchen. In der Regel ruft die Datenbank Tabellendaten ab, indem sie alternativ einen Indexblock und dann einen Tabellenblock liest.
-
Full Index Scan Bei einem Full Index Scan liest die Datenbank den gesamten Index in der Reihenfolge. Ein Full Index Scan ist verfügbar, wenn eine predicate-Klausel (
WHERE-Klausel) in der SQL-Anweisung eine Spalte im Index referenziert und unter Umständen kein Prädikat angegeben wird. Ein Full Scan kann die Sortierung eliminieren, da die Daten nach Indexschlüssel sortiert werden. -
Fast Full Index Scan Ein Fast Full Index Scan ist ein Full Index Scan, bei dem die Datenbank auf die Daten im Index selbst zugreift, ohne auf die Tabelle zuzugreifen, und die Datenbank die Indexblöcke in keiner bestimmten Reihenfolge liest.
-
Indexbereichs-Scan Ein Indexbereichs-Scan ist ein sortierter Scan eines Index, bei dem eine oder mehrere führende Spalten eines Index in Bedingungen angegeben sind und 0, 1 oder mehr Werte für einen Indexschlüssel möglich sind.
-
Eindeutiger Indexscan Im Gegensatz zu einem Indexbereichsscan muss für einen eindeutigen Indexscan entweder 0 oder 1 Zeilen-ID mit einem Indexschlüssel verknüpft sein.
-
Index Skip Scan Ein Index Skip Scan verwendet logische Teilindizes eines zusammengesetzten Index. Die Datenbank "überspringt" durch einen einzelnen Index, als würde sie separate Indizes durchsuchen.
-
Index-Clustering-Faktor Der Index-Clustering-Faktor misst die Zeilenreihenfolge in Bezug auf einen indizierten Wert, wie z.B. den Nachnamen des Mitarbeiters. Mit zunehmendem Ordnungsgrad nimmt der Clusterfaktor ab. Siehe auch: SQL-Tuning-Handbuch für Oracle AI Database für detaillierte Informationen zu Indexscans
Vollständiger Indexscan
Bei einem vollständigen Indexscan liest die Datenbank den gesamten Index in der richtigen Reihenfolge. Ein Full Index Scan ist verfügbar, wenn eine predicate-Klausel (WHERE-Klausel) in der SQL-Anweisung eine Spalte im Index referenziert und unter Umständen kein Prädikat angegeben wird. Ein Full Scan kann die Sortierung eliminieren, da die Daten nach Indexschlüssel sortiert werden.
Beispiel 5-1: Full Index Scan
Angenommen, eine Anwendung führt die folgende Abfrage aus:
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;
In diesem Beispiel sind department_id, last_name und salary ein zusammengesetzter Schlüssel in einem Index. Oracle AI Database führt einen vollständigen Scan des Index durch, liest ihn in sortierter Reihenfolge (nach Abteilungs-ID und Nachname sortiert) und filtert nach dem Gehaltsattribut. Auf diese Weise scannt die Datenbank eine Gruppe von Daten, die kleiner ist als die Tabelle employees, die mehr Spalten enthält als in der Abfrage enthalten sind, und vermeidet das Sortieren der Daten.
Der Full Scan konnte die Indexeinträge wie folgt lesen:
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
Schnelle vollständige Index-Scans
Ein Fast Full Index Scan ist ein Full Index Scan, bei dem die Datenbank auf die Daten im Index selbst zugreift, ohne auf die Tabelle zuzugreifen, und die Datenbank die Indexblöcke in keiner bestimmten Reihenfolge liest.
Fast Full Index Scans sind eine Alternative zu einem Full Table Scan, wenn beide der folgenden Bedingungen erfüllt sind:
-
Der Index muss alle für die Abfrage benötigten Spalten enthalten.
-
Eine Zeile, die alle Nullwerte enthält, darf nicht in der Abfrageergebnismenge angezeigt werden. Damit dieses Ergebnis garantiert werden kann, muss mindestens eine Spalte im Index über Folgendes verfügen:
-
NOT NULL-Constraint -
Ein auf die Spalte angewendetes Prädikat, das verhindert, dass Nullwerte in der Abfrageergebnismenge berücksichtigt werden
-
Beispiel 5-2: Fast Full Index Scan
Angenommen, eine Anwendung gibt die folgende Abfrage aus, die keine ORDER BY-Klausel enthält:
SELECT last_name, salary
FROM   employees;
Die Spalte last_name hat einen Constraint, der nicht Null ist. Wenn der Nachname und das Gehalt ein zusammengesetzter Schlüssel in einem Index sind, kann ein Fast Full Index Scan die Indexeinträge lesen, um die angeforderten Informationen zu erhalten:
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
Indexbereichsscan
Ein Indexbereichsscan ist ein geordneter Scan eines Index, bei dem eine oder mehrere führende Spalten eines Index in Bedingungen angegeben werden und 0, 1 oder mehr Werte für einen Indexschlüssel möglich sind.
Eine Bedingung gibt eine Kombination von einem oder mehreren Ausdrücken und logischen Operatoren (booleschen) an. Gibt den Wert TRUE, FALSE oder UNKNOWN zurück.
Die Datenbank verwendet häufig einen Index Range Scan, um auf selektive Daten zuzugreifen. Die Selektivität ist der Prozentsatz der Zeilen in der Tabelle, die von der Abfrage ausgewählt werden, wobei 0 keine Zeilen und 1 alle Zeilen bedeutet. Die Selektivität ist an ein Abfrage-Prädikat gebunden, z.B. WHERE last_name LIKE 'A%' oder eine Kombination von Prädikaten. Ein Prädikat wird selektiver, wenn sich der Wert 0 nähert, und weniger selektiv (oder unselektiver), wenn sich der Wert 1 nähert.
Beispiel: Ein Benutzer fragt Mitarbeiter ab, deren Nachnamen mit A beginnen. Angenommen, die Spalte last_name ist indexiert und enthält folgende Einträge:
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
Die Datenbank könnte einen Range Scan verwenden, da die Spalte last_name im Prädikat angegeben ist und mehrere RowIDs für jeden Indexschlüssel möglich sind. Beispiel: Zwei Mitarbeiter heißen Austin, sodass dem Schlüssel Austin zwei ROWIDs zugeordnet sind.
Ein Index Range Scan kann auf beiden Seiten begrenzt werden, wie in einer Abfrage für Abteilungen mit IDs zwischen 10 und 40, oder auf nur einer Seite begrenzt werden, wie in einer Abfrage für IDs über 40. Um den Index zu scannen, wird die Datenbank rückwärts oder vorwärts durch die Leaf-Blöcke verschoben. Beispiel: Ein Scan nach IDs zwischen 10 und 40 lokalisiert den ersten Index-Leaf-Block, der den niedrigsten Schlüsselwert enthält, der 10 oder höher ist. Der Scan verläuft dann horizontal durch die verknüpfte Liste der Blattknoten, bis ein Wert größer als 40 gefunden wird.
Eindeutiger Indexscan
Im Gegensatz zu einem Indexbereichsscan muss einem eindeutigen Indexscan entweder 0 oder 1 Zeilen-ID mit einem Indexschlüssel verknüpft sein.
Die Datenbank führt einen eindeutigen Scan aus, wenn ein Prädikat alle Spalten im Schlüssel eines UNIQUE-Index mit einem Gleichheitsoperator referenziert. Ein eindeutiger Indexscan stoppt die Verarbeitung, sobald der erste Datensatz gefunden wird, da kein zweiter Datensatz möglich ist.
Angenommen, ein Benutzer führt die folgende Abfrage aus:
SELECT *
FROM   employees
WHERE  employee_id = 5;
Angenommen, die Spalte employee_id ist der Primärschlüssel und wird wie folgt mit Einträgen indiziert:
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
In diesem Fall kann die Datenbank einen eindeutigen Indexscan verwenden, um die Zeilen-ID für den Mitarbeiter mit der Personalnummer 5 zu ermitteln.
Index - Scan überspringen
Ein Index-Skip-Scan verwendet logische Teilindizes eines zusammengesetzten Index. Die Datenbank "überspringt" durch einen einzelnen Index, als würde sie separate Indizes durchsuchen.
Das Überspringen von Scans ist von Vorteil, wenn in der führenden Spalte eines zusammengesetzten Index nur wenige eindeutige Werte und im nicht führenden Schlüssel des Index viele eindeutige Werte vorhanden sind. Die Datenbank kann einen Index Skip Scan wählen, wenn die führende Spalte des zusammengesetzten Index nicht in einem Abfrageprädikat angegeben ist.
Beispiel 5-3: Scan eines zusammengesetzten Index überspringen
Angenommen, Sie führen die folgende Abfrage für einen Kunden in der Tabelle sh.customers aus:
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';Die Tabelle customers enthält die Spalte cust_gender, deren Werte entweder M oder F lauten. Angenommen, für die Spalten ist ein zusammengesetzter Index vorhanden (cust_gender, cust_email). Das folgende Beispiel zeigt einen Teil der Indexeinträge:
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowid
Die Datenbank kann einen Skip Scan dieses Index verwenden, obwohl cust_gender nicht in der WHERE-Klausel angegeben ist.
Bei einem Skip Scan wird die Anzahl der logischen Subindizes durch die Anzahl der eindeutigen Werte in der führenden Spalte bestimmt. Im vorherigen Beispiel weist die führende Spalte zwei mögliche Werte auf. Die Datenbank teilt den Index logisch in einen Subindex mit dem Schlüssel F und einen zweiten Subindex mit dem Schlüssel M auf.
Bei der Suche nach dem Datensatz für den Kunden, dessen E-Mail-Adresse Abbey@company.example.com lautet, durchsucht die Datenbank zuerst den Subindex mit dem Wert F und dann den Subindex mit dem Wert M. Die Datenbank verarbeitet die Abfrage konzeptionell wie folgt:
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
  AND cust_email = 'Abbey@company.example.com';
Siehe auch: Oracle AI Database SQL Tuning Guide, um mehr über Skip Scans zu erfahren
Index-Clustering-Faktor
Der Index-Clustering-Faktor misst die Zeilenreihenfolge in Bezug auf einen indizierten Wert, wie z.B. den Nachnamen des Mitarbeiters. Mit zunehmendem Ordnungsgrad nimmt der Clusterfaktor ab.
Der Clustering-Faktor eignet sich als grobes Maß für die Anzahl der I/Os, die zum Lesen einer gesamten Tabelle mit einem Index erforderlich sind:
-
Wenn der Clustering-Faktor hoch ist, führt Oracle AI Database bei einem Scan mit großem Indexbereich eine relativ hohe Anzahl von I/Os aus. Die Indexeinträge verweisen auf zufällige Tabellenblöcke, so dass die Datenbank möglicherweise immer wieder dieselben Blöcke lesen und erneut lesen muss, um die vom Index referenzierten Daten abzurufen.
-
Wenn der Clustering-Faktor niedrig ist, führt Oracle AI Database bei einem Scan mit großem Indexbereich eine relativ geringe Anzahl von I/Os aus. Die Indexschlüssel in einem Bereich zeigen in der Regel auf denselben Datenblock, sodass die Datenbank nicht immer dieselben Blöcke lesen und erneut lesen muss.
Der Clusterfaktor ist für Index-Scans relevant, da er Folgendes anzeigen kann:
-
Gibt an, ob die Datenbank einen Index für Scans mit großem Bereich verwendet
-
Der Grad der Tabellenorganisation in Bezug auf den Indexschlüssel
-
Ob Sie die Verwendung einer indexorganisierten Tabelle, Partitionierung oder eines Tabellenclusters in Betracht ziehen sollten, wenn Zeilen nach dem Indexschlüssel sortiert werden müssen
Beispiel 5-4: Clusteringfaktor
Angenommen, die Tabelle employees passt in zwei Datenblöcke. In Tabelle 5-3 werden die Zeilen in den beiden Datenblöcken dargestellt (die Auslassungspunkte geben Daten an, die nicht angezeigt werden).
Tabelle 3: Inhalt von zwei Datenblöcken in der Mitarbeitertabelle
| Datenblock 1 | Datenblock 2 |
|---|---|
|
|
Zeilen werden in den Blöcken in der Reihenfolge des Nachnamens (fett dargestellt) gespeichert. Beispiel: Die untere Zeile in Datenblock 1 beschreibt Abel, die nächste Zeile nach oben beschreibt Ande usw. alphabetisch bis zur oberen Zeile in Block 1 für Steven King. Die untere Zeile in Block 2 beschreibt Kochar, die nächste Zeile nach oben beschreibt Kumar und so weiter alphabetisch bis zur letzten Zeile im Block für Zlotkey.
Angenommen, für die Nachnamensspalte ist ein Index vorhanden. Jeder Namenseintrag entspricht einer Zeilen-ID. Die Indexeinträge sehen konzeptionell wie folgt aus:
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
Angenommen, in der Spalte für die Personalnummer ist ein eigener Index vorhanden. Die Indexeinträge können konzeptionell wie folgt aussehen, wobei die Personalnummern an fast zufälligen Stellen in den beiden Blöcken verteilt sind:
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
Die folgende Anweisung fragt die View ALL_INDEXES für den Clustering-Faktor für diese beiden Indizes ab:
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX                          2
Der Clustering-Faktor für EMP_NAME_IX ist niedrig. Das bedeutet, dass benachbarte Indexeinträge in einem einzelnen Leaf-Block tendenziell auf Zeilen in denselben Datenblöcken zeigen. Der Clustering-Faktor für EMP_EMP_ID_PK ist hoch. Das bedeutet, dass benachbarte Indexeinträge im selben Leaf-Block viel seltener auf Zeilen in denselben Datenblöcken verweisen.
Siehe auch: Oracle AI Database Reference, um mehr über ALL_INDEXES zu erfahren
Reverse-Key-Indizes
Ein Reverse-Key-Index ist ein Typ des B*-Baumindex, der die Byte jedes Indexschlüssels physisch umkehrt, während die Spaltenreihenfolge beibehalten wird.
Beispiel: Wenn der Indexschlüssel 20 ist und die beiden für diesen Schlüssel in Hexadezimalgröße gespeicherten Byte C1,15 in einem Standard-B*-Baumindex sind, speichert ein Reverse Key-Index die Byte als 15,C1.
Durch Umkehren der Taste wird das Problem der Zugriffskonflikte für Leaf-Blöcke auf der rechten Seite eines B*-Baumindex gelöst. Dieses Problem kann in einer Oracle Real Application Clusters-(Oracle RAC-)Datenbank besonders akut sein, in der mehrere Instanzen wiederholt denselben Block ändern. Beispiel: In einer Tabelle orders sind die Primärschlüssel für Aufträge sequenziell. Eine Instanz im Cluster fügt die Reihenfolge 20 hinzu, während eine andere 21 hinzufügt, wobei jede Instanz ihren Schlüssel in denselben Leaf-Block auf der rechten Seite des Index schreibt.
Bei einem Reverse Key-Index verteilt die Umkehrung der Byte-Reihenfolge Einfügungen auf alle Leaf-Schlüssel im Index. Beispielsweise werden Schlüssel wie 20 und 21, die in einem Standardschlüsselindex benachbart gewesen wären, jetzt weit auseinander in separaten Blöcken gespeichert. Somit ist I/O für das Einfügen von sequenziellen Schlüsseln gleichmäßiger verteilt.
Da die Daten im Index beim Speichern nicht nach Spaltenschlüssel sortiert werden, entfällt die Möglichkeit, in einigen Fällen eine Indexbereichs-Scanabfrage auszuführen. Beispiel: Wenn ein Benutzer eine Abfrage für Bestell-IDs größer als 20 ausgibt, kann die Datenbank nicht mit dem Block beginnen, der diese ID enthält, und horizontal durch die Leaf-Blöcke fortfahren.
Aufsteigend und absteigend Indizes
In einem aufsteigenden Index speichert Oracle AI Database Daten in aufsteigender Reihenfolge. Standardmäßig werden Zeichendaten nach Binärwerten sortiert, die in jedem Byte des Werts enthalten sind, numerische Daten von der kleinsten bis zur größten Zahl und das Datum vom frühesten bis zum letzten Wert.
Ein Beispiel für einen aufsteigenden Index ist die folgende SQL-Anweisung:
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);Oracle AI Database sortiert die Tabelle hr.employees in der Spalte department_id. Der aufsteigende Index wird mit department_id und den entsprechenden Zeilen-ID-Werten in aufsteigender Reihenfolge geladen, beginnend mit 0. Wenn der Index verwendet wird, durchsucht Oracle AI Database die sortierten department_id-Werte und verwendet die zugehörigen Zeilen-IDs, um Zeilen mit dem angeforderten department_id-Wert zu suchen.
Wenn Sie das Schlüsselwort DESC in der CREATE INDEX-Anweisung angeben, können Sie einen absteigenden Index erstellen. In diesem Fall speichert der Index Daten in einer oder mehreren angegebenen Spalten in absteigender Reihenfolge. Wenn der Index in Tabelle 5-3 in der Spalte employees.department_id absteigend ist, befindet sich das Leaf-Blocking mit 250 auf der linken Seite des Baums und des Blocks mit 0 auf der rechten Seite. Die Standardsuche durch einen absteigenden Index erfolgt vom höchsten zum niedrigsten Wert.
Absteigende Indizes sind nützlich, wenn eine Abfrage einige Spalten aufsteigend und andere absteigend sortiert. Angenommen, Sie erstellen einen zusammengesetzten Index für die Spalten last_name und department_id wie folgt:
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);Wenn ein Benutzer hr.employees nach Nachnamen in aufsteigender Reihenfolge (A bis Z) und Abteilungs-IDs in absteigender Reihenfolge (hoch bis niedrig) abfragt, kann die Datenbank diesen Index verwenden, um die Daten abzurufen und den zusätzlichen Sortierschritt zu vermeiden.
Siehe:
-
Oracle AI Database SQL Tuning Guide, um mehr über auf- und absteigende Indexsuchen zu erfahren
-
Oracle AI Database SQL Language Reference für Beschreibungen der Optionen
ASCundDESCvonCREATE INDEX
Indexkomprimierung
Um Speicherplatz in Indizes zu reduzieren, kann Oracle AI Database verschiedene Komprimierungsalgorithmen verwenden.
-
Präfixkomprimierung Oracle AI Database kann Präfixkomprimierung, auch als Schlüsselkomprimierung bezeichnet, verwenden, um Teile der Primärschlüsselspaltenwerte in einem B*-Baumindex oder einer indexorganisierten Tabelle zu komprimieren. Die Präfixkomprimierung kann den vom Index belegten Speicherplatz erheblich reduzieren.
-
Erweiterte Indexkomprimierung Ab Oracle Database 12c Release 1 (12.1.0.2) verbessert die erweiterte Indexkomprimierung die herkömmliche Präfixkomprimierung für unterstützte Indizes in Heap-organisierten Tabellen.
Präfixkomprimierung
Oracle AI Database kann die Präfixkomprimierung, auch als Schlüsselkomprimierung bezeichnet, verwenden, um Teile der Primärschlüsselspaltenwerte in einem B*-Baumindex oder einer indexorganisierten Tabelle zu komprimieren. Die Präfixkomprimierung kann den vom Index belegten Speicherplatz erheblich reduzieren.
Ein unkomprimierter Indexeintrag hat ein Stück. Ein Indexeintrag mit Präfixkomprimierung besteht aus zwei Teilen: einem Präfixeintrag, der das Gruppierungselement ist, und einem Suffixeintrag, der das eindeutige oder nahezu eindeutige Element ist. Die Datenbank erreicht Komprimierung, indem sie die Präfixeinträge unter den Suffixeinträgen in einem Indexblock gemeinsam verwendet. Hinweis: Wenn für einen Schlüssel kein eindeutiges Stück definiert ist, stellt die Datenbank eines bereit, indem eine Zeilen-ID an das Gruppierungsstück angehängt wird.
Standardmäßig besteht das Präfix eines eindeutigen Index aus allen Schlüsselspalten außer der letzten, während das Präfix eines nicht eindeutigen Index aus allen Schlüsselspalten besteht. Angenommen, Sie erstellen einen zusammengesetzten, eindeutigen Index für zwei Spalten der Tabelle oe.orders wie folgt:
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Im vorherigen Beispiel könnte ein Indexschlüssel online,0 sein. Die ROWID wird im Schlüsseldatenteil des Eintrags gespeichert und gehört nicht zum Schlüssel selbst.
Hinweis: Wenn Sie einen eindeutigen Index für eine einzelne Spalte erstellen, kann Oracle AI Database keine Präfixschlüsselkomprimierung verwenden, da keine gemeinsamen Präfixe vorhanden sind.
Angenommen, Sie erstellen einen nicht eindeutigen Index für dieselben Spalten:
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Gehen Sie auch davon aus, dass sich wiederholende Werte in den Spalten order_mode und order_status befinden. Ein Indexblock kann Einträge enthalten, wie im folgenden Beispiel gezeigt:
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
Im vorherigen Beispiel würde das Schlüsselpräfix aus einer Verkettung der Werte order_mode und order_status bestehen, wie in online,0. Das Suffix besteht in der Zeilen-ID, wie in AAAPvCAAFAAAAFaAAa. Die ROWID macht den gesamten Indexeintrag eindeutig, da eine ROWID selbst in der Datenbank eindeutig ist.
Wenn der Index im vorherigen Beispiel mit der Standardpräfixkomprimierung (angegeben durch das Schlüsselwort COMPRESS) erstellt wurde, werden doppelte Schlüsselpräfixe wie online,0 und online,3 komprimiert. Konzeptionell erreicht die Datenbank die Komprimierung wie folgt:
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
Suffixeinträge (die ROWIDs) bilden die komprimierte Version von Indexzeilen. Jeder Suffixeintrag referenziert einen Präfixeintrag, der im selben Indexblock wie das Suffix gespeichert ist.
Alternativ können Sie eine Präfixlänge angeben, wenn Sie einen Index erstellen, der Präfixkomprimierung verwendet. Beispiel: Wenn Sie COMPRESS 1 angegeben haben, lautet das Präfix order_mode, und das Suffix lautet order_status,rowid. Für die Werte im Beispiel für einen Indexblock würde der Index doppelte Vorkommen des Präfixes online ausgleichen, das konzeptionell wie folgt dargestellt werden kann:
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
Der Index speichert höchstens einmal pro Blattblock ein bestimmtes Präfix. Nur Schlüssel in den Leaf-Blöcken eines B*-Baumindex werden komprimiert. In den Verzweigungsblöcken kann das Schlüsselsuffix abgeschnitten werden, der Schlüssel wird jedoch nicht komprimiert.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie komprimierte Indizes verwendet werden
-
Oracle AI Database VLDB and Partitioning Guide enthält Informationen zur Verwendung der Präfixkomprimierung für partitionierte Indizes
-
Oracle AI Database SQL Language Reference für Beschreibungen der key_compression-Klausel von
CREATE INDEX
Erweiterte Indexkomprimierung
Ab Oracle Database 12c Release 1 (12.1.0.2) verbessert sich die erweiterte Indexkomprimierung bei der herkömmlichen Präfixkomprimierung für unterstützte Indizes in Heap-organisierten Tabellen.
Vorteile der erweiterten Indexkomprimierung
Die Präfixkomprimierung weist Einschränkungen für unterstützte Indextypen, Komprimierungsverhältnis und Benutzerfreundlichkeit auf. Im Gegensatz zur Präfixkomprimierung, bei der für jeden Block eine feste Eliminierung doppelter Schlüssel verwendet wird, verwendet die erweiterte Indexkomprimierung eine adaptive Eliminierung doppelter Schlüssel pro Block. Die Hauptvorteile der erweiterten Indexkomprimierung sind:
-
Die Datenbank wählt automatisch die beste Komprimierung für jeden Block. Dabei werden eine Reihe interner Algorithmen verwendet, wie Präfixe auf Spaltenebene, Eliminierung doppelter Schlüssel und Komprimierung von Zeilenkennungen. Im Gegensatz zur Präfixkomprimierung erfordert die erweiterte Indexkomprimierung nicht, dass der Benutzer Dateneigenschaften kennt.
-
Die erweiterte Komprimierung funktioniert sowohl für nicht eindeutige und eindeutige Indizes. Die Präfixkomprimierung funktioniert bei einigen nicht eindeutigen Indizes gut, aber die Verhältnisse sind bei Indizes niedriger, deren führende Spalten nicht viele Wiederholungen aufweisen.
-
Der komprimierte Index kann wie ein unkomprimierter Index verwendet werden. Der Index unterstützt dieselben Zugriffspfade: eindeutige Schlüssel-Lookups, Range Scans und schnelle Full Scans.
-
Indizes können die erweiterte Komprimierung von einer übergeordneten Tabelle erben oder einen Tablespace enthalten.
-
Index-organisierte Tabellen und funktionsbasierte Indizes unterstützen die erweiterte Indexkomprimierung. Index-organisierte Tabellen unterstützen niedrige Komprimierung. Funktionsbasierte Indizes unterstützen sowohl niedrige als auch hohe Komprimierung.
Funktionsweise der erweiterten Indexkomprimierung
Die erweiterte Indexkomprimierung funktioniert auf Blockebene, um die beste Komprimierung für jeden Block bereitzustellen. Die Datenbank verwendet die folgende Technik:
-
Wenn ein Leaf-Block bei der Indexerstellung voll wird, komprimiert die Datenbank den Block automatisch auf die optimale Ebene.
-
Wenn bei der Reorganisation eines Indexblocks als Ergebnis von DML ausreichend Speicherplatz für den eingehenden Indexeintrag erstellt werden kann, erfolgt keine Blockaufteilung. Bei DML ohne erweiterte Indexkomprimierung tritt jedoch immer eine Indexblockaufteilung auf, wenn der Block voll wird.
Erweiterte Indexkomprimierung HIGH
In Releases vor Oracle Database 12c Release 2 (12.2) war die einzige Form der erweiterten Indexkomprimierung eine niedrige Komprimierung (COMPRESS ADVANCED LOW). Jetzt können Sie auch die hohe Komprimierung (COMPRESS ADVANCED HIGH) angeben, die Standardeinstellung. Die erweiterte Indexkomprimierung mit der Option HIGH bietet die folgenden Vorteile:
-
Höhere Komprimierungsverhältnisse in den meisten Fällen bei gleichzeitiger Verbesserung der Performance für Abfragen, die auf den Index zugreifen
-
Verwendet komplexere Komprimierungsalgorithmen als Advanced Low
-
Speichert Daten in einer Komprimierungseinheit. Dies ist ein spezielles Festplattenformat. Hinweis: Wenn Sie die Komprimierung
HIGHanwenden, werden alle Blöcke komprimiert. Wenn Sie dieLOW-Komprimierung anwenden, kann die Datenbank einige Blöcke dekomprimieren. Mit Statistiken können Sie bestimmen, wie viele Blöcke nicht komprimiert wurden.
Beispiel 5-5: Index mit erweiterter hoher Komprimierung erstellen
In diesem Beispiel wird die erweiterte Indexkomprimierung für einen Index in der Tabelle hr.employees aktiviert:
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
Die folgende Abfrage zeigt den Komprimierungstyp an:
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie die erweiterte Indexkomprimierung aktivieren
-
Oracle AI Database SQL Language Reference für Beschreibungen der key_compression-Klausel von
CREATE INDEX -
Oracle AI Database Reference, um mehr über
ALL_INDEXESzu erfahren
Überblick über Bitmap-Indizes
In einem Bitmapindex speichert die Datenbank eine Bitmap für jeden Indexschlüssel. In einem herkömmlichen B*-Baumindex verweist ein Indexeintrag auf eine einzelne Zeile. In einem Bitmap-Index speichert jeder Indexschlüssel Zeiger auf mehrere Zeilen.
Bitmap-Indizes sind hauptsächlich für Data Warehousing oder Umgebungen konzipiert, in denen Abfragen viele Spalten ad hoc referenzieren. Zu den Situationen, die einen Bitmap-Index erfordern können, gehören:
-
Die indizierten Spalten haben eine niedrige Kardinalität, d.h. die Anzahl der eindeutigen Werte ist im Vergleich zur Anzahl der Tabellenzeilen gering.
-
Die indizierte Tabelle ist entweder schreibgeschützt oder unterliegt keiner signifikanten Änderung durch DML-Anweisungen.
Bei einem Data Warehouse-Beispiel enthält die Tabelle sh.customers eine Spalte cust_gender mit nur zwei möglichen Werten: M und F. Angenommen, Abfragen für die Anzahl der Kunden eines bestimmten Geschlechts sind häufig. In diesem Fall wäre die Spalte customers.cust_gender ein Kandidat für einen Bitmapindex.
Jedes Bit in der Bitmap entspricht einer möglichen Rowid. Wenn das Bit gesetzt ist, enthält die Zeile mit der entsprechenden Zeilen-ID den Schlüsselwert. Eine Mapping-Funktion konvertiert die Bit-Position in eine tatsächliche Rowid, sodass der Bitmap-Index die gleiche Funktionalität wie ein B*-Baumindex bietet, obwohl er eine andere interne Darstellung verwendet.
Wenn die indizierte Spalte in einer einzelnen Zeile aktualisiert wird, sperrt die Datenbank den Indexschlüsseleintrag (z.B. M oder F) und nicht das einzelne Bit, das der aktualisierten Zeile zugeordnet ist. Da ein Schlüssel auf viele Zeilen verweist, sperrt DML für indizierte Daten in der Regel alle diese Zeilen. Aus diesem Grund eignen sich Bitmap-Indizes nicht für viele OLTP-Anwendungen.
-
Beispiel: Bitmapindizes für eine einzelne Tabelle In diesem Beispiel sind einige Spalten der Tabelle
sh.customersKandidaten für einen Bitmapindex. -
Bitmap Join-Indizes Ein Bitmap Join-Index ist ein Bitmapindex für den Join von zwei oder mehr Tabellen.
-
Bitmap-Speicherstruktur Oracle AI Database verwendet eine B*-Baumindexstruktur, um Bitmaps für jeden indizierten Schlüssel zu speichern.
Siehe:
-
SQL Tuning Guide für Oracle AI Database, um mehr über Bitmapindizes zu erfahren
-
Oracle AI Database Data Warehousing Guide mit Informationen zur Verwendung von Bitmap-Indizes in einem Data Warehouse
Beispiel: Bitmap-Indizes für eine einzelne Tabelle
In diesem Beispiel sind einige Spalten der Tabelle sh.customers Kandidaten für einen Bitmap-Index.
Beachten Sie die folgende Abfrage:
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
Die Spalten cust_marital_status und cust_gender weisen eine niedrige Kardinalität auf, cust_id und cust_last_name hingegen nicht. Daher können Bitmap-Indizes für cust_marital_status und cust_gender geeignet sein. Ein Bitmap-Index ist für die anderen Spalten wahrscheinlich nicht nützlich. Stattdessen würde ein eindeutiger B*-Baumindex für diese Spalten wahrscheinlich die effizienteste Darstellung und den effizientesten Abruf bieten. In Tabelle 5-4 ist der Bitmapindex für die im vorherigen Beispiel gezeigte Spaltenausgabe cust_gender dargestellt. Es besteht aus zwei separaten Bitmaps, eine für jedes Geschlecht.
Tabelle 4: Beispiel-Bitmap für eine Spalte
| Wert | Zeile 1 | Zeile 2 | Zeile 3 | Zeile 4 | Zeile 5 | Zeile 6 | Zeile 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
Eine Zuordnungsfunktion konvertiert jedes Bit in der Bitmap in eine Zeilen-ID der Tabelle customers. Jeder Bitwert hängt von den Werten der entsprechenden Zeile in der Tabelle ab. Beispiel: Die Bitmap für den Wert M enthält ein 1 als erstes Bit, da das Geschlecht in der ersten Zeile der Tabelle customers M lautet. Das Bitmap cust_gender='M' hat eine 0 für die Bits in den Zeilen 2, 6 und 7, da diese Zeilen nicht M als Wert enthalten.
Hinweis: Bitmap-Indizes können Schlüssel enthalten, die vollständig aus Nullwerten bestehen, im Gegensatz zu B*-Baumindizes. Das Indizieren von Nullwerten kann für einige SQL-Anweisungen nützlich sein, z.B. für Abfragen mit der Aggregatfunktion COUNT.
Ein Analyst, der demografische Trends der Kunden untersucht, kann fragen: "Wie viele unserer weiblichen Kunden sind single oder geschieden?" Diese Frage entspricht der folgenden SQL-Abfrage:
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
Bitmap-Indizes können diese Abfrage effizient verarbeiten, indem sie die Anzahl der 1-Werte in der resultierenden Bitmap zählen, wie in Tabelle 5-5 dargestellt. Um die Kunden zu identifizieren, die diese Kriterien erfüllen, kann Oracle AI Database die resultierende Bitmap für den Zugriff auf die Tabelle verwenden.
Tabelle 5: Beispiel-Bitmap für zwei Spalten
| Wert | Zeile 1 | Zeile 2 | Zeile 3 | Zeile 4 | Zeile 5 | Zeile 6 | Zeile 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single oder divorced und F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
Bei der Bitmap-Indexierung werden Indizes, die mehreren Bedingungen in einer WHERE-Klausel entsprechen, effizient zusammengeführt. Zeilen, die einige, aber nicht alle Bedingungen erfüllen, werden herausgefiltert, bevor auf die Tabelle selbst zugegriffen wird. Diese Technik verbessert die Reaktionszeit, oft dramatisch.
Bitmap Join-Indizes
Ein Bitmap Join-Index ist ein Bitmap-Index für den Join von zwei oder mehr Tabellen.
Für jeden Wert in einer Tabellenspalte speichert der Index die Zeilen-ID der entsprechenden Zeile in der indizierten Tabelle. Im Gegensatz dazu wird ein Standard-Bitmap-Index für eine einzelne Tabelle erstellt.
Ein Bitmap Join-Index ist ein effizientes Mittel, um das Datenvolumen zu reduzieren, das verknüpft werden muss, indem im Voraus Einschränkungen durchgeführt werden. Angenommen, Benutzer fragen häufig die Anzahl der Mitarbeiter mit einem bestimmten Jobtyp ab, wenn ein Bitmap Join-Index nützlich wäre. Eine typische Abfrage könnte wie folgt aussehen:
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
Die vorhergehende Abfrage würde normalerweise einen Index für jobs.job_title verwenden, um die Zeilen für Accountant und dann die Job-ID abzurufen, und einen Index für employees.job_id, um die übereinstimmenden Zeilen zu suchen. Um die Daten aus dem Index selbst und nicht aus einem Scan der Tabellen abzurufen, können Sie wie folgt einen Bitmap Join-Index erstellen:
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
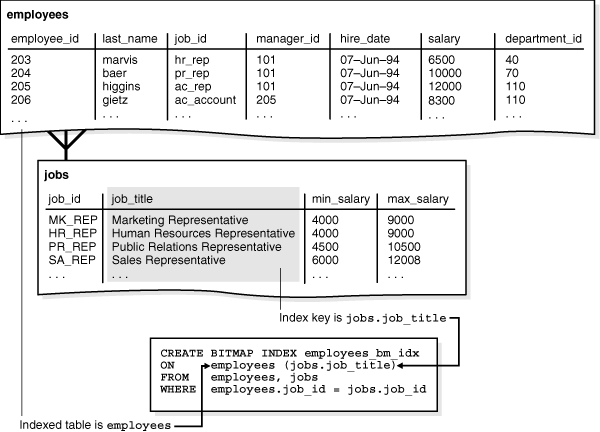
Wie in der folgenden Abbildung dargestellt, lautet der Indexschlüssel jobs.job_title und die indizierte Tabelle employees.
Abbildung 2: Bitmap Join-Index
Beschreibung der Abbildung cncpt239.gif
Im Allgemeinen ist employees_bm_idx ein Index der Spalte jobs.title in der SQL-Abfrage, die in der folgenden Abfrage angezeigt wird (Beispielausgabe enthalten). Der Schlüssel job_title im Index verweist auf Zeilen in der Tabelle employees. Eine Abfrage der Anzahl der Buchhalter kann den Index verwenden, um den Zugriff auf die Tabellen employees und jobs zu vermeiden, da der Index selbst die angeforderten Informationen enthält.
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.
In einem Data Warehouse ist die Join-Bedingung ein Equi Join (er verwendet den Gleichheitsoperator) zwischen den Primärschlüsselspalten der Dimensionstabellen und den Fremdschlüsselspalten in der Faktentabelle. Bitmap Join-Indizes sind im Speicher manchmal viel effizienter als Materialized Join-Views, eine Alternative zur vorab materialisierten Joins.
Siehe auch: Oracle AI Database Data Warehousing Guide für weitere Informationen zu Bitmap Join-Indizes
Bitmap-Speicherstruktur
Oracle AI Database verwendet eine B*-Baumindexstruktur, um Bitmaps für jeden indizierten Schlüssel zu speichern.
Beispiel: Wenn jobs.job_title die Schlüsselspalte eines Bitmap-Index ist, speichert ein B-Baum die Indexdaten. Die Blattblöcke speichern die einzelnen Bitmaps.
Beispiel 5-6: Bitmap-Speicher
Angenommen, die Spalte jobs.job_title enthält eindeutige Werte Shipping Clerk, Stock Clerk und einige andere. Ein Bitmap-Indexeintrag für diesen Index enthält die folgenden Komponenten:
-
Die Tätigkeit als Indexschlüssel
-
Ein niedriges Rowid und ein hohes Rowid für eine Reihe von Rowids
-
Bitmap für bestimmte ROWIDs im Bereich
Im Prinzip könnte ein Index-Leaf-Block in diesem Index Einträge wie folgt enthalten:
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
Die gleiche Tätigkeit wird in mehreren Einträgen angezeigt, da sich der Rowid-Bereich unterscheidet.
In einer Session wird die Job-ID eines Mitarbeiters von Shipping Clerk in Stock Clerk aktualisiert. In diesem Fall benötigt die Session exklusiven Zugriff auf den Indexschlüsseleintrag für den alten Wert (Shipping Clerk) und den neuen Wert (Stock Clerk). Oracle AI Database sperrt die Zeilen, auf die durch diese beiden Einträge verwiesen wird, jedoch nicht die Zeilen, auf die durch Accountant oder einen anderen Schlüssel verwiesen wird, bis UPDATE festgeschrieben wird.
Die Daten für einen Bitmap-Index werden in einem Segment gespeichert. Oracle AI Database speichert jede Bitmap in einem oder mehreren Teilen. Jedes Stück nimmt einen Teil eines einzelnen Datenblocks ein.
Siehe auch: "Benutzersegmente" erläutert die verschiedenen Segmenttypen und die Erstellung von Segmenten.
Überblick über funktionsbasierte Indizes
Ein funktionsbasierter Index berechnet den Wert einer Funktion oder eines Ausdrucks, der eine oder mehrere Spalten umfasst, und speichert ihn in einen Index. Ein funktionsbasierter Index kann entweder ein B*-Baum oder ein Bitmap-Index sein.
Die indizierte Funktion kann ein arithmetischer Ausdruck oder ein Ausdruck sein, der eine SQL-Funktion, eine benutzerdefinierte PL/SQL-Funktion, eine Packagefunktion oder einen C-Callout enthält. Beispiel: Eine Funktion kann die Werte in zwei Spalten hinzufügen.
-
Verwendungen von funktionsbasierten Indizes Funktionsbasierte Indizes sind effizient für die Auswertung von Anweisungen, die Funktionen in ihren
WHERE-Klauseln enthalten. Die Datenbank verwendet den funktionsbasierten Index nur, wenn die Funktion in einer Abfrage enthalten ist. Wenn die Datenbank die AnweisungenINSERTundUPDATEverarbeitet, muss sie jedoch die Funktion auswerten, um die Anweisung zu verarbeiten. -
Optimierung mit funktionsbasierten Indizes Bei Abfragen mit Ausdrücken in einer
WHERE-Klausel verwendet der Optimizer möglicherweise einen Index Range Scan für einen funktionsbasierten Index.
Siehe:
-
Oracle AI Database - Administratordokumentation zum Erstellen funktionsbasierter Indizes
-
Oracle AI Database Development Guide für weitere Informationen zur Verwendung funktionsbasierter Indizes
-
Oracle AI Database SQL Language Reference für Einschränkungen und Nutzungshinweise für funktionsbasierte Indizes
Verwendungen von funktionsbasierten Indizes
Funktionsbasierte Indizes sind effizient für die Auswertung von Anweisungen, die Funktionen in ihren WHERE-Klauseln enthalten. Die Datenbank verwendet den funktionsbasierten Index nur, wenn die Funktion in einer Abfrage enthalten ist. Wenn die Datenbank die Anweisungen INSERT und UPDATE verarbeitet, muss sie jedoch die Funktion auswerten, um die Anweisung zu verarbeiten.
Beispiel 5-7: Index basierend auf arithmetischem Ausdruck
Beispiel: Sie erstellen den folgenden funktionsbasierten Index:
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
Die Datenbank kann den vorherigen Index verwenden, wenn Abfragen wie die folgende verarbeitet werden (teilweise Beispielausgabe enthalten):
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
Beispiel 5-8: Index basierend auf einer UPPER-Funktion
Funktionsbasierte Indizes, die für die SQL-Funktionen UPPER(column_name) oder LOWER(column_name) definiert sind, erleichtern die Suche ohne Berücksichtigung der Groß-/Kleinschreibung. Beispiel: Angenommen, die Spalte first_name in employees enthält Zeichen in Groß- und Kleinschreibung. Sie erstellen den folgenden funktionsbasierten Index für die Tabelle hr.employees:
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
Der Index emp_fname_uppercase_idx kann Abfragen wie die folgenden erleichtern:
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
Beispiel 5-9: Spezifische Zeilen in einer Tabelle indizieren
Ein funktionsbasierter Index ist auch nützlich, um nur bestimmte Zeilen in einer Tabelle zu indizieren. Beispiel: Die Spalte cust_valid in der Tabelle sh.customers hat entweder I oder A als Wert. Um nur die A-Zeilen zu indexieren, können Sie eine Funktion schreiben, die einen Nullwert für alle anderen Zeilen als die A-Zeilen zurückgibt. Sie können den Index wie folgt erstellen:
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
Siehe:
-
Oracle AI Database Globalization Support Guide für Informationen zu linguistischen Indizes
-
Oracle AI Database SQL Language Reference, um mehr über SQL-Funktionen zu erfahren
Optimierung mit funktionsbasierten Indizes
Bei Abfragen mit Ausdrücken in einer WHERE-Klausel verwendet der Optimizer möglicherweise einen Index Range Scan für einen funktionsbasierten Index.
Der Bereichsscan-Zugriffspfad ist besonders dann von Vorteil, wenn das Prädikat sehr selektiv ist, d.h. wenn relativ wenige Zeilen ausgewählt werden. Wenn in Beispiel 5-7 ein Index für den Ausdruck 12*salary*commission_pct erstellt wird, kann der Optimizer einen Indexbereichsscan verwenden.
Eine virtuelle Spalte ist auch nützlich, um den Zugriff auf Daten zu beschleunigen, die aus Ausdrücken abgeleitet werden. Beispiel: Sie können die virtuelle Spalte annual_sal als 12*salary*commission_pct definieren und einen funktionsbasierten Index für annual_sal erstellen.
Der Optimizer führt einen Ausdrucksabgleich durch, indem er den Ausdruck in einer SQL-Anweisung analysiert und anschließend die Ausdrucksbäume der Anweisung und den funktionsbasierten Index vergleicht. Bei diesem Vergleich wird die Groß-/Kleinschreibung nicht beachtet. Leerzeichen werden ignoriert.
Verschiedene Abfragen können unterschiedliche Arten von Index-Scans verwenden.
Siehe:
-
Oracle AI Database SQL Tuning Guide, um mehr über das Sammeln von Statistiken zu erfahren
-
Oracle AI Database Administrator's Guide zum Hinzufügen virtueller Spalten zu einer Tabelle
Übersicht über Anwendungsdomänenindizes
Ein Anwendungsdomainindex ist ein angepasster Index für eine Anwendung.
Umfangreiche Indizierung kann:
-
Indizes für benutzerdefinierte, komplexe Datentypen wie Dokumente, räumliche Daten, Bilder und Videoclips berücksichtigen (siehe )
-
Spezialisierte Indizierungstechniken nutzen
Sie können anwendungsspezifische Indexverwaltungsroutinen als ein Indextyp-Schemaobjekt kapseln und dann einen Domainindex für Tabellenspalten oder Attribute eines Objekttyps definieren. Die erweiterbare Indexierung kann anwendungsspezifische Operatoren effizient verarbeiten.
Die Anwendungssoftware, die als Kassette bezeichnet wird, steuert die Struktur und den Inhalt eines Domainindex. Die Datenbank interagiert mit der Anwendung, um den Domainindex zu erstellen, zu verwalten und zu durchsuchen. Die Indexstruktur selbst kann in der Datenbank als indexorganisierte Tabelle oder extern als Datei gespeichert werden.
Siehe:
-
Oracle AI Database Development Guide, um mehr über komplexe Datentypen zu erfahren
-
Oracle AI Database Data Cartridge Developer's Guide für Informationen zur Verwendung von Datenkassetten in der Erweiterbarkeitsarchitektur von Oracle AI Database
Übersicht über skalare quantisierte HNSW-Indizes
Skalare quantisierte Hierarchical Navigable Small World-(HNSW-)Indizes können verwendet werden, um den Speicherbedarf zu reduzieren und die Ähnlichkeitssuche zu beschleunigen.
Im Kontext von Vektordatenbanken ist die skalare Quantisierung eine Methode zur Komprimierung oder Annäherung hochdimensionaler Datenvektoren, indem jede Dimension (oder skalare Komponente) des Vektors unabhängig quantifiziert wird. Dieser Ansatz wird verwendet, um die Speicheranforderungen einer Vektordatenbank zu reduzieren und gleichzeitig die wesentliche Struktur der Daten für Aufgaben wie die Ähnlichkeitssuche zu erhalten. Skalare Quantisierung kann besonders vorteilhaft sein, wenn Einfachheit und geringer Speicherbedarf hohe Priorität haben.
Hochdimensionale Vektoren, die als Gleitkommazahlen gespeichert werden, benötigen erheblichen Speicherplatz. Skalare Quantisierung spart Speicher durch Komprimieren der Vektoren. Beispielsweise benötigt ein 128-dimensionaler Vektor, der in 8 Bit (INT8) pro Dimension gespeichert ist, nur 128 Byte Speicher, während ein 32-Bit-Gleitkommaspeicher (Float32) 512 Byte und ein 64-Bit-Doppelspeicher (Float64) 1024 Byte erfordert. Aufgrund dieses reduzierten Speicherbedarfs kann die skalare Quantisierung es Vektordatenbanken ermöglichen, sehr große Datasets zu verarbeiten, die aus sogar Milliarden von Vektoren bestehen, was sonst aufgrund von Speicherbeschränkungen unpraktisch wäre.
Ein weiterer Vorteil der skalaren Quantisierung ist die verbesserte Suchgeschwindigkeit. Ungefähre Nearest Neighbor-(ANN-)Suchmethoden können quantisierte Daten für schnellere Vergleiche nutzen, da Operationen an Ganzzahlen oder Binärcodes schneller sind als Gleitkommaberechnungen.
Mit Oracle AI Database ist die einheitliche Skalarquantisierung die implementierte Komprimierungsmethode, d.h. der Eingabebereich wird in Intervalle gleicher Größe unterteilt. Jedes Intervall wird durch eine einzige Quantisierungsebene dargestellt, in der Regel seinen Mittelpunkt. Der Bereich jeder Dimension wird in 2b gleiche Intervalle unterteilt, wobei b die Anzahl der Bits ist (Beispiel: 8 Bit für int8). Jeder Float-Wert wird der nächsten Quantisierungsebene zugeordnet.
Siehe:
-
Oracle AI Database AI Vector Search - Benutzerhandbuch für HNSW-Indexsyntax und -parameter
-
Oracle AI Database SQL Language Reference für die
CREATE VECTOR INDEX-Anweisung
Überblick über Index-organisierte Tabellen
Eine indexorganisierte Tabelle ist eine Tabelle, die in einer Variation einer B*-Baumindexstruktur gespeichert ist. Im Gegensatz dazu fügt eine heap-organisierte Tabelle Zeilen dort ein, wo sie passen.
In einer indexorganisierten Tabelle werden Zeilen in einem Index gespeichert, der für den Primärschlüssel der Tabelle definiert ist. Jeder Indexeintrag im B-Baum speichert auch die Nicht-Schlüsselspaltenwerte. Daher ist der Index die Daten, und die Daten sind der Index. Anwendungen bearbeiten indexorganisierte Tabellen wie Heap-organisierte Tabellen mit SQL-Anweisungen.
Angenommen, ein Personalverwalter hat für eine Analogie zu einer indexorganisierten Tabelle einen Buchkasten mit Kartons. Jede Box ist mit einer Zahl-1, 2, 3, 4 usw. gekennzeichnet, aber die Boxen sitzen nicht in der Reihenfolge auf den Regalen. Stattdessen enthält jedes Feld einen Zeiger auf die Regalposition des nächsten Feldes in der Folge.
In jedem Feld werden Ordner gespeichert, die Mitarbeiter-Records enthalten. Die Ordner werden nach Personalnummer sortiert. Der König des Mitarbeiters hat die ID 100, die niedrigste ID. Daher befindet sich sein Ordner unten in Feld 1. Der Ordner für Mitarbeiter 101 ist auf 100, 102 auf 101 und so weiter, bis Feld 1 voll ist. Der nächste Ordner in der Sequenz befindet sich unten in Feld 2.
In dieser Analogie ermöglicht das Sortieren von Ordnern nach Personalnummer eine effiziente Suche nach Ordnern, ohne dass ein separater Index verwaltet werden muss. Angenommen, ein Benutzer fordert die Datensätze für die Mitarbeiter 107, 120 und 122 an. Anstatt einen Index in einem Schritt zu durchsuchen und die Ordner in einem separaten Schritt abzurufen, kann der Manager die Ordner in sequenzieller Reihenfolge durchsuchen und jeden Ordner wie gefunden abrufen.
Index-organisierte Tabellen ermöglichen einen schnelleren Zugriff auf Tabellenzeilen nach Primärschlüssel oder einem gültigen Präfix des Schlüssels. Das Vorhandensein von Nicht-Schlüsselspalten einer Zeile im Leaf-Block vermeidet ein zusätzliches Datenblock-I/O. Beispiel: Das Gehalt von Mitarbeiter 100 wird in der Indexzeile selbst gespeichert. Da Zeilen in Primärschlüsselreihenfolge gespeichert werden, sind für den Range-Zugriff durch den Primärschlüssel oder das Präfix minimale Block-I/Os erforderlich. Ein weiterer Vorteil ist die Vermeidung des Speicherplatz-Overheads eines separaten Primärschlüsselindex.
Index-organisierte Tabellen sind nützlich, wenn zusammengehörige Datenteile zusammen gespeichert werden müssen oder Daten physisch in einer bestimmten Reihenfolge gespeichert werden müssen. Ein typischer Verwendungstyp dieser Tabelle ist für den Informationsabruf, räumliche Daten und OLAP-Anwendungen.
-
Eigenschaften indexorganisierter Tabellen Das Datenbanksystem führt alle Vorgänge für indexorganisierte Tabellen durch, indem die B*-Baumindexstruktur bearbeitet wird.
-
Indexorganisierte Tabellen mit Zeilenüberlaufbereich Beim Erstellen einer indexorganisierten Tabelle können Sie ein separates Segment als Zeilenüberlaufbereich angeben.
-
Sekundäre Indizes auf indexorganisierten Tabellen Ein Sekundärer Index ist ein Index für eine indexorganisierte Tabelle.
Siehe:
-
Oracle Spatial Developer's Guide für einen Überblick über Oracle Spatial and Graph
-
Oracle AI Database Administrator's Guide zum Verwalten von indexorganisierten Tabellen
-
Oracle AI Database SQL Language Reference für
CREATE TABLE ... ORGANIZATION INDEX-Syntax und Semantik
Indexorganisierte Tabelleneigenschaften
Das Datenbanksystem führt alle Vorgänge für indexorganisierte Tabellen durch, indem es die B*-Baumindexstruktur bearbeitet.
In der folgenden Tabelle werden die Unterschiede zwischen indexorganisierten und Heap-organisierten Tabellen zusammengefasst.
Tabelle 6: Vergleich von Heap-organisierten Tabellen mit Index-organisierten Tabellen
| Heap-organisierte Tabelle | Indexorganisierte Tabelle |
|---|---|
| Die ROWID identifiziert eine Zeile eindeutig. Primärschlüssel-Constraint kann optional definiert werden. | Primärschlüssel kennzeichnet eine Zeile eindeutig. Primärschlüssel-Constraint muss definiert werden. |
Die physische Zeilen-ID in der ROWID-Pseudospalte ermöglicht das Erstellen sekundärer Indizes. |
Die logische ROWID in der Pseudospalte ROWID ermöglicht das Erstellen von sekundären Indizes. |
| Einzelne Zeilen können direkt über die Zeilen-ID aufgerufen werden. | Der Zugriff auf einzelne Zeilen kann indirekt über den Primärschlüssel erfolgen. |
| Der sequenzielle Full Table Scan gibt alle Zeilen in einer bestimmten Reihenfolge zurück. | Ein Full Index Scan oder Fast Full Index Scan gibt alle Zeilen in einer bestimmten Reihenfolge zurück. |
| Kann in einem Tabellencluster mit anderen Tabellen gespeichert werden. | Kann nicht in einem Tabellencluster gespeichert werden. |
Kann eine Spalte des Datentyps LONG und Spalten von LOB-Datentypen enthalten. |
Kann LOB-Spalten, aber keine LONG-Spalten enthalten. |
| Kann virtuelle Spalten enthalten (nur relationale Heap-Tabellen werden unterstützt). | Virtuelle Spalten können nicht enthalten sein. |
Index-organisierte Tabellen können mit der Advanced Low-Komprimierung komprimiert werden, indem die COMPRESS ADVANCED LOW-Klausel zur CREATE TABLE-Anweisung hinzugefügt wird. Advanced Low-Komprimierung ist eine adaptive Form der Präfixkomprimierung, die autonom die optimale Anzahl von Präfixspalten für jeden Leaf-Block berechnet, was zu einer optimalen Komprimierung auf Blockebene ohne Benutzereingriff führt. Dies schließt die Möglichkeit ein, gegebenenfalls überhaupt nicht zu komprimieren. Dies garantiert, dass eine negative Kompression nicht möglich ist. Größere Komprimierungsverhältnisse werden mit vernachlässigbarem Gesamtoverhead beobachtet.
Scans für indexorganisierte Tabellen können an Exadata Smart Scan ausgelagert werden, wo der Optimizer der Ansicht ist, dass die Abfrage als Fast Full Scan ausgeführt werden kann. Dies erfordert kein Eingreifen des Benutzers. Die vollständige Zellseitenverarbeitung wird für Index-organisierte Tabellen-Leaf-Blöcke unterstützt, in denen sich alle relevanten Spalten im Leaf-Block befinden. In Fällen, in denen sich einige Spalten im Überlaufsegment befinden, verarbeitet der Smart Scan solche Spalten nicht, und die Datenbank schließt den Scan ab. In Abbildung 5-3 wird die Struktur einer indexorganisierten departments-Tabelle dargestellt. Die Leaf-Blöcke enthalten die Tabellenzeilen, die sequenziell nach Primärschlüssel sortiert sind. Beispiel: Der erste Wert im ersten Leaf-Block enthält die Abteilungs-ID 20, den Abteilungsnamen Marketing, die Manager-ID 201 und die Standort-ID 1800.
Abbildung 3: Indexorganisierte Tabelle
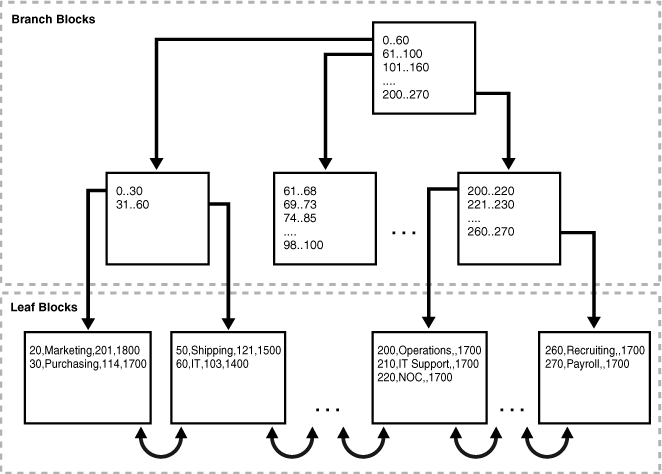
Beschreibung der Abbildung cncpt272.gif
Beispiel 5-10: Scan der indexorganisierten Tabelle
In einer indexorganisierten Tabelle werden alle Daten in derselben Struktur gespeichert. Die Zeilen-ID muss nicht gespeichert werden. Wie in Abbildung 5-3 dargestellt, kann Leaf Block 1 in einer indexorganisierten Tabelle Einträge wie folgt enthalten, sortiert nach Primärschlüssel:
20,Marketing,201,1800
30,Purchasing,114,1700
Blattblock 2 in einer indexorganisierten Tabelle kann folgende Einträge enthalten:
50,Shipping,121,1500
60,IT,103,1400
Bei einem Scan der Index-organisierten Tabellenzeilen in Primärschlüsselreihenfolge werden die Blöcke in der folgenden Reihenfolge gelesen:
-
Block 1
-
Block 2
Beispiel 5-11: Scannen der Heap-organisierten Tabelle
Angenommen, der Block 1 eines Heap-organisierten departments-Tabellensegments enthält Zeilen, um den Datenzugriff in einer Heap-organisierten Tabelle mit einer indexorganisierten Tabelle zu vergleichen:
50,Shipping,121,1500
20,Marketing,201,1800
Block 2 enthält Zeilen für dieselbe Tabelle wie folgt:
30,Purchasing,114,1700
60,IT,103,1400
Ein B*-Baumindex-Leaf-Block für diese Heap-organisierte Tabelle enthält die folgenden Einträge, wobei der erste Wert der Primärschlüssel und der zweite die ROWID ist:
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
Bei einem Scan der Tabellenzeilen in Primärschlüsselreihenfolge werden die Tabellensegmentblöcke in der folgenden Reihenfolge gelesen:
-
Block 1
-
Block 2
-
Block 1
-
Block 2
Somit ist die Anzahl der Block-I/Os in diesem Beispiel doppelt so hoch wie im indexorganisierten Beispiel.
Siehe:
Weitere Informationen zu Heap-organisierten Tabellen
um mehr über die Beziehung zwischen Segmenten und Datenblöcken zu erfahren
Index-organisierte Tabellen mit Zeilenüberlaufbereich
Beim Erstellen einer indexorganisierten Tabelle können Sie ein separates Segment als Zeilenüberlaufbereich angeben.
In indexorganisierten Tabellen können B*-Baumindexeinträge groß sein, da sie eine ganze Zeile enthalten. Daher ist ein separates Segment nützlich, das die Einträge enthält. Im Gegensatz dazu sind B*-Baumeinträge in der Regel klein, da sie aus Schlüssel und Rowid bestehen.
Wenn ein Zeilenüberlaufbereich angegeben wird, kann die Datenbank eine Zeile in einer indexorganisierten Tabelle in die folgenden Teile aufteilen:
-
Der Indexeintrag
Dieser Teil enthält Spaltenwerte für alle Primärschlüsselspalten, eine physische Zeilen-ID, die auf den Überlaufteil der Zeile verweist, und optional einige der Nicht-Schlüsselspalten. Dieser Teil wird im Indexsegment gespeichert.
-
Der Überlaufteil
Dieser Teil enthält Spaltenwerte für die restlichen Nicht-Schlüsselspalten. Dieses Teil wird im Überlaufspeicherbereichssegment gespeichert.
Siehe:
-
Oracle AI Database Administrator's Guide, in dem beschrieben wird, wie Sie mit der
OVERFLOW-Klausel vonCREATE TABLEeinen Zeilenüberlaufbereich festlegen -
Oracle AI Database SQL Language Reference für
CREATE TABLE ... OVERFLOW-Syntax und Semantik
Sekundäre Indizes für indexorganisierte Tabellen
Ein sekundärer Index ist ein Index für eine indexorganisierte Tabelle.
In gewisser Weise ist ein sekundärer Index ein Index für einen Index. Es handelt sich um ein unabhängiges Schemaobjekt, das separat von der indexorganisierten Tabelle gespeichert wird.
Oracle AI Database verwendet Zeilen-IDs, die als logische Zeilen-IDs für indexorganisierte Tabellen bezeichnet werden. Eine logische Rowid ist eine base64-codierte Darstellung des Tabellenprimärschlüssels. Die Länge der logischen Zeilen-ID hängt von der Länge des Primärschlüssels ab.
Zeilen in Index-Leaf-Blöcken können aufgrund von Einfügungen innerhalb oder zwischen Blöcken verschoben werden. Zeilen in indexorganisierten Tabellen werden nicht wie Heap-organisierte Zeilen migriert. Da Zeilen in indexorganisierten Tabellen keine permanenten physischen Adressen aufweisen, verwendet die Datenbank logische ROWIDs auf Basis des Primärschlüssels.
Beispiel: Angenommen, die Tabelle departments ist indexorganisiert. In der Spalte location_id wird die ID jeder Abteilung gespeichert. In der Tabelle werden Zeilen wie folgt gespeichert, wobei der letzte Wert die Standortkennung ist:
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
Ein sekundärer Index für die Spalte location_id kann wie folgt Indexeinträge enthalten, wobei der Wert nach dem Komma die logische Zeilen-ID ist:
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
Sekundäre Indizes bieten schnellen und effizienten Zugriff auf indexorganisierte Tabellen mit Spalten, die weder der Primärschlüssel noch ein Präfix des Primärschlüssels sind. Beispiel: Eine Abfrage der Namen von Abteilungen, deren ID größer als 1700 ist, könnte den sekundären Index verwenden, um den Datenzugriff zu beschleunigen.
-
Logische Rowids und physische Guesses Sekundäre Indizes verwenden logische Rowids, um Tabellenzeilen zu suchen.
-
Bitmapindizes für indexorganisierte Tabellen Ein sekundärer Index für eine indexorganisierte Tabelle kann ein Bitmapindex sein. Ein Bitmap-Index speichert ein Bitmap für jeden Indexschlüssel.
Siehe:
-
"Rowid-Datentypen", um mehr über die Verwendung von Rowids und die Pseudospalte
ROWIDzu erfahren -
"Chained und Migrated Rows", um zu erfahren, warum Zeilen migriert werden und warum die Anzahl der I/Os durch die Migration erhöht wird
-
Oracle AI Database Administrator's Guide zum Erstellen sekundärer Indizes für eine indexorganisierte Tabelle
-
Oracle AI Database VLDB and Partitioning Guide mit Informationen zum Erstellen von sekundären Indizes für indexierte-organisierte Tabellenpartitionen
Logische Rowids und physische Guess
Sekundäre Indizes verwenden logische ROWIDs, um Tabellenzeilen zu suchen.
Eine logische Rowid enthält eine physische Vermutung, die physische Rowid des Indexeintrags, als er zum ersten Mal erstellt wurde. Oracle AI Database kann physische Vermutungen verwenden, um direkt in den Leaf-Block der indexorganisierten Tabelle zu untersuchen, wobei die Primärschlüsselsuche umgangen wird. Wenn sich die physische Position einer Zeile ändert, bleibt die logische Zeilen-ID gültig, auch wenn sie eine veraltete physische Vermutung enthält.
Bei einer Heap-organisierten Tabelle umfasst der Zugriff durch einen sekundären Index einen Scan des sekundären Index und ein zusätzliches I/O zum Abrufen des Datenblocks, der die Zeile enthält. Bei indexorganisierten Tabellen variiert der Zugriff nach einem sekundären Index, je nach Verwendung und Genauigkeit physischer Vermutungen:
-
Ohne physische Vermutungen umfasst der Zugriff zwei Indexscans: einen Scan des sekundären Index, gefolgt von einem Scan des Primärschlüsselindex.
-
Bei physischen Vermutungen hängt der Zugriff von ihrer Genauigkeit ab:
-
Bei genauen physischen Vermutungen umfasst der Zugriff einen sekundären Index-Scan und ein zusätzliches I/O zum Abrufen des Datenblocks, der die Zeile enthält.
-
Bei ungenauen physischen Vermutungen umfasst der Zugriff einen sekundären Index-Scan und ein I/O zum Abrufen des falschen Datenblocks (wie durch die Vermutung angegeben), gefolgt von einem eindeutigen Index-Scan der indexorganisierten Tabelle nach Primärschlüsselwert.
-
Bitmap-Indizes für indexorganisierte Tabellen
Ein sekundärer Index für eine indexorganisierte Tabelle kann ein Bitmapindex sein. Ein Bitmap-Index speichert ein Bitmap für jeden Indexschlüssel.
Wenn Bitmap-Indizes für eine indexorganisierte Tabelle vorhanden sind, verwenden alle Bitmap-Indizes eine Heap-organisierte Zuordnungstabelle. In der Zuordnungstabelle werden die logischen ROWIDs der indexorganisierten Tabelle gespeichert. Jede Zeile der Zuordnungstabelle speichert eine logische Zeilen-ID für die entsprechende Zeile der indexorganisierten Tabelle.
Die Datenbank greift über einen Suchschlüssel auf einen Bitmap-Index zu. Wenn die Datenbank den Schlüssel findet, wird der Bitmap-Eintrag in eine physische ROWID konvertiert. Bei Heap-organisierten Tabellen verwendet die Datenbank die physische ROWID, um auf die Basistabelle zuzugreifen. Bei indexorganisierten Tabellen greift die Datenbank mithilfe der physischen ROWID auf die Mapping-Tabelle zu. Dies wiederum führt zu einer logischen ROWID, mit der die Datenbank auf die indexorganisierte Tabelle zugreift. Die folgende Abbildung veranschaulicht den Indexzugriff für eine Abfrage der Tabelle departments_iot.
Abbildung 4: Bitmap-Index in indexorganisierter Tabelle
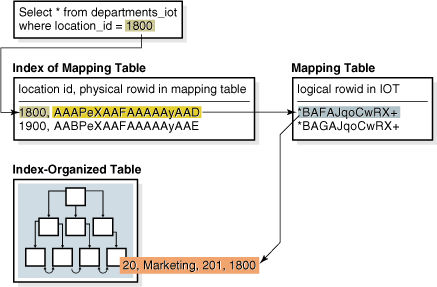
Beschreibung der Abbildung cncpt330.gif
Hinweis: Das Verschieben von Zeilen in einer indexorganisierten Tabelle lässt die Bitmap-Indizes, die auf dieser indexorganisierten Tabelle erstellt wurden, nicht unbrauchbar.
Siehe auch: "Zeilen-IDs von Zeilen-Pieces", um mehr über die Unterschiede zwischen physischen und logischen Zeilen-IDs zu erfahren