Tabellen und Tabellencluster
In diesem Kapitel erhalten Sie eine Einführung in Schemaobjekte und erfahren, welche Tabellen die häufigsten Typen von Schemaobjekten sind.
-
Einführung in Schemaobjekte Ein Datenbank-Schema ist ein logischer Container für Datenstrukturen, die als Schemaobjekte bezeichnet werden. Beispiele für Schemaobjekte sind Tabellen und Indizes. Sie erstellen und bearbeiten Schemaobjekte mit SQL.
-
Übersicht über Tabellen Eine Tabelle ist die grundlegende Einheit der Datenorganisation in einer Oracle-Datenbank.
-
Überblick über Tabellencluster Ein Tabellencluster ist eine Gruppe von Tabellen, die gemeinsame Spalten verwenden und zugehörige Daten in denselben Blöcken speichern.
-
Überblick über attributgeclusterte Tabellen Eine attributegeclusterte Tabelle ist eine Heap-organisierte Tabelle, in der Daten in unmittelbarer Nähe auf dem Datenträger basierend auf benutzerdefinierten Clustering-Anweisungen gespeichert werden. In den Anweisungen werden Spalten in einzelnen oder mehreren Tabellen angegeben.
-
Überblick über temporäre Tabellen Eine temporäre Tabelle enthält Daten, die nur für die Dauer einer Transaktion oder Session vorhanden sind.
-
Überblick über externe Tabellen Eine externe Tabelle greift auf Daten in externen Quellen zu, als ob diese Daten in einer Tabelle in der Datenbank vorhanden wären.
-
Überblick über Blockchain-Tabellen Eine Blockchain-Tabelle ist eine Nur-Anhangstabelle, die für zentralisierte Blockchain-Anwendungen entwickelt wurde.
-
Unveränderbare Tabellen - Überblick Unveränderbare Tabellen sind schreibgeschützte Tabellen, die nicht autorisierte Datenänderungen durch Insider und versehentliche Datenänderungen aufgrund von menschlichen Fehlern verhindern.
-
Überblick über Objekttabellen Eine Objekttabelle ist eine spezielle Art von Tabelle, in der jede Zeile ein Objekt darstellt.
Schemaobjekte – Einführung
Ein Datenbankschema ist ein logischer Container für Datenstrukturen, die als Schemaobjekte bezeichnet werden. Beispiele für Schemaobjekte sind Tabellen und Indizes. Sie erstellen und bearbeiten Schemaobjekte mit SQL.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Info zu allgemeinen und lokalen Benutzeraccounts Ein Datenbankbenutzeraccount verfügt über ein Kennwort und bestimmte Datenbankberechtigungen.
-
Allgemeine und lokale Objekte Ein allgemeines Objekt ist entweder in der CDB-Root oder in einer Anwendungs-Root definiert und kann über Metadatenlinks oder Objektlinks referenziert werden. Ein lokales Objekt ist jedes Objekt, das kein gemeinsames Objekt ist.
-
Schemaobjekttypen Mit Oracle SQL können Sie viele andere Typen von Schemaobjekten erstellen und bearbeiten.
-
Schema Object Storage Einige Schemaobjekte speichern Daten in einer logischen Speicherstruktur, die als Segment bezeichnet wird. Beispiel: Eine nicht partitionierte Heap-organisierte Tabelle oder ein Index erstellt ein Segment.
-
Schemaobjektabhängigkeiten Einige Schemaobjekte verweisen auf andere Objekte, wodurch eine Schemaobjektabhängigkeit erstellt wird.
-
Beispielschemas Eine Oracle-Datenbank kann Beispielschemas enthalten, bei denen es sich um eine Gruppe verknüpfter Schemas handelt, mit denen die Oracle-Dokumentation und die Oracle-Anweisungsmaterialien allgemeine Datenbankaufgaben veranschaulichen können. Siehe auch: Oracle AI Database - Sicherheitshandbuch, um mehr über Benutzer und Berechtigungen zu erfahren
Allgemeine und lokale Benutzerkonten
Ein Datenbankbenutzeraccount verfügt über ein Kennwort und bestimmte Datenbankberechtigungen.
Benutzeraccounts und Schemas
Jeder Benutzeraccount besitzt ein einzelnes Schema, das denselben Namen wie der Benutzer hat. Das Schema enthält die Daten für den Benutzer, der das Schema besitzt. Beispiel: Der Benutzeraccount hr ist Eigentümer des Schemas hr, das Schemaobjekte wie die Tabelle employees enthält. In einer Produktionsdatenbank stellt der Schemaeigentümer normalerweise eine Datenbankanwendung und nicht eine Person dar.
Innerhalb eines Schemas hat jedes Schemaobjekt eines bestimmten Typs einen eindeutigen Namen. Beispiel: hr.employees referenziert die Tabelle employees im Schema hr. Die folgende Abbildung zeigt einen Schemaeigentümer namens hr und Schemaobjekte im Schema hr.
Abbildung 1: HR-Schema
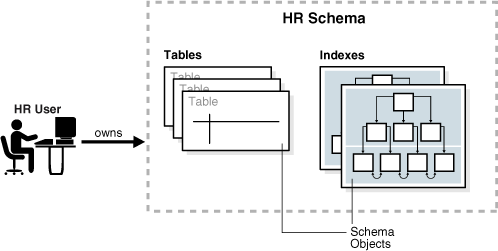
Beschreibung der Abbildung cncpt230.gif
Gemeinsame und lokale Benutzerkonten
Wenn ein Benutzeraccount Eigentümer von Objekten ist, die die Datenbank definieren, ist dieser Benutzeraccount allgemein. Benutzerkonten, die nicht von Oracle bereitgestellt werden, sind lokal oder allgemein. Ein allgemeiner CDB-Benutzer ist ein allgemeiner Benutzer, der in der CDB-Root erstellt wird. Ein allgemeiner Anwendungsbenutzer ist ein Benutzer, der in einem Anwendungs-Root erstellt wird und nur in diesem Anwendungs-Container verwendet wird.
Die folgende Grafik zeigt die möglichen Benutzeraccounttypen in einer CDB.
Abbildung 2: Benutzerkonten in einer CDB
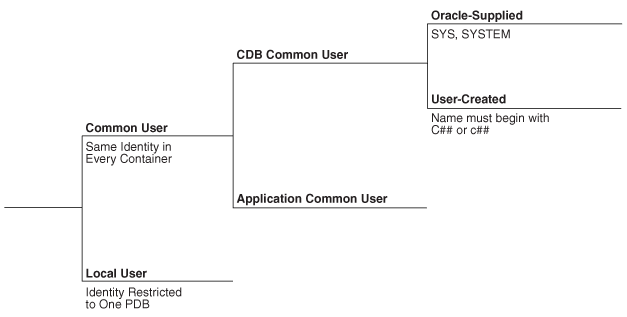
Beschreibung der Abbildung cncpt370.png
Ein allgemeiner CDB-Benutzer kann eine Verbindung zu einem Container in der CDB herstellen, für den er über ausreichende Berechtigungen verfügt. Im Gegensatz dazu kann ein allgemeiner Anwendungsbenutzer je nach seinen Berechtigungen nur eine Verbindung zur Anwendungs-Root herstellen, in der er erstellt wurde, oder zu einer PDB, die an diese Anwendungs-Root angeschlossen ist.
-
Allgemeine Benutzeraccounts Im Kontext des Systemcontainers (CDB) oder eines Anwendungscontainers ist ein normaler Benutzer ein Datenbankbenutzer, der dieselbe Identität in der Root und in jeder vorhandenen und zukünftigen PDB in diesem Container aufweist.
-
Lokale Benutzeraccounts Ein lokaler Benutzer ist ein Datenbankbenutzer, der nicht häufig verwendet wird und nur innerhalb einer einzelnen PDB ausgeführt werden kann.
Allgemeine Benutzerkonten
Im Kontext des Systemcontainers (CDB) oder eines Anwendungscontainers ist ein allgemeiner Benutzer ein Datenbankbenutzer, der dieselbe Identität in der Root und in jeder vorhandenen und zukünftigen PDB in diesem Container aufweist.
Jeder allgemeine Benutzer kann sich bei der Root seines Containers und in jeder PDB, in der er über ausreichende Berechtigungen verfügt, anmelden und Vorgänge ausführen. Einige administrative Aufgaben müssen von einem allgemeinen Benutzer ausgeführt werden. Beispiele: Erstellen einer PDB und Aufheben der Integration einer PDB.
Beispiel: SYSTEM ist ein allgemeiner CDB-Benutzer mit DBA-Berechtigungen. Somit kann SYSTEM eine Verbindung zur CDB-Root und zu einer beliebigen PDB in der Datenbank herstellen. Sie können einen allgemeinen Benutzer saas_sales_admin im Anwendungscontainer saas_sales erstellen. In diesem Fall konnte der Benutzer saas_sales_admin nur eine Verbindung zur Anwendungs-Root saas_sales oder zu einer Anwendungs-PDB im Anwendungscontainer saas_sales herstellen.
Jeder allgemeine Benutzer wird entweder von Oracle bereitgestellt oder vom Benutzer erstellt. Beispiele für von Oracle bereitgestellte allgemeine Benutzer sind SYS und SYSTEM. Jeder vom Benutzer erstellte allgemeine Benutzer ist entweder ein allgemeiner CDB-Benutzer oder ein allgemeiner Anwendungsbenutzer.
In der folgenden Abbildung werden Beispielbenutzer und Schemas in zwei PDBs dargestellt: hrpdb und salespdb. SYS und c##dba sind allgemeine CDB-Benutzer, die Schemas in CDB$ROOT, hrpdb und salespdb aufweisen. Die lokalen Benutzer hr und rep sind in hrpdb vorhanden. Die lokalen Benutzer hr und rep sind auch in salespdb vorhanden.
Abbildung 3: Benutzer und Schemas in einer CDB
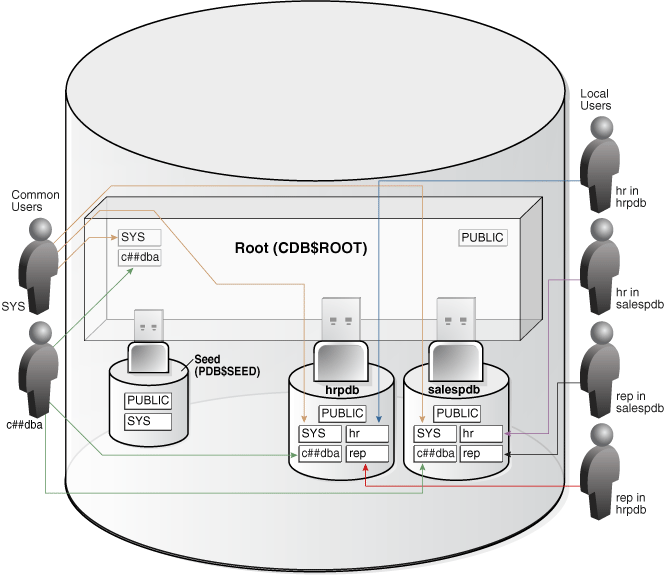
Beschreibung der Abbildung cncpt340.png
Allgemeine Benutzer weisen folgende Merkmale auf:
-
Ein allgemeiner Benutzer kann sich bei jedem Container (einschließlich
CDB$ROOT) anmelden, in dem er über die BerechtigungCREATE SESSIONverfügt.Ein allgemeiner Benutzer muss nicht in jedem Container über dieselben Berechtigungen verfügen. Beispiel: Der Benutzer
c##dbahat möglicherweise die Berechtigung, eine Session inhrpdbund im Root-Verzeichnis zu erstellen, aber keine Session insalespdbzu erstellen. Da ein allgemeiner Benutzer mit den entsprechenden Berechtigungen zwischen Containern wechseln kann, kann ein allgemeiner Benutzer in der Root PDBs verwalten. -
Ein allgemeiner Anwendungsbenutzer verfügt in keinem Container außerhalb seines eigenen Anwendungscontainers über die Berechtigung
CREATE SESSION.Daher ist ein allgemeiner Anwendungsbenutzer auf seinen eigenen Anwendungscontainer beschränkt. Beispiel: Der in der Anwendung
saas_saleserstellte allgemeine Benutzer der Anwendung kann nur eine Verbindung zur Anwendungs-Root und zu den PDBs im Anwendungscontainersaas_salesherstellen. -
Die Namen der vom Benutzer erstellten allgemeinen CDB-Benutzer müssen die Benennungsregeln für andere Datenbankbenutzer befolgen. Darüber hinaus müssen die Namen mit den vom Initialisierungsparameter
COMMON_USER_PREFIXangegebenen Zeichen beginnen, die standardmäßigc##oderC##lauten. Von Oracle bereitgestellte allgemeine Benutzernamen und von Benutzern erstellte allgemeine Benutzernamen von Anwendungen weisen diese Einschränkung nicht auf.Kein lokaler Benutzername darf mit den Zeichen
c##oderC##beginnen. -
Jeder allgemeine Benutzer wird in allen PDBs innerhalb des Containers (entweder dem Systemcontainer oder einem bestimmten Anwendungscontainer) eindeutig benannt, in dem er erstellt wurde.
Ein allgemeiner CDB-Benutzer wird in der CDB-Root definiert, muss jedoch in der Lage sein, eine Verbindung zu jeder PDB mit derselben Identität herzustellen. Ein allgemeiner Anwendungsbenutzer befindet sich in der Anwendungs-Root und kann sich mit derselben Identität bei jeder Anwendungs-PDB in seinem Container anmelden.
-
Eigenschaften von allgemeinen Benutzern Jeder allgemeine Benutzer wird entweder von Oracle bereitgestellt oder vom Benutzer erstellt.
-
SYS- und SYSTEM-Accounts Alle Oracle-Datenbanken enthalten allgemeine Standardbenutzeraccounts mit Administratorberechtigungen.
Merkmale allgemeiner Benutzer
Jeder allgemeine Benutzer wird entweder von Oracle bereitgestellt oder vom Benutzer erstellt.
Gemeinsame Benutzeraccounts weisen folgende Merkmale auf:
-
Ein allgemeiner Benutzer kann sich bei jedem Container (einschließlich
CDB$ROOT) anmelden, in dem er über die BerechtigungCREATE SESSIONverfügt.Ein allgemeiner Benutzer muss nicht in jedem Container über dieselben Berechtigungen verfügen. Beispiel: Der Benutzer
c##dbahat möglicherweise die Berechtigung, eine Session inhrpdbund im Root-Verzeichnis zu erstellen, jedoch nicht, um eine Session insalespdbzu erstellen. Da ein allgemeiner Benutzer mit den entsprechenden Berechtigungen zwischen Containern wechseln kann, kann ein allgemeiner Benutzer in der Root PDBs verwalten. -
Ein allgemeiner Anwendungsbenutzer verfügt in keinem Container außerhalb seines eigenen Anwendungscontainers über die Berechtigung
CREATE SESSION.Daher ist ein allgemeiner Anwendungsbenutzer auf seinen eigenen Anwendungscontainer beschränkt. Beispiel: Der in der Anwendung
saas_saleserstellte allgemeine Benutzer der Anwendung kann nur eine Verbindung zur Anwendungs-Root und zu den PDBs im Anwendungscontainersaas_salesherstellen. -
Die Namen der vom Benutzer erstellten allgemeinen CDB-Benutzer müssen die Benennungsregeln für andere Datenbankbenutzer befolgen. Darüber hinaus müssen die Namen mit den vom Initialisierungsparameter
COMMON_USER_PREFIXangegebenen Zeichen beginnen, die standardmäßigc##oderC##lauten. Von Oracle bereitgestellte allgemeine Benutzernamen und von Benutzern erstellte allgemeine Benutzernamen von Anwendungen weisen diese Einschränkung nicht auf.Kein lokaler Benutzername darf mit den Zeichen
c##oderC##beginnen. -
Jeder allgemeine Benutzer wird in allen PDBs innerhalb des Containers (entweder dem Systemcontainer oder einem bestimmten Anwendungscontainer) eindeutig benannt, in dem er erstellt wurde.
Ein allgemeiner CDB-Benutzer wird in der CDB-Root definiert, muss jedoch in der Lage sein, eine Verbindung zu jeder PDB mit derselben Identität herzustellen. Ein allgemeiner Anwendungsbenutzer befindet sich in der Anwendungs-Root und kann eine Verbindung zu jeder Anwendungs-PDB in seinem Container mit derselben Identität herstellen.
In der folgenden Abbildung werden Beispielbenutzer und Schemas in zwei PDBs dargestellt: hrpdb und salespdb. SYS und c##dba sind allgemeine CDB-Benutzer, die Schemas in CDB$ROOT, hrpdb und salespdb aufweisen. Die lokalen Benutzer hr und rep sind in hrpdb vorhanden. Die lokalen Benutzer hr und rep sind auch in salespdb vorhanden.
Abbildung 4: Benutzer und Schemas in einer CDB
Beschreibung der Abbildung cncpt340.png
Siehe:
-
Oracle AI Database - Sicherheitshandbuch, um mehr über gängige Benutzerkonten zu erfahren
-
Oracle AI Database Reference, um mehr über
COMMON_USER_PREFIXzu erfahren
SYS- und SYSTEM-Konten
Alle Oracle-Datenbanken enthalten allgemeine Standardbenutzeraccounts mit Administratorberechtigungen.
Administratoraccounts sind mit zahlreichen Privilegien ausgestattet und sollten nur von Personen verwendet werden, um Aufgaben wie Starten und Stoppen der Datenbank, Verwalten von Speicher und Speicher, Erstellen und Verwalten von Datenbankbenutzern usw. auszuführen.
Der allgemeine Benutzeraccount SYS wird automatisch erstellt, wenn eine Datenbank erstellt wird. Dieses Konto kann alle administrativen Funktionen der Datenbank ausführen. Das Schema SYS speichert die Basistabellen und Views für das Data Dictionary. Diese Basistabellen und -ansichten sind für den Betrieb von Oracle AI Database von kritischer Bedeutung. Tabellen im Schema SYS werden nur von der Datenbank bearbeitet und dürfen von keinem Benutzer geändert werden.
Der SYSTEM-Administrationsaccount wird auch automatisch erstellt, wenn eine Datenbank erstellt wird. Das Schema SYSTEM speichert zusätzliche Tabellen und Views, die administrative Informationen anzeigen, sowie interne Tabellen und Views, die von verschiedenen Oracle AI Database-Optionen und -Tools verwendet werden. Verwenden Sie niemals das Schema SYSTEM, um relevante Tabellen für Benutzer ohne Administratorrechte zu speichern.
Siehe:
-
Oracle AI Database - Sicherheitshandbuch für Informationen zu Benutzeraccounts
-
Oracle AI Database Administrator's Guide mit Informationen zu
SYS,SYSTEMund anderen administrativen Accounts
Lokale Benutzerkonten
Ein lokaler Benutzer ist ein Datenbankbenutzer, der nicht häufig verwendet wird und nur innerhalb einer einzelnen PDB ausgeführt werden kann.
Lokale Benutzer haben die folgenden Eigenschaften:
-
Ein lokaler Benutzer ist für eine PDB spezifisch und kann Eigentümer eines Schemas in dieser PDB sein.
Im Beispiel in "Eigenschaften allgemeiner Benutzer" ist der lokale Benutzer
hrinhrpdbEigentümer des Schemashr. Beisalespdbist der lokale BenutzerrepEigentümer des Schemasrep, und der lokale Benutzerhrist Eigentümer des Schemashr. -
Ein lokaler Benutzer kann eine PDB verwalten, einschließlich Öffnen und Schließen.
Ein allgemeiner Benutzer mit
SYSDBA-Berechtigungen kann einem lokalen BenutzerSYSDBA-Berechtigungen erteilen. In diesem Fall bleibt der privilegierte Benutzer lokal. -
Ein lokaler Benutzer in einer PDB kann sich nicht bei einer anderen PDB oder bei der CDB-Root anmelden.
Beispiel: Wenn der lokale Benutzer
hreine Verbindung zuhrpdbherstellt, kannhrnicht auf Objekte im Schemashzugreifen, die sich in der Datenbanksalespdbbefinden, ohne einen Datenbanklink zu verwenden. Wenn sich der lokale Benutzershbei der PDBsalespdbanmeldet, kannshauf Objekte im Schemahr, das sich inhrpdbbefindet, nicht zugreifen, ohne einen Datenbanklink zu verwenden. -
Der Name eines lokalen Benutzers darf nicht mit den Zeichen
c##oderC##beginnen. -
Der Name eines lokalen Benutzers darf nur innerhalb seiner PDB eindeutig sein.
Der Benutzername und die PDB, in der dieses Benutzerschema enthalten ist, bestimmen einen eindeutigen lokalen Benutzer. "Eigenschaften allgemeiner Benutzer" zeigt, dass ein lokaler Benutzer und ein lokales Schema mit dem Namen
repinhrpdbvorhanden sind. In der PDBsalespdbist ein vollständig unabhängiger lokaler Benutzer und ein vollständig unabhängiges Schema mit dem Namenrepvorhanden.
In der folgenden Tabelle wird ein Szenario beschrieben, in dem die CDB in "Eigenschaften allgemeiner Benutzer" enthalten ist. Jede Zeile beschreibt eine Aktion, die nach der Aktion in der vorhergehenden Zeile erfolgt. Der allgemeine Benutzer SYSTEM erstellt lokale Benutzer in zwei PDBs.
Tabelle 1: Lokale Benutzer in einer CDB
| Arbeitsvorgang | Beschreibung |
|---|---|
|
SYSTEM stellt eine Verbindung zum Container hrpdb mit dem Servicenamen hrpdb her. |
|
SYSTEM erstellt jetzt einen lokalen Benutzer rep und erteilt diesem Benutzer die Berechtigung CREATE SESSION in dieser PDB. Der Benutzer ist lokal, da allgemeine Benutzer nur von einem gemeinsamen Benutzer erstellt werden können, der mit der Root verbunden ist. |
|
Der rep-Benutzer, der lokal bei hrpdb ist, versucht, eine Verbindung zu salespdb herzustellen. Der Versuch ist nicht erfolgreich, weil rep in PDB salespdb nicht vorhanden ist. |
|
SYSTEM stellt eine Verbindung zum Container salespdb mit dem Servicenamen salespdb her. |
|
SYSTEM erstellt den lokalen Benutzer rep in salespdb und erteilt diesem Benutzer die Berechtigung CREATE SESSION in dieser PDB. Da der Name eines lokalen Benutzers nur innerhalb seiner PDB eindeutig sein darf, kann ein Benutzer mit dem Namen rep sowohl in salespdb als auch in hrpdb vorhanden sein. |
|
Der Benutzer rep meldet sich erfolgreich bei salespdb an. |
Siehe auch: Oracle AI Database - Sicherheitshandbuch, um Informationen zu lokalen Benutzeraccounts zu erhalten
Gemeinsame und lokale Objekte
Ein gemeinsames Objekt ist entweder in der CDB-Root oder in einer Anwendungs-Root definiert und kann über Metadatenlinks oder Objektlinks referenziert werden. Ein lokales Objekt ist jedes Objekt, das kein gemeinsames Objekt ist.
Von der Datenbank bereitgestellte gemeinsame Objekte werden in CDB$ROOT definiert und können nicht geändert werden. Oracle Database unterstützt die Erstellung allgemeiner Objekte in CDB$ROOT nicht.
Sie können die meisten Schemaobjekte wie Tabellen, Views, PL/SQL- und Java-Programmeinheiten, Sequences usw. als gemeinsame Objekte in einer Anwendungs-Root erstellen. Wenn das Objekt in einem Anwendungs-Root vorhanden ist, wird es als allgemeines Anwendungsobjekt bezeichnet.
Ein lokaler Benutzer kann Eigentümer eines gemeinsamen Objekts sein. Außerdem kann ein allgemeiner Benutzer ein lokales Objekt besitzen, jedoch nur, wenn das Objekt nicht mit Daten verknüpft oder mit Metadaten verknüpft ist und auch weder ein Metadatenlink noch ein Datenlink ist.
Siehe auch: Oracle AI Database - Sicherheitshandbuch, um mehr über die Berechtigungsverwaltung für gemeinsame Objekte zu erfahren
Schemaobjekttypen
Mit Oracle SQL können Sie viele andere Typen von Schemaobjekten erstellen und bearbeiten.
Die Haupttypen von Schemaobjekten werden in der folgenden Tabelle dargestellt.
Tabelle 2 Schemaobjekte
| Objekt | Beschreibung | Weitere Infos |
|---|---|---|
| Tabelle | In einer Tabelle werden Daten in Zeilen gespeichert. Tabellen sind die wichtigsten Schemaobjekte in einer relationalen Datenbank. | "Tabellen - Überblick" |
| Indizes | Indizes sind Schemaobjekte, die einen Eintrag für jede indizierte Zeile der Tabelle oder des Tabellenclusters enthalten und direkten, schnellen Zugriff auf Zeilen ermöglichen. Oracle AI Database unterstützt verschiedene Indextypen. Eine indexorganisierte Tabelle ist eine Tabelle, in der die Daten in einer Indexstruktur gespeichert werden. | "Indizes und indexorganisierte Tabellen" |
| Partitionen | Partitionen sind Teile großer Tabellen und Indizes. Jede Partition hat ihren eigenen Namen und kann optional ihre eigenen Speichereigenschaften haben. | "Überblick über Partitionen" |
| Ansichten | Views sind benutzerdefinierte Präsentationen von Daten in einer oder mehreren Tabellen oder anderen Views. Sie sind mit gespeicherten Abfragen vergleichbar. Views enthalten keine Daten. | "Überblick über Ansichten" |
| Belegnummern | Eine Sequence ist ein vom Benutzer erstelltes Objekt, das von mehreren Benutzern gemeinsam verwendet werden kann, um Ganzzahlen zu generieren. In der Regel verwenden Sie Sequences, um Primärschlüsselwerte zu generieren. | "Überblick über Sequences" |
| Dimensionen | Eine Dimension definiert eine über-/untergeordnete Beziehung zwischen Paaren von SpaltenSets, wobei alle Spalten eines SpaltenSets aus derselben Tabelle stammen müssen. Dimensionen werden häufig verwendet, um Daten wie Kunden, Produkte und Zeit zu kategorisieren. | "Dimensionen - Überblick" |
| Synonyme | Ein Synonym ist ein Alias für einen anderen Schemaobjekt. Da ein Synonym einfach ein Alias ist, muss lediglich dessen Definition im Data Dictionary gespeichert werden. | "Überblick über Synonyme" |
| PL/SQL-Unterprogramme und -Packages | PL/SQL ist die prozedurale Erweiterung von SQL von Oracle. Ein PL/SQL-Unterprogramm ist ein benannter PL/SQL-Block, der mit einer Gruppe von Parametern aufgerufen werden kann. Ein PL/SQL-Package gruppiert logisch verknüpfte PL/SQL-Typen, -Variablen und -Unterprogramme. | "PL/SQL-Unterprogramme" |
Andere Objekttypen werden ebenfalls in der Datenbank gespeichert und können mit SQL-Anweisungen erstellt und bearbeitet werden, sind jedoch nicht in einem Schema enthalten. Zu diesen Objekten gehören Datenbankbenutzer-Account, Rollen, Kontexte und Dictionary-Objekte.
Siehe:
-
Oracle AI Database - Administratordokumentation zum Verwalten von Schemaobjekten
-
SQL-Sprachreferenz für Oracle AI Database für mehr über Schemaobjekte und Datenbankobjekte
Schemaobjektspeicher
Einige Schemaobjekte speichern Daten in einer logischen Speicherstruktur, die als Segment bezeichnet wird. Beispiel: Eine nicht partitionierte Heap-organisierte Tabelle oder ein Index erstellt ein Segment.
Andere Schemaobjekte, wie Views und Sequences, bestehen nur aus Metadaten. In diesem Thema werden nur Schemaobjekte beschrieben, die Segmente enthalten.
Oracle AI Database speichert ein Schemaobjekt logisch in einem Tablespace. Es gibt keine Beziehung zwischen Schemas und Tablespaces: Ein Tablespace kann Objekte aus verschiedenen Schemas enthalten, und die Objekte für ein Schema können in verschiedenen Tablespaces enthalten sein. Die Daten jedes Objekts sind physisch in einer oder mehreren Datendateien enthalten.
Die folgende Abbildung zeigt eine mögliche Konfiguration von Tabellen- und Indexsegmenten, Tablespaces und Datendateien. Das Datensegment für eine Tabelle umfasst zwei Datendateien, die beide Teil desselben Tablespace sind. Ein Segment kann nicht mehrere Tablespaces umfassen.
Abbildung 5: Segmente, Tablespaces und Datendateien
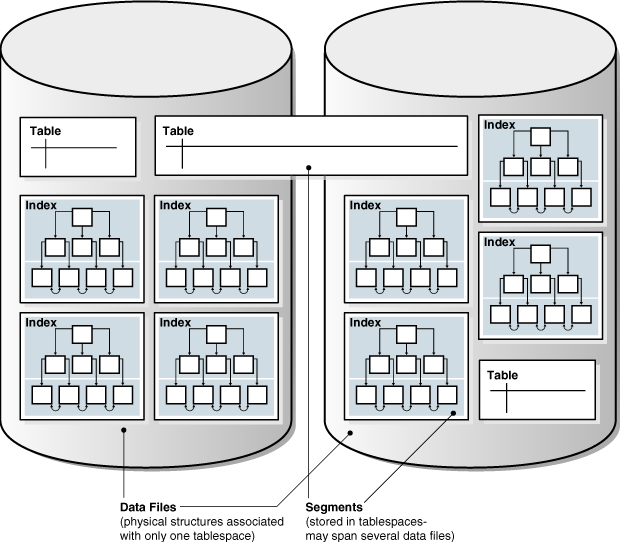
Beschreibung der Abbildung cncpt284.gif
Siehe:
-
"Logische Speicherstrukturen", um mehr über Tablespaces und Segmente zu erfahren
-
Oracle AI Database Administrator's Guide zum Verwalten des Speichers für Schemaobjekte
Schemaobjektabhängigkeiten
Einige Schemaobjekte verweisen auf andere Objekte und erstellen eine Schemaobjektabhängigkeit.
Beispiel: Eine View enthält eine Abfrage, die Tabellen oder Views referenziert, während ein PL/SQL-Unterprogramm andere Unterprogramme aufruft. Wenn die Definition von Objekt A das Objekt B verweist, dann ist A ein abhängiges Objekt auf B, und B ist ein referenziertes Objekt für A.
Oracle AI Database bietet einen automatischen Mechanismus, mit dem sichergestellt wird, dass ein abhängiges Objekt in Bezug auf die referenzierten Objekte immer auf dem neuesten Stand ist. Wenn Sie ein abhängiges Objekt erstellen, verfolgt die Datenbank Abhängigkeiten zwischen dem abhängigen Objekt und den referenzierten Objekten. Wenn sich ein referenziertes Objekt in einer Weise ändert, die sich auf ein abhängiges Objekt auswirken kann, markiert die Datenbank das abhängige Objekt als ungültig. Beispiel: Wenn ein Benutzer eine Tabelle löscht, kann keine Ansicht basierend auf der gelöschten Tabelle verwendet werden.
Ein ungültiges abhängiges Objekt muss mit der neuen Definition eines referenzierten Objekts neu kompiliert werden, bevor das abhängige Objekt verwendet werden kann. Die Rekompilierung erfolgt automatisch, wenn das ungültige abhängige Objekt referenziert wird.
Zur Veranschaulichung, wie Schemaobjekte Abhängigkeiten erstellen können, erstellt das folgende Beispielskript eine Tabelle test_table und anschließend eine Prozedur, die diese Tabelle abfragt:
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
Die folgende Abfrage des Status der Prozedur test_proc zeigt, dass sie gültig ist:
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Nachdem Sie die Spalte col3 zu test_table hinzugefügt haben, ist die Prozedur noch gültig, da die Prozedur keine Abhängigkeiten von dieser Spalte aufweist:
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Wenn Sie jedoch den Datentyp der Spalte col1 ändern, von der die Prozedur test_proc abhängt, wird die Prozedur invalidiert:
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
Wenn Sie die Prozedur ausführen oder neu kompilieren, ist sie wieder gültig, wie im folgenden Beispiel gezeigt:
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Siehe auch: Oracle AI Database Administrator's Guide und Oracle AI Database Development Guide, in dem Sie erfahren, wie Schemaobjektabhängigkeiten verwaltet werden
Beispielschemas
Eine Oracle-Datenbank kann Beispielschemas enthalten, bei denen es sich um eine Gruppe miteinander verknüpfter Schemas handelt, die der Oracle-Dokumentation und den Oracle-Anweisungsmaterialien die Möglichkeit geben, allgemeine Datenbankaufgaben zu veranschaulichen.
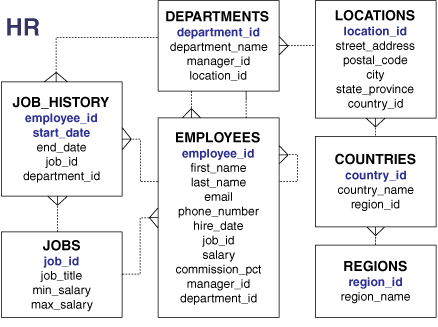
Das Beispielschema hr enthält Informationen zu Mitarbeitern, Abteilungen und Standorten, Arbeitsverläufen usw. Die folgende Abbildung zeigt ein Entity-Relationship-Diagramm der Tabellen in hr. Die meisten Beispiele in diesem Handbuch verwenden Objekte aus diesem Schema.
Abbildung 6: HR-Schema
Beschreibung der Abbildung cncpt292.gif
Siehe auch: Oracle AI Database-Beispielschemas, um zu erfahren, wie Sie die Beispielschemas installieren
Tabellen - Überblick
Eine Tabelle ist die grundlegende Einheit der Datenorganisation in einer Oracle-Datenbank.
In einer Tabelle wird eine Entity beschrieben, die eine Bedeutung hat, zu der Informationen aufgezeichnet werden müssen. Beispiel: Ein Mitarbeiter kann eine Entität sein.
Oracle AI Database-Tabellen fallen in die folgenden grundlegenden Kategorien:
-
Relationale Tabellen
Relationale Tabellen haben einfache Spalten und sind der häufigste Tabellentyp. Beispiel 4-1 zeigt eine
CREATE TABLE-Anweisung für eine relationale Tabelle. -
Objekttabellen
Die Spalten entsprechen den Attributen der obersten Ebene eines Objekttyps. Siehe "Überblick über Objekttabellen".
Sie können eine relationale Tabelle mit den folgenden organisatorischen Eigenschaften erstellen:
-
In einer heap-organisierten Tabelle werden keine Zeilen in einer bestimmten Reihenfolge gespeichert. Die Anweisung
CREATE TABLEerstellt standardmäßig eine Heap-organisierte Tabelle. -
Eine indexorganisierte Tabelle ordnet Zeilen gemäß den Primärschlüsselwerten an. Bei einigen Anwendungen verbessern Index-organisierte Tabellen die Performance und nutzen Plattenspeicherplatz effizienter. Siehe "Überblick über Index Organized Tables".
-
Eine externe Tabelle ist eine schreibgeschützte Tabelle, deren Metadaten in der Datenbank gespeichert werden, deren Daten jedoch außerhalb der Datenbank gespeichert werden. Siehe "Externe Tabellen - Überblick".
Eine Tabelle ist entweder permanent oder temporär. Eine permanente Tabellendefinition und Daten bleiben über Sessions hinweg bestehen. Eine Definition einer temporären Tabelle bleibt genauso wie eine Definition einer permanenten Tabelle bestehen, die Daten sind jedoch nur für die Dauer einer Transaktion oder Session vorhanden. Temporäre Tabellen sind in Anwendungen nützlich, in denen eine Ergebnismenge vorübergehend gespeichert werden muss, da das Ergebnis möglicherweise durch die Ausführung mehrerer Vorgänge erstellt wird.
-
Spalten Eine Tabellendefinition enthält einen Tabellennamen und eine Gruppe von Spalten.
-
Zeilen Eine Zeile ist eine Sammlung von Spalteninformationen, die einem Datensatz in einer Tabelle entsprechen.
-
Beispiel: CREATE TABLE- und ALTER TABLE-Anweisungen Die Oracle SQL-Anweisung zum Erstellen einer Tabelle lautet
CREATE TABLE. -
Oracle-Datentypen Jede Spalte hat einen Datentyp, der mit einem bestimmten Speicherformat, Constraints und einem gültigen Wertebereich verknüpft ist. Der Datentyp eines Wertes verknüpft eine feste Gruppe von Eigenschaften mit dem Wert.
-
Integritäts-Constraints Ein Integritäts-Constraint ist eine benannte Regel, mit der die Werte für eine oder mehrere Spalten in einer Tabelle eingeschränkt werden.
-
Table Storage Oracle AI Database verwendet ein Datensegment in einem Tablespace, um Tabellendaten zu speichern.
-
Tabellenkomprimierung Die Datenbank kann die Tabellenkomprimierung verwenden, um den für die Tabelle erforderlichen Speicherplatz zu reduzieren. Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Tabellen verwaltet werden.
Spalten
Eine Tabellendefinition enthält einen Tabellennamen und eine Gruppe von Spalten.
Eine Spalte gibt ein Attribut der in der Tabelle beschriebenen Entity an. Beispiel: Die Spalte employee_id in der Tabelle employees verweist auf das Attribut "Mitarbeiter-ID" einer Mitarbeiterentität.
Im Allgemeinen geben Sie jeder Spalte einen Spaltennamen, einen Datentyp und eine Breite, wenn Sie eine Tabelle erstellen. Beispiel: Der Datentyp für employee_id ist NUMBER(6). Dies gibt an, dass diese Spalte nur numerische Daten mit einer Breite von bis zu 6 Stellen enthalten kann. Die Breite kann durch den Datentyp vorgegeben werden, wie bei DATE.
-
Virtuelle Spalten Eine Tabelle kann eine virtuelle Spalte enthalten, die auch als Ausdrucksspalte bezeichnet wird. Ausdrucksspalten können virtuell sein, d.h. nicht auf Platte gespeichert oder materialisiert, d.h. auf Platte gespeichert.
-
Unsichtbare Spalten Eine unsichtbare Spalte ist eine benutzerdefinierte Spalte, deren Werte nur sichtbar sind, wenn die Spalte explizit nach Name angegeben wird. Sie können einer Tabelle eine unsichtbare Spalte hinzufügen, ohne vorhandene Anwendungen zu beeinträchtigen, und die Spalte bei Bedarf sichtbar machen.
-
Sperrefreie Reservierung Mit einer Sperrefreie Reservierung können mehrere gleichzeitige Aktualisierungen für einen numerischen Spaltenwert fortgesetzt werden, ohne durch nicht festgeschriebene Aktualisierungen blockiert zu werden, wenn der Spaltenwert addiert oder vom Spaltenwert subtrahiert wird.
Virtuelle Spalten
Eine Tabelle kann eine virtuelle Spalte enthalten, die auch als Ausdrucksspalte bezeichnet wird. Ausdrucksspalten können virtuell sein, d.h. nicht auf Platte gespeichert oder materialisiert, d.h. auf Platte gespeichert.
Virtuelle Spalten, auch Ausdrucksspalten genannt, leiten die Werte ab, indem sie eine Gruppe von benutzerdefinierten Ausdrücken oder Funktionen berechnen. Eine Tabelle kann eine von mehreren solchen Spalten enthalten, muss jedoch immer eine reguläre Spalte enthalten. Beispiel: Die folgende Tabellendefinition EMP enthält den berechneten Stundensatz basierend auf dem Gehalt des Mitarbeiters dividiert durch 2080 Stunden pro Jahr.
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
Fügen Sie als Nächstes Werte in die nicht-virtuellen Spalten ein.
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
Wenn Sie die Tabelle abfragen, wird der berechnete Wert nun als Ausdrucksspalte zurückgegeben.
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
Solche Ausdrucksspalten können virtuell oder auf Platte materialisiert sein. Bei reinen virtuellen Spalten (Ausdrucksspalten) belegen die Spaltenwerte keinen Festplattenspeicher und werden bei Bedarf zur Zugriffszeit berechnet. Bei Materialized Expression-Spalten werden die Werte zur DML-Zeit berechnet und auf Platte gespeichert.
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie virtuelle Spalten verwalten.
Unsichtbare Spalten
Eine unsichtbare Spalte ist eine benutzerdefinierte Spalte, deren Werte nur sichtbar sind, wenn die Spalte explizit nach Name angegeben wird. Sie können einer Tabelle eine unsichtbare Spalte hinzufügen, ohne vorhandene Anwendungen zu beeinträchtigen, und die Spalte bei Bedarf sichtbar machen.
Im Allgemeinen helfen unsichtbare Spalten bei der Migration und Weiterentwicklung von Online-Anwendungen. Ein Anwendungsfall kann eine Anwendung sein, die eine Tabelle mit drei Spalten mit einer SELECT *-Anweisung abfragt. Wenn Sie der Tabelle eine vierte Spalte hinzufügen, wird die Anwendung unterbrochen, die drei Datenspalten erwartet. Wenn Sie eine vierte unsichtbare Spalte hinzufügen, funktioniert die Anwendung normal. Ein Entwickler kann die Anwendung dann so ändern, dass sie eine vierte Spalte verarbeitet, und die Spalte beim Go-Live der Anwendung sichtbar machen.
Im folgenden Beispiel wird eine Tabelle products mit einer unsichtbaren Spalte count erstellt. Anschließend wird die unsichtbare Spalte sichtbar:
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten unsichtbarer Spalten
-
Oracle AI Database SQL Language Reference für weitere Informationen zu unsichtbaren Spalten
Sperrfreie Reservierung
Mit einer kostenlosen Reservierung können mehrere gleichzeitige Aktualisierungen für einen numerischen Spaltenwert fortgesetzt werden, ohne durch nicht festgeschriebene Aktualisierungen blockiert zu werden, wenn der Spaltenwert addiert oder vom Spaltenwert subtrahiert wird.
Durch die Vermeidung des herkömmlichen Sperrmechanismus bei Aktualisierungen können Sie die Benutzererfahrung mit reduzierter Blockierung bei häufigen gleichzeitigen Aktualisierungen von reservierbaren Spalten erheblich verbessern. Wenn in früheren Releases ein Spaltenwert einer Zeile durch Hinzufügen oder Subtrahieren aktualisiert wird, werden alle anderen Aktualisierungen dieser Zeile blockiert, bis die Transaktion festgeschrieben wird. Mit der Einführung des Features "Lock-Free Reservation" in Oracle AI Database 26ai können Sie zulassen, dass Transaktionen gleichzeitig die reservierbare Spalte derselben Zeile hinzufügen oder von ihr subtrahieren, ohne sich gegenseitig zu blockieren, indem Sie die Bedingungen angeben, unter denen die Updates fortgesetzt werden können. Dazu müssen Sie angeben, dass es sich bei der numerischen Spalte um eine RESERVABLE-Spalte handelt, und ein CHECK-Constraint für die Spalte erstellen. Eine zusätzliche Verbesserung des Durchsatzes kann auch erreicht werden, da die Aktualisierungen der reservierbaren Spalte die Zeilen nicht sperren und daher keine weitere Transaktion daran hindern, nicht reservierbare Spalten derselben Zeile gleichzeitig zu aktualisieren.
Beispiel: Sie können zulassen, dass Additions- und Subtraktionsvorgänge für eine Bestandsmenge erfolgreich sind, wenn der Lagerbestand für die Anforderung ausreicht und unseren Lagerplatz für 100 Artikel nicht überschreitet. Eine solche Aktualisierung des Mengenwerts kann fortgesetzt werden, ohne durch nicht zugesagte Aktualisierungen blockiert zu werden, solange der Mengenwert größer als Null und kleiner oder gleich 100 ist. Der hinzugefügte oder subtrahierte Betrag wird über einen internen Reservierungsmechanismus reserviert und garantiert, sodass die Transaktion fortgesetzt werden kann, ohne auf andere Transaktionen zu warten, die frühere Reservierungen für die reservierbare Spalte derselben Zeile vorgenommen haben.
CHECK Constraints auf Tabellenebene dürfen sowohl reservierbare als auch nicht reservierbare Spalten enthalten. Eine ausstehende sperrfreie Reservierung, die zum Zeitpunkt der Veröffentlichung einer Aktualisierung genehmigt wurde, kann später gegen eine solche Einschränkung zum Zeitpunkt des Festschreibens der Transaktion verstoßen. Dies kann passieren, wenn die nicht reservierbaren Spalten des Constraints in der Zeit nach der Reservierung aktualisiert wurden, sodass ihre aktuellen Werte den CHECK-Constraint verletzen können. Die Transaktion muss beendet werden, wenn der Constraint verletzt wird. Die nicht reservierbaren Spalten in einem Constraint auf Tabellenebene sind jedoch in der Regel Schwellenwerte, die sehr selten geändert werden. Regalfläche, der erforderliche Saldo in einem Konto und Ausgabenlimits sind Beispiele für solche Schwellenwerte.
Im folgenden Beispiel wird die Tabelle inventory mit der reservierbaren Spalte qty_on_hand erstellt. Der CHECK-Constraint in qty_on_hand gibt an, dass null oder mehr Artikel auf Lager sein müssen und nicht mehr als die Regalkapazität für diesen Artikel für eine Aktualisierung in qty_on_hand vorhanden sein müssen, um fortzufahren, ohne andere Aktualisierungen zu blockieren. Im folgenden Beispiel wird die Tabelle inventory mit den entsprechenden Constraints erstellt, mehrere Datenzeilen eingefügt und das Data Dictionary für die Tabelle inventory abgefragt.
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
Beispiel für mehrere gleichzeitige Aktualisierungen der reservierbaren Spalte:
-
Transaktion 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
Transaktion 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
Transaktion 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
Transaktion 2:
commit; -
Transaktion 3:
commit; -
Transaktion 1:
commit;
Eine reservierbare Spalte kann einer Tabelle mit dem Befehl ALTER TABLE hinzugefügt werden, der ein optionales CHECK-Constraint angibt. Beispiel:
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
Eine reservierbare Spalte kann mit dem folgenden ALTER TABLE-Befehl in eine nicht reservierbare Spalte konvertiert werden. Anwendungen können die Constraints durchsetzen, obwohl die reservierbaren Reservierungen deaktiviert sind. Daher wird das Constraint nicht automatisch gelöscht, wenn eine Spalte in eine nicht reservierbare Spalte konvertiert wird. Je nach Ihren Anforderungen ist das Löschen des Constraints optional. Beispiel:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
Eine nicht reservierbare Spalte kann mit dem Befehl ALTER TABLE in eine reservierbare Spalte konvertiert werden. Beispiel:
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
Zeilen
Eine Zeile ist eine Sammlung von Spalteninformationen, die einem Datensatz in einer Tabelle entsprechen.
Beispiel: In einer Zeile in der Tabelle employees werden die Attribute eines bestimmten Mitarbeiters beschrieben: Angestellten-ID, Nachname, Vorname usw. Nachdem Sie eine Tabelle erstellt haben, können Sie mit SQL Zeilen einfügen, abfragen, löschen und aktualisieren.
Beispiel: CREATE TABLE- und ALTER TABLE-Anweisungen
Die Oracle SQL-Anweisung zum Erstellen einer Tabelle lautet CREATE TABLE.
Beispiel 4-1: CREATE TABLE employees
Das folgende Beispiel zeigt die CREATE TABLE-Anweisung für die Tabelle employees im Beispielschema hr. Die Anweisung gibt Spalten wie employee_id, first_name usw. an und gibt einen Datentyp wie NUMBER oder DATE für jede Spalte an.
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
Beispiel 4-2: ALTER TABLE-Mitarbeiter
Das folgende Beispiel zeigt eine ALTER TABLE-Anweisung, die der Tabelle employees Integritäts-Constraints hinzufügt. Integritäts-Constraints erzwingen Geschäftsregeln und verhindern die Eingabe ungültiger Informationen in Tabellen.
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
Beispiel 4-3: Zeilen in der Mitarbeitertabelle
Die folgende Beispielausgabe zeigt 8 Zeilen und 6 Spalten der Tabelle hr.employees.
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
In der vorherigen Ausgabe werden einige der folgenden wichtigen Eigenschaften von Tabellen, Spalten und Zeilen dargestellt:
-
In einer Zeile der Tabelle werden die Attribute eines Angestellten beschrieben: Name, Gehalt, Abteilung usw. Beispiel: Die erste Zeile in der Ausgabe zeigt den Datensatz für den Mitarbeiter Steven King an.
-
Eine Spalte beschreibt ein Attribut des Mitarbeiters. Im Beispiel ist die Spalte
employee_idder Primärschlüssel. Das bedeutet, dass jeder Mitarbeiter durch die Personalnummer eindeutig identifiziert wird. Zwei Mitarbeiter haben garantiert nicht dieselbe Personalnummer. -
Eine Nicht-Schlüsselspalte kann Zeilen mit identischen Werten enthalten. Im Beispiel ist der Gehaltswert für die Mitarbeiter 101 und 102 identisch:
17000. -
Eine Spalte Fremdschlüssel bezieht sich auf einen Primär- oder eindeutigen Schlüssel in derselben Tabelle oder einer anderen Tabelle. In diesem Beispiel entspricht der Wert von
90indepartment_idder Spaltedepartment_idder Tabelledepartments. -
Ein Feld ist der Schnittpunkt einer Zeile und Spalte. Sie kann nur einen Wert enthalten. Beispiel: Das Feld für die Abteilungs-ID von Mitarbeiter 103 enthält den Wert
60. -
Einem Feld kann ein Wert fehlen. In diesem Fall soll das Feld einen Null-Wert enthalten. Der Wert der Spalte
commission_pctfür Mitarbeiter 100 ist Null, während der Wert im Feld für Mitarbeiter 149.2ist. Eine Spalte lässt Nullwerte zu, es sei denn, für diese Spalte wurde einNOTNULL- oder Primärschlüsselintegritäts-Constraint definiert. In diesem Fall kann keine Zeile ohne einen Wert für diese Spalte eingefügt werden.
Siehe auch: Oracle AI Database SQL Language Reference für CREATE TABLE-Syntax und Semantik
Oracle-Datentypen
Jede Spalte hat einen Datentyp, der mit einem bestimmten Speicherformat, Constraints und einem gültigen Wertebereich verknüpft ist. Der Datentyp eines Wertes verknüpft eine feste Gruppe von Eigenschaften mit dem Wert.
Diese Eigenschaften bewirken, dass Oracle AI Database Werte eines Datentyps anders behandelt als Werte eines anderen Datentyps. Beispiel: Sie können Werte des Datentyps NUMBER multiplizieren, nicht jedoch Werte des Datentyps RAW.
Beim Erstellen einer Tabelle müssen Sie für jede der Spalten einen Datentyp angeben. Jeder Wert, der dann in eine Spalte eingefügt wird, nimmt den Datentyp der Spalte an.
Oracle AI Database bietet mehrere integrierte Datentypen. Die am häufigsten verwendeten Datentypen fallen in die in diesem Abschnitt detaillierten Kategorien.
Weitere wichtige Kategorien von integrierten Typen sind Raw, Large Objects (LOBs) und Collections. PL/SQL verfügt über Datentypen für Konstanten und Variablen, die BOOLEAN, Referenztypen, zusammengesetzte Typen (Datensätze) und benutzerdefinierte Typen umfassen.
-
Zeichendatentypen Zeichendatentypen speichern alphanumerische Daten in Zeichenfolgen. Der häufigste Zeichendatentyp ist
VARCHAR2. Dies ist die effizienteste Option zum Speichern von Zeichendaten. -
Numerische Datentypen Die numerischen Datentypen von Oracle AI Database speichern Fest- und Gleitkommazahlen, Null und Unendlich. Einige numerische Typen speichern auch Werte, die das undefinierte Ergebnis eines Vorgangs sind, der als "keine Zahl" oder
NaNbezeichnet wird. -
Datetime-Datentypen Die Datentypen datetime sind
DATEundTIMESTAMP. Oracle AI Database bietet umfassende Zeitzonenunterstützung für Zeitstempel. -
Rowid-Datentypen Jede in der Datenbank gespeicherte Zeile verfügt über eine Adresse – eine interne Darstellung zur Suche nach dieser Zeile in der Datenbank. Oracle AI Database verwendet einen Datentyp
ROWID, um die Adresse (Zeilen-ID) jeder Zeile in der Datenbank zu speichern. -
Boolescher Datentyp Der Datentyp BOOLEAN umfasst die eindeutigen Wahrheitswerte
TrueundFalse. -
Modelle und Datentypen formatieren Ein Formatmodell ist ein Zeichenliteral, das das Format von Datetime- oder numerischen Daten beschreibt, die in einer Zeichenfolge gespeichert sind. Ein Formatmodell ändert die interne Darstellung des Wertes in der Datenbank nicht.
Siehe:
-
Entwicklerhandbuch für Oracle AI Database SecureFiles und Large Objects
-
Oracle AI Database SQL Language Reference, um mehr über integrierte SQL-Datentypen zu erfahren
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zu PL/SQL-Datentypen
-
Oracle AI Database Development Guide, um zu erfahren, wie die integrierten Datentypen verwendet werden
Zeichendatentypen
Zeichendatentypen speichern alphanumerische Daten in Zeichenfolgen. Der häufigste Zeichendatentyp ist VARCHAR2. Dies ist die effizienteste Option zum Speichern von Zeichendaten.
Die Bytewerte entsprechen dem Schema character encoding, das im Allgemeinen als character set bezeichnet wird. Der Datenbankzeichensatz wird beim Erstellen der Datenbank eingerichtet. Beispiele für Zeichensätze sind 7-Bit ASCII, EBCDIC und Unicode UTF-8.
Die Längensemantik von Zeichendatentypen ist in Byte oder Zeichen messbar. Die Behandlung von Zeichenfolgen als Bytefolge wird als Byte-Semantik bezeichnet. Dies ist der Standardwert für Zeichendatentypen. Die Behandlung von Zeichenfolgen als Folge von Zeichen wird als Zeichensemantik bezeichnet. Ein Zeichen ist ein Codepunkt des Datenbankzeichensatzes.
-
Datentypen VARCHAR2 und CHAR Der Datentyp
VARCHAR2speichert Zeichenliterale mit variabler Länge. Ein Literal ist ein fester Datenwert. -
NCHAR- und NVARCHAR2-Datentypen Die Datentypen
NCHARundNVARCHAR2speichern Unicode-Zeichendaten.
Siehe:
-
Oracle AI Database Globalization Support Guide, um mehr über Zeichensätze zu erfahren
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung für eine kurze Einführung in Datentypen
-
Oracle AI Database Development Guide, um zu erfahren, wie Sie einen Zeichendatentyp auswählen
Datentypen VARCHAR2 und CHAR
Der Datentyp VARCHAR2 speichert Zeichenliterale mit variabler Länge. Ein Literal ist ein fester Datenwert.
Beispiel: 'LILA', 'St. George Island' und '101' sind alle Zeichenliterale. 5001 ist ein numerisches Literal. Zeichenliterale werden in einfache Anführungszeichen gesetzt, damit die Datenbank sie von Schemaobjektnamen unterscheiden kann. Hinweis: In diesem Handbuch werden die Begriffe Textliteral, Zeichenliteral und Zeichenfolge synonym verwendet.
Wenn Sie eine Tabelle mit einer Spalte VARCHAR2 erstellen, geben Sie eine maximale Zeichenfolgenlänge an. In Beispiel 4-1 hat die Spalte last_name den Datentyp VARCHAR2(25). Das bedeutet, dass jeder in der Spalte gespeicherte Name maximal 25 Byte hat.
Für jede Zeile speichert Oracle AI Database jeden Wert in der Spalte als Feld mit variabler Länge, es sei denn, ein Wert überschreitet die maximale Länge. In diesem Fall gibt die Datenbank einen Fehler zurück. Beispiel: Wenn Sie in einem Einzelbyte-Zeichensatz 10 Zeichen für den Spaltenwert last_name in einer Zeile eingeben, speichert die Spalte im Zeilenteil nur 10 Zeichen (10 Byte) und nicht 25 Zeichen. Durch die Verwendung von VARCHAR2 wird der Speicherplatzverbrauch reduziert.
Im Gegensatz zu VARCHAR2 speichert CHAR Zeichenfolgen mit fester Länge. Wenn Sie eine Tabelle mit einer Spalte CHAR erstellen, erfordert die Spalte eine Zeichenfolgenlänge. Der Standardwert ist 1 Byte. Die Datenbank verwendet Leerzeichen, um den Wert auf die angegebene Länge aufzufüllen.
Oracle AI Database vergleicht VARCHAR2-Werte mit nicht aufgefüllter Vergleichssemantik und vergleicht CHAR-Werte mit leer aufgefüllter Vergleichssemantik.
Siehe auch: Oracle AI Database SQL Language Reference für Details zur leer aufgefüllten und nicht aufgefüllten Vergleichssemantik
NCHAR- und NVARCHAR2-Datentypen
Die Datentypen NCHAR und NVARCHAR2 speichern Unicode-Zeichendaten.
Unicode ist ein universell codierter Zeichensatz, der Informationen in jeder Sprache mit einem einzelnen Zeichensatz speichern kann. NCHAR speichert Zeichenfolgen mit fester Länge, die dem nationalen Zeichensatz entsprechen, während NVARCHAR2 Zeichenfolgen mit variabler Länge speichert.
Beim Erstellen einer Datenbank geben Sie einen länderspezifischen Zeichensatz an. Der Zeichensatz der Datentypen NCHAR und NVARCHAR2 muss entweder AL16UTF16 oder UTF8 sein. Beide Zeichensätze verwenden Unicode-Codierung.
Wenn Sie eine Tabelle mit einer Spalte NCHAR oder NVARCHAR2 erstellen, wird die maximale Größe immer in Zeichenlängensemantik angegeben. Zeichenlängensemantik ist die Standard- und nur Längensemantik für NCHAR oder NVARCHAR2.
Siehe auch: Oracle AI Database Globalization Support Guide für Informationen zum Globalisierungssupportfeature von Oracle
Numerische Datentypen
Die numerischen Datentypen von Oracle AI Database speichern Fest- und Gleitkommazahlen, Null und Unendlich. Einige numerische Typen speichern auch Werte, die das undefinierte Ergebnis eines Vorgangs sind, der als "keine Zahl" oder NaN bezeichnet wird.
Oracle AI Database speichert numerische Daten im Format mit variabler Länge. Jeder Wert wird in wissenschaftlicher Notation gespeichert, wobei 1 Byte zum Speichern des Exponenten verwendet wird. Die Datenbank verwendet bis zu 20 Byte, um die Mantisse zu speichern. Dies ist der Teil einer Gleitkommazahl, die ihre signifikanten Stellen enthält. In Oracle AI Database werden keine führenden und nachgestellten Nullen gespeichert.
-
NUMBER-Datentyp Der Datentyp
NUMBERspeichert feste und Gleitkommazahlen. Die Datenbank kann Zahlen in nahezu jeder Größenordnung speichern. Diese Daten sind garantiert zwischen verschiedenen Betriebssystemen portierbar, auf denen Oracle AI Database ausgeführt wird. Der DatentypNUMBERwird in den meisten Fällen empfohlen, in denen Sie numerische Daten speichern müssen. -
Gleitkommazahlen Oracle AI Database stellt zwei numerische Datentypen ausschließlich für Gleitkommazahlen bereit:
BINARY_FLOATundBINARY_DOUBLE.
NUMBER-Datentyp
Der Datentyp NUMBER speichert feste und Gleitkommazahlen. Die Datenbank kann Zahlen in nahezu jeder Größenordnung speichern. Diese Daten sind garantiert zwischen verschiedenen Betriebssystemen portierbar, auf denen Oracle AI Database ausgeführt wird. Der Datentyp NUMBER wird in den meisten Fällen empfohlen, in denen Sie numerische Daten speichern müssen.
Sie geben eine feste Punktzahl im Format NUMBER(p,s) an, wobei p und s auf die folgenden Merkmale verweisen:
-
Nachkommastellen
Die Präzision gibt die Gesamtzahl der Stellen an. Wenn keine Gesamtstellenanzahl angegeben wird, speichert die Spalte die Werte genau so, wie sie von der Anwendung bereitgestellt werden, ohne dass eine Rundung vorgenommen wird.
-
Skalierung
Die Skalierung gibt die Anzahl der Stellen ab dem Dezimalkomma zur letzten signifikanten Stelle an. Positive Skalierung zählt Ziffern rechts vom Dezimalpunkt bis hin zur am wenigsten signifikanten Ziffer. Die negative Skala zählt Ziffern links vom Dezimalpunkt bis hin zur am wenigsten signifikanten Ziffer. Wenn Sie eine Gesamtstellenzahl ohne Skalierung angeben, wie in
NUMBER(6), ist die Skalierung 0.
In Beispiel 4-1 ist die Spalte salary der Typ NUMBER(8,2), sodass die Nachkommastellen 8 und die Nachkommastellen 2 sind. Daher speichert die Datenbank ein Gehalt von 100.000 als 100000.00.
Gleitkommazahlen
Oracle AI Database stellt zwei numerische Datentypen ausschließlich für Gleitkommazahlen bereit: BINARY_FLOAT und BINARY_DOUBLE.
Diese Typen unterstützen alle grundlegenden Funktionen, die vom Datentyp NUMBER bereitgestellt werden. Während NUMBER jedoch Dezimalstellen verwendet, verwenden BINARY_FLOAT und BINARY_DOUBLE binäre Dezimalstellen, was schnellere arithmetische Berechnungen ermöglicht und normalerweise den Speicherbedarf reduziert.
BINARY_FLOAT und BINARY_DOUBLE sind ungefähre numerische Datentypen. Sie speichern ungefähre Darstellungen von Dezimalwerten und nicht exakte Darstellungen. Beispiel: Der Wert 0.1 kann nicht exakt durch BINARY_DOUBLE oder BINARY_FLOAT dargestellt werden. Sie werden häufig für wissenschaftliche Berechnungen verwendet. Ihr Verhalten ähnelt den Datentypen FLOAT und DOUBLE in Java und XMLSchema.
Siehe auch: Oracle AI Database SQL Language Reference, um mehr über Präzision, Skalierung und andere Merkmale numerischer Typen zu erfahren
Datetime-Datentypen
Die Datentypen datetime sind DATE und TIMESTAMP. Oracle AI Database bietet umfassende Zeitzonenunterstützung für Zeitstempel.
-
Datentyp für Datum: Der Datentyp
DATEspeichert Datum und Uhrzeit. Obwohl Datenzeiten in Zeichen- oder Zahlendatentypen dargestellt werden können, verfügtDATEüber spezielle zugeordnete Eigenschaften. -
TIMESTAMP-Datentyp Der Datentyp
TIMESTAMPist eine Erweiterung des DatentypsDATE.
DATE-Datentyp
Der Datentyp DATE speichert Datum und Uhrzeit. Obwohl Datenzeiten in Zeichen- oder Zahlendatentypen dargestellt werden können, verfügt DATE über spezielle zugeordnete Eigenschaften.
Die Datenbank speichert Datumsangaben intern als Zahlen. Datumsangaben werden in Feldern mit fester Länge von jeweils 7 Byte gespeichert. Dies entspricht Jahrhundert, Jahr, Monat, Tag, Stunde, Minute und Sekunde. Hinweis: Datumsangaben unterstützen arithmetische Vorgänge vollständig, sodass Sie Datumsangaben genauso wie Zahlen hinzufügen und von diesen abziehen können.
Die Datenbank zeigt Datumsangaben gemäß dem angegebenen Formatmodell an. Ein Formatmodell ist ein Zeichenliteral, das das Format eines Datetime in einer Zeichenfolge beschreibt. Das Standarddatumsformat ist DD-MON-RR, das Datumsangaben im Format 01-JAN-11 anzeigt.
RR ist ähnlich wie YY (die letzten beiden Ziffern des Jahres), aber das Jahrhundert des Rückgabewertes variiert je nach dem angegebenen zweistelligen Jahr und den letzten beiden Ziffern des aktuellen Jahres. Angenommen, 1999 zeigt die Datenbank 01-JAN-11 an. Wenn das Datumsformat RR verwendet, gibt 11 2011 an, während 11 1911 angibt, wenn das Format YY verwendet. Sie können das Standarddatumsformat sowohl auf Datenbankinstanz- als auch auf Sessionebene ändern.
Oracle AI Database speichert die Zeit im 24-Stunden-Format-HH:MI:SS. Wenn kein Zeitabschnitt eingegeben wird, lautet die Uhrzeit in einem Datumsfeld standardmäßig 00:00:00 A.M. Bei einem reinen Zeiteintrag entspricht der Datumsbereich standardmäßig dem ersten Tag des aktuellen Monats.
Siehe:
-
Oracle AI Database Development Guide für weitere Informationen zu Jahrhunderten und Datumsformatmasken
-
Oracle AI Database SQL Language Reference für Informationen zu Datums-/Uhrzeitformatcodes
-
Oracle AI Database - Entwicklungshandbuch, um zu erfahren, wie arithmetische Vorgänge mit Datetime-Datentypen ausgeführt werden
TIMESTAMP-Datentyp
Der Datentyp TIMESTAMP ist eine Erweiterung des Datentyps DATE.
In TIMESTAMP werden neben den im Datentyp DATE gespeicherten Informationen auch Sekundenbruchteile gespeichert. Der Datentyp TIMESTAMP ist nützlich, um genaue Zeitwerte zu speichern, z.B. in Anwendungen, die die Ereignisreihenfolge verfolgen müssen.
Die DATETIME-Datentypen TIMESTAMP WITH TIME ZONE und TIMESTAMP WITH LOCAL TIME ZONE sind zeitzonenbezogen. Wenn ein Benutzer die Daten auswählt, wird der Wert an die Zeitzone der Benutzersession angepasst. Dieser Datentyp ist nützlich für die Erfassung und Auswertung von Datumsinformationen über geografische Regionen hinweg.
Siehe auch: Oracle AI Database SQL Language Reference enthält Details zur Syntax für das Erstellen und Eingeben von Daten in Zeitstempelspalten
Rowid-Datentypen
Jede in der Datenbank gespeicherte Zeile hat eine Adresse - eine interne Darstellung, um diese Zeile in der Datenbank zu suchen. Oracle AI Database verwendet einen Datentyp ROWID, um die Adresse (Zeilen-ID) jeder Zeile in der Datenbank zu speichern.
Zeilen-IDs fallen in die folgenden Kategorien:
-
Physische ROWIDs speichern die Adressen von Zeilen in Heap-organisierten Tabellen, Tabellenclustern sowie Tabellen- und Indexpartitionen.
-
Logische ROWIDs speichern die Adressen von Zeilen in indexorganisierten Tabellen.
-
Fremd-Zeilen-IDs sind IDs in Fremdtabellen, wie DB2-Tabellen, auf die über ein Gateway zugegriffen wird. Sie sind keine standardmäßigen Oracle AI Database-Rowids.
Ein Datentyp, der als universelle Rowid oder urowid bezeichnet wird, unterstützt alle Arten von Rowids.
-
Verwendung von Rowids Oracle AI Database verwendet intern Rowids für die Erstellung von Indizes.
-
ROWID-Pseudospalte Jede Tabelle in einer Oracle-Datenbank verfügt über eine Pseudospalte namens
ROWID.
Verwendung von Rowids
Oracle AI Database verwendet intern ROWIDs für die Erstellung von Indizes.
Ein Baumindex, der häufigste Typ, enthält eine geordnete Liste von Schlüsseln, die in Bereiche unterteilt sind. Jeder Schlüssel ist mit einer Zeilen-ID verknüpft, die für einen schnellen Zugriff auf die Adresse der zugehörigen Zeile zeigt.
Endbenutzer und Anwendungsentwickler können auch ROWIDs für mehrere wichtige Funktionen verwenden:
-
Zeilen-IDs sind ein schnelles Mittel zum erneuten Zugriff auf eine Zeile, wenn
rowidzuvor mit einer SELECT-Anweisung abgerufen wurde. -
Mit Zeilenkennungen können Sie sehen, wie eine Tabelle organisiert ist.
Sie können zwar Tabellen mit Spalten erstellen, die mit dem Datentyp ROWID definiert wurden, aber Sie sollten keine Zeilen-IDs speichern, damit sie später auf Daten zugreifen können. Die Verwendung von ROWIDs auf diese Weise kann zu unvorhersehbaren oder falschen Ergebnissen führen. Die rowid für eine Zeile kann sich aus mehreren Gründen ändern, die vom Benutzer oder intern von der Datenbank-Engine initiiert werden können. Sie können sich nicht darauf verlassen, dass rowid auf dieselbe Zeile oder eine gültige Zeile verweist, nachdem einer dieser Vorgänge ausgeführt wurde.
ROWID-Pseudospalte
Jede Tabelle in einer Oracle-Datenbank hat eine Pseudospalte mit dem Namen ROWID.
Eine Pseudospalte verhält sich wie eine Tabellenspalte, ist jedoch nicht wirklich in der Tabelle gespeichert. Sie können unter Pseudospalten wählen, können jedoch deren Werte nicht einfügen, aktualisieren oder löschen. Eine Pseudospalte ist auch mit einer SQL-Funktion ohne Argumente vergleichbar. Funktionen ohne Argumente geben im Allgemeinen denselben Wert für jede Zeile in der Ergebnismenge zurück, während Pseudospalten in der Regel einen unterschiedlichen Wert für jede Zeile zurückgeben.
Werte der Pseudospalte ROWID sind Zeichenfolgen, die für die Adresse jeder Zeile stehen. Diese Zeichenfolgen haben den Datentyp ROWID. Diese Pseudospalte ist weder ersichtlich, wenn die Struktur einer Tabelle durch Ausführen von SELECT oder DESCRIBE aufgeführt wird, noch belegt die Pseudospalte Speicherplatz. Die Zeilen-ID jeder Zeile kann jedoch mit einer SQL-Abfrage abgerufen werden, wobei das reservierte Wort ROWID als Spaltenname verwendet wird.
Das folgende Beispiel fragt die Pseudospalte ROWID ab, um die Zeilen-ID der Zeile in der Tabelle employees für Mitarbeiter 100 anzuzeigen:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
Siehe:
-
Oracle AI Database Development Guide, um zu erfahren, wie Zeilen nach Adresse identifiziert werden können
-
Oracle AI Database SQL Language Reference, um Informationen zu Rowid-Typen zu erhalten
Boolescher Datentyp
Der BOOLEAN-Datentyp umfasst die eindeutigen Wahrheitswerte True und False.
Sofern nicht durch ein NOT NULL-Constraint verboten, unterstützt der boolesche Datentyp auch den Truth-Wert UNKNOWN als Nullwert. Sie können den booleschen Datentyp überall dort verwenden, wo der Datentyp in der Oracle SQL-Syntax angezeigt wird.
Siehe:
- Kurzreferenz zu Oracle AI Database SQL Language für Informationen zum booleschen Datentyp.
Modelle und Datentypen formatieren
Ein Formatmodell ist ein Zeichenliteral, das das Format von Datetime- oder numerischen Daten beschreibt, die in einer Zeichenfolge gespeichert ist. Ein Formatmodell ändert die interne Darstellung des Wertes in der Datenbank nicht.
Wenn Sie die Zeichenfolge in ein Datum (Date) oder eine Zahl (Number)) konvertieren, bestimmt ein Formatmodell, wie die Datenbank die Zeichenfolge interpretiert. In SQL können Sie ein Formatmodell als Argument der Funktionen TO_CHAR und TO_DATE verwenden, um einen Wert zu formatieren, der von der Datenbank zurückgegeben wird, oder um einen Wert zu formatieren, der in der Datenbank gespeichert werden soll.
Die folgende Anweisung wählt die Gehälter der Mitarbeiter in Abteilung 80 und verwendet die Funktion TO_CHAR, um diese Gehälter in Zeichenwerte mit dem durch das Zahlenformatmodell '$99,990.99' angegebenen Format zu konvertieren:
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
Im folgenden Beispiel wird ein Einstellungsdatum mit der Funktion TO_DATE mit der Formatmaske 'YYYY MM DD' aktualisiert, um die Zeichenfolge '1998 05 20' in einen DATE-Wert zu konvertieren:
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
  3  WHERE last_name = 'Hunold';
Siehe auch: Oracle AI Database SQL Language Reference, um mehr über Formatmodelle zu erfahren
Integritätseinschränkungen
Ein Integritäts-Constraint ist eine benannte Regel, mit der die Werte für eine oder mehrere Spalten in einer Tabelle eingeschränkt werden.
Datenintegritätsregeln verhindern eine ungültige Dateneingabe in Tabellen. Außerdem können Constraints das Löschen einer Tabelle verhindern, wenn bestimmte Abhängigkeiten vorhanden sind.
Wenn ein Constraint aktiviert ist, prüft die Datenbank die Daten bei der Eingabe oder Aktualisierung. Oracle AI Database verhindert, dass Daten eingegeben werden, die nicht dem Constraint entsprechen. Wenn ein Constraint deaktiviert ist, können Daten, die nicht dem Constraint entsprechen, mit Oracle AI Database in die Datenbank eingegeben werden.
In Beispiel 4-1 gibt die CREATE TABLE-Anweisung NOT NULL-Constraints für die Spalten last_name, email, hire_date und job_id an. Die Constraint-Klauseln identifizieren die Spalten und die Bedingungen des Constraints. Diese Constraints stellen sicher, dass die angegebenen Spalten keine Nullwerte enthalten. Beispiel: Wenn Sie versuchen, einen neuen Mitarbeiter ohne Tätigkeits-ID einzufügen, wird ein Fehler ausgegeben.
Sie können ein Constraint erstellen, wenn oder nachdem Sie eine Tabelle erstellt haben. Sie können Constraints bei Bedarf vorübergehend deaktivieren. Die Datenbank speichert Constraints im Data Dictionary.
Siehe:
-
"Datenintegrität", um mehr über Integritäts-Constraints zu erfahren
-
"Überblick über das Data Dictionary" mit Informationen zum Data Dictionary
-
Oracle AI Database SQL Language Reference zum Erlernen von SQL-Constraint-Klauseln
Tabellenspeicher
Oracle AI Database verwendet ein Datensegment in einem Tablespace, um Tabellendaten zu speichern.
Ein Segment enthält Extents, die aus Datenblöcken bestehen. Das Datensegment für eine Tabelle (oder ein Clusterdatensegment für ein Tabellencluster) befindet sich entweder im Standard-Tablespace des Tabellenbesitzers oder in einem Tablespace, der in der CREATE TABLE-Anweisung benannt ist.
-
Tabellenorganisation Standardmäßig ist eine Tabelle als Heap organisiert. Das bedeutet, dass die Datenbank Zeilen dort platziert, wo sie am besten passen, und nicht in einer benutzerdefinierten Reihenfolge. Daher ist eine Heap-organisierte Tabelle eine ungeordnete Collection von Zeilen.
-
Zeilenspeicher Die Datenbank speichert Zeilen in Datenblöcken. Jede Zeile einer Tabelle, die Daten für weniger als 256 Spalten enthält, ist in einem oder mehreren Zeilenteilen enthalten.
-
Zeilen-IDs Eine Zeilen-ID ist eine physische 10-Byte-Adresse einer Zeile.
-
Speicherung von Nullwerten Ein Null ist das Fehlen eines Wertes in einer Spalte. Nullwerte geben an, dass Daten fehlen, unbekannt oder nicht anwendbar sind. Siehe auch: "Benutzersegmente", um mehr über die Segmenttypen und deren Erstellung zu erfahren.
Tabellenorganisation
Standardmäßig wird eine Tabelle als Heap organisiert. Dies bedeutet, dass die Datenbank Zeilen an die Stelle setzt, an die sie am besten passen, anstatt sie in einer benutzerdefinierten Reihenfolge zu platzieren. Daher ist eine Heap-organisierte Tabelle eine ungeordnete Collection von Zeilen. Hinweis: Indexorganisierte Tabellen verwenden ein anderes Organisationsprinzip.
Wenn Benutzer Zeilen hinzufügen, platziert die Datenbank die Zeilen im ersten verfügbaren freien Speicherplatz im Datensegment. Zeilen werden nicht in der Reihenfolge abgerufen, in der sie eingefügt wurden.
Die Tabelle hr.departments ist eine Heap-organisierte Tabelle. Es enthält Spalten für Abteilungskennung, Name, Managerkennung und Standortkennung. Wenn Zeilen eingefügt werden, speichert die Datenbank sie überall dort, wo sie passen. Ein Datenblock im Tabellensegment kann die nicht sortierten Zeilen enthalten, die im folgenden Beispiel angezeigt werden:
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
Die Spaltenreihenfolge ist für alle Zeilen in einer Tabelle identisch. Die Datenbank speichert Spalten in der Regel in der Reihenfolge, in der sie in der CREATE TABLE-Anweisung aufgeführt wurden. Diese Reihenfolge ist jedoch nicht garantiert. Beispiel: Wenn eine Tabelle eine Spalte vom Typ LONG enthält, speichert Oracle AI Database diese Spalte immer zuletzt in der Zeile. Wenn Sie einer Tabelle eine neue Spalte hinzufügen, wird die neue Spalte die letzte gespeicherte Spalte.
Eine Tabelle kann eine virtuelle Spalte enthalten, die im Gegensatz zu normalen Spalten keinen Speicherplatz auf der Festplatte belegt. Die Datenbank leitet die Werte in einer virtuellen Spalte bei Bedarf ab, indem sie eine Gruppe von benutzerdefinierten Ausdrücken oder Funktionen berechnet. Sie können virtuelle Spalten indexieren, Statistiken zu diesen Spalten sammeln und Integritäts-Constraints erstellen. Daher sind virtuelle Spalten ähnlich wie nicht virtuelle Spalten.
Siehe:
-
Oracle AI Database SQL Language Reference, um mehr über virtuelle Spalten zu erfahren
Zeilenspeicher
Die Datenbank speichert Zeilen in Datenblöcken. Jede Zeile einer Tabelle, die Daten für weniger als 256 Spalten enthält, ist in einem oder mehreren Zeilenteilen enthalten.
Wenn möglich speichert Oracle AI Database jede Zeile als ein Zeilenstück. Wenn jedoch nicht alle Zeilendaten in einen einzelnen Datenblock eingefügt werden können oder eine Aktualisierung einer vorhandenen Zeile dazu führt, dass die Zeile über ihren Datenblock hinausgeht, speichert die Datenbank die Zeile mit mehreren Zeilenteilen.
Zeilen in einem Tabellencluster enthalten dieselben Informationen wie Zeilen in nicht geclusterten Tabellen. Darüber hinaus enthalten Zeilen in einem Tabellencluster Informationen, die den Cluster-Schlüssel referenzieren, zu dem sie gehören.
Siehe auch: "Datenblockformat", um mehr über die Komponenten eines Datenblocks zu erfahren
Zeilen-IDs von Zeilen-Stücken
Eine rowid ist eine physische 10-Byte-Adresse einer Zeile.
Jede Zeile in einer Heap-organisierten Tabelle hat eine eindeutige Zeilen-ID für diese Tabelle, die der physischen Adresse eines Zeilenteils entspricht. Bei Tabellenclustern können Zeilen in verschiedenen Tabellen, die sich im selben Datenblock befinden, dieselbe Zeilen-ID aufweisen.
Oracle AI Database verwendet intern ROWIDs für die Erstellung von Indizes. Beispiel: Jeder Schlüssel in einem Baumindex ist mit einer Zeilen-ID verknüpft, die auf die Adresse der zugehörigen Zeile für schnellen Zugriff verweist. Physische ROWIDs bieten den schnellstmöglichen Zugriff auf eine Tabellenzeile, sodass die Datenbank eine Zeile in nur einem I/O abrufen kann.
Siehe:
-
"Zeilenformat", um mehr über die Struktur einer Zeilen-ID zu erfahren
-
"Überblick über B*-Baumindizes", um mehr über die Typen und die Struktur von B*-Baumindizes zu erfahren
Speicherung von Nullwerten
Ein Null ist das Fehlen eines Wertes in einer Spalte. Nullwerte geben an, dass Daten fehlen, unbekannt oder nicht anwendbar sind.
Nullwerte werden in der Datenbank gespeichert, wenn sie zwischen Spalten mit Datenwerten liegen. In diesen Fällen benötigen sie 1 Byte, um die Länge der Spalte (null) zu speichern. Nachgestellte Nullwerte in einer Zeile erfordern keinen Speicher, da ein neuer Zeilenheader signalisiert, dass die verbleibenden Spalten in der vorherigen Zeile Null sind. Beispiel: Wenn die letzten drei Spalten einer Tabelle Null sind, werden keine Daten für diese Spalten gespeichert.
Siehe auch: Oracle AI Database SQL Language Reference, um mehr über Nullwerte zu erfahren
Tabellenkomprimierung
Die Datenbank kann die Tabellenkomprimierung verwenden, um den für die Tabelle erforderlichen Speicherplatz zu reduzieren.
Die Komprimierung spart Plattenspeicherplatz, reduziert die Speicherauslastung im Datenbankpuffercache und beschleunigt in einigen Fällen die Abfrageausführung. Die Tabellenkomprimierung ist für Datenbankanwendungen transparent.
-
Basic Table Compression and Advanced Row Compression Dictionary-basierte Tabellenkomprimierung bietet gute Komprimierungsverhältnisse für Heap-organisierte Tabellen.
-
Hybrid Columnar Compression Mit Hybrid Columnar Compression speichert die Datenbank dieselbe Spalte für eine Gruppe von Zeilen zusammen. Der Datenblock speichert keine Daten im Zeilenformat, sondern verwendet eine Kombination aus Zeilen- und Spaltenmethoden.
-
Memory Speed Hybrid Columnar Compression Memory Speed Hybrid Columnar Compression führt Formate für On-Disk-Komprimierungseinheiten ein, die mit Speichergeschwindigkeit verarbeitet werden können.
Grundlegende Tabellenkomprimierung und erweiterte Zeilenkomprimierung
Dictionary-basierte Tabellenkomprimierung bietet gute Komprimierungsverhältnisse für Heap-organisierte Tabellen.
Oracle AI Database unterstützt die folgenden Arten der Dictionary-basierten Tabellenkomprimierung:
-
Grundlegende Tabellenkomprimierung
Diese Art der Komprimierung ist für Bulk Load-Vorgänge vorgesehen. Die Datenbank komprimiert keine Daten, die mit herkömmlicher DML geändert wurden. Sie müssen Direct Path INSERT-Vorgänge,
ALTER TABLE . . . MOVE-Vorgänge oder Online-Tabellenneudefinition verwenden, um eine grundlegende Tabellenkomprimierung zu erreichen. -
Erweiterte Zeilenkomprimierung
Diese Art der Komprimierung ist für OLTP-Anwendungen gedacht und komprimiert Daten, die von einem beliebigen SQL-Vorgang bearbeitet werden. Die Datenbank erreicht ein wettbewerbsfähiges Komprimierungsverhältnis, während die Anwendung DML in etwa der gleichen Zeit wie DML in einer unkomprimierten Tabelle ausführen kann.
Bei den oben genannten Komprimierungstypen speichert die Datenbank komprimierte Zeilen im Zeilen-Hauptformat. Alle Spalten einer Zeile werden zusammen gespeichert, gefolgt von allen Spalten der nächsten Zeile usw. Die Datenbank ersetzt doppelte Werte durch einen kurzen Verweis auf eine Symboltabelle, die am Anfang des Blocks gespeichert ist. Daher werden Informationen, die von der Datenbank zur Neuerstellung der unkomprimierten Daten benötigt werden, im Datenblock selbst gespeichert.
Komprimierte Datenblöcke ähneln normalen Datenblöcken. Die meisten Datenbankfeatures und -funktionen, die an regulären Datenblöcken arbeiten, arbeiten auch an komprimierten Blöcken.
Sie können die Komprimierung auf Tablespace-, Tabellen-, Partitions- oder Unterpartitionsebene deklarieren. Wenn die Tabellen auf Tablespace-Ebene angegeben wird, werden alle in dem Tablespace erstellten Tabellen standardmäßig komprimiert.
Beispiel 4-4: Komprimierung auf Tabellenebene
Die folgende Anweisung wendet die erweiterte Zeilenkomprimierung auf die Tabelle orders an:
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;Beispiel 4-5: Komprimierung auf Partitionsebene
Das folgende Beispiel einer partiellen CREATE TABLE-Anweisung gibt die erweiterte Zeilenkomprimierung für eine Partition und die grundlegende Tabellenkomprimierung für die andere Partition an:
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
Siehe:
-
"Zeilenformat", um zu erfahren, wie Werte in einer Zeile gespeichert werden
-
"Datenblockkomprimierung", um mehr über das Format komprimierter Datenblöcke zu erfahren
-
Oracle AI Database Utilities, um mehr über die Verwendung von SQL*Loader für Direct Path-Ladevorgänge zu erfahren
-
Oracle AI Database Administrator's Guide und Oracle AI Database Performance Tuning Guide, um mehr über die Tabellenkomprimierung zu erfahren
Hybrid Columnar Compression
Bei Hybrid Columnar Compression speichert die Datenbank dieselbe Spalte für eine Gruppe von Zeilen zusammen. Der Datenblock speichert keine Daten im Zeilenformat, sondern verwendet eine Kombination aus Zeilen- und Spaltenmethoden.
Durch das gemeinsame Speichern von Spaltendaten mit demselben Datentyp und ähnlichen Eigenschaften werden die durch die Komprimierung erzielten Speichereinsparungen erheblich erhöht. Die Datenbank komprimiert Daten, die von einem SQL-Vorgang bearbeitet werden, obwohl die Komprimierungsebenen für Direct Path-Ladevorgänge höher sind. Datenbankvorgänge arbeiten transparent mit komprimierten Objekten, sodass keine Anwendungsänderungen erforderlich sind.
Hinweis: Hybrid Column Compression und In-Memory Column Store (IM-Spaltenspeicher) sind eng miteinander verknüpft. Der Hauptunterschied besteht darin, dass Hybrid Column Compression den Plattenspeicher optimiert, während der IM-Spaltenspeicher den Arbeitsspeicher optimiert.
-
Typen der Hybrid Columnar Compression Wenn Ihr zugrunde liegender Speicher die Hybrid Columnar Compression unterstützt, können Sie je nach Ihren Anforderungen verschiedene Komprimierungstypen angeben.
-
Hybrid Columnar Compression von Komprimierungseinheiten verwendet ein logisches Konstrukt, das als Komprimierungseinheit bezeichnet wird, um eine Reihe von Zeilen zu speichern.
-
Hybrid Columnar Compression von DML und Hybrid Columnar Compression hat Auswirkungen auf Zeilensperren in verschiedenen Typen von DML-Vorgängen. Siehe auch: "In-Memory-Bereich", um mehr über den IM-Spaltenspeicher zu erfahren
Hybrid Columnar Compression
Wenn Ihr zugrunde liegender Speicher Hybrid Columnar Compression unterstützt, können Sie je nach Ihren Anforderungen verschiedene Komprimierungstypen angeben.
Die Komprimierungsoptionen sind:
-
Warehouse-Komprimierung
Diese Art der Komprimierung ist optimiert, um Speicherplatz zu sparen, und ist für Data Warehouse-Anwendungen vorgesehen.
-
Archivkomprimierung
Diese Art der Komprimierung ist für maximale Komprimierungsebenen optimiert und ist für historische Daten und Daten gedacht, die sich nicht ändern.
Hybrid Columnar Compression ist für Data Warehousing- und Decision Support-Anwendungen auf Oracle Exadata-Speicher optimiert. Oracle Exadata maximiert die Performance von Abfragen auf Tabellen, die mit Hybrid Columnar Compression komprimiert werden, und nutzt dabei die Verarbeitungsleistung, den Arbeitsspeicher und die Infiniband-Netzwerkbandbreite, die für den Oracle Exadata-Speicherserver von wesentlicher Bedeutung sind.
Andere Oracle-Speichersysteme unterstützen Hybrid Columnar Compression und bieten dieselben Speicherplatzeinsparungen wie bei Oracle Exadata-Speicher, bieten jedoch nicht die gleiche Abfrageperformance. Für diese Speichersysteme ist Hybrid Columnar Compression ideal für die datenbankinterne Archivierung älterer Daten, auf die selten zugegriffen wird.
Komprimierungseinheiten
Hybrid Columnar Compression verwendet ein logisches Konstrukt, das als Komprimierungseinheit bezeichnet wird, um eine Reihe von Zeilen zu speichern.
Wenn Sie Daten in eine Tabelle laden, speichert die Datenbank Zeilengruppen im Spaltenformat, wobei die Werte für jede Spalte gespeichert und zusammen komprimiert werden. Nachdem die Datenbank die Spaltendaten für eine Gruppe von Zeilen komprimiert hat, passt die Datenbank die Daten in die Komprimierungseinheit an.
Beispiel: Sie wenden Hybrid Columnar Compression auf eine daily_sales-Tabelle an. Am Ende eines jeden Tages füllen Sie die Tabelle mit Artikeln und der verkauften Nummer auf, wobei die Artikel-ID und das Datum einen zusammengesetzten Primärschlüssel bilden. Die folgende Tabelle zeigt eine Teilmenge der Zeilen in daily_sales.
Tabelle 3 Beispieltabelle daily_sales
| Item_ID | Datum | Num_Sold | Shipped_From | Wiederauffüllen |
|---|---|---|---|---|
| 1.000 | 01-JUN-18 | 2 | WAREHOUSE1 | J |
| 1.001 | 01-JUN-18 | 0 | WAREHOUSE3 | N |
| 1.002 | 01-JUN-18 | 1 | WAREHOUSE3 | N |
| 1.003 | 01-JUN-14 | 0 | WAREHOUSE2 | N |
| 1.004 | 01-JUN-18 | 2 | WAREHOUSE1 | N |
| 1.005 | 01-JUN-18 | 1 | WAREHOUSE2 | N |
Angenommen, diese Teilmenge von Zeilen wird in einer Komprimierungseinheit gespeichert. Hybrid Columnar Compression speichert die Werte für jede Spalte zusammen und verwendet dann mehrere Algorithmen, um jede Spalte zu komprimieren. Die Datenbank wählt die Algorithmen basierend auf einer Vielzahl von Faktoren aus, einschließlich des Datentyps der Spalte, der Kardinalität der tatsächlichen Werte in der Spalte und der vom Benutzer gewählten Komprimierungsebene.
Wie in der folgenden Grafik dargestellt, kann jede Komprimierungseinheit mehrere Datenblöcke umfassen. Die Werte für eine bestimmte Spalte können mehrere Blöcke umfassen.
Abbildung 7: Kompressionseinheit
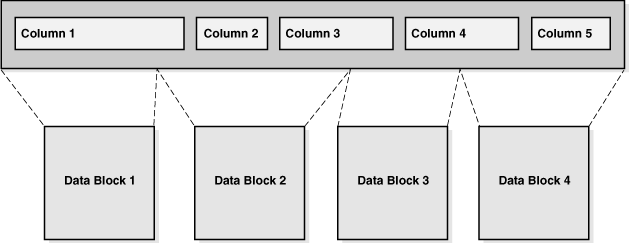
Beschreibung der Abbildung sagug004.gif
Wenn die Hybrid Columnar Compression nicht zu Speicherplatzeinsparungen führt, speichert die Datenbank die Daten im Format DBMS_COMPRESSION.COMP_BLOCK. In diesem Fall wendet die Datenbank die OLTP-Komprimierung auf die Blöcke an, die sich in einem Hybrid Columnar Compression-Segment befinden.
Siehe:
-
Benutzerhandbuch zu Lizenzinformationen für Oracle AI Database, um mehr über die Lizenzierungsanforderungen für Hybrid Columnar Compression zu erfahren
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Sie Hybrid Columnar Compression verwenden
-
Oracle AI Database SQL Language Reference für
CREATE TABLE-Syntax und Semantik -
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zum
DBMS_COMPRESSION-Package
DML und Hybrid Columnar Compression
Hybrid Columnar Compression hat Auswirkungen auf die Zeilensperrung in verschiedenen Typen von DML-Vorgängen.
Direct Path-Ladevorgänge und herkömmliche Einfügevorgänge
Beim Laden von Daten in eine Tabelle, die Hybrid Columnar Compression verwendet, können Sie konventionelle Einfügungen oder Direct Path-Ladevorgänge verwenden. Direct Path-Ladevorgänge sperren die gesamte Tabelle, wodurch der gleichzeitige Zugriff verringert wird.
Ab Oracle Database 12c Release 2 (12.2) wird Unterstützung für herkömmliche Array-Einfügungen im Hybrid Columnar Compression-Format hinzugefügt. Die Vorteile herkömmlicher Array-Einsätze sind:
-
Eingefügte Zeilen verwenden Sperren auf Zeilenebene, was den gleichzeitigen Zugriff erhöht.
-
Automatic Data Optimization (ADO) und Heat Map unterstützen Hybrid Columnar Compression für Richtlinien auf Zeilenebene. Daher kann die Datenbank Hybrid Columnar Compression für berechtigte Blöcke verwenden, selbst wenn DML-Aktivitäten an anderen Segmentteilen stattfinden.
Wenn die Anwendung herkömmliche Array-Einfügungen verwendet, speichert Oracle AI Database die Zeilen in Komprimierungseinheiten, wenn die folgenden Bedingungen erfüllt sind:
-
Die Tabelle wird in einem ASSM-Tablespace gespeichert.
-
Die Kompatibilitätsebene ist 12.2.0.1 oder höher.
-
Die Tabellendefinition erfüllt die vorhandenen Constraints der Hybrid Columnar Compression-Tabelle, einschließlich keiner Spalten vom Typ
LONGund keiner Zeilenabhängigkeiten.
Herkömmliche Einfügungen generieren Redo und Undo. Daher werden Komprimierungseinheiten, die mit herkömmlichen DML-Anweisungen erstellt werden, zusammen mit der DML zurückgerollt oder festgeschrieben. Die Datenbank führt die Indexverwaltung automatisch aus, ebenso wie bei Zeilen, die in herkömmlichen Datenblöcken gespeichert sind.
Ab Oracle AI Database 26ai ermöglicht Automatic Storage Compression es Oracle AI Database, Daten zunächst in ein unkomprimiertes Format zu laden und dann die Zeilen schrittweise im Hintergrund in das Format Hybrid Columnar Compression zu verschieben. Dies ist für Benutzer transparent und verbessert gleichzeitig die ETL-Performance und sorgt für eine schnelle Abfrageperformance.
Aktualisierungen und Löschvorgänge
Standardmäßig sperrt die Datenbank alle Zeilen in der Komprimierungseinheit, wenn eine Aktualisierung oder Löschung auf eine Zeile in der Einheit angewendet wird. Um dieses Problem zu vermeiden, können Sie festlegen, dass Sperren auf Zeilenebene für eine Tabelle aktiviert werden. In diesem Fall sperrt die Datenbank nur Zeilen, die vom Aktualisierungs- oder Löschvorgang betroffen sind.
Siehe:
-
Oracle AI Database Administrator's Guide, in dem Sie erfahren, wie herkömmliche Einfügungen durchgeführt werden
-
Oracle AI Database SQL Language Reference, um mehr über die
INSERT-Anweisung zu erfahren -
Oracle AI Database SQL Language Reference für Informationen zur Verwendung des Hint
COMPRESS_IMMEDIATE -
Oracle AI Database VLDB and Partitioning Guide für Informationen zur Verwendung der automatischen Speicherkomprimierung
Speichergeschwindigkeit Hybrid Columnar Compression
Memory Speed Hybrid Columnar Compression führt Formate von On-Disk-Komprimierungseinheiten ein, die mit Speichergeschwindigkeit verarbeitet werden können.
Ähnlich wie bei Hybrid Columnar Compression eignet sich Memory Speed Hybrid Columnar Compression für Data Warehousing-Umgebungen. Es transformiert die Daten in ein spaltenorientiertes Format und komprimiert sie während des Dataloads. Der Hauptunterschied besteht darin, dass Memory Speed Hybrid Columnar Compression dasselbe spezielle Spaltenformat verwendet wie der In-Memory-Spaltenspeicher und CELLMEMORY im Exadata-Flashcache. So werden in allen Speicherebenen Hochgeschwindigkeits-Spaltenscans und effizientes Spaltencaching erreicht. Darüber hinaus sind Memory Speed Hybrid Columnar Compression-Einheiten deutlich größer als Hybrid-Säulenkompressionseinheiten, was eine effektive Verwendung des In-Memory-Säulenformats auf der Festplatte ermöglicht.
Die Hybrid-Spaltenkomprimierung der Speichergeschwindigkeit wird als Erweiterung der Hybrid-Spaltenkomprimierung mit dem Befehl CREATE TABLE aktiviert, indem das Schlüsselwort MEMSPEED hinzugefügt wird.
Beispiel 4-6: Hybrid Columnar Compression mit Speichergeschwindigkeit
Im folgenden Beispiel wird die Tabelle orders mit aktivierter Hybrid-Spaltenkomprimierung für die Speichergeschwindigkeit erstellt:
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;Hinweis: Weitere Informationen finden Sie in der Oracle AI Database SQL Language Reference.
Übersicht über Tabellencluster
Ein Tabellencluster ist eine Gruppe von Tabellen, die gemeinsame Spalten verwenden und zugehörige Daten in denselben Blöcken speichern.
Wenn Tabellen geclustert sind, kann ein einzelner Datenblock Zeilen aus mehreren Tabellen enthalten. Beispiel: In einem Block können Zeilen aus den Tabellen employees und departments statt nur aus einer einzelnen Tabelle gespeichert werden.
Der Clusterschlüssel ist die Spalte(n), die in den geclusterten Tabellen gemeinsam verwendet werden. Beispiel: Die Tabellen employees und departments verwenden die Spalte department_id gemeinsam. Sie geben den Cluster-Schlüssel beim Erstellen des Tabellenclusters und beim Erstellen jeder Tabelle an, die dem Tabellencluster hinzugefügt wird.
Der Cluster-Schlüsselwert ist der Wert der Cluster-Schlüsselspalten für eine bestimmte Gruppe von Zeilen. Alle Daten, die denselben Clusterschlüsselwert enthalten, wie department_id=20, werden physisch zusammen gespeichert. Jeder Cluster-Schlüsselwert wird nur einmal im Cluster und im Cluster-Index gespeichert, unabhängig davon, wie viele Zeilen verschiedener Tabellen den Wert enthalten.
Angenommen, ein HR-Manager hat zwei Bücherregale: eine mit Feldern von Mitarbeiterordnern und die andere mit Feldern von Abteilungsordnern. Benutzer fragen häufig nach den Ordnern für alle Mitarbeiter in einer bestimmten Abteilung. Um das Abrufen zu erleichtern, ordnet der Manager alle Felder in einem einzigen Buchkoffer um. Sie dividiert die Felder durch die Abteilungskennung. Somit befinden sich alle Ordner für Mitarbeiter in Abteilung 20 und der Ordner für Abteilung 20 selbst in einem Feld; die Ordner für Mitarbeiter in Abteilung 100 und der Ordner für Abteilung 100 sind in einem anderen Feld usw.
Clustering-Tabellen sollten in Betracht gezogen werden, wenn sie hauptsächlich abgefragt (aber nicht geändert) werden und Datensätze aus den Tabellen häufig zusammen abgefragt oder verknüpft werden. Da Tabellencluster zugehörige Zeilen verschiedener Tabellen in denselben Datenblöcken speichern, bieten korrekt verwendete Tabellencluster die folgenden Vorteile gegenüber nicht geclusterten Tabellen:
-
Datenträger-I/O wird für Joins von geclusterten Tabellen reduziert.
-
Die Zugriffszeit verbessert sich für Joins von geclusterten Tabellen.
-
Zum Speichern zugehöriger Tabellen- und Indexdaten ist weniger Speicher erforderlich, da der Cluster-Schlüsselwert nicht wiederholt für jede Zeile gespeichert wird.
Clustering-Tabellen sind in den folgenden Situationen normalerweise nicht geeignet:
-
Die Tabellen werden häufig aktualisiert.
-
Für die Tabellen ist häufig ein vollständiger Table Scan erforderlich.
-
Die Tabellen müssen abgeschnitten werden.
-
Überblick über indizierte Cluster Ein Indexcluster ist ein Tabellencluster, das einen Index zum Suchen von Daten verwendet. Der Clusterindex ist ein B*-Baumindex für den Clusterschlüssel. Bevor Zeilen in geclusterte Tabellen eingefügt werden können, muss ein Clusterindex erstellt werden.
-
Überblick über Hashcluster Ein Hashcluster ähnelt einem indizierten Cluster. Der Indexschlüssel wird jedoch durch eine Hashfunktion ersetzt. Kein separater Clusterindex vorhanden. In einem Hash Cluster sind die Daten der Index.
Indexierte Cluster - Überblick
Ein Indexcluster ist ein Tabellencluster, das einen Index zum Suchen von Daten verwendet. Der Clusterindex ist ein B*-Baumindex für den Clusterschlüssel. Bevor Zeilen in geclusterte Tabellen eingefügt werden können, muss ein Clusterindex erstellt werden.
Beispiel 4-7: Tabellencluster und zugehörigen Index erstellen
Angenommen, Sie erstellen das Cluster employees_departments_cluster mit dem Clusterschlüssel department_id, wie im folgenden Beispiel dargestellt:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
Da die HASHKEYS-Klausel nicht angegeben ist, ist employees_departments_cluster ein indiziertes Cluster. Im vorherigen Beispiel wird ein Index mit dem Namen idx_emp_dept_cluster für den Clusterschlüssel department_id erstellt.
Beispiel 4-8: Tabellen in einem indizierten Cluster erstellen
Sie erstellen die Tabellen employees und departments im Cluster und geben die Spalte department_id wie folgt als Clusterschlüssel an (die Auslassungspunkte markieren die Stelle, an der sich die Spaltenspezifikation befindet):
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
Angenommen, Sie fügen Zeilen zu den Tabellen employees und departments hinzu. Die Datenbank speichert alle Zeilen für jede Abteilung aus den Tabellen employees und departments physisch in denselben Datenblöcken. Die Datenbank speichert die Zeilen in einem Heap und sucht sie mit dem Index. In Abbildung 4-8 ist das Tabellencluster employees_departments_cluster dargestellt, das employees und departments enthält. Die Datenbank speichert Datensätze für die Mitarbeiter in Abteilung 20 zusammen, Abteilung 110 zusammen usw. Wenn die Tabellen nicht geclustert sind, stellt die Datenbank nicht sicher, dass die zugehörigen Zeilen zusammen gespeichert werden.
Abbildung 8: Gruppierte Tabellendaten
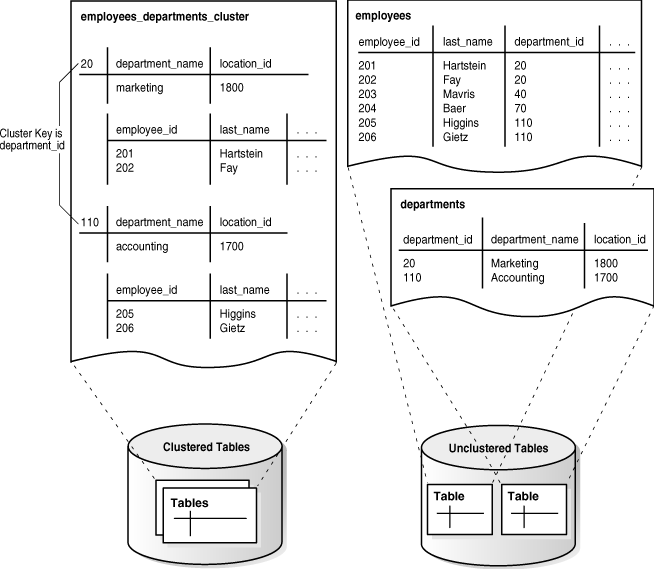
Beschreibung der Abbildung cncpt023.gif
Der B*-Baumclusterindex verknüpft den Clusterschlüsselwert mit der Datenbankblockadresse (DBA) des Blocks, der die Daten enthält. Beispiel: Der Indexeintrag für Schlüssel 20 zeigt die Adresse des Blocks, der Daten für Mitarbeiter in Abteilung 20 enthält:
20,AADAAAA9dDer Clusterindex wird separat verwaltet, genau wie ein Index für eine nicht geclusterte Tabelle. Er kann in einem separaten Tablespace vom Tabellencluster vorhanden sein.
Siehe:
-
Oracle AI Database - Administratordokumentation zum Erstellen und Verwalten indexierter Cluster
-
Oracle AI Database SQL Language Reference für
CREATE CLUSTER-Syntax und Semantik
Überblick über Hash-Cluster
Ein Hashcluster ähnelt einem indizierten Cluster. Der Indexschlüssel wird jedoch durch eine Hashfunktion ersetzt. Kein separater Clusterindex vorhanden. In einem Hash Cluster sind die Daten der Index.
Bei einer indizierten Tabelle oder einem indizierten Cluster sucht Oracle AI Database Tabellenzeilen anhand von Schlüsselwerten, die in einem separaten Index gespeichert sind. Um eine Zeile in einer indizierten Tabelle oder einem Tabellencluster zu suchen oder zu speichern, muss die Datenbank mindestens zwei I/Os ausführen:
-
Ein oder mehrere I/Os zum Suchen oder Speichern des Schlüsselwerts im Index
-
Ein anderes I/O zum Lesen oder Schreiben der Zeile im Tabellen- oder Tabellencluster
Um eine Zeile in einem Hash Cluster zu suchen oder zu speichern, wendet Oracle AI Database die Hash-Funktion auf den Cluster-Schlüsselwert der Zeile an. Der resultierende Hash-Wert entspricht einem Datenblock im Cluster, den die Datenbank im Namen der ausgegebenen Anweisung liest oder schreibt.
Hashing ist eine optionale Möglichkeit, Tabellendaten zu speichern, um die Performance des Datenabrufs zu verbessern. Hash-Cluster können von Vorteil sein, wenn die folgenden Bedingungen erfüllt sind:
-
Eine Tabelle wird viel häufiger abgefragt als geändert.
-
Die Hashschlüsselspalte wird häufig mit Gleichheitsbedingungen abgefragt, z.B.
WHERE department_id=20. Bei solchen Abfragen wird der Cluster-Schlüsselwert gehasht. Der Hash-Schlüsselwert verweist direkt auf den Plattenbereich, in dem die Zeilen gespeichert sind. -
Sie können die Anzahl der Hash-Schlüssel und die Größe der mit jedem Schlüsselwert gespeicherten Daten vernünftigerweise erraten.
-
Hashcluster erstellen Um ein Hashcluster zu erstellen, verwenden Sie dieselbe
CREATE CLUSTER-Anweisung wie für ein indiziertes Cluster. Fügen Sie dazu einen Hashschlüssel hinzu. Die Anzahl der Hash-Werte für das Cluster hängt vom Hash-Schlüssel ab. -
Hashclusterabfragen In Abfragen eines Hashclusters bestimmt die Datenbank, wie die vom Benutzer eingegebenen Schlüsselwerte gehasht werden.
-
Hashclustervarianten Ein Hashcluster mit einer einzelnen Tabelle ist eine optimierte Version eines Hashclusters, das jeweils nur eine Tabelle unterstützt. Zwischen Hash-Schlüsseln und Zeilen ist eine Eins-zu-Eins-Zuordnung vorhanden.
-
Hash Cluster Storage Oracle AI Database weist Speicherplatz für ein Hashcluster anders als ein indiziertes Cluster zu.
Hashcluster erstellen
Um ein Hash-Cluster zu erstellen, verwenden Sie dieselbe CREATE CLUSTER-Anweisung wie für ein indiziertes Cluster, wobei Sie einen Hash-Schlüssel hinzufügen. Die Anzahl der Hash-Werte für das Cluster hängt vom Hash-Schlüssel ab.
Der Clusterschlüssel ist, wie der Schlüssel eines indizierten Clusters, eine einzelne Spalte oder ein zusammengesetzter Schlüssel, der von den Tabellen im Cluster gemeinsam verwendet wird. Ein Hashschlüsselwert ist ein tatsächlicher oder möglicher Wert, der in die Clusterschlüsselspalte eingefügt wird. Beispiel: Wenn der Clusterschlüssel department_id lautet, können Hashschlüsselwerte 10, 20, 30 usw. sein.
Oracle AI Database verwendet eine Hash-Funktion, die eine unendliche Anzahl von Hash-Schlüsselwerten als Eingabe akzeptiert und in eine begrenzte Anzahl von Buckets sortiert. Jeder Bucket verfügt über eine eindeutige numerische ID, die als Hashwert bezeichnet wird. Jeder Hash-Wert ist der Datenbankblockadresse für den Block zugeordnet, der die Zeilen speichert, die dem Hash-Schlüsselwert entsprechen (Abteilung 10, 20, 30 usw.).
Im folgenden Beispiel ist die Anzahl der wahrscheinlich vorhandenen Abteilungen 100. Daher wird HASHKEYS auf 100 gesetzt:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;
Nachdem Sie employees_departments_cluster erstellt haben, können Sie die Tabellen employees und departments im Cluster erstellen. Anschließend können Sie Daten wie im indizierten Cluster in das Hash Cluster laden.
Siehe:
-
Oracle AI Database Administrator's Guide mit Informationen zum Erstellen und Verwalten von Hash-Clustern
Hash Cluster-Abfragen
Bei Abfragen eines Hash Clusters bestimmt die Datenbank, wie die vom Benutzer eingegebenen Schlüsselwerte gehasht werden.
Beispiel: Benutzer führen häufig Abfragen wie die folgenden aus und geben unterschiedliche Abteilungsnummern für p_id ein:
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
Wenn ein Benutzer Mitarbeiter in department_id=20 abfragt, kann die Datenbank diesen Wert in Bucket 77 Hash ausführen. Wenn ein Benutzer Mitarbeiter in department_id=10 abfragt, kann die Datenbank diesen Wert in Bucket 15 Hash ausführen. Die Datenbank verwendet den intern generierten Hashwert, um den Block zu suchen, der die Mitarbeiterdatensätze für die angeforderte Abteilung enthält.
Die folgende Abbildung zeigt ein Hash Cluster-Segment als horizontale Blockzeile. Wie in der Grafik dargestellt, kann eine Abfrage Daten in einem einzelnen I/O abrufen.
Abbildung 9: Daten von einem Hash-Cluster abrufen
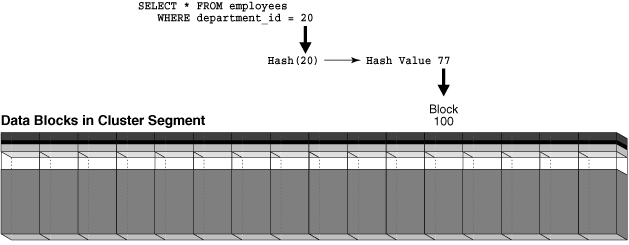
Beschreibung der Abbildung cncpt329.gif
Eine Einschränkung von Hash Clustern ist die Nichtverfügbarkeit von Range Scans für nicht indizierte Clusterschlüssel. Angenommen, für das Hashcluster, das bei der Hashclustererstellung erstellt wurde, ist kein separater Index vorhanden. Eine Abfrage für Abteilungen mit IDs zwischen 20 und 100 kann den Hashing-Algorithmus nicht verwenden, da nicht jeder mögliche Wert zwischen 20 und 100 Hash ausführen kann. Da kein Index vorhanden ist, muss die Datenbank einen vollständigen Scan durchführen.
Siehe auch: "Indexbereichscan"
Hashclustervarianten
Ein Hash Cluster mit einer einzelnen Tabelle ist eine optimierte Version eines Hash Clusters, das jeweils nur eine Tabelle unterstützt. Zwischen Hash-Schlüsseln und Zeilen ist eine Eins-zu-Eins-Zuordnung vorhanden.
Ein Hash-Cluster mit einer einzelnen Tabelle kann von Vorteil sein, wenn Benutzer schnellen Zugriff auf eine Tabelle nach Primärschlüssel benötigen. Beispiel: Benutzer suchen häufig einen Mitarbeiterdatensatz in der Tabelle employees nach employee_id.
Ein sortiertes Hashcluster speichert die Zeilen, die jedem Wert der Hashfunktion entsprechen, so, dass die Datenbank sie effizient in sortierter Reihenfolge zurückgeben kann. Die Datenbank führt die optimierte Sortierung intern aus. Für Anwendungen, die immer Daten in sortierter Reihenfolge konsumieren, kann diese Technik einen schnelleren Datenabruf bedeuten. Beispiel: Eine Anwendung sortiert immer nach der Spalte order_date der Tabelle orders.
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie einzelne Tabellen- und sortierte Hash-Cluster erstellen.
Hashclusterspeicher
Oracle AI Database weist einem Hash-Cluster anders Speicherplatz zu als einem indizierten Cluster.
Im Beispiel unter Hashcluster erstellen gibt HASHKEYS die Anzahl der Abteilungen an, die wahrscheinlich vorhanden sind, während SIZE die Größe der Daten angibt, die mit jeder Abteilung verknüpft sind. Die Datenbank berechnet einen Speicherplatzwert basierend auf der folgenden Formel:
HASHKEYS * SIZE / database_block_sizeWenn die Blockgröße im Beispiel unter Hashcluster erstellen 4096 Byte beträgt, weist die Datenbank dem Hashcluster mindestens 200 Blöcke zu.
Oracle AI Database begrenzt nicht die Anzahl der Hash-Schlüsselwerte, die Sie in das Cluster einfügen können. Beispiel: Obwohl HASHKEYS 100 ist, verhindert nichts, dass Sie 200 eindeutige Abteilungen in die Tabelle departments einfügen. Die Effizienz des Hash-Cluster-Abrufs verringert sich jedoch, wenn die Anzahl der Hash-Werte die Anzahl der Hash-Schlüssel überschreitet.
Um die Abrufprobleme zu veranschaulichen, gehen Sie davon aus, dass Block 100 in Abbildung 4-9 vollständig mit Zeilen für Abteilung 20 gefüllt ist. Ein Benutzer fügt eine neue Abteilung mit department_id 43 in die Tabelle departments ein. Die Anzahl der Abteilungen überschreitet den Wert HASHKEYS, sodass die Datenbank den Hashwert 77 in department_id 43 hasht. Dies ist derselbe Hashwert, der für department_id 20 verwendet wird. Das Hashing mehrerer Eingabewerte auf denselben Ausgabewert wird als Hash-Collision bezeichnet.
Wenn Benutzer Zeilen für Abteilung 43 in das Cluster einfügen, kann die Datenbank diese Zeilen nicht in Block 100 speichern, der voll ist. Die Datenbank verknüpft Block 100 mit einem neuen Überlaufblock, z. B. Block 200, und speichert die eingefügten Zeilen im neuen Block. Sowohl Block 100 als auch Block 200 können jetzt Daten für jede Abteilung speichern. Wie in Abbildung 4-10 dargestellt, erfordert eine Abfrage der Abteilung 20 oder 43 jetzt zwei I/Os, um die Daten abzurufen: Block 100 und der zugehörige Block 200. Sie können dieses Problem lösen, indem Sie das Cluster mit einem anderen HASHKEYS-Wert neu erstellen.
Abbildung 10: Daten aus einem Hash-Cluster abrufen, wenn ein Hash-Collision auftritt
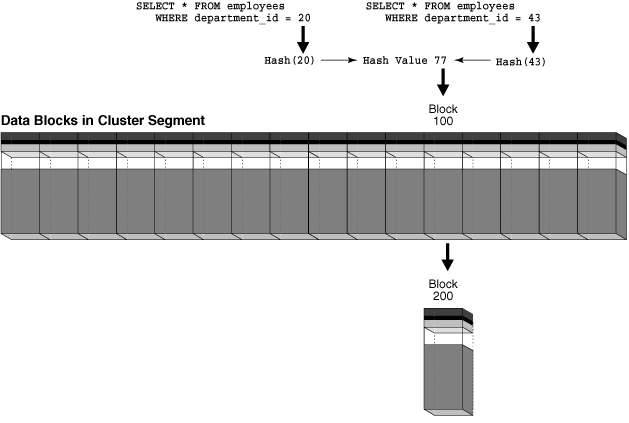
Beschreibung der Abbildung cncpt331.gif
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Sie Speicherplatz in Hashclustern verwalten.
Überblick über attributgeclusterte Tabellen
Eine attributegeclusterte Tabelle ist eine Heap-organisierte Tabelle, in der Daten in unmittelbarer Nähe auf dem Datenträger basierend auf benutzerdefinierten Clustering-Anweisungen gespeichert werden. In den Anweisungen werden Spalten in einzelnen oder mehreren Tabellen angegeben.
Die Richtlinien lauten wie folgt:
-
Die Direktive
CLUSTERING ... BY LINEAR ORDERordnet Daten in einer Tabelle gemäß den angegebenen Spalten an.Verwenden Sie das
BY LINEAR ORDER-Clustering, das die Standardeinstellung ist, wenn Abfragen das Präfix der in der Clustering-Klausel angegebenen Spalten angeben. Beispiel: Wenn Abfragen vonsh.saleshäufig entweder eine Kunden-ID oder sowohl eine Kunden-ID als auch eine Produkt-ID angeben, können Sie Daten in der Tabelle mit der linearen Spaltenreihenfolgecust_id,prod_idclustern. -
Die Direktive
CLUSTERING ... BY INTERLEAVED ORDERordnet Daten in einer oder mehreren Tabellen mit einem speziellen Algorithmus an, ähnlich einer Z-Reihenfolge-Funktion, die eine mehrspaltige I/O-Reduzierung ermöglicht.Verwenden Sie das
BY INTERLEAVED ORDER-Clustering, wenn Abfragen eine Vielzahl von Spaltenkombinationen angeben. Beispiel: Wenn Abfragen vonsh.salesverschiedene Dimensionen in verschiedenen Reihenfolge angeben, können Sie Daten in der Tabellesalesentsprechend den Spalten in diesen Dimensionen clustern.
Attributclustering ist nur für Direct Path INSERT-Vorgänge verfügbar. Wird bei herkömmlicher DML ignoriert.
Der vorliegende Abschnitt umfasst die folgenden Themen:
-
Attributgeclusterte Tabellen mit verschachtelter Reihenfolge
-
Vorteile von attributgeclusterten Tabellen Der Hauptvorteil von attributgeclusterten Tabellen ist die I/O-Reduktion, die I/O-Kosten und CPU-Kosten von Tabellenscans erheblich reduzieren kann. Die I/O-Reduktion erfolgt entweder bei Zonen oder durch Reduzierung des physischen I/O durch eine engere physische Nähe auf der Festplatte für die geclusterten Werte.
-
Geclusterte Tabellen von Join-Attributen Das auf Join-Spalten basierende Attributclustering wird als Join-Attributclustering bezeichnet. Im Gegensatz zu Tabellenclustern speichern geclusterte Join-Attributtabellen keine Daten aus einer Gruppe von Tabellen in denselben Datenbankblöcken.
-
I/O-Reduktion mit Zonen Eine Zone ist eine Gruppe zusammenhängender Datenblöcke, in denen die Mindest- und Höchstwerte der relevanten Spalten gespeichert werden.
-
Attributgeclusterte Tabellen mit linearer Reihenfolge Ein lineares Sortierschema für eine Tabelle teilt Zeilen in Bereiche auf, die auf benutzerdefinierten Attributen in einer bestimmten Reihenfolge basieren. Oracle AI Database unterstützt die lineare Reihenfolge in einzelnen oder mehreren Tabellen, die über eine Primär-/Fremdschlüsselbeziehung verbunden sind.
-
Attributgeclusterte Tabellen mit verschachtelter Bestellung Interleaved Ordering verwendet eine Technik, die einer Z-Reihenfolge ähnelt.
Vorteile attributgeclusterter Tabellen
Der Hauptvorteil von attributgeclusterten Tabellen ist die I/O-Reduzierung, wodurch die I/O-Kosten und CPU-Kosten von Tabellenscans erheblich reduziert werden können. Die I/O-Reduktion erfolgt entweder bei Zonen oder durch Reduzierung des physischen I/O durch eine engere physische Nähe auf der Festplatte für die geclusterten Werte.
Eine Attribut-geclusterte Tabelle bietet die folgenden Vorteile:
-
Sie können Faktentabellen basierend auf Dimensionsspalten in Star-Schemas gruppieren.
In Star-Schemas qualifizieren die meisten Abfragen Dimensionstabellen und nicht Fakttabellen. Daher ist das Clustering nach Fakttabellenspalten nicht gültig. Oracle AI Database unterstützt das Clustering auf Spalten in Dimensionstabellen.
-
Die E/A-Reduktion kann in verschiedenen Szenarien erfolgen:
-
Bei Verwendung mit Oracle Exadata-Speicherindizes, Oracle In-Memory-Min/Max-Pruning oder Zonenzuordnungen
-
In OLTP-Anwendungen für Abfragen, die ein Präfix qualifizieren und Attribut-Clustering mit linearer Reihenfolge verwenden
-
In einer Teilmenge der Clustering-Spalten für das
BY INTERLEAVED ORDER-Clustering
-
-
Das Clustering von Attributen kann die Datenkomprimierung verbessern und auf diese Weise indirekt die Table Scan-Kosten verbessern.
Wenn die gleichen Werte auf der Platte nahe beieinander liegen, kann die Datenbank sie einfacher komprimieren.
-
Für Oracle AI Database fallen keine Speicher- und Wartungskosten für einen Index an.
Siehe auch: Oracle AI Database Data Warehousing Guide für weitere Vorteile von attributgeclusterten Tabellen
Cluster-Tabellen für Join-Attribute
Das Attribut-Clustering, das auf verknüpften Spalten basiert, wird als Join-Attribut-Clustering bezeichnet. Im Gegensatz zu Tabellenclustern speichern geclusterte Join-Attributtabellen keine Daten aus einer Gruppe von Tabellen in denselben Datenbankblöcken.
Beispiel: Eine mit einem Attribut geclusterte Tabelle, sales, ist mit einer Dimensionstabelle verknüpft, products. Die Tabelle sales enthält nur Zeilen aus der Tabelle sales. Die Reihenfolge der Zeilen basiert jedoch auf den Werten der Spalten, die aus der Tabelle products verknüpft sind. Der entsprechende Join wird während der Datenverschiebung, der Direct Path-Einfügung und der CREATE TABLE AS SELECT-Vorgänge ausgeführt. Wenn sich sales und products hingegen in einem Standardtabellencluster befinden, enthalten die Datenblöcke Zeilen aus beiden Tabellen.
Siehe auch: Oracle AI Database Data Warehousing Guide für weitere Informationen zum Clustering von Join-Attributen
I/O-Reduzierung mit Zonen
Eine Zone ist eine Gruppe zusammenhängender Datenblöcke, in denen die Mindest- und Höchstwerte der relevanten Spalten gespeichert werden.
Wenn eine SQL-Anweisung Prädikate für Spalten enthält, die in einer Zone gespeichert sind, vergleicht die Datenbank die Prädikatwerte mit dem in der Zone gespeicherten Minimum und Maximum. Auf diese Weise bestimmt die Datenbank, welche Zonen während der SQL-Ausführung gelesen werden.
I/O-Reduzierung ist die Möglichkeit, Tabellen- oder Indexblöcke zu überspringen, die keine Daten enthalten, die von der Datenbank benötigt werden, um eine Abfrage zu erfüllen. Diese Reduzierung kann die I/O- und CPU-Kosten von Tabellenscans erheblich reduzieren.
-
Zweck von Zonen Um eine lose Analogie zu Zonen zu erhalten, sollten Sie einen Vertriebsleiter in Betracht ziehen, der ein Taubenlochbuch verwendet, das den Datenblöcken entspricht.
-
Zonenzuordnungen Eine Zonenzuordnung ist eine unabhängige Zugriffsstruktur, die Datenblöcke in Zonen aufteilt. Oracle AI Database implementiert jede Zonenzuordnung als Typ der Materialized View.
-
Zonenzuordnung erstellen Grundlegende Zonenzuordnungen werden entweder manuell oder automatisch erstellt.
-
Funktionsweise einer Zonenzuordnung: Beispiel Dieses Beispiel veranschaulicht, wie eine Zonenzuordnung Daten in einer Abfrage bereinigen kann, deren Prädikat eine Konstante enthält.
Zweck der Zonen
Für eine lose Analogie von Zonen sollten Sie einen Vertriebsleiter in Betracht ziehen, der ein Taubenlochbuch verwendet, das mit Datenblöcken vergleichbar ist.
Jedes Taubenloch hat Belege (Zeilen), die an einen Kunden verkaufte Hemden beschreiben, nach Versanddatum bestellt. In dieser Analogie ist eine Zonenkarte wie ein Stapel von Indexkarten. Jede Karte entspricht einer "Zone" (kontinuierlicher Bereich) von Taubenlöchern, wie Taubenlöchern 1-10. Für jeden Abschnitt listet die Karte das minimale und maximale Versanddatum für die im Abschnitt gespeicherten Belege auf.
Wenn jemand wissen möchte, welche Hemden an einem bestimmten Datum versandt wurden, dreht der Manager die Karten um, bis sie in den Datumsbereich kommt, der das angeforderte Datum enthält, notiert die Taubenlochzone und durchsucht dann nur Taubenlöcher in dieser Zone nach den angeforderten Quittungen. Auf diese Weise vermeidet der Manager, jedes Taubenloch im Bücherregal nach den Quittungen zu durchsuchen.
Zonenzuordnungen
Eine Zonenzuordnung ist eine unabhängige Zugriffsstruktur, die Datenblöcke in Zonen aufteilt. Oracle AI Database implementiert jede Zonenzuordnung als Typ der Materialized View.
Wie Indizes können Zonenzuordnungen die I/O- und CPU-Kosten von Tabellenscans reduzieren. Wenn eine SQL-Anweisung Prädikate für Spalten in einer Zonenzuordnung enthält, vergleicht die Datenbank die Prädikatwerte mit den minimalen und maximalen Tabellenspaltenwerten, die in jeder Zone gespeichert sind, um zu bestimmen, welche Zonen während der SQL-Ausführung gelesen werden sollen.
Eine Grundzonenkarte wird in einer einzelnen Tabelle definiert und behält die Mindest- und Höchstwerte einiger Spalten dieser Tabelle bei. Eine Join Zone Map wird für eine Tabelle definiert, die über einen Outer Join mit einer oder mehreren anderen Tabellen verfügt und die Mindest- und Höchstwerte einiger Spalten in den anderen Tabellen beibehält. In Oracle AI Database werden beide Zonentypen automatisch verwaltet.
In einer Tabelle kann höchstens eine Zonenzuordnung vorhanden sein. Bei einer partitionierten Tabelle ist für alle Partitionen und Unterpartitionen eine Zonenzuordnung vorhanden. Bei einer Zonenzuordnung einer partitionierten Tabelle werden auch die Mindest- und Höchstwerte pro Zone, pro Partition und pro Unterpartition verfolgt. Definitionen für Zonenzuordnungen können Mindest- und Höchstwerte von Dimensionsspalten enthalten, sofern die Tabelle über einen Outer Join mit den Dimensionstabellen verfügt. Hinweis: Sie können eine Zonenzuordnung erstellen, die nur den Abschnitt auf Partitions- oder Unterpartitionsebene enthält. Durch das Erstellen einer solchen Zonenzuordnung werden die Partitions-Pruning-Funktionen über die Partitionsmetadaten hinaus erweitert.
Siehe auch: Oracle AI Database Data Warehousing Guide für einen Überblick über Zonenkarten
Zonenzuordnung erstellen
Grundlegende Zonenzuordnungen werden entweder manuell oder automatisch erstellt.
-
Manuelle Zonenzuordnungen Mit DDL-Anweisungen können Sie Zonenzuordnungen erstellen, löschen und verwalten.
-
Automatische Zonenzuordnungen Oracle AI Database kann grundlegende Zonenzuordnungen automatisch erstellen. Diese werden als automatische Zonenzuordnungen bezeichnet.
Manuelle Zonenzuordnungen
Mit DDL-Anweisungen können Sie Zonenzuordnungen erstellen, löschen und verwalten.
Wenn Sie die CLUSTERING-Klausel in einer CREATE TABLE- oder ALTER TABLE-Anweisung angeben, erstellt die Datenbank automatisch eine Zonenzuordnung für die angegebenen Clustering-Spalten. Die Zonenzuordnung korreliert die Mindest- und Höchstwerte von Spalten mit aufeinander folgenden Datenblöcken in der attributgeclusterten Tabelle. Attribute geclusterte Tabellen verwenden Zonenzuordnungen zur I/O-Reduzierung.
Mit der Anweisung CREATE MATERIALIZED ZONEMAP können Sie auch explizit Zonenzuordnungen erstellen. In diesem Fall können Sie Zonenzuordnungen für die Verwendung mit oder ohne Attribut-Clustering erstellen. Beispiel: Sie können eine Zonenzuordnung für eine Tabelle erstellen, deren Zeilen natürlich in einer Gruppe von Spalten angeordnet sind, z.B. eine Aktienhandelstabelle, deren Trades nach Zeit sortiert sind.
Siehe:
-
Oracle AI Database Data Warehousing Guide für weitere Informationen zum Erstellen von Zonenzuordnungen
Automatische Zonenzuordnungen
Oracle AI Database kann grundlegende Zonenzuordnungen automatisch erstellen. Diese werden als automatische Zonenzuordnungen bezeichnet.
Oracle AI Database kann grundlegende Zonenzuordnungen automatisch für partitionierte und nicht partitionierte Tabellen erstellen. Ein Hintergrundprozess verwaltet automatisch Zonenzuordnungen, die auf diese Weise erstellt wurden.
Verwenden Sie das Verfahren DBMS_AUTO_ZONEMAP, um automatische Zonenkarten zu aktivieren:
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')Siehe:
-
Oracle AI Database Data Warehousing Guide, um mehr über die Verwaltung automatischer Zonenzuordnungen mit dem Package
DBMS_AUTO_ZONEMAPzu erfahren -
Oracle AI Database PL/SQL Packages and Types Reference für weitere Informationen zum
DBMS_AUTO_ZONEMAP-Package -
Benutzerhandbuch zu Oracle AI Database-Lizenzierungsinformationen für Details, welche Features für verschiedene Editionen und Services unterstützt werden
Funktionsweise einer Zonenzuordnung – Beispiel
Dieses Beispiel veranschaulicht, wie eine Zonenzuordnung Daten in einer Abfrage bereinigen kann, deren Prädikat eine Konstante enthält.
Angenommen, Sie erstellen die folgende Tabelle lineitem:
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
Die Tabelle lineitem enthält 4 Datenblöcke mit 2 Zeilen pro Block. In Tabelle 4-4 sind die 8 Zeilen der Tabelle dargestellt.
Tabelle 4 Datenblöcke für Lineitem-Tabelle
| Blockieren | Auftragsschlüssel | Lieferdatum | Zahlungsdatum | Ziel | Menge |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
Mit der Anweisung CREATE MATERIALIZED ZONEMAP können Sie eine Zonenzuordnung in der Tabelle lineitem erstellen. Jede Zone enthält 2 Blöcke und speichert das Minimum und Maximum der Spalten orderkey, shipdate und receiptdate. In Tabelle 4-5 ist die Zonenzuordnung dargestellt.
Tabelle 5: Zonenzuordnung für Lineitem-Tabelle
| Blockbereich | Min. Bestellschlüssel | max. Bestellschlüssel | Min. Versanddatum | max. Versanddatum | Min. Wareneingangsdatum | max. Wareneingangsdatum |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
Wenn Sie die folgende Abfrage ausführen, kann die Datenbank die Zonenzuordnung lesen und dann nur die Blöcke 1 und 2 scannen und daher die Blöcke 3 und 4 überspringen, da das Datum 1-3-2014 zwischen dem minimalen und dem maximalen Datum liegt:
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';Siehe:
-
Oracle AI Database Data Warehousing Guide: Informationen zur Verwendung von Zonenzuordnungen
-
Oracle AI Database SQL Language Reference für Syntax und Semantik der
CREATE MATERIALIZED ZONEMAP-Anweisung
Attributgeclusterte Tabellen mit linearer Reihenfolge
Ein lineares Sortierschema für eine Tabelle teilt Zeilen in Bereiche auf, die auf benutzerdefinierten Attributen in einer bestimmten Reihenfolge basieren. Oracle AI Database unterstützt die lineare Reihenfolge in einzelnen oder mehreren Tabellen, die über eine Primär-/Fremdschlüsselbeziehung verbunden sind.
Beispiel: Die Tabelle sales teilt die Spalten cust_id und prod_id in Bereiche auf und gruppiert diese Bereiche dann auf dem Datenträger. Wenn Sie die Direktive BY LINEAR ORDER für eine Tabelle angeben, kann eine signifikante I/O-Reduktion auftreten, wenn ein Prädikat entweder die Präfixspalte oder alle Spalten in der Direktive angibt.
Angenommen, Abfragen von sales geben häufig entweder eine Kunden-ID oder eine Kombination aus Kunden-ID und Produkt-ID an. Sie können eine Attribut-geclusterte Tabelle erstellen, sodass diese Abfragen von der I/O-Reduzierung profitieren:
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
Abfragen, die beide Spalten cust_id und prod_id oder das Präfix cust_id qualifizieren, führen zu einer I/O-Reduzierung. Abfragen, die prod_id qualifizieren, weisen nur keine signifikante I/O-Reduzierung auf, da prod_id das Suffix der BY LINEAR ORDER-Klausel ist. Die folgenden Beispiele zeigen, wie die Datenbank I/O bei Table Scans reduzieren kann.
Beispiel 4-9: Nur cust_id angeben
Eine Anwendung gibt die folgende Abfrage aus:
SELECT * FROM sales WHERE cust_id = 100;Da die Tabelle sales ein BY LINEAR ORDER-Cluster ist, darf die Datenbank nur die Zonen lesen, die den cust_id-Wert von 100 enthalten.
Beispiel 4-10: prod_id und cust_id angeben
Eine Anwendung gibt die folgende Abfrage aus:
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;Da die Tabelle sales ein BY LINEAR ORDER-Cluster ist, darf die Datenbank nur die Zonen lesen, die den cust_id-Wert von 100 und den prod_id-Wert von 2300 enthalten.
Siehe:
-
Oracle AI Database Data Warehousing Guide, um zu erfahren, wie Tabellen mit linearer Reihenfolge geclustert werden
-
Oracle AI Database SQL Language Reference für Syntax und Semantik der
BY LINEAR ORDER-Klausel
Attributgeclusterte Tabellen mit verschachtelter Reihenfolge
Interleaved Order verwendet eine Technik, die einem Z-Order ähnelt.
Durch die verschachtelte Reihenfolge kann die Datenbank I/O basierend auf einer Teilmenge von Prädikaten in den Clustering-Spalten bereinigen. Verschachtelte Sortierung ist nützlich für Dimensionshierarchien in einem Data Warehouse.
Wie bei attributgeclusterten Tabellen mit linearer Reihenfolge unterstützt Oracle AI Database die verschachtelte Reihenfolge in einzelnen oder mehreren Tabellen, die über eine Primär-/Fremdschlüsselbeziehung verbunden sind. Spalten in anderen Tabellen als der Attribut-geclusterten Tabelle müssen mit einem Fremdschlüssel verknüpft und mit der Attribut-geclusterten Tabelle verknüpft werden.
Große Data Warehouses organisieren häufig Daten in einem Sternschema. Eine Dimensionstabelle verwendet eine Hierarchie aus über- und untergeordneten Elementen und ist über einen Fremdschlüssel mit einer Fakttabelle verbunden. Durch das Clustering einer Faktentabelle nach verschachtelter Reihenfolge kann die Datenbank mithilfe einer speziellen Funktion Werte in Dimensionsspalten bei Table Scans überspringen.
Beispiel 4-11: Verschachtelte Anforderungen
Angenommen, das Data Warehouse enthält eine Faktentabelle sales und die zugehörigen beiden Dimensionstabellen: customers und products. Die meisten Abfragen haben Prädikate für die Tabellenhierarchie (cust_state_province, cust_city) customers und die Produkthierarchie (prod_category, prod_subcategory). Sie können die verschachtelte Reihenfolge für die Tabelle sales verwenden, wie in der Teilanweisung im folgenden Beispiel dargestellt:
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;
Hinweis: Die in der BY INTERLEAVED ORDER-Klausel angegebenen Spalten müssen nicht in tatsächlichen Dimensionstabellen enthalten sein, sondern müssen über eine Primär-/Fremdschlüsselbeziehung verbunden sein.
Angenommen, eine Anwendung fragt die Tabellen sales, products und customers in einem Join ab. Die Abfrage gibt die Spalten customers.prod_category und customers_cust_state_province im Prädikat wie folgt an:
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;
In der vorherigen Abfrage sind die Spalten prod_category und cust_state_province Teil der Clustering-Definition, die im Beispiel CREATE TABLE gezeigt wird. Beim Scannen der Tabelle sales kann die Datenbank die Zonenzuordnung prüfen und nur auf die ROWIDs in dieser Zone zugreifen.
Siehe:
-
Oracle AI Database Data Warehousing Guide, um zu erfahren, wie Sie Tabellen mit interleaved order clustern
-
Oracle AI Database SQL Language Reference für Syntax und Semantik der
BY INTERLEAVED ORDER-Klausel
Überblick über temporäre Tabellen
Eine temporäre Tabelle enthält Daten, die nur für die Dauer einer Transaktion oder Session vorhanden sind.
Daten in einer temporären Tabelle sind für die Session privat. Jede Session kann nur ihre eigenen Daten anzeigen und ändern.
Sie können entweder eine globale temporäre Tabelle oder eine private temporäre Tabelle erstellen. Die folgende Tabelle zeigt die wesentlichen Unterschiede zwischen ihnen.
Tabelle 6: Eigenschaften der temporären Tabelle
| Eigenschaft | Global | Privat |
|---|---|---|
| Benennungsregeln | Wie bei permanenten Tabellen | Muss mit dem Präfix ORA$PTT_ versehen sein |
| Sichtbarkeit der Tabellendefinition | Alle Sessions | Nur die Session, die die Tabelle erstellt hat |
| Speicherung der Tabellendefinition | Festplatte | Nur Speicher |
| Typen | Transaktionsspezifisch (ON COMMIT DELETE ROWS) oder sitzungsspezifisch (ON COMMIT PRESERVE ROWS) |
Transaktionsspezifisch (ON COMMIT DROP DEFINITION) oder sitzungsspezifisch (ON COMMIT PRESERVE DEFINITION) |
Ein dritter Typ einer temporären Tabelle, die als cursor-duration temporäre Tabelle bezeichnet wird, wird von der Datenbank automatisch für bestimmte Abfragetypen erstellt.
-
Zweck temporärer Tabellen Temporäre Tabellen sind nützlich in Anwendungen, in denen eine Ergebnismenge gepuffert werden muss.
-
Segmentzuweisung in temporären Tabellen Wie permanente Tabellen sind globale temporäre Tabellen persistente Objekte, die im Data Dictionary statisch definiert sind. Bei privaten temporären Tabellen sind Metadaten nur im Speicher vorhanden, können sich aber im temporären Tablespace auf Platte befinden.
-
Temporäre Tabellenerstellung Die Anweisung
CREATE ... TEMPORARY TABLEerstellt eine temporäre Tabelle. Siehe auch: Oracle AI Database SQL Tuning Guide, um mehr über temporäre Cursor-Dauer-Tabellen zu erfahren
Zweck von temporären Tabellen
Temporäre Tabellen sind in Anwendungen nützlich, in denen eine Ergebnismenge gepuffert werden muss.
Mit einer Planungsanwendung können Studenten beispielsweise optionale Kurse für das Semester erstellen. Eine Zeile in einer globalen temporären Tabelle stellt jeden Zeitplan dar. Während der Session sind die Plandaten privat. Wenn der Teilnehmer einen Zeitplan wählt, verschiebt die Anwendung die Zeile für den ausgewählten Zeitplan in eine permanente Tabelle. Am Ende der Session löscht die Datenbank automatisch die Plandaten aus der globalen temporären Tabelle.
Private temporäre Tabellen sind für dynamische Berichtsanwendungen nützlich. Beispiel: Eine CRM-Anwendung (Customer Resource Management) kann unbegrenzt eine Verbindung mit demselben Benutzer herstellen, wobei mehrere Sessions gleichzeitig aktiv sind. Jede Session erstellt eine private temporäre Tabelle mit dem Namen ORA$PTT_crm für jede neue Transaktion. Die Anwendung kann für jede Session denselben Tabellennamen verwenden, die Definition jedoch ändern. Die Daten und die Definition sind nur für die Sitzung sichtbar. Die Tabellendefinition bleibt bestehen, bis die Transaktion beendet oder die Tabelle manuell gelöscht wird.
Segmentzuweisung in temporären Tabellen
Wie permanente Tabellen sind auch globale temporäre Tabellen persistente Objekte, die im Data Dictionary statisch definiert sind. Bei privaten temporären Tabellen sind Metadaten nur im Speicher vorhanden, können sich aber im temporären Tablespace auf Platte befinden.
Bei globalen und privaten temporären Tabellen weist die Datenbank temporäre Segmente zu, wenn eine Session zum ersten Mal Daten einfügt. Bis Daten in einer Session geladen werden, wird die Tabelle leer angezeigt. Bei transaktionsspezifischen temporären Tabellen löscht die Datenbank die Zuweisung temporärer Segmente am Ende der Transaktion. Bei sessionspezifischen temporären Tabellen löscht die Datenbank die Zuweisung temporärer Segmente am Ende der Session.
Siehe auch: "Temporäre Segmente"
Temporäre Tabellenerstellung
Die Anweisung CREATE ... TEMPORARY TABLE erstellt eine temporäre Tabelle.
Geben Sie entweder GLOBAL TEMPORARY TABLE oder PRIVATE TEMPORARY TABLE an. In beiden Fällen gibt die ON COMMIT-Klausel an, ob die Tabellendaten transaktionsspezifisch (Standard) oder sessionspezifisch sind. Sie erstellen eine temporäre Tabelle für die Datenbank selbst, nicht für jede Stored Procedure in PL/SQL.
Sie können Indizes für globale (nicht private) temporäre Tabellen mit der Anweisung CREATE INDEX erstellen. Diese Indizes sind ebenfalls temporär. Die Daten im Index haben denselben Session- oder Transaktionsgeltungsbereich wie die Daten in der temporären Tabelle. Sie können auch eine Ansicht oder einen Trigger für eine globale temporäre Tabelle erstellen.
Siehe:
-
Oracle AI Database Administrator's Guide zum Erstellen und Verwalten von temporären Tabellen
-
Oracle AI Database SQL Language Reference für
CREATE ... TEMPORARY TABLE-Syntax und Semantik
Übersicht über externe Tabellen
Eine externe Tabelle greift auf Daten in externen Quellen zu, als ob diese Daten in einer Tabelle in der Datenbank wären.
Die Daten können in jedem Format vorliegen, für das ein Zugriffstreiber bereitgestellt wird. Mit SQL (seriell oder parallel), PL/SQL und Java können Sie externe Tabellen abfragen.
-
Externe Tabellen Zweck externer Tabellen sind nützlich, wenn eine Oracle-Datenbankanwendung auf nicht relationale Daten zugreifen muss.
-
Externe Tabellen von Daten in Objektspeichern können für den Zugriff auf Daten in Objektspeichern verwendet werden.
-
Zugriffstreiber für externe Tabellen Ein Zugriffstreiber ist eine API, mit der die externen Daten für die Datenbank interpretiert werden. Der Zugriffstreiber wird innerhalb der Datenbank ausgeführt, die den Treiber zum Lesen der Daten in der externen Tabelle verwendet. Der Zugriffstreiber und die externe Tabellenschicht sind für die Durchführung der Transformationen verantwortlich, die für die Daten in der Datendatei erforderlich sind, damit sie mit der Definition der externen Tabelle übereinstimmen.
-
Externe Tabelle erstellen Intern bedeutet das Erstellen einer externen Tabelle, dass Metadaten im Data Dictionary erstellt werden. Im Gegensatz zu einer normalen Tabelle beschreibt eine externe Tabelle keine in der Datenbank gespeicherten Daten und beschreibt auch nicht, wie Daten extern gespeichert werden. Stattdessen werden in den Metadaten externer Tabellen beschrieben, wie die externe Tabellenschicht Daten in der Datenbank anzeigen muss.
-
Automatisches Caching von externen Tabellendaten Daten aus externen Tabellen werden transparent gecacht, um die Abfrageperformance zu verbessern.
Zweck externer Tabellen
Externe Tabellen sind nützlich, wenn eine Oracle-Datenbankanwendung auf nicht relationale Daten zugreifen muss.
Beispiel: Eine SQL-basierte Anwendung muss möglicherweise auf eine Textdatei zugreifen, deren Datensätze in der folgenden Form vorliegen:
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
Sie können eine externe Tabelle erstellen, die Textdatei an den in der Definition der externen Tabelle angegebenen Speicherort kopieren und dann SQL verwenden, um die Datensätze in der Textdatei abzufragen. Ebenso können Sie externe Tabellen verwenden, um schreibgeschützten Zugriff auf JSON-Dokumente oder LOBs zu erteilen.
In Data Warehouse-Umgebungen sind externe Tabellen nützlich, um ETL-Aufgaben (Extrahieren, Transformieren und Laden) auszuführen. Beispiel: Mit externen Tabellen können Sie die Dataload-Phase mit der Transformationsphase Pipeline erstellen. Mit dieser Technik müssen keine Daten mehr in der Datenbank zwischengespeichert werden, um die weitere Verarbeitung innerhalb der Datenbank vorzubereiten.
Sie können externe Tabellen in virtuelle oder nicht virtuelle Spalten partitionieren. Außerdem können Sie eine hybride partitionierte Tabelle erstellen, in der einige Partitionen intern und einige externe Partitionen enthalten sind. Wie interne Partitionen profitieren auch externe Partitionen von Leistungsverbesserungen wie Partitions-Pruning und partitionsweisen Joins. Beispiel: Sie können partitionierte externe Tabellen verwenden, um große Volumes von nicht relationalen Daten zu analysieren, die in Hadoop Distributed File System (HDFS) oder einer NoSQL-Datenbank gespeichert sind.
Siehe auch: "Partitionierte Tabellen"
Daten in Objektspeichern
Externe Tabellen können für den Zugriff auf Daten in Objektspeichern verwendet werden.
Oracle unterstützt nicht nur den Zugriff auf externe Daten in Betriebssystemdateien und Big Data-Quellen, sondern auch den Zugriff auf externe Daten in Objektspeichern. Der Objektspeicher ist in der Cloud üblich und bietet eine flache Architektur zur Verwaltung einzelner Objekte, jeder Art unstrukturierter Daten mit Metadaten, indem sie in einfachen Containern gruppiert werden. Obgleich Objektspeicher überwiegend eine Datenspeicherarchitektur in der Cloud ist, ist er auch als On-Premises-Speicherhardware verfügbar.
Sie können auf Daten in Objektspeichern zugreifen, indem Sie das Package DBMS_CLOUD verwenden oder externe Tabellen manuell definieren. Oracle empfiehlt unbedingt die Verwendung des Packages DBMS_CLOUD, da es zusätzliche Funktionen bietet und vollständig mit Oracle Autonomous Database kompatibel ist.
Treiber für externen Tabellenzugriff
Ein Zugriffstreiber ist eine API, mit der die externen Daten für die Datenbank interpretiert werden. Der Zugriffstreiber wird innerhalb der Datenbank ausgeführt, die den Treiber zum Lesen der Daten in der externen Tabelle verwendet. Der Zugriffstreiber und die externe Tabellenschicht sind für die Durchführung der Transformationen verantwortlich, die für die Daten in der Datendatei erforderlich sind, damit sie mit der Definition der externen Tabelle übereinstimmen.
Die folgende Abbildung stellt den SQL-Zugriff auf externe Daten dar.
Abbildung 11: Externe Tabellen
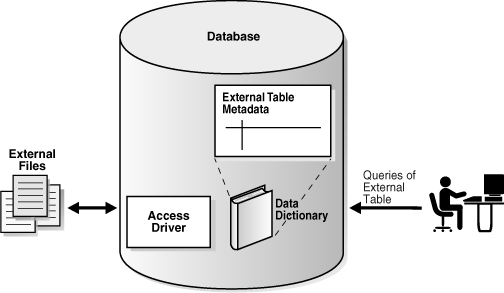
Beschreibung der Abbildung cncpt231.gif
Oracle stellt die folgenden Zugriffstreiber für externe Tabellen bereit:
-
ORACLE_LOADER(Standard)Ermöglicht den Zugriff auf externe Dateien mit den meisten von SQL*Loader unterstützten Formaten. Mit dem Treiber
ORACLE_LOADERkönnen Sie keine externe Datei erstellen, aktualisieren oder an eine externe Datei anhängen. -
ORACLE_DATAPUMPErmöglicht das Entladen oder Laden externer Daten. Ein Entladevorgang liest Daten aus der Datenbank und fügt die Daten in eine externe Tabelle ein, die durch eine oder mehrere externe Dateien dargestellt wird. Nachdem externe Dateien erstellt wurden, kann die Datenbank keine Daten aktualisieren oder an sie anhängen. Ein Ladevorgang liest eine externe Tabelle und lädt ihre Daten in eine Datenbank.
-
ORACLE_HDFSAktiviert die Extraktion von Daten, die in einem Hadoop Distributed File System (HDFS) gespeichert sind.
-
ORACLE_HIVEErmöglicht den Zugriff auf Daten, die in einer Apache Hive-Datenbank gespeichert sind. Die Quelldaten können in HDFS, HBase, Cassandra oder anderen Systemen gespeichert werden. Im Gegensatz zu den anderen Zugriffstreibern können Sie keinen Speicherort angeben, da
ORACLE_HIVEStandortinformationen aus einem externen Metadatenspeicher abruft. -
ORACLE_BIGDATAErmöglicht schreibgeschützten Zugriff auf Daten, die sowohl in strukturierten als auch in unstrukturierten Formaten gespeichert sind, einschließlich Apache Parquet, Apache Avro, Apache ORC, Apache Iceberg, dem Linux Open Project Delta Sharing-Protokoll und Textformaten. Mit diesem Treiber können Sie auch lokale Daten abfragen. Dies ist nützlich für Tests und kleinere Datasets.
Externe Tabelle erstellen
Intern bedeutet das Erstellen einer externen Tabelle, dass Metadaten im Data Dictionary erstellt werden. Im Gegensatz zu einer normalen Tabelle beschreibt eine externe Tabelle keine in der Datenbank gespeicherten Daten und beschreibt auch nicht, wie Daten extern gespeichert werden. Stattdessen werden in den Metadaten externer Tabellen beschrieben, wie die externe Tabellenschicht Daten in der Datenbank anzeigen muss.
Eine CREATE TABLE ... ORGANIZATION EXTERNAL-Anweisung besteht aus zwei Teilen. In der Definition der externen Tabelle werden die Spaltentypen beschrieben. Diese Definition ähnelt einer View, mit der SQL externe Daten abfragen kann, ohne sie in die Datenbank zu laden. Der zweite Teil der Anweisung ordnet die externen Daten den Spalten zu.
Externe Tabellen sind schreibgeschützt, es sei denn, sie werden mit CREATE TABLE AS SELECT mit dem Zugriffstreiber ORACLE_DATAPUMP erstellt. Einschränkungen für externe Tabellen enthalten keine Unterstützung für indizierte Spalten und Spaltenobjekte.
Siehe:
-
Oracle AI Database-Utilitys, um mehr über externe Tabellen zu erfahren
-
Oracle AI Database Administrator's Guide zum Verwalten externer Tabellen, externer Verbindungen und Verzeichnisobjekte
-
Oracle AI Database SQL Language Reference für Informationen zum Erstellen und Abfragen externer Tabellen
Automatisches Caching externer Tabellendaten
Daten aus externen Tabellen werden transparent gecacht, um die Abfrageperformance zu verbessern.
Daten, auf die häufig aus externen Tabellen zugegriffen wird, die sich ganz oder teilweise im Objektspeicher befinden, werden automatisch gecacht, um die Performance zu steigern. Für das Caching externer Tabellendaten sind keine Anwendungsänderungen erforderlich, da sie automatisch von der Oracle-Datenbank verarbeitet werden.
Übersicht über Blockchain-Tabellen
Eine Blockchain-Tabelle ist eine Nur-Anhangstabelle, die für zentralisierte Blockchain-Anwendungen entwickelt wurde.
In Oracle Blockchain Table sind Peers Datenbankbenutzer, die der Datenbank vertrauen, um ein manipulationssicheres Ledger zu verwalten. Das Ledger wird als Blockchain-Tabelle implementiert, die von der Anwendung definiert und verwaltet wird. Vorhandene Anwendungen können sich vor Betrug schützen, ohne dass eine neue Infrastruktur oder ein neues Programmiermodell erforderlich ist. Obwohl der Transaktionsdurchsatz niedriger ist als bei einer Standardtabelle, ist die Performance für eine Blockchain-Tabelle besser als für eine dezentrale Blockchain.
Eine Blockchain-Tabelle ist nur angehängt, weil die einzig zulässige DML INSERT-Befehle sind. Die Tabelle lässt UPDATE-, DELETE-, MERGE-, TRUNCATE- und Direct Path-Ladevorgänge nicht zu. Datenbanktransaktionen können sich über Blockchain-Tabellen und Standardtabellen erstrecken. Beispiel: Eine einzelne Transaktion kann Zeilen in eine Standardtabelle und zwei verschiedene Blockchain-Tabellen einfügen.
Blockchain-Tabellen können verwendet werden, um Flashback Data Archive-Inhalte zu sichern. So können Sie feststellen, ob jemand den Inhalt einer Tabelle manipuliert hat. Eine Blockchain-Protokollhistorientabelle kann als die Aufrechterhaltung eines kryptografisch sicheren logischen Redo Logs für Änderungen an einer verfolgten Benutzertabelle betrachtet werden.
Sie können Benutzerspalten aus Blockchain-Tabellen hinzufügen oder löschen, die mit Blockchain-Tabellen der Version 2 beginnen. Das Hinzufügen oder Löschen von Benutzerspalten aus Blockchain-Tabellen der Version 1 ist nicht zulässig. Die physischen Spalten und Daten werden nicht tatsächlich gelöscht, sondern als unsichtbar markiert.
-
Zeilenketten In einer Blockchain-Tabelle ist eine Zeilenkette eine Reihe von Zeilen, die mit einem Hashing-Schema verknüpft sind.
-
Zeileninhalt Der Zeileninhalt ist eine zusammenhängende Bytefolge mit den Spaltendaten der Zeile und dem Hashwert der vorherigen Zeile in der Kette.
-
Benutzeroberfläche für Blockchain-Tabellen Wie eine Standardtabelle wird eine Blockchain-Tabelle von SQL erstellt und unterstützt skalare Datentypen, LOBs, JSON und Partitionen. Sie können auch Indizes und Trigger für Blockchain-Tabellen erstellen.
Zeilenketten
In einer Blockchain-Tabelle ist eine Zeilenkette eine Reihe von Zeilen, die mit einem Hashing-Schema verknüpft sind.
Eine Systemzeilenkette wird durch eine eindeutige Kombination aus Datenbankinstanz-ID und Ketten-ID in einer Blockchain-Tabelle der Version 1 identifiziert. Ab Version 2 der Blockchain-Tabellen wird zusätzlich zu diesen beiden IDs die globale eindeutige ID der Datenbank benötigt, in der die Zeile eingefügt wurde. Eine Systemzeilenkette wird durch eine eindeutige Kombination aus globaler eindeutiger ID, Datenbankinstanz-ID und Ketten-ID der integrierbaren Datenbank in einer Blockchain-Tabelle der Version 2 identifiziert. Eine Zeile in einer Blockchain-Tabelle gehört genau zu einer Systemzeilenkette. Eine einzelne Tabelle unterstützt mehrere Systemzeilenketten. Hinweis: Eine verkettete Zeile in einer Standardtabelle ist orthogonal zu einer Zeilenkette in einer Blockchain-Tabelle. Nur das Wort "Kette" ist das gleiche.
Jede Zeile in einer Kette hat eine eindeutige Folgenummer. Die Datenbank sequenziert die Zeilen mit einer Hash-Berechnung SHA2-512 für die Zeilen jeder Kette. Der Hash für jede eingefügte Zeile wird vom Zeileninhalt der eingefügten Zeile abgeleitet, der den Hashwert der zuvor eingefügten Zeile in der Kette enthält.
Während jede Zeile in einer Blockchain-Tabelle genau zu einer Systemkette gehört, kann sie auch zu einer Benutzerkette gehören, die auf Werten aus einer Gruppe von Benutzerspalten basiert, die beim Erstellen der Blockchain-Tabelle angegeben werden.
Zeileninhalt
Der Zeileninhalt ist eine zusammenhängende Bytefolge, die Spaltendaten der Zeile und den Hashwert der vorherigen Zeile in der Kette enthält.
Wenn Sie eine Blockchain-Tabelle erstellen, erstellt die Datenbank mehrere verborgene Spalten. Beispiel: Sie können die Blockchain-Tabelle bank_ledger mit den Spalten bank und deposit erstellen:
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
Die Datenbank erstellt automatisch ausgeblendete Spalten mit dem Präfix ORABCTAB: ORABCTAB_INST_ID$, ORABCTAB_CHAIN_ID$, ORABCTAB_SEQ_NUM$ und andere. Diese ausgeblendeten Spalten, von denen die meisten nicht geändert oder verwaltet werden können, implementieren den Anti-Tampering-Algorithmus. Dieser Algorithmus vermeidet Deadlocks, indem er eindeutige Chain-Sperren auf Tabellenebene in einer bestimmten Reihenfolge zum Commit-Zeitpunkt erfasst.
Hinweis: Zeileninhalt für Blockchain-Tabellen wird in Standarddatenblöcken gespeichert. In diesem Release von Oracle AI Database unterstützen Blockchain-Tabellen keine Tabellencluster.
Die Instanz-ID, die Ketten-ID und die laufende Nummer kennzeichnen einen Datensatz eindeutig. Ab Version 2 der Blockchain-Tabellen wird zusätzlich zu diesen drei Werten die globale eindeutige ID der Datenbank benötigt, in der die Zeile eingefügt wurde. Jede Zeile hat einen plattformunabhängigen SHA2-512-Hash, der in der ausgeblendeten Spalte ORABCTAB_HASH$ gespeichert ist. Der Hash basiert auf dem Inhalt der eingefügten Zeile und dem Hash der vorherigen Zeile in der Kette.
Das Datenformat für den Spaltenwert einer Zeile besteht aus Byte aus den Spaltenmetadaten und dem Inhalt. Die Spaltenmetadaten sind eine 20-Byte-Struktur, die Eigenschaften wie Position in der Tabelle, Datentyp, Nullstatus und Bytelänge beschreibt. Der Spalteninhalt ist das Byte-Set, das den Wert in einer Zeile darstellt. Beispiel: Die ASCII-Darstellung des Werts Chase ist 43 68 61 73 65. Mit der Funktion DUMP in SQL können Sie Spaltenmetadaten und -inhalt abrufen.
Der Zeileninhalt für eine Hash-Berechnung umfasst die Spaltendatenformate aus mehreren Spalten: den Hashwert in der vorherigen Zeile in der Kette, die benutzerdefinierten Spalten und eine feste Anzahl ausgeblendeter Spalten.
Die Reihenfolge, in der zugehörige Zeilen eingefügt werden, die so genannten Zeilenversionen, kann vom System verfolgt und aufgezeichnet werden, indem eine Gruppe von Spalten angegeben wird, über die Zeilenversionen definiert werden. Wenn Zeilenversionen angegeben werden, wird automatisch eine View erstellt und verwaltet, in der die letzte Zeile angezeigt wird, die für jede Kombination von Werten in der benutzerdefinierten Gruppe von Spalten eingefügt wurde. Der Ansichtsname verwendet die Benennungskonvention Blockchain_Table_Name_LAST$.
In vielen Fällen müssen Zeilen zusätzlich oder alternativ von einem Delegierten des Endbenutzers signiert werden. Ein Beispiel ist ein Bankmanager, der eine Zeile signiert, die von einem Endbenutzer eingefügt wurde. Ein delegierter Signaturgeber ist ein anderer Datenbankbenutzer, der seine Signatur in einer Zeile hinzufügen kann, die über den kryptografischen Hash des Systems der Zeile berechnet wird. Eine Zeile kann von einem Endbenutzer, einem Delegierten oder beidem signiert werden. Die Signatur eines Delegierten wird nur akzeptiert, wenn die Signatur mit dem Zertifikat des Delegierten verifiziert werden kann und das Zertifikat des Delegierten in einer Datenbank-Dictionary-Tabelle aufgezeichnet wird.
Wenn eine Zeile von einem Endbenutzer oder Delegierten signiert wird, kann der Benutzer eine Gegenzeichnung für die Zeile anfordern. Eine Gegenzeichnung kann als Blockchain-Tabellendigest speziell für die Zeile betrachtet werden, die bereits von einem Endbenutzer oder Delegierten signiert wurde. Wenn eine Zeile gegengezeichnet wird, wird die Gegenzeichnung an den Zeilenunterzeichner zurückgegeben und auch in dieser Zeile gespeichert. Der Benutzer, der die Gegenzeichnung in der Zeile anfordert, kann diese Informationen zu Nichtrückweisungszwecken in einem separaten Datenspeicher speichern.
Benutzeroberfläche für Blockchain-Tabellen
Wie eine Standardtabelle wird eine Blockchain-Tabelle von SQL erstellt und unterstützt skalare Datentypen, LOBs, JSON und Partitionen. Sie können auch Indizes und Trigger für Blockchain-Tabellen erstellen.
Um eine Blockchain-Tabelle zu erstellen, verwenden Sie eine CREATE BLOCKCHAIN TABLE-Anweisung. Eine Blockchain-Tabelle hat einen Aufbewahrungszeitraum, der in der NO DROP UNTIL n DAYS IDLE-Klausel angegeben ist. Sie können die Tabelle mit DROP TABLE entfernen.
Oracle Blockchain Table unterstützt die folgenden Schnittstellen:
-
Mit dem Package
DBMS_BLOCKCHAIN_TABLEkönnen Sie verschiedene Vorgänge für Tabellenzeilen ausführen. Beispiel: Um eine Signatur auf den Inhalt einer zuvor eingefügten Zeile anzuwenden, verwenden Sie die ProzedurSIGN_ROW. Um zu prüfen, ob die Zeilen nicht manipuliert wurden, verwenden SieVERIFY_ROWS. Um Zeilen zu entfernen, nachdem der Aufbewahrungszeitraum (durch dieNO DELETE-Klausel angegeben) überschritten wurde, verwenden SieDELETE_EXPIRED_ROWS. -
In der Ansicht
DBA_BLOCKCHAIN_TABLESwerden Tabellenmetadaten wie der Zeilenaufbewahrungszeitraum, der Inaktivitätszeitraum vor dem Löschen einer Tabelle und der Hash-Algorithmus angezeigt.
Hinweis:
-
Oracle AI Database Administrator's Guide zum Verwalten von Blockchain-Tabellen
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zum
DBMS_BLOCKCHAIN_TABLE-Package -
Oracle AI Database-Referenz zur
DBA_BLOCKCHAIN_TABLES-Ansicht
Überblick über unveränderliche Tabellen
Unveränderbare Tabellen sind schreibgeschützte Tabellen, die nicht autorisierte Datenänderungen durch Insider und versehentliche Datenänderungen aufgrund von menschlichen Fehlern verhindern.
Nicht autorisierte Änderungen können von kompromittierten oder betrügerischen Mitarbeitern versucht werden, die Zugriff auf Insider-Anmeldeinformationen haben.
Einer unveränderlichen Tabelle können neue Zeilen hinzugefügt werden, vorhandene Zeilen können jedoch nicht geändert werden. Sie müssen einen Aufbewahrungszeitraum sowohl für die unveränderliche Tabelle als auch für Zeilen innerhalb der unveränderlichen Tabelle angeben. Zeilen werden nach dem angegebenen Zeilenaufbewahrungszeitraum veraltet. Nur veraltete Zeilen können aus der unveränderlichen Tabelle gelöscht werden.
Unveränderliche Tabellen enthalten vom System generierte verborgene Spalten. Die Spalten sind die gleichen wie die für Blockchain-Tabellen. Wenn eine Zeile eingefügt wird, wird ein Nicht-NULL-Wert für die Spalten ORABCTAB_CREATION_TIME$ und ORABCTAB_USER_NUMBER$ festgelegt. Mit Ausnahme der unveränderlichen Tabellen V1 wird ein Nicht-NULL-Wert für die Spalte ORABCTAB_PDB_GUID$ festgelegt. Wenn die unveränderliche Tabelle mit Zeilenversionen erstellt wurde, wird ein Nicht-NULL-Wert für die Spalten ORABCTAB_ROW_VERSION$ und ORABCTAB_LAST_ROW_VERSION_NUMBER$ festgelegt. Der Wert der verbleibenden vom System generierten ausgeblendeten Spalten wird auf NULL gesetzt.
Für die Verwendung unveränderlicher Tabellen sind keine Änderungen an vorhandenen Anwendungen erforderlich.
Objekttabellen - Überblick
Eine Objekttabelle ist eine spezielle Art von Tabelle, in der jede Zeile ein Objekt darstellt.
Ein Oracle-Objekttyp ist ein benutzerdefinierter Typ mit einem Namen, Attributen und Methoden. Mit Objekttypen können reale Entitäten wie Kunden und Bestellungen als Objekte in der Datenbank modelliert werden.
Ein Objekttyp definiert eine logische Struktur, erstellt jedoch keinen Speicher. Im folgenden Beispiel wird ein Objekttyp namens department_typ erstellt:
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
Im folgenden Beispiel wird eine Objekttabelle mit dem Namen departments_obj_t des Objekttyps department_typ erstellt und anschließend eine Zeile in die Tabelle eingefügt. Die Attribute (Spalten) der Tabelle departments_obj_t werden aus der Definition des Objekttyps abgeleitet.
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
Wie eine relationale Spalte kann eine Objekttabelle nur Zeilen einer Art von Dingen enthalten, nämlich Objektinstanzen desselben deklarierten Typs wie die Tabelle. Standardmäßig verfügt jedes Zeilenobjekt in einer Objekttabelle über einen zugehörigen logischen Objektbezeichner (OID), der es in einer Objekttabelle eindeutig identifiziert. Die OID-Spalte einer Objekttabelle ist eine ausgeblendete Spalte.
Siehe:
-
Oracle AI Database Object-Relational Developer's Guide für Informationen zu objektrelationalen Features in Oracle AI Database
-
Oracle AI Database SQL Language Reference für
CREATE TYPE-Syntax und Semantik