Partitionen, Ansichten und andere Schemaobjekte
Obwohl Tabellen und Indizes die wichtigsten und am häufigsten verwendeten Schemaobjekte sind, unterstützt die Datenbank viele andere Typen von Schemaobjekten, die am häufigsten in diesem Kapitel behandelt werden.
-
Überblick über Partitionen In einer Oracle-Datenbank können Sie mit der Partitionierung sehr große Tabellen und Indizes in kleinere und verwaltbarere Teile, die als Partitionen bezeichnet werden, zerlegen. Jede Partition ist ein unabhängiges Objekt mit eigenem Namen und optional eigenen Speichereigenschaften.
-
Überblick über in Shards unterteilte Tabellen In einer Oracle-Datenbank können Sie mit dem Feature "Globally Distributed Database" alle Tabellen in Form von Shards unterteilen, die in mehreren Datenbanken gespeichert werden können.
-
Überblick über Ansichten Eine Ansicht ist eine logische Darstellung einer oder mehrerer Tabellen. Im Wesentlichen ist eine View eine gespeicherte Abfrage.
-
Überblick über Materialized Views Eine Materialized View ist ein Abfrageergebnis, das im Voraus als Schemaobjekt gespeichert oder "materialisiert" wurde. Die
FROM-Klausel der Abfrage kann Tabellen, Views oder Materialized Views benennen. -
Überblick über Sequences Eine Sequenz ist ein Schemaobjekt, aus dem mehrere Benutzer eindeutige Ganzzahlen generieren können. Ein Sequenzgenerator bietet eine hoch skalierbare und leistungsstarke Methode, um Surrogatschlüssel für einen Zahlendatentyp zu generieren.
-
Überblick über Dimensionen Ein typisches Data Warehouse verfügt über zwei wichtige Komponenten: Dimensionen und Fakten.
-
Überblick über Synonyme Ein Synonym ist ein Alias für ein Schemaobjekt. Beispiel: Sie können ein Synonym für eine Tabelle oder View, eine Sequence, eine PL/SQL-Programmeinheit, einen benutzerdefinierten Objekttyp oder ein anderes Synonym erstellen. Da ein Synonym einfach ein Alias ist, muss lediglich dessen Definition im Data Dictionary gespeichert werden.
Partitionen - Überblick
In einer Oracle-Datenbank können Sie mit der Partitionierung sehr große Tabellen und Indizes in kleinere und mehr verwaltbare Teile, die als Partitionen bezeichnet werden, zerlegen. Jede Partition ist ein unabhängiges Objekt mit eigenem Namen und optional eigenen Speichereigenschaften.
Angenommen, ein HR-Manager hat ein großes Feld, das Mitarbeiterordner enthält. In jedem Ordner wird das Einstellungsdatum des Mitarbeiters aufgeführt. Häufig werden Anfragen für Mitarbeiter gestellt, die in einem bestimmten Monat eingestellt wurden. Eine Möglichkeit, solche Anforderungen zu erfüllen, besteht darin, einen Index für das Einstellungsdatum der Mitarbeiter zu erstellen, der die Standorte der Ordner angibt, die im gesamten Feld verstreut sind. Im Gegensatz dazu verwendet eine Partitionierungsstrategie viele kleinere Felder, wobei jede Box Ordner für Mitarbeiter enthält, die in einem bestimmten Monat eingestellt wurden.
Die Verwendung kleinerer Boxen hat mehrere Vorteile. Wenn Sie aufgefordert werden, die Ordner für Mitarbeiter abzurufen, die im Juni eingestellt wurden, kann der HR-Manager das Feld "Juni" abrufen. Darüber hinaus, wenn eine kleine Box vorübergehend beschädigt wird, bleiben die anderen kleinen Boxen verfügbar. Das Umziehen von Büros wird auch einfacher, da der Manager mehrere kleine Kisten bewegen kann, anstatt eine einzige schwere Kiste zu bewegen.
Aus Sicht einer Anwendung ist nur ein Schemaobjekt vorhanden. SQL-Anweisungen erfordern keine Änderung für den Zugriff auf partitionierte Tabellen. Die Partitionierung ist für viele verschiedene Arten von Datenbankanwendungen nützlich, insbesondere für Anwendungen, die große Datenmengen verwalten. Zu den Vorteilen zählen:
-
Höhere Verfügbarkeit
Die Nichtverfügbarkeit einer Partition führt nicht dazu, dass das Objekt nicht verfügbar ist. Der Abfrage-Optimizer entfernt automatisch nicht referenzierte Partitionen aus dem Abfrageplan, sodass Abfragen nicht betroffen sind, wenn die Partitionen nicht verfügbar sind.
-
Einfachere Administration von Schemaobjekten
Ein partitioniertes Objekt enthält Teile, die entweder kollektiv oder einzeln verwaltet werden können. DDL-Anweisungen können Partitionen und nicht ganze Tabellen oder Indizes bearbeiten. Auf diese Weise können Sie ressourcenintensive Aufgaben aufteilen, wie die Neuerstellung eines Index oder einer Tabelle. Beispiel: Sie können eine Tabellenpartition nacheinander verschieben. Wenn ein Problem auftritt, muss nur die Partitionsverschiebung erneut ausgeführt werden, nicht die Tabellenverschiebung. Durch das Löschen einer Partition werden außerdem zahlreiche
DELETE-Anweisungen nicht ausgeführt. -
Geringere Zugriffskonflikte auf gemeinsam genutzte Ressourcen in OLTP-Systemen
In einigen OLTP-Systemen können Partitionen die Zugriffskonflikte auf eine gemeinsam genutzte Ressource verringern. Beispiel: DML wird auf viele Segmente anstatt auf ein Segment verteilt.
-
Verbesserte Abfrageleistung in Data Warehouses
In einem Data Warehouse kann die Partitionierung die Verarbeitung von Ad-hoc-Abfragen beschleunigen. Beispiel: Eine Verkaufstabelle mit einer Million Zeilen kann nach Quartal partitioniert werden.
-
Partitionseigenschaften Jede Partition einer Tabelle oder eines Index muss dieselben logischen Attribute aufweisen, wie Spaltennamen, Datentypen und Constraints.
-
Partitionierte Tabellen Eine partitionierte Tabelle besteht aus einer oder mehreren Partitionen, die einzeln verwaltet werden und unabhängig von den anderen Partitionen betrieben werden können.
-
Partitionierte Indizes Ein partitionierter Index ist ein Index, der wie eine partitionierte Tabelle in kleinere und verwaltbarere Teile unterteilt wurde.
-
Teilindizes für partitionierte Tabellen Ein Teilindex ist ein Index, der mit den Indexierungseigenschaften einer zugehörigen partitionierten Tabelle korreliert.
-
Objektspeicher für ältere Partitionen verwenden Bei schreibgeschützten Partitionen können Sie kostengünstigen Speicher wie Objektspeicher in der Cloud verwenden. Siehe auch: Oracle AI Database VLDB and Partitioning Guide für eine Einführung in die Partitionierung
Partitionseigenschaften
Jede Partition einer Tabelle oder eines Index muss dieselben logischen Attribute aufweisen, wie Spaltennamen, Datentypen und Constraints.
Beispiel: Alle Partitionen in einer Tabelle verwenden dieselben Spalten- und Constraint-Definitionen. Jede Partition kann jedoch separate physische Attribute aufweisen, z. B. den Tablespace, zu dem sie gehört.
-
Partitionsschlüssel Der Partitionsschlüssel besteht aus einer oder mehreren Spalten, die bestimmen, in welche Partition jede Zeile in einer partitionierten Tabelle verschoben werden soll. Jede Zeile wird einer einzelnen Partition eindeutig zugewiesen.
-
Partitionierungsstrategien Oracle Partitioning bietet mehrere Partitionierungsstrategien, die steuern, wie die Datenbank Daten in Partitionen platziert. Die grundlegenden Strategien sind Range-, List- und Hash-Partitionierung.
Partitionsschlüssel
Der Partitionsschlüssel besteht aus einer oder mehreren Spalten, die bestimmen, in welcher Partition jede Zeile in einer partitionierten Tabelle abgelegt werden soll. Jede Zeile wird einer einzelnen Partition eindeutig zugewiesen.
In der Tabelle sales können Sie die Spalte time_id als Schlüssel einer Bereichspartition angeben. Die Datenbank weist Partitionen Zeilen zu, je nachdem, ob das Datum in dieser Spalte in einen bestimmten Bereich fällt. Oracle AI Database leitet Einfüge-, Aktualisierungs- und Löschvorgänge automatisch mit dem Partitionsschlüssel an die entsprechende Partition weiter.
Partitionierungsstrategien
Oracle Partitioning bietet verschiedene Partitionierungsstrategien, mit denen gesteuert wird, wie die Datenbank Daten in Partitionen platziert. Die grundlegenden Strategien sind Range-, List- und Hash-Partitionierung.
Eine Partitionierung auf einer Ebene verwendet nur eine Methode der Datenverteilung, z.B. nur die Listenpartitionierung oder nur die Range-Partitionierung. Bei der Composite-Partitionierung wird eine Tabelle nach einer Datenverteilungsmethode partitioniert. Anschließend wird jede Partition mit einer zweiten Datenverteilungsmethode weiter in Unterpartitionen unterteilt. Beispiel: Sie können eine Listenpartition für channel_id und eine Bereichsunterpartition für time_id verwenden.
Beispiel 6-1: Beispiel-Zeilenset für partitionierte Tabelle
In diesem Partitionierungsbeispiel wird davon ausgegangen, dass Sie eine partitionierte Tabelle sales mit den folgenden Zeilen füllen möchten:
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
Bereichspartitionierung Bei der Bereichspartitionierung ordnet die Datenbank Zeilen Partitionen basierend auf Wertebereichen des Partitionierungsschlüssels zu. Die Range-Partitionierung ist der häufigste Partitionierungstyp und wird häufig mit Datumsangaben verwendet.
-
Die Intervalspartitionierung ist eine Erweiterung der Range-Partitionierung.
-
Listenpartitionierung Bei der Listenpartitionierung verwendet die Datenbank eine Liste diskreter Werte als Partitionsschlüssel für jede Partition. Der Partitionierungsschlüssel besteht aus einer oder mehreren Spalten.
-
Hash-Partitionierung Bei der Hash-Partitionierung ordnet die Datenbank Zeilen Partitionen basierend auf einem Hashing-Algorithmus zu, den die Datenbank für den benutzerdefinierten Partitionierungsschlüssel anwendet.
-
Referenzpartitionierung In der Referenzpartitionierung wird die Partitionierungsstrategie einer untergeordneten Tabelle ausschließlich über die Fremdschlüsselbeziehung mit einer übergeordneten Tabelle definiert. Für jede Partition in der übergeordneten Tabelle ist genau eine entsprechende Partition in der untergeordneten Tabelle vorhanden. In der übergeordneten Tabelle werden die übergeordneten Datensätze in einer bestimmten Partition gespeichert. In der untergeordneten Tabelle werden die untergeordneten Datensätze in der entsprechenden Partition gespeichert.
-
Composite-Partitionierung Bei der Composite-Partitionierung wird eine Tabelle nach einer Datenverteilungsmethode partitioniert. Anschließend wird jede Partition mit einer zweiten Datenverteilungsmethode weiter in Unterpartitionen unterteilt. Daher kombiniert die Composite-Partitionierung die grundlegenden Datenverteilungsmethoden. Alle Unterpartitionen für eine bestimmte Partition stellen eine logische Teilmenge der Daten dar.
Range-Partitionierung
In der Bereichspartitionierung ordnet die Datenbank Zeilen Partitionen basierend auf Wertebereichen des Partitionierungsschlüssels zu. Die Range-Partitionierung ist der häufigste Partitionierungstyp und wird häufig mit Datumsangaben verwendet.
Angenommen, Sie erstellen time_range_sales als partitionierte Tabelle mit der folgenden SQL-Anweisung, wobei die Spalte time_id der Partitionsschlüssel ist:
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
 );
Danach laden Sie time_range_sales mit den Zeilen aus Beispiel 6-1. Der Code zeigt die Zeilenverteilungen in den vier Partitionen an. Die Datenbank wählt die Partition für jede Zeile basierend auf dem Wert time_id gemäß den in der PARTITION BY RANGE-Klausel angegebenen Regeln aus. Der Wert des Bereichspartitionsschlüssels bestimmt den nicht einschließlichen High-Bound für eine angegebene Partition.
Intervallpartitionierung
Die Intervalspartitionierung ist eine Erweiterung der Range-Partitionierung.
Wenn Sie Daten einfügen, die vorhandene Bereichspartitionen überschreiten, erstellt Oracle AI Database automatisch Partitionen in einem bestimmten Intervall. Beispiel: Sie können eine Umsatzhistorientabelle erstellen, in der Daten für jeden Monat in einer separaten Partition gespeichert werden.
Mit Intervallpartitionen können Sie vermeiden, dass Bereichspartitionen explizit erstellt werden. Sie können Intervallpartitionierung für fast jede Tabelle verwenden, die Range-partitioniert ist und feste Intervalle für neue Partitionen verwendet. Sofern Sie keine Range-Partitionen mit unterschiedlichen Intervallen erstellen oder keine spezifischen Partitionsattribute festlegen, sollten Sie Interval-Partitionen verwenden.
Bei der Partitionierung nach Intervall müssen Sie mindestens eine Bereichspartition angeben. Der Wert des Range-Partitionierungsschlüssels bestimmt den hohen Wert der Range-Partitionen, die als Übergangspunkt bezeichnet werden. Die Datenbank erstellt automatisch Intervallpartitionen für Daten mit Werten, die über den Übergangspunkt hinausgehen. Die untere Grenze jeder Intervallpartition ist die inklusive obere Grenze der vorherigen Bereichs- oder Intervallpartition. Daher befindet sich in Beispiel 6-2 der Wert 01-JAN-2011 in Partition p2.
Die Datenbank erstellt Intervallpartitionen für Daten über den Übergangspunkt hinaus. Eine Intervalspartition erweitert die Range-Partitionierung, indem sie die Datenbank anweist, Partitionen mit dem angegebenen Bereich oder Intervall zu erstellen. Die Datenbank erstellt die Partitionen automatisch, wenn die in die Tabelle eingefügten Daten alle vorhandenen Range-Partitionen überschreiten. In Beispiel 6-2 enthält die Partition p3 Zeilen mit Partitionsschlüsselwerten time_id, die größer oder gleich 01-JAN-2013 sind.
Beispiel 6-2: Intervallpartitionierung
Angenommen, Sie erstellen eine Verkaufstabelle mit vier Partitionen unterschiedlicher Breite. Sie geben an, dass die Datenbank über dem Übergangspunkt vom 1. Januar 2013 Partitionen in Abständen von einem Monat erstellen soll. Die hohe Grenze der Partition p3 stellt den Übergangspunkt dar. Die Partition p3 und alle darunter liegenden Partitionen befinden sich im Bereich, während alle darüber liegenden Partitionen in den Intervallbereich fallen.
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
Sie fügen einen Verkauf am Datum Oktober 10, 2014:
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
Eine Abfrage von USER_TAB_PARTITIONS zeigt, dass die Datenbank eine neue Partition für den Verkauf am 10. Oktober erstellt hat, weil das Verkaufsdatum nach dem Übergangspunkt lag:
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
Siehe auch: Oracle AI Database VLDB and Partitioning Guide, um mehr über Intervallpartitionen zu erfahren
List-Partitionierung
In der Listenpartitionierung verwendet die Datenbank eine Liste diskreter Werte als Partitionsschlüssel für jede Partition. Der Partitionierungsschlüssel besteht aus einer oder mehreren Spalten.
Mit der Listenpartitionierung können Sie steuern, wie einzelne Zeilen bestimmten Partitionen zugeordnet werden. Mithilfe von Listen können Sie zusammengehörige Datengruppen gruppieren und organisieren, wenn der zur Identifizierung verwendete Schlüssel nicht bequem sortiert ist.
Beispiel 6-3: List-Partitionierung
Angenommen, Sie erstellen list_sales als List-partitionierte Tabelle mit der folgenden Anweisung, wobei die Spalte channel_id der Partitionsschlüssel ist:
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
 );
Anschließend laden Sie die Tabelle mit den Zeilen aus Beispiel 6-1. Der Code zeigt die Zeilenverteilung in den beiden Partitionen an. Die Datenbank wählt die Partition für jede Zeile basierend auf dem Wert channel_id gemäß den in der PARTITION BY LIST-Klausel angegebenen Regeln aus. Zeilen mit dem channel_id-Wert 2 oder 4 werden in den EVEN_CHANNELS-Partitionen gespeichert, während Zeilen mit dem channel_id-Wert 3 oder 9 in der ODD_CHANNELS-Partition gespeichert werden.
Hash-Partitionierung
Bei der Hash-Partitionierung ordnet die Datenbank Zeilen Partitionen basierend auf einem Hashing-Algorithmus zu, der für den vom Benutzer angegebenen Partitionierungsschlüssel gilt.
Das Ziel einer Zeile wird durch die interne Hash-Funktion bestimmt, die von der Datenbank auf die Zeile angewendet wird. Wenn die Anzahl der Partitionen eine Leistung von 2 ist, erzeugt der Hashing-Algorithmus eine ungefähr gleichmäßige Verteilung der Zeilen auf alle Partitionen.
Die Hash-Partitionierung eignet sich zum Teilen großer Tabellen, um die Verwaltbarkeit zu erhöhen. Statt einer großen Tabelle zu verwalten, haben Sie mehrere kleinere Stücke. Der Verlust einer einzelnen Hash-Partition wirkt sich nicht auf die verbleibenden Partitionen aus und kann unabhängig wiederhergestellt werden. Die Hash-Partitionierung eignet sich auch für OLTP-Systeme mit hohen Aktualisierungskonflikten. Beispiel: Ein Segment wird in mehrere Teile unterteilt, die jeweils aktualisiert werden, anstatt in ein einzelnes Segment, das Konflikte verursacht.
Angenommen, Sie erstellen die partitionierte Tabelle hash_sales mit der folgenden Anweisung, wobei die Spalte prod_id der Partitionsschlüssel ist:
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;
Anschließend laden Sie die Tabelle mit den Zeilen aus Beispiel 6-1. Der Code zeigt eine mögliche Zeilenverteilung in den beiden Partitionen an. Die Namen dieser Partitionen werden vom System generiert.
Wenn Sie Zeilen einfügen, versucht die Datenbank, sie zufällig und gleichmäßig auf Partitionen zu verteilen. Sie können nicht die Partition angeben, in der eine Zeile platziert wird. Die Datenbank wendet die Hash-Funktion an, deren Ergebnis bestimmt, welche Partition die Zeile enthält.
Siehe:
-
Oracle AI Database VLDB and Partitioning Guide zum Erstellen von Partitionen
-
Oracle AI Database SQL Language Reference für
CREATE TABLE ... PARTITION BY-Beispiele
Referenzpartitionierung
In der Referenzpartitionierung wird die Partitionierungsstrategie einer untergeordneten Tabelle ausschließlich über die Fremdschlüsselbeziehung mit einer übergeordneten Tabelle definiert. Für jede Partition in der übergeordneten Tabelle ist genau eine entsprechende Partition in der untergeordneten Tabelle vorhanden. In der übergeordneten Tabelle werden die übergeordneten Datensätze in einer bestimmten Partition gespeichert. In der untergeordneten Tabelle werden die untergeordneten Datensätze in der entsprechenden Partition gespeichert.
Beispiel: Eine Tabelle orders ist das übergeordnete Element der Tabelle line_items, wobei ein Primärschlüssel und ein Fremdschlüssel in order_id definiert sind. Die Tabellen werden nach Referenz partitioniert. Beispiel: Wenn die Datenbank Bestellung 233 in Partition Q3_2015 von orders speichert, speichert die Datenbank alle Positionen für Bestellung 233 in Partition Q3_2015 von line_items. Wenn Partition Q4_2015 zu orders hinzugefügt wird, fügt die Datenbank Q4_2015 automatisch zu line_items hinzu.
Die Vorteile der Referenzpartitionierung sind:
-
Wenn Sie dieselbe Partitionierungsstrategie sowohl für die übergeordnete als auch für die untergeordnete Tabelle verwenden, vermeiden Sie das Duplizieren aller Partitionierungsschlüsselspalten. Diese Strategie reduziert den manuellen Overhead der Denormalisierung und spart Platz.
-
Wartungsvorgänge für eine übergeordnete Tabelle werden automatisch in der untergeordneten Tabelle ausgeführt. Beispiel: Wenn Sie eine Partition zur primären Tabelle hinzufügen, propagiert die Datenbank diese Ergänzung automatisch an ihre untergeordneten Tabellen.
-
Die Datenbank verwendet automatisch partitionsweise Joins der Partitionen in der übergeordneten und untergeordneten Tabelle, wodurch die Performance verbessert wird.
Sie können die Referenzpartitionierung mit allen grundlegenden Partitionierungsstrategien verwenden, einschließlich der Intervallpartitionierung. Sie können auch partitionierte Referenztabellen als partitionierte Composite-Tabellen erstellen.
Beispiel 6-4: Referenzpartitionierte Tabellen erstellen
In diesem Beispiel wird eine übergeordnete Tabellenreihenfolge erstellt, die Range-partitioniert auf order_date ist. Die referenzpartitionierte untergeordnete Tabelle order_items wird mit vier Partitionen erstellt, Q1_2015, Q2_2015, Q3_2015 und Q4_2015, wobei jede Partition die order_items-Zeilen enthält, die den Anforderungen in der jeweiligen übergeordneten Partition entsprechen.
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
    PARTITION BY REFERENCE(order_items_fk);
Siehe auch: Oracle AI Database VLDB and Partitioning Guide für einen Überblick über die Referenzpartitionierung
Composite-Partitionierung
Bei der Composite-Partitionierung wird eine Tabelle nach einer Datenverteilungsmethode partitioniert. Anschließend wird jede Partition mit einer zweiten Datenverteilungsmethode weiter in Unterpartitionen unterteilt. Daher kombiniert die Composite-Partitionierung die grundlegenden Datenverteilungsmethoden. Alle Unterpartitionen für eine bestimmte Partition stellen eine logische Teilmenge der Daten dar.
Composite-Partitionierung bietet mehrere Vorteile:
-
Je nach SQL-Anweisung kann das Partitions-Pruning für eine oder zwei Dimensionen die Performance verbessern.
-
Abfragen können vollständige oder teilweise partitionsweise Joins für jede Dimension verwenden.
-
Sie können ein paralleles Backup und Recovery einer einzelnen Tabelle durchführen.
-
Die Anzahl der Partitionen ist größer als bei der Single-Level-Partitionierung, was für die parallele Ausführung von Vorteil sein kann.
-
Sie können ein rollierendes Fenster implementieren, um historische Daten zu unterstützen und trotzdem auf einer anderen Dimension zu partitionieren, wenn viele Anweisungen von Partitions-Pruning oder partitionsweisen Joins profitieren können.
-
Sie können Daten je nach Identifizierung durch einen Partitionierungsschlüssel unterschiedlich speichern. Beispiel: Sie können Daten für einen bestimmten Produkttyp in einem schreibgeschützten, komprimierten Format speichern und andere Produkttypdaten unkomprimieren.
Range-, List- und Hash-Partitionierung können als Unterpartitionsstrategien für zusammengesetzte partitionierte Tabellen verwendet werden. Die folgende Abbildung bietet eine grafische Ansicht der Range-Hash- und Range-List Composite-Partitionierung.
Abbildung 1: Composite Range-List-Partitionierung
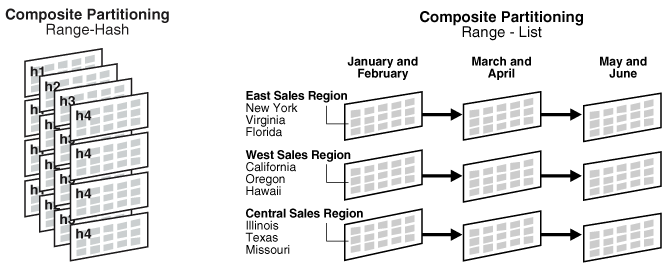
Beschreibung der Abbildung vldbg009.gif
Die Datenbank speichert jede Unterpartition in einer zusammengesetzten partitionierten Tabelle als separates Segment. Daher können sich Unterpartitionseigenschaften von den Eigenschaften der Tabelle oder von der Partition unterscheiden, zu der die Unterpartitionen gehören.
Siehe auch: Oracle AI Database VLDB and Partitioning Guide, um mehr über die Composite-Partitionierung zu erfahren
Partitionierte Tabellen
Eine partitionierte Tabelle besteht aus einer oder mehreren Partitionen, die einzeln verwaltet werden und unabhängig von den anderen Partitionen betrieben werden können.
Eine Tabelle ist partitioniert oder nicht partitioniert. Selbst wenn eine partitionierte Tabelle nur aus einer Partition besteht, unterscheidet sich diese Tabelle von einer nicht partitionierten Tabelle, der keine Partitionen hinzugefügt werden können.
-
Segmente für partitionierte Tabellen Eine partitionierte Tabelle besteht aus einem oder mehreren Tabellenpartitionssegmenten.
-
Komprimierung für partitionierte Tabellen Einige oder alle Partitionen einer Heap-organisierten Tabelle können in einem komprimierten Format gespeichert werden.
Siehe:
Beispiele für partitionierte Tabellen finden Sie unter "Partition Characteristics".
"Überblick über indexorganisierte Tabellen", um den Zweck und die Eigenschaften indexorganisierter Tabellen kennenzulernen. Diese können auch von einer Partitionierung profitieren, die eine verbesserte Verwaltbarkeit, Verfügbarkeit und Performance bietet.
Segmente für partitionierte Tabellen
Eine partitionierte Tabelle besteht aus einem oder mehreren Tabellenpartitionssegmenten.
Wenn Sie eine partitionierte Tabelle mit dem Namen hash_products erstellen, wird für diese Tabelle kein Tabellen-Segment zugewiesen. Stattdessen speichert die Datenbank Daten für jede Tabellenpartition in ihrem eigenen Partitionssegment. Jedes Tabellenpartitionssegment enthält einen Teil der Tabellendaten.
Wenn eine externe Tabelle partitioniert ist, befinden sich alle Partitionen außerhalb der Datenbank. In einer hybriden partitionierten Tabelle werden einige Partitionen in Segmenten gespeichert, andere hingegen extern. Beispiel: Einige Partitionen der Tabelle sales werden in Datendateien und andere in Kalkulationstabellen gespeichert.
Siehe:
Informationen zur Beziehung zwischen Objekten und Segmenten
Komprimierung für partitionierte Tabellen
Einige oder alle Partitionen einer Heap-organisierten Tabelle können in einem komprimierten Format gespeichert werden.
Die Komprimierung spart Platz und kann die Abfrageausführung beschleunigen. Aus diesem Grund kann die Komprimierung in Umgebungen wie Data Warehouses, in denen nur geringe Einfüge- und Updatevorgänge vorkommen, und in OLTP-Umgebungen nützlich sein.
Sie können die Attribute für die Tabellenkomprimierung für einen Tablespace, eine Tabelle oder eine Tabellenpartition deklarieren. Wenn die Deklaration auf Tablespace-Ebene erfolgt, werden Tabellen, die im Tablespace erstellt wurden, standardmäßig komprimiert. Sie können das Komprimierungsattribut für eine Tabelle ändern. In diesem Fall wird die Änderung nur auf neue Daten in dieser Tabelle angewendet. Folglich kann eine einzelne Tabelle oder Partition komprimierte und unkomprimierte Blöcke enthalten, wodurch sichergestellt wird, dass die Datengröße aufgrund der Komprimierung nicht erhöht wird. Wenn die Komprimierung die Größe eines Blocks erhöhen könnte, wendet die Datenbank ihn nicht auf den Block an.
Siehe:
-
"Tabellenkomprimierung", um Informationen zu Tabellenkomprimierungstypen zu erhalten, einschließlich grundlegender, erweiterter Zeilen und Hybrid Columnar Compression
-
Oracle AI Database Data Warehousing Guide für Informationen zur Tabellenkomprimierung in einem Data Warehouse
Partitionierte Indizes
Ein partitionierter Index ist ein Index, der wie eine partitionierte Tabelle in kleinere und besser zu verwaltende Teile unterteilt wurde.
Globale Indizes werden unabhängig von der Tabelle, für die sie erstellt werden, partitioniert, während lokale Indizes automatisch mit der Partitionierungsmethode für eine Tabelle verknüpft werden. Partitionierte Indizes verbessern wie partitionierte Tabellen die Verwaltbarkeit, Verfügbarkeit, Performance und Skalierbarkeit.
Die folgende Grafik zeigt Optionen für die Indexpartitionierung.
Abbildung 2: Indexpartitionierungsoptionen
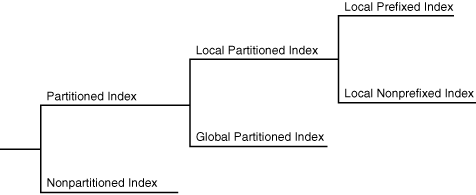
Beschreibung der Abbildung cncpt301.gif
-
Lokale partitionierte Indizes In einem lokalen partitionierten Index wird der Index auf dieselben Spalten partitioniert, wobei die Anzahl der Partitionen und die Partitionsgrenzen der Tabelle identisch sind.
-
Globale partitionierte Indizes Ein global partitionierter Index ist ein B*-Baumindex, der unabhängig von der zugrunde liegenden Tabelle, auf der er erstellt wird, partitioniert ist. Eine einzelne Indexpartition kann auf eine oder alle Tabellenpartitionen verweisen, während in einem lokal partitionierten Index eine Eins-zu-Eins-Parität zwischen Indexpartitionen und Tabellenpartitionen vorhanden ist.
Siehe:
-
"Einführung in Indizes", um den Unterschied zwischen eindeutigen und nicht eindeutigen Indizes und den verschiedenen Indextypen kennenzulernen
-
Oracle AI Database VLDB and Partitioning Guide für weitere Informationen zu partitionierten Indizes und zur Entscheidung, welcher Typ verwendet werden soll
Lokale partitionierte Indizes
In einem lokalen partitionierten Index wird der Index in dieselben Spalten partitioniert, wobei die Anzahl der Partitionen und die Partitionsgrenzen der Tabelle identisch sind.
Jede Indexpartition ist mit genau einer Partition der zugrunde liegenden Tabelle verknüpft, sodass alle Schlüssel in einer Indexpartition nur auf Zeilen verweisen, die in einer einzelnen Tabellenpartition gespeichert sind. Auf diese Weise synchronisiert die Datenbank Indexpartitionen automatisch mit den zugehörigen Tabellenpartitionen, sodass jedes Tabellenindexpaar unabhängig ist.
Lokale partitionierte Indizes sind in Data Warehousing-Umgebungen üblich. Lokale Indizes bieten folgende Vorteile:
-
Die Verfügbarkeit wird erhöht, weil Aktionen, die Daten in einer Partition ungültig oder nicht verfügbar machen, sich nur auf diese Partition auswirken.
-
Die Partitionsverwaltung wird vereinfacht. Wenn eine Tabellenpartition verschoben wird oder Daten aus einer Partition gelöscht werden, muss nur die zugehörige lokale Indexpartition neu erstellt oder verwaltet werden. In einem globalen Index müssen alle Indexpartitionen neu erstellt oder verwaltet werden.
-
Wenn ein Point-in-Time Recovery einer Partition stattfindet, können die Indizes bis zur Recovery-Zeit wiederhergestellt werden (siehe Oracle AI Database Backup and Recovery User's Guide). Der gesamte Index muss nicht neu erstellt werden.
Das Beispiel in Hash-Partitionierung zeigt die Erstellungsanweisung für die partitionierte Tabelle hash_sales, wobei die Spalte prod_id als Partitionsschlüssel verwendet wird. Im folgenden Beispiel wird ein lokaler partitionierter Index für die Spalte time_id der Tabelle hash_sales erstellt:
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;In Abbildung 6-3 verfügt die Tabelle hash_products über zwei Partitionen, sodass hash_sales_idx über zwei Partitionen verfügt. Jede Indexpartition ist mit einer anderen Tabellenpartition verknüpft. Indexpartition SYS_P38 indiziert Zeilen in Tabellenpartition SYS_P33, während Indexpartition SYS_P39 Zeilen in Tabellenpartition SYS_P34 indiziert.
Abbildung 3: Lokale Indexpartitionen
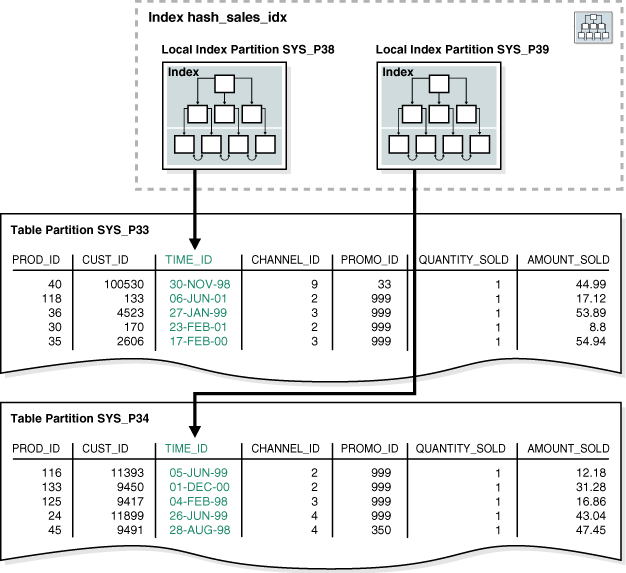
Beschreibung der Abbildung cncpt302.gif
Sie können eine Partition nicht explizit zu einem lokalen Index hinzufügen. Stattdessen werden neue Partitionen nur dann zu lokalen Indizes hinzugefügt, wenn Sie der zugrunde liegenden Tabelle eine Partition hinzufügen. Ebenso können Sie eine Partition nicht explizit aus einem lokalen Index löschen. Stattdessen werden lokale Indexpartitionen nur gelöscht, wenn Sie eine Partition aus der zugrunde liegenden Tabelle löschen.
Wie andere Indizes können Sie einen Bitmapindex für partitionierte Tabellen erstellen. Die einzige Einschränkung besteht darin, dass Bitmap-Indizes lokal für die partitionierte Tabelle sein müssen. Sie können keine globalen Indizes sein. Globale Bitmap-Indizes werden nur für nicht partitionierte Tabellen unterstützt.
-
Lokale Prefixed und Nonprefixed Indizes Lokale partitionierte Indizes sind entweder vorangestellt oder nicht vorangestellt.
-
Lokaler partitionierter Indexspeicher Wie eine Tabellenpartition wird eine lokale Indexpartition in einem eigenen Segment gespeichert. Jedes Segment enthält einen Teil der Gesamtindexdaten. Somit wird ein lokaler Index aus vier Partitionen nicht in einem einzelnen Indexsegment, sondern in vier separaten Segmenten gespeichert.
Lokale Indizes mit Präfix und ohne Präfix
Lokale partitionierte Indizes sind entweder vorangestellt oder nicht vorangestellt.
Die Indexuntertypen sind wie folgt definiert:
-
Lokale vorfixierte Indizes
In diesem Fall befinden sich die Partitionsschlüssel an der Vorderkante der Indexdefinition. Im Beispiel
time_range_salesin Bereichspartitionierung wird die Tabelle nach Bereich intime_idpartitioniert. Ein lokaler vorangestellter Index für diese Tabelle würdetime_idals erste Spalte in der Liste enthalten. -
Lokale, nicht vorangestellte Indizes
In diesem Fall befinden sich die Partitionsschlüssel nicht an der Vorderkante der indizierten Spaltenliste und müssen überhaupt nicht in der Liste enthalten sein. Im Beispiel
hash_sales_idxunter Lokale partitionierte Indizes ist der Index lokal und nicht als Präfix festgelegt, da sich der Partitionsschlüsselproduct_idnicht auf der Vorderseite befindet.
Beide Indextypen können die Eliminierung von Partitionen (auch als Partitions-Pruning bezeichnet) nutzen. Dies geschieht, wenn der Optimizer den Datenzugriff beschleunigt, indem Partitionen ausgeschlossen werden. Ob eine Abfrage Partitionen entfernen kann, hängt vom Abfrage-Prädikat ab. Eine Abfrage, die einen lokalen Index mit Präfix verwendet, ermöglicht immer die Eliminierung von Indexpartitionen, während eine Abfrage, die einen lokalen Index ohne Präfix verwendet, dies möglicherweise nicht tut.
Siehe auch: Oracle AI Database VLDB and Partitioning Guide enthält Informationen zur Verwendung von Indizes mit Präfix und ohne Präfix
Lokaler partitionierter Indexspeicher
Wie eine Tabellenpartition wird eine lokale Indexpartition in ihrem eigenen Segment gespeichert. Jedes Segment enthält einen Teil der Gesamtindexdaten. Somit wird ein lokaler Index aus vier Partitionen nicht in einem einzelnen Indexsegment, sondern in vier separaten Segmenten gespeichert.
Siehe auch: Oracle AI Database SQL Language Reference für CREATE INDEX ... LOCAL-Beispiele
Globale partitionierte Indizes
Ein global partitionierter Index ist ein B*-Baumindex, der unabhängig von der zugrunde liegenden Tabelle, auf der er erstellt wird, partitioniert ist. Eine einzelne Indexpartition kann auf eine oder alle Tabellenpartitionen verweisen, während in einem lokal partitionierten Index eine Eins-zu-Eins-Parität zwischen Indexpartitionen und Tabellenpartitionen vorhanden ist.
Im Allgemeinen sind globale Indizes für OLTP-Anwendungen nützlich, bei denen schneller Zugriff, Datenintegrität und Verfügbarkeit wichtig sind. In einem OLTP-System kann eine Tabelle durch einen Schlüssel partitioniert werden, z.B. die Spalte employees.department_id. Eine Anwendung muss jedoch möglicherweise mit vielen verschiedenen Schlüsseln auf die Daten zugreifen, z.B. mit employee_id oder job_id. Globale Indizes können in diesem Szenario nützlich sein.
Angenommen, Sie erstellen einen globalen partitionierten Index für die Tabelle time_range_sales aus "Range Partitioning". In dieser Tabelle werden Zeilen für Verkäufe aus dem Jahr 1998 in einer Partition gespeichert, Zeilen für Verkäufe aus dem Jahr 1999 in einer anderen Partition usw. Das folgende Beispiel erstellt einen globalen Index, der nach Bereich in der Spalte channel_id partitioniert ist:
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
       PARTITION p3 VALUES LESS THAN (MAXVALUE));
Wie in Abbildung 6-4 dargestellt, kann eine globale Indexpartition Einträge enthalten, die auf mehrere Tabellenpartitionen verweisen. Die Indexpartition p1 verweist auf die Zeilen mit dem Wert channel_id von 2, die Indexpartition p2 auf die Zeilen mit dem Wert channel_id von 3 und die Indexpartition p3 auf die Zeilen mit dem Wert channel_id von 4 oder 9.
Abbildung 4: Globaler partitionierter Index
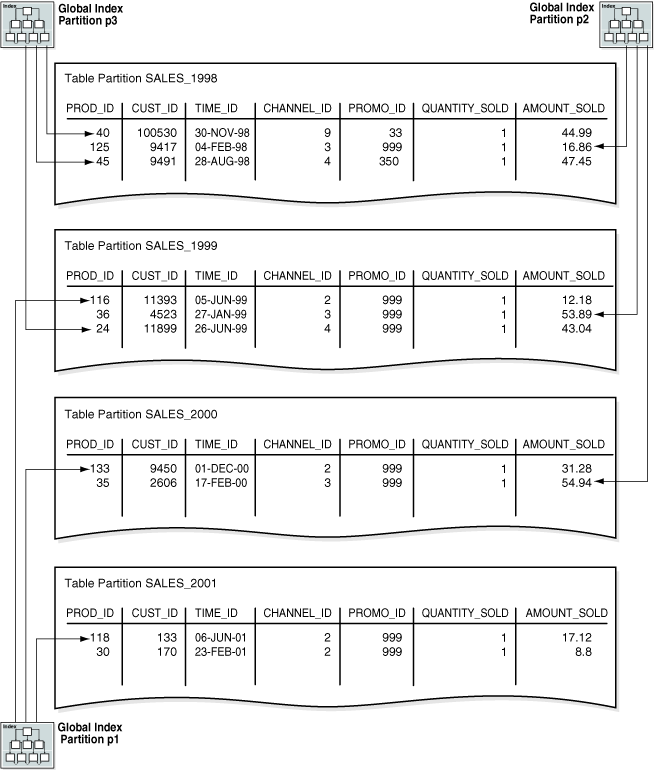
Beschreibung der Abbildung cncpt300.gif
Siehe:
-
Oracle AI Database VLDB and Partitioning Guide zum Verwalten globaler partitionierter Indizes
-
Oracle AI Database SQL Language Reference, um mehr über die
GLOBAL PARTITION-Klausel vonCREATE INDEXzu erfahren
Teilindizes für partitionierte Tabellen
Ein Teilindex ist ein Index, der mit den Indexierungseigenschaften einer zugehörigen partitionierten Tabelle korreliert ist.
Mit der Korrelation können Sie angeben, welche Tabellenpartitionen indiziert werden. Teilindizes bieten die folgenden Vorteile:
-
Nicht indizierte Tabellenpartitionen vermeiden, dass unnötiger Indexspeicherplatz belegt wird.
-
Die Performance von Ladevorgängen und Abfragen kann sich verbessern.
Vor Oracle Database 12c erforderte ein Austauschpartitionsvorgang eine physische Aktualisierung eines zugehörigen globalen Index, um ihn als verwendbar beizubehalten. Wenn ab Oracle Database 12c die Partitionen, die an einer Partitionswartung beteiligt sind, nicht Teil eines partiellen globalen Index sind, bleibt der Index ohne globale Indexwartung verwendbar.
-
Wenn Sie bei der Indexerstellung nur einige Tabellenpartitionen indexieren und später andere Partitionen indexieren, können Sie den für die Indexerstellung erforderlichen Sortierspeicher reduzieren.
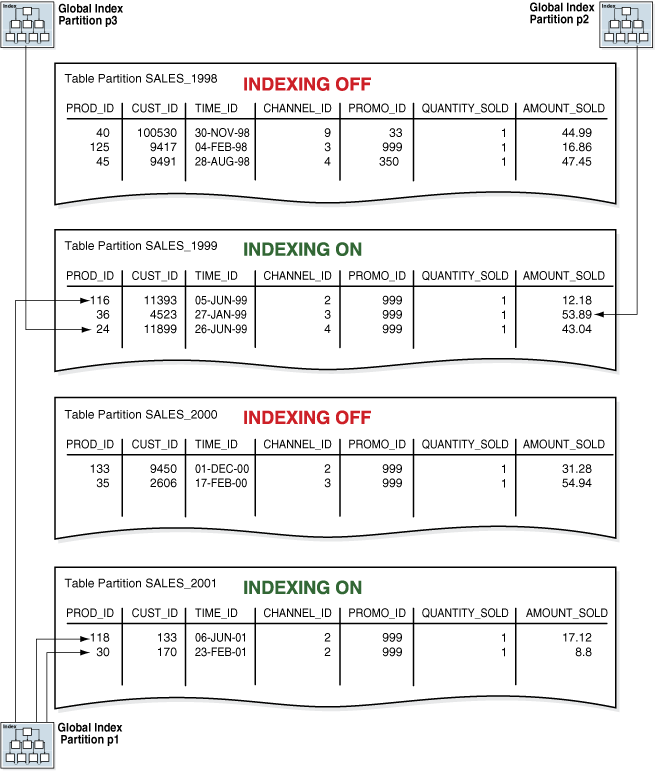
Sie können die Indexierung für die einzelnen Partitionen einer Tabelle ein- oder ausschalten. Ein partieller lokaler Index verfügt nicht über verwendbare Indexpartitionen für alle Tabellenpartitionen, bei denen die Indexierung deaktiviert ist. Ein globaler Index, unabhängig davon, ob er partitioniert ist oder nicht, schließt die Daten aus allen Partitionen aus, bei denen die Indexierung deaktiviert ist. Die Datenbank unterstützt keine Teilindizes für Indizes, die eindeutige Constraints durchsetzen. Abbildung 6-5 zeigt denselben globalen Index wie in Abbildung 6-4, mit der Ausnahme, dass der globale Index teilweise ist. Für die Tabellenpartitionen SALES_1998 und SALES_2000 ist die Indexierungseigenschaft auf OFF gesetzt, sodass sie vom partiellen globalen Index nicht indexiert werden.
Abbildung 5: Teilweiser globaler partitionierter Index
Beschreibung der Abbildung cncpt342.png
Objektspeicher für ältere Partitionen verwenden
Bei schreibgeschützten Partitionen können Sie kostengünstigen Speicher wie Objektspeicher in der Cloud verwenden.
Das Datenvolumen ist in den letzten zehn Jahren enorm gewachsen. Darüber hinaus haben staatliche Vorschriften und Richtlinien in vielen Fällen die Datenspeicherung für sehr große Zeiträume vorgeschrieben. Kunden von Oracle-Datenbanken verwenden verschiedene Datenmanagementstrategien für sehr große Datenbanken. Kunden haben die folgenden Hauptziele, die sie erfüllen möchten.
Große Datenmengen zu geringstmöglichen Kosten speichern Um die neuen gesetzlichen Anforderungen an die Datenspeicherung und den Datenschutz zu erfüllen Um die Geschäftschancen durch eine bessere Analyse auf der Grundlage einer erhöhten Datenmenge zu verbessern.
On-Premise-Kunden haben verschiedene Lösungen, um die oben genannten Ziele zu erreichen. Oracle AI Database bietet Ihnen jetzt dieses Feature, mit dem Sie ähnliche Datenmanagementstrategien für Ihre Cloud-Datenbanken entwickeln können, indem Sie kostengünstige Speicherebenen wie den Objektspeicher in der Cloud nutzen.
Oracle-Datenbankkunden haben mit der Entwicklung und dem Wachstum ihrer Datensätze verschiedene Datenmanagementstrategien entwickelt. Alle diese Strategien fallen unter Information Lifecycle Management (ILM). Einige der Datenbankfeatures, die bei der Implementierung einer ILM-Lösung helfen, umfassen Datenpartitionierung, Advanced Row Compression, Hybrid Columnar Compression, Automatic Data Optimization und andere.
Einer der Aspekte einer ILM-Lösung ist die Definition einer kostengünstigen Storage Tier. Dadurch können Sie große Datenmengen für die geringstmöglichen Kosten aufbewahren. Die Oracle ILM-Strategie ermöglicht die automatische Datenkomprimierung und Datenverschiebung auf eine kostengünstigere Speicherebene. Kunden von On-Premise-Oracle-Datenbanken verwenden Oracle-Speicherlösungen wie Oracle ZFS Storage Appliance oder Oracle Exadata Extended (XT) Storage Server als kostengünstige Speicheroption für Daten, auf die selten zugegriffen wird, ältere oder regulatorische Daten. Sie können auch ähnliche kostengünstige Speicheroptionen von Drittanbietern auswählen.
Mit dem Objektspeicher können Sie:
-
Speichern Sie ältere Partitionen und Read-Only Tablespaces im Objektspeicher.
-
Fragen Sie die Daten aus Objektspeicherdateien online ab.
-
Verhindern Sie unbefugten Zugriff auf Objektspeicherdateien, deren Eigentümer eine PDB aus einer anderen PDB ist.
-
Verschieben Sie Daten aus dem Objektspeicher in den regulären Speicher, wenn Sie Änderungen an schreibgeschützten Daten vornehmen möchten.
-
Tablespaces mit Datendateien im Objektspeicher löschen
-
Ältere Partitionen und Read-Only Tablespaces in Objektspeicher verschieben Sie können eine zeitbasierte Partitionierungsstrategie erstellen und die Datendateien für einen Read-Only Tablespace in eine kostengünstigere Storage Tier wie Object Storage verschieben.
-
Auf Objekte in Object Storage zugreifen Der Zugriff auf Daten aus Tabellen und Partitionen im Objektspeicher ist für Benutzer und SQL-Clients vollständig transparent.
-
Zugangsdatenverwaltung für Objektspeicherdateien Für den Zugriff auf Dateien im Objektspeicher sind Zugangsdaten erforderlich.
-
Datendateien aus Object Storage in traditionellen Speicher zurückversetzen Wenn Objektspeicherdaten aktualisiert werden müssen, müssen die Daten zuerst in den traditionellen Speicher zurückversetzt werden.
-
Objektspeicherdatendateien löschen Sie können Tablespaces mit Datendateien mit dem Standardbefehl
DROP TABLESPACElöschen.
Ältere Partitionen und schreibgeschützte Tablespaces in Objektspeicher verschieben
Sie können eine zeitbasierte Partitionierungsstrategie erstellen und die Datendateien für einen Read-Only Tablespace in eine kostengünstigere Storage Tier wie Object Storage verschieben.
Angenommen, Sie haben eine Tabelle mit dem Namen "Orders", die in der Spalte DATE Range partitioniert ist. Jede Partition enthält Zeilen für ein bestimmtes Jahr. Für 2022 und 2023 sind Partitionen vorhanden. Demnächst beschließt der Datenbankadministrator, eine neue Partition für das Jahr 2024 hinzuzufügen. Gleichzeitig entscheidet der Datenbankadministrator, dass die älteste Partition in eine kostengünstige Storage Tier verschoben werden soll.
Das folgende Workflowbeispiel stellt ein Szenario dar, in dem der Tablespace eine einzelne Partition für eine einzelne Tabelle enthält. Das ist keine Einschränkung. Der Read-Only Tablespace kann Partitionen für eine oder mehrere Tabellen enthalten. Außerdem haben Sie die Möglichkeit, die Partition zusätzlich zum Schreibschutz für den Tablespace schreibgeschützt zu machen. Als Best Practice können Sie festlegen, dass der Tablespace schreibgeschützt ist, und auf einen bestimmten Zeitraum warten, bevor Sie die Dateien in den Objektspeicher verschieben. Dadurch wird sichergestellt, dass alle Versuche, die schreibgeschützten Daten zu aktualisieren, abgefangen und ein Fehler zurückgegeben wird. Es ist viel schneller, mutierende Daten in einen anderen Tablespace zu verschieben, während sich die Daten noch in Exadata oder einem anderen herkömmlichen Speicher befinden. Es wird viel langsamer sein, wenn diese Daten aus dem Objektspeicher kopiert werden müssen.
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Auf Objekte in Object Storage zugreifen
Der Zugriff auf Daten aus Tabellen und Partitionen im Objektspeicher ist für Benutzer und SQL-Clients vollständig transparent.
Das Eingabe-/Ausgabe-Subsystem der Datenbank fragt intern Blöcke aus Dateien ab, die im Objektspeicher gespeichert sind. Die folgende SQL fragt die Zeilen aus der schreibgeschützten Partition orders_2022 ab, die im vorherigen Beispiel in den Objektspeicher verschoben wurde.
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
Vorhandene Indizes, sowohl global als auch lokal, arbeiten transparent. Die Abfrage von hybriden Spaltenkomprimierungsdaten und TDE-verschlüsselten Daten funktioniert sowohl transparent als auch aus Clientperspektive.
Zugangsdatenverwaltung für Objektspeicherdateien
Für den Zugriff auf Dateien im Objektspeicher sind Zugangsdaten erforderlich.
Ein Berechtigungsnachweis ist ein Datenbankobjekt, das einen Benutzernamen und ein Kennwort speichert. Die Zugangsdaten werden verschlüsselt und sicher im PDB-Schema gespeichert, in dem sie erstellt werden.
Wenn Sie Datendateien in den Objektspeicher verschieben möchten, müssen Sie Standardzugangsdaten definieren. Diese Standardzugangsdaten werden für den Zugriff auf Datendateien im Objektspeicher verwendet.
Wählen Sie die Standardzugangsdaten mit den minimal erforderlichen Berechtigungen. Nachdem die Standardzugangsdaten den Zugriff auf den Objektspeicher aktiviert haben, bestimmen die standardmäßige Datenbankauthentifizierung und -autorisierung, welche Datenbankbenutzer diese Datendateien abfragen oder bearbeiten können.
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Datendateien aus Object Storage in traditionellen Speicher verschieben
Wenn Objektspeicherdaten aktualisiert werden müssen, müssen die Daten zunächst wieder in den traditionellen Speicher verschoben werden.
In seltenen Fällen, in denen Sie die schreibgeschützten Daten ändern müssen, die sich bereits im Objektspeicher befinden, besteht die einzige Option darin, die Daten zurück aus dem Objektspeicher in den herkömmlichen Speicher zu verschieben. Der folgende Workflow zeigt, wie die Datendatei aus dem Objektspeicher zurück in das ASM-Dateisystem verschoben werden kann. Das Kopieren einer Datei aus dem Objektspeicher hat Auswirkungen auf die Performance.
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
Datendateien des Objektspeichers löschen
Sie können Tablespaces mit Datendateien mit dem Standardbefehl DROP TABLESPACE löschen.
Mit der Klausel AND DATAFILES werden die Datendateien aus dem Backend-Speicher gelöscht. Dadurch werden die Dateien aus dem Objektspeicher gelöscht. Wenn die Objektspeicherdatei mehrere Blöcke im Objektspeicher enthält, werden alle Blöcke sowie das Manifest gelöscht.
drop tablespace orders_2022 including contents and datafiles;Übersicht über in Shards unterteilte Tabellen
In einer Oracle-Datenbank können Sie mit dem Feature "Globally Distributed Database" alle Tabellen in sogenannte Shards aufteilen, die in mehreren Datenbanken gespeichert werden können.
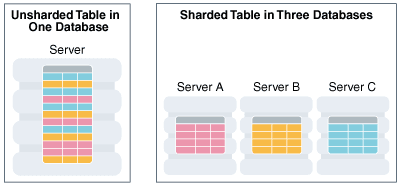
Bei der horizontalen Partitionierung wird eine Datenbanktabelle auf Shards aufgeteilt, sodass jedes Shard die Tabelle mit denselben Spalten, aber einer anderen Teilmenge von Zeilen enthält. Eine Tabelle, die auf diese Weise aufgeteilt wird, wird auch als gemeinsam verwendete Tabelle bezeichnet.
Die folgende Abbildung zeigt eine Tabelle, die horizontal über drei Shards partitioniert ist.
Abbildung 6: Horizontale Partitionierung einer Tabelle über Shards
Beschreibung der Abbildung admin_3v_134a.png
- Gemeinsam verwendete Tabellen Eine Datenbanktabelle wird auf die Shards aufgeteilt, sodass jedes Shard die Tabelle mit denselben Spalten, jedoch eine unterschiedliche Teilmenge von Zeilen enthält. Eine Tabelle, die auf diese Weise aufgeteilt wird, wird als gemeinsam verwendete Tabelle bezeichnet. Siehe auch: Oracle Globally Distributed AI Database
Shard-Tabellen
Eine Datenbanktabelle wird auf die Shards aufgeteilt, sodass jedes Shard die Tabelle mit denselben Spalten, jedoch eine unterschiedliche Teilmenge von Zeilen enthält. Eine Tabelle, die auf diese Weise aufgeteilt wird, wird als gemeinsam verwendete Tabelle bezeichnet.
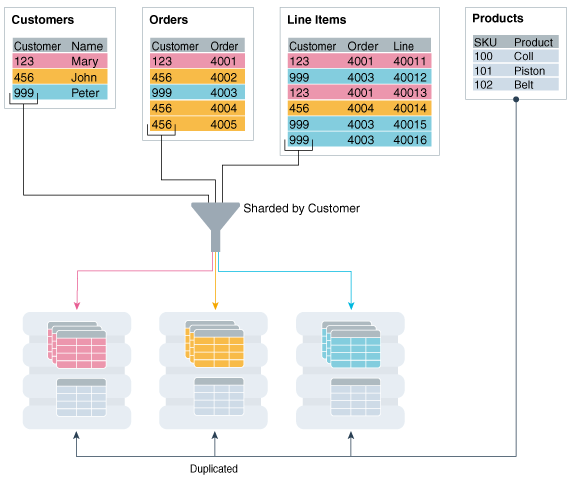
Die folgende Abbildung zeigt, wie eine Gruppe von Tabellen (als Tabellenfamilie bezeichnet) horizontal über eine Gruppe von Shard-PDBs partitioniert werden kann, sodass jedes Shard eine Teilmenge der Daten enthält, die mit roten, gelben und blauen Zeilen gekennzeichnet sind.
Abbildung 7: Horizontale Partitionierung einer Tabelle über Shards
Beschreibung der Abbildung admin_3v_138e.png
Partitionen werden auf Tablespace-Ebene auf Shards verteilt, die auf einem Sharding-Schlüssel basieren. Beispiele für Schlüssel sind Kunden-ID, Kontonummer und Länder-ID.
Jede Partition einer in Shards unterteilten Tabelle befindet sich in einem separaten Tablespace, und jeder Tablespace ist mit einem bestimmten Shard verknüpft. Je nach Sharding-Methode kann die Zuordnung automatisch erstellt oder vom Administrator definiert werden.
Obwohl sich die Partitionen einer in Shards unterteilten Tabelle in mehreren Shards befinden, sieht und verhält sich die Tabelle für die Anwendung genauso wie eine partitionierte Tabelle in einer einzelnen Datenbank. Von einer Anwendung abgesetzte SQL-Anweisungen müssen niemals auf Shards verweisen oder von der Anzahl der Shards und ihrer Konfiguration abhängen.
Die bekannte SQL-Syntax für die Tabellenpartitionierung gibt an, wie Zeilen über Shards partitioniert werden sollen. Beispiel: Mit der folgenden SQL-Anweisung wird eine in Shards unterteilte Tabelle erstellt, wobei die Tabelle basierend auf dem Sharding-Schlüssel cust_id horizontal partitioniert wird.
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;
Die in Shards unterteilte Tabelle im obigen Beispiel wird durch konsistenten Hash partitioniert, einen speziellen Hash-Partitionierungstyp, der häufig in skalierbaren verteilten Systemen verwendet wird. Diese Technik verteilt Tablespaces automatisch auf Shards, um eine gleichmäßige Verteilung von Daten und Arbeitslast zu gewährleisten. Hinweis: Globale Indizes für in Shards unterteilte Tabellen werden nicht unterstützt. Lokale Indizes werden jedoch unterstützt.
Überblick über Ansichten
Eine Ansicht ist eine logische Darstellung einer oder mehrerer Tabellen. Im Wesentlichen ist eine View eine gespeicherte Abfrage.
Eine View leitet ihre Daten aus den Tabellen ab, auf denen sie basiert, die als Basistabellen bezeichnet werden. Basistabellen können Tabellen oder andere Views sein. Alle an einer View ausgeführten Vorgänge wirken sich auf die Basistabellen aus. Sie können Views an den meisten Stellen verwenden, an denen Tabellen verwendet werden.
Hinweis: Materialized Views verwenden eine andere Datenstruktur als Standard-Views.
Mit Ansichten können Sie die Darstellung der Daten an verschiedene Benutzertypen anpassen. Views werden häufig verwendet, um:
-
eine zusätzliche Sicherheitsebene auf Tabellenebene schaffen, indem der Zugriff auf eine vorher festgelegte Gruppe von Zeilen oder Spalten einer Tabelle eingeschränkt werden
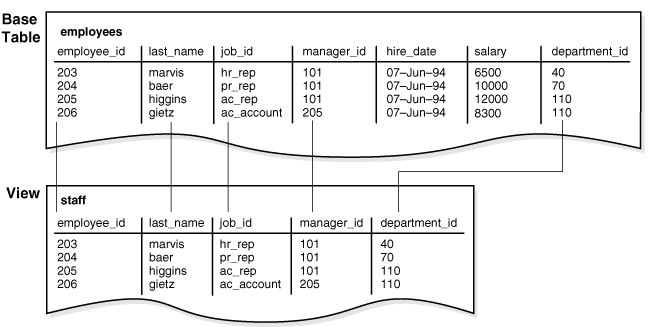
Beispiel: Abbildung 6-8 zeigt, wie in der Ansicht
staffdie Spaltensalaryodercommission_pctder Basistabelleemployeesnicht angezeigt werden. -
Datenkomplexität ausblenden
Beispiel: Eine einzelne Ansicht kann mit einem Join definiert werden. Dabei handelt es sich um eine Sammlung zusammengehöriger Spalten oder Zeilen in mehreren Tabellen. Die View verbirgt jedoch die Tatsache, dass diese Informationen tatsächlich aus mehreren Tabellen stammen. Eine Abfrage kann auch umfangreiche Berechnungen mit Tabelleninformationen durchführen. So können Benutzer eine View abfragen, ohne zu wissen, wie Joins oder Berechnungen ausgeführt werden.
-
die Daten aus einer anderen Perspektive darzustellen als die der Basistabelle
Beispiel: Die Spalten einer Ansicht können umbenannt werden, ohne dass sich dies auf die Tabellen auswirkt, auf denen die Ansicht basiert.
-
Anwendungen von Änderungen in Definitionen von Basistabellen isolieren
Beispiel: Wenn die definierende Abfrage einer Ansicht drei Spalten einer Tabelle mit vier Spalten referenziert und der Tabelle eine fünfte Spalte hinzugefügt wird, ist die Definition der Ansicht nicht betroffen, und alle Anwendungen, die diese Ansicht verwenden, sind nicht betroffen.
Ein Beispiel für die Verwendung von Views ist die Tabelle hr.employees, die mehrere Spalten und zahlreiche Zeilen enthält. Damit Benutzer nur fünf dieser Spalten oder nur bestimmte Zeilen anzeigen können, können Sie eine View wie folgt erstellen:
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
Wie bei allen Unterabfragen kann die Abfrage, die eine View definiert, nicht die FOR UPDATE-Klausel enthalten. Die folgende Grafik zeigt die Ansicht mit dem Namen staff. Beachten Sie, dass in der View nur fünf der Spalten in der Basistabelle angezeigt werden.
Abbildung 8: Anzeigen
Beschreibung der Abbildung cncpt045.gif
-
Eigenschaften von Ansichten Im Gegensatz zu einer Tabelle ist einer Ansicht kein Speicherplatz zugewiesen, und eine Ansicht enthält auch keine Daten. Eine View wird vielmehr durch eine Abfrage definiert, die Daten aus den Basistabellen extrahiert oder ableitet, die von der View referenziert werden. Da eine View auf anderen Objekten basiert, benötigt sie nur Speicher für die Abfrage, die die View im Data Dictionary definiert.
-
Aktualisierbare Join-Ansichten Eine Join-Ansicht enthält mehrere Tabellen oder Ansichten in der
FROM-Klausel. -
Objektansichten Wie eine Ansicht eine virtuelle Tabelle ist, ist eine Objektansicht eine virtuelle Objekttabelle. Jede Zeile in der Ansicht ist ein Objekt, das eine Instanz eines Objekttyps ist. Ein Objekttyp ist ein benutzerdefinierter Datentyp.
Siehe:
-
Oracle AI Database Administrator's Guide zum Verwalten von Ansichten
-
Oracle AI Database SQL Language Reference für
CREATE VIEW-Syntax und Semantik
Eigenschaften von Ansichten
Im Gegensatz zu einer Tabelle wird einer View weder Speicherplatz zugewiesen, noch enthält eine View Daten. Eine View wird vielmehr durch eine Abfrage definiert, die Daten aus den Basistabellen extrahiert oder ableitet, die von der View referenziert werden. Da eine View auf anderen Objekten basiert, benötigt sie nur Speicher für die Abfrage, die die View im Data Dictionary definiert.
Eine View weist Abhängigkeiten von den referenzierten Objekten auf, die automatisch von der Datenbank verarbeitet werden. Beispiel: Wenn Sie eine Basistabelle einer View löschen und neu erstellen, bestimmt die Datenbank, ob die neue Basistabelle für die View-Definition akzeptabel ist.
-
Datenbearbeitung in Ansichten Da Ansichten aus Tabellen abgeleitet werden, weisen sie viele Ähnlichkeiten auf. Benutzer können Views abfragen, und mit einigen Einschränkungen können sie DML für Views ausführen. Vorgänge, die für eine View ausgeführt werden, wirken sich auf Daten in einer Basistabelle der View aus und unterliegen den Integritäts-Constraints und Triggern der Basistabellen.
-
Zugriff auf Daten in Ansichten Oracle AI Database speichert eine Ansichtsdefinition im Data Dictionary als Text der Abfrage, mit der die Ansicht definiert wird.
Datenbearbeitung in Views
Da Views aus Tabellen abgeleitet werden, weisen sie viele Ähnlichkeiten auf. Benutzer können Views abfragen, und mit einigen Einschränkungen können sie DML für Views ausführen. Vorgänge, die für eine View ausgeführt werden, wirken sich auf Daten in einer Basistabelle der View aus und unterliegen den Integritäts-Constraints und Triggern der Basistabellen.
Im folgenden Beispiel wird eine Ansicht der Tabelle hr.employees erstellt:
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
Die definierende Abfrage referenziert nur Zeilen für Abteilung 10. Die CHECK OPTION erstellt die View mit einem Constraint, sodass die für die View abgesetzten Anweisungen INSERT und UPDATE nicht zu Zeilen führen können, die von der View nicht ausgewählt werden können. Auf diese Weise können Datensätze für Mitarbeiter in Abteilung 10 eingefügt werden, jedoch keine Datensätze für Abteilung 30.
Siehe auch: Oracle AI Database SQL Language Reference enthält Informationen zu Unterabfrageeinschränkungen in CREATE VIEW-Anweisungen
Zugriff auf Daten in Ansichten
Oracle AI Database speichert eine View-Definition im Data Dictionary als Text der Abfrage, die die View definiert.
Wenn Sie eine View in einer SQL-Anweisung referenzieren, führt Oracle AI Database die folgenden Aufgaben aus:
-
Führt eine Abfrage (sofern möglich) mit den Abfragen zusammen, die den View definieren, und allen zugrunde liegenden Views.
Oracle AI Database optimiert die zusammengeführte Abfrage so, als hätten Sie die Abfrage abgesetzt, ohne die Views zu referenzieren. Daher kann Oracle AI Database Indizes für alle referenzierten Basistabellenspalten verwenden, unabhängig davon, ob die Spalten in der View-Definition oder in der Benutzerabfrage für die View referenziert werden.
Manchmal kann Oracle AI Database die Ansichtsdefinition nicht mit der Benutzerabfrage zusammenführen. In solchen Fällen verwendet Oracle AI Database möglicherweise nicht alle Indizes für referenzierte Spalten.
-
Parst die zusammengeführte Anweisung in einem Shared SQL-Bereich
Oracle AI Database parst eine Anweisung, die eine Ansicht in einem neuen Shared SQL-Bereich referenziert, nur, wenn kein vorhandener Shared SQL-Bereich eine ähnliche Anweisung enthält. Daher bieten Views den Vorteil einer reduzierten Speicherauslastung im Zusammenhang mit Shared SQL.
-
Führt die SQL-Anweisung
Das folgende Beispiel veranschaulicht den Datenzugriff, wenn eine Ansicht abgefragt wird. Angenommen, Sie erstellen employees_view basierend auf den Tabellen employees und departments:
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
Ein Benutzer führt die folgende Abfrage von employees_view aus:
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Database führt die View und die Benutzerabfrage zusammen, um die folgende Abfrage zu erstellen. Diese Abfrage wird dann ausgeführt, um die Daten abzurufen:
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
Siehe:
-
SQL Tuning Guide für Oracle AI Database mit Informationen zur Abfrageoptimierung
Aktualisierbare Join Views
Eine Join-Ansicht enthält mehrere Tabellen oder Views in der FROM-Klausel.
Im folgenden Beispiel verknüpft die View staff_dept_10_30 die Tabellen employees und departments, einschließlich nur Mitarbeiter in den Abteilungen 10 oder 30:
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND    e.department_id = d.department_id;
Eine updatierbare Join-Ansicht, die auch als modifizierbare Join-Ansicht bezeichnet wird, umfasst zwei oder mehr Basistabellen oder -ansichten und ermöglicht DML-Vorgänge. Eine aktualisierbare View enthält mehrere Tabellen in der FROM-Klausel der obersten Ebene der SELECT-Anweisung. Sie ist nicht durch die WITH READ ONLY-Klausel eingeschränkt.
Damit eine View von Natur aus aktualisiert werden kann, muss sie mehrere Kriterien erfüllen. Beispiel: Eine allgemeine Regel lautet, dass ein INSERT-, UPDATE- oder DELETE-Vorgang für eine Join-Ansicht nur jeweils eine Basistabelle ändern kann. Die folgende Abfrage der Data Dictionary-View USER_UPDATABLE_COLUMNS zeigt, dass die View staff_dept_10_30 aktualisierbar ist:
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
Ab Oracle Database Release 21c ist es nicht erforderlich, dass alle aktualisierbaren Spalten in einer Join-Ansicht Spalten einer schlüsselbeibehaltenen Tabelle zugeordnet werden. Die Tabelle, in der die Schlüssel beibehalten werden, ist eine Tabelle, in der jede Zeile der zugrunde liegenden Tabelle höchstens einmal in der Abfrageausgabe angezeigt wird. In der Ansicht staff_dept_10_30 ist department_id der Primärschlüssel der Tabelle departments. Daher wird jede Zeile aus der Tabelle employees maximal einmal in der Ergebnismenge angezeigt, sodass die Tabelle employees schlüsselsicher bleibt. Die Tabelle departments ist nicht schlüsselsicher, da jede ihrer Zeilen mehrmals in der Ergebnismenge angezeigt werden kann. Die Spalten in einer Tabelle, die keinen Schlüssel enthält, können aktualisiert werden, wenn der Vorgang UPDATE nur Spalten aus einer einzelnen Tabelle aktualisiert und die Aktualisierung deterministisch ist. Das heißt, jede Zeile wird nur einmal aktualisiert.
Siehe auch: Im Oracle AI Database Administrator's Guide erfahren Sie, wie Join-Ansichten aktualisiert werden.
Objektansichten
Genauso wie eine View eine virtuelle Tabelle ist, ist eine Objektansicht eine virtuelle Objekttabelle. Jede Zeile in der Ansicht ist ein Objekt, das eine Instanz eines Objekttyps ist. Ein Objekttyp ist ein benutzerdefinierter Datentyp.
Sie können relationale Daten abrufen, aktualisieren, einfügen und löschen, als wären sie als Objekttyp gespeichert. Sie können auch Views mit Spalten definieren, die Objektdatentypen sind, z.B. Objekte, REFs und Collections (Nested Tables und VARRAYs).
Wie relationale Ansichten können Objektansichten nur die Daten darstellen, die von Datenbankadministratoren angezeigt werden sollen. Beispielsweise könnte eine Objektansicht Daten über IT-Programmierer darstellen, aber vertrauliche Daten über Gehälter weglassen. Im folgenden Beispiel wird ein employee_type-Objekt und dann die View it_prog_view basierend auf diesem Objekt erstellt:
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
Objektansichten sind beim Prototyping oder beim Übergang zu objektorientierten Anwendungen nützlich, da die Daten in der Ansicht aus relationalen Tabellen übernommen und aufgerufen werden können, als ob die Tabelle als Objekttabelle definiert wäre. Sie können objektorientierte Anwendungen ausführen, ohne vorhandene Tabellen in eine andere physische Struktur zu konvertieren.
Siehe:
-
Oracle AI Database Object-Relational Developer's Guide enthält Informationen zu Objekttypen und Objektansichten
-
Oracle AI Database SQL Language Reference, um mehr über die
CREATE TYPE-Anweisung zu erfahren
Materialized Views – Überblick
Eine Materialized View ist ein Abfrageergebnis, das im Voraus als Schemaobjekt gespeichert oder "materialisiert" wurde. Die FROM-Klausel der Abfrage kann Tabellen, Views oder Materialized Views benennen.
Eine Materialized View dient häufig als Mastertabelle in der Replikation und als Fakttabelle im Data Warehousing. Materialized Views fassen Daten zusammen, berechnen, replizieren und verteilen sie. Sie eignen sich für verschiedene Computing-Umgebungen, wie z. B.:
-
In Data Warehouses können Materialized Views Daten berechnen und speichern, die aus Aggregatfunktionen wie Summen und Durchschnittswerten generiert wurden.
Eine Zusammenfassung ist eine Aggregatansicht, die die Abfragezeit reduziert, indem Joins und Aggregationsvorgänge vorab berechnet und die Ergebnisse in einer Tabelle gespeichert werden. Materialized Views entsprechen Summen. Sie können auch Materialized Views verwenden, um Joins mit oder ohne Aggregationen zu berechnen.
-
Bei der Materialized View-Replikation, die mit XStream und Oracle GoldenGate erreicht wird, enthält die Ansicht eine vollständige oder teilweise Kopie einer Tabelle von einem einzigen Zeitpunkt an. Materialized Views replizieren Daten an verteilten Sites und synchronisieren Updates, die an mehreren Sites ausgeführt werden. Diese Form der Replikation eignet sich für Umgebungen wie den Außendienst, wenn Datenbanken nicht immer mit dem Netzwerk verbunden sind.
-
In mobilen Computing-Umgebungen können Materialized Views eine Datenteilmenge von zentralen Servern auf mobile Clients herunterladen, wobei regelmäßige Aktualisierungen von den zentralen Servern und die Verbreitung von Updates durch Clients auf die zentralen Server erfolgen.
In einer Replikationsumgebung nutzt eine Materialized View Daten gemeinsam mit einer Tabelle in einer anderen Datenbank, die als Masterdatenbank bezeichnet wird. Die Tabelle, die mit der Materialized View an der Master Site verknüpft ist, ist die Master-Tabelle. In Abbildung 6-9 wird eine Materialized View in einer Datenbank dargestellt, die auf einer Master-Tabelle in einer anderen Datenbank basiert. Aktualisierungen der Master-Tabelle werden in der Materialized View-Datenbank repliziert.
Abbildung 9: Materialized View
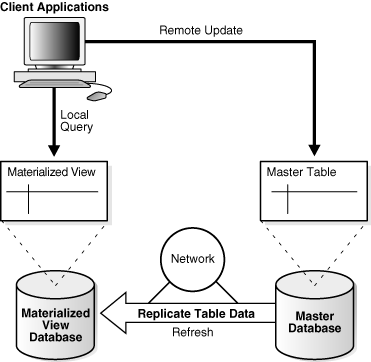
Beschreibung der Abbildung cncpt260.gif
-
Eigenschaften von Materialized Views Materialized Views verwenden einige Eigenschaften von Indizes und nicht materialisierten Views gemeinsam.
-
Aktualisierungsmethoden für Materialized Views Die Datenbank verwaltet Daten in Materialized Views, indem sie diese nach Änderungen an den Basistabellen aktualisiert. Die Aktualisierungsmethode kann inkrementell oder eine vollständige Aktualisierung sein.
-
Automatische Materialized Views Ab Oracle Database Release 21c können Materialized Views automatisch erstellt und verwaltet werden.
-
Query Rewrite transformiert eine in Form von Master-Tabellen geschriebene Benutzeranforderung in eine semantisch äquivalente Anforderung, die Materialized Views einbezieht.
Siehe:
-
Oracle AI Database Data Warehousing Guide für weitere Informationen zu Zusammenfassungen
-
Oracle AI Database XStream Guide für eine Einführung in XStream
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html, um mehr über Oracle GoldenGate zu erfahren
-
Oracle AI Database SQL Language Reference, um mehr über die
CREATE MATERIALIZED VIEW-Anweisung zu erfahren
Eigenschaften von Materialized Views
Materialized Views weisen einige Eigenschaften von Indizes und nicht materialisierten Views auf.
Materialized Views ähneln Indizes auf folgende Weise:
-
Sie enthalten tatsächliche Daten und belegen Speicherplatz.
-
Sie können aktualisiert werden, wenn sich die Daten in den Master-Tabellen ändern.
-
Sie können die Performance der SQL-Ausführung verbessern, wenn sie für Query Rewrite-Vorgänge verwendet wird.
-
Ihre Existenz ist für SQL-Anwendungen und -Benutzer transparent.
Eine Materialized View ähnelt einer nicht materialisierten View, da sie Daten in anderen Tabellen und Views darstellt. Im Gegensatz zu Indizes können Benutzer Materialized Views direkt mit SELECT-Anweisungen abfragen. Je nach erforderlichen Refresh-Typen können die Views auch mit DML-Anweisungen aktualisiert werden.
Im folgenden Beispiel wird eine Materialized Aggregat-View basierend auf drei Mastertabellen im Beispielschema sh erstellt und aufgefüllt:
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
Im folgenden Beispiel wird die Tabelle sales gelöscht, die eine Mastertabelle für sales_mv ist, und dann sales_mv abgefragt. Die Abfrage wählt Daten aus, da die Zeilen getrennt von den Daten in den Master-Tabellen gespeichert (materialisiert) werden.
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
Eine Materialized View kann partitioniert werden. Sie können eine Materialized View auf einer partitionierten Tabelle definieren. Außerdem können Sie einen oder mehrere Indizes auf der Materialized View definieren.
Siehe auch: Im Oracle AI Database Data Warehousing Guide erfahren Sie, wie Sie Materialized Views in einem Data Warehouse verwenden.
Aktualisierungsmethoden für Materialized Views
Die Datenbank verwaltet Daten in Materialized Views, indem sie diese nach Änderungen an den Basistabellen aktualisiert. Die Aktualisierungsmethode kann inkrementell oder eine vollständige Aktualisierung sein.
-
Aktualisierung abschließen Eine vollständige Aktualisierung führt die Abfrage aus, mit der die Materialized View definiert wird. Eine vollständige Aktualisierung erfolgt beim erstmaligen Erstellen der Materialized View, es sei denn, die Materialized View referenziert eine vordefinierte Tabelle, oder Sie definieren die Tabelle als
BUILD DEFERRED. -
Inkrementelle Aktualisierung Bei einer inkrementellen Aktualisierung, auch als schnelle Aktualisierung bezeichnet, werden nur die Änderungen an den vorhandenen Daten verarbeitet. Bei dieser Methode müssen Materialized Views nicht von Anfang an neu erstellt werden. Die Verarbeitung nur der Änderungen kann zu einer sehr schnellen Aktualisierungszeit führen.
-
In-Place- und Out-of-Place-Aktualisierung Für die vollständigen und inkrementellen Methoden kann die Datenbank die Materialized View an Ort und Stelle aktualisieren. Dadurch werden Anweisungen direkt in der View oder außerhalb der View aktualisiert.
Vollständige Aktualisierung
Eine vollständige Aktualisierung führt die Abfrage aus, mit der die Materialized View definiert wird. Eine vollständige Aktualisierung erfolgt beim erstmaligen Erstellen der Materialized View, es sei denn, die Materialized View referenziert eine vordefinierte Tabelle, oder Sie definieren die Tabelle als BUILD DEFERRED.
Eine vollständige Aktualisierung kann langsam sein, insbesondere wenn die Datenbank große Datenmengen lesen und verarbeiten muss. Nach der Erstellung der Materialized View können Sie jederzeit eine vollständige Aktualisierung durchführen.
Inkrementelle Aktualisierung
Eine inkrementelle Aktualisierung, auch als schnelle Aktualisierung bezeichnet, verarbeitet nur die Änderungen an den vorhandenen Daten. Bei dieser Methode müssen Materialized Views nicht von Anfang an neu erstellt werden. Die Verarbeitung nur der Änderungen kann zu einer sehr schnellen Aktualisierungszeit führen.
Sie können Materialized Views entweder nach Bedarf oder in regelmäßigen Zeitintervallen aktualisieren. Alternativ können Sie Materialized Views in derselben Datenbank wie ihre Basistabellen so konfigurieren, dass sie aktualisiert werden, wenn eine Transaktion Änderungen an den Basistabellen festschreibt.
Fast Refreshes sind in einer der folgenden Formen verfügbar:
-
Logbasierte Aktualisierung
Bei dieser Art der Aktualisierung werden in einem Materialized View Log oder einem Direct Loader Log Änderungen an den Basistabellen aufgezeichnet. Ein Materialized View Log ist ein Schemaobjekt, das Änderungen an einer Basistabelle aufzeichnet, sodass eine in der Basistabelle definierte Materialized View inkrementell aktualisiert werden kann. Jedes Materialized View Log ist mit einer einzelnen Basistabelle verknüpft.
-
Partitionsänderungsverfolgung (PCT) aktualisieren
PCT-Aktualisierung ist nur gültig, wenn die Basistabellen partitioniert sind. Bei der PCT-Aktualisierung werden alle Daten in den betroffenen Materialized View-Partitionen oder betroffenen Datenteilen entfernt und anschließend neu berechnet. Die Datenbank verwendet die geänderten Basistabellenpartitionen, um die betroffenen Partitionen oder Datenteile in der Ansicht zu identifizieren. Wenn Partitionswartungsvorgänge für die Basistabellen ausgeführt wurden, ist die PCT-Aktualisierung die einzige verwendbare inkrementelle Aktualisierungsmethode.
Aktualisierung an Ort und Stelle (Out-of-Place)
Für die vollständigen und inkrementellen Methoden kann die Datenbank die vorhandene Materialized View aktualisieren. Dadurch werden Anweisungen direkt in der View oder außerhalb der View aktualisiert.
Eine Out-of-Place-Aktualisierung erstellt eine oder mehrere externe Tabellen, führt die Refresh-Anweisungen für sie aus und schaltet dann die Materialized View oder die betroffenen Partitionen mit den externen Tabellen um. Diese Technik erreicht eine hohe Verfügbarkeit während der Aktualisierung, insbesondere wenn die Ausführung von Aktualisierungsanweisungen lange dauert.
Die synchrone Aktualisierung ist eine Art von Out-of-Place-Aktualisierung. Bei einer synchronen Aktualisierung wird der Inhalt der Basistabellen nicht geändert, sondern die APIs im Paket für die synchrone Aktualisierung verwendet. Dies gewährleistet Konsistenz, indem diese Änderungen gleichzeitig auf die Basistabellen und Materialized Views angewendet werden. Mit diesem Ansatz können eine Gruppe von Tabellen und die für sie definierten Materialized Views immer synchronisiert werden. In einem Data Warehouse ist die Methode der synchronen Aktualisierung aus den folgenden Gründen gut geeignet:
-
Das Laden von inkrementellen Daten wird streng kontrolliert und erfolgt in regelmäßigen Abständen.
-
Tabellen und ihre Materialized Views werden häufig auf dieselbe Weise partitioniert, oder ihre Partitionen sind von einer funktionalen Abhängigkeit abhängig.
Siehe auch: Im Oracle AI Database Data Warehousing Guide erfahren Sie, wie Sie Materialized Views aktualisieren.
Automatische Materialized Views
Ab Oracle Database Release 21c können Materialized Views automatisch erstellt und verwaltet werden.
Oracle AI Database kann Materialized Views automatisch erstellen und verwalten, um die Abfrageperformance zu optimieren. Mit sehr wenig oder keiner Interaktion mit dem DBA überwachen und analysieren Hintergrundaufgaben Workload-Eigenschaften und identifizieren, wo Materialized Views die SQL-Performance verbessern. Der Performancevorteil von Materialized Views für Kandidaten wird im Hintergrund (mit Workload-Abfragen) gemessen, bevor sie für die Workload sichtbar gemacht werden.
Siehe:
-
Oracle AI Database Data Warehousing Guide für weitere Informationen
-
Oracle AI Database PL/SQL Packages and Types Reference, in der Sie erfahren, wie Sie das Package
DBMS_AUTO_MVzur Implementierung automatischer Materialized Views verwenden
Query Rewrite
Query Rewrite transformiert eine in Form von Master-Tabellen geschriebene Benutzeranforderung in eine semantisch äquivalente Anforderung, die Materialized Views einbezieht.
Wenn Basistabellen große Datenmengen enthalten, ist die Berechnung eines Aggregats oder Joins teuer und zeitaufwendig. Da Materialized Views vorab berechnete Aggregate und Joins enthalten, kann Query Rewrite Abfragen mithilfe von Materialized Views schnell beantworten.
Der Abfragetransformator schreibt die Anforderung zur Verwendung der Materialized View transparent um, sodass kein Benutzereingriff und keine Referenz auf die Materialized View in der SQL-Anweisung erforderlich sind. Da das Neuschreiben der Abfrage transparent ist, können Materialized Views hinzugefügt oder gelöscht werden, ohne dass die SQL im Anwendungscode ungültig wird.
Im Allgemeinen verbessert das Umschreiben von Abfragen, um Materialized Views anstelle von Detailtabellen zu verwenden, die Antwortzeit. Die folgende Abbildung zeigt die Datenbank, die einen Ausführungsplan für die ursprüngliche und umgeschriebene Abfrage generiert und den Kostenplan mit den niedrigsten Kosten auswählt.
Abbildung 10: Query Rewrite
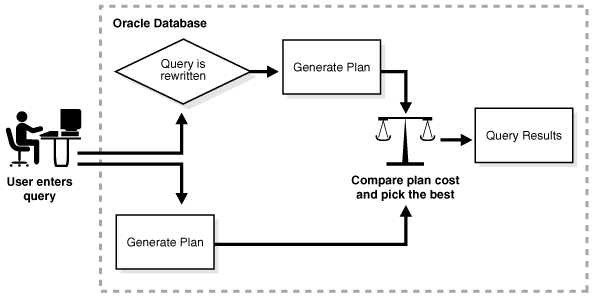
Beschreibung der Abbildung cncpt334.gif
Siehe:
-
"Überblick über den Optimizer", um mehr über die Abfragetransformation zu erfahren
-
Oracle AI Database Data Warehousing Guide mit Informationen zur Verwendung von Query Rewrite
Sequences - Überblick
Eine Sequenz ist ein Schemaobjekt, aus dem mehrere Benutzer eindeutige Ganzzahlen generieren können. Ein Sequenzgenerator bietet eine hoch skalierbare und leistungsstarke Methode, um Surrogatschlüssel für einen Zahlendatentyp zu generieren.
-
Sequenzeigenschaften Eine Sequence-Definition gibt allgemeine Informationen über die Sequence an, einschließlich ihres Namens und ob die Sequence auf- oder absteigend ist.
-
Gleichzeitiger Zugriff auf Sequences Der gleiche Sequence-Generator kann Zahlen für mehrere Tabellen generieren.
Sequenzeigenschaften
Eine Sequenzdefinition gibt allgemeine Informationen über die Sequenz an, einschließlich ihres Namens und ob die Sequenz auf- oder absteigt.
Eine Sequence-Definition gibt außerdem Folgendes an:
-
Das Intervall zwischen Zahlen
-
Gibt an, ob die Datenbank Sets mit generierten Sequenznummern im Speicher cachen soll
-
Gibt an, ob die Sequenz neu gestartet werden soll, wenn ein Grenzwert erreicht wird
Im folgenden Beispiel wird die Sequence customers_seq im Beispielschema oe erstellt. Eine Anwendung könnte diese Sequenz verwenden, um Kunden-ID-Nummern anzugeben, wenn Zeilen zur Tabelle customers hinzugefügt werden.
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;
Die erste Referenz auf customers_seq.nextval gibt 1000 zurück. Der zweite Wert gibt 1001 zurück. Jede nachfolgende Referenz gibt einen Wert 1 zurück, der größer als die vorherige Referenz ist.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung für ein Tutorial, das Ihnen zeigt, wie Sie eine Sequenz erstellen
-
Oracle AI Database Administrator's Guide zum Referenzieren einer Sequenz in einer SQL-Anweisung
-
Oracle AI Database SQL Language Reference für
CREATE SEQUENCE-Syntax und Semantik
Gleichzeitiger Zugriff auf Belegnummern
Der gleiche Sequence-Generator kann Nummern für mehrere Tabellen generieren.
Der Generator kann Primärschlüssel automatisch erstellen und Schlüssel über mehrere Zeilen oder Tabellen hinweg koordinieren. Beispiel: Eine Sequence kann Primärschlüssel für eine orders-Tabelle und eine customers-Tabelle generieren.
Der Sequence-Generator ist besonders in Mehrbenutzerumgebungen nützlich, um eindeutige Sequenzen zu generieren, ohne dass es zu einem Overhead von Platten-I/O oder Transaktionssperre kommt. Beispiel: Zwei Benutzer fügen gleichzeitig neue Zeilen in die Tabelle orders ein. Wenn Sie eine Sequence verwenden, um eindeutige Nummern für die Spalte order_id zu generieren, muss keiner der Benutzer darauf warten, dass der andere die nächste verfügbare Auftragsnummer eingibt. Die Sequence generiert automatisch die richtigen Werte für jeden Benutzer.
Jeder Benutzer, der eine Sequenz referenziert, hat Zugriff auf die aktuelle Sequenznummer, die letzte in der Session generierte Sequenz. Ein Benutzer kann eine Anweisung ausgeben, um eine neue Folgenummer zu generieren, oder die aktuelle Nummer verwenden, die zuletzt von der Session generiert wurde. Nachdem eine Anweisung in einer Session eine laufende Nummer generiert hat, ist sie nur für diese Session verfügbar. Einzelne Folgenummern können übersprungen werden, wenn sie generiert und in einer Transaktion verwendet wurden, die letztendlich zurückgesetzt wurde.
Warnung: Wenn für Ihre Anwendung eine lückenlose Gruppe von Zahlen erforderlich ist, können Sie keine Oracle-Sequenzen verwenden. Sie müssen Aktivitäten in der Datenbank mit Ihrem eigenen entwickelten Code serialisieren.
Siehe auch: "Datennebenläufigkeit und -konsistenz", um zu erfahren, wie Sessions gleichzeitig auf Daten zugreifen
Überblick über Dimensionen
Ein typisches Data Warehouse besteht aus zwei wichtigen Komponenten: Dimensionen und Fakten.
Eine Dimension ist eine beliebige Kategorie, die zur Angabe von Geschäftsfragen verwendet wird, z.B. Zeit, Geografie, Produkt, Abteilung und Vertriebskanal. Ein Fakt ist ein Ereignis oder eine Entität, die einem bestimmten Set von Dimensionswerten zugeordnet ist, z.B. verkaufte Einheiten oder Gewinne.
Beispiele für mehrdimensionale Anforderungen:
-
Zeigen Sie den Gesamtumsatz für alle Produkte mit steigenden Aggregationsebenen für eine Geografiedimension an, von Staat zu Land zu Region, für 2013 und 2014.
-
Erstellen Sie für 2013 und 2014 eine tabellarische Analyse unserer Abläufe, in der die Ausgaben nach Gebieten in Südamerika angezeigt werden. Alle möglichen Zwischensummen einschließen.
-
Listen Sie die Top 10-Vertriebsmitarbeiter in Asien nach dem Umsatz von 2014 für Automobilprodukte auf und bewerten Sie ihre Provisionen.
Viele mehrdimensionale Fragen erfordern aggregierte Daten und Vergleiche von Datensätzen, oft über Zeit, Geografie oder Budgets hinweg.
Das Erstellen einer Dimension ermöglicht die breitere Verwendung des Query Rewrite-Features. Durch das transparente Umschreiben von Abfragen zur Verwendung von Materialized Views kann die Datenbank die Abfrageperformance verbessern.
-
Hierarchische Struktur einer Dimension Eine Dimensionstabelle ist eine logische Struktur, die hierarchische (über-/untergeordnete) Beziehungen zwischen Spaltenpaaren oder Spaltensets definiert.
-
Dimensionen erstellen Sie erstellen Dimensionen mit der SQL-Anweisung
CREATE DIMENSION. Siehe auch: Oracle AI Database Data Warehousing Guide, um mehr über Dimensionen zu erfahren
Hierarchische Struktur einer Dimension
Eine Dimensionstabelle ist eine logische Struktur, die hierarchische (übergeordnete/untergeordnete) Beziehungen zwischen Spaltenpaaren oder Spaltensets definiert.
Beispiel: Eine Dimension kann angeben, dass in einer Zeile die Spalte city den Wert der Spalte state impliziert, und die Spalte state den Wert der Spalte country impliziert.
Innerhalb einer Kundendimension können Kunden zu Ort, Bundesland, Land, Unterregion und Region zusammengefasst werden. Die Datenanalyse beginnt in der Regel auf höheren Ebenen in der Dimensionshierarchie und führt schrittweise einen Drilldown durch, wenn die Situation eine solche Analyse rechtfertigt.
Jeder Wert auf der untergeordneten Ebene ist nur einem Wert auf der übergeordneten Ebene zugeordnet. Eine hierarchische Beziehung ist eine funktionale Abhängigkeit von einer Hierarchieebene zur nächsten Hierarchieebene.
Einer Dimension ist kein Datenspeicher zugewiesen. Dimensionsinformationen werden in Dimensionstabellen gespeichert, während Fakteninformationen in einer Faktentabelle gespeichert werden.
Siehe:
- Oracle AI Database Data Warehousing Guide für Informationen zu Dimensionen
Erstellung von Dimensionen
Sie erstellen Dimensionen mit der SQL-Anweisung CREATE DIMENSION.
Diese Anweisung gibt Folgendes an:
-
Mehrere
LEVEL-Klauseln, von denen jede eine Spalte oder ein SpaltenSet in der Dimension identifiziert -
Eine oder mehrere
HIERARCHY-Klauseln, die über-/untergeordnete Beziehungen zwischen benachbarten Ebenen angeben -
Optionale
ATTRIBUTE-Klauseln, die jeweils ein zusätzliches Spalten- oder SpaltenSet kennzeichnen, das einer einzelnen Ebene zugeordnet ist
Die folgende Anweisung wurde verwendet, um die Dimension customers_dim im Beispielschema sh zu erstellen:
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
Die Spalten in einer Dimension können entweder aus derselben Tabelle (denormalisiert) oder aus mehreren Tabellen (vollständig oder teilweise normalisiert) stammen. Beispiel: Eine normalisierte Zeitdimension kann eine Datumstabelle, eine Monatstabelle und eine Jahrentabelle mit Join-Bedingungen enthalten, die jede Datumszeile mit einer Monatszeile und jede Monatszeile mit einer Jahreszeile verbinden. In einer vollständig denormalisierten Zeitdimension befinden sich die Spalten für Datum, Monat und Jahr in derselben Tabelle. Unabhängig davon, ob normalisiert oder denormalisiert, müssen die hierarchischen Beziehungen zwischen den Spalten in der Anweisung CREATE DIMENSION angegeben werden.
Siehe auch: Oracle AI Database SQL Language Reference für CREATE DIMENSION-Syntax und Semantik
Synonyme - Überblick
Ein Synonym ist ein Alias für ein Schemaobjekt. Beispiel: Sie können ein Synonym für eine Tabelle oder View, eine Sequence, eine PL/SQL-Programmeinheit, einen benutzerdefinierten Objekttyp oder ein anderes Synonym erstellen. Da ein Synonym einfach ein Alias ist, muss lediglich dessen Definition im Data Dictionary gespeichert werden.
Synonyme können SQL-Anweisungen für Datenbankbenutzer vereinfachen. Synonyme sind auch nützlich, um die Identität und den Speicherort eines zugrunde liegenden Schemaobjekts zu verbergen. Wenn das zugrunde liegende Objekt umbenannt oder verschoben werden muss, muss nur das Synonym neu definiert werden. Anwendungen, die auf dem Synonym basieren, funktionieren weiterhin ohne Änderungen.
Sie können sowohl private als auch öffentliche Synonyme erstellen. Ein privates Synonym befindet sich im Schema eines bestimmten Benutzers, der die Kontrolle über seine Verfügbarkeit für andere Benutzer hat. Ein öffentliches Synonym gehört zur Benutzergruppe PUBLIC und ist für jeden Datenbankbenutzer zugänglich.
Beispiel 6-5: Öffentliches Synonym
Angenommen, ein Datenbankadministrator erstellt ein öffentliches Synonym namens people für die Tabelle hr.employees. Der Benutzer meldet sich dann beim Schema oe an und zählt die Anzahl der Zeilen in der Tabelle, auf die das Synonym verweist.
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
Verwenden Sie öffentliche Synonyme sparsam, da sie die Datenbankkonsolidierung erschweren. Wenn ein anderer Administrator versucht, das öffentliche Synonym people zu erstellen, verläuft die Erstellung wie im folgenden Beispiel nicht erfolgreich, weil nur ein öffentliches Synonym people in der Datenbank vorhanden sein kann. Eine übermäßige Verwendung öffentlicher Synonyme führt zu Namensraumkonflikten zwischen Anwendungen.
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
Synonyme selbst sind nicht sicher. Wenn Sie Objektberechtigungen für ein Synonym erteilen, erteilen Sie wirklich Berechtigungen für das zugrunde liegende Objekt. Das Synonym wird nur als Alias für das Objekt in der GRANT-Anweisung verwendet.
Siehe:
-
Oracle AI Database Administrator's Guide, um zu erfahren, wie Synonyme verwaltet werden
-
Oracle AI Database SQL Language Reference für
CREATE SYNONYM-Syntax und Semantik