SQL
In diesem Kapitel erhalten Sie einen Überblick über die strukturierte Abfragesprache (SQL) und die Verarbeitung von SQL-Anweisungen durch Oracle AI Database.
-
Einführung in SQL SQL (ausgesprochen Sequel) ist die gruppenbasierte deklarative High-Level-Computersprache, mit der alle Programme und Benutzer auf Daten in einer Oracle-Datenbank zugreifen können.
-
Überblick über SQL-Anweisungen Alle Vorgänge, die für die Informationen in einer Oracle-Datenbank ausgeführt werden, werden mit SQL-Anweisungen ausgeführt. Eine SQL-Anweisung ist ein Computerprogramm oder eine Anweisung, die aus Bezeichnern, Parametern, Variablen, Namen, Datentypen und reservierten Wörtern in SQL besteht.
-
Überblick über den Optimizer Um zu verstehen, wie Oracle AI Database SQL-Anweisungen verarbeitet, müssen Sie den Teil der Datenbank verstehen, der als Optimizer bezeichnet wird (auch als Abfrageoptimierer oder kostenbasierter Optimizer bezeichnet). Alle SQL-Anweisungen verwenden den Optimizer, um die effizienteste Methode für den Zugriff auf die angegebenen Daten zu bestimmen.
-
Überblick über SQL-Verarbeitung In diesem Abschnitt wird erläutert, wie Oracle AI Database SQL-Anweisungen verarbeitet. Insbesondere wird im Abschnitt erläutert, wie die Datenbank DDL-Anweisungen zum Erstellen von Objekten verarbeitet, DML zum Ändern von Daten und Abfragen zum Abrufen von Daten.
SQL – Einführung
SQL (ausgesprochen Sequel) ist die setbasierte deklarative High-Level-Computersprache, mit der alle Programme und Benutzer auf Daten in einer Oracle-Datenbank zugreifen können.
Obwohl einige Oracle-Tools und -Anwendungen die SQL-Verwendung maskieren, werden alle Datenbankaufgaben mit SQL ausgeführt. Jede andere Datenzugriffsmethode umgeht die in Oracle AI Database integrierte Sicherheit und beeinträchtigt möglicherweise die Datensicherheit und -integrität.
SQL stellt eine Schnittstelle zu einer relationalen Datenbank wie Oracle AI Database bereit. SQL vereint Aufgaben wie die folgenden in einer konsistenten Sprache:
-
Objekte erstellen, ersetzen, ändern und löschen
-
Tabellenzeilen einfügen, aktualisieren und löschen
-
Daten abfragen
-
Zugriff auf die Datenbank und ihre Objekte steuern
-
Datenbankkonsistenz und -integrität gewährleisten
SQL kann interaktiv verwendet werden, was bedeutet, dass Anweisungen manuell in ein Programm eingegeben werden. SQL-Anweisungen können auch in ein Programm eingebettet werden, das in einer anderen Sprache wie C oder Java geschrieben wurde.
-
SQL-Datenzugriff Es gibt zwei große Familien von Computersprachen: deklarative Sprachen, die nicht prozedural sind und beschreiben, was getan werden soll, und prozedurale Sprachen wie C++ und Java, die beschreiben, wie wie Dinge getan werden sollten.
-
SQL-Standards Oracle ist bestrebt, branchenweit anerkannte Standards zu befolgen und nimmt aktiv an SQL-Standardausschüssen teil.
Siehe:
-
Oracle AI Database Development Guide, um zu erfahren, wie Sie eine Programmierumgebung auswählen
-
Oracle AI Database SQL Language Reference für eine Einführung in SQL
SQL-Datenzugriff
Es gibt zwei große Familien von Computersprachen: deklarative Sprachen, die nicht prozedural sind und beschreiben, was getan werden sollte, und prozedurale Sprachen wie C++ und Java, die beschreiben, wie wie Dinge getan werden sollten.
SQL ist deklarativ in dem Sinne, dass Benutzer das gewünschte Ergebnis angeben und nicht, wie es abgeleitet werden soll. Beispiel: Die folgende Anweisung fragt Datensätze für Mitarbeiter ab, deren Nachname mit K beginnt:
Die Datenbank erstellt eine Prozedur, um durch die Daten zu navigieren und die angeforderten Ergebnisse abzurufen. Die deklarative Art von SQL ermöglicht es Ihnen, mit Daten auf logischer Ebene zu arbeiten. Sie müssen sich nur mit Implementierungsdetails befassen, wenn Sie die Daten bearbeiten.
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;
Die Datenbank ruft alle Zeilen ab, die der WHERE-Bedingung, die auch als Prädikat bezeichnet wird, in einem einzigen Schritt entsprechen. Die Datenbank kann diese Zeilen als Einheit an den Benutzer, eine andere SQL-Anweisung oder eine Anwendung übergeben. Die Anwendung muss die Datensätze nicht einzeln verarbeiten, und der Entwickler muss auch nicht wissen, wie die Datensätze physisch gespeichert oder abgerufen werden.
Alle SQL-Anweisungen verwenden den Optimizer, eine Komponente der Datenbank, die den effizientesten Zugriff auf die angeforderten Daten bestimmt. Oracle Database unterstützt auch Techniken, mit denen Sie die Performance des Optimizers verbessern können.
Siehe auch: Oracle AI Database SQL Language Reference enthält detaillierte Informationen zu SQL-Anweisungen und anderen Teilen von SQL (wie Operatoren, Funktionen und Formatmodelle).
SQL Standards
Oracle ist bestrebt, von der Branche akzeptierte Standards zu befolgen und nimmt aktiv an SQL-Standardausschüssen teil.
Von der Industrie akzeptierte Ausschüsse sind das American National Standards Institute (ANSI) und die International Organization for Standardization (ISO). Sowohl ANSI als auch ISO/IEC haben SQL als Standardsprache für relationale Datenbanken akzeptiert.
Der SQL-Standard besteht aus zehn Teilen. Ein Teil (SQL/RPR:2012) ist neu im Jahr 2012. Fünf weitere Teile wurden 2011 überarbeitet. Für die anderen vier Teile bleibt die Version 2008 bestehen. Oracle SQL umfasst viele Erweiterungen der ANSI/ISO-Standard-SQL-Sprache, und Oracle AI Database-Tools und -Anwendungen stellen zusätzliche Anweisungen bereit. Mit den Tools SQL*Plus, SQL Developer und Oracle Enterprise Manager können Sie jede ANSI/ISO-Standard-SQL-Anweisung für eine Oracle-Datenbank und alle zusätzlichen Anweisungen oder Funktionen ausführen, die für diese Tools verfügbar sind.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung
-
Oracle AI Database SQL Language Reference zur Erläuterung der Unterschiede zwischen Oracle SQL und Standard-SQL
-
SQL*Plus User's Guide and Reference für SQL*Plus-Befehle, einschließlich ihrer Unterscheidung von SQL-Anweisungen
SQL-Anweisungen - Überblick
Alle Vorgänge, die für die Informationen in einer Oracle-Datenbank ausgeführt werden, werden mit SQL-Anweisungen ausgeführt. Eine SQL-Anweisung ist ein Computerprogramm oder eine Anweisung, die aus Bezeichnern, Parametern, Variablen, Namen, Datentypen und reservierten Wörtern in SQL besteht. Hinweis: SQL-reservierte Wörter haben eine besondere Bedeutung in SQL und dürfen nicht für andere Zwecke verwendet werden. Beispiel: SELECT und UPDATE sind reservierte Wörter und dürfen nicht als Tabellennamen verwendet werden.
Eine SQL-Anweisung muss einem vollständigen SQL-Satz entsprechen, z.B.:
SELECT last_name, department_id FROM employeesOracle AI Database führt nur vollständige SQL-Anweisungen aus. Ein Fragment wie das Folgende generiert einen Fehler, der angibt, dass mehr Text erforderlich ist:
SELECT last_name;Oracle SQL-Anweisungen sind in folgende Kategorien unterteilt:
-
Data Definition Language-(DDL-)Anweisungen Data Definition Language-(DLL-)Anweisungen definieren, ändern und löschen Schemaobjekte.
-
DML-(Data Manipulation Language-)Anweisungen Data Manipulation Language-(DML-)Anweisungen fragen Daten in vorhandenen Schemaobjekten ab oder bearbeiten sie.
-
Transaktionskontrollanweisungen Transaktionskontrollanweisungen verwalten die von DML-Anweisungen vorgenommenen Änderungen und gruppieren DML-Anweisungen in Transaktionen.
-
Session-Kontrollanweisungen Session-Kontrollanweisungen verwalten die Eigenschaften einer Benutzer-Session dynamisch.
-
Systemsteuerungsanweisung Eine Systemsteuerungsanweisung ändert die Eigenschaften der Datenbankinstanz.
-
Eingebettete SQL-Anweisungen Eingebettete SQL-Anweisungen integrieren DDL-, DML- und Transaktionskontrollanweisungen in ein prozedurales Sprachprogramm.
Data Definition Language (DDL)-Anweisungen
Data Definition Language-(DLL-)Anweisungen definieren, ändern und löschen Schemaobjekte.
Mit DDL können Sie Attribute eines Objekts ändern, ohne die Anwendungen zu ändern, die auf das Objekt zugreifen. Beispiel: Sie können eine Spalte zu einer Tabelle hinzufügen, auf die eine Human Resources-Anwendung zugreift, ohne die Anwendung neu zu schreiben. Sie können auch DDL verwenden, um die Struktur von Objekten zu ändern, während Datenbankbenutzer in der Datenbank arbeiten.
Mit DDL-Anweisungen können Sie:
-
Erstellen, ändern und löschen Sie Schemaobjekte und andere Datenbankstrukturen, einschließlich der Datenbank selbst und der Datenbankbenutzer. Die meisten DDL-Anweisungen beginnen mit den Schlüsselwörtern
CREATE,ALTERoderDROP. -
Löschen Sie alle Daten in Schemaobjekten, ohne die Struktur dieser Objekte zu entfernen (
TRUNCATE).Hinweis: Im Gegensatz zu
DELETEgeneriertTRUNCATEkeine Undo-Daten, wodurch sie schneller alsDELETEsind. Außerdem ruftTRUNCATEkeine Löschtrigger auf -
Erteilen und entziehen Sie Berechtigungen und Rollen (
GRANT,REVOKE). -
Aktivieren und deaktivieren Sie die Auditingoptionen (
AUDIT,NOAUDIT). -
Fügen Sie dem Data Dictionary (
COMMENT) einen Kommentar hinzu.
Beispiel 10-1: DDL-Anweisungen
Im folgenden Beispiel werden DDL-Anweisungen verwendet, um die Tabelle plants zu erstellen. Anschließend werden mit DML zwei Zeilen in die Tabelle eingefügt. Das Beispiel verwendet dann DDL, um die Tabellenstruktur zu ändern, einem Benutzer Leseberechtigungen für diese Tabelle zu erteilen und zu entziehen, und dann die Tabelle zu löschen.
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;
Eine implizite COMMIT tritt unmittelbar vor der Ausführung einer DDL-Anweisung durch die Datenbank auf, und eine COMMIT- oder ROLLBACK-Anweisung tritt unmittelbar danach auf. Im vorherigen Beispiel folgt auf zwei INSERT-Anweisungen eine ALTER TABLE-Anweisung, sodass die Datenbank die beiden INSERT-Anweisungen festschreibt. Wenn die ALTER TABLE-Anweisung erfolgreich ist, schreibt die Datenbank diese Anweisung fest. Andernfalls setzt die Datenbank diese Anweisung zurück. In beiden Fällen wurden die beiden INSERT-Anweisungen bereits festgeschrieben.
Siehe:
-
Oracle AI Database - Sicherheitshandbuch, um mehr über Berechtigungen und Rollen zu erfahren
-
Oracle AI Database – Erste Schritte mit Oracle AI Database Development und Oracle AI Database Administrator's Guide, um zu erfahren, wie Schemaobjekte erstellt werden
-
Oracle AI Database Development Guide, um mehr über den Unterschied zwischen Blockieren und Nichtblockieren von DDL zu erfahren
-
Oracle AI Database SQL Language Reference für eine Liste der DDL-Anweisungen
Data Manipulation Language (DML)-Anweisungen
Data Manipulation Language-(DML-)Anweisungen fragen Daten in vorhandenen Schemaobjekten ab oder bearbeiten sie.
Während DDL-Anweisungen die Struktur der Datenbank ändern, fragen DML-Anweisungen den Inhalt ab oder ändern ihn. Beispiel: ALTER TABLE ändert die Struktur einer Tabelle, während INSERT der Tabelle eine oder mehrere Zeilen hinzufügt.
DML-Anweisungen sind die am häufigsten verwendeten SQL-Anweisungen. Sie ermöglichen:
-
Daten aus einer oder mehreren Tabellen oder Views abrufen oder abrufen (
SELECT). -
Fügen Sie neue Datenzeilen zu einer Tabelle oder View (
INSERT) hinzu, indem Sie eine Liste mit Spaltenwerten angeben oder eine Unterabfrage verwenden, um vorhandene Daten auszuwählen und zu bearbeiten. -
Ändern Sie Spaltenwerte in vorhandenen Zeilen einer Tabelle oder View (
UPDATE). -
Zeilen bedingt in eine Tabelle oder Ansicht (
MERGE) aktualisieren oder einfügen. -
Zeilen aus Tabellen oder Views entfernen (
DELETE). -
Zeigen Sie den Ausführungsplan für eine SQL-Anweisung an (
EXPLAINPLAN). -
Sperren Sie eine Tabelle oder View, und beschränken Sie den Zugriff vorübergehend auf andere Benutzer (
LOCKTABLE).
Im folgenden Beispiel wird die Tabelle employees mit DML abgefragt. Im Beispiel wird DML verwendet, um eine Zeile in employees einzufügen, diese Zeile zu aktualisieren und dann zu löschen:
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;
Eine Sammlung von DML-Anweisungen, die eine logische Arbeitseinheit bilden, wird als Transaktion bezeichnet. Beispiel: Eine Transaktion zur Geldüberweisung kann drei diskrete Vorgänge umfassen: Verringerung des Sparkontosaldos, Erhöhung des Girokontosaldos und Erfassung der Überweisung in einer Kontohistorientabelle. Im Gegensatz zu DDL-Anweisungen schreiben DML-Anweisungen die aktuelle Transaktion nicht implizit fest.
-
SELECT-Anweisungen Eine Abfrage ist ein Vorgang, der Daten aus einer Tabelle oder View abruft.
-
Joins Ein Join ist eine Abfrage, die Zeilen aus zwei oder mehr Tabellen, Views oder Materialized Views kombiniert.
-
Unterabfragen Eine Unterabfrage ist eine
SELECT-Anweisung, die in einer anderen SQL-Anweisung verschachtelt ist. Unterabfragen sind nützlich, wenn Sie mehrere Abfragen ausführen müssen, um ein einzelnes Problem zu lösen.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung, um zu erfahren, wie Sie Daten abfragen und bearbeiten
-
Oracle AI Database SQL Language Reference für eine Liste der DML-Anweisungen
SELECT-Statements
Eine Abfrage ist ein Vorgang, der Daten aus einer Tabelle oder View abruft.
SELECT ist die einzige SQL-Anweisung, mit der Sie Daten abfragen können. Das Dataset, das aus der Ausführung einer SELECT-Anweisung abgerufen wurde, wird als Ergebnissatz bezeichnet.
Die folgende Tabelle zeigt ein erforderliches Schlüsselwort und drei Schlüsselwörter, die häufig in einer SELECT-Anweisung enthalten sind. In der Tabelle werden auch Funktionen einer SELECT-Anweisung mit den Schlüsselwörtern verknüpft.
Schlüsselwörter in Tabelle 1 in einer SQL-Anweisung
| Schlüsselwort | Erforderlich? | Beschreibung | Fähigkeit |
|---|---|---|---|
SELECT |
Ja | Gibt an, welche Spalten im Ergebnis angezeigt werden sollen. Projektion erzeugt eine Teilmenge der Spalten in der Tabelle. Ein Ausdruck ist eine Kombination aus einem oder mehreren Werten, Operatoren und SQL-Funktionen, die in einen Wert aufgelöst werden. Die Liste der Ausdrücke, die nach dem Schlüsselwort |
Prognose |
FROM |
Nein | Gibt die Tabellen oder Views an, aus denen die Daten abgerufen werden sollen. | Beitreten |
WHERE |
Nein | Gibt eine Bedingung zum Filtern von Zeilen an, wodurch eine Teilmenge der Zeilen in der Tabelle erzeugt wird. Eine Bedingung gibt eine Kombination von einem oder mehreren Ausdrücken und logischen (Booleschen) Operatoren an und gibt den Wert TRUE, FALSE oder UNKNOWN zurück. |
Auswahl |
ORDER BY |
Nein | Gibt die Reihenfolge an, in der die Zeilen angezeigt werden sollen. |
Siehe auch: Oracle AI Database SQL Language Reference für SELECT-Syntax und Semantik
Joins
Ein Join ist eine Abfrage, die Zeilen aus zwei oder mehr Tabellen, Views oder Materialized Views kombiniert.
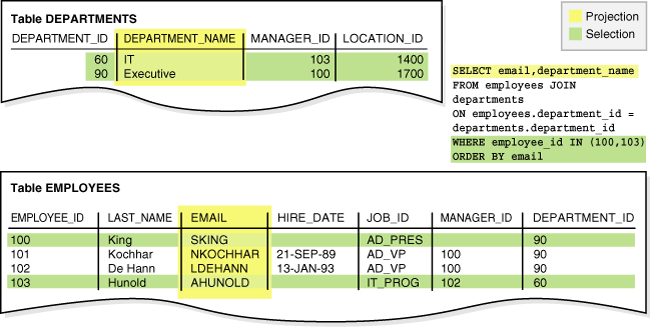
Im folgenden Beispiel werden die Tabellen employees und departments (Klausel FROM) verknüpft, nur Zeilen ausgewählt, die bestimmte Kriterien erfüllen (Klausel WHERE) und mithilfe von Projektionen Daten aus zwei Spalten abrufen (SELECT). Die Beispielausgabe folgt der SQL-Anweisung.
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
Die folgende Grafik stellt die Vorgänge der Projektion und Auswahl in dem Join dar, der in der vorherigen Abfrage angezeigt wird.
Abbildung 1: Projektion und Auswahl
Beschreibung der Abbildung cncpt290.gif
Die meisten Joins haben mindestens eine Join-Bedingung, entweder in der FROM-Klausel oder in der WHERE-Klausel, die zwei Spalten vergleicht, die jeweils aus einer anderen Tabelle stammen. Die Datenbank kombiniert Zeilenpaare, die jeweils eine Zeile aus jeder Tabelle enthalten, für die die Join-Bedingung TRUE ergibt. Der Optimizer bestimmt die Reihenfolge, in der die Datenbank Tabellen verknüpft, basierend auf den Join-Bedingungen, Indizes und allen verfügbaren Statistiken für die Tabellen.
Zu den Join-Typen gehören:
-
Inner Joins
Ein innerer Join ist ein Join aus zwei oder mehr Tabellen, der nur Zeilen zurückgibt, die der Join-Bedingung entsprechen. Beispiel: Wenn die Join-Bedingung
employees.department_id=departments.department_idlautet, werden keine Zeilen zurückgegeben, die diese Bedingung nicht erfüllen. -
Äußere Joins
Ein Outer Join gibt alle Zeilen zurück, die der Join-Bedingung entsprechen, und gibt auch Zeilen aus einer Tabelle zurück, für die keine Zeilen aus der anderen Tabelle die Bedingung erfüllen.
Das Ergebnis eines Linken Outer Joins für Tabelle A und B enthält immer alle Datensätze der linken Tabelle A, selbst wenn die Join-Bedingung nicht mit einem Datensatz in der rechten Tabelle B übereinstimmt. Wenn keine übereinstimmende Zeile aus B vorhanden ist, enthalten B-Spalten Nullwerte für Zeilen, die keine Übereinstimmung in B aufweisen. Beispiel: Wenn nicht alle Mitarbeiter in Abteilungen arbeiten, ruft ein linker Outer Join von
employees(linke Tabelle) unddepartments(rechte Tabelle) alle Zeilen inemployeesab, selbst wenn keine Zeilen indepartmentsdie Join-Bedingung erfüllen (employees.department_idist null).Das Ergebnis eines rechten Outer Joins für Tabelle A und B enthält alle Datensätze der rechten Tabelle B, selbst wenn die Join-Bedingung nicht mit einer Zeile in der linken Tabelle A übereinstimmt. Wenn keine übereinstimmende Zeile aus A vorhanden ist, enthalten A-Spalten Nullwerte für Zeilen, die keine Übereinstimmung in A aufweisen. Beispiel: Wenn nicht alle Abteilungen Mitarbeiter haben, ruft ein rechter Outer Join von
employees(linke Tabelle) unddepartments(rechte Tabelle) alle Zeilen indepartmentsab, selbst wenn keine Zeilen inemployeesdie Join-Bedingung erfüllen.Ein Full Outer Join ist die Kombination aus einem Left Outer Join und einem Right Outer Join.
-
Kartesische Produkte
Wenn zwei Tabellen in einer Join-Abfrage keine Join-Bedingung aufweisen, führt die Datenbank einen Cartesian Join aus. Jede Zeile einer Tabelle wird mit jeder Zeile der anderen Tabelle kombiniert. Beispiel: Wenn
employees107 Zeilen unddepartments27 Zeilen enthält, enthält das kartesische Produkt 107*27 Zeilen. Ein kartesisches Produkt ist selten nützlich.
Siehe:
-
SQL-Tuning-Handbuch für Oracle AI Database mit Informationen zu Joins
-
Oracle AI Database SQL Language Reference für detaillierte Beschreibungen und Beispiele für Joins
Unterabfragen
Eine Unterabfrage ist eine SELECT-Anweisung, die in einer anderen SQL-Anweisung verschachtelt ist. Unterabfragen sind nützlich, wenn Sie mehrere Abfragen ausführen müssen, um ein einzelnes Problem zu lösen.
Jeder Abfrageteil einer Anweisung wird als Abfrageblock bezeichnet. In der folgenden Abfrage ist die Unterabfrage in Klammern der innere Abfrageblock:
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
         WHERE location_id = 1800 );
Die innere SELECT-Anweisung ruft die IDs der Abteilungen mit der Standort-ID 1800 ab. Diese Abteilungskennungen werden vom äußeren Abfrageblock benötigt, der die Namen der Mitarbeiter in den Abteilungen abruft, deren Kennungen von der Unterabfrage bereitgestellt wurden.
Die Struktur der SQL-Anweisung zwingt die Datenbank nicht, die innere Abfrage zuerst auszuführen. Beispiel: Die Datenbank könnte die gesamte Abfrage als Join von employees und departments neu schreiben, sodass die Unterabfrage nie selbst ausgeführt wird. Ein weiteres Beispiel: Das Feature Virtual Private Database (VPD) könnte die Abfrage von Mitarbeitern mit einer WHERE-Klausel einschränken, sodass die Datenbank zuerst die Mitarbeiter abfragt und dann die Abteilungs-IDs abruft. Der Optimizer bestimmt die beste Abfolge von Schritten zum Abrufen der angeforderten Zeilen.
Siehe auch: Oracle AI Database - Sicherheitshandbuch, um mehr über VPD zu erfahren
Transaktionssteuerungsauszüge
Transaktionskontrollanweisungen verwalten die von DML-Anweisungen vorgenommenen Änderungen und gruppieren DML-Anweisungen in Transaktionen.
Mit diesen Anweisungen können Sie:
-
Ändern Sie eine Transaktion dauerhaft (
COMMIT). -
Machen Sie die Änderungen in einer Transaktion rückgängig, seit die Transaktion gestartet wurde (
ROLLBACK) oder seit einem Savepoint (ROLLBACK TO SAVEPOINT). Ein Savepoint ist ein vom Benutzer deklarierter Zwischenmarker im Kontext einer Transaktion.Hinweis: Die
ROLLBACK-Anweisung beendet eine Transaktion,ROLLBACK TO SAVEPOINTjedoch nicht. -
Legen Sie einen Punkt fest, auf den Sie einen Rollback durchführen können (
SAVEPOINT). -
Legen Sie Eigenschaften für eine Transaktion fest (
SETTRANSACTION). -
Geben Sie an, ob nach jeder DML-Anweisung ein verzögerbares Integritäts-Constraint geprüft wird oder ob die Transaktion festgeschrieben wird (
SET CONSTRAINT).
Im folgenden Beispiel wird eine Transaktion namens Update salaries gestartet. Im Beispiel wird ein Savepoint erstellt, ein Mitarbeitergehalt aktualisiert und dann die Transaktion zum Savepoint zurückgesetzt. Im Beispiel wird das Gehalt auf einen anderen Wert aktualisiert und festgeschrieben.
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
Siehe:
-
Wenn die Datenbank Constraints und Assertions auf Gültigkeit prüft
-
Oracle AI Database SQL Language Reference, um mehr über Anweisungen zur Transaktionskontrolle zu erfahren
Session-Kontrollanweisungen
Session-Kontrollanweisungen verwalten die Eigenschaften einer Benutzersession dynamisch.
Eine Session ist eine logische Entity im Speicher der Datenbankinstanz, die den Status einer aktuellen Benutzeranmeldung bei einer Datenbank darstellt. Eine Session dauert von dem Zeitpunkt an, an dem der Benutzer von der Datenbank authentifiziert wird, bis der Benutzer die Datenbankanwendung trennt oder beendet.
Mit Session Control-Anweisungen können Sie:
-
Ändern Sie die aktuelle Session, indem Sie eine spezielle Funktion ausführen, z.B. das Standarddatumsformat (
ALTER SESSION) festlegen. -
Aktivieren und deaktivieren Sie Rollen, bei denen es sich um Berechtigungsgruppen handelt, für die aktuelle Session (
SET ROLE).
Mit der folgenden Anweisung wird das Standarddatumsformat für Ihre Session dynamisch in 'YYYY MM DD-HH24:MI:SS' geändert:
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
Session Control-Anweisungen schreiben die aktuelle Transaktion nicht implizit fest.
Siehe:
-
Oracle AI Database SQL Language Reference für
ALTER SESSION-Syntax und Semantik
Systemsteuerungsanweisung
Eine Systemsteuerungsanweisung ändert die Eigenschaften der Datenbankinstanz.
Die einzige Systemsteuerungsanweisung ist ALTER SYSTEM. Es ermöglicht Ihnen, Einstellungen wie die Mindestanzahl von Shared Servern zu ändern, eine Sitzung zu beenden und andere Aufgaben auf Systemebene auszuführen.
Beispiele für die Systemsteuerungsanweisung:
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
Die ALTER SYSTEM-Anweisung schreibt die aktuelle Transaktion nicht implizit fest.
Siehe auch: Oracle AI Database SQL Language Reference für ALTER SYSTEM-Syntax und Semantik
Eingebettete SQL-Anweisungen
Eingebettete SQL-Anweisungen integrieren DDL-, DML- und Transaktionskontrollanweisungen in ein prozedurales Sprachprogramm.
Eingebettete Anweisungen werden mit den Oracle-Precompilern verwendet. Embedded SQL ist ein Ansatz für die Integration von SQL in Ihre prozeduralen Sprachanwendungen. Ein weiterer Ansatz besteht darin, eine prozedurale API wie Open Database Connectivity (ODBC) oder Java Database Connectivity (JDBC) zu verwenden.
Mit eingebetteten SQL-Anweisungen können Sie:
-
Definieren, weisen Sie einen Cursor zu, und geben Sie ihn frei (
DECLARE CURSOR,OPEN,CLOSE). -
Geben Sie eine Datenbank an, und melden Sie sich bei ihr an (
DECLARE DATABASE,CONNECT). -
Variablennamen zuweisen (
DECLARE STATEMENT). -
Initialisieren Sie Deskriptoren (
DESCRIBE). -
Geben Sie an, wie Fehler- und Warnbedingungen behandelt werden (
WHENEVER). -
Parsen und führen Sie SQL-Anweisungen aus (
PREPARE,EXECUTE,EXECUTE IMMEDIATE). -
Daten aus der Datenbank abrufen (
FETCH).
Überblick über den Optimizer
Um zu verstehen, wie Oracle AI Database SQL-Anweisungen verarbeitet, müssen Sie den Teil der Datenbank verstehen, der als Optimizer (auch als Abfrageoptimierer oder kostenbasierter Optimizer bezeichnet) bezeichnet wird. Alle SQL-Anweisungen verwenden den Optimizer, um die effizienteste Methode für den Zugriff auf die angegebenen Daten zu bestimmen.
-
Verwendung des Optimizers Der Optimizer generiert Ausführungspläne, in denen mögliche Ausführungsmethoden beschrieben werden.
-
Optimizer-Komponenten Der Optimizer enthält drei Hauptkomponenten: Transformator, Schätzer und Plangenerator.
-
Zugriffspfade Ein Zugriffspfad ist das Verfahren, mit dem eine Abfrage Zeilen abruft.
-
Optimizer-Statistiken Die Optimizer-Statistiken sind Zusammenstellungen von Daten, mit denen Details zur Datenbank und Zu den Objekten in der Datenbank beschrieben wird. Die Statistiken bieten ein statistisch korrektes Bild der Datenspeicherung und -verteilung, das vom Optimizer bei der Auswertung der Zugriffspfade verwendet werden kann.
-
Optimizer-Tipps Ein Hinweis ist ein Kommentar in einer SQL-Anweisung, der als Anweisung für den Optimizer fungiert.
Verwendung des Optimizers
Der Optimizer generiert Ausführungspläne, die mögliche Ausführungsmethoden beschreiben.
Der Optimizer ermittelt, welcher Ausführungsplan am effizientesten ist, indem er mehrere Informationsquellen berücksichtigt. Beispiel: Der Optimizer berücksichtigt Abfragebedingungen, verfügbare Zugriffspfade, für das System gesammelte Statistiken und Hints.
Um eine DML-Anweisung auszuführen, muss Oracle AI Database möglicherweise viele Schritte ausführen. Jeder Schritt ruft entweder physisch Datenzeilen aus der Datenbankab oder bereitet sie für den Benutzer vor, der die Anweisung ausstellt. Die Schritte, mit denen die Datenbank eine Anweisung ausführt, wirken sich stark darauf aus, wie schnell die Anweisung ausgeführt wird. Häufig sind verschiedene Arten der Verarbeitung einer DML-Anweisung möglich. Beispiel: Die Reihenfolge, in der auf Tabellen oder Indizes zugegriffen wird, kann variieren.
Wenn der Optimizer den besten Ausführungsplan für eine SQL-Anweisung ermittelt, führt er die folgenden Vorgänge aus:
-
Auswertung von Ausdrücken und Bedingungen
-
Prüfung von Integritäts-Constraints, um mehr über die Daten zu erfahren und basierend auf diesen Metadaten zu optimieren
-
Anweisungstransformation
-
Wahl der Optimizer-Ziele
-
Auswahl der Zugriffspfade
-
Auswahl von Join-Aufträgen
Der Optimizer generiert die meisten möglichen Methoden zur Verarbeitung einer Abfrage und weist jedem Schritt im generierten Ausführungsplan Kosten zu. Der Plan mit den niedrigsten Kosten wird als Abfrageplan ausgewählt, der ausgeführt werden soll.
Hinweis: Sie können einen Ausführungsplan für eine SQL-Anweisung abrufen, ohne den Plan auszuführen. Nur ein Ausführungsplan, mit dem die Datenbank tatsächlich eine Abfrage ausführt, wird korrekt als Abfrageplan bezeichnet.
Sie können die Optimizer-Auswahl beeinflussen, indem Sie das Optimizer-Ziel festlegen und repräsentative Statistiken für den Optimizer sammeln. Beispiel: Sie können das Optimizer-Ziel auf einen der folgenden Werte setzen:
-
Durchsatz gesamt
Der Hint
ALL_ROWSweist den Optimizer an, die letzte Zeile des Ergebnisses so schnell wie möglich an die Clientanwendung abzurufen. -
Anfangsreaktionszeit
Der Hint
FIRST_ROWSweist den Optimizer an, die erste Zeile so schnell wie möglich an den Client zu senden.
Eine typische, interaktive Anwendung für Endbenutzer würde von der Optimierung der anfänglichen Reaktionszeit profitieren, während eine nicht-interaktive Anwendung im Batchmodus von der Optimierung des Gesamtdurchsatzes profitieren würde.
Siehe:
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zur Verwendung von
DBMS_STATS -
SQL Tuning Guide für Oracle AI Database für weitere Informationen zum Optimizer und zur Verwendung von Hints
Optimizer-Komponenten
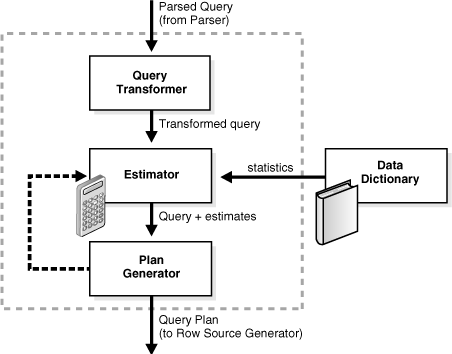
Der Optimizer enthält drei Hauptkomponenten: Transformator, Schätzer und Plangenerator.
Das folgende Diagramm zeigt die Komponenten:
Abbildung 2: Optimizer-Komponenten
Beschreibung der Abbildung cncpt287.gif
Die Eingabe für den Optimizer ist eine geparste Abfrage. Der Optimizer führt die folgenden Vorgänge aus:
-
Der Optimizer empfängt die geparste Abfrage und generiert eine Gruppe potenzieller Pläne für die SQL-Anweisung basierend auf verfügbaren Zugriffspfaden und Hints.
-
Der Optimizer schätzt die Kosten für jeden Plan auf der Grundlage von Statistiken im Data Dictionary. Die Kosten sind ein geschätzter Wert, der proportional zur erwarteten Ressourcennutzung ist, die zur Ausführung der Anweisung mit einem bestimmten Plan erforderlich ist.
-
Der Optimizer vergleicht die Kosten von Plänen und wählt den kostengünstigsten Plan, den so genannten Abfrageplan, der an den Zeilenquellengenerator übergeben wird.
-
Abfragetransformator Der Abfragetransformator bestimmt, ob es hilfreich ist, die Form der Abfrage zu ändern, damit der Optimizer einen besseren Ausführungsplan generieren kann. Die Eingabe für den Abfragetransformator ist eine geparste Abfrage, die der Optimizer als Gruppe von Abfrageblöcken darstellt.
-
Estimator Der Estimator bestimmt die Gesamtkosten eines bestimmten Ausführungsplans.
-
Plangenerator: Der Plangenerator versucht verschiedene Pläne für eine weitergeleitete Abfrage. Der Optimizer wählt den Plan mit den niedrigsten Kosten aus.
Abfrage-Transformator
Der Abfragetransformator bestimmt, ob es hilfreich ist, die Form der Abfrage zu ändern, damit der Optimizer einen besseren Ausführungsplan generieren kann. Die Eingabe für den Abfragetransformator ist eine geparste Abfrage, die der Optimizer als Gruppe von Abfrageblöcken darstellt.
Siehe auch: Abfrage umschreiben
Schätzer
Der Schätzer bestimmt die Gesamtkosten eines bestimmten Ausführungsplans.
Der Schätzer generiert drei verschiedene Arten von Maßnahmen, um dieses Ziel zu erreichen:
-
Selektivität
Diese Kennzahl stellt einen Bruchteil der Zeilen aus einem ZeilenSet dar. Die Selektivität ist mit einem Abfrageprädikat wie
last_name='Smith'oder einer Kombination von Prädikaten verknüpft. -
Kardinalität
Diese Kennzahl stellt die Anzahl der Zeilen in einem ZeilenSet dar.
-
Kosten
Diese Kennzahl stellt Arbeitseinheiten oder verwendete Ressourcen dar. Der Query Optimizer verwendet Platten-I/O, CPU-Auslastung und Speicherauslastung als Arbeitseinheiten.
Wenn Statistiken verfügbar sind, verwendet der Schätzer sie zur Berechnung der Kennzahlen. Die Statistiken verbessern den Grad der Genauigkeit der Maßnahmen.
Plangenerator
Der Plangenerator versucht verschiedene Pläne für eine weitergeleitete Abfrage. Der Optimizer wählt den Plan mit den niedrigsten Kosten aus.
Für jede verschachtelte Unterabfrage und nicht zusammengeführte View generiert der Optimizer einen Unterplan. Der Optimizer stellt jeden Unterplan als separaten Abfrageblock dar. Der Plangenerator untersucht verschiedene Pläne für einen Abfrageblock, indem er verschiedene Zugriffspfade, Join-Methoden und Join-Reihenfolgen ausprobiert.
Die Funktion adaptive Abfrageoptimierung ändert Pläne basierend auf Statistiken, die während der Anweisungsausführung gesammelt wurden. Alle adaptiven Mechanismen können einen endgültigen Plan für eine Anweisung ausführen, die sich vom Standardplan unterscheidet. Die adaptive Optimierung verwendet entweder dynamische Pläne, die während der Anweisungsausführung zwischen Unterplänen wählen, oder die Reoptimierung, die einen Plan für Ausführungen nach der aktuellen Ausführung ändert.
Siehe:
-
Oracle AI Database – Erste Schritte mit Performance Tuning für eine Einführung in das SQL-Tuning
-
SQL Tuning Guide für Oracle AI Database mit Informationen zu den Optimizer-Komponenten und zur adaptiven Optimierung
Zugriffspfade
Ein Zugriffspfad ist das Verfahren, mit dem eine Abfrage Zeilen abruft.
Beispiel: Eine Abfrage, die einen Index verwendet, hat einen anderen Zugriffspfad als eine Abfrage, die dies nicht tut. Im Allgemeinen eignen sich Indexzugriffspfade am besten für Anweisungen, die eine kleine Teilmenge von Tabellenzeilen abrufen. Vollständige Scans sind effizienter für den Zugriff auf einen großen Teil einer Tabelle.
Die Datenbank kann verschiedene Zugriffspfade verwenden, um Daten aus einer Tabelle abzurufen. Es folgt eine repräsentative Liste:
-
Full Table Scans
Bei diesem Scan-Typ werden alle Zeilen aus einer Tabelle gelesen und diejenigen herausgefiltert, die nicht den Auswahlkriterien entsprechen. Die Datenbank scannt alle Datenblöcke im Segment sequenziell, einschließlich der Datenblöcke unter der High Water Mark (HWM), die den belegten vom nicht belegten Speicherplatz trennen (siehe "Segment Space and the High Water Mark").
-
Rowid-Scans
Das Zeilen-ID einer Zeile gibt die Datendatei und den Datenblock an, in dem sich die Zeile und der Speicherort der Zeile in diesem Block befindet. Die Datenbank ruft zuerst die Zeilen-IDs der ausgewählten Zeilen ab, entweder aus der Klausel
WHEREder Anweisung oder über einen Index-Scan, und sucht dann jede ausgewählte Zeile basierend auf ihrer Zeilen-ID. -
Indexscans
Dieser Scan durchsucht einen Index nach den indizierten Spaltenwerten, auf die von der SQL-Anweisung zugegriffen wird (siehe "Indexscans"). Greift die Anweisung nur auf Indexspalten zu, liest Oracle AI Database die indexierten Spaltenwerte direkt aus dem Index.
-
Cluster-Scans
Ein Cluster Scan ruft Daten aus einer Tabelle ab, die in einem indizierten Tabellencluster gespeichert ist. Dabei werden alle Zeilen mit demselben Clusterschlüsselwert im selben Datenblock gespeichert (siehe "Übersicht über indizierte Cluster"). Die Datenbank ruft zuerst die Zeilen-ID einer ausgewählten Zeile ab, indem sie den Cluster-Index scannt. Oracle AI Database lokalisiert die Zeilen basierend auf dieser Zeilen-ID.
-
Hash-Scans
Ein Hash Scan lokalisiert Zeilen in einem Hash Cluster, in denen alle Zeilen mit demselben Hashwert im selben Datenblock gespeichert sind (siehe "Überblick über Hash Cluster"). Die Datenbank ruft zuerst den Hasch-Wert durch Anwenden einer Hash-Funktion auf einen in der Anweisung angegebenen Cluster-Schlüsselwert ab. Oracle AI Database scannt dann die Datenblöcke, in denen Zeilen mit diesem Hashwert enthalten sind.
Der Optimizer wählt einen Zugriffspfad basierend auf den verfügbaren Zugriffspfaden für die Anweisung und den geschätzten Kosten für die Verwendung der einzelnen Zugriffspfade oder Pfadkombinationen.
Siehe auch: Oracle AI Database – Erste Schritte mit Performance Tuning und Oracle AI Database SQL Tuning Guide, um mehr über Zugriffspfade zu erfahren
Optimizer-Statistiken
Die Optimizer-Statistiken sind Zusammenstellungen von Daten, mit denen Details zur Datenbank und die Objekte in der Datenbank beschrieben sind. Die Statistiken bieten ein statistisch korrektes Bild der Datenspeicherung und -verteilung, das vom Optimizer bei der Auswertung der Zugriffspfade verwendet werden kann.
Optimizer-Statistiken enthalten folgende Elemente:
-
Tabellenstatistiken
Dazu gehören die Anzahl der Zeilen und die Anzahl der Blöcke sowie eine durchschnittliche Zeilenlänge.
-
Spaltenstatistiken
Dazu gehören die Anzahl der eindeutigen Werte und Nullwerte in einer Spalte und die Verteilung der Daten.
-
Indexstatistiken
Dazu gehören die Anzahl der Leaf-Blöcke und Indexebenen.
-
Systemstatistiken
Dazu gehören CPU- und I/O-Performance und -Nutzung.
Oracle AI Database sammelt automatisch Optimizer-Statistiken für alle Datenbankobjekte und verwaltet diese Statistiken als automatisierte Wartungsaufgabe. Sie können Statistiken auch manuell mit dem Package DBMS_STATS erfassen. Dieses PL/SQL-Package kann Statistiken ändern, anzeigen, exportieren, importieren und löschen. Hinweis: Optimizer-Statistiken werden für die Abfrageoptimierung erstellt und im Data Dictionary gespeichert. Verwechseln Sie diese Statistiken nicht mit Performancestatistiken, die in dynamischen Performance-Views angezeigt werden.
Optimizer Statistics Advisor ist eine integrierte Diagnosesoftware, die analysiert, wie Sie derzeit Statistiken sammeln, die Effektivität vorhandener Jobs zur Statistiksammlung und die Qualität der gesammelten Statistiken. Optimizer Statistics Advisor verwaltet Regeln, die Best Practices von Oracle auf Basis des aktuellen Featuresets darstellen. Auf diese Weise liefert der Advisor immer die aktuellsten Empfehlungen für die Statistiksammlung.
Siehe:
-
Oracle AI Database – Erste Schritte mit Performance Tuning und Oracle AI Database SQL Tuning Guide, um zu erfahren, wie Statistiken gesammelt und verwaltet werden
-
Oracle AI Database PL/SQL Packages and Types Reference für Informationen zu
DBMS_STATS
Optimizer-Hinweise
Ein Hinweis ist ein Kommentar in einer SQL-Anweisung, der als Anweisung für den Optimizer dient.
Manchmal kann der Anwendungsdesigner, der mehr Informationen über die Daten einer bestimmten Anwendung hat, als für den Optimizer verfügbar ist, eine effektivere Methode zum Ausführen einer SQL-Anweisung wählen. Der Application Designer kann Hints in SQL-Anweisungen verwenden, um anzugeben, wie die Anweisung ausgeführt werden soll. Die folgenden Beispiele veranschaulichen die Verwendung von Hints.
Beispiel 10-2: Ausführungsplan für SELECT mit FIRST_ROWS-Hinweis
Angenommen, Ihre interaktive Anwendung führt eine Abfrage aus, die 50 Zeilen zurückgibt. Diese Anwendung ruft zunächst nur die ersten 25 Zeilen der Abfrage ab, die dem Endbenutzer angezeigt werden sollen. Sie möchten, dass der Optimizer einen Plan generiert, der die ersten 25 Datensätze so schnell wie möglich abruft, sodass der Benutzer nicht gezwungen wird, zu warten. Sie können diese Anweisung mit einem Hint an den Optimizer übergeben, wie in der SELECT-Anweisung und der AUTOTRACE-Ausgabe im folgenden Beispiel dargestellt:
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------
In diesem Beispiel zeigt der Ausführungsplan, dass der Optimizer einen Index für die Spalte employees.department_id auswählt, um die ersten 25 Zeilen von employees zu suchen, deren Abteilungs-ID über 50 ist. Der Optimizer verwendet die aus dem Index abgerufene Zeilen-ID, um den Datensatz aus der Tabelle employees abzurufen und an den Client zurückzugeben. Der Abruf des ersten Datensatzes erfolgt in der Regel fast unmittelbar.
Beispiel 10-3: Ausführungsplan für SELECT ohne Hinweis
Angenommen, Sie führen dieselbe Anweisung aus, jedoch ohne den Optimizer Hint:
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
|  4 |    INDEX FAST FULL SCAN| EMP_EMP_ID_PK     | 50   | 350   |
In diesem Fall verknüpft der Ausführungsplan zwei Indizes, um die angeforderten Datensätze so schnell wie möglich zurückzugeben. Anstatt wie in Beispiel 10-2 wiederholt von Index zu Tabelle zu wechseln, wählt der Optimizer einen Range Scan von EMP_DEPARTMENT_IX aus, um alle Zeilen zu suchen, bei denen die Abteilungs-ID über 50 liegt, und diese Zeilen in einer Hash-Tabelle zu platzieren. Der Optimizer liest dann den Index EMP_EMP_ID_PK. Für jede Zeile in diesem Index durchsucht es die Hash-Tabelle, um die Abteilungskennung zu ermitteln.
In diesem Fall kann die Datenbank die erste Zeile erst an den Client zurückgeben, wenn der Indexbereichsscan von EMP_DEPARTMENT_IX abgeschlossen ist. Daher würde es länger dauern, bis der erste Datensatz zurückgegeben wird. Im Gegensatz zum Plan in Beispiel 10-2, der nach Index-Rowid auf die Tabelle zugreift, verwendet der Plan Multiblock-I/O, was zu großen Lesezugriffen führt. Mit den Lesevorgängen kann die letzte Zeile der gesamten Ergebnismenge schneller zurückgegeben werden.
Siehe auch: In Oracle AI Database SQL Tuning Guide erfahren Sie, wie Optimizer Hints verwendet werden.
SQL-Verarbeitung - Überblick
In diesem Abschnitt wird erläutert, wie Oracle AI Database SQL-Anweisungen verarbeitet. Insbesondere wird im Abschnitt erläutert, wie die Datenbank DDL-Anweisungen zum Erstellen von Objekten verarbeitet, DML zum Ändern von Daten und Abfragen zum Abrufen von Daten.
-
Stufen der SQL-Verarbeitung Die allgemeinen Phasen der SQL-Verarbeitung sind Parsing, Optimierung, Generierung und Ausführung von Zeilenquellen. Je nach Anweisung kann die Datenbank einige dieser Schritte auslassen.
-
Unterschiede zwischen DML- und DDL-Verarbeitung Oracle AI Database verarbeitet DDL anders als DML.
Phasen der SQL-Verarbeitung
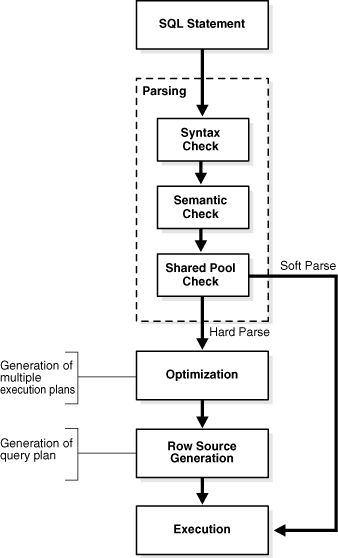
Die allgemeinen Phasen der SQL-Verarbeitung sind Parsing, Optimierung, Generierung von Zeilenquellen und Ausführung. Je nach Anweisung kann die Datenbank einige dieser Schritte auslassen.
Die folgende Abbildung zeigt die allgemeinen Phasen:
Abbildung 3: Phasen der SQL-Verarbeitung
Beschreibung der Abbildung cncpt250.gif
-
SQL Parsing Die erste Phase der SQL-Verarbeitung ist das SQL Parsing. In dieser Phase werden die Teile einer SQL-Anweisung in eine Datenstruktur unterteilt, die von anderen Routinen verarbeitet werden kann.
-
Die Abfrageoptimierung ist der Prozess, bei dem die effizienteste Methode zum Ausführen einer SQL-Anweisung ausgewählt wird.
-
Generierung von SQL-Zeilenquellen Der Zeilenquellengenerator ist eine Software, die den optimalen Ausführungsplan vom Optimizer empfängt und einen iterativen Plan erstellt, der als Abfrageplan bezeichnet wird und vom Rest der Datenbank verwendet werden kann.
-
SQL-Ausführung Während der Ausführung führt die SQL-Engine jede Zeilenquelle im Baum aus, der vom Zeilenquellengenerator erstellt wird. Dies ist der einzige obligatorische Schritt in der DML-Verarbeitung.
SQL-Parsing
Die erste Phase der SQL-Verarbeitung ist das SQL-Parsing. In dieser Phase werden die Teile einer SQL-Anweisung in eine Datenstruktur unterteilt, die von anderen Routinen verarbeitet werden kann.
Wenn eine Anwendung eine SQL-Anweisung absetzt, ruft die Anwendung die Datenbank mit einem Parse-Aufruf auf, um die Anweisung für die Ausführung vorzubereiten. Der Parse-Aufruf wird geöffnet oder erstellt einen Cursor. Dabei handelt es sich um ein Handle für den sessionspezifischen privaten SQL-Bereich, der eine geparste SQL-Anweisung und andere Verarbeitungsinformationen enthält. Der Cursor und der private SQL-Bereich befinden sich in der PGA.
Während des Parse-Aufrufs führt die Datenbank die folgenden Prüfungen aus:
-
Syntaxprüfung
-
Semantische Prüfung
-
Prüfung auf gemeinsamen Pool
Die vorherigen Prüfungen identifizieren die Fehler, die vor der Ausführung einer Anweisung gefunden werden können. Einige Fehler können beim Parsen nicht abgefangen werden. Beispiel: Die Datenbank kann nur während der Ausführung der Anweisung auf einen Deadlock oder Fehler bei der Datenkonvertierung stoßen.
Die Datenbank versucht eine automatische Fehlerbehebung für SQL-Anweisungen, die während der Parsephase mit einem ORA-00600-Fehler nicht erfolgreich sind. Ein ORA-00600 ist ein schwerwiegender Fehler. Es gibt an, dass bei einem Prozess eine unerwartete Bedingung auf niedriger Ebene aufgetreten ist. Wenn eine SQL-Anweisung während der Parsephase mit diesem Fehler nicht erfolgreich ist, wird diese automatisch abgefangen und versucht, die Bedingung zu lösen. Wenn eine Auflösung gefunden wird, generiert die Datenbank einen SQL-Patch, um den SQL-Ausführungsplan anzupassen. Wenn mit diesem Patch der Parse-Vorgang erfolgreich abgeschlossen werden kann, wird der ORA-00600-Fehler nicht ausgelöst. Die Anwendung sieht keine Ausnahme.
SQL Optimierung
Die Abfrageoptimierung ist der Prozess, bei dem die effizienteste Methode zum Ausführen einer SQL-Anweisung ausgewählt wird.
Die Datenbank optimiert Abfragen auf der Grundlage von Statistiken, die über die tatsächlich abgerufenen Daten gesammelt wurden. Der Optimizer verwendet die Anzahl der Zeilen, die Größe des Datasets und andere Faktoren, um mögliche Ausführungspläne zu generieren und jedem Plan numerische Kosten zuzuweisen. Die Datenbank verwendet den Plan mit den niedrigsten Kosten.
Die Datenbank muss mindestens einmal einen Hard Parse-Vorgang für jede eindeutige DML-Anweisung ausführen und während dieses Parse-Vorgangs eine Optimierung durchführen. DDL wird nie optimiert, es sei denn, es enthält eine DML-Komponente wie eine Unterabfrage, die optimiert werden muss.
Siehe:
-
SQL Tuning Guide für Oracle AI Database mit detaillierten Informationen zum Query Optimizer
Generierung von SQL-Zeilenquellen
Der Zeilenquellengenerator ist eine Software, die den optimalen Ausführungsplan vom Optimizer empfängt und einen iterativen Plan, den so genannten Abfrageplan, erstellt, der vom Rest der Datenbank verwendet werden kann.
Der Abfrageplan besteht aus einer Kombination von Schritten. Jeder Schritt gibt ein Zeilenset zurück. Die Zeilen in dieser Gruppe werden entweder vom nächsten Schritt verwendet oder im letzten Schritt an die Anwendung zurückgegeben, die die SQL-Anweisung absetzt.
Eine Zeilenquelle ist ein Zeilenset, das von einem Schritt im Ausführungsplan zusammen mit einer Kontrollstruktur zurückgegeben wird, die Zeilen iterativ verarbeiten kann. Die Zeilenquelle kann eine Tabelle, eine View oder das Ergebnis eines Join- oder Gruppierungsvorgangs sein.
SQL-Ausführung
Während der Ausführung führt die SQL-Engine jede Zeilenquelle im Baum aus, der vom Zeilenquellengenerator erstellt wird. Dies ist der einzige obligatorische Schritt in der DML-Verarbeitung.
Wenn sich die Daten während der Ausführung nicht im Speicher befinden, liest die Datenbank die Daten vom Datenträger in den Speicher. Die Datenbank entfernt auch alle Sperren und Latches, die zur Gewährleistung der Datenintegrität erforderlich sind, und protokolliert alle Änderungen, die während der SQL-Ausführung vorgenommen wurden. In der letzten Phase der Verarbeitung einer SQL-Anweisung wird der Cursor geschlossen.
Wenn die Datenbank so konfiguriert ist, dass In-Memory Column Store (IM-Spaltenspeicher) verwendet wird, leitet die Datenbank Abfragen nach Möglichkeit transparent an den IM-Spaltenspeicher und ansonsten an Datenträger und Datenbankpuffercache weiter. Eine einzelne Abfrage kann auch den IM-Spaltenspeicher, den Datenträger und den Puffercache verwenden. Beispiel: Eine Abfrage kann zwei Tabellen verknüpfen, von denen nur eine IM IM-Spaltenspeicher gecacht ist.
Siehe:
-
Oracle AI Database SQL Tuning Guide für detaillierte Informationen zu Ausführungsplänen und der
EXPLAIN PLAN-Anweisung
Unterschiede zwischen DML- und DDL-Verarbeitung
Oracle AI Database verarbeitet DDL anders als DML.
Beispiel: Wenn Sie eine Tabelle erstellen, optimiert die Datenbank die Anweisung CREATE TABLE nicht. Stattdessen parst Oracle AI Database die DDL-Anweisung und führt den Befehl aus.
Im Gegensatz zu DDL verfügen die meisten DML-Anweisungen über eine Abfragekomponente. Bei einer Abfrage platziert die Ausführung eines Cursors die von der Abfrage generierte Zeile in der Ergebnismenge.
Die Datenbank kann Ergebnismengenzeilen entweder eine Zeile nach der anderen oder in Gruppen abrufen. Im Fetch wählt die Datenbank Zeilen aus und sortiert, falls von der Abfrage angefordert, die Zeilen. Jeder nachfolgende Abruf ruft eine weitere Zeile des Ergebnisses ab, bis die letzte Zeile abgerufen wurde.
Siehe auch: Oracle AI Database Development Guide enthält Informationen zur Verarbeitung von DDL, zur Transaktionskontrolle und zu anderen Anweisungstypen