Serverseitige Programmierung: PL/SQL, Java und JavaScript
In SQL wird die SQL-Sprache (Structured Query Language) und die Verarbeitung von SQL-Anweisungen durch die Datenbank erläutert. In diesem Kapitel wird erläutert, wie in der Datenbank gespeicherte Procedural Language/SQL-(PL/SQL-) oder Java-Programme SQL verwenden können.
-
Einführung in serverseitige Programmierung In einer nicht-prozeduralen Sprache wie SQL wird das Datenset angegeben, das bearbeitet werden soll, jedoch nicht die auszuführenden Vorgänge oder die Art und Weise, in der sie ausgeführt werden sollen.
-
Überblick über PL/SQL PL/SQL bietet eine serverseitige, gespeicherte prozedurale Sprache, die benutzerfreundlich, nahtlos mit SQL, robust, portabel und sicher ist. Mit prozeduralen Objekten, die als PL/SQL-Einheiten bezeichnet werden, können Sie auf Datenbankdaten zugreifen und diese bearbeiten.
-
Überblick über Java in Oracle AI Database Java hat sich als objektorientierte Programmiersprache der Wahl herausgestellt.
-
Überblick über JavaScript in Oracle AI Database JavaScript ist heute eine der beliebtesten Programmiersprachen. Oracle AI Database, die unter Linux x86-64 oder Linux aarch64 bereitgestellt wird, fügt JavaScript zur Liste der Sprachen hinzu, die für die serverseitige Entwicklung unterstützt werden.
-
Überblick über Trigger Ein Trigger einer Datenbank ist eine kompilierte gespeicherte Programmeinheit, die in PL/SQL, Java oder JavaScript geschrieben ist und in bestimmten Situationen automatisch von Oracle Database aufgerufen ("ausgelöst") wird. Siehe auch: SQL für einen Überblick über die SQL-Sprache.
Einführung in die serverseitige Programmierung
In einer nicht-prozeduralen Sprache wie SQL wird die zu bearbeitende Datenmenge angegeben, nicht jedoch die auszuführenden Vorgänge oder die Art und Weise, wie sie ausgeführt werden sollen.
In einem prozeduralen Sprachprogramm hängt die Ausführung der meisten Anweisungen von vorherigen oder nachfolgenden Anweisungen und von Kontrollstrukturen ab, wie Schleifen oder bedingten Verzweigungen, die in SQL nicht verfügbar sind. Angenommen, die folgende SQL-Anweisung fragt die Tabelle employees ab, um den Unterschied zwischen prozeduralen und nicht prozeduralen Sprachen zu veranschaulichen:
SELECT employee_id, department_id, last_name, salary FROM employees;Die vorhergehende Anweisung fordert Daten an, wendet jedoch keine Logik auf die Daten an. Angenommen, Sie möchten von einer Anwendung feststellen, ob jeder Mitarbeiter im Dataset eine Gehaltserhöhung auf der Grundlage der Gehalts- und Abteilungsleistung verdient. Eine notwendige Bedingung für eine Gehaltserhöhung ist, dass der Mitarbeiter in den letzten fünf Jahren nicht mehr als drei Gehaltserhöhungen erhalten hat. Wenn eine Gehaltserhöhung erforderlich ist, muss die Anwendung das Gehalt anpassen und eine E-Mail an den Manager senden. Andernfalls muss die Anwendung einen Bericht aktualisieren.
Das Problem besteht darin, wie prozedurale Datenbankanwendungen, die bedingte Logik und Programmflusssteuerung erfordern, SQL verwenden können. Die grundlegenden Entwicklungsansätze sind wie folgt:
-
Client-seitige Programmierung verwenden, um SQL-Anweisungen in Anwendungen einzubetten, die in prozeduralen Sprachen wie C, C++ oder Java geschrieben sind
Sie können SQL-Anweisungen im Quellcode speichern und vor der Kompilierung an einen Precompiler- oder Java-Übersetzer weiterleiten. Alternativ können Sie den Vorkompilierungsschritt eliminieren und eine API wie Java Database Connectivity (JDBC) oder Oracle Call Interface (OCI) verwenden, um die Interaktion der Anwendung mit der Datenbank zu ermöglichen.
-
Verwenden Sie serverseitige Programmierung, um Datenlogik zu entwickeln, die sich in der Datenbank befindet
Eine Anwendung kann gespeicherte Unterprogramme (Prozeduren und Funktionen), die in PL/SQL (ausgesprochen P L-Sequel) Java oder JavaScript geschrieben sind, explizit aufrufen. Sie können auch einen Trigger erstellen. Dabei handelt es sich um eine benannte Programmeinheit, die in der Datenbank gespeichert und als Reaktion auf ein bestimmtes Ereignis aufgerufen wird.
In diesem Kapitel wird der zweite Ansatz erläutert. Der Hauptvorteil der serverseitigen Programmierung besteht darin, dass die in der Datenbank integrierte Funktionalität überall bereitgestellt werden kann. Die Datenbank und nicht die Anwendung bestimmen, wie Aufgaben auf einem bestimmten Betriebssystem am besten ausgeführt werden. Außerdem erhöhen Unterprogramme die Skalierbarkeit, indem die Anwendungsverarbeitung auf dem Server zentralisiert wird, sodass Clients Code wiederverwenden können. Da Unterprogrammaufrufe schnell und effizient sind, kann ein einzelner Aufruf ein rechenintensives gespeichertes Unterprogramm starten und so den Netzwerkverkehr reduzieren.
In den folgenden Sprachen können Sie Datenlogik in Oracle AI Database speichern:
-
PL/SQL
PL/SQL ist die prozedurale Erweiterung von Oracle AI Database auf SQL. PL/SQL ist in die Datenbank integriert und unterstützt alle Oracle SQL-Anweisungen, -Funktionen und -Datentypen. In Datenbank-APIs geschriebene Anwendungen können gespeicherte PL/SQL-Unterprogramme aufrufen und PL/SQL-Codeblöcke zur Ausführung an die Datenbank senden.
-
Java
Oracle AI Database unterstützt auch die Entwicklung, Speicherung und Bereitstellung von Java-Anwendungen. In Java gespeicherte Unterprogramme werden in der Datenbank ausgeführt und sind unabhängig von Programmen, die in der Middle Tier ausgeführt werden. Java Stored Subprograms Interface mit SQL mit einem ähnlichen Ausführungsmodell wie PL/SQL.
-
JavaScript
Wenn Oracle AI Database unter Linux x86-64 oder Linux aarch64 bereitgestellt wird, können Entwickler Geschäftslogik in JavaScript ausdrücken. Die Ad-hoc-Ausführung von JavaScript wird durch das PL/SQL-Package DBMS_MLE und die zugehörigen Unterroutinen ermöglicht. Wenn Sie Geschäftslogik als JavaScript-Schemaobjekte speichern, können Sie komplexere Anwendungen schreiben. Aufrufspezifikationen stellen JavaScript-Code bereit, der in der Datenbank in SQL und PL/SQL gespeichert ist, und zwar ähnlich wie bei gespeicherten Java-Prozeduren.
Siehe:
-
Oracle AI Database Development Guide mit Informationen zum Einbetten von SQL mit Precompilern und APIs
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung für eine Einführung in die Anwendungsentwicklung von Oracle AI Database
-
Oracle AI Database Development Guide, um zu erfahren, wie Sie eine Programmierumgebung auswählen
-
Oracle AI Database JavaScript – Leitfaden für Entwickler, um mehr über den JavaScript-Support in Oracle AI Database zu erfahren.
PL/SQL - Überblick
PL/SQL bietet eine serverseitige, gespeicherte prozedurale Sprache, die benutzerfreundlich, nahtlos mit SQL, robust, portabel und sicher ist. Mit prozeduralen Objekten, die als PL/SQL-Einheiten bezeichnet werden, können Sie auf Datenbankdaten zugreifen und diese bearbeiten.
PL/SQL-Einheiten werden im Allgemeinen wie folgt kategorisiert:
-
Ein PL/SQL-Unterprogramm ist ein PL/SQL-Block, der in der Datenbank gespeichert ist und nach Namen von einer Anwendung aufgerufen werden kann. Wenn Sie ein Unterprogramm erstellen, parst die Datenbank das Unterprogramm und speichert die geparste Darstellung in der Datenbank. Sie können ein Unterprogramm als Prozedur oder Funktion deklarieren.
-
Ein anonymer PL/SQL-Block ist ein PL/SQL-Block, der in Ihrer Anwendung angezeigt wird und nicht benannt oder in der Datenbank gespeichert ist. In vielen Anwendungen können PL/SQL-Blöcke überall dort angezeigt werden, wo SQL-Anweisungen angezeigt werden können.
PL/SQL-Compiler und -Interpreter sind in Oracle SQL Developer eingebettet, sodass Entwickler ein konsistentes und nutzbares Entwicklungsmodell auf Client und Server erhalten. Darüber hinaus können gespeicherte PL/SQL-Prozeduren von mehreren Datenbankclients aufgerufen werden, wie Pro*C, JDBC, ODBC oder OCI sowie von Oracle Reports und Oracle Forms.
-
PL/SQL-Unterprogramme Ein PL/SQL-Unterprogramm ist ein benannter PL/SQL-Block, mit dem der Aufrufer Parameter bereitstellen kann, die nur Eingabe-, Ausgabe- oder Eingabe- und Ausgabewerte sein können.
-
PL/SQL-Packages Ein PL/SQL-Package ist eine Gruppe zusammengehöriger Unterprogramme, die zusammen mit den verwendeten Cursorn und Variablen zur fortlaufenden Verwendung als Komponente in der Datenbank gespeichert werden. In Packages integrierte Unterprogramme können von Anwendungen oder Benutzern explizit aufgerufen werden.
-
Anonyme PL/SQL-Blöcke Ein anonymer PL/SQL-Block ist eine unbenannte, nicht persistente PL/SQL-Einheit.
-
PL/SQL-Sprachkonstrukte PL/SQL-Blöcke können eine Vielzahl verschiedener PL/SQL-Sprachkonstrukte enthalten.
-
PL/SQL-Collections und -Datensätze Viele Programmierungstechniken verwenden Collection-Typen wie Arrays, Taschen, Listen, verschachtelte Tabellen, Sets und Bäume.
-
PL/SQL-Ausführungen PL/SQL unterstützt sowohl die interpretierte Ausführung als auch die native Ausführung.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung
-
Oracle AI Database PL/SQL Language Reference für ausführliche Informationen über PL/SQL, einschließlich Packages
PL/SQL-Unterprogramme
Ein PL/SQL-Unterprogramm ist ein benannter PL/SQL-Block, mit dem der Aufrufer Parameter bereitstellen kann, die nur Input-, Output- oder Input- und Output-Werte sein können.
Ein Unterprogramm löst ein bestimmtes Problem oder führt zugehörige Aufgaben aus und dient als Baustein für modulare, wartbare Datenbankanwendungen. Ein Unterprogramm ist eine PL/SQL-Prozedur oder eine PL/SQL-Funktion. Prozeduren und Funktionen sind identisch. Funktionen geben dem Aufrufenden jedoch immer einen Einzelwert zurück, Prozeduren aber nicht. Der Begriff PL/SQL-Prozedur in diesem Kapitel bezieht sich entweder auf eine Prozedur oder eine Funktion.
-
Vorteile von PL/SQL-Unterprogrammen Die serverseitige Programmierung hat viele Vorteile gegenüber der clientseitigen Programmierung.
-
Erstellung von PL/SQL-Unterprogrammen Ein eigenständiges gespeichertes Unterprogramm ist ein Unterprogramm, das auf Schemaebene mit der Anweisung
CREATE PROCEDUREoderCREATE FUNCTIONerstellt wird. In einem Package definierte Unterprogramme werden als Packageunterprogramme bezeichnet und werden als Teil des Packages betrachtet. -
Ausführung von PL/SQL-Unterprogrammen Benutzer können ein Unterprogramm auf verschiedene Weise interaktiv ausführen.
Siehe:
-
Pro*C/C++ Developer's Guide und Pro*COBOL Developer's Guide für weitere Informationen zu gespeicherten Prozeduren in diesen Sprachen
Vorteile von PL/SQL-Unterprogrammen
Server-seitige Programmierung hat viele Vorteile gegenüber Client-seitiger Programmierung.
Vorteile sind:
-
Verbesserte Leistung
-
Die Menge an Informationen, die eine Anwendung über ein Netzwerk senden muss, ist gering im Vergleich zur Ausgabe einzelner SQL-Anweisungen oder zum Senden des Textes eines gesamten PL/SQL-Blocks an Oracle AI Database, da die Informationen nur einmal gesendet und danach bei ihrer Verwendung aufgerufen werden.
-
Die kompilierte Form einer Prozedur ist problemlos in der Datenbank verfügbar, sodass zur Ausführungszeit keine Kompilierung erforderlich ist.
-
Wenn die Prozedur im Shared Pool der SGA vorhanden ist, muss die Datenbank sie nicht von der Festplatte abrufen und kann sofort mit der Ausführung beginnen.
-
-
Speicherzuweisung
Da Stored Procedures die Shared Memory-Funktionen von Oracle AI Database nutzen, darf sie zur Ausführung durch mehrere Benutzer nur eine einzige Kopie der Prozedur in den Speicher laden. Die gemeinsame Nutzung von Code unter Benutzern führt zu einer erheblichen Reduzierung der Datenbankspeicheranforderungen für Anwendungen.
-
Verbesserte Produktivität
Gespeicherte Verfahren steigern die Entwicklungsproduktivität. Durch das Entwerfen von Anwendungen um eine allgemeine Gruppe von Prozeduren können Sie redundante Codierung vermeiden. Beispiel: Sie können Prozeduren schreiben, um Zeilen in der Tabelle
employeeszu bearbeiten. Jede Anwendung kann diese Prozeduren aufrufen, ohne dass SQL-Anweisungen neu geschrieben werden müssen. Wenn sich die Methoden der Datenverwaltung ändern, müssen nur die Prozeduren geändert werden, nicht die Anwendungen, die diese Prozeduren verwenden.Gespeicherte Prozeduren sind vielleicht der beste Weg, um die Wiederverwendung von Code zu erreichen. Da jede Clientanwendung, die in einer beliebigen Sprache erstellt wurde, die sich bei der Datenbank anmeldet, Stored Procedures aufrufen kann, bieten sie die maximale Wiederverwendung von Code in allen Umgebungen.
-
Integrität
Gespeicherte Prozeduren verbessern die Integrität und Konsistenz Ihrer Anwendungen. Durch die Entwicklung von Anwendungen für eine gemeinsame Gruppe von Prozeduren reduzieren Sie die Wahrscheinlichkeit von Codierungsfehlern.
Beispiel: Sie können ein Unterprogramm testen, um sicherzustellen, dass es ein genaues Ergebnis zurückgibt, und es nach der Prüfung in einer beliebigen Anzahl von Anwendungen wiederverwenden, ohne erneut zu testen. Wenn die von der Prozedur referenzierten Datenstrukturen geändert werden, müssen Sie die Prozedur nur neu kompilieren. Anwendungen, die das Verfahren aufrufen, müssen nicht unbedingt geändert werden.
-
Sicherheit mit den Rechten des Eigentümers
Gespeicherte Prozeduren können zur Durchsetzung der Datensicherheit beitragen. Eine definer's rights-PL/SQL-Prozedur wird mit der Berechtigung des Eigentümers ausgeführt, nicht mit dem aktuellen Benutzer. Auf diese Weise können Sie die Datenbank-Tasks einschränken, die Benutzer ausführen, indem Sie ihnen den Zugriff auf Daten nur über Prozeduren und Funktionen ermöglichen, die mit den Berechtigungen des Eigentümers ausgeführt werden.
Beispiel: Sie können Benutzern Zugriff auf eine Prozedur erteilen, die eine Tabelle aktualisiert, aber keinen Zugriff auf die Tabelle selbst gewährt. Wenn ein Benutzer die Prozedur aufruft, wird sie mit den Privilegien seines Eigentümers ausgeführt. Benutzer, die nur über die Berechtigung zum Ausführen der Prozedur verfügen (aber nicht über die Berechtigung zum Abfragen, Aktualisieren oder Löschen aus den zugrunde liegenden Tabellen), können die Prozedur aufrufen, jedoch Tabellendaten nicht auf andere Weise bearbeiten.
-
Geerbte Berechtigungen und Schemakontext mit Prozeduren für Rechte des ausführenden Benutzers
Eine PL/SQL-Prozedur mit Rechten des ausführenden Benutzers wird im Schema des aktuellen Benutzers mit den Berechtigungen des aktuellen Benutzers ausgeführt. Das heißt, die Rechteprozedur eines ausführenden Benutzers ist nicht an einen bestimmten Benutzer oder ein bestimmtes Schema gebunden. Die Rechteprozeduren des ausführenden Benutzers erleichtern Anwendungsentwicklern die Zentralisierung der Anwendungslogik, selbst wenn die zugrunde liegenden Daten auf Benutzerschemas aufgeteilt sind.
Beispiel: Ein
hr_manager-Benutzer, der eine Aktualisierungsprozedur für die Tabellehr.employeesausführt, kann Gehälter aktualisieren, während einhr_clerk, der dieselbe Prozedur ausführt, auf die Aktualisierung von Adressdaten beschränkt ist.
Siehe:
-
Oracle AI Database PL/SQL Language Reference für einen Überblick über PL/SQL-Unterprogramme
-
Oracle AI Database - Sicherheitshandbuch, um mehr über die Rechte des Eigentümers und des ausführenden Benutzers zu erfahren
PL/SQL-Unterprogramme erstellen
Ein eigenständiges gespeichertes Unterprogramm ist ein Unterprogramm, das auf Schemaebene mit der Anweisung CREATE PROCEDURE oder CREATE FUNCTION erstellt wird. In einem Package definierte Unterprogramme werden als Packageunterprogramme bezeichnet und werden als Teil des Packages betrachtet.
Die Datenbank speichert Unterprogramme im Data Dictionary als Schemaobjekte. Ein Unterprogramm verfügt über eine Spezifikation, die Beschreibungen aller Parameter und einen Body enthält.
Beispiel 11-1: PL/SQL-Prozedur
Dieses Beispiel zeigt einen Teil einer Erstellungsanweisung für die Standalone-PL/SQL-Prozedur hire_employees. Die Prozedur fügt eine Zeile in die Tabelle employees ein.
CREATE PROCEDURE hire_employees
  (p_last_name VARCHAR2, p_job_id VARCHAR2, p_manager_id NUMBER,
   p_hire_date DATE, p_salary NUMBER, p_commission_pct NUMBER,
   p_department_id NUMBER)
IS
BEGIN
.
.
.
  INSERT INTO employees (employee_id, last_name, job_id, manager_id, hire_date,
    salary, commission_pct, department_id)
  VALUES (emp_sequence.NEXTVAL, p_last_name, p_job_id, p_manager_id,
          p_hire_date, p_salary, p_commission_pct, p_department_id);
.
.
.
END;
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung, um zu erfahren, wie Unterprogramme erstellt werden
-
Oracle AI Database PL/SQL Language Reference, um mehr über die Anweisung
CREATE PROCEDUREzu erfahren
Ausführung von PL/SQL-Unterprogrammen
Benutzer können ein Unterprogramm auf unterschiedliche Weise interaktiv ausführen.
Verfügbare Optionen:
-
Oracle-Tools wie SQL*Plus oder SQL Developer
-
explizit im Code einer Datenbankanwendung wie einer Oracle Forms- oder Precompiler-Anwendung aufgerufen werden
-
Sie explizit im Code einer anderen Prozedur oder Trigger aufrufen
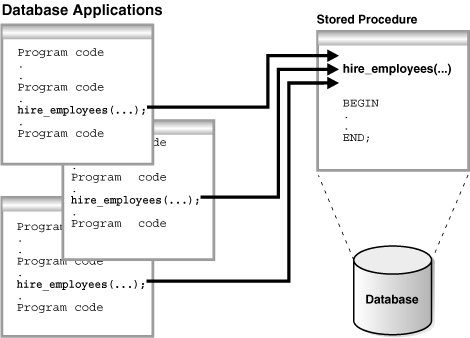
Die folgende Grafik zeigt verschiedene Datenbankanwendungen, die hire_employees aufrufen.
Abbildung 1: Mehrere Ausführungen einer gespeicherten Prozedur
Beschreibung der Abbildung cncpt073.gif
Alternativ kann ein berechtigter Benutzer Oracle Enterprise Manager oder SQL*Plus verwenden, um die Prozedur hire_employees mit einer Anweisung wie der folgenden auszuführen:
EXECUTE hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);Mit der vorherigen Anweisung wird ein neuer Datensatz für TSMITH in die Tabelle employees eingefügt.
Eine Stored Procedure hängt von den Objekten ab, die in ihrem Body referenziert werden. Die Datenbank verfolgt und verwaltet diese Abhängigkeiten automatisch. Beispiel: Wenn Sie die Definition der Tabelle employees, die von der Prozedur hire_employees referenziert wird, so ändern, dass sich dies auf diese Prozedur auswirkt, muss die Prozedur neu kompiliert werden, um zu prüfen, ob sie noch wie geplant funktioniert. In der Regel verwaltet die Datenbank diese Abhängigkeitsverwaltung automatisch.
Siehe:
-
Oracle AI Database – Erste Schritte mit Oracle AI Database Development, um mehr über SQL*Plus und SQL Developer zu erfahren
-
Oracle AI Database Development Guide, um mehr über Precompiler zu erfahren
-
Oracle AI Database PL/SQL Language Reference mit Informationen zur Verwendung von PL/SQL-Unterprogrammen
-
SQL*Plus User's Guide and Reference zum
EXECUTE-Befehl
PL/SQL-Packages
Ein PL/SQL-Package ist eine Gruppe zusammengehöriger Unterprogramme, die zusammen mit den verwendeten Cursorn und Variablen zur fortlaufenden Verwendung als Maßeinheit in der Datenbank gespeichert werden. In Packages integrierte Unterprogramme können von Anwendungen oder Benutzern explizit aufgerufen werden.
Oracle AI Database umfasst viele bereitgestellte Packages, die Datenbankfunktionen erweitern und PL/SQL-Zugriff auf SQL-Features ermöglichen. Beispiel: Mit dem Package UTL_HTTP können HTTP-Callouts von PL/SQL und SQL auf Daten im Internet zugreifen oder Oracle Web Server-Cartridges aufrufen. Sie können die bereitgestellten Packages beim Erstellen von Anwendungen oder als Ideenquelle beim Erstellen eigener gespeicherter Prozeduren verwenden.
-
Vorteile von PL/SQL-Packages PL/SQL-Packages bieten dem Anwendungsentwickler eine Reihe von Vorteilen.
-
PL/SQL-Packages erstellen Sie erstellen ein Package in zwei Teilen: der Spezifikation und dem Body. Die Package-Spezifikation deklariert alle öffentlichen Konstrukte des Packages, während der Package-Body alle Konstrukte (öffentlich und privat) des Packages definiert.
-
Ausführung von PL/SQL-Packageunterprogrammen Datenbank-Triggern, gespeicherten Unterprogrammen, 3GL-Anwendungsprogrammen und Oracle-Tools können Packageinhalte referenzieren.
Vorteile von PL/SQL-Packages
PL/SQL-Packages bieten dem Anwendungsentwickler eine Reihe von Vorteilen.
Vorteile sind:
-
Kapselung
Mit Packages können Sie gespeicherte Prozeduren, Variablen, Datentypen usw. in einer benannten, gespeicherten Einheit kapseln oder gruppieren. Die Kapselung bietet eine bessere Organisation während der Entwicklung und auch mehr Flexibilität. Sie können Spezifikationen erstellen und öffentliche Prozeduren referenzieren, ohne den Package Body tatsächlich zu erstellen. Die Kapselung vereinfacht die Berechtigungsverwaltung. Das Erteilen der Berechtigung für ein Package macht Packagekonstrukte für den Berechtigten zugänglich.
-
Datensicherheit
Mit den Methoden der Packagedefinition können Sie angeben, welche Variablen, Cursor und Prozeduren öffentlich und privat sind. Öffentlich bedeutet, dass es für den Benutzer eines Pakets direkt zugänglich ist. Privat bedeutet, dass es für den Benutzer eines Pakets ausgeblendet ist.
Beispiel: Ein Package kann 10 Prozeduren enthalten. Sie können das Package so definieren, dass nur drei Prozeduren öffentlich sind und daher von einem Benutzer des Packages ausgeführt werden können. Die restlichen Prozeduren sind privat und können nur von den Prozeduren im Paket aufgerufen werden. Verwechseln Sie öffentliche und private Packagevariablen nicht mit Berechtigungen für
PUBLIC. -
Bessere Leistung
Ein ganzes Package wird in kleinen Chunks in den Speicher geladen, wenn eine Prozedur im Package zum ersten Mal aufgerufen wird. Dieser Ladevorgang wird in einem Vorgang abgeschlossen, im Gegensatz zu den separaten Ladevorgängen, die für eigenständige Prozeduren erforderlich sind. Bei Aufrufen zugehöriger in einem Package integrierter Prozeduren ist kein Datenträger-I/O erforderlich, um den kompilierten Code im Speicher auszuführen.
Ein Packagebody kann ersetzt und rekompiliert werden, ohne dass sich dies auf die Spezifikation auswirkt. Daher müssen Schemaobjekte, die Konstrukte eines Packages (immer durch die Spezifikation) referenzieren, nur rekompiliert werden, wenn auch die Packagespezifikation ersetzt wird. Durch die Verwendung von Packages können unnötige Rekompilierungen minimiert werden, was zu geringeren Auswirkungen auf die Gesamtperformance der Datenbank führt.
PL/SQL-Packages erstellen
Sie erstellen ein Package in zwei Teilen: der Spezifikation und dem Body. Die Package-Spezifikation deklariert alle öffentlichen Konstrukte des Packages, während der Package-Body alle Konstrukte (öffentlich und privat) des Packages definiert.
Das folgende Beispiel zeigt einen Teil einer Anweisung, mit der die Packagespezifikation für employees_management erstellt wird. Dadurch werden mehrere Unterprogramme kapselt, mit denen eine Mitarbeiterdatenbank verwaltet wird. Jeder Teil des Packages wird mit einer anderen Anweisung erstellt.
CREATE PACKAGE employees_management AS
  FUNCTION hire_employees (last_name VARCHAR2, job_id VARCHAR2, manager_id NUMBER,
    salary NUMBER, commission_pct NUMBER, department_id NUMBER) RETURN NUMBER;
  PROCEDURE fire_employees(employee_id NUMBER);
  PROCEDURE salary_raise(employee_id NUMBER, salary_incr NUMBER);
.
.
.
  no_sal EXCEPTION;
END employees_management;
Die Spezifikation deklariert die Funktion hire_employees, die Prozeduren fire_employees und salary_raise und die Ausnahme no_sal. Alle diese öffentlichen Programmobjekte stehen Benutzern zur Verfügung, die Zugriff auf das Paket haben.
Die Anweisung CREATE PACKAGE BODY definiert Objekte, die in der Spezifikation deklariert sind. Der Packagebody muss im selben Schema wie das Package erstellt werden. Nachdem Sie das Package erstellt haben, können Sie Anwendungen entwickeln, die eine dieser öffentlichen Prozeduren oder Funktionen aufrufen oder eine der öffentlichen Exceptions des Packages auslösen.
Siehe auch: Oracle AI Database PL/SQL Language Reference, um mehr über die Anweisung CREATE PACKAGE zu erfahren
Ausführung von PL/SQL-Packageunterprogrammen
Datenbank-Trigger, gespeicherte Unterprogramme, 3GL-Anwendungsprogramme und Oracle-Tools können Packageinhalte referenzieren.
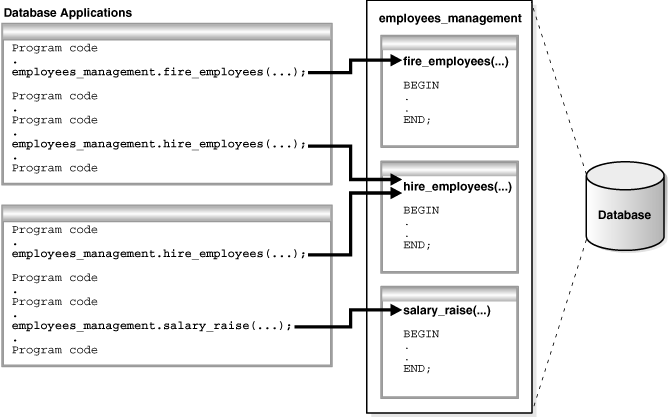
Die folgende Grafik zeigt Datenbankanwendungen, die Prozeduren und Funktionen im Package employees_management aufrufen.
Abbildung 2: Unterprogramme in einem PL/SQL-Package aufrufen
Beschreibung der Abbildung cncpt075.gif
Datenbankanwendungen rufen gepackte Prozeduren bei Bedarf explizit auf. Nachdem einem Benutzer die Berechtigungen für das Package employees_management erteilt wurden, kann er alle darin enthaltenen Prozeduren explizit ausführen. Beispiel: SQL*Plus kann die folgende Anweisung absetzen, um die Packageprozedur hire_employees auszuführen:
EXECUTE employees_management.hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);Siehe:
-
Oracle AI Database PL/SQL Language Reference für eine Einführung in PL/SQL-Packages
-
Oracle AI Database Development Guide, um zu erfahren, wie PL/SQL-Packages codiert werden
Anonymer PL/SQL-Block
Ein anonymer PL/SQL-Block ist eine nicht benannte, nicht persistente PL/SQL-Einheit.
Typische Verwendungsmöglichkeiten für anonyme Blöcke sind:
-
Aufrufe von Unterprogrammen und Packagekonstrukten initiieren
-
Exception-Behandlung isolieren
-
Steuerung durch Verschachtelung von Code in anderen PL/SQL-Blöcken verwalten
Anonyme Blöcke haben nicht die Vorteile der Codewiederverwendung gespeicherter Unterprogramme. In Tabelle 11-1 werden die Unterschiede zwischen den beiden Typen von PL/SQL-Einheiten zusammengefasst.
Tabelle 1: Unterschiede zwischen anonymen Blöcken und Unterprogrammen
| Ist die PL/SQL-Einheit … | Anonyme Blöcke | Unterprogramme |
|---|---|---|
| Mit einem Namen angegeben? | Nein | Ja |
| Zusammengestellt mit jeder Wiederverwendung? | Nein | Nein |
| In der Datenbank gespeichert? | Nein | Ja |
| Durch andere Anwendungen aufrufbar? | Nein | Ja |
| Kann Bind-Variablenwerte zurückgegeben werden? | Ja | Ja |
| Fähigkeit, Funktionswerte zurückzugeben? | Nein | Ja |
| Fähigkeit, Parameter zu akzeptieren? | Nein | Ja |
Ein anonymer Block besteht aus einem optionalen deklarativen Teil, einem ausführbaren Teil und einem oder mehreren optionalen Exception Handlern. Im folgenden anonymen Beispielblock wird der Nachname eines Mitarbeiters in einer Variablen ausgewählt und der Name ausgegeben:
DECLARE
  v_lname VARCHAR2(25);
BEGIN
  SELECT last_name
    INTO v_lname
  FROM employees
  WHERE employee_id = 101;
  DBMS_OUTPUT.PUT_LINE('Employee last name is '||v_lname);
END;
Oracle AI Database kompiliert den PL/SQL-Block und platziert ihn im Shared Pool der SGA, speichert den Quellcode oder die kompilierte Version jedoch nicht in der Datenbank, um sie über die aktuelle Instanz hinaus wiederzuverwenden. Im Gegensatz zu Triggern wird ein anonymer Block jedes Mal kompiliert, wenn er in den Speicher geladen wird. Mit Shared SQL können anonyme PL/SQL-Blöcke im Shared Pool wiederverwendet und gemeinsam genutzt werden, bis sie aus dem Shared Pool entfernt werden.
Siehe auch: Oracle AI Database Development Guide, um mehr über anonyme PL/SQL-Blöcke zu erfahren
PL/SQL-Sprachkonstrukte
PL/SQL-Blöcke können verschiedene PL/SQL-Sprachkonstrukte enthalten.
Diese Konstrukte umfassen:
-
Variablen und Konstanten
Sie können diese Konstrukte in einer Prozedur, Funktion oder einem Package deklarieren. Sie können eine Variable oder Konstante in einer SQL- oder PL/SQL-Anweisung verwenden, um bei Bedarf einen Wert zu erfassen oder bereitzustellen.
-
Cursor
Sie können einen Cursor explizit in einer Prozedur, Funktion oder einem Package deklarieren, um die datensatzorientierte Verarbeitung von Oracle AI Database-Daten zu erleichtern. Die PL/SQL-Engine kann Cursor auch implizit deklarieren.
-
Ausnahmen
Mit PL/SQL können Sie explizit interne und benutzerdefinierte Fehlerbedingungen verarbeiten, die als Ausnahmen bezeichnet werden und bei der Verarbeitung von PL/SQL-Code auftreten.
PL/SQL kann dynamische SQL-Anweisungen ausführen, deren vollständiger Text erst zur Laufzeit bekannt ist. Dynamische SQL-Anweisungen werden in Zeichenfolgen gespeichert, die zur Laufzeit in das Programm eingegeben oder von diesem erstellt werden. Mit dieser Technik können Sie allgemeine Prozeduren erstellen. Beispiel: Sie können eine Prozedur erstellen, die eine Tabelle bearbeitet, deren Name erst zur Laufzeit bekannt ist.
Siehe:
-
Oracle AI Database PL/SQL Packages and Types Reference für Details zu dynamischem SQL
-
Oracle AI Database PL/SQL Packages and Types Reference, um zu erfahren, wie dynamisches SQL im Package
DBMS_SQLverwendet wird
PL/SQL-Sammlungen und -Datensätze
Bei vielen Programmierungstechniken werden Collection-Typen wie Arrays, Taschen, Listen, Nested Tables, Sets und Bäume verwendet.
Um Collection-Techniken in Datenbankanwendungen zu unterstützen, stellt PL/SQL die Datentypen TABLE und VARRAY bereit. Mit diesen Typen können Sie assoziative Arrays, Nested Tables und Arrays mit variabler Größe deklarieren.
-
Collections Eine PL/SQL-Collection ist eine geordnete Gruppe von Elementen, die alle denselben Typ aufweisen.
-
Datensätze Ein PL/SQL-Datensatz ist eine zusammengesetzte Variable, die Datenwerte unterschiedlicher Typen speichern kann, ähnlich wie ein Strukturtyp in C, C++ oder Java. Datensätze eignen sich für die Speicherung von Daten in Tabellenzeilen oder für bestimmte Spalten aus Tabellenzeilen.
Inkasso
Eine PL/SQL-Collection ist eine geordnete Gruppe von Elementen, die alle denselben Typ aufweisen.
Jedes Element hat ein individuelles untergeordnetes Skript, das seine Position in der Collection bestimmt. Um eine Collection zu erstellen, definieren Sie zunächst einen Collection-Typ und deklarieren dann eine Variable dieses Typs.
Collections funktionieren wie die Arrays in den meisten Programmiersprachen der dritten Generation. Außerdem können Collections als Parameter übergeben werden. Sie können sie also verwenden, um Datenspalten in Datenbanktabellen oder zwischen Client-seitigen Anwendungen und gespeicherten Unterprogrammen zu verschieben.
Datensätze
Ein PL/SQL-Datensatz ist eine zusammengesetzte Variable, die Datenwerte unterschiedlicher Typen speichern kann, ähnlich wie ein Strukturtyp in C, C++ oder Java. Datensätze eignen sich für die Speicherung von Daten in Tabellenzeilen oder für bestimmte Spalten aus Tabellenzeilen.
Angenommen, Sie haben Daten zu einem Mitarbeiter, z.B. Name, Gehalt und Einstellungsdatum. Diese Elemente sind vom Typ her unterschiedlich, aber logisch miteinander verbunden. Mit einem Datensatz, der ein Feld für jedes Element enthält, können Sie die Daten als logische Einheit behandeln.
Mit dem Attribut %ROWTYPE können Sie einen Datensatz deklarieren, der eine Tabellenzeile oder -zeile darstellt, die von einem Cursor abgerufen wurde. Mit benutzerdefinierten Datensätzen können Sie eigene Felder deklarieren.
Siehe auch: Oracle AI Database PL/SQL Language Reference, um zu erfahren, wie PL/SQL-Datensätze verwendet werden
PL/SQL-Ausführungen
PL/SQL unterstützt sowohl die interpretierte als auch die native Ausführung.
Bei der interpretierten Ausführung wird der PL/SQL-Quellcode in eine sogenannte Bytecode-Darstellung kompiliert. Ein portabler virtueller Computer, der als Teil von Oracle AI Database implementiert ist, führt diesen Bytecode aus.
Native Ausführung bietet die beste Performance auf rechenintensiven Einheiten. In diesem Fall wird der Quellcode von PL/SQL-Einheiten direkt zu Objektcode für die angegebene Plattform kompiliert. Dieser Objektcode ist mit Oracle AI Database verknüpft.
Die PL/SQL-Engine definiert, kompiliert und führt PL/SQL-Einheiten aus. Diese Engine ist eine spezielle Komponente vieler Oracle-Produkte, einschließlich Oracle AI Database. Während viele Oracle-Produkte über PL/SQL-Komponenten verfügen, behandelt dieses Thema insbesondere die PL/SQL-Einheiten, die in Oracle AI Database gespeichert und mit der Oracle AI Database PL/SQL-Engine verarbeitet werden können. In der Dokumentation für jedes Oracle-Tool werden die PL/SQL-Funktionen beschrieben.
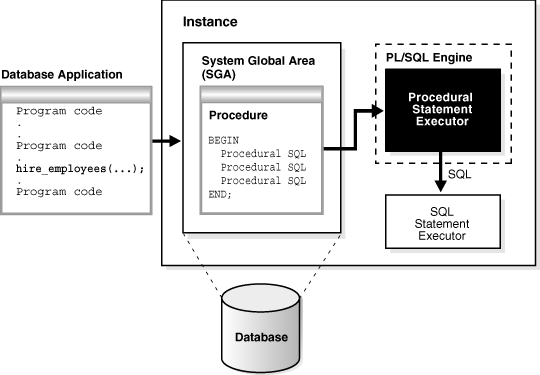
In der folgenden Abbildung wird die PL/SQL-Engine in Oracle AI Database dargestellt.
Abbildung 3: PL/SQL-Engine und Oracle AI Database
Beschreibung der Abbildung cncpt070.gif
Die PL/SQL-Einheit wird in einer Datenbank gespeichert. Wenn eine Anwendung eine Stored Procedure aufruft, lädt die Datenbank die kompilierte PL/SQL-Einheit in den Shared Pool in der System Global Area (SGA). Die PL/SQL- und SQL-Anweisung Executors arbeiten zusammen, um die Anweisungen in der Prozedur zu verarbeiten.
Sie können eine Stored Procedure aus einem anderen PL/SQL-Block aufrufen, der entweder ein anonymer Block oder eine andere Stored Procedure sein kann. Beispiel: Sie können eine Stored Procedure in Oracle Forms aufrufen.
Eine PL/SQL-Prozedur, die auf Oracle AI Database ausgeführt wird und eine externe Prozedur oder Funktion aufrufen kann, die in der C-Programmiersprache geschrieben und in einer gemeinsamen Library gespeichert sind. Die C-Routine wird in einem separaten Adressraum von Oracle AI Database ausgeführt.
Siehe:
-
"Shared Pool", um mehr über Zweck und Inhalt des Shared Pools zu erfahren
-
Oracle AI Database PL/SQL Language Reference als Lernmaterial zum PL/SQL-Architektur
-
Oracle AI Database Development Guide, um mehr über externe Verfahren zu erfahren
Überblick über Java in Oracle AI Database
Java ist die objektorientierte Programmiersprache der Wahl.
Java umfasst die folgenden Funktionen:
-
Eine Java Virtual Machine (JVM), die als Grundlage für die Plattformunabhängigkeit dient
-
Automatisierte Speicherverwaltungstechniken wie Garbage Collection
-
Sprachsyntax, die von C übernommen wird und eine starke Eingabe durchsetzt Hinweis: In diesem Kapitel wird davon ausgegangen, dass Sie mit der Java-Sprache vertraut sind.
Die Datenbank bietet Java-Programmen eine dynamische Datenverarbeitungs-Engine, die komplexe Abfragen und mehrere Datenansichten unterstützt. Clientanforderungen werden zur sofortigen Verarbeitung als Datenabfragen zusammengestellt. Abfrageergebnisse werden dynamisch generiert.
Die Kombination aus Java und Oracle AI Database hilft Ihnen, komponentenbasierte, netzwerkorientierte Anwendungen zu erstellen, die leicht aktualisiert werden können, wenn sich die Geschäftsanforderungen ändern. Darüber hinaus können Sie Anwendungen und Datenspeicher vom Desktop auf intelligente Netzwerke und netzwerkorientierte Server verschieben. Noch wichtiger ist, dass Sie von jedem Clientgerät aus auf diese Anwendungen und Datenspeicher zugreifen können.
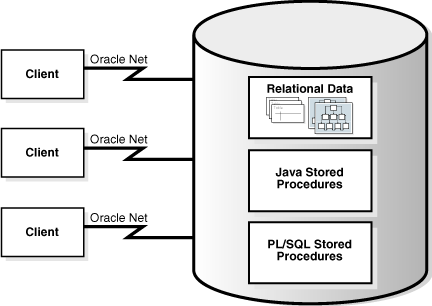
Die folgende Abbildung zeigt eine herkömmliche Two-Tier-Client/Server-Konfiguration, bei der Clients gespeicherte Java-Prozeduren auf dieselbe Weise aufrufen wie PL/SQL-Unterprogramme.
Abbildung 4: Konfiguration von Client/Server mit zwei Ebenen
Beschreibung der Abbildung cncpt236.gif
-
Überblick über Java Virtual Machine (JVM) Ein JVM ist ein virtueller Prozessor, der kompilierten Java-Code ausführt.
-
Java-Programmierumgebung Oracle bietet Entwicklern von Unternehmensanwendungen eine End-to-End-Java-Lösung zum Erstellen, Bereitstellen und Verwalten von Java-Anwendungen. Siehe auch: Oracle AI Database – Erste Schritte mit der Java-Entwicklung für eine Einführung in die Verwendung von Java mit Oracle AI Database
Überblick über Java Virtual Machine (JVM)
Ein JVM ist ein virtueller Prozessor, der kompilierten Java-Code ausführt.
Der Java-Quellcode wird zu Maschinenanweisungen auf niedriger Ebene kompiliert, die als Bytecodes bezeichnet werden und plattformunabhängig sind. Die Java-Bytecodes werden über die JVM in plattformabhängige Aktionen interpretiert.
-
Überblick über Oracle JVM Die Oracle JVM ist eine standardmäßige, Java-kompatible Umgebung, in der jede reine Java-Anwendung ausgeführt wird. Sie ist mit den JLS- und JVM-Spezifikationen kompatibel.
-
Hauptkomponenten der Oracle JVM Oracle JVM werden im selben Prozess- und Adressraum wie der Datenbank-Kernel ausgeführt, indem die Speicher-Heaps gemeinsam genutzt und direkt auf die relationalen Daten zugegriffen wird. Dieses Design optimiert die Speicherauslastung und erhöht den Durchsatz.
Oracle JVM - Überblick
Die Oracle JVM ist eine standardmäßige, Java-kompatible Umgebung, in der jede reine Java-Anwendung ausgeführt wird. Sie ist mit den JLS- und JVM-Spezifikationen kompatibel.
Die Oracle JVM unterstützt das standardmäßige Java-Binärformat und die APIs. Darüber hinaus hält sich Oracle AI Database an die standardmäßige Java-Sprachsemantik, einschließlich des dynamischen Ladens von Klassen zur Laufzeit.
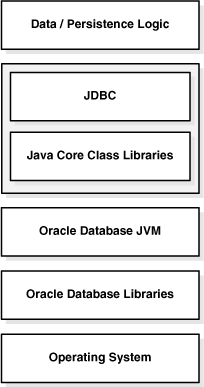
Die folgende Abbildung veranschaulicht, wie sich Oracle Java-Anwendungen auf den Java-Core-Klassenbibliotheken befinden, die sich auf der Oracle JVM befinden. Da sich das Oracle Java-Supportsystem in der Datenbank befindet, interagiert die JVM mit Datenbank-Librarys, anstatt direkt mit dem Betriebssystem zu interagieren.
Abbildung 5: Java-Komponentenstruktur
Beschreibung der Abbildung cncpt206.gif
Im Gegensatz zu anderen Java-Umgebungen ist Oracle JVM in Oracle AI Database eingebettet. Zwischen Oracle JVM und typischen Client-JVMs bestehen einige wichtige Unterschiede. Beispiel: In einer Java-Standardumgebung führen Sie eine Java-Anwendung über den Interpreter aus, indem Sie den folgenden Befehl in der Befehlszeile absetzen, wobei classname der Name der Klasse ist, die von der JVM zuerst interpretiert wird:
java classnameMit dem vorstehenden Befehl wird die Anwendung in einem Prozess auf Ihrem Betriebssystem ausgeführt. Wenn Sie jedoch nicht die Befehlszeilenschnittstelle verwenden, müssen Sie die Anwendung in die Datenbank laden, die Schnittstelle veröffentlichen und dann die Anwendung in einem Datenbank-Data Dictionary ausführen.
Siehe auch: In Oracle AI Database Java Developer's Guide finden Sie eine Beschreibung anderer Unterschiede zwischen der Oracle JVM und typischen Client-JVMs.
Hauptkomponenten der Oracle JVM
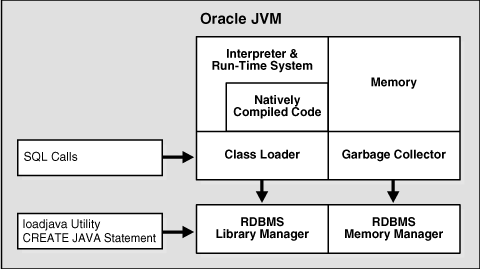
Die Oracle JVM wird im selben Prozess- und Adressraum wie der Datenbank-Kernel ausgeführt, indem die Speicher-Heaps gemeinsam genutzt und direkt auf die relationalen Daten zugegriffen wird. Dieses Design optimiert die Speicherauslastung und erhöht den Durchsatz.
Oracle JVM bietet eine Laufzeitumgebung für Java-Objekte. Es unterstützt vollständig Java-Datenstrukturen, Methoden-Dispatch, Exception-Behandlung und Threads auf Sprachebene. Außerdem werden alle Core-Java-Klassenbibliotheken unterstützt, einschließlich java.lang, java.io, java.net, java.math und java.util.
Die folgende Abbildung zeigt die Hauptkomponenten der Oracle JVM.
Abbildung 6: Hauptkomponenten der Oracle JVM
Beschreibung der Abbildung cncpt254.gif
In Oracle JVM wird der Standard-Java-Namespace in die Datenbankschemas eingebettet. Mit dieser Funktion können Java-Programme auf Java-Objekte zugreifen, die in Oracle AI Database und auf Anwendungsservern im gesamten Unternehmen gespeichert sind.
Darüber hinaus ist Oracle JVM eng in die skalierbare Shared Memory-Architektur der Datenbank integriert. Java-Programme verwenden Anruf-, Sitzungs- und Objektlebenszeiten effizient, ohne dass der Benutzer eingreifen muss. Daher können Oracle JVM- und Middle Tier-Java-Geschäftsobjekte auch dann skaliert werden, wenn sie einen Session-Long-Status aufweisen.
Siehe auch: Oracle AI Database Java Developer's Guide für eine Beschreibung der Hauptkomponenten von Oracle JVM
Java-Programmierumgebung
Oracle bietet Entwicklern von Unternehmensanwendungen eine End-to-End-Java-Lösung zum Erstellen, Bereitstellen und Verwalten von Java-Anwendungen.
Die Lösung besteht aus clientseitigen und serverseitigen Programmschnittstellen, Tools zur Unterstützung der Java-Entwicklung und einer Java Virtual Machine, die in Oracle AI Database integriert ist. Alle diese Produkte sind mit Java-Standards kompatibel.
Die Java-Programmierumgebung umfasst die folgenden zusätzlichen Features:
-
Java Stored Procedures als Java-Äquivalent und Begleiter für PL/SQL. Java Stored Procedures sind eng in PL/SQL integriert. Sie können gespeicherte Java-Prozeduren aus PL/SQL-Packages und Prozeduren aus gespeicherten Java-Prozeduren aufrufen.
-
Die Programmierschnittstellen JDBC und SQLJ für den Zugriff auf SQL-Daten.
-
Tools und Skripte, die beim Entwickeln, Laden und Verwalten von Klassen helfen.
-
Gespeicherte Java-Prozeduren Eine gespeicherte Java-Prozedur ist eine Java-Methode, die in SQL veröffentlicht und in der Datenbank gespeichert wird.
-
Java- und PL/SQL-Integration Sie können vorhandene PL/SQL-Programme aus Java- und Java-Programmen aus PL/SQL aufrufen. Diese Lösung schützt und nutzt Ihren PL/SQL- und Java-Code.
Java Stored Procedures
Eine Java Stored Procedure ist eine Java-Methode, die in SQL veröffentlicht und in der Datenbank gespeichert wird.
Wie ein PL/SQL-Unterprogramm kann eine Java-Prozedur direkt mit Produkten wie SQL*Plus oder indirekt mit einem Trigger aufgerufen werden. Sie können von jedem Oracle Net-Client-OCI, -Precompiler oder -JDBC darauf zugreifen.
Um Java-Methoden zu veröffentlichen, schreiben Sie Aufrufspezifikationen, die Java-Methodennamen, Parametertypen und Rückgabetypen ihren SQL-Pendants zuordnen. Wenn eine gespeicherte Java-Prozedur von Clientanwendungen aufgerufen wird, kann sie Argumente akzeptieren, Java-Klassen referenzieren und Java-Ergebniswerte zurückgeben.
Anwendungen, die die Java-Methode aufrufen, indem sie den Namen der Aufrufspezifikation referenzieren. Das Laufzeitsystem sucht die Definition der Aufrufspezifikation im Oracle Data Dictionary und führt die entsprechende Java-Methode aus.
Darüber hinaus können Sie mit Java leistungsfähige Programme unabhängig von PL/SQL entwickeln. Oracle AI Database bietet eine vollständig konforme Implementierung der Java-Programmiersprache und JVM.
Siehe auch: In Oracle AI Database Java Developer's Guide wird erläutert, wie Stored Procedures in Java geschrieben werden, wie Sie von PL/SQL darauf zugreifen und wie Sie von Java aus auf PL/SQL-Funktionen zugreifen.
Java- und PL/SQL-Integration
Sie können vorhandene PL/SQL-Programme aus Java- und Java-Programmen aus PL/SQL aufrufen. Diese Lösung schützt und nutzt Ihren PL/SQL- und Java-Code.
Oracle AI Database bietet JDBC für den Zugriff auf SQL-Daten von Java auf Client und Server.
- JDBC-Treiber JDBC ist ein Datenbankzugriffsprotokoll, mit dem Sie eine Verbindung zu einer Datenbank herstellen und SQL-Anweisungen und Abfragen zur Datenbank ausführen können.
JDBC-Treiber
JDBC ist ein Datenbankzugriffsprotokoll, mit dem Sie sich bei einer Datenbank anmelden und SQL-Anweisungen und -Abfragen in der Datenbank ausführen können.
Die Core-Java-Klassen-Librarys stellen nur eine JDBC-API bereit, java.sql. JDBC wurde jedoch entwickelt, um es Anbietern zu ermöglichen, Treiber bereitzustellen, die die erforderliche Spezialisierung für eine bestimmte Datenbank bieten. Oracle stellt die eindeutigen JDBC-Treiber bereit, die in der folgenden Tabelle gezeigt werden.
Tabelle 2: JDBC-Treiber
| Treiber | Beschreibung |
|---|---|
| JDBC-Thin-Treiber | Mit dem JDBC-Thin-Treiber können Sie reine Java-Anwendungen und -Applets schreiben, die auf Oracle SQL-Daten zugreifen. Der JDBC-Thin-Treiber eignet sich besonders gut für webbasierte Anwendungen und Applets, da Sie ihn wie jedes andere Java-Applet dynamisch von einer Webseite herunterladen können. |
| JDBC-OCI-Treiber | Der JDBC-OCI-Treiber greift auf Oracle-spezifischen nativen Code, d.h. Nicht-Java-Code, und Librarys auf der Client- oder Middle Tier zu und bietet eine Performancesteigerung im Vergleich zum JDBC-Thin-Treiber auf Kosten einer deutlich größeren Größe und einer clientseitigen Installation. |
| Interner JDBC-Serverseitiger Treiber | Oracle AI Database verwendet den serverseitigen internen Treiber, wenn der Java-Code auf dem Server ausgeführt wird. Damit können Java-Anwendungen, die in Oracle JVM auf dem Server ausgeführt werden, mit JDBC auf lokal definierte Daten zugreifen, d.h. auf Daten auf demselben System und im selben Prozess. Es bietet eine Performancesteigerung, da die zugrunde liegenden Oracle RDBMS-Librarys direkt verwendet werden können, ohne dass der Overhead einer zwischengeschalteten Netzwerkverbindung zwischen Java-Code und SQL-Daten entsteht. Durch die Unterstützung derselben Java-SQL-Schnittstelle auf dem Server müssen Sie in Oracle AI Database den Code beim Deployment nicht überarbeiten. |
Siehe:
Überblick über JavaScript in Oracle AI Database
JavaScript ist heute eine der beliebtesten Programmiersprachen. Oracle AI Database, die unter Linux x86-64 oder Linux aarch64 bereitgestellt wird, fügt JavaScript zur Liste der Sprachen hinzu, die für die serverseitige Entwicklung unterstützt werden.
Sie können Module von JavaScript in der Datenbank speichern und Daten dort verarbeiten, wo sie leben, was potenziell erhebliche Verbesserungen gegenüber kundenseitigen Entwicklungsansätzen bietet. JavaScript wird von der Multilingual Engine (MLE) ausgeführt.
Entwickler haben die Wahl, ob sie eigenständigen JavaScript-Code ausführen und den JavaScript-Code nativ in der Datenbank als Module speichern.
-
Geschäftslogik als Module in der Datenbank speichern Wie bei der clientseitigen entwicklungsbezogenen JavaScript kann Code zusammen in Form eines Moduls gespeichert werden.
-
Dynamische Ausführung von JavaScript Code-Framework-Entwicklern und alle, die eigenständigen JavaScript-Code ausführen möchten, ohne Code in der Datenbank speichern zu müssen, können das
DBMS_MLE-Package und die zugehörigen Unterroutinen verwenden. -
Inline JavaScript Stored Procedures Inline-MLE-Aufrufspezifikationen betten den JavaScript-Code direkt in die DDLs
CREATE FUNCTIONundCREATE PROCEDUREein. Siehe auch: Oracle AI Database JavaScript Developer's Guide, um mehr über den JavaScript-Support in Oracle AI Database zu erfahren.
Geschäftslogik als Module in der Datenbank speichern
Wie bei der clientseitigen entwicklungsbezogenen JavaScript kann der Code zusammen in Form eines Moduls gespeichert werden.
Entwickler mit PL/SQL-Hintergrund können sich ein JavaScript-Modul als Äquivalent zu einem PL/SQL-Packagebody vorstellen, jedoch in JavaScript geschrieben. In einem Modul deklarierte Funktionen können als exportiert oder privat markiert werden.
JavaScript in Oracle AI Database entspricht dem ECMAScript 2023-Standard und bietet Entwicklern eine Vielzahl von Möglichkeiten, Geschäftslogik in der Datenbank zu speichern.
Hinweis:
Siehe auch:
-
Oracle AI Database JavaScript Developer's Guide Kapitel 2 für eine umfassende Einführung in MLE-Module.
-
Oracle AI Database JavaScript Developer's Guide Kapitel 5 für Details zu Anrufspezifikationen.
Im Folgenden finden Sie ein Beispiel für das Erstellen eines JavaScript-Moduls mit MLE:
create mle module if not exists example_module
language javascript as

export function string2obj(inputString) {
   if ( inputString === undefined ) {
      throw `must provide a string in the form of key1=value1;...;keyN=valueN`;
   }

   let myObject = {};
   if ( inputString.length === 0 ) {
      return myObject;
   }

   const kvPairs = inputString.split(";");
   kvPairs.forEach( pair => {
      const tuple = pair.split("=");
      if ( tuple.length === 1 ) {
          tuple[1] = false;
      } else if ( tuple.length != 2 ) {
          throw "parse error: you need to use exactly one '=' between key and value and not use '=' in either key or value";
      }
      myObject[tuple[0]] = tuple[1];
  });

  return myObject;
}
/
Das Modul JavaScript, auch als MLE-Modul bezeichnet, wird jetzt im Schema des Benutzers gespeichert. Die einzige Funktion, string2obj(), kann SQL und PL/SQL angezeigt werden, indem eine Aufrufspezifikation erstellt wird. Aufrufspezifikationen sind PL/SQL-Programmeinheiten, mit denen Sie JavaScript-Code überall dort aufrufen können, wo SQL und PL/SQL aufgerufen werden können. Die Aufrufspezifikation für string2obj() kann wie folgt geschrieben werden:
create function if not exists p_string_to_JSON(p_str varchar2) return JSON
as mle module example_module
   signature 'string2obj(string)';
/
Mit der erstellten Funktion kann sie aus SQL aufgerufen werden:
declare
   l_json   JSON;
   l_string VARCHAR2(100);
begin
   l_string := 'a=1;b=2;c=3;d';
   l_json := p_string_to_JSON(l_string);
   dbms_output.put_line(json_serialize(l_json PRETTY));
end;
/

{
  "a" : "1",
  "b" : "2",
  "c" : "3",
  "d" : false
}

PL/SQL procedure successfully completed.
Dynamische Ausführung des Codes JavaScript
Framework-Entwickler und alle, die Standalone-JavaScript-Code ausführen möchten, ohne Code in der Datenbank speichern zu müssen, können das DBMS_MLE-Package und die zugehörigen Unterroutinen verwenden.
Beispiel: Oracle Application Express und Database Actions integrieren DBMS_MLE und verbergen die Tatsache, dass ein PL/SQL-Package unter den Covers aufgerufen wird.
Im Vergleich zu MLE-Modulen erschwert die Verwendung von DBMS_MLE das Schreiben ganzer Anwendungen. Beispiel: Es ist schwieriger, eine Anwendung logisch in separate Entitys aufzuteilen. Die Debugging-Funktion nach der Ausführung erfordert Module, die es schwieriger machen, Probleme in Code-Snippets zu beheben. Continuous Integration-(CI-)Pipelines können auch Probleme mit dem Linting von PL/SQL- und JavaScript-Code in derselben Datei haben. Ebenso gibt es ein potenzielles Problem mit Ihrer integrierten Entwicklungsumgebung (IDE), da die meisten Probleme mit der Arbeit mit PL/SQL und JavaScript im selben Fenster haben.
Hinweis:
Siehe auch:
-
Oracle AI Database PL/SQL Packages and Types Reference für weitere Details zu
DBMS_MLEund den zugehörigen Unterroutinen. -
Oracle AI Database JavaScript Developer's Guide Kapitel 3 für weitere Details zum dynamischen JavaScript-Aufruf.
Inline JavaScript - Gespeicherte Prozeduren
Inline-MLE-Aufrufspezifikationen betten den JavaScript-Code direkt in die DDLs CREATE FUNCTION und CREATE PROCEDURE ein.
Wenn Sie eine einfache Funktionalität mit JavaScript schnell implementieren möchten, sind inlinierte MLE-Aufrufspezifikationen möglicherweise eine gute Wahl. Mit dieser Option müssen Sie kein separates Modul bereitstellen, das den JavaScript-Code enthält. Stattdessen ist die Funktion JavaScript in die Definition der Aufrufspezifikation selbst integriert.
Mit der Klausel MLE LANGUAGE wird angegeben, dass die Funktion mit JavaScript implementiert wird. Die Zeichenfolge, die dem Sprachnamen folgt, wird als Hauptteil einer JavaScript-Funktion behandelt, die die Funktionalität der Aufrufspezifikation implementiert. Wenn der Code ausgeführt wird, werden PL/SQL-Parameter automatisch in den Standardtyp JavaScript konvertiert und als Parameter desselben Namens an die Funktion JavaScript übergeben. Beachten Sie, dass Parameternamen ohne Anführungszeichen JavaScript-Namen in Großbuchstaben zugeordnet werden. Der von einer JavaScript-Funktion zurückgegebene Wert wird wie bei den Aufrufspezifikationen für MLE-Module in den Rückgabetyp der PL/SQL-Aufrufspezifikation konvertiert.
Hinweis:
Siehe auch:
- Oracle AI Database JavaScript Developer's Guide Kapitel 5 für weitere Details zu gespeicherten Inline-JavaScript-Prozeduren.
Trigger – Überblick
Ein Trigger einer Datenbank ist eine kompilierte gespeicherte Programmeinheit, die in PL/SQL, Java oder JavaScript geschrieben ist und in bestimmten Situationen automatisch von Oracle Database aufgerufen ("ausgelöst") wird.
Ein Trigger wird ausgelöst, wenn einer der folgenden Vorgänge ausgeführt wird:
-
DML-Anweisungen für eine bestimmte Tabelle oder View, die von einem beliebigen Benutzer abgesetzt wurden
DML-Anweisungen ändern Daten in Schemaobjekten. Beispiel: Das Einfügen und Löschen von Zeilen sind DML-Vorgänge.
-
DDL-Anweisungen, die von einem bestimmten Benutzer oder einem beliebigen Benutzer abgesetzt wurden
DDL-Anweisungen definieren Schemaobjekte. Beispiel: Das Erstellen einer Tabelle und das Hinzufügen einer Spalte sind DDL-Vorgänge.
-
Datenbankereignisse
Benutzeranmeldung oder -abmeldung, Fehler sowie Hoch- oder Herunterfahren der Datenbank sind Ereignisse, die Trigger aufrufen können.
Trigger sind Schemaobjekte, die Unterprogrammen ähneln, sich jedoch in ihrer Aufrufweise unterscheiden. Ein Unterprogramm wird explizit von einem Benutzer, einer Anwendung oder einem Trigger ausgeführt. Trigger werden implizit von der Datenbank aufgerufen, wenn ein auslösendes Ereignis auftritt.
-
Vorteile von Triggern Mit der richtigen Verwendung von Triggern können Sie Anwendungen erstellen und bereitstellen, die robuster sind und die Datenbank effektiver nutzen.
-
Triggertypen-Trigger können nach ihrem Aufrufmittel und dem Typ der von ihnen ausgeführten Aktionen kategorisiert werden.
-
Timing für Trigger Sie können das Trigger-Timing definieren – unabhängig davon, ob die Triggeraktion vor oder nach der auslösenden Anweisung ausgeführt werden soll.
-
Erstellung von Triggern Die Anweisung
CREATE TRIGGERerstellt oder ersetzt einen Datenbanktrigger. -
Ausführung von Triggern Oracle Database führt einen Trigger intern aus und verwendet dabei dieselben Schritte wie bei der Ausführung von Unterprogrammen.
-
Speicher von Triggern Oracle Database speichert PL/SQL-Trigger in kompilierter Form in einem Datenbankschema, genau wie bei gespeicherten PL/SQL-Prozeduren.
Siehe:
-
"Überblick über SQL-Anweisungen", um mehr über DML und DDL zu erfahren
-
"Überblick über das Hochfahren und Herunterfahren von Datenbankinstanzen"
Vorteile von Triggern
Mit der korrekten Verwendung von Triggern können Sie Anwendungen erstellen und bereitstellen, die robuster sind und die Datenbank effektiver nutzen.
Sie können Trigger für folgende Zwecke verwenden:
-
Abgeleitete Spaltenwerte automatisch generieren
-
Verhindern Sie ungültige Transaktionen
-
Bereitstellung von Auditing und Ereignisprotokollierung
-
Datensatzinformationen zum Tabellenzugriff
Sie können Trigger verwenden, um allgemeine Geschäftsregeln auf niedriger Ebene für alle Clientanwendungen durchzusetzen. Beispiel: Mehrere Anwendungen können auf die Tabelle employees zugreifen. Wenn ein Trigger für diese Tabelle das Format der eingefügten Daten sicherstellt, muss diese Geschäftslogik nicht in jedem Client reproduziert werden. Da der Trigger von der Anwendung nicht umgangen werden kann, wird die Geschäftslogik im Trigger automatisch verwendet.
Sie können sowohl Trigger als auch Integritäts-Constraints verwenden, um jede Art von Integritätsregel zu definieren und durchzusetzen. Oracle empfiehlt jedoch dringend, dass Sie nur Trigger verwenden, um komplexe Geschäftsregeln durchzusetzen, die nicht mit einem Integritäts-Constraint definiert werden können.
Eine übermäßige Verwendung von Triggern kann zu komplexen Interdependenzen führen, die in einer großen Anwendung nur schwer zu verwalten sind. Beispiel: Wenn ein Trigger aufgerufen wird, kann eine SQL-Anweisung in ihrer Triggeraktion möglicherweise andere Trigger auslösen. Dies führt zu kaskadierenden Triggern, die unbeabsichtigte Effekte erzeugen können.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung
-
Oracle AI Database PL/SQL Language Reference für Richtlinien und Einschränkungen bei der Planung von Triggern für Ihre Anwendung
automatisch in bestimmten Situationen.")
Triggertypen
Trigger können nach ihren Aufrufmitteln und der Art der von ihnen ausgeführten Aktionen kategorisiert werden.
Oracle Database unterstützt die folgenden Trigger-Typen:
-
Zeilen-Trigger
Ein Zeilentrigger wird jedes Mal ausgelöst, wenn die Tabelle von der auslösenden Anweisung betroffen ist. Beispiel: Wenn eine Anweisung mehrere Zeilen aktualisiert, wird ein Zeilentrigger einmal für jede Zeile ausgelöst, die von der
UPDATEbetroffen ist. Wenn sich eine auslösende Anweisung auf keine Datensätze auswirkt, wird kein Zeilen-Trigger ausgeführt. Row-Trigger sind nützlich, wenn der Code in der Trigger-Aktion von den Daten abhängt, die von der auslösenden Anweisung oder den betroffenen Zeilen bereitgestellt werden. -
Anweisungstrigger
Ein Anweisungstrigger wird einmal für die auslösende Anweisung ausgelöst, unabhängig von der Anzahl der Zeilen, die von der auslösenden Anweisung betroffen sind. Beispiel: Wenn eine Anweisung 100 Zeilen aus einer Tabelle löscht, wird ein Trigger auf Anweisungsebene
DELETEnur einmal ausgelöst. Anweisungs-Trigger sind nützlich, wenn der Code in der Trigger-Aktion nicht von den Daten abhängt, die von der auslösenden Anweisung oder den betroffenen Zeilen bereitgestellt werden. -
Trigger
INSTEAD OFEin INSTEAD OF-Trigger wird von Oracle Database ausgelöst, anstatt die auslösende Anweisung auszuführen. Diese Trigger sind nützlich, um Views transparent zu ändern, die nicht direkt über DML-Anweisungen geändert werden können.
-
Ereignistrigger
Mit Triggern können Sie Informationen zu Datenbankereignissen an Subscriber veröffentlichen. Ereignis-Trigger sind in folgende Kategorien unterteilt:
-
Ein Systemereignistrigger kann durch Ereignisse wie Hoch- und Herunterfahren der Datenbankinstanz oder Fehlermeldungen verursacht werden.
-
Ein Benutzerereignistrigger wird aufgrund von Ereignissen ausgelöst, die sich auf die Benutzeranmeldung und -abmeldung, DDL-Anweisungen und DML-Anweisungen beziehen.
-
Siehe:
automatisch in bestimmten Situationen.")
Timing für Trigger
Sie können das Trigger-Timing definieren, unabhängig davon, ob die Triggeraktion vor oder nach der auslösenden Anweisung ausgeführt werden soll.
Ein einfacher Trigger ist ein einzelner Trigger für eine Tabelle, mit dem Sie Aktionen für genau einen der folgenden Zeitpunkte angeben können:
-
Vor der Feuererklärung
-
Vor jeder Zeile, die von der Auslöseanweisung betroffen ist
-
Nach jeder Zeile, die von der Auslöseanweisung betroffen ist
-
Nach dem Auslösen
Für Anweisungs- und Zeilentrigger kann ein BEFORE-Trigger die Sicherheit erhöhen und Geschäftsregeln aktivieren, bevor Änderungen an der Datenbank vorgenommen werden. Der Trigger AFTER eignet sich ideal für Loggingaktionen.
Ein Compound-Trigger kann zu verschiedenen Zeitpunkten ausgelöst wird. Zusammengesetzte Trigger helfen bei der Programmierung eines Ansatzes, bei dem die Aktionen, die Sie für verschiedene Zeitpunkte implementieren, gemeinsame Daten verwenden.
Siehe auch: Oracle AI Database PL/SQL Language Reference, um mehr über zusammengesetzte Trigger zu erfahren
automatisch in bestimmten Situationen.")
Trigger erstellen
Die Anweisung CREATE TRIGGER erstellt oder ersetzt einen Datenbanktrigger.
Ein PL/SQL-Trigger hat die folgende allgemeine syntaktische Form:
CREATE TRIGGER trigger_name
  triggering_statement
  [trigger_restriction]
BEGIN
 triggered_action;
END;
Ein PL/SQL-Trigger enthält die folgenden grundlegenden Komponenten:
-
Trigger-Name
Der Name muss unter anderen Triggernamen im selben Schema eindeutig sein. Beispiel: Der Name kann
part_reorder_triggerlauten. -
Triggerereignis oder -anweisung
Ein auslösendes Ereignis oder eine auslösende Anweisung ist die SQL-Anweisung, das Datenbankereignis oder das Benutzerereignis, durch das ein Trigger aufgerufen wird. Beispiel: Ein Benutzer aktualisiert eine Tabelle.
-
Triggereinschränkung
Eine Triggereinschränkung gibt einen booleschen Ausdruck an, der
truesein muss, damit ein Trigger ausgelöst wird. Beispiel: Der Trigger wird nur aufgerufen, wenn die Anzahl der verfügbaren Teile unter einem aktuellen Neuanforderungsbetrag liegt. -
Ausgelöste Aktion
Eine ausgelöste Aktion ist die Prozedur, die SQL-Anweisungen und Code enthält, die ausgeführt werden sollen, wenn eine auslösende Anweisung abgesetzt wird und die Triggereinschränkung als wahr ausgewertet wird. Beispiel: Ein Benutzer fügt eine Zeile in eine Tabelle mit ausstehenden Anforderungen ein.
-
Beispiel: CREATE TRIGGER-Anweisung In diesem Beispiel wird ein TRIGGER erstellt, der ausgelöst wird, wenn eine
INSERT-,UPDATE- oderDELETE-Anweisung in einer Positionstabelle ausgeführt wird. -
Beispiel: Trigger auf Zeilenebene aufrufen In diesem Szenario initiiert ein Kunde zwei Aufträge und fügt Positionen zu den Aufträgen hinzu und entfernt sie.
Siehe:
-
Oracle AI Database – Erste Schritte mit der Oracle AI Database-Entwicklung und Oracle AI Database PL/SQL Language Reference, um zu erfahren, wie Trigger erstellt werden
-
Oracle AI Database SQL Language Reference, um mehr über die
CREATE TRIGGER-Anweisung zu erfahren
automatisch in bestimmten Situationen.")
Beispiel: Anweisung CREATE TRIGGER
In diesem Beispiel wird ein Trigger erstellt, der ausgelöst wird, wenn eine INSERT-, UPDATE- oder DELETE-Anweisung in einer Positionstabelle ausgeführt wird.
Angenommen, Sie erstellen die Tabellen orders und lineitems mit den folgenden Anweisungen. Die Tabelle orders enthält eine Zeile für jede eindeutige Reihenfolge, während die Tabelle lineitems eine Zeile für jedes Element in einer Reihenfolge enthält.
CREATE TABLE orders
( order_id NUMBER PRIMARY KEY,
  /* other attributes */
  line_items_count NUMBER DEFAULT 0 );

CREATE TABLE lineitems
( order_id REFERENCES orders,
  seq_no   NUMBER,
  /* other attributes */
  CONSTRAINT lineitems PRIMARY KEY(order_id,seq_no) );
Mit der folgenden Anweisung wird ein Beispieltrigger erstellt, der die Tabelle orders automatisch mit der Anzahl der Artikel in einer Reihenfolge aktualisiert:
CREATE OR REPLACE TRIGGER lineitems_trigger
  AFTER INSERT OR UPDATE OR DELETE ON lineitems
  FOR EACH ROW
BEGIN
  IF (INSERTING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)+1
    WHERE order_id = :new.order_id;
  END IF;
  IF (DELETING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)-1
    WHERE order_id = :old.order_id;
  END IF;
END;
/
In lineitems_trigger ist die auslösende Anweisung in der Tabelle lineitems ein INSERT, UPDATE oder DELETE. Keine auslösende Einschränkung vorhanden. Der Trigger wird für jede geänderte Zeile aufgerufen. Der Trigger hat Zugriff auf die alten und neuen Spaltenwerte der aktuellen Zeile, die von der auslösenden Anweisung betroffen ist. Für jede Spalte der zu ändernden Tabelle sind zwei Korrelationsnamen vorhanden: der alte Wert (:old) und der neue Wert (:new). Wenn eine Session Zeilen in lineitems für eine Bestellung aktualisiert oder einfügt, berechnet der Trigger nach der Aktion die Anzahl der Elemente in dieser Reihenfolge und aktualisiert die Tabelle orders mit der Anzahl.
Beispiel: Trigger auf Zeilenebene aufrufen
In diesem Szenario initiiert ein Kunde zwei Aufträge und fügt Positionen zu den Aufträgen hinzu bzw. entfernt diese.
Das Szenario basiert auf dem TRIGGER, der in Beispiel: CREATE TRIGGER-Anweisung erstellt wurde.
Tabelle 3: Trigger-Szenario auf Zeilenebene
| SQL-Anweisung | Ausgelöste SQL-Anweisung | Beschreibung |
|---|---|---|
SQL> INSERT INTO orders (order_id) VALUES (78); 1 row created. |
Der Kunde erstellt einen Auftrag mit der ID 78. Zu diesem Zeitpunkt hat der Kunde keine Artikel in der Bestellung. Da keine Aktion für die Tabelle |
|
SQL> INSERT INTO orders (order_id) VALUES (92); 1 row created. |
Der Kunde erstellt einen separaten Auftrag mit der ID 92. Zu diesem Zeitpunkt hat der Kunde keine Artikel in der Bestellung. Da keine Aktion für die Tabelle |
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,1); 1 row created. |
UPDATE orders SET line_items_count = NVL(NULL,0)+1 WHERE order_id = 78; |
Der Kunde fügt einen Artikel zur Bestellung 78 hinzu.
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,2); 1 row created. |
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 78; |
Der Kunde fügt der Bestellung 78 einen zusätzlichen Artikel hinzu.
|
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 2 92 0 |
Der Kunde fragt den Status der beiden Aufträge ab. Bestellung 78 enthält zwei Artikel. Bestellung 92 enthält keine Artikel. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 78 1 78 2 |
Der Kunde fragt den Status der Positionen ab. Jeder Artikel wird durch die Auftrags-ID und die Folgenummer eindeutig identifiziert. | |
SQL> UPDATE lineitems SET order_id = 92; 2 rows updated. |
UPDATE orders
  SET line_items_count =
  NVL(NULL,0)+1
 WHERE order_id = 92;

  UPDATE orders
  SET line_items_count =
  NVL(2,0)-1
 WHERE order_id = 78;
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 78; |
Der Kunde verschiebt die Positionen aus Auftrag 78 in Auftrag 92. Die Jedes Mal, wenn der Trigger aufgerufen wird, werden beide |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 2 |
Der Kunde fragt den Status der beiden Aufträge ab. Der Nettoeffekt ist, dass die Anzahl der Positionen für Auftrag 92 von 0 auf 2 gestiegen ist, während die Anzahl für Auftrag 78 von 2 auf 0 gesunken ist. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 92 1 92 2 |
Der Kunde fragt den Status der Positionen ab. Jeder Artikel wird durch die Auftrags-ID und die Folgenummer eindeutig identifiziert. | |
SQL> DELETE FROM lineitems; 2 rows deleted. |
UPDATE orders SET line_items_count = NVL(2,0)-1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 92; |
Der Kunde entfernt jetzt alle Positionen aus allen Aufträgen. Die |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 0 SQL> SELECT * FROM lineitems; no rows selected |
Der Kunde fragt den Status der beiden Aufträge ab. Keiner der Aufträge enthält Positionen. Der Kunde fragt auch den Status der Positionen ab. Keine Artikel vorhanden. |
Ausführung von Triggern
Oracle Database führt einen Trigger intern aus und verwendet dabei dieselben Schritte wie bei der Ausführung von Unterprogrammen.
Der einzige subtile Unterschied besteht darin, dass ein Benutzerkonto das Recht hat, einen Trigger auszulösen, wenn es über die Berechtigung zum Ausführen der auslösenden Anweisung verfügt. Mit dieser Ausnahme validiert und führt die Datenbank Trigger auf dieselbe Weise aus wie gespeicherte Unterprogramme.
Siehe auch: Oracle AI Database PL/SQL Language Reference, um mehr über die Triggerausführung zu erfahren
automatisch in bestimmten Situationen.")
Speicherung von Triggern
Oracle Database speichert PL/SQL-Trigger in kompilierter Form in einem Datenbankschema, genau wie PL/SQL-Stored Procedures.
Wenn eine CREATE TRIGGER-Anweisung festgeschrieben wird, wird der kompilierte PL/SQL-Code in der Datenbank gespeichert. Der Shared Pool entfernt den Quellcode des PL/SQL-Triggers.
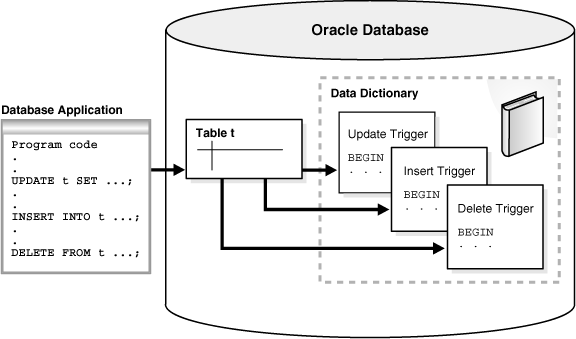
Die folgende Abbildung zeigt eine Datenbankanwendung mit SQL-Anweisungen, die implizit PL/SQL-Trigger aufrufen. Die Trigger werden getrennt von den verknüpften Tabellen gespeichert.
Abbildung 7: Trigger
Beschreibung der Abbildung cncpt076.gif
Java-Trigger werden auf dieselbe Weise gespeichert wie PL/SQL-Trigger. Ein Java-Trigger referenziert jedoch Java-Code, der separat mit einer CALL-Anweisung kompiliert wurde. Daher besteht die Erstellung eines Java-Triggers darin, Java-Code zu erstellen und den Trigger zu erstellen, der diesen Java-Code referenziert.
Siehe auch: Oracle AI Database PL/SQL Language Reference enthält Informationen zum Kompilieren und Speichern von Triggern
automatisch in bestimmten Situationen.")