Introducción a Oracle AI Database
En este capítulo, se ofrece una información general de Oracle AI Database.
Este capítulo contiene los siguientes temas:
-
Acerca de los Sistemas de Información Cada organización tiene información que debe almacenar y gestionar para cumplir sus requisitos. Por ejemplo, una corporación debe recopilar y mantener registros de recursos humanos para sus empleados. Esta información debe estar disponible para aquellos que la necesitan.
-
Objetos de Esquema Una característica de un RDBMS es la independencia del almacenamiento de datos físico de las estructuras de datos lógicas.
-
Acceso a datos Un requisito general para un DBMS es cumplir con los estándares aceptados del sector para un lenguaje de acceso a datos.
-
Gestión de transacciones Oracle AI Database está diseñado como una base de datos multiusuario. La base de datos debe asegurarse de que varios usuarios puedan trabajar simultáneamente sin dañar los datos de los demás.
-
Arquitectura de Oracle AI Database Un servidor de base de datos es la clave para la gestión de la información.
Acerca de los sistemas de información
Cada organización tiene información que debe almacenar y gestionar para cumplir con sus requisitos. Por ejemplo, una corporación debe recopilar y mantener registros de recursos humanos para sus empleados. Esta información debe estar disponible para aquellos que la necesitan.
Un sistema de información es un sistema formal para almacenar y procesar información. Una base de datos es una recopilación organizada de información tratada como una unidad. El objetivo de una base del datos es recopilar, almacenar y recuperar información relacionada para su uso por parte de aplicaciones de base del mismo.
Cuando los sistemas de base de datos se inventaron por primera vez, se diseñaron para una carga de trabajo específica. A lo largo de los años se ha hecho evidente que las bases de datos de un solo propósito ya no satisfacen todos los requisitos: además de las cargas de trabajo relacionales, los desarrolladores necesitaban almacenar datos en otros formatos como XML, espacial, gráfico, JSON y, más recientemente, datos vectoriales para la era de la IA.
Oracle AI Database se ha desarrollado desde un motor de base de datos relacional hasta un motor convergente, lo que permite a los desarrolladores almacenar casi cualquier tipo de datos en el formato que su aplicación requiere de forma nativa y totalmente integrada en su arquitectura empresarial.
-
Sistema de gestión de bases de datos (DBMS) Un sistema de gestión de bases de datos (DBMS) es un software que controla el almacenamiento, la organización y la recuperación de datos.
-
Modelo relacional En su artículo seminal de 1970 "Un modelo relacional de datos para grandes bancos de datos compartidos", E. F. Codd definió un modelo relacional basado en la teoría matemática de conjuntos. Hoy en día, el modelo de base de datos más aceptado es el modelo relacional.
-
Sistema de gestión de bases de datos relacionales (RDBMS) El modelo relacional es la base de un sistema de gestión de bases de datos relacionales (RDBMS). Un RDBMS mueve los datos a una base de datos, almacena los datos y los recupera para que las aplicaciones puedan manipularlos.
Sistema de gestión de bases de datos (DBMS)
Un sistema de gestión de bases de datos (DBMS) es un software que controla el almacenamiento, la organización y la recuperación de datos.
Normalmente, un DBMS tiene los siguientes elementos:
-
Código de núcleo
Este código gestiona el almacenamiento y la memoria para DBMS.
-
Repositorio de metadatos
Este repositorio se suele denominar diccionario de datos o catálogo de metadatos.
-
Idiomas de consulta
Los lenguajes de consulta facilitan el acceso a datos. Las bases de datos convergentes, como Oracle AI Database, admiten varios lenguajes de consulta.
Una aplicación de base de datos es un programa que interactúa con una base de datos para acceder a los datos y manipularlos. Oracle AI Database fue uno de los primeros motores de base de datos en soportar el modelo relacional. Desde su creación, se ha convertido en un motor de base de datos convergente, que admite casi cualquier tipo de datos y muchas cargas de trabajo diversas.
Modelo Relacional
En su artículo seminal de 1970 "Un Modelo Relacional de Datos para Grandes Bancos de Datos Compartidos", E. F. Codd definió un modelo relacional basado en la teoría matemática de conjuntos. Hoy en día, el modelo de base de datos más aceptado es el modelo relacional.
Una base de datos relacional es una base de datos que se ajusta al modelo relacional. El modelo relacional tiene los siguientes aspectos principales:
-
Estructuras
Los objetos bien definidos almacenan o acceden a los datos de una base de datos.
-
Operaciones
Las acciones claramente definidas permiten a las aplicaciones manipular los datos y las estructuras de una base de datos.
-
Reglas de integridad
Las reglas de integridad rigen las operaciones en los datos y estructuras de una base de datos.
Una base de datos relacional almacena datos en un juego de relaciones simples. Una relación es un juego de tuplas. Una tupla es un juego desordenado de valores de atributo.
Una tabla es una representación bidimensional de una relación en forma de filas (tuples) y columnas (atributos). Cada fila de una tabla tiene el mismo juego de columnas. Una base de datos relacional es una base de datos que almacena datos en relaciones (tablas). Por ejemplo, una base de datos relacional podría almacenar información sobre los empleados de la compañía en una tabla de empleados, una tabla de departamentos y una tabla de salarios.
Temas relacionados
Sistema de gestión de bases de datos relacionales (RDBMS)
El modelo relacional es la base de un sistema de gestión de bases de datos relacionales (RDBMS). Un RDBMS mueve los datos a una base de datos, almacena los datos y los recupera para que las aplicaciones puedan manipularlos.
Un RDBMS distingue entre los siguientes tipos de operaciones:
-
Operaciones lógicas
En este caso, una aplicación especifica el qué contenido es necesario. Por ejemplo, una aplicación solicita un nombre de empleado o agrega un registro de empleado a una tabla.
-
Operaciones físicas
En este caso, el RDBMS determina cómo se deben hacer las cosas y lleva a cabo la operación. Por ejemplo, después de que una aplicación consulta una tabla, la base de datos puede utilizar un índice para buscar las filas solicitadas, leer los datos en la memoria y realizar muchos otros pasos antes de devolver un resultado al usuario. El RDBMS almacena y recupera datos para que las operaciones físicas sean transparentes para las aplicaciones de base de datos.
Oracle AI Database es un RDBMS en su núcleo. Un RDBMS que implementa funciones orientadas a objetos, como los tipos definidos por el usuario, la herencia y el polimorfismo, se denomina sistema de gestión de bases de datos relacionales de objetos (ORDBMS). Oracle AI Database amplía el modelo relacional a un modelo relacional de objetos, lo que permite almacenar modelos de negocio complejos en una base de datos relacional. Con el tiempo, el motor de datos principal de Oracle ha evolucionado hasta convertirse en un modelo mucho más potente que ahora se conoce como base de datos convergente.
Arquitectura de base de datos convergente
Oracle AI Database es una base de datos convergente que admite varios modelos de datos y cargas de trabajo en un único motor de base de datos. Además de los datos relacionales, puede gestionar documentos JSON, datos de gráficos, datos espaciales, texto, vectores y otros tipos de datos especializados.
Estas capacidades comparten servicios de base de datos comunes, incluidos transacciones, seguridad, copia de seguridad y recuperación, alta disponibilidad, auditoría y optimización de consultas. Por lo tanto, las aplicaciones pueden utilizar diferentes modelos de datos sin necesidad de una base de datos independiente para cada uno.
Por ejemplo, una aplicación puede almacenar datos de clientes y transacciones en tablas relacionales, atributos flexibles en documentos JSON, información geográfica como datos espaciales e incrustaciones vectoriales para la búsqueda semántica. SQL se puede utilizar para consultar y combinar estas formas de datos en una sola operación. Hay disponible una API de estilo de documento para los desarrolladores que prefieren este estilo NoSQL.
Una base de datos convergente proporciona las siguientes ventajas:
- Reducción del movimiento de datos entre sistemas especializados
- Seguridad y gobernanza coherentes
- Transacciones integradas en datos relacionados
- Arquitectura operativa y de aplicaciones simplificadas
- Análisis unificado de varios tipos de datos
- Auditoría unificada de operaciones de base de datos
Convergence no requiere que todas las cargas de trabajo utilicen todas las capacidades o residan en una base de datos física. Las aplicaciones solo pueden utilizar las funciones que necesitan. La arquitectura flexible de Oracle permite a los desarrolladores distribuir aplicaciones en varias bases de datos conectables.
Oracle Database sigue siendo relacional en su núcleo. Su arquitectura convergente amplía esa base para que las aplicaciones puedan trabajar con múltiples modelos de datos al tiempo que utilizan un conjunto común de servicios de base de datos que atienden a casi todas las cargas de trabajo.
Objetos de Esquema
Una característica de un RDBMS es la independencia del almacenamiento de datos físicos de las estructuras de datos lógicas.
En Oracle AI Database, un esquema de base de datos es una recopilación de estructuras de datos lógicas u objetos de esquema. Un usuario de base de datos es propietario de un esquema de base de datos, que tiene el mismo nombre que el nombre de usuario.
Los objetos de esquema son estructuras creadas por el usuario que hacen referencia directamente a los datos de la base de datos. La base de datos soporta muchos tipos de objetos de esquema, el más importante de los cuales son tablas e índices. Los usuarios que prefieren una API de tipo documento para acceder a sus datos pueden crear recopilaciones (JSON) o vistas de dualidad relacional de JSON.
Un objeto de esquema es un tipo de objeto de base de datos. Algunos objetos de base de datos, como perfiles y roles, no residen en esquemas.
-
Tablas Una tabla describe una entidad, como los empleados.
-
Índices Un índice es una estructura de datos opcional que puede crear en una o más columnas de una tabla. Los índices pueden aumentar el rendimiento de la recuperación de datos.
Temas relacionados
Tablas
Una tabla describe una entidad, como los empleados.
Puede definir una tabla con un nombre de tabla, como employees, y un juego de columnas. En general, a cada columna se le asigna un nombre, un tipo de dato y un ancho al crear la tabla.
Una tabla es un juego de filas. Una columna identifica un atributo de la entidad que describe la tabla, mientras que una fila identifica una instancia de la entidad. Por ejemplo, los atributos de la entidad employees corresponden a columnas para el ID de empleado y el apellido. Una fila identifica a un empleado específico.
Opcionalmente, puede especificar una regla, denominada restricción de integridad, para una columna. Un ejemplo es una restricción de integridad NOT NULL. Esta restricción fuerza a la columna a contener un valor en cada fila. Las restricciones que abarcan varias tablas se pueden definir como afirmaciones SQL. Antes de Oracle AI Database 26ai, podía utilizar disparadores de base de datos para aplicar la lógica de negocio como parte de una transacción.
Temas relacionados
Índices
Un índice es una estructura de datos opcional que puede crear en una o más columnas de una tabla. Los índices pueden aumentar el rendimiento de la recuperación de datos.
Al procesar una solicitud, la base de datos puede utilizar los índices disponibles para localizar las filas solicitadas de forma eficaz. Los índices son útiles cuando las aplicaciones consultan a menudo una fila o un rango de filas específicos.
Los índices son lógica y físicamente independientes de los datos. Por lo tanto, puede borrar y crear índices sin que esto afecte a las tablas u otros índices. Todas las aplicaciones siguen funcionando después de borrar un índice.
Temas relacionados
Acceso a datos
Un requisito general para un DBMS es cumplir con los estándares aceptados del sector para un lenguaje de acceso a datos. Nota: JavaScript requiere que Oracle 26ai se ejecute en Linux x86-64 o Linux aarch64.
-
SQL de lenguaje de consulta estructurado (SQL) es un lenguaje declarativo basado en juegos que proporciona una interfaz a un RDBMS como Oracle AI Database.
-
PL/SQL es una extensión de procedimiento de Oracle SQL. Java y JavaScript son opciones adicionales que puede utilizar para almacenar la lógica de negocio en la base de datos.
Lenguaje de consulta estructurado (SQL)
SQL es un lenguaje declarativo basado en juegos que proporciona una interfaz para un RDBMS como Oracle AI Database.
Los lenguajes de procedimiento, como C, describen cómo se deben hacer las cosas. SQL no es de procedimiento y describe qué se debe hacer.
SQL es el lenguaje estándar ANSI para bases de datos relacionales. Todas las operaciones en los datos de una base de datos Oracle se realizan mediante sentencias SQL. Por ejemplo, se utiliza SQL para crear tablas y consultar y modificar datos en tablas.
Una sentencia SQL se puede considerar como un programa o instrucción de computadora muy simple, pero potente. Los usuarios especifican el resultado que desean (por ejemplo, los nombres de los empleados), no cómo derivarlo. Una sentencia SQL es una cadena de texto SQL como la siguiente:
SELECT first_name, last_name FROM employees;Las sentencias SQL le permiten realizar las siguientes tareas:
-
Consultar datos
-
Insertar, actualizar y suprimir filas de una tabla
-
Crear, sustituir, modificar y borrar objetos
-
Controle el acceso a la base de datos y sus objetos
-
Garantizar la coherencia e integridad de la base de datos
SQL unifica las tareas anteriores en un lenguaje consistente. Oracle SQL es una implantación del estándar ANSI. Oracle SQL soporta numerosas funciones que van más allá del SQL estándar.
Temas relacionados
PL/SQL, Java y JavaScript
PL/SQL es una extensión de procedimiento de Oracle SQL. Java y JavaScript son opciones adicionales que puede utilizar para almacenar la lógica de negocio en la base de datos.
PL/SQL está integrado con Oracle AI Database, lo que le permite utilizar todas las sentencias, funciones y tipos de datos de Oracle AI Database SQL. Puede utilizar PL/SQL para controlar el flujo de un programa SQL, utilizar variables y escribir procedimientos de manejo de errores.
Una ventaja principal de PL/SQL es la capacidad de almacenar la lógica de aplicación en la propia base de datos. Un procedimiento PL/SQL o función es un objeto de esquema que consta de un juego de sentencias SQL y otras construcciones PL/SQL, agrupadas, almacenadas en la base de datos y que se ejecutan como unidad para solucionar un problema concreto o realizar un juego de tareas relacionadas. La principal ventaja de la programación del lado del servidor es que la funcionalidad incorporada se puede desplegar en cualquier lugar.
Oracle AI Database también puede almacenar unidades de programa escritas en Java y JavaScript. Un procedimiento almacenado en Java es un método Java publicado en SQL y almacenado en la base de datos para uso general. Puede llamar a los programas PL/SQL existentes desde Java y JavaScript, y a los programas Java y JavaScript desde PL/SQL.
Multilingual Engine (MLE) ofrece la posibilidad de escribir la lógica de negocio en JavaScript y almacenar el código en la base de datos como módulos MLE. Las funciones exportadas por los módulos MLE se pueden exponer a SQL y PL/SQL mediante las especificaciones de llamada. Estas especificaciones de llamada son unidades PL/SQL (funciones, procedimientos y paquetes) y se pueden llamar en cualquier lugar donde se llame a PL/SQL.
Temas relacionados
API NoSQL para el acceso a documentos
Simple Oracle Document Access (SODA) es un conjunto de API de estilo NoSQL para gestionar recopilaciones de documentos, en particular documentos JSON, en Oracle AI Database. Las aplicaciones pueden crear recopilaciones e insertar, recuperar, actualizar, suprimir y consultar documentos sin necesidad de conocer SQL o el esquema de base de datos subyacente.
SODA proporciona un modelo de programación centrado en documentos basado en recopilaciones, documentos y filtros de consulta por ejemplo. Esto es lo contrario a SQL, que proporciona una interfaz declarativa orientada a juegos para consultar y modificar datos relacionales y puede expresar uniones, agregaciones y operaciones en varios tipos de datos.
SODA es útil cuando una aplicación funciona principalmente con documentos JSON y requiere una API de documento simple, y puede ser una alternativa para los desarrolladores que desean utilizar una API NoSQL.
Los desarrolladores que transfieren cargas de trabajo de documentos a la base de datos Oracle AI desde un almacén de datos de un solo uso de terceros tienen la opción de utilizar la API de base de datos Mongo para Oracle AI Database, que es similar a SODA, pero tiene como objetivo facilitar las migraciones. En el caso más sencillo, cambiar la cadena de conexión de la aplicación del almacén de datos de un solo propósito a Oracle AI Database es todo lo que se debe hacer.
Gestión de Transacciones
Oracle AI Database se ha diseñado como una base de datos multiusuario. La base de datos debe asegurarse de que varios usuarios puedan trabajar simultáneamente sin dañar los datos de los demás.
-
Transacciones Una transacción es una unidad de trabajo lógica y atómica que contiene una o más sentencias SQL.
-
Concurrencia de datos Un requisito de un RDBMS de varios usuarios es el control de la concurrencia de datos, que es el acceso simultáneo de los mismos datos por parte de varios usuarios.
-
Coherencia de datos En Oracle AI Database, cada usuario debe ver una vista coherente de los datos, incluidos los cambios visibles realizados por las propias transacciones de un usuario y las transacciones confirmadas de otros usuarios.
Transacciones
Una transacción es una unidad de trabajo lógica y atómica que contiene una o más sentencias SQL.
Un RDBMS debe poder agrupar sentencias SQL para que estén confirmadas, lo que significa que se aplican a la base de datos o se realiza un rollback de todas ellas, lo que significa que se deshacen.
Una ilustración de la necesidad de transacciones es una transferencia de fondos de una cuenta de ahorros a una cuenta corriente. La transferencia consiste en las siguientes operaciones separadas:
-
Disminuir la cuenta de ahorros.
-
Aumente la cuenta corriente.
-
Registro de la transacción en el asiento de la transacción.
Oracle AI Database garantiza que las tres operaciones se realicen correctamente o fallen como unidad. Por ejemplo, si un fallo de hardware impide que se ejecute una sentencia en la transacción, se debe realizar un rollback de las demás sentencias.
Las transacciones son una función que distingue Oracle AI Database de un sistema de archivos. Si realiza una operación atómica que actualiza varios archivos y si el sistema falla a mitad de camino, los archivos no serán consistentes. Por el contrario, una transacción mueve una base de datos Oracle de un estado consistente a otro. El principio básico de una transacción es "todo o nada": una operación atómica tiene éxito o falla en su conjunto.
Temas relacionados
Simultaneidad de Datos
Un requisito de un RDBMS de varios usuarios es el control de la concurrencia de datos, que es el acceso simultáneo de los mismos datos por parte de varios usuarios.
Sin controles de simultaneidad, los usuarios podrían cambiar los datos de forma incorrecta, lo que comprometería la integridad de los datos. Por ejemplo, un usuario puede actualizar una fila mientras que otro usuario la actualiza simultáneamente.
Si varios usuarios acceden a los mismos datos, una forma de gestionar la simultaneidad es hacer que los usuarios esperen. Sin embargo, el objetivo de un DBMS es reducir el tiempo de espera para que sea inexistente o insignificante. Todas las sentencias SQL que modifican datos deben proceder con la menor interferencia posible. Las interacciones destructivas, que son interacciones que actualizan datos incorrectamente o alteran estructuras de datos subyacentes, deben evitarse.
Oracle AI Database utiliza bloqueos para controlar el acceso simultáneo a los datos. Un bloqueo es un mecanismo que evita la interacción destructiva entre transacciones que acceden a un recurso compartido. Los bloqueos ayudan a garantizar la integridad de los datos, al tiempo que permiten un acceso simultáneo máximo a los datos.
Temas relacionados
Coherencia de datos
En Oracle AI Database, cada usuario debe ver una vista consistente de los datos, incluidos los cambios visibles realizados por las propias transacciones de un usuario y las transacciones confirmadas de otros usuarios.
Por ejemplo, la base de datos debe evitar el problema de lectura sucia, que se produce cuando una transacción ve cambios sin confirmar realizados por otra transacción simultánea.
Oracle AI Database siempre aplica la consistencia de lectura a nivel de sentencia, lo que garantiza que los datos que devuelve una sola consulta se confirmen y sean coherentes para un único punto en el tiempo. Según el nivel de aislamiento de la transacción, este punto es el momento en que se abrió la sentencia o el momento en que se inició la transacción. La función de consulta de Oracle Flashback permite especificar explícitamente este punto en el tiempo.
La base de datos también puede proporcionar consistencia de lectura a todas las consultas de una transacción, conocida como consistencia de lectura a nivel de transacción. En este caso, cada sentencia de una transacción ve datos del mismo punto en el tiempo, que es el momento en que se inició la transacción.
Temas relacionados
Arquitectura de Oracle AI Database
Un servidor de base de datos es la clave para la gestión de la información.
En general, un servidor gestiona de forma fiable una gran cantidad de datos en un entorno de varios usuarios para que los usuarios puedan acceder simultáneamente a los mismos datos. Un servidor de base de datos también evita el acceso no autorizado y proporciona soluciones eficientes para la recuperación de fallos.
-
Base de datos e instancia Un servidor de base de datos Oracle consta de una base de datos y al menos una instancia de base de datos, comúnmente conocida como simplemente una instancia.
-
Estructuras de almacenamiento de base de datos Una base de datos se puede considerar desde una perspectiva física y lógica.
-
Estructuras de instancia de base de datos Una base de datos Oracle utiliza estructuras y procesos de memoria para gestionar y acceder a la CDB. Todas las estructuras de memoria existen en la memoria principal de los equipos que constituyen el RDBMS.
-
Arquitectura de aplicaciones y redes Para aprovechar al máximo un sistema informático o una red determinados, Oracle AI Database permite dividir el procesamiento entre el servidor de base de datos y los programas cliente. El equipo que ejecuta RDBMS maneja las responsabilidades del servidor de base de datos mientras que los equipos que ejecutan las aplicaciones manejan la interpretación y visualización de datos.
Base de Datos e Instancia
Un servidor de base de datos Oracle consta de una base de datos y al menos una instancia de base de datos, comúnmente conocida como simplemente una instancia.
Debido a que una instancia y una base de datos están tan estrechamente conectadas, el término base de datos Oracle a veces se refiere tanto a la instancia como a la base de datos. En sentido estricto, los términos tienen los siguientes significados:
-
Base de datos
Una base de datos es un juego de archivos, ubicado en el disco, que almacenan datos de usuario. Estos archivos de datos pueden existir independientemente de una instancia de base de datos. A partir de Oracle Database 21c, "base de datos" se refiere específicamente a los archivos de datos de una base de datos de contenedor (CDB) multiinquilino, una base de datos conectable (PDB) o un contenedor de aplicación.
-
Instancia de la Base de Datos
Una instancia es un juego con nombre de estructuras de memoria que gestionan archivos de base de datos. Una instancia de base de datos consta de un área de memoria compartida, denominada área global del sistema (SGA), y un juego de procesos en segundo plano. Una instancia puede existir independientemente de los archivos de base de datos.
-
Arquitectura multiinquilino La arquitectura multiinquilino permite que una instancia de Oracle AI Database sea una CDB.
-
Arquitectura de base de datos distribuida globalmente Oracle Globally Distributed Database (anteriormente denominada Oracle Sharding) es una técnica de escala de base de datos basada en la partición horizontal de datos en varias PDB. Las aplicaciones perciben el pool de PDB como una única base de datos lógica. Cada partición se denomina shard.
Arquitectura multiinquilino
La arquitectura multiinquilino permite que Oracle AI Database sea una CDB.
Cada base de datos de Oracle AI Database debe contener o poder contener otra base de datos. Por ejemplo, una CDB contiene PDB y un contenedor de aplicación contiene PDB de aplicación. Una CDB o un contenedor de aplicaciones contienen una PDB, y una CDB contiene un contenedor de aplicaciones.
A partir de Oracle Database 21c, la única arquitectura soportada es una base de datos de contenedor multi-inquilino. En versiones anteriores, Oracle admitía bases de datos sin contenedor (no CDB).
-
Bases de datos de contenedor Una CDB contiene una o más PDB creadas con el usuario y contenedores de aplicaciones.
-
Bases de Datos de Conexión Una PDB es una recopilación portátil de esquemas, objetos de esquema y objetos no de esquema que aparece en una aplicación como una base de datos independiente.
-
Contenedores de aplicación Un contenedor de aplicación es un contenedor opcional creado por el usuario dentro de una CDB que almacena datos y metadatos para una o más aplicaciones.
Bases de datos de contenedor
Una CDB contiene una o más PDB creadas con el usuario y contenedores de aplicaciones.
En el nivel físico, una CDB es un juego de archivos: archivo de control, archivos redo log en línea y archivos de datos. La instancia de base de datos gestiona los archivos que componen la CDB.
En la siguiente figura se muestra una CDB y una instancia de base de datos asociada.
Figura 1: Instancia de base de datos y CDB
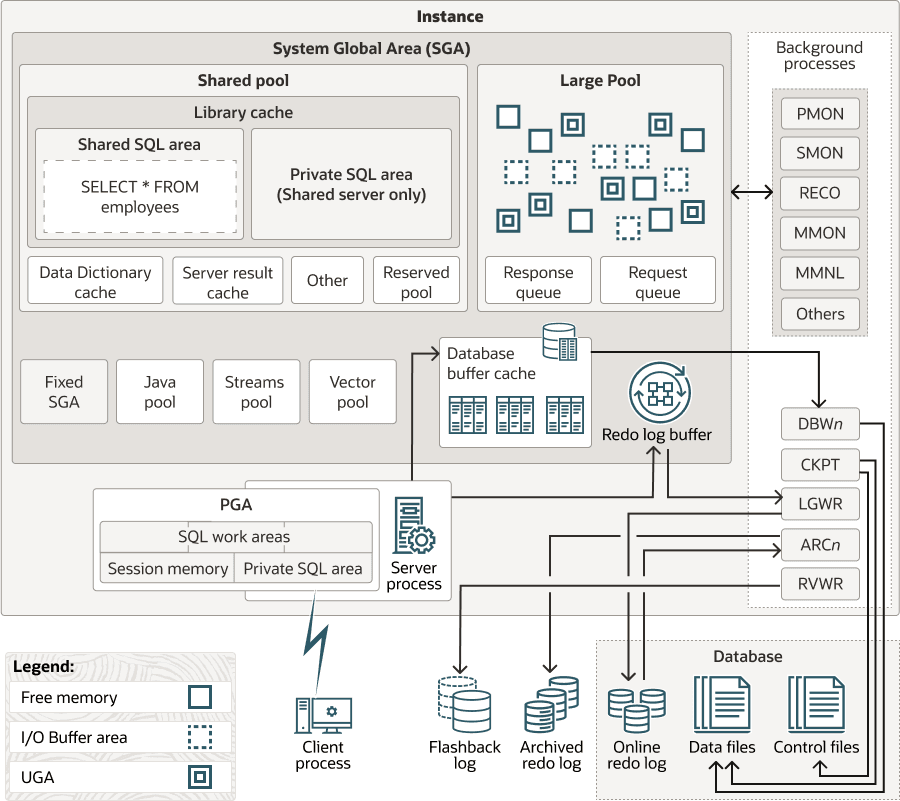
Descripción de la ilustración cncpt233.png
Bases de datos conectables
Una PDB es una recopilación portátil de esquemas, objetos de esquema y objetos no de esquema que aparece en una aplicación como una base de datos independiente.
En el nivel físico, cada PDB tiene su propio juego de archivos de datos que almacenan los datos para la PDB. La CDB incluye todos los archivos de datos de las PDB que contiene, así como un juego de archivos de datos del sistema que almacenan metadatos para la propia CDB.
Para mover o archivar una PDB, puede desconectarla. Una PDB desconectada consta de archivos de datos de PDB y un archivo de metadatos. Una PDB desconectada no se puede utilizar hasta que se conecte a una CDB.
En la siguiente figura, se muestra una CDB denominada MYCDB.
Figura 2: PDB en una CDB
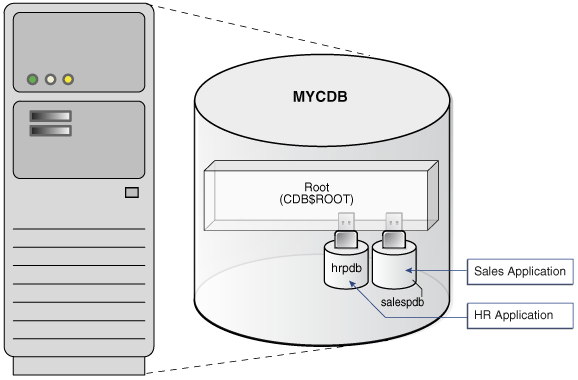
Descripción de la ilustración cncpt352.png
Físicamente, MYCDB es una instancia de Oracle AI Database, en el sentido de un juego de archivos de datos asociados a una instancia. MYCDB tiene una instancia de base de datos, aunque se pueden utilizar varias instancias en Oracle Real Application Clusters y un juego de archivos de base de datos.
MYCDB contiene dos PDB: hrpdb y salespdb. Como se muestra en la Figura 1-2, estas PDB aparecen en sus respectivas aplicaciones como bases de datos independientes. Una aplicación no sabe si se está conectando a una CDB o PDB.
Para administrar la propia CDB o cualquier PDB dentro de ella, puede conectarse a la raíz de CDB. La raíz es una recopilación de esquemas, objetos de esquema y objetos no de esquema a los que pertenecen todas las PDB y los contenedores de aplicación.
Contenedores de aplicaciones
Un contenedor de aplicación es un contenedor opcional creado por el usuario dentro de una CDB que almacena datos y metadatos para una o más aplicaciones.
En este contexto, una aplicación (también denominada definición de aplicación maestra) es un juego con nombre y versiones de datos y metadatos comunes almacenados en la raíz de aplicación. Por ejemplo, la aplicación puede incluir definiciones de tablas, vistas, cuentas de usuario y paquetes PL/SQL que son comunes a un juego de PDB.
De alguna manera, un contenedor de aplicaciones funciona como una CDB específica de la aplicación dentro de una CDB. Un contenedor de aplicación, como la propia CDB, puede incluir varias PDB de aplicación y permite que estas PDB compartan metadatos y datos. En el nivel físico, un contenedor de aplicación tiene su propio juego de archivos de datos, al igual que una PDB.
Por ejemplo, un despliegue SaaS puede utilizar varias PDB de aplicación, cada una para un cliente independiente, que comparte metadatos y datos de la aplicación. Por ejemplo, en la siguiente figura, sales_app es el modelo de aplicación de la raíz de aplicación. La PDB de aplicación denominada cust1_pdb solo contiene datos de ventas para el cliente 1, mientras que la PDB de aplicación denominada cust2_pdb solo contiene datos de ventas para el cliente 2. El plugin, la desconexión, la clonación y otras operaciones de nivel de PDB están disponibles para PDB de clientes individuales.
Figura 3: Caso de uso de SaaS
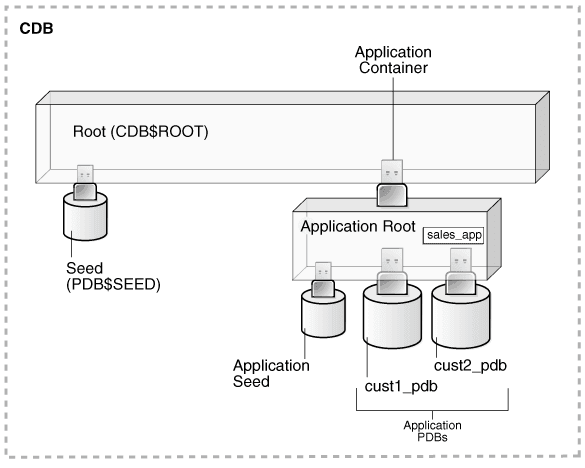
Descripción de la ilustración cncpt389.png
Arquitectura de Base de Datos Distribuida Globalmente
Oracle Globally Distributed Database (anteriormente denominada Oracle Sharding) es una técnica de escala de base de datos basada en la partición horizontal de datos en varias PDB. Las aplicaciones perciben el pool de PDB como una única base de datos lógica. Cada partición se denomina shard.
Las principales ventajas de la fragmentación para las aplicaciones incluyen la escalabilidad lineal, la contención de fallos y la distribución de datos geográficos. Globally Distributed Database es adecuada para el despliegue en Oracle Cloud. A diferencia de los almacenes de datos NoSQL que implantan la fragmentación, la base de datos distribuida globalmente proporciona las ventajas de la fragmentación sin sacrificar las capacidades de un RDBMS empresarial.
En una arquitectura de fragmentación, cada CDB se aloja en un servidor dedicado con sus propios recursos locales: CPU, memoria, flash o disco. Puede designar una PDB como fragmento. Las particiones horizontales de PDB de diferentes CDB forman una única base de datos lógica, a la que se hace referencia como una base de datos con particiones horizontales. Dos particiones horizontales en la misma CDB no pueden ser miembros de la misma base de datos con particiones horizontales. Sin embargo, dentro de la misma CDB, una PDB podría estar en una base de datos con particiones horizontales y otra PDB podría estar en una base de datos con particiones horizontales independiente.
La partición horizontal implica dividir una tabla de base de datos entre particiones horizontales para que cada partición contenga la tabla con las mismas columnas pero un subjuego diferente de filas. Una división de tabla de esta forma también se conoce como tabla con particiones horizontales. En la siguiente figura se muestra una tabla con particiones horizontales particionadas horizontalmente en tres particiones horizontales, cada una de las cuales es una PDB en una CDB independiente.
Figura 4: Partición horizontal de una tabla entre particiones horizontales
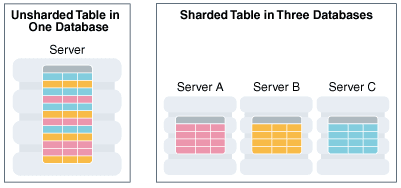
Descripción de la ilustración admin_3v_134a.png
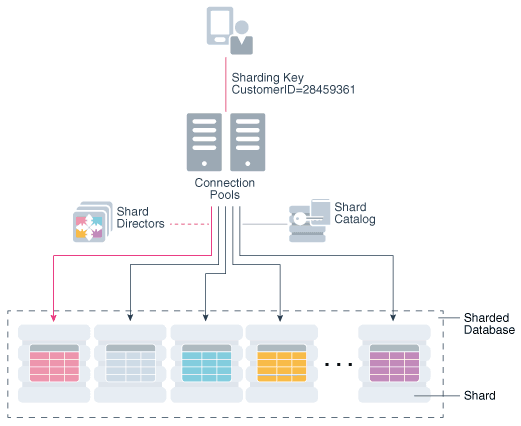
Un caso de uso consiste en distribuir datos de cuentas de clientes entre varias CDB. Por ejemplo, un cliente con el ID 28459361 puede buscar sus registros. En la siguiente figura, se muestra una posible arquitectura. La solicitud del cliente se enruta a través de un pool de conexiones, donde los directores de fragmentación ( listeners de red) dirigen la solicitud a la partición horizontal de PDB adecuada, que contiene todas las filas del cliente.
Figura 5: Arquitectura de Oracle Globally Distributed Database
Descripción de la ilustración admin_3v_143d.png
Temas relacionados
Estructuras de Almacenamiento de Bases de Datos
Una base de datos se puede considerar tanto desde una perspectiva física como lógica.
Los datos físicos son datos visibles en el nivel del sistema operativo. Por ejemplo, las utilidades del sistema operativo, como ls y ps de Linux, pueden mostrar los archivos y procesos de la base de datos. Los datos lógicos, como una tabla, solo son significativos para la base de datos. Una sentencia SQL puede mostrar las tablas de una base de datos Oracle, pero una utilidad del sistema operativo no puede.
La base de datos tiene estructuras físicas y lógicas. Debido a que las estructuras físicas y lógicas son independientes, puede gestionar el almacenamiento físico de datos sin afectar el acceso a las estructuras de almacenamiento lógicas. Por ejemplo, el cambio de nombre de un archivo de base de datos física no cambia el nombre de las tablas cuyos datos se almacenan en este archivo.
-
Estructuras de almacenamiento físico Las estructuras de la base de datos física son los archivos que almacenan los datos.
-
Las estructuras de almacenamiento lógicas de Logical Storage Structures permiten a Oracle AI Database tener un control detallado del uso del espacio en disco.
Estructuras de almacenamiento físico
Las estructuras de la base de datos física son los archivos que almacenan los datos.
Al ejecutar un comando CREATE DATABASE, crea una CDB. Se crean los siguientes archivos:
-
Archivos de Datos
Cada CDB tiene uno o más archivos de datos físicos, que contienen todos los datos de la base de datos. Los datos de las estructuras de bases de datos lógicas, como tablas e índices, se almacenan físicamente en los archivos de datos.
-
Archivos de Control
Cada CDB tiene un archivo de control. Un archivo de control contiene metadatos que especifican la estructura física de la base de datos, incluido el nombre de la base de datos y los nombres y ubicaciones de los archivos de base de datos.
-
Archivos redo log en línea
Cada CDB tiene un redo log en línea, que es un juego de dos o más archivos redo log en línea. Un redo log en línea está formado por entradas de redo (también denominadas registros de redo log), que registran todos los cambios realizados en los datos.
Al ejecutar un comando CREATE PLUGGABLE DATABASE en una CDB, se crea una PDB. La PDB contiene un juego dedicado de archivos de datos dentro de la CDB. Una PDB no tiene un archivo de control independiente y dedicado ni un redo log en línea: estas PDB comparten estos archivos.
Muchos otros archivos son importantes para el funcionamiento de una CDB. Estos incluyen archivos de parámetros y archivos de red. Los archivos de copia de seguridad y los archivos redo log archivados son archivos fuera de línea importantes para la copia de seguridad y la recuperación.
Temas relacionados
Consulte también: "Estructuras de almacenamiento físico"
Estructuras de almacenamiento lógico
Las estructuras de almacenamiento lógico permiten a Oracle AI Database tener un control detallado del uso del espacio en disco.
En este tema se tratan las estructuras de almacenamiento lógicas:
-
Bloques de Datos
En el mejor nivel de granularidad, los datos de Oracle AI Database se almacenan en bloques de datos. Un bloque de datos se corresponde con un número concreto de bytes de disco.
-
Extensiones
Una extensión es un número específico de bloques que se obtienen en una única asignación, que se utilizan para almacenar un tipo específico de información.
-
Segmentos
Un segmento es un juego de extensiones asignadas para un objeto de usuario (por ejemplo, una tabla o un índice), datos de deshacer o datos temporales.
-
Tablespaces
Una base de datos está dividida en unidades de almacenamiento lógicas denominadas tablespaces. Un tablespace es el contenedor lógico para segmentos. Cada tablespace consta de al menos un archivo de datos.
Temas relacionados
Estructuras de instancia de base de datos
Una base de datos Oracle utiliza estructuras y procesos de memoria para gestionar y acceder a la CDB. Todas las estructuras de memoria existen en la memoria principal de los equipos que constituyen el RDBMS.
Cuando las aplicaciones se conectan a una CDB o PDB, se conectan a una instancia de base de datos. La instancia presta servicios a las aplicaciones mediante la asignación de otras áreas de memoria además de SGA, y el inicio de otros procesos además de los procesos en segundo plano.
-
Procesos de Oracle AI Database Un proceso es un mecanismo de un sistema operativo que puede ejecutar una serie de pasos. Algunos sistemas operativos utilizan los términos job, task o thread.
-
Estructuras de memoria de instancia Oracle AI Database crea y utiliza estructuras de memoria para el código de programa, los datos compartidos entre usuarios y las áreas de datos privadas para cada usuario conectado.
Procesos de Oracle AI Database
Un proceso es un mecanismo de un sistema operativo que puede ejecutar una serie de pasos. Algunos sistemas operativos utilizan los términos job, task o thread.
Para los fines de este tema, un thread es equivalente a un proceso. Una instancia de base de datos Oracle tiene los siguientes tipos de procesos:
-
Procesos de cliente
Estos procesos se crean y mantienen para ejecutar el código de software de un programa de aplicación o una herramienta de Oracle. La mayoría de los entornos tienen computadoras separadas para los procesos del cliente.
-
Procesos en segundo plano
Estos procesos consolidan funciones que de otra manera tendrían que gestionarse a través del uso de varios programas de la Oracle AI Database, los cuales habrían que ejecutar para cada proceso de cliente. Los procesos en segundo plano realizan la E/S de forma asíncrona y supervisan otros procesos de Oracle AI Database para proporcionar un mayor paralelismo y mejorar el rendimiento y la fiabilidad.
-
Procesos del Servidor
Estos procesos se comunican con los procesos del cliente e interactúan con Oracle AI Database para satisfacer las solicitudes.
Los procesos de Oracle incluyen procesos de servidor y procesos en segundo plano. En la mayoría de los entornos, los procesos de Oracle y los procesos de cliente se ejecutan en computadoras independientes.
Temas relacionados
Estructuras de memoria de instancia
Oracle AI Database crea y utiliza estructuras de memoria para el código de programa, los datos compartidos entre los usuarios y las áreas de datos privados para cada usuario conectado.
Las siguientes estructuras de memoria están asociadas a una instancia de base de datos:
-
Área Global de Sistema (SGA)
El SGA es un grupo de estructuras de memoria compartida que contienen datos e información de control de una instancia del base de datos. Algunos ejemplos de componentes de SGA son la caché de buffers de la base de datos y las áreas SQL compartidas. El SGA puede contener un almacén de columnas en memoria opcional (almacén de columnas de IM), que permite que los datos se rellenen en memoria en un formato de columna.
-
Áreas Globales de Programa (PGA)
PGA es una región de memoria que contiene datos y controla la información para un proceso de servidor o en segundo plano. El acceso a la PGA es exclusivo del proceso. Cada proceso de servidor y proceso en segundo plano tiene su propio PGA.
Temas relacionados
Arquitectura de aplicaciones y redes
Para aprovechar al máximo un sistema informático o una red determinados, Oracle AI Database permite dividir el procesamiento entre el servidor de base de datos y los programas cliente. El equipo que ejecuta RDBMS maneja las responsabilidades del servidor de base de datos mientras que los equipos que ejecutan las aplicaciones manejan la interpretación y visualización de datos.
-
Arquitectura de aplicación: la arquitectura de aplicación es el entorno informático en el que una aplicación de base de datos se conecta a una base de datos Oracle. Las dos arquitecturas de base de datos más comunes son cliente/servidor y de varios niveles.
-
Arquitectura de Oracle Net Services
Oracle Net Services es la interfaz entre la base de datos y los protocolos de comunicación de red que facilitan el procesamiento distribuido y las bases de datos distribuidas.
Arquitectura de la aplicación
La arquitectura de la aplicación es el entorno informático en el que una aplicación de base de datos se conecta a una base de datos Oracle. Las dos arquitecturas de base de datos más comunes son cliente/servidor y de varios niveles.
Arquitectura cliente-servidor
En una arquitectura de cliente/servidor, la aplicación cliente inicia una solicitud para realizar una operación en el servidor de base de datos. El servidor ejecuta el software de Oracle AI Database y gestiona las funciones necesarias para el acceso simultáneo a datos compartidos. El servidor recibe y procesa las solicitudes que se originan desde los clientes.
Arquitectura de Varios Niveles
En una arquitectura de varios niveles, uno o más servidores de aplicaciones realizan partes de la operación. Un servidor de aplicaciones contiene una gran parte de la lógica de la aplicación, proporciona acceso a los datos para el cliente y realiza algún procesamiento de consulta. De esta forma, la carga en la base de datos disminuye. El servidor de aplicaciones puede servir como una interfaz entre clientes y varias bases de datos y proporcionar un nivel adicional de seguridad.
Una arquitectura orientada a servicios (SOA) es una arquitectura de varios niveles en la que la funcionalidad de la aplicación se encapsula en servicios. Los servicios SOA se suelen implantar como servicios web. Se puede acceder a los servicios web a través de HTTP y se basan en estándares basados en XML, como Web Services Description Language (WSDL) y SOAP. Oracle AI Database puede actuar como proveedor de servicios web en un entorno SOA o de varios niveles tradicional.
Una arquitectura de microservicios divide una aplicación en servicios pequeños, desarrollados e implementados de forma independiente. Cada servicio posee su lógica de negocio y, idealmente, sus datos, lo que reduce el acoplamiento y permite a los equipos escalar, actualizar y operar servicios de forma independiente.
La arquitectura multiinquilino de Oracle se asigna naturalmente al patrón de base de datos por servicio. Cada microservicio puede utilizar su propia base de datos de conexión (PDB), que proporciona un límite administrativo, de seguridad y de datos independiente, mientras que varias PDB comparten los recursos de una base de datos de contenedor (CDB) común.
Este enfoque combina el aislamiento del servicio con una consolidación eficiente. Las PDB se pueden aprovisionar, clonar, aplicar parches, realizar copias de seguridad, reubicar y ampliar de forma independiente, mientras que los administradores conservan el control centralizado de la infraestructura de base de datos subyacente.
Temas relacionados
Arquitectura de Oracle Net Services
Oracle Net Services es la interfaz entre la base de datos y los protocolos de comunicación de red que facilitan el procesamiento distribuido y las bases de datos distribuidas.
Los protocolos de comunicación definen la forma en que los datos se transmiten y reciben en una red. Oracle Net Services soporta comunicaciones en todos los protocolos de red principales, incluidos TCP/IP, HTTP, FTP y WebDAV. La Red de Oracle, un componente de Oracle Net Services, establece y mantiene una sesión de red desde una aplicación cliente a un servidor de base de datos. Después de establecer una sesión en red, la Red de Oracle actúa como el mensajero de datos de la aplicación cliente y el servidor de la base de datos, intercambiando mensajes entre ellos. La red de Oracle puede realizar estas tareas porque está en todas las computadoras de la red.
Un componente importante de Net Services es el Oracle Net Listener (denominado listener), que es un proceso que se ejecuta en la base de datos o en cualquier otro lugar de la red. Las aplicaciones cliente envían solicitudes de conexión al listener, que gestiona el tráfico de estas solicitudes a la base de datos. Cuando se establece una conexión, el cliente y la base de datos se comunican directamente.
Oracle REST Data Services
Oracle REST Data Services (ORDS) proporciona un gateway HTTPS a Oracle AI Database. Permite a las aplicaciones exponer tablas, vistas, procedimientos almacenados escritos en PL/SQL, JavaScript y Java, y operaciones de base de datos personalizadas como API de REST seguras, a menudo sin necesidad de un servidor de aplicaciones independiente o un amplio código de middleware.
ORDS también soporta Oracle Database API for MongoDB, lo que permite a las aplicaciones utilizar controladores, herramientas y comandos MongoDB compatibles para acceder a recopilaciones de documentos JSON almacenadas en Oracle Database. El protocolo de transferencia MongoDB se traduce a operaciones de base de datos mediante ORDS, lo que permite que las aplicaciones REST, MongoDB y SQL funcionen con datos gestionados por la misma base de datos convergente.
Temas relacionados