Estructuras de almacenamiento físico
Las estructuras de la base de datos física de una base de datos Oracle se pueden ver en el nivel del sistema operativo.
-
Introducción a las Estructuras de Almacenamiento Físico Una característica de un RDBMS es la independencia de las estructuras de datos lógicas, como tablas, vistas e índices, de las estructuras de almacenamiento físicas, como archivos.
-
Visión general de archivos de datos En el nivel del sistema operativo, Oracle AI Database almacena datos en estructuras denominadas archivos de datos. Cada base de datos Oracle, ya sea una CDB o PDB, debe tener al menos un archivo de datos.
-
Visión general de archivos de control El archivo de control de la base de datos es un pequeño archivo binario asociado a una sola CDB.
-
Visión General del Redo Log en Línea La estructura más importante para la recuperación es el redo log en línea, que consta de dos o más archivos preasignados que almacenan los cambios en la base de datos a medida que se producen. El redo log en línea registra los cambios en los archivos de datos.
Introducción a las estructuras de almacenamiento físico
Una característica de un RDBMS es la independencia de las estructuras de datos lógicas, como tablas, vistas e índices, de las estructuras de almacenamiento físicas, como archivos.
Debido a que las estructuras físicas y lógicas están separadas, puede gestionar el almacenamiento físico de datos sin afectar el acceso a las estructuras lógicas. Por ejemplo, el cambio de nombre de un archivo de base de datos no cambia el nombre de las tablas almacenadas en él.
Una base de datos Oracle es un juego de archivos que almacenan datos de Oracle en un almacenamiento persistente. A partir de Oracle Database 21c, la única arquitectura soportada es una base de datos de contenedor (CDB) multi-inquilino. Una CDB contiene una o más PDB.
En esta sección se describen los archivos de base de datos generados al emitir una sentencia CREATE DATABASE para crear una CDB:
-
Archivos de datos y archivos temporales
Un archivo de datos es un archivo físico en el almacenamiento persistente creado por Oracle AI Database y que contiene estructuras de datos como tablas e índices. Un archivo temporal es un archivo de datos que pertenece a un tablespace temporal. La base de datos escribe datos en estos archivos en un formato propietario de Oracle que no pueden leer otros programas.
Al crear una PDB en una PDB, la PDB tiene su propio juego de archivos de datos dentro del juego general de archivos de datos que forma la CDB. Por ejemplo, puede crear una CDB denominada
mycdby, a continuación, crear dos PDB en ella:hrpdbysalespdb. En este caso,mycdbtendría su propio juego de archivos de datos y archivos temporales, al igual quehrpdbysalespdb. -
Archivos de Control
Un archivo de control es un archivo raíz que realiza un seguimiento de los componentes físicos de la CDB. Las PDB no tienen sus propios archivos de control independientes.
-
Archivos redo log en línea
El redo log en línea es un juego de archivos que contiene registros de los cambios realizados en los datos de la CDB. Las PDB no tienen sus propios archivos redo log en línea independientes.
Una instancia de base de datos es un juego de estructuras de memoria que gestionan archivos de base de datos en una CDB. En el siguiente gráfico se muestra la relación entre la instancia y los archivos que gestiona.
Figura 1: Instancia de base de datos y archivos de base de datos
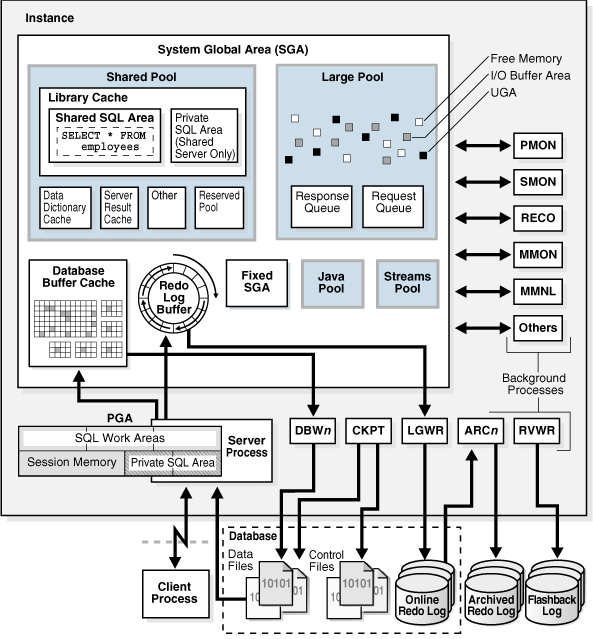
Descripción de la ilustración cncpt223.gif
-
Mecanismos para almacenar archivos de base de datos Hay varios mecanismos disponibles para asignar y gestionar el almacenamiento de estos archivos.
-
Oracle Managed Files y User-Managed Files Oracle Managed Files es una estrategia de nomenclatura de archivos que permite especificar operaciones en términos de objetos de base de datos en lugar de nombres de archivo. Por ejemplo, puede crear un tablespace sin especificar los nombres de sus archivos de datos.
-
Oracle Automatic Storage Management (Oracle ASM) Oracle ASM es una solución de almacenamiento de alto rendimiento y fácil gestión para archivos de Oracle AI Database. Oracle ASM es un gestor de volúmenes y proporciona un sistema de archivos diseñado exclusivamente para que la base de datos lo utilice.
-
Oracle Persistent Memory Filestore (PMEM Filestore) PMEM es una memoria persistente con direcciones de bytes. El almacén de archivos de memoria persistente (PMEM Filestore) de Oracle puede almacenar archivos de datos, archivos redo log en línea y archivos de control.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a crear una base de datos
-
Referencia de lenguaje SQL de Oracle AI Database para la semántica y la sintaxis
CREATE DATABASE
Mecanismos para almacenar archivos de base de datos
Hay varios mecanismos disponibles para asignar y gestionar el almacenamiento de estos archivos.
Los mecanismos incluyen:
-
Sistema de archivos del sistema operativo
La mayoría de las bases de datos Oracle almacenan archivos en un sistema de archivos, que es una estructura para almacenar y recuperar datos.
Un sistema de archivos permite que el espacio de almacenamiento se utilice para los datos de la aplicación de forma estándar y coherente. Cada archivo tiene un nombre y aparece como un espacio de direcciones contiguo para aplicaciones como Oracle AI Database. La base de datos puede crear, leer, escribir, cambiar el tamaño y suprimir archivos.
Un sistema de archivos se suele construir sobre un volumen lógico creado por un paquete de software denominado administrador de volúmenes lógicos (LVM). El LVM permite que partes de varios discos físicos se combinen en lo que aparece como un único espacio de dirección contiguo.
-
Sistema de archivos de clusters
Un sistema de archivos de cluster es un sistema de archivos distribuido que es un cluster de servidores que colaboran para proporcionar consistencia y alto rendimiento a sus clientes. En un entorno de Oracle RAC, un sistema de archivos de cluster hace que el almacenamiento compartido aparezca como un sistema de archivos compartido por muchas computadoras en un entorno de cluster. Con un sistema de archivos de cluster, el fallo de un equipo en el cluster no hace que el sistema de archivos no esté disponible. Sin embargo, en un sistema de archivos del sistema operativo, si un equipo que comparte archivos a través de NFS u otros medios falla, el sistema de archivos no está disponible.
-
Almacén de Archivos de Memoria Persistente de Oracle (Archivo de PMEM)
El almacén de archivos PMEM está diseñado para almacenar archivos de base de datos en memoria persistente (PMEM), que es una memoria persistente con direcciones de bytes. Cree un almacén de archivos con el comando
CREATE PMEM FILESTORE. En el nivel del sistema operativo Linux, el almacén de archivos almacena datos en un sistema de archivos ext4 grande montado en modofsdax. PMEM Filestore aparece en Oracle AI Database como un sistema de archivos nativo en Linux.Nota: A diferencia de un sistema de archivos compatible con POSIX, el almacén de archivos PMEM no puede ser compartido por varias bases de datos Oracle.
-
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM incluye un sistema de archivos diseñado exclusivamente para su uso por Oracle AI Database.
Una base de datos puede utilizar una combinación de los mecanismos de almacenamiento anteriores. Por ejemplo, una base de datos podría almacenar el archivo de parámetros del servidor en un sistema de archivos tradicional, almacenar archivos de base de datos en el almacén de archivos PMEM y, a continuación, archivar los archivos redo log en un sistema de archivos de cluster.
Consulte además:
-
Oracle AI Database Administrator's Guide (Guía del administrador de Oracle AI Database) para ver estructuras de almacenamiento de base de datos mediante la consulta de vistas de base de datos
Oracle Managed Files y archivos gestionados por el usuario
Oracle Managed Files es una estrategia de nomenclatura de archivos que permite especificar operaciones en términos de objetos de base de datos en lugar de nombres de archivos. Por ejemplo, puede crear un tablespace sin especificar los nombres de sus archivos de datos.
Oracle Managed Files elimina la necesidad de que los administradores gestionen directamente los archivos del sistema operativo en una base de datos. Oracle ASM necesita Oracle Managed Files.
Nota: Esta función no afecta a la creación ni a la nomenclatura de archivos administrativos, como archivos de rastreo, archivos de auditoría y logs de alertas.
Con los archivos gestionados por el usuario, se gestionan directamente los archivos del sistema operativo en la base de datos. Puede tomar las decisiones relacionadas con la estructura de archivos y la nomenclatura. Por ejemplo, al crear un tablespace, se definen el nombre y la ruta de acceso de los archivos de datos del tablespace.
Mediante los parámetros de inicialización, se especifica el directorio del sistema de archivos para un tipo específico de archivo. La función Oracle Managed Files garantiza que la base de datos crea un archivo único y lo suprime cuando ya no es necesario. La base de datos utiliza internamente interfaces de sistema de archivos estándar para crear y suprimir archivos para archivos de datos y archivos temporales, archivos de control y archivos relacionados con la recuperación almacenados en el área de recuperación rápida.
Los archivos gestionados de Oracle no eliminan la funcionalidad existente. Puede crear nuevos archivos mientras administra manualmente los archivos antiguos. Por lo tanto, una base de datos puede tener una mezcla de archivos gestionados por Oracle y archivos gestionados por el usuario.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a utilizar los archivos gestionados de Oracle
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM es una solución de almacenamiento de alto rendimiento y fácil gestión para archivos de Oracle AI Database. Oracle ASM es un gestor de volúmenes y proporciona un sistema de archivos diseñado exclusivamente para que la base de datos lo utilice.
Oracle ASM ofrece varias ventajas con respecto a los sistemas de archivos y los gestores de almacenamiento convencionales, como las siguientes:
-
Simplifica las tareas relacionadas con el almacenamiento, como la creación y distribución de bases de datos y la gestión del espacio en disco
-
Distribuye los datos entre los discos físicos para eliminar los puntos conflictivos y proporcionar un rendimiento uniforme entre los discos.
-
Vuelve a equilibrar los datos automáticamente después de los cambios de configuración de almacenamiento
Para utilizar Oracle ASM, se asignan discos particionados para Oracle AI Database con preferencias de segmentación y duplicación. Oracle ASM gestiona el espacio en disco y distribuye la carga de E/S entre todos los recursos disponibles para optimizar el rendimiento, al tiempo que elimina la necesidad de ajustar manualmente la E/S. Por ejemplo, puede aumentar el tamaño del disco para la base de datos o mover partes de la base de datos a nuevos dispositivos sin tener que cerrar la base de datos.
-
Oracle ASM Storage Components Oracle AI Database puede almacenar un archivo de datos como un archivo de Oracle ASM en un grupo de discos de Oracle ASM. En un grupo de discos, Oracle ASM expone una interfaz de sistema de archivos para los archivos de base de datos.
-
Instancias de Oracle ASM Una instancia de Oracle ASM es una instancia especial de Oracle que gestiona discos de Oracle ASM.
Componentes de Almacenamiento de Oracle ASM
Oracle AI Database puede almacenar un archivo de datos como archivo de Oracle ASM en un grupo de discos de Oracle ASM. En un grupo de discos, Oracle ASM expone una interfaz de sistema de archivos para los archivos de base de datos.
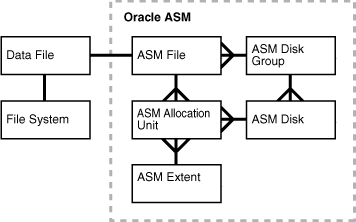
En la siguiente figura se muestran las relaciones entre los componentes de almacenamiento de una base de datos que utiliza Oracle ASM. El diagrama muestra la relación entre un archivo de Oracle ASM y un archivo de datos, aunque Oracle ASM puede almacenar otros tipos de archivos. La notación de pata de gallo representa una relación de uno a varios.
Figura 2: Componentes de Oracle ASM
Descripción de la ilustración cncpt267.gif
La Figura 14-2 ilustra los siguientes conceptos de Oracle ASM:
-
Discos de Oracle ASM
Un disco de Oracle ASM es un dispositivo de almacenamiento aprovisionado para un grupo de discos de Oracle ASM. Un disco de Oracle ASM puede ser un disco físico o una partición, un número de unidad lógica (LUN) de una matriz de almacenamiento, un volumen lógico o un archivo asociado a la red.
Los discos de Oracle ASM se pueden agregar o borrar de un grupo del disco mientras se está ejecutando la base de datos. Cuando se agrega un disco a un grupo de discos, se asigna un nombre de disco o se le asigna un nombre de disco de Oracle ASM automáticamente.
-
Grupos de discos de Oracle ASM
Un grupo de discos de Oracle ASM es una recopilación de discos de Oracle ASM gestionados como una unidad lógica. Las estructuras de datos de un grupo del disco son autocontenidas y consumen parte de espacio en disco en un grupo.
En un grupo de discos, Oracle ASM expone una interfaz de sistema de archivos para los archivos de la base de datos Oracle. El contenido de los archivos que se almacenan en un grupo de discos se distribuye de manera uniforme, o se segmenta, para eliminar puntos conflictivos y proporcionar un rendimiento uniforme en todos los discos.
-
Archivos de Oracle ASM
Un archivo de Oracle ASM es un archivo almacenado en un grupo de discos de Oracle ASM. Oracle AI Database se comunica con Oracle ASM en términos de archivos. La base de datos puede almacenar archivos de datos, archivos de control, archivos redo log en línea y otros tipos de archivos como archivos de Oracle ASM. Cuando la base de datos lo solicita, Oracle ASM crea un archivo de Oracle ASM y le asigna un nombre que empieza por un signo más (
+) seguido de un nombre de grupo de discos, como en+DISK1.Nota: Los archivos de Oracle ASM pueden coexistir con otras opciones de gestión de almacenamiento, como sistemas de archivos de terceros. Esta capacidad simplifica la integración de Oracle ASM en entornos preexistentes.
-
Extensiones de Oracle ASM
Una extensión de Oracle ASM es una sección de un archivo de Oracle ASM. Un archivo de Oracle ASM consta de una o varias extensiones de archivo. Cada extensión de Oracle ASM consta de una o más unidades de asignación en un disco específico.
Nota: Una extensión de Oracle ASM es diferente de la extensión utilizada para almacenar datos en un segmento.
-
Unidades de asignación de Oracle ASM
Una unidad de asignación de Oracle ASM es la unidad fundamental de asignación dentro de un grupo. Una unidad de asignación es el espacio de disco contiguo más bajo que asigna Oracle ASM. Una o más unidades de asignación forman una extensión de Oracle ASM.
Consulte también: Guía del administrador de Oracle Automatic Storage Management para obtener más información sobre Oracle ASM
Instancias de Oracle ASM
Una instancia de Oracle ASM es una instancia especial de Oracle que gestiona discos de Oracle ASM.
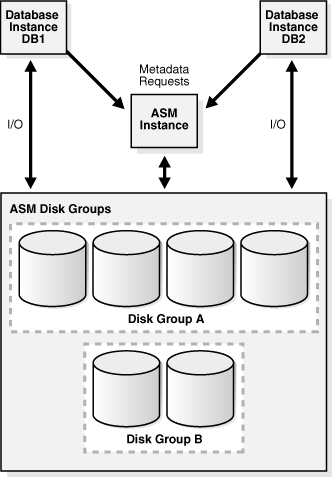
Tanto Oracle ASM como las instancias de base de datos necesitan acceso compartido a los discos de un grupo de discos de Oracle ASM. Las instancias de Oracle ASM gestionan los metadatos del grupo de discos y proporcionan información de diseño de archivos a las instancias de base de datos. Las instancias de base de datos dirigen la E/S a los discos de Oracle ASM sin pasar por una instancia de Oracle ASM.
Una instancia de Oracle ASM se crea con la misma tecnología que una instancia de base de datos. Por ejemplo, una instancia de Oracle ASM tiene un área global del sistema (SGA) y procesos en segundo plano similares a los de una instancia de base de datos. Sin embargo, una instancia de Oracle ASM no puede montar una base de datos y realiza menos tareas que una instancia de base de datos. La Figura 14-3 muestra una configuración de nodo único con una instancia de Oracle ASM y dos instancias de base de datos, cada una asociada a una base de datos de instancia única diferente. La instancia de Oracle ASM gestiona los metadatos y proporciona asignación de espacio para los archivos de Oracle ASM que almacenan los datos para las dos bases de datos. Un grupo de discos de Oracle ASM tiene cuatro discos de Oracle ASM y el otro dos discos. Ambas instancias de base de datos pueden acceder a los grupos de discos.
Figura 3: Instancias de Instancia y Base de Datos de Oracle ASM
Descripción de la ilustración cncpt266.gif
Consulte también: Guía del administrador de Oracle Automatic Storage Management para obtener más información sobre Oracle ASM
Almacén de Archivos de Memoria Persistente de Oracle (Archivo de PMEM)
PMEM es una memoria persistente direccionable por bytes. El almacén de archivos de memoria persistente (PMEM Filestore) de Oracle puede almacenar archivos de datos, archivos redo log en línea y archivos de control.
Las consultas pueden leer bytes directamente desde PMEM sin migrar primero los bloques a la caché de buffers de la base de datos. Este mecanismo de alto rendimiento evita la redundancia de datos y la E/S innecesaria. Nota: Un almacén de archivos PMEM no puede almacenar archivos de rastreo, archivos de auditoría o archivos de parámetros del servidor. Los tipos de archivo soportados para PMEM son similares a los tipos de Oracle ASM.
-
Caché de Buffer Asignada Directamente En la pirámide de almacenamiento tradicional, PMEM se encuentra entre la DRAM, que no es persistente, y Flash, que es persistente (no volátil).
-
La interfaz del sistema de archivos para PMEM Filestore PMEM Filestore implementa un protocolo denominado Sistema de archivos en espacio de usuario (FUSE).
-
Interfaz de usuario para el almacén de archivos PMEM Para crear un almacén de archivos PMEM, utilice el comando
CREATE PMEM FILESTORE.
Caché de Buffers Asignada Directamente
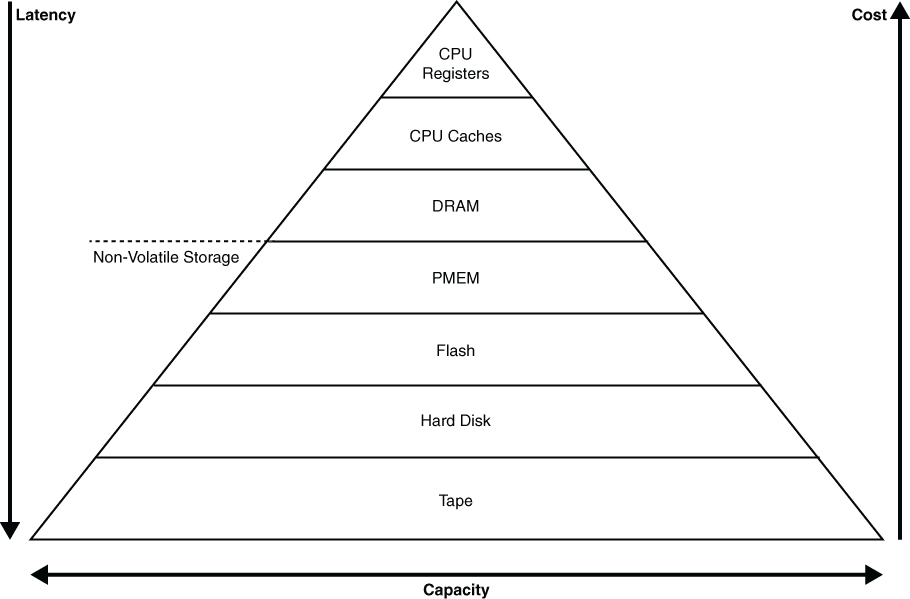
En la pirámide de almacenamiento tradicional, PMEM se encuentra entre DRAM, que no es persistente, y Flash, que es persistente (no volátil).
Figura 4: Pirámide de almacenamiento
Descripción de la ilustración pmem.png
La caché de buffers de la base de datos reside en DRAM. Los procesos de Oracle tienen acceso directo a direcciones de bytes a los bloques de un almacén de archivos PMEM, que se asignan a la caché de buffers de la base de datos. El mecanismo de asignación se invoca automáticamente al colocar un archivo de datos en un almacén de archivos PMEM.
Oracle AI Database utiliza un algoritmo interno para decidir si se migran bloques de datos del almacén de archivos PMEM a la DRAM. Entre los motivos habituales de la migración se incluyen las modificaciones de DML, la consistencia de lectura y un acceso más rápido para los bloques de datos activos.
Consulte también: " Buffers de DRAM y PMEM"
Interfaz del sistema de archivos para el almacén de archivos PMEM
PMEM Filestore implementa un protocolo denominado Sistema de archivos en el espacio de usuario (FUSE).
FUSE permite a los usuarios de sistemas operativos sin privilegios, como el propietario del software Oracle AI Database, crear y gestionar sistemas de archivos y los directorios y archivos que contienen. Por ejemplo, puede utilizar los comandos cp, rm y ls.
Un sistema de archivos típico utiliza el almacenamiento raw como su almacén de copia de seguridad, mientras que PMEM Filestore obtiene el almacenamiento de un archivo de sistema operativo nativo en un sistema de archivos DAX de PMEM. Este archivo se denomina archivo de respaldo y se puede ver como un archivo en el sistema operativo. El almacén de archivos PMEM subdivide el almacenamiento dentro del archivo de copia de seguridad y lo presenta como un sistema de archivos local.
Consulte además:
- Guía del administrador de Oracle AI Database para obtener más información sobre PMEM Filestore
Interfaz de usuario para el almacén de archivos PMEM
Para crear un almacén de archivos PMEM, utilice el comando CREATE PMEM FILESTORE.
El almacén de archivos PMEM se monta automáticamente después de su creación. El almacén de archivos PMEM aparece en el punto de montaje especificado como si fuera un sistema de archivos nativo.
El parámetro de inicialización PMEM_FILESTORE especifica un almacén de archivos PMEM que la instancia de base de datos monta automáticamente cuando se inicia. El parámetro se define en un par ordenado de cadenas. La primera cadena de la lista de valores de parámetros es el directorio donde se monta el almacén de archivos PMEM. La segunda cadena es el archivo de respaldo.
V$PMEM_FILESTORE muestra metadatos sobre un almacén de archivos PMEM. Por ejemplo, puede ver la ruta del directorio del punto de montaje, la ruta del archivo de copia de seguridad y el tamaño del almacén de archivos.
Consulte también: Guía del administrador de Oracle AI Database para aprender a crear y gestionar un almacén de archivos PMEM
Visión General de Archivos de Datos
En el nivel del sistema operativo, Oracle AI Database almacena datos en estructuras denominadas archivos de datos. Cada base de datos Oracle, ya sea una CDB o PDB, debe tener al menos un archivo de datos.
-
Uso de archivos de datos Oracle AI Database almacena físicamente los datos del tablespace en los archivos de datos.
-
Archivos de datos permanentes y temporales Un tabla permanente contiene objetos de esquema persistentes. Los objetos de los tablespaces permanentes se almacenan en archivos de datos.
-
Archivos de datos en línea y fuera de línea Todos los archivos de datos están en línea (disponibles) o fuera de línea (no disponibles).
-
Estructura de archivo de datos Oracle AI Database crea un archivo de datos para un tablespace asignando la cantidad especificada de espacio en disco más la sobrecarga para la cabecera del archivo de datos. El sistema operativo en el que se ejecuta Oracle AI Database es responsable de borrar información y autorizaciones antiguas de un archivo antes de asignarlas a la base de datos.
Uso de archivos de datos
Oracle AI Database almacena físicamente los datos de tablespace en los archivos de datos.
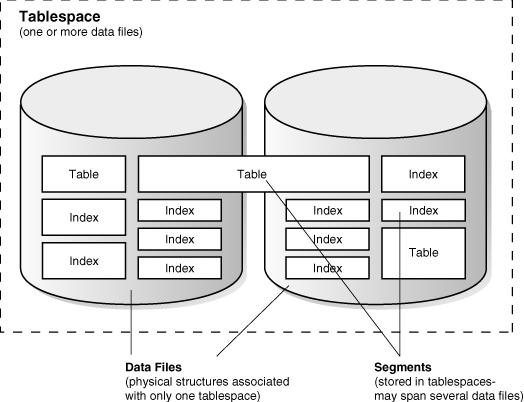
Cada objeto de esquema no particionado y cada partición de un objeto se almacena en su propio segmento, que pertenece a un solo tablespace. Por ejemplo, los datos de una tabla no particionada se almacenan en un único segmento, que a su vez se almacena en un tablespace. Los tablespaces y los archivos de datos están estrechamente relacionados, pero tienen diferencias importantes:
-
Cada tablespace consta de uno o más archivos de datos, que se ajustan al sistema operativo en el que se ejecuta Oracle AI Database.
-
Los datos de una base de datos se almacenan colectivamente en los archivos de datos ubicados en cada tablespace de la base de datos.
-
Un segmento puede abarcar uno o más archivos de datos, pero no varios tablespaces.
-
Una CDB debe tener los tablespaces
SYSTEMySYSAUX. Cada PDB de una CDB tiene sus propios tablespacesSYSTEMySYSAUX. Oracle AI Database asigna automáticamente los primeros archivos de datos de cualquier base de datos para el tablespaceSYSTEMdurante la creación de la base de datos.El tablespace
SYSTEMcontiene el diccionario de datos, un juego de tablas que contiene metadatos de base de datos. Normalmente, una base de datos también tiene un tabla de deshacer y un tablespace temporal (normalmente denominadoTEMP).
En la siguiente figura se muestra la relación entre tablespaces, archivos de datos y segmentos.
Figura 5: Archivos de Datos y Tablespaces
Descripción de la ilustración cncpt037.gif
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar archivos de datos
Archivos de datos permanentes y temporales
Un tabla permanente contiene objetos de esquema persistentes. Los objetos de los tablespaces permanentes se almacenan en archivos de datos.
Un tabla temporal contiene objetos de esquema solo durante la duración de una sesión. Los tablespaces temporales gestionados localmente tienen archivos temporales (archivos de plantilla), que son archivos especiales diseñados para almacenar datos en hash, ordenación y otras operaciones. Los archivos temporales también almacenan datos del juego de resultados cuando no hay suficiente espacio en la memoria.
Los archivos temporales son similares a los archivos de datos permanentes, con las siguientes excepciones:
-
Los objetos de base de datos permanentes, como las tablas, nunca se almacenan en archivos temporales.
-
Los archivos temporales siempre se definen en el modo
NOLOGGING, lo que significa que nunca se han generado redo para ellos. La recuperación de medios físicos no reconoce los archivos temporales. -
No puede hacer que un archivo temporal sea de solo lectura.
-
No puede crear un archivo temporal con la sentencia
ALTERDATABASE. -
Al crear o cambiar el tamaño de los archivos temporales, no siempre se garantiza la asignación de espacio en disco para el tamaño de archivo especificado. En sistemas de archivos como Linux y UNIX, los archivos temporales se crean como archivos dispersos. En este caso, los bloques de disco no se asignan al crear o cambiar el tamaño del archivo, sino a medida que se accede a los bloques por primera vez.
Nota: Los archivos dispersos permiten crear y cambiar el tamaño de archivos temporales rápidamente; sin embargo, el disco podría quedarse sin espacio más tarde cuando se accede a los archivos temporales.
-
La información del archivo temporal se muestra en la vista del diccionario de datos
DBA_TEMP_FILESy en la vista de rendimiento dinámicoV$TEMPFILE, pero no enDBA_DATA_FILESni en la vistaV$DATAFILE.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar archivos temporales
Archivos de datos en línea y fuera de línea
Cada archivo de datos está en línea (disponible) o fuera de línea (no disponible).
Puede modificar la disponibilidad de archivos de datos individuales o archivos temporales si los pone fuera de línea o los pone en línea. La base de datos no puede acceder a los archivos de datos fuera de línea hasta que se ponen en línea.
Puede poner los archivos de datos fuera de línea por muchos motivos, incluida la realización de copias de seguridad fuera de línea o la corrupción de bloques. La base de datos pone un archivo de datos fuera de línea automáticamente si la base de datos no puede escribir en él.
Al igual que un archivo de datos, un tablespace en sí está fuera de línea o en línea. Al poner un archivo de datos fuera de línea en un tablespace en línea, el propio tablespace permanece en línea. Puede hacer que todos los archivos de datos de un tablespace no estén disponibles temporalmente poniendo el propio tablespace fuera de línea.
A partir de Oracle Database 12c, puede utilizar la sentencia ALTER DATABASE MOVE DATAFILE para mover un archivo de datos en línea de un archivo físico a otro mientras la base de datos está abierta y accede al archivo. Puede utilizar esta técnica para lograr los siguientes objetivos:
-
Mover un tablespace de un tipo de almacenamiento a otro
-
Mueva los archivos de datos a los que se accede con poca frecuencia para reducir el costo de almacenamiento
-
Hacer que un tablespace sea de solo lectura y mover sus archivos de datos al almacenamiento de una sola escritura, como una unidad de escritura única y lectura múltiple (WORM)
-
Mover una base de Datos a Oracle ASM
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a modificar la disponibilidad de los archivos de datos
-
Oracle AI Database Administrator's Guide para aprender a mover archivos de datos en línea
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre
ALTER DATABASE . . . MOVE DATAFILE
Estructura de archivo de datos
Oracle AI Database crea un archivo de datos para un tablespace asignando la cantidad especificada de espacio en disco más la sobrecarga para la cabecera del archivo de datos. El sistema operativo en el que se ejecuta Oracle AI Database es responsable de borrar información y autorizaciones antiguas de un archivo antes de asignarlas a la base de datos.
El encabezado del archivo de datos contiene metadatos sobre el archivo de datos, como su tamaño y punto de control SCN. Cada cabecera contiene un número de archivo absoluto, que identifica de forma única el archivo de datos dentro de la base de datos, y un número de archivo relativo, que identifica de forma única un archivo de datos dentro de un tablespace.
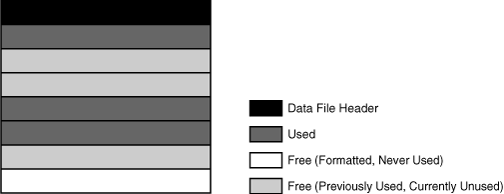
Cuando Oracle AI Database crea por primera vez un archivo de datos, el espacio en disco asignado se formatea, pero no contiene datos de usuario. Sin embargo, la base de datos reserva el espacio para contener los datos de segmentos futuros del tablespace asociado. A medida que los datos crecen en un tablespace, Oracle AI Database utiliza el espacio libre en los archivos de datos para asignar extensiones para el segmento.
En la siguiente figura, se ilustran los diferentes tipos de espacio en un archivo de datos. Las extensiones se utilizan, lo que significa que contienen datos de segmento, o son gratuitas, lo que significa que están disponibles para su reutilización. Con un tiempo, las actualizaciones y supresiones en objetos de un tablespace pueden crear bolsillos de espacio vacío que, de forma individuo, no son lo suficientemente grandes como para reutilizarlos para nuevos datos. Este tipo de espacio vacío se denomina espacio libre fragmentado.
Figura 6: Espacio en un archivo de datos
Descripción de la ilustración cncpt273.gif
Consulte también: Guía del administrador de Oracle AI Database para obtener información sobre cómo ver la información del archivo de datos
Visión General de los Archivos de Control
El archivo de control de la base de datos es un pequeño archivo binario asociado con una sola CDB.
Cada CDB tiene un único archivo de control, aunque se permiten varias copias idénticas. Las PDB no tienen archivos de control independientes.
-
Uso de archivos de control Oracle AI Database utiliza el archivo de control para localizar archivos de base de datos y gestionar el estado de la base de datos en general.
-
Varios archivos de control Oracle AI Database permite que varios archivos de control idénticos se abran simultáneamente y se escriban en la misma base de datos. Al multiplexar un archivo de control en diferentes discos, la base de datos puede lograr redundancia y, por lo tanto, evitar un único punto de fallo.
-
Estructura de archivo de control La información sobre la base de datos se almacena en diferentes secciones del archivo de control. Cada sección es un juego de registros sobre un aspecto de la base de datos.
Uso de Archivos de Control
Oracle AI Database utiliza el archivo de control para localizar archivos de base de datos y gestionar el estado de la base de datos de forma general.
Un archivo de control contiene información como la siguiente:
-
Nombre de base de datos e identificador único de base de datos (DBID)
-
Registro de hora de creación de la base de datos
-
Información sobre archivos de datos, archivos redo log en línea y archivos redo log archivados
-
Información de Tablespace
-
Copias de seguridad de RMAN
El archivo de control tiene las siguientes finalidades:
-
Contiene información sobre archivos de datos, archivos redo log en línea, etc. que son necesarios para abrir la base de datos.
El archivo de control realiza un seguimiento de los cambios estructurales en la base de datos. Por ejemplo, cuando un administrador agrega, cambia el nombre o borra un archivo de datos o un archivo redo log en línea, la base de datos actualiza el archivo de control para reflejar este cambio.
-
Contiene metadatos a los que se debe poder acceder cuando la base de datos no está abierta.
Por ejemplo, el archivo de control contiene la información necesaria para recuperar la base de datos, incluidos los puntos de control. Un punto de control indica el SCN en el flujo de redo en el que sería necesaria la recuperación de la instancia para empezar. Se garantiza que todos los cambios confirmados antes de que se guarde un SCN de punto de control en el disco de los archivos de datos. Al menos cada tres segundos, el proceso de punto de control registra información en el archivo de control sobre la posición del punto de control en el redo log en línea.
Oracle AI Database lee y escribe en el archivo de control continuamente durante el uso de la base de datos y debe estar disponible para escritura siempre que la base de datos esté abierta. Por ejemplo, la recuperación de una base de datos implica leer desde el archivo de control los nombres de todos los archivos de datos que contiene la base de datos. Otras operaciones, como agregar un archivo de datos, actualizan la información almacenada en el archivo de control.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar el archivo de control
Varios archivos de control
Oracle AI Database permite que varios archivos de control idénticos se abran simultáneamente y se escriban en la misma base de datos. Al multiplexar un archivo de control en diferentes discos, la base de datos puede lograr redundancia y, por lo tanto, evitar un único punto de fallo. Nota: Oracle recomienda mantener varias copias del archivo de control, cada una en un disco diferente.
Si un archivo de control deja de ser utilizable, la instancia de base de datos falla cuando intenta acceder al archivo de control dañado. Cuando existen otras copias actuales del archivo de control, puede volver a montar la base de datos y abrirla sin recuperación de medios. Sin embargo, si se pierden todos los archivos de control de una base de datos, la instancia de base de datos falla y se necesita la recuperación del medio físico. La recuperación de medios físicos no es sencilla si se debe utilizar una copia de seguridad anterior de un archivo de control porque no hay disponible una copia actual.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a mantener varios archivos de control
-
Guía del usuario de copia de seguridad y recuperación de Oracle AI Database para aprender a realizar copias de seguridad y restaurar archivos de control
Estructura de archivo de control
La información sobre la base de datos se almacena en diferentes secciones del archivo de control. Cada sección es un juego de registros sobre un aspecto de la base de datos.
Por ejemplo, una sección del archivo de control realiza un seguimiento de los archivos de datos y contiene un juego de registros, uno para cada archivo de datos. Cada sección se almacena en varios bloques de archivos de control lógicos. Los registros pueden abarcar bloques dentro de una sección.
El archivo de control contiene los siguientes tipos de registros:
-
Registros de reutilización circular
Un registro de reutilización circular contiene información no crítica que puede sobrescribirse si es necesario. Cuando todos los espacios de registro disponibles están llenos, la base de datos amplía el archivo de control para dejar espacio para un nuevo registro o sobrescribe el registro más antiguo. Entre los ejemplos se incluyen registros sobre archivos redo log archivados y copias de seguridad de RMAN.
-
Registros de reutilización no circular
Un registro de reutilización no circular contiene información crítica que no cambia con frecuencia y que no se puede sobrescribir. Entre los ejemplos de información se incluyen tablespaces, archivos de datos, archivos redo log en línea y threads de redo. Oracle AI Database nunca vuelve a utilizar estos registros a menos que el objeto correspondiente se borre del tablespace.
Puede consultar las vistas de rendimiento dinámico, también conocidas como vistas V$, para ver la información almacenada en el archivo de control. Por ejemplo, puede consultar V$DATABASE para obtener el nombre de la base de datos y el DBID. Sin embargo, sólo la base de datos puede modificar la información del archivo de control.
La lectura y escritura de los bloques de archivos de control es diferente de la lectura y escritura de bloques de datos. Para el archivo de control, Oracle AI Database lee y escribe directamente desde el disco en el área global del programa (PGA). Cada proceso asigna una cierta cantidad de su memoria PGA para los bloques de archivos de control.
Consulte además:
-
Oracle AI Database Reference para obtener más información sobre la vista
V$CONTROLFILE_RECORD_SECTION -
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
CONTROL_FILE_RECORD_KEEP_TIME
Visión General del Redo Log en Línea
La estructura más importante para la recuperación es el redo log en línea, que consta de dos o más archivos preasignados que almacenan los cambios en la base de datos a medida que se producen. El redo log en línea registra los cambios en los archivos de datos.
-
Uso del Redo Log en Línea: la base de datos mantiene los archivos redo log en línea para proteger contra la pérdida de datos. En concreto, después de un fallo de instancia, los archivos redo log en línea permiten a Oracle AI Database recuperar los datos confirmados que aún no se han escrito en los archivos de datos.
-
Cómo escribe Oracle AI Database en el redo log en línea El redo log en línea para una instancia de base de datos se denomina subproceso de redo.
-
La estructura de los archivos redo log en línea contiene registros de redo.
Uso del Redo Log en Línea
La base de datos mantiene los archivos redo log en línea para proteger contra la pérdida de datos. En concreto, después de un fallo de instancia, los archivos redo log en línea permiten a Oracle AI Database recuperar los datos confirmados que aún no se han escrito en los archivos de datos.
Los procesos de servidor escriben cada transacción de forma síncrona en el buffer de redo log, que el proceso LGWR escribe en el redo log en línea. El contenido del redo log en línea incluye transacciones sin confirmar y sentencias de gestión de objetos y esquemas.
A medida que la base de datos realiza cambios en los segmentos de deshacer, también escribe estos cambios en los redo logs en línea. Por lo tanto, el redo log en línea siempre contiene los datos de deshacer de los objetos permanentes. Puede configurar la base de datos para almacenar todos los datos de deshacer de los objetos temporales en un segmento de deshacer temporal, que ahorra espacio y mejora el rendimiento, o bien permitir que la base de datos almacene datos de deshacer permanentes y temporales en el redo log en línea.
Oracle AI Database utiliza el redo log en línea solo para la recuperación. Sin embargo, los administradores pueden consultar los archivos redo log en línea mediante una interfaz SQL en la utilidad Oracle LogMiner. Los archivos redo log son una fuente útil de información histórica sobre la actividad de la base de datos.
Consulte además:
-
"Arquitectura de procesos" para obtener más información sobre los procesos de Oracle
-
Oracle AI Database Administrator's Guide para obtener más información sobre los segmentos de deshacer temporales
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
TEMP_UNDO_ENABLED
Cómo escribe Oracle AI Database en el redo log en línea
El redo log en línea para una instancia de base de datos se denomina subproceso de redo.
En las configuraciones de instancia única, solo una instancia accede a una base de datos, por lo que solo hay un thread de redo presente. Sin embargo, en una configuración de Oracle Real Application Clusters (Oracle RAC), varias instancias acceden simultáneamente a una base de datos, y cada instancia tiene su propio thread de redo. Un thread de redo independiente para cada instancia evita la contención de un único juego de archivos redo log en línea.
Un redo log en línea consta de dos o más archivos redo log en línea. Oracle AI Database requiere un mínimo de dos archivos para garantizar que un archivo siempre esté disponible para escritura en caso de que el otro archivo esté en proceso de borrado o archivado.
-
Conmutadores de Redo Log en Línea Oracle AI Database utiliza solo un archivo redo log en línea a la vez para almacenar los registros escritos desde el buffer de redo log.
-
Varias Copias de Archivos Redo Log en Línea Oracle AI Database puede mantener automáticamente dos o más copias idénticas del redo log en línea en ubicaciones independientes.
-
Archivos Redo Log Archivados Un archivo redo log archivado es una copia de un miembro rellenado de un grupo de redo logs en línea.
Consulte también: Oracle Real Application Clusters Administration and Deployment Guide para obtener más información sobre los grupos de redo logs en línea en Oracle RAC
Switches de Redo Log en Línea
Oracle AI Database utiliza sólo un archivo redo log en línea a la vez para almacenar los registros escritos desde el buffer de redo log.
El archivo redo log en línea en el que el proceso de guionista de logs (LGWR) está escribiendo activamente se denomina archivo redo log en línea actual.
Un cambio de log se produce cuando la base de datos deja de escribir en un archivo redo log en línea y comienza a escribir en otro. Normalmente, se produce un cambio cuando el archivo redo log en línea actual está lleno y la escritura debe continuar. Sin embargo, puede configurar los cambios de log para que se produzcan a intervalos regulares, independientemente de si se ha rellenado el archivo redo log en línea actual y forzar los cambios de log manualmente.
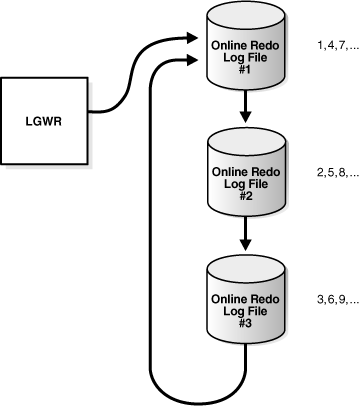
El escritor de logs escribe en los archivos redo log en línea de forma circular. Cuando el escritor de logs rellena el último archivo redo log en línea disponible, el proceso escribe en el primer archivo log y reinicia el ciclo. La Figura 14-7 ilustra la escritura circular del redo log.
Figura 7: Reutilización de Archivos Redo Log en Línea
Descripción de la ilustración admin054.gif
Los números de la Figura 14-7 muestran la secuencia en la que LGWR escribe en cada archivo redo log en línea. La base de datos asigna a cada archivo un nuevo número de secuencia de log cuando un log cambia y los escritores de logs comienzan a escribir en él. Cuando la base de datos reutiliza un archivo redo log en línea, este archivo recibe el siguiente número de secuencia de log disponible.
Los archivos redo log en línea rellenados están disponibles para su reutilización en función del modo de archivado:
-
Si el archivado está desactivado, lo que significa que la base de datos está en modo
NOARCHIVELOG, un archivo redo log en línea rellenado estará disponible después de que los cambios registrados en ella hayan sido puntuados (escritos) en el disco por el escritor de base de datos (DBW). -
Si el archivado está activado, lo que significa que la base de datos está en el modo ARCHIVELOG, un archivo redo log en línea rellenado estará disponible para el escritor de logs después de que los cambios se hayan escrito en los archivos de datos y el archivo se haya archivado.
En algunas circunstancias, se puede evitar que el escritor de logs reutilice un archivo redo log en línea existente. Se necesita un archivo redo log en línea activo para la recuperación de instancias, donde no se necesita un archivo redo log en línea inactivo para la recuperación de instancias. Además, un archivo redo log en línea puede estar en proceso de borrado.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar el redo log en línea
Varias copias de archivos redo log en línea
Oracle AI Database puede mantener automáticamente dos o más copias idénticas del redo log en línea en ubicaciones independientes.
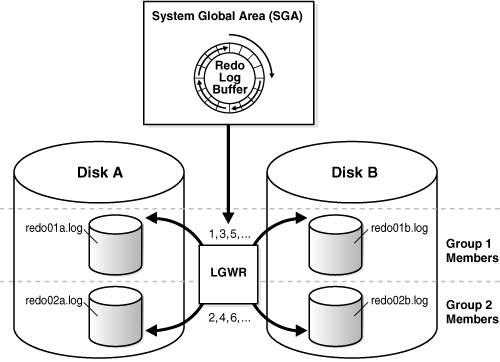
Un grupo de redo logs en línea consta de un archivo redo log en línea y sus copias redundantes. Cada copia idéntica es miembro del grupo de redo logs en línea. Cada grupo está definido por un número, como el grupo 1, el grupo 2, etc.
El mantenimiento de varios miembros de un grupo de redo logs en línea protege frente a la pérdida del redo log. Lo ideal es que las ubicaciones de los miembros estén en discos independientes para que el fallo de un disco no cause la pérdida de todo el redo log en línea.
En la Figura 14-8, A_LOG1 y B_LOG1 son miembros idénticos del grupo 1, mientras que A_LOG2 y B_LOG2 son miembros idénticos del grupo 2. Cada miembro de un grupo debe tener el mismo tamaño. LGWR escribe simultáneamente en el grupo 1 (miembros A_LOG1 y B_LOG1), luego escribe simultáneamente en el grupo 2 (miembros A_LOG2 y B_LOG2), luego escribe en el grupo 1, y así sucesivamente. LGWR nunca escribe simultáneamente a miembros de diferentes grupos.
Figura 8: Copias múltiples de archivos redo log en línea
Descripción de la ilustración cncpt270.gif
Nota: Oracle recomienda que multiplexe el redo log en línea. La pérdida de archivos log puede ser catastrófica si se requiere recuperación. Al multiplexar el redo log en línea, la base del datos debe aumentar la cantidad de E/S que realiza. Según el sistema, esta E/S adicional puede afectar al rendimiento general de la base de datos.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a mantener varias copias de los archivos redo log en línea
-
Conceptos y Administración de Oracle Data Guard para obtener más información sobre la transferencia automatizada de datos de redo entre miembros de una configuración de Data Guard
Archivos Redo Log Archivados
Un archivo redo log archivado es una copia de un miembro rellenado de un grupo de redo logs en línea.
Un archivo redo log archivado no se considera parte de la base de datos. En su lugar, es una copia fuera de línea de un archivo redo log en línea creado por la base de datos y escrito en una ubicación especificada por el usuario.
Los archivos redo log archivados son una parte crucial de una estrategia de copia de seguridad y recuperación. Puede utilizar archivos redo log archivados para:
-
Recuperación de una Copia de Seguridad de Base de Datos
-
Actualización de una base de datos en espera
-
Obtener información sobre el historial de una base de datos mediante la utilidad Oracle LogMiner
La operación de generación de un archivo redo log archivado se conoce como archiving. Esta operación es automática o manual. Solo es posible cuando la base de datos está en modo ARCHIVELOG.
Un archivo redo log archivado incluye las entradas de redo y el número de secuencia de log del miembro idéntico del grupo de redo logs en línea. En "Múltiples Copias de Archivos Redo Log en Línea", los archivos A_LOG1 y B_LOG1 son miembros idénticos del Grupo 1. Si la base de datos está en modo ARCHIVELOG y si el archivado automático está activado, el proceso de archivador (ARCn) archivará uno de estos archivos. Si A_LOG1 está corrupto, el proceso puede archivar B_LOG1. El redo log archivado contiene una copia de cada grupo de redo logs que existía a partir del momento en que activó el archivado.
Consulte además:
-
Oracle AI Database Utilities para obtener más información sobre Oracle LogMiner
-
Oracle AI Database Administrator's Guide para aprender a gestionar el redo log archivado
-
Conceptos y Administración de Oracle Data Guard para aprender a configurar el archivado de redo log en espera
Estructura del Redo Log en Línea
Los archivos redo log en línea contienen registros de redo.
Un registro de redo está formado por un grupo de vectores de cambio, cada uno de los cuales describe un cambio en un bloque de datos. Por ejemplo, una actualización de un salario en la tabla employees genera un registro de redo que describe los cambios en el bloque del segmento de datos para la tabla, el bloque de datos del segmento de deshacer y la tabla de transacciones de los segmentos de deshacer.
Los registros de redo tienen todos los metadatos relevantes para el cambio, incluidos los siguientes:
-
SCN y registro de hora del cambio
-
ID de transacción de la transacción que generó el cambio
-
SCN y registro de hora cuando se confirma la transacción (si se confirma)
-
Tipo de operación que ha realizado el cambio
-
Nombre y tipo del segmento de datos modificado
Consulte también: "Visión General de Bloques de Datos"