Arquitectura de memoria
En este capítulo se describe la arquitectura de memoria de una instancia de base de datos.
-
Introducción a las estructuras de memoria de Oracle AI Database Cuando se inicia una instancia, Oracle AI Database asigna un área de memoria e inicia procesos en segundo plano.
-
Visión General del Área Global del Sistema (SGA) SGA es un área de memoria de lectura/escritura que, junto con los procesos en segundo plano de Oracle, forman una instancia de base de datos.
-
Visión General del Área Global de Programa (PGA) El PGA es la memoria específica de un proceso operativo o thread que no está compartido por otros procesos o threads del sistema. Puesto que el PGA es específico del proceso, nunca se asigna en el SGA.
-
Visión General del Área Global de Usuario: UGA es la memoria de sesión, que es la memoria asignada para variables de sesión, como la información de conexión y otra información necesaria para una sesión de base de datos. Básicamente, el UGA almacena el estado de la sesión.
-
Visión General del Área Global Gestionada (MGA) El Área Global Gestionada (MGA) es un marco de memoria único que tiene la capacidad de compartir y coordinar la memoria en un juego de procesos de Oracle de confianza.
-
Visión general de áreas de código de software Un área de código de software es una parte de la memoria que almacena el código que se está ejecutando o que se puede ejecutar. El código de Oracle AI Database se almacena en un área de software que suele ser más exclusiva y protegida que la ubicación de los programas de usuario. Consulte también: Guía del administrador de Oracle AI Database para obtener instrucciones para configurar y gestionar la memoria.
Introducción a las estructuras de memoria de Oracle AI Database
Cuando se inicia una instancia, Oracle AI Database asigna un área de memoria e inicia procesos en segundo plano.
El área de memoria almacena información como la siguiente:
-
Código del programa
-
Información sobre cada sesión conectada, incluso si no está activa actualmente
-
Información necesaria durante la ejecución del programa, por ejemplo, el estado actual de una consulta de la que se están recuperando filas
-
Información como datos de bloqueo que se comparten y se comunican entre procesos
-
Datos en caché, como bloques de datos y registros de redo, que también existen en el disco
-
Estructuras de memoria básicas Oracle AI Database incluye varias áreas de memoria, cada una de las cuales contiene varios subcomponentes.
-
La gestión de la memoria de Oracle AI Database Memory Management conlleva el mantenimiento de tamaños óptimos de las instancias de memoria de Oracle según van pasando las necesidades de uso de la base de datos. Oracle AI Database gestiona la memoria según la configuración de los parámetros de inicialización relacionados con la memoria. Consulte también: "Arquitectura de Procesos"
Estructuras básicas de memoria
Oracle AI Database incluye varias áreas de memoria, cada una de las cuales contiene varios subcomponentes.
Las estructuras de memoria básicas asociadas a Oracle AI Database incluyen:
-
Área global del sistema (SGA)
El SGA es un grupo de estructuras de memoria compartida, conocidas como componentes de SGA, que contienen datos e información de control para una instancia de Oracle AI Database. Todos los procesos de servidor y en segundo plano comparten el SGA. Entre los ejemplos de datos almacenados en SGA se incluyen bloques de datos en caché y áreas SQL compartidas.
-
Área global de programa (PGA)
Una PGA es una región de memoria no compartida que contiene datos e información de control exclusivamente para que los utilice un proceso de Oracle. Oracle AI Database crea el PGA cuando se inicia un proceso de Oracle.
Existe una PGA para cada proceso de servidor y proceso en segundo plano. La recopilación de PGA individuales es el PGA de instancia total o PGA de instancia. Los parámetros de inicialización de la base de datos definen el tamaño de la PGA de la instancia, no de las PGA individuales.
-
Área global del usuario (UGA)
UGA es la memoria asociada a una sesión de usuario.
-
Área Global Gestionada (MGA)
MGA es un componente de memoria semi compartida que utiliza una instancia de Oracle AI Database. Tiene la capacidad de compartir y coordinar la memoria en un pequeño juego de procesos de Oracle de confianza. Tiene la capacidad de ser configurable, elástico, modular, bajo demanda y reutilizable. A diferencia de SGA, los módulos de Oracle AI Database pueden elegir qué procesos se asocian a esta área y este comportamiento es dinámico.
-
Áreas de código de software
Las áreas de código de software son partes de la memoria que se utilizan para almacenar el código que se está ejecutando o que se puede ejecutar. El código de Oracle AI Database se almacena en un área de software que normalmente se encuentra en una ubicación diferente a la de los programas de usuario, una ubicación más exclusiva o protegida.
En el gráfico siguiente, se ilustran las relaciones entre estas estructuras de memoria.
Figura 1: Estructuras de memoria de Oracle AI Database
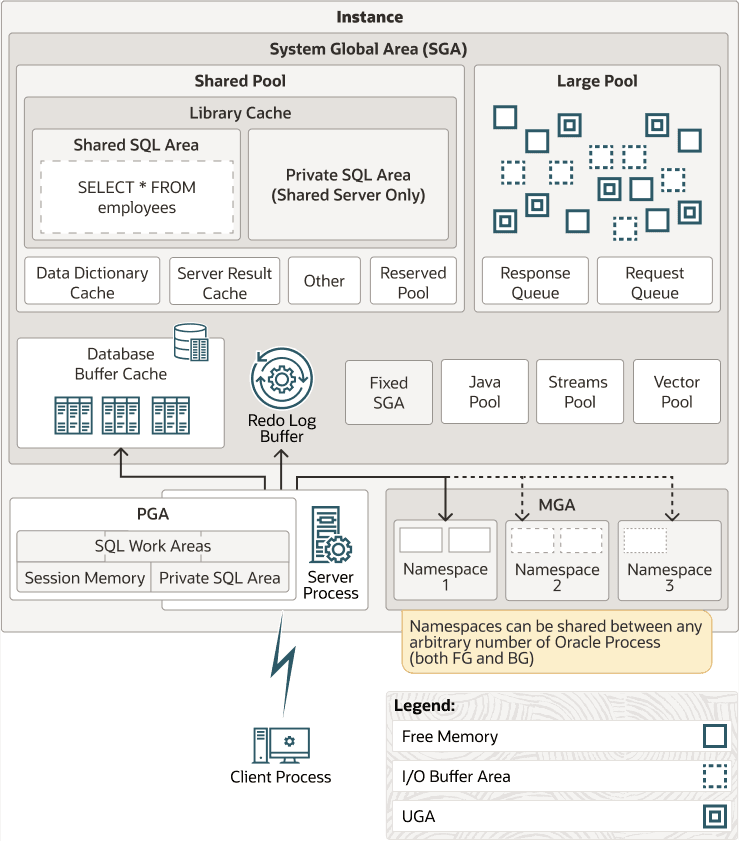
Descripción de la ilustración cncpt217.png
Gestión de memoria de Oracle AI Database
La gestión de memoria implica el mantenimiento de tamaños óptimos de las estructuras del recuerdo de las instancias de Oracle según van cambiando las necesidades de uso de la base de datos. Oracle AI Database gestiona la memoria según la configuración de los parámetros de inicialización relacionados con la memoria.
Las opciones básicas para la gestión de memoria son las siguientes:
-
Gestión de memoria unificada
Unified Memory configura la memoria de la instancia de base de datos con un único parámetro,
MEMORY_SIZE. La base de datos puede utilizar dinámicamente esta memoria para cualquier ratio de SGA, PGA, MGA, UGA y otros segmentos de memoria según la carga de trabajo actual. La división entre diferentes segmentos de memoria se basa en el tamaño de la memoria de las PDB abiertas actualmente en la CDB. Si se configuran páginas grandes, se pueden utilizar tanto para SGA como para PGA. La memoria unificada proporciona una configuración de memoria extremadamente flexible. -
Gestión automática de memoria
Especifique el tamaño de destino para la memoria de la instancia de base de datos. La instancia se ajusta automáticamente al tamaño de memoria de destino, redistribuyendo la memoria según sea necesario entre el SGA y el PGA de la instancia.
-
Gestión automática de memoria compartida
Este modo de gestión está parcialmente automatizado. Defina un tamaño de destino para SGA y, a continuación, tenga la opción de definir un tamaño de destino agregado para PGA o gestionar áreas de trabajo de PGA individualmente.
-
Gestión manual de memoria
En lugar de definir el tamaño total de memoria, puede definir muchos parámetros de inicialización para gestionar componentes de SGA y PGA de instancia de forma individual.
Si crea una base de datos con el Asistente de Configuración de Bases de Datos (DBCA) y elige la opción de instalación básica, la gestión automática de memoria es el valor por defecto.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para obtener más información sobre las opciones de gestión de memoria para los administradores de bases de datos.
-
Oracle AI Database Administrator's Guide para obtener más información sobre las opciones de gestión de memoria.
-
Oracle AI Database Reference para obtener más información sobre los parámetros de inicialización.
Visión General del Área Global del Sistema (SGA)
La SGA es un área de memoria de lectura/escritura que, junto con los procesos en segundo plano de Oracle, forman una instancia de base de datos. Nota: Los procesos de servidor y en segundo plano no residen dentro del SGA, sino que existen en un espacio de memoria independiente.
Todos los procesos de servidor que se ejecutan en nombre de los usuarios pueden leer información en la instancia de SGA. Varios procesos escriben en SGA durante la operación de la base de datos.
Cada instancia de base de datos tiene su propio SGA. Oracle AI Database asigna automáticamente memoria para un SGA al iniciar la instancia y reclama la memoria al cerrar la instancia. Al iniciar una instancia con SQL*Plus u Oracle Enterprise Manager, el tamaño de SGA se muestra como en el siguiente ejemplo:
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.
Como se muestra en la Figura 17-1, la SGA consta de varios componentes de memoria, que son agrupaciones de memoria utilizadas para satisfacer una determinada clase de solicitudes de asignación de memoria. Todos los componentes de SGA, excepto el buffer de redo log, asignan y desasignan espacio en unidades de memoria contigua denominadas gránulos. El tamaño del gránulo es específico de la plataforma y está determinado por el tamaño total de SGA.
Puede consultar la vista V$SGASTAT para obtener información sobre los componentes de SGA.
Los componentes de SGA más importantes son los siguientes:
-
Caché de Buffer de Base de Datos La caché de buffers de base de datos, también denominada caché de buffers, es el área de memoria que almacena copias de bloques de datos leídos de archivos de datos.
-
Buffer de redo log El buffer de redo log es un buffer circular en SGA que almacena entradas de redo que describen los cambios realizados a la base de datos.
-
Agrupación compartida La agrupación compartida almacena en caché varios tipos de datos de programa.
-
Agrupación grande La agrupación grande es un área de memoria opcional diseñada para asignaciones de memoria que son más grandes de lo adecuado para el pool compartido.
-
Pool de Java El pool de Java es un área de memoria que almacena todos los datos y código Java específicos de la sesión dentro de Java Virtual Machine (JVM). Esta memoria incluye objetos Java que se migran al espacio de sesión Java al final de la llamada.
-
SGA fijo: el SGA fijo es un área de mantenimiento interna.
-
Subáreas de SGA opcionales relacionadas con el rendimiento Algunas subáreas de SGA solo están activadas para funciones de rendimiento específicas.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para obtener más información sobre el tamaño de gránulos
Caché de Buffers de Base de Datos
La caché de buffers de base de datos, también denominada caché de buffers, es el área de memoria que almacena copias de los bloques de datos leídos de los archivos de datos.
Un buffer es una dirección de memoria principal en la que el gestor de buffers almacena temporalmente en caché un bloque de datos utilizado actualmente o recientemente. Todos los usuarios conectados simultáneamente a una instancia de base de datos comparten el acceso a la caché de buffers.
-
Propósito de la caché de buffers de base de datos Oracle AI Database utiliza la caché de buffers para lograr varios objetivos.
-
Estados de buffer: la base de datos utiliza algoritmos internos para gestionar buffers en la caché.
-
Modos de buffer Cuando un cliente solicita datos, Oracle AI Database recupera los buffers de la caché de buffers de la base de datos en modo actual o en modo consistente.
-
E/S del buffer: una E/S lógica, también conocida como E/S del buffer, hace referencia a lecturas y escrituras de buffers en la caché del buffer.
-
Agrupaciones de buffers Una agrupación de buffers es una recopilación de buffers.
-
Buffers y exploraciones de tablas completas La base de datos utiliza un algoritmo complicado para gestionar exploraciones de tablas. Por defecto, cuando los buffers se deben leer desde el disco, la base de datos inserta los buffers en el centro de la lista LRU. De esta forma, los bloques activos pueden permanecer en la caché para que no sea necesario volver a leerlos del disco.
-
Los buffers de base de datos estándar (DRAM) de bufferes de DRAM y PMEM difieren de los buffers de PMEM, pero comparten características.
Objetivo de la Caché de Buffer de la Base de datos
Oracle AI Database utiliza la caché de buffers para lograr varios objetivos.
Los objetivos incluyen:
-
Optimizar la E/S física
La base de datos actualiza los bloques de datos en la caché y almacena metadatos sobre los cambios en el buffer de redo log. Después de
COMMIT, la base de datos escribe los buffers de redo en el redo log en línea, pero no escribe inmediatamente bloques de datos en los archivos de datos. En su lugar, el escritor de base de datos (DBW) realiza escrituras diferidas en segundo plano. -
Mantener bloques a los que se accede con frecuencia en la caché de buffers y escribir bloques a los que no se accede con frecuencia en el disco
Cuando la caché flash inteligente de base de datos (caché flash) está activada, parte de la caché de buffers puede residir en la caché flash. Esta extensión de caché de buffers se almacena en uno o más dispositivos flash. La base de datos puede mejorar el rendimiento mediante el almacenamiento en caché de los buffers en la memoria flash en lugar de la lectura desde el disco magnético.
Utilice los parámetros de inicialización
DB_FLASH_CACHE_FILEyDB_FLASH_CACHE_SIZEpara configurar varios dispositivos flash. La caché de buffers realiza un seguimiento de cada dispositivo y distribuye los buffers a los dispositivos de forma uniforme.Nota: La caché flash inteligente de base de datos solo está disponible en Solaris y Oracle Linux.
-
Gestionar cabeceras de buffer que apuntan a archivos de datos en Oracle Persistent Memory Filestore (PMEM Filestore)
Si activa el almacén de archivos PMEM, los archivos de base de datos se asignan para el acceso directo de solo lectura. Las consultas pueden omitir el mecanismo de caché de buffers tradicional, evitando la E/S innecesaria. En este caso, las cabeceras de buffer deben almacenar los metadatos correspondientes a los bloques PMEM. La base de datos aún puede utilizar la caché de buffers tradicional (DRAM) para modificaciones, consistencia de lectura y acceso más rápido para bloques de datos "en caliente".
Consulte además:
-
"Almacén de Archivos de Memoria Persistente de Oracle (Almacén de Archivos PMEM)"
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
DB_FLASH_CACHE_FILE
Estados de buffer
La base de datos utiliza algoritmos internos para gestionar buffers en la caché.
Un buffer puede estar en cualquiera de los siguientes estados mutuamente excluyentes:
-
No utilizado
El buffer está disponible para su uso porque nunca se ha utilizado o no se utiliza actualmente. Este tipo de buffer es el más fácil de utilizar para la base de datos.
-
Limpiar
Este buffer se ha utilizado anteriormente y ahora contiene una versión de lectura consistente de un bloque a partir de un momento concreto. El bloque contiene datos, pero está "limpio", por lo que no necesita un punto de control. La base de datos puede fijar el bloque y reutilizarlo.
-
Sucio
El buffer contiene datos modificados que aún no se han escrito en el disco. La base de datos debe establecer un punto de control del bloque antes de reutilizarlo.
Cada buffer tiene un modo de acceso: fijado o libre (sin apuntar). Un buffer se "ancla" en la caché para que no quede obsoleto mientras una sesión de usuario accede a ella. Varias sesiones no pueden modificar un buffer anclado al mismo tiempo.
Modos de Buffer
Cuando un cliente solicita datos, Oracle AI Database recupera los buffers de la caché de buffers de la base de datos en modo actual o en modo consistente.
Los modos difieren de la siguiente manera:
-
Modo actual
Una obtención de modo actual, también denominada obtención de bloques de base de datos, es una recuperación de un bloque tal como aparece actualmente en la caché de buffers. Por ejemplo, si una transacción sin confirmar ha actualizado dos filas en un bloque, un modo actual obtiene el bloque con estas filas sin confirmar. La base de datos utiliza el bloque de base de datos obtiene con mayor frecuencia durante las sentencias de modificación, que deben actualizar solo la versión actual del bloque.
-
Modo consistente
Una lectura consistente get es una recuperación de una versión de lectura consistente de un bloque. Esta recuperación puede utilizar datos de deshacer. Por ejemplo, si una transacción sin confirmar ha actualizado dos filas en un bloque y si una consulta de una sesión independiente solicita el bloque, la base de datos utiliza datos de deshacer para crear una versión de lectura consistente de este bloque (denominada clonación de lectura consistente) que no incluya las actualizaciones sin confirmar. Normalmente, una consulta recupera bloques en modo consistente.
Consulte además:
-
Referencia de Oracle AI Database para obtener descripciones de estadísticas de base de datos, como db block get y coherent read get.
E/S de buffer
Una E/S lógica, también conocida como E/S del buffer, hace referencia a la lectura y las escrituras de buffers en la caché del buffer.
Cuando no se encuentra un buffer solicitado en la memoria, la base de datos realiza una E/S física para copiar el buffer de la caché flash o del disco en la memoria. A continuación, la base de datos realiza una E/S lógica para leer el buffer almacenado en caché.
-
Algoritmos de Sustitución de Buffers Para que el acceso a buffer sea eficaz, la base de datos debe decidir qué buffers desea almacenar en caché en la memoria y a qué acceder desde el disco.
-
Escrituras de buffer: el proceso de escritor de base de datos (DBW) escribe periódicamente buffers inactivos y sucios en el disco.
-
Lecturas de Buffers Cuando el número de buffers no utilizados es bajo, la base de datos debe eliminar los buffers de la caché de buffers.
-
Recuentos táctiles de buffer: la base de datos mide la frecuencia de acceso de los buffers en la lista LRU mediante un recuento táctil. Este mecanismo permite a la base de datos incrementar un contador cuando se ancla un buffer en lugar de mezclar buffers constantemente en la lista LRU.
Algoritmos de sustitución de buffer
Para que el acceso al buffer sea eficaz, la base de datos debe decidir qué buffers desea almacenar en caché en la memoria y a qué acceder desde el disco.
La base de datos utiliza los siguientes algoritmos:
-
Algoritmo de sustitución de nivel de bloque basado en LRU
Este sofisticado algoritmo, que es el predeterminado, utiliza una lista de uso menos reciente (LRU) que contiene punteros a buffers sucios y no sucios. La lista LRU tiene un extremo caliente y un extremo frío. Un buffer en frío es un buffer que no se ha utilizado recientemente. A un buffer de acceso directo se accede con frecuencia y se ha utilizado recientemente. Conceptualmente, sólo hay una LRU, pero para la concurrencia de datos la base de datos utiliza realmente varias LRU.
-
Algoritmo de sustitución de nivel de objeto basado en temperatura
A partir de Oracle Database 12c Versión 1 (12.1.0.2), la función automática de almacenamiento en caché de tablas grandes permite que las exploraciones de tablas utilicen un algoritmo diferente en los siguientes escenarios:
-
Consultas en paralelo
En bases de datos de instancia única y cluster de aplicaciones de Oracle Real (Oracle RAC), las consultas paralelas pueden utilizar la caché de tabla grande cuando el parámetro de inicialización
DB_BIG_TABLE_CACHE_PERCENT_TARGETse define en un valor distinto de cero yPARALLEL_DEGREE_POLICYse define enautooadaptive. -
Consultas en serie
En una configuración de instancia única únicamente, las consultas en serie pueden utilizar la caché de tabla grande cuando el parámetro de inicialización
DB_BIG_TABLE_CACHE_PERCENT_TARGETse define en un valor distinto de cero.
Cuando una tabla no cabe en la memoria, la base de datos decide qué buffers desea almacenar en caché según los patrones de acceso. Por ejemplo, si solo el 95% de una tabla popular cabe en la memoria, la base de datos puede optar por dejar el 5% de los bloques en el disco en lugar de leer cíclicamente bloques en la memoria y escribir bloques en el disco, un fenómeno conocido como paginación. Al almacenar en caché varios objetos grandes, la base de datos considera que las tablas más populares son más activas y menos populares, lo que influye en los bloques que se almacenan en caché. El parámetro de inicialización
DB_BIG_TABLE_CACHE_PERCENT_TARGETdefine el porcentaje de la caché de buffers que utiliza este algoritmo.Nota: En este documento se explica el algoritmo de sustitución de nivel de bloque basado en LRU.
-
Consulte también: Guía de Oracle AI Database VLDB y particiones para obtener más información sobre el algoritmo basado en la temperatura
Escrituras de Buffer
El proceso de escritor de base de datos (DBW) escribe periódicamente buffers inactivos y sucios en el disco.
DBW escribe buffers en las siguientes circunstancias:
-
Un proceso de servidor no puede encontrar buffers limpios para leer nuevos bloques en la caché de buffers de la base de datos.
Como los buffers están sucios, el número de buffers libres disminuye. Si el número cae por debajo de un umbral interno y si se necesitan buffers limpios, los procesos de servidor indican a DBW que escriba.
La base de datos utiliza LRU para determinar qué buffers sucios escribir. Cuando los buffers sucios llegan al extremo frío de la LRU, la base de datos los mueve de la LRU a una cola de escritura. DBW escribe buffers en la cola en el disco, utilizando escrituras multibloque si es posible. Este mecanismo evita que el final de la LRU se obstruya con buffers sucios y permite encontrar buffers limpios para su reutilización.
-
La base de datos debe avanzar en el punto de control, que es la posición en el thread de redo desde la que debe comenzar la recuperación de instancias.
-
Los tablespaces se cambian a estado de solo lectura o se ponen fuera de línea.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para aprender a diagnosticar y ajustar problemas de escritura en buffer
Lecturas de Buffer
Cuando el número de buffers no utilizados es bajo, la base de datos debe eliminar los buffers de la caché de buffers.
El algoritmo depende de si la caché flash está activada:
-
Caché flash desactivada
La base de datos reutiliza cada buffer limpio según sea necesario, sobrescribiéndolo. Si el buffer sobrescrito se necesita más adelante, la base de datos debe leerlo desde el disco magnético.
-
Caché flash activada
DBW puede escribir el cuerpo de un buffer limpio en la caché flash, lo que permite reutilizar su buffer en memoria. La base de datos mantiene la cabecera del buffer en una lista de LRU en la memoria principal para realizar un seguimiento del estado y la ubicación del cuerpo del buffer en la caché flash. Si este buffer es necesario más adelante, la base de datos puede leerlo desde la caché flash en lugar de desde el disco magnético.
Cuando un proceso de cliente solicita un buffer, el proceso de servidor busca el buffer en la caché de buffers. Se produce un acierto de caché si la base de datos encuentra el buffer en la memoria. El orden de búsqueda es el siguiente:
-
El proceso de servidor busca todo el buffer en la caché de buffers.
Si el proceso encuentra todo el buffer, la base de datos realiza una lectura lógica de este buffer.
-
El proceso de servidor busca la cabecera de buffer en la lista LRU de caché flash.
Si el proceso encuentra la cabecera del buffer, la base de datos realiza una lectura física optimizada del cuerpo del buffer de la caché flash en la caché en memoria.
-
Si el proceso no encuentra el buffer en la memoria (falta de caché), el proceso de servidor realiza los siguientes pasos:
-
Copia el bloque de un archivo de datos en el disco en la memoria (una lectura física)
-
Realiza una lectura lógica del buffer que se ha leído en la memoria
-
La Figura 17-2 ilustra el orden de búsqueda del buffer. La caché de buffers ampliada incluye tanto la caché de buffers en memoria, que contiene buffers completos, como la caché flash, que contiene cuerpos de buffer. En la figura, la base de datos busca un buffer en la caché de buffers y, al no encontrar el buffer, lo lee en la memoria desde el disco magnético.
Figura 2: Búsqueda en Buffer
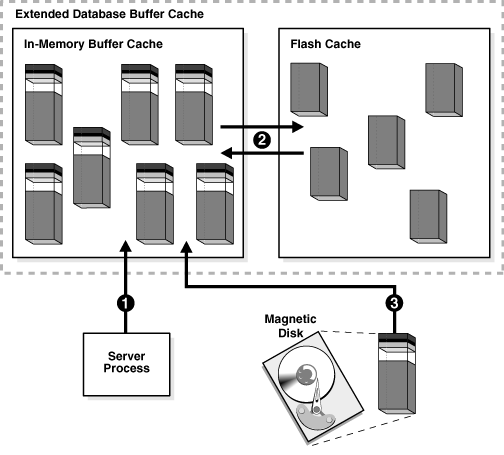
Descripción de la ilustración cncpt304.gif
En general, el acceso a los datos a través del acierto del caché es más rápido que el que se hace mediante una falta de caché. El ratio de aciertos de caché de buffers mide la frecuencia con la que la base de datos ha encontrado un bloque solicitado en la caché de buffers sin necesidad de leerlo del disco.
La base de datos puede realizar lecturas físicas desde un archivo de datos o un archivo de plantilla. Las lecturas de un archivo de datos van seguidas de las E/S lógicas. Las lecturas de un archivo temporal se producen cuando la memoria insuficiente fuerza a la base de datos a escribir datos en una tabla temporal y volver a leerla más tarde. Estas lecturas físicas omiten la caché de buffers y no incurren en una E/S lógica.
Consulte también: Oracle AI Database Performance Tuning Guide para aprender a calcular el ratio de aciertos de caché de buffers
Recuentos de toques de buffer
La base de datos mide la frecuencia de acceso de los buffers en la lista LRU mediante un recuento táctil. Este mecanismo permite a la base de datos incrementar un contador cuando se ancla un buffer en lugar de mezclar buffers constantemente en la lista LRU.
Nota: La base de datos no mueve físicamente los bloques de la memoria. El movimiento es el cambio en la ubicación de un puntero en una lista.
Cuando se fija un buffer, la base de datos determina cuándo se incrementó por última vez su recuento de contactos. Si el recuento se incrementó hace más de tres segundos, el recuento se incrementa; de lo contrario, el recuento permanece igual. La regla de tres segundos evita una ráfaga de pines en un buffer que cuenta tantos toques. Por ejemplo, una sesión puede insertar varias filas en un bloque de datos, pero la base de datos considera estas inserciones como un solo toque.
Si un buffer está en el extremo frío de la LRU, pero su recuento de contactos es alto, el buffer se mueve al extremo caliente. Si el recuento de contactos es bajo, el buffer se queda obsoleto en la caché.
Pools de Buffers
Una agrupación de buffers es una recopilación de buffers.
La caché de buffers de la base de datos se divide en uno o más pools de buffers, que gestionan los bloques de la misma forma. Las agrupaciones no tienen algoritmos radicalmente diferentes para el envejecimiento o el almacenamiento en caché de bloques.
Puede configurar manualmente pools de buffers independientes que mantengan los datos en la caché de buffers o que hagan que los buffers estén disponibles para los nuevos datos inmediatamente después de utilizar los bloques de datos. A continuación, puede asignar objetos de esquema específicos al pool de buffers adecuado para controlar cómo quedan fuera de la caché los bloques. Por ejemplo, puede separar segmentos en pools de buffers calientes, cálidos y fríos.
Los posibles pools de buffers son los siguientes:
-
Pool por defecto
Este pool es la ubicación en la que normalmente se almacenan en caché los bloques. A menos que configure manualmente agrupaciones independientes, la agrupación por defecto es la única agrupación de buffers. La configuración opcional de las otras agrupaciones no afecta a la agrupación predeterminada.
La caché de tabla grande es una sección opcional de la agrupación predeterminada que utiliza un algoritmo de sustitución de nivel de objeto basado en temperatura. En bases de datos de instancia única y Oracle RAC, las consultas paralelas pueden utilizar la caché de tabla grande cuando el parámetro de inicialización
DB_BIG_TABLE_CACHE_PERCENT_TARGETse define en un valor distinto de cero yPARALLEL_DEGREE_POLICYse define enautooadaptive. Solo en configuraciones de instancia única, las consultas en serie pueden utilizar la caché de tabla grande cuando se defineDB_BIG_TABLE_CACHE_PERCENT_TARGET. -
Mantener agrupación
Esta agrupación está destinada a bloques a los que se ha accedido con frecuencia, pero que han quedado obsoletos en la agrupación por defecto debido a la falta de espacio. El objetivo del pool de buffers KEEP es retener objetos en la memoria, evitando así las operaciones de E/S.
Nota: El pool KEEP gestiona los buffers de la misma forma que los demás pools: no utiliza un algoritmo especial para anclar buffers. La palabra "guardar" es una convención de nomenclatura. Puede colocar las tablas que desee mantener en el pool KEEP más grande y colocar las tablas que no desee mantener en el pool KEEP más pequeño.
-
Pool de reciclaje
Esta agrupación está destinada a bloques que se utilizan con poca frecuencia. Un pool de reciclaje evita que los objetos consuman espacio innecesario en la caché.
Una base de datos tiene un tamaño de bloque estándar. Puede crear un tablespace con un tamaño de bloque que difiera del tamaño estándar. Cada tamaño de bloque que no es por defecto tiene su propia agrupación. Oracle AI Database gestiona los bloques de estos pools de la misma forma que en el pool por defecto.
En la siguiente figura se muestra la estructura de la caché de buffers cuando se utilizan varios pools. La caché contiene pools por defecto, de conservación y de reciclaje. El tamaño del bloque predeterminado es 8 KB. La caché contiene pools independientes para tablespaces que utilizan tamaños de bloque no estándar de 2 KB, 4 KB y 16 KB.
Figura 3: Caché de Buffer de Base de datos
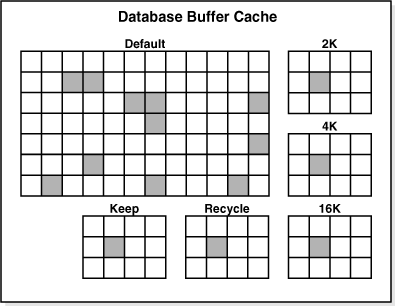
Descripción de la ilustración cncpt220.gif
Consulte además:
-
"Database Block Size" (Tamaño del Bloque de Base de Datos)
-
Oracle AI Database Administrator's Guide para obtener más información sobre los pools de buffers
-
Guía de ajuste de rendimiento de Oracle AI Database para aprender a utilizar varios pools de buffers
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
DB_BIG_TABLE_CACHE_PERCENT_TARGET
Buffers y Exploraciones de Tabla Completa
La base de datos utiliza un algoritmo complicado para gestionar exploraciones de tablas. Por defecto, cuando los buffers se deben leer desde el disco, la base de datos inserta los buffers en el centro de la lista LRU. De esta forma, los bloques activos pueden permanecer en la caché para que no sea necesario volver a leerlos del disco.
Un problema se plantea mediante una exploración completa de la tabla, que lee secuencialmente todas las filas de la tabla marca de agua superior (HWM). Supongamos que el tamaño total de los bloques de un segmento de tabla es mayor que el tamaño de la caché de buffers. Una exploración completa de esta tabla podría limpiar la caché de buffers, evitando que la base de datos mantenga una caché de bloques a los que se accede con frecuencia.
-
Modo por Defecto para Exploraciones de Tabla Completa Por defecto, la base de datos adopta un enfoque conservador para las exploraciones de tabla completa, cargando una tabla pequeña en la memoria solo cuando el tamaño de la tabla es un pequeño porcentaje de la caché de buffers.
-
Ejecución de Consulta Paralela Al realizar una exploración de tabla completa, la base de datos a veces puede mejorar el tiempo de respuesta mediante el uso de varios servidores de ejecución en paralelo.
-
Atributo de CACHE En el raro caso en el que no se desea el comportamiento por defecto de almacenamiento en caché, puede utilizar
ALTER TABLE ... CACHEpara cambiar la forma en que se leen los bloques de tablas grandes en la caché de buffers de la base de datos. -
Atributo deKEEP Para tablas grandes, puede utilizar
ALTER TABLE ... STORAGE BUFFER_POOL KEEPpara hacer que las exploraciones carguen bloques para estas tablas en el pool KEEP. -
Forzar Modo de Almacenamiento en Caché de Base de Datos Completa Para mejorar el rendimiento en algunas situaciones, puede ejecutar explícitamente la sentencia
ALTER DATABASE ... FORCE FULL DATABASE CACHINGpara activar el forzar Modo de Almacenamiento en Caché de Base de Datos Completa. Consulte también: "Espacio de segmento y marca de agua alta"
Modo por defecto para exploraciones de tabla completa
Por defecto, la base de datos adopta un enfoque conservador para las exploraciones de tablas completas, cargando una tabla pequeña en la memoria solo cuando el tamaño de la tabla es un pequeño porcentaje de la caché de buffers.
Para determinar si las tablas de tamaño medio se deben almacenar en caché, la base de datos utiliza un algoritmo que incorpora el intervalo entre la última exploración de tabla, el registro de hora de vencimiento de la caché de buffers y el espacio restante en la caché de buffers.
Para tablas muy grandes, la base de datos normalmente utiliza una lectura de ruta de acceso directa, que carga bloques directamente en la PGA y omite la SGA por completo, para evitar rellenar la caché de buffers. Para las tablas de tamaño medio, la base de datos puede utilizar una lectura directa o una lectura de caché. Si decide utilizar una lectura de caché, la base de datos coloca los bloques al final de la lista LRU para evitar que la exploración limpie eficazmente la caché de buffers.
A partir de Oracle Database 12c Versión 1 (12.1.0.2), la caché de buffers de una instancia de base de datos realiza automáticamente un cálculo interno para determinar si la memoria es suficiente para que la base de datos se almacene completamente en caché en SGA de la instancia y si el almacenamiento en caché de tablas en acceso sería beneficioso para el rendimiento. Si toda la base de datos puede caber completamente en la memoria y se cumplen otros criterios internos, Oracle AI Database trata todas las tablas de la base de datos como tablas pequeñas y las considera elegibles para el almacenamiento en caché. Sin embargo, la base de datos no almacena en caché los LOB marcados con el atributo NOCACHE.
Ejecución de consultas en paralelo
Al realizar una exploración de tabla completa, la base de datos a veces puede mejorar el tiempo de respuesta mediante el uso de varios servidores de ejecución en paralelo.
En algunos casos, como cuando la base de datos tiene una gran cantidad de memoria, la base de datos puede almacenar en caché datos de consulta paralelos en el área global del sistema (SGA) en lugar de utilizar lecturas de ruta de acceso directa en el área global del programa (PGA). Normalmente, las consultas paralelas se producen en almacenes de datos de baja simultaneidad debido al posible uso de recursos.
Consulte además:
-
Guía de almacenamiento de datos de Oracle AI Database para una introducción a los almacenes de datos
-
Guía de Oracle AI Database VLDB y partición para obtener más información sobre la ejecución en paralelo
Atributo CACHE
En el raro caso en el que no se desea el comportamiento de almacenamiento en caché por defecto, puede utilizar ALTER TABLE ... CACHE para cambiar la forma en que se leen los bloques de tablas grandes en la caché de buffers de la base de datos.
Para las tablas con el juego de atributos CACHE, la base de datos no fuerza ni ancla los bloques en la caché de buffers. En su lugar, la base de datos elimina los bloques de la caché de la misma forma que cualquier otro bloque de tabla. Tenga cuidado al ejercer esta opción porque una exploración completa de una tabla grande puede limpiar la mayoría de los otros bloques de la caché. Nota: La ejecución de ALTER TABLE ... CACHE no causa que una tabla se almacene en caché.
Atributo KEEP
Para tablas grandes, puede utilizar ALTER TABLE ... STORAGE BUFFER_POOL KEEP para que las exploraciones carguen bloques para estas tablas en el pool KEEP.
Al colocar una tabla en el pool KEEP, se cambia la parte de la caché de buffers en la que se almacenan los bloques. En lugar de almacenar en caché bloques en el pool de buffers por defecto, la base de datos los almacena en caché en el pool de buffers KEEP. Ningún control de algoritmo independiente mantiene el almacenamiento en caché del pool.
Consulte además:
-
Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre la cláusula
CACHEy el atributoKEEP -
Oracle AI Database Performance Tuning Guide para aprender a interpretar las estadísticas del asesor de caché de buffers
Forzar Modo de Caché de Base de Datos Completa
Para mejorar el rendimiento en algunas situaciones, puede ejecutar explícitamente la sentencia ALTER DATABASE ... FORCE FULL DATABASE CACHING para activar el modo de almacenamiento en caché completo de la base de datos.
A diferencia del modo por defecto, que es automático, el modo forzar caché de base de datos completa considera que toda la base de datos, incluidos los LOB NOCACHE, son aptos para el almacenamiento en caché en la caché de buffers de la base de datos. Este modo está disponible a partir de Oracle Database 12c versión 1 (12.1.0.2). Nota: La activación del modo forzado de almacenamiento en caché completo de la base de datos no fuerza a la base de datos a la memoria. En su lugar, toda la base de datos se puede almacenar en caché en la caché de buffers. Oracle AI Database almacena en caché las tablas solo cuando se accede a ellas.
Oracle recomienda activar el modo de caché de base de datos completa forzada solo cuando el tamaño de la caché de buffers de cada instancia individual sea mayor que el tamaño de la base de datos. Esta directriz se aplica a las bases de datos de instancia única y Oracle RAC. Sin embargo, cuando las aplicaciones Oracle RAC están bien particionadas, puede activar el modo forzado de almacenamiento en caché de la base de datos completa cuando la caché de buffers combinada de todas las instancias, con espacio adicional para manejar bloques duplicados en caché entre instancias, sea mayor que el tamaño de la base de datos.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a activar el modo de almacenamiento en caché completo forzado de la base de datos
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
ALTER DATABASE ... FORCE FULL DATABASE CACHING
Buffers DRAM y PMEM
Los buffers de base de datos estándar (DRAM) difieren de los buffers PMEM, pero comparten características.
Cuando se configura Oracle Persistent Memory Filestore (PMEM Filestore), todos los bloques de datos se asignan directamente a la caché de buffers en DRAM. A diferencia de los buffers DRAM, los buffers PMEM no copian el contenido de los bloques de datos. En su lugar, las cabeceras de buffer PMEM apuntan a los bloques de datos almacenados en el almacén de archivos PMEM. Para la mayoría de las lecturas, la base de datos solo almacena en caché los metadatos del bloque, no el contenido. Los buffers PMEM utilizan un tipo especial de gránulo cuya estructura es diferente de los gránulos de caché de buffers estándar.
Nota: El parámetro de inicialización DB_CACHE_SIZE especifica el tamaño mínimo de la caché de DRAM. La sobrecarga de metadatos de PMEM no se incluye en esta asignación.
Los buffers PMEM pueden tener cualquiera de los siguientes estados:
-
Actual
Esta es la versión actual de un buffer de PMEM. Se puede acceder directamente desde el almacén de archivos.
Oracle AI Database mantiene la versión actual de PMEM independiente de la versión actual del buffer de DRAM estándar. Esta separación ayuda a reducir la complejidad del código durante la fijación, limpieza y migración de bloques PMEM a DRAM.
-
Consistente
Versión de lectura consistente de un buffer de PMEM. Se crea después de que la base de datos crea una clonación en DRAM. Se puede acceder directamente al buffer de PMEM desde el almacén de archivos.
-
Libre
Se trata de un buffer PMEM gratuito. Puede ser reutilizado por un bloque PMEM. Después del inicio de la instancia, todos los buffers de PMEM están en estado libre.
PMEM tiene una latencia mayor que la DRAM. Oracle AI Database utiliza un algoritmo interno basado en carga de trabajo para decidir qué bloques migrar de PMEM a DRAM.
Consulte además:
-
"Almacén de Archivos de Memoria Persistente de Oracle (Almacén de Archivos PMEM)"
-
Oracle AI Database Administrator's Guide para aprender a configurar PMEM Filestore
Buffer del Redo Logs
El buffer de redo log es un buffer circular en SGA que almacena entradas de redo que describen los cambios realizados a la base de datos.
Un registro de redo es una estructura de datos que contiene la información necesaria para reconstruir o rehacer los cambios realizados en la base de datos por las operaciones DML o DDL. La recuperación de la base de datos aplica entradas de redo a los archivos de datos para reconstruir los cambios perdidos.
Los procesos de la base de datos copian las entradas de redo del espacio de memoria del usuario en el buffer de redo log en SGA. Las entradas de redo ocupan espacio continuo y secuencial en el buffer. El proceso de escritor de logs (LGWR) del proceso en segundo plano escribe el buffer de redo log en el grupo de redo logs en línea activo del disco. La Figura 17-4 muestra esta actividad de buffer de redo.
Figura 4: Buffer de Redo Log
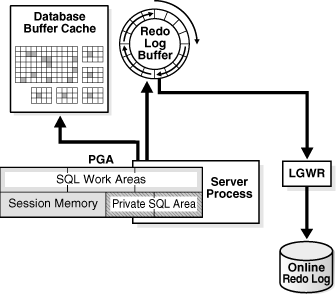
Descripción de la ilustración cncpt226.gif
LGWR escribe redo de forma secuencial en el disco mientras DBW realiza escrituras dispersas de bloques de datos en el disco. Las escrituras dispersas tienden a ser mucho más lentas que las escrituras secuenciales. Dado que LGWR permite a los usuarios evitar esperar a que DBW complete sus escrituras lentas, la base de datos ofrece un mejor rendimiento.
El parámetro de inicialización LOG_BUFFER especifica la cantidad de memoria que Oracle AI Database utiliza al almacenar en buffer las entradas de redo. A diferencia de otros componentes de SGA, el buffer de redo log y el buffer de SGA fijo no dividen la memoria en gránulos.
Consulte además:
-
"Proceso de Escritor de Log (LGWR)" y "Importancia de los Puntos de Control para la Recuperación de Instancias"
-
Oracle AI Database Administrator's Guide para obtener información sobre el redo log en línea.
Pool Compartido
La agrupación compartida almacena en caché varios tipos de datos de programa.
Por ejemplo, el pool compartido almacena SQL analizado, código PL/SQL, parámetros del sistema e información del diccionario de datos. El pool compartido está implicado en casi todas las operaciones que se producen en la base de datos. Por ejemplo, si un usuario ejecuta una sentencia SQL, Oracle AI Database accede al pool compartido.
El pool compartido se divide en varios subcomponentes, el más importante de los cuales se muestra en la Figure 17-5.
Figura 5: Pool Compartido
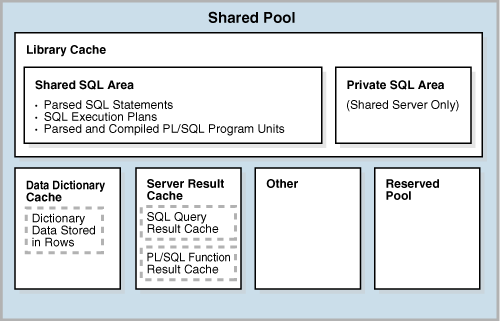
Descripción de la ilustración cncpt225.gif
En esta sección se incluyen los temas siguientes:
-
Caché de biblioteca La caché de biblioteca es una estructura de memoria de pool compartido que almacena código SQL y PL/SQL ejecutable.
-
Caché de Diccionario de Datos El diccionario de datos es una recopilación de tablas y vistas de bases de datos que contienen información de referencia sobre la base, sus estructuras y usuarios.
-
Caché de resultados del servidor La caché de resultados del servidor es un pool de memoria dentro del pool compartido. A diferencia de los pools de buffers, la caché de resultados del servidor contiene juegos de resultados y no bloques de datos.
-
Pool reservado El pool reservado es un área de memoria del pool compartido que Oracle AI Database puede utilizar para asignar grandes fragmentos contiguos de memoria.
Caché de biblioteca
La caché de biblioteca es una estructura de memoria de pool compartido que almacena código SQL y PL/SQL ejecutable.
Esta caché contiene las áreas SQL y PL/SQL compartidas y las estructuras de control, como bloqueos y manejadores de caché de biblioteca. En una arquitectura de servidor compartido, la caché de biblioteca también contiene áreas SQL privadas.
Cuando se ejecuta una sentencia SQL, la base de datos intenta reutilizar el código ejecutado anteriormente. Si existe una representación analizada de una sentencia SQL en la caché de biblioteca y se puede compartir, la base de datos reutiliza el código, conocido como análisis suave o acierto de caché de biblioteca. De lo contrario, la base de datos debe crear una nueva versión ejecutable del código de aplicación, conocida como análisis estricto o falta de caché de biblioteca.
-
Áreas SQL Compartidas La base de datos representa cada sentencia SQL que ejecuta en el área SQL compartida y el área SQL privada.
-
Unidades de programa y caché de biblioteca La caché de biblioteca contiene formas ejecutables de programas PL/SQL y clases Java. Estos elementos se denominan colectivamente unidades de programa.
-
Asignación y Reutilización de Memoria en el Pool Compartido La base de datos asigna memoria del pool compartido cuando se analiza una nueva sentencia SQL, a menos que la sentencia sea DDL, que no se considera que se puede compartir. El tamaño de la memoria asignada depende de la complejidad de la sentencia.
Áreas SQL Compartidas
La base de datos representa cada sentencia SQL que ejecuta en el área SQL compartida y el área SQL privada.
La base de datos utiliza el área SQL compartida para procesar la primera incidencia de una sentencia SQL. Esta área es accesible para todos los usuarios y contiene el árbol de análisis de sentencias y el plan de ejecución. Solo existe un área SQL compartida para una sentencia única. Cada sesión que emite una sentencia SQL tiene un área SQL privada en su PGA. Cada usuario que envía la misma sentencia tiene un área SQL privada que apunta a la misma área SQL compartida. Por lo tanto, muchas áreas SQL privadas en PGA independientes se pueden asociar a la misma área SQL compartida.
La base de datos determina automáticamente cuándo las aplicaciones envían sentencias SQL similares. La base de datos considera tanto las sentencias SQL emitidas directamente por usuarios y aplicaciones como las sentencias SQL recursivas emitidas internamente por otras sentencias.
La base de datos realiza los siguientes pasos:
-
Comprueba el pool compartido para ver si existe un área SQL compartida para una sentencia sintáctica y semánticamente idéntica:
-
Si existe una sentencia idéntica, la base de datos utiliza el área SQL compartida para la ejecución de las nuevas instancias posteriores de la sentencia, lo que reduce el consumo de memoria.
-
Si no existe una sentencia idéntica, la base de datos asigna un nuevo área SQL compartida en el pool compartido. Una sentencia con la misma sintaxis pero semántica diferente utiliza un cursor secundario.
En cualquier caso, el área SQL privada del usuario apunta al área SQL compartida que contiene la sentencia y el plan de ejecución.
-
-
Asigna un área SQL privada en nombre de la sesión
La ubicación del área SQL privada depende de la conexión establecida para la sesión. Si una sesión está conectada a través de un servidor compartido, parte del área SQL privada se mantiene en SGA.
La Figura 17-6 muestra una arquitectura de servidor dedicado en la que dos sesiones mantienen una copia de la misma sentencia SQL en sus propias PGA. En un servidor compartido, esta copia está en el UGA, que está en el MGA.
Figura 6: Áreas SQL privadas y Área SQL compartida
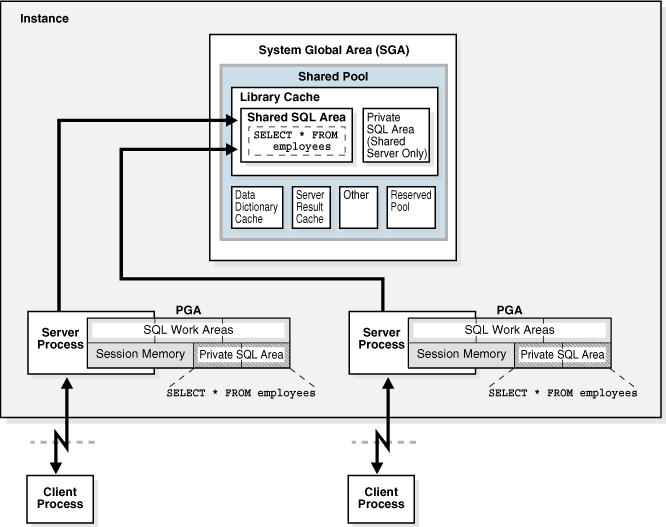
Descripción de la ilustración cncpt252.gif
Consulte además:
-
Oracle AI Database Performance Tuning Guide para obtener más información sobre la gestión de la caché de biblioteca
-
Guía de desarrollo de Oracle AI Database para obtener más información sobre SQL compartido
Unidades de programa y caché de biblioteca
La caché de biblioteca contiene formas ejecutables de programas PL/SQL y clases Java. Estos elementos se denominan colectivamente unidades de programa.
La base de datos procesa las unidades de programa de forma similar a las sentencias SQL. Por ejemplo, la base de datos asigna un área compartida para contener el formato compilado analizado de un programa PL/SQL. La base de datos asigna un área privada para contener valores específicos de la sesión que ejecuta el programa, incluidas variables locales, globales y de paquete, y buffers para ejecutar SQL. Si varios usuarios ejecutan el mismo programa, cada usuario mantiene una copia independiente de su área SQL privada, que contiene valores específicos de la sesión, y accede a un único área SQL compartida.
La base de datos procesa sentencias SQL individuales dentro de una unidad de programa PL/SQL como se ha descrito anteriormente. A pesar de sus orígenes dentro de una unidad de programa PL/SQL, estas sentencias SQL utilizan un área compartida para contener sus representaciones analizadas y un área privada para cada sesión que ejecuta la sentencia.
Asignación y Reutilización de Memoria en el Pool Compartido
La base de datos asigna memoria de pool compartido cuando se analiza una nueva sentencia SQL, a menos que la sentencia sea DDL, que no se considera que se puede compartir. El tamaño de la memoria asignada depende de la complejidad de la sentencia.
En general, un elemento del pool compartido permanece hasta que la base de datos lo elimina según un algoritmo de uso menos reciente (LRU). La base de datos permite que los elementos del pool compartido utilizados por muchas sesiones permanezcan en memoria siempre que sean útiles, incluso si el proceso de base de datos que ha creado el elemento termina. Este mecanismo minimiza la sobrecarga y el procesamiento de sentencias SQL. Si se necesita espacio para nuevos elementos, la base de datos libera la memoria consumida por los elementos que se utilizan con poca frecuencia.
La sentencia ALTER SYSTEM FLUSH SHARED_POOL elimina toda la información del pool compartido, al igual que el cambio del nombre de la base de datos global.
Consulte además:
-
Oracle AI Database SQL Tuning Guide para obtener una visión general del ciclo de vida de un área SQL compartida
-
Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre el uso de
ALTER SYSTEM FLUSH SHARED_POOL -
Referencia de Oracle AI Database para obtener información sobre las vistas dinámicas
V$SQLyV$SQLAREA
Caché del diccionario de datos
El diccionario de datos es una recopilación de tablas y vistas de bases de datos que contienen información de referencia sobre la base del datos, sus estructuras y usuarios.
Oracle AI Database accede al diccionario de datos con frecuencia durante el análisis de sentencias SQL. Oracle AI Database accede al diccionario de datos con tanta frecuencia que las siguientes ubicaciones de memoria especiales están designadas para contener los datos del diccionario:
-
Caché de diccionario de datos
Esta caché contiene información sobre los objetos de la base de datos. La caché también se conoce como caché de filas porque contiene datos como filas en lugar de buffers.
-
Caché de biblioteca
Todos los procesos del servidor comparten estas cachés para acceder a la información del diccionario de datos.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para aprender a asignar memoria adicional a la caché del diccionario de datos
Caché de resultados del servidor
La caché de resultados del servidor es un pool de memoria dentro del pool compartido. A diferencia de los pools de buffers, la caché de resultados del servidor contiene juegos de resultados y no bloques de datos. Nota: Una caché de resultados de cliente difiere de la caché de resultados del servidor. Una caché de cliente se configura en el nivel de aplicación y se encuentra en la memoria del cliente, no en la memoria de la base de datos.
-
Caché de Resultados de Consultas SQL La caché de resultados de consultas SQL es un subjuego de la caché de resultados del servidor que almacena los resultados de consultas y fragmentos de consultas. Puede activar o desactivar el almacenamiento en caché de resultados en el nivel de base de datos o sentencia.
-
Caché de resultados de función PL/SQL La caché de resultados de función PL/SQL es un subjuego de la caché de resultados del servidor que almacena juegos de resultados de función.
-
Infraestructura de caché de resultados del servidor La caché de resultados de consulta y la caché de resultados de función PL/SQL comparten la misma infraestructura.
-
Interfaz de Usuario de Caché de Resultados del Servidor El parámetro de inicialización
RESULT_CACHE_MODEdetermina si la caché de resultados de consulta SQL se utiliza para todas las consultas posibles o solo para consultas con indicaciones.
Caché de resultados de consultas SQL
La caché de resultados de consulta SQL es un subjuego de la caché de resultados del servidor que almacena los resultados de las consultas y los fragmentos de consulta. Puede activar o desactivar el almacenamiento en caché de resultados en el nivel de base de datos o sentencia.
Cuando se ejecuta una consulta, la base de datos determina si el resultado existe en la caché de resultados de consulta. Si el resultado no se almacena en caché y si el almacenamiento en caché está activado para la consulta, la base de datos ejecuta la consulta, devuelve el resultado y, a continuación, la almacena en caché. Sin embargo, si el resultado existe, la base de datos lo recupera de la caché en lugar de ejecutar la consulta.
La base de datos invalida automáticamente un resultado almacenado en caché cada vez que una transacción modifica los datos o metadatos de los objetos de base de datos utilizados para construir el resultado. La siguiente consulta no puede utilizar el resultado almacenado en caché, por lo que la base de datos calcula automáticamente un nuevo resultado y, a continuación, lo almacena en caché para que lo utilicen las consultas posteriores. El proceso de refrescamiento de caché es transparente para la aplicación.
En efecto, la caché de resultados de consulta funciona como una vista materializada "just-in-time" que la base de datos crea y mantiene según sea necesario. La caché permite a la base de datos evitar el costoso funcionamiento de volver a leer los bloques de datos y volver a calcular los resultados. La mayoría de las aplicaciones se benefician de esta mejora del rendimiento.
Consulte también: Oracle AI Database Administrator's Guide para aprender a optimizar el tiempo de respuesta mediante la caché de resultados de consulta
Caché de resultados de funciones PL/SQL
La caché de resultados de funciones PL/SQL es un subjuego de la caché de resultados del servidor que almacena juegos de resultados de funciones.
Sin el almacenamiento en caché, 1000 llamadas de una función PL/SQL a 1 segundo por llamada tardarían 1000 segundos. Con el almacenamiento en caché, 1000 llamadas a funciones con las mismas entradas podrían tardar 1 segundo total. Los buenos candidatos para el almacenamiento en caché de resultados son funciones que se invocan con frecuencia y que dependen de datos relativamente estáticos.
El código de función PL/SQL puede incluir una solicitud para almacenar en caché sus resultados. Al invocar esta función, el sistema comprueba la caché. Si la caché contiene el resultado de una llamada de función anterior con los mismos valores de parámetro, el sistema devuelve el resultado al invocador y no vuelve a ejecutar el cuerpo de la función. Si la caché no contiene el resultado, el sistema ejecuta el cuerpo de la función y agrega el resultado (para estos valores de parámetros) a la caché antes de devolver el control al invocador.
Nota: Puede especificar los objetos de base de datos utilizados para calcular un resultado almacenado en caché, de modo que si se actualiza alguno de ellos, el resultado almacenado en caché no sea válido y se deba volver a calcular.
Una función que se llama con frecuencia con diferentes argumentos puede generar resultados que rara vez se reutilizan, lo que provoca una degradación del rendimiento. Oracle AI Database realiza un seguimiento de las funciones PL/SQL utilizadas recientemente que tienen la indicación RESULT_CACHE. Con este historial, la base de datos solo almacena en caché una función PL/SQL y un par de argumentos si la ha visto x veces en el historial reciente, donde x se define mediante un umbral interno. Si la base de datos necesita más memoria porque hay demasiados resultados almacenados en caché, uno o más resultados almacenados en caché quedan obsoletos.
RESULT_CACHE_EXECUTION_THRESHOLD especifica el número de veces que se debe ver una función y un juego concreto de argumentos hasta que se almacene en caché. Tenga en cuenta que las funciones se consideran únicas si tienen diferentes argumentos, por ejemplo, MYFUNC(1,2) y MYFUNC(1,3). Este parámetro sólo se puede definir en el nivel de sistema, no en el nivel de sesión.
Consulte además:
-
Oracle AI Database Development Guide para obtener más información sobre la caché de resultados de funciones PL/SQL
-
Referencia de lenguaje PL/SQL de Oracle AI Database para obtener más información sobre la caché de resultados de funciones PL/SQL
Infraestructura de Caché de Resultados del Servidor
La caché de resultados de consulta y la caché de resultados de función PL/SQL comparten la misma infraestructura.
Tipos de Objeto: Resultado, Dependencia y Temporal
Dentro de la caché de resultados del servidor, un objeto de resultados es una estructura de datos que almacena las filas devueltas por una consulta o función PL/SQL. Un objeto de dependencia almacena los metadatos de los objetos a los que hacen referencia las consultas almacenadas como objetos de resultado.
Un resultado de consulta típico es pequeño, costoso de calcular, se reutiliza a menudo y se basa en tablas no volátiles. Sin embargo, los resultados a veces pueden ser grandes. Si un resultado de consulta supera el límite de tamaño, la base de datos almacena parte del resultado como un objeto de plantilla y parte como un objeto de resultado estándar. Un objeto temporal es una recopilación de metadatos de caché de resultados que apunta a un segmento de tablespace temporal que contiene el resultado de la consulta real.
Subcachés de resultados
Según la carga de trabajo, la base de datos puede crear subcachés de resultados para soportar una mayor simultaneidad durante el acceso de lectura/escritura. Oracle AI Database utiliza un algoritmo interno para decidir si se crean subcachés y, en caso afirmativo, cuántos se deben crear.
Interfaz de usuario de caché de resultados del servidor
El parámetro de inicialización RESULT_CACHE_MODE determina si la caché de resultados de consulta SQL se utiliza para todas las consultas posibles o solo para consultas con indicaciones.
El parámetro de inicialización RESULT_CACHE_MAX_TEMP_SIZE controla la cantidad máxima de memoria de tablespace temporal que la caché de resultados puede consumir en la PDB. RESULT_CACHE_MAX_TEMP_RESULT controla la cantidad máxima de memoria de tablespace temporal que puede consumir una consulta almacenada en caché.
Para sustituir el valor del parámetro RESULT_CACHE_MODE, puede anotar una consulta o un fragmento de consulta con una indicación RESULT_CACHE. A partir de Oracle Database 21c, la indicación acepta la opción TEMP={TRUE|FALSE}, que controla si los resultados se pueden almacenar en un tablespace temporal.
El paquete DBMS_RESULT_CACHE permite administrar la parte del pool compartido que utilizan la caché de resultados SQL y la caché de resultados de funciones PL/SQL. Puede invalidar objetos, consultas y objetos de listas de bloqueo, y realizar operaciones relacionadas.
La columna V$RESULT_CACHE_OBJECTS.TYPE indica el tipo de objetos de la caché. Si los resultados de la consulta se almacenan en un tablespace temporal, TYPE muestra dos objetos: Result y Temp. Se puede acceder a los metadatos de subcaché mediante V$RESULT_SUBCACHE_STATISTICS y las vistas relacionadas.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener información sobre el tamaño y el control del comportamiento de la caché de resultados
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener información sobre el paquete
DBMS_RESULT_CACHE -
Oracle AI Database Performance Tuning Guide para obtener más información sobre la caché de resultados del cliente
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
RESULT_CACHE_MODE -
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la indicación
RESULT_CACHE
Pool reservado
El pool reservado es un área de memoria en el pool compartido que Oracle AI Database puede utilizar para asignar grandes fragmentos contiguos de memoria.
La base de datos asigna memoria del pool compartido en fragmentos. La fragmentación permite cargar objetos grandes (más de 5 KB) en la caché sin necesidad de un único área contigua. De esta forma, la base de datos reduce la posibilidad de quedarse sin memoria contigua debido a la fragmentación.
Con poca frecuencia, los cursores Java, PL/SQL o SQL pueden realizar asignaciones desde el pool compartido que tienen más de 5 KB. Para permitir que estas asignaciones se realicen de forma más eficaz, la base de datos segrega una pequeña cantidad del pool compartido para el pool reservado.
Consulte también: Guía de ajuste de rendimiento de Oracle AI Database para aprender a configurar el pool reservado
Piscina grande
La agrupación grande es un área de memoria opcional diseñada para asignaciones de memoria que son más grandes de lo adecuado para el pool compartido.
La agrupación grande puede proporcionar grandes asignaciones de memoria para lo siguiente:
-
Buffers de mensajes utilizados en la ejecución en paralelo
-
Buffers para procesos secundarios de E/S de Recovery Manager (RMAN)
-
Buffers para inserciones diferidas (inserciones con la indicación
MEMOPTIMIZE_WRITE)
En la siguiente figura, se muestra la agrupación grande.
Figura 7: Piscina grande
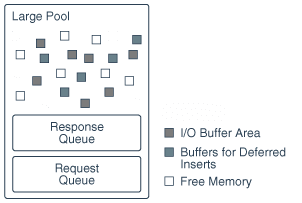
Descripción de la ilustración cncpt221.png
-
Gestión de memoria de pool grande El pool grande gestiona la memoria de forma diferente a la del pool compartido, que utiliza una lista de LRU para que las partes de la memoria se agoten.
-
Bufers de agrupaciones grandes para inserciones diferidas Para un tipo especial de inserción conocido como inserción diferida, la base de datos asigna buffers de la agrupación grande.
Consulte además:
-
"Query Coordinator" para obtener información sobre la asignación de memoria para la ejecución en paralelo
-
"Colas de Solicitud y Respuesta del Distribuidor" para obtener más información sobre la asignación de memoria de sesión para el servidor compartido
-
Guía de desarrollo de Oracle AI Database para obtener información sobre Oracle XA
-
Guía de ajuste de rendimiento de Oracle AI Database para obtener más información sobre el pool grande
Gestión de Memoria de Pool Grande
El pool grande gestiona la memoria de forma diferente a la del pool compartido, que utiliza una lista LRU para que las partes de la memoria se agoten.
La agrupación grande no tiene una lista de LRU. Cuando la base de datos asigna memoria de pool grande a una sesión de base de datos, esta memoria no se puede liberar a menos que la sesión la libere. Tan pronto como se libera una parte de la memoria, otros procesos pueden usarla. Al asignar memoria de sesión desde el pool grande, la base de datos evita la fragmentación que se puede producir en el pool compartido.
Buffers de pool grandes para inserciones diferidas
Para un tipo especial de inserción conocido como inserción diferida, la base de datos asigna buffers de la agrupación grande.
Para las inserciones rápidas de "inicio y olvido" desde aplicaciones de Internet of Things (IoT), la infraestructura de base de datos crea sobrecarga de rendimiento. Por ejemplo, la ruta de código incluye la navegación de la caché de buffers, los pines de buffer y las protecciones de simultaneidad. Las inserciones de matriz minimizan estos costos, pero la matriz debe crearse en el lado del cliente, lo que no es típico para las aplicaciones de Internet of Things. Para solucionar este problema, una aplicación de Oracle puede utilizar una indicación para insertar filas en una tabla especificada como MEMOPTIMIZE FOR WRITE.
Las inserciones se aplazan porque se almacenan en buffer en el pool grande y, a continuación, los procesos en segundo plano las escriben en el disco de forma asíncrona. Los procesos de base de datos aplazan las inserciones de la siguiente manera:
-
La aplicación envía inserciones
MEMOPTIMIZE_WRITEa una capa media, que puede agregar los datos. Aunque una aplicación IoT casi siempre enviará inserciones a la capa media, también es posible enviar inserciones directamente a la base de datos. Por ejemplo, con SQL*Plus se envían las inserciones directamente a la base de datos. -
La capa media escribe la agregación de inserciones en el servidor de base de datos.
-
Opcionalmente, el cliente de capa media conserva una copia local de los datos que escribió en el paso anterior.
-
Un proceso de servidor escribe datos en un buffer o buffers en el pool grande.
Para evitar la contención, cada buffer tiene su propio mecanismo de bloqueo interno. Este mecanismo de bloqueo es independiente del mecanismo de bloqueo que utiliza la caché de buffers de la base de datos para sus buffers. El proceso de escritura básico es el siguiente:
-
Después del inicio de la instancia, la primera inserción
MEMOPTIMIZE_WRITEasigna los buffers del pool grande. -
El escritor selecciona un buffer de la lista de buffers disponibles.
-
Si el buffer seleccionado no está bloqueado y si este buffer tiene espacio libre, el cliente escribe en el buffer, marcando cada escritura de buffer con un número de secuencia específico de la sesión. Si no es así, el escritor vuelve al paso anterior y continúa de esta manera hasta que se encuentre un buffer o se haya liberado suficiente espacio en el pool grande.
-
-
La base de datos crea una matriz de servidor a partir de los datos almacenados en buffer.
-
El coordinador de gestión de espacio (SMCO) y sus procesos auxiliares (Wnnn) escriben la matriz en el disco de forma asíncrona mediante el formato de bloque de datos estándar.
A diferencia de las inserciones estándar, las inserciones diferidas se confirman automáticamente y no se puede realizar un rollback. La base de datos confirma las inserciones en un objeto determinado en el orden en que aparecen en una sesión. No hay garantía de ordenar entre objetos o sesiones.
La base de datos soporta restricciones y mantenimiento de índices al igual que para inserciones normales. Sin embargo, la base de datos realiza evaluaciones durante la escritura en el disco, no durante la escritura en la agrupación grande.
Nota: Para obtener el mejor rendimiento, Oracle recomienda desactivar las restricciones.
En la siguiente figura, se muestra el flujo de trabajo de las inserciones diferidas.
Figura 8: Diferido InsertMechanism
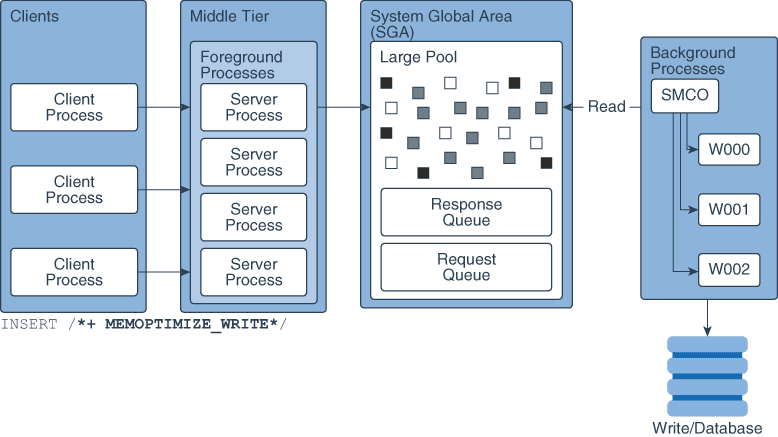
Descripción de la ilustración cncpt_pb_002a.png
Consulte además:
-
Oracle AI Database Performance Tuning Guide para aprender a especificar tablas como
MEMOPTIMIZE FOR WRITE -
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
INSERT -
Referencia de Oracle AI Database para obtener más información sobre
MEMOPTIMIZE_POOL_SIZE
Pool Java
El pool Java es un área de memoria que almacena todos el código Java específico de una sesión y los datos dentro de Java Virtual Machine (JVM). Esta memoria incluye objetos Java que se migran al espacio de sesión Java al final de la llamada.
Para las conexiones de servidor dedicado, el pool Java incluye la parte compartida de cada clase Java, incluidos los métodos y la memoria de solo lectura, como los vectores de código, pero no el estado Java por sesión de cada sesión. Para el servidor compartido, el pool incluye la parte compartida de cada clase y algunos UGA utilizados para el estado de cada sesión. Cada UGA crece y se reduce según sea necesario, pero el tamaño total de UGA debe caber en el espacio del pool Java.
Las estadísticas del Asesor de Pool Java proporcionan información sobre la memoria de caché de biblioteca utilizada para Java y predicen cómo los cambios en el tamaño del pool Java pueden afectar al ratio de análisis. El Asesor de Pool Java se activa internamente cuando statistics_level se define en TYPICAL o superior. Estas estadísticas se restablecen cuando el asesor está desactivado.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para obtener más información sobre las vistas que contienen estadísticas de asesoramiento del pool Java
SGA fija
El SGA fijo es un área interna de mantenimiento.
Por ejemplo, el SGA fijo contiene:
-
Información general sobre el estado de la base de datos y la instancia a la que deben acceder los procesos en segundo plano
-
Información comunicada entre procesos, como información sobre bloqueos
El tamaño del SGA fijo lo define Oracle AI Database y no se puede modificar manualmente. El tamaño de SGA fijo puede cambiar de una versión a otra.
Consulte también: "Visión General de Bloqueos Automáticos"
Subáreas SGA opcionales relacionadas con el rendimiento
Algunas subáreas de SGA solo están activadas para funciones de rendimiento específicas.
Esta sección incluye los siguientes temas:
-
Área en memoria El área en memoria es un componente de SGA opcional que contiene el almacén de columnas en memoria (almacén de columnas de IM).
-
Memoptimizar pool: memoptimizar pool almacena buffers y estructuras relacionadas para tablas organizadas por pilas especificadas como
MEMOPTIMIZE FOR READ.
Área en Memoria
El área en memoria es un componente SGA opcional que contiene el almacén de columnas en memoria (almacén de columnas de IM).
El almacén de columnas de IM contiene copias de tablas, particiones y vistas materializadas en un formato de columna optimizado para exploraciones rápidas. El almacén de columnas de IM complementa la caché de buffers de la base de datos, que almacena datos en formato de fila tradicional.
Nota: Para activar un almacén de columnas de IM, debe tener la opción Oracle AI Database In-Memory.
Consulte también: Guía de Oracle AI Database In-Memory para obtener más información sobre el área en memoria y el almacén de columnas de IM
Pool de Memoptimize
El poolmemoptimize almacena buffers y estructuras relacionadas para tablas organizadas por pilas especificadas como MEMOPTIMIZE FOR READ.
Esta estructura proporciona un alto rendimiento y escalabilidad para consultas basadas en claves, como SELECT * FROM cust WHERE cid = 10. Para reducir el tiempo de respuesta integral, los clientes extraen los buffers solicitados directamente desde la SGA a través de la red, evitando la sobrecarga de la CPU y el sistema operativo. Las aplicaciones pueden beneficiarse del grupo de memoptimización sin necesidad de cambios de código.
El pool memoptimize contiene dos partes:
-
Área de buffer de Memoptimize
Para evitar la E/S de disco, la base de datos bloquea permanentemente los buffers para las tablas
MEMOPTIMIZE FOR READen el pool memoptimize, hasta que la tabla se marque comoNO MEMOPTIMIZE FOR READ. Los buffers de memoptimize utilizan la misma estructura que los buffers de la caché de buffers de la base de datos. Sin embargo, los buffers del pool memoptimize están completamente separados de la caché de buffers de la base de datos y no cuentan para su tamaño. El área de memoria intermedia memoptimize ocupa el 75% de la piscina memoptimize. -
Índice hash
Un índice hash es una estructura de datos de segmento no persistente. La base de datos asigna el índice hash como varias unidades de memoria no contiguas. Cada unidad contiene una serie de cubos hash. Una estructura de mapa independiente correlaciona una unidad de memoria con una clave primaria. El índice hash ocupa el 25% del pool memoptimize. Figura 9: Memoptimize Pool
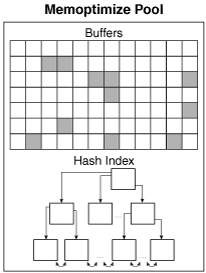
Descripción de la ilustración cncpt_pb_001a.png
Para activar el pool memoptimize, defina el parámetro de inicialización MEMOPTIMIZE_POOL_SIZE en un valor entero (el pool está desactivado por defecto). El valor especifica la cantidad de SGA que se debe asignar al pool. El valor MEMOPTIMIZE_POOL_SIZE cuenta para SGA_TARGET, pero la base de datos no aumenta ni reduce el pool memoptimize automáticamente. Por ejemplo, si SGA_TARGET es 10 GB y MEMOPTIMIZE_POOL_SIZE es 1 GB, hay un total de 9 GB disponibles para la memoria SGA que no sea el pool memoptimize.
Para cambiar el tamaño del pool memoptimize, debe definir MEMOPTIMIZE_POOL_SIZE manualmente y reiniciar la instancia de base de datos. No puede cambiar el tamaño del pool de forma dinámica mediante ALTER SYSTEM.
El paquete DBMS_MEMOPTIMIZE permite rellenar explícitamente una tabla en el pool memoptimize.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para aprender a mejorar el rendimiento de las consultas mediante la activación del pool memoptimize
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre el paquete
DBMS_MEMOPTIMIZE -
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre
CREATE TABLE ... MEMOPTIMIZE FOR READ -
Referencia de Oracle AI Database para obtener más información sobre
MEMOPTIMIZE_POOL_SIZE
Visión General del Área Global de Programa (PGA)
PGA es la memoria específica de un proceso operativo o thread que no comparte otros procesos o threads en el sistema. Puesto que el PGA es específico del proceso, nunca se asigna en el SGA.
PGA es una pila de memoria que contiene variables dependientes de la sesión requeridas por un proceso de servidor dedicado o compartido. El proceso de servidor asigna las estructuras de memoria que necesita en el PGA.
Una analogía para una PGA es un espacio de trabajo de encimera temporal utilizado por un empleado de archivos. En esta analogía, el administrador de archivos es el proceso del servidor que trabaja en nombre del cliente (proceso del cliente). El empleado borra una sección de la encimera, utiliza el espacio de trabajo para almacenar detalles sobre la solicitud del cliente y para ordenar las carpetas solicitadas por el cliente y, a continuación, deja el espacio cuando se realiza el trabajo.
En la siguiente figura se muestra una instancia de PGA (recopilación de todas las PGA) para una instancia que no está configurada para servidores compartidos. Puede utilizar un parámetro de inicialización para definir un tamaño máximo de destino de la instancia PGA. Los PGA individuales pueden crecer según sea necesario hasta este tamaño objetivo.
Figura 10: PGA de Instancia
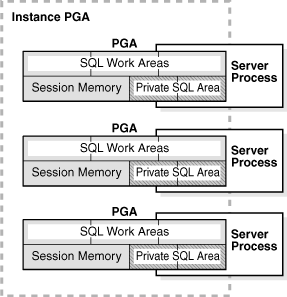
Descripción de la ilustración cncpt218.gif
Nota: Los procesos en segundo plano también asignan sus propios PGA. Esta discusión se centra únicamente en las PGA de procesos de servidor.
-
Contenido de la PGA: el PGA se subdivide en diferentes áreas, cada una con una finalidad diferente.
-
La asignación de memoria PGA Uso de PGA en Modos de Servidor Dedicado y Compartido depende de si la base de datos utiliza conexiones de servidor dedicadas o compartidas. Consulte también: Guía de ajuste de rendimiento de Oracle AI Database para obtener una visión general de la gestión de memoria PGA
Contenido de la PGA
El PGA se subdivide en diferentes áreas, cada una con un propósito diferente.
En la siguiente figura, se muestra el posible contenido de la PGA para una sesión de servidor dedicado. No todas las áreas de PGA existirán en todos los casos.
Figura 11: Contenido de PGA
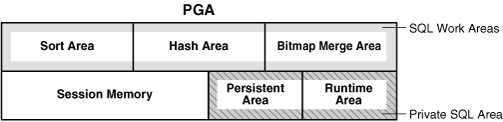
Descripción de la ilustración cncpt219.gif
-
Área SQL privada Un área SQL privada contiene información sobre una sentencia SQL analizada y otra información específica de la sesión para su procesamiento.
-
Áreas de trabajo de SQL Un área de trabajo es una asignación privada de memoria PGA utilizada para operaciones que hacen un uso intensivo de la memoria.
Área SQL Privada
Un área SQL privada contiene información sobre una sentencia SQL analizada y otra información específica de la sesión para su procesamiento.
Cuando un proceso de servidor ejecuta código SQL o PL/SQL, el proceso utiliza el área SQL privada para almacenar valores de variable de enlace, información de estado de ejecución de consultas y áreas de trabajo de ejecución de consultas.
No confunda un área SQL privada, que está en la PGA, con el área SQL compartida, que almacena los planes de ejecución en la SGA. Varias áreas SQL privadas en la misma sesión o en diferentes sesiones pueden apuntar a un único plan de ejecución en SGA. Por ejemplo, 20 ejecuciones de SELECT * FROM sales en una sesión y 10 ejecuciones de la misma consulta en una sesión diferente pueden compartir el mismo plan. Las áreas SQL privadas para cada ejecución no se comparten y pueden contener valores y datos diferentes.
Un cursor es un nombre o un manejador para un área SQL privada específica. Como se muestra en el siguiente gráfico, puede pensar en un cursor como un puntero en el cliente y como un estado en el servidor. Puesto que los cursores están estrechamente asociados a áreas SQL privadas, los términos a veces se utilizan indistintamente.
Figura 12: Cursor
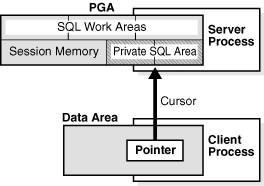
Descripción de la ilustración cncpt324.gif
Un área SQL privada se divide en las siguientes áreas:
-
El área de tiempo de ejecución
Esta área contiene información de estado de ejecución de consulta. Por ejemplo, el área de tiempo de ejecución realiza un seguimiento del número de filas recuperadas hasta el momento en una exploración completa de la tabla.
Oracle AI Database crea el área de tiempo de ejecución como el primer paso de una solicitud de ejecución. Para las sentencias DML, el área de tiempo de ejecución se libera cuando se cierra la sentencia SQL.
-
El área persistente
Esta área contiene valores de variable de enlace. Se proporciona un valor de variable de enlace a una sentencia SQL en tiempo de ejecución cuando se ejecuta la sentencia. El área persistente se libera solo cuando se cierra el cursor.
El proceso de cliente es responsable de gestionar las áreas SQL privadas. La asignación y desasignación de áreas SQL privadas depende en gran medida de la aplicación, aunque el número de áreas SQL privadas que puede asignar un proceso de cliente está limitado por el parámetro de inicialización OPEN_CURSORS.
Aunque la mayoría de los usuarios confían en el manejo automático de cursores de las utilidades de base de datos, las interfaces programáticas de Oracle AI Database ofrecen a los desarrolladores más control sobre los cursores. En general, las aplicaciones deben cerrar todos los cursores abiertos que no se volverán a utilizar para liberar el área persistente y minimizar la memoria necesaria para los usuarios de la aplicación.
Consulte además:
-
Oracle AI Database Development Guide y Oracle AI Database PL/SQL Language Reference para aprender a utilizar cursores
Áreas de Trabajo de SQL
Un área de trabajo es una asignación privada de memoria PGA utilizada para operaciones que hacen un uso intensivo de la memoria.
Por ejemplo, un operador de ordenación utiliza el área de ordenación para ordenar un juego de filas. Del mismo modo, un operador de unión hash utiliza un área hash para crear una tabla hash a partir de su entrada izquierda, mientras que una fusión de mapa de bits utiliza el área de fusión de mapa de bits para fusionar los datos recuperados de exploraciones de varios índices de mapa de bits.
En el siguiente ejemplo, se muestra una unión de employees y departments con su plan de consulta:
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------
En el ejemplo anterior, el área de tiempo de ejecución realiza un seguimiento del progreso de las exploraciones de tablas completas. La sesión realiza una unión hash en el área hash para que coincida con las filas de las dos tablas. La ordenación ORDER BY se produce en el área de ordenación.
Si la cantidad de datos que deben procesar los operadores no encaja en un área de trabajo, Oracle AI Database divide los datos de entrada en partes más pequeñas. De esta forma, la base de datos procesa algunas partes de datos en memoria mientras escribe el resto en el almacenamiento de disco temporal para su procesamiento posterior.
La base de datos ajusta automáticamente los tamaños del área de trabajo cuando se activa la gestión automática de memoria PGA. También puede controlar y ajustar manualmente el tamaño de un área de trabajo.
Por lo general, las áreas de trabajo más grandes pueden mejorar significativamente el rendimiento de un operador a costa de un mayor consumo de memoria. De manera óptima, el tamaño de un área de trabajo es suficiente para acomodar los datos de entrada y las estructuras de memoria auxiliares asignadas por su operador SQL asociado. Si no es así, el tiempo de respuesta aumenta porque parte de los datos de entrada se deben almacenar en caché en disco. En el caso extremo, si el tamaño de un área de trabajo es demasiado pequeño en comparación con el tamaño de los datos de entrada, la base de datos debe realizar varias transferencias a través de las partes de datos, lo que aumenta drásticamente el tiempo de respuesta.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a utilizar la gestión automática de PGA
-
Guía de ajuste de rendimiento de Oracle AI Database para aprender a ajustar la memoria PGA
Uso de PGA en Modos de Servidor Dedicado y Compartido
La asignación de memoria PGA depende de si la base de datos utiliza conexiones de servidor dedicadas o compartidas.
En la tabla siguiente se muestran las diferencias.
Tabla 1 Diferencias en la asignación de memoria entre servidores dedicados y compartidos
| Área de memoria | Servidor Dedicado | Servidor Compartido |
|---|---|---|
| Naturaleza de la memoria de la sesión | Privado | Compartido |
| Ubicación del área persistente | PGA | SGA |
| Ubicación del área de tiempo de ejecución para sentencias DML y DDL | PGA | PGA |
Consulte también: Guía del administrador de Oracle AI Database para aprender a configurar una base de datos para un servidor compartido
Visión General del Área Global de Usuario
UGA es la memoria de sesión, que es la memoria asignada para las variables de sesión, como la información de conexión y otra información necesaria para una sesión de base de datos. Básicamente, el UGA almacena el estado de la sesión.
En la siguiente figura, se muestra el UGA.
Figura 13: Área Global de Usuario (UGA)
Descripción de la ilustración cncpt222.gif
Si una sesión carga un paquete PL/SQL en la memoria, el UGA contiene el estado del paquete, que es el juego de valores almacenados en todas las variables del paquete en un momento específico. El estado del paquete cambia cuando un subprograma de paquete cambia las variables. Por defecto, las variables de paquete son únicas y persisten durante toda la sesión.
El pool de páginas OLAP también se almacena en el UGA. Esta agrupación gestiona páginas de datos de OLAP, que son equivalentes a los bloques de datos. El pool de páginas se asigna al inicio de una sesión OLAP y se libera al final de la sesión. Una sesión OLAP se abre automáticamente cada vez que un usuario consulta un objeto dimensional, como un cubo.
El UGA debe estar disponible para una sesión de base de datos mientras dure la sesión. Por este motivo, el UGA no se puede almacenar en el PGA al utilizar una conexión de servidor compartido porque el PGA es específico de un único proceso. Por lo tanto, el UGA se almacena en el MGA al utilizar conexiones de servidor compartido, lo que permite que cualquier proceso de servidor compartido acceda a él. Al utilizar una conexión de servidor dedicado, el UGA se almacena en el PGA.
Consulte además:
-
Oracle AI Database Net Services Administrator's Guide para obtener información sobre las conexiones de servidor compartido
Visión General del Área Global Gestionada (MGA)
El área global gestionada (MGA) es un marco de memoria único que tiene la capacidad de compartir y coordinar la memoria en un juego de procesos de Oracle de confianza.
Tiene la capacidad de ser un área de memoria compartida configurable, flexible, modular, a demanda y recuperable. MGA proporciona una forma de utilizar diferentes tipos de áreas de memoria compartida en la base de datos. Se muestra como espacios de nombres para las capas internas de la base de datos, cada una de las cuales pertenece solo a una de ellas. Un espacio de nombres consiste principalmente en un juego de segmentos de memoria compartida y metadatos que lo acompañan.
Las capas de la base de datos pueden definir las características, el ámbito, la duración y el tamaño del segmento interno del espacio de nombres. Todos los MGA se contabilizan bajo el límite agregado de PGA.
En Linux, MGA necesita tempfs montado en /dev/shm y está configurado al menos en el tamaño del límite agregado de PGA. Cuando se ejecutan varias instancias en la misma máquina, el tamaño de /dev/shm debe ser al menos sum(PGA_AGGREGATE_LIMIT) en todas las instancias.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para obtener más información sobre el tamaño de gránulos
Descripción general de áreas de código de software
Un área de código de software es una parte de la memoria que almacena el código que se está ejecutando o que se puede ejecutar. El código de Oracle AI Database se almacena en un área de software que suele ser más exclusiva y protegida que la ubicación de los programas de usuario.
Las áreas de software suelen tener un tamaño estático, y solo cambian cuando el software se actualiza o se vuelve a instalar. El tamaño requerido de estas áreas varía según el sistema operativo.
Las áreas de software son de solo lectura y se pueden instalar compartidas o no compartidas. Algunas herramientas y utilidades de base de datos, como Oracle Forms y SQL*Plus, se pueden instalar compartidas, pero algunas no. Cuando es posible, el código de base de datos se comparte para que todos los usuarios puedan acceder a él sin tener varias copias en la memoria, lo que resulta en una reducción de la memoria principal y una mejora general del rendimiento. Varias instancias de una base de datos pueden utilizar la misma área de código de base de datos con diferentes bases de datos si se ejecutan en la misma computadora. Nota: La opción de instalar software compartido no está disponible para todos los sistemas operativos, por ejemplo, en PC que utilicen Microsoft Windows. Consulte la documentación específica del sistema operativo para obtener más información.