Arquitectura de Aplicaciones y Oracle Net Services
En este capítulo se define la arquitectura de la aplicación y se describe cómo funcionan las aplicaciones de bases de datos y bases de datos Oracle en un entorno de procesamiento distribuido. Este material se aplica a casi todos los tipos de entornos de Oracle AI Database.
-
Visión General de la Arquitectura de Aplicaciones de Oracle En el contexto de este capítulo, la arquitectura de aplicaciones hace referencia al entorno informático en el que una aplicación de base de datos se conecta a una base de datos Oracle.
-
Visión General de la Arquitectura de Oracle Net Services
Oracle Net Services es un conjunto de componentes de red que proporciona soluciones de conectividad para toda la empresa en entornos informáticos distribuidos y heterogéneos.
-
Visión general de la interfaz de programa La interfaz de programa es la capa de software entre una aplicación de base de datos y Oracle AI Database.
-
Visión General de Oracle True Cache True Cache es una caché en memoria de solo lectura delante de Oracle AI Database.
Visión General de la Arquitectura de Aplicaciones de Oracle
En el contexto de este capítulo, la arquitectura de aplicación hace referencia al entorno informático en el que una aplicación de base de datos se conecta a una base de datos Oracle.
-
Visión general de la arquitectura de cliente/servidor En el entorno de Oracle AI Database, la aplicación de base de datos y la base de datos se separan en una arquitectura de cliente/servidor.
-
Visión General de la Arquitectura de Varios Niveles En una arquitectura tradicional de varios niveles, un servidor de aplicaciones proporciona datos para los clientes y sirve como interfaz entre los clientes y los servidores de bases de datos.
-
Visión general de la arquitectura de grid En un entorno de Oracle AI Database, la computación de cuadrícula es una arquitectura informática que agrupa eficazmente un gran número de servidores y almacenamiento en un recurso informático flexible bajo demanda.
Descripción general de la arquitectura de cliente/servidor
En el entorno de Oracle AI Database, la aplicación de base de datos y la base de datos se separan en una arquitectura de cliente/servidor.
Los componentes son los siguientes:
-
El cliente ejecuta la aplicación de base de datos, por ejemplo, SQL*Plus o un programa de entrada de datos de Visual Basic, que accede a la información de la base de datos e interactúa con un usuario.
-
El servidor ejecuta el software de Oracle AI Database y gestiona las funciones necesarias para el acceso simultáneo a datos compartidos a una base de datos Oracle.
Aunque la aplicación cliente y la base de datos pueden ejecutarse en la misma computadora, a menudo se logra una mayor eficiencia cuando las partes cliente y servidor son ejecutadas por diferentes computadoras conectadas a través de una red. En las siguientes secciones, se analizan las variaciones en la arquitectura de cliente/servidor de Oracle AI Database.
-
Procesamiento distribuido El uso de varios hosts para procesar una tarea individual se conoce como procesamiento distribuido.
-
Ventajas de una arquitectura de cliente/servidor La arquitectura de cliente/servidor de Oracle AI Database en un entorno de procesamiento distribuido proporciona una serie de ventajas.
Procesamiento distribuido
El uso de varios hosts para procesar una tarea individual se conoce como procesamiento distribuido.
El procesamiento de front-end y back-end se produce en diferentes equipos. En la Figura 19-1, el cliente y el servidor se encuentran en diferentes hosts conectados mediante Oracle Net Services.
Figura 1: Arquitectura cliente/servidor y procesamiento distribuido
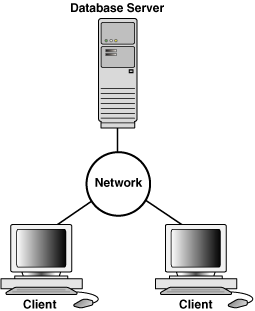
Descripción de la ilustración cncpt083.gif
La Figura 19-2 es una variación que representa una base de datos distribuida. En este ejemplo, una base de datos en un host accede a los datos de una base de datos independiente ubicada en un host diferente.
Figura 2: Arquitectura Cliente/Servidor y Base de Datos Distribuida
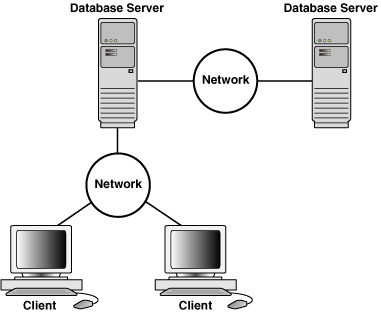
Descripción de la ilustración cncpt240.gif
Nota: El resto de este capítulo se aplica a los entornos con una base de datos en un servidor.
Ventajas de una Arquitectura de Cliente/Servidor
La arquitectura de cliente/servidor de Oracle AI Database en un entorno de procesamiento distribuido proporciona una serie de ventajas.
Estas son algunas de las ventajas:
-
Las aplicaciones cliente no son responsables de realizar el procesamiento de datos. En su lugar, solicitan la entrada de los usuarios, solicitan datos del servidor y luego analizan y presentan estos datos utilizando las capacidades de visualización de la estación de trabajo del cliente o el terminal (por ejemplo, utilizando gráficos u hojas de cálculo).
-
Las aplicaciones cliente no dependen de la ubicación física de los datos. Incluso si los datos se mueven o distribuyen a otros servidores de base de datos, la aplicación sigue funcionando con poca o ninguna modificación.
-
Oracle AI Database aprovecha las instalaciones de multitarea y memoria compartida de su sistema operativo subyacente. Por lo tanto, ofrece el mayor grado posible de simultaneidad, integridad de datos y rendimiento a sus aplicaciones cliente.
-
Las estaciones de trabajo o terminales de los clientes se pueden optimizar para la presentación de datos (por ejemplo, proporcionando soporte de gráficos y mouse), mientras que el servidor se puede optimizar para el procesamiento y almacenamiento de datos (por ejemplo, al tener grandes cantidades de memoria y espacio en disco).
-
En entornos de red, puede utilizar estaciones de trabajo de cliente de bajo costo para acceder a los datos remotos del servidor de manera efectiva.
-
La base de datos se puede ampliar a medida que el sistema crece. Puede agregar varios servidores para distribuir la carga de procesamiento de la base de datos en toda la red (escalada horizontalmente), o puede mover la base de datos a un minicomputador o mainframe para aprovechar el rendimiento de un sistema más grande (escalada verticalmente). En cualquier caso, los datos y las aplicaciones se mantienen con poca o ninguna modificación porque Oracle AI Database es portátil entre sistemas.
-
En entornos de red, los datos compartidos se almacenan en los servidores en lugar de en todos los equipos, lo que facilita y hace más eficiente la gestión del acceso simultáneo.
-
En entornos de red, las aplicaciones cliente envían solicitudes de base de datos al servidor mediante sentencias SQL. Una vez recibida, el servidor procesa cada sentencia SQL, que devuelve los resultados al cliente. El tráfico de red se minimiza porque solo las solicitudes y los resultados se envían a través de la red.
Consulte también: Guía del administrador de Oracle AI Database para obtener más información sobre las bases de datos distribuidas
Visión General de la Arquitectura de Varios Niveles
En una arquitectura tradicional de varios niveles, un servidor de aplicaciones proporciona datos para los clientes y sirve como interfaz entre los clientes y los servidores de bases de datos.
Esta arquitectura permite utilizar un servidor de aplicaciones para:
-
Validar las credenciales de un cliente, como un explorador web
-
Conectar a un Servidor de Base de Datos
-
Realización de la operación solicitada
En la Figura 19-3 aparece un ejemplo de arquitectura de varios niveles.
Figura 3: Entorno de Arquitectura de Varios Niveles
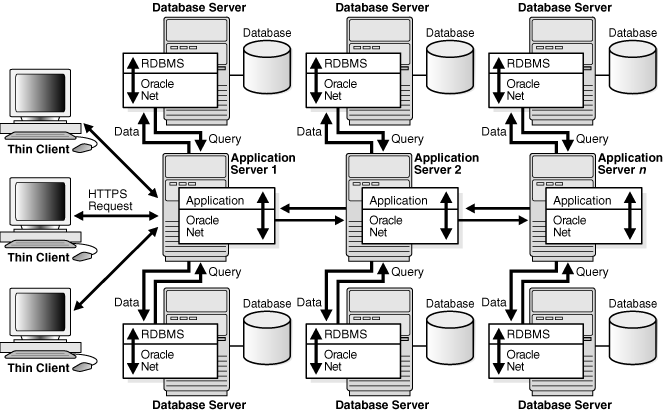
Descripción de la ilustración cncpt121.gif
-
Clientes Un cliente inicia una solicitud para que se realice una operación en el servidor de base de datos.
-
Servidores de Aplicaciones Un servidor de aplicaciones proporciona acceso a los datos del cliente. Sirve como una interfaz entre el cliente y uno o más servidores de base de datos, y aloja las aplicaciones.
-
Servidores de base de datos Un servidor de base de datos proporciona los datos solicitados por un servidor de aplicaciones en nombre de un cliente. La base de datos realiza el procesamiento de consultas.
-
Arquitectura orientada a servicios (SOA) La base de datos puede servir como proveedor de servicios web en entornos tradicionales de varias capas o arquitectura orientada a servicios (SOA).
Clientes
Un cliente inicia una solicitud para que se realice una operación en el servidor de base de datos.
El cliente puede ser un explorador web u otro programa de usuario final. En una arquitectura de varios niveles, el cliente se conecta al servidor de base de datos a través de uno o más servidores de aplicaciones.
Servidores de aplicaciones
Un servidor de aplicaciones proporciona acceso a los datos del cliente. Sirve como una interfaz entre el cliente y uno o más servidores de base de datos, y aloja las aplicaciones.
Un servidor de aplicaciones permite a los clientes delgados, que son clientes equipados con configuraciones de software mínimas, acceder a las aplicaciones sin necesidad de mantenimiento continuo de las computadoras cliente. El servidor de aplicaciones también puede realizar un nuevo formato de datos para el cliente, lo que reduce la carga en la estación de trabajo del cliente.
El servidor de aplicaciones asume la identidad del cliente cuando realiza operaciones en el servidor de base de datos para este cliente. La mejor práctica es restringir los privilegios del servidor de aplicaciones para evitar que realice operaciones innecesarias y no deseadas durante una operación de cliente.
Servidores de base de datos
Un servidor de base de datos proporciona los datos solicitados por un servidor de aplicaciones en nombre de un cliente. La base de datos realiza el procesamiento de consultas.
El servidor de base de datos puede auditar las operaciones realizadas por el servidor de aplicaciones en nombre de los clientes y en su propio nombre. Por ejemplo, una operación de cliente puede solicitar información que se muestre en el cliente, mientras que una operación de servidor de aplicaciones puede solicitar una conexión al servidor de base de datos.
En la auditoría unificada, la base de datos puede agregar contextos de aplicación, que son pares de nombre y valor específicos de la aplicación, a los registros de la pista de auditoría unificada. Puede configurar qué contextos de aplicación escribe la base de datos en los registros de auditoría de la base de datos.
Consulte también: Guía de seguridad de Oracle AI Database para obtener una introducción a la auditoría
Arquitectura Orientada a Servicios (SOA)
La base de datos puede servir como proveedor de servicios web en entornos tradicionales de varios niveles o de arquitectura orientada a servicios (SOA).
SOA es una arquitectura de varios niveles que depende de servicios que soportan la interacción de computadora a computadora a través de una red. En el contexto de SOA, un servicio es un punto final funcional autosuficiente que tiene una funcionalidad y un acuerdo de nivel de servicio bien definidos, que se puede supervisar y gestionar y que puede ayudar a aplicar el cumplimiento de políticas.
Los servicios SOA se suelen implantar como servicios web a los que se puede acceder mediante el protocolo HTTP. Se basan en estándares XML como WSDL y SOAP.
La capacidad de servicio web de Oracle AI Database, que se implanta como parte de Oracle XML DB, debe estar activada específicamente por el DBA. A continuación, las aplicaciones pueden realizar lo siguiente a través de servicios web de base de datos:
-
Enviar consultas SQL o XQuery y recibir resultados como XML
-
Llamar a funciones PL/SQL autónomas y recibir resultados
-
Llamada a Funciones de Paquetes PL/SQL y Recepción de Resultados
Los servicios Web de base de datos proporcionan una forma sencilla de agregar servicios Web a un entorno de aplicación sin la necesidad de un servidor de aplicaciones. Sin embargo, la llamada a servicios web a través de servidores de aplicaciones como Oracle Fusion Middleware ofrece seguridad, escalabilidad, registro UDDI y mensajería fiable en un entorno SOA. Sin embargo, dado que los servicios Web de la base de datos se integran fácilmente con Oracle Fusion Middleware, pueden ser adecuados para optimizar las soluciones SOA.
Consulte además:
-
Oracle XML Developer's Kit Programmer's Guide para obtener información sobre la activación y el uso de servicios web de bases de datos.
-
Documentación de Oracle Fusion Middleware para obtener más información sobre los servicios web y SOA
Visión General de la Arquitectura de Grid
En un entorno de Oracle AI Database, la computación en red es una arquitectura informática que agrupa eficazmente grandes cantidades de servidores y almacenamiento en un recurso informático flexible y a demanda.
Los componentes modulares de hardware y software se pueden conectar y volver a unir bajo demanda para satisfacer las necesidades cambiantes de las empresas.
Consulte también: Guía de despliegue y administración de Oracle Clusterware para obtener información más detallada sobre las cuadrículas de almacenamiento y servidor
Visión General de la Arquitectura de Oracle Net Services
Oracle Net Services es un conjunto de componentes de red que proporciona soluciones de conectividad para toda la empresa en entornos informáticos distribuidos y heterogéneos.
Oracle Net Services permite una sesión de red desde una aplicación a una instancia de base de datos y una instancia de base de datos a otra instancia de base de datos.
Oracle Net Services proporciona transparencia para la ubicación, configuración y gestión centralizadas, así como una instalación y configuración rápidas. También le permite maximizar los recursos del sistema y mejorar el rendimiento. La arquitectura del servidor compartido aumenta la escalabilidad de las aplicaciones y el número de clientes conectados simultáneamente a la base de datos. El protocolo de interfaz virtual (VI) coloca la mayor parte de la carga de mensajería en el hardware de red de alta velocidad, liberando la CPU.
Oracle Net Services utiliza los protocolos de comunicación o las interfaces de programación de aplicaciones (API) soportadas por una amplia gama de redes para proporcionar bases de datos distribuidas y procesamiento distribuido. Una vez establecida una sesión de red, Oracle Net Services actúa como un servicio de mensajería de datos para la aplicación cliente y el servidor de base de datos, estableciendo y manteniendo una conexión e intercambiando mensajes. Oracle Net Services puede realizar estas tareas porque existen en cada equipo de la red.
-
Cómo funciona Oracle Net Services Los protocolos de Oracle AI Database aceptan sentencias SQL de la interfaz de las aplicaciones de Oracle y, a continuación, las empaquetan para su transmisión a Oracle AI Database.
-
Oracle Net Listener Oracle Net Listener (el listener) es un proceso del servidor que escucha las solicitudes de conexión de cliente entrantes y gestiona el tráfico a la base de datos. Cuando se inicia una instancia de base de datos y en varios momentos de su vida útil, la instancia se pone en contacto con un listener y establece una ruta de comunicación para esta instancia.
-
Arquitectura de servidor dedicado En una arquitectura de servidor dedicado, el proceso de servidor creado en nombre de cada proceso de cliente se denomina proceso de servidor dedicado (o proceso shadow).
-
Arquitectura de servidor compartido En una arquitectura de servidor compartido, un distribuidor dirige varias solicitudes de sesión de red entrantes a un pool de procesos de servidor compartido.
-
El pool de conexiones residentes (DRCP) de la base de datos Pool de conexiones residentes de la base de datos proporciona un pool de conexiones de servidores dedicados para escenarios de aplicaciones web típicos. Consulte también: Guía del administrador de Oracle AI Database Net Services para obtener una visión general de la arquitectura de Oracle Net
Funcionamiento de Oracle Net Services
Los protocolos de Oracle AI Database aceptan sentencias SQL de la interfaz de las aplicaciones de Oracle y, a continuación, las empaquetan para su transmisión a Oracle AI Database.
La transmisión se produce a través de una API o un protocolo de nivel superior estándar del sector soportado. Las respuestas de Oracle AI Database se empaquetan mediante el mismo mecanismo de comunicaciones de nivel superior. Este trabajo se realiza independientemente del sistema operativo de la red.
Según el sistema operativo que ejecute Oracle AI Database, el software de Oracle Net Services del servidor de base de datos podría incluir el software del controlador e iniciar un proceso adicional en segundo plano.
Consulte también: Guía del administrador de Oracle AI Database Net Services para obtener más información sobre cómo funciona Oracle Net Services
Listener de Red Oracle Net Listener
Oracle Net Listener (el listener) es un proceso del servidor que escucha las solicitudes de conexión de cliente entrantes y gestiona el tráfico a la base de datos. Cuando se inicia una instancia de base de datos y en varios momentos de su vida útil, la instancia se pone en contacto con un listener y establece una ruta de comunicación para esta instancia.
El registro del servicio permite al listener determinar si un servicio de base de datos y sus manejadores de servicios están disponibles. Un manejador de servicios es un proceso de servidor o distribuidor dedicado que actúa como punto de conexión a una base de datos. Durante el registro, el proceso LREG proporciona al listener el nombre de la instancia, los nombres del servicio de base de datos y el tipo y las direcciones de los manejadores de servicios. Esta información permite al listener iniciar un manejador de servicios cuando llega una solicitud de cliente.
En el siguiente gráfico, se muestran dos bases de datos, cada una en un host independiente. El entorno de base de datos es atendido por dos listeners, cada uno en un host independiente. El proceso LREG que se ejecuta en cada instancia de base de datos se comunica con ambos listeners para registrar la base de datos.
Figura 4: Dos Listeners
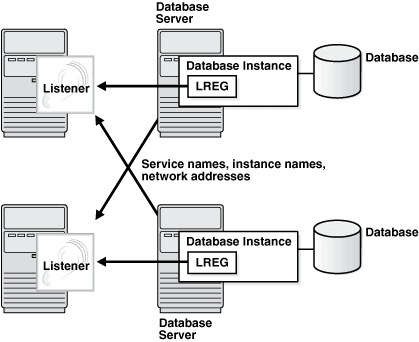
Descripción de la ilustración cncpt315.png
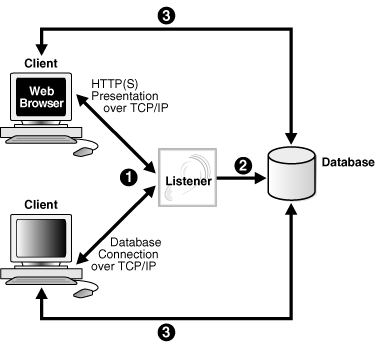
La Figura 19-5 muestra un explorador que realiza una conexión HTTP y un cliente que realiza una conexión a la base de datos a través de un listener. El listener no necesita residir en el host de la base de datos.
Figura 5: Arquitectura del Listener
Descripción de la ilustración cncpt311.gif
Los pasos básicos mediante los cuales un cliente establece una conexión a través de un listener son:
-
Un proceso de cliente u otra base de datos solicita una conexión.
-
El listener selecciona un manejador de servicios adecuado para atender la solicitud del cliente y reenvía la solicitud al manejador.
-
El proceso de cliente se conecta directamente al manejador de servicios. El oyente ya no está involucrado en la comunicación.
-
Nombres de servicio Un nombre de servicio es una representación lógica de un servicio utilizado para conexiones de cliente.
-
Los clientes de Servicios en un entorno multiinquilino deben conectarse a PDB o raíces de aplicaciones mediante servicios.
-
Registro de Servicio En la Red de Oracle, el registro de servicio es una función mediante la cual el proceso LREG registra dinámicamente la información de instancia con un listener. Consulte también: "Visión General de los Procesos del Cliente" y "Visión General de los Procesos del Servidor"
Nombres de Servicios
Un nombre de servicio es una representación lógica de un servicio utilizado para conexiones de cliente.
Cuando un cliente se conecta a un listener, solicita una conexión a un servicio. Cuando se inicia una instancia de base de datos, se registra con un listener para proporcionar uno o más servicios por nombre. Por lo tanto, el listener actúa como mediador entre el cliente y las instancias y enruta la solicitud de conexión al lugar correcto.
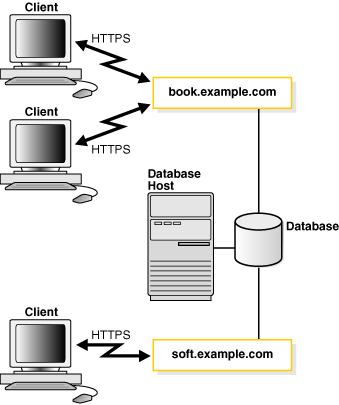
Un único servicio, conocido por un listener, puede identificar una o más instancias de base de datos. Además, una única instancia de base de datos puede registrar uno o más servicios con un listener. Los clientes que se conectan a un servicio no necesitan especificar qué instancia necesitan. La Figura 19-6 muestra una base de datos de instancia única asociada a dos servicios, book.example.com y soft.example.com. Los servicios permiten que diferentes clientes identifiquen la misma base de datos de forma diferente. Un administrador de base de datos puede limitar o reservar recursos del sistema, lo que permite una mejor asignación de recursos a los clientes que solicitan uno de estos servicios.
Figura 6: Varios Servicios Asociados a una Base de Datos
Descripción de la ilustración cncpt314.gif
Consulte también: Oracle AI Database Net Services Administrator's Guide para obtener más información sobre los métodos de nomenclatura
Servicios en un Entorno Multi-Inquilino
Los clientes deben conectarse a PDB o raíces de aplicación mediante servicios.
Una conexión que utiliza un nombre de servicio inicia una nueva sesión en una PDB o raíz de aplicación. Un proceso en primer plano, y por lo tanto una sesión, en cada momento de su vida útil, tiene un contenedor actual definido de forma única.
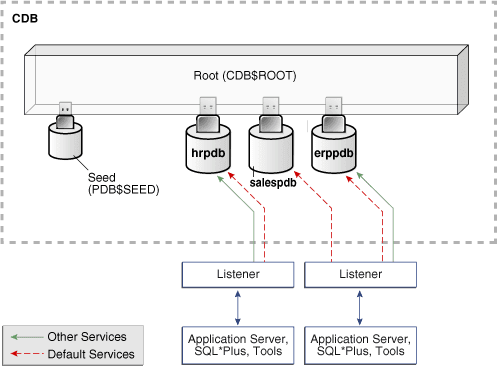
En el siguiente gráfico se muestran dos clientes que se conectan a PDB mediante dos listeners diferentes.
Figura 7: Servicios en una CDB
Descripción de la ilustración cncpt368.png
-
Creación de servicio Al ejecutar la sentencia
CREATE PLUGGABLE DATABASEpara crear una PDB, la base de datos crea e inicia automáticamente un servicio dentro de la CDB. -
Conexiones a contenedores en una CDB Normalmente, un administrador de CDB debe tener los privilegios adecuados para aprovisionar PDB y conectarse a varios contenedores. Los administradores de CDB son usuarios comunes.
Creación de Servicio
Al ejecutar la sentencia CREATE PLUGGABLE DATABASE para crear una PDB, la base de datos crea e inicia automáticamente un servicio dentro de la CDB.
El servicio por defecto tiene una propiedad que identifica la PDB como el contenedor actual inicial para el servicio. La propiedad se muestra en la columna DBA_SERVICES.PDB.
-
Servicios por Defecto El servicio por defecto tiene el mismo nombre que la PDB. El nombre de PDB debe ser un nombre de servicio válido, que debe ser único dentro de la CDB.
-
Servicios no por defecto Puede crear servicios adicionales para cada PDB, hasta un máximo de 10 000 por CDB. Cada servicio adicional denota su PDB como contenedor actual inicial.
Servicios por Defecto
El servicio por defecto tiene el mismo nombre que la PDB. El nombre de PDB debe ser un nombre de servicio válido, que debe ser único dentro de la CDB.
Al crear un contenedor de aplicación, que requiere la especificación de la cláusula AS APPLICATION CONTAINER, Oracle AI Database crea automáticamente un nuevo servicio por defecto para la raíz de aplicación. El servicio tiene el mismo nombre que el contenedor de aplicaciones. Oracle Net Services debe estar configurado correctamente para que los clientes accedan a este Servicio. Asimismo, cada PDB de aplicación tiene su propio nombre de servicio por defecto y una PDB inicial de aplicación tiene su propio nombre de servicio por defecto.
Ejemplo 19-1 Cambio a una PDB mediante un Servicio por Defecto
En este ejemplo, se cambia a los nombres de PDB salespdb mediante el servicio por defecto, que tiene el mismo nombre que la PDB:
ALTER SESSION SET CONTAINER = salespdb;Servicios no por defecto
Puede crear servicios adicionales para cada PDB, hasta un máximo de 10 000 por CDB. Cada servicio adicional denota su PDB como contenedor actual inicial.
En la Figura 19-7, existen servicios no predeterminados para erppdb y hrpdb. Por ejemplo, en la Figura 19-7, la PDB denominada hrpdb tiene un servicio por defecto denominado hrpdb. El servicio por defecto no se puede borrar.
Al cambiar a un contenedor mediante ALTER SESSION SET CONTAINER, la sesión utiliza el servicio por defecto para el contenedor. Opcionalmente, puede utilizar un servicio diferente para el contenedor especificando SERVICE = service_name, donde service_name es el nombre del servicio. Puede que desee utilizar un servicio concreto para que la sesión pueda aprovechar sus atributos y funciones de servicio, como métricas de servicio, equilibrio de carga, configuración del gestor de recursos, etc.
Ejemplo 19-2 Cambio a una PDB mediante un Servicio que no es por defecto
En este ejemplo, el servicio por defecto para hrpdb no soporta todos los atributos y funciones del servicio, como métricas de servicio, FAN, equilibrio de carga, Gestor de Recursos de Oracle AI Database, Gestor de Transacciones, Continuidad de Aplicaciones, etc. Cambie a un servicio que no sea por defecto de la siguiente manera:
ALTER SESSION SET CONTAINER = hrpdb SERVICE = hrpdb_full;Conexiones a Contenedores en una CDB
Normalmente, un administrador de CDB debe tener los privilegios adecuados para aprovisionar PDB y conectarse a varios contenedores. Los administradores de CDB son usuarios comunes.
El administrador de la CDB puede utilizar cualquiera de las siguientes técnicas:
-
Conéctese directamente a una PDB o raíz de aplicación.
El usuario necesita el privilegio
CREATE SESSIONen el contenedor. -
Utilice la sentencia
ALTER SESSION SET CONTAINER, que es útil tanto para el pool de conexiones como para la administración avanzada de CDB, para cambiar entre contenedores. La sintaxis esALTER SESSION SET CONTAINER = container_name [SERVICE = service_name].Por ejemplo, un administrador de CDB puede conectarse a la raíz en una sesión y, a continuación, en la misma sesión, cambiar a una PDB. En este caso, el usuario necesita el privilegio del sistema
SET CONTAINERen el contenedor.
En la siguiente tabla, se describe un escenario relacionado con la CDB en la Figure 19-7. Cada fila describe una acción que se produce después de la acción en la fila anterior. El usuario común SYSTEM consulta el nombre del contenedor actual y los nombres de las PDB en la CDB.
Tabla 1 Servicios de una CDB
| Operación | Descripción |
|---|---|
|
El usuario SYSTEM, que es común a todos los contenedores de la CDB, se conecta a la raíz mediante el servicio denominado prod. |
|
SYSTEM utiliza el comando SQL*Plus SHOW CON_NAME para mostrar el nombre del contenedor al que está conectado actualmente el usuario. CDB$ROOT es el nombre del contenedor raíz. |
|
Una consulta de V$SERVICES muestra que existen tres PDB con nombres de servicio que coinciden con el nombre de PDB. Tanto hrpdb como erppdb tienen un servicio adicional. |
|
SYSTEM utiliza ALTER SESSION para conectarse a hrpdb. |
|
Una consulta confirma que el contenedor actual es ahora hrpdb. |
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener la sintaxis y la semántica de ALTER SESSION SET CONTAINER
Registro de Servicio
En la Red de Oracle, el registro de servicio es una función mediante la cual el proceso LREG registra dinámicamente la información de la instancia con un listener.
Esta información permite al listener reenviar solicitudes de conexión de cliente al manejador de servicios adecuado. LREG proporciona al listener información sobre lo siguiente:
-
Nombres de los servicios de base de datos proporcionados por la base de datos
-
Nombre de la instancia de base de datos asociada a los servicios y su carga actual y máxima
-
Manejadores de servicios (distribuidores y servidores dedicados) disponibles para la instancia, incluido su tipo, direcciones de protocolo y carga actual y máxima
El registro de servicio es dinámico y no requiere configuración en el archivo listener.ora. El registro dinámico reduce la sobrecarga administrativa de varias bases de datos o instancias.
El parámetro de inicialización SERVICE_NAMES muestra los servicios a los que pertenece una instancia. Al iniciar, cada instancia se registra con los listeners de otras instancias que pertenecen a los mismos servicios. Durante las operaciones de base de datos, las instancias de cada servicio transfieren información sobre el uso de CPU y los recuentos de conexiones actuales a todos los listeners de los mismos servicios. Esta comunicación permite el equilibrio de carga dinámico y la conmutación por error de conexión.
Consulte además:
-
Oracle AI Database Net Services Administrator's Guide para obtener más información sobre el registro de servicios
-
Oracle Real Application Clusters Administration and Deployment Guide para obtener más información sobre el registro de instancias y las conexiones de cliente/servicio en Oracle RAC
Arquitectura de servidor dedicado
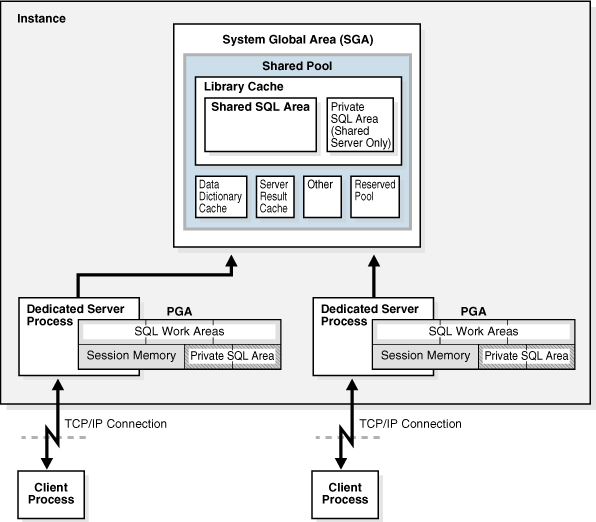
En una arquitectura de servidor dedicado, el proceso de servidor creado en nombre de cada proceso de cliente se denomina proceso de servidor dedicado (o proceso shadow).
Un proceso de servidor dedicado es independiente del proceso de cliente y sólo actúa en su nombre, como se muestra en la Figura 19-8.
Figura 8: Oracle AI Database mediante procesos de servidor dedicados
Descripción de la ilustración cncpt303.gif
Existe una relación uno a uno entre los procesos de cliente y los procesos de servidor. Incluso cuando el usuario no realiza una solicitud de base de datos de forma activa, el proceso de servidor dedicado permanece, aunque está inactivo y se puede localizar en algunos sistemas operativos. La Figura 19-8 muestra los procesos de usuario y servidor que se ejecutan en equipos en red. Sin embargo, la arquitectura del servidor dedicado también se utiliza si el mismo equipo ejecuta tanto la aplicación cliente como el código de base de datos, pero el sistema operativo host no pudo mantener la separación de los dos programas si se ejecutaban en un único proceso. Linux es un ejemplo de este sistema operativo.
En la arquitectura del servidor dedicado, los procesos de usuario y servidor se comunican mediante diferentes mecanismos:
-
Si el proceso cliente y el proceso de servidor dedicado se ejecutan en el mismo equipo, la interfaz de programa utiliza el mecanismo de comunicación entre procesos del sistema operativo host para realizar su trabajo.
-
Si el proceso de cliente y el proceso de servidor dedicado se ejecutan en distintas computadoras, la interfaz de programa proporciona los mecanismos de comunicación (como el software de red y Oracle Net Services) entre los programas.
Los servidores dedicados infrautilizados a veces resultan en un uso ineficiente de los recursos del sistema operativo. Considere un sistema de entrada de indicaciones con procesos de servidor dedicados. Un cliente realiza un pedido cuando un empleado introduce el pedido en la base de datos. Para la mayor parte de la transacción, el empleado está hablando con el cliente mientras el proceso del servidor dedicado al proceso del cliente del empleado está inactivo. El proceso del servidor no es necesario durante la mayor parte de la transacción, y el sistema puede ser más lento para otros empleados que introducen indicaciones si el sistema está gestionando demasiados procesos. Para aplicaciones de este tipo, puede ser preferible la arquitectura de servidor compartido.
Consulte también: Oracle AI Database Net Services Administrator's Guide para obtener más información sobre los procesos de servidor dedicados
Arquitectura del Servidor Compartido
En una arquitectura de servidor compartido, un distribuidor dirige varias solicitudes de sesión de red entrantes a un pool de procesos de servidor compartido.
El pool compartido elimina la necesidad de un proceso de servidor dedicado para cada conexión. Un proceso de servidor compartido inactivo del pool toma una solicitud de una cola común.
Los beneficios potenciales del servidor compartido son los siguientes:
-
Reduce el número de procesos en el sistema operativo
Un pequeño número de servidores compartidos puede realizar la misma cantidad de procesamiento que muchos servidores dedicados.
-
Reduce la memoria PGA de instancia
Cada servidor dedicado o compartido tiene un PGA. Menos procesos de servidor significa menos PGA y menos gestión de procesos.
-
Aumenta la escalabilidad de la aplicación y el número de clientes que se pueden conectar simultáneamente a la base de datos
-
Puede ser más rápido que el servidor dedicado cuando el ratio de conexiones y desconexiones del cliente es alto
El servidor compartido tiene varias desventajas, incluido un tiempo de respuesta más lento en algunos casos, un soporte de funciones incompleto y una mayor complejidad para la configuración y el ajuste. Como directriz general, solo utilice el servidor compartido cuando tenga más conexiones simultáneas a la base de datos que las que puede manejar el sistema operativo.
Los siguientes procesos son necesarios en una arquitectura de servidor compartido:
-
Un listener de red que conecta los procesos de cliente a distribuidores o servidores dedicados (el listener forma parte de Oracle Net Services, no de Oracle AI Database)
Nota: Para utilizar servidores compartidos, un proceso de cliente debe conectarse a través de Oracle Net Services, incluso si el proceso se ejecuta en la misma computadora que la instancia de Oracle AI Database.
-
Uno o más proceso de distribuidor (Dnnn)
-
Uno o más procesos de servidor compartido
Una base de datos puede soportar conexiones de servidor compartido y de servidor dedicado simultáneamente. Por ejemplo, un cliente puede conectarse mediante un servidor dedicado mientras que otro cliente se conecta a la misma base de datos mediante un servidor compartido.
-
Colas de Solicitud y Respuesta del Distribuidor Una solicitud de un usuario es una única llamada de API que forma parte de la sentencia SQL del usuario.
-
Operaciones Restringidas del Servidor Compartido No se pueden realizar actividades administrativas específicas mientras se conecta a un proceso de distribuidor, incluido el cierre o inicio de una recuperación de instancias y medios físicos.
Consulte además:
-
Oracle AI Database Net Services Administrator's Guide para obtener más información sobre la arquitectura de servidor compartido.
-
Oracle AI Database Administrator's Guide para aprender a configurar una base de datos para un servidor compartido
Colas de solicitud y respuesta del distribuidor
Una solicitud de un usuario es una única llamada de API que forma parte de la sentencia SQL del usuario.
Cuando un usuario realiza una llamada, se producen las siguientes acciones:
-
El distribuidor coloca la solicitud en la cola de solicitudes, donde la recoge el siguiente proceso de servidor compartido disponible.
La cola de solicitudes está en SGA y es común a todos los procesos del distribuidor de una instancia.
-
Los procesos de servidor compartido comprueban la cola de solicitudes común en busca de nuevas solicitudes, seleccionando las nuevas solicitudes por orden de llegada.
-
Un proceso de servidor compartido recoge una solicitud en la cola y realiza todas las llamadas necesarias a la base de datos para completar esta solicitud.
Un proceso de servidor diferente puede manejar cada llamada a la base de datos. Por lo tanto, las solicitudes para analizar una consulta, recuperar la primera fila, recuperar la siguiente fila y cerrar el juego de resultados pueden ser procesadas por un servidor compartido diferente.
-
Cuando el proceso de servidor completa la solicitud, coloca la respuesta en la cola de respuesta del distribuidor que realiza la llamada. Cada distribuidor tiene su propia cola de respuesta.
-
El distribuidor devuelve la solicitud completada al proceso de cliente adecuado.
Por ejemplo, en un sistema de entrada de pedidos, el proceso de cliente de cada empleado se conecta a un distribuidor. Cada solicitud realizada por el secretario se envía a este distribuidor, lo que coloca la solicitud en la cola. El siguiente servidor compartido disponible recoge la solicitud, la presta servicios y coloca la respuesta en la cola de respuestas. Cuando se completa una solicitud, el empleado permanece conectado al distribuidor, pero el servidor compartido que procesó la solicitud se libera y está disponible para otras solicitudes. Mientras un empleado habla con un cliente, otro puede utilizar el mismo proceso de servidor compartido. La Figura 19-9 muestra cómo los procesos de cliente se comunican con el distribuidor a través de la API y cómo el distribuidor comunica las solicitudes de usuario a los procesos de servidor compartido.
Figura 9: Configuración y procesos del servidor compartido
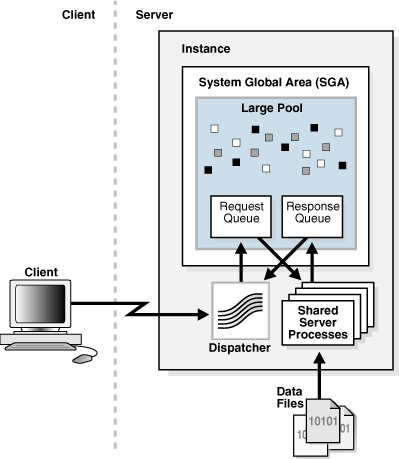
Descripción de la ilustración cncpt067.gif
-
Procesos del distribuidor (Dnnn) Los procesos del distribuidor permiten que los procesos del cliente compartan un número limitado de procesos del servidor.
-
Procesos de Servidor Compartido (Snnn) Cada proceso de servidor compartido atiende varias solicitudes de cliente en la configuración del servidor compartido. Consulte también: "Agrupación grande"
Procesos de distribuidor (D nnn)
Los procesos del distribuidor permiten que los procesos del cliente compartan un número limitado de procesos del servidor.
Puede crear varios procesos de distribuidor para una única instancia de base de datos. El número óptimo de procesos del distribuidor en función de la limitación del sistema operativo y el número de conexiones para cada proceso.
Nota: Cada proceso de cliente que se conecta a un distribuidor debe utilizar Oracle Net Services, incluso si ambos procesos se ejecutan en el mismo host.
Los procesos del distribuidor establecen la comunicación de la siguiente manera:
-
Cuando se inicia una instancia, el proceso del listener de red se abre y establece una ruta de comunicación a través de la cual los usuarios se conectan a Oracle AI Database.
-
Cada proceso de distribuidor proporciona al proceso de listener una dirección en la que el distribuidor recibe las solicitudes de conexión.
Se debe configurar e iniciar al menos un proceso de distribuidor para cada protocolo de red que utilizarán los clientes de base de datos.
-
Cuando un proceso de cliente realiza una solicitud de conexión, el listener determina si el proceso de cliente debe utilizar un proceso de servidor compartido:
-
Si el listener determina que es necesario un proceso de servidor compartido, el listener devuelve la dirección del proceso de distribuidor que tiene la carga más ligera y el proceso de cliente se conecta directamente al distribuidor.
-
Si el proceso no se puede comunicar con el distribuidor o si el proceso de cliente solicita un servidor dedicado, el listener crea un proceso de servidor dedicado y establece una conexión adecuada.
-
Consulte también: Guía del administrador de Oracle AI Database Net Services para aprender a configurar distribuidores
Procesos de Servidor Compartido (S nnn)
Cada proceso de servidor compartido atiende varias solicitudes de cliente en la configuración del servidor compartido.
Los procesos de servidor compartido y dedicado proporcionan la misma funcionalidad, excepto que los procesos de servidor compartido no están asociados a un proceso de cliente específico. En su lugar, un proceso de servidor compartido sirve a cualquier solicitud de cliente en la configuración del servidor compartido.
El PGA de un proceso de servidor compartido no contiene datos UGA, que deben ser accesibles para todos los procesos de servidor compartido. El PGA del servidor compartido solo contiene datos específicos del proceso.
Toda la información relacionada con la sesión se incluye en SGA. Cada proceso de servidor compartido debe poder acceder a los espacios de datos de todas las sesiones para que cualquier servidor pueda manejar las solicitudes de cualquier sesión. El espacio se asigna en el SGA para el espacio de datos de cada sesión.
Consulte también: "Visión General del Área Global del Programa (PGA)"
Operaciones Restringidas del Servidor Compartido
No se pueden realizar actividades administrativas específicas mientras se conecta a un proceso de distribuidor, incluido el cierre o el inicio de una recuperación de instancia y medios físicos.
Estas actividades se suelen realizar cuando se conectan con privilegios de administrador. Para conectarse con privilegios de administrador en un sistema configurado con servidores compartidos, debe especificar que está utilizando un proceso de servidor dedicado.
Consulte también: Oracle AI Database Net Services Administrator's Guide para obtener la sintaxis de cadena de conexión adecuada
Pool de Conexiones Residentes de la Base de Datos
El pool de conexiones residentes de base de datos (DRCP) proporciona un pool de conexiones de servidores dedicados para escenarios de aplicaciones web típicos.
Una aplicación web normalmente realiza una conexión a la base de datos, utiliza la conexión brevemente y, a continuación, la libera. Mediante DRCP, la base de datos se puede escalar a decenas de miles de conexiones simultáneas.
DRCP proporciona las siguientes ventajas:
-
Completa los pools de conexiones de capa media que comparten conexiones entre threads en un proceso de capa media.
-
Permite que las conexiones a la base de datos se compartan entre varios procesos de capa media. Estos procesos de capa media pueden pertenecer al mismo host de capa media o a otro diferente.
-
Permite una reducción significativa de los recursos clave de la base de datos necesarios para soportar muchas conexiones de cliente. Por ejemplo, DRCP reduce la memoria necesaria para la base de datos y aumenta la escalabilidad de la base de datos y la capa media. El pool de servidores disponibles también reduce el costo de volver a crear conexiones de cliente.
-
Proporciona pooling para arquitecturas con servidores de aplicaciones de un solo thread y multiproceso, como PHP y Apache, que no pueden realizar pool de conexiones de capa media.
DRCP utiliza un servidor agrupado, que es el equivalente de un proceso de servidor dedicado (no un proceso de servidor compartido) y una sesión de base de datos combinada. El modelo de servidor agrupado evita la sobrecarga que supone dedicar un servidor a cada conexión que requiera el servidor durante un período corto.
Los clientes que obtienen conexiones del pool de conexiones residente de la base de datos se conectan a un proceso en segundo plano de Oracle conocido como broker de conexiones. El broker de conexiones implementa la funcionalidad del pool y multiplexa los servidores agrupados entre las conexiones entrantes de los procesos del cliente.
Como se muestra en la Figura 19-10, cuando un cliente requiere acceso a la base de datos, el broker de conexiones selecciona un proceso de servidor del pool y lo entrega al cliente. El cliente está conectado directamente al proceso del servidor hasta que se sirve la solicitud. Una vez que el servidor ha terminado, el proceso de servidor se libera en el pool. La conexión del cliente se restaura al broker.
Figura 10: DRCP
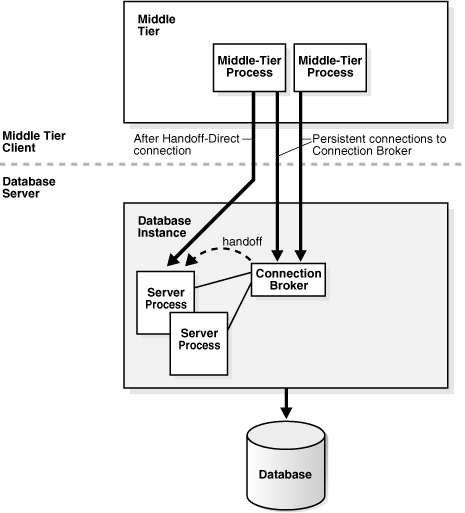
Descripción de la ilustración cncpt312.gif
En DRCP, la liberación de recursos deja la sesión intacta, pero ya no está asociada a una conexión (proceso de servidor). A diferencia del servidor compartido, esta sesión almacena su UGA en el PGA, no en el SGA. Un cliente puede restablecer una conexión de forma transparente al detectar la actividad.
Consulte además:
-
Oracle AI Database Administrator's Guide y Oracle Call Interface Developer's Guide para obtener más información sobre DRCP
Descripción general de la interfaz de programa
La interfaz de programa es la capa de software entre una aplicación de base de datos y Oracle AI Database.
La interfaz del programa realiza las siguientes funciones:
-
Proporciona una barrera de seguridad que impide el acceso destructivo a SGA por parte de los procesos del cliente
-
Actúa como mecanismo de comunicación, formatea solicitudes de información, transfiere datos y detecta y devuelve errores
-
Convierte y traduce datos, especialmente entre diferentes tipos de computadoras o a tipos de datos de programas de usuarios externos
El código de Oracle actúa como servidor, realizando tareas de base de datos en nombre de una aplicación (un cliente), como recuperar filas de bloques de datos. La interfaz del programa consta de varias partes, proporcionadas tanto por el software Oracle AI Database como por el software específico del sistema operativo.
-
Estructura de interfaz de programa La interfaz de programa consta de varios componentes diferentes.
-
Controladores de interfaz de programa Un controlador es un software que transporta datos, generalmente a través de una red.
-
Software de comunicaciones para el sistema operativo El software de nivel más bajo que conecta el lado del usuario con el lado de Oracle AI Database de la interfaz del programa es el software de comunicaciones que proporciona el sistema operativo host.
Estructura de interfaz de programa
La interfaz del programa consta de varios componentes diferentes.
Estos componentes incluyen:
-
Interfaz de llamadas de Oracle (OCI) o biblioteca de tiempo de ejecución de Oracle (SQLLIB)
-
El cliente o el usuario de la interfaz del programa
-
Varios controladores de Oracle Net Services (software de comunicaciones específico del protocolo)
-
Software de comunicaciones del sistema operativo
-
Servidor u Oracle AI Database de la interfaz del programa (también denominada OPI)
El usuario y el lado de Oracle AI Database de la interfaz del programa ejecutan el software de Oracle, al igual que los controladores.
Controladores de interfaz de programa
Un controlador es un software que transporta datos, generalmente a través de una red.
Los controladores realizan operaciones como conexión, desconexión, errores de señal y prueba de errores. Los controladores son específicos de un protocolo de comunicaciones.
Siempre existe un controlador predeterminado. Puede instalar varios controladores, como los controladores asíncronos o DECnet, y seleccionar uno como el controlador predeterminado, pero permitir que un usuario utilice otros controladores especificando un controlador al conectarse.
Diferentes procesos pueden utilizar diferentes controladores. Un proceso puede tener conexiones simultáneas a una única base de datos o a varias bases de datos con distintos controladores de Oracle Net Services.
Consulte además:
-
Guía de instalación y configuración del sistema para obtener detalles sobre cómo seleccionar, instalar y agregar controladores
-
Oracle AI Database Net Services Administrator's Guide para obtener más información sobre los controladores JDBC
Software de comunicaciones para el sistema operativo
El software de nivel inferior que conecta el lado del usuario al lado de Oracle AI Database de la interfaz del programa es el software de comunicaciones que proporciona el sistema operativo host.
DECnet, TCP/IP, LU6.2 y ASYNC son ejemplos. El software de comunicación puede ser suministrado por Oracle, pero generalmente se adquiere por separado del proveedor de hardware o de un proveedor de software de terceros.
Visión General de Oracle True Cache
True Cache es una caché en memoria de solo lectura delante de Oracle AI Database.
Al igual que Oracle Active Data Guard, True Cache es una réplica totalmente funcional y de solo lectura de la base de datos primaria, excepto que en su mayoría no tiene disco.
Las aplicaciones modernas suelen requerir un gran número de conexiones y un acceso rápido y de baja latencia a los datos. Un enfoque popular es colocar las cachés delante de la base de datos porque las aplicaciones suelen realizar muchas más lecturas que actualizaciones, y pueden leer desde la caché sin afectar al rendimiento de la base de datos. Por ejemplo, un sistema de reserva de aerolíneas lee datos con frecuencia mientras las personas compran vuelos, y está bien si los datos no son los más actuales en comparación con lo que hay en la base de datos. La aplicación solo necesita acceder a los datos más actuales cuando alguien reserva un vuelo.
A diferencia de las cachés convencionales, True Cache mantiene automáticamente los datos a los que se accede con más frecuencia en la caché y mantiene la caché consistente con la base de datos primaria, otros objetos de la misma caché y otras cachés. Almacena en caché todos los objetos y tipos de datos de Oracle AI Database, incluido JSON.
Debido a que True Cache implementa políticas de seguridad de Oracle AI Database, puede controlar el acceso a la caché. Esto le permite almacenar en caché datos confidenciales, como información personal privada, que normalmente no puede almacenar en caché.
Temas relacionados