Programación en el Servidor: PL/SQL, Java y JavaScript
SQL explica el lenguaje de lenguaje de consulta estructurado (SQL) y cómo la base de datos procesa las sentencias SQL. En este capítulo se explica cómo los programas SQL o de lenguaje de procedimiento (PL/SQL) o Java almacenados en la base de datos pueden utilizar SQL.
-
Introducción a la Programación en el Servidor En un lenguaje no procedimental como SQL, se especifica el juego de datos en el que se va a operar, pero no las operaciones que se van a realizar o la forma en que se van a realizar.
-
Visión general de PL/SQL PL/SQL proporciona un lenguaje de procedimiento almacenado del lado del servidor que es fácil de usar, sin problemas con SQL, robusto, portátil y seguro. Puede acceder y manipular datos de base de datos mediante objetos de procedimiento denominados unidades PL/SQL.
-
Visión general de Java en Oracle AI Database Java se ha convertido en el lenguaje de programación orientado a objetos elegido.
-
La visión general de JavaScript en Oracle AI Database JavaScript es uno de los lenguajes de programación más populares en la actualidad. Oracle AI Database desplegado en Linux x86-64 o Linux aarch64 agrega JavaScript a la lista de lenguajes soportados para el desarrollo del lado del servidor.
-
Visión General de Disparadores Un disparador de base de datos es una unidad de programa almacenada compilada, escrita en PL/SQL, Java o JavaScript, que Oracle Database llama automáticamente en determinadas situaciones. Consulte también: SQL para obtener una visión general del lenguaje SQL.
Introducción a la Programación del Servidor
En un lenguaje no procedimental como SQL, se especifica el conjunto de datos que se van a operar, pero no las operaciones que se van a realizar o la forma en que se van a llevar a cabo.
En un programa de lenguaje de procedimiento, la mayoría de las ejecuciones de sentencias dependen de sentencias anteriores o posteriores y de estructuras de control, como bucles o bifurcaciones condicionales, que no están disponibles en SQL. Para ver una ilustración de la diferencia entre lenguajes de procedimiento y no de procedimiento, suponga que la siguiente sentencia SQL consulta la tabla employees:
SELECT employee_id, department_id, last_name, salary FROM employees;La sentencia anterior solicita datos, pero no aplica lógica a los datos. Sin embargo, suponga que desea que una aplicación determine si cada empleado del juego de datos merece un aumento en función del salario y el rendimiento del departamento. Una condición necesaria para un aumento de sueldo es que el empleado no haya recibido más de tres aumentos en los últimos cinco años. Si se solicita un aumento, la aplicación debe ajustar el salario y enviar un correo electrónico al mánager; de lo contrario, la aplicación debe actualizar un informe.
El problema es cómo las aplicaciones de base de datos de procedimiento que requieren lógica condicional y control de flujo de programa pueden utilizar SQL. Los enfoques básicos de desarrollo son los siguientes:
-
Utilizar la programación del lado del cliente para embeber sentencias SQL en aplicaciones escritas en lenguajes de procedimiento como C, C++ o Java
Puede colocar sentencias SQL en el código fuente y enviarlas a un precompilador o traductor de Java antes de la compilación. También puede eliminar el paso de precompilación y utilizar una API como Java Database Connectivity (JDBC) u Oracle Call Interface (OCI) para permitir que la aplicación interactúe con la base de datos.
-
Utilizar la programación del servidor para desarrollar la lógica de datos que reside en la base de datos
Una aplicación puede llamar explícitamente a subprogramas almacenados (procedimientos y funciones), escritos en PL/SQL (pronunciado P L sequel) Java, o JavaScript. También puede crear un disparador, que se denomina unidad de programa que se almacena en la base de datos y se llama en respuesta a un evento especificado.
En este capítulo se explica el segundo enfoque. La principal ventaja de la programación del lado del servidor es que la funcionalidad incorporada en la base de datos se puede desplegar en cualquier lugar. La base de datos y no la aplicación determinan la mejor manera de realizar tareas en un sistema operativo determinado. Además, los subprogramas aumentan la escalabilidad al centralizar el procesamiento de aplicaciones en el servidor, lo que permite a los clientes reutilizar el código. Debido a que las llamadas de subprograma son rápidas y eficientes, una sola llamada puede iniciar un subprograma almacenado con un uso intensivo de recursos informáticos, lo que reduce el tráfico de red.
Puede utilizar los siguientes idiomas para almacenar la lógica de datos en Oracle AI Database:
-
PL/SQL
PL/SQL es la extensión de procedimiento de Oracle AI Database a SQL. PL/SQL está integrado con la base de datos, soportando todas las sentencias SQL, funciones y tipos de dato de Oracle. Las aplicaciones escritas en API de base de datos pueden llamar a subprogramas PL/SQL almacenados y enviar bloques de código PL/SQL a la base de datos para su ejecución.
-
Java
Oracle AI Database también proporciona soporte para desarrollar, almacenar y desplegar aplicaciones Java. Los subprogramas almacenados de Java se ejecutan en la base de datos y son independientes de los programas que se ejecutan en la capa media. Los subprogramas almacenados Java interactúan con SQL mediante un modelo de ejecución similar al de PL/SQL.
-
JavaScript
Cuando se implementa en Linux x86-64 o Linux aarch64, Oracle AI Database permite a los desarrolladores expresar la lógica de negocio en JavaScript. La ejecución ad hoc de JavaScript es posible gracias al paquete PL/SQL DBMS_MLE y sus subrutinas. El almacenamiento de la lógica de negocio como objetos de esquema JavaScript permite escribir aplicaciones más complejas. Las especificaciones de llamada exponen el código JavaScript almacenado en la base de datos en SQL y PL/SQL de una forma similar a los procedimientos almacenados Java.
Consulte además:
-
Oracle AI Database Development Guide para obtener más información sobre la incorporación de SQL con precompiladores y API
-
Oracle AI Database: Introducción al desarrollo de Oracle AI Database para obtener una introducción al desarrollo de aplicaciones de Oracle AI Database
-
Oracle AI Database Development Guide para aprender a elegir un entorno de programación
-
Oracle AI Database JavaScript Developer's Guide para obtener más información sobre el soporte de JavaScript en Oracle AI Database.
Visión General de PL/SQL
PL/SQL proporciona un lenguaje de procedimiento almacenado del lado del servidor que es fácil de usar, sin problemas con SQL, robusto, portátil y seguro. Puede acceder y manipular datos de base de datos mediante objetos de procedimiento denominados unidades PL/SQL.
Las unidades PL/SQL generalmente se clasifican de la siguiente manera:
-
Un subprograma PL/SQL es un bloque PL/SQL que se almacena en la base de datos y que se puede llamar por nombre desde una aplicación. Al crear un subprograma, la base de datos analiza el subprograma y almacena su representación analizada en la base de datos. Puede declarar un subprograma como un procedimiento o una función.
-
Un bloque anónimo PL/SQL es un bloque PL/SQL que aparece en la aplicación y no tiene nombre ni se almacena en la base de datos. En muchas aplicaciones, los bloques PL/SQL pueden aparecer dondequiera que aparezcan sentencias SQL.
El compilador e intérprete PL/SQL están embebidos en Oracle SQL Developer, lo que proporciona a los desarrolladores un modelo de desarrollo consistente y aprovechado tanto en el cliente como en el servidor. Además, los procedimientos almacenados PL/SQL se pueden llamar desde varios clientes de base de datos, como Pro*C, JDBC, ODBC u OCI, y desde Oracle Reports y Oracle Forms.
-
Subprogramas PL/SQL Un subprograma PL/SQL es un bloque PL/SQL con nombre que permite al emisor de llamada proporcionar parámetros que solo pueden ser valores de entrada, salida o entrada y salida.
-
Paquetes PL/SQL Un paquete PL/SQL es un grupo de subprogramas relacionados, junto con los cursores y variables que utilizan, almacenados en la base de datos como una unidad para el uso continuo. Las aplicaciones o los usuarios pueden llamar explícitamente a los subprogramas empaquetados.
-
Bloques anónimos PL/SQL Un bloque anónimo PL/SQL es una unidad PL/SQL sin nombre y no persistente.
-
Los bloques PL/SQL de construcciones de lenguaje PL/SQL pueden incluir varias construcciones de lenguaje PL/SQL diferentes.
-
Recopilaciones y registros PL/SQL Muchas técnicas de programación utilizan tipos de recopilación, como matrices, bolsas, listas, tablas anidadas, juegos y árboles.
-
Cómo se ejecuta PL/SQL PL/SQL soporta tanto la ejecución interpretada como la ejecución nativa.
Consulte además:
-
Oracle AI Database: Introducción al desarrollo de Oracle AI Database
-
Referencia de lenguaje PL/SQL de Oracle AI Database para obtener información completa sobre PL/SQL, incluidos los paquetes
Subprogramas PL/SQL
Un subprograma PL/SQL es un bloque PL/SQL con nombre que permite al emisor de llamada proporcionar parámetros que solo pueden ser valores de entrada, de salida o de entrada y de salida.
Un subprograma resuelve un problema específico o realiza tareas relacionadas y sirve como bloque de construcción para aplicaciones de base de datos modulares y mantenibles. Un subprograma es un procedimiento PL/SQL o una función PL/SQL. Los procedimientos y las funciones son idénticos salvo que la función siempre devuelven un único valor al emisor de la llamada, mientras que la función no lo hace. El término procedimiento PL/SQL de este capítulo hace referencia a un procedimiento o a una función.
-
Ventajas de la programación en el servidor de subprogramas PL/SQL La programación en el lado del cliente tiene muchas ventajas.
-
Creación de Subprogramas PL/SQL Un subprograma almacenado autónomo es un subprograma creado en el nivel de esquema con la sentencia
CREATE PROCEDUREoCREATE FUNCTION. Los subprogramas definidos en un paquete se denominan subprogramas de paquetes y se consideran parte del paquete. -
Ejecución de Subprogramas PL/SQL Los usuarios pueden ejecutar un subprograma de forma interactiva de varias formas.
Consulte además:
-
Pro*C/C++ Developer's Guide y Pro*COBOL Developer's Guide para obtener información sobre los procedimientos almacenados en estos idiomas
Ventajas de los Subprogramas PL/SQL
La programación del lado del servidor tiene muchas ventajas sobre la programación del lado del cliente.
Las ventajas incluyen:
-
Rendimiento mejorado
-
La cantidad de información que una aplicación debe enviar a través de una red es pequeña en comparación con la emisión de sentencias SQL individuales o el envío de texto de un bloque PL/SQL completo a Oracle AI Database, porque la información se envía solo una vez y posteriormente se llama cuando se utiliza.
-
La forma compilada de un procedimiento está disponible en la base de datos, por lo que no es necesaria ninguna compilación en el momento de la ejecución.
-
Si el procedimiento está presente en la agrupación compartida de la SGA, la base de datos no necesita recuperarla del disco y puede comenzar la ejecución inmediatamente.
-
-
Asignación de Memoria
Dado que los procedimientos almacenados aprovechan las capacidades de memoria compartida de Oracle AI Database, solo debe cargar una única copia del procedimiento en la memoria para que la ejecuten varios usuarios. Compartir código entre los usuarios da como resultado una reducción sustancial en los requisitos de memoria de la base de datos para las aplicaciones.
-
Mejora de la productividad
Los procedimientos almacenados aumentan la productividad del desarrollo. Al diseñar aplicaciones en torno a un conjunto común de procedimientos, puede evitar la codificación redundante. Por ejemplo, puede escribir procedimientos para manipular filas en la tabla
employees. Cualquier aplicación puede llamar a estos procedimientos sin necesidad de reescribir sentencias SQL. Si los métodos de gestión de datos cambian, solo se deben modificar los procedimientos, no las aplicaciones que utilizan los procedimientos.Los procedimientos almacenados son quizás la mejor manera de lograr la reutilización del código. Puesto que cualquier aplicación cliente escrita en cualquier idioma que se conecte a la base de datos puede llamar a los procedimientos almacenados, proporciona la máxima reutilización de código en todos los entornos.
-
Integridad
Los procedimientos almacenados mejoran la integridad y la coherencia de las aplicaciones. Al desarrollar aplicaciones en torno a un grupo común de procedimientos, se reduce la probabilidad de errores de codificación.
Por ejemplo, puede probar un subprograma para garantizar que devuelve un resultado preciso y, una vez verificado, volver a utilizarlo en cualquier número de aplicaciones sin volver a probarlo. Si se modifican las estructuras de datos a las que hace referencia el procedimiento, solo debe volver a compilar el procedimiento. Las aplicaciones que llaman al procedimiento no requieren necesariamente modificaciones.
-
Seguridad con procedimientos de derechos del responsable de la definición
Los procedimientos almacenados pueden ayudar a aplicar la seguridad de los datos. Un procedimiento PL/SQL de derechos del definidor se ejecuta con el privilegio de su propietario, no de su usuario actual. Por lo tanto, puede restringir las tareas de la base de datos que realizan los usuarios permitiéndoles acceder a los datos solo a través de procedimientos y funciones que se ejecutan con los privilegios del responsable de la definición.
Por ejemplo, puede otorgar a los usuarios acceso a un procedimiento que actualiza una tabla, pero no otorgar acceso a la propia tabla. Cuando un usuario llama al procedimiento, se ejecuta con los privilegios de su propietario. Los usuarios que sólo tienen el privilegio para ejecutar el procedimiento (pero no privilegios para consultar, actualizar o suprimir de las tablas subyacentes) pueden llamar al procedimiento, pero no manipular los datos de la tabla de ninguna otra forma.
-
Privilegios heredados y contexto de esquema con procedimientos de derechos del invocador
Un procedimiento PL/SQL de derechos del invocador se ejecuta en el esquema del usuario actual con los privilegios del usuario actual. En otras palabras, el procedimiento de derechos de un invocador no está vinculado a un usuario o esquema concreto. Los procedimientos de derechos del invocador facilitan a los desarrolladores de aplicaciones la centralización de la lógica de la aplicación, incluso cuando los datos subyacentes se dividen entre esquemas de usuario.
Por ejemplo, un usuario
hr_managerque ejecuta un procedimiento de actualización en la tablahr.employeespuede actualizar salarios, mientras que un usuariohr_clerkque ejecuta el mismo procedimiento está restringido a actualizar datos de dirección.
Consulte además:
-
Referencia de lenguaje PL/SQL de Oracle AI Database para obtener una visión general de los subprogramas PL/SQL
-
Oracle AI Database Security Guide para obtener más información sobre los derechos del responsable de la definición y del invocador
Creación de Subprogramas PL/SQL
Un subprograma almacenado autónomo es un subprograma creado en el nivel de esquema con la sentencia CREATE PROCEDURE o CREATE FUNCTION. Los subprogramas definidos en un paquete se denominan subprogramas de paquetes y se consideran parte del paquete.
La base de datos almacena subprogramas en el diccionario de datos como objetos de esquema. Un subprograma tiene una especificación, que incluye descripciones de cualquier parámetro y un cuerpo.
Ejemplo 11-1 Procedimiento PL/SQL
En este ejemplo se muestra parte de una sentencia de creación para el procedimiento PL/SQL autónomo hire_employees. El procedimiento inserta una fila en la tabla employees.
CREATE PROCEDURE hire_employees
  (p_last_name VARCHAR2, p_job_id VARCHAR2, p_manager_id NUMBER,
   p_hire_date DATE, p_salary NUMBER, p_commission_pct NUMBER,
   p_department_id NUMBER)
IS
BEGIN
.
.
.
  INSERT INTO employees (employee_id, last_name, job_id, manager_id, hire_date,
    salary, commission_pct, department_id)
  VALUES (emp_sequence.NEXTVAL, p_last_name, p_job_id, p_manager_id,
          p_hire_date, p_salary, p_commission_pct, p_department_id);
.
.
.
END;
Consulte además:
-
Oracle AI Database: introducción al desarrollo de Oracle AI Database para aprender a crear subprogramas
-
Referencia de lenguaje PL/SQL de Oracle AI Database para obtener más información sobre la sentencia
CREATE PROCEDURE
Ejecución de Subprogramas PL/SQL
Los usuarios pueden ejecutar un subprograma de forma interactiva de varias formas.
Las opciones son las siguientes:
-
Uso de una herramienta de Oracle, como SQL*Plus o SQL Developer
-
Llamarlo explícitamente en el código de una aplicación de base de datos, como una aplicación de Oracle Forms o precompilador
-
Llamarlo explícitamente en el código de otro procedimiento o disparador
En el siguiente gráfico se muestran diferentes aplicaciones de base de datos que llaman a hire_employees.
Figura 1: Ejecución Múltiple de un Procedimiento Almacenado
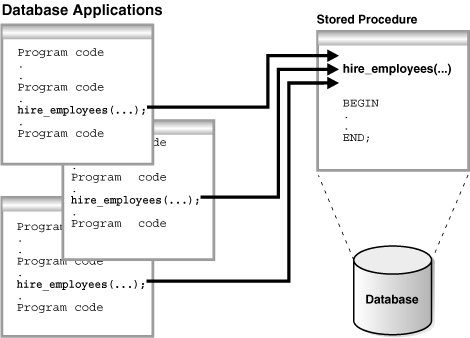
Descripción de la ilustración cncpt073.gif
Como alternativa, un usuario con privilegios puede utilizar Oracle Enterprise Manager o SQL*Plus para ejecutar el procedimiento hire_employees mediante una sentencia como la siguiente:
EXECUTE hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);La sentencia anterior inserta un nuevo registro para TSMITH en la tabla employees.
Un procedimiento almacenado depende de los objetos a los que se hace referencia en su cuerpo. La base de datos realiza un seguimiento y gestiona automáticamente estas dependencias. Por ejemplo, si modifica la definición de la tabla employees a la que hace referencia el procedimiento hire_employees de forma que afecte a este procedimiento, se debe recompilar el procedimiento para validar que aún funciona según lo diseñado. Normalmente, la base de datos administra automáticamente dicha gestión de dependencias.
Consulte además:
-
Oracle AI Database: introducción al desarrollo de Oracle AI Database para obtener más información sobre SQL*Plus y SQL Developer
-
Oracle AI Database Development Guide para obtener más información sobre los precompiladores
-
Referencia de lenguaje PL/SQL de Oracle AI Database para aprender a utilizar subprogramas PL/SQL
-
Guía del usuario y referencia de SQL*Plus para obtener más información sobre el comando
EXECUTE
Paquetes PL/SQL
Un paquete PL/SQL es un grupo de subprogramas relacionados, junto con los cursores y variables que utilizan, almacenados juntos en la base de datos para su uso continuo como una unidad. Las aplicaciones o los usuarios pueden llamar explícitamente a los subprogramas empaquetados.
Oracle AI Database incluye muchos paquetes proporcionados que amplían la funcionalidad de la base de datos y proporcionan acceso PL/SQL a las funciones SQL. Por ejemplo, el paquete UTL_HTTP permite llamadas HTTP de PL/SQL y SQL para acceder a datos en Internet o llamar a cartuchos de Oracle Web Server. Puede utilizar los paquetes proporcionados al crear aplicaciones o como fuente de ideas al crear sus propios procedimientos almacenados.
-
Las ventajas de los paquetes PL/SQL PL/SQL proporcionan una serie de ventajas al desarrollador de aplicaciones.
-
Creación de paquetes PL/SQL Puede crear un paquete en dos partes: la especificación y el cuerpo. La especificación del paquete declara todas las construcciones públicas del paquete, mientras que el cuerpo del paquete define todas las construcciones (públicas y privadas) del paquete.
-
Ejecución de Subprogramas de Paquete PL/SQL Los disparadores de base de datos, los subprogramas almacenados, los programas de aplicación 3GL y las herramientas de Oracle pueden hacer referencia al contenido de los paquetes.
Ventajas de los Paquetes PL/SQL
Los paquetes PL/SQL proporcionan una serie de ventajas al desarrollador de aplicaciones.
Las ventajas incluyen:
-
Encapsulación
Los paquetes permiten encapsular o agrupar procedimientos almacenados, variables, tipos de dato, etc., en una unidad con nombre y almacenada. La encapsulación proporciona una mejor organización durante el desarrollo y también más flexibilidad. Puede crear especificaciones y hacer referencia a procedimientos públicos sin crear realmente el cuerpo del paquete. La encapsulación simplifica la gestión de privilegios. La concesión del privilegio para un paquete hace que las construcciones de paquetes sean accesibles para el usuario con privilegios.
-
Seguridad de los datos
Los métodos de definición de paquetes permiten especificar qué variables, cursores y procedimientos son públicos y privados. Público significa que es directamente accesible para el usuario de un paquete. Privado significa que está oculto para el usuario de un paquete.
Por ejemplo, un paquete puede contener 10 procedimientos. Puede definir el paquete para que solo tres procedimientos sean públicos y, por lo tanto, estén disponibles para su ejecución por parte de un usuario del paquete. Los procedimientos restantes son privados y solo pueden acceder a ellos los procedimientos del paquete. No confunda las variables de paquete públicas y privadas con permisos para
PUBLIC. -
Mejor rendimiento
Un paquete completo se carga en la memoria en pequeños fragmentos cuando se llama por primera vez a un procedimiento del paquete. Esta carga se completa en una operación, a diferencia de las cargas independientes necesarias para los procedimientos independientes. Cuando se realizan llamadas a procedimientos empaquetados relacionados, no se necesita ninguna E/S de disco para ejecutar el código compilado en la memoria.
Un cuerpo del paquete se puede sustituir y recompilar sin que afecte a la especificación. Por lo tanto, los objetos de esquema que hacen referencia a las construcciones de un paquete (siempre a través de la especificación) no se deben recompilar a menos que la especificación del paquete también se reemplace. Al utilizar paquetes, se pueden minimizar las recompilaciones innecesarias, lo que se traduce en un menor impacto en el rendimiento general de la base de datos.
Creación de Paquetes PL/SQL
Un paquete se crea en dos partes: la especificación y el cuerpo. La especificación del paquete declara todas las construcciones públicas del paquete, mientras que el cuerpo del paquete define todas las construcciones (públicas y privadas) del paquete.
En el siguiente ejemplo se muestra parte de una sentencia que crea la especificación de paquete para employees_management, que encapsula varios subprogramas utilizados para gestionar una base de datos de empleados. Cada parte del paquete se crea con una sentencia diferente.
CREATE PACKAGE employees_management AS
  FUNCTION hire_employees (last_name VARCHAR2, job_id VARCHAR2, manager_id NUMBER,
    salary NUMBER, commission_pct NUMBER, department_id NUMBER) RETURN NUMBER;
  PROCEDURE fire_employees(employee_id NUMBER);
  PROCEDURE salary_raise(employee_id NUMBER, salary_incr NUMBER);
.
.
.
  no_sal EXCEPTION;
END employees_management;
La especificación declara la función hire_employees, los procedimientos fire_employees y salary_raise, y la excepción no_sal. Todos estos objetos de programa público están disponibles para los usuarios que tienen acceso al paquete.
La sentencia CREATE PACKAGE BODY define los objetos declarados en la especificación. El cuerpo del paquete se debe crear en el mismo esquema que el paquete. Después de crear el paquete, puede desarrollar aplicaciones que llamen a cualquiera de estos procedimientos o funciones públicos o que emitan cualquiera de las excepciones públicas del paquete.
Consulte también: Referencia de lenguaje PL/SQL de Oracle AI Database para obtener más información sobre la sentencia CREATE PACKAGE
Ejecución de Subprogramas de Paquete PL/SQL
Los disparadores de base de datos, los subprogramas almacenados, los programas de aplicación 3GL y las herramientas de Oracle pueden hacer referencia al contenido de los paquetes.
En el siguiente gráfico se muestran las aplicaciones de base de datos que llaman a procedimientos y funciones en el paquete employees_management.
Figura 2: Llamada a Subprogramas en un Paquete PL/SQL
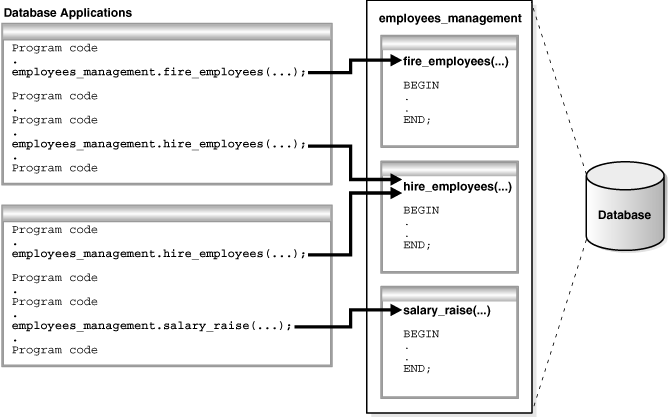
Descripción de la ilustración cncpt075.gif
Las aplicaciones de base de datos llaman explícitamente a los procedimientos empaquetados según sea necesario. Después de otorgar los privilegios para el paquete employees_management, un usuario puede ejecutar explícitamente cualquiera de los procedimientos que contiene. Por ejemplo, SQL*Plus puede emitir la siguiente sentencia para ejecutar el procedimiento del paquete hire_employees:
EXECUTE employees_management.hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);Consulte además:
-
Referencia de lenguaje PL/SQL de Oracle AI Database para una introducción a los paquetes PL/SQL
-
Oracle AI Database Development Guide para aprender a codificar paquetes PL/SQL
Bloques Anónimos PL/SQL
Un bloque anónimo PL/SQL es una unidad PL/SQL sin nombre y no persistente.
Los usos típicos de los bloques anónimos incluyen:
-
Inicio de llamadas a subprogramas y construcciones de paquetes
-
Aislamiento del manejo de excepciones
-
Gestión del Control Anidando Código en Otros Bloques PL/SQL
Los bloques anónimos no tienen las ventajas de reutilización de código de los subprogramas almacenados. La Tabla 11-1 resume las diferencias entre los dos tipos de unidades PL/SQL.
Tabla 1 Diferencias entre bloques anónimos y subprogramas
| Es la unidad PL/SQL... | Bloques Anónimos | Subprogramas |
|---|---|---|
| ¿Se ha especificado con un nombre? | No | Sí |
| ¿Se compila con cada reutilización? | No | No |
| ¿Se almacenan en la Base de Datos? | No | Sí |
| ¿Invocable por otras aplicaciones? | No | Sí |
| ¿Se pueden devolver valores de variables ligadas? | Sí | Sí |
| ¿Capaz de devolver valores de función? | No | Sí |
| ¿Capaz de aceptar parámetros? | No | Sí |
Un bloque anónimo consta de una parte declarativa opcional, una parte ejecutable y uno o más manejadores de excepciones opcionales. El siguiente bloque anónimo de ejemplo selecciona los apellidos de un empleado en una variable e imprime el nombre:
DECLARE
  v_lname VARCHAR2(25);
BEGIN
  SELECT last_name
    INTO v_lname
  FROM employees
  WHERE employee_id = 101;
  DBMS_OUTPUT.PUT_LINE('Employee last name is '||v_lname);
END;
Oracle AI Database compila el bloque PL/SQL y lo coloca en el pool compartido de SGA, pero no almacena el código fuente ni la versión compilada en la base de datos para su reutilización más allá de la instancia actual. A diferencia de los disparadores, un bloque anónimo se compila cada vez que se carga en la memoria. El SQL compartido permite reutilizar y compartir bloques PL/SQL anónimos en el pool compartido hasta que se vacíen del pool compartido.
Consulte también: Guía de desarrollo de Oracle AI Database para obtener más información sobre bloques PL/SQL anónimos
Construcciones de Lenguaje PL/SQL
Los bloques PL/SQL pueden incluir varias construcciones de lenguaje PL/SQL diferentes.
Estas construcciones incluyen las siguientes:
-
Variables y constantes:
Puede declarar estas construcciones dentro de un procedimiento, función o paquete. Puede utilizar una variable o constante en una sentencia SQL o PL/SQL para capturar o proporcionar un valor cuando sea necesario.
-
Cursores
Puede declarar un cursor explícitamente dentro de un procedimiento, función o paquete para facilitar el procesamiento orientado a registros de los datos de Oracle AI Database. El motor PL/SQL también puede declarar cursores de forma implícita.
-
Excepciones
PL/SQL permite manejar explícitamente las condiciones de error internas y definidas por el usuario, denominadas excepciones, que surgen durante el procesamiento del código PL/SQL.
PL/SQL puede ejecutar sentencias SQL dinámico cuyo texto completo no se conoce hasta el tiempo de ejecución. Las sentencias SQL dinámicas se almacenan en cadenas de caracteres que el programa introduce o crea en tiempo de ejecución. Esta técnica permite crear procedimientos de uso general. Por ejemplo, puede crear un procedimiento que funcione en una tabla cuyo nombre no se conoce hasta el tiempo de ejecución.
Consulte además:
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre SQL dinámico
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para aprender a utilizar SQL dinámico en el paquete
DBMS_SQL
Recopilaciones y Registros PL/SQL
Muchas técnicas de programación utilizan tipos de recopilación, como matrices, bolsas, listas, tablas anidadas, juegos y árboles.
Para soportar técnicas de recopilación en aplicaciones de base de datos, PL/SQL proporciona los tipos de dato TABLE y VARRAY. Estos tipos permiten declarar matrices asociativas, tablas anidadas y matrices de tamaño variable.
-
Recopilaciones Una recopilación PL/SQL es un grupo ordenado de elementos, todos del mismo tipo.
-
Registros: un registro PL/SQL es una variable compuesta que puede almacenar valores de datos de diferentes tipos, similares a un tipo estructural en C, C++ o Java. Los registros son útiles para contener datos de las filas de tablas o determinadas columnas de filas de tablas.
Recopilaciones
Una recopilación PL/SQL es un grupo ordenado de elementos, todos del mismo tipo.
Cada elemento tiene un subíndice único que determina su posición en la recopilación. Para crear una recopilación, primero debe definir un tipo de recopilación y, a continuación, declarar una variable de ese tipo.
Las colecciones funcionan como las matrices que se encuentran en la mayoría de los lenguajes de programación de tercera generación. Además, las recopilaciones se pueden transferir como parámetros. Por lo tanto, puede utilizarlas para mover columnas de datos a y fuera de las tablas de base de datos o entre aplicaciones de cliente y subprogramas almacenados.
Registros
Un registro PL/SQL es una variable compuesta que puede almacenar valores de datos de diferentes tipos, similares a un tipo de estructura en C, C++ o Java. Los registros son útiles para contener datos de las filas de tablas o determinadas columnas de filas de tablas.
Supongamos que tiene datos sobre un empleado, como el nombre, el salario y la fecha de contratación. Estos elementos son de tipo diferente, pero lógicamente relacionados. Un registro que contiene un campo para cada artículo le permite tratar los datos como una unidad lógica.
Puede utilizar el atributo %ROWTYPE para declarar un registro que represente una fila de tabla o una fila recuperada de un cursor. Con los registros definidos por el usuario, puede declarar sus propios campos.
Consulte también: Referencia de lenguaje PL/SQL de Oracle AI Database para aprender a utilizar registros PL/SQL
Ejecución de PL/SQL
PL/SQL soporta tanto la ejecución interpretada como la ejecución nativa.
En la ejecución interpretada, el código fuente PL/SQL se compila en una representación de código de byte. Una computadora virtual portátil implementada como parte de Oracle AI Database ejecuta este código de byte.
La ejecución nativa ofrece el mejor rendimiento en unidades con un uso intensivo de computación. En este caso, el código fuente de las unidades PL/SQL se compila directamente en el código de objeto para la plataforma especificada. Este código de objeto está enlazado a Oracle AI Database.
El motor PL/SQL define, compila y ejecuta unidades PL/SQL. Este motor es un componente especial de muchos productos de Oracle, incluido Oracle AI Database. Aunque muchos productos de Oracle tienen componentes PL/SQL, este tema trata específicamente las unidades PL/SQL que se pueden almacenar en Oracle AI Database y procesar mediante el motor PL/SQL de Oracle AI Database. En la documentación de cada herramienta de Oracle se describen sus capacidades PL/SQL.
En el siguiente gráfico se ilustra el motor PL/SQL incluido en Oracle AI Database.
Figura 3: Motor PL/SQL y Oracle AI Database
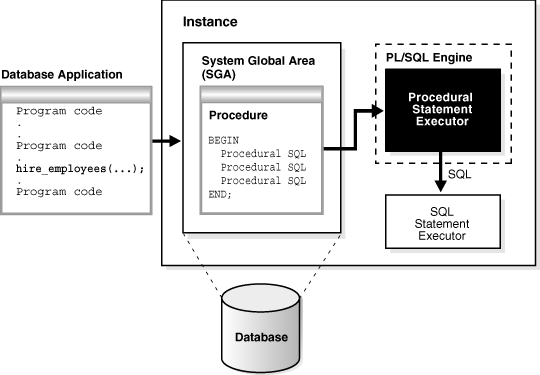
Descripción de la ilustración cncpt070.gif
La unidad PL/SQL se almacena en una base de datos. Cuando una aplicación llama a un procedimiento almacenado, la base de datos carga la unidad PL/SQL compilada en el pool compartido en el área global del sistema (SGA). Los ejecutores de sentencias SQL y PL/SQL trabajan juntos para procesar las sentencias del procedimiento.
Puede llamar a un procedimiento almacenado desde otro bloque PL/SQL, que puede ser un bloque anónimo u otro procedimiento almacenado. Por ejemplo, puede llamar a un procedimiento almacenado desde Oracle Forms.
Un procedimiento PL/SQL que se ejecuta en Oracle AI Database puede llamar a una función o procedimiento externo escrito en lenguaje de programación C y almacenado en una biblioteca compartida. La rutina C se ejecuta en un espacio de direcciones independiente del de Oracle AI Database.
Consulte además:
-
"Shared Pool" para obtener más información sobre la finalidad y el contenido del pool compartido
-
Oracle AI Database PL/SQL Language Reference si desea obtener más Información acerca de la arquitectura PL/SQL
-
Oracle AI Database Development Guide para obtener más información sobre los procedimientos externos
Visión general de Java en Oracle AI Database
Java se ha convertido en el lenguaje de programación orientado a objetos elegido.
Java incluye las siguientes funciones:
-
Una Java Virtual Machine (JVM), que proporciona la base para la independencia de la plataforma
-
Técnicas automatizadas de gestión de almacenamiento, como la recolección de basura
-
Sintaxis de lenguaje que toma prestado de C y fuerza la escritura fuerte Nota: en este capítulo se asume que está familiarizado con el lenguaje Java.
La base de datos proporciona programas Java con un motor de procesamiento de datos dinámico que soporta consultas complejas y varias vistas de datos. Las solicitudes de los clientes se ensamblan como consultas de datos para su procesamiento inmediato. Los resultados de la consulta se generan dinámicamente.
La combinación de Java y Oracle AI Database le ayuda a crear aplicaciones basadas en componentes y centradas en la red que se pueden actualizar fácilmente a medida que cambian las necesidades empresariales. Además, puede mover aplicaciones y almacenes de datos fuera del escritorio y a redes inteligentes y servidores centrados en la red. Más importante aún, puede acceder a estas aplicaciones y almacenes de datos desde cualquier dispositivo cliente.
En la siguiente figura se muestra una configuración de cliente/servidor tradicional de dos niveles en la que los clientes llaman a procedimientos almacenados Java de la misma forma que llaman a subprogramas PL/SQL.
Figura 4: Configuración de cliente/servidor de dos niveles
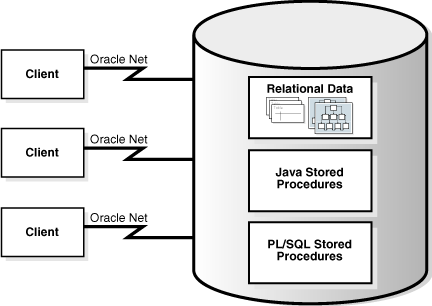
Descripción de la ilustración cncpt236.gif
-
Visión general de Java Virtual Machine (JVM) Un JVM es un procesador virtual que ejecuta código Java compilado.
-
Entorno de programación Java Oracle proporciona a los desarrolladores de aplicaciones empresariales una solución Java integral para crear, desplegar y gestionar aplicaciones Java. Consulte también: Oracle AI Database Introducción al desarrollo de Java para obtener una introducción al uso de Java con Oracle AI Database
Visión General de Java Virtual Machine (JVM)
Un JVM es un procesador virtual que ejecuta código Java compilado.
El código fuente de Java compila con instrucciones de máquina de bajo nivel, conocidas como códigos de bytes, que son independientes de la plataforma. Los códigos de byte Java se interpretan a través de JVM en acciones dependientes de la plataforma.
-
Visión General de Oracle JVM La Oracle JVM es un entorno estándar compatible con Java que ejecuta cualquier aplicación Java pura. Es compatible con JLS y las especificaciones de JVM.
-
Componentes Principales de Oracle JVM Oracle JVM se ejecuta en el mismo espacio de proceso y espacio de dirección que el núcleo de base de datos compartiendo sus pilas de memoria y accediendo directamente a sus datos relacionales. Este diseño optimiza el uso de la memoria y aumenta el rendimiento.
Visión General de Oracle JVM
Oracle JVM es un entorno estándar compatible con Java que ejecuta cualquier aplicación Java pura. Es compatible con JLS y las especificaciones de JVM.
Oracle JVM soporta las API y el formato binario Java estándar. Además, Oracle AI Database se adhiere a la semántica estándar del lenguaje Java, incluida la carga dinámica de clases en tiempo de ejecución.
En la siguiente figura se muestra cómo residen las aplicaciones Java de Oracle sobre las bibliotecas de clases principales de Java, que residen sobre la JVM de Oracle. Puesto que el sistema de soporte de Oracle Java se encuentra en la base de datos, JVM interactúa con las bibliotecas de la base de datos, en lugar de interactuar directamente con el sistema operativo.
Figura 5: Estructura de componentes Java
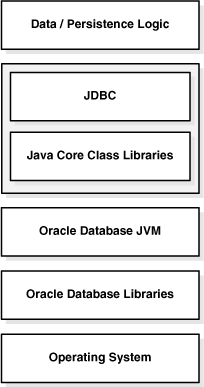
Descripción de la ilustración cncpt206.gif
A diferencia de otros entornos Java, Oracle JVM está integrado en Oracle AI Database. Existen algunas diferencias importantes entre la JVM de Oracle y las JVM de cliente típicas. Por ejemplo, en un entorno Java estándar, ejecute una aplicación Java mediante el intérprete emitiendo el siguiente comando en la línea de comandos, donde classname es el nombre de la clase que JVM interpreta en primer lugar:
java classnameEl comando anterior hace que la aplicación se ejecute dentro de un proceso en el sistema operativo. Sin embargo, si no utiliza la interfaz de línea de comandos, debe cargar la aplicación en la base de datos, publicar la interfaz y, a continuación, ejecutar la aplicación en un diccionario de datos de base de datos.
Consulte también: Consulte Oracle AI Database Java Developer's Guide para obtener una descripción de otras diferencias entre la JVM de Oracle y las JVM de cliente habituales
Componentes Principales de Oracle JVM
Oracle JVM se ejecuta en el mismo espacio de proceso y espacio de dirección que el núcleo de base de datos al compartir sus pilas de memoria y acceder directamente a sus datos relacionales. Este diseño optimiza el uso de la memoria y aumenta el rendimiento.
Oracle JVM proporciona un entorno de tiempo de ejecución para objetos Java. Soporta completamente estructuras de datos Java, distribución de métodos, manejo de excepciones y threads de nivel de lenguaje. También soporta todas las bibliotecas de clases Java principales, incluidas java.lang, java.io, java.net, java.math y java.util.
En la siguiente ilustración se muestran los componentes principales de Oracle JVM.
Figura 6: Componentes Principales de Oracle JVM
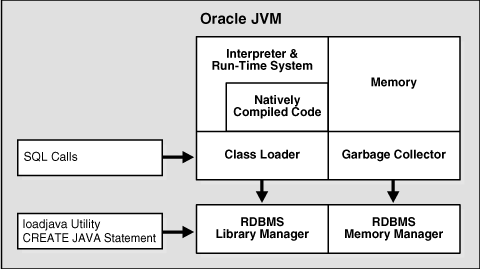
Descripción de la ilustración cncpt254.gif
Oracle JVM embebebe el espacio de nombres Java estándar en los esquemas de base de datos. Esta función permite a los programas Java acceder a los objetos Java almacenados en Oracle AI Database y los servidores de aplicaciones de toda la empresa.
Además, Oracle JVM está estrechamente integrado con la arquitectura de memoria compartida escalable de la base de datos. Los programas Java utilizan la duración de las llamadas, las sesiones y los objetos de forma eficaz sin la intervención del usuario. En consecuencia, los objetos de negocio Java de capa media y JVM de Oracle se pueden escalar, incluso cuando tienen un estado de sesión larga.
Consulte también: Guía del desarrollador de Oracle AI Database Java para obtener una descripción de los componentes principales de Oracle JVM
Entorno de programación Java
Oracle proporciona a los desarrolladores de aplicaciones empresariales una solución Java integral para crear, desplegar y gestionar aplicaciones Java.
La solución consta de interfaces programáticas del lado del cliente y del servidor, herramientas para soportar el desarrollo de Java y una Java Virtual Machine integrada con Oracle AI Database. Todos estos productos son compatibles con los estándares Java.
El entorno de programación Java consta de las siguientes funciones adicionales:
-
Los procedimientos almacenados de Java como equivalentes de Java y complementarios para PL/SQL. Los procedimientos almacenados Java están estrechamente integrados con PL/SQL. Puede llamar a procedimientos almacenados Java desde paquetes y procedimientos PL/SQL desde procedimientos almacenados Java.
-
Interfaces de programación de JDBC y SQLJ para acceder a datos SQL.
-
Herramientas y scripts que ayudan a desarrollar, cargar y gestionar clases.
-
Procedimientos almacenados Java Un procedimiento almacenado Java es un método Java publicado en SQL y almacenado en la base de datos.
-
Integración de Java y PL/SQL Puede llamar a programas PL/SQL existentes desde programas Java y Java desde PL/SQL. Esta solución protege y aprovecha el código PL/SQL y Java.
Procedimientos Almacenados Java
Un procedimiento almacenado en Java es un método Java publicado en SQL y almacenado en la base de datos.
Al igual que sucede con un subprograma PL/SQL, se puede llamar directamente a un procedimiento Java con productos como SQL*Plus o indirectamente con un disparador. Puede acceder a ella desde cualquier cliente-OCI, precompilador o JDBC de Oracle Net.
Para publicar métodos Java, se escriben especificaciones de llamada, que asignan nombres de métodos Java, tipos de parámetros y tipos de retorno a sus equivalentes SQL. Cuando las llaman las aplicaciones cliente, un procedimiento almacenado Java puede aceptar argumentos, hacer referencia a clases Java y devolver valores de resultados Java.
Aplicaciones que llaman al método Java haciendo referencia al nombre de la especificación de llamada. El sistema de tiempo de ejecución busca la definición de especificación de llamada en el diccionario de datos de Oracle y ejecuta el método Java correspondiente.
Además, puede utilizar Java para desarrollar programas potentes independientemente de PL/SQL. Oracle AI Database proporciona una implementación totalmente compatible del lenguaje de programación Java y JVM.
Consulte también: Oracle AI Database Java Developer's Guide explica cómo escribir procedimientos almacenados en Java, cómo acceder a ellos desde PL/SQL y cómo acceder a la funcionalidad PL/SQL desde Java
Integración de Java y PL/SQL
Puede llamar a programas PL/SQL existentes desde programas Java y Java desde PL/SQL. Esta solución protege y aprovecha el código PL/SQL y Java.
Oracle AI Database ofrece JDBC para acceder a datos SQL desde Java tanto en el cliente como en el servidor.
- JDBC de controladores JDBC es un protocolo de acceso a base de datos que permite conectarse a una base de datos y ejecutar sentencias SQL y consultas a la base de datos.
Controladores JDBC
JDBC es un protocolo de acceso a base de datos que permite conectarse a una base de datos y ejecutar sentencias SQL y consultas a la base de datos.
Las bibliotecas de clases Java principales proporcionan solo una API de JDBC, java.sql. Sin embargo, JDBC está diseñado para permitir a los proveedores suministrar controladores que ofrecen la especialización necesaria para una base de datos concreta. Oracle proporciona los distintos controladores JDBC que se muestran en la siguiente tabla.
Tabla 2 Controladores JDBC
| Controlador | Descripción |
|---|---|
| Controlador JDBC Thin | Puede utilizar el controlador JDBC Thin para escribir aplicaciones y applets Java puros que accedan a los datos de Oracle SQL. El controlador JDBC Thin es especialmente adecuado para aplicaciones y applets basados en Web, ya que puede descargarlo dinámicamente desde una página Web, similar a cualquier otro applet de Java. |
| Controlador JDBC OCI | El controlador JDBC OCI accede al código nativo específico de Oracle, es decir, al código que no es Java y a las bibliotecas del cliente o de la capa media, lo que proporciona un aumento del rendimiento en comparación con el controlador JDBC Thin, a costa de un tamaño significativamente mayor y de una instalación del cliente. |
| Controlador interno del servidor JDBC | Oracle AI Database utiliza el controlador interno del servidor cuando el código Java se ejecuta en el servidor. Permite a las aplicaciones Java que se ejecutan en Oracle JVM en el servidor acceder a datos definidos localmente, es decir, datos en el mismo sistema y en el mismo proceso, con JDBC. Proporciona un aumento del rendimiento, debido a su capacidad para utilizar las bibliotecas subyacentes de Oracle RDBMS directamente, sin la sobrecarga de una conexión de red intermedia entre el código Java y los datos SQL. Al admitir la misma interfaz Java-SQL en el servidor, Oracle AI Database no requiere que vuelva a procesar el código al desplegarlo. |
Consulte además:
-
Guía de desarrollo de Oracle AI Database para obtener una visión general de JDBC
-
Oracle AI Database: introducción al desarrollo de Java y Oracle AI Database JDBC Developer's Guide
Visión general de JavaScript en Oracle AI Database
JavaScript es uno de los lenguajes de programación más populares en la actualidad. Oracle AI Database desplegado en Linux x86-64 o Linux aarch64 agrega JavaScript a la lista de lenguajes soportados para el desarrollo del lado del servidor.
Puede almacenar módulos de JavaScript en la base de datos, procesando datos donde residen ofreciendo mejoras potencialmente significativas sobre los enfoques de desarrollo del lado del cliente. JavaScript es ejecutado por Multilingual Engine (MLE).
Los desarrolladores pueden elegir entre ejecutar código JavaScript independiente y almacenar código JavaScript de forma nativa en la base de datos como módulos.
-
Almacenamiento de Lógica de Negocio como Módulos en la Base de Datos Al igual que con el desarrollo del cliente relacionado con JavaScript, el código se puede almacenar juntos en forma de módulo.
-
Ejecución dinámica de desarrolladores de marco de JavaScript Code y cualquier persona que desee ejecutar código JavaScript independiente sin necesidad de almacenar código en la base de datos puede utilizar el paquete
DBMS_MLEy sus subrutinas. -
Procedimientos almacenados en línea JavaScript Las especificaciones de llamada MLE en línea embeben el código JavaScript directamente en las DDL
CREATE FUNCTIONyCREATE PROCEDURE. Consulte también: Oracle AI Database JavaScript Developer's Guide para obtener más información sobre el soporte de JavaScript en Oracle AI Database.
Almacenamiento de la Lógica de Negocio como Módulos en la Base de Datos
Al igual que con el desarrollo del lado del cliente relacionado con JavaScript, el código se puede almacenar juntos en forma de módulo.
Los desarrolladores con un fondo PL/SQL pueden pensar en un módulo JavaScript como el equivalente de un cuerpo de paquete PL/SQL, pero escrito en JavaScript. Las funciones declaradas en un módulo se pueden marcar para exportarse o mantenerse privadas.
JavaScript en Oracle AI Database cumple con el estándar ECMAScript 2023 y ofrece a los desarrolladores una amplia gama de posibilidades para almacenar la lógica de negocio dentro de la base de datos.
Nota:
Consulte también:
-
Oracle AI Database JavaScript Developer's Guide capítulo 2 para una introducción exhaustiva de los módulos MLE.
-
Guía del desarrollador de Oracle AI Database JavaScript, capítulo 5, para obtener detalles sobre las especificaciones de llamadas.
A continuación, se muestra un ejemplo de creación de un módulo JavaScript con MLE:
create mle module if not exists example_module
language javascript as

export function string2obj(inputString) {
   if ( inputString === undefined ) {
      throw `must provide a string in the form of key1=value1;...;keyN=valueN`;
   }

   let myObject = {};
   if ( inputString.length === 0 ) {
      return myObject;
   }

   const kvPairs = inputString.split(";");
   kvPairs.forEach( pair => {
      const tuple = pair.split("=");
      if ( tuple.length === 1 ) {
          tuple[1] = false;
      } else if ( tuple.length != 2 ) {
          throw "parse error: you need to use exactly one '=' between key and value and not use '=' in either key or value";
      }
      myObject[tuple[0]] = tuple[1];
  });

  return myObject;
}
/
El módulo JavaScript, también conocido como módulo MLE, ahora se almacena en el esquema del usuario. Su única función, string2obj(), se puede exponer a SQL y PL/SQL mediante la creación de una especificación de llamada. Las especificaciones de llamada son unidades de programa PL/SQL que permiten llamar al código JavaScript dondequiera que se pueda llamar a SQL y PL/SQL. La especificación de llamada para string2obj() se puede escribir de la siguiente manera:
create function if not exists p_string_to_JSON(p_str varchar2) return JSON
as mle module example_module
   signature 'string2obj(string)';
/
Con la función creada, se puede llamar desde SQL:
declare
   l_json   JSON;
   l_string VARCHAR2(100);
begin
   l_string := 'a=1;b=2;c=3;d';
   l_json := p_string_to_JSON(l_string);
   dbms_output.put_line(json_serialize(l_json PRETTY));
end;
/

{
  "a" : "1",
  "b" : "2",
  "c" : "3",
  "d" : false
}

PL/SQL procedure successfully completed.
Ejecución dinámica de código JavaScript
Los desarrolladores de marcos y cualquier persona que desee ejecutar código JavaScript independiente sin necesidad de almacenar código en la base de datos pueden utilizar el paquete DBMS_MLE y sus subrutinas.
Oracle Application Express y Database Actions, por ejemplo, integran DBMS_MLE, ocultando el hecho de que se llama a un paquete PL/SQL en las cubiertas.
En comparación con los módulos MLE, el uso de DBMS_MLE dificulta la escritura de aplicaciones completas. Por ejemplo, es más difícil dividir lógicamente una aplicación en entidades separadas. La función de depuración posterior a la ejecución requiere módulos que dificulten la resolución de problemas en los fragmentos de código. Los pipelines de integración continua (CI) también pueden tener problemas con la introducción de código PL/SQL y JavaScript en el mismo archivo. Del mismo modo, existe un problema potencial con el entorno de desarrollo integrado (IDE), ya que la mayoría tendrá dificultades para trabajar con PL/SQL y JavaScript en la misma ventana.
Nota:
Consulte también:
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre
DBMS_MLEy sus subrutinas. -
Oracle AI Database JavaScript Developer's Guide capítulo 3 para obtener más información sobre la llamada dinámica a JavaScript.
Procedimientos almacenados en línea JavaScript
Las especificaciones de llamada de MLE en línea embeben código JavaScript directamente en las DDL CREATE FUNCTION y CREATE PROCEDURE.
Si desea implantar rápidamente una funcionalidad sencilla mediante JavaScript, las especificaciones de llamada MLE en línea pueden ser una buena opción. Con esta opción, no es necesario desplegar un módulo independiente que contenga el código JavaScript. En su lugar, la función JavaScript está integrada en la definición de la especificación de llamada en sí.
La cláusula MLE LANGUAGE se utiliza para especificar que la función se implanta mediante JavaScript. La cadena que sigue al nombre de idioma se trata como el cuerpo de una función JavaScript que implementa la funcionalidad de la especificación de llamada. Cuando se ejecuta el código, los parámetros PL/SQL se convierten automáticamente al tipo JavaScript por defecto y se transfieren a la función JavaScript como parámetros con el mismo nombre. Tenga en cuenta que los nombres de parámetros sin comillas se asignan a nombres JavaScript en mayúsculas. El valor devuelto por una función JavaScript se convierte en el tipo de retorno de la especificación de llamada PL/SQL, al igual que con las especificaciones de llamada para módulos MLE.
Nota:
Consulte también:
- Oracle AI Database JavaScript Developer's Guide capítulo 5 para obtener más información sobre los procedimientos almacenados en línea JavaScript.
Visión General de Disparadores
Un disparador de base de datos es una unidad de programa almacenada compilada, escrita en PL/SQL, Java o JavaScript, que Oracle Database llama automáticamente en determinadas situaciones.
Un disparador arranca cada vez que se produce una de las siguientes operaciones:
-
Sentencias DML en una tabla o vista concreta, emitidas por cualquier usuario
Las sentencias DML modifican los datos de los objetos de esquema. Por ejemplo, la inserción y supresión de filas son operaciones DML.
-
Sentencias DDL emitidas por un usuario concreto o cualquier usuario
Las sentencias DDL definen objetos de esquema. Por ejemplo, la creación de una tabla y la adición de una columna son operaciones DDL.
-
Eventos de base de datos
La conexión o desconexión del usuario, los errores y el inicio o cierre de la base de datos son eventos que pueden llamar a disparadores.
Los disparadores son objetos de esquema que son similares a los subprogramas pero que difieren en la forma en que se llaman. Un subprograma lo ejecuta explícitamente un usuario, una aplicación o un disparador. La base de datos llama implícitamente a los disparadores cuando se produce un evento disparador.
-
Ventajas de los disparadores El uso correcto de los disparadores permite crear y desplegar aplicaciones más sólidas y que utilizan la base de datos de forma más eficaz.
-
Los disparadores de tipos de disparadores se pueden clasificar según sus medios de llamada y el tipo de acciones que realizan.
-
Tiempo para Disparadores Puede definir el tiempo del disparador, tanto si la acción del disparador se va a ejecutar antes como después de la sentencia disparadora.
-
Creación de disparadores La sentencia
CREATE TRIGGERcrea o sustituye un disparador de base de datos. -
Ejecución de Disparadores Oracle Database ejecuta un disparador internamente mediante los mismos pasos que para la ejecución del subprograma.
-
Almacenamiento de Disparadores Oracle Database almacena disparadores PL/SQL en formato compilado en un esquema de base de datos, al igual que los procedimientos almacenados PL/SQL.
Consulte además:
-
"Visión General de Sentencias SQL" para obtener más información sobre DML y DDL
-
"Visión General de Inicio y Cierre de las Instancias de Base de Datos"
Ventajas de los disparadores
El uso correcto de los disparadores permite crear y desplegar aplicaciones más sólidas y que utilizan la base de datos de forma más eficaz.
Puede utilizar disparadores para:
-
Generar automáticamente valores de columna derivados
-
Evitar transacciones no válidas
-
Proporcionar auditoría y registro de eventos
-
Registrar información sobre el acceso a la tabla
Puede utilizar disparadores para aplicar reglas de negocio de bajo nivel comunes para todas las aplicaciones cliente. Por ejemplo, varias aplicaciones pueden acceder a la tabla employees. Si un disparador de esta tabla garantiza el formato de los datos insertados, no es necesario reproducir esta lógica de negocio en todos los clientes. Puesto que la aplicación no puede eludir el disparador, la lógica de negocio del disparador se utiliza automáticamente.
Puede utilizar tanto disparadores como restricciones de integridad para definir y aplicar cualquier tipo de regla de integridad. Sin embargo, Oracle recomienda que solo utilice disparadores para aplicar reglas de negocio complejas que no se puedan definir mediante una restricción de integridad.
El uso excesivo de disparadores puede dar lugar a interdependencias complejas que pueden ser difíciles de mantener en una aplicación grande. Por ejemplo, cuando se llama a un disparador, una sentencia SQL dentro de su acción de disparador puede arrancar otros disparadores, lo que da como resultado disparadores en cascada que pueden producir efectos no deseados.
Consulte además:
-
Oracle AI Database: Introducción al desarrollo de Oracle AI Database
-
Referencia de lenguaje PL/SQL de Oracle AI Database para obtener directrices y restricciones al planificar disparadores para su aplicación
automáticamente en ciertas situaciones.")
Tipos de disparadores
Los disparadores se pueden clasificar según sus medios de llamada y el tipo de acciones que realizan.
Oracle Database soporta los siguientes tipos de disparadores:
-
Disparadores de fila
Un disparador de fila se arranca cada vez que la sentencia disparadora afecta a la tabla. Por ejemplo, si una sentencia actualiza varias filas, un disparador de fila se arranca una vez para cada fila afectada por
UPDATE. Si una sentencia disparadora no afecta a ninguna fila, no se ejecuta un disparador de fila. Los disparadores de fila son útiles si el código de la acción del disparador depende de los datos proporcionados por la sentencia disparadora o las filas afectadas. -
Disparadores de sentencias
Un disparador de sentencia arranca una vez en nombre de la sentencia disparadora, independientemente del número de filas afectadas por la sentencia disparadora. Por ejemplo, si una sentencia suprime 100 filas de una tabla, un disparador
DELETEde nivel de sentencia solo arranca una vez. Los disparadores de sentencia son útiles si el código de la acción de disparador no depende de los datos proporcionados por la sentencia disparadora o de las filas afectadas. -
Disparadores
INSTEAD OFOracle Database arranca un disparador INSTEAD OF en lugar de ejecutar la sentencia disparadora. Estos disparadores son útiles para modificar de forma transparente vistas que no se pueden modificar directamente mediante sentencias DML.
-
Disparadores de evento
Puede utilizar disparadores para publicar información sobre eventos de base de datos en los suscriptores. Los disparadores de eventos se dividen en las siguientes categorías:
-
Un disparador de eventos del sistema puede estar causado por eventos como el inicio y el cierre de la instancia de base de datos o mensajes de error.
-
Un disparador de evento de usuario arranca debido a eventos relacionados con la conexión y desconexión del usuario, sentencias DDL y sentencias DML.
-
Consulte además:
automáticamente en ciertas situaciones.")
Tiempo para disparadores
Puede definir el tiempo del disparador, independientemente de si la acción del disparador se va a ejecutar antes o después de la sentencia disparadora.
Un disparador simple es un único disparador en una tabla que permite especificar acciones para exactamente uno de los siguientes puntos de temporización:
-
Antes de la sentencia de arranque
-
Antes de cada fila afectada por la sentencia de arranque
-
Después de cada fila afectada por la sentencia de arranque
-
Después de la sentencia de arranque
Para los disparadores de sentencia y fila, un disparador BEFORE puede mejorar la seguridad y activar las reglas de negocio antes de realizar cambios en la base de datos. El disparador AFTER es ideal para registrar acciones.
Un disparador compuesto puede arrancar en varios puntos en temporización. Los disparadores compuestos ayudan a programar un enfoque en el que las acciones que implanta para varios puntos de temporización comparten datos comunes.
Consulte también: Referencia de lenguaje PL/SQL de Oracle AI Database para obtener más información sobre los disparadores compuestos
automáticamente en ciertas situaciones.")
Creación de disparadores
La sentencia CREATE TRIGGER crea o sustituye un disparador de base de datos.
Un disparador PL/SQL tiene el siguiente formato sintáctico general:
CREATE TRIGGER trigger_name
  triggering_statement
  [trigger_restriction]
BEGIN
 triggered_action;
END;
Un disparador PL/SQL tiene los siguientes componentes básicos:
-
Nombre del disparador
El nombre debe ser único entre otros nombres de disparador del mismo esquema. Por ejemplo, el nombre puede ser
part_reorder_trigger. -
El evento o sentencia disparador
Un evento o sentencia disparadora es la sentencia SQL, el evento de base de datos o el evento de usuario que hace que se llame a un disparador. Por ejemplo, un usuario actualiza una tabla.
-
Restricción de disparador
Una restricción de disparador especifica una expresión booleana que debe ser
truepara que el disparador se arranque. Por ejemplo, el disparador no se llama a menos que el número de piezas disponibles sea menor que un importe de reorden actual. -
Acción disparada
Una acción disparada es el procedimiento que contiene las sentencias SQL y el código que se va a ejecutar cuando se emite una sentencia disparadora y la restricción del disparador se evalúa como true. Por ejemplo, un usuario inserta una fila en una tabla de pedidos pendientes.
-
Ejemplo: sentencia CREATE TRIGGER Este ejemplo crea un disparador que se arranca cuando se ejecuta una sentencia
INSERT,UPDATEoDELETEen una tabla de líneas de ítem. -
Ejemplo: llamada a un disparador de nivel de fila En este escenario, un cliente inicia dos órdenes y agrega y elimina líneas de artículo de las órdenes.
Consulte además:
-
Oracle AI Database Introducción a Oracle AI Database Development y Referencia de lenguaje PL/SQL de Oracle AI Database para aprender a crear disparadores
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
CREATE TRIGGER
automáticamente en ciertas situaciones.")
Ejemplo: sentencia CREATE TRIGGER
En este ejemplo se crea un disparador que se arranca cuando se ejecuta una sentencia INSERT, UPDATE o DELETE en una tabla de líneas de ítem.
Supongamos que crea las tablas orders y lineitems con las siguientes sentencias. La tabla orders contiene una fila para cada orden único, mientras que la tabla lineitems contiene una fila para cada elemento de un orden.
CREATE TABLE orders
( order_id NUMBER PRIMARY KEY,
  /* other attributes */
  line_items_count NUMBER DEFAULT 0 );

CREATE TABLE lineitems
( order_id REFERENCES orders,
  seq_no   NUMBER,
  /* other attributes */
  CONSTRAINT lineitems PRIMARY KEY(order_id,seq_no) );
La siguiente sentencia crea un disparador de ejemplo que actualiza automáticamente la tabla orders con el número de elementos en un orden:
CREATE OR REPLACE TRIGGER lineitems_trigger
  AFTER INSERT OR UPDATE OR DELETE ON lineitems
  FOR EACH ROW
BEGIN
  IF (INSERTING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)+1
    WHERE order_id = :new.order_id;
  END IF;
  IF (DELETING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)-1
    WHERE order_id = :old.order_id;
  END IF;
END;
/
En lineitems_trigger, la sentencia disparadora es INSERT, UPDATE o DELETE en la tabla lineitems. No existe ninguna restricción disparadora. Se llama al disparador para cada fila cambiada. El disparador tiene acceso a los valores de columna antiguos y nuevos de la fila actual afectada por la sentencia disparadora. Existen dos nombres de correlación para cada columna de la tabla que se va a modificar: el valor antiguo (:old) y el nuevo (:new). Si una sesión actualiza o inserta filas en lineitems para un pedido, después de la acción, el disparador calcula el número de artículos en este pedido y actualiza la tabla orders con el recuento.
Ejemplo: Llamada a un Disparador de Nivel de Fila
En este escenario, un cliente inicia dos pedidos y agrega y elimina líneas de ítem de los pedidos.
El escenario se basa en el disparador creado en el ejemplo: sentencia CREATE TRIGGER.
Tabla 3 Escenario de disparador de nivel de fila
| Sentencia SQL | Sentencia SQL Disparada | Descripción |
|---|---|---|
SQL> INSERT INTO orders (order_id) VALUES (78); 1 row created. |
El cliente crea un pedido con el ID 78. En este punto, el cliente no tiene artículos en la orden. Puesto que no se realiza ninguna acción en la tabla |
|
SQL> INSERT INTO orders (order_id) VALUES (92); 1 row created. |
El cliente crea un pedido independiente con el ID 92. En este punto, el cliente no tiene artículos en la orden. Puesto que no se realiza ninguna acción en la tabla |
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,1); 1 row created. |
UPDATE orders SET line_items_count = NVL(NULL,0)+1 WHERE order_id = 78; |
El cliente agrega un artículo al pedido 78.
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,2); 1 row created. |
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 78; |
El cliente agrega un artículo adicional a la orden 78.
|
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 2 92 0 |
El cliente consulta el estado de los dos pedidos. La Orden 78 contiene dos artículos. La orden 92 no contiene artículos. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 78 1 78 2 |
El cliente consulta el estado de las líneas de ítem. Cada artículo se identifica de forma exclusiva mediante el ID de pedido y el número de secuencia. | |
SQL> UPDATE lineitems SET order_id = 92; 2 rows updated. |
UPDATE orders
  SET line_items_count =
  NVL(NULL,0)+1
 WHERE order_id = 92;

  UPDATE orders
  SET line_items_count =
  NVL(2,0)-1
 WHERE order_id = 78;
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 78; |
El cliente mueve las líneas de ítem de la orden 78 a la orden 92. La sentencia Cada vez que se llama al disparador, se cumplen ambas condiciones |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 2 |
El cliente consulta el estado de los dos pedidos. El efecto neto es que el recuento de líneas de artículo de la orden 92 ha aumentado de 0 a 2, mientras que el recuento de la orden 78 ha disminuido de 2 a 0. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 92 1 92 2 |
El cliente consulta el estado de las líneas de ítem. Cada artículo se identifica de forma exclusiva mediante el ID de pedido y el número de secuencia. | |
SQL> DELETE FROM lineitems; 2 rows deleted. |
UPDATE orders SET line_items_count = NVL(2,0)-1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 92; |
El cliente ahora elimina todas las líneas de artículo de todas las órdenes. La sentencia |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 0 SQL> SELECT * FROM lineitems; no rows selected |
El cliente consulta el estado de los dos pedidos. Ninguna de las órdenes contiene líneas de artículo. El cliente también consulta el estado de las líneas de ítem. No existen artículos. |
Ejecución de activadores
Oracle Database ejecuta un disparador internamente mediante los mismos pasos que para la ejecución del subprograma.
La única diferencia sutil es que una cuenta de usuario tiene derecho a disparar un disparador si tiene el privilegio de ejecutar la sentencia disparadora. Con esta excepción, la base de datos valida y ejecuta los disparadores de la misma forma que los subprogramas almacenados.
Consulte también: Referencia de lenguaje PL/SQL de Oracle AI Database para obtener más información sobre la ejecución de disparadores
automáticamente en ciertas situaciones.")
Almacenamiento de Disparadores
Oracle Database almacena disparadores PL/SQL en formato compilado en un esquema de base de datos, al igual que los procedimientos almacenados PL/SQL.
Cuando se confirma una sentencia CREATE TRIGGER, el código PL/SQL compilado se almacena en la base de datos. El pool compartido elimina el código fuente del disparador PL/SQL.
En el siguiente gráfico se muestra una aplicación de base de datos con sentencias SQL que llaman implícitamente a disparadores PL/SQL. Los disparadores se almacenan independientemente de sus tablas asociadas.
Figura 7: Disparadores
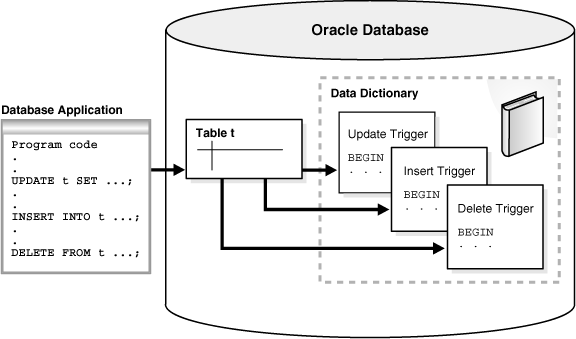
Descripción de la ilustración cncpt076.gif
Los disparadores Java se almacenan de la misma forma que los disparadores PL/SQL. Sin embargo, un disparador Java hace referencia al código Java que se ha compilado por separado con una sentencia CALL. Por lo tanto, la creación de un disparador Java implica la creación de código Java y la creación del disparador que hace referencia a este código Java.
Consulte también: Referencia de lenguaje PL/SQL de Oracle AI Database para obtener más información sobre la compilación y el almacenamiento de disparadores
automáticamente en ciertas situaciones.")