Instancia de Oracle AI Database
En este capítulo se explica la naturaleza de una instancia de base de datos Oracle, los archivos de parámetros y de diagnóstico asociados a una instancia y lo que ocurre durante la creación de la instancia y la apertura y el cierre de una base de datos.
Nota: A efectos de este capítulo, el término "base de datos" hace referencia a una base de datos de contenedor (CDB) multi-inquilino, a menos que se indique lo contrario.
-
Introducción a la instancia de Oracle AI Database Una instancia de base de datos es un juego de estructuras de memoria que gestionan archivos de base de datos.
-
Visión general del inicio y cierre de instancias de base de datos Una instancia de base de datos proporciona acceso de usuario a una base de datos. La instancia y la base de datos pueden estar en varios estados.
-
Visión general de puntos de control Un punto de control es un mecanismo crucial en cierres de bases de datos coherentes, recuperación de instancias y operación de Oracle AI Database en general.
-
Visión General de Recuperación de Instancias
La recuperación de instancias es el proceso de aplicación de registros en el redo log en línea a los archivos de datos para reconstruir los cambios realizados después del punto de control más reciente.
-
Visión general de archivos de parámetros Para iniciar una instancia de base de datos, Oracle AI Database debe leer un archivo de parámetros del servidor, que se recomienda, o un archivo de parámetros de inicialización de texto, que es una implementación heredada. Estos archivos contienen una lista de parámetros de configuración.
-
Visión general de archivos de diagnóstico Oracle AI Database incluye una infraestructura de diagnóstico de fallos para prevenir, detectar, diagnosticar y resolver problemas de la base de datos. Los problemas incluyen errores críticos, como bugs de código, corrupción de metadatos y corrupción de datos de clientes.
Introducción a la instancia de Oracle AI Database
Una instancia de base de datos es un juego de estructuras de memoria que gestionan archivos de base de datos.
En el nivel físico, una CDB es un juego de archivos en disco creado por la sentencia CREATE DATABASE. Una CDB contiene una o más PDB creadas con el usuario. Una PDB contiene su propio juego de archivos de datos dentro del juego general de archivos de datos que pertenece a la CDB. La instancia de base de datos gestiona los datos asociados a la CDB y sus PDB y sirve a sus usuarios.
Cada CDB en ejecución está asociada a al menos una instancia de base de datos Oracle. Puesto que una instancia existe en la memoria y una base de datos (en el sentido más estrecho del término) es un juego de archivos en el disco, una instancia puede existir sin una base de datos y una base de datos puede existir sin una instancia.
-
Estructura de instancia de base de datos Cuando se inicia una instancia, Oracle AI Database asigna un área de memoria denominada área global del sistema (SGA) e inicia uno o más procesos en segundo plano.
-
Configuraciones de instancia de base de datos Oracle AI Database se ejecuta en una configuración de instancia única o en una configuración de Oracle Real Application Clusters (Oracle RAC). Estas configuraciones se excluyen mutuamente.
-
Instancias de lectura/escritura y de solo lectura Cada instancia de base de datos es de lectura/escritura o de solo lectura.
-
Duración de una instancia de base de datos Una instancia de base de datos comienza cuando se crea con el comando
STARTUPy termina cuando se termina. -
Identificación de una instancia de base de datos Pueden residir varias instancias de base de datos en un único host. Por lo tanto, debe tener un medio para especificar a qué instancia desea acceder.
Estructura de instancia de base de datos
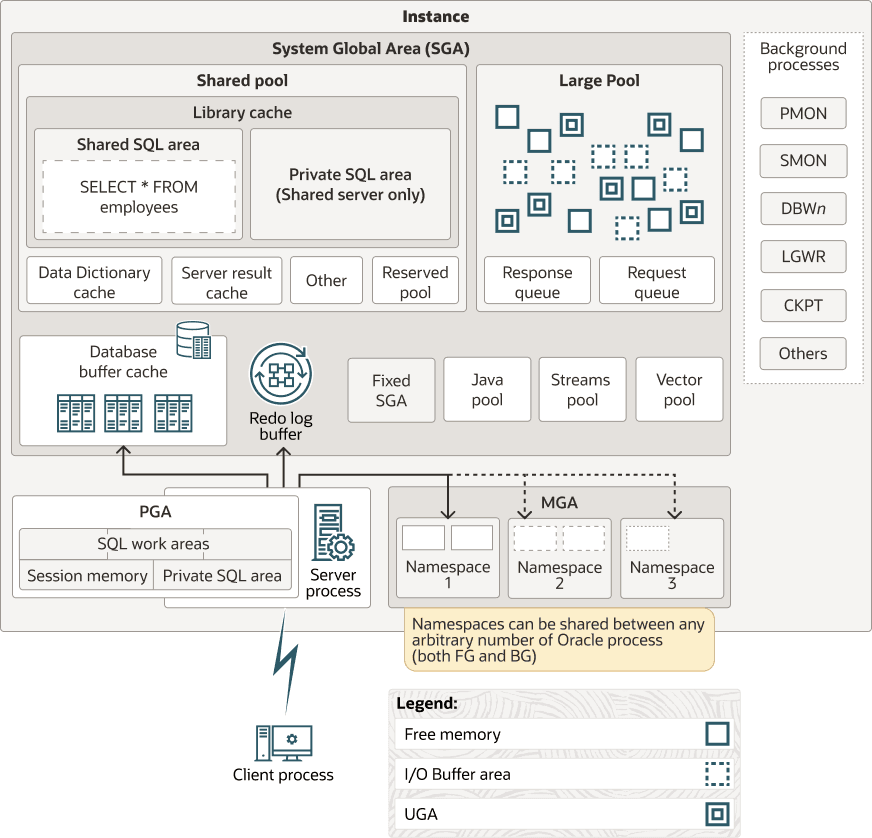
Cuando se inicia una instancia, Oracle AI Database asigna un área de memoria denominada área global del sistema (SGA) e inicia uno o más procesos en segundo plano.
El SGA tiene diversos fines, incluidos los siguientes:
-
Mantenimiento de estructuras de datos internas a las que acceden simultáneamente muchos procesos y threads
-
Almacenamiento en caché de bloques de datos leídos desde el disco
-
Almacenamiento en buffer de los datos de redo antes de escribirlos en los archivos redo log en línea
-
Almacenamiento de planes de ejecución SQL
Los procesos de Oracle que se ejecutan en una única computadora comparten el SGA. La forma en que los procesos de Oracle se asocian a SGA varía en función del sistema operativo.
Una instancia de base de datos también incluye procesos en segundo plano y procesos de servidor. Cada proceso tiene su propia memoria dedicada considerada como parte de la instancia. La instancia sigue funcionando cuando terminan los procesos del servidor.
En el siguiente gráfico se muestran los componentes principales de una instancia de base de datos Oracle.
Figura 1: Instancia de base de datos
Descripción de la ilustración cncpt325.png
Consulte además:
Configuraciones de instancia de base de datos
Oracle AI Database se ejecuta en una configuración de instancia única o en una configuración de Oracle Real Application Clusters (Oracle RAC). Estas configuraciones se excluyen mutuamente.
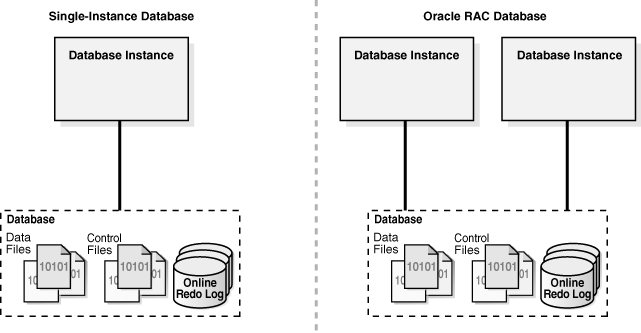
En una configuración de instancia única, existe una relación de uno a uno entre la base de datos y una instancia de base de datos. En Oracle RAC, existe una relación de uno a varios entre la base de datos y las instancias de base de datos.
En la siguiente figura se muestran las posibles configuraciones de instancias de base de datos.
Figura 2: Configuraciones de instancia de base de datos
Descripción de la ilustración cncpt296.gif
Ya sea en una configuración de instancia única u Oracle RAC, una instancia de base de datos está asociada a una sola base de datos a la vez. Puede iniciar una instancia de base de datos y montar (asociar la instancia a) una base de datos, pero no montar dos bases de datos simultáneamente con la misma instancia. Nota: En este capítulo se trata una configuración de base de datos de instancia única, a menos que se indique lo contrario.
Varias instancias se pueden ejecutar simultáneamente en la misma computadora, cada una con acceso a su propia base de datos. Por ejemplo, una computadora puede alojar dos bases de datos distintas: prod1 y prod2. Una instancia de base de datos gestiona prod1, mientras que una instancia independiente gestiona prod2.
Consulte también: Guía de despliegue y administración de Oracle Real Application Clusters para obtener información específica de Oracle RAC
Instancias de lectura/escritura y de solo lectura
Cada instancia de base de datos es de lectura/escritura o de solo lectura.
Una instancia de base de datos de lectura/escritura, que es el valor por defecto, puede procesar DML y soporta conexiones directas desde aplicaciones cliente. Por el contrario, una instancia de base de datos de sólo lectura puede procesar consultas, pero no soporta la modificación de DML (UPDATE, DELETE, INSERT y MERGE) ni conexiones de cliente directas.
Nota: A menos que se indique lo contrario en este manual, todas las referencias a instancias de base de datos son a instancias de lectura/escritura.
En versiones anteriores, todas las instancias de base de datos, a menos que accedieran a una base de datos en espera, eran de lectura/escritura. A partir de Oracle Database 12c versión 2 (12.2), las instancias de solo lectura y de lectura/escritura pueden coexistir en una única base de datos. Esta configuración es útil para sentencias SQL paralelas que consultan y modifican datos, ya que tanto las instancias de lectura/escritura como las de solo lectura pueden consultar, mientras que las instancias de lectura/escritura modifican.
A diferencia de las instancias de lectura/escritura, las instancias de solo lectura tienen las siguientes características:
-
Solo se puede abrir una base de datos que ya haya sido abierta por una instancia de lectura/escritura
-
Desactivar muchos procesos en segundo plano, incluidos los procesos de punto de control y archivador, que no son necesarios
-
Puede montar un thread de redo desactivado o un thread sin ningún redo log en línea
Para designar una instancia como de solo lectura, defina el parámetro de inicialización INSTANCE_MODE en READ_ONLY. El valor por defecto del parámetro es READ_WRITE.
Consulte además:
-
"Visión General de Procesos en Segundo Plano" para obtener más información sobre los procesos de punto de control y en segundo plano del archivador
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
INSTANCE_MODE
Duración de una instancia de base de datos
Una instancia de base de datos comienza cuando se crea con el comando STARTUP y termina cuando se termina.
Durante este período, una instancia de base de datos se puede asociar a una sola base de datos. Además, la instancia solo puede montar una base de datos una vez, cerrarla solo una vez y abrirla solo una vez. Después de cerrar o cerrar una base de datos, debe iniciar una instancia diferente para montar y abrir esta base de datos.
La siguiente tabla ilustra una instancia de base de datos que intenta volver a abrir una base de datos que ha cerrado anteriormente.
Tabla 1 Duración de una instancia
| Sentencia | Explicación |
|---|---|
|
El comando STARTUP crea una instancia, que monta y abre la base de datos. |
|
Esta consulta muestra la hora a la que se inició la instancia actual. |
|
La instancia cierra la base de datos y se cierra, poniendo fin a la vida útil de esta instancia. |
|
El comando STARTUP crea una nueva instancia y monta y abre la base de datos. |
|
Esta consulta muestra la hora a la que se inició la instancia actual. La hora de inicio diferente muestra que esta instancia es diferente de la que cierra la base de datos. |
Identificación de una instancia de base de datos
Varias instancias de base de datos pueden residir en un único host. Por lo tanto, debe tener un medio para especificar a qué instancia desea acceder. Las reglas de Oracle Optimal Flexible Architecture (OFA) son un juego de directrices de configuración creadas para garantizar instalaciones de Oracle bien organizadas. En los ejemplos de esta sección se asume una arquitectura OFA.
Esta sección incluye los siguientes temas:
-
Directorio Base de Oracle El directorio base de Oracle almacena los binarios para los productos de Oracle.
-
Directorio raíz de Oracle El directorio raíz de Oracle es la ubicación de software de una base de datos Oracle.
-
Identificador del sistema (SID) de Oracle El identificador del sistema (SID) es un nombre único para una instancia de base de datos Oracle en un host específico. Consulte también: Guía de instalación de Oracle AI Database para Linux para obtener una visión general de OFA
Directorio Base de Oracle
El directorio base de Oracle almacena los binarios de los productos de Oracle.
El directorio base de Oracle es el directorio raíz de la base de datos para los propietarios de la instalación de Oracle AI Database. Puede haber muchas instalaciones de Oracle AI Database en un host y muchos propietarios de instalaciones de software de Oracle AI Database.
En el siguiente ejemplo se muestra el directorio base de Oracle de la cuenta de usuario del sistema operativo oracle:
/u01/app/oracleEn la ruta anterior, /u01/ es el punto de montaje y /u01/app/ es el subárbol del software de la aplicación.
Consulte también: Guía de instalación de Oracle AI Database para Linux para obtener una visión general de la base de datos de Oracle
Directorio Raíz de Oracle
El directorio raíz de Oracle es la ubicación de software de una base de datos Oracle.
Debe especificar un nuevo directorio principal de Oracle para cada instalación nueva de software de Oracle AI Database. A partir de Oracle Database 21c, el directorio raíz de Oracle es de solo lectura. El directorio raíz de Oracle almacena archivos estáticos, como archivos binarios.
Por defecto, el directorio raíz de Oracle es un descendiente del árbol de directorios base (ORACLE_BASE) de Oracle. Puede instalar esta versión, o versiones anteriores del software de base de datos, más de una vez en el mismo host, en diferentes directorios raíz de Oracle dentro de un único base de Oracle. Varias bases de datos, de diferentes versiones y propiedad de diferentes cuentas de usuario, pueden coexistir simultáneamente.
En el siguiente ejemplo se muestran los nombres de ruta de acceso completa de tres directorios raíz de Oracle diferentes, todos dentro del mismo directorio base de Oracle de /u01/app/oracle/:
/u01/app/oracle/product/19.3.0/dbhome_1
/u01/app/oracle/product/19.3.0/dbhome_2
/u01/app/oracle/product/20.1.0/dbhome_1
La parte del nombre de la ruta después del directorio base de Oracle (/u01/app/oracle/) incluye el número de versión del producto (por ejemplo, 19.3.0) y el directorio relativo del directorio raíz de Oracle (por ejemplo, dbhome_1). El directorio /u01/app/oracle/product/19.3.0/ contiene dos directorios raíz de Oracle independientes: dbhome_1 y dbhome_2.
El directorio directorio raíz base de Oracle (ORACLE_BASE_HOME), que se encuentra en ORACLE_BASE/homes/home_name, almacena archivos dinámicos específicos de un directorio raíz de Oracle. El directorio de configuración base de Oracle (ORACLE_BASE_CONFIG), que comparten todos los directorios raíz de Oracle en un directorio base de Oracle, almacena archivos dinámicos específicos de la instancia.
En el siguiente ejemplo, la primera ruta es un directorio raíz de Oracle y la segunda ruta es el directorio raíz base de Oracle para este directorio raíz de Oracle:
/u01/app/oracle/product/20.1.0/dbhome_1
/u01/app/oracle/homes/dbhome_1
Consulte también: Oracle AI Database Installation Guide for Linux para obtener una visión general del directorio raíz de Oracle
Identificador del Sistema Oracle (SID)
El identificador del sistema (SID) es un nombre único para una instancia de base de datos Oracle en un host específico.
En UNIX y Linux, Oracle AI Database utiliza el SID y los valores del directorio raíz de Oracle para crear una clave para la memoria compartida. Además, Oracle AI Database utiliza el SID por defecto para localizar el archivo de parámetros de inicialización, que localiza archivos relevantes como los archivos de control de la base de datos.
En la mayoría de las plataformas, la variable de entorno ORACLE_SID define el SID y la variable ORACLE_HOME define el directorio raíz de Oracle. Al conectarse a una instancia de base de datos, los clientes pueden especificar el SID en una conexión de Red de Oracle o utilizar un nombre de servicio de red. Oracle AI Database convierte un nombre de servicio de red en ORACLE_HOME y ORACLE_SID.
Los archivos específicos de la instancia se almacenan por separado en la base de Oracle. Los archivos cuyos nombres incluyen el SID residen en el subdirectorio dbs del directorio de configuración base de Oracle (ORACLE_BASE_CONFIG). Debido a esta separación, puede crear una base de datos con software en un directorio raíz de Oracle existente y, a continuación, iniciar una instancia para esta base de datos con software que reside en un nuevo directorio raíz de Oracle.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a especificar un SID de Oracle
Visión General de Inicio y Cierre de Instancias de Base de Datos
Una instancia de base de datos proporciona acceso de usuario a una base de datos. La instancia y la base de datos pueden estar en varios estados.
-
Visión general del inicio de instancias y bases de datos Normalmente, se inicia manualmente una instancia y, a continuación, se monta y se abre la base de datos, lo que hace que esté disponible para los usuarios. Puede utilizar el comando
STARTUPde SQL*Plus, Oracle Enterprise Manager (Enterprise Manager) o la utilidad SRVCTL para realizar estos pasos. -
Visión General del Cierre de Base de Datos e Instancia En un caso de uso típico, cierre manualmente la base de datos, lo que hace que no esté disponible para los usuarios mientras realiza tareas de mantenimiento u otras tareas administrativas. Puede utilizar el comando
SHUTDOWNde SQL*Plus o Enterprise Manager para realizar estos pasos.
Visión General del Inicio de Instancia y Base de Datos
Normalmente, inicia manualmente una instancia y, a continuación, monta y abre la base de datos, lo que hace que esté disponible para los usuarios. Puede utilizar el comando STARTUP de SQL*Plus, Oracle Enterprise Manager (Enterprise Manager) o la utilidad SRVCTL para realizar estos pasos.
Para iniciar una instancia de base de datos con la Red de Oracle, se debe cumplir lo siguiente:
-
La base de datos se registra estáticamente con un listener de Red de Oracle.
-
El cliente está conectado a la base de datos con el privilegio
SYSDBA.
El listener crea un servidor dedicado, que puede iniciar la instancia de base de datos.
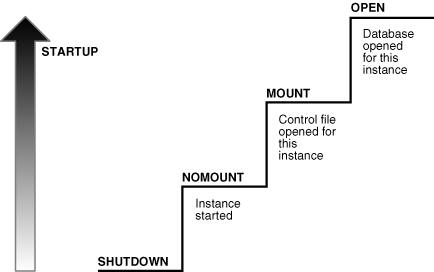
En el siguiente gráfico se muestra cómo la base de datos avanza de un estado de cierre a un estado abierto.
Figura 3: Secuencia de Inicio de Instancia y Base de Datos
Descripción de la ilustración cncpt212.gif
Una base de datos realiza las siguientes fases cuando pasa de un estado de cierre a un estado de base de datos abierta.
Tabla 2 Pasos en el inicio de la instancia
| Fase | Estado de montaje | Descripción | Para saber más |
|---|---|---|---|
| 1 | Instancia iniciada sin montar la base de datos | La instancia se ha iniciado, pero aún no está asociada a una base de datos. | "Cómo se inicia una instancia" |
| 2 | Base de datos montada | La instancia se inicia y se asocia a una base de datos leyendo su archivo de control. La base de datos está cerrada a los usuarios. | "Cómo se monta una base de datos" |
| 3 | Apertura de Base de Datos | La instancia se inicia y está asociada a una base de datos abierta. Los datos contenidos en los archivos de datos son accesibles para los usuarios autorizados. | "Cómo se abre una base de datos" |
-
Conexión con privilegios de administrador El inicio y el cierre de la base de datos son potentes opciones administrativas que están restringidas a los usuarios que se conectan a Oracle AI Database con privilegios de administrador.
-
Cómo se inicia una instancia Cuando Oracle AI Database inicia una instancia, avanza por etapas.
-
Cómo se monta una base de datos La instancia monta una base de datos para asociar la base de datos a esta instancia.
-
Cómo se abre una base de datos La apertura de una base de datos montada hace que esté disponible para el funcionamiento normal de la base de datos.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a iniciar una instancia
-
Oracle AI Database Administrator's Guide para aprender a utilizar SRVCTL
Conexión con Privilegios de Administrador
El inicio y el cierre de la base de datos son potentes opciones administrativas que están restringidas a los usuarios que se conectan a Oracle AI Database con privilegios de administrador.
Los usuarios normales no tienen control sobre el estado actual de una base de datos Oracle. Según el sistema operativo, una de las siguientes condiciones establece privilegios de administrador para un usuario:
-
Los privilegios del sistema operativo del usuario permiten al usuario conectarse mediante privilegios de administrador.
-
Al usuario se le otorgan privilegios especiales del sistema y la base de datos utiliza archivos de contraseña para autenticar a los administradores de la base de datos a través de la red.
Los siguientes privilegios especiales del sistema permiten el acceso a una instancia de base de datos incluso cuando la base de datos no está abierta:
-
SYSDBA -
SYSOPER -
SYSBACKUP -
SYSDG -
SYSKM
El control de los privilegios anteriores está fuera de la propia base de datos. Al conectarse a una base de datos con el privilegio del sistema SYSDBA, se encuentra en el esquema propiedad de SYS. Cuando se conecta como SYSOPER, se encuentra en el esquema público. Los privilegios SYSOPER son un subjuego de privilegios SYSDBA.
Consulte además:
-
Oracle AI Database Security Guide para obtener más información sobre las cuentas administrativas predefinidas
-
Oracle AI Database Administrator's Guide para obtener información sobre los privilegios del sistema
-
Oracle AI Database Installation Guide para obtener más información sobre los grupos de privilegios del sistema operativo
Cómo se inicia una instancia
Cuando Oracle AI Database inicia una instancia, avanza por etapas.
Las etapas son las siguientes:
-
Busca un archivo de parámetros del servidor en una ubicación predeterminada específica de la plataforma y, si no se encuentra, un archivo de parámetros de inicialización de texto (especificar
STARTUPcon los parámetrosSPFILEoPFILEsustituye el comportamiento predeterminado). -
Lee el archivo de parámetros para determinar los valores de los parámetros de inicialización
-
Asigna el SGA según la configuración del parámetro de inicialización
-
Inicia los procesos en segundo plano de Oracle
-
Abre los archivos de rastreo y alert log y escribe todos los valores de parámetros explícitos en el log de alertas en una sintaxis de parámetros válida
En esta etapa, no hay ninguna base de datos asociada a la instancia. Los escenarios que necesitan un estado NOMOUNT incluyen la creación de la base de datos y determinadas operaciones de copia de seguridad y recuperación.
Consulte también: Oracle AI Database Administrator's Guide para aprender a gestionar los parámetros de inicialización mediante un archivo de parámetros del servidor
Cómo se monta una base de datos
La instancia monta una base de datos para asociar la base de datos a esta instancia.
Para montar la base de datos, la instancia obtiene los nombres de los archivos de control de la base de datos especificados en el parámetro de inicialización CONTROL_FILES y abre los archivos. Oracle AI Database lee los archivos de control para buscar los nombres de los archivos de datos y los archivos redo log en línea a los que intentará acceder al abrir la base de datos.
En una base de datos montada, la base de datos se cierra y solo pueden acceder a ella los administradores de la base de datos. Los administradores pueden mantener la base de datos cerrada al completar operaciones de mantenimiento específicas. Sin embargo, la base de datos no está disponible para operaciones normales.
Si Oracle AI Database permite que varias instancias monten la misma base de datos simultáneamente, la configuración del parámetro de inicialización CLUSTER_DATABASE puede hacer que la base de datos esté disponible para varias instancias. El comportamiento de la base de datos depende de la configuración:
-
Si
CLUSTER_DATABASEesfalse(por defecto) para la primera instancia que monta una base de datos, solo esta instancia puede montar la base de datos. -
Si
CLUSTER_DATABASEestruepara la primera instancia, otras instancias pueden montar la base de datos si sus valores de parámetroCLUSTER_DATABASEestán definidos entrue. El número de instancias que pueden montar la base de datos está sujeto a un máximo predeterminado especificado al crear la base de datos.
Consulte además:
-
Guía del administrador de Oracle AI Database para aprender a montar una base de datos
-
Guía de administración y despliegue de Oracle Real Application Clusters para obtener más información sobre el uso de varias instancias con una única base de datos
Cómo se abre una base de datos
Abrir una base de datos montada hace que esté disponible para el funcionamiento normal de la base de datos.
Cualquier usuario válido puede conectarse a una base de datos abierta y acceder a su información. Normalmente, un administrador de la base de datos abre la base de datos para que esté disponible para uso general.
Al abrir la base de datos, Oracle AI Database realiza las siguientes acciones:
-
Abre los archivos de datos en línea en tablespaces que no sean de deshacer
Si un tablespace estaba fuera de línea cuando la base de datos se cerró anteriormente, el tablespace y sus correspondientes archivos de datos estarán fuera de línea cuando la base de datos se vuelva a abrir.
-
Adquiere un tablespace de deshacer
Si existen varios tablespaces de deshacer, el parámetro de inicialización
UNDO_TABLESPACEdesigna el tablespace de deshacer que se va a utilizar. Si no se define este parámetro, se selecciona el primer tablespace de deshacer disponible. -
Abre los archivos redo log en línea
-
Modo de Sólo Lectura Por defecto, la base de datos se abre en modo de lectura/escritura. En este modo, los usuarios pueden realizar cambios en los datos, generando redo en el redo log en línea. También se puede abrir en el modo de solo lectura para evitar que las transacciones de usuario modifiquen los datos.
-
Comprobaciones de Archivos de Base de Datos Si alguno de los archivos de datos o archivos redo log no está presente cuando la instancia intenta abrir la base de datos, o si los archivos están presentes pero fallan las pruebas de consistencia, la base de datos devuelve un error. Puede ser necesaria la recuperación de medios físicos.
Consulte además:
-
Oracle AI Database Backup and Recovery User's Guide para obtener más información sobre la reparación de datos
Modo de solo lectura
Por defecto, la base de datos se abre en el modo de lectura/escritura. En este modo, los usuarios pueden realizar cambios en los datos, generando redo en el redo log en línea. También se puede abrir en el modo de solo lectura para evitar que las transacciones de usuario modifiquen los datos. Nota: Por defecto, una base de datos en espera física se abre en modo de solo lectura.
El modo de solo lectura restringe el acceso a la base de datos a transacciones de solo lectura, que no pueden escribir en archivos de datos ni en archivos redo log en línea. Sin embargo, la base de datos puede realizar operaciones de recuperación que cambien el estado de la base de datos sin generar redo. Por ejemplo, en modo de solo lectura:
-
Los archivos de datos se pueden desconectar y conectar. Sin embargo, no puede poner fuera de línea los tablespaces permanentes.
-
Los tablespaces y archivos de datos fuera de línea se pueden recuperar.
-
El archivo de control permanece disponible para las actualizaciones sobre el estado de la base de datos.
-
Los tablespaces temporales creados con la sentencia
CREATE TEMPORARY TABLESPACEson de lectura/escritura. -
Las escrituras en las pistas de auditoría del sistema operativo, los archivos de rastreo y los logs de alertas pueden continuar.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a abrir una base de datos en modo de solo lectura
Comprobaciones de archivos de base de datos
Si alguno de los archivos de datos o redo log no está presente cuando la instancia intenta abrir la base de datos, o si los archivos están presentes pero fallan las pruebas de consistencia, la base de datos devuelve un error. Puede ser necesaria la recuperación de medios físicos.
Consulte también: Guía del usuario de copia de seguridad y recuperación de Oracle AI Database para obtener una visión general de la copia de seguridad y la recuperación
Visión General del Cierre de Base de Datos e Instancia
En un caso de uso típico, cierre manualmente la base de datos, lo que hace que no esté disponible para los usuarios mientras realiza tareas de mantenimiento u otras tareas administrativas. Puede utilizar el comando SHUTDOWN de SQL*Plus o Enterprise Manager para realizar estos pasos.
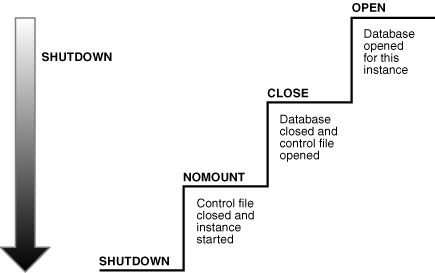
En la siguiente figura, se muestra la progresión de un estado abierto a un cierre consistente.
Figura 4: Secuencia de Cierre de Instancia y Base de Datos
Descripción de la ilustración cncpt281.gif
Oracle AI Database realiza automáticamente los siguientes pasos cada vez que una base de datos abierta se cierra de forma consistente.
Tabla 3 Pasos del Cierre Consistente
| Fase | Estado de montaje | Descripción | Para saber más |
|---|---|---|---|
| 1 | Database closed | La base de datos está montada, pero los archivos de datos en línea y los archivos redo log están cerrados. | "Cómo se Cerra una Base de Datos" |
| 2 | Base de datos desmontada | La instancia se inicia, pero ya no está asociada al archivo de control de la base de datos. | "Cómo se desmonta una base de datos" |
| 3 | Instancia de base de datos cerrada | La instancia de base de datos ya no se inicia. | "Cómo se cierra una instancia" |
Oracle AI Database no realiza todos los pasos anteriores en un fallo de instancia o SHUTDOWN ABORT, que termina inmediatamente la instancia.
-
Modos de Cierre Un administrador de base de datos con privilegios
SYSDBAoSYSOPERpuede cerrar la base de datos mediante el comandoSHUTDOWNde SQL*Plus o Enterprise Manager. El comandoSHUTDOWNtiene opciones que determinan el comportamiento de cierre. -
Cómo se cierra una base de datos La operación de cierre de base de datos está implícita en un cierre de base de datos. La naturaleza de la operación depende de si el cierre de la base de datos es normal o anormal.
-
Cómo se desmonta una base de datos Después de cerrar la base de datos, Oracle AI Database desmonta la base de datos para desasociarla de la instancia.
-
Cómo se cierra una instancia El paso final en el cierre de la base de datos es cerrar la instancia. Cuando la instancia de base de datos se cierra, SGA deja de ocupar memoria y los procesos en segundo plano terminan. Consulte también: Guía del administrador de Oracle AI Database para aprender a cerrar una base de datos
Modos de cierre
Un administrador de base de datos con privilegios SYSDBA o SYSOPER puede cerrar la base de datos mediante el comando SHUTDOWN de SQL*Plus o Enterprise Manager. El comando SHUTDOWN tiene opciones que determinan el comportamiento de cierre.
En la siguiente tabla, se resume el comportamiento de los diferentes modos de cierre.
Tabla 4 Modos de cierre de la base de datos
| Comportamiento de la base de datos | ABORT (ABORT) | IMMEDIATE | TRANSACCIONAL | NORMAL |
|---|---|---|---|---|
| Permite nuevas conexiones de usuario | No | No | No | No |
| Espera hasta que finalicen las sesiones actuales | No | No | No | Sí |
| Espera hasta que finalicen las transacciones actuales | No | No | Sí | Sí |
| Realiza un punto de control y cierra los archivos abiertos | No | Sí | Sí | Sí |
Las posibles sentencias SHUTDOWN son:
-
SHUTDOWN ABORTEste modo está diseñado para situaciones de emergencia, como cuando ninguna otra forma de cierre se realiza correctamente. Este modo de apagado es el más rápido. Sin embargo, una apertura posterior de esta base de datos puede tardar mucho más porque se debe realizar la recuperación de instancias para que los archivos de datos sean coherentes.
Puesto que
SHUTDOWN ABORTno establece un punto de control para los archivos de datos abiertos, la recuperación de la instancia es necesaria para que la base de datos se pueda volver a abrir. Los otros modos de cierre no necesitan la recuperación de la instancia para que la base de datos se pueda volver a abrir.Nota: En una PDB, la emisión de
SHUTDOWN ABORTes equivalente a la emisión deSHUTDOWN IMMEDIATEen el nivel de la CDB. -
SHUTDOWN IMMEDIATEEste modo suele ser el más rápido junto a
SHUTDOWN ABORT. Oracle AI Database termina cualquier sentencia SQL en ejecución y desconecta a los usuarios. Las transacciones activas se terminan y se realiza un rollback de los cambios sin confirmar. -
SHUTDOWN TRANSACTIONALEste modo impide que los usuarios inicien nuevas transacciones, pero espera a que se completen todas las transacciones actuales antes de cerrarlas. Este modo puede llevar mucho tiempo dependiendo de la naturaleza de las transacciones actuales.
-
SHUTDOWN NORMALÉste es el modo predeterminado de cierre. La base de datos espera a que todos los usuarios conectados se desconecten antes de cerrar.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener información sobre los diferentes modos de cierre
-
Guía del usuario y referencia de SQL*Plus para obtener más información sobre el comando
SHUTDOWN
Cómo se cierra una base de datos
La operación de cierre de base de datos está implícita en un cierre de base de datos. La naturaleza de la operación depende de si el cierre de la base de datos es normal o anormal.
-
Cómo se cierra una base de datos durante el cierre normal Cuando una base de datos se cierra como parte de
SHUTDOWNcon cualquier opción que no seaABORT, Oracle AI Database escribe datos en el SGA en los archivos de datos y en los archivos redo log en línea. -
Cómo se cierra una base de datos durante un cierre anormal Si se produce una terminación
SHUTDOWN ABORTo anormal, la instancia de una base de datos abierta se cierra y cierra la base de datos instantáneamente.
Cómo se cierra una base de datos durante el cierre normal
Cuando una base de datos se cierra como parte de una SHUTDOWN con cualquier opción que no sea ABORT, Oracle AI Database escribe datos en SGA en los archivos de datos y en los archivos redo log en línea.
Posteriormente, la base de datos cierra los archivos de datos en línea y los archivos redo log en línea. Los archivos de datos fuera de línea de los tablespaces fuera de línea ya se han cerrado. Cuando la base de datos se vuelve a abrir, cualquier tablespace que estaba fuera de línea permanece fuera de línea.
En esta etapa, la base de datos se cierra y no se puede acceder a ella para las operaciones normales. Los archivos de control permanecen abiertos después de cerrar una base de datos.
Cómo se cierra una base de datos durante un cierre anormal
Si se produce una terminación SHUTDOWN ABORT o anormal, la instancia de una base de datos abierta se cierra y cierra la base de datos de forma instantánea.
En un cierre anormal, Oracle AI Database no escribe datos en los buffers del SGA en los archivos datos y los archivos redo log. La siguiente vez de que vuelva a abrirse la base de datos requerirá la recuperación a instancias, proceso que Oracle AI Database realiza automáticamente.
Cómo se desmonta una base de datos
Después de cerrar la base de datos, Oracle AI Database desmonta la base de datos para desasociarla de la instancia.
Después de desmontar una base de datos, Oracle AI Database cierra los archivos de control de la base de datos. En este punto, la instancia de base de datos permanece en memoria.
Cómo cerrar una instancia
El paso final en el cierre de la base de datos es cerrar la instancia. Cuando la instancia de base de datos se cierra, SGA deja de ocupar memoria y los procesos en segundo plano terminan.
En circunstancias poco habituales, puede que el cierre de una instancia de base de datos no se produzca correctamente. Es posible que las estructuras de memoria no se eliminen de la memoria o que uno de los procesos en segundo plano no se termine. Cuando existen restos de una instancia anterior, puede fallar un inicio de instancia posterior. En tales situaciones, puede forzar el inicio de la nueva instancia eliminando los restos de la instancia anterior y, a continuación, iniciando una nueva instancia o emitiendo una sentencia SHUTDOWN ABORT.
En algunos casos, la limpieza de procesos en sí puede encontrar errores, lo que puede provocar la terminación del monitor de procesos (PMON) o la instancia. El parámetro de inicialización dinámica INSTANCE_ABORT_DELAY_TIME especifica cuántos segundos debe retrasar un fallo de instancia generado internamente. Este retraso le da la oportunidad de responder. La base de datos escribe un mensaje en el log de alertas cuando se inicia la terminación retrasada. En algunas circunstancias, al permitir que determinados recursos de la base de datos se pongan en cuarentena, la instancia puede evitar la terminación.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener información más detallada sobre el cierre de la base de datos
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
INSTANCE_ABORT_DELAY_TIME
Visión General de los Puntos de Control
Un punto de control es un mecanismo crucial para los cierres de bases de datos coherentes, la recuperación de instancias y la operación de Oracle AI Database en general.
El término tiene los siguientes significados relacionados:
-
Estructura de datos que indica la posición de punto de control, que es el SCN en el flujo de redo donde debe comenzar la recuperación de instancias
La posición del punto de control viene determinada por el buffer sucio más antiguo de la caché de buffers de la base de datos. La posición del punto de control actúa como puntero al flujo de redo y se almacena en el archivo de control y en cada cabecera del archivo de datos.
-
Escritura de buffers de base de datos modificados en la caché de buffers de base de datos en el disco
-
Propósito de los puntos de control Oracle AI Database utiliza puntos de control para lograr varios objetivos.
-
Cuando Oracle AI Database inicia puntos de control el proceso de punto de control (CKPT) es responsable de escribir puntos de control en las cabeceras y el archivo de control del archivo de datos. Consulte también: "Números de cambio del sistema (SCN)"
Objetivo de los puntos de control
Oracle AI Database utiliza puntos de control para lograr varios objetivos.
Los objetivos incluyen los siguientes:
-
Reducir el tiempo necesario para una recuperación en caso de fallo de una instancia o un medio físico
-
Asegúrese de que la base de datos escribe regularmente buffers sucios en la caché de buffers en el disco.
-
Asegúrese de que la base de datos escribe todos los datos confirmados en el disco durante un cierre consistente
Cuando Oracle AI Database inicia puntos de control
El proceso de punto de control (CKPT) es responsable de escribir puntos de control en las cabeceras y el archivo de control del archivo de datos.
Los puntos de control se producen en diversas situaciones. Por ejemplo, Oracle AI Database utiliza los siguientes tipos de puntos de control:
-
Puntos de control de thread
La base de datos escribe en el disco todos los buffers modificados por redo en un thread específico antes de un destino determinado. El juego de puntos de control de thread en todas las instancias de una base de datos es un punto de control de base de datos. Los puntos de control de thread se producen en las siguientes situaciones:
-
Cierre consistente de la base de datos
-
Sentencia
ALTER SYSTEM CHECKPOINT -
Cambio de redo log online
-
Sentencia
ALTER DATABASE BEGIN BACKUP
-
-
Tablespace y puntos de control de archivos de datos
La base de datos escribe en el disco todos los buffers modificados por redo antes de un destino específico. Un punto de control de tablespace es un juego de puntos de control de archivos de datos, uno para cada archivo de datos del tablespace. Estos puntos de control se producen en diversas situaciones, como hacer que un tablespace sea de solo lectura o ponerlo fuera de línea normal, reducir un archivo de datos o ejecutar
ALTER TABLESPACE BEGIN BACKUP. -
Puntos de control incrementales
Un punto de control incremental es un tipo de punto de control de thread destinado en parte a evitar escribir un gran número de bloques en los cambios de redo log en línea. DBW comprueba al menos cada tres segundos para determinar si tiene trabajo que hacer. Cuando DBW escribe buffers sucios, avanza la posición del punto de control, lo que hace que CKPT escriba la posición del punto de control en el archivo de control, pero no en las cabeceras del archivo de datos.
Otros tipos de puntos de control incluyen puntos de control y de recuperación de medios físicos e instancias cuando los objetos de esquema se borran o truncan.
Consulte además:
-
Guía de despliegue y administración de Oracle Real Application Clusters para obtener información sobre los puntos de control globales en Oracle RAC
Visión General de Recuperación de Instancias
La recuperación de instancias es el proceso de aplicación de registros en el redo log en línea a los archivos de datos para reconstruir los cambios realizados después del punto de control más reciente.
La recuperación de instancias se produce automáticamente cuando un administrador intenta abrir una base de datos que anteriormente se había cerrado de forma inconsistente.
-
La recuperación de instancias de Propósito de la recuperación de instancias garantiza que la base de datos esté en un estado consistente después de un fallo de instancia. Los archivos de una base de datos se pueden dejar en un estado inconsistente debido a cómo Oracle AI Database gestiona los cambios de la base de datos.
-
Cuando Oracle AI Database realiza una recuperación de instancia La necesidad de recuperación de instancia depende del estado de los threads de redo.
-
La recuperación de instancias de Importancia de puntos de control para la recuperación de instancias utiliza puntos de control para determinar qué cambios se deben aplicar a los archivos de datos. La posición del punto de control garantiza que cada cambio confirmado con un SCN menor que el SCN del punto de control se guarde en los archivos de datos.
-
Fases de Recuperación de Instancias La primera fase de recuperación de instancias se denomina recuperación de caché o avanzar y vuelve a aplicar todos los cambios registrados en el redo log en línea a los archivos de datos.
Objetivo de la Recuperación de Instancias
La recuperación de instancias garantiza que la base de datos se encuentre en un estado consistente después de un fallo de la instancia. Los archivos de una base de datos se pueden dejar en un estado inconsistente debido a cómo Oracle AI Database gestiona los cambios de la base de datos.
Un subproceso de deshacer es un registro de todos los cambios generados por una instancia. Una base de datos de instancia única tiene un thread de redo, mientras que una base de datos Oracle RAC tiene varios threads de redo, uno para cada instancia de base de datos.
Cuando se confirma una transacción, el proceso de escritor de logs (LGWR) escribe tanto las entradas de redo restantes en la memoria como el SCN de la transacción en el redo log en línea. Sin embargo, el proceso de escritor de base de datos (DBW) escribe bloques de datos modificados en los archivos de datos siempre que sea más eficaz. Por este motivo, los cambios sin confirmar pueden existir temporalmente en los archivos de datos mientras que los cambios confirmados aún no existen en los archivos de datos.
Si falla una instancia de una base de datos abierta, ya sea debido a una sentencia SHUTDOWN ABORT o a una terminación anormal, pueden producirse las siguientes situaciones:
-
Los bloques de datos confirmados por una transacción no se escriben en los archivos de datos y solo aparecen en el redo log en línea. Estos cambios se deben volver a aplicar a los archivos de datos.
-
Los archivos de datos contienen cambios que no se han confirmado cuando falló la instancia. Se debe realizar un rollback de estos cambios para garantizar la consistencia transaccional.
La recuperación de instancias utiliza solo archivos redo log en línea y archivos de datos en línea actuales para sincronizar los archivos de datos y garantizar que sean coherentes.
Consulte además:
Cuando Oracle AI Database realiza una recuperación de instancia
La necesidad de recuperación de instancias depende del estado de los threads de redo.
Un thread de redo se marca como abierto en el archivo de control cuando una instancia de base de datos se abre en modo de lectura/escritura y se marca como cerrado cuando la instancia se cierra de forma consistente. Si los threads de redo se marcan como abiertos en el archivo de control, pero ninguna instancia activa contiene las colas de threads correspondientes a estos threads, la base de datos necesita la recuperación de la instancia.
Oracle AI Database realiza la recuperación de instancias automáticamente en las siguientes situaciones:
-
La base de datos se abre por primera vez después del fallo de una base de datos de instancia única o de todas las instancias de una base de datos Oracle RAC. Esta forma de recuperación de instancias también se denomina recuperación por caída. Oracle AI Database recupera los threads de redo en línea de las instancias terminadas juntas.
-
Algunas instancias de una base de datos Oracle RAC, pero no todas, fallan. La recuperación de instancias la realiza automáticamente una instancia restante en la configuración.
El proceso en segundo plano SMON realiza la recuperación de instancias y aplica el redo en línea automáticamente. No se requiere intervención del usuario.
Consulte además:
-
Oracle Real Application Clusters Administration and Deployment Guide para obtener más información sobre la recuperación de instancias en una base de datos Oracle RAC
Importancia de los puntos de control para la recuperación de instancias
La recuperación de instancias utiliza puntos de control para determinar qué cambios se deben aplicar a los archivos de datos. La posición del punto de control garantiza que cada cambio confirmado con un SCN menor que el SCN del punto de control se guarde en los archivos de datos.
En la siguiente figura se muestra el thread de redo en el redo log en línea.
Figura 5: Posición de Punto de Control en Redo Log en Línea
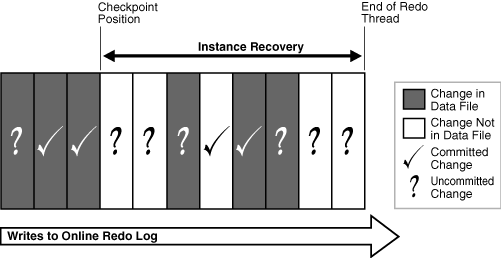
Descripción de la ilustración cncpt282.gif
Durante la recuperación de instancias, la base de datos debe aplicar los cambios que se producen entre la posición del punto de control y el final del thread de redo. Como se muestra en la Figura 16-5, es posible que algunos cambios ya se hayan escrito en los archivos de datos. Sin embargo, solo los cambios con SCN inferiores a la posición del punto de control están garantizados de estar en el disco.
Consulte también: Guía de ajuste de rendimiento de Oracle AI Database para aprender a limitar el tiempo de recuperación de instancias
Fases de Recuperación de Instancias
La primera fase de recuperación de instancias se denomina recuperación de caché o avanzar y vuelve a aplicar todos los cambios registrados en el redo log en línea a los archivos de datos.
Puesto que el redo log en línea contiene datos de deshacer, el reenvío también regenera los segmentos de deshacer correspondientes. El avance continúa a través de tantos archivos redo log en línea como sea necesario para que la base de datos avance a tiempo. Después de la operación de transferencia, los bloques de datos contienen todos los cambios confirmados registrados en los archivos redo log en línea. Estos archivos también pueden contener cambios sin confirmar que se hayan guardado en los archivos de datos antes del fallo o que se hayan registrado en el redo log en línea y que se hayan introducido durante la recuperación de caché.
Después de la renovación, cualquier cambio que no se haya confirmado se debe deshacer. Oracle AI Database utiliza la posición del punto de control, lo que garantiza que todos los cambios confirmados con un SCN inferior al SCN del punto de control se guarden en el disco. Oracle AI Database aplica bloques de deshacer para realizar un rollback de los cambios sin confirmar en los bloques de datos que se escribieron antes del fallo o se introdujeron durante la recuperación de caché. Esta fase se denomina reversión o recuperación de transacciones.
En la siguiente figura, se muestran los dos pasos necesarios para realizar una recuperación tras un fallo de la instancia de base de datos.
Figura 6: Pasos Básicos de Recuperación de Instancias: Reversión y Reversión
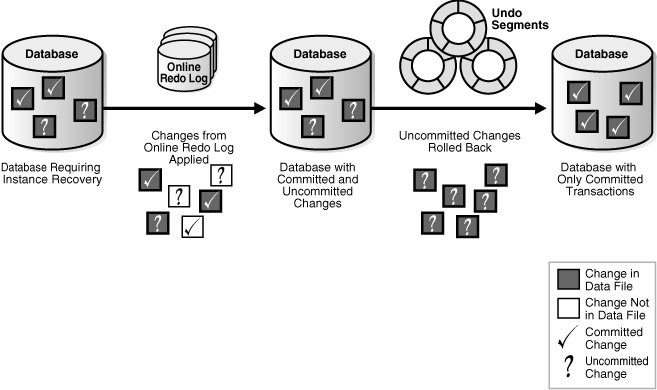
Descripción de la ilustración cncpt196.gif
Oracle AI Database puede realizar un rollback de varias transacciones simultáneamente según sea necesario. Todas las transacciones que estaban activas en el momento del fallo se marcan como finalizadas. En lugar de esperar a que el proceso SMON realice un rollback de las transacciones terminadas, las nuevas transacciones pueden realizar un rollback de bloques individuales para obtener los datos necesarios.
Consulte además:
-
"Segmentos de Deshacer" para obtener más información sobre los datos de deshacer
-
Oracle AI Database Performance Tuning Guide para un análisis de la mecánica y el ajuste de la recuperación de instancias
Visión general de los archivos de parámetros
Para iniciar una instancia de base de datos, Oracle AI Database debe leer un archivo de parámetros del servidor, que se recomienda, o un archivo de parámetros de inicialización de texto, que es una implementación heredada. Estos archivos contienen una lista de parámetros de configuración.
Para crear una base de datos manualmente, debe iniciar una instancia con un archivo de parámetros y, a continuación, emitir una sentencia CREATE DATABASE. Por lo tanto, la instancia y el archivo de parámetros pueden existir incluso cuando la base de datos en sí no existe.
-
Los parámetros de inicialización son parámetros de configuración que afectan al funcionamiento básico de una instancia. La instancia lee los parámetros de inicialización de un archivo en el inicio.
-
Archivos de parámetros del servidor Un archivo de parámetros del servidor es un repositorio para los parámetros de inicialización.
-
Archivos de Parámetros de Inicialización de Texto Un archivo de parámetros de inicialización de texto es un archivo de texto que contiene una lista de parámetros de inicialización.
-
Modificación de Valores de Parámetros de Inicialización Puede ajustar los parámetros de inicialización para modificar el comportamiento de una base de datos. La clasificación de los parámetros como static o dynamic determina cómo se pueden modificar.
Parámetros de Inicialización
Los parámetros de inicialización son parámetros de configuración que afectan al funcionamiento básico de una instancia. La instancia lee los parámetros de inicialización de un archivo en el inicio.
Oracle AI Database proporciona muchos parámetros de inicialización para optimizar su funcionamiento en diversos entornos. Solo se deben definir explícitamente algunos de estos parámetros porque los valores por defecto suelen ser los adecuados.
-
Los parámetros de inicialización de los grupos funcionales de parámetros de inicialización se dividen en diferentes grupos funcionales.
-
Parámetros de Inicialización Básicos y Avanzados Los parámetros de inicialización se dividen en dos grupos: básico y avanzado.
Grupos funcionales de parámetros de inicialización
Los parámetros de inicialización se dividen en diferentes grupos funcionales.
La mayoría de los parámetros de inicialización pertenecen a uno de los siguientes grupos:
-
Parámetros que asignan nombres a entidades como archivos o directorios
-
Parámetros que definen los límites de un proceso, recurso de base de datos o la propia base de datos
-
Parámetros que afectan la capacidad, como el tamaño de la SGA (estos parámetros se denominan parámetros variables)
Los parámetros variables son de especial interés para los administradores de la base de datos porque pueden utilizar estos parámetros para mejorar el rendimiento de la base de datos.
Parámetros de Inicialización Básica y Avanzada
Los parámetros de inicialización se dividen en dos grupos: básico y avanzado.
Normalmente, debe definir y ajustar solo los aproximadamente 30 parámetros básicos para obtener un rendimiento razonable. Los parámetros básicos definen características como el nombre de la base de datos, las ubicaciones de los archivos de control, el tamaño de bloque de la base de datos y el tablespace de deshacer.
En raras situaciones, puede ser necesario modificar los parámetros avanzados para obtener un rendimiento óptimo. Los parámetros avanzados permiten a los DBA expertos adaptar el comportamiento de Oracle AI Database para cumplir con requisitos únicos.
Oracle AI Database proporciona valores en el archivo de parámetros de inicialización de inicio proporcionado con el software de la base de datos o según lo haya creado el asistente de configuración de bases de datos (DBCA). Puede editar estos parámetros de inicialización proporcionados por Oracle y agregar otros, según la configuración y la forma en que planea ajustar la base de datos. Para los parámetros de inicialización relevantes no incluidos en el archivo de parámetros, Oracle AI Database proporciona los valores por defecto.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a especificar los parámetros de inicialización
-
Oracle AI Database Reference para obtener una explicación de los tipos de parámetros de inicialización
-
Referencia de Oracle AI Database para obtener una descripción de
V$PARAMETERy Referencia y guía del usuario de SQL*Plus para la sintaxisSHOW PARAMETER
Archivos de Parámetros del Servidor
Un archivo de parámetros del servidor es un repositorio para los parámetros de inicialización.
Un archivo de parámetros del servidor tiene las siguientes características clave:
-
Solo Oracle AI Database lee y escribe en el archivo de parámetros del servidor.
-
Solo existe un archivo de parámetros de servidor para una base de datos. Este archivo debe residir en el host de la base de datos.
-
El archivo de parámetros del servidor es binario y no puede ser modificado por un editor de texto.
-
Los parámetros de inicialización almacenados en el archivo de parámetros del servidor son persistentes. Cualquier cambio realizado en los parámetros mientras se ejecuta una instancia de base de datos puede persistir en el cierre y el inicio de la instancia.
Un archivo de parámetros del servidor elimina la necesidad de mantener varios archivos de parámetros de inicialización de texto para las aplicaciones cliente. Un archivo de parámetros del servidor se crea inicialmente a partir de un archivo de parámetros de inicialización de texto mediante la sentencia CREATE SPFILE. También se puede crear directamente mediante el asistente de configuración de bases de datos.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre los archivos de parámetros del servidor
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre
CREATE SPFILE
Archivos de Parámetros de Inicialización de Texto
Un archivo de parámetros de inicialización de texto es un archivo de texto que contiene una lista de parámetros de inicialización.
Este tipo de archivo de parámetros, que es una implementación heredada del archivo de parámetros, tiene las siguientes características clave:
-
Al iniciar o cerrar una base de datos, el archivo de parámetros de inicialización de texto debe residir en el mismo host que la aplicación cliente que se conecta a la base de datos.
-
Un archivo de parámetros de inicialización de texto está basado en texto, no en binario.
-
Oracle AI Database puede leer pero no escribir en el archivo de parámetros de inicialización de texto. Para cambiar los valores de parámetros, debe modificar manualmente el archivo con un editor de texto.
-
Los cambios en los valores de parámetros de inicialización por
ALTER SYSTEMsolo están en vigor para la instancia actual. Debe actualizar manualmente el archivo de parámetros de inicialización de texto y reiniciar la instancia para que se conozcan los cambios.
El archivo de parámetros de inicialización de texto contiene una serie de pares key=value, uno por línea. Por ejemplo, una parte de un archivo de parámetros de inicialización podría tener el siguiente aspecto:
db_name=sample
control_files=/disk1/oradata/sample_cf.dbf
db_block_size=8192
open_cursors=52
undo_management=auto
shared_pool_size=280M
pga_aggregate_target=29M
.
.
.
Para ilustrar los problemas de gestión que pueden crear los archivos de parámetros de texto, suponga que utiliza los equipos clienta y clientb y debe poder iniciar la base de datos con SQL*Plus en cualquiera de los equipos. En este caso, deben existir dos archivos de parámetros de inicialización de texto independientes, uno en cada equipo, como se muestra en la Figure 16-7. Un archivo de parámetros del servidor resuelve el problema de la proliferación de archivos de parámetros.
Figura 7: Varios archivos de parámetros de inicialización
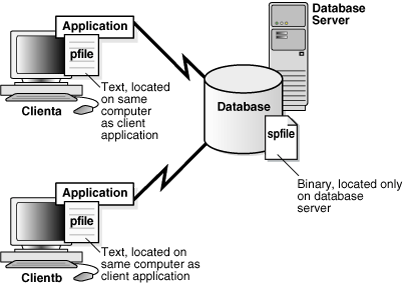
Descripción de la ilustración cncpt247.gif
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre los archivos de parámetros de inicialización de texto
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre
CREATE PFILE
Modificación de Valores de Parámetros de Inicialización
Puede ajustar los parámetros de inicialización para modificar el comportamiento de una base de datos. La clasificación de los parámetros como static o dynamic determina cómo se pueden modificar.
En la siguiente tabla se resumen las diferencias.
Tabla 5 Parámetros de inicialización estáticos y dinámicos
| Característica | Estático | Dinámico |
|---|---|---|
| Requiere modificación del archivo de parámetros (texto o servidor) | Sí | No |
| Necesita reiniciar la instancia de base de datos antes de que se aplique el valor | Sí | No |
| Se describe como "Modificable" en la entrada del parámetro de inicialización Oracle AI Database Reference | No | Sí |
| Solo modificable para la base de datos o la instancia | Sí | No |
Los parámetros estáticos incluyen DB_BLOCK_SIZE, DB_NAME y COMPATIBLE. Los parámetros dinámicos se agrupan en parámetros de nivel de sesión, que afectan sólo a la sesión de usuario actual, y parámetros de nivel de sistema, que afectan a la base de datos y a todas las sesiones. Por ejemplo, MEMORY_TARGET es un parámetro de nivel de sistema, mientras que NLS_DATE_FORMAT es un parámetro de nivel de sesión.
El ámbito de un cambio de parámetro depende de cuándo se aplique el cambio. Cuando se ha iniciado una instancia con un archivo de parámetros de servidor, puede utilizar la sentencia ALTER SYSTEM SET para cambiar los valores de los parámetros de nivel de sistema de la siguiente manera:
-
SCOPE=MEMORYLos cambios se aplican solo a la instancia de base de datos. El cambio no se mantendrá si la base de datos se cierra y se reinicia.
-
SCOPE=SPFILELos cambios se aplican al archivo de parámetros del servidor, pero no afectan a la instancia actual. Por lo tanto, los cambios no se aplican hasta que se reinicia la instancia.
Nota: Debe especificar
SPFILEal cambiar el valor de un parámetro que se describe como no modificable en Oracle AI Database Reference. -
SCOPE=BOTHOracle AI Database escribe cambios tanto en la memoria como en el archivo de parámetros del servidor. Este es el ámbito por defecto cuando la base de datos utiliza un archivo de parámetros de servidor.
La base de datos imprime el nuevo valor y el antiguo valor de un parámetro de inicialización en el log de alertas. Como medida preventiva, la base de datos valida los cambios de parámetros básicos para evitar que se escriban valores no válidos en el archivo de parámetros del servidor.
Consulte además:
-
Oracle AI Database Globalization Support Guide para obtener información sobre cómo seleccionar una configuración regional con la variable de entorno
NLS_LANG -
Oracle AI Database Administrator's Guide para aprender a cambiar la configuración de los parámetros de inicialización
-
Oracle AI Database Reference para obtener descripciones de todos los parámetros de inicialización
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
ALTER SYSTEM
Descripción general de archivos de diagnóstico
Oracle AI Database incluye una infraestructura de diagnóstico de fallos para prevenir, detectar, diagnosticar y resolver problemas de la base de datos. Los problemas incluyen errores críticos, como bugs de código, corrupción de metadatos y corrupción de datos de clientes.
Los objetivos de la infraestructura avanzada de diagnóstico de fallos son los siguientes:
-
Detección de problemas de forma proactiva
-
Limitación de daños e interrupciones después de detectar un problema
-
Reducción del tiempo de diagnóstico y resolución de problemas
-
Mejora de la capacidad de gestión mediante la activación de la partición de los archivos de rastreo, lo que permite al usuario definir el tamaño por pieza y el número máximo de piezas que retener, y desactivando el rastreo después de alcanzar un límite de espacio en disco especificado por el usuario
-
Simplificación de la interacción del cliente con los Servicios de Soporte Oracle
-
Repositorio de Diagnóstico Automático Repositorio de Diagnóstico Automático (ADR) es un repositorio basado en archivos que almacena datos de diagnóstico de la base de datos, como archivos de rastreo, el log de alertas, el log DDL y los informes de supervisión de estado.
-
Log de alertas Cada base de datos tiene un log de alertas, que es un archivo que contiene un log cronológico de mensajes y errores de la base de datos.
-
Log de atención Cada base de datos tiene un log de atención, que contiene eventos de base de datos críticos y muy visibles.
-
Log de DDL: el log de DDL tiene el mismo formato y comportamiento básico que el log de alertas, pero solo contiene sentencias y detalles de DDL. La base de datos escribe la información DDL en su propio archivo para reducir el desorden en el log de alertas.
-
Archivos de rastreo Un archivo de rastreo es un archivo que contiene datos de diagnóstico utilizados para investigar problemas. Además, los archivos de rastreo pueden proporcionar orientación para ajustar aplicaciones o una instancia.
-
Volcados de diagnóstico Un archivo de volcado de diagnóstico es un tipo especial de archivo de rastreo que contiene información detallada puntual sobre un estado o una estructura. Consulte también: Guía del administrador de Oracle AI Database para obtener información sobre cómo gestionar archivos de diagnóstico
Repositorio de Diagnóstico Automático
El repositorio de diagnóstico automático (ADR) es un repositorio basado en archivos que almacena datos de diagnóstico de la base de datos, como archivos de rastreo, el log de alertas, el log DDL y los informes de supervisión de estado.
Las características clave de ADR incluyen:
-
Estructura de directorios unificada
-
Formatos de datos de diagnóstico consistentes
-
Conjunto de herramientas unificado
Las características anteriores permiten a los clientes y a los Servicios de Soporte Oracle correlacionar y analizar datos de diagnóstico en varias instancias, componentes y productos de Oracle.
ADR se encuentra fuera de la base de datos, lo que permite a Oracle AI Database acceder y gestionar ADR cuando la base de datos física no está disponible. Una instancia de base de datos puede crear ADR antes de crear una base de datos.
-
ADR de Problemas e incidentes realiza un seguimiento proactivo de los problemas, que son errores críticos en la base de datos.
-
Estructura de ADR base de ADR es el directorio raíz de ADR.
Problemas e Incidentes
ADR realiza un seguimiento proactivo de los problemas, que son errores críticos en la base de datos.
Los errores críticos se manifiestan como errores internos, como ORA-600, u otros errores graves. Cada problema dispone de una clave de problema, que es una cadena de texto que lo describe.
Cuando se produce un problema varias veces, ADR crea un incidente con registro de hora para cada incidencia. Un incidente se identifica de forma única mediante un ID de incidente numérico. Cuando se produce un incidente, ADR envía una alerta de incidente a Enterprise Manager. El diagnóstico y la resolución de errores críticos suelen comenzar a partir de una alerta de incidente.
Debido a que un problema puede generar muchos incidentes en poco tiempo, ADR aplica el control de inundación a la generación de incidentes después de que se alcancen ciertos umbrales. Un incidente controlado por el flujo genera una entrada de log de alertas, pero no genera volcados de incidentes. De esta manera, ADR le informa que hay un error crítico en curso sin sobrecargar el sistema con datos de diagnóstico.
Consulte también: Guía del administrador de Oracle AI Database para obtener información detallada sobre la infraestructura de diagnóstico de fallos
Estructura de ADR
ADR base es el directorio raíz de ADR.
La base de ADR puede contener varios directorios raíz de ADR, donde cada directorio raíz de ADR es el directorio raíz para todos los rastreos de datos de diagnóstico, volcados, el log de alertas, etc. para una instancia de un producto o componente de Oracle. Por ejemplo, en un entorno de Oracle RAC con almacenamiento compartido y Oracle ASM, cada instancia de base de datos y cada instancia de Oracle ASM tienen su propio directorio raíz de ADR. La Figura 16-8 ilustra la jerarquía de directorios de ADR para una instancia de base de datos. En esta jerarquía pueden existir otros directorios raíz de ADR para otros productos o componentes de Oracle, como Oracle ASM u Oracle Net Services, en la misma base de ADR.
Figura 8: Estructura de directorios de ADR para una instancia de Oracle AI Database
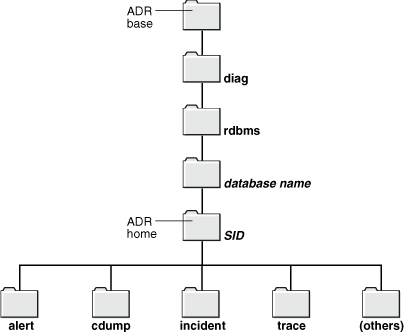
Descripción de la ilustración admin077.gif
Como se muestra en el siguiente ejemplo de Linux, al iniciar una instancia con un SID y un nombre de base de datos únicos antes de crear una base de datos, Oracle AI Database crea ADR por defecto como una estructura de directorios en el sistema de archivos del host. El SID y el nombre de la base de datos forman parte del nombre de ruta de acceso para los archivos del directorio raíz de ADR.
Ejemplo 16-1 Creación de ADR
% setenv ORACLE_SID osi
% echo "DB_NAME=dbn" > init.ora
% sqlplus / as sysdba
.
.
.
Connected to an idle instance.

SQL> STARTUP NOMOUNT PFILE="./init.ora"
ORACLE instance started.

Total System Global Area  146472960 bytes
Fixed Size                  1317424 bytes
Variable Size              92276176 bytes
Database Buffers           50331648 bytes
Redo Buffers                2547712 bytes

SQL> COL NAME FORMAT a21
SQL> COL VALUE FORMAT a60
SQL> SELECT NAME, VALUE FROM V$DIAG_INFO;

NAME                  VALUE
--------------------- --------------------------------------------------------
Diag Enabled          TRUE
ADR Base              /d1/3910926111/oracle/log
ADR Home              /d1/3910926111/oracle/log/diag/rdbms/dbn/osi
Diag Trace            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace
Diag Alert            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/alert
Diag Incident         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/incident
Diag Cdump            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/cdump
Health Monitor        /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/hm
Default Trace File    /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/osi_ora_29229.trc
Active Problem Count  0
Active Incident Count 0
ORACLE_HOME           /d1/3910926111/oracle
Attention Log         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/attention_osi.log
13 rows selected.
Log de Alertas
Cada base de datos tiene un alert log, que es un archivo que contiene un log cronológico de mensajes y errores de la base de datos.
El contenido del log de alertas incluye lo siguiente:
-
Todos los errores internos (
ORA-600), los errores de corrupción de bloques (ORA-1578) y los errores deadlock (ORA-60) -
Operaciones administrativas como los comandos
STARTUP,SHUTDOWN,ARCHIVE LOGyRECOVERde SQL*Plus -
Varios mensajes y errores relacionados con las funciones de los procesos de servidor compartido y distribuidor
-
Errores durante el refrescamiento automático de una vista materializada
Si una operación administrativa se realiza correctamente, Oracle AI Database escribe un mensaje en el log de alertas como "completado" junto con un registro de hora.
Oracle AI Database crea un log de alertas en el subdirectorio alert que se muestra en la Figura 16-8 al iniciar por primera vez una instancia de base de datos, incluso si aún no se ha creado ninguna base de datos. Este archivo se encuentra en formato XML. El subdirectorio trace contiene un log de alertas de solo texto.
Consulte V$DIAG_INFO para localizar el log de alertas.
Log de atención
Cada base de datos tiene un log de atención, que contiene eventos de base de datos críticos y muy visibles.
El log de atención incluye solo eventos de base de datos críticos y muy visibles, lo que permite identificar una alerta y realizar las acciones adecuadas. Cada mensaje del log de atención tiene varios atributos, incluidos el público objetivo, la causa y una acción que se debe realizar. El log de atención proporciona información con el siguiente formato:
-
ID de mensaje de atención
-
Tipo de mensaje de atención: error, notificación, advertencia
-
Urgencia del mensaje de atención: DEFERABLE, INMEDIATE, INFO, SOON
-
Ámbito de mensaje de atención: CDB, cluster de CDB, instancia de CDB, PDB, sesión, instancia de PDB, proceso, sesión
-
Texto del mensaje de atención
-
Usuario de destino del mensaje de atención: administrador de CDB, administrador de Clusterware, administrador de PDB
-
Causa
-
Acción
Oracle AI Database crea un log de atención denominado attention_ORACLE_SID.log en el subdirectorio trace que se muestra en la Figura 16-8. También puede consultar V$DIAG_INFO para localizar el log de atención.
Log de DDL
El log DDL tiene el mismo formato y el mismo comportamiento básico que el log de alertas, pero solo contiene sentencias DDL y detalles. La base de datos escribe la información DDL en su propio archivo para reducir el desorden en el log de alertas.
Los registros log DDL son texto DDL, que, opcionalmente, se aumenta con información adicional. Existe un registro log para cada sentencia DDL. El log DDL se almacena en el subdirectorio log/ddl del directorio raíz de ADR.
Archivos de Rastreo
Un archivo de rastreo es un archivo que contiene datos de diagnóstico utilizados para investigar problemas. Además, los archivos de rastreo pueden proporcionar orientación para ajustar aplicaciones o una instancia.
-
Tipos de archivos de rastreo Cada proceso de servidor y en segundo plano puede escribir periódicamente en un archivo de rastreo asociado. Los archivos contienen información sobre el entorno del proceso, el estado, las actividades y los errores.
-
ADR de Ubicaciones de Archivos de Rastreo almacena archivos de rastreo en el subdirectorio
trace. Los nombres de archivo de rastreo dependen de la plataforma y utilizan la extensión.trc. -
Segmentación de Archivos de Rastreo Cuando el tamaño del archivo de rastreo es limitado, la base de datos puede dividirlo automáticamente en un máximo de cinco segmentos. Los segmentos son archivos independientes que tienen el mismo nombre que el archivo de rastreo activo, pero con un número de segmento agregado, como en
ora_1234_2.trc. Consulte también: Oracle AI Database: Introducción al ajuste del rendimiento
Tipos de archivos de rastreo
Cada proceso de servidor y en segundo plano puede escribir periódicamente en un archivo de rastreo asociado. Los archivos contienen información sobre el entorno del proceso, el estado, las actividades y los errores.
La utilidad de rastreo SQL también crea archivos de rastreo, que proporcionan información de rendimiento sobre sentencias SQL individuales. Puede activar el rastreo de un identificador de cliente, servicio, módulo, acción, sesión, instancia o base de datos de varias formas. Por ejemplo, puede ejecutar los procedimientos adecuados en el paquete DBMS_MONITOR o definir eventos.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre los archivos de rastreo, los volcados y los archivos del núcleo central
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre el rastreo de aplicaciones
Ubicaciones de archivos de rastreo
ADR almacena los archivos de rastreo en el subdirectorio trace. Los nombres de archivo de rastreo dependen de la plataforma y utilizan la extensión .trc.
Normalmente, los nombres de los archivos de rastreo de procesos en segundo plano de la base de datos contienen el SID de Oracle, el nombre del proceso en segundo plano y el número de proceso del sistema operativo. Un ejemplo de archivo de rastreo para el proceso RECO es mytest_reco_10355.trc.
Los nombres de archivo de rastreo de procesos del servidor contienen el SID de Oracle, la cadena ora y el número de proceso del sistema operativo. Un ejemplo de nombre de archivo de rastreo de procesos de servidor es mytest_ora_10304.trc.
A veces, los archivos de rastreo tienen los correspondientes archivos de metadatos de rastreo, que terminan con la extensión .trm. Estos archivos contienen información estructural denominada trace maps que la base de datos utiliza para la búsqueda y la navegación.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a buscar archivos de rastreo
Segmentación de archivos de rastreo
Cuando el tamaño del archivo de rastreo es limitado, la base de datos puede dividirlo automáticamente en un máximo de cinco segmentos. Los segmentos son archivos independientes que tienen el mismo nombre que el archivo de rastreo activo, pero con un número de segmento agregado, como en ora_1234_2.trc.
Cada segmento suele ser el 20% del límite definido por MAX_DUMP_FILE_SIZE. Cuando el tamaño combinado de todos los segmentos supera el límite, la base de datos suprime el segmento más antiguo (aunque nunca el primer segmento, que puede contener información relevante sobre el estado inicial del proceso) y, a continuación, crea un nuevo segmento vacío.
Consulte también: Guía del administrador de Oracle AI Database para aprender a controlar el tamaño de los archivos de rastreo
Volcados de Diagnóstico
Un archivo de volcado de diagnóstico es un tipo especial de archivo de rastreo que contiene información detallada puntual sobre un estado o una estructura.
Un rastreo tiende a ser una salida continua de datos de diagnóstico. Por el contrario, un volcado suele ser una salida puntual de datos de diagnóstico en respuesta a un evento.
- Rastreo de Volcados e Incidentes La mayoría de los volcados se producen debido a incidentes.
Rastreo de volcados e incidentes
La mayoría de los volcados se producen debido a incidentes.
Cuando se produce un incidente, la base de datos escribe uno o más volcados en el directorio de incidentes creado para el incidente. Los volcados de incidentes también contienen el número de incidente en el nombre del archivo.
Durante la creación del incidente, una aplicación puede realizar un volcado de estado de pila o del sistema como parte de una acción. En estos casos, la base de datos agrega el nombre del volcado al nombre del archivo de incidente en lugar del nombre del archivo de rastreo por defecto. Por ejemplo, debido a un incidente en un proceso, la base de datos crea el archivo prod_ora_90348.trc. Un volcado en el incidente genera el archivo prod_ora_90348_incident_id.trc, donde incident_id es el ID numérico del incidente. Una acción de volcado de pila creada como parte del incidente genera el archivo de volcado de pila prod_ora_90348_incident_id_dump_id.trc, donde dump_id es el ID numérico del volcado de rastreo.